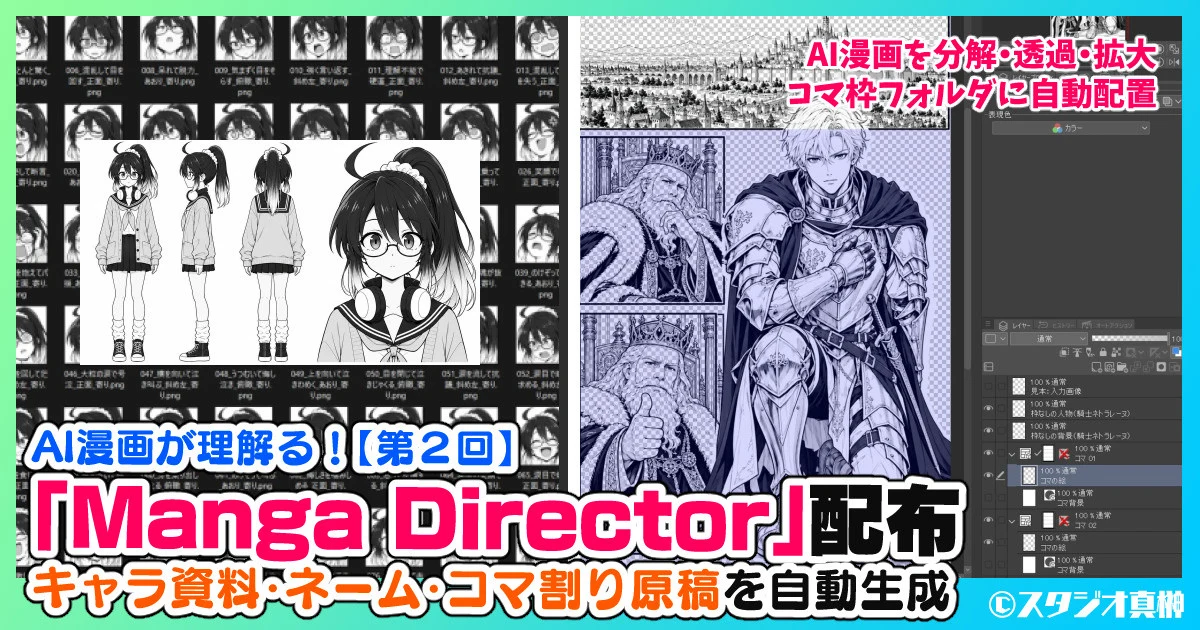

こんばんは、スタジオ真榊です。AIを使った漫画作りの現在地を検証する連載「AI漫画が理解る!」の第2回です。前回は、AI漫画が「絵はきれいなのに読みにくく、退屈」になってしまう理由を4つの問題点に整理しましたので、今回はその解消編です。
試行錯誤の結果、「リファレンス資料の整備」「AIネームの作成」「クリスタ原稿への変換」という3段階を自動化する漫画スキル「Manga Director」を作ることで、不自然さをかなり解消することができました。今回はその仕組みを解説するとともに、スキル本体を配布します。
「Manga Director」は、Codex向けの漫画スキルです。キャラクターを一貫性を持って再現できる資料を自動整備し、読みやすい情報量に整理した上、人間が自由に編集できる形で出力できるのが特徴。今回の特集では、スキルを使って「AI臭」をどれだけ脱臭できるか、実際に漫画を作りながら検証していきたいと思います。【約1万7500字】
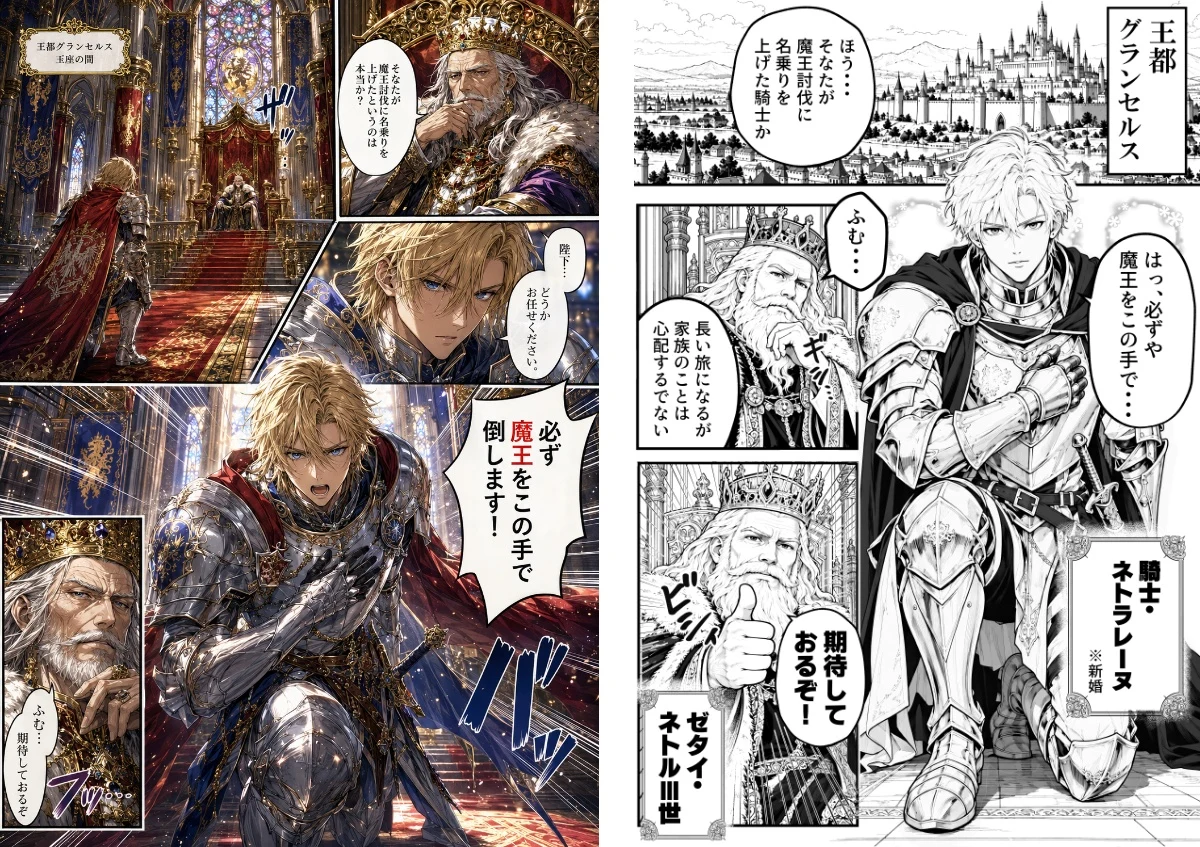
▲情報過多で読み順も分かりにくいAI漫画(左)を、スキルで交通整理
1.「4つの不自然さ」とその解消法
まずは第1回の内容をざっくり振り返っておきましょう。
連載第1回では、AI漫画の作り方を「text-to-manga」「img-to-manga」「name-to-manga」の3種類に分類。その上で、漫画制作の経験がないユーザーがtext-to-mangaすると、毎コマ「時間・空間(場所)・登場人物・出来事」がすべて無差別に盛り込まれたフィルムコミック風の仕上がりになりがち、という話からスタートしたのでした。
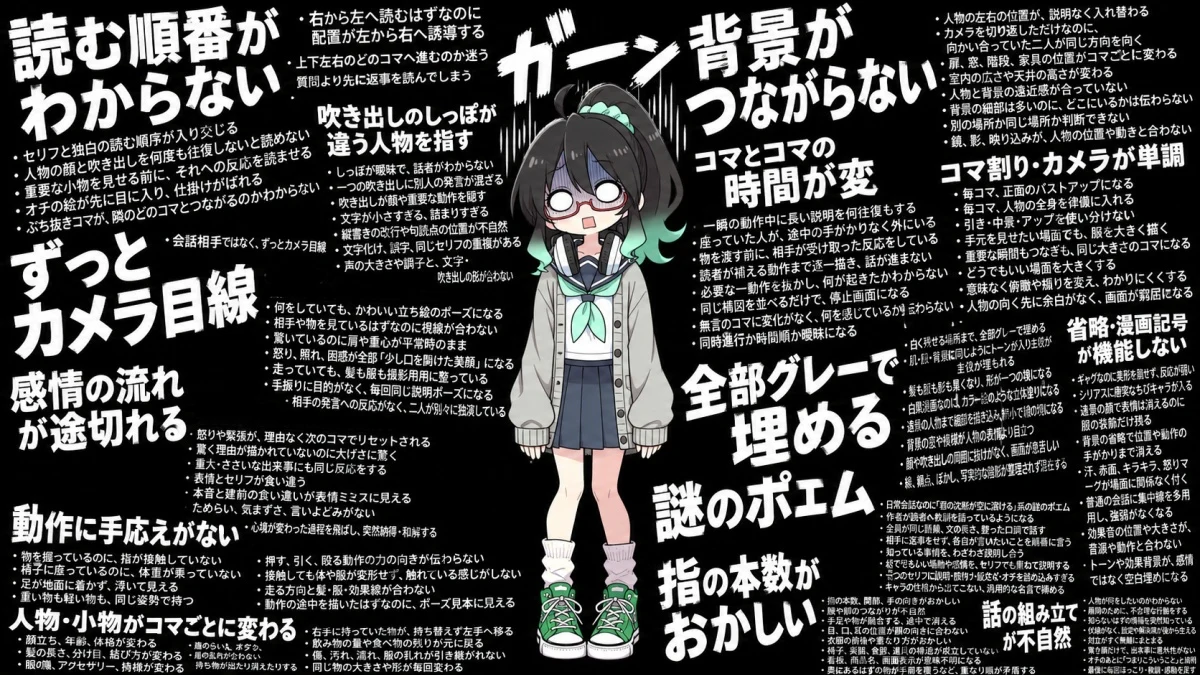
AI漫画で生じがちな「不自然になるポイント」は、次の4つ。
①視線誘導と情報整理の失敗
コマ割りやコマの内容で何を伝えるべきかが整理されておらず、視線誘導やカメラワークの概念もないため、漫画としてすらっと読めない。
②背景演出の失敗
コマごとの意図を伝えるために背景を使う発想がなく、ただキャラがいる場所を埋めている。
③感情表現の不足
劇中の出来事に対するキャラの演技が薄いか不自然。ただバストアップのイラストを並べただけのように見える。
④粗密・コントラスト
そのコマごとに何を見せたいのか、被写体の主従がはっきりせず、見せたい情報が埋没する。(退屈なグレー現象)
この4つの不自然さをAIに自動で回避してもらうため、「Manga Director」は制作作業を3段階に分割することにしました。まず画風とキャラデザインを安定させるための「リファレンス資料」を作成。その資料を使って読み順や情報量が整理された「AIネーム」を生成し、ユーザーがクリスタで編集しやすい原稿ファイルとして「本番生成」するという流れになっています。
特に力を入れたのが、最後の「クリスタ化」の段階です。AI絵もAI漫画も同じですが、不自然で手抜きに見える「AI Slop感」を引き起こす大きな要因の一つが、生成画像の編集性の低さ。AIで生成した画像は基本的にレイヤーが統合された状態で出てくる上、AIにそれを直させようとすると別の部分がおかしくなるので、ユーザーがおかしさに気づけても、気軽には直しにくかったわけですね。
Manga Directorは、絵の描けないユーザーでもスムーズに漫画編集作業に進めるよう、フキダシや文字情報をカットし、透過した画像をコマ割り済みの.clipファイルとして出力することができます。これによって、各コマのキャラやフキダシの配置などをユーザー判断で細かく調整することが可能となっています。
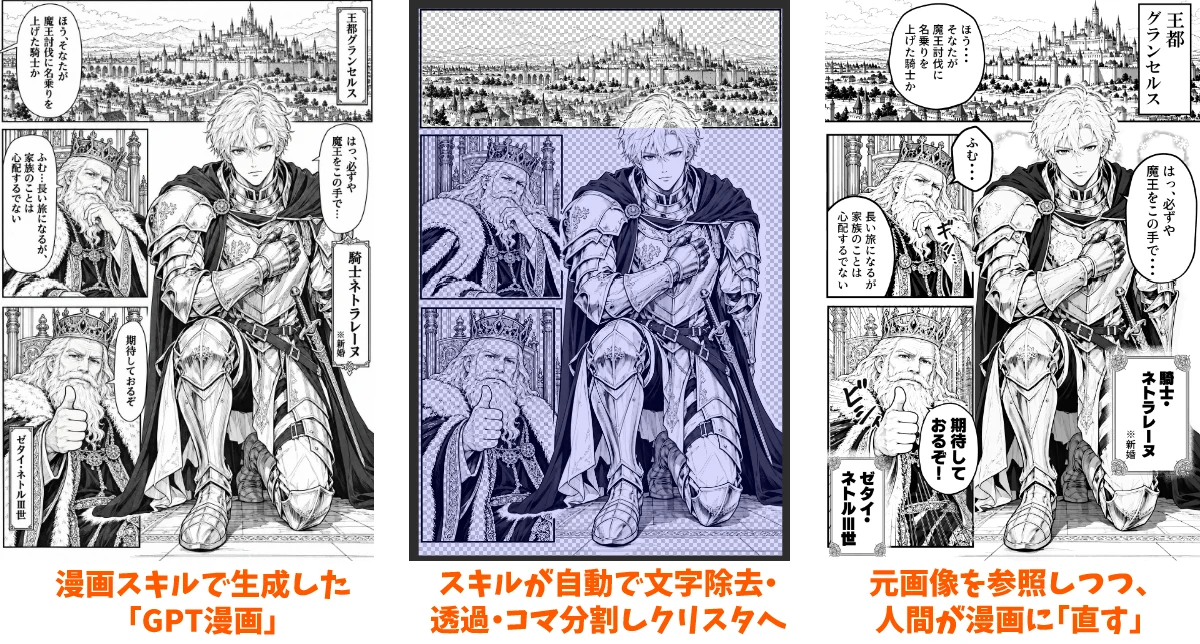
「4つの不自然さ」のうち、キャラの感情表現の乏しさはリファレンス資料(特に表情集)で、視線誘導や背景演出はネーム技術の徹底スキル化で改善を目指します。さらに、生成画像の情報量やコントラスト、その他細かなミスの修正は、クリスタ原稿に変換して人間が編集できるようにすることで対処する、という考え方です。
▲スキルのテストのために作った2p漫画。なにこれ

2.理想的なリファレンス資料
スキルの解説に入る前に、まずGPTに見せる「リファレンス資料」はどのような形式がいいかについて整理しておきます。
キャラの容姿や画風をChatGPTやSeedance2.5といったモデルに伝えるときは、「キャラシート」などと呼ばれる三面図やバストアップを組み合わせた画像を与えるのが一般的です。キャラデザや画風だけでなく、線画のタッチや白黒の濃淡や塗分けなどにも関わってくるので、どんな画像をリファレンス(参照)させるかはAI漫画をつくる上でスキルと同じくらい重要な要素と言えます。
私は当初、動画生成サービスの「Higgsfield」が紹介していた手法を採用し、こちらのように顔を消した全身図と、顔のアップを並べた資料をリファレンスさせていました。
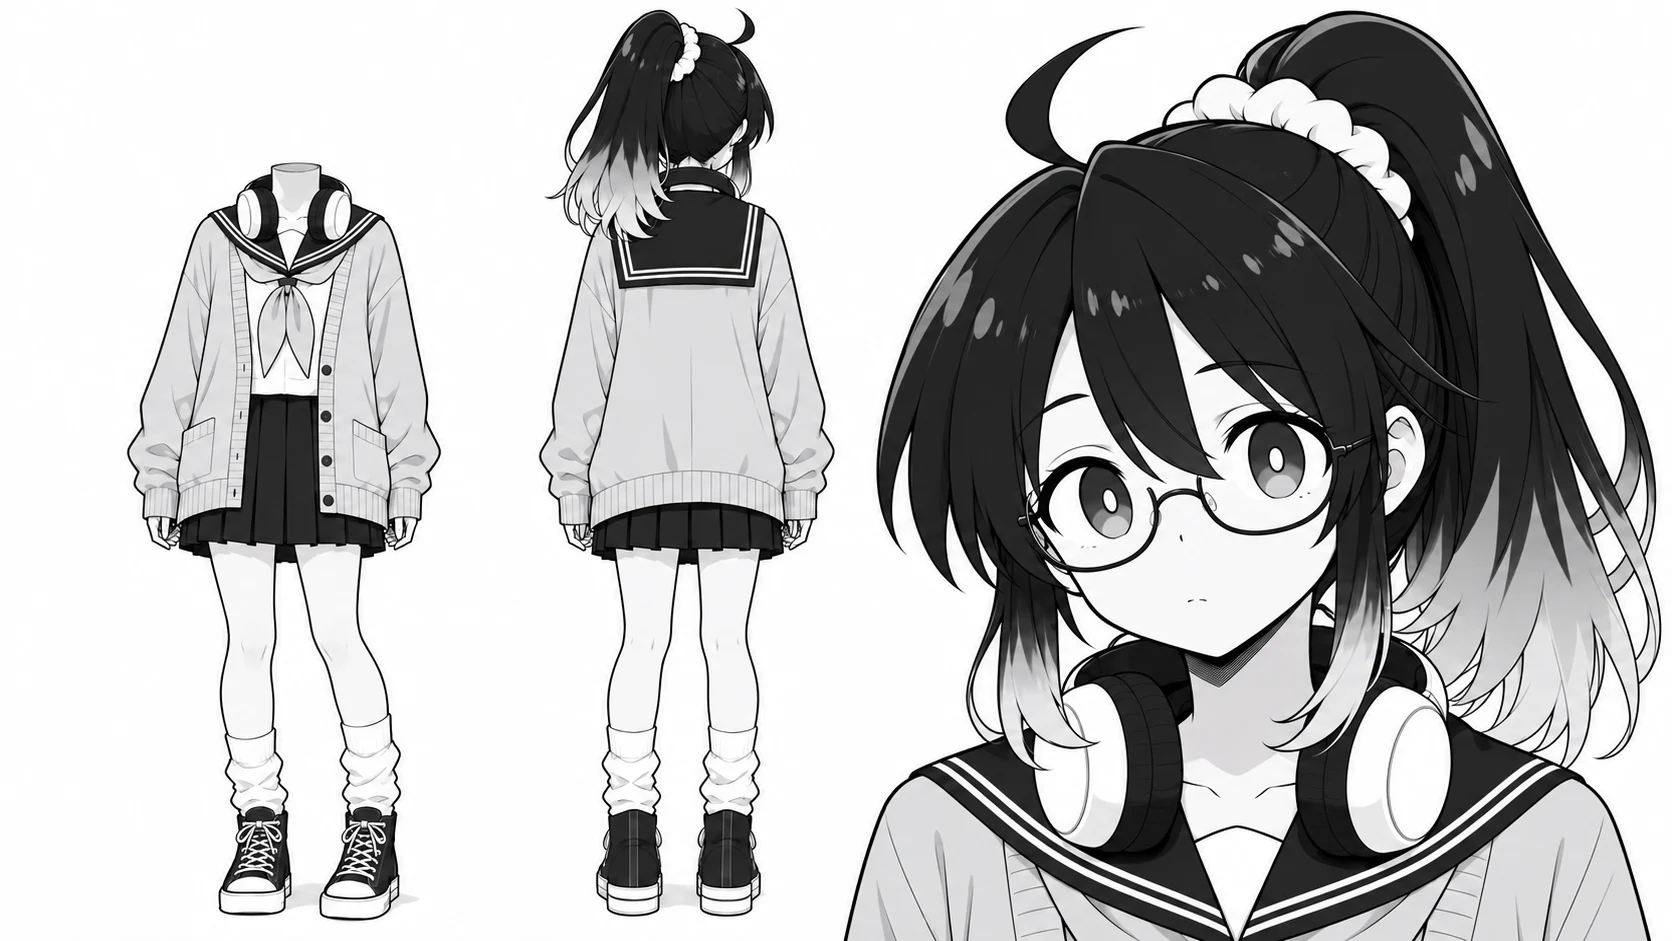
▲顔を消した全身図と顔のアップを並べた、Higgsfield流のキャラシート
全身図の顔をわざわざ消しておくのは、小さく描かれた全身の顔と、大きく描いた顔のアップの両方をAIが参照して、別人になってしまわないようにするためです。AIは小さい範囲に描かれたものを再現するのが苦手なので、「顔はバストアップ、衣装は全身図」と整理するためにこのようなやり方が推奨されていました。
ただ、実際にこれで漫画を生成させてみると、頭身がうまくコントロールできないことが分かりました。Higgsfieldのツイートのように被写体が実写調ならともかく、デフォルメされたアニメ絵や漫画の場合はそうはいきません。例えばこのように、描かれるコマの縦横比やポーズの都合で、スペースにちょうどおさまるような頭身に調整されてしまうのです。
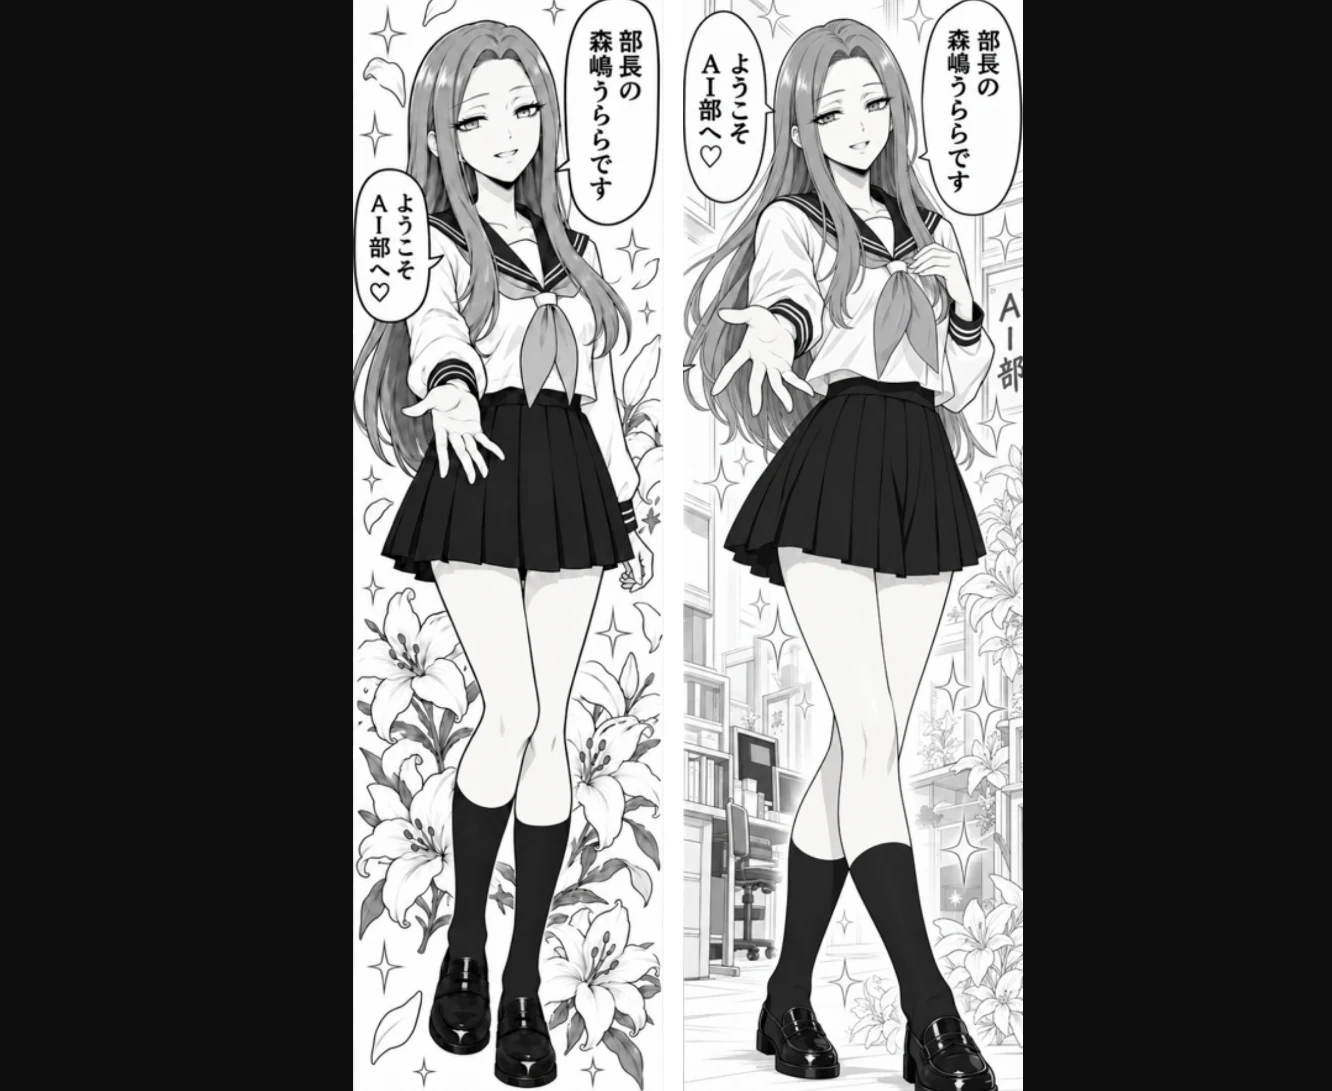
▲同じキャラなのに頭身が違って見える
もう一つ困ったのが、横から見たときのキャラデザインです。動画生成モデルは前後の画像だけでも比較的自然に人物を回転させられるのですが、ChatGPTで漫画的な演技をつけると、横顔や髪型、服の形が変わってしまうことが多々ありました。
実写調ならなんとかなるのですが、あしたのジョーやスネ夫の髪型を正面から描くのが難しいように、デフォルメが強いキャラほど厄介なようなので、リファレンス画像は正面・背後だけでなくちゃんと3面図にしたほうがよさそうです。
<三面図+バストアップが最適か>
現時点の結論として、GPT用のリファレンス画像としては、このような「頭身の分かる三面図+バストアップ」のキャラシートがよいと考えます。全身の正面・真横・背面を同じ縮尺で並べて頭のてっぺんから靴の先まで描き、右側にバストアップ画像を添えたものです。
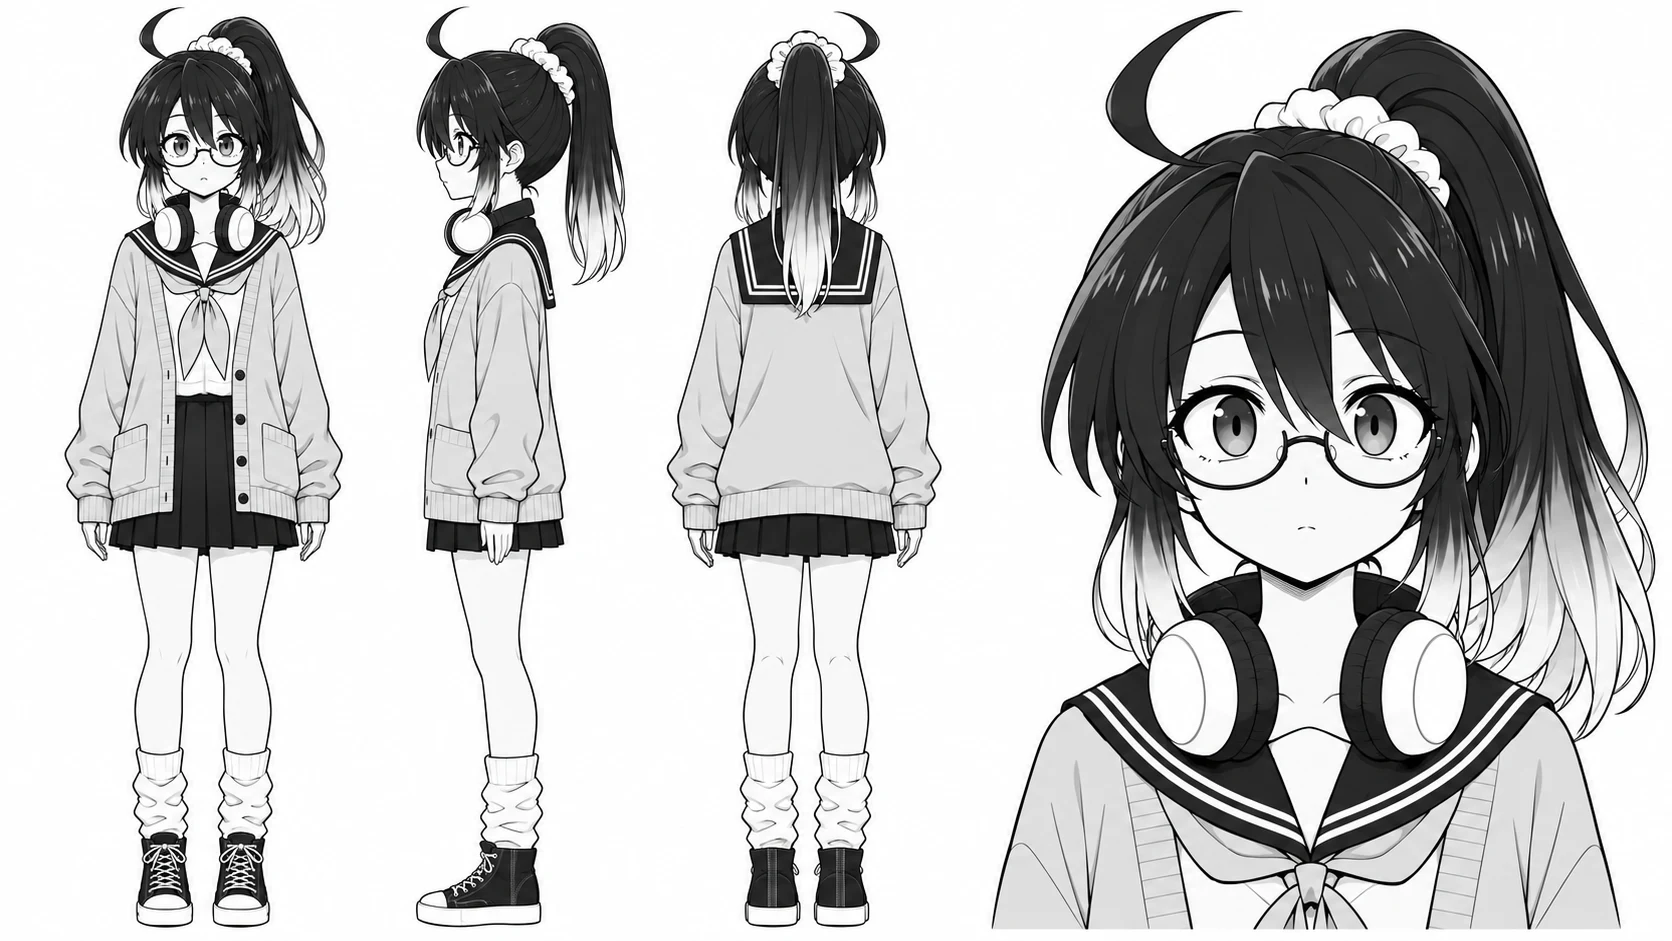
ちなみに、瞳のデザインを右下に追加する手法も試しましたが、こうすると目の表情を漫画的に崩しにくくなることが分かりました。漫画は一貫性がありすぎてもなさすぎてもエンタメにならないので、大変難しいですね…。
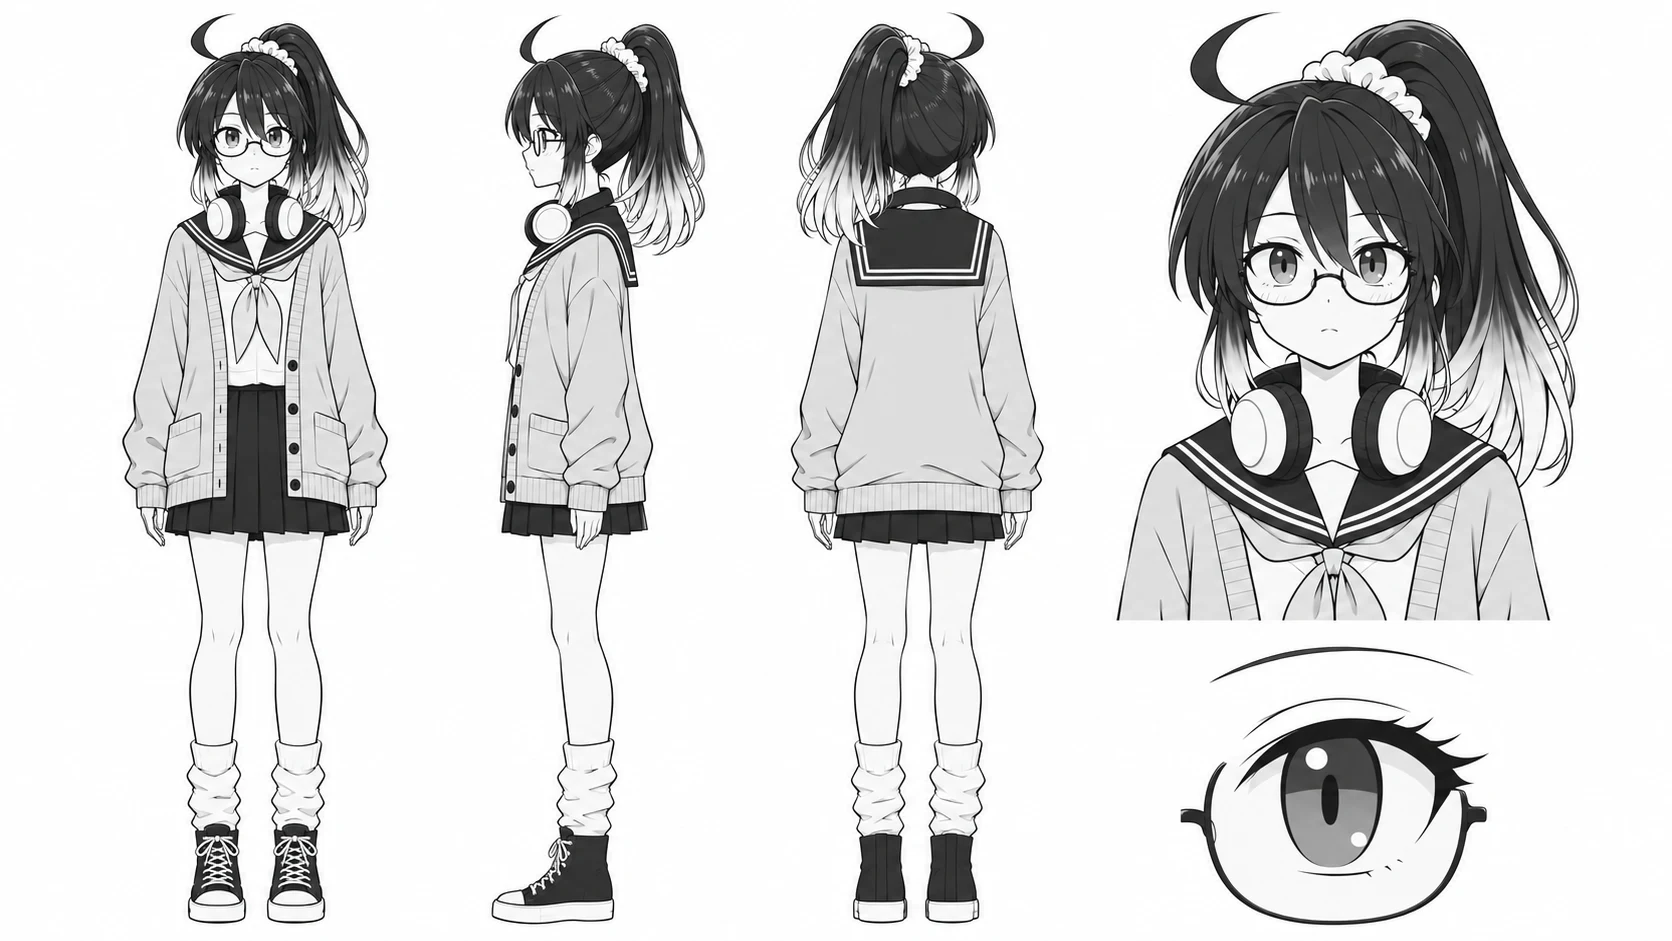
キャラの頭身や性格などのプロフィールを文字として画像に書き込むやり方も試しましたが、こちらは明確なメリットが感じられませんでした。文字がキャラクターの一部として誤認されてしまう可能性もありますし、普通にプロンプトに書き添えればいいだけですしね…。
キャラシートの役割は、頭身と衣装のデザインをしっかり維持しつつ、顔立ちも安定させることです。特に制服はコマごとに変化してしまうと非常に不自然ですので、あらかじめ固定するのがとても重要。今回配布するスキルでは、このシートを画像1枚からでも簡単に作ることができる仕組みになっています。
<表情集で「ハンコ絵」を防ぐ>
ただ、「三面図+バストアップ」のキャラシートを使って実際に漫画にしてみると、今度は表情の変化が乏しく感じることに気づきます。漫画はキャラクターの豊かな感情表現やリアクションが命なのに、AIがキャラシートを正確に反映させようとするほど、演技の振れ幅が控えめになってしまうのです。
▲表情変化が乏しいと、生き生きしたキャラに見えない
そこで、リファレンス資料はキャラシートだけでなく、そのキャラの特徴や性格をとらえた「表情集」を同時に与える手法を採用しました。こちらは3×3の9コマで、ミナちゃんに漫画でやってほしい表情変化を描かせたものです。
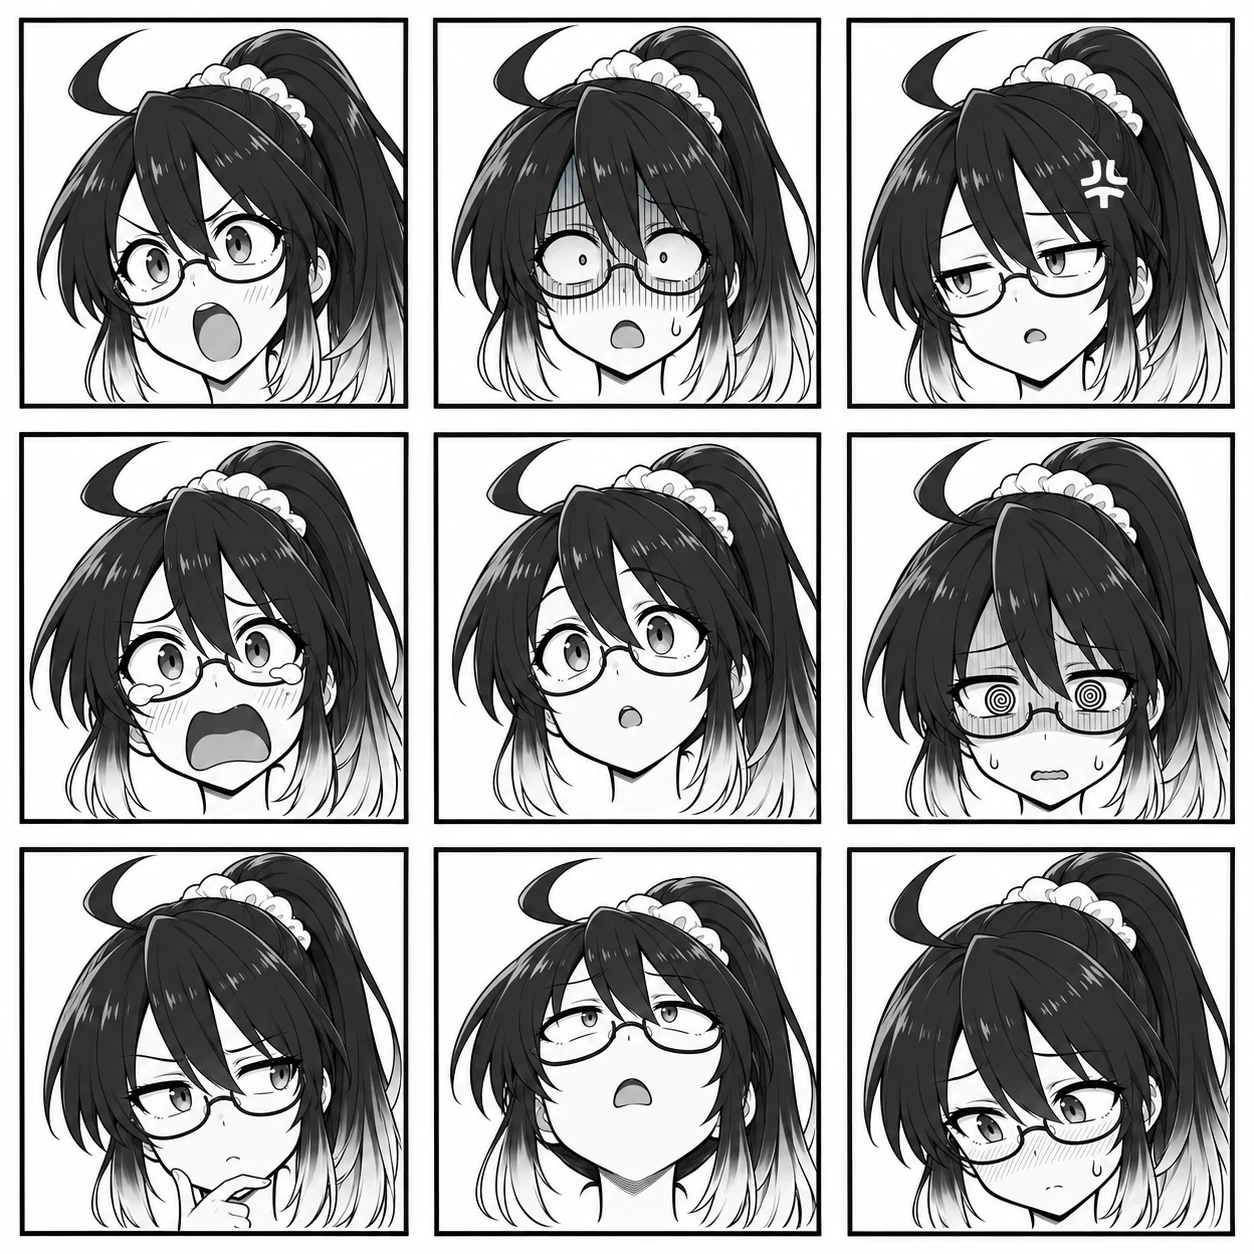
キャラシートに加えて、このような驚き、ツッコミ、青ざめなどの漫画らしい表情のラインナップを見せておくと、GPT側も「このくらいまでなら顔を崩していいんだ」と分かってくれます。
<表情集は首から上がいい?>
そのほか、あれこれ試して得られた知見として、「表情集には衣装の情報はあまり入れないほうがよさそう」というものがあります。表情集は同時に9枚作るので、襟などのデザインを間違えたものが混じると生成する漫画にも継承されてしまいますし、シーンによって違う服を着せることも難しくなってしまうからです。服の見本はキャラシートに任せて、表情集では「感情によってどのように表情が変わるか(どのくらい崩してよいか)」を参照させることに専念させるのがよいでしょう。
Manga Directorには、こうした表情集を大量ストックしてデータベース化しておく仕組みもつくってあります。作業フォルダの中にこうしたデータベースを作っておけば、GPTがコマごとの必要に応じて表情を参照しにいけますし、ユーザー側も「3コマ目の表情はこの表情にして」と指示しやすくなるというわけです。
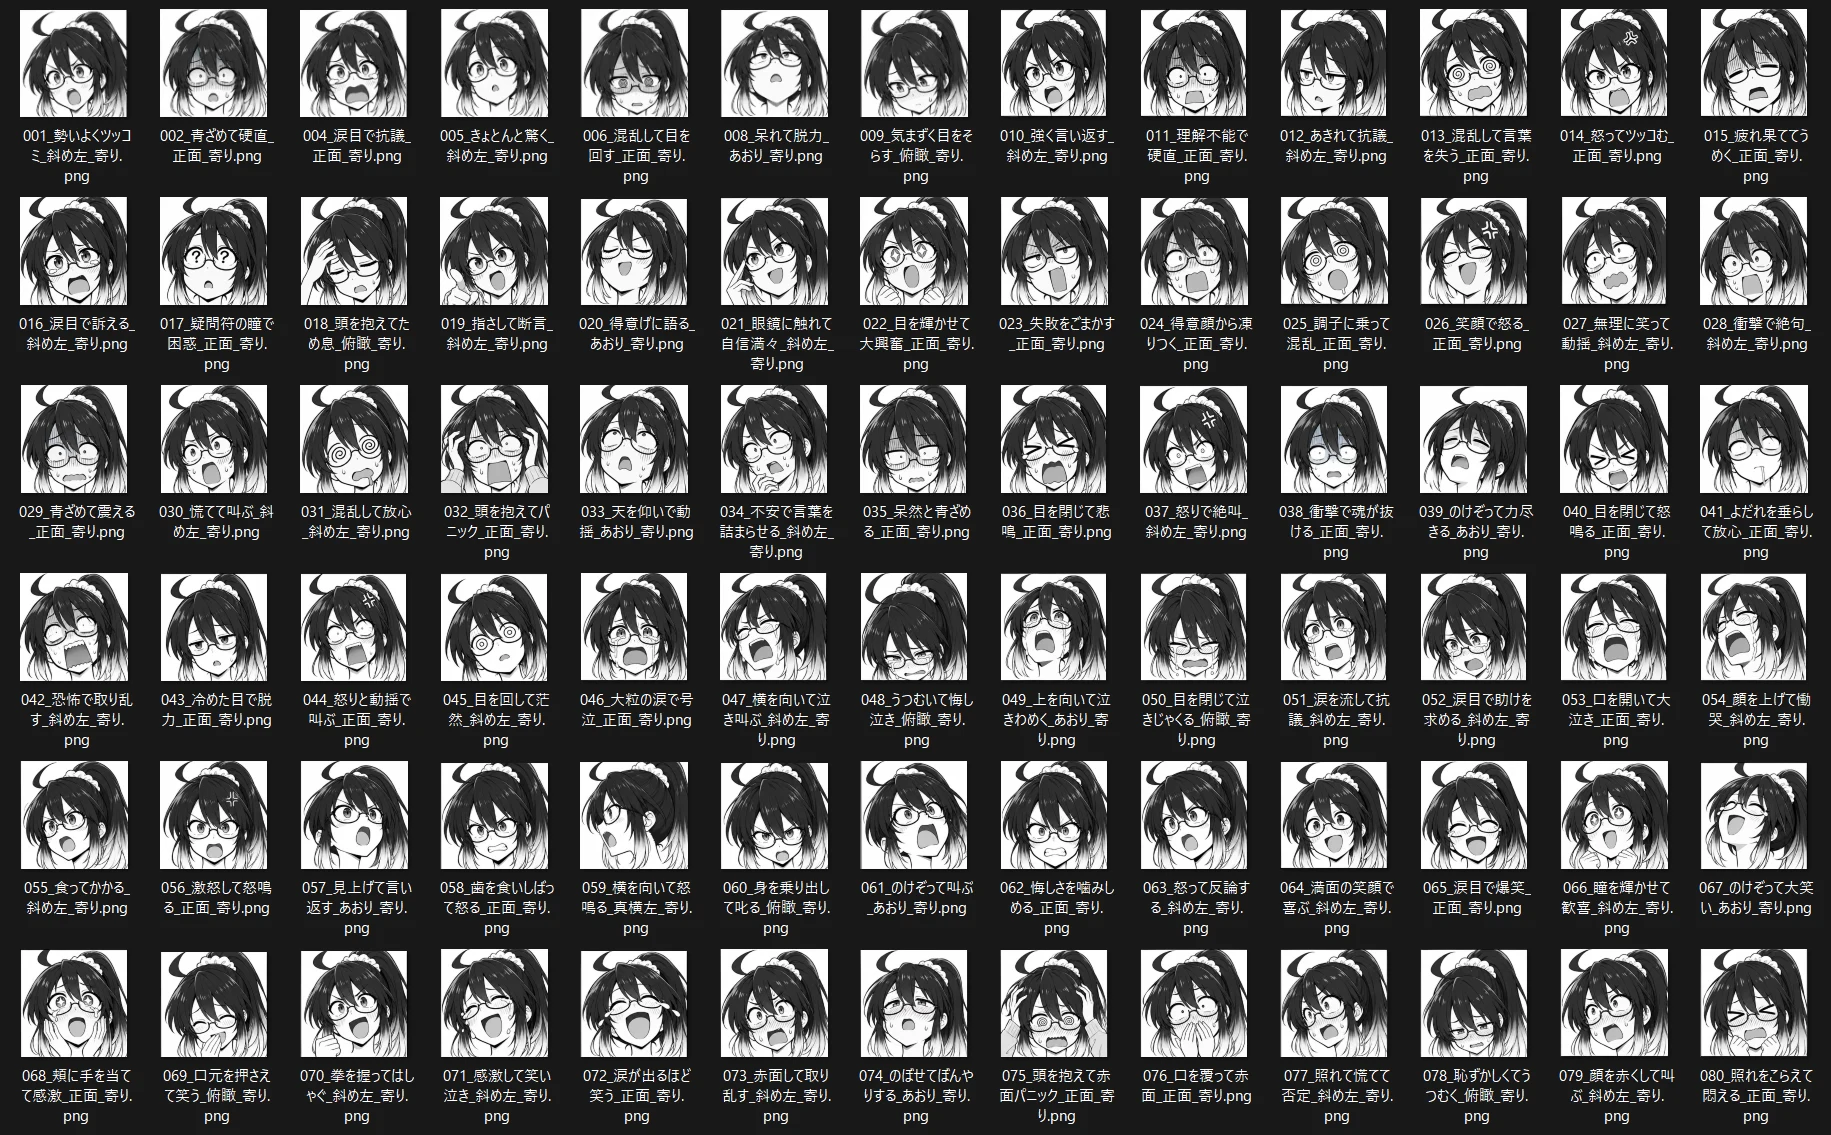
▲作業フォルダ内に自動で整備された表情データベース。イメージ違いは削除しよう

3.「漫画のルール」をAIに理解させる
リファレンス資料が揃ったら、全身図で衣装・頭身・画風を、表情集でキャラクター性・作風を維持できるようになります。ただ、3コマ以上ある漫画だと読み順がおかしくなったり、コマ当たりの情報量が過多になったりして、自然さがどんどん失われてしまうのがネック。そこで、「日本語漫画のルール」を徹底的に言語化することで、ChatGPTに漫画の仕組みを理解してもらうことにしました。
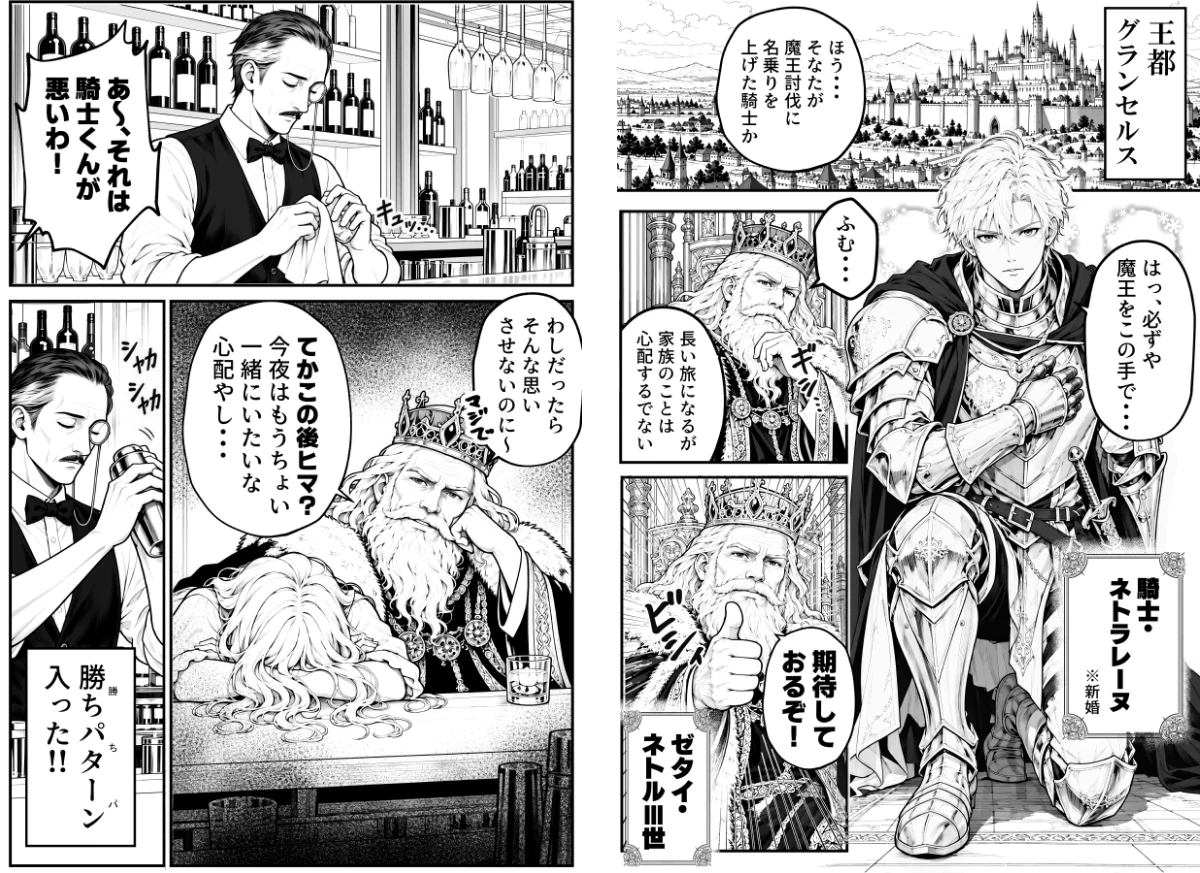
こちらの2枚をご覧ください。左が前回取り上げたテキトー騎士漫画、右が今回のスキルで作り直したものです。(どちらも出力物そのまま、無加筆)
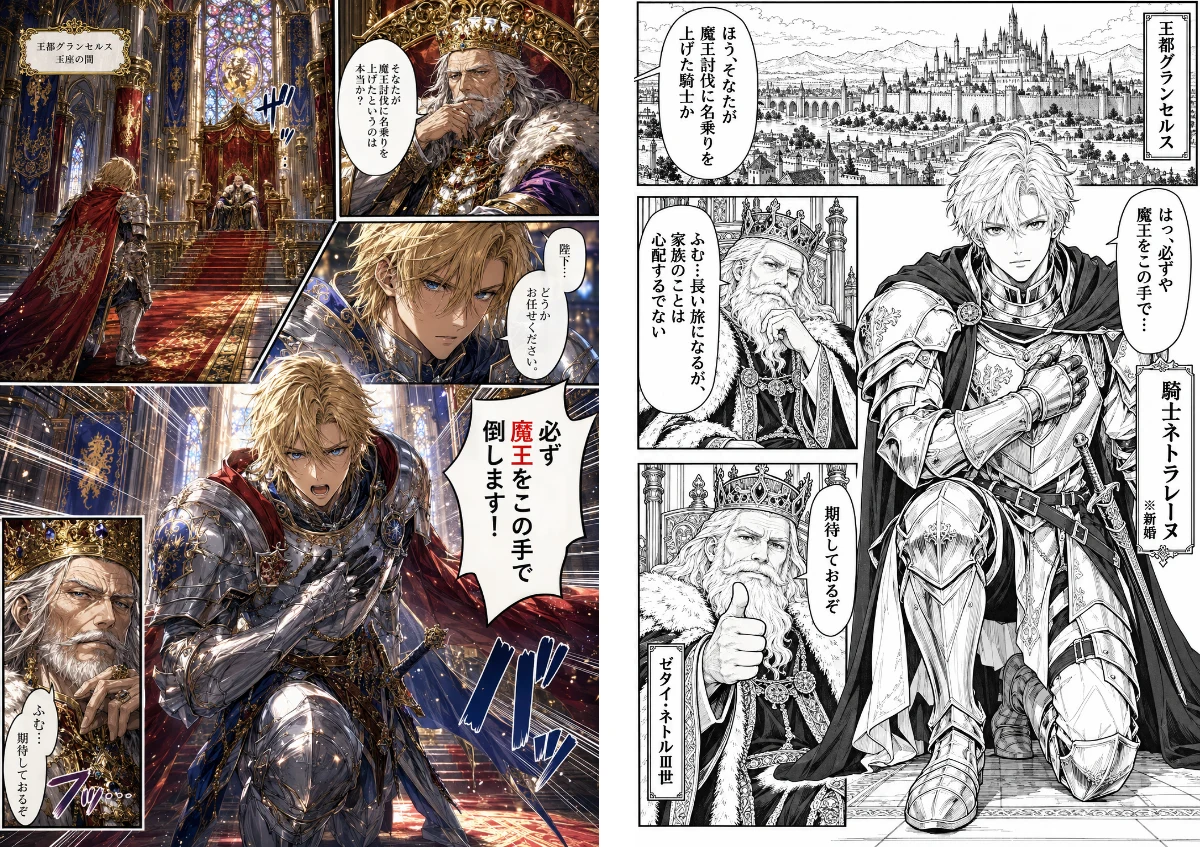
日本の漫画について知識がない状態だと、左のようにどのコマにも背景と人物が同じ密度で描き込まれ、読み順や伝えたいことが判然としない漫画になってしまいます。スキルを使って生成した右側は、いちいち読み順などを指示しなくてもある程度自然に読めるつくりになっているかと思います。
GPT-6 Astraを始めとしたGPTモデルが常識的な漫画を生成できるようにするためには、まず「日本の漫画の基本ルール」を言葉にする必要がありました。例えば読み順だけに限って言うなら以下のような内容です。
・右綴じで縦書き。ページは右上から始まり、左下で終わります。
・段は上から下へ読みます。同じ段のコマは、右から左へ読みます。
・段と段の間の隙間は広く、同じ段で隣り合うコマの間の隙間は狭くします。こうすると、読者は同じ段を横に読み切ってから、次の段へ下ります。隙間が同じ幅だと、読む順を間違えやすくなります。
詳しくはあとで配布するスキルの中身のmd(マークダウン)ファイルをお読み頂ければと思いますが、こうした「日本人にとっては当たり前の漫画ルール」をスキルとしてあらかじめ渡してしまうことで、いちいちプロンプト指示しないで済むような作りになっています。
ただし、漫画のルールはAIだけが理解していればOKというわけにもいきません。AIに指示を出す人間側も最低限理解しておきたいルールについて、7つのポイントにまとめました。
<漫画の「可読性」と「推進力」>
前回整理したポイントの一つに「アニメの一部を切り出して並べれば漫画になるわけではない」というものがありました。漫画は読者が正しい順で誤解なく読める「可読性」と、興味を引いてページをめくらせる「推進力」の両方を、コマ割りによって巧みに成立させなければいけません。そのために最低限必要な知識をまとめると、以下のようになります。
<①各コマにはカテゴリと役割がある>
漫画を構成する一つ一つの「コマ」には、以下のようなさまざまな分類があり、それぞれ異なる役割を果たしています。
【役割で分けると…】
見せゴマ、決めゴマ、メクリ、説明ゴマ、場面転換ゴマ、間のコマ、リアクションのコマ、捨てゴマ、オチのコマなど
【描かれているもので分けると…】
人物、会話、物・小道具、身体の一部、背景・風景、群衆、イメージ・象徴など
【カメラワークで分けると…】
ロング(引き)、全身、カウボーイショット(太ももから上)、アップ、俯瞰、アオリ、主観、肩越しなど
【コマの形状で分けると…】
大ゴマ、小ゴマ、横長コマ、縦長コマ、変形ゴマ、横断コマ、枠なし、タチキリ(ページのふちまで描かれるコマ)、ぶち抜き、枠からのはみ出しなど
【時間で分けると…】
回想コマ、夢コマ、時間経過、一瞬を細かく刻むコマ、複数の時点をまとめるコマなど
【置かれる位置で分けると…】
入りゴマ、メクリ、ウケ(めくった先のコマ)、作品の最終コマなど
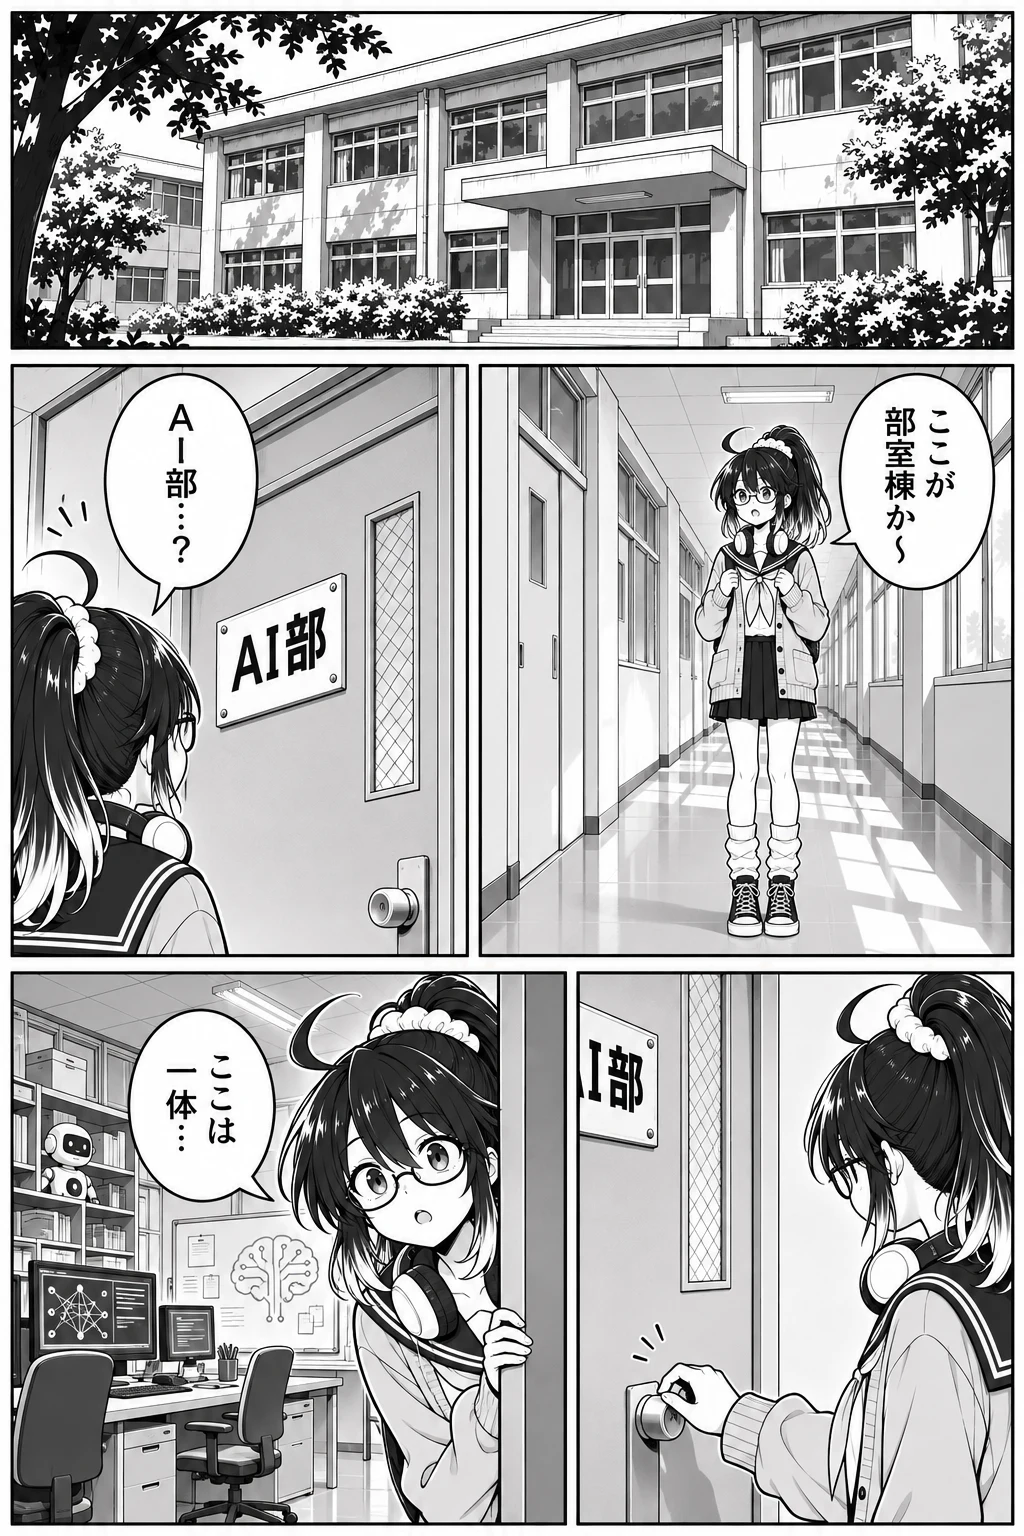
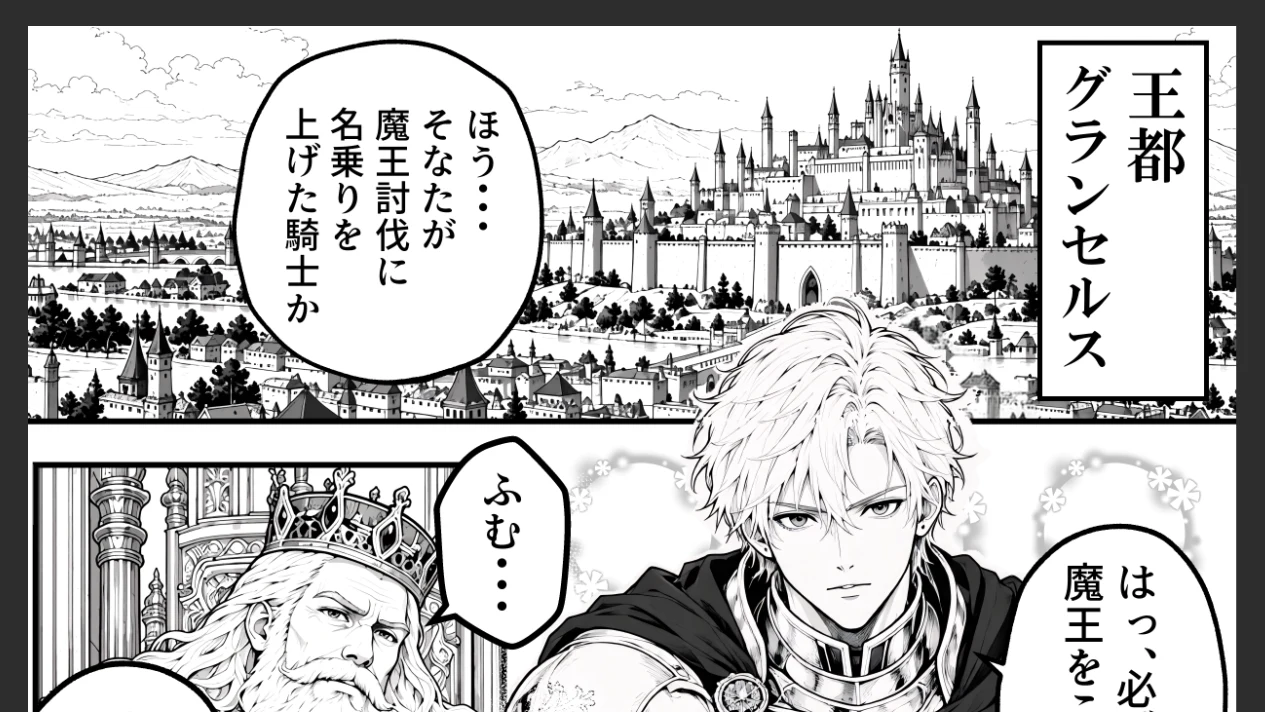
各コマは、同時に複数のカテゴリに所属するのが普通です。例えば下図の「王都グランセルス」と描かれた1コマ目なら、役割は舞台を一目で伝える横長の「説明ゴマ」、描かれているものは「背景・風景」、画角は「ロング」、位置は「入りゴマ」ということになるでしょうか。
実はスキルなしで生成したときも、GPTは似たようなことを試みています。下図をみると、書きだしのコマを説明コマにしようとしているのが分かりますね。
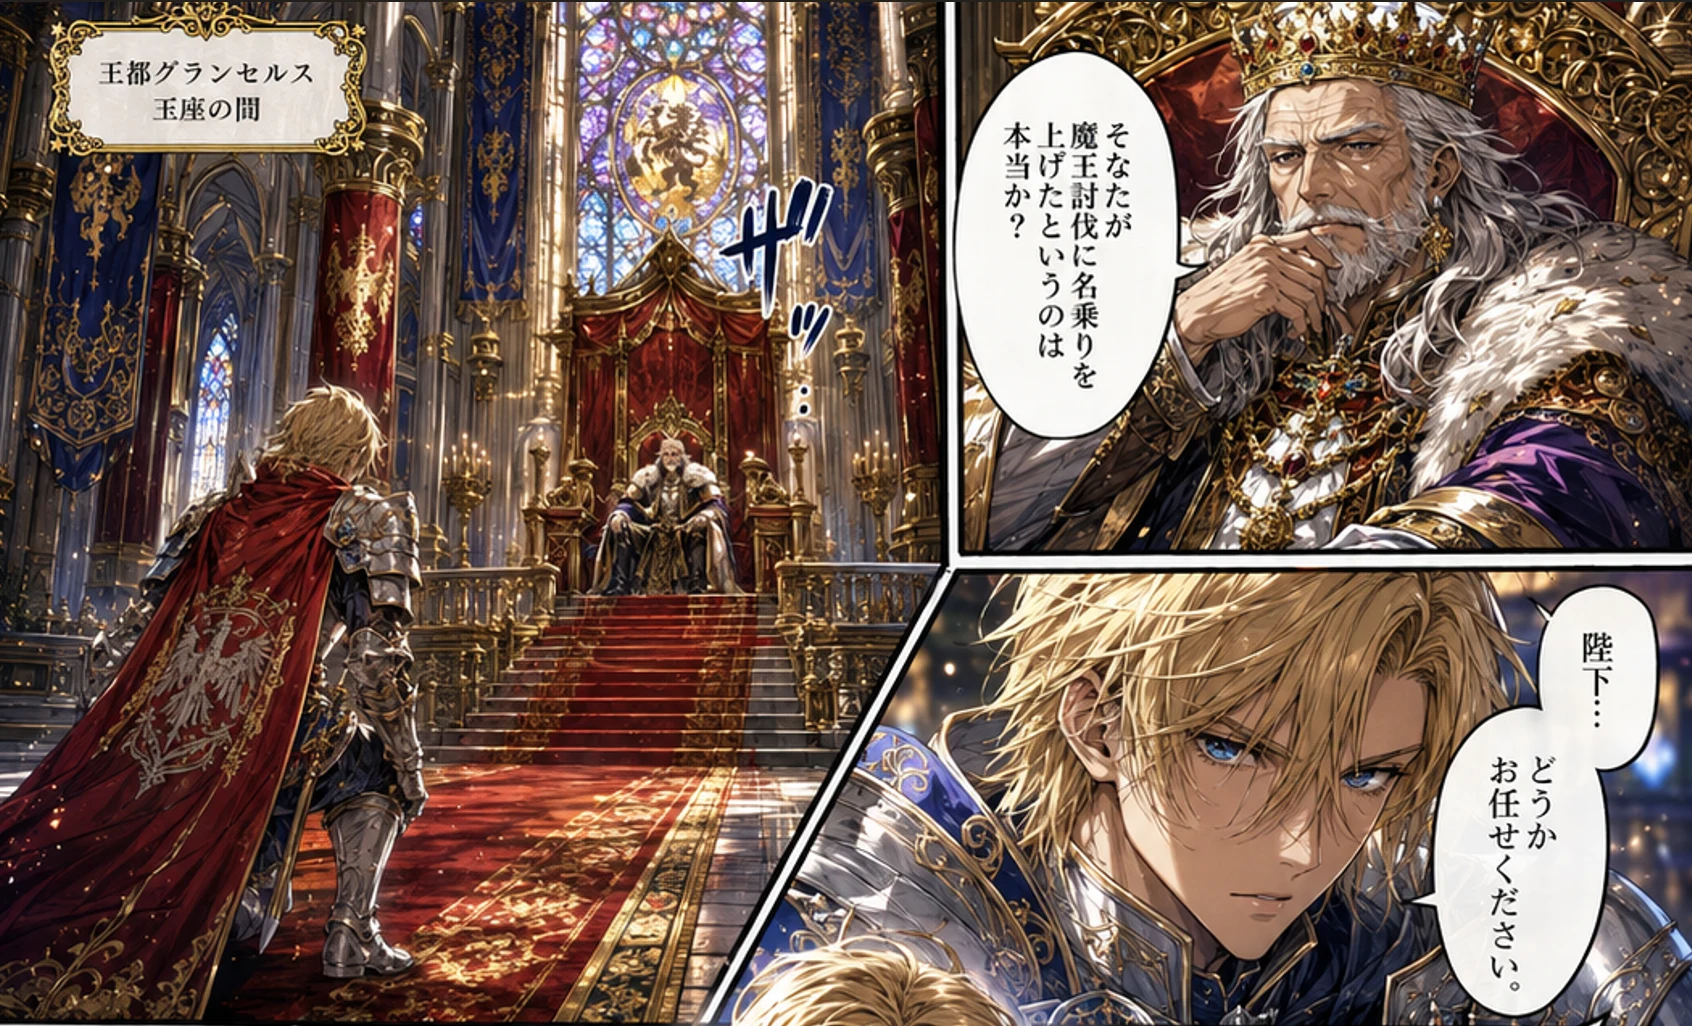
このシーンは最初のセリフが王様の問いかけで始まりますが、その手前に騎士が王の御前に参じるシーンを「バックショット・引き」ではさんで、王都の玉座の間であることも説明しています。これは漫画の「可読性」を高めるために大事な配慮ですが、いかんせん読み順からして判然としないので、これは舞台説明以前の問題ですね…。
<②フリとウケの連続が推進力になる>
再生ボタンを押したら勝手に進んでいく動画と違って、漫画は読者がページをめくったり、クリックしたり、フリックしたりしないと進みません。つまり、先を読ませる「推進力」が必要です。ネタとしての面白さやロングスパンで気になる要素(犯人は誰か?ONE PIECEとはどんな財宝なのか?)もそうなのですが、各ページを構成する一つ一つのコマに「フリ」と「ウケ」の役割があり、ページをめくらせる重要な原動力になっています。
「フリ」とは読者に「!」(=驚き)や「?」(=疑問・期待)を抱かせるもの。
「ウケ」はそれに応える(答えを出して納得させる)ものと考えてください。
AI漫画にはこのフリとウケの概念があまりないので、どのコマも「ユーザーが指示したセリフを言っている人の顔」をなんとなく描くだけになりがちです。前のコマを受けてもいないし、次を振ってもいないので、退屈な仕上がりになるわけです。フリウケについては、前回紹介した参考図書「マンガの原理」p.12で詳しく解説されていますので、ぜひご参照ください。
フリウケの概念は、お笑いで言う「フリとオチ」「ボケとツッコミ」に近いのですが、漫画の場合はギャグに限らず、バトルでもサスペンスでも、この組み合わせでコマが進んでいきます。例えば、「お前が例の騎士か」とフったら、次の大ゴマでその騎士が現れて「はい」と答える程度のことも、立派なフリウケの最小単位です。ウケのコマがさらに次へのフリになっていることも珍しくなく、面白い漫画はこのフリウケが絶え間なく続くことで、ページをめくる推進力を生みだしています。
フリウケの構造の中でも強く効かせたいのが、ページの最後で次のページへの期待感に繋がるコマ、いわゆる「メクリ(メクリゴマ)」によるフリです。紙の漫画なら左のページの最終コマだけですが、Xなどで読むネット漫画なら毎ページの最終コマがメクリになり、ここで強く興味を引かないと読者は興味を失って離脱してしまいます。地上波番組で「いったいどうなってしまうんだ?」と興味を引いたところで答えを見せずCMに入る作りと全く同じですね。
<③コマ割りで時間をコントロールする>
漫画は「コマ割りによって時間の進み方をコントロールする」のが基本です。こちらは2人のキャラが並んで自己紹介しているシーンですが、どちらが自然に読めるでしょうか。
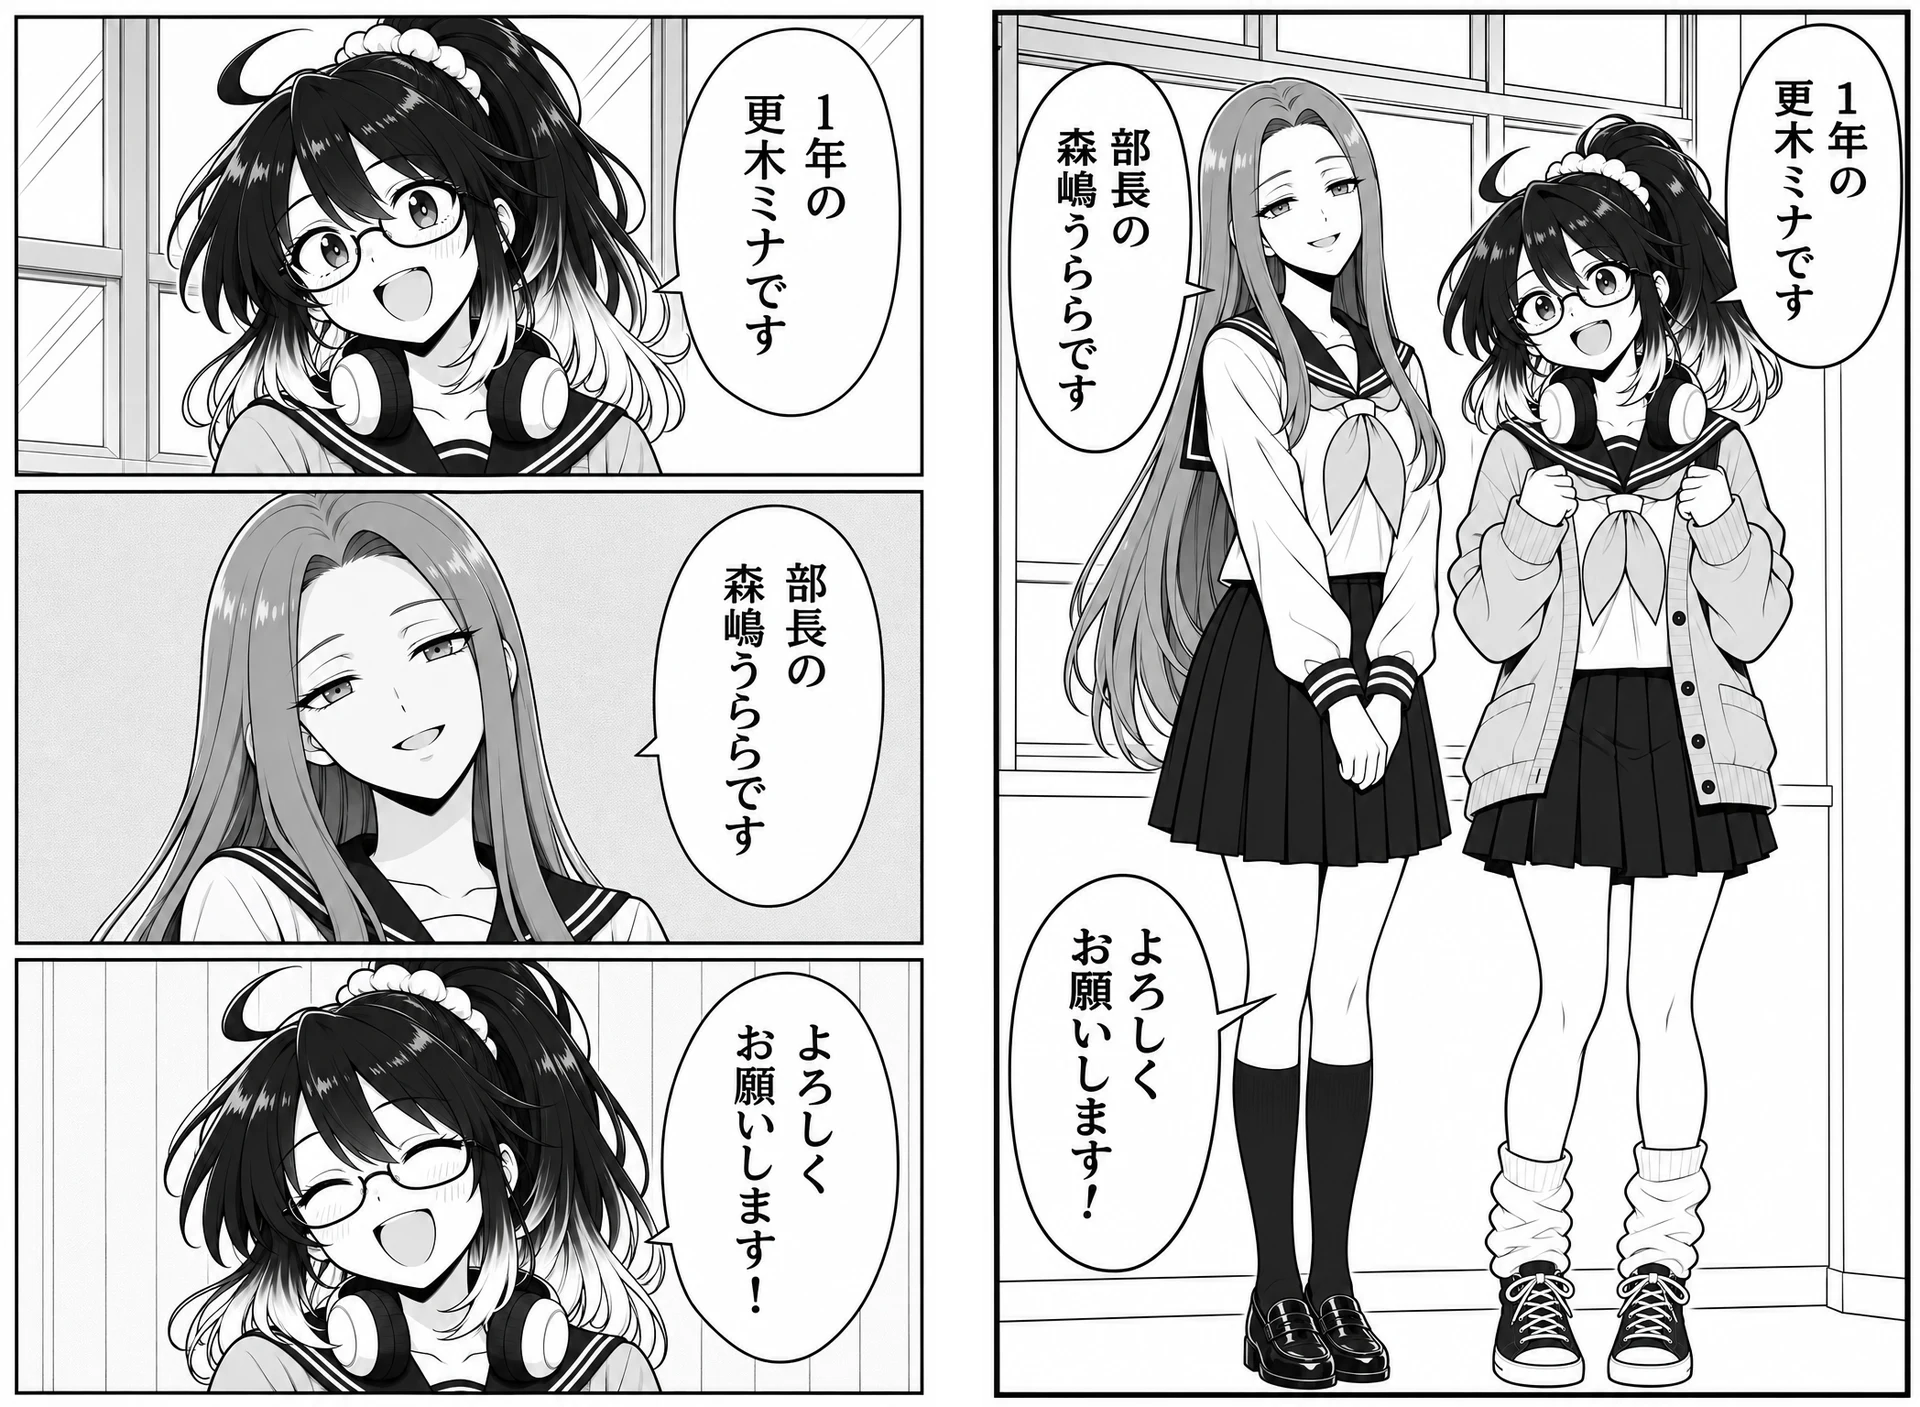
普通にAIは左図のように、発言者ごとにコマを分けて描きがち。しかし、右のように1コマにおさめてしまったほうが「つんのめり感」がなく、すらっと読めるかと思います。
この例でもう一つ分かるのは、「一つのコマの中でも時間経過は起こっている」ということ。右側(右上)が前の時間、左側(左下)へ行くほど後の時間になります。フキダシの位置によって視線誘導も同時に起こるので、右はフキダシを追うだけで登場人物の顔立ちが自然と目に入るつくりになっています。
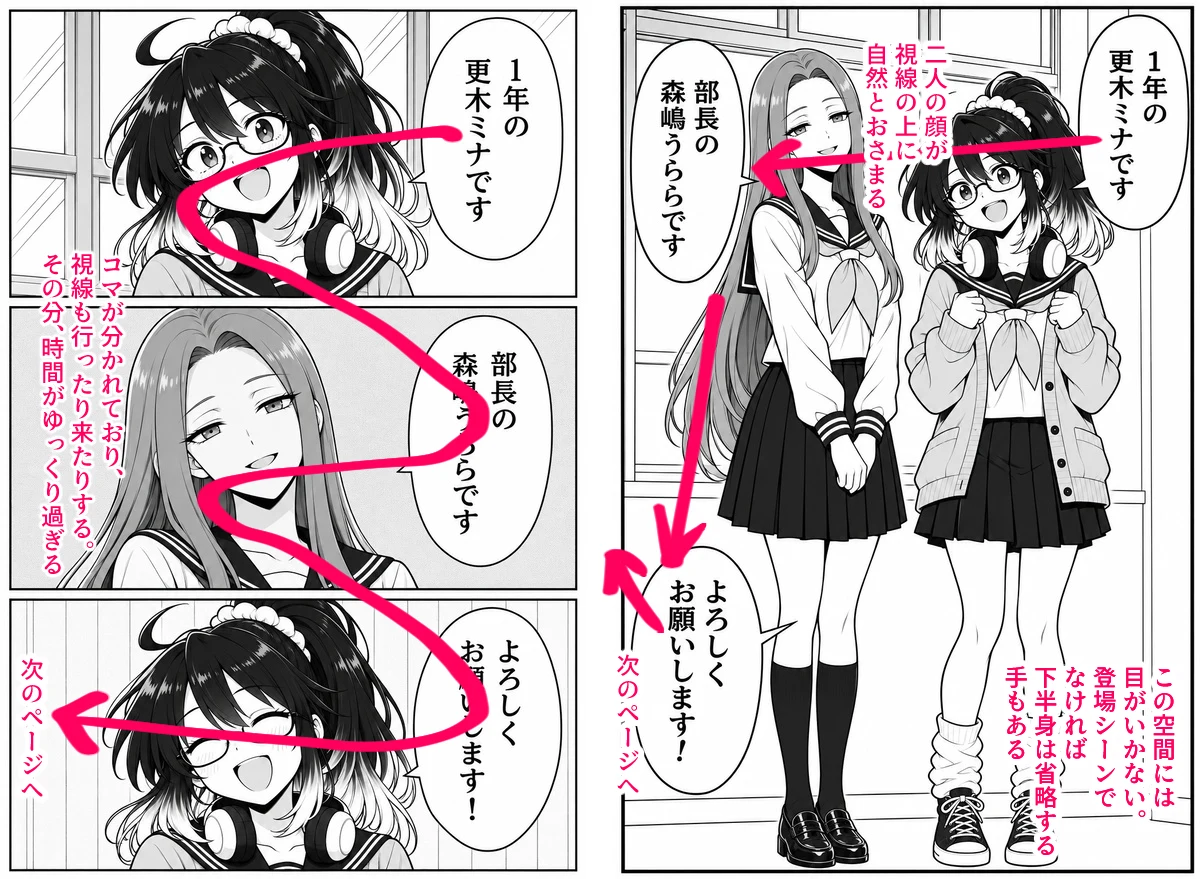
これは「右が正解、左は間違い」というわけではなく、「コマをどう割るか、フキダシをどう配置するかによって、視線の動きやコマごとの滞在時間をコントロールできる」ということでもあります。このシーンで読者に何を感じさせたいかによって、最適なコマ割りは変わります。
こちらの漫画の大ゴマでは、王が「わしだったらそんな思いさせないのに〜」と言ってから「てかこのあとヒマ?」と続けるまでの時間が1コマに収まっていますが、もしこれを二コマに分けるとテンポが悪くなってしまうでしょう。
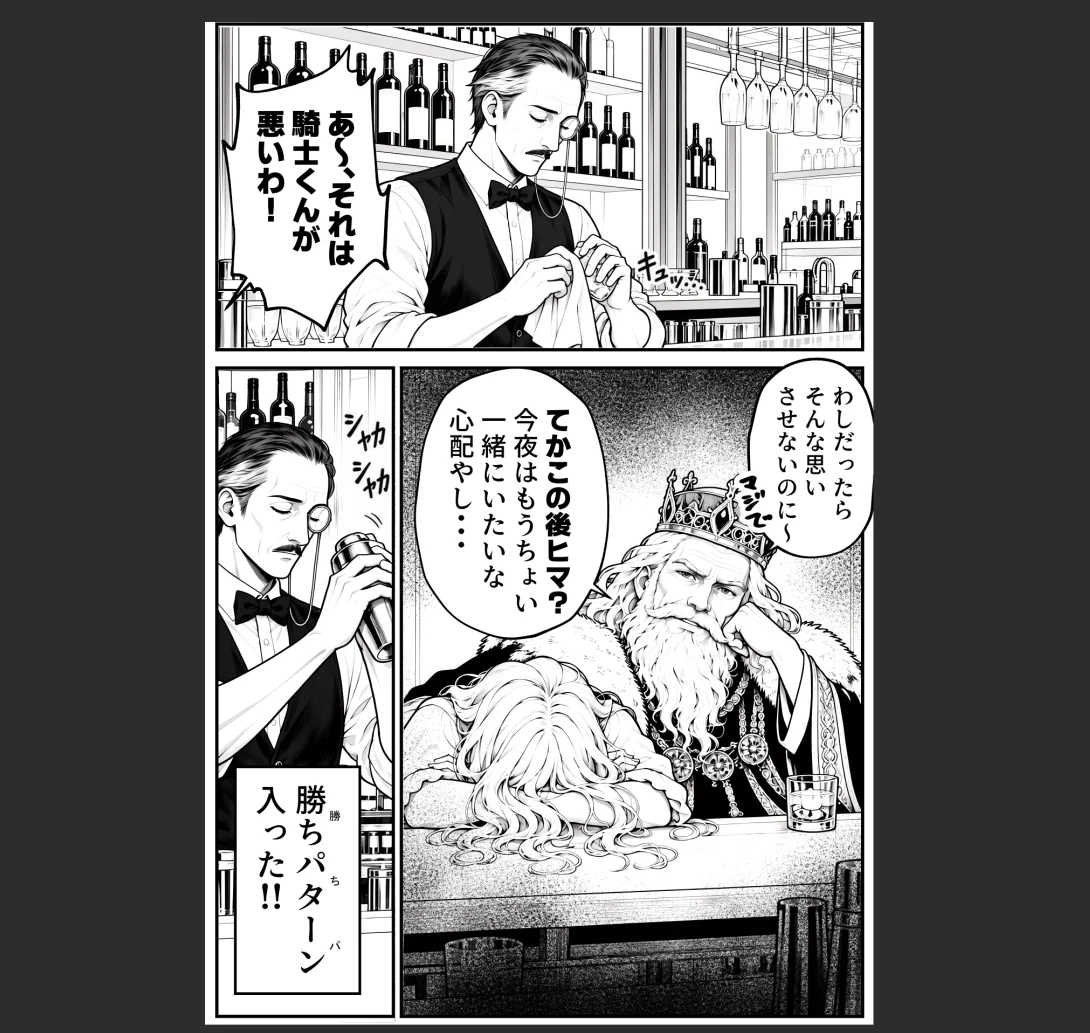
1コマで済ませられるやりとりを意図なく複数コマに分割すると、間延び感が出てなかなか先に進まない漫画になります。逆に言えば、わざとコマを分割することで「時間をゆっくり進ませる」ことも自在にできるので、野球漫画で1球投げるのに1話使ったり、バスケの3ポイントシュートの滞空時間中に練習時の回想をはさんだりして演出をすることが可能なわけです。
<④背景には優先順位がある>
AIは放っておくと、キャラがいる場所を背景に毎コマ描き込んできます。が、これは前回触れた「同じ背景を続ける無意味さ」そのもの。読者に不要な情報を垂れ流して可読性を損なう原因となりますので、それなら「どこにいるか」を何度も説明せず、こんな風に心象風景などを演出したほうがずっと良いわけです。
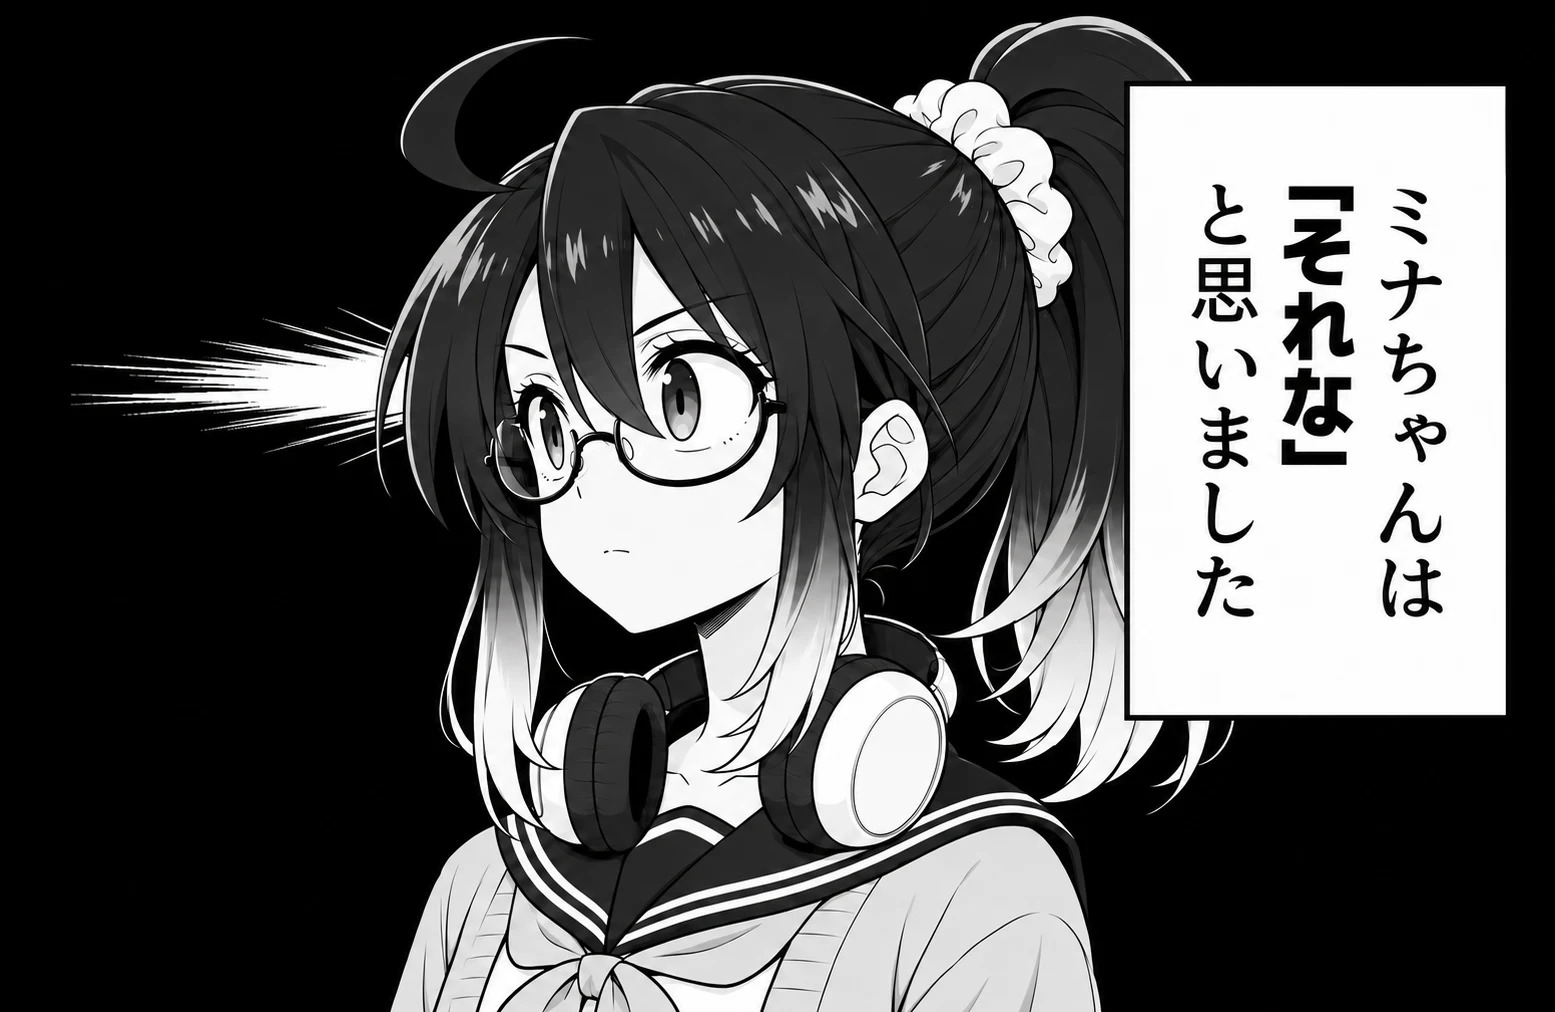
ただし、「どこで何が起きているか」を読者に分かりやすく伝える必要があるコマで背景を省いてしまうと、状況が全く理解できなくなってしまいます。例えばこちらの漫画は、2コマ目の背景が省略されているため、3コマ目で手を伸ばしているのが部室棟に入るドアなのか、それとも建物の中にある部室のドアなのか、判読不可能になっています。
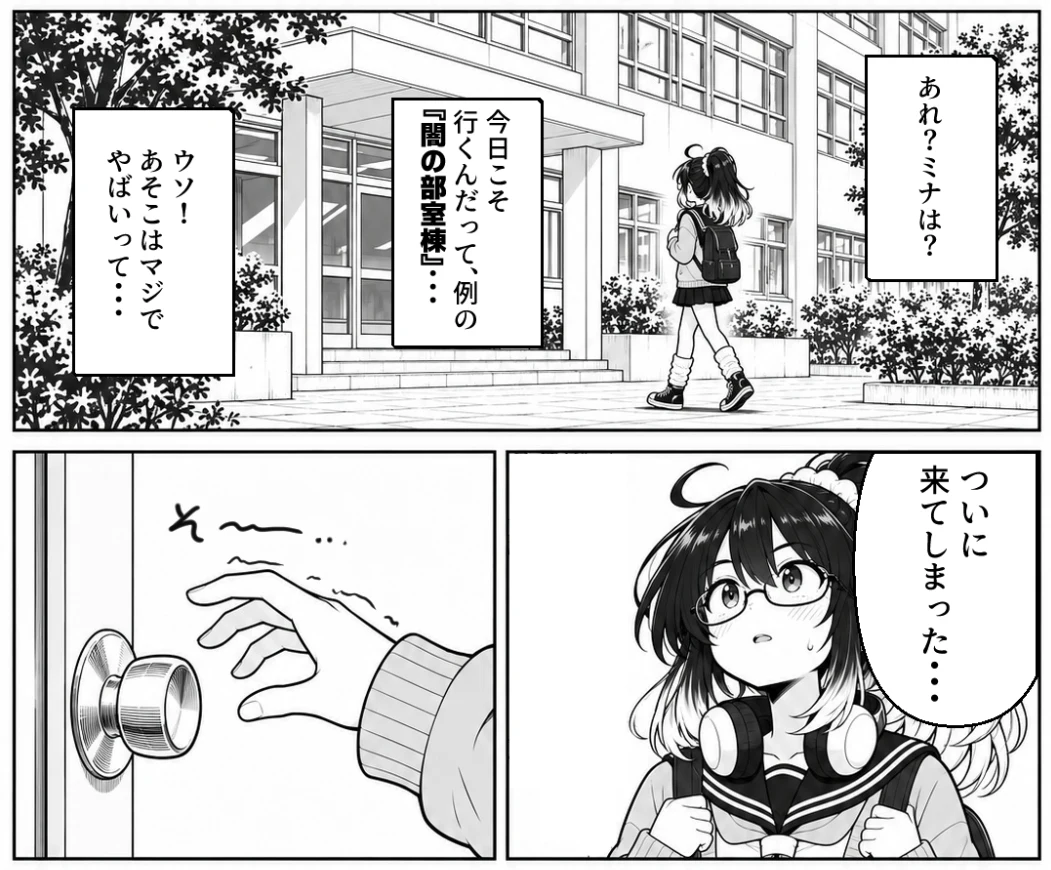
2コマ目の後ろに1コマ目と同じ植物や空を描けば、まだ外にいてこれから建物に入るところであると分かりますし、廊下の天井なら、手を伸ばしたのは部室のドアであることになります。このように、各コマの背景に何を描くか、どこをカメラでとらえるかは、可読性と推進力双方に関わる漫画の重大要素であることが分かります。
上の画像の3コマ目では、ミナちゃんの手元だけがアップでとらえられています。
実際の漫画では、「背景だけ」「物体だけ」「キャラの一部のアップ」といったコマがよく登場します。これらは単なる風景や小物の描写ではなく、時間の流れを調整したり、状況を説明したり、次のコマへのフリを作ったりする役割を持っています。こうしたコマのうち、主役のアクションや重要な出来事を直接描かず、場面のつなぎや間を作るものは「捨てゴマ」と呼ばれることもあります。
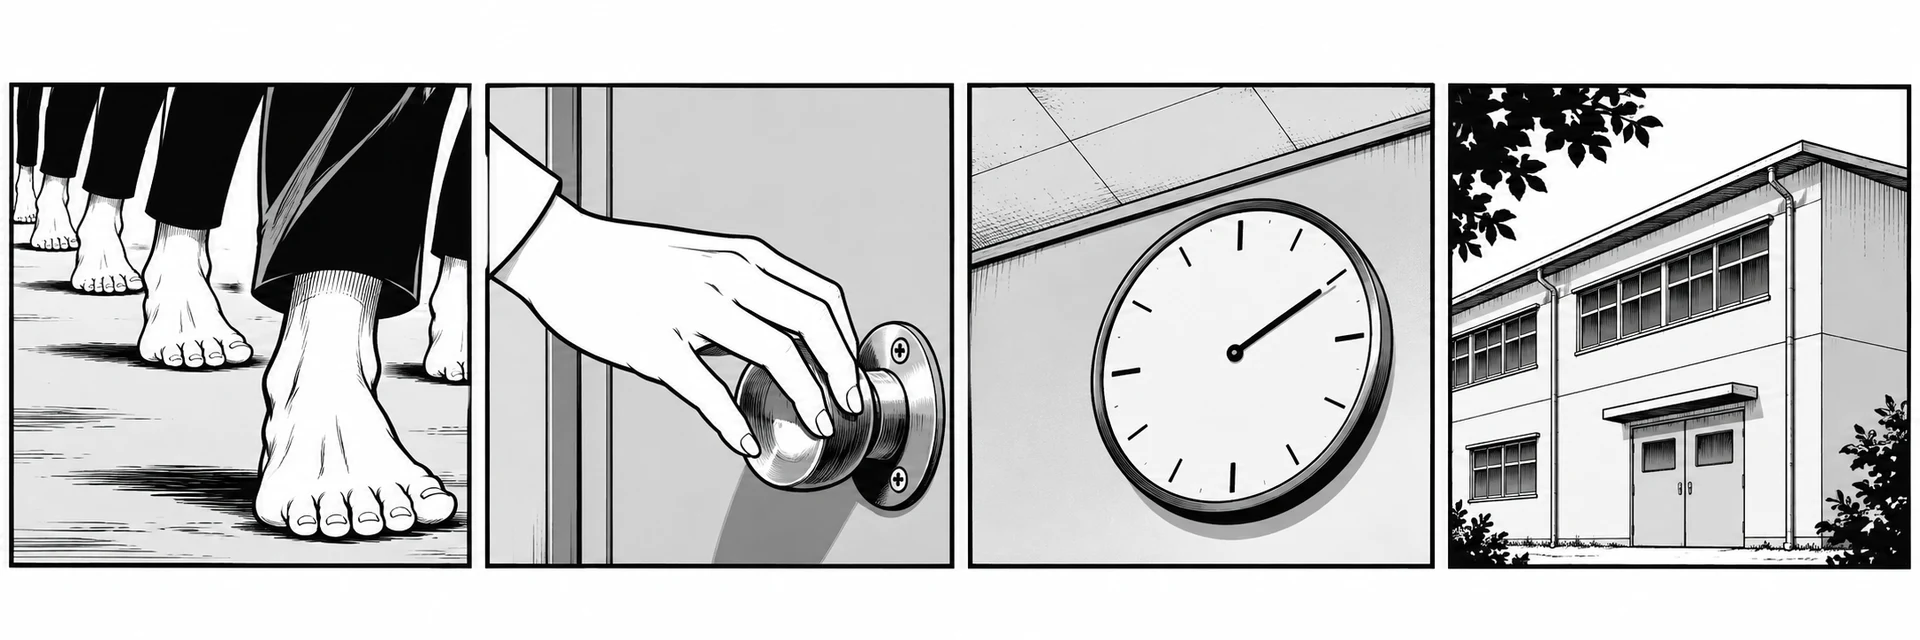
こうした「寄り」のコマは、主要人物の顔ばかり写した「顔漫画」を脱してメリハリをつける上でも重要なカットなのですが、AIはユーザーに指示されないとなかなか描いてくれません。カメラが常に喋っている(動いている)主役を中央に捉えるので、メリハリや演出が感じられない「ベタ撮り」の素人ドラマになってしまうというわけです。
<⑤キャラのいないコマにもフキダシを置いてよい>
いま掲載した時計や校舎のコマにはキャラクターが描かれていませんが、こういうコマにもセリフや擬音を問題なく載せることができます。例えば、時計に「あ…もうこんな時間!」とフキダシを載せたり、校舎の絵にキーンコーンカーンコーン♪とチャイムを鳴らしたりすると、校舎や時計が演出の一部として成立しますよね。
普段漫画を読んでいるときは当たり前のようにこういうコマを見かけますが、作る側に回るとそういう発想ができなくなるので不思議なものです。
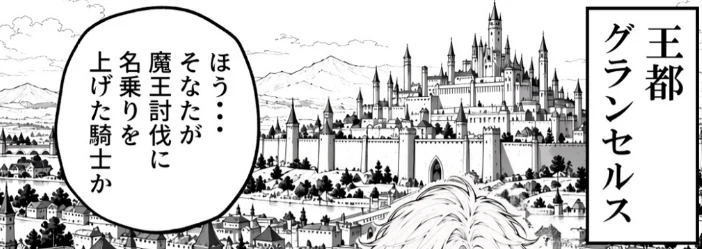
例えば、王様漫画のこのコマ。しゃべっているのはバーテンではなく、枠外にいる人物(王)だということがぱっとみて分かると思います。
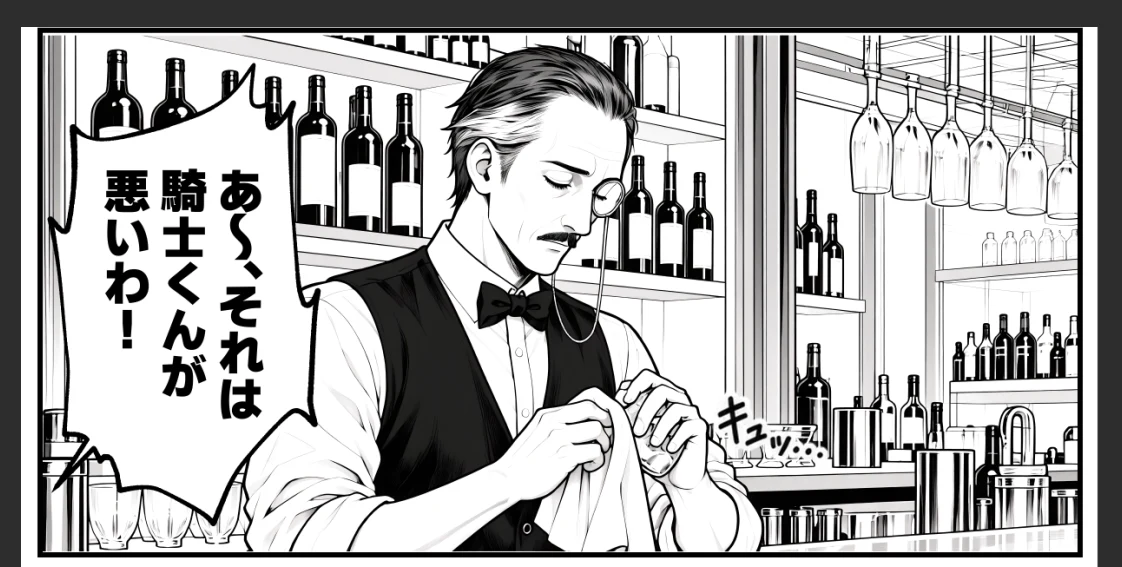
このとき、バーテンは風景の一部として演出しないと、バーテンがこのセリフを叫んでいると誤読される可能性があります。そのため、ここでは口を閉じ、大声を出さなそうな静的な演技をさせています。
このように、主役の代わりに別のものを映すとき、「コマの外にいる人物のセリフ」が添えられることはよくあります。ただ、AIはフキダシのしっぽをいちばん近くにいる人物に向けて描いてしまいがち。最初は上の例のように「しっぽはフキダシにいちばん近いコマ枠の外へ出す」と毎回指示していたのですが、GPTではかなりの確率で、しっぽが近い人物(上の例ならバーテン)のほうへ曲がってしまいました。よって、今回のスキルでは「枠外からのセリフにはしっぽをつけない」という基本ルールにしています。
<⑥登場コマはキャラの名刺>
人物を初めてしっかり見せる「登場コマ」は、読者に「この人はこういう人」と印象付ける名刺のようなもので、立ち方、仕草、表情、ポーズを通じてそのキャラの性格を伝えることが大事になります。下図は4段分のコマをタテにぶち抜いてミナちゃんの全身が描かれており、しかもそのコマには枠線をなくしてタチキリ(ページの端まで描く)にしています。こうした演出とセリフ、ポーズで、主人公がどんな人物かをできるだけ早めにアピールしておくのが常道です。
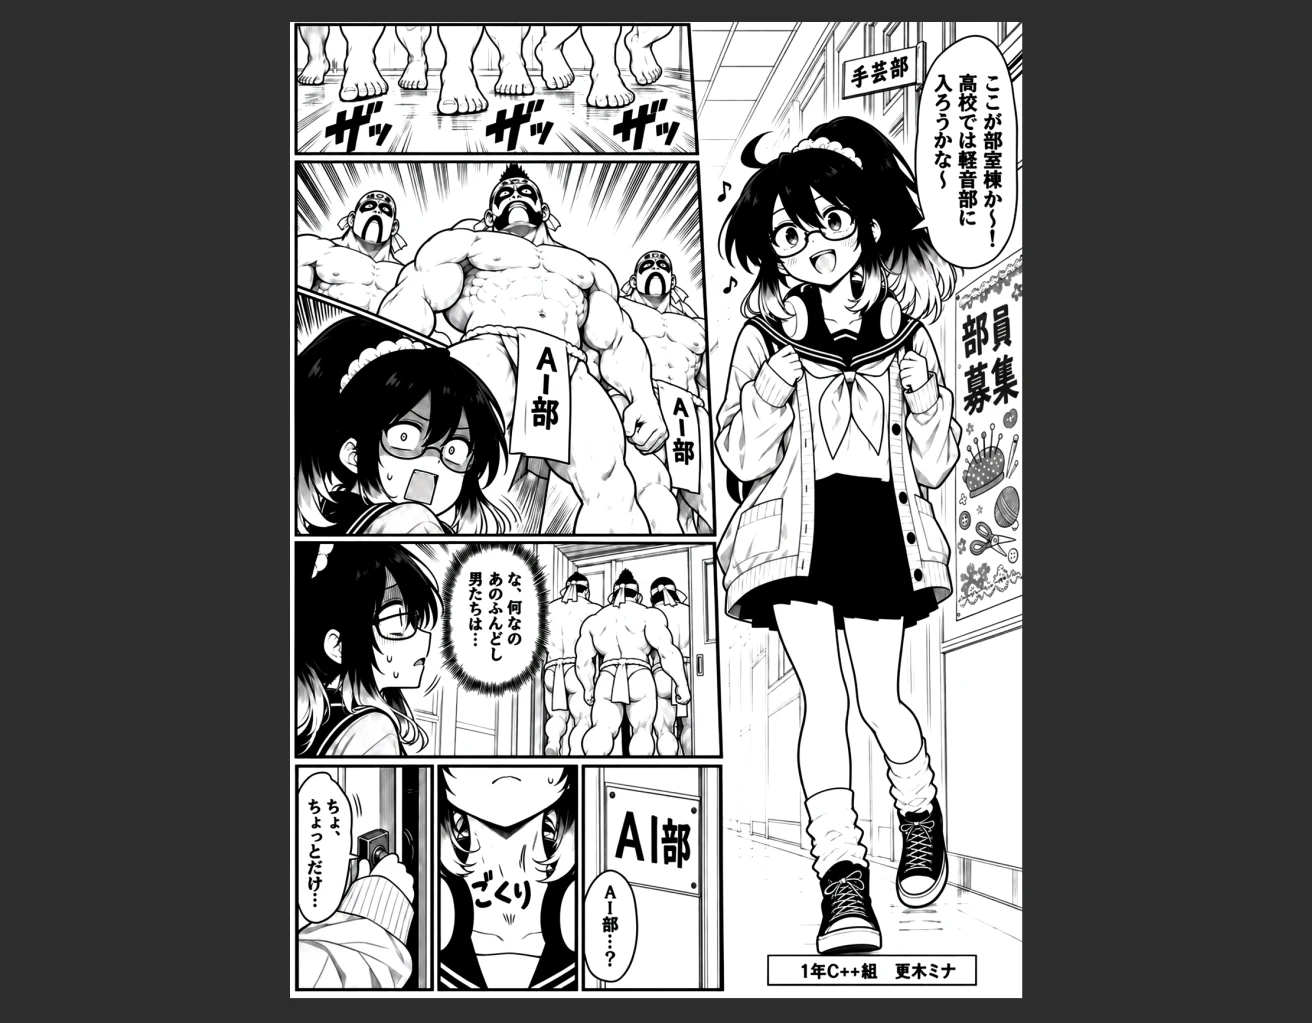
ぶち抜きで描かれたキャラは、枠線をはみ出して他のコマの内部に食い込むことがよくあります。ただ、今回のスキルでそれをやるとあとで自動コマ分割した際にうまく処理できないことが多いので、コマ枠をはみだす表現は生成段階では避けることをおすすめします。
<⑦作品ジャンルごとに演出は異なる>
AIに漫画を生成させるときは、「作品ジャンル」を伝えておいたほうがよいでしょう。なぜなら、ギャグ漫画とホラー漫画では、見た目も構成も描画もまったく違うことに注意しなくてはならないからです。背後の音に気付くリアクション一つとっても、これくらいの差が生じてしまいます。
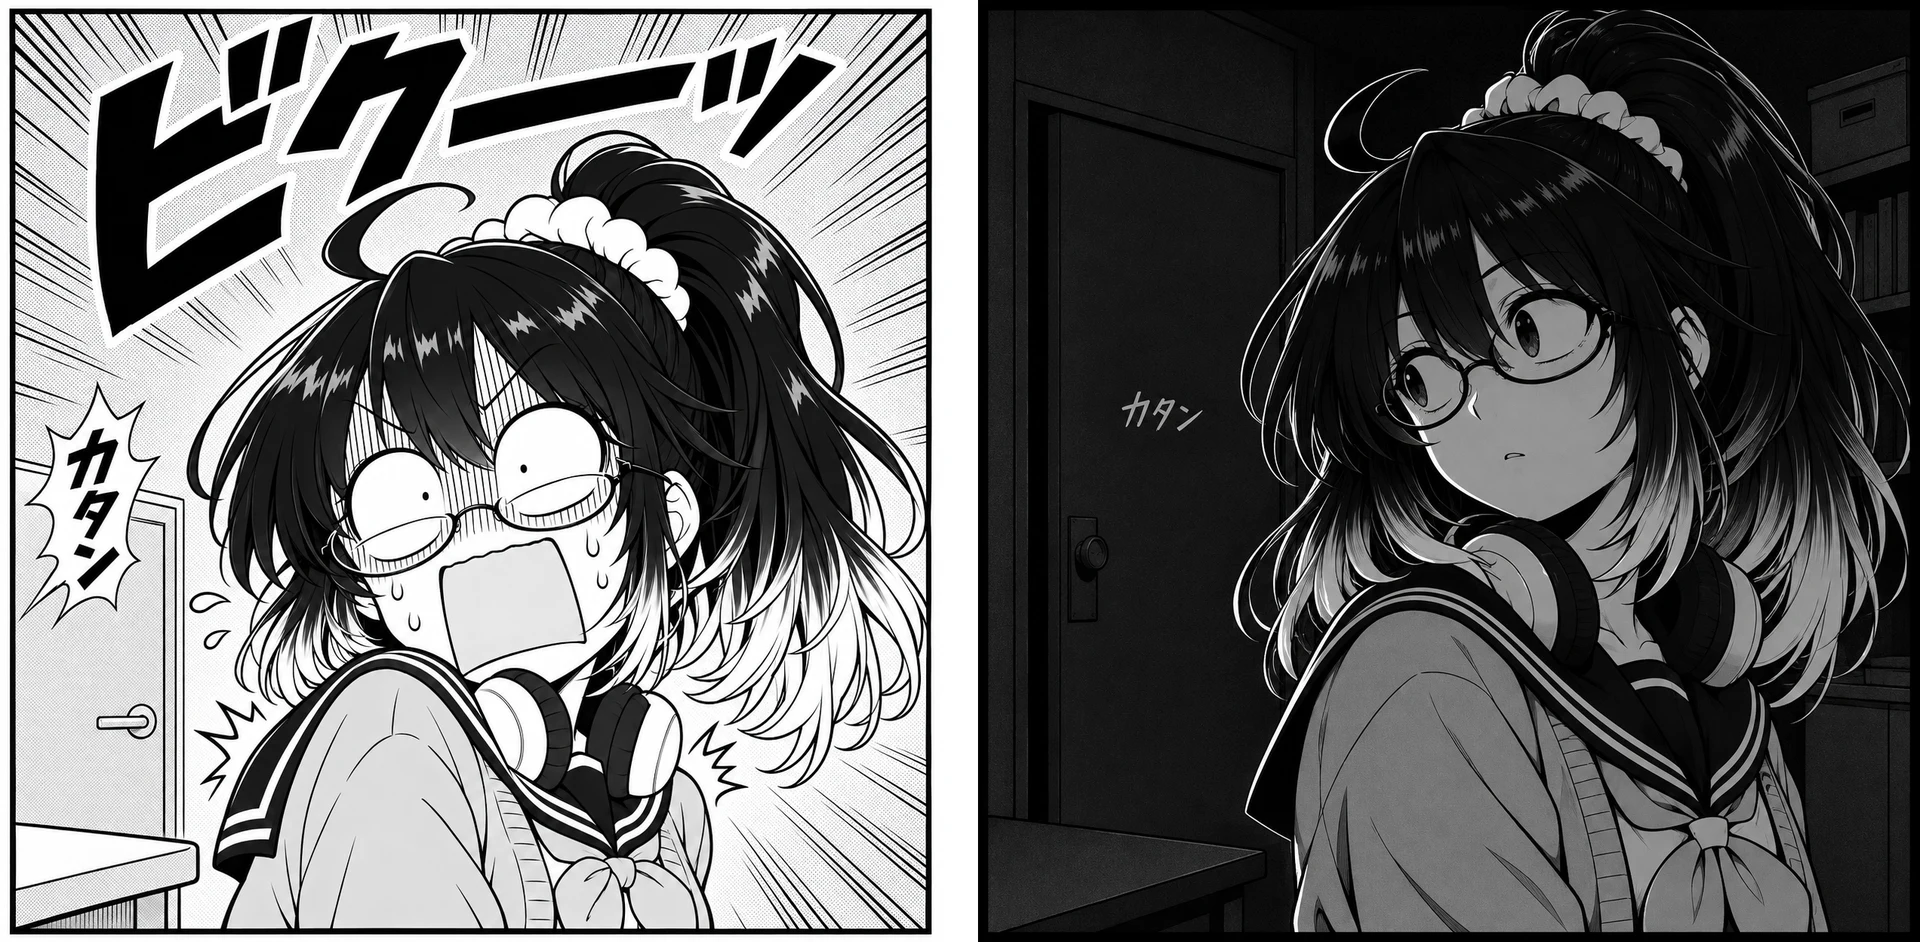
ホラー漫画でギャグ風の演出をしたら台なしです。今回のスキルではこれをGPTに理解してもらうため、コミカル、バトル、シリアス、恋愛、NSFWといったジャンル別の特徴を書き込んで、作品ごとにどれか1つのプリセットを選ぶ仕組みになっています。
<⑧イマジナリーラインを理解する>
最後に、映像的作劇では重要な「イマジナリーライン」について。2人の登場人物が向き合う場面では、2人を結ぶ線(イマジナリーライン)の片側にカメラを置き続けるのが基本です。こうすると、右にいる人物はどのコマでも右側にいて左を向き、左の人物は右を向くので、読者は誰が誰に話しているかを迷わず追えます。横から撮り続けるという意味ではなく、アップや斜めのコマでも左右と顔の向きだけを守るということです。
こちらの2つの漫画をご覧ください。左がイマジナリーラインを守れていない例です。男性とヒロインが立っている方向がコマごとに二転三転するので、読者は読みづらく感じるはずです。右の例では、「ヒロインは右、男性は左」という位置関係をおおむね守っているので、さほど混乱しないかと思います。
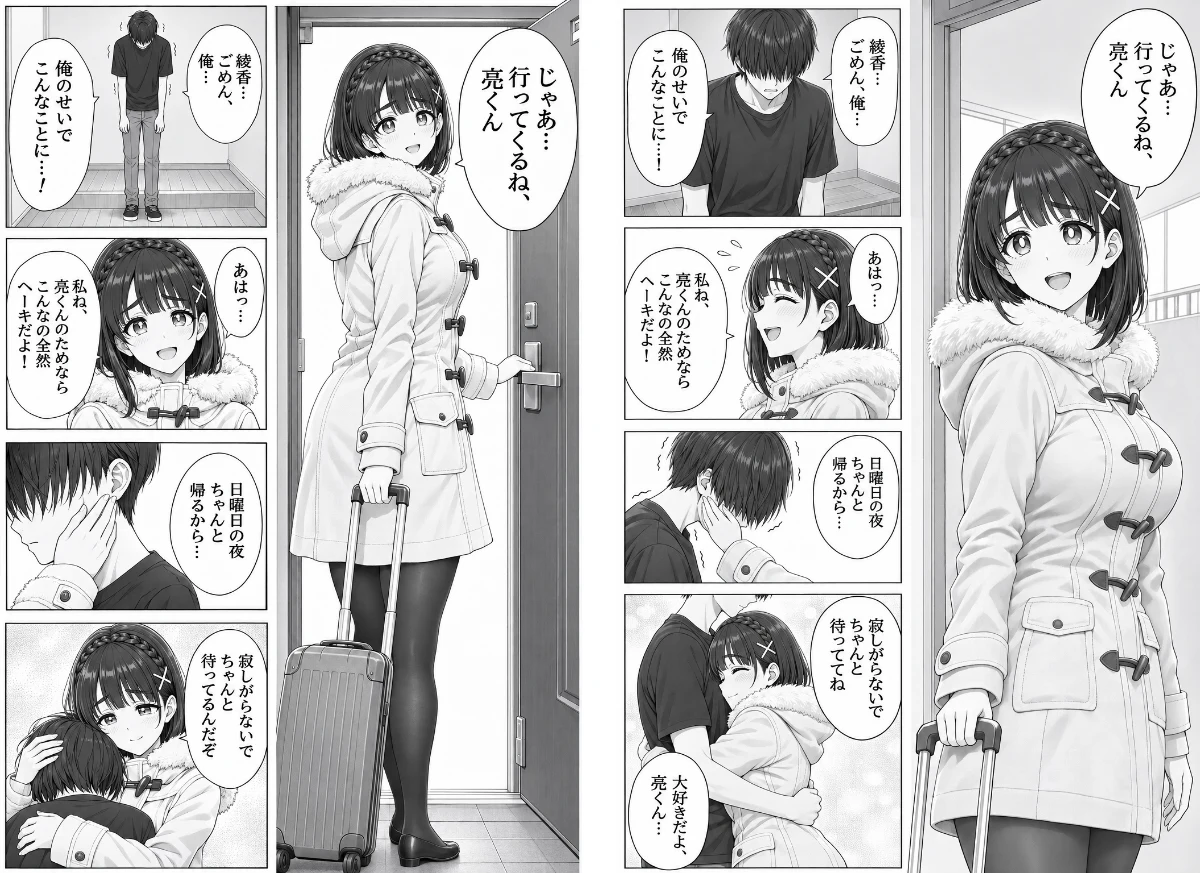
もちろん、常に横からのショットになってしまうのも不自然ですから、「いったん2人の位置関係を描いたら、カメラが向こう側に回り込んで左右逆転しないようにする」ということを覚えておけばOKです。右から左に向かって読む漫画の都合上、最初にフるキャラは右側、ウケるキャラが左側にあるとコマを割りやすいということもあります。
今回のスキルでは一応、場面ごとに「妻は右、夫は左」のように立ち位置を決めてから描かせるイマジナリーラインルールを作っています。ただし、ユーザーの指示やコマ割りの都合によってはうまくいかないこともありますので、ライン違反を起こしていないかときどきチェックしてみてください。

4.漫画スキル「Manga Director」配布
今回配布する「Manga Director」はCodex用スキルです。ClaudeCodeでも読み込むことができますが、GPT Imageを使った画像生成が使えることを前提としているため、ClaudeCodeでできるのは一部機能にとどまります。
ダウンロードする前に必ず、こちらの利用規約に目を通すようにしてください。本スキルをダウンロード、展開又は利用した時点で、規約に同意したものとみなします。
ざっくり言うと、本スキルで作った漫画や画像、.clipファイルについて、スキル配布者が成果物としての権利を主張することはありません。個人の創作であれば商用利用も可能ですが、スキル本体の再配布は禁止です。法人・団体での利用は別途ご相談ください。
<導入方法>
こちらがスキル本体のzipファイルです。デスクトップアプリのCodexで使う場合、ダウンロードしてきたzipファイルを展開し、中の3つのフォルダーをユーザーフォルダの中の「.codex\skills」に入れるだけで導入完了です。
配布ファイルはPixivFANBOX限定ですダウンロードはFANBOXの記事からどうぞ。PixivFANBOXの記事を開く
基本的にこのスキルはデスクトップアプリのCodex上で使うことを想定していますが、クラウド上のChatGPT(Workモード)で使う場合は、「プラグイン▶スキル▶追加▶コンピューターからアップロード」で、zipを展開せずそのまま渡します。
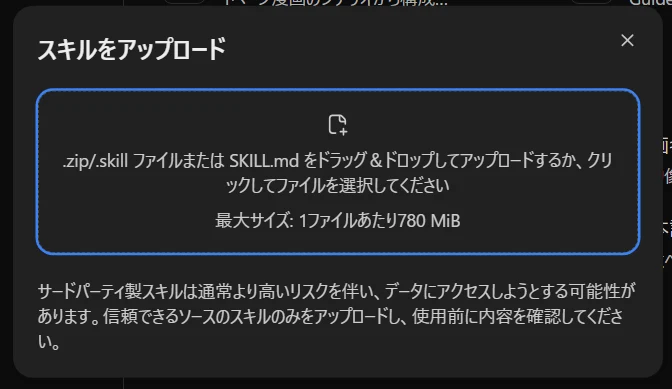
ただし、ChatGPTのスキル機能は契約プランやワークスペースの設定によって利用できない場合があります。クラウド版のGPT WorkはPC内の作業フォルダーに直接アクセスできないため、ローカル版とはファイルの受け渡し方法が異なる点もご注意ください。
<3つのスキル>
zipファイルの中身はこのような構成になっています。3つのフォルダはそれぞれ、リファレンス・漫画生成・クリスタ化を担当する別個のスキルです。互いの決まりを読み合う作りなので、必ず3つとも入れてください。あとはCodex上で
「この画像で参照資料を作って」「この台詞で1ページ漫画を作って」「この漫画をクリスタにして」などと頼めば動きます。
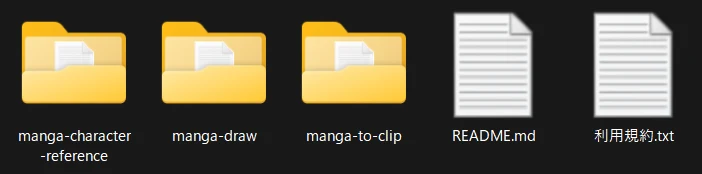
・manga-character-reference(キャラの資料を作る)
「参照資料を作ってください」などと頼むと発動します。 手元の画像から、頭身を決めた全身の三面図(バストアップつき)、見た目を書いたキャラ説明、表情集(3×3)を作ります。画像がなければ、言葉の説明から10案を出します。頼めば、さらに多数の表情を追加してデータベースを構築できます。
・manga-draw(AIネームを描く)
「○○漫画を作ってください」などと指示すると、 台詞や状況などのメモからまずシナリオを執筆。それをもとに、「試し描き」のネーム案を1枚画像生成してくれます。ユーザーに直しを指示されたら、ネームが完成するまでその通りにやり直します。1ページ漫画、4コマ漫画、複数ページに対応しています。
・manga-to-clip(AIネームをクリスタにする)
「クリスタにして」と頼むと、いま生成した漫画のpng画像からフキダシと台詞だけを取り除き(描き文字・集中線・動きの線は残します)、コマごとに大きく描き直して、コマ枠フォルダーに分けた .clip とコマごとの絵を作ります。AI の漫画でも、人の描いた漫画でも使えます。
他にも、以下のような指示に反応して、求められた作業を行います。
・「キャラシートを作って」:全身の正面・真横・背面と、バストアップを並べた1枚ができる。
・「表情集を作って」:顔を3×3に並べた1枚ができる。指示するときに作品のジャンルやキャラの性格を伝えるとよい。(例:AI部を舞台にしたシュールギャグ。このキャラは明るく元気な後輩で、ツッコミ役)
・「参照資料を作って」:キャラシートと表情集を順に作成します。
・「データベースを作って」:キャラシートをもとに表情集を追加生成し、最大99種類の表情をデータベース化する。
・「○○漫画を作って」:参照資料を踏まえて、漫画のページを描画する。4コマ漫画、1P漫画などと具体的に指示する。
・「クリスタにして」:全コマを三面図と表情集に合わせてGPT image 2.5で描き直し、.clipファイル化
・「清書せずそのままクリスタにして」:各コマを描き直さず、最終案の絵のまま.clipファイル化
もちろん、既にキャラシートがある場合は漫画作り(manga-draw)からいきなり始めることもできますし、不要なデータベース作りをスキップすることも可能です。あまり深く考えず、チャットで相談しながら進めていけるつくりを意識していますので、分からないことはCodexに直接尋ねてみてください。
<利用している技術>
このスキルは基本的に、GPT Work/Codexで完結して動くように作ってあります。モデルはGPT-6系を想定していますので、契約プランによって余裕があれば重量級のGPT-6 Astraを使ってもよいですし、より速度の速いGPT-6.1 Terraに任せてもよいかと思います。
三面図や表情集、ネーム案を描く部分は、GPT Image2.5(CodexやChatGPTのWorkモードの画像生成)が使われます。「クリスタにして」と頼む際の清書も同じです。コマ枠の読み取りや.clipファイルの書き出し、白い部分の透過についてはPythonというプログラミング言語で行うので、これもモデルを新たに用意する必要はありません。
ただし、ぶち抜きの人物がとなりのコマに重なっている漫画を.clipファイルにしたいときなど、GPTで完結してできない作業と判断した場合は、ComfyUIのQwen-Imageを要求することがあります。生成環境のフォルダ位置を伝えると勝手に活用してくれますので、あらかじめこちらの記事を参考に導入しておいてもよいでしょう。