更新履歴
・2026/08/01:Copita v1.21に更新
Civitai経由で海外の読者が増えたことを受け、英語利用の規約や説明文を充実させました。日本人ユーザーにとって中身の変更はありません。
・2026/07/18:Copita v1.2に更新
Anima用画像の前処理を刷新し、学習精度を向上。層別学習機能を追加したほか、各種安定化、不具合修正などを含みます。
・2026/07/06:Copita v1.11に更新
一部環境でフォルダ選択ダイアログが正常に開かない問題があったため、フォルダ指定時の処理を変更し、直接パス入力でも設定できるようにしました。
・2026/07/04:Copita v1.1に更新。「学習履歴タブ」を新たに実装しました。
Python 3.10 / 3.11が入っていないPCでも、初回セットアップ時にCopita用のPython 3.11をCopita内に自動で用意できるようになりました。画像のドラッグ&ドロップ読み込み、通常時より詳細にタグ付けするボタン、LoRAフュージョンモードのUI改修、SDXL / Anima別の学習プリセット表示など、操作性を改善しました。
一部のAnimaモデルでVAE関連キーが含まれている場合に学習前チェックで止まる問題に対策をしました。
・2026/06/27:v1.02に更新
SDXL向け学習プリセットの設定に不備があり、SDXLをベースとした学習が失敗する不具合を修正しました。また、膨大になりがちだった進行ログを見やすく改善しました。
・2026/06/27:v1.01に更新
Copita公開。RTX50系GPU環境でPyTorchのCUDA対応版が合わない問題を修正したv1.01に更新。

こんばんは、スタジオ真榊です。今回は、1枚の画像からSDXL / Anima向けの画風LoRAを学習できるアプリ「Copita」を公開します。
Copitaは、1枚のお手本画像からそれに対応する「比較画像」を作ることで、2枚の違いをLoRAとして取り出すアプリです。画風だけが違うペアなら画風LoRAに、線の太さだけが違うペアならBoldLoRAのような概念スライダーLoRAになります。どれくらいしっかり学習する設定かにもよりますが、RTX3060なら1時間弱、4080なら数十分程度でLoRAを作ることができます。
Copitaのインストール方法や基本的な使い方だけでなく、グラフィックボードの性能に合わせてより精度の高いLoRAを作れるように、各パラメータの解説や効果的な設定方法も深掘りします。導入や操作で詰まったら、記事末尾の「トラブルシューティングとFAQ」もご活用ください。【約2万字】
はじめに - Copitaでできること
Copitaは、「コピー機法」と呼ばれる手法を使って、「1枚の画像から画風LoRAを作れるAnima/SDXL兼用の学習アプリ」です。内部的には2枚の画像の違いをLoRAとして抽出する動作をするので、画風LoRAだけでなく、線画の太さや胸の大きさなどをスライダーのように増減する調整系LoRAも作ることができます。
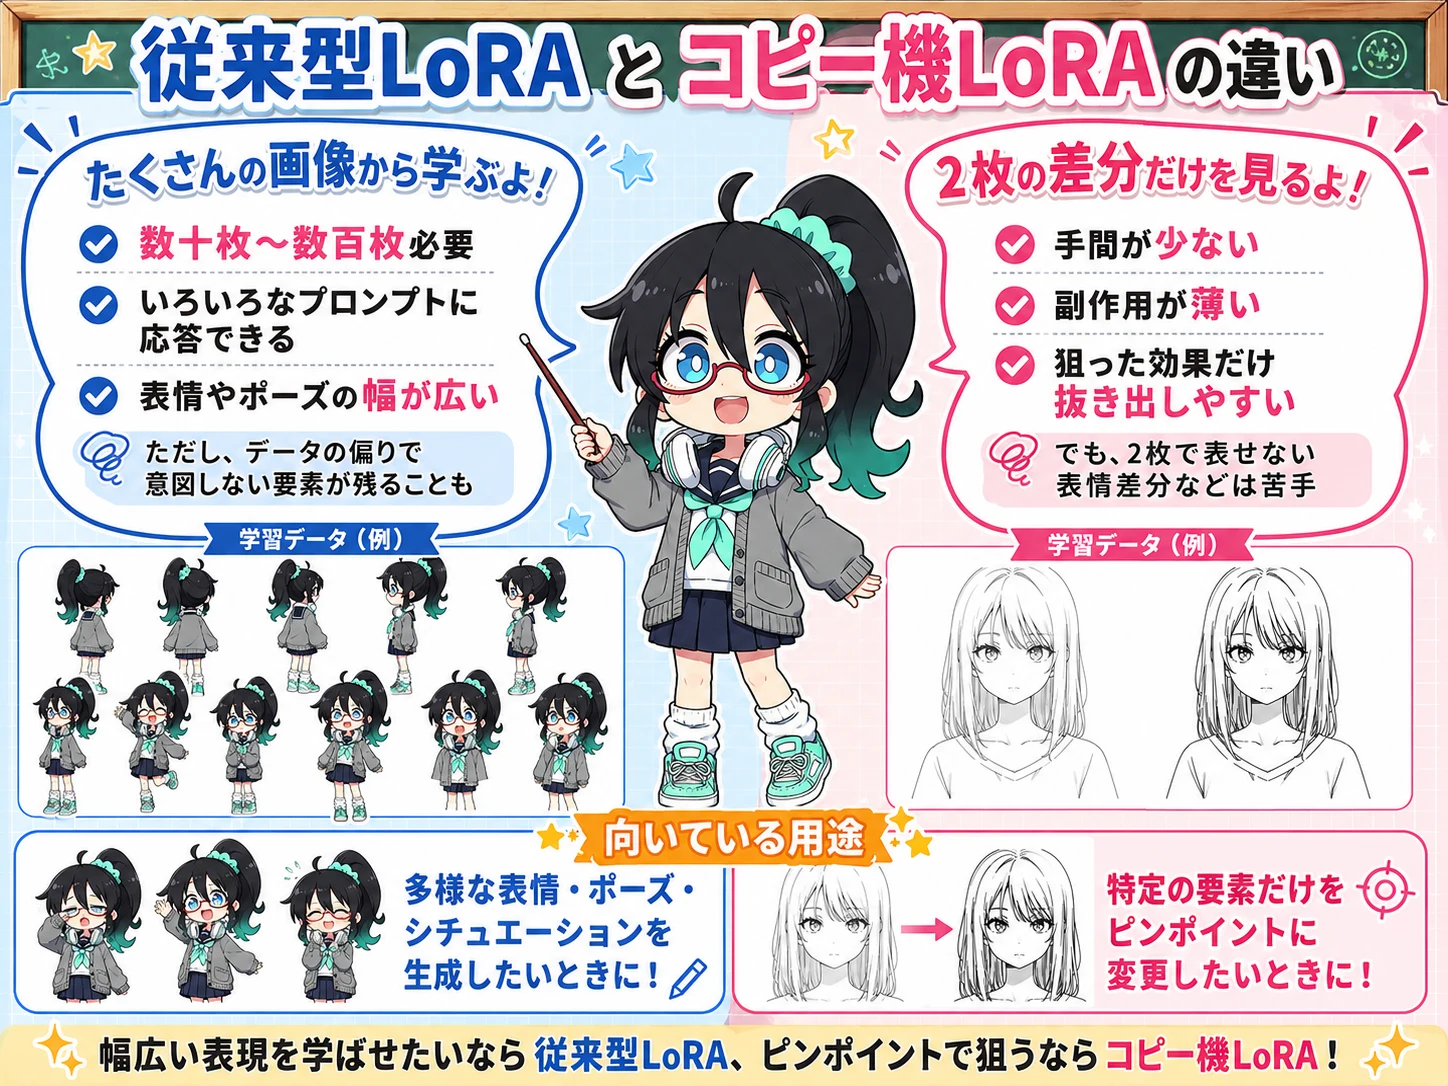
数十枚~数百枚のデータセットを反復学習させる従来型の学習法との違いはこんな感じ。コピー機法は手軽にLoRAを作れて、狙った要素だけを抜き出すことができる代わりに、2枚の差分で表現できない概念の学習は苦手ということだけ覚えておきましょう。
Copitaはこの「コピー機法」を簡単に使えるようにしたアプリ。画面の左側に「学習させたい概念」のお手本画像を入力し、画面の案内通りにぽちぽちすると「比較画像」を簡単に入手できるつくりになっています。例えば下図のようなペアなら、「線画を太くするコピー機LoRA」ができるわけです。
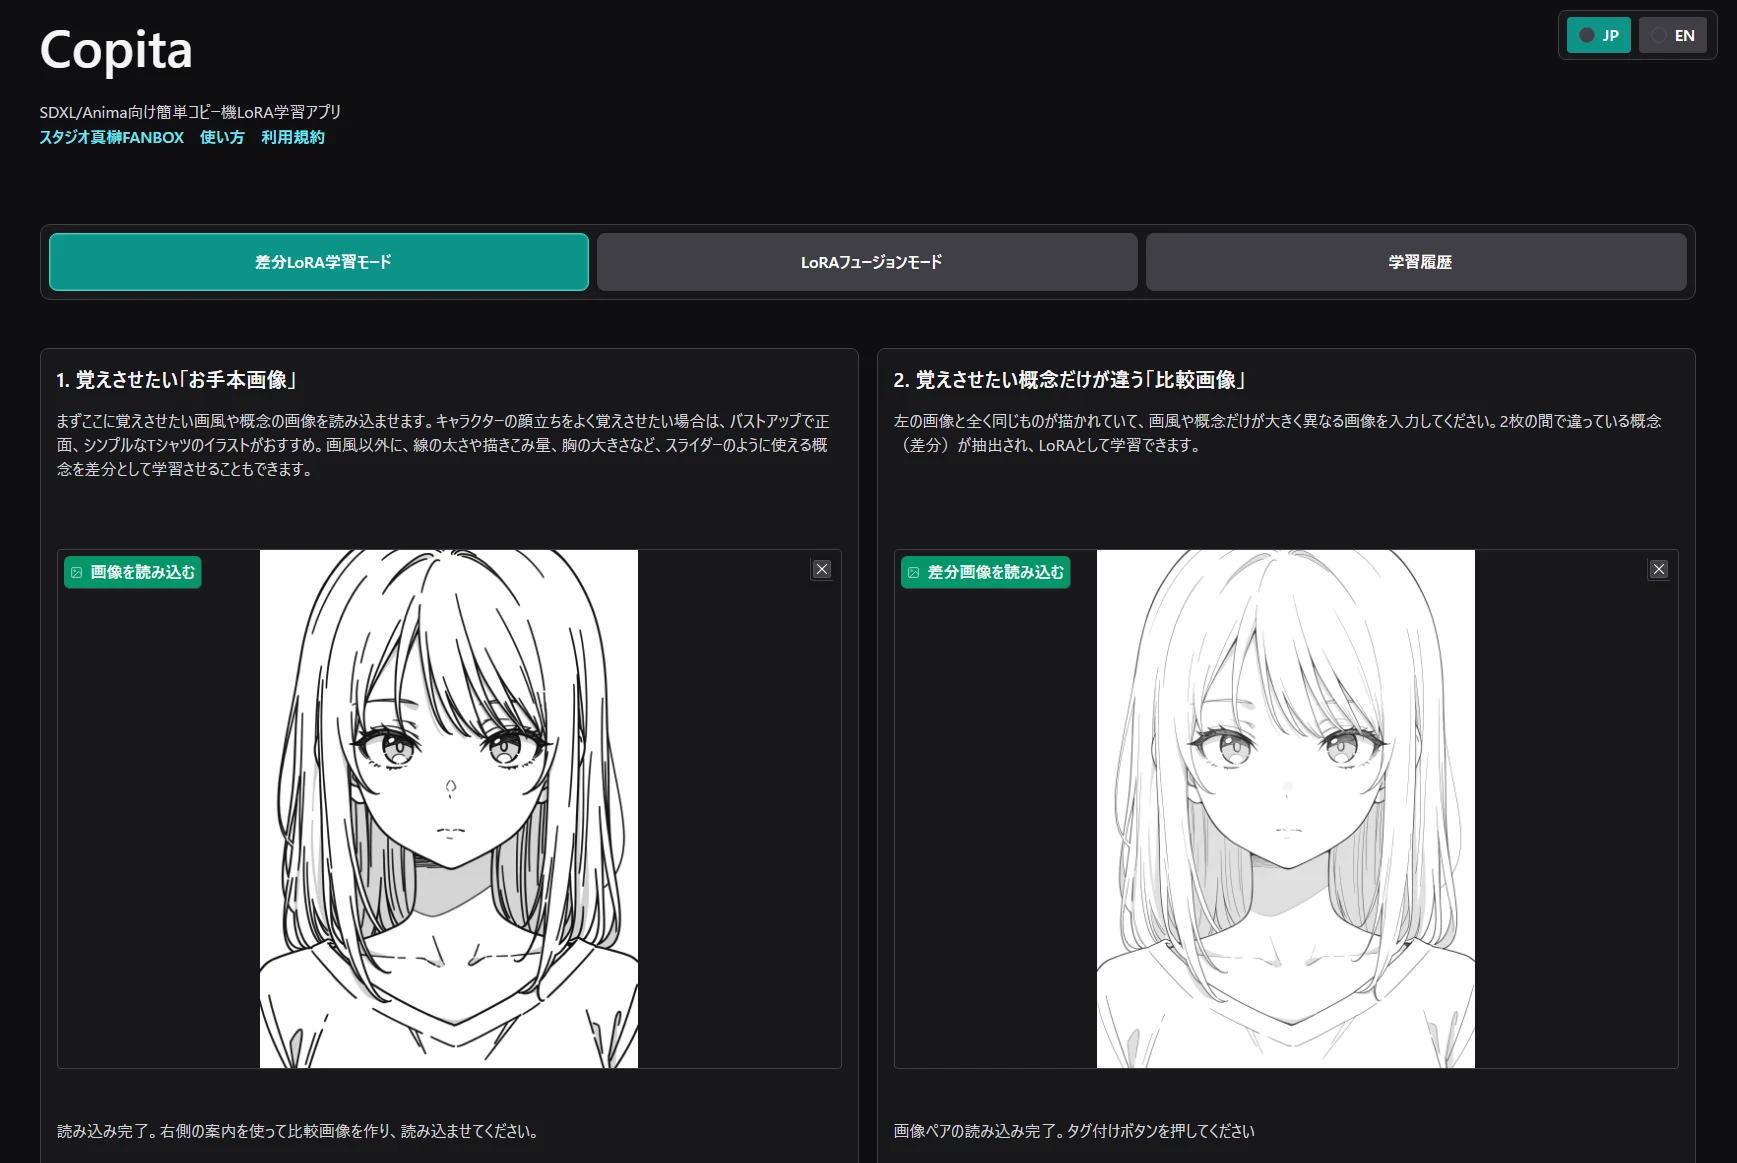
2枚の間で共通している人物の容姿、服、ポーズ、構図、背景は学習されにくくなり、差異を作った部分(線、塗り、影、質感、カラーリング、筆致など)がLoRAとして抽出・学習されます。つまり、純粋に「狙った概念だけが違う画像ペア」を上手に作れるかどうかでLoRAの精度は変化します。
実験的機能として、過去に作ったLoRAを2〜4個混ぜる「LoRAフュージョン」機能も実装しました。1つ1つでは精度が足りない(ポーズが変わるなどの副作用がある)同種のLoRAを合体することで、狙った効果は残しつつ、副作用を弱めるのが狙いです。記事後半でやり方や実際の効果を検証しています。

<推奨環境と利用規約>
Copitaは以下の環境を想定して開発されています。
・Windows 10 / 11
・NVIDIA製グラフィックボード(VRAM 12GB〜で動作確認)
・Python 3.10または3.11(3.11推奨)
※PC全体の既定Pythonが3.12 / 3.13でも、v1.1以降なら初回セットアップ時にCopita専用のPython 3.11環境を自動で用意します。PC全体の既定PythonやForge Neo / Stability Matrixの環境は変更しません。
・空き容量20GB以上推奨
本アプリはスタジオ真榊FANBOX支援者向けのオリジナルアプリです。アプリ本体や配布ZIP、同梱ファイル、記事本文内の配布リンク、ダウンロードURLを無断で共有・転載・再配布することは禁じられています。
本アプリをダウンロード、展開、起動、または利用した時点で、こちらの利用規約に同意したものとみなします。アプリにも同じ内容のテキストが同梱されていますので、必ず事前にお読みください。

Copitaのインストール方法
①Copitaをダウンロード
さきほどの利用規約を了解いただけたら、こちらから最新版の配布ZIPをダウンロードし、PC内の好きな場所に解凍してください。
【最新】Copita v1.21 - 2026年8月01日更新
Civitai経由で海外ユーザーが利用することに備え、英語利用の規約や説明文を充実させました。日本人ユーザーにとって中身の変更はありません。
配布ファイルはPixivFANBOX限定ですダウンロードはFANBOXの記事からどうぞ。PixivFANBOXの記事を開く
②setup_first_time.batを実行
解凍したフォルダの中に、次の2つのbatファイルがあります。
・setup_first_time.bat:初期設定用。1度しか使わない
・start_copita.bat:今後毎回copita起動時に使う実行ファイル
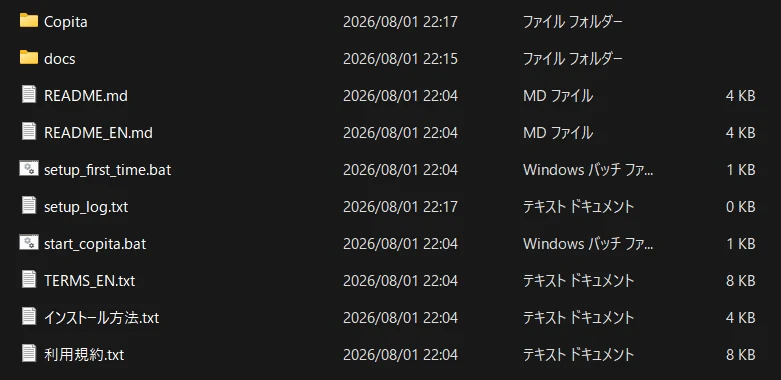
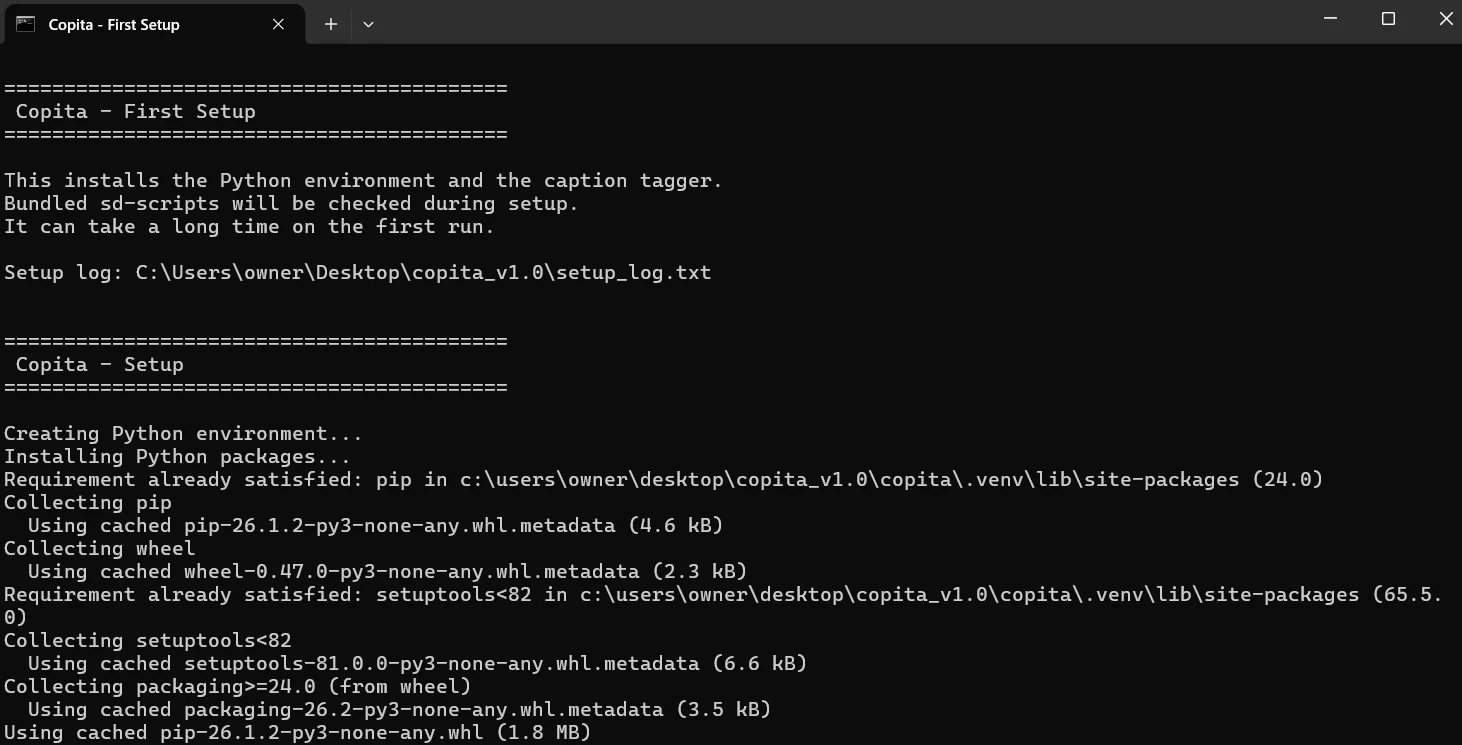
初回だけ、setup_first_time.batをダブルクリックします。必要なファイルのDLを含めた環境作りが自動で行われ、LoRA学習に使う「sd-scripts」や、タグ付けに使うモデルなどが準備されます。ここだけ少し時間が掛かるので、しばらく放置しておいてください。(手元環境では8分程度でセットアップ完了)
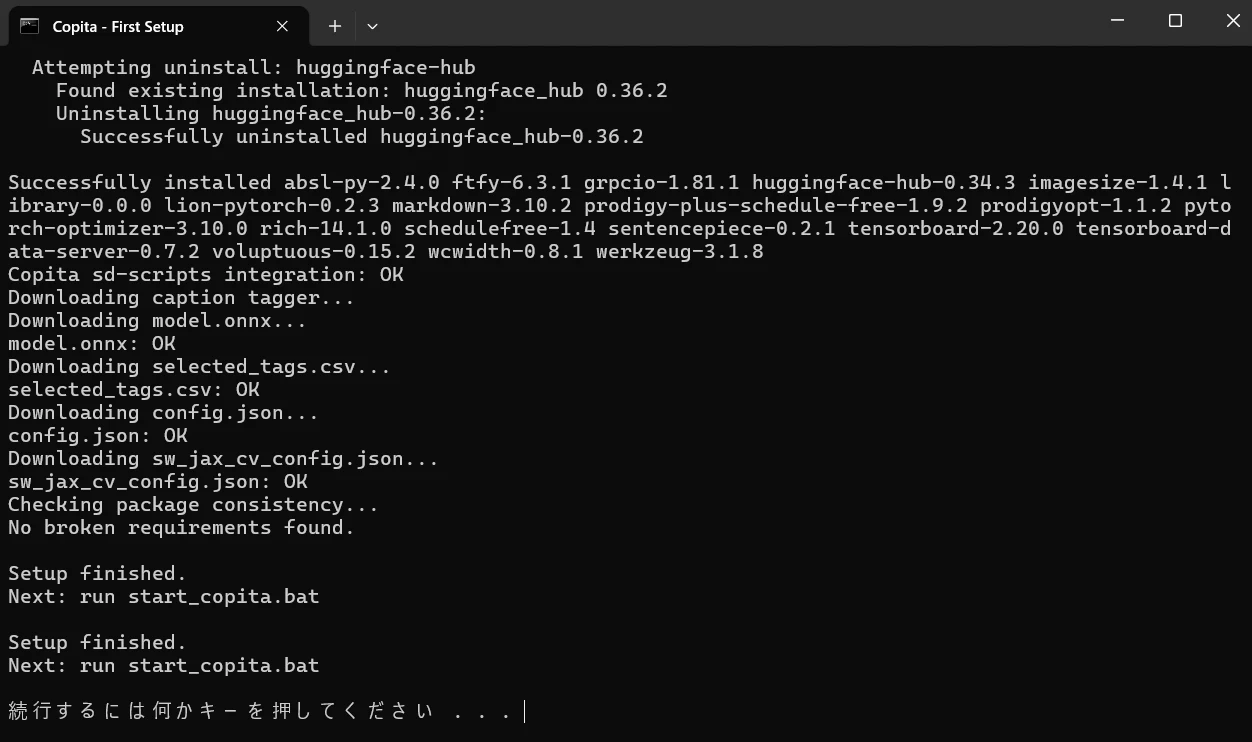
「Setup finished」と表示され、画面がこのようになれば終了です。何かキーを押すと画面が閉じます。
③start_copita.batを実行
起動用の「start_copita.bat」をダブルクリックします。少し待つと自動でブラウザが開き、Copitaの起動画面が表示されるはずです。ブラウザが自動で開かない場合は、黒い画面に表示されている「http://127.0.0.1:7865」を手動で開いてください。(Ctrlキーを押しながらクリックすればOK)
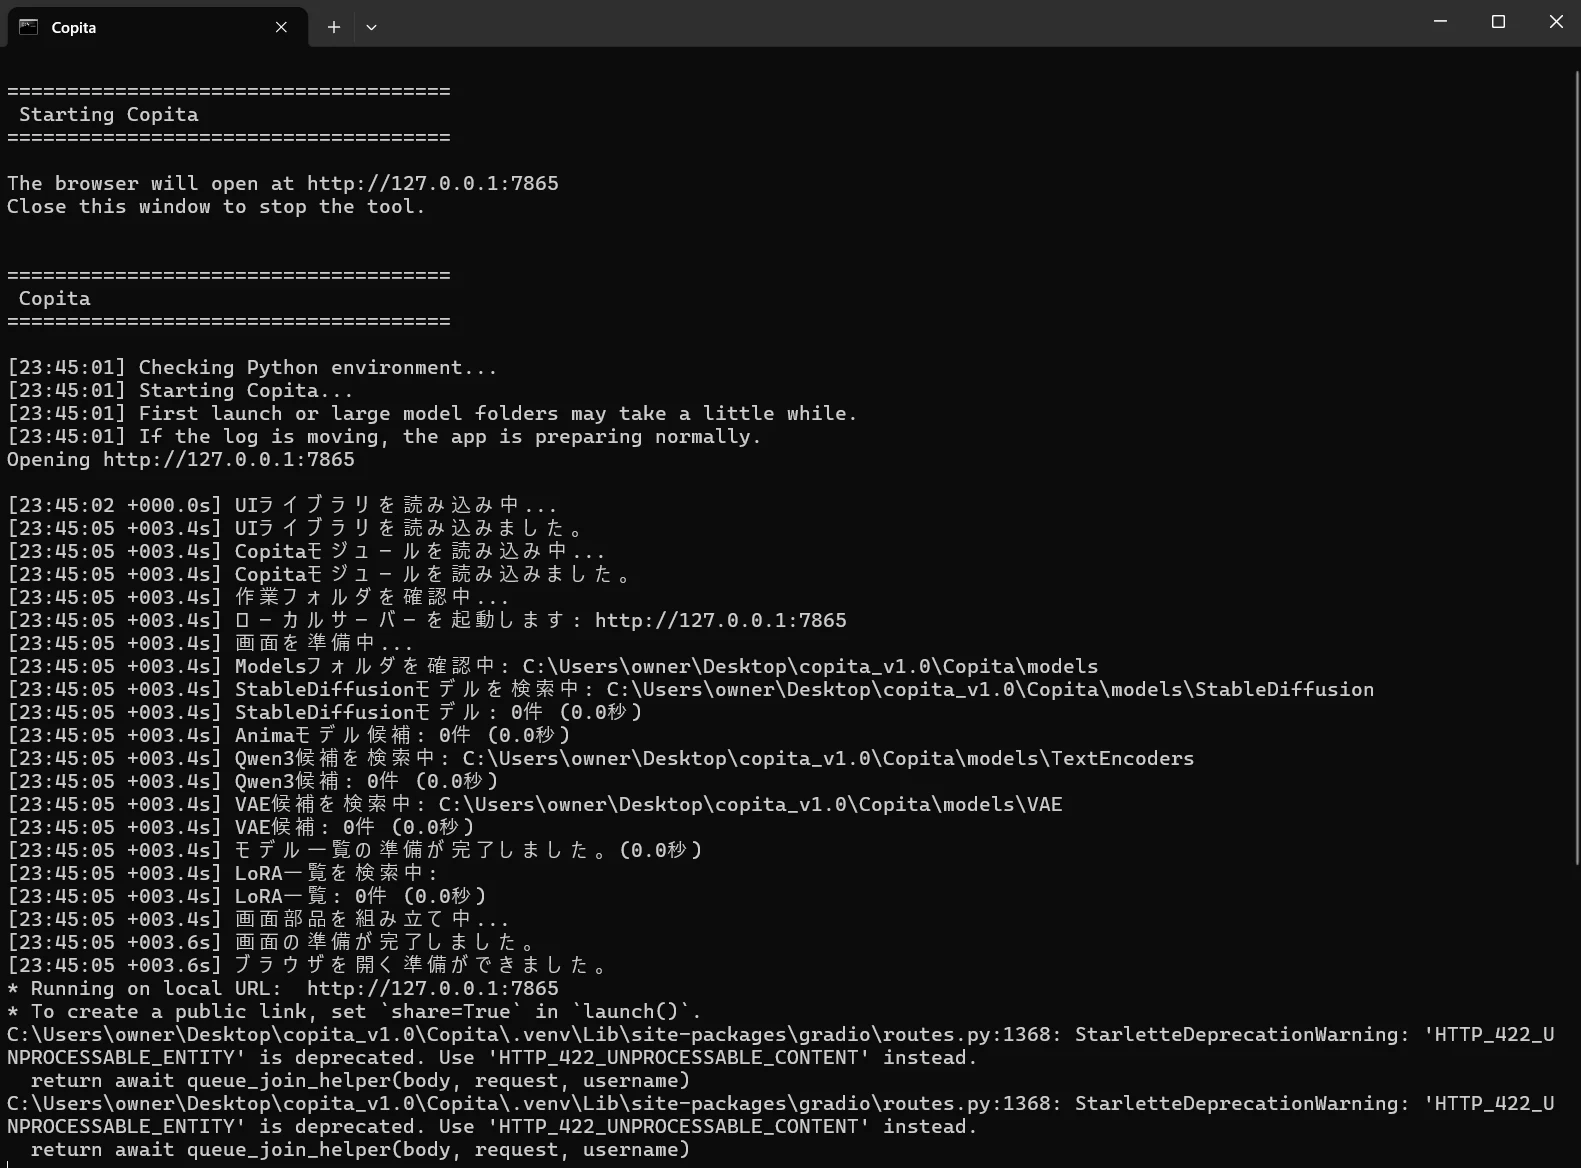
Copitaを終了したいときは、ブラウザ画面と起動時に開いた黒い画面を閉じればOKです。今後、アップデートがあった際はこちらのページや最新記事で告知しますので、旧バージョンを削除し、新しいバージョンを使うようにしてください。

基本的な使い方
こちらがCopitaの起動画面です。メインとなる「差分LoRA学習モード」のほかに、実験的機能の「LoRAフュージョンモード」(後述)を上部のタブから選ぶことができます。v1.1以降は「学習履歴」で過去のCopita学習の履歴を確認することができるようになりました。
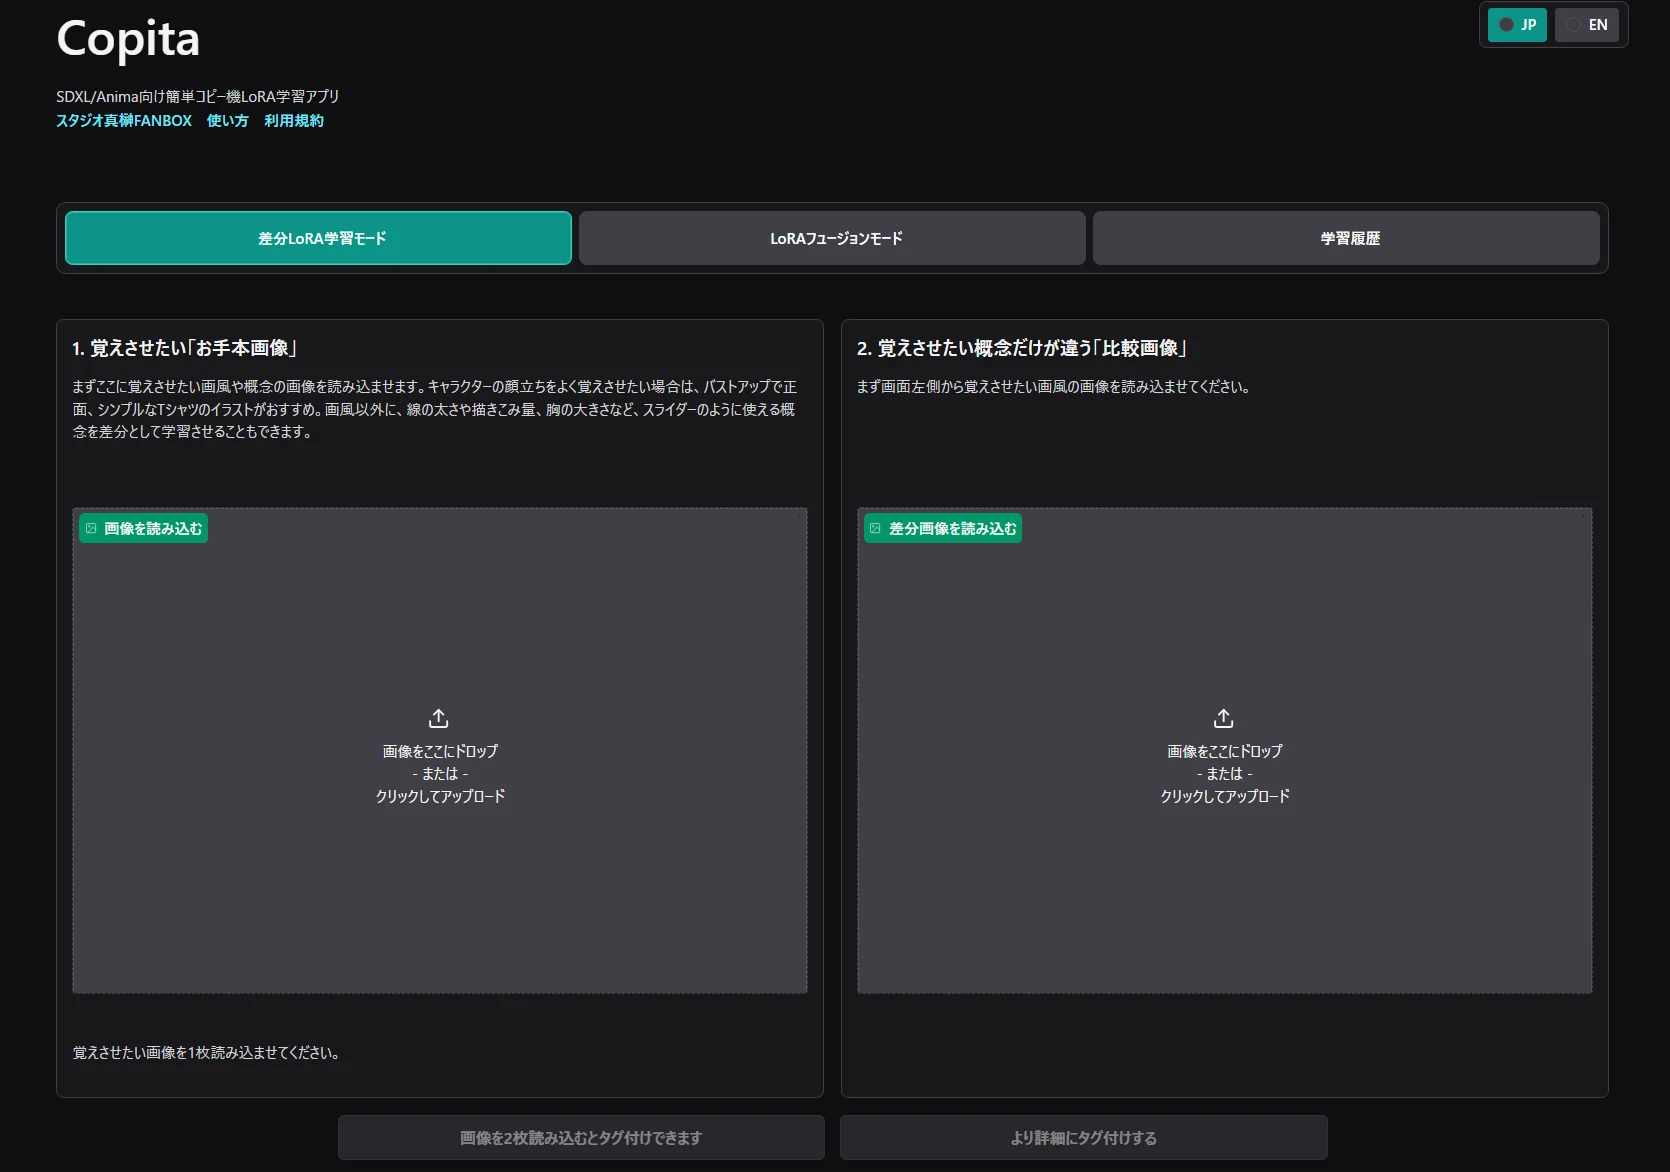
さっそく、「差分LoRA学習モード」で画風LoRAを学習させてみましょう。
①覚えさせたい「お手本画像」を入力
まず、画面左側の 「覚えさせたい画風の画像」に、学習したい画風の画像を1枚入れます。キャラクターの顔立ちや線の癖を覚えさせたい場合は、顔が小さい全身図よりバストアップの方がおすすめ。正面寄りでシンプルな服、笑顔か真顔、シンプルな背景を選ぶと、安定したLoRAにしやすいです。今回はこちらの画像で学習させてみます。
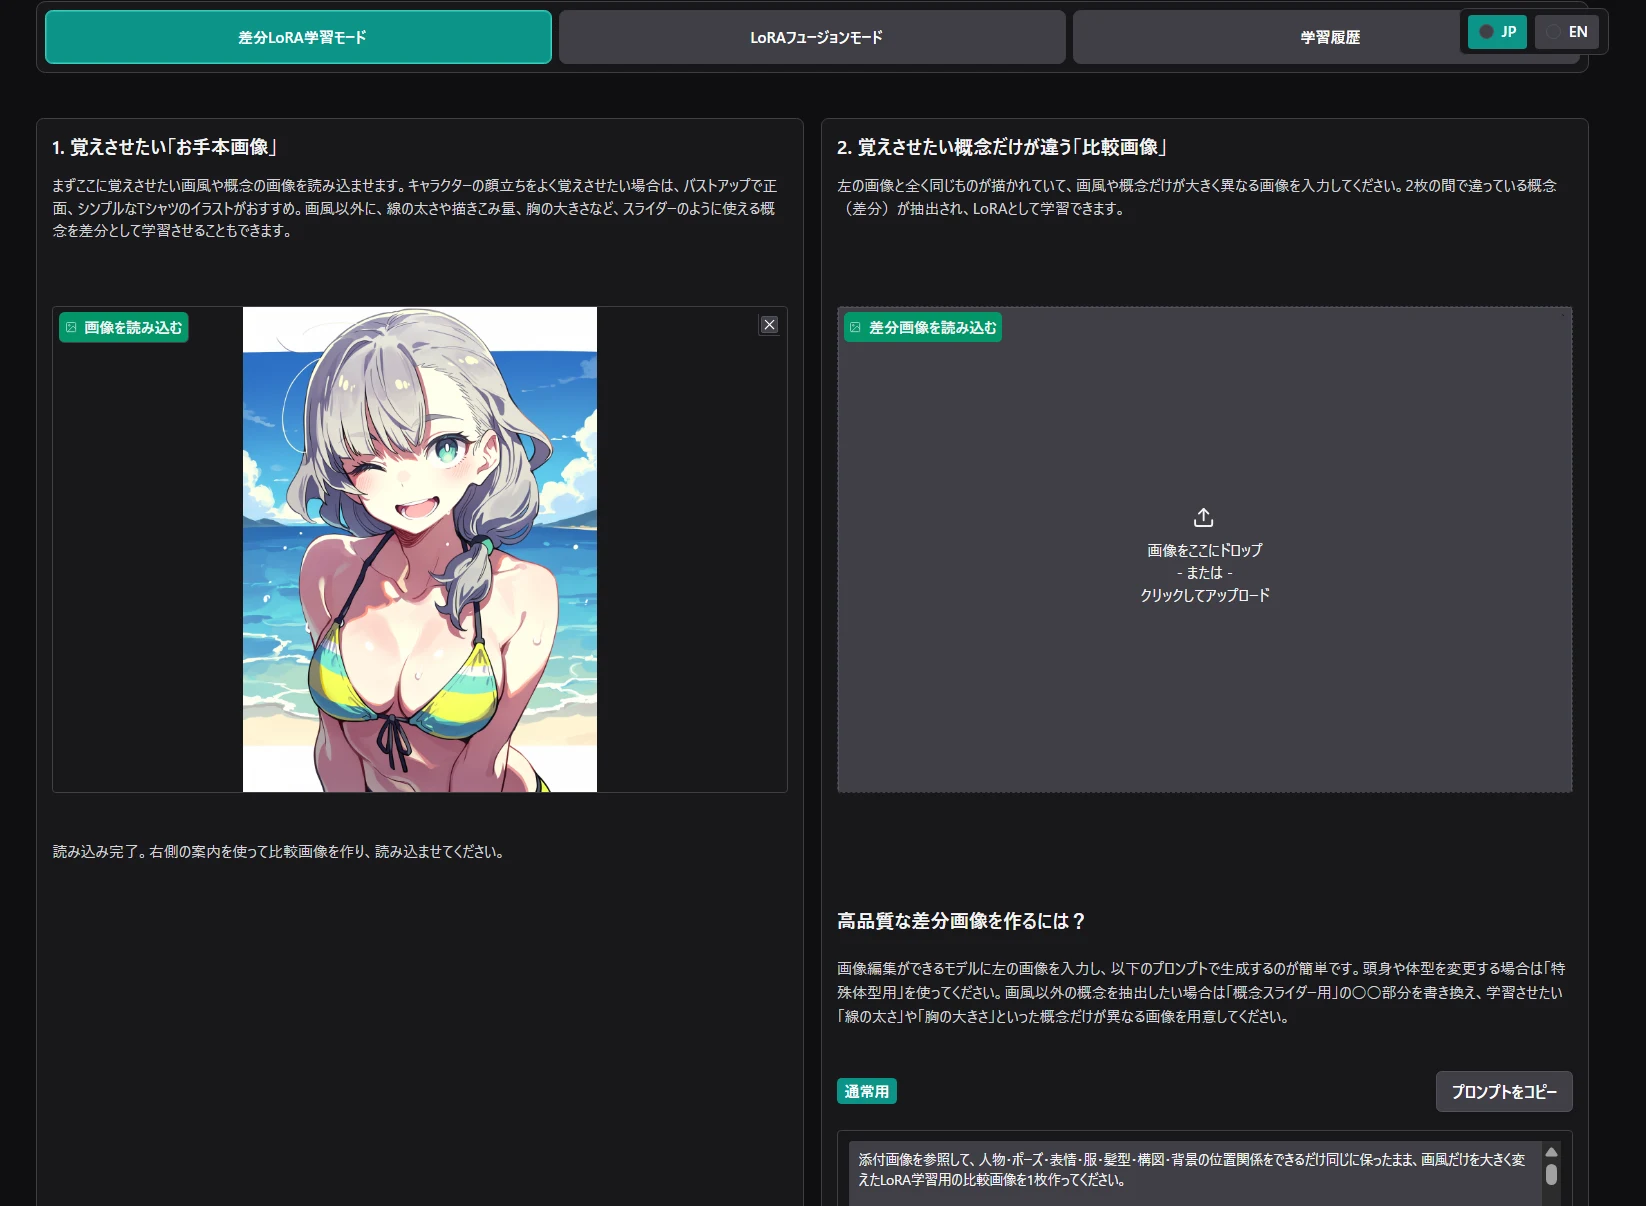
画像は正方形から3:4程度までのアスペクト比のpng/jpgファイルを選びます。サイズが大きすぎる場合は内部的に自動縮小されますので、事前リサイズの必要はありません。左右の画像の大きさが違っても学習できますが、アスペクト比はできるだけ一致させましょう。
<コピー機LoRA法に適した入力画像は?>
例えばこちらのような白背景のキャラ画像から画風LoRAを作ると、覚えてほしいカラーやタッチ、顔立ち、手の描き方だけでなく、水滴や塵、吐息表現、脚を途中までしか描かないこと、アホ毛があることなども一緒に「画風」として学習されてしまいます。もちろんプロンプトで取捨選択はできますが、強く掛けるとこのキャラ絵の持つ特徴がどれもこれも発現してきてしまうわけですね。
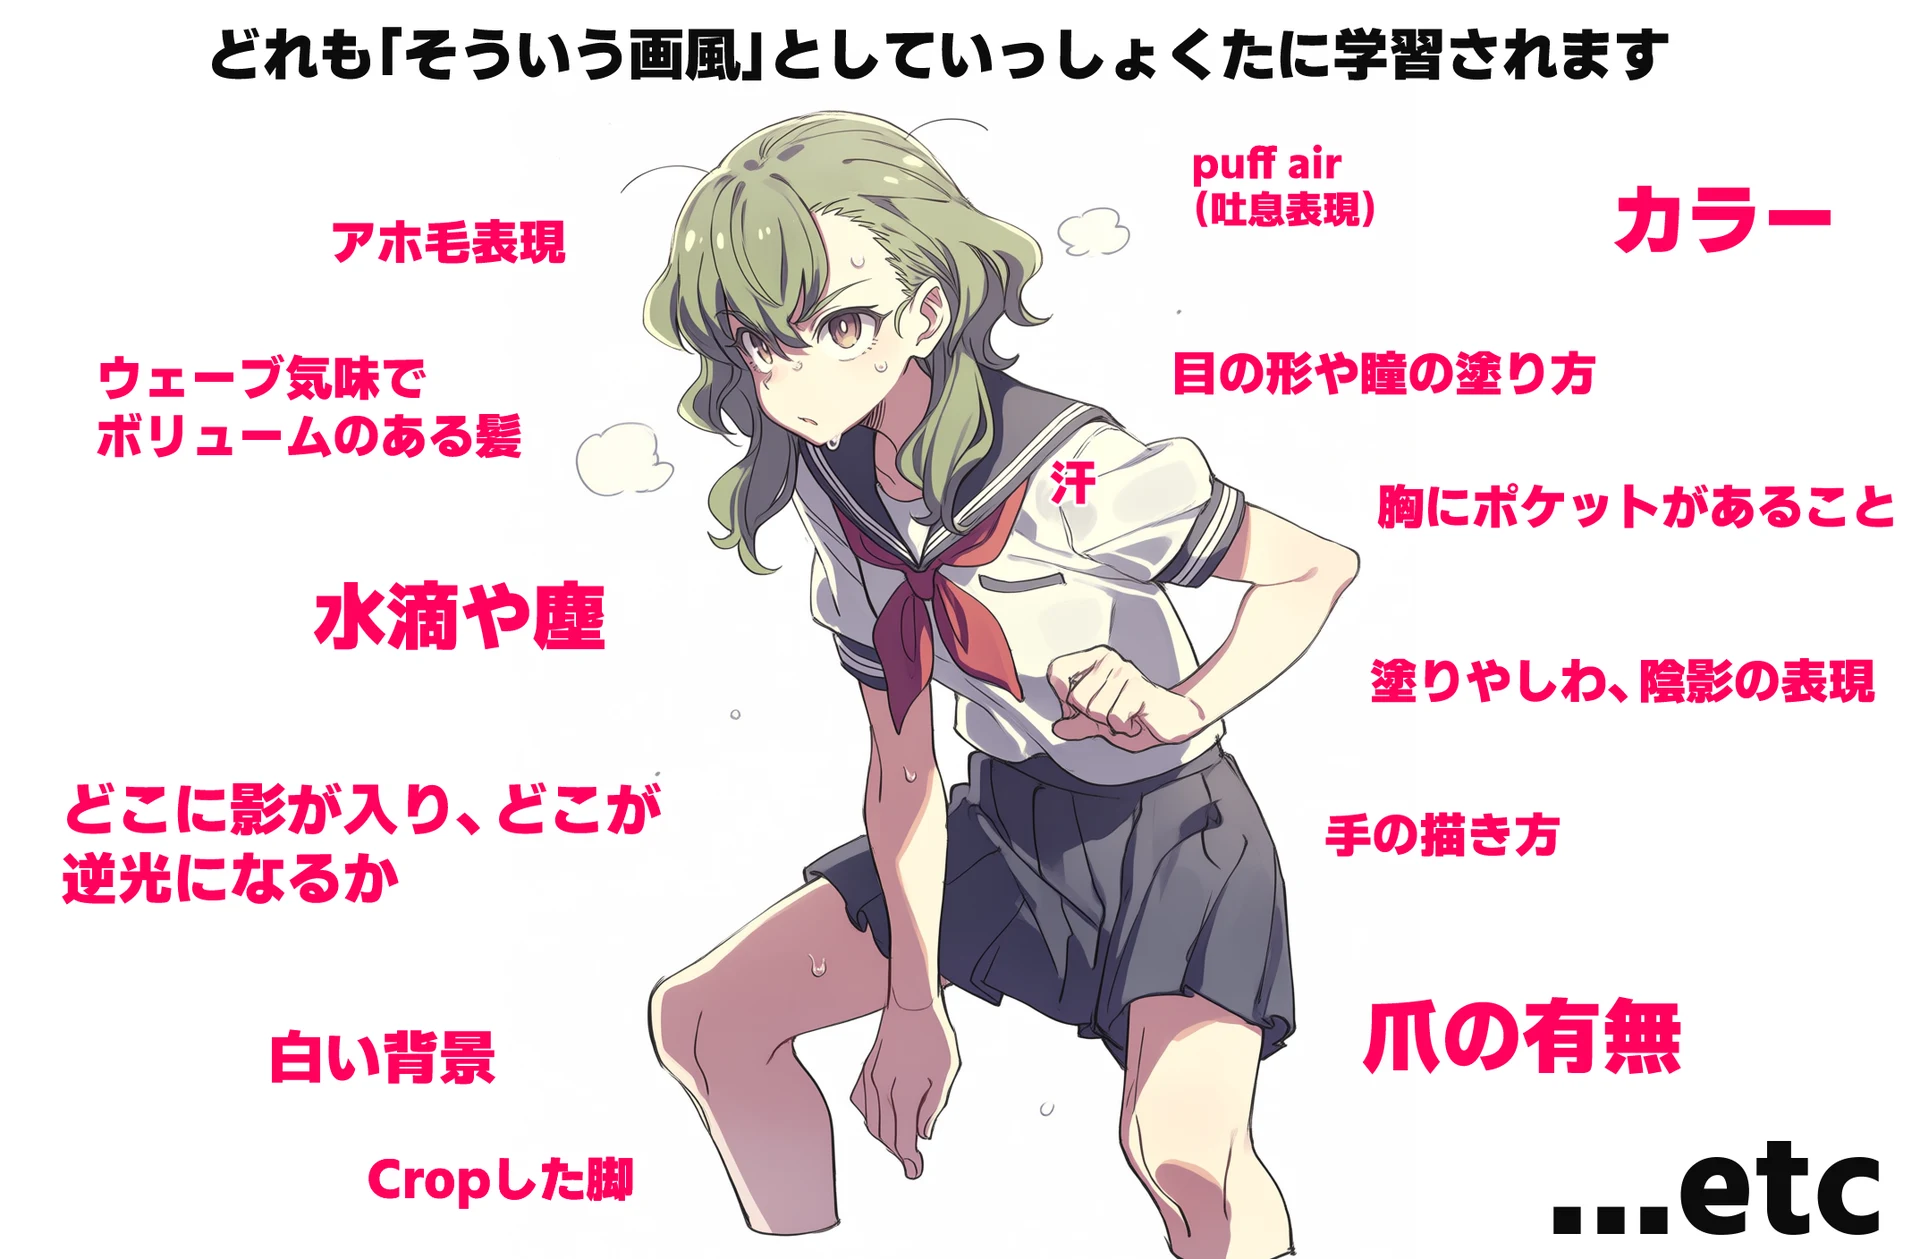
余計な概念の混入を避けるためには、必要な要素が大きくはっきりと描かれ、余計な要素をできるだけ排除したお手本画像を用意するのがコツです。汗や濡れた肌、フキダシ、空中に浮かぶ飛沫、漫符など、LoRAで再現してほしい概念と関係ない要素、特にdanbooruタグで表現しにくい要素はできるだけ避けましょう。(※今回の学習例ではそうした要素の影響を見せるために水滴が肌や空中に描かれている画像を使っていますが、本来はあまり適さない画像です)
・全身の頭身や体型を変えたい場合:全身が見える画像を使ってください。塗りを覚えさせたくない場合は白黒の画像から学習させればOK。その場合はキャプションに「monochrome」を入れましょう。
・キャラクター容姿以外の余計な要素を排除したい場合:白背景で学習させるのが効果的ですが、その場合背景をどのように描けばいいかは学習されませんし、白背景が選択されやすい傾向のLoRAになります。

②覚えさせたい概念だけが違う「比較画像」を作る
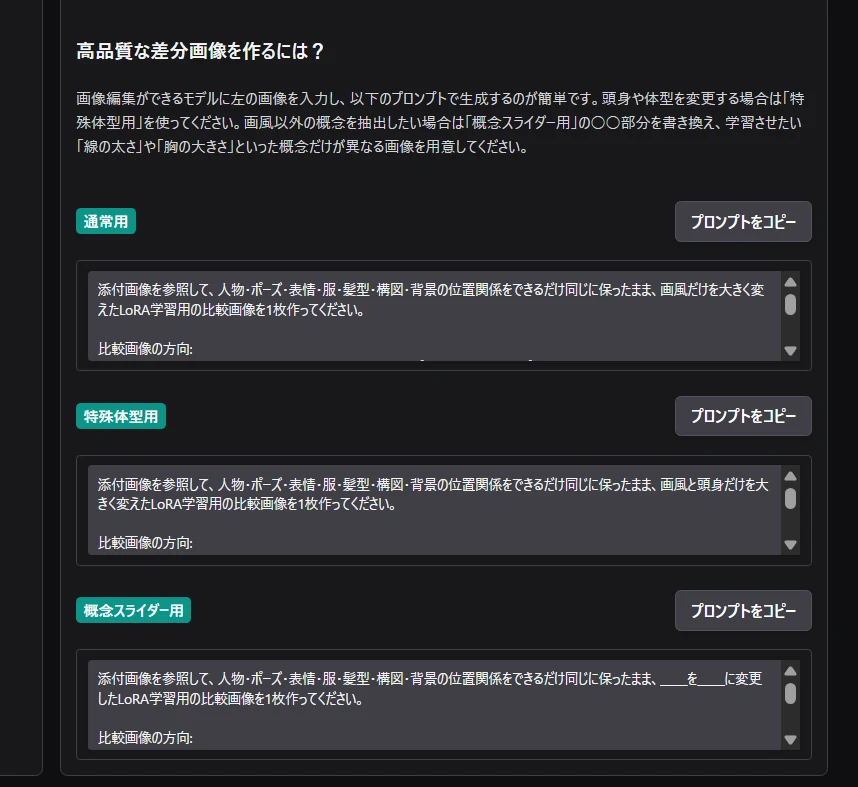
1枚目の画像を入力すると、画面右側にこのような文章が表示されます。これは、ChatGPTなどに指示して、Copitaが学習しやすい「比較画像」を入手するためのプロンプト例です。(※出力画像のAI学習利用を一切禁じているモデルも多いので、事前に必ず利用規約を確認するようにしましょう)
<比較画像とは?>
Copitaで画風LoRAを学習する場合、画面左で入力した画像と同じ人物、同じ服、同じポーズ、同じ構図で、画風だけが違う画像を「差分」として用意する必要があります。経験則としておすすめなのが、ChatGPTなどで実写調に変換した画像。違う部分が学習されるので、被写体の概念は同じでも、線画も塗りも何もかも異なる実写画像と比較すると画風を抜き取りやすいです。
Copitaは比較画像を入手するためのプロンプトを自動で提案してくれますので、さきほどの画像とプロンプトを画像編集ができるAIにコピペするだけで、このような比較画像を得られます。ただし、そのAIでLoRA学習用の画像を生成してよいかは必ず事前に規約などで確認すること!
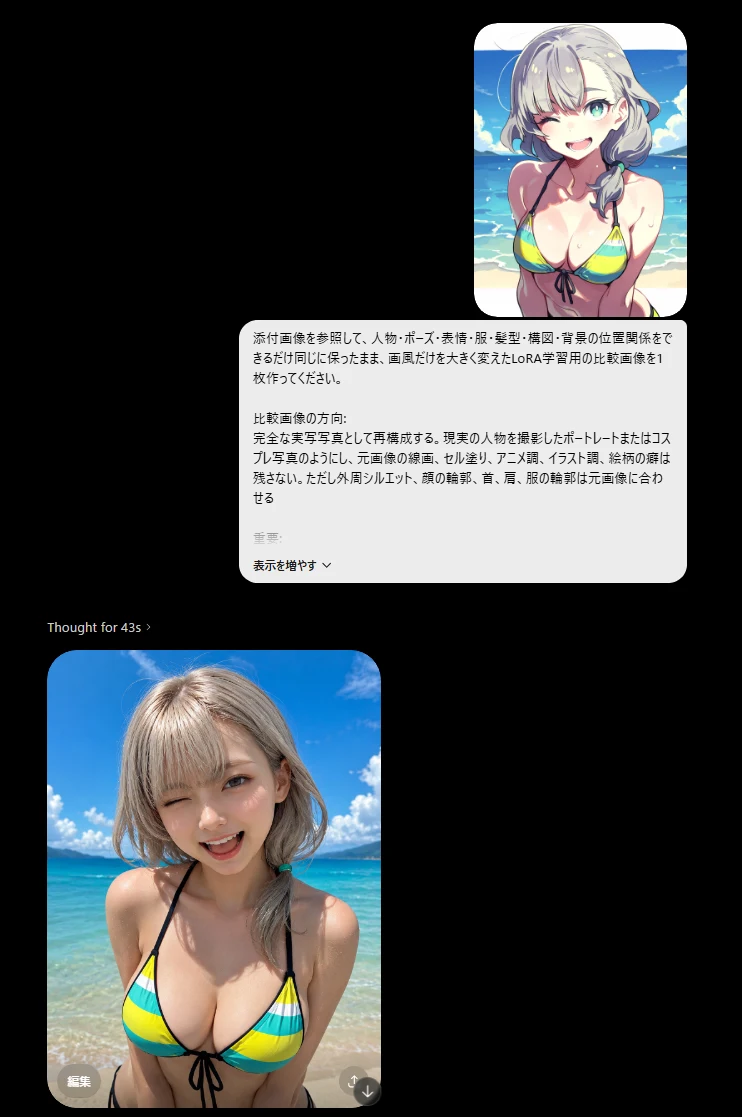
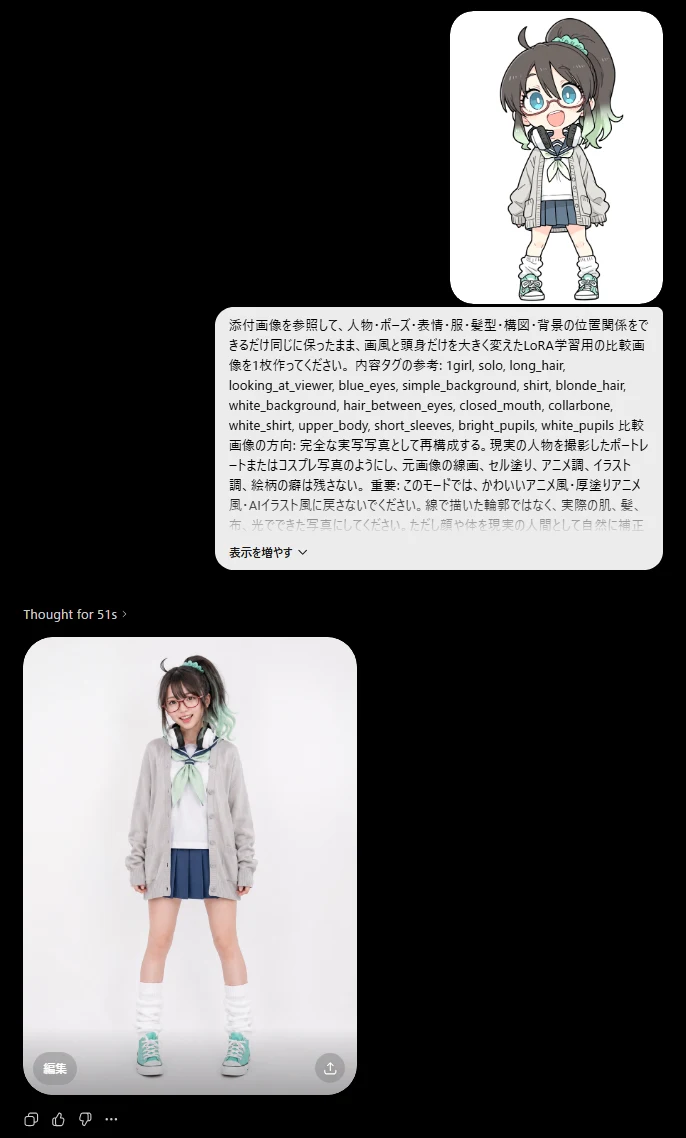
プロンプト例は「通常用」「特殊体型用」「概念スライダー用」の3種類があります。普通の画風LoRAなら通常用でOKですが、ちびキャラのように頭身や体型も含めて学習させたい場合は特殊体型用を使ってください。この2枚のように、画風だけでなく体型も大きく変化することを覚えさせる必要があります。
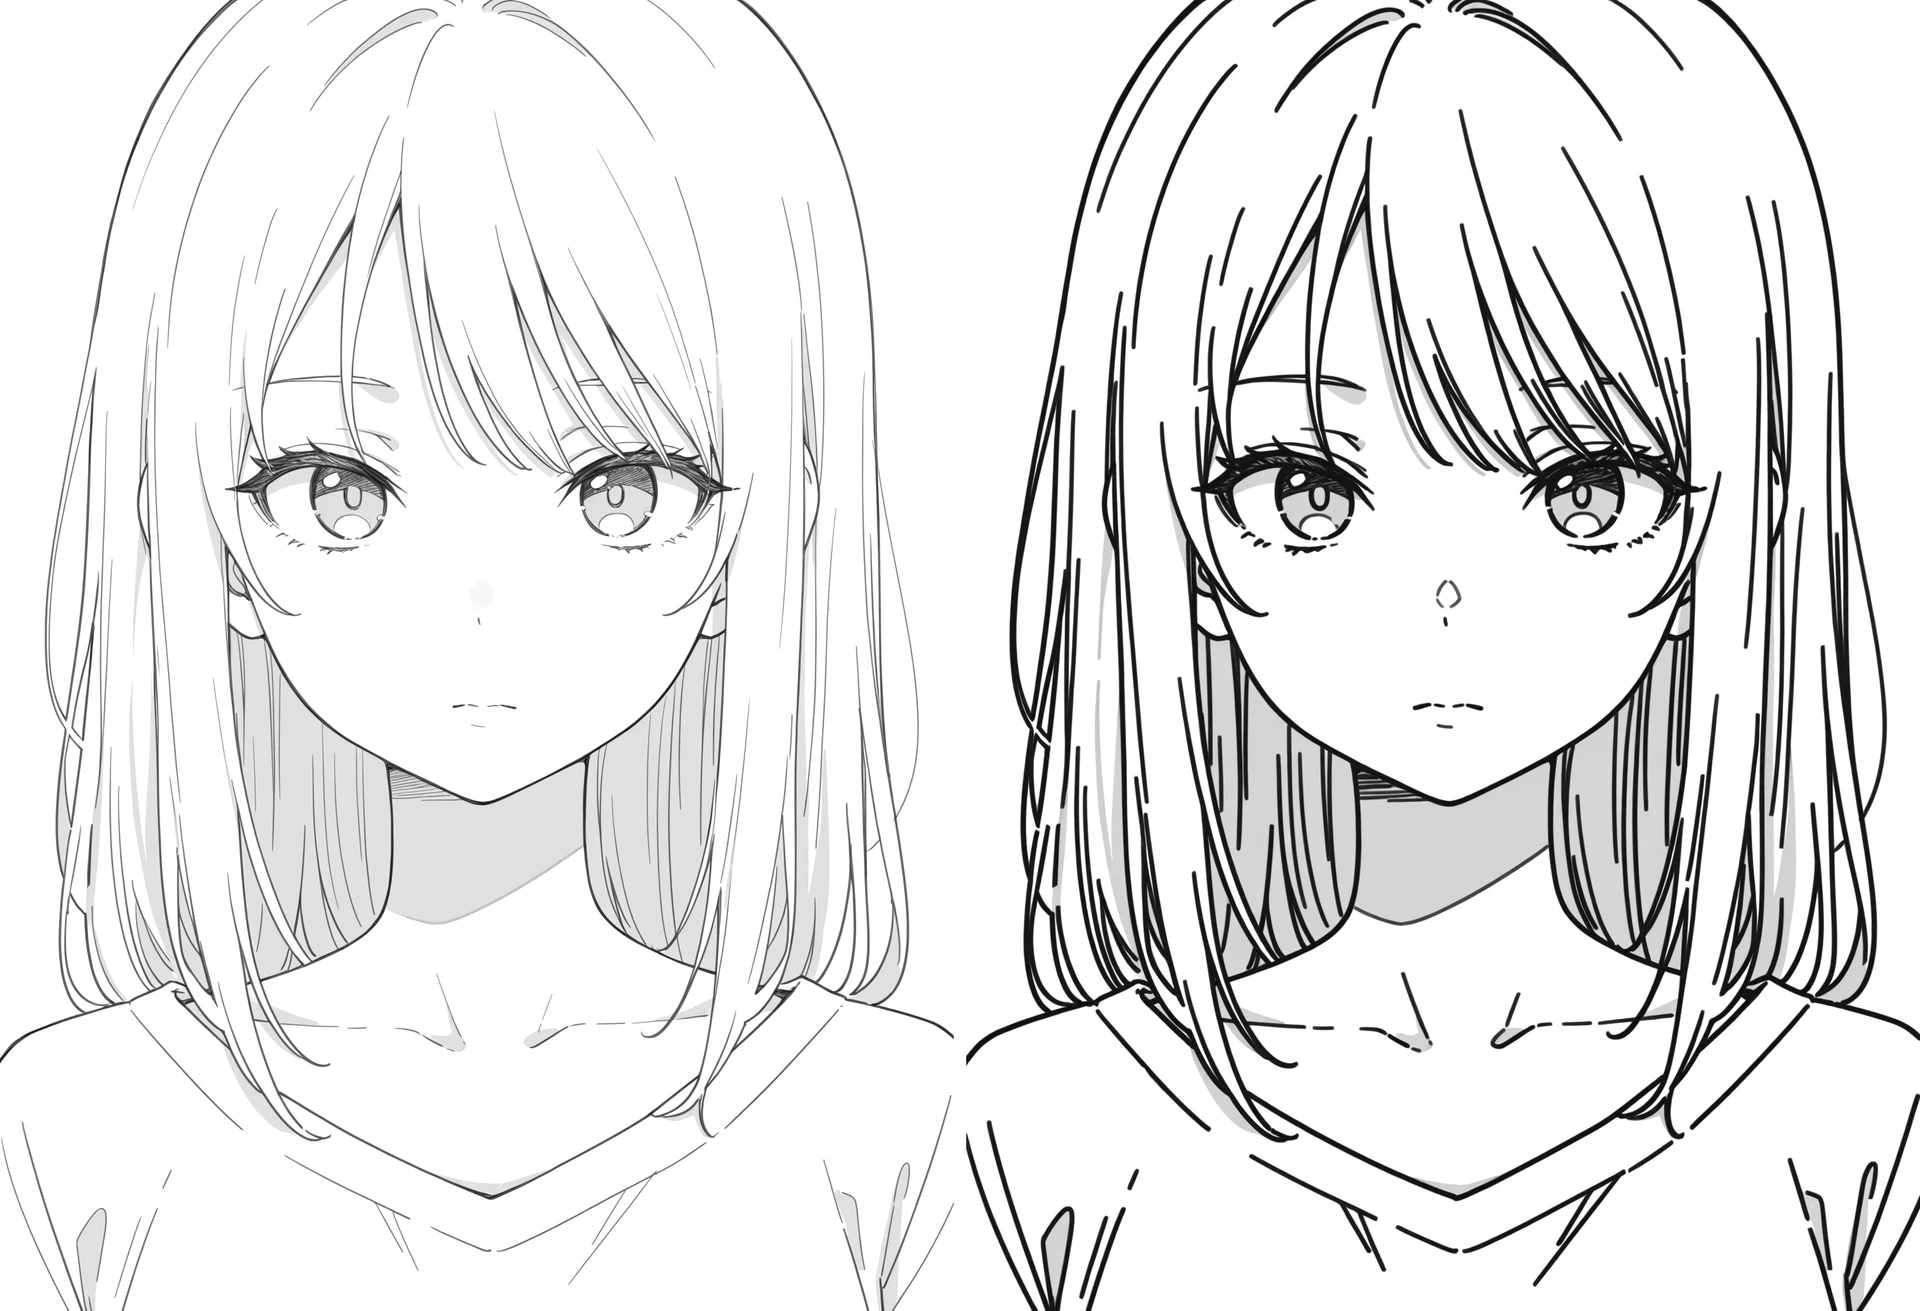
線の太さや胸の大きさなどの概念を調整できるLoRAにしたい場合は「概念スライダー用」を使います。テンプレートでは「添付画像を参照して、人物・ポーズ・表情・服・髪型・構図・背景の位置関係をできるだけ同じに保ったまま、__を__に変更したLoRA学習用の比較画像を1枚作ってください」等となっているので、「__」部分を適宜書き換えてご使用ください。
例えば、線を太くするLoRAを作るならこのようなペアを用意する必要がありますので、「線画を太く変更した…」とするわけです。
2枚のペアを見比べて、服が変わっている、顔の向きが変わっている、指などが破綻している、縦横比が大きく変わっている、余白が増えて人物が小さくなっている…といった場合は、余計な差分が混入して低品質なLoRAになる恐れがあります。この2枚の精度がLoRAの精度に直結しますので、余計な概念が映り込まないよう、適宜工夫して調整しましょう。(※ChatGPTに差分を頼む場合、「n=10」と末尾に書いて10枚生成のうち一番よくできた画像を選ぶだけでも品質が向上します)
※コピー機LoRA法におけるペアの作り方については、こちらの記事で深堀りしています。目の光を消すLoRAやR-18系調整LoRA(乳首LoRA、ぶっかけ増量LoRA)を作れるペアの作り方はこちらもご参照ください。

③比較画像を入力して「タグ付け」
次に、画像に何が描かれているかAIに説明する「タグ付け」を行います。
v1.1以降では「タグ付けする」と「より詳細にタグ付けする」の2種類があります。まずは通常の「タグ付けする」でOKです。タグが少なすぎる、服や小物、汗、背景などの要素が拾えていないと感じた場合は、「より詳細にタグ付けする」を試してください。(誤検出の可能性も高まるので、必ず目視チェックしてください)
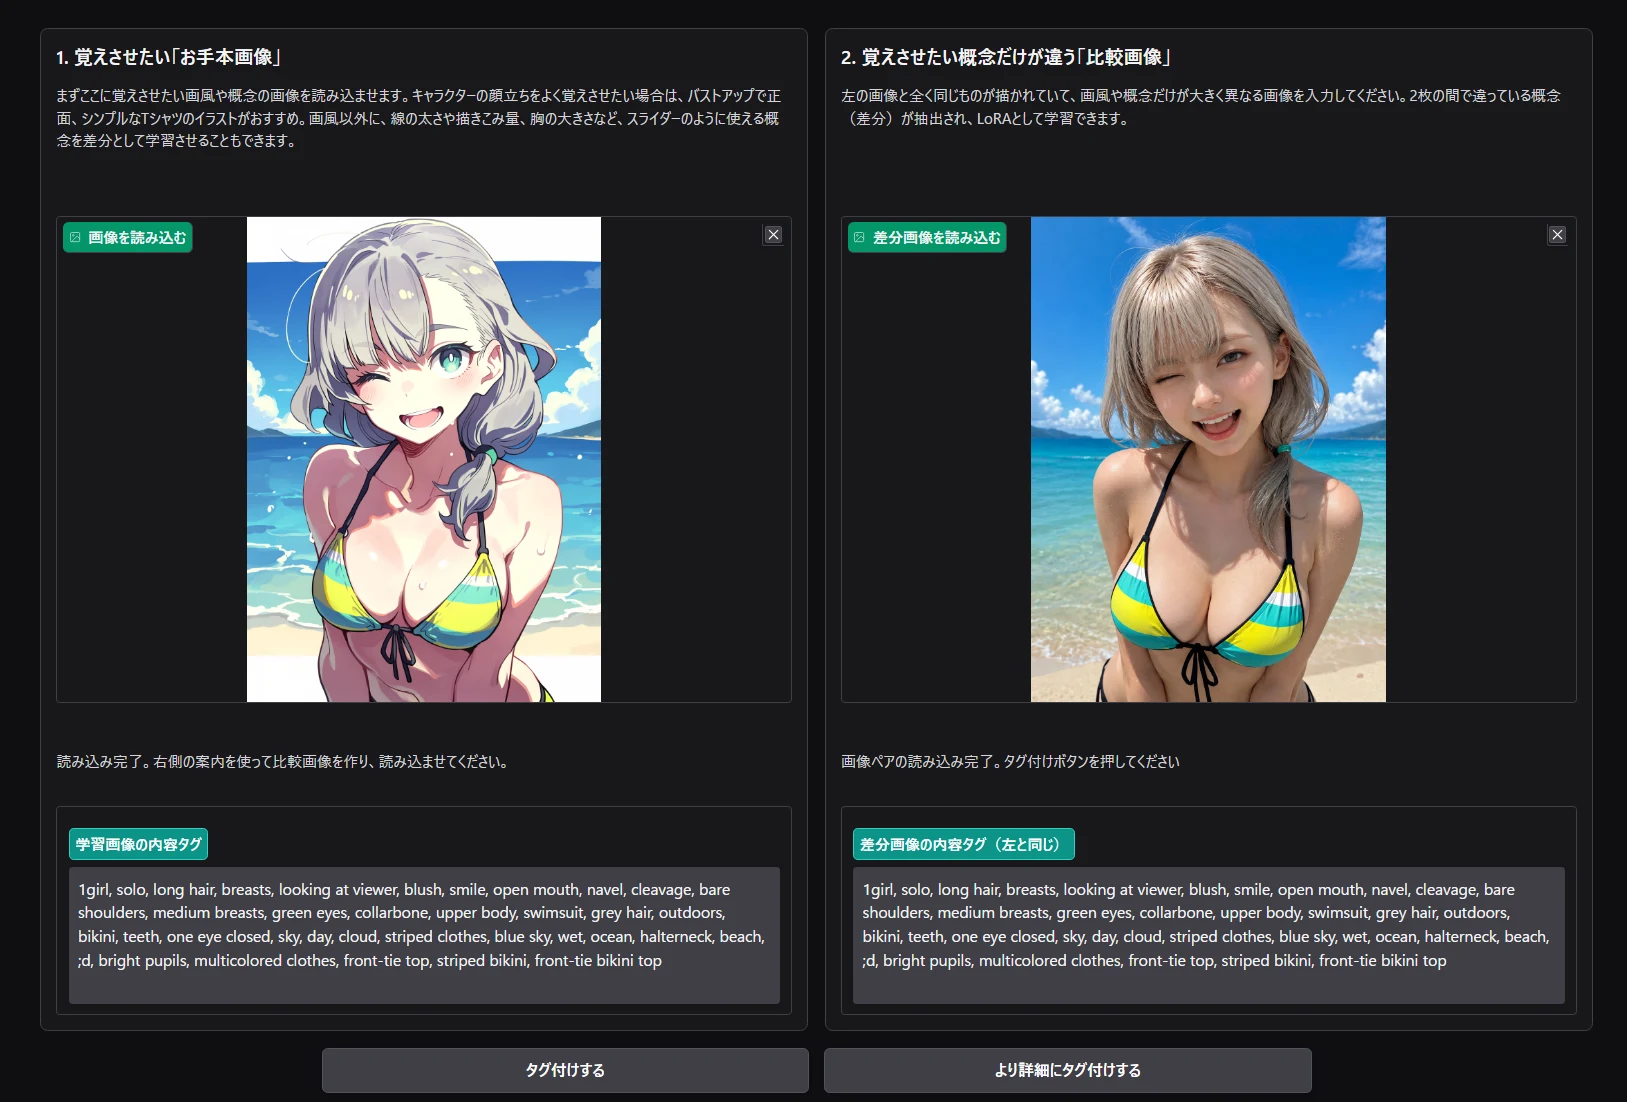
<タグ付けのポイント>
検出された内容を必ずチェックして、間違ったタグや重複タグ、画風や主観に関するタグは削除してください。以下のタグは検出されても自動で除去される設定になっています。
「作者名」「作品名」「キャラクター名」「artist_name」「watermark」「signature」「text」「bad_hands」「monochrome」(その他、被写体についてではなく描き方を示す画風タグや概念タグ)
例えば、white shirtがあればshirtは不要ですし、red bowがあればred ribbonは不要です。作家タグや「anime screenshot」、「watercolor_(medium)」といった画風に関するタグが混入した場合も、手動で削除してください。
例えば、以下の検出結果なら、除去するべきなのは「sailor uniform」「blush」「shirt」「skirt」「yellow hair」「flat color」となります。
1girl, solo, long_hair, looking_at_viewer, sailor uniform, blush, full-face_blush, simple_background, shirt, skirt,blonde hair,white shirt, blue skirt, pleated skirt, long_sleeves, white_background, closed_mouth, twintails, school_uniform, serafuku, white_shirt, yellow hair, flat color
より詳しい概念や重複概念である「serafuku」「full-face_blush」「white shirt」「blue skirt」「blonde hair」があるからですね。「blue skirt, pleated skirt」は違う概念なので両方残します。「flat color」はまさにLoRAを適用したら覚えてほしい特徴なので、これも外します。逆に、LoRAとして学習されたくない「monochrome」タグなどは、もし検出されなかったら手動で書き足さないと、画風+白黒LoRAになってしまいます。
大事なのは、2枚のキャプションを全く同じ内容にすることです。AI側から見ると
🤖「お、全く同じプロンプトで全く同じ画像が描かれているな」
🤖「ん?でもこの二つを見比べると、この概念だけが大きく違うな…」
🤖「違う概念だけをいつでも再現できるように覚えよう!」
…となり、純粋な概念をLoRAとして抽出しやすくなります。(このとき、プロンプトにない水しぶきや吐息などの要素があると、いっしょくたに学習されるわけです)

④「学習設定」を入力
ペア画像の準備とタグ付けが済んだら、学習設定に進みます。まずはこれから学習させたいベースモデルをSDXLかAnimaから選び、フォルダボタン「📁」を押して普段使うCheckpointやLoRAなどが入っている「Models」フォルダを指定します。
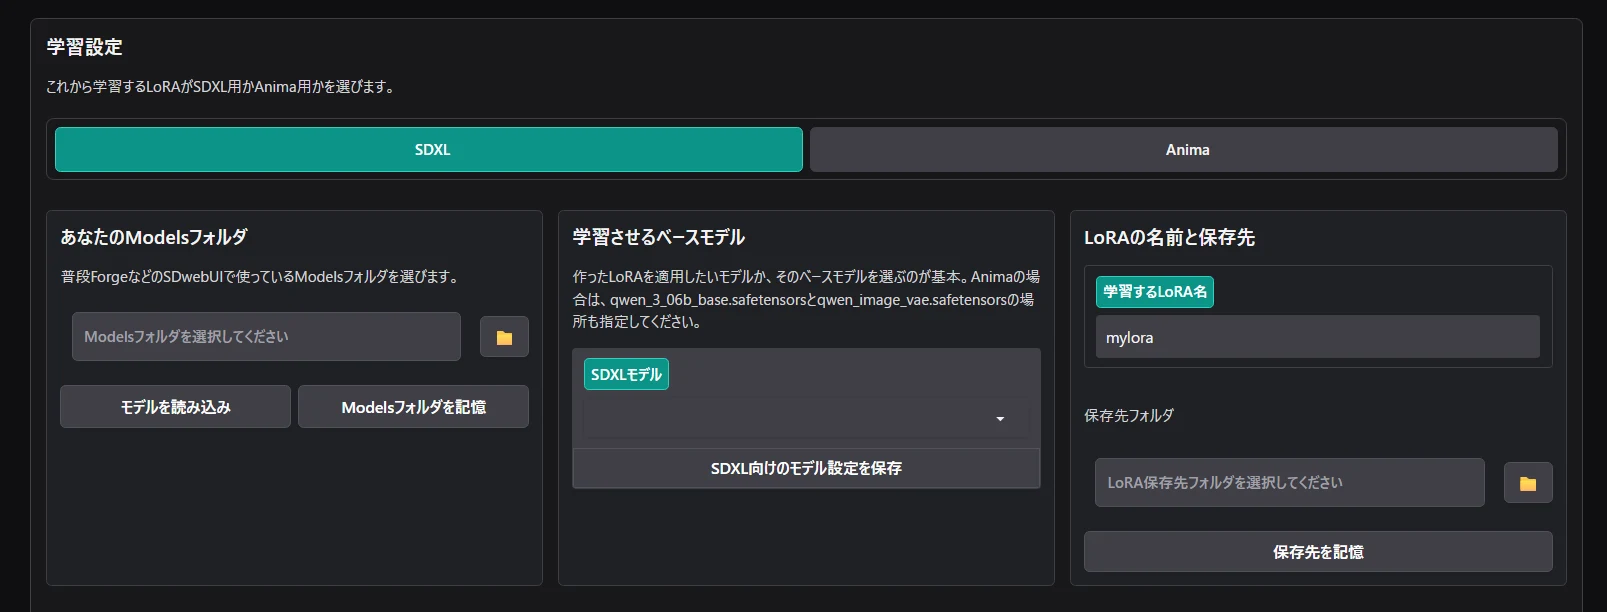
このとき「Modelsフォルダを記憶」しておくと、次回から自動で同じフォルダが選ばれるので便利です。
学習させるベースモデルは、初めての場合は「anima_baseV10.safetensors」を選ぶようにしてください。できたLoRAを使用する予定のcheckpointでも良いですが、WAI ANIMAのようにそのモデルが強く特定のアニメ塗りを覚えている場合、その画風に上塗りされてうまくLoRAの効果が確認できなくなることがありますので、マージモデルをベースにするのは2回目以降がおすすめです。
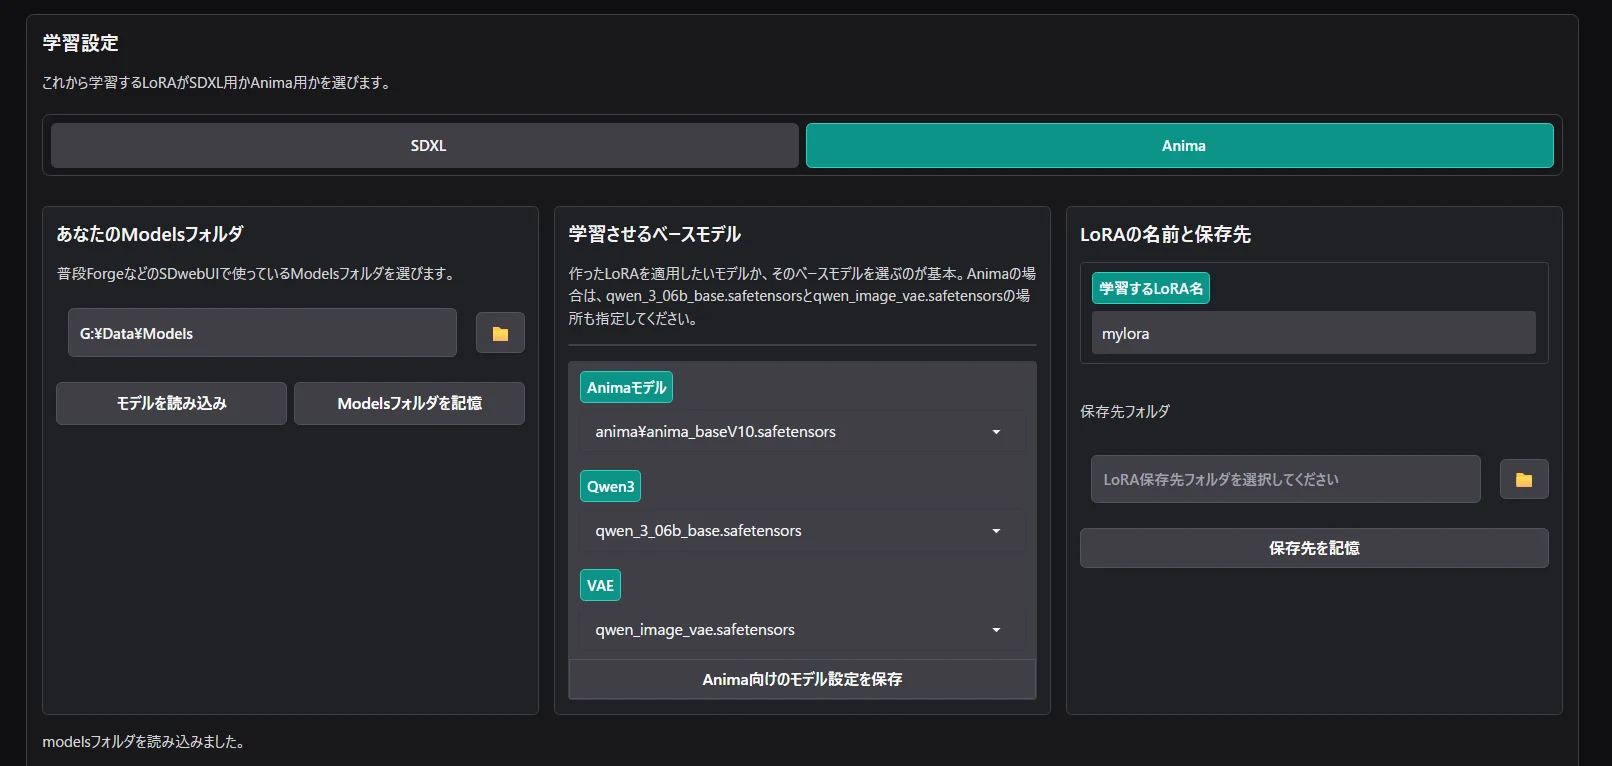
Animaで学習するときはベースモデルだけでなく、普段生成時に使っているテキストエンコーダ(qwen_3_06b_base.safetensors)とVAE(qwen_image_vae.safetensors)の場所をそれぞれ指定する必要がありますが、Modelsフォルダ内から検出できれば自動で読み込まれます。次回から同じものを自動読み込みできるよう、「Anima向けのモデル設定を保存」もできます。
テキストエンコーダなどの意味が分からない方は、「Anima&ForgeNeo超入門」特集の該当部分をご参照ください。
次に、これから学習するLoRAの名前を付け、完成した際に保存されるフォルダも設定しておきます。StabilityMatrixなどのModelsフォルダを設定した場合、自動でModels/LoRAフォルダが読み込まれているはずです。
保存先に同じ名前のLoRAが既にある場合、警告が出ます。末尾に「v1」などと番号を振っておくとよいでしょう。
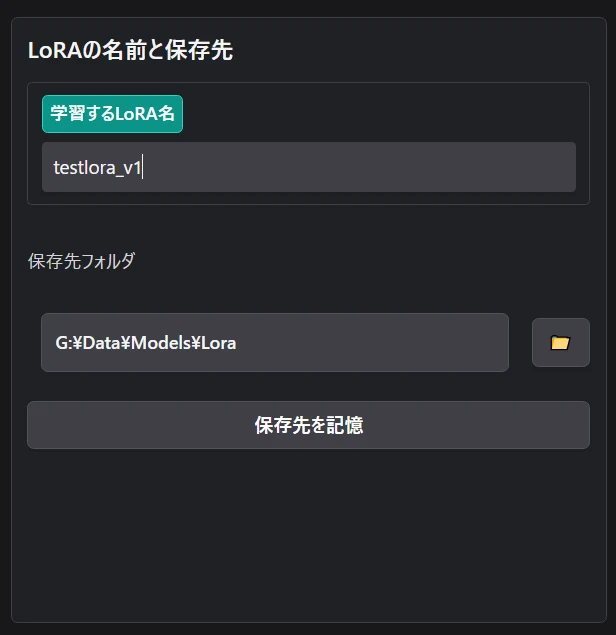
「mylora_v12」とかになってくると、どんな画像でどのモデル向けに学習させたLoRAか思い出せなくなるので、LoRA名は何の画像ペアから学習させたか、SDXL向けかAnima向けか思い出せる名前にしておくと便利です。

⑤学習プリセットを選択
最後に、こちらの3種類のプリセットからどのような設定で学習するかを選んでください。Anima用とSDXL用でそれぞれのセットの設定内容は異なりますが、最初は「通常学習セット」でOKです。
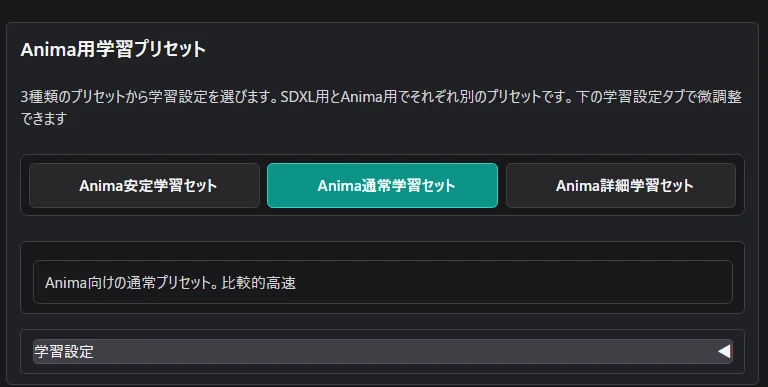
通常学習セットではグラボへの負担が重すぎる、学習に時間が掛かりすぎると感じる場合は、完走最優先の「安定学習セット」、通常でのセットでは顔立ちや塗りがあまり似ないと感じたら「詳細学習セット」を試してください。まつ毛や爪の細かなデザインまで覚えたい画風LoRAの場合、詳細学習セットの利用を推奨します。
Anima向けLoRAの学習時間は、SDXL向けより重いです。RTX4080環境でAnima向けLoRAの学習に掛かる時間は、だいたい通常学習セットで30~40分、詳細学習セットで45分~1時間といったところ。一方、RTX3060環境で試したところ、安定学習セットで40~45分、通常学習セットでは2時間前後掛かりました。学習時間が長過ぎると感じる場合はステップ数を減らすこともできますが、LoRAの精度に直結しますので、それぞれの環境に合った設定を探ってみてください。
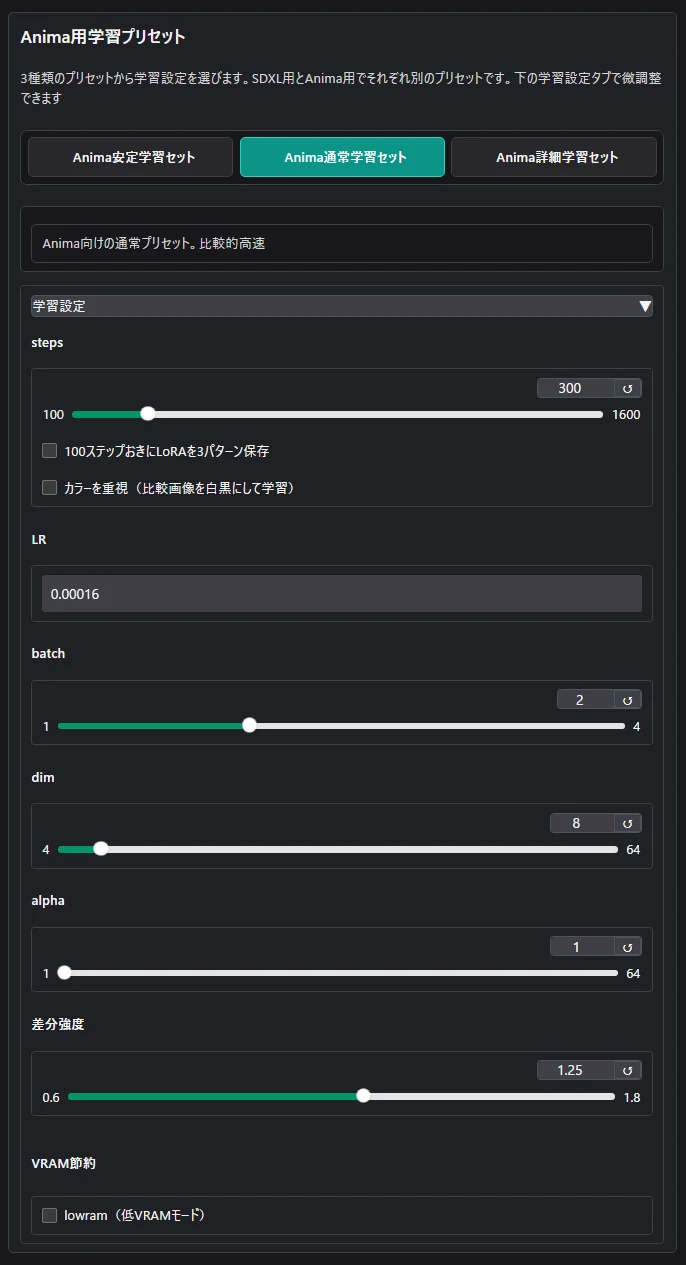
「学習設定」タブを開くと、各プリセットでどんな設定が選ばれるか確認し、細かく変更することができます。(各パラメータの意味は後で見ていきます)
⑥「学習開始」
準備ができたら、学習開始ボタンを押します。StabilityMatrixやSteamなど、VRAMを圧迫するプログラムはあらかじめ終了しておきましょう。
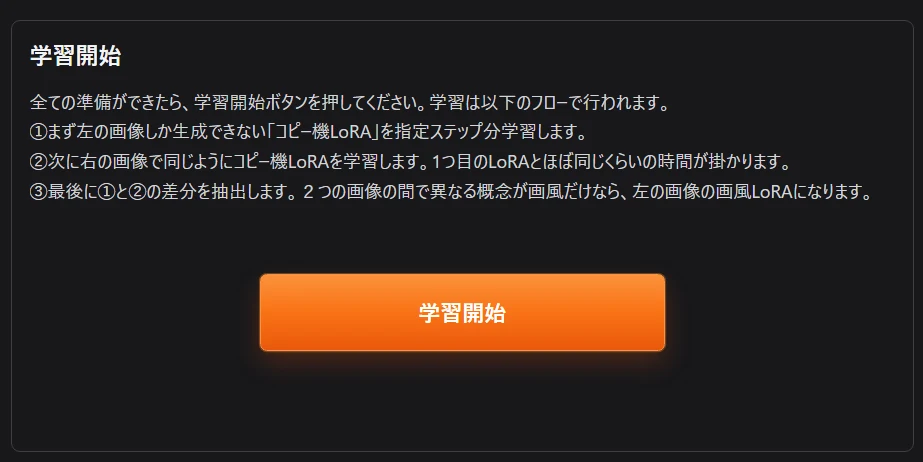
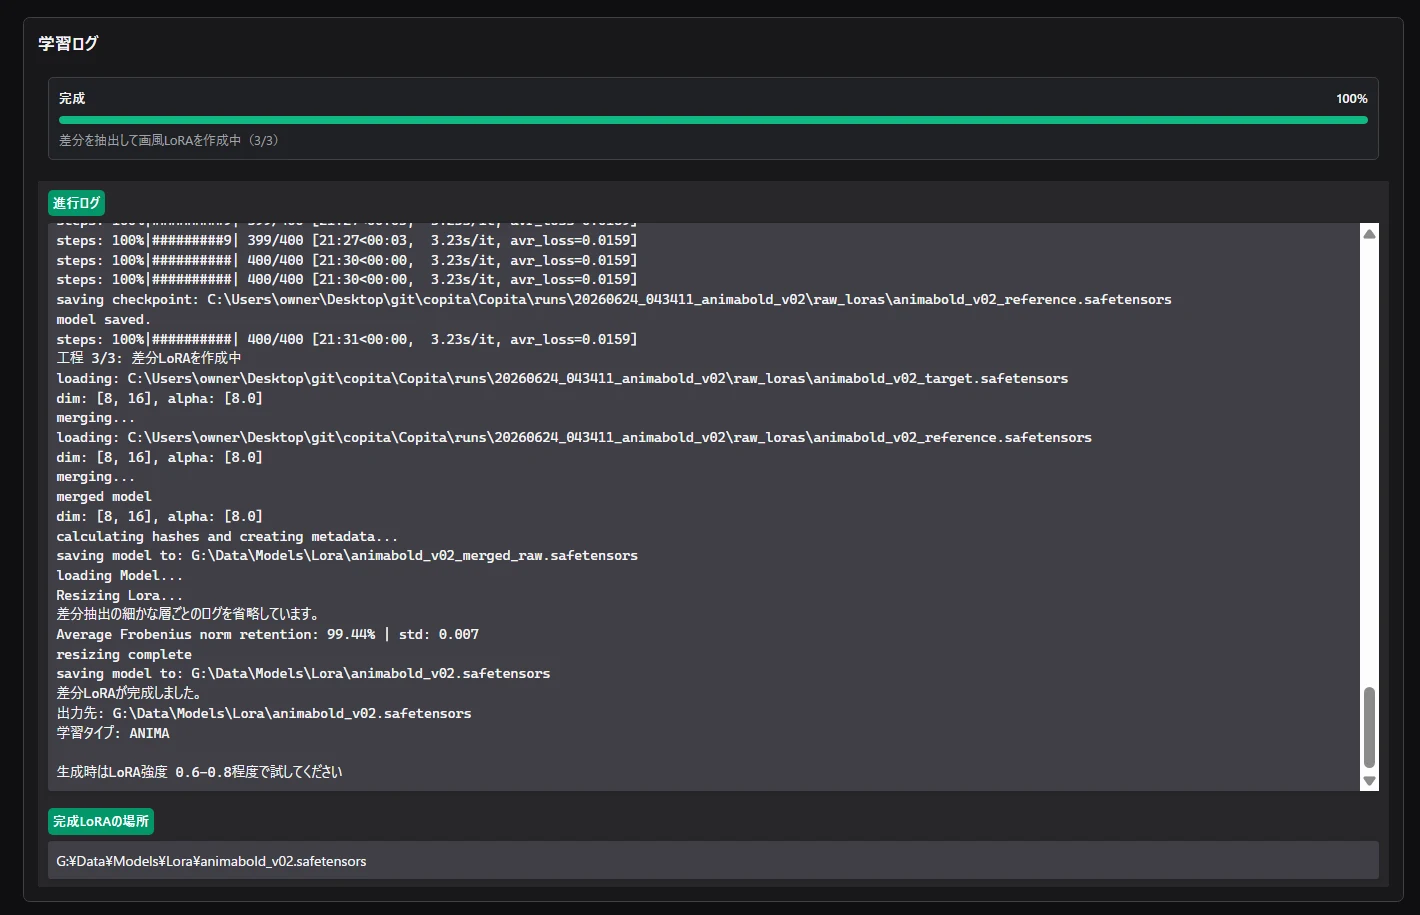
学習フローは①左画像のコピー機LoRA作成、②右画像のコピー機LoRA作成、③差分抽出の順に進みます。1枚だけの学習に見えても、実際には2回分のLoRA学習を行うため、それなりに時間が掛かります。(stepsが多いほど1本当たりに掛かる時間は長くなり、batchを増やして同時学習すれば短縮できます)
画面下部の「学習ログ」で進み具合をチェックでき、いつでも「学習停止」ボタンで中止してやり直すことができます。完成したLoRAは、自動で指定したLoRA保存先に入ります。(バックアップとしてCopita\outputフォルダにもコピーされます)
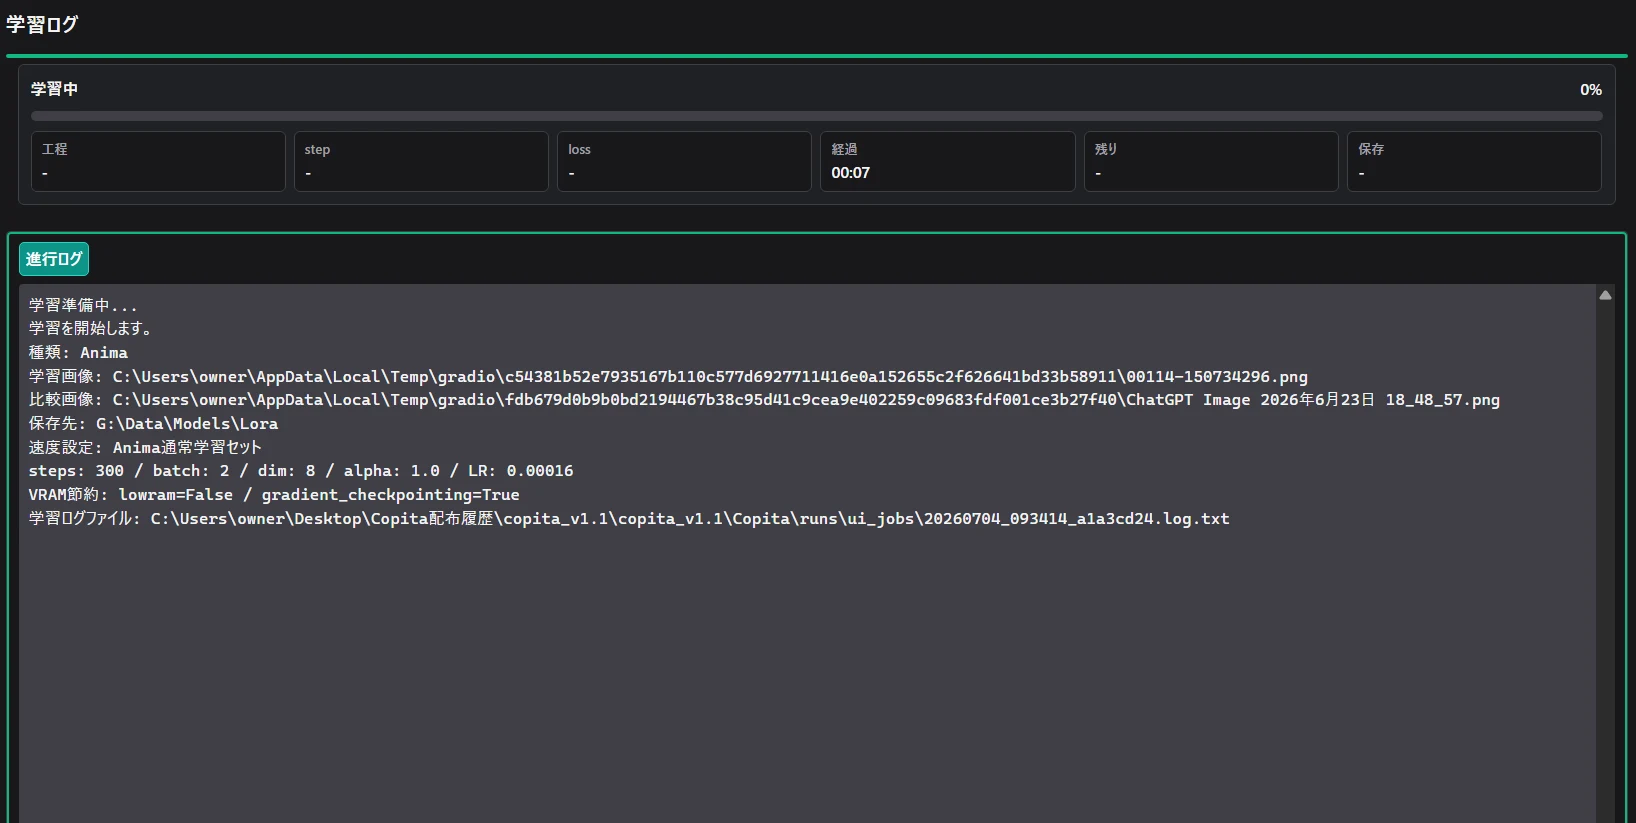
学習に異常に時間が掛かる場合、GPUメモリからあふれている恐れがあります。タスクマネージャーを開いて、VRAM容量が足りていない場合、いったん学習を停止。VRAMを圧迫しているプログラムがあれば終了し、バッチ数やdimを下げてやり直してみてください。
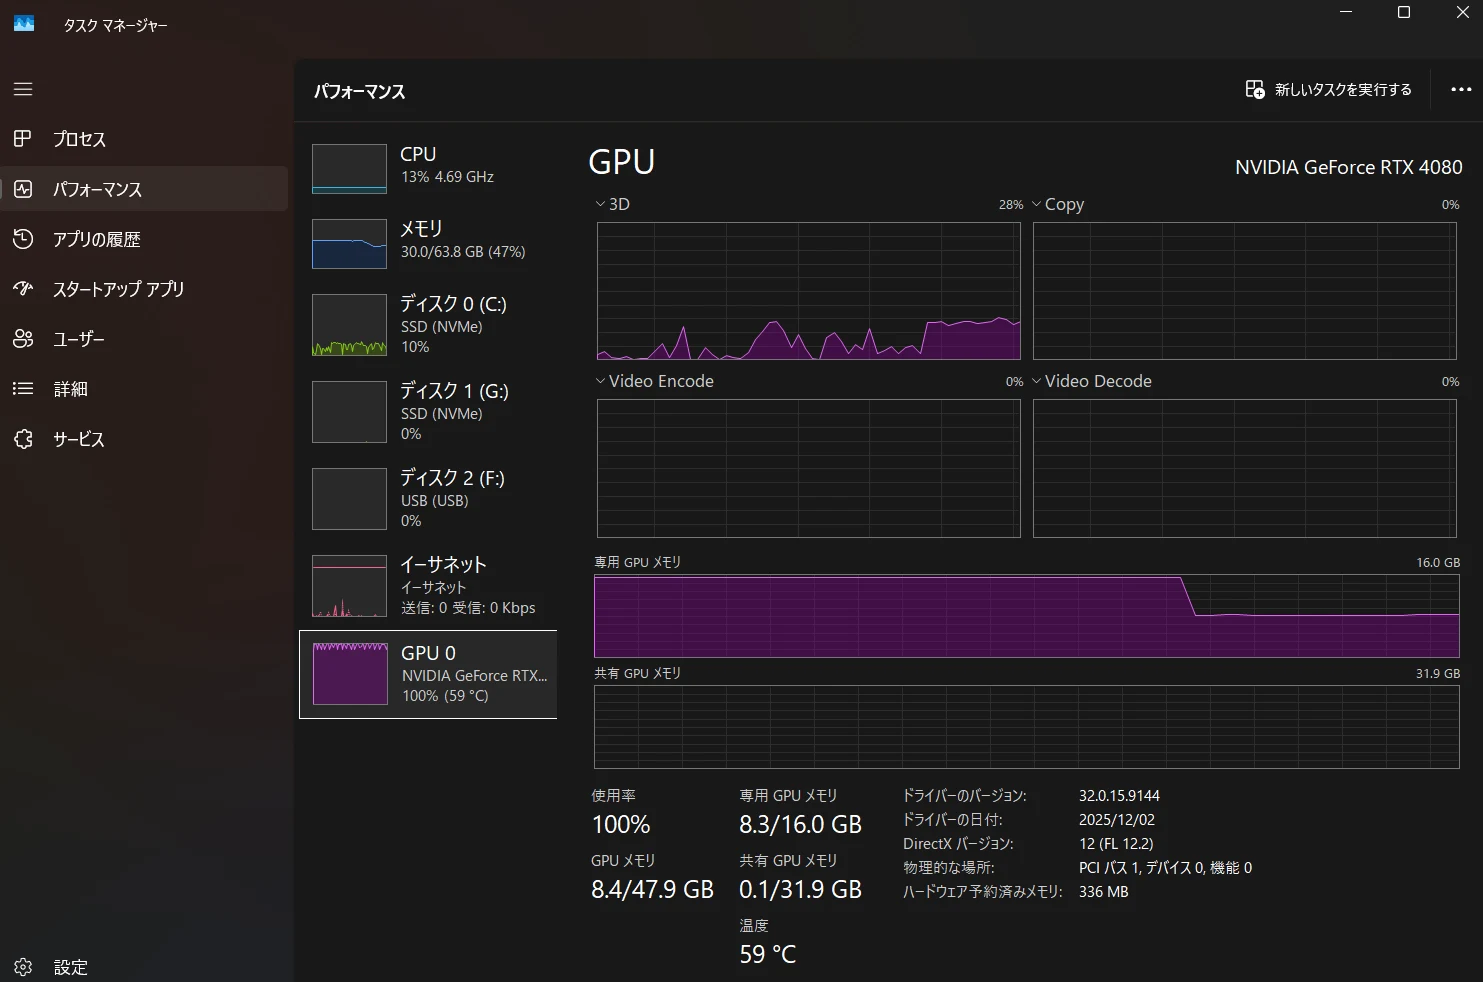
▲グラボのVRAM容量がいっぱいだったのでStabilityMatrixを終了して容量確保
学習が正常に完了すると、緑色のバーが100%になり、完成LoRAが保存された場所が表示されます。あとはForgeNeoなどで出来栄えを試すだけ。お疲れさまでした!
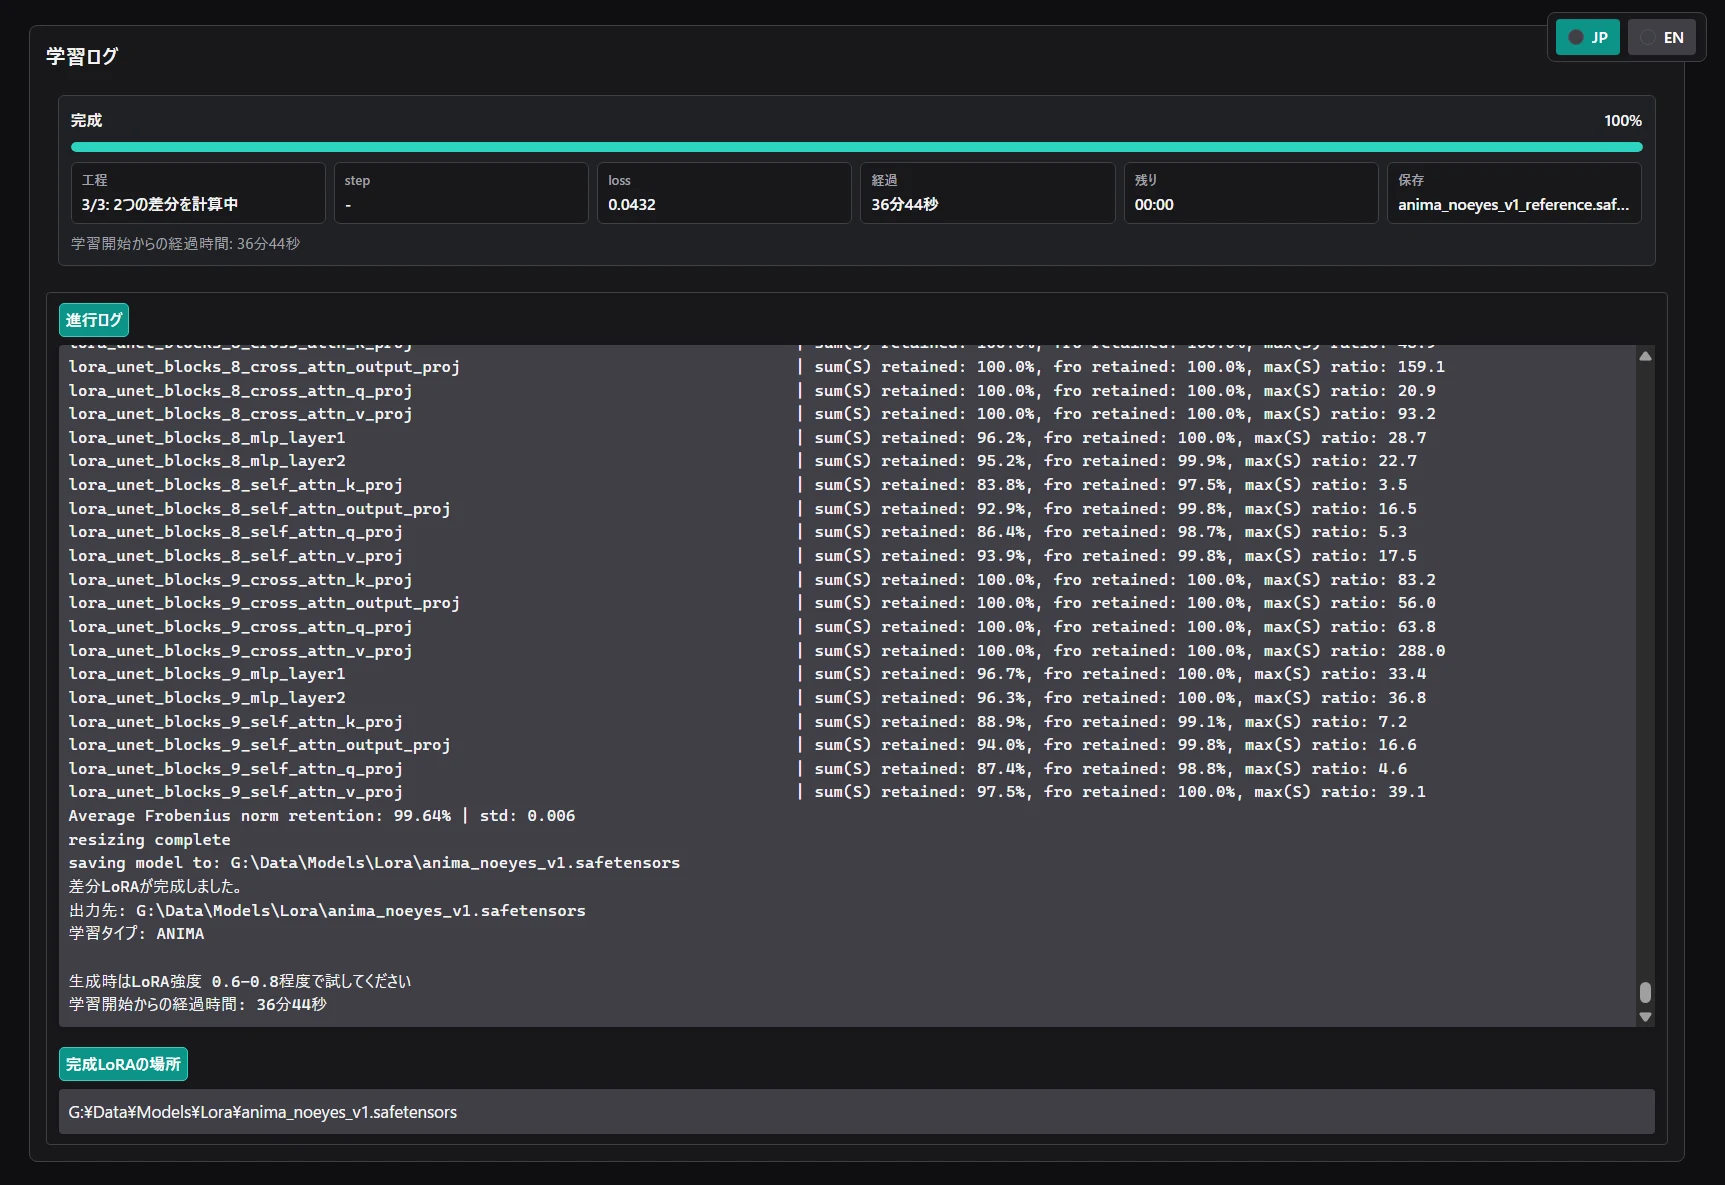
⑦学習履歴を確認する(New!)
v1.1から「学習履歴」タブが追加されました。学習が終了すると、お手本画像、比較画像、LoRA名、学習設定、完走/停止の状態が自動で記録されます。
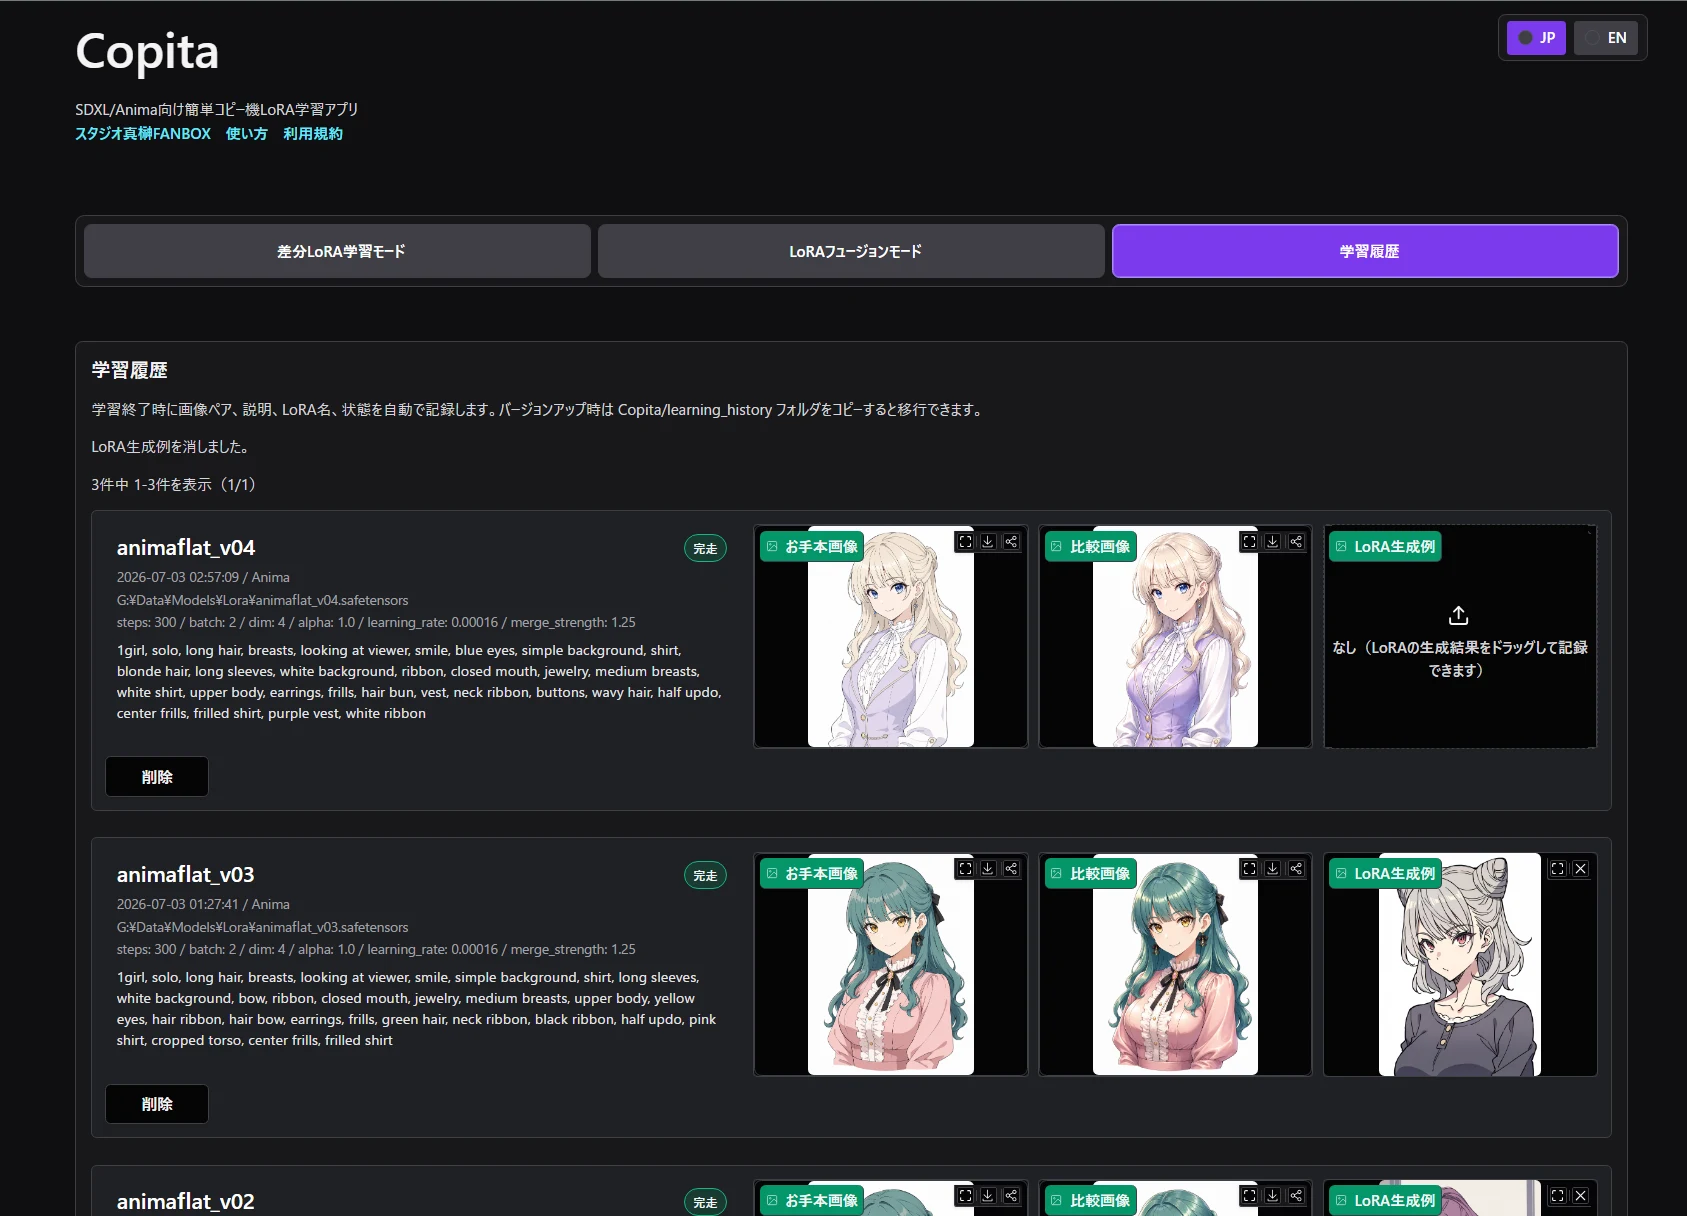
「LoRA生成例」の欄はデフォルトでは空になっていますが、どういうLoRAになったのかユーザーが画像をドラッグしてメモしておける機能です。作ったLoRAが増えてくると、どの画像ペアから作ったものか分からなくなりがちなので、気に入った生成結果を履歴にドラッグしてメモしておくと整理しやすくなります。
今後バージョンアップするとまた履歴が空欄になりますが、古いバージョンのフォルダから「Copita/learning_history」フォルダを新しいCopitaにコピーすれば履歴を引き継げます。

できた画風LoRAで生成テスト
<RTX4080&詳細学習モード>
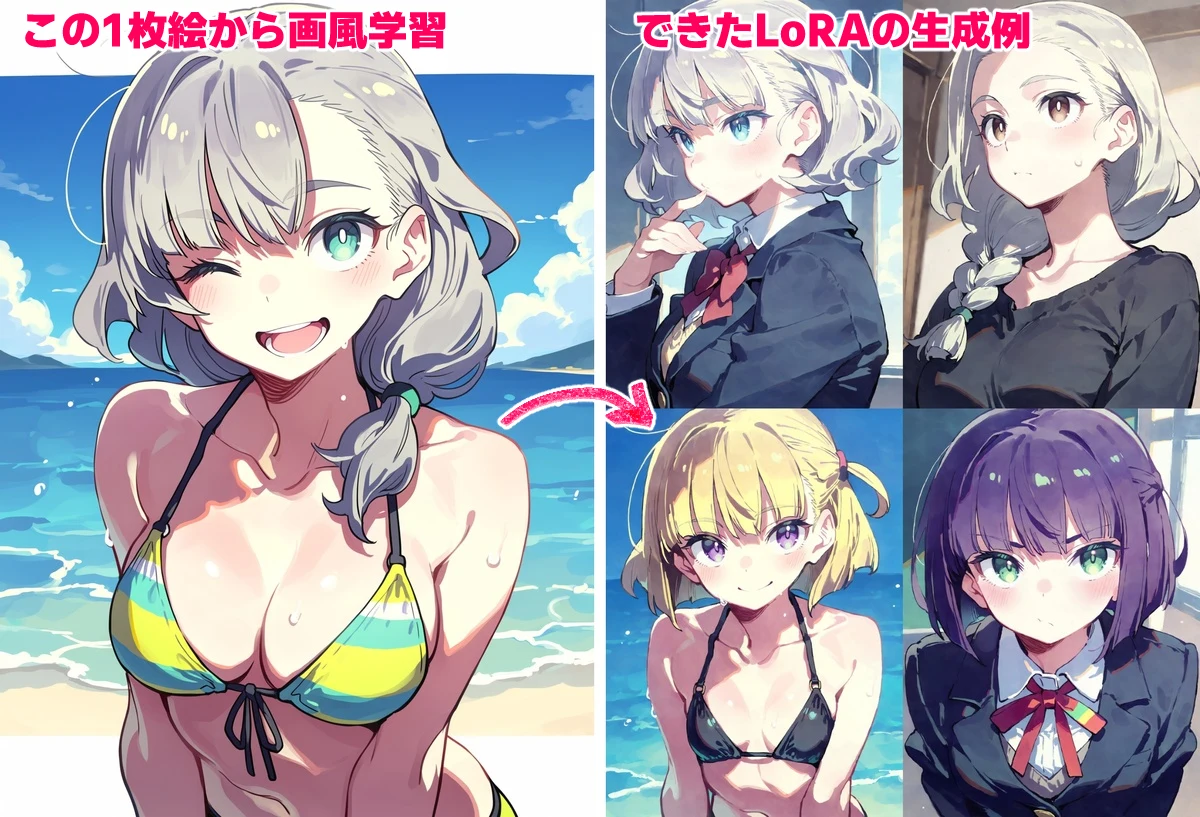
今回はこちらのペアを使い、RTX4080(VRAM16GB)環境&「詳細学習」モードで画風LoRAを作ってみましたので、さっそくAnimaに適用してテスト生成してみましょう。
Animaのベースモデルである「anima_baseV10.safetensors」をそのまま学習ベースにしたので、基本的にどの派生Animaモデルでも似た効果が得られる画風LoRAになっているはずです。(もちろん、WAI ANIMAに適用するとWAI ANIMAの「マスピ顔」「マスピ塗り」に寄るのは避けられません。WAIにこのLoRAを適用するというのは、むしろそうした画風の混ざりを期待するときいうことになります)
こちらがXYZ Plotでの比較図。上のほうがLoRAの強度が強く、下に行くほど弱まります。(ひまわり畑で麦わら帽子の女の子が振り返っているという自然言語プロンプトです)
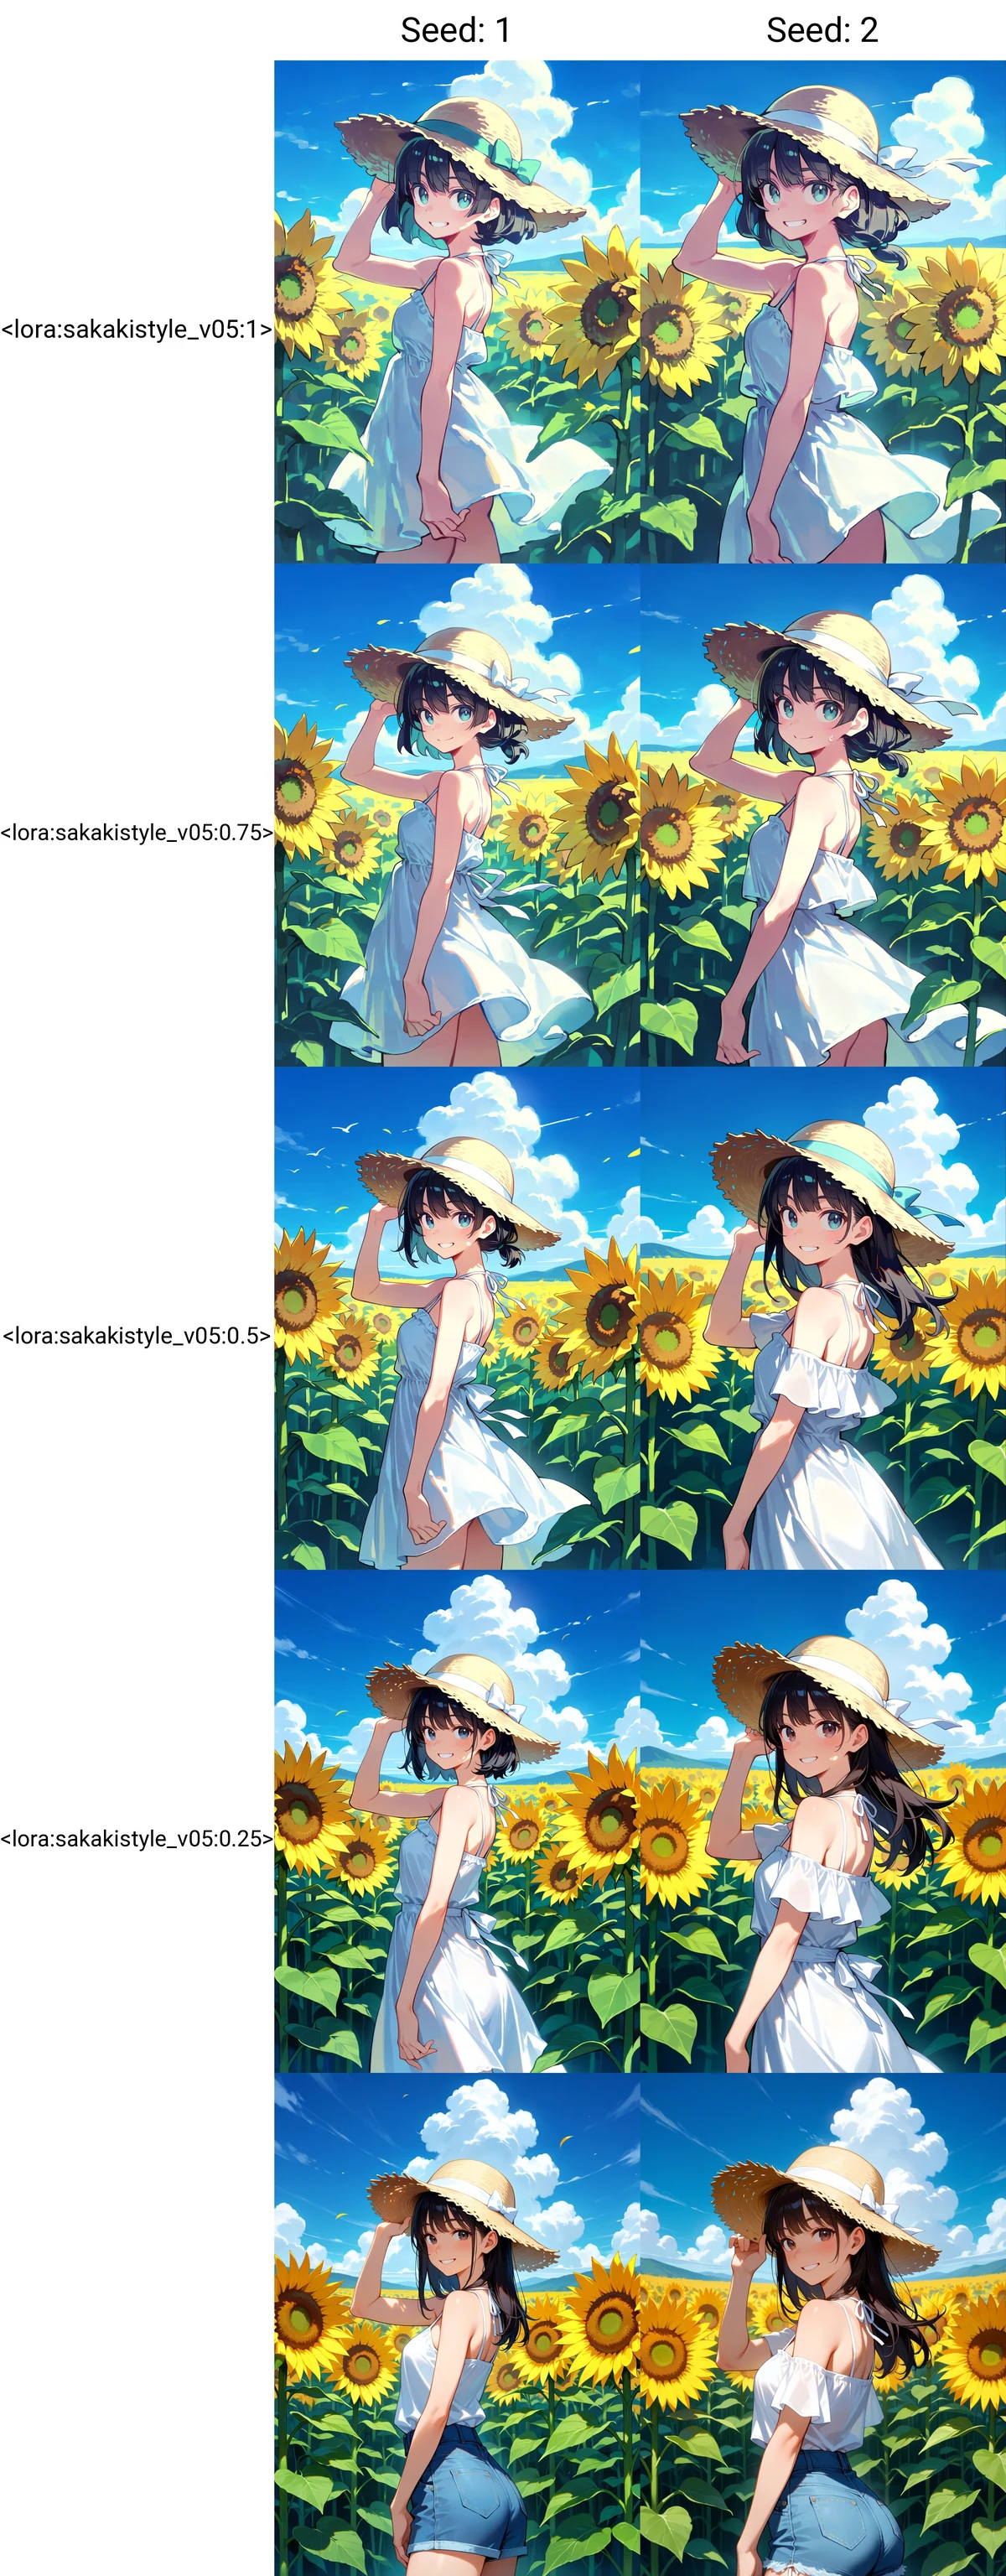
一番下がLoRA無適用の状態です。基本的に構図はそのままに、強度0.6~0.7あたりから入力画像の画風がよく出るLoRAにできたのではないかと思います。
LoRA強度「0.8」で、ランダムなプロンプトで生成するとこのような感じ。絵画っぽい塗りや淡いパステル調、縦長の瞳やハイライトが似ていますね。しかし、やたら汗というか、水滴が目立つのが気になります。
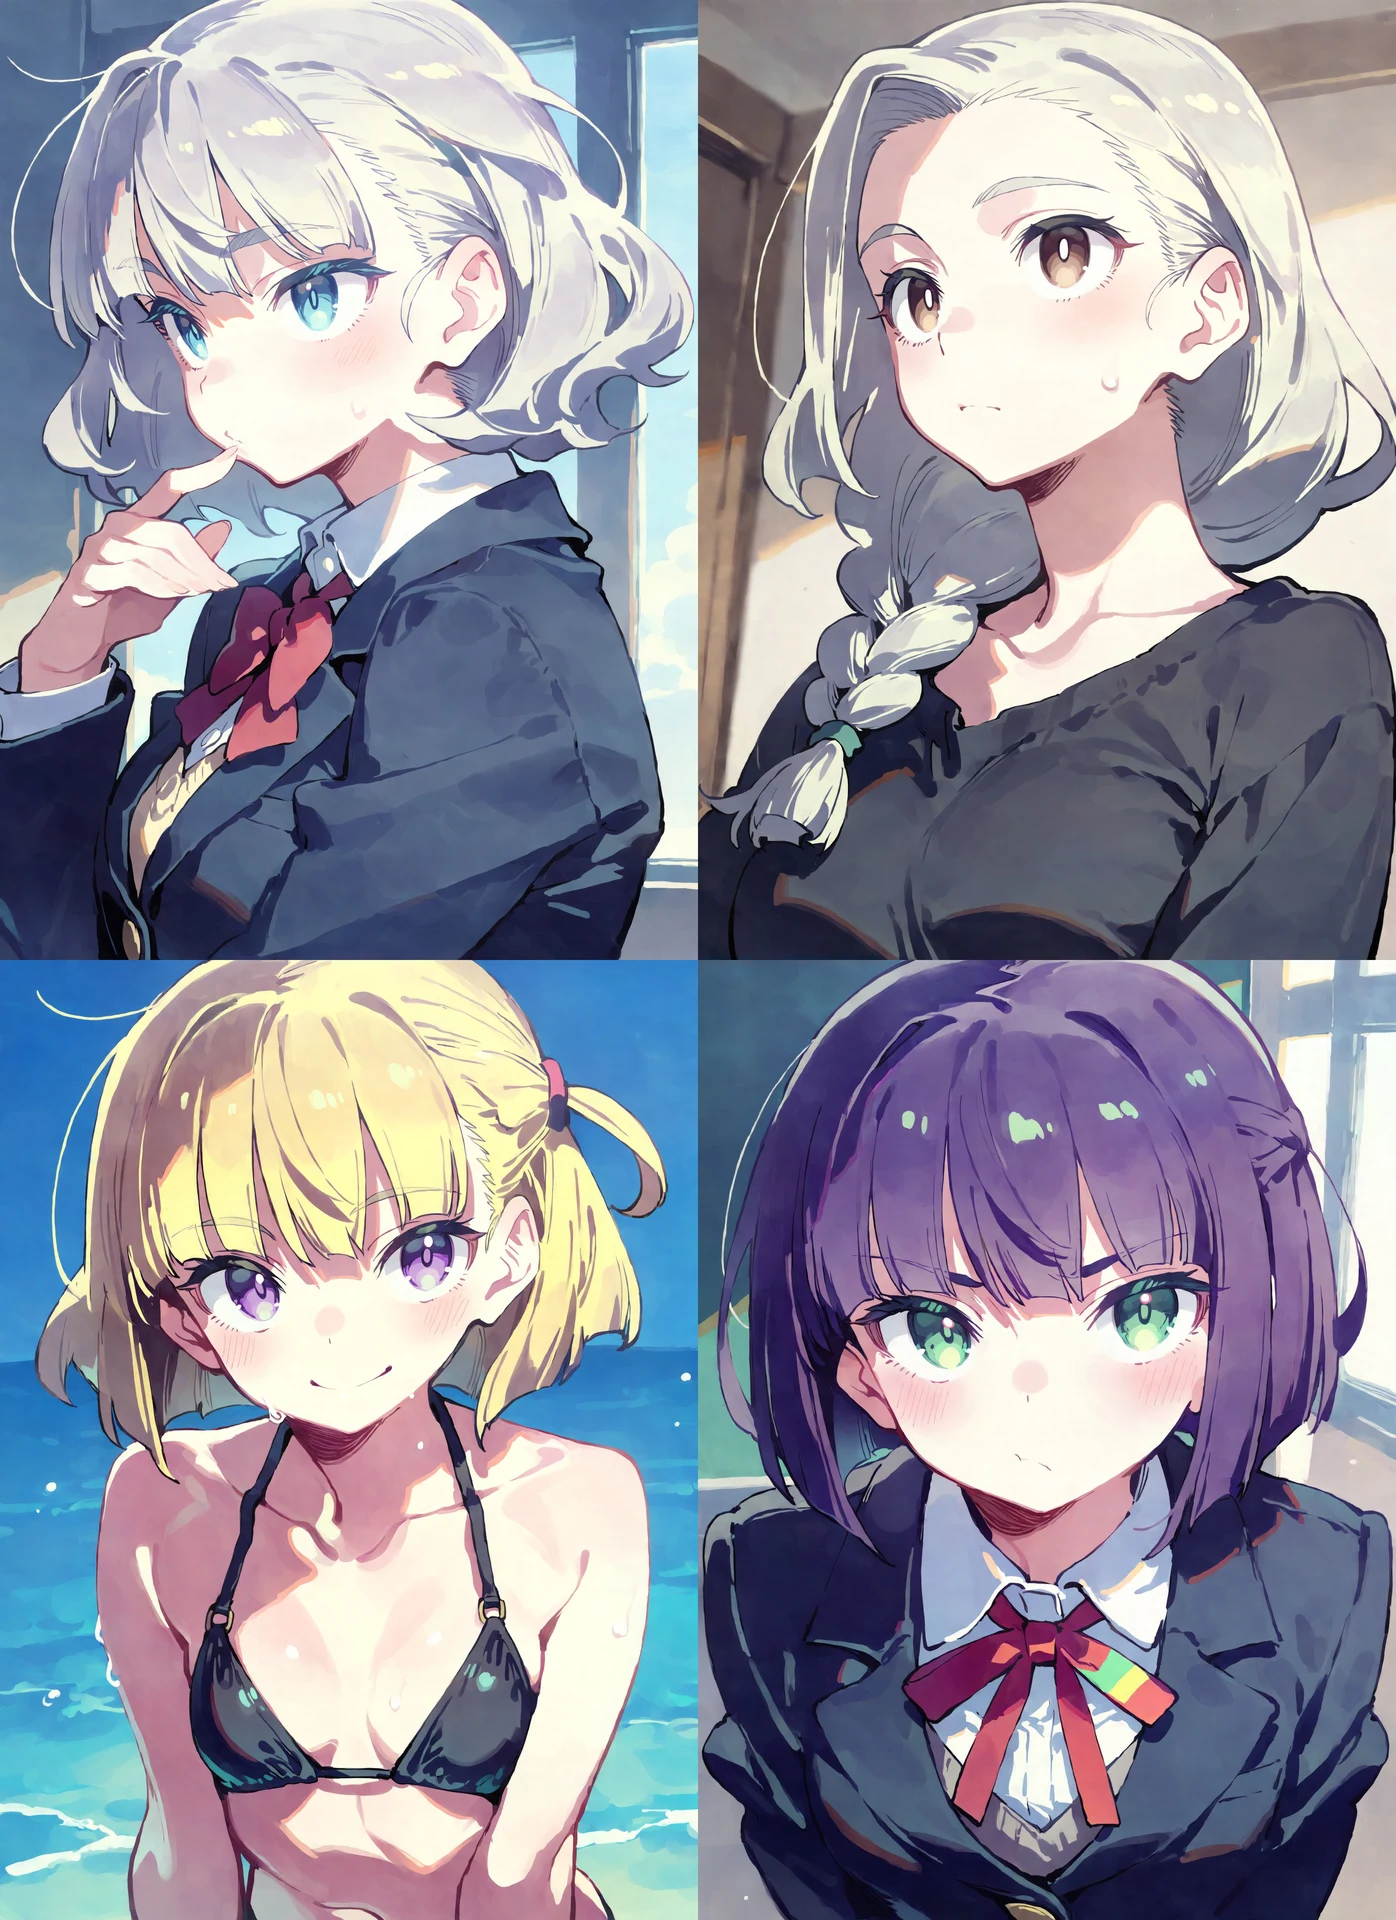
原因はお手本にした入力画像にあります。さきほども少し触れましたが、この画像には汗とも海の飛沫ともつかない水滴が描かれており、しかも比較した差分の実写画像にはその要素がはっきりと見えないため、画風+水滴追加LoRAになってしまったのですね。さらに、dim16&alpha8とかなり強めに細部を学習する設定なので、画風とは言えない部分もいっしょくたに学習されています。
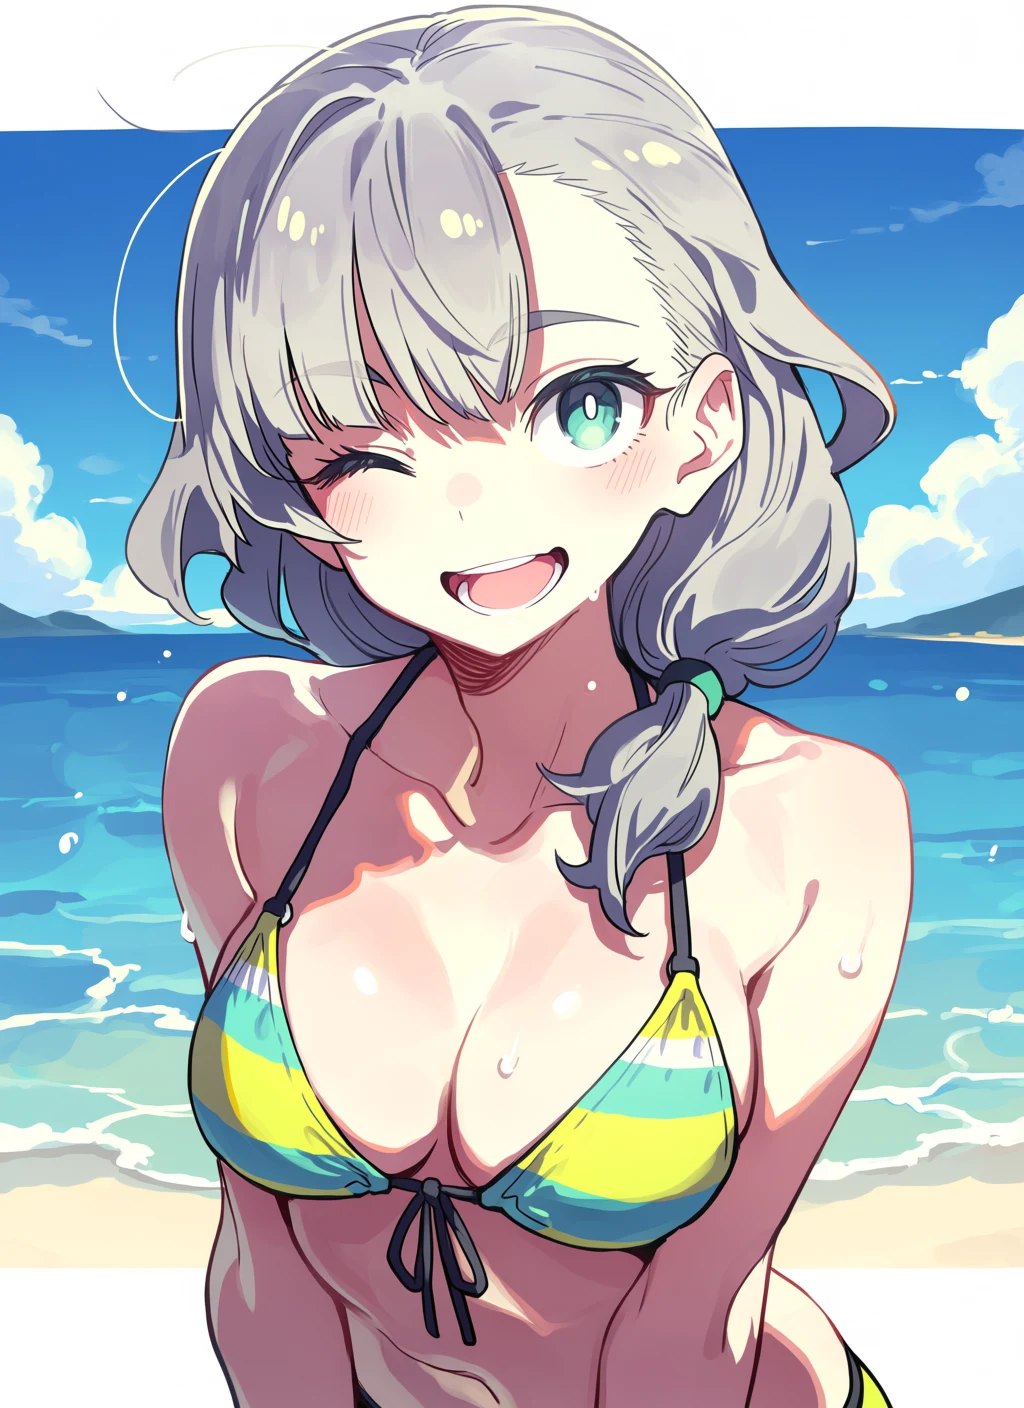
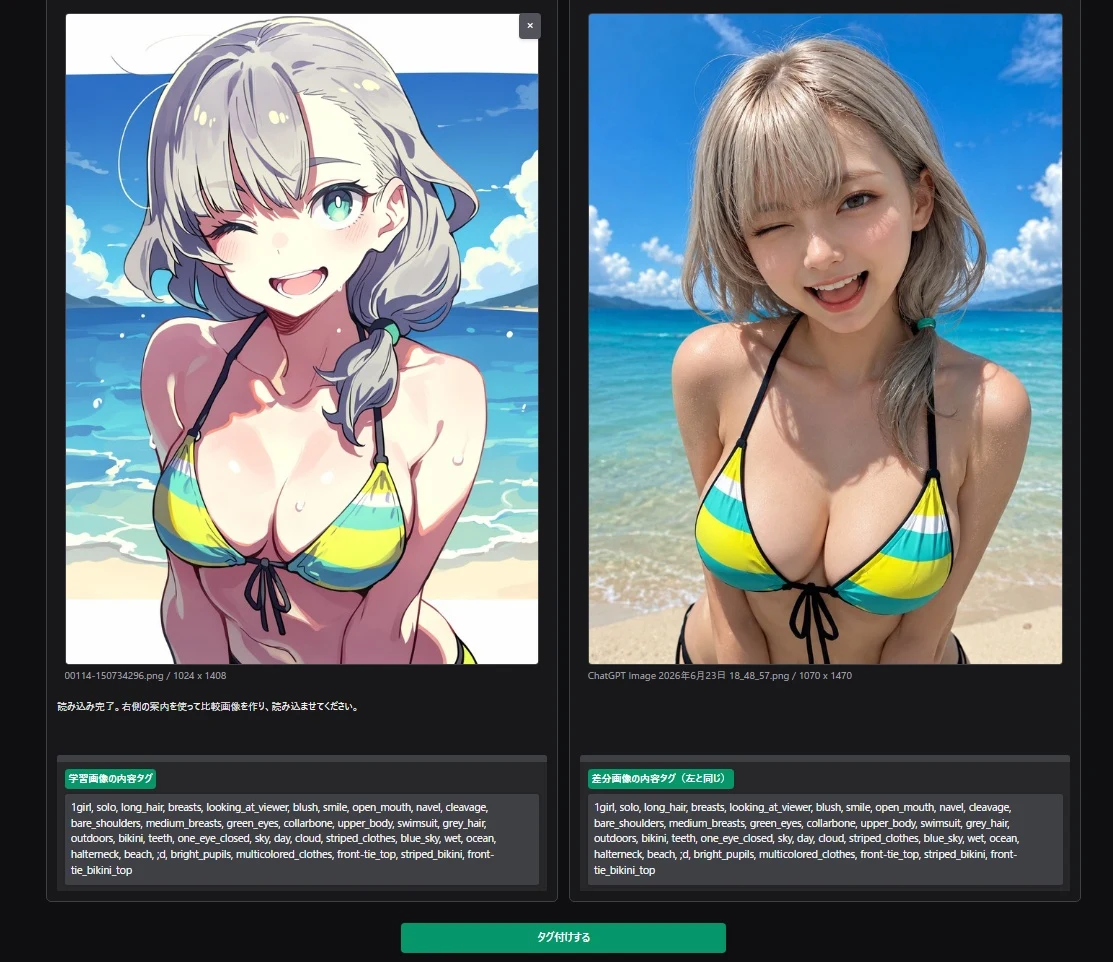
学習時に使用したタグ付けをチェックすると、「1girl, solo, long hair, breasts, looking_at_viewer, blush, smile, open mouth, navel, cleavage, bare shoulders, medium_breasts, green eyes, collarbone, upper body, swimsuit, grey hair, outdoors, bikini, teeth, one eye closed, sky, day, cloud, striped clothes, blue sky, wet, ocean, halterneck, beach, ;d, bright pupils, multicolored clothes, front-tie top, striped bikini, front-tie bikini top」となっており、汗や水滴に関するタグが「wet」しかありません。
詳細学習モード、つまり頭でっかちの高dim設定を選んだので、
🤖「sweatと書いていないのにsweatっぽいものが描かれている…この汗みたいなものはLoRAを適用したときに再現しないといけない画風の一部なんだな、OK!」
…と思い込んでしまうわけですね。
このように、danbooruタグだけで差分を上手に「こし取る」のには限界があり、しばしば予想しない要素が一緒に学習されてしまうことがあります。まずはお手本となる入力画像を、できるだけ学習させたい要素だけで構成するのが大事です。
ちなみに、学習時に「bright pupils」(白い瞳孔)タグを除去していないので、AIは「瞳の真ん中が白いけど、この瞳はユーザーがそう指示したからこうなっているだけであって、今回覚えなくてはいけない画風ではないんだな」と理解されています。そのため、生成した4枚画像は指示しない場合(右上以外)白い瞳孔が出にくくなっています。
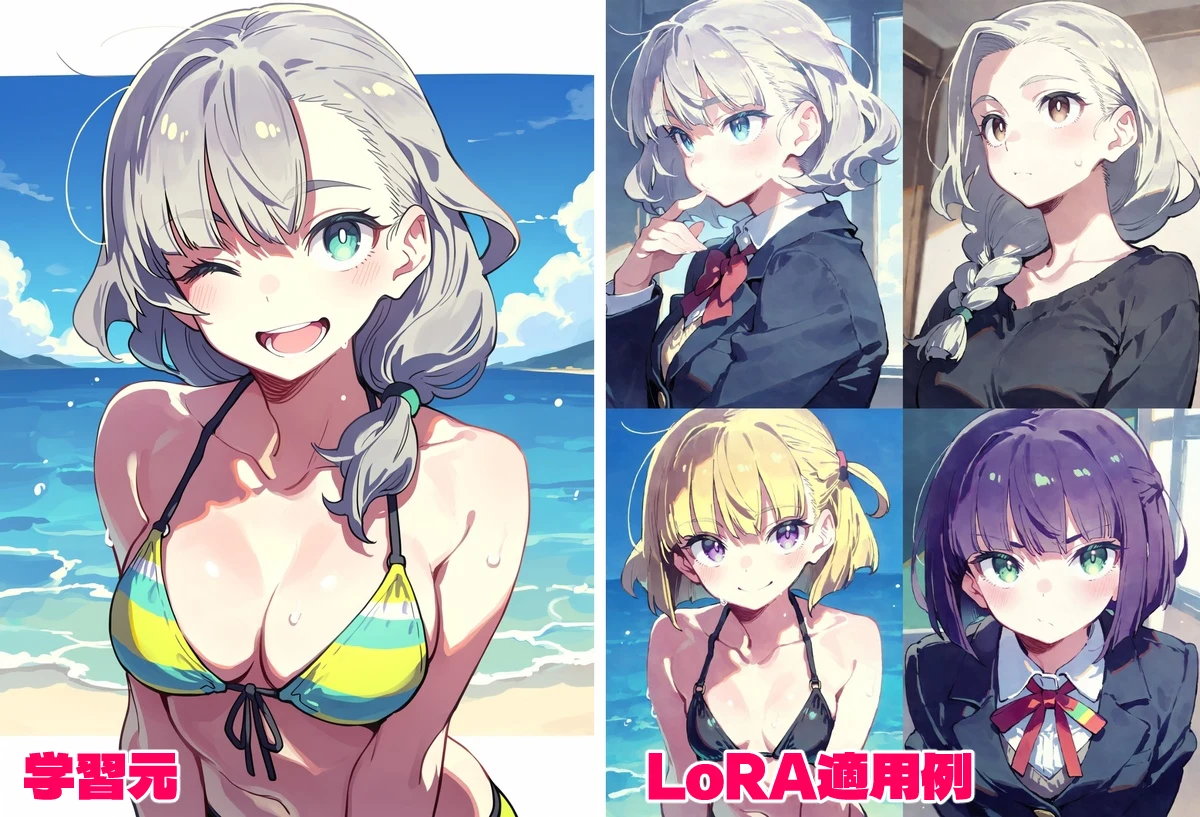
ただ、さきほど「wet」とタグに書いているのに水滴が学習されたように、タグ付けしたら学習から完璧に除去できるわけではなく、傾向としてはどうしても残ります。タグ付けは学習の取捨選択に使える重要要素ですが、ある程度学習傾向をコントロールできるだけなので、できるだけ入力画像と比較画像のペアで概念をシンプルに示せるように工夫しましょう。
<RTX3060&安定学習モード>
RTX3060(VRAM12GB)環境でもテストしました。こちらのペアを使い、「安定学習モード」で画風学習してみると、50分ほどで完走しました。タスクマネージャーで監視していましたが、VRAMは8.6GBくらいしか占有しなかったのでまだ余裕がありましたが、演算性能の方がいっぱいいっぱいのようでした。
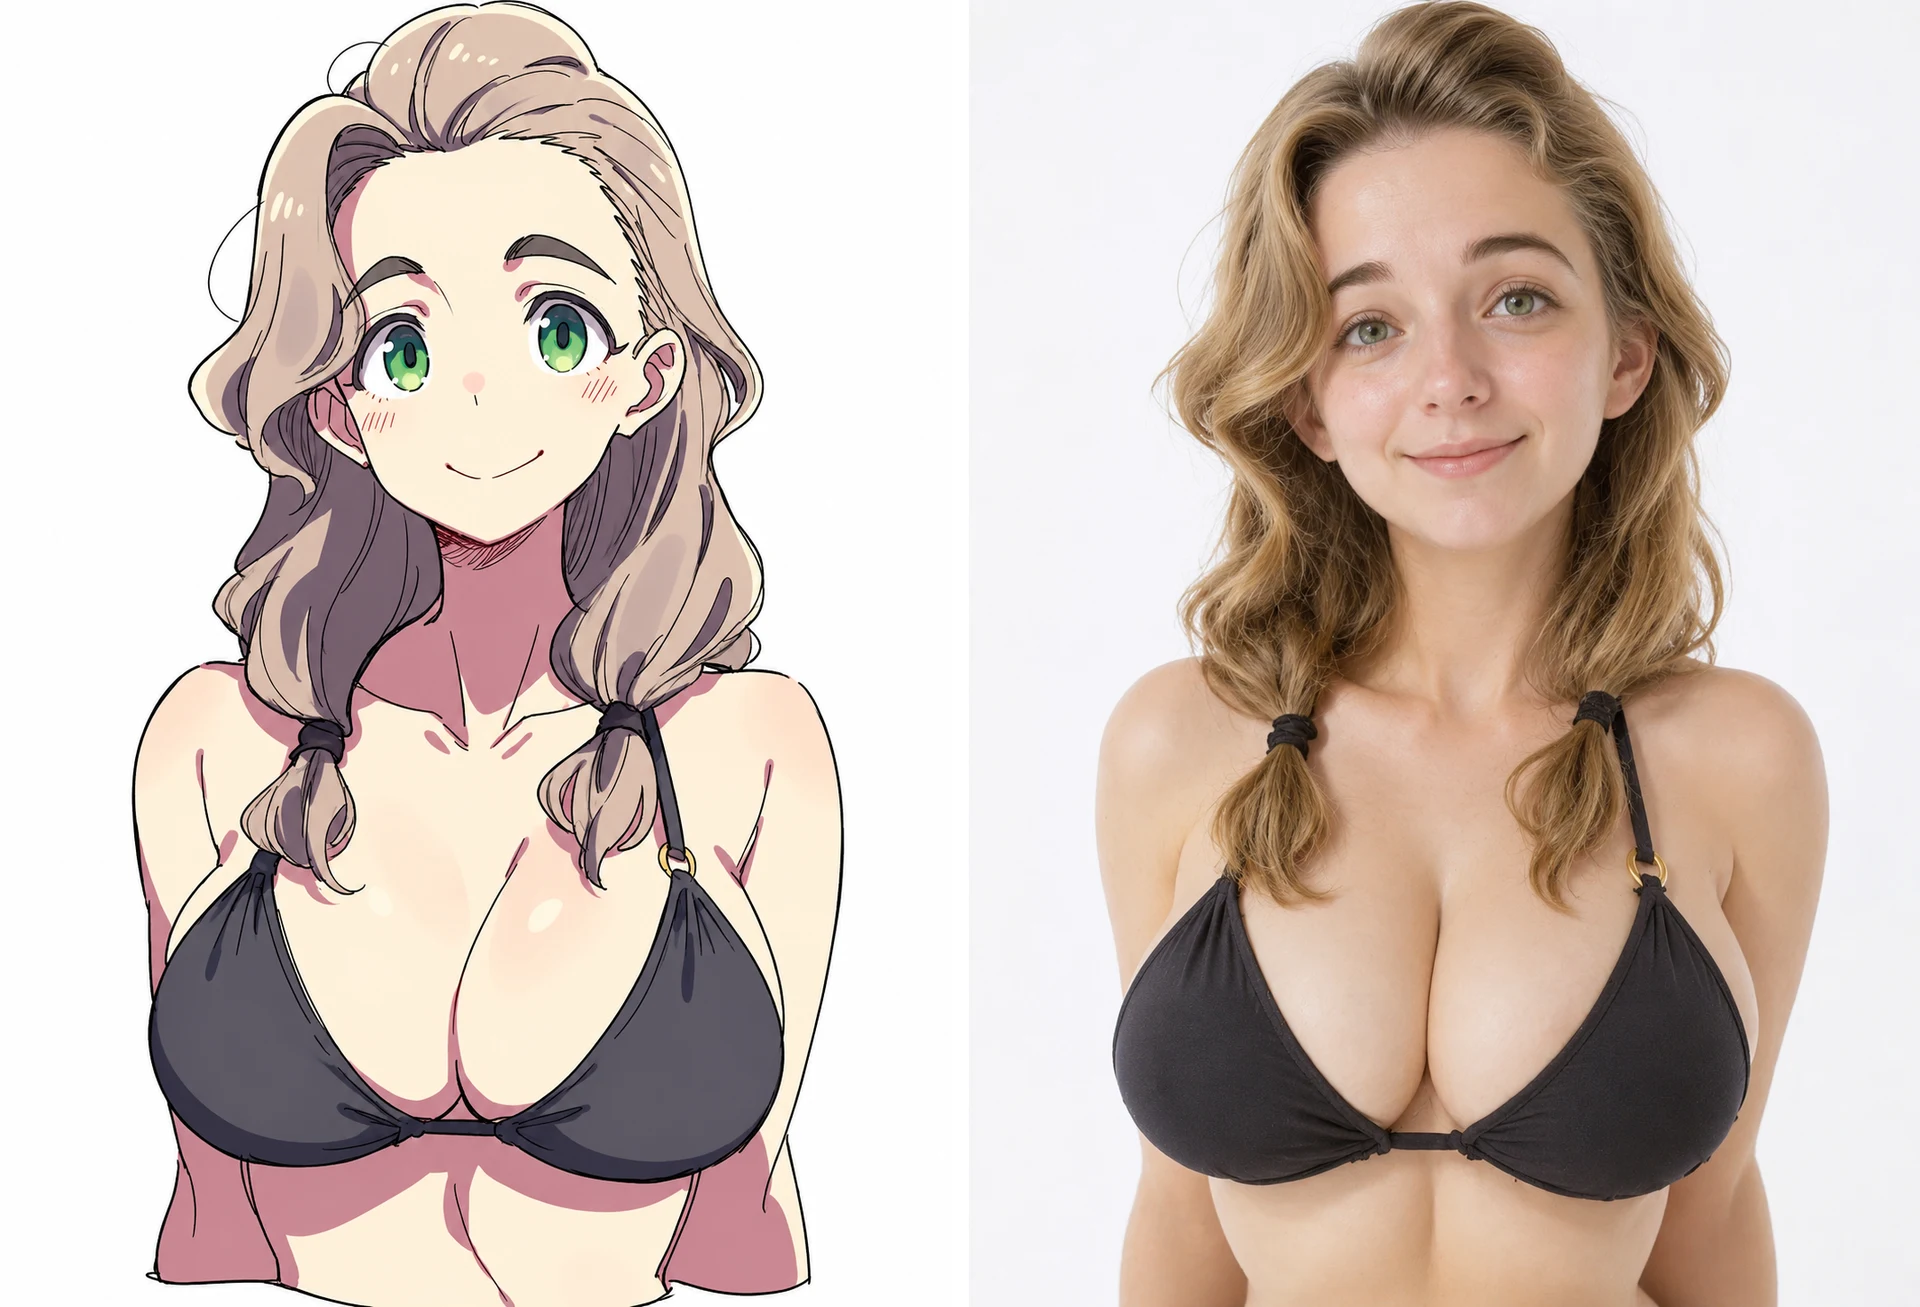
こちらが生成結果。RTX4080を使った「詳細学習モード」での画風学習に比べるとstep数やdim/alphaの値がかなり少ないので、お手本画像を細かく覚えることはせず、ベースモデルにうっすら「お化粧」する程度の画風再現になっています。(※ベースモデルが子供っぽいキャラを描きたいなら、それを上の主婦キャラっぽい顔立ちに変換するほどの強制力はなく、ハイライトやカラー、瞳や頬赤の描き方、アホ毛、塗りなどの再現にとどまるということです)
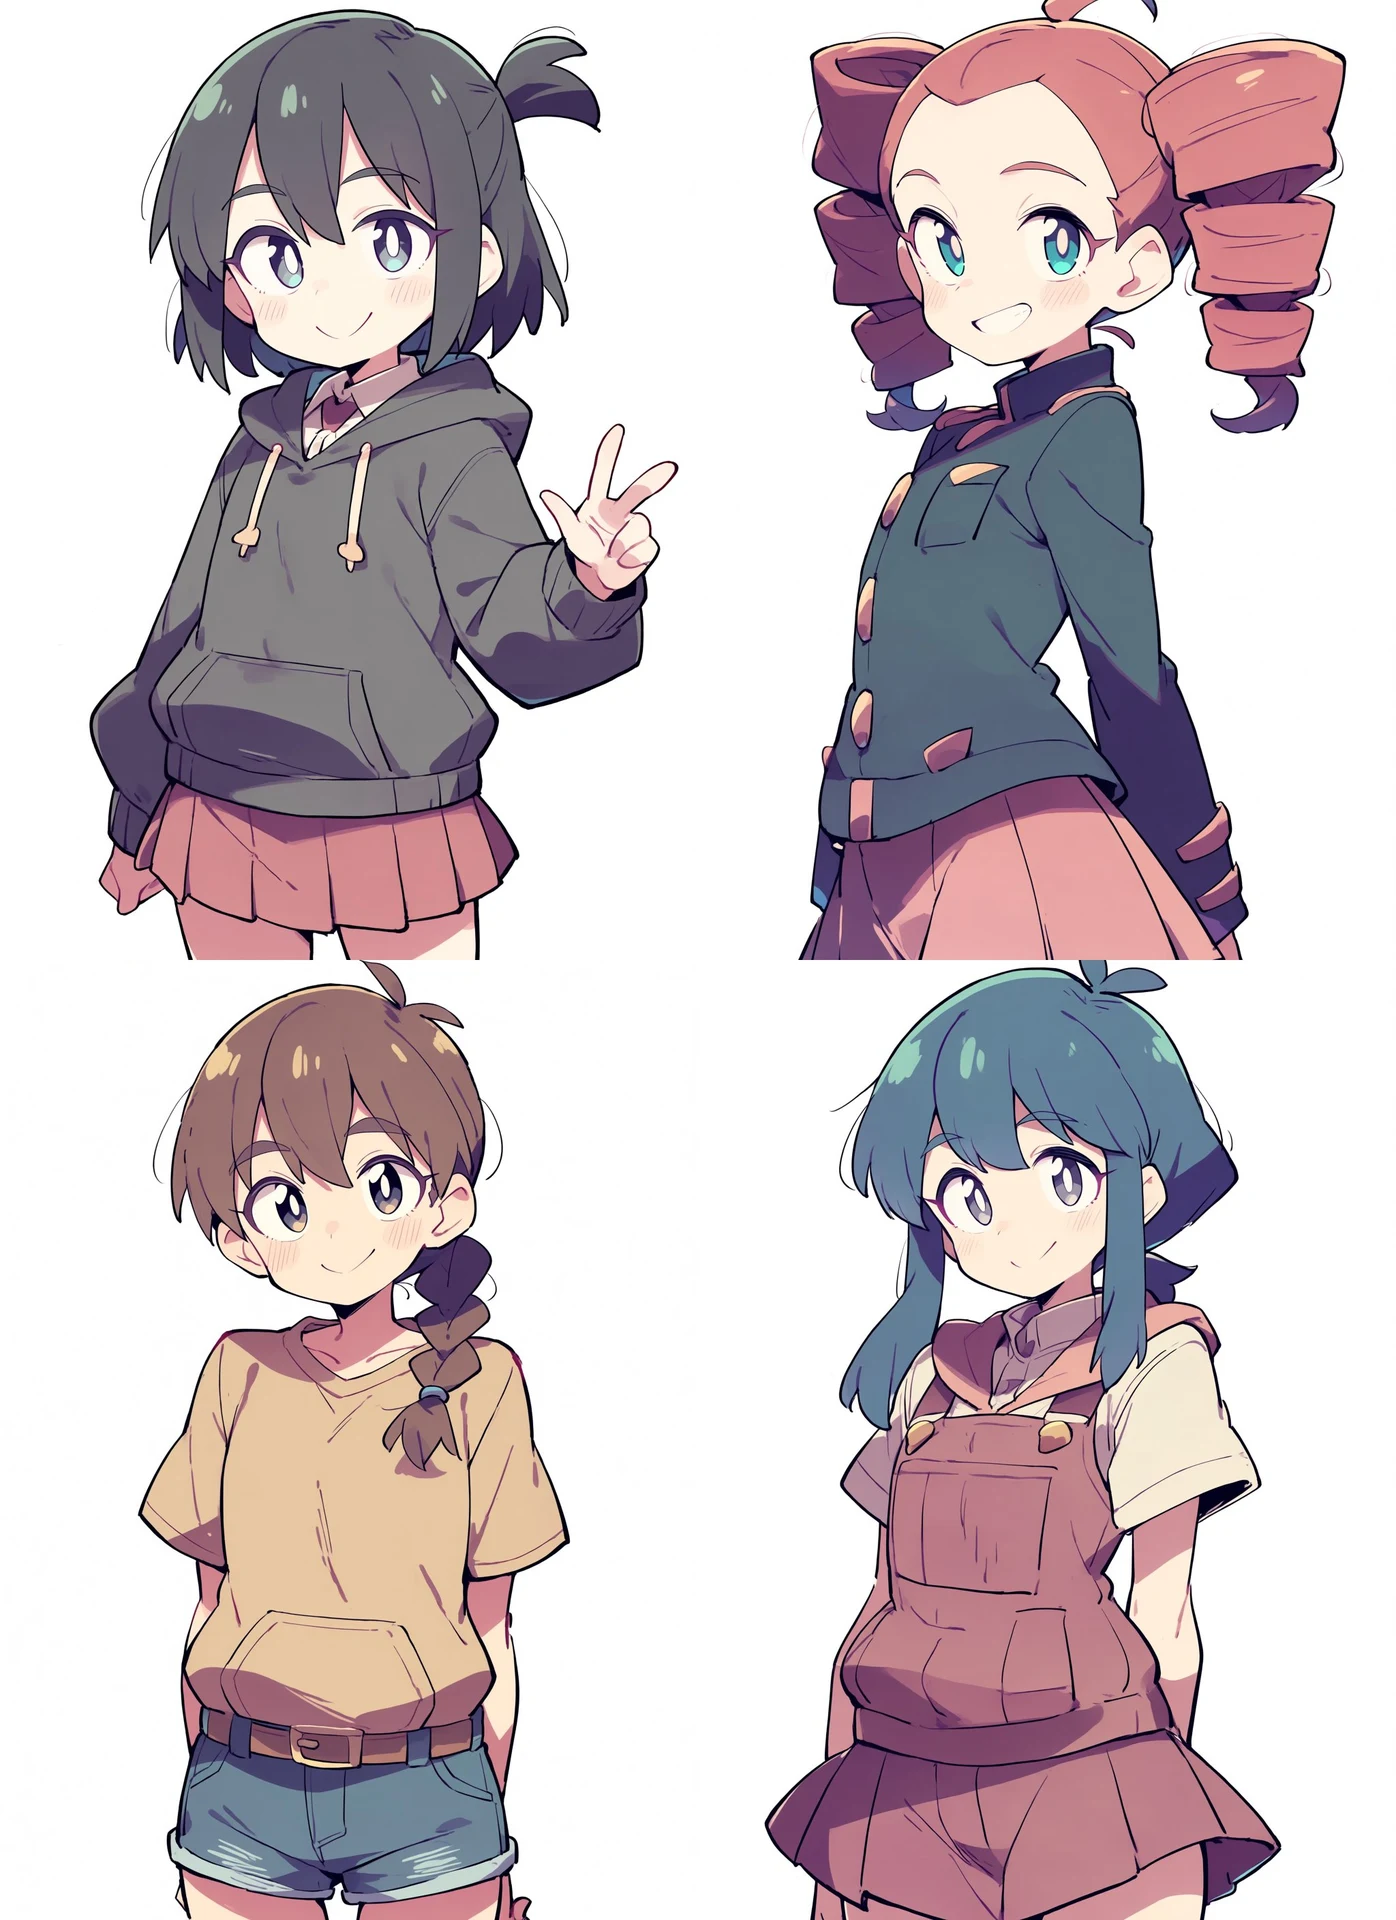
その代わり、詳細学習モードの時にあったような「水着になりやすい・巨乳になりやすい・主婦っぽいキャラが出やすい」といった余計な要素の影響が少なくなるのはメリットでもあります。お手本画像の主婦っぽいキャラを出したいなら、「mature female, wife, thick eyebrows, large breasts」などとプロンプト指示すればよいわけです。
グラボ性能と相談しながら、どれくらいの学習時間なら許容できるか、どれくらい強く絵柄を再現してほしいかでプリセットのさじ加減を判断するとよいでしょう。
<うまく画風が再現されないときは>
テスト生成で画風が再現されない場合、適用しているモデルの画風が前に出ているか、クォリティタグが画風を上書きしている可能性があります。「4K」や「ultra detailed」「bold line」「watercolor(_medium)」などの画風に関わる指示を入れている場合は、いったん削除してやりなおしてみてください。それでもダメな場合、「トラブルシューティング」の項を参考にしてみると改善するかもしれません。

「学習プリセット」解説
ここで、各学習プリセットのパラメータの意味についても説明しておきます。慣れてきたら、プリセットだけでなく自分の好みの設定を試してみてください。LR(学習率)やdim、alphaについては、LoRA学習の基本記事もご参照ください。
<プリセットの違い>
3つのプリセットを選択すると、それぞれ下記のパラメータを自動選択します。
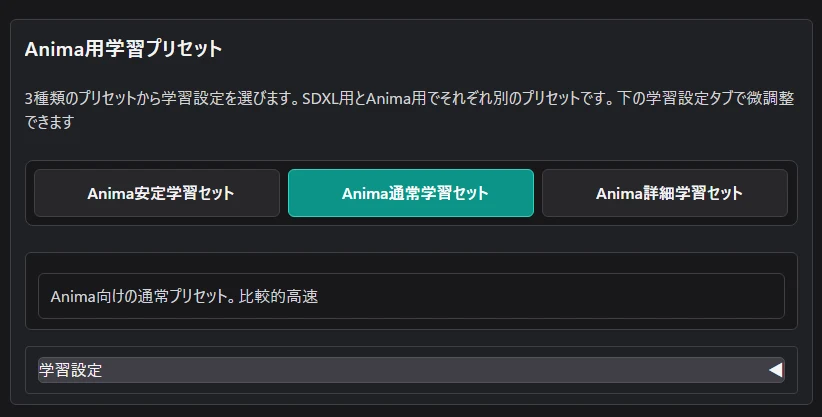
<Anima向けの場合>
「Anima通常学習セット」は、標準の学習設定です。steps 300、LR 0.00016、batch 2、dim 8、alpha 1、差分強度1.25が選択されます。できるだけ短時間で、できるだけきちんと画風が学習できるバランスに調整しました。
「Anima安定学習セット」は、通常学習セットでは止まってしまう、または極端に遅くなる環境向けのセットです。steps 200、batch 1、dim 8、alpha 2(step不足を補う思想)、差分強度1.25が選択されます。lowramを手動でONにするとVRAM消費量をさらに抑制することができますが、代わりに学習速度が落ちます。
「Anima詳細学習セット」は、通常学習では顔立ちや塗りが弱いとき用です。steps 400、LR 0.00012、batch 2、dim 16、alpha 8、差分強度1.25が選択されます。後述する「カラーを重視」機能がオンになるため、塗りの色合いをより強く学習できます。

<SDXL向けの場合>
「SDXL通常学習セット」は、標準の学習設定です。steps 500、LR 0.0001、batch 2、dim 16、alpha 16、差分強度1.0が選択されます。SDXLはAnimaより学習が軽めなので、Anima向けよりやや多めのstepsと大きめのdim/alphaで、画風をしっかり拾う設定にしています。
「SDXL安定学習セット」は、通常学習セットではVRAMが厳しい、または途中で止まってしまう環境向けのセットです。steps 300、LR 0.0001、batch 1、dim 16、alpha 16、差分強度1.0が選択されます。batchを1にすることでVRAM消費を抑えつつ、SDXL向けLoRAとして最低限の学習量を確保する設定です。
「SDXL詳細学習セット」は、通常学習では顔立ちや塗り、線の癖が弱いとき用です。steps 600、LR 0.00008、batch 2、dim 32、alpha 32、差分強度1.0が選択されます。より細かい特徴を拾いやすくなりますが、そのぶん入力画像に含まれる余計な癖も学習しやすくなるため、画像ペアとタグの整理が重要になります。

<各パラメータの意味>
・steps(ステップ数)
コピー機LoRAを作るための学習を何回くり返すか。Copitaは1枚の画像を強烈に学習させて、それしか生成できないような(まるでコピー機のような)LoRAを二つ作り、差分を抽出するわけなので、しっかりコピー機レベルにするためにはある程度のステップ数が必要です。
ステップ数が多いほど画風を覚えやすくなりますが、学習時間も長くなります。ただし、無闇に多くすると元画像の内容まで覚えすぎ、顔や構図が固定されやすくなったり、細部が壊れたりする恐れがあります。設定できる範囲は100〜1600stepです。
・LR(Learning Rate=学習率)
1回ごとの学習の強さです。大きいほど早いstepから効果が出てきますが、強すぎると線や色が荒れたり、余計な癖まで入りやすくなります。基本はプリセットのままでOKです。LRを高めるのは「一夜漬け」で猛勉強するようなものですので、テスト範囲の学習はすぐ終わりますが、覚え方は雑になります。
・batch(バッチ数)
一度に処理する画像の数。コピー機LoRA法では1枚しかないので、同時に同じ画像を学習して過学習を起こすことになります。2にすると速くなりやすいですが、その分VRAMを多く使います。VRAM不足なら1にしてください。範囲は1〜4ですが、3以上にしても早くならない(むしろ遅くなる)ことがありますので、VRAM容量と相談して1か2にするのがおすすめ。
・dim(dimension=次元数)
LoRAが画風などを覚えるための「入れ物の大きさ」のようなもの。大きいほど細かい顔立ちや塗りを覚えやすくなりますが、余計な特徴も拾いやすくなります。
例えば、魔法少女キャラの複雑な衣装を細部まで覚えて再現するには高いdimが必要になりますが、線を太くするだけのLoRAなのに高いdimにすると、線の太さ以外の概念をあれこれ学習してしまって使いにくくなります。
「高いdimは細かいことにこだわる頭でっかち」「低いdimはおおざっぱな単純タイプ」と覚えておくと遠からずです。Copita上での設定可能範囲は4〜64。
・alpha
alphaは、LoRAのrank/dimとセットで効き方を調整する係数です。ざっくり言えば、dimに対してalphaが小さいほど控えめに、大きいほど強めにLoRAが働きやすくなります。ただ、学習率や保存される重みの扱いにも関わるため、LoRA適用強度のようなものと考えると誤解しやすいです。
料理の匙加減のようなもので正解はないのですが、civitaiなどでは、alphaをdimの8分の1から半分程度に設定しているLoRAが多い印象。Copita上での設定可能範囲は1〜64です。
・差分強度
左画像のコピー機LoRAから右画像のコピー機LoRAを引くときの強さです。大きいほど画風差分が強く出ますが、強すぎると崩れやすくなります。初期値は1.25。選択可能範囲は0.6〜1.8です。LoRAの強度は適用時にも選べますから、さほど気にしなくてもよいでしょう。
・「100ステップおきにLoRAを3パターン保存」
完成版だけでなく、途中ステップのLoRAも保存する設定です。学習しすぎる前のLoRAのほうが自然に効くことがあるため、比較したい場合に使います。3つを限度にしているので、たとえ800ステップ学習しても保存されるのは600/700/800ステップ時点のLoRA。「最終結果の手前2個を100ステップ間隔で残し、最終LoRAと合わせて最大3パターンにする機能」というのが正確です。
・「カラーを重視」
Animaにおけるコピー機学習法では、線画にくらべてカラーや塗りがあまりしっかり学習されない傾向があることを踏まえた実験機能。画面右側で読み込んだ比較画像だけを内部的に白黒化(彩度0のグレースケール化)してから学習することで、お手本画像の色作りをより差分として残しやすくする設定です。色味や塗りを強く出したいときに試してください。
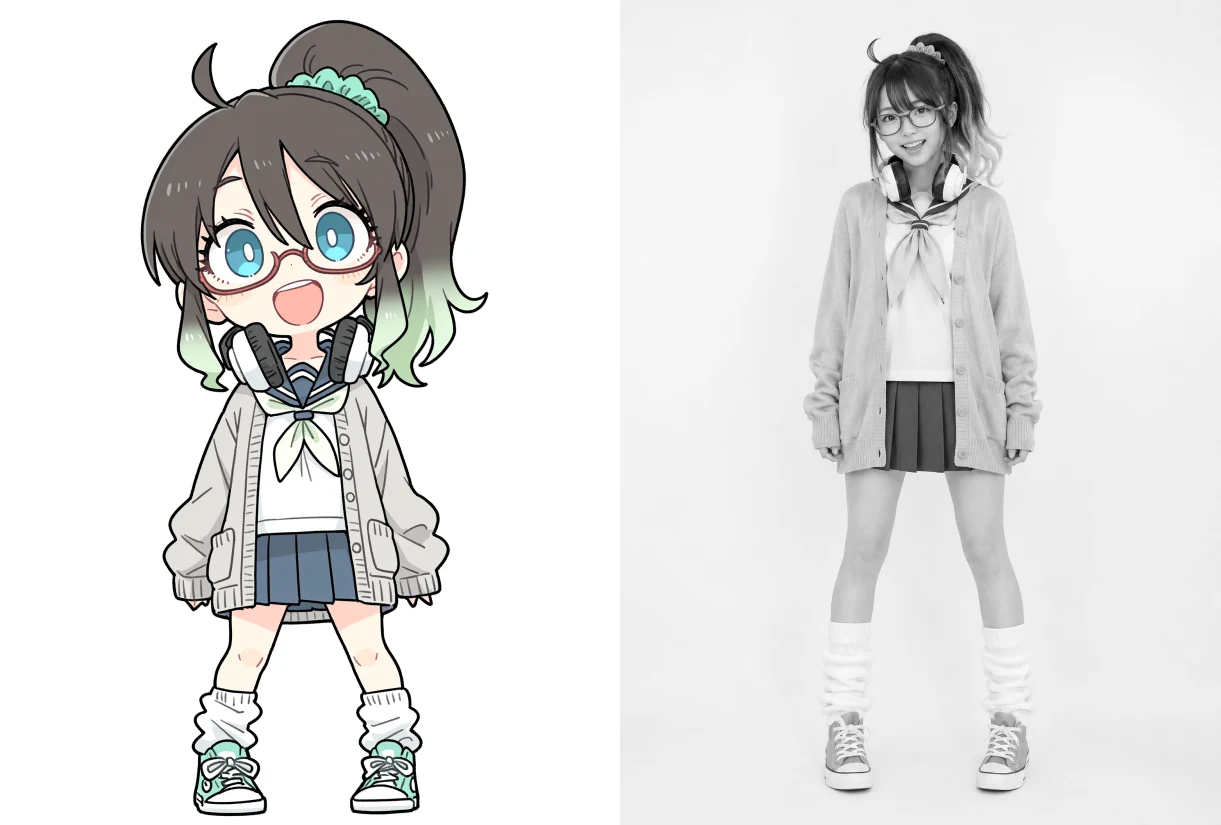
▲オンにすると、内部的にはこのようなペアで学習される
オンにした場合も、red eyesやblonde hairといったプロンプトはそのまま残して大丈夫です。右側だけにmonochromeなどと入れる必要はなく、堂々と「これは金髪で赤い目のキャラクターだ」と言い張ることで、AIは
🤖「ふーんそうなんだ。とりあえず2枚で違うとこをしっかり学習するね。あっすごい!2枚ですごい色が違う!ここを覚えよう!」
となり、左画像のカラーが強くLoRAに焼き込まれるーという狙いです。
・lowram(低VRAMモード)
速度を犠牲にする代わりにVRAM消費量を抑制する機能です。VRAM8GB以下の環境を想定したものですので、VRAMに余裕があるなら外します。
・層別学習機能
v1.2から実装したAnimaのみの追加機能です。「セルフアテンション」「クロスアテンション」「MLP」の三つのモジュール別に学習率(LR)を設定できるようになります。
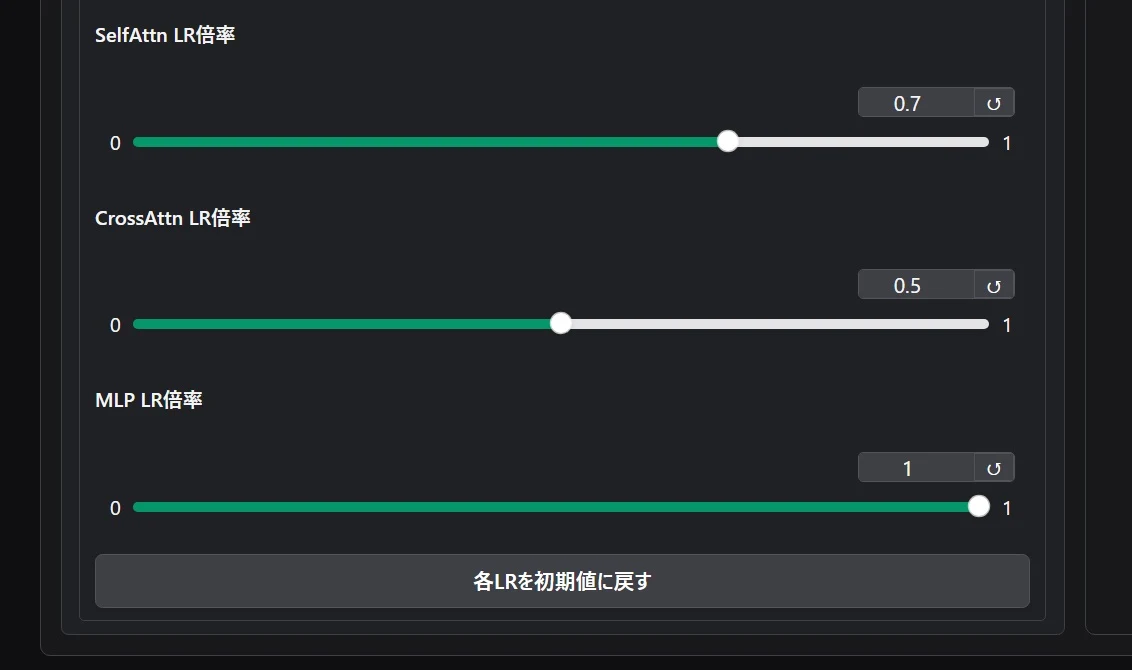
デフォルトは1/1/1で、よく分からない場合はデフォルト値のままでの学習を強くお勧めします。詳しい使い方はこちらの記事を参照のこと。
<TIPS:dimとalphaの考え方>
dimは「LoRAがどれくらい細かい特徴まで覚えられるか」を決める容量のようなものですが、「大きければ大きいほど重くて高性能なLoRAができる」というわけではなく、「学習したい差分が複雑・複合的なら大きめ、単純・単一なら小さめ」が基本。これはコピー機LoRA法でも同じです。
画風LoRAの場合、線や塗り、目の描き方、影、色使いなど覚えたい情報が多いので、通常学習セットの8か、詳細学習セットで採用しているdim16あたりが扱いやすいように感じます。かなり複雑な画風を強めに覚えさせたい場合はdim32~64も選択肢になりますが、そのぶん入力画像に含まれる汗、水滴、構図、カメラワーク、ポーズ、表情の癖、破綻なども一緒に入ってしまい、「似ているけど作りたい画像と違う」結果に陥りやすいです。
一方、線を太くするLoRAのような「概念スライダー系LoRA」は覚えさせたい差分が比較的シンプルです。「線を太くする」だけなら、構図や顔立ちや衣装の細部、しわの質感、カメラワークなどは不要、というより覚えられたら困るわけですから、dimは低いほうが良いことになります。dim8か、dim4 / alpha1あたりでもいいかもしれません。ただ、容量が小さすぎると効きが弱かったり、強度を上げたときに破綻したりすることもあるため、「必ずこの設定が最適」とは言い切れないところがあります。(新しいモデルであるAnimaならなおさらです)
何はともあれ、スライダー系LoRAの効きが悪かったり、余計な学習をしてしまっている(副作用がある)ときは、dimを上げるのではなくステップ数を増やしたりペア画像の精度を上げる方が先。dimを上げると、むしろ余計なことを覚えて逆効果になりやすいということは言えそうです。

概念スライダーLoRAを学習するには
さて、画風LoRAの次は、特定概念をスライダーのように調整できるLoRAの作り方を検証します。SDXLでは、例えば線を太くするBoldLoRAや描き込み量を減らして量を減らしてフラットなタッチにするFlatLoRAなどが有名ですね。これらのLoRAはマイナス方向に適用することで、逆に「線を細くするLoRA」や「描き込み量を増やすLoRA」にもできる便利なLoRAです。
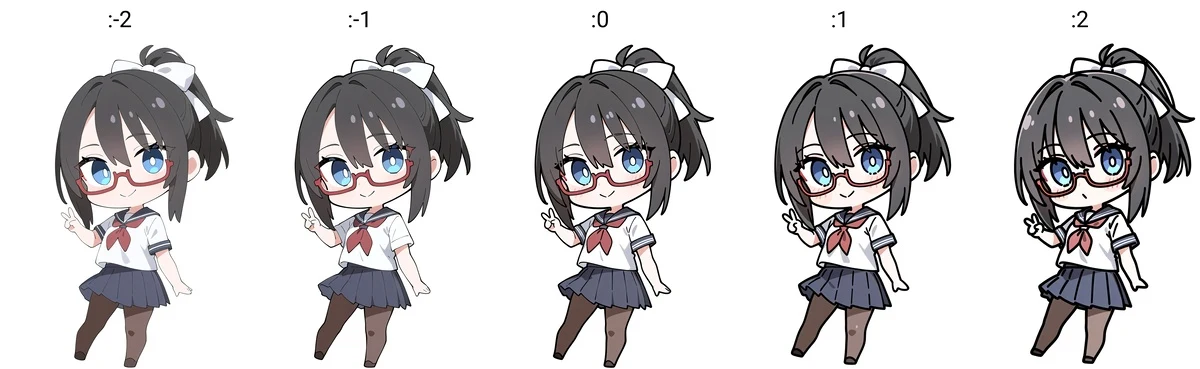
こうした単一概念の学習こそコピー機LoRA法が得意とするところですが、線画の太さだけに純粋に干渉できる高品質なBoldLoRAが一発でできるわけではありません。このSDXL用BoldLoRAは月須和・那々さんが何度も調整やマージを(恐らく)繰り返して作った特製品ですので、この精度で誰でも簡単に学習できるわけではないことを最初に断っておきます。
<BoldLoRAの学習例>
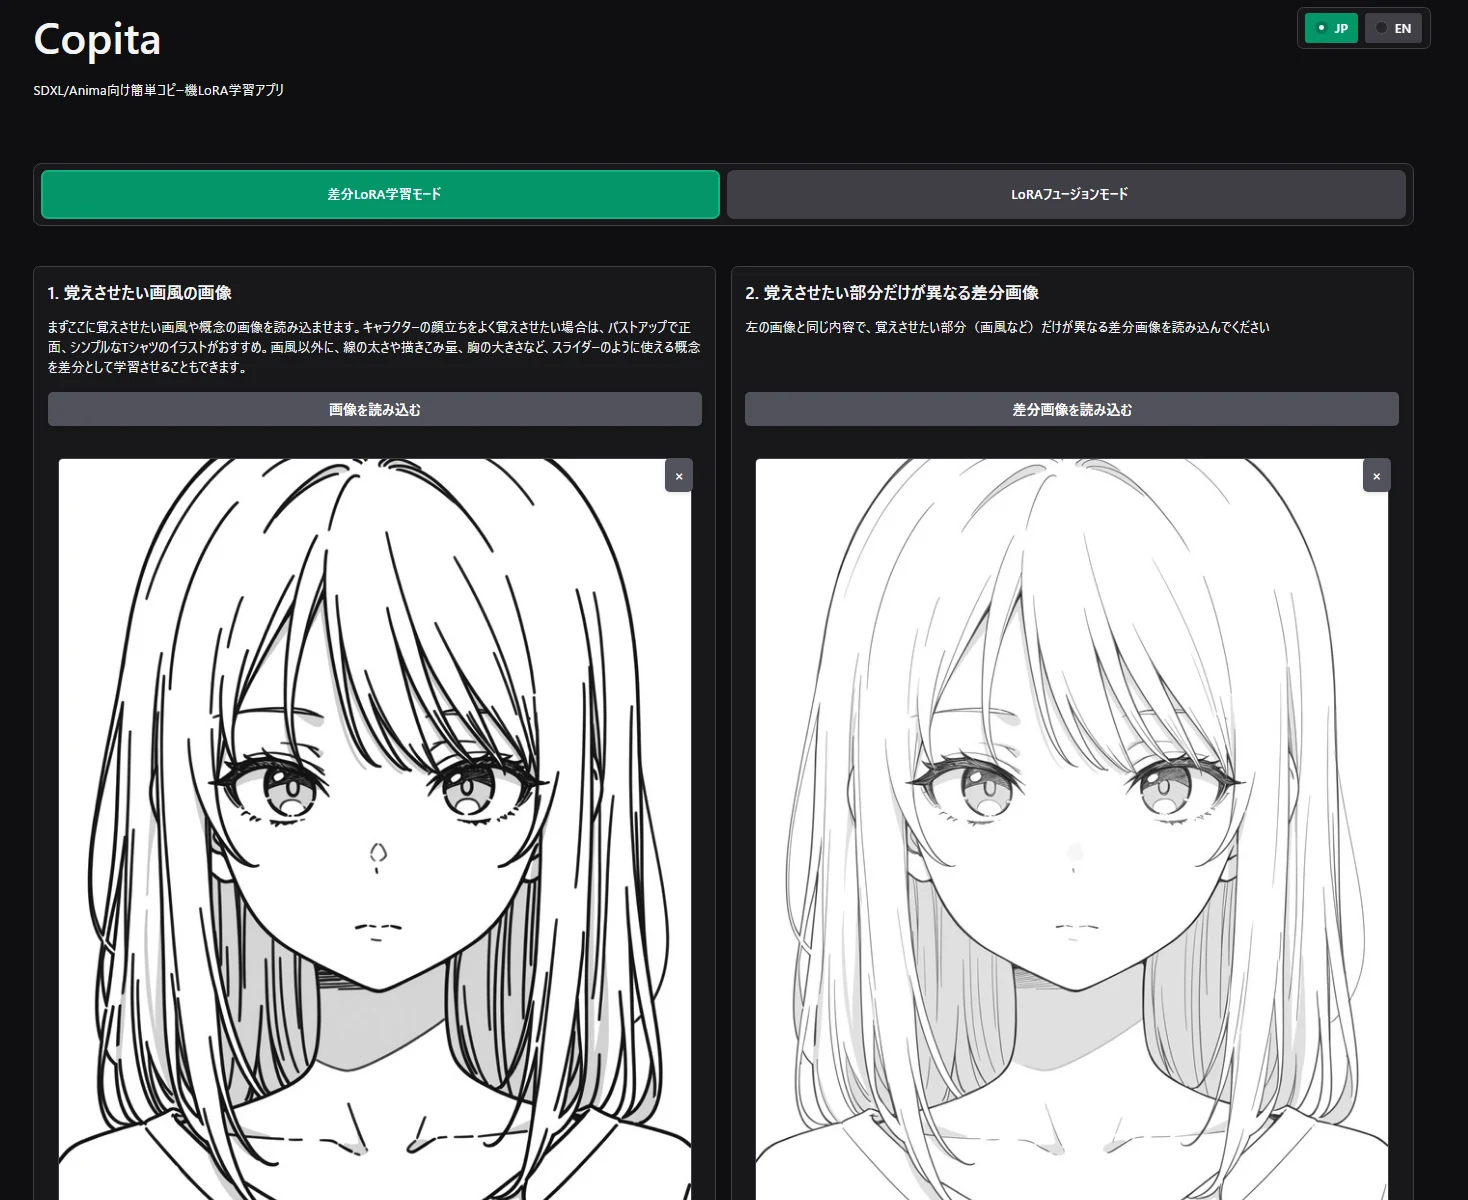
というわけで、今度はAnima用に「BoldLoRA」を学習させてみましょう。お手本画像と比較画像のペアはこちらです。
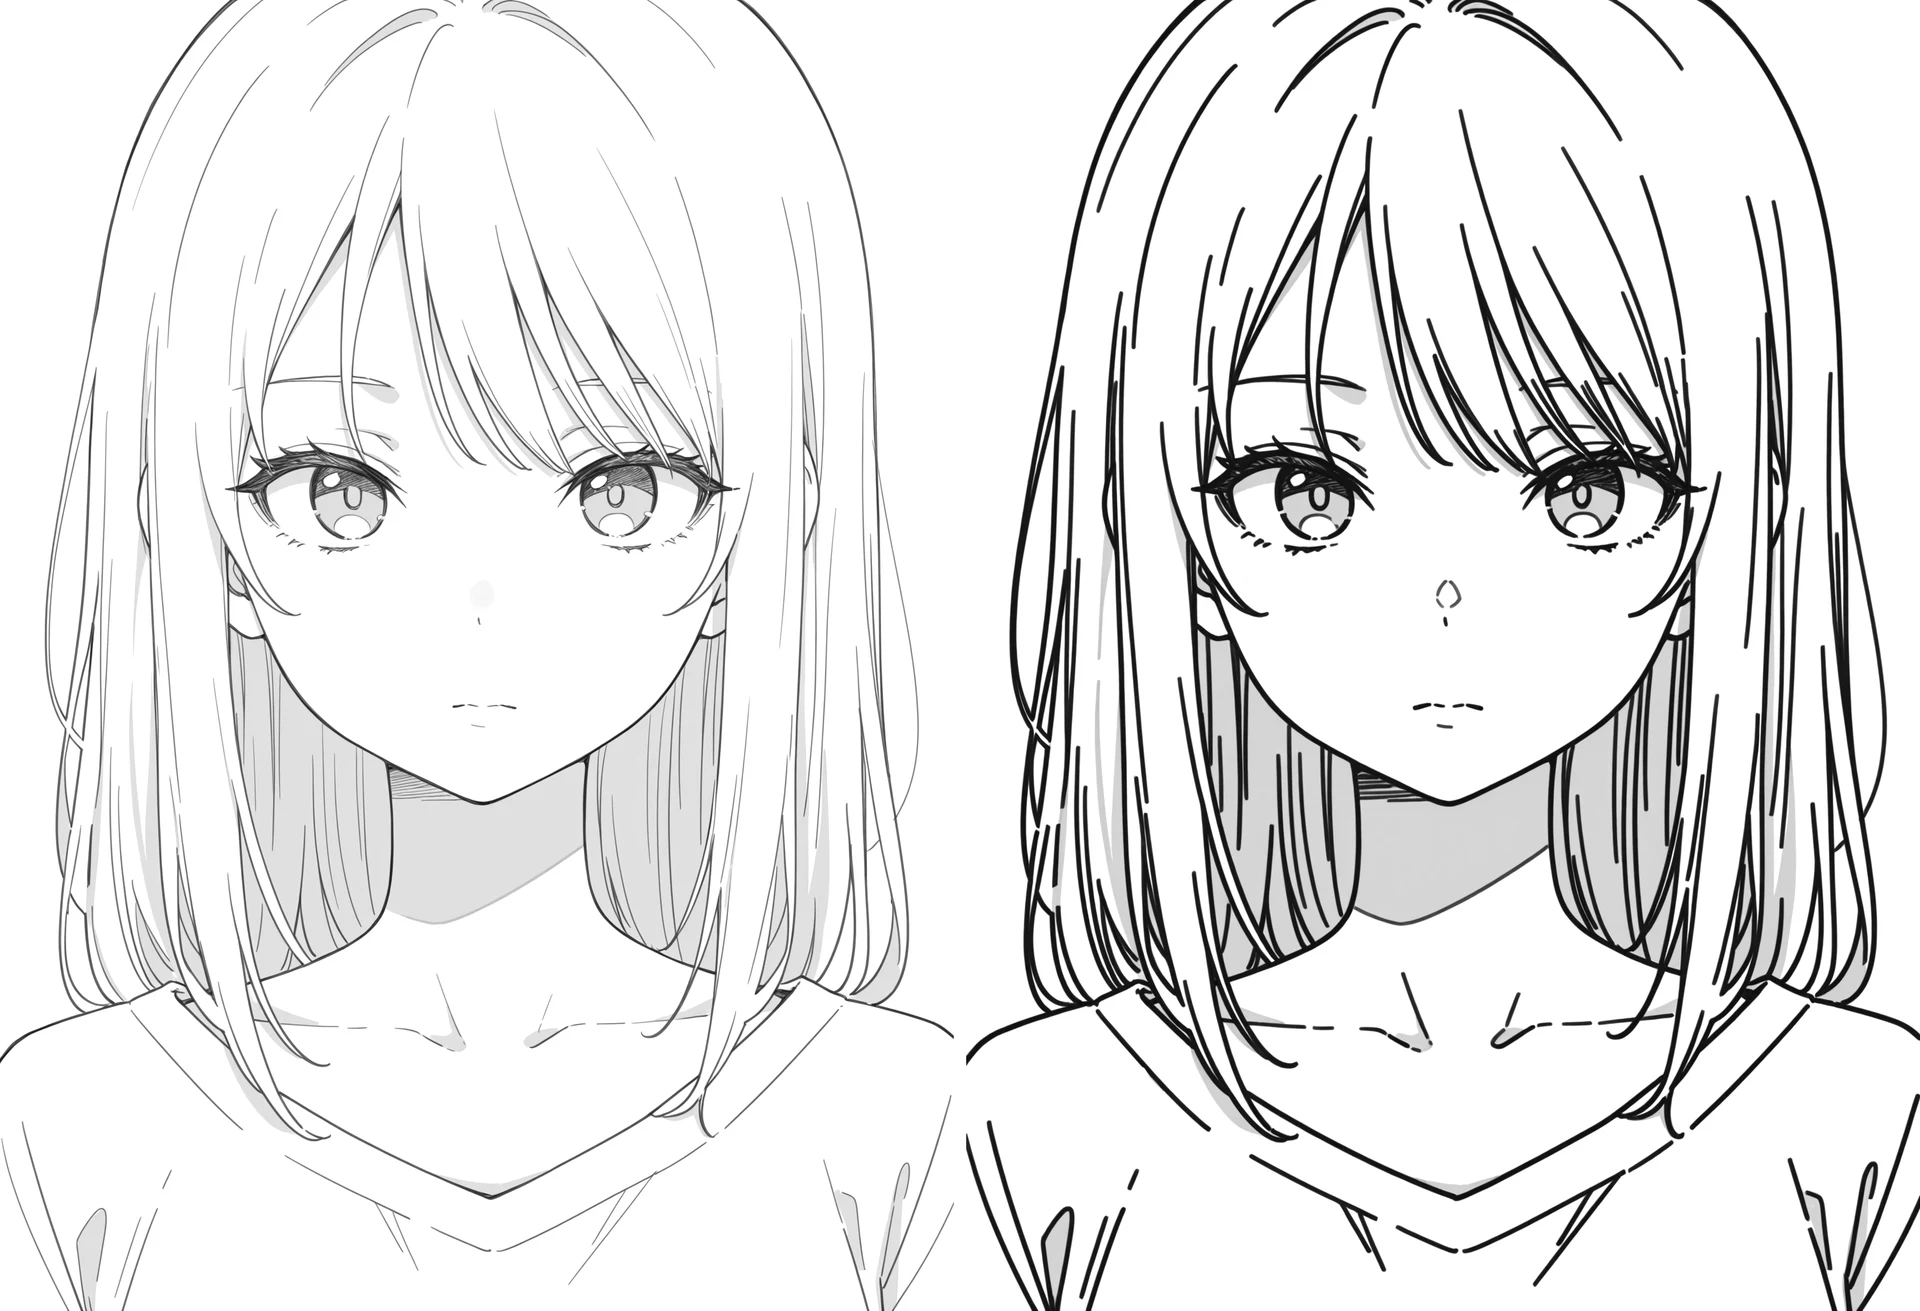
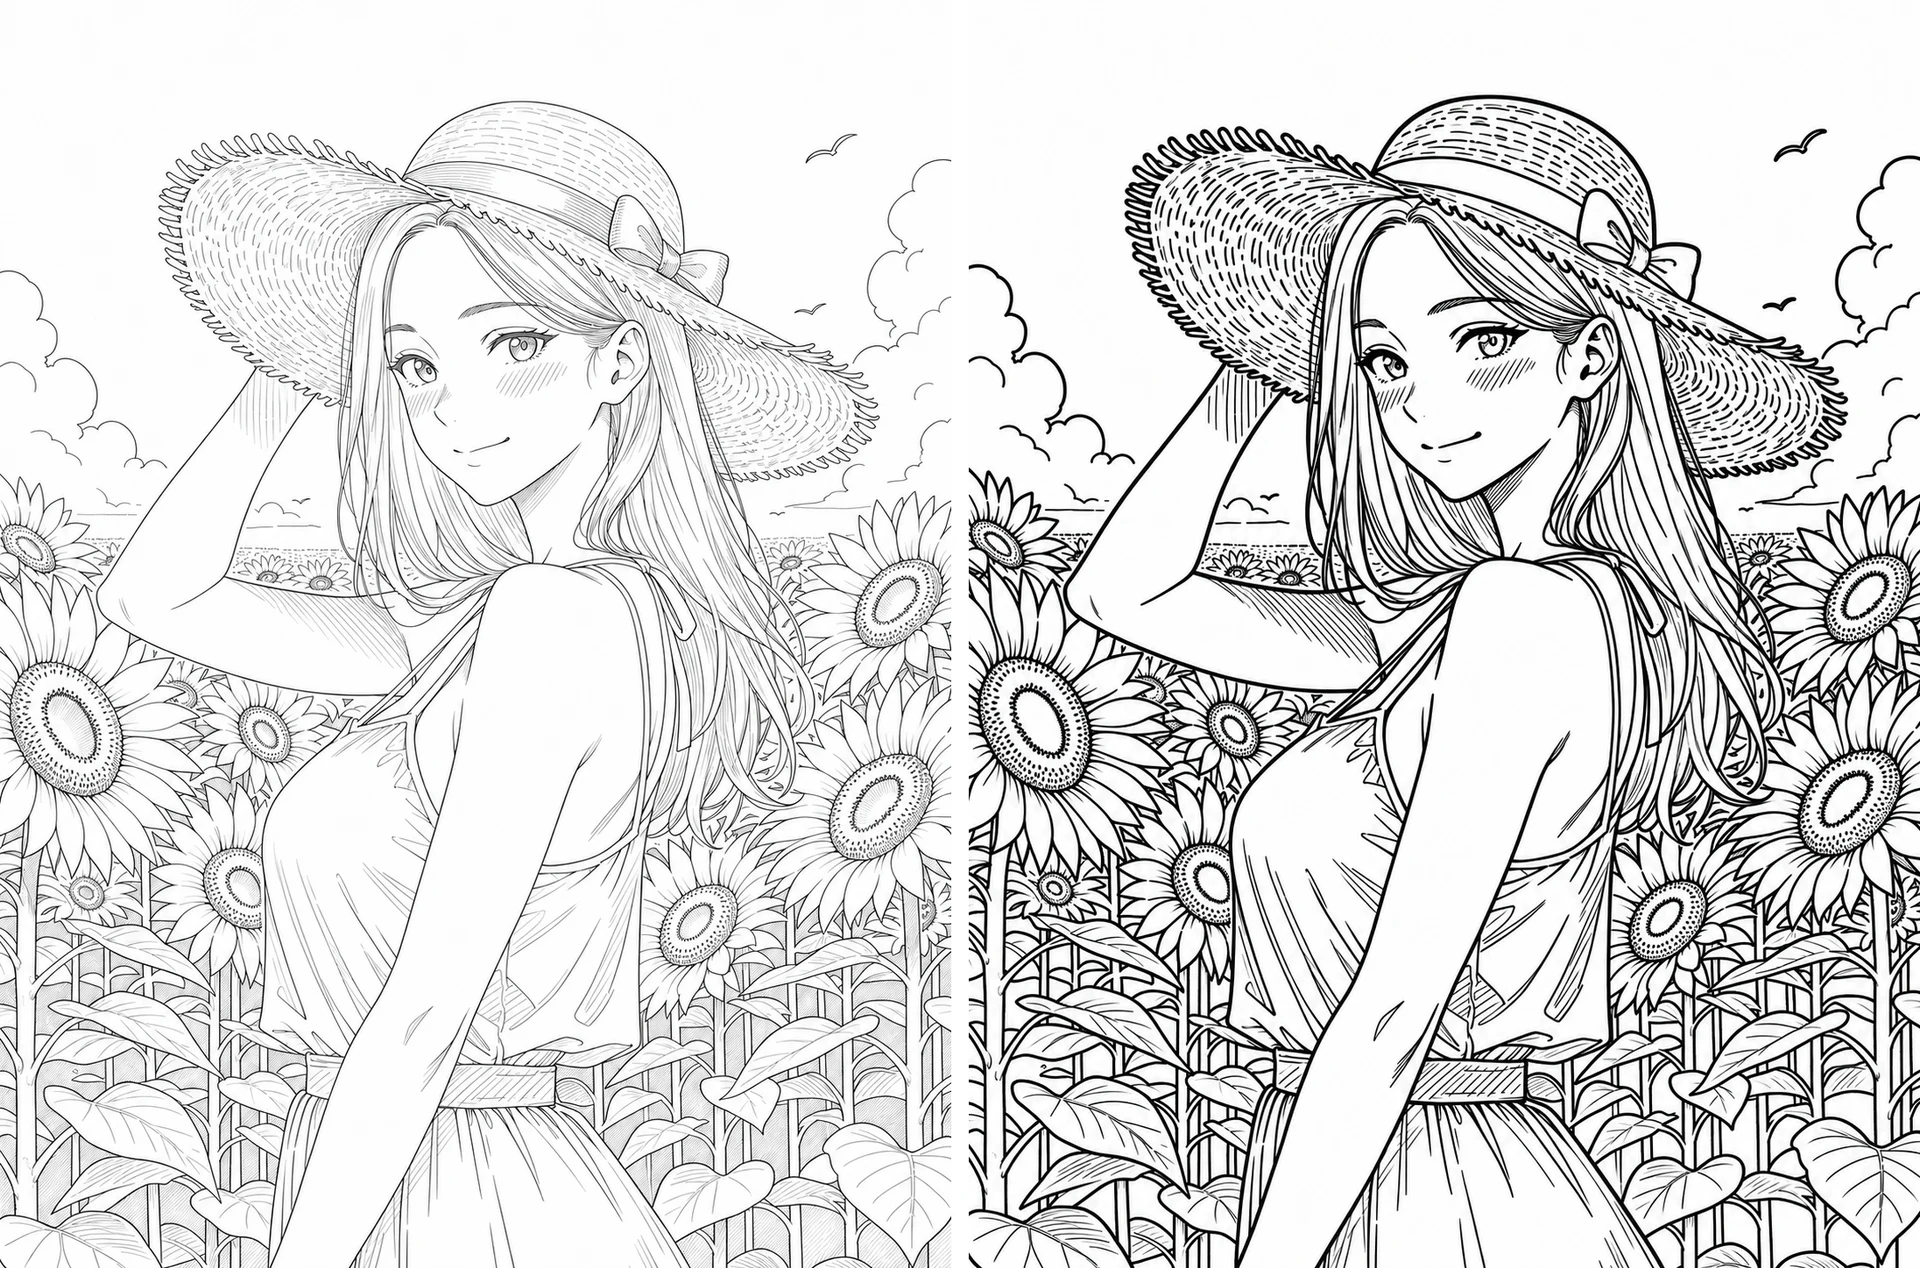
今回作りたいのは「適用すると線が太くなるLoRA」です。そのため、Copitaでは左に太線版、右に細線版を入力します。逆にすると、線を細くする方向のLoRAになります。
ペアの作り方は簡単。まず元になる線の細い画像をSDXLでtxt2imgし、それをControlNet「Anytest v3」で参照させ、「BoldLoRA」を強度1.5で適用して太線版を作るだけです。
ただ、SDXLで「monochrome」指示をして生成したところ、このように微妙にセピア色になってしまったため、画像編集ソフト(クリスタ)で彩度を0にしてモノクロ化しました。また、ピンクの矢印をつけた部分は元画像にない要素がBold化の際に付け加えられてしまったので、差分の純度を高めるために手描きで消しています。
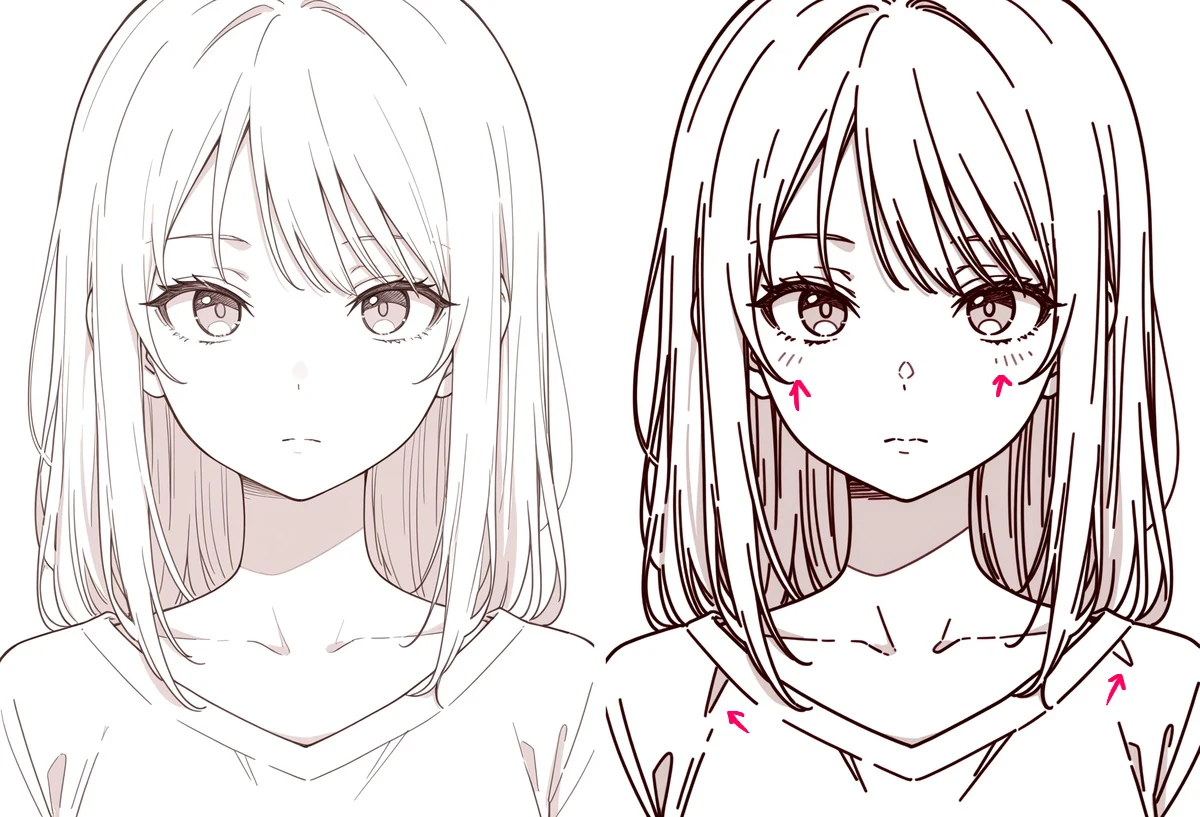
もちろん、ChatGPTなどに左を入力して「線画は一切ずらさずに、線を太くして」と指示することでも比較画像は作れます。各自やりやすい方法で作りましょう。
では、こちらのペアで学習開始します。自動検出されたタグに「monochrome」が抜けていたので、書き足しておきます。(1girl, solo, long_hair, looking_at_viewer, simple_background, shirt, white_background, closed_mouth, collarbone, upper_body, medium_hair, expressionless, portrait, monochrome)
詳細学習モードで45分ほどで終了。さっそくAnimaに適用して生成してみます。
こちらがLoRAを強度別で適用した生成結果です。一番上がマイナス適用で線が細く、一番下が太くなっています。
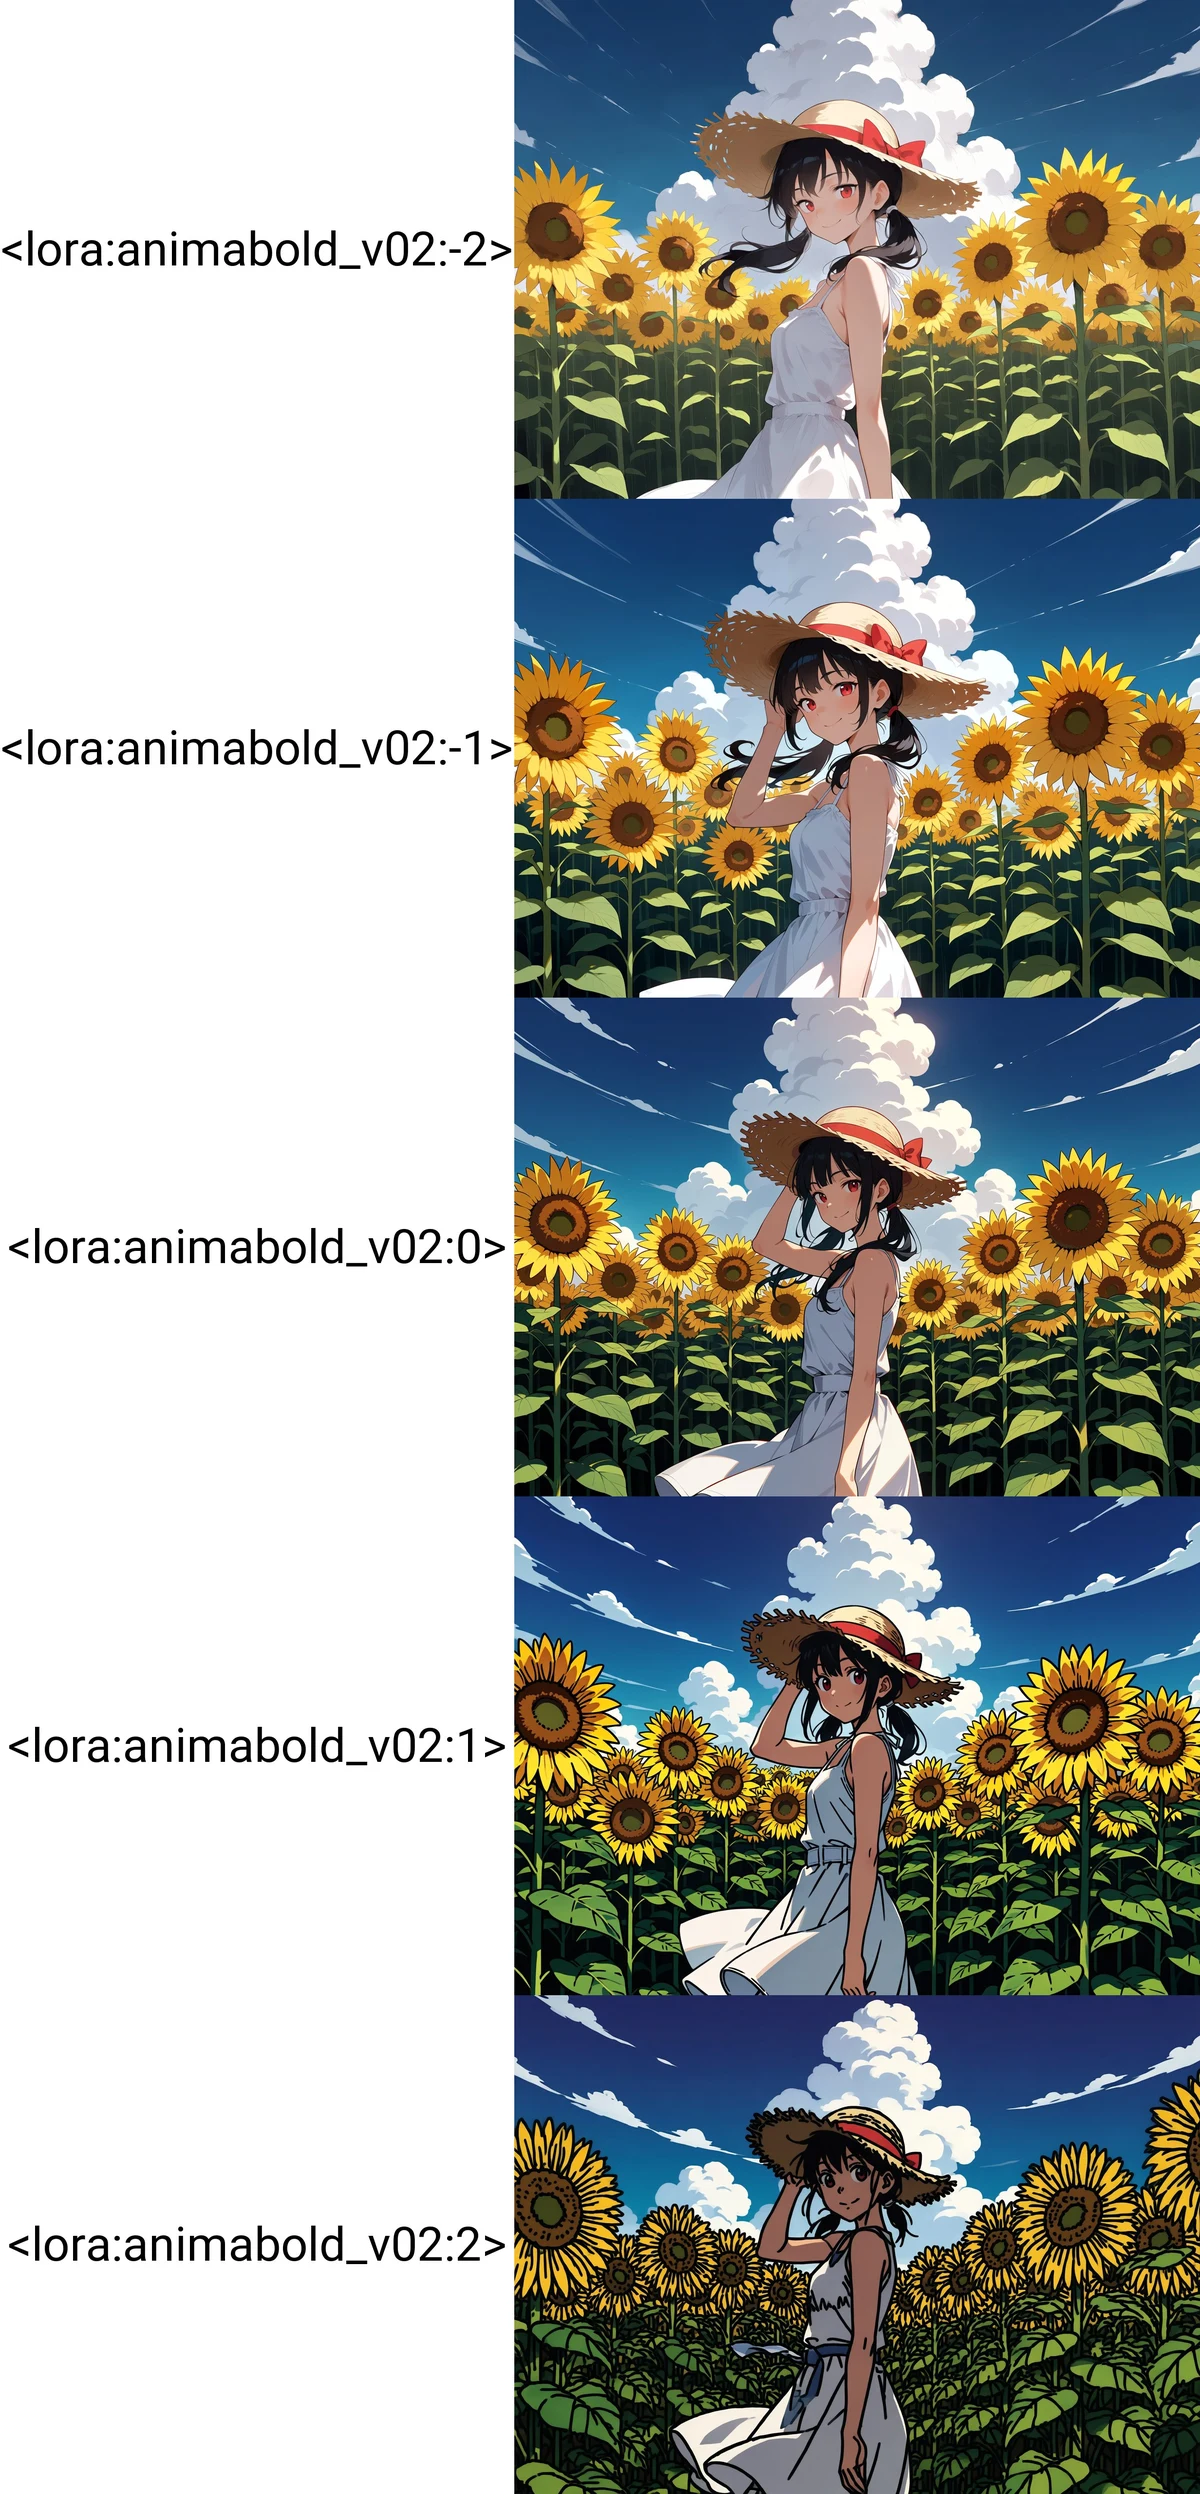
狙った効果はきちんと生じていますし、マイナス適用するとちゃんと線画が細くなっていますね、ただ、月須和さんのBoldLoRAほど純粋に差分を抜き出しきれず、絵柄や構図に影響してしまっています。詳細学習モードのdim16が悪い方に働いて、線の太さ以外に余計な要素を学習してしまっているように見えます。
<副作用の少ないスライダーLoRAにするには?>
さきほどの入力画像はSDXLで作ったものだったので、Animaのベースモデルと画風が遠く、そのせいで構図に影響が出てしまった可能性もあります。また、強度2まで強めないと狙った効果が出ないのではちょっと使いづらいため、もっとペア間の差分を広げたいところ。そこで、次はベースモデルを「WAI ANIMA」に変更し、同じWAI ANIMAの画風で作った画像ペアで差分学習させる作戦でいってみます。
まず用意したのはこちらの画像。WAI ANIMAで「1girl, solo, cowboy shot, monochrome, black hair, safe, black eyes, white t-shirt, bob cut, looking at viewer, white background, simple background」で作った「マスピ顔」の画像です。
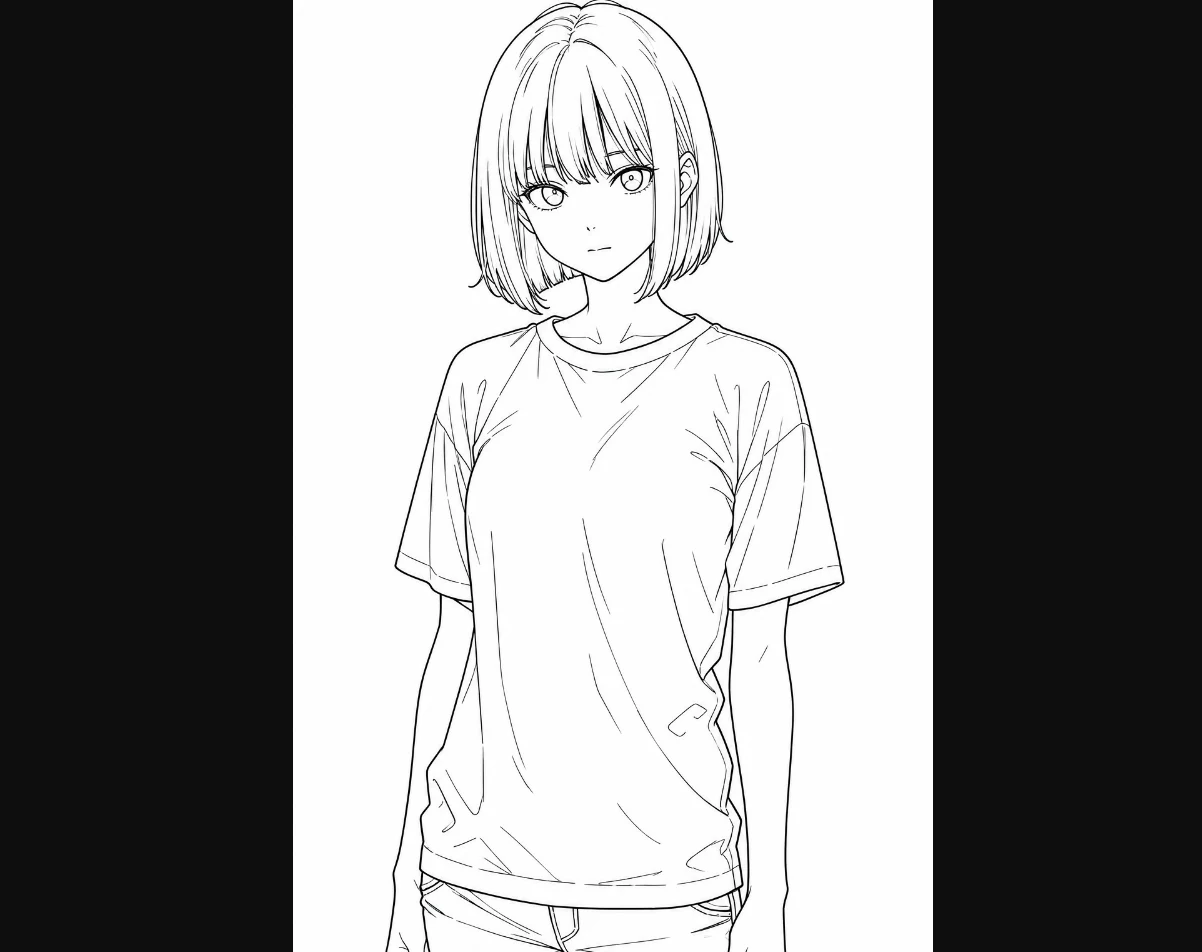
こちらをChatGPT-5.5でこのように指示し、線を太くしたものと細くしたものを入手します。そうすることで、ペア間の線の太さを大きく突き放します。
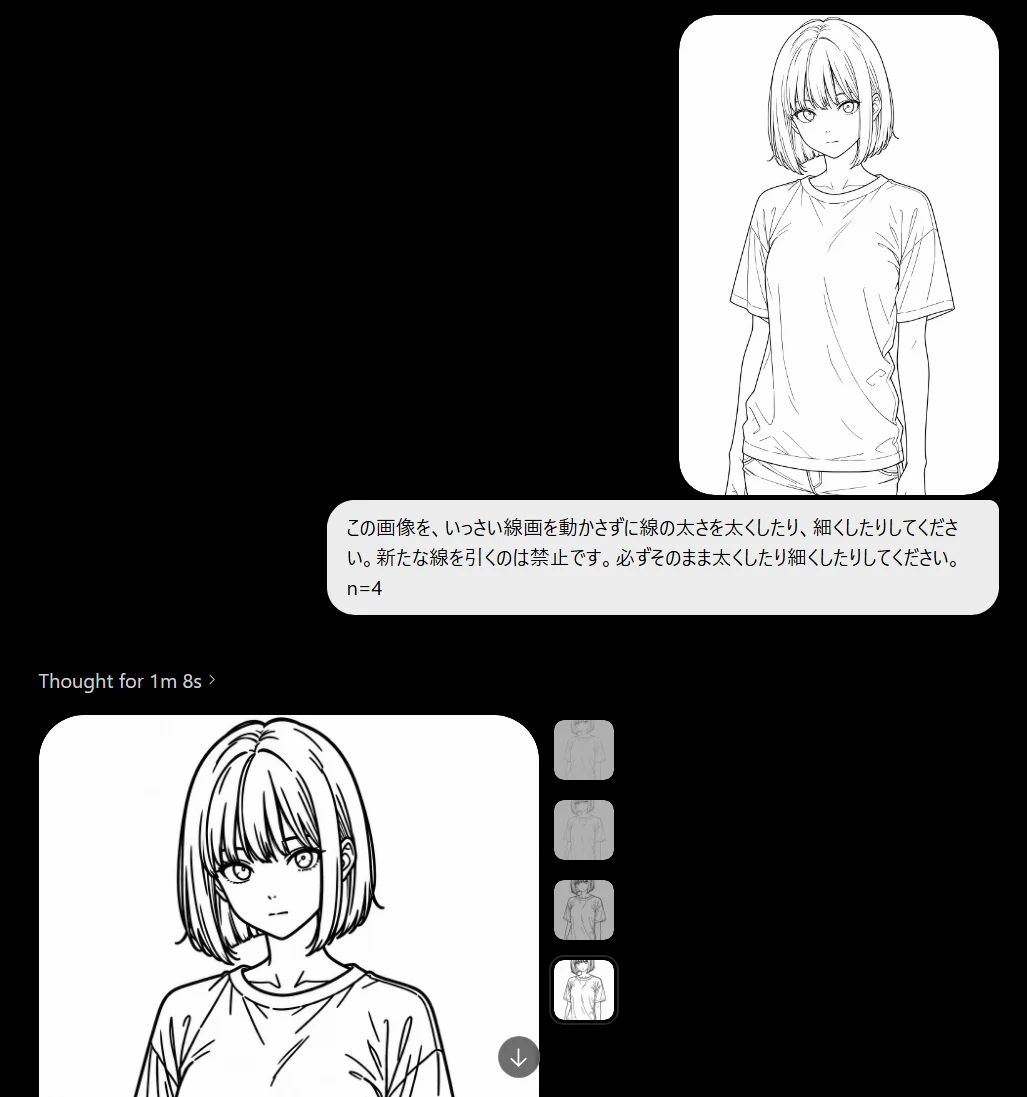
こちらができたペア。ベースモデルの典型的画風で、線画の太さだけをしっかり変更できました。
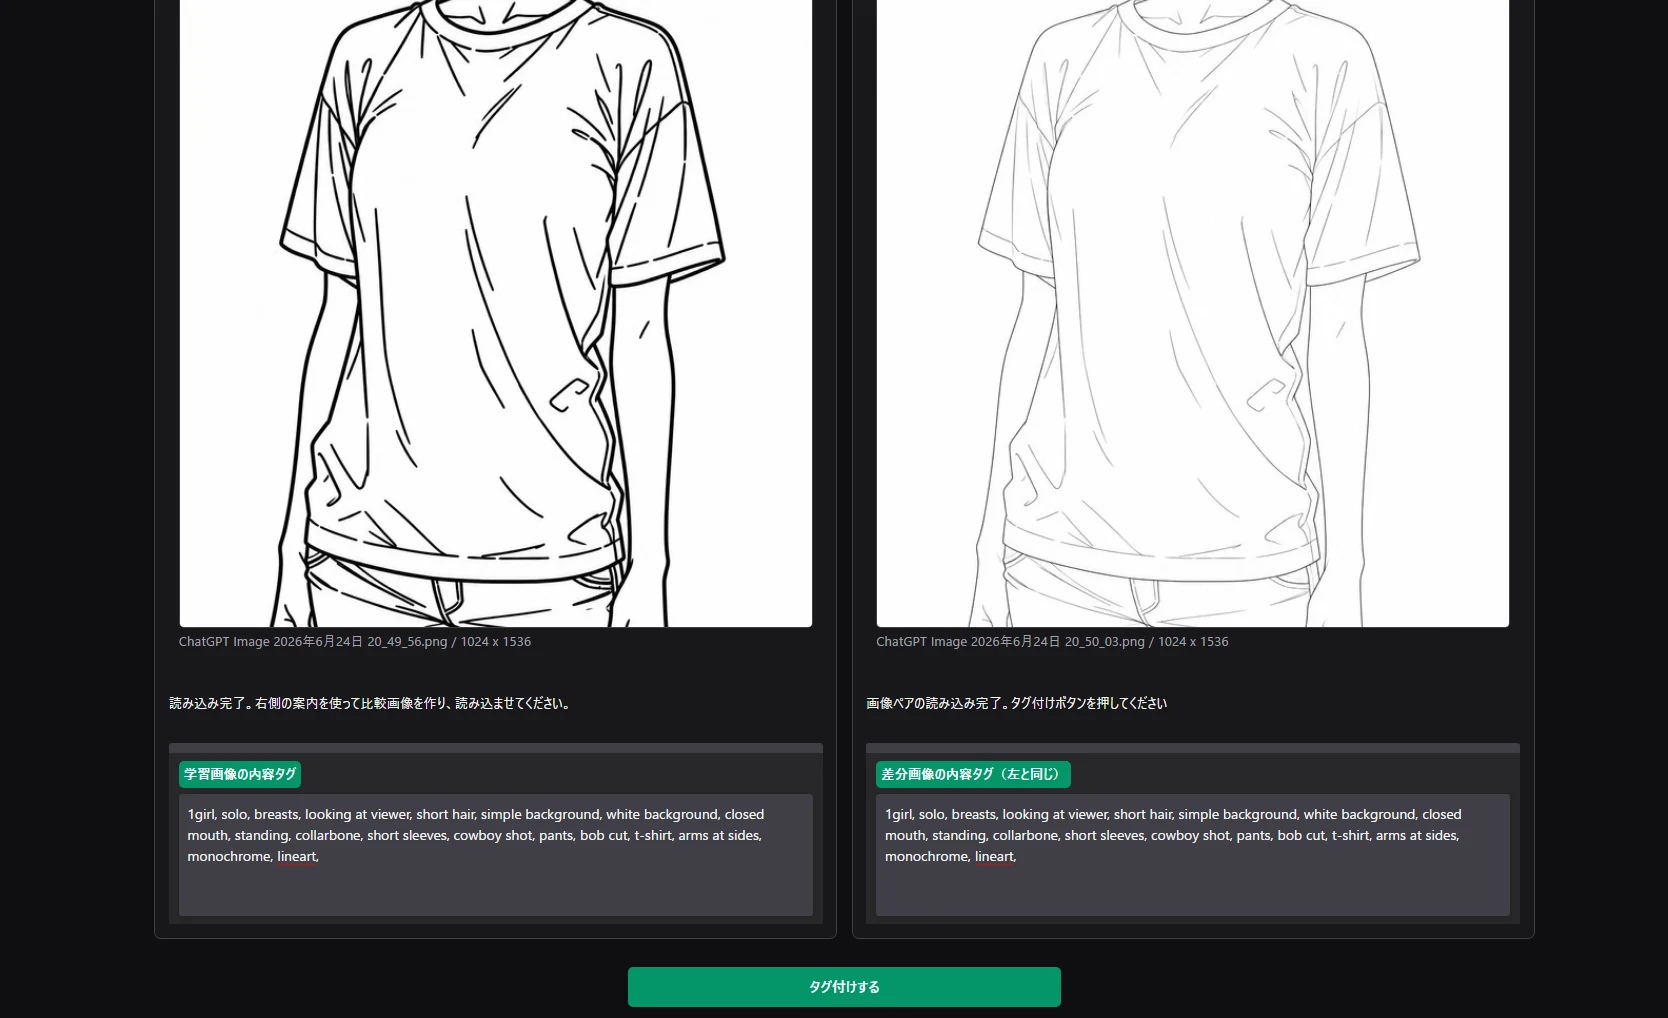
ペアを入力し、タグ付け。monochromeとlineartを追記しました。再確認ですが、LoRAを適用したら線画が太くなるLoRAにしたいので、左に太い方、右に細い方を入力しています。
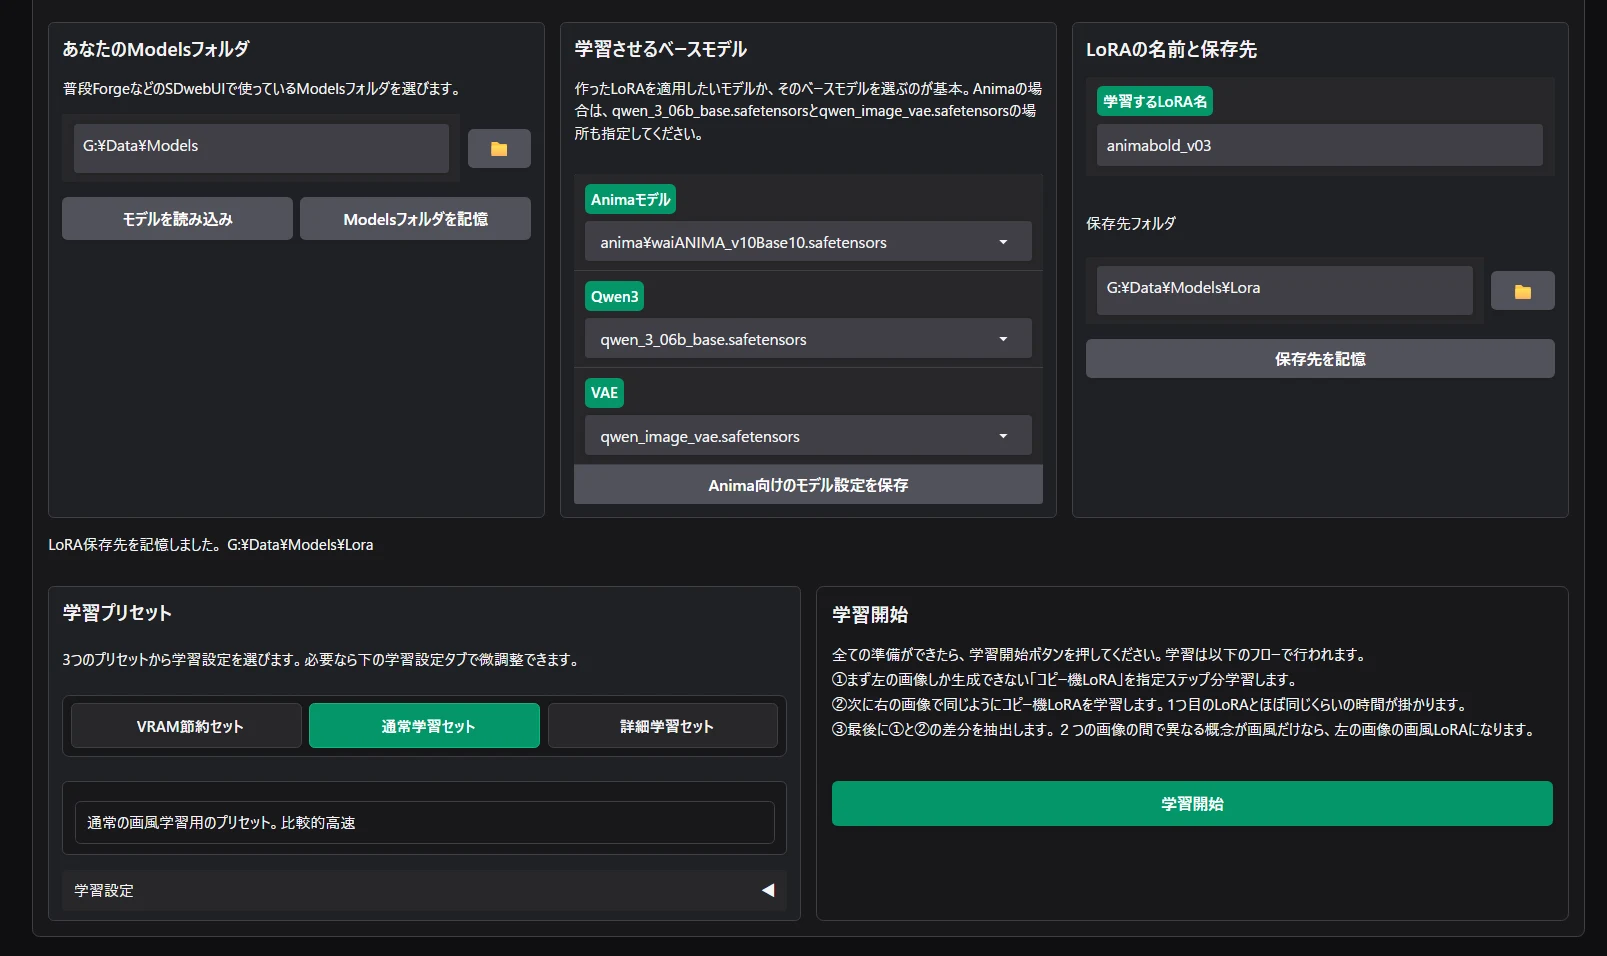
今度はベースモデルを「waiANIMA_v10Base10」に変更し、dim8の通常学習セットで学習開始してみます。dimを16から8に下げたので、余計な画風の学習は少しおさまるはずです。
こちらが生成結果。
構図への影響が出ていますが、dim16のときよりは控えめになったように見えます。また、線画の太さの差を前より突き放したので、より線画がきっちり太くできました。
逆にdimを上げると本当に構図への影響が大きくなるかどうか確かめたくなり、dim64/alpha32に変更、stepsを600ステップに増やしてみるとこうなりました。
思った通り、線の太さ以外に余計なものを学習しすぎて、構図に影響するどころか破綻してしまいましたね。
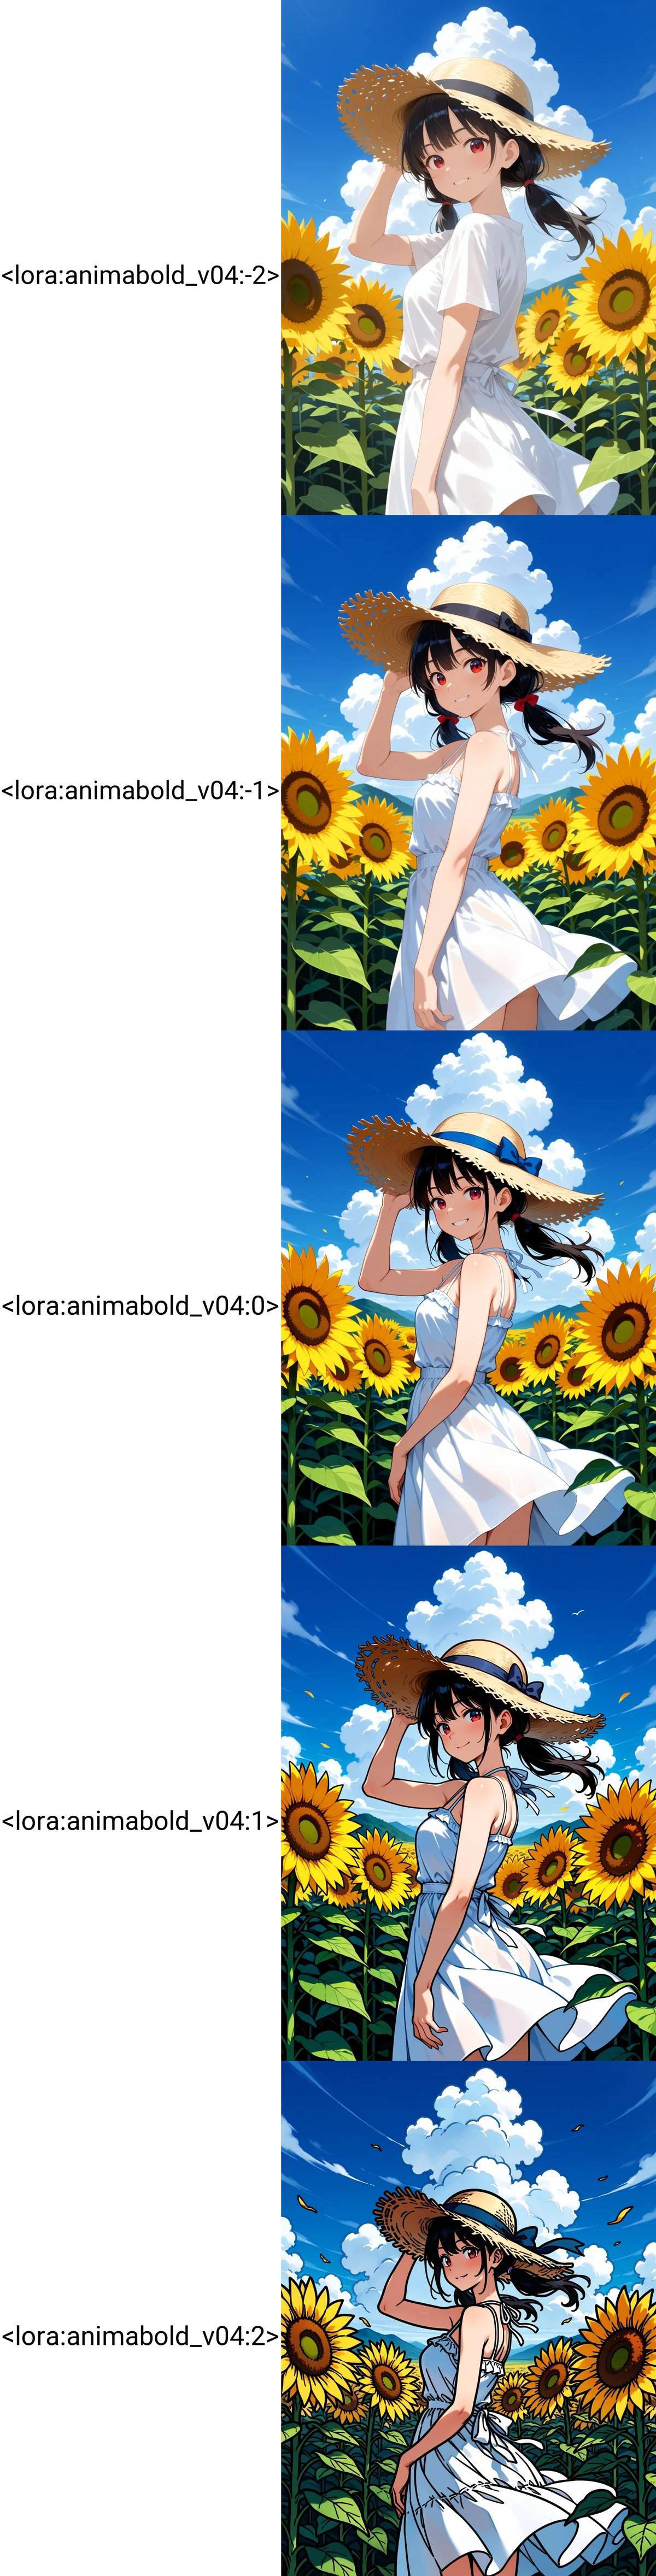
やはり概念が単純なスライダー系LoRAでは、できるだけdimを下げた「単純バカ」な🤖のほうが良い結果が得られそう。というわけで、こちらが最後に作ったdim4/alpha1、300ステップの生成結果です。
これを見ると分かる通り、
「単純なスライダーLoRAならdim4~8程度が良さそう」
「高すぎると余計な要素を学習してしまう」
「1回の差分学習で完璧なスライダーLoRAにはならない」
ーという想定通りの結果になりました。
上図を見ると、LoRAの適用強度を強めるほどにカメラが引いてパンチラ構図になってしまったり、帽子のリボンの色が変化しているのがわかります。月須和さん謹製のSDXL向けBoldLoRAのように、Anima用でももっと高品質なスライダーLoRAを作れないものでしょうか?

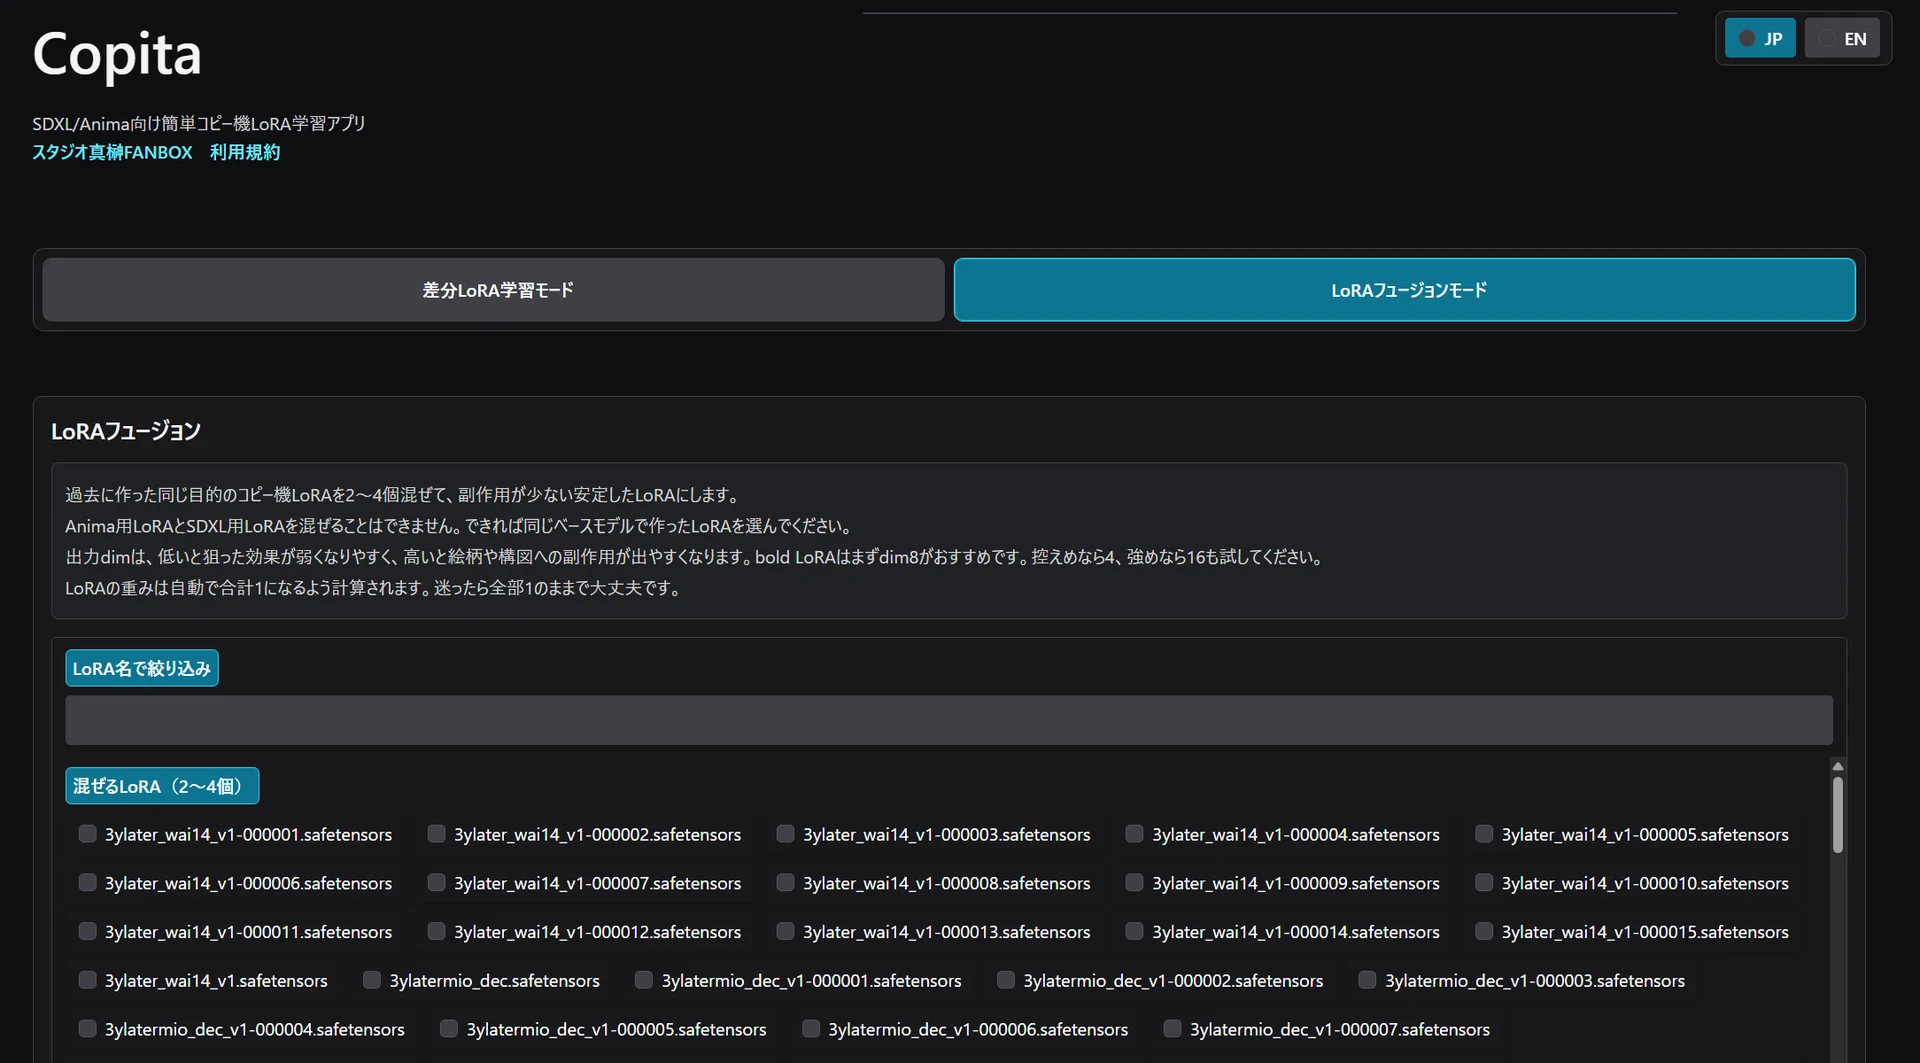
実験機能「LoRAフュージョン」
そこで開発したのがこちらの「LoRAフュージョン」モード。Copitaの最上部から選択することができます。
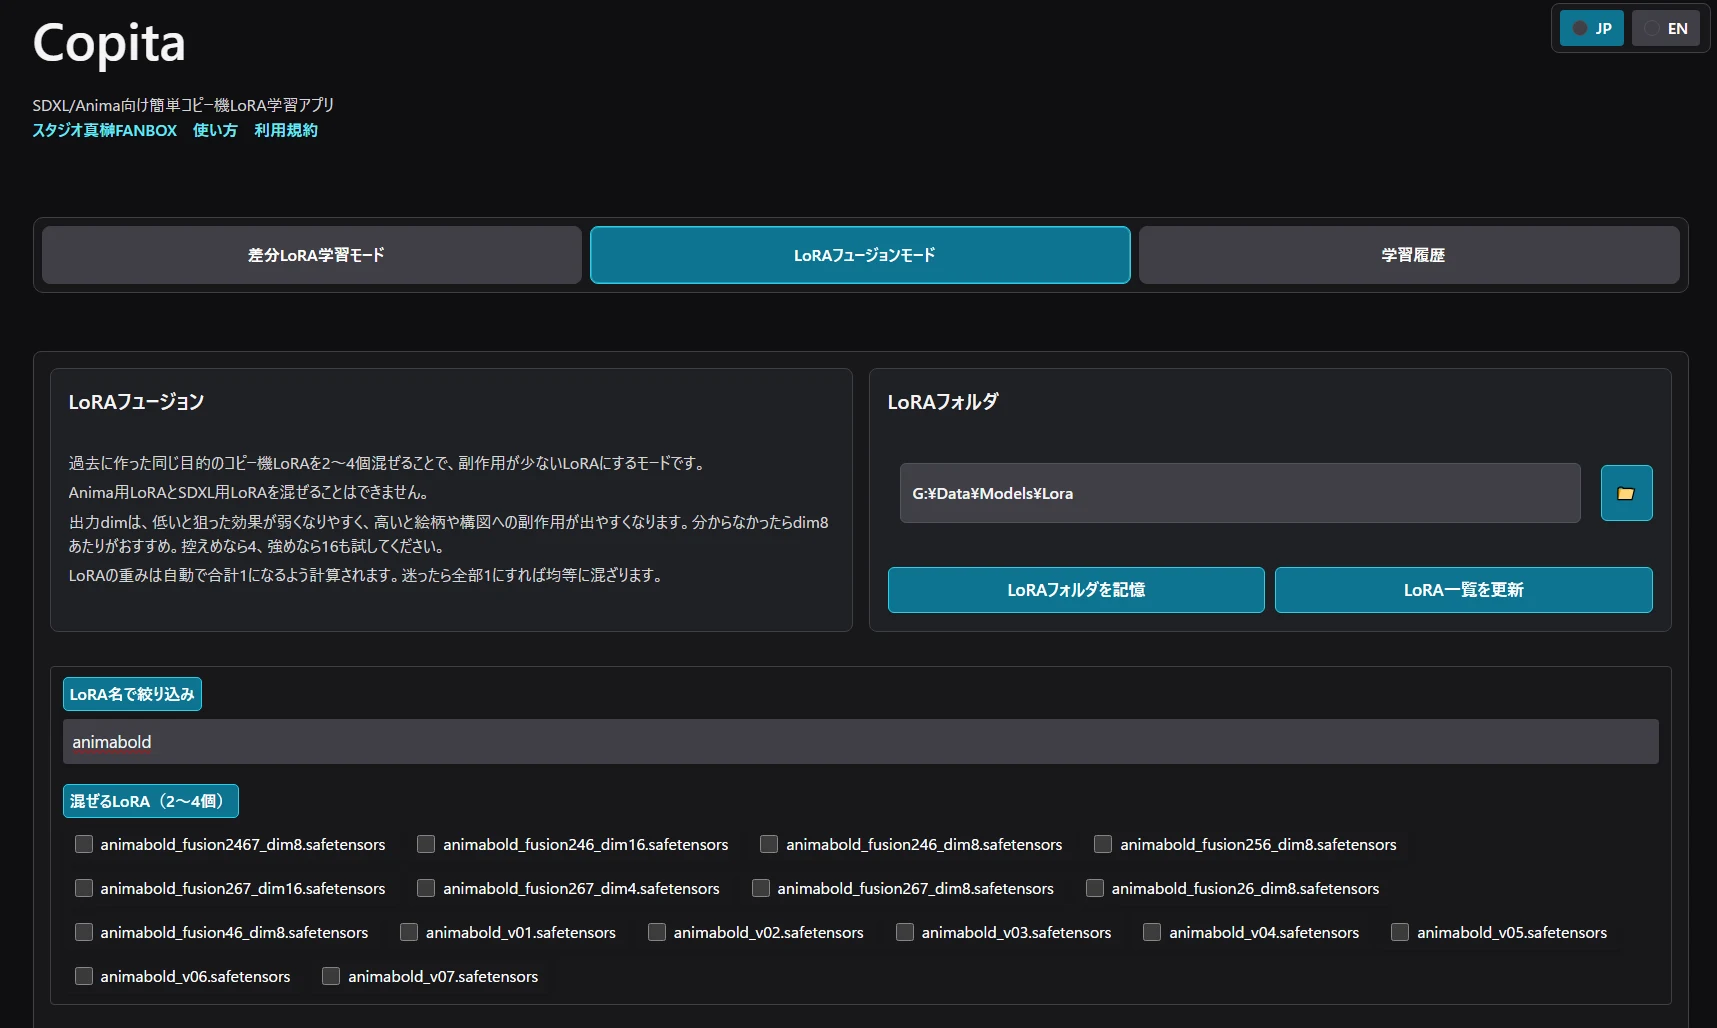
これは、過去に作った同種効果のLoRAを2〜4個混ぜて圧縮することで、より安定したLoRAを作る機能です。複数のLoRAを重み付きで混ぜ、指定したdimのLoRAとして近似出力するので、共通する効果だけを機械的に抽出できるわけではありませんが、異なる副作用を持つLoRAを平均化することで、狙った効果が残りやすくなります。
例えば、さきほどの画像ペアで作ったAnima用BoldLoRAは構図や被写体への影響が避けられませんでしたが、他の画像ペアで作り直しても、恐らく毎回異なる副作用が混じるはずです。ただ、ペアごとに混入する副作用は異なっても、「線を太らせる」という効果だけは共通しているはず。そこで、複数の試作LoRAを合体させて、共通する「線を太らせる効果」をできるだけ残し、副作用を軽減することを狙ったのが、このフュージョンモードというわけです。
文字だけでは分かりにくいので、実際にやってみましょう。
<LoRAフュージョンの方法>
使い方は簡単で、保存先フォルダにあるLoRAをリストから2〜4個選び、重みを指定して、出力名を決めて「フュージョン開始」を押すだけ。いちから学習するわけではないので、短時間で完了します。LoRA名の一部を入力欄に記入すると、絞り込みを行うことができます。
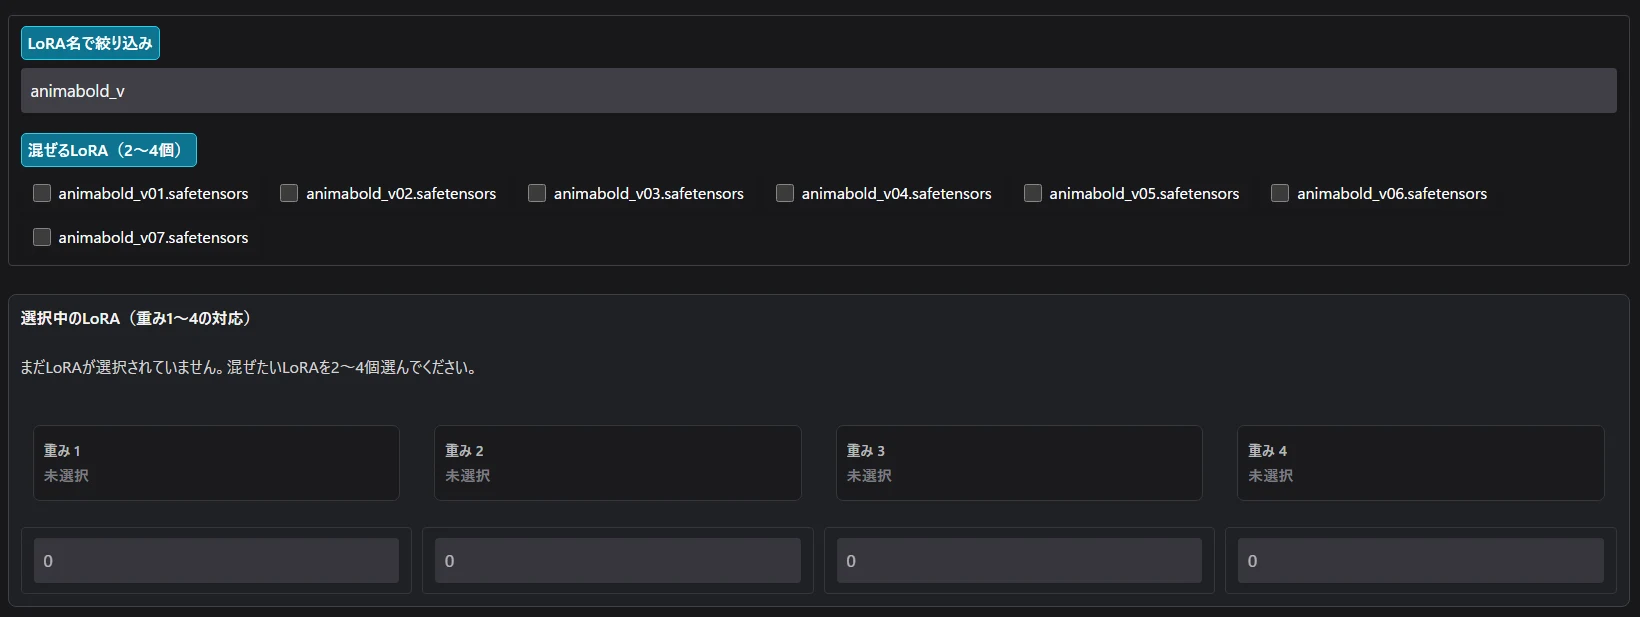
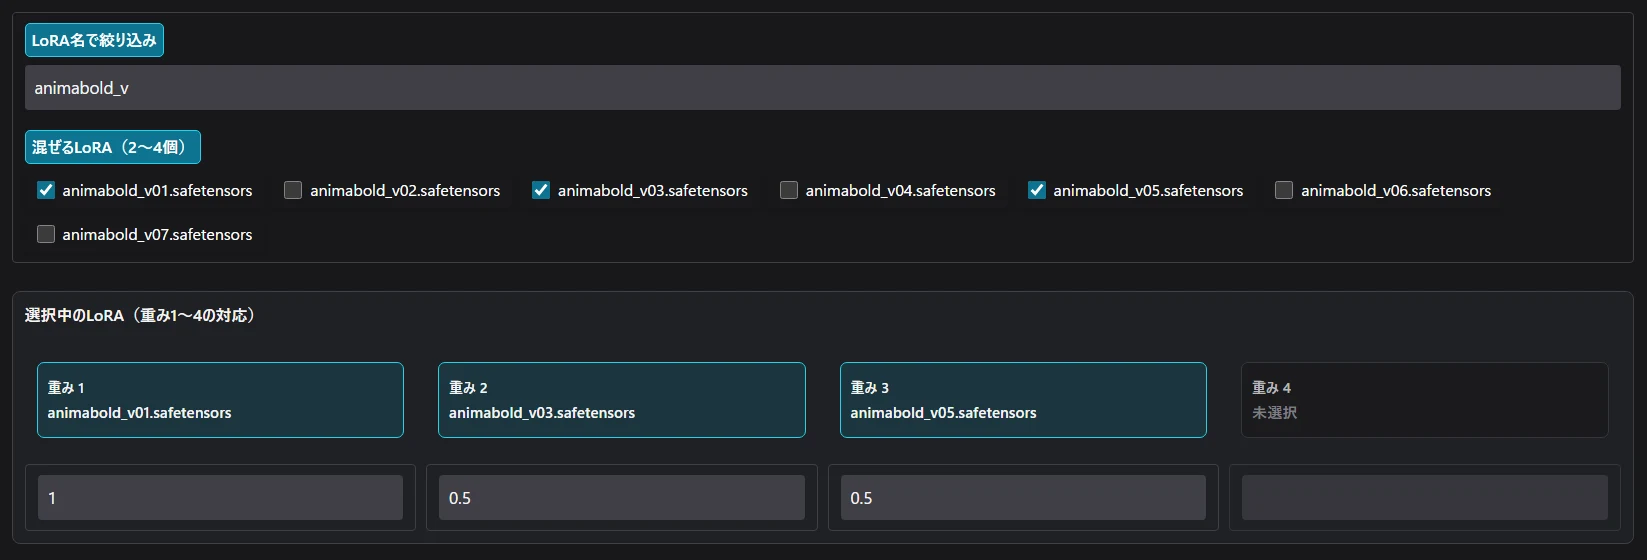
重みは「0.25・0.25・0.5」のように揃えなくても、合計1になるよう内部的に自動計算されますので、迷ったら全部1のままでOK。BoldLoRAを純粋化させる用途だけでなく、顔の描き方LoRA、全身の画風LoRA、色の塗り方LoRAを1:1:1や2:3:1といった好みの比率で混ぜて、より理想的な画風LoRAを作る、といった使い方もできます。
例えば、このように「1:0.5:0.5」と記入しても、「2:1:1」と記入しても結果は同じです。
ただし、SDXL用LoRAとAnima用LoRAは混ぜられませんので、同じモデル種別、できれば同じベースモデルで作ったLoRA同士を選んでください。構造が大きく違うLoRAは混ぜられないか、混ぜられても期待した効果が得られない可能性が高いです。

BoldLoRAで検証
今回、他にもこちらのようなさまざまなペアでBoldLoRAを作ってみました。v1~v7まで作りましたので、そのうちまともな効果が得られたv2、v4、v6、v7あたりをフュージョンに使ってみます。
v1.1からは、LoRAフュージョンモード内で直接LoRAフォルダを指定できるようになりました。差分学習モードで保存先フォルダを記憶している場合は、そのフォルダが自動で表示されます。
混ぜたいLoRAは2〜4個まで選択できます。選んだ順に「重み1」「重み2」…として表示されるので、それぞれの重みを指定してから「フュージョン開始」を押します。5個以上は選べません。
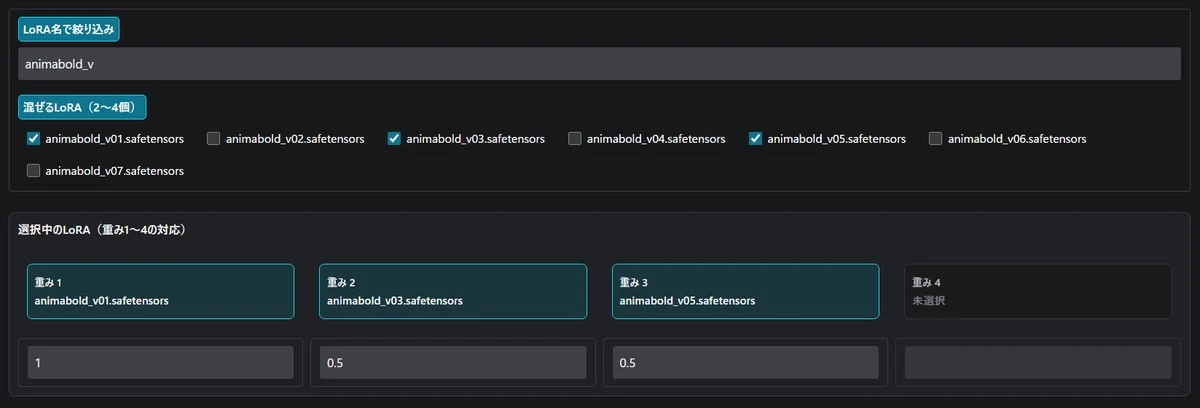
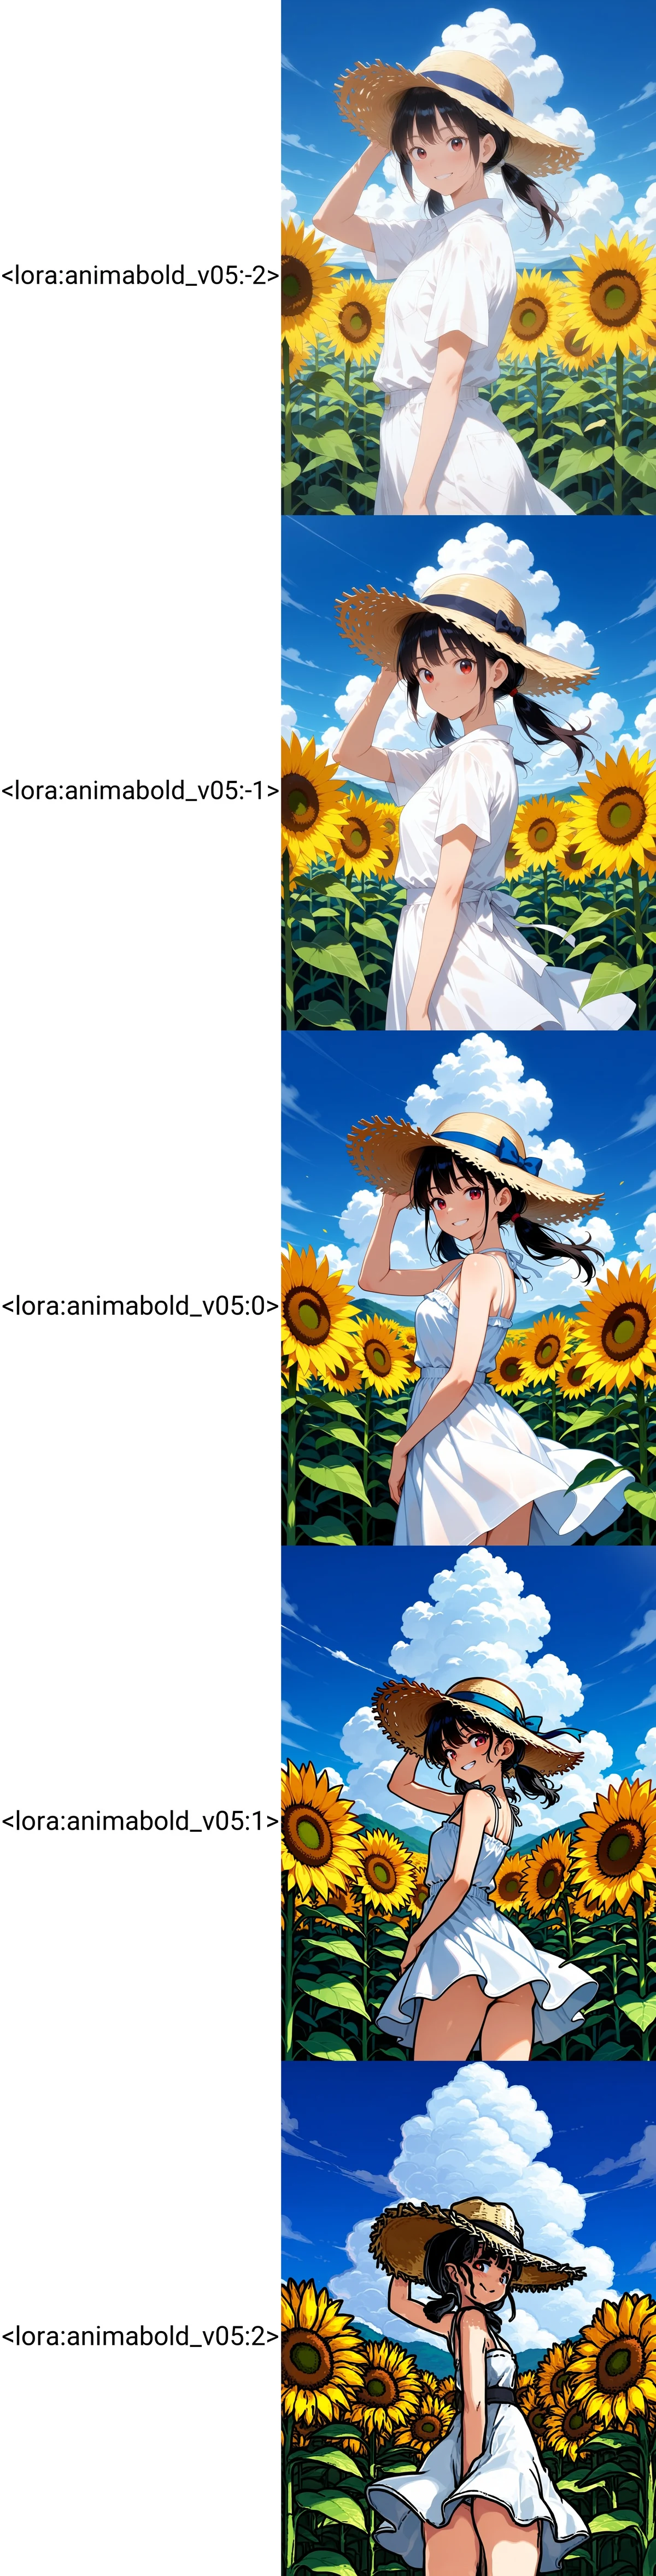
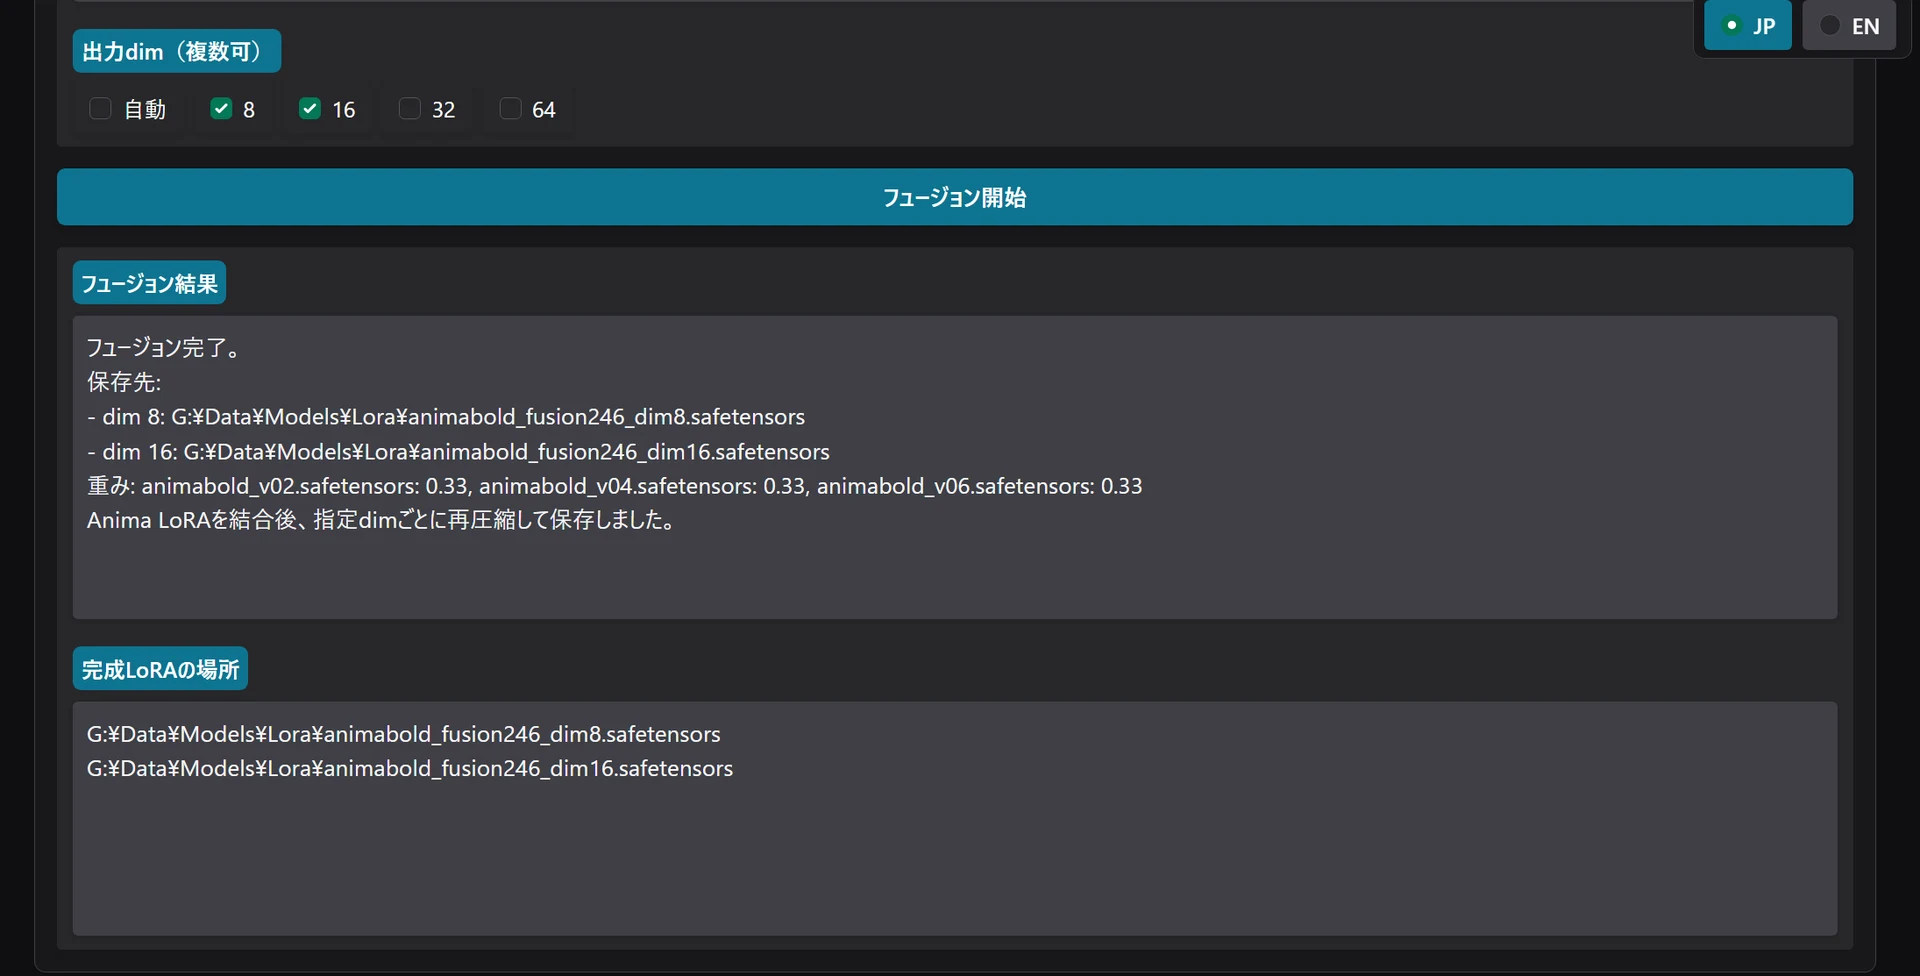
v02はdim16、v04はdim8、v06はv04と同じペアでdim4、v07はdim4と、それぞれ次元数が異なりますが、問題なく混ぜることができます。出力するdimは複数選べるので、8と16を選ぶとこのように出力されます。(これはv2v4v6を混ぜたもの)
こちらがv2v4v6v7を全部1:1:1:1で混ぜたフュージョンLoRAの生成例です。
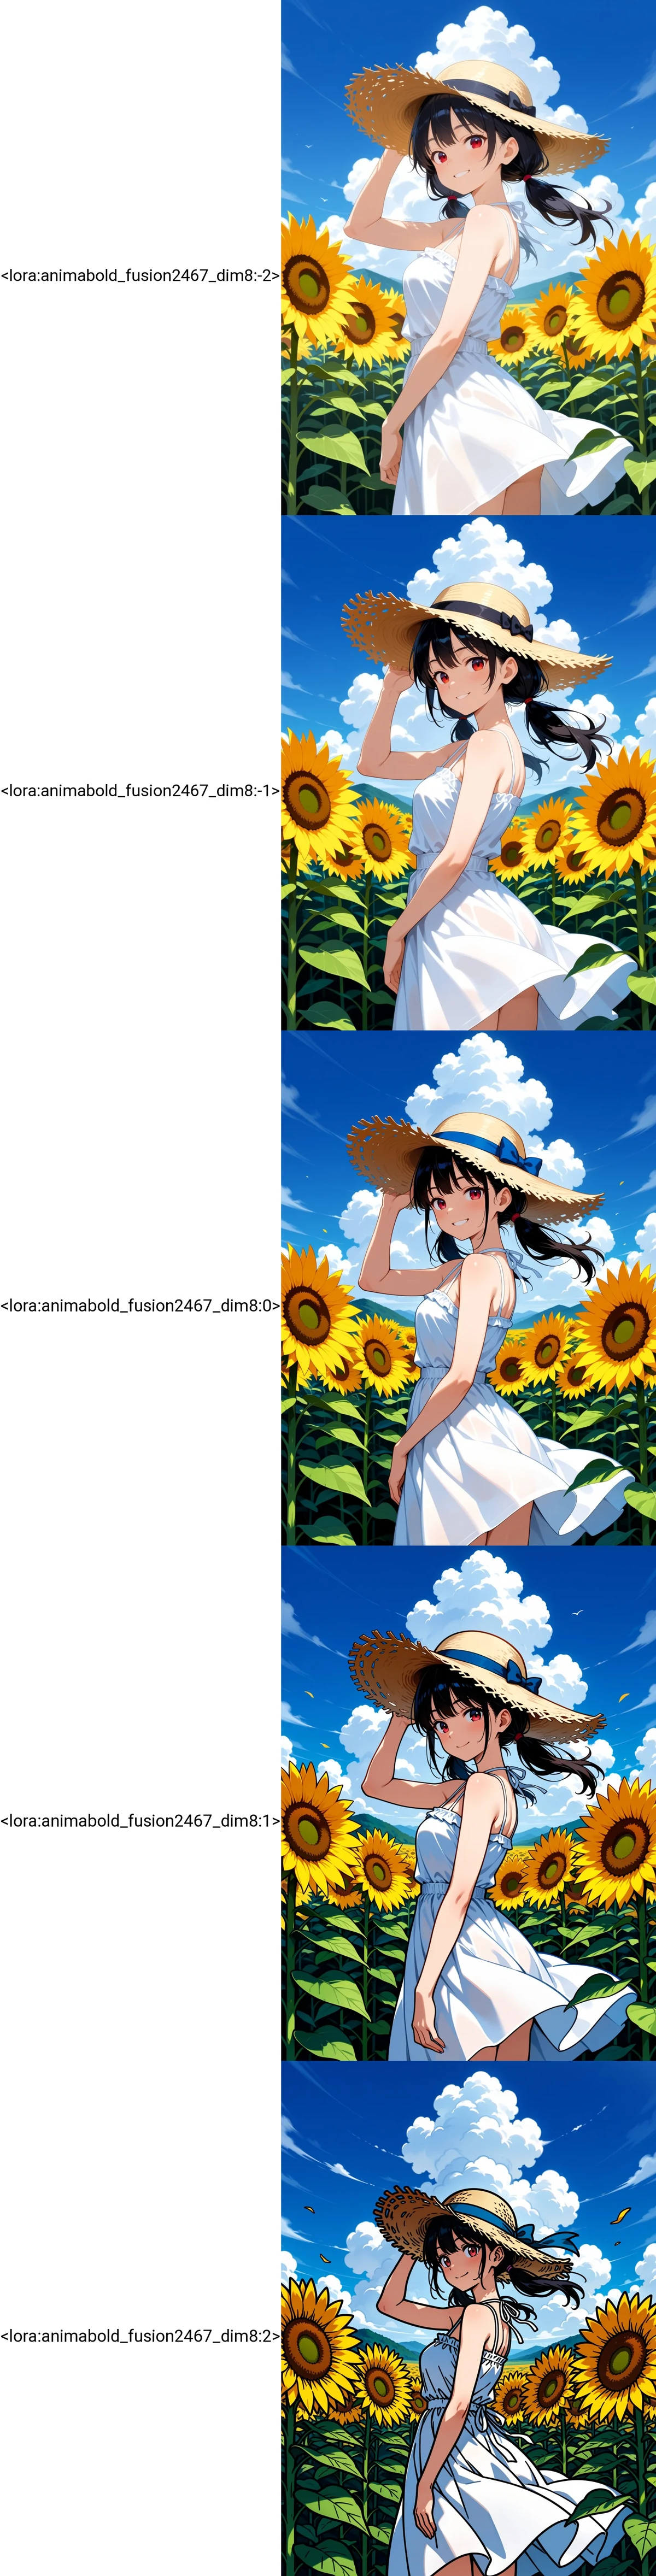
さきほど作ったLoRAは強度を強めるとどんどんスカートの位置が変化していましたが、こちらは構図や容姿への影響が抑制されていますね。帽子のリボンの色はやはり変化していますが、こちらのほうが変化の度合いが小さいことがわかります。
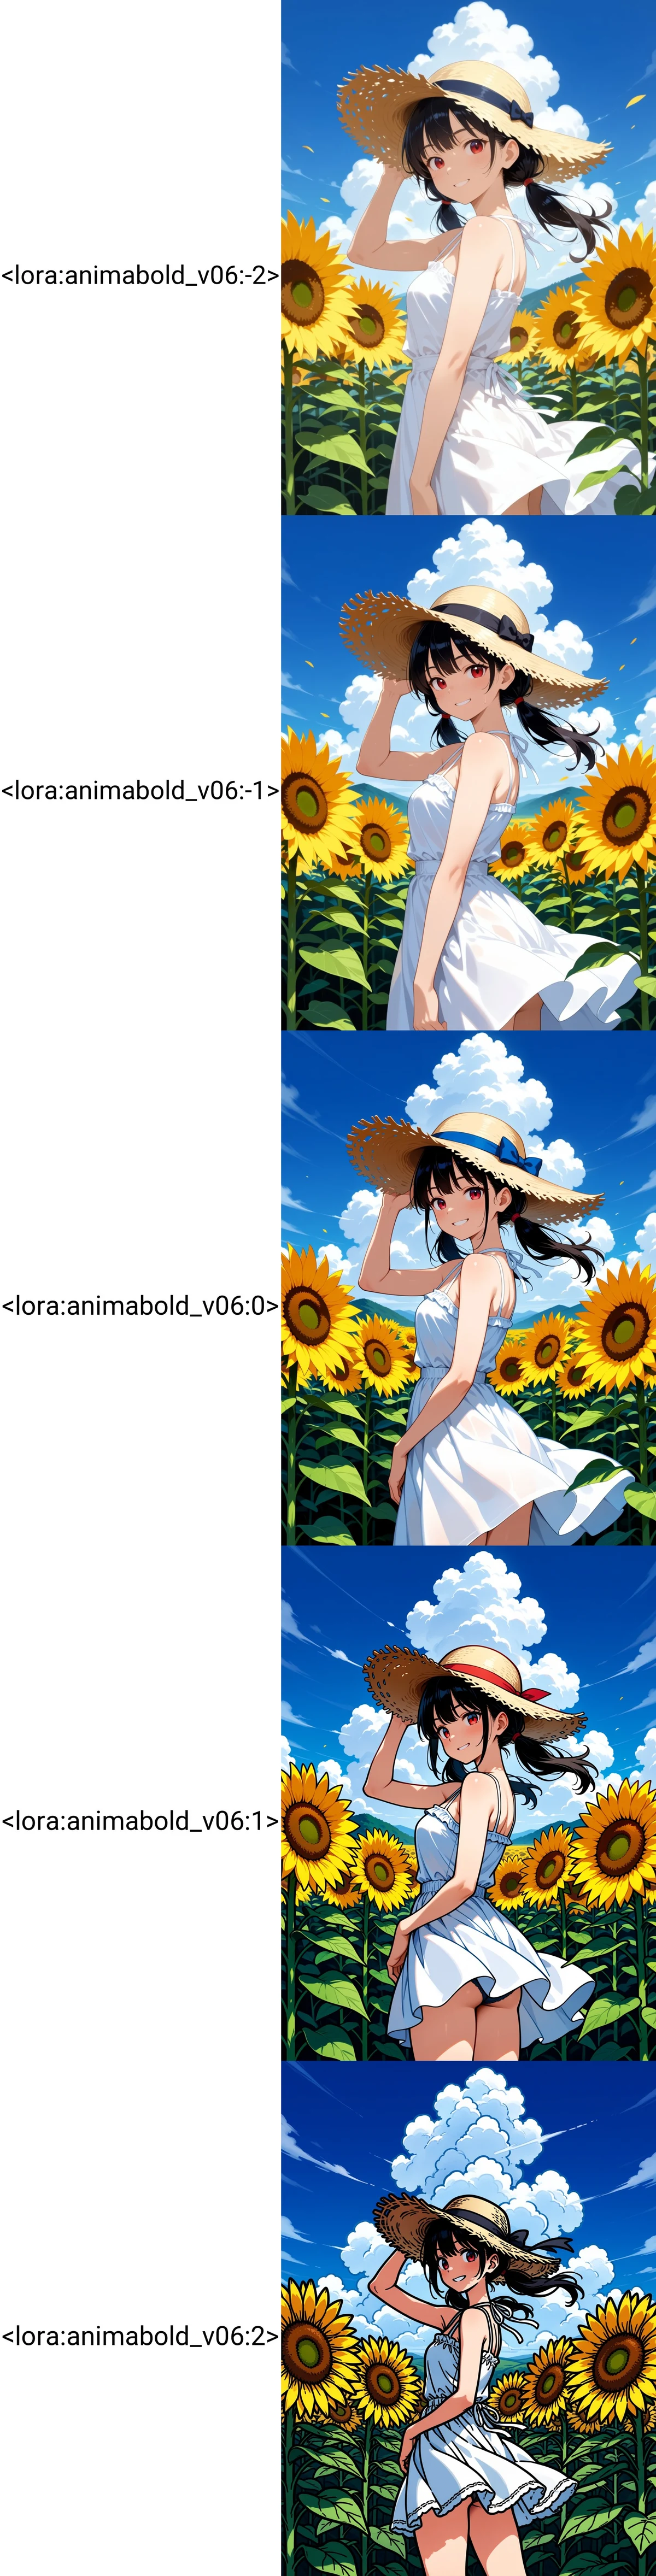
より分かりやすくするために、v06を左列に、フュージョンLoRAを右列に並べるとこうなります。右列は、右下のひまわりの葉とスカートの位置がほぼ変わらず維持できています。
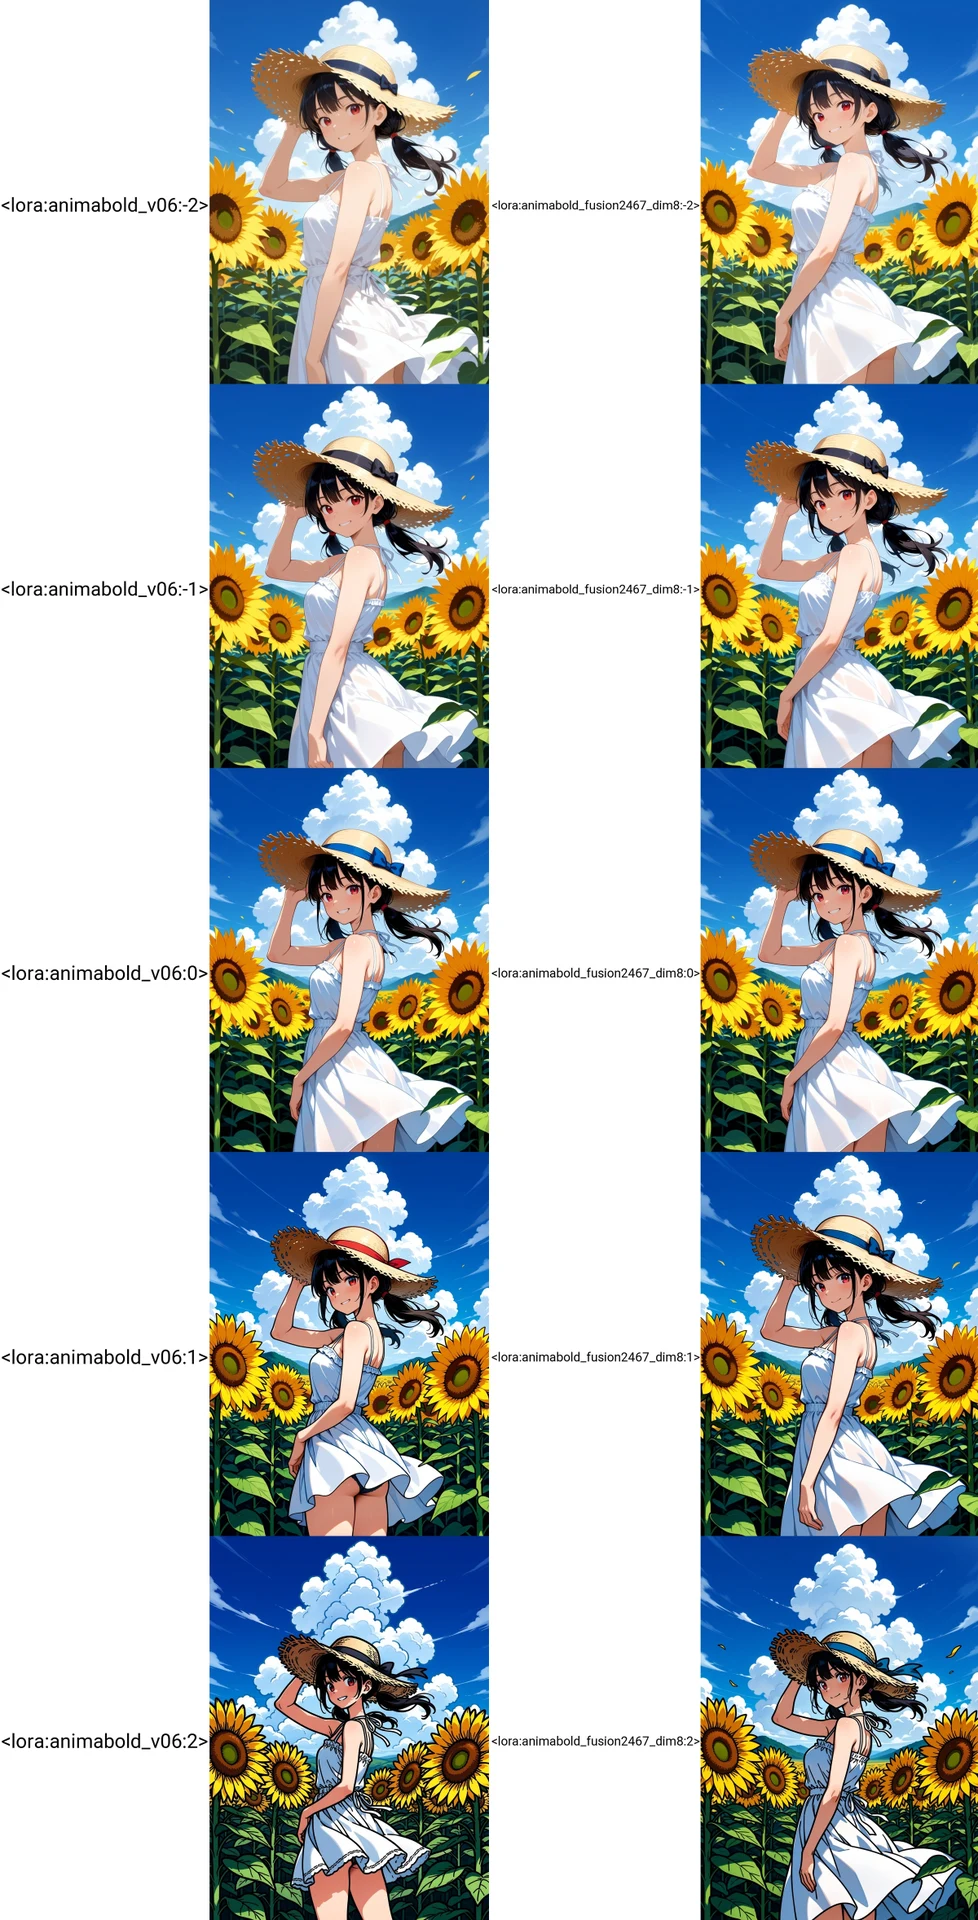
効果の薄いLoRAも混ぜて平均化しているので、向日葵や雲の線はやや太くなりきれていませんが、左列ではカメラが引いてパンチラしていくのに対して、右列はそこまで影響が強くありません。
v4とv6は同じペアのdim違いでしたので、絵柄の副作用が強い方の「v4」を排除し、v02・v06・v07で作ったのがこちら。
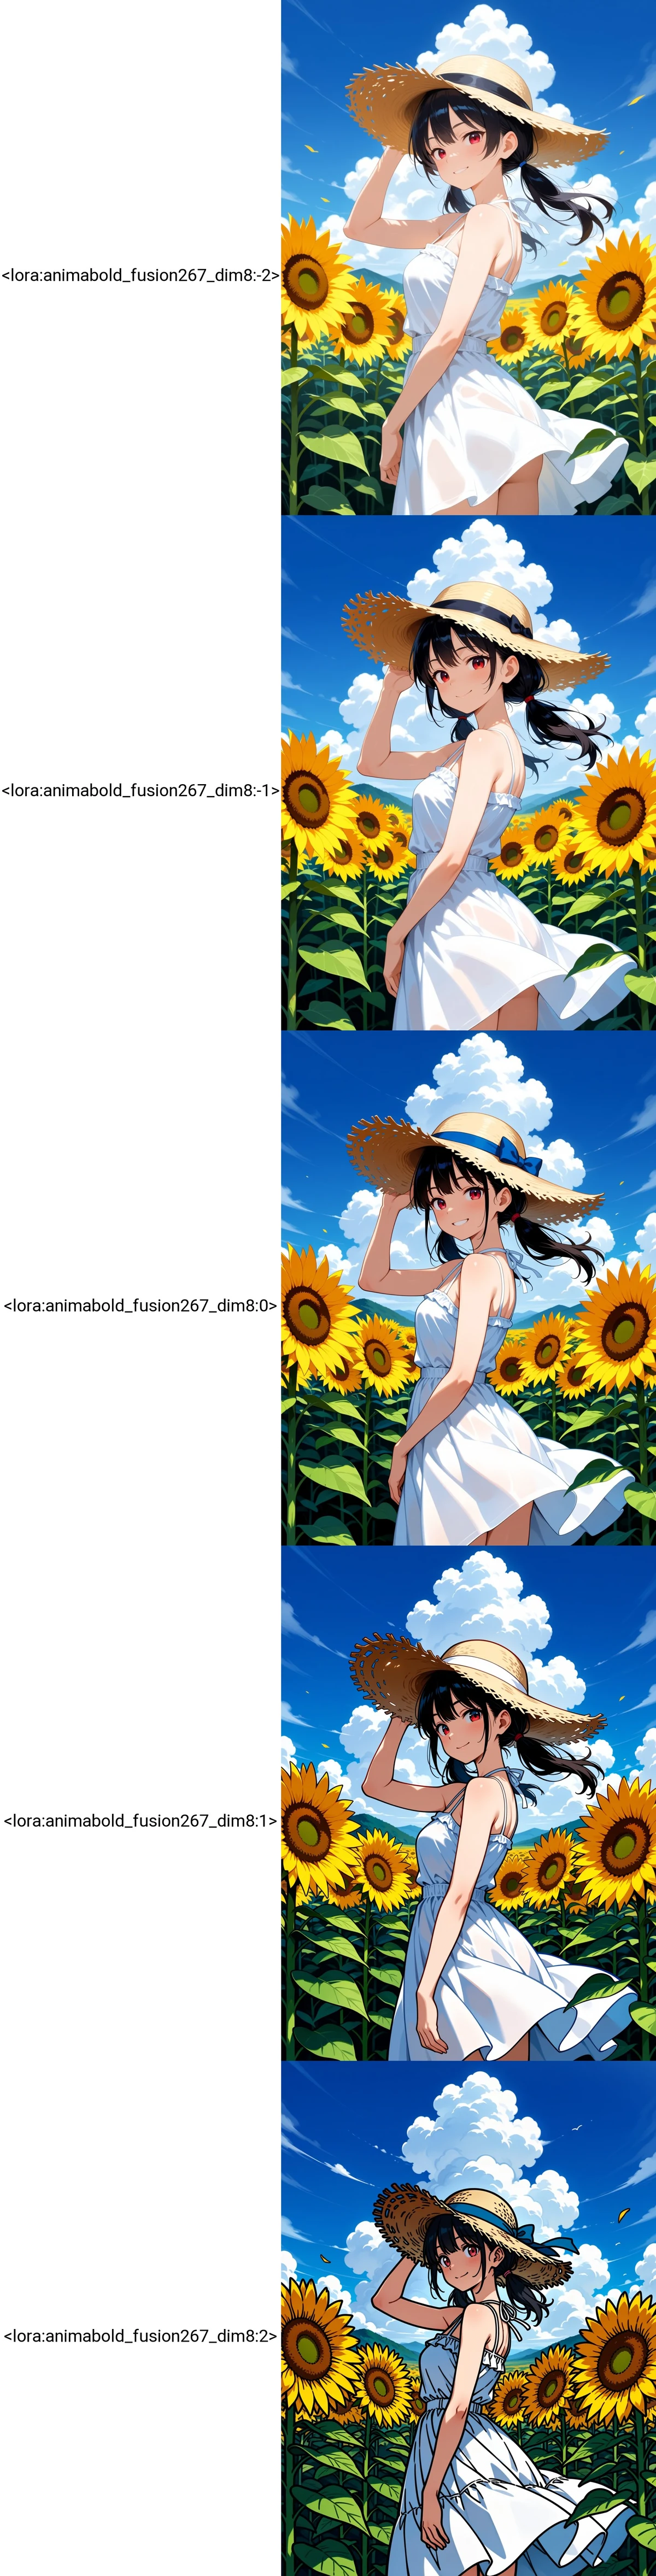
しっかり線画を太くする効果は出つつ、構図への悪影響を抑えることができました。今回は1:1:1で混ぜましたが、性能を踏まえて比率を変えるともっと良い結果にできそうです。
こちらのように別のプロンプトで試しても、-1~+1の範囲ならほとんど構図を変えずに線画を調整できるようになりました。LoRAフュージョンモードはあくまで実験的機能ですが、少なくともスライダー系LoRAにおいては一定の有用性があるように思います。
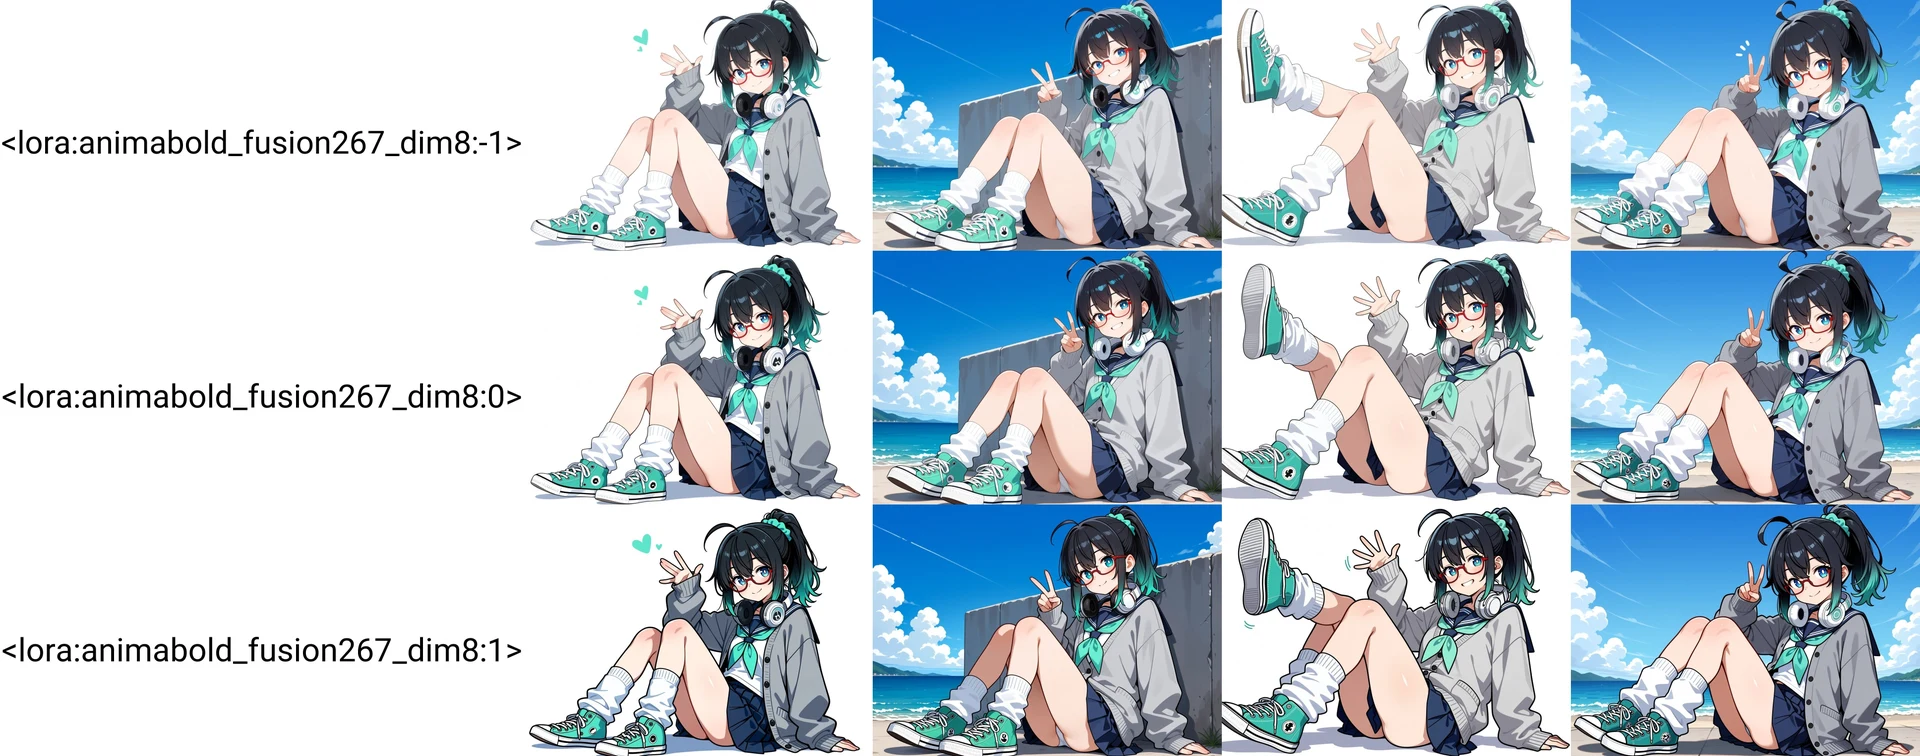
Copitaの次回以降の構想として、はじめから複数のペアを入力して複数種類のスライダー系LoRAをいっぺん作れる「連続学習モード」を作れると便利そう。ChatGPTで2枚ずつ線の太さの違う画像を出してもらって、いっぺんにタグ付けして数時間放置する…といったやり方で、狙った効果のあるLoRAを量産し、フュージョンするやり方ができるようになるといいですね。

トラブルシューティングとFAQ(常時更新)
学習がうまくいかないときはこちらの一覧をご覧ください。未知の不具合が生じた場合は、大変お手数ですがコメント欄でご指摘いただけますと幸いです。
Q. 完成したLoRAを適用したが、効果がみられない
まず、Copitaの画面最下部を確認し、最新バージョンであることを確認してください。その上で、生成時のLoRA適用強度を「2」程度に上げてみて、狙った効果が多少なりとも学習できているか確かめてみてください。段階的に上げると狙った効果(画風が似る、線画が太くなる等)が出てくる場合、差分として検出はできていますが、効果が十分でなく、適用したモデルのプロンプト応答結果が押し勝ってしまっています。
特に、画風がAIっぽいアニメ塗りやマスピ塗りになってしまっている場合は、クォリティタグが画風を「上塗り」している可能性があります。「4k」とか「anime screenshot」など、描き方を変更するクォリティタグをいったん全て抜いて、Copitaで作ったLoRAだけで画風指示してみてください。WAI ANIMAなどのようにアニメ塗りにファインチューンされたモデルにLoRAを適用した場合、その方向に画風が強く引っ張られるのは避けられません(むしろ、その画風になるようにわざわざ作られたモデルなので)。anima_baseV10.safetensorsをベースに学習して、生成時も同じanima_baseV10.safetensorsに適用すると、混じりけのない学習結果が素直に出ます。
Q. 完成したLoRAの効きが弱い
LoRA強度「2」以上なら効果が出るが、「1」では弱すぎて使えない場合、学習時のペアの「差分」がはっきり見えるよう誇張して作り直してみます。また、画風LoRAの場合はdim/alphaを上げるのも手です(ただし、予想しない部分が画風としていっしょくたに学習される危険性も高まります)。
それでも効果が弱い場合は、ペアの違いが概念として読み取りにくいか、タグ付けの不備(必要なものが足りていない、or被写体が複雑すぎる)の可能性があります。
Q. LoRAを適用すると、想定していない副作用が生じる
画風だけ覚えさせたいのに、表情や構図までお手本画像そっくりになるとか、指示と違うものが一緒に描かれる場合、dimとalphaがそれぞれ高すぎる、比較画像と元画像の内容がずれている、またはキャプションから消すべきタグが残っている可能性があります。生成時のLoRA強度を下げるか、比較画像を作り直してください。
(そもそもAnimaはdanbooruタグで指示していないものが描かれやすいモデルです。同じSeed値・プロンプトでLoRAを外して生成しても同じようになるなら、作ったLoRAのせいではなくAnima側の問題です)
Q.手が崩壊するLoRAになった
手が描かれていないペアで学習したら、生成すると手が崩壊するLoRAになってしまったというケースがあります。特に、ラフなスケッチ感のある画風LoRAを作ろうとするとよく起きる現象です。お手本画像に描かれていない部分の画風は、学習内容から類推されるので、ラフな画風を学んだLoRAは「手もラフに描こう」とする傾向があります。手の描画はご存じのように非常にAIが苦手なので、とたんに指の本数があいまいになる現象が起こります。
これを避けるためには、手が描かれているペアをお手本にするか、ラフな線をいったん諦める方法があります。つまり、はっきりした線画でまずその画風を覚えてから、その画風をラフな線に変換するLoRAを別に作るのがよいはずです。言い換えれば「ラフな画風LoRA」を覚えようとすると「ラフな画風+手崩壊LoRA」になるので、「画風LoRA」と「ラフ化LoRA」を別に作った方が使いやすいということですね。
Q. 無表情だとお手本画像に似るが、細かく指示するとだんだん似なくなる
1枚絵(と比較画像)からコピー機法で抽出できるのは、あくまで表層的な外観だけです。そのキャラがどうやって笑うのか、怒るのか、どんな仕草をするのか、後頭部の描き方がどうなっているかなど、1枚絵に描かれていない要素まで覚えることはできません。
そうした豊かなバリエーションを再現したい場合は、やはり数十枚のデータセットから学習する従来の学習法の方が向いています。以前こちらの記事で紹介したように、作りたいLoRAによって学習法を切り替えたり、別々のLoRAを併用したりすることで理想に近い画風に近づけます。
Q.似ないのではなく、適用すると絵がおかしくなるLoRAになった
ペア画像とタグから、学習すべき差分が収束させられず、発散してしまった可能性があります。特に版権キャラでキャラタグとともに画風を学習しようとしたときによく起きる印象です(例:エヴァのアスカの画像と実写化画像のペアで1girl,solo,souryuu asuka langley...で学習)。
AIからすれば🤖「はいはい、アスカを描くときは今後こうするのね…ん?じゃあ1girlはどう描けばいいの?」となっているようなもので、限定されたプロンプトでの差分しか抽出されなかった可能性があります。
画風を抽出するペアはできるだけ条件付けの少ない、シンプルな内容のペアの方が向いています。どうしても版権キャラで学習したい場合は、比較画像をLLMによる実写化ではなく、ベースモデルによるi2i(そのモデルのマスピ顔)で作ってみるのも手です。
Q. Copita起動時に自動で画面が開かない
A.お使いのブラウザによって自動で開かない場合があります。その場合は、黒い画面に出ている http://127.0.0.1:7865 をCtrlを押しながらクリックするなどして、手動で開いてください。
Q. 起動しようとしたら「Python environment is missing」とエラーが出た
初回セットアップが正常に終わっていません。先に必ずsetup_first_time.batを実行してください。
Q. 初回セットアップが途中で失敗し、「sd-scripts: 未セットアップ」と出た
setup_first_time.batをもう一度実行してください。初回セットアップが途中で失敗した場合は、もう一度実行すれば途中まで済んだものは再利用されます。うまくいかない場合は、もう一度最初からやり直してみてください。
Q. 起動時に「このファイルがブロックされました」と出た
Windows 11 の「スマートアプリコントロール」がオンになっている環境で、start_copita.bat を実行すると、「ImportError: DLL load failed while importing arrays:
アプリケーション制御ポリシーによりこのファイルがブロックされました」などとエラーメッセージが出ることがあります。
これはCopitaの不具合ではなく、内部で必要な「pandas」という部品の最新版が、Windows側にまだ安全だと認識してもらえていないため、インポート作業が止められている状態です。以下の手順で、少し前の安定版に入れ替えれば解決します。
1. Copitaの黒い画面が開いていたら閉じます。
2. エクスプローラーで、start_copita.bat があるフォルダを開きます。
3. 上部のアドレス欄(フォルダの場所が書かれている欄)をクリックし、そこに書かれている文字をすべて消してcmdと入力し、Enter。
4. すると黒い画面が開くので、次の1行をコピーして貼り付け、Enterキーを押します。
Copita\.venv\Scripts\python.exe -m pip install "pandas==2.2.3"
5. しばらく待って「Successfully installed pandas-2.2.3」と出れば完了です。
黒い画面を閉じて、start_copita.bat を起動し直してください。
Q. 学習に使用したいモデルが画面上に出てこない
まず、modelsフォルダのパス指定が正しいか確認してください。StabilityMatrixのdata/modelsフォルダのように、StableDiffusionやTextEncoders、VAEフォルダを含む親フォルダを指定する必要があります。(子フォルダがなく、指定したmodelsフォルダの直下に各モデルがある場合も検出できます)
Q. LoRAフュージョンモードでLoRA一覧が表示されない
先に、「差分学習モード」の下のほうにある「LoRAの名前と保存先」から、混ぜたいLoRAを格納しているLoRAフォルダのパスを記憶させてください。その後、フュージョンモードの「LoRA一覧を更新」ボタンを押せば読み込まれるはずです。
Q. 説明通りに試みたが、学習が完走できない
インストールに成功しているのに、学習が途中で止まるか、事前にエラーメッセージが出て学習開始できない場合、GPUの性能と学習設定がマッチしていない可能性が高いです。学習プリセットを安定学習セットにする、batchを1にする、dimを8にする、lowramをオンにするなどしてみてください。
Q.この記事のスクリーンショットと自分のCopitaの画面が違う
すみません、できるだけ最新バージョンに準拠していますが、機能説明の過程で古いバージョンのスクリーンショットも一部混じる可能性があります。
Q. 学習時間が長すぎる
できるだけ短い時間で学習できる設定を模索していますが、グラフィックボードの性能により、学習時間短縮には限界があります。stepsを減らせば学習時間も減りますが、その分どうしてもLoRAの精度は落ちてしまいます。どれくらい細部までしっかり学習したいかによって、必要なステップ数やdimを調整してみてください。
Q. 学習失敗の理由が分からない
「copita_v1.0\Copita\runs\ui_jobs」内にログのtxtファイルが保存されていますので、LLMなどに見せて原因を尋ねると解決するかもしれません。VRAM12GB環境でも安定学習セットで動作確認していますが、設定や常駐ソフトによっては不安定になる可能性がありますので、おのおのの環境に応じた学習設定になるよう適宜調整してみてください。
Q. PCの既定Pythonが3.13でもCopitaは使える?
A. 使えます。v1.1以降のバージョンでは、Copitaが使えるPython 3.11 / 3.10を自動で探し、見つからない場合はCopita専用のPython 3.11を配布フォルダ内に用意します。PC全体の既定PythonやForge Neo / Stability MatrixのPython環境は変更しません。

終わりに
というわけで、着想から公開までかなり掛かってしまいましたが、Anima向けコピー機LoRA学習アプリ「Copita」のご案内でした。
Copitaは完璧なLoRAを一発で作る魔法の杖ではありませんが、比較画像を丁寧に作り、キャプションを整理していくことで、自分の作品づくりに使いやすい画風のベースを作るのに役立つはずです。特に、これまでSDXLで表現してきた過去作品と同じ画風でAnimaでも生成したいニーズを踏まえて、誰でもこれまでの画風をAnimaに「移植」できるアプリになることを目指して整備しました。
AnimaはSDXLに比べてまだまだ歴史の浅いモデルですし、SDXLのように多彩なLoRAのある覇権モデルになれるかどうかはまだ分かりませんが、このアプリを使って過去資産を容易に「お引越し」できるようになるといいなと思っています。
それでは今回はこのへんで。スタジオ真榊でした。
追伸:もし感想などを頂ける場合は、こちらのツイートの引用やRPにご協力ください~!
<おまけ>
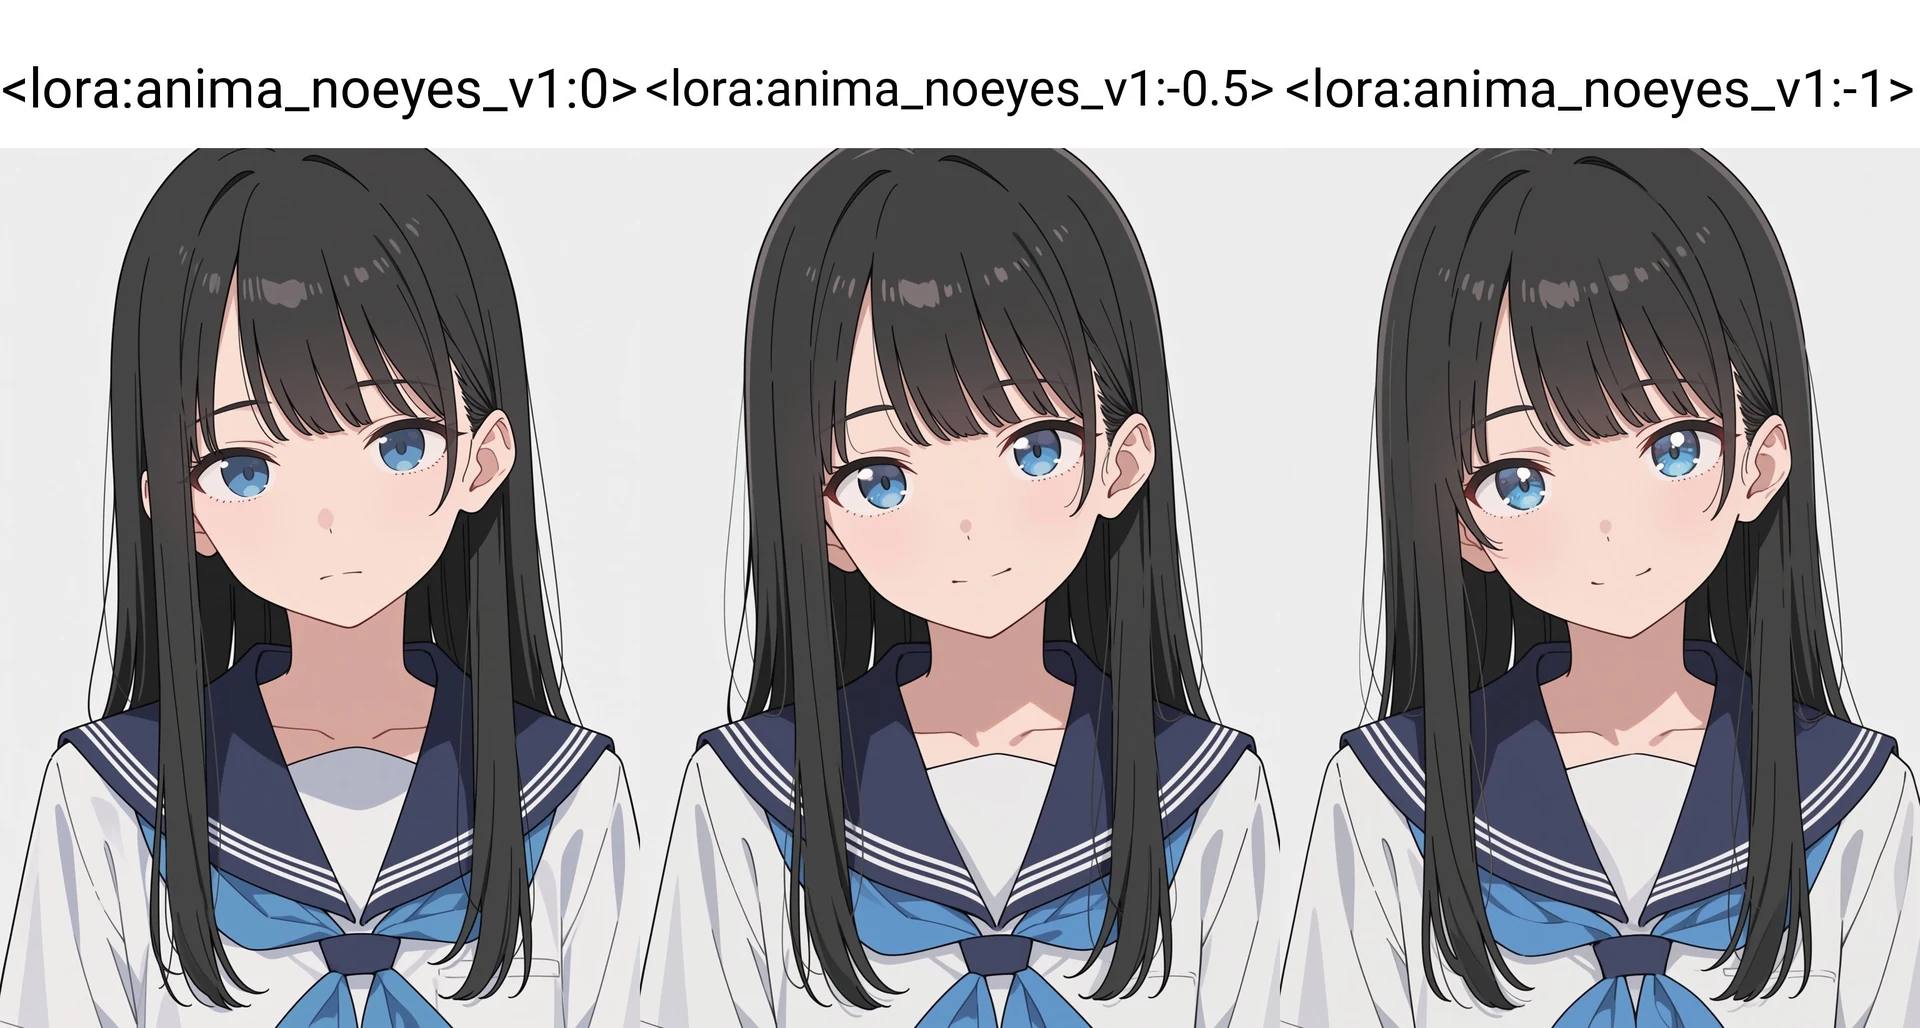
これまで、CoppyLoRAwebUIなどでSDXL用コピー機LoRAを作ったときのペア画像が残っていれば、そのままAnimaに流用できます。例えばこれは以前CoppyLoRAで「虚ろ目LoRA」(目のハイライトを消すLoRA)を作ったときのペアですが…
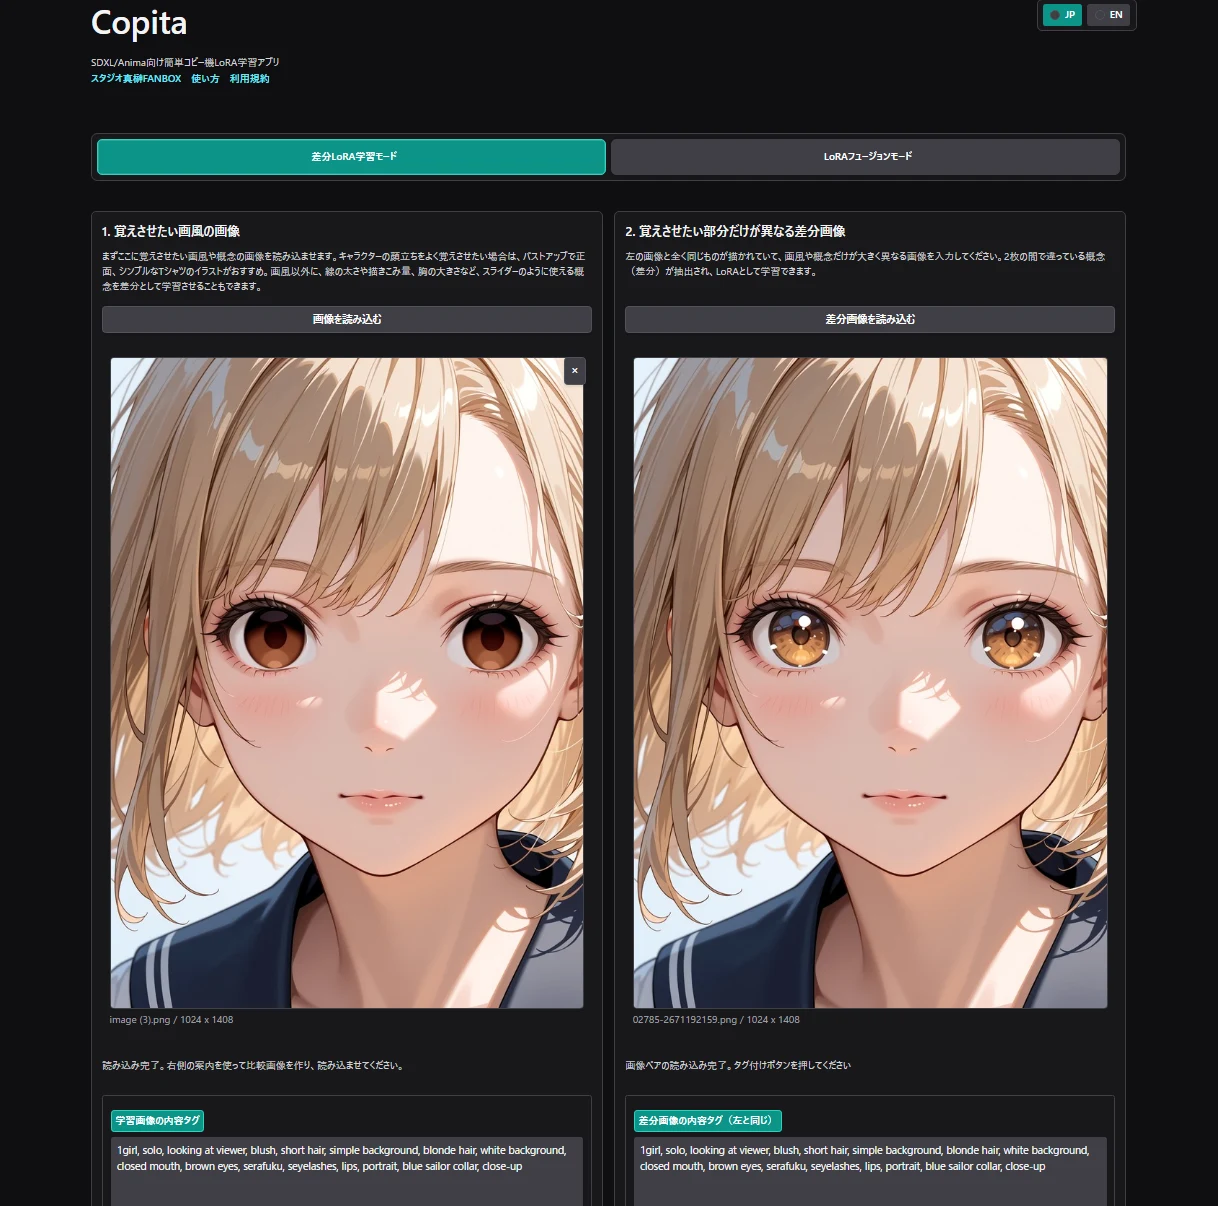
このように、Copitaでも同様の虚ろ目LoRAを作ることができます。
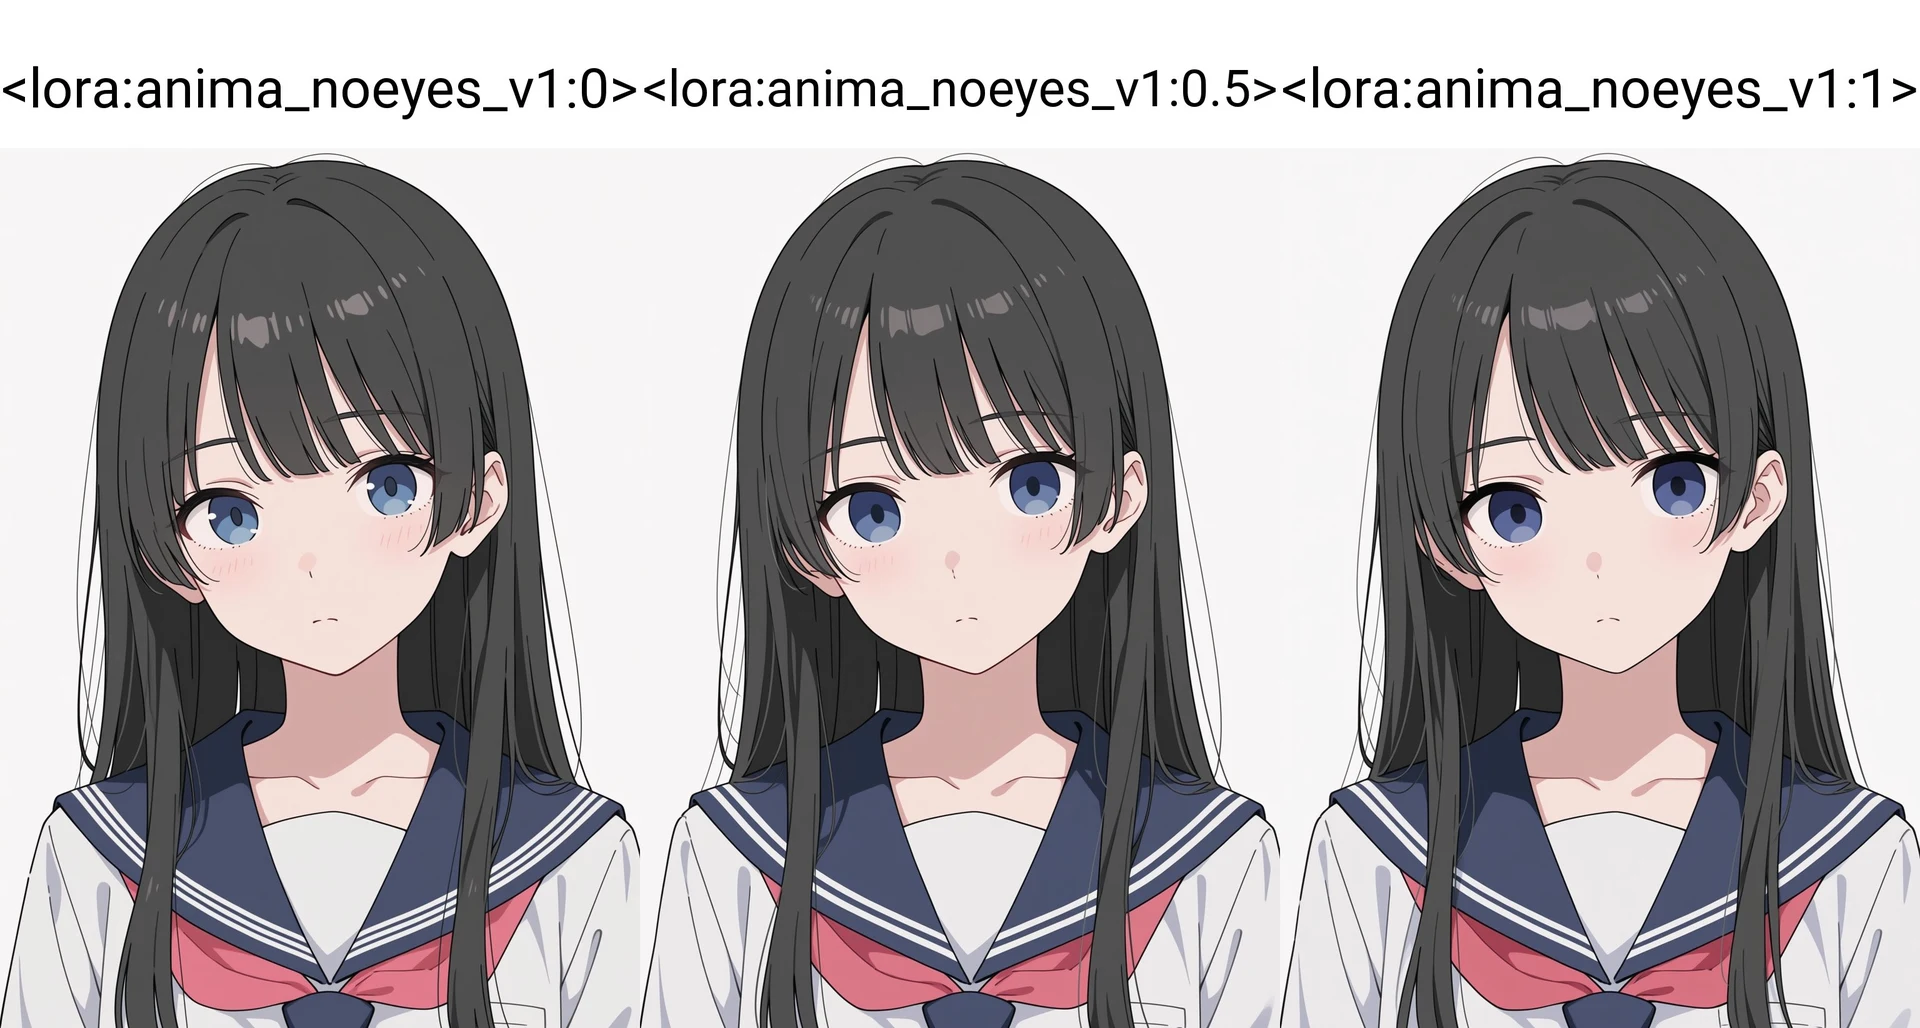
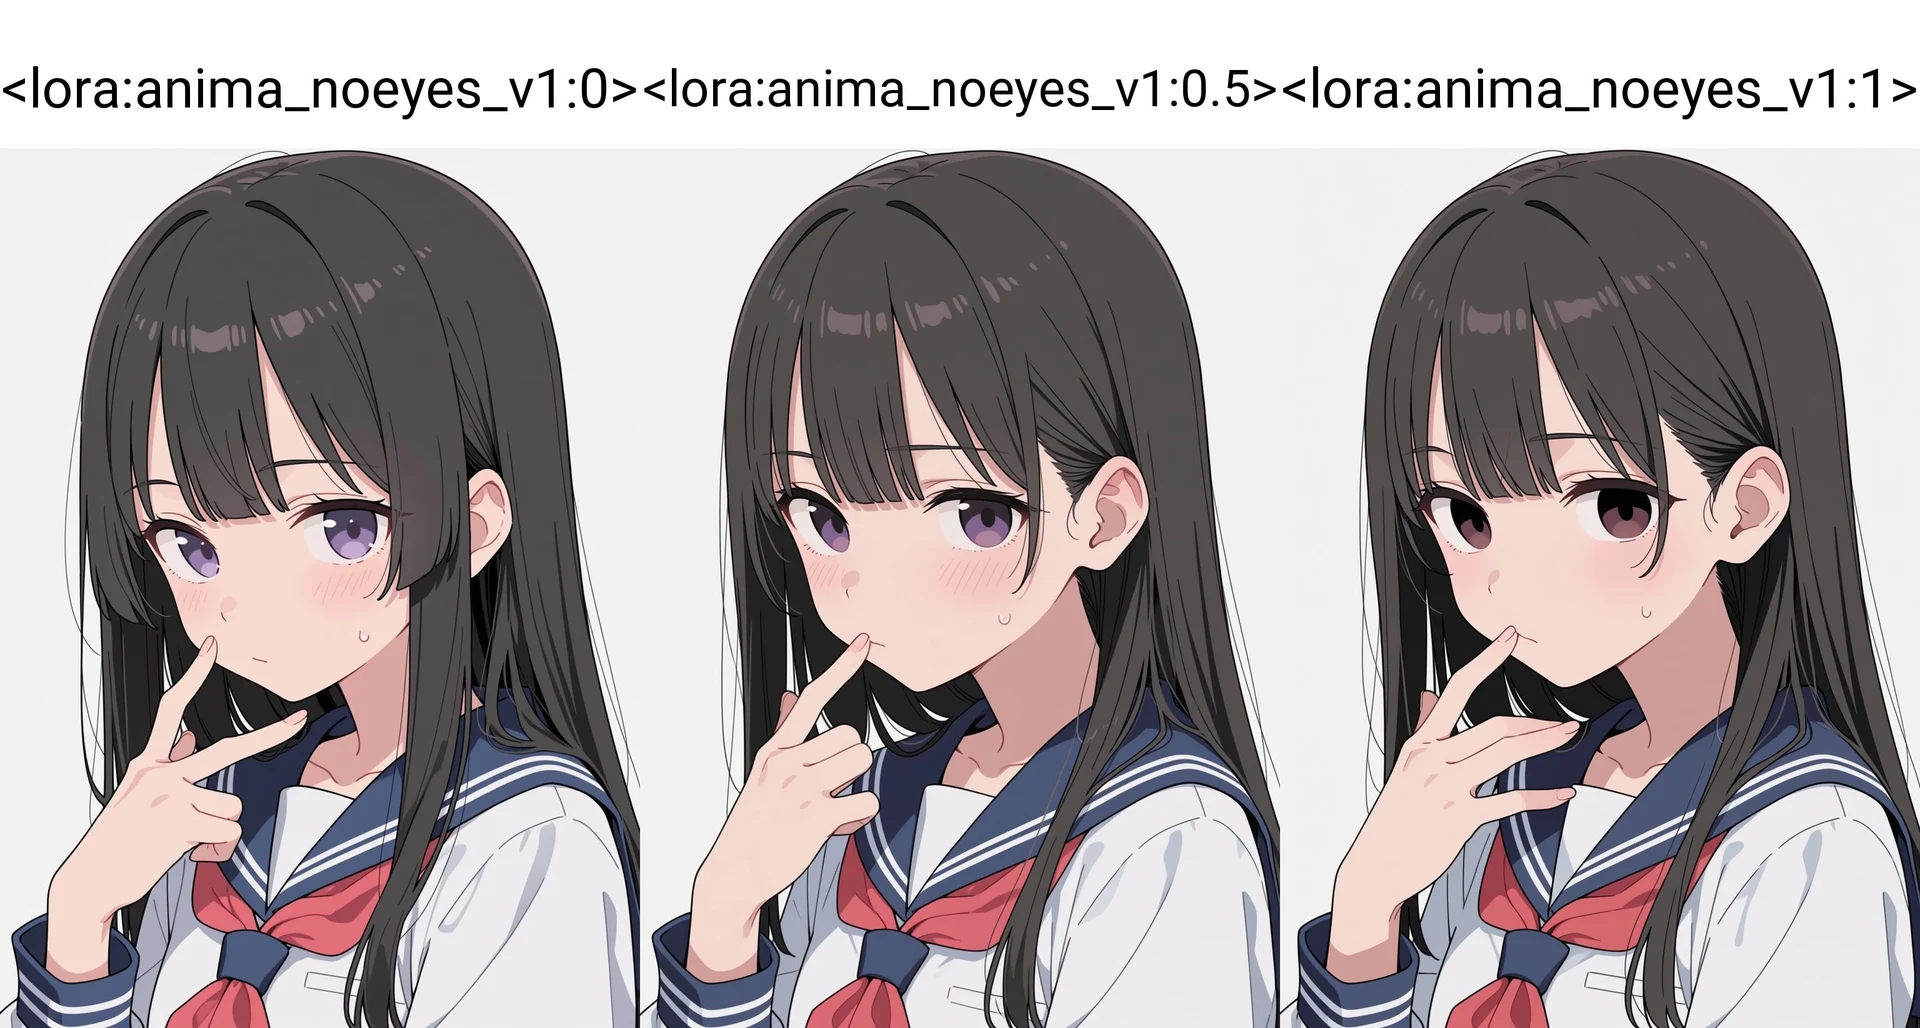
瞳のハイライトを減らすLoRAとして学習されているので、マイナス適用すると「瞳のハイライトを増やすLoRA」として使うこともできます。精度を上げたい(目以外の変化を抑制したい)場合は、別のペアで作った同様の虚ろ目LoRAとフュージョンモードで合体させるとよいでしょう。