こんばんは、スタジオ真榊です。2025年3月、Chatbotに自然言語で指示して画像を生成してもらう「LLM画像生成」に革新が起きました。一つは「Google AI Studio」で画像生成・編集機能を備えたモデル「Gemini 2.0 Flash Experimental」が試験公開されたこと。もう一つは、昨日からTLをにぎわせている「ChatGPT4o」の画像生成機能向上です。
どちらもStableDiffusionやNovelAIのような画像生成専用モデルとは異なり、Chatbotに自然言語(普通の日本語)で作ってほしい画像を「お願い」するもの。ChatGPTに指示して画像生成を行うこと自体は2023年から可能でしたし、最近ではXでGrok3に指示すればFlux.1クォリティの画像が出力できたわけですが、Geminiと4oはそれらをはるか凌駕する実力を示しています。
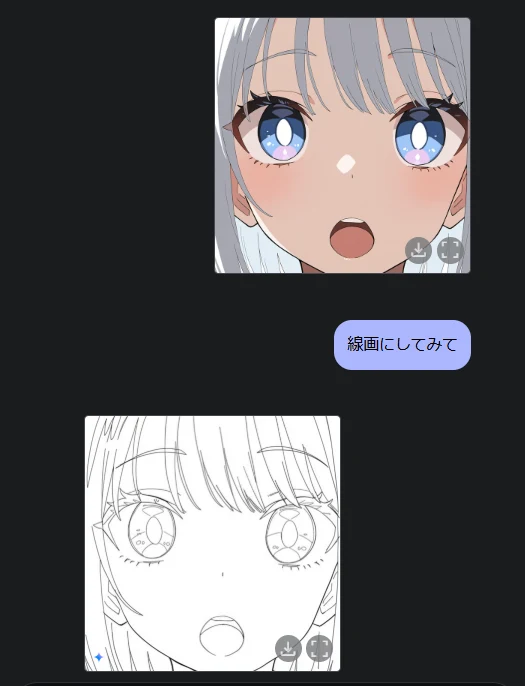
例えばGeminiはこのように、カラー画像から線画を抜き出したり、線画を保持してカラー化したりするControlnetじみた画像編集が一発でできます。
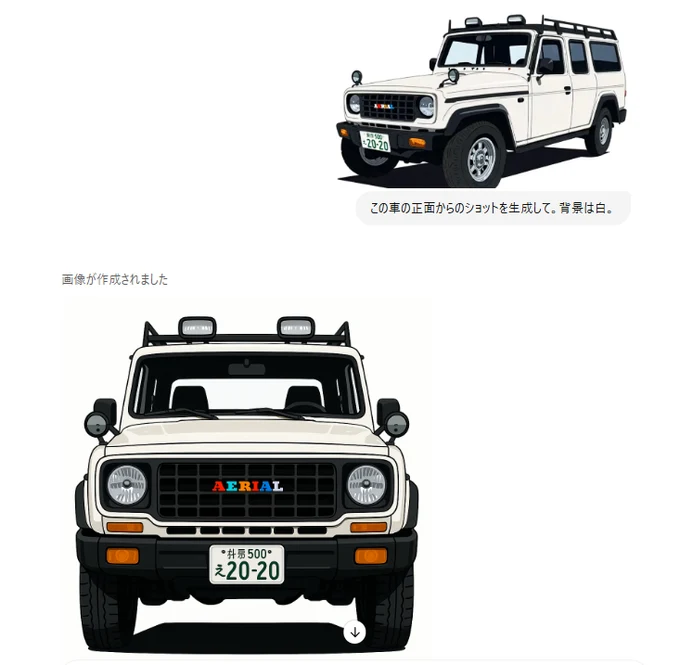
超進化した4oも、これまでは動画生成AIの力を借りるしかなかった「一貫性を持った別角度の一発生成」ができてしまいます。
4oが白眉なのは、これまではほぼできなかった日本語の文字生成がかなりできるようになったこと。コマ割りの概念もしっかり理解できており、このような漫画生成も予備知識なしでできてしまいます。
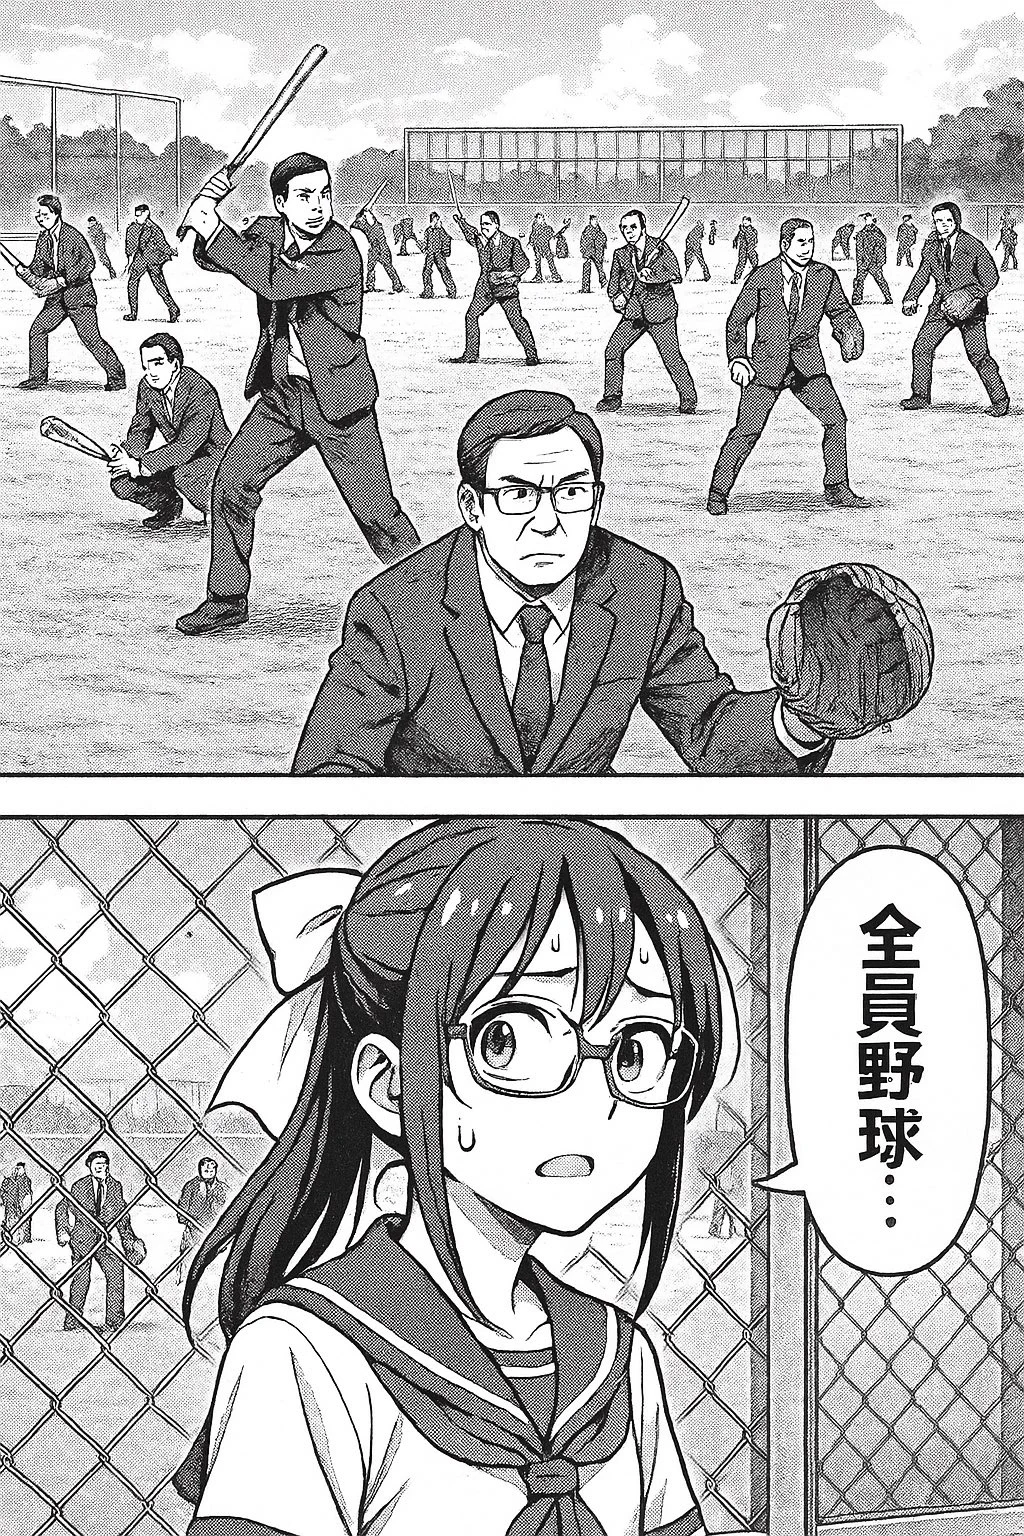
今回はこの2つのLLM系モデルの実力をさまざまに実験し、モデルごとの特性・得意分野の違いや、4oを使った「GPT漫画」の作り方、StableDiffusionやNovelAIといった画像生成専用モデルとどう掛け合わせられるかなどを一つ一つ検証していきたいと思います。
1.Gemini2.0Flash Experimentalの使い方
Googleが2025年3月12日に試験公開した「Gemini2.0Flash Experimental」は、画像編集機能に優れたマルチモーダル型の大規模言語モデル(LLM)です。いずれ有償サービス化されることが予想されますが、記事執筆時点では、GoogleアカウントさえあればGoogleAIStudio上で誰でも無料で生成を行うことができます。
初めての方は、まず上記のリンクからGoogleAIStudioにログインします。これは、Googleの最新AIで試験的に無料生成できるAI開発者向けプラットフォームですので、一般顧客向けの正式サービスではないことに留意して利用してください。
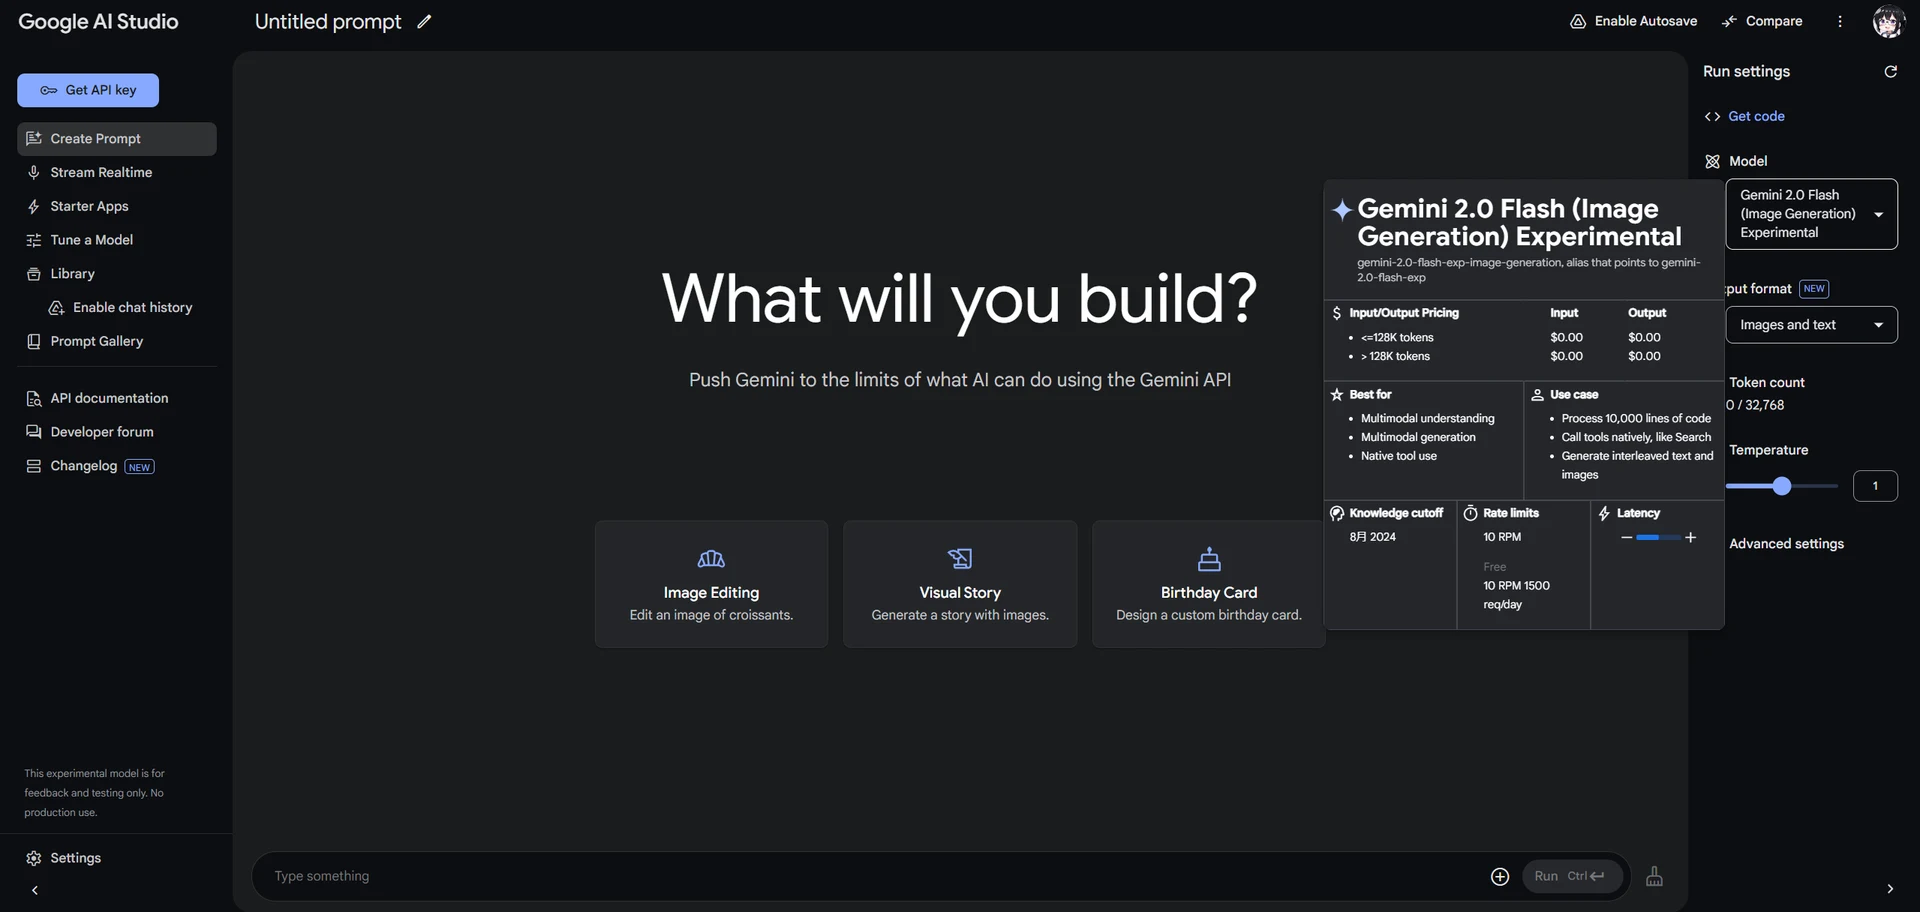
こちらの画面まで来たら、画面右側の「Model」からGemini 2.0 Flash (Image Generation) Experimentalを選び、「Output format」には「Images and text」を選択すればOK。あとは、画面下部のウィンドウに日本語で指示すれば画像生成(text2image)が始まります。右下の「+」ボタンから、画像を読み込ませることも可能です。
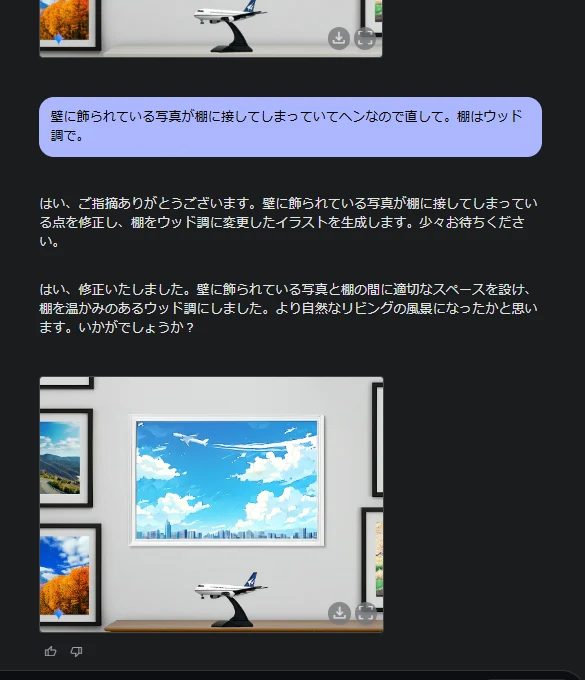
さっそく実例を見ていきましょう。マルチモーダル型の画像生成が優れているのは、Chatbotと自然に会話をしながら、直感的に微修正を加えていけること。たとえばこのような感じです。
さらに、インペイントやimg2imgのような操作だけでなく、このようにアイデアが「飛躍」するような画像加工も可能です。
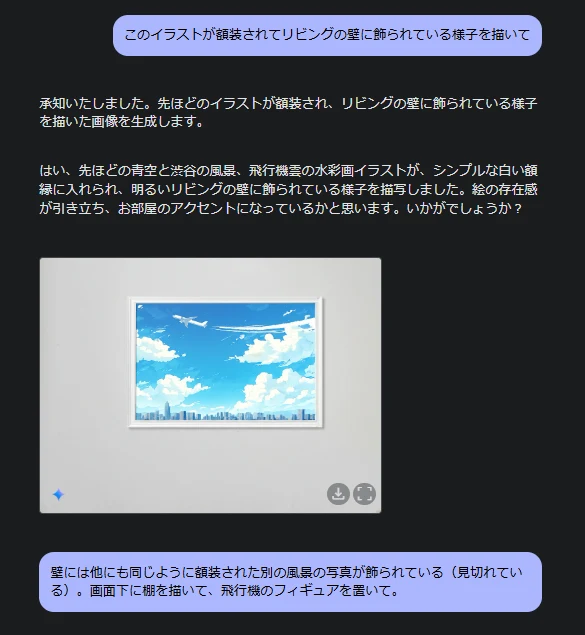
間違ったところがあれば、言葉で具体的にどう直したいのか指示することで、かなりユーザーの意を汲んだ結果を得ることができます。
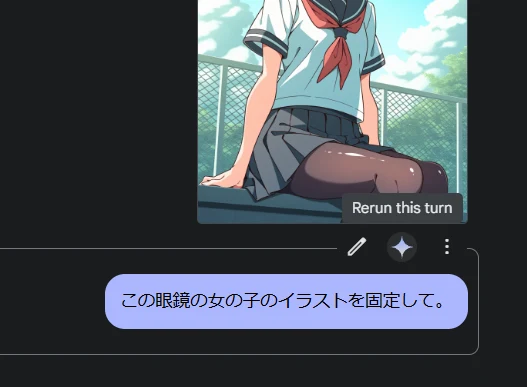
生成結果が気に入らない場合は、入力したプロンプト履歴の上にポップアップする星型のボタン(Rerun this turn)を押せばもう一度生成を行うことが可能。その横のペンマークから一部プロンプトを書き換えてやり直すこともできます。
ただ、正式サービスではない試験公開のためか、ChatGPTのようにやりとりのログを残すことはできません(記事執筆時点)。プロンプトと生成結果は一期一会ですので、気に入った画像はきちんとダウンロードし、やりとりのログを残したい場合はスクリーンショットしておくことをおすすめします。
また、性的な印象が強いキャラクターイラストの生成は、規約エラーで弾かれることが多いです。最初は制服を着ている女の子というだけで弾かれていたので、これでもかなり緩和されたのですが、胸元やお尻などが強調されているイラストの生成や加工は引き続き難しいかもしれません。
2.Gemini2.0Flash Experimentalでできること
さて、基本的な使い方が理解できたところで、じゃあどんなところが革新的なのか?ということを一つずつ見ていきましょう。
①Controlnet風の画像編集
t2iの能力もとても高いのですが、Geminiの実力が分かるのは、やはり画像を入力しての編集指示をしたときです。+ボタンから「Upload Image」を選ぶと、自由に画像を入力することができ、線画を保持した画像編集を指示することができます。
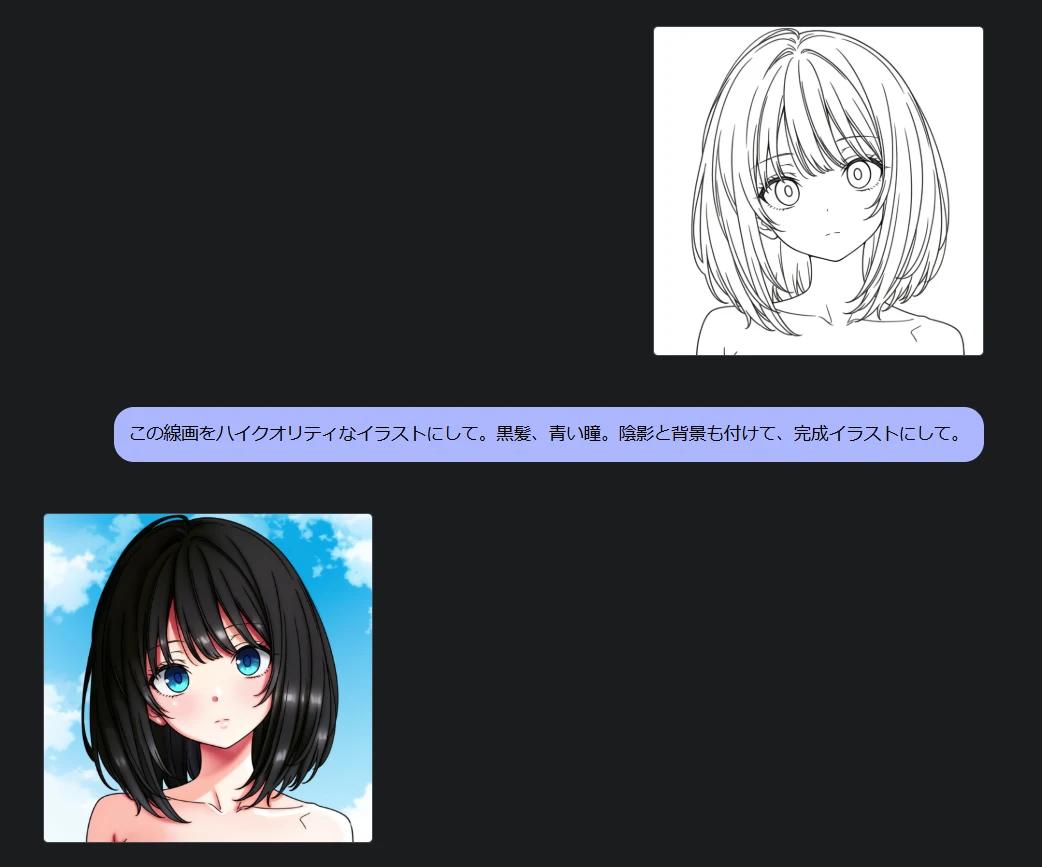
マルチモーダル型の強みは、ここから自然言語で会話をしていくだけで、好みの結果に寄せていくことができることです。このイラストの人物部分は必要な部分だけが継承されており、背景に合わせてカラーなども調整されていることがわかります。
ただ、ハイライトの不自然さなどを見て頂くと分かるとおり、Geminiのイラスト生成の実力はIllustrious系などをしのぐほどではなく、出力される解像度も高くはありません。これがそのままStableDiffusionやNovelAIの代替になるかというと微妙ですので、SDやNAIでは出しにくい部分をスポットでやってもらい、アップスケール元などとして使うのが現実的でしょう。
②連続画像生成
Geminiは通常、1枚ずつ画像を生成しますが、指示次第では複数枚の連続生成も可能です。ただ、普通に頼むとこのように、同じ画像が1枚出るだけで失敗することが多いようです。
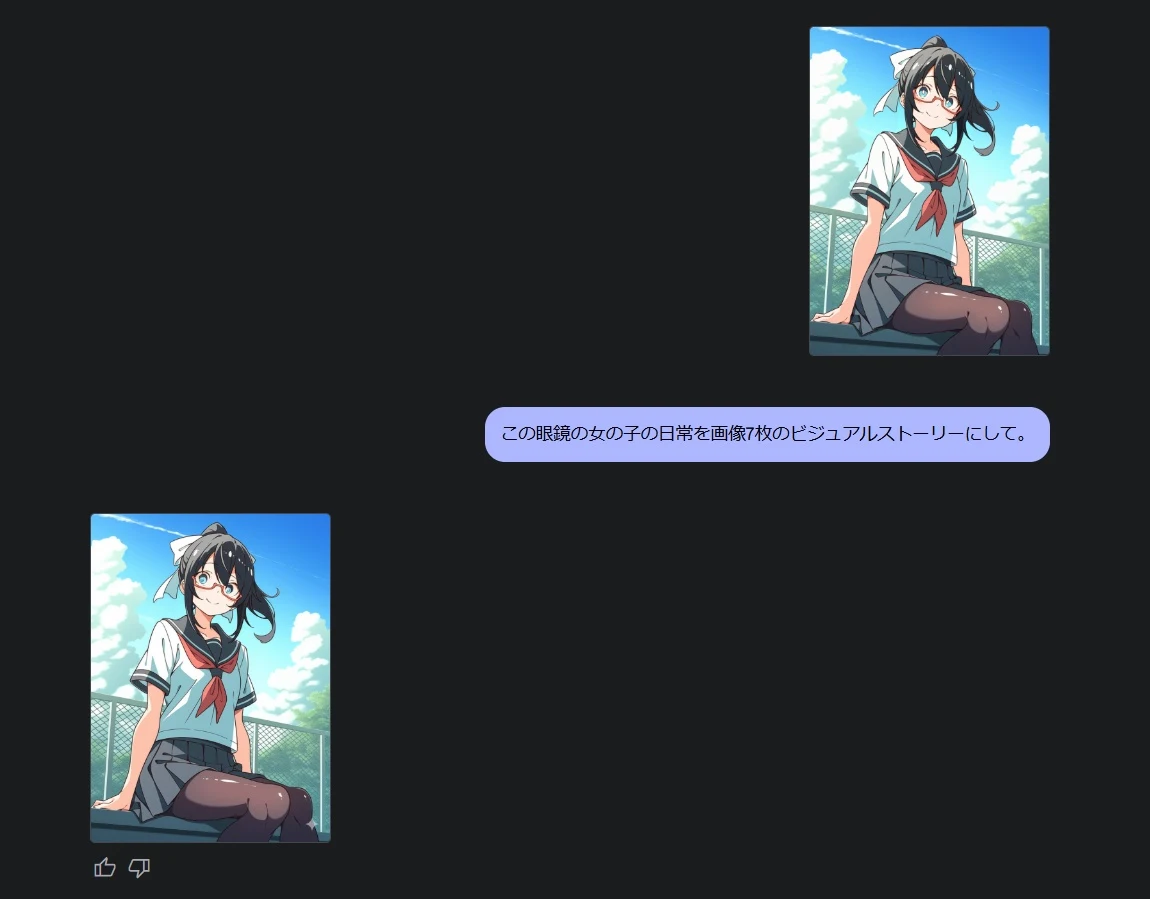
いろいろ試行錯誤してみたのですが、こういうときは、「いったん同じ画像を生成させる」テクニックが有効なようです。いきなりミナちゃんのイラストを「〇〇して」と頼むのではなく、いったん「同じ画像を生成して」とか「固定して」とか頼み、Geminiに同じ画像を生成させます。
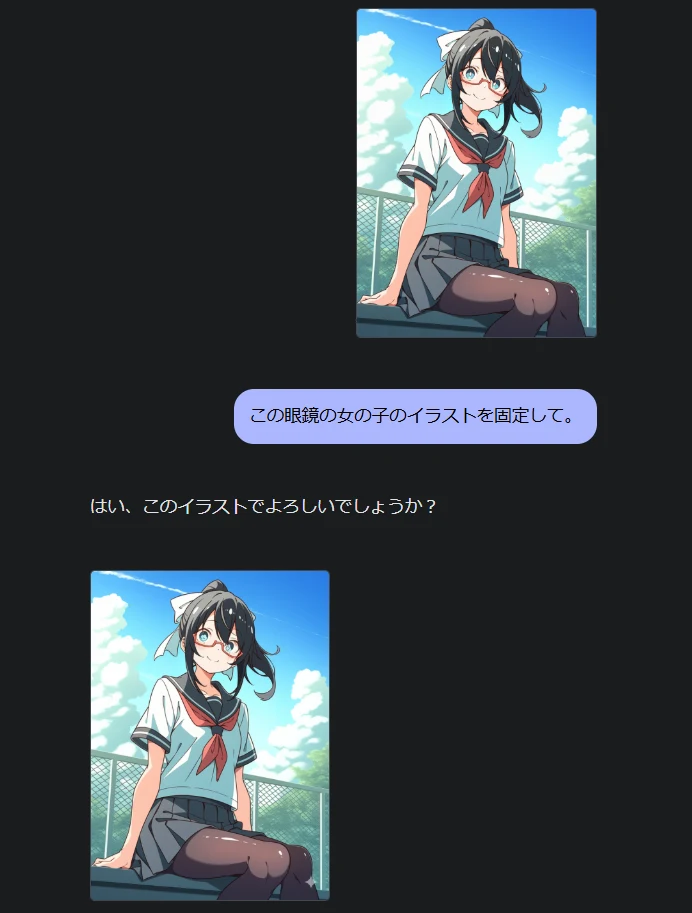
この工程を挟んで指示すると、なぜかGeminiは自分で生成した画像をいろいろと自由にいじることができるようになります。試験モデルですので、これもいずれ修正されるかもしれません。
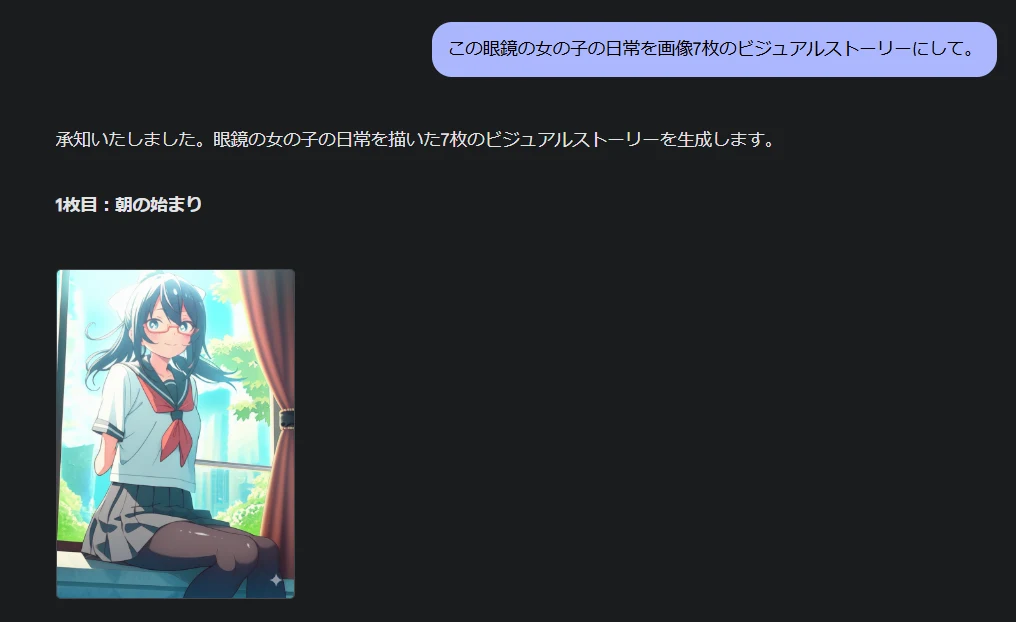
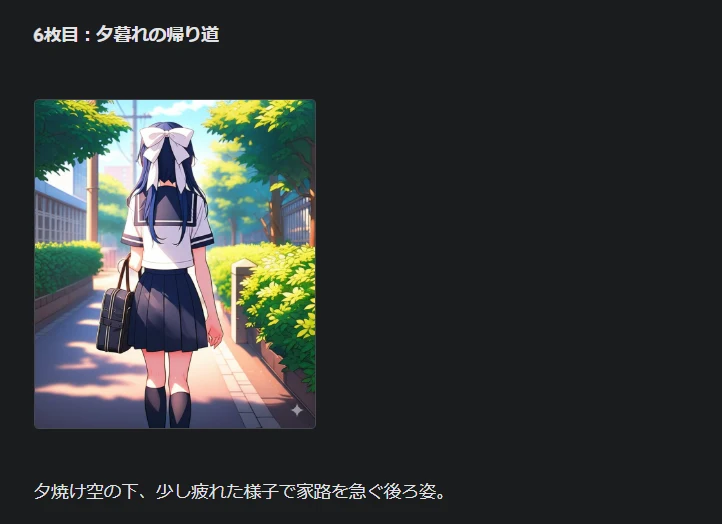
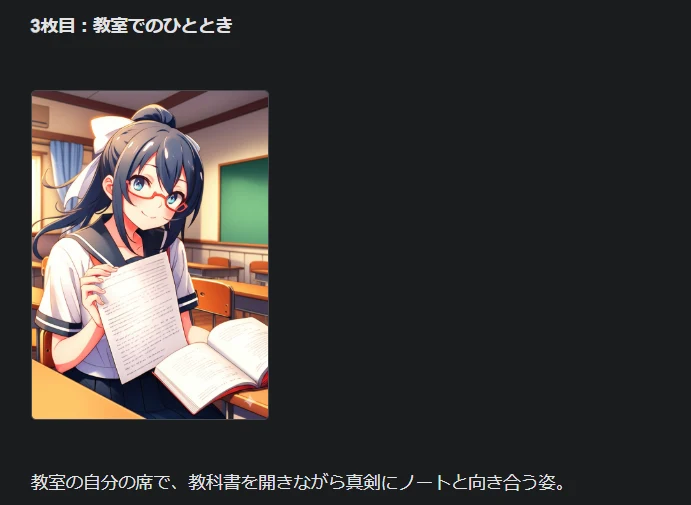
この連作イラストでは、自由なアイデアで作ってもらったからか、画風やキャラクターデザインが大きくぶれてしまっていますが、きちんと指示すれば、Geminiはかなり「線画・画風を守る」のが得意なモデルです。
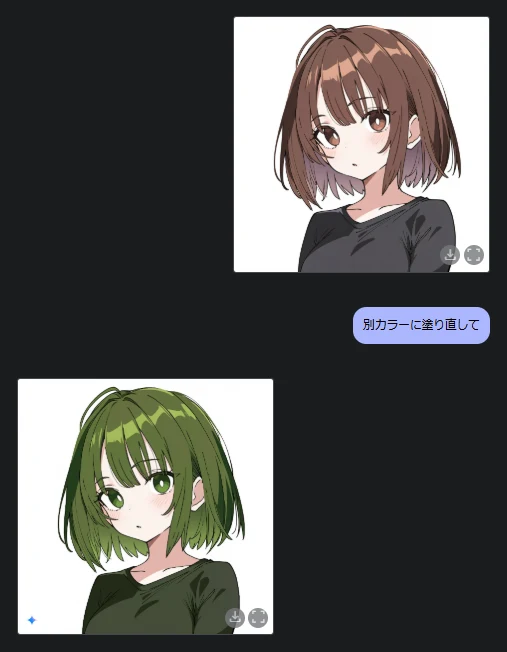
先ほども線画をカラー化してもらえましたが、StableDiffusionでいうControlnetのように、入力した画像の線を動かさずに指示通りの変更を行うことができます。
4oもかなり性能が高いのですが、どうしても「描き直し(生成し直し)」の印象が強く、参照させたのと同じキャラになりにくいのが弱点と言えば弱点。その分、想像力や空気を読む力は4oの方が上回っている感触があります。この辺りは後で詳しく比較していきます。
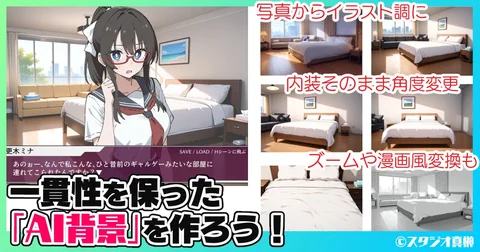
③一貫性を持った別カット生成
Geminiは単に入力画像の線画部分を守るだけでなく、入力画像を一貫性を持ったまま別カットに変更することも可能です。
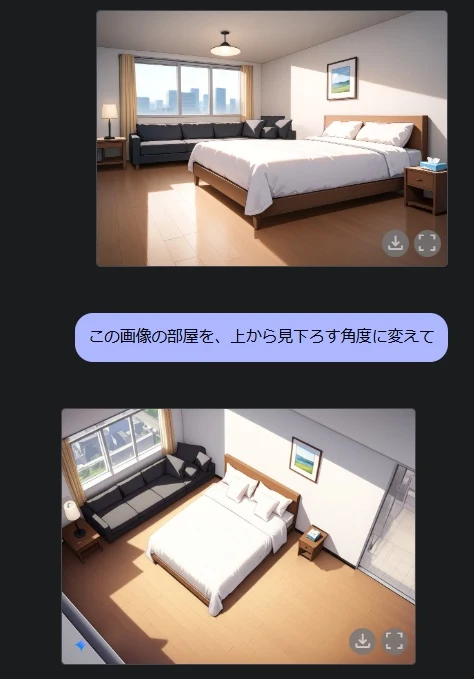
これはついこの間、動画生成AIでできるようになって革新的に思っていたテクニックだったのですが、あっという間に静止画生成でもできるようになってしまいました。進歩が速すぎる!
④画風変換
これもついこの間までControlnetを使って苦心していたもの。輪郭を守ることができるので、このようなことが簡単にできてしまいます。さきほどと同じ、いったん同じものを生成させてから変容させるテクニックを使っています。
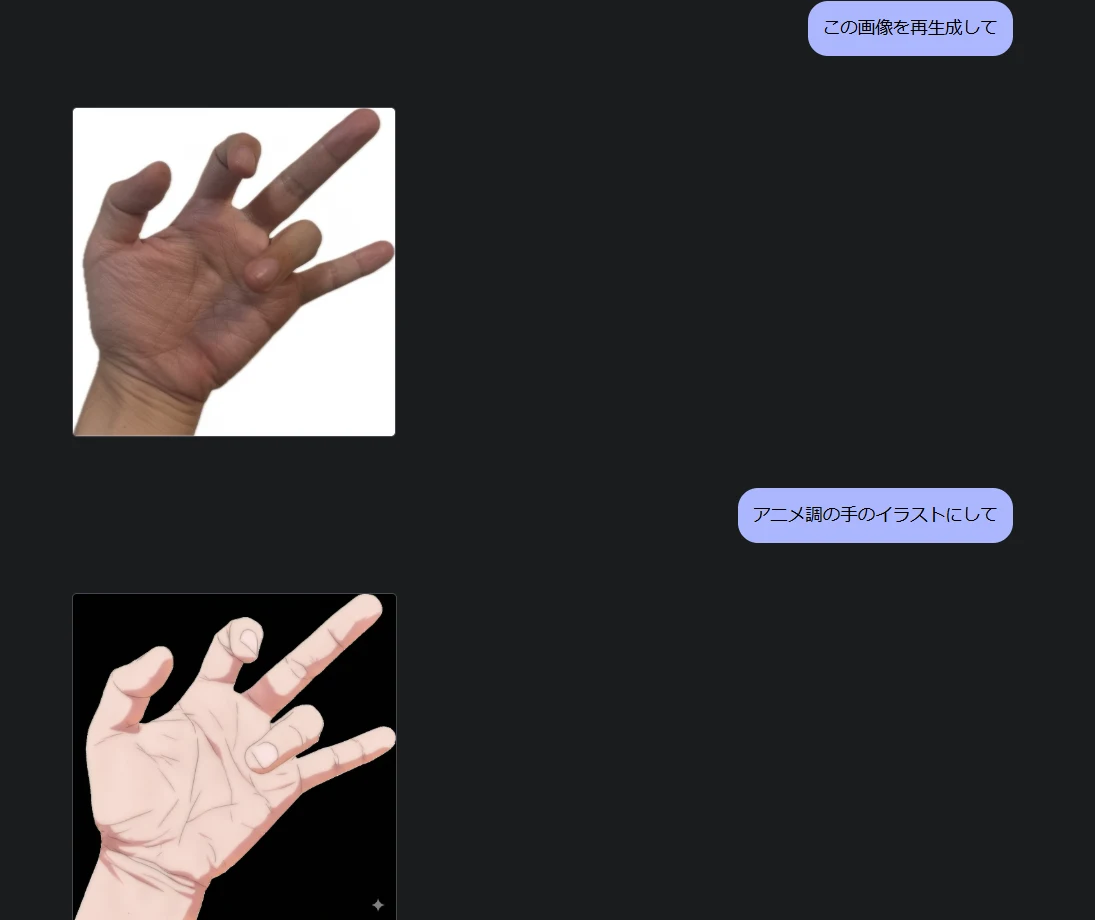
こちらの記事でやっていたのと似たことを内部的にやってくれているのかなと思いますが、それにしても工数が段違いです。こんなに簡単にできてしまっていいのでしょうか。
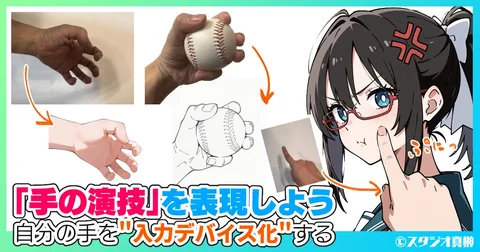
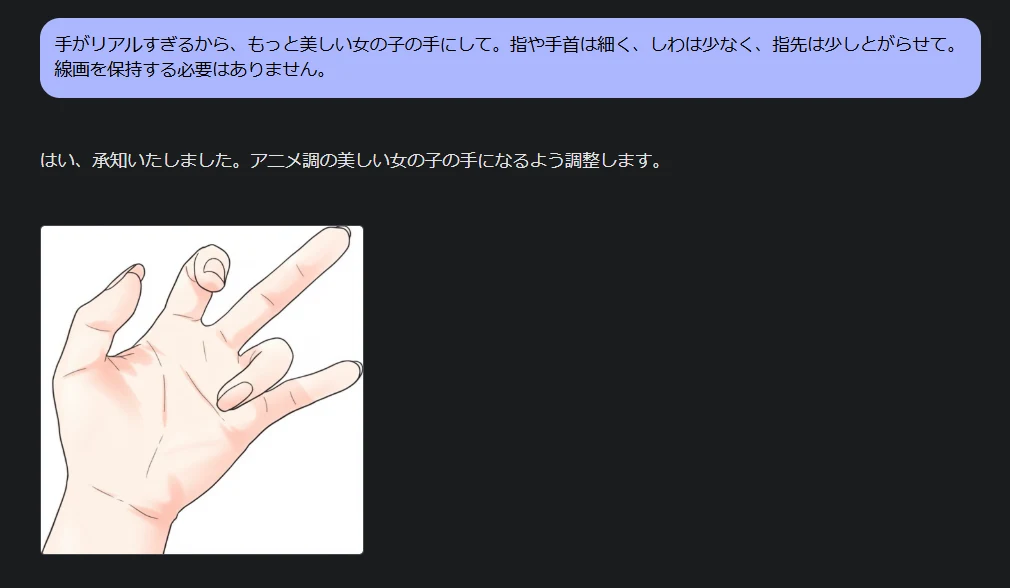
手の形状を保持しながら、おっさん(私)の手を女の子に寄せて、と頼むとこんな感じ。それまでの画像の線画部分の印象に引きずられることが多いので、「線画を保持しなくていいよ」と言う必要があります。この指示の有無で、Controlnet的なシークエンスを挟むかどうかが変わるのかもしれません。