【注】この記事は過去記事のアーカイブです。特に理由がなければ、現在の環境に合わせたアップデート版の特集をお読みください。
こんばんは、スタジオ真榊です。今日はAnimagineXLベースのLoRAを自分で作れるようになる方法についての大型検証記事をお届けします。1枚の画像から簡易的な画風LoRAやキャラLoRAを作る「CoppyLoRA」式ではなく、数十~100枚程度の画像から思い通りのLoRAを作り出すスタンダードな追加学習のやり方について、データセットの準備から設定方法、タグ付けの仕方まで、初心者がつまずきやすいポイントに触れながら、2万8000字を超える大ボリュームで分かりやすく解説していきたいと思います。
この記事では主にAnimagineXLベースの学習法について見ていきますが、SD1.5ベースでもほぼ同じ方法で作ることができます。
SDXL用の追加学習はVRAM消費量が高く、時間も掛かるのが特徴ですが、この記事で紹介する方法では、RTX3060(12GB)でも1時間半程度で学習できることを確認しています。AnimagineXLで良質なLoRAを作るには、どうやって学習データセットを準備するか、どんな数値を設定したらいいか、この記事を読むだけで初めてでも理解できるように解説していきたいと思います。
【2024/12/09更新】「高性能な"wd-swinv2-tagger-v3"を入手しよう」のタガーの追加方法について、インデント(文字列の開始位置)に関する注意書きを追記しました。
LoRAの基礎知識や、作り方ではなく「使い方」についてはこちらの記事にまとめています。
はじめに(LoRAの基礎知識)
LoRAは「Low-Rank Adaptation」の略。基板となる学習済みモデルに対して、その名の通り「低ランク行列」を適応させることで、効率的に「ファインチューニング」(意図通りの生成ができるモデルに調整)できる技術です。
いかに無数の画像で学習している優秀なCheckpointであっても、ちゃんと学習していない概念(キャラクター・画風・構図など)を生成することはできません。そこで、ユーザーが必要なデータセットを用意することで、大がかりな設備がなくても意図通りの生成ができるようにするのが、LoRAをはじめとした追加学習技術というわけ。追加学習で得られた比較的軽量なファイルをやりとりすることで、学習者以外が気軽に成果を享受できるのも、LoRAの大きなメリットの一つです。
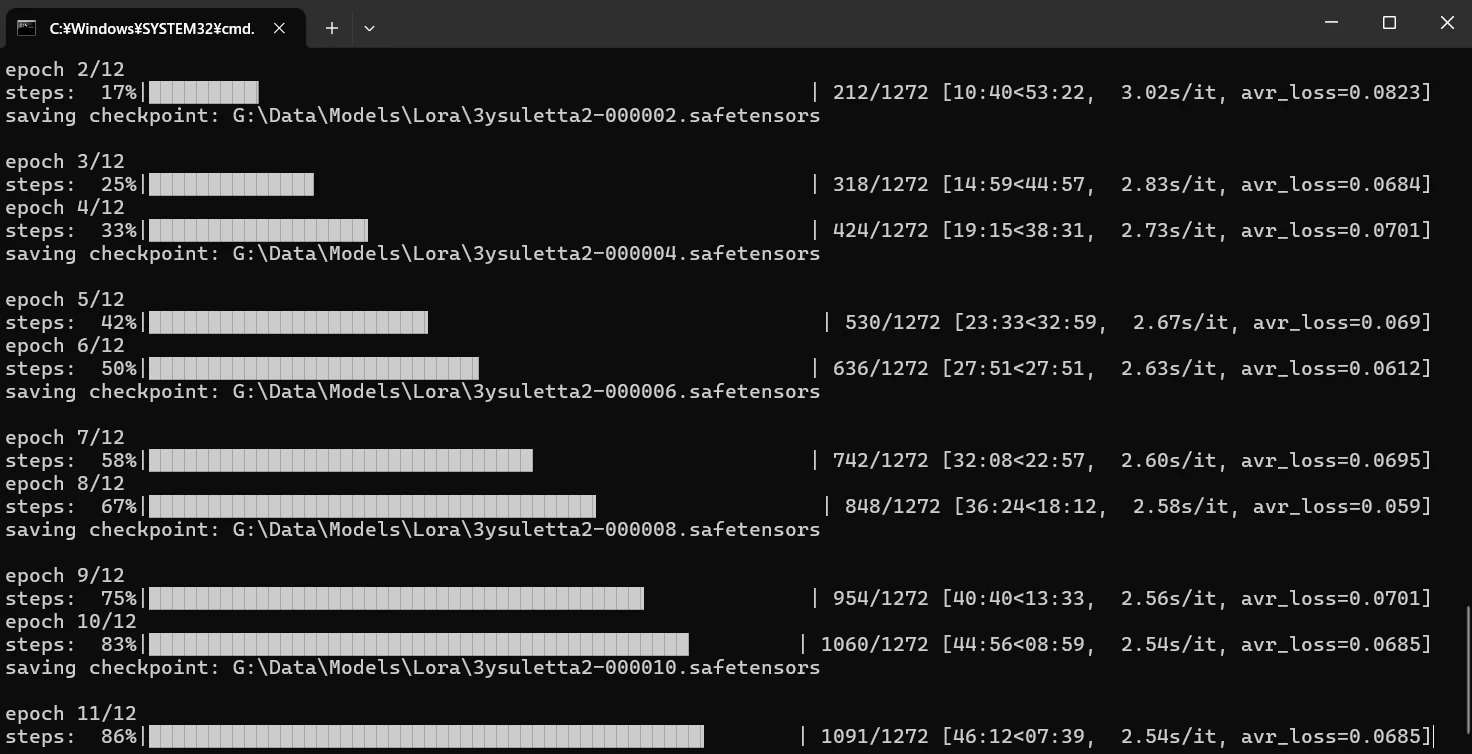
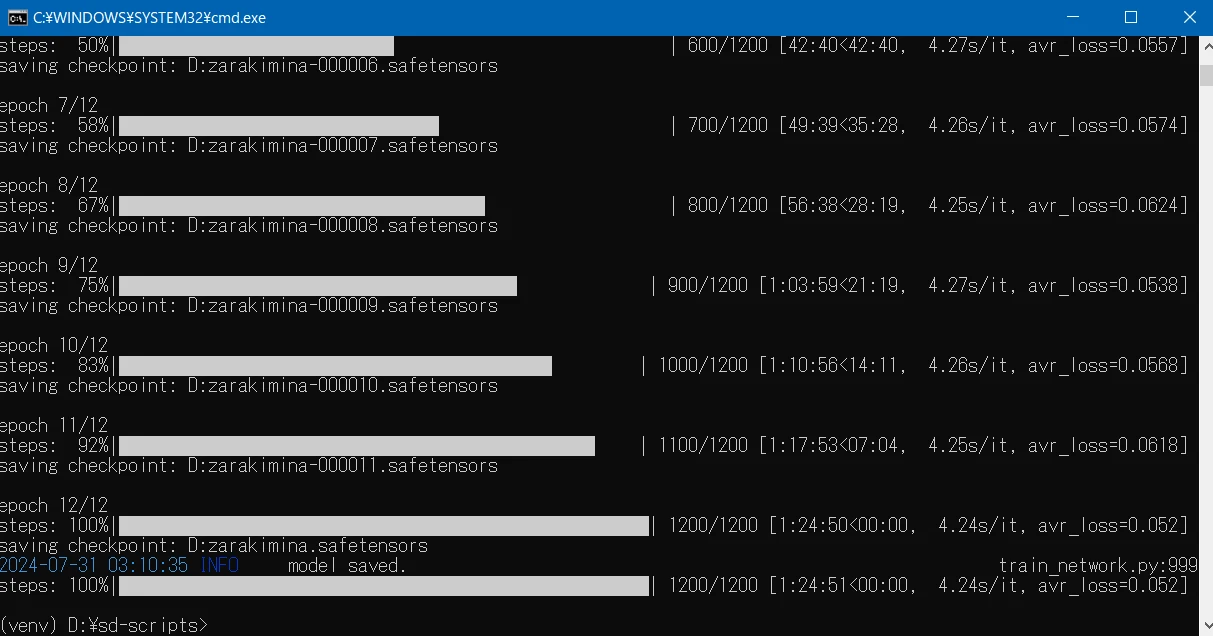
先ほども触れましたが、SDXLベースの追加学習を快適に行うにはそれなりに性能の良いグラボが必要で、VRAMは最低12GBは欲しいところです。学習設定にもよりますが、スタジオ真榊で使用しているRTX4080(16GB)では、AnimagineXLベースのLoRAを作るのにだいたい30~50分程度かかります。ちなみに、RTX3060(12GB)でほぼ同条件の学習を試したところ、所要時間は約1時間半でした。
<RTX4080での学習:50分強で終了>
<RTX3060での学習:約1時間半で終了>
追加学習するデータセットを用意するのはそれなりに手間が掛かりますし、より品質の良いLoRAにするためには画像の加工やタグ付けにも気を遣う必要があります。グラボの性能は大きなネックにはなりますが、さほど難解な操作や知識がなくても手順通りにやればLoRAはちゃんと作れますので、まずは恐れずに試してみることをおすすめします。
「やってはいけないこと」を再確認
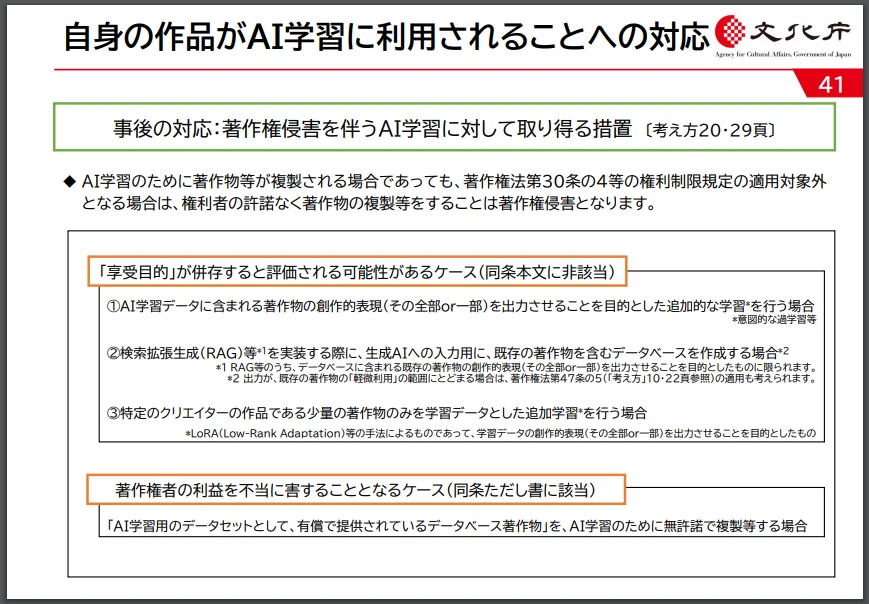
この記事を読んで下さる方の中には、今回初めて画像生成AIの「利用」ではなく「学習」に踏み出す方もいると思います。利用段階と学習段階では著作権に関する考え方が異なりますので、もう一度、文化庁が公開した「AIと著作権に関する考え方について」の内容を確認し、日本著作権法下における「やってはいけないこと・危ないこと」のラインを再確認してください。
以下は要点をまとめた「概要版」ですが、8ページ目にLoRAに関わる記述があります。
AI画像の生成段階においては、手描き絵と同様に誰かの著作物と似ているか(類似性)、本当にその著作物に基づいて作り出されたか(依拠性)の二つによって著作権侵害かどうかが主に判断されるわけですが、LoRA制作を含む学習段階においては、追加学習させる画像の収集行為が「著作物に表現された思想又は感情の享受を目的としない」ことや、「権利者の経済的利益を不当に害しない」ことが重要になります。とりわけ、キャラ再現LoRAや画風再現LoRAの作成については、どこに著作権侵害のラインが引かれるか非常に分かりにくいのが難点です。
著作権法においては、ご承知のように「作風(画風)やアイデアは保護されない」「著作権保護されるのは"表現"のみ」(表現とアイデアの二元論)というのが絶対的ルール。あるクリエイターの権利を保護しようとして、その人の作風やアイデアに似た絵を描いた人がかたっぱしから逮捕・訴訟されてしまうのでは創作全体が委縮するためですが、「それなら作風や画風はAIで模倣し放題なのか?」というとそうではありません。
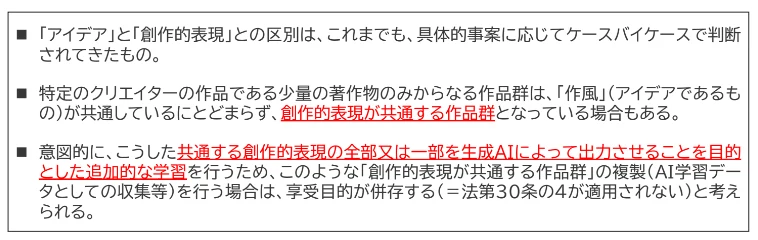
▲「AIと著作権に関する考え方について(概要)」8ページより
ある著作権者を「狙い撃ち」にするような方法で作風や画風の追加学習を行った場合、故意かそうでないかは別として、保護されない作風を超えて、著作権保護される「表現」まで模倣できてしまうことがあるーというのが重要なポイント。極端な話をすれば、教師データをトレパクしたかのような酷似画像ばかりが生成されてしまうLoRAがあったとすれば、学習段階でその著作権者のイラストを利用する際に許諾が必要となり、無許諾であれば著作権侵害となる恐れがあると言えます。
画像生成AIと著作権に詳しいSTORIA法律事務所の柿沼弁護士はこの点について、
と表現しており(リンク先より引用)、プロの目から見ても「学習段階においてセーフとアウトを区別するのは相当困難」ということのようです。
国内でLoRAの違法性が問われた判例はまだ一件もありませんので、どこにラインが引かれるかは判然とせず、素人が「ここまではセーフ」ということはできません。また、非営利のキャラクター二次創作(いわゆるファンアート)に話が及ぶとさらにややこしいことになります。もう一度文化庁資料をしっかり読み込んで、トラブルを招かないようしっかり自己防衛することが最も重要なことと思います。
【2024/08/01追記】
文化庁が新たに「AIと著作権に関するチェックリスト&ガイダンス」を公開しました。上記の「考え方」を基に、AI利用者が気を付けるべきことや、逆にAIを使って自分の作品に類似したものを生成された被害者の取るべき対応などが分かりやすく整理されています。
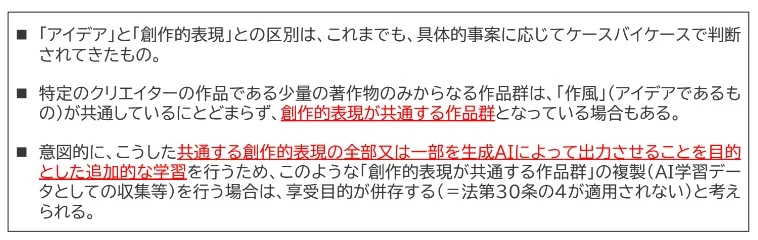
LoRA学習については、例えば「学習データに含まれる創作的表現の全部又は一部を出力させることを目的として追加学習を行う場合(特定のクリエイターの作品である少量の著作物のみを学習データとした追加学習を行う場合など)」は享受目的が併存すると評価される可能性があり、その場合は無許諾で画像をデータセットとしてDLすることなどが著作権侵害になると説明されています。
誰でもできる!LoRA学習環境を導入しよう
さて、LoRAの学習にはいくつかの方法がありますが、この記事では賢木が試して最も失敗が少なく、シンプルで、上級者になっても使えると感じた「Kohya_LoRA_GUI」(RedRayzさん作成)を使った方法を紹介します。
LoRAの学習には主にKohya (@kohya_tech)さんが作成された「sd-script」というツールが使われているのですが、黒いコマンドプロンプト画面で直接指示する作業がもう厳しい私のような文系人間のために、sd-scriptの仕組みを理解していなくても直感的に操作できるGUIがいくつか存在します。
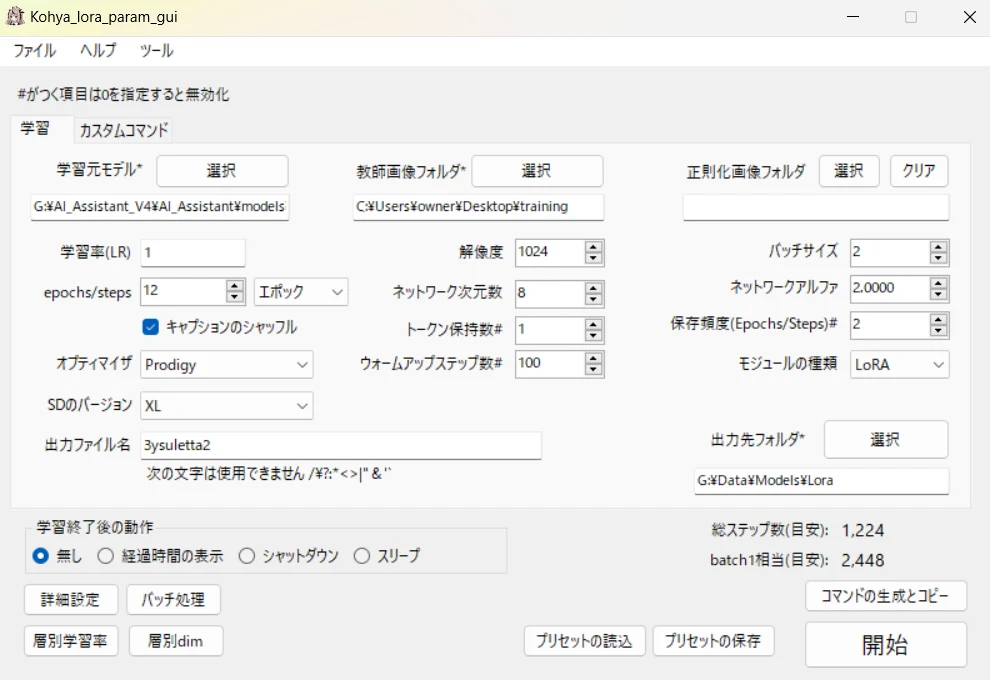
中でもこの「Kohya Lora param GUI」は見た目がシンプルにまとまっている点、入力欄にカーソルを合わせると分かりやすい説明文がポップアップする点、画面を閉じたときのパラメータを次回起動時に自動で再現してくれる点が非常に使いやすいです。RedRayzさんがLoRAを作るための最適設定を「基本プリセット」として配布されているので、それらを引用すれば、初心者でも高品質なLoRAを簡単に作ることができます。
<インストール手順>
さっそく下記の手順で導入してみましょう。Python3.10.6とGitが既にインストールしてあれば、「3」から始めてOKです(所要時間10分程度)
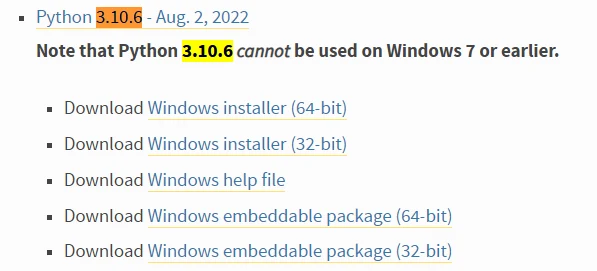
1.Python 3.10.6をインストールする
「Python(パイソン)」はAI開発に使われるプログラミング言語。StableDiffusionを既に触っている方はほとんどがPython 3.10.6を導入済みと思いますが、入門記事ですので一応導入方法を書き記しておきます。
Python公式サイトにアクセスし、Python 3.10.6のインストーラーをダウンロードします。最新版ではなく、ちゃんとバージョン3.10.6を選びましょう。
DLしたインストーラーを実行します。最初の画面で出てくる「Add Python 3.10 to PATH」にチェックを入れてから、「Install Now」をクリック。無事「setup was successful」と表示されたら「Close」をクリックでOKです。
2.Gitをインストールする
「Git」はファイルのバージョン管理が簡単にできるツール。公式サイトのダウンロードページに行き、最新版へのリンクである「Click here to download the latest」をクリックしましょう。
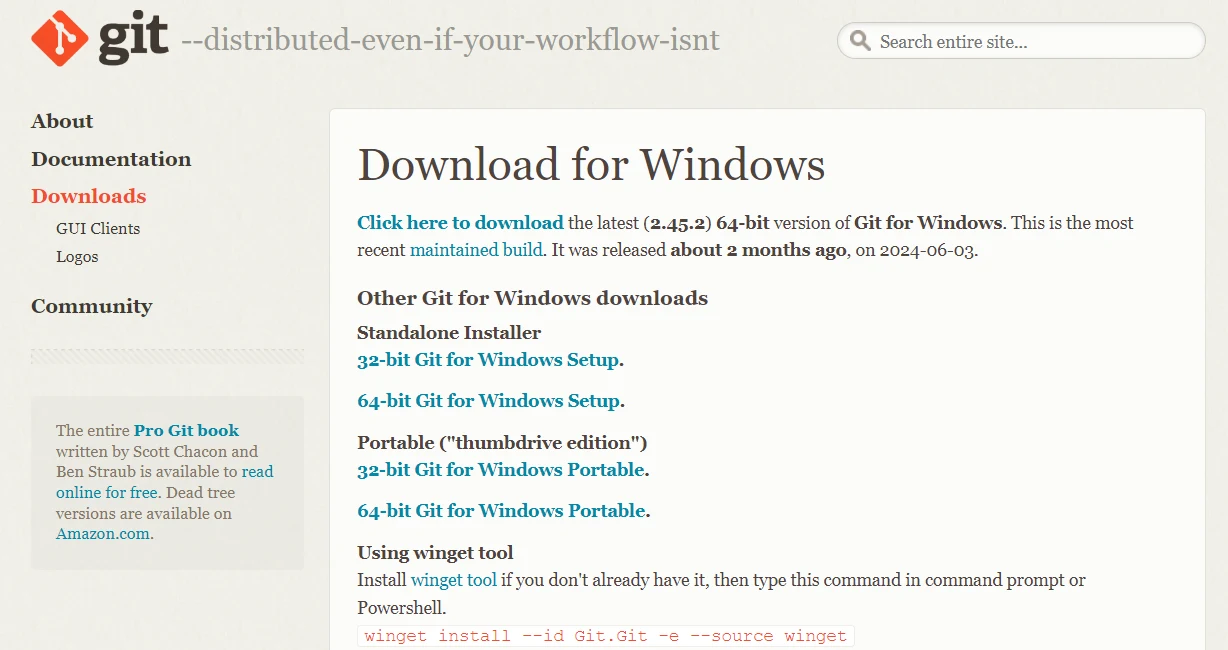
・ダウンロードしてきたexeファイルを実行。(記事執筆時点では2.45.2が最新です)
・インストールボタンが出るまで「Next」を連打します。チェックマークは変更しなくてOK。「Install」が出たらクリックしてインストール。
・インストールに成功したら、「View Release Notes」は見なくていいのでチェックを外し、「Finish」。デスクトップなどを右クリックしてこちらのメニュー(Git Bash Here)が生成されていたらOKです。
3.Kohya Lora param GUIをインストールする
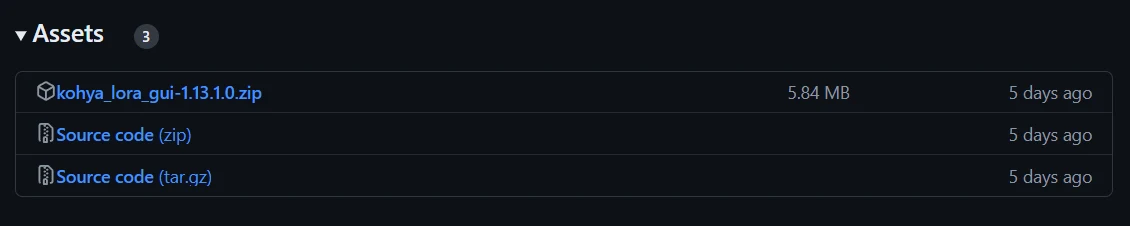
Python3.10.6とGitが準備できたら、Kohya Lora param GUIをインストールします。こちらのURL(▲)にアクセスし、「kohya_lora_gui-x.x.x.zip」をDLしましょう。(記事執筆時点の最新バージョンは1.13.1.0)
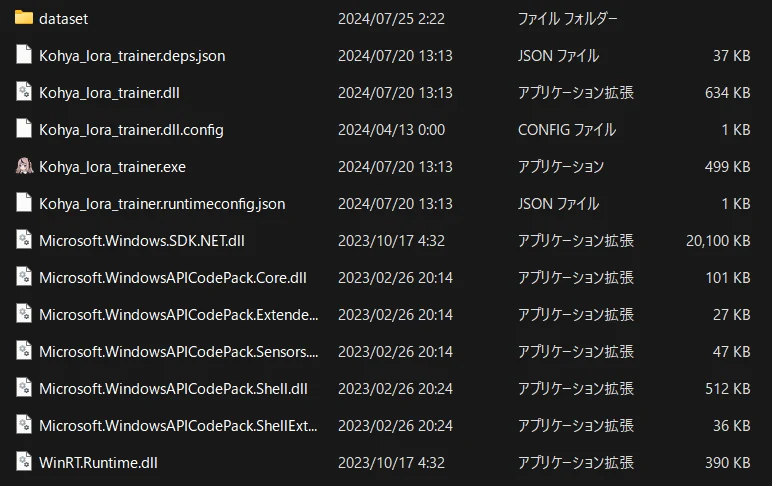
zipファイルを適当な場所に解凍します。いつものことですが、容量に余裕のあるドライブを選ぶこと。「kohya_lora_gui-1.13.1.0」というフォルダができると思いますので、中にある「Kohya lora trainer.exe」をダブルクリックしてGUIを起動しましょう。
初回起動時はこのように、sd-scriptのインストールが完了していないため「train network.pyが見つかりません」と赤字で表示されるはずです。まずは上部にある「簡易インストーラー」ボタンをクリックしましょう。
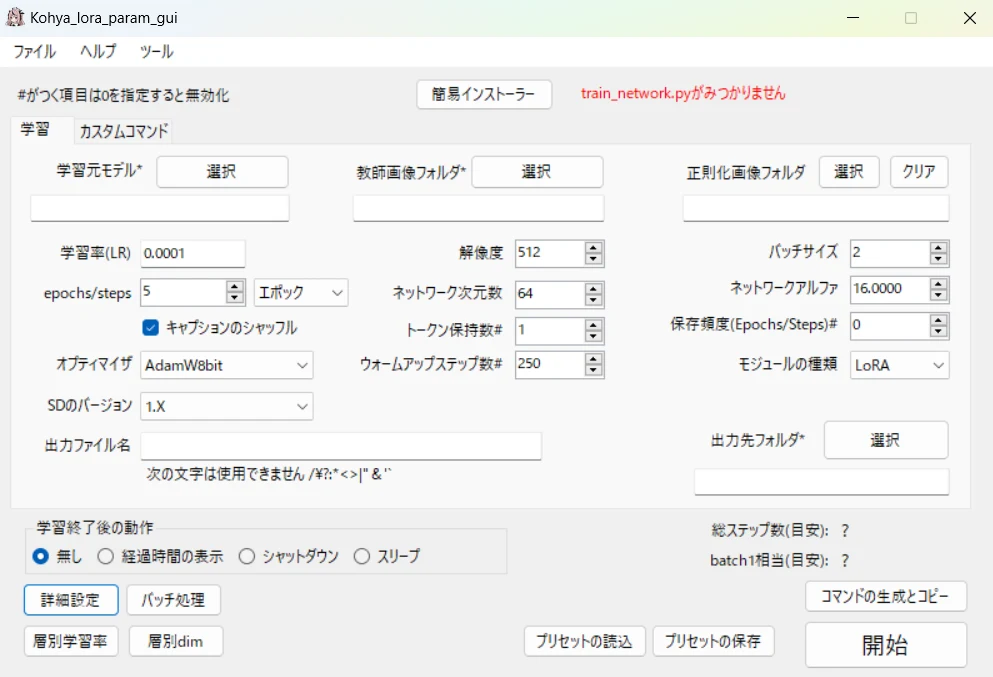
こちらの説明文を熟読して、理解出来たらインストールボタンを押します。「pythonの代わりにpyを使用する」にはチェックを入れなくてOK。インストール先フォルダの選択画面が出ますので、「GUIが入ったフォルダと同階層」を指定します。
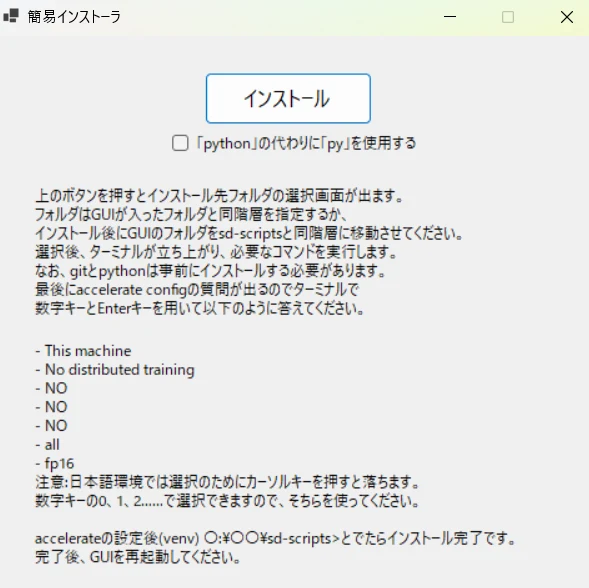
※「同階層を指定」というのは、例えば「C:ドライブ直下にさきほどkohya_lora_gui-1.13.1.0フォルダを解凍したのであれば、同じようにここでもC:ドライブ直下に指定してね」という意味です。もし違う場所にsd-scriptsをインストールしてしまった場合は、インストール後にGUIのフォルダをsd-scriptsと同じ階層に移動させましょう。
<注意:つまずきポイント>
インストールが進むのをしばらく待つと、最後に問答をする場面が出てきます。ここがつまずきがちなので、詳しく手順を説明します。
「This machine」など大半はエンターキーをぽんぽんと押せばOKですし、「NO」と答える部分は、そのまま半角英数大文字でその2文字を打ち込んでエンターキーを押すだけです。「all」は打ち込まなくても、そのままエンターキーでOK。
最後、「fp16」を選択するところだけが鬼門です!カーソルキーの「↓」を押したくなるのですが、絶対に押してはダメ。キーボードの「1」を押さないと最初からやり直しになってしまいます。「fp16」を選択状態にすると、下図のように「fp166」と表示されることがありますが、問題ありません。
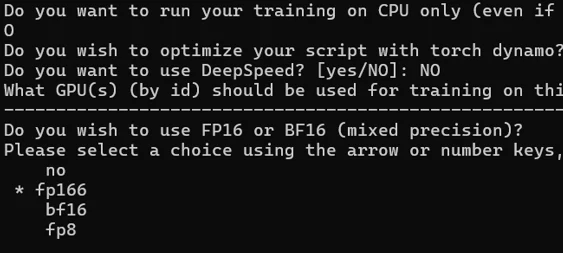
何度でもやり直せますから、さほど深く考えず、fp16(fp166)のところを「1」キーで選んで、エンターキーを押しましょう。
最後に 〇:¥〇〇¥sd-scripts> というメッセージが出たらインストールはおしまいです。「Kohya_lora_trainer.exe」も含めて開いている画面を閉じましょう。次回からは「Kohya_lora_trainer.exe」をダブルクリックすれば起動できるので、デスクトップにでもショートカットを作っておくことをおすすめします。
「kohya_lora_gui-〇.〇.〇」と「sd-scripts」両方のフォルダが、同じ階層にそろっていることを再度確認してください。「kohya_lora_gui-〇.〇.〇」フォルダは好きな名前にリネームしても構いませんが、「sd-scripts」はリネームしないようにしましょう。
何のLoRAを作るか決めよう
まずは「何の画像を集めて」「何のLoRAを作るか」を決めましょう。種類としては、キャラLoRA、画風LoRA、構図LoRA、ポーズLoRA、シチュエーションLoRA、スライダー系LoRA(描き込み量や胸の大きさ、年齢などを調整するもの)などがあり、基本的には再現したい概念が描かれた画像を数十枚収集することになります。
画像収集のポイントは次の5つ。
①追加学習させたい被写体・概念が大きく鮮明に描かれていて、
②「余計な概念」が映り込んでおらず、
③角度や表情、性別などさまざまなバリエーションがある画像を、
④できるだけたくさん集めること。
⑤迷ったら量より質!(最重要)
大事なのは②と③。キャラクターLoRAなら「全身図・バストアップ・横から・背後から・脚先や手先がよく映っているもの・アクションしているもの・さまざまな表情」とバリエーション豊かな教師画像が揃っているほど、プロンプト応用の利く(色んなプロンプト指示をしても破綻しない)LoRAになります。ただ、バリエーションがある方がいいと言っても「余計な概念」が映り込んでいないことに注意してください。
★余計な概念とは?
データの数は多いほど良いのですが、画質が悪かったり誤解が生じやすかったりする画像が混じっていると、誤った学習が行われてしまう恐れがあります。データセットを準備する際は「⑤迷ったら、量より質」を心がけてください。AIはデータセット内の何を学習して、何を学習してはいけないか理解できません。余計なキャラが映り込んでいたり、覚えさせたい状態と違う髪型だったり、ラフ画だったりするイラストがデータセットに混じっていると、思ったのと違う髪型や髪色で生成されてしまったり、線が乱れてしまったりします。
リンゴを持っているのび太の画像を学習させるとき、「holding apple」を覚えないように指示すれば、AIはのび太だけを学習できます。しかし、のび太と一緒にキテレツが映り込んでいた場合、「kiteretsuを覚えないで」と頼んでも、AIは「誰それ?」となります。すると、完成したLoRAはのび太の背後にキテレツらしきものを勝手に描いたり、キテレツっぽい服装ののび太を描いたりしてしまうかもしれません。「nobita」という概念が「のび太というめがねをかけた半ズボンの1人の少年キャラクター」に収束せず、余計な概念が混入してしまうのです。
基盤モデルが学習しておらず、除去しにくい要素(=余計なもの)が映り込んでいる画像は学習データとして避けたほうがよいということです。
また、集めたのが「笑顔でバストアップ」ばかりの画像だと、足元や背後がどうなっているか、笑っていないときはどんな表情をするキャラなのか学習してもらえず、プロンプト指示がうまくできなくなったり、四肢がすぐ破綻したりします。また、特定のイラストレーターさんの絵ばかりで追加学習させると、キャラLoRAというよりキャラ+画風LoRAになってしまう(意図せず"狙い撃ち"状態になる)ので、画風抜きでキャラのデザインだけを学ばせたい場合は、できるだけさまざまな描かれ方をしたイラストを学習することをおすすめします。
もう一度文化庁資料にあったことを思い出して、「アイデアを超えて表現をもコピーしてしまわないようなデータセット」を準備することを心掛けましょう。「だれだれの画像で学習させた」と吹聴するなど、ことさらに他人の気分を害すような振る舞いを避けるのも、トラブルに巻き込まれないコツであろうかと思います。
理想的なデータセットとは?
学習元となる画像は10枚以下でも作れますが、できれば最低20枚~50枚程度用意することをおすすめします。画像が多い方がいろいろな画像を出せる柔軟で高品質なLoRAになるのですが、枚数を優先して低画質な画像まで学習させてしまうと、「あ、このキャラは低画質に描いて欲しいキャラなんだな」とAIに誤解されるので、枚数よりもできるだけ高品質な画像を揃えることを優先しましょう(量より質)。キャラの特徴をつかんでいなかったり、遠くにぽちっと映り込んでいたりするレベルの画像は必要ありません。
【画像サイズと拡張子】
アスペクト比は正方形~4:3程度まで、縦長でも横長でも可。できれば短辺が1024pxあるものが望ましい。jpgもしくはpng。
【画風】
画風再現をしたくない場合は、特定のクリエイターの画風に偏らない方が望ましい。ちびキャラもあって構わない(詳しくは後述しますが、chibiなどのタグ付けはすること)。ただ、ラフ絵などキャラの特徴がはっきりしないものは取り除いたほうがいい。
【カラー】
夕焼けや夜、ネオンの光を浴びるなどしてキャラの色が変容している画像ばかりになるのは避ける。常に夕日を浴びているようなカラーリングになってしまう恐れがあるため。ただ、少ない枚数ならそうした画像があってもよい(これもnightやgolden hourなどとタグをつけよう)
【ほかのキャラの映り込み】
キャラLoRAを作るとき、別のキャラが映り込んでいない方がよい。ちょっと見切れる程度なら数枚そうした画像があっても問題ないが、できれば消しゴムした方が良い。1girl,soloと指定しても複数キャラが生成されやすいLoRAになってしまうため(非常によくある、キャラLoRAで失敗するケースです)
※ただし、今後2人で描くことが多いカップリングを学習させる場合、2人でいるイラストもある程度学習させたほうが背丈や体格の差などを学習できる場合もある。
【背景】
白背景、もしくは透過背景がおすすめ。のび太LoRAを作るとして、のび太の部屋の背景の画像ばかり学習させると、のび太という概念の中にのび太の部屋が混ざってしまい、柔軟な背景が生成しにくくなる。(手作業で一つ一つ背景を消すのは大変なので、一括削除する手法も解説します)
(※人間キャラなら1girlか1boyかでたいてい体格も学習できるが、全く新しい存在(ポケモンやモビルスーツなど)を学習させる場合、どれくらいの大きさなのかが分かるよう背景込みや人間込みの画像があったほうが良い)
全く同じイラストでも、詳細に覚えてほしい顔部分やディティールをクローズアップした画像も用意して学習させるとよいでしょう。下図は一例ですが、このようにただアップにしたり、単に左右反転させただけの「バージョン違い」も、ちゃんと容姿を覚える役に立ちます。(もちろん、デザインが左右非対称のキャラクターはNG)
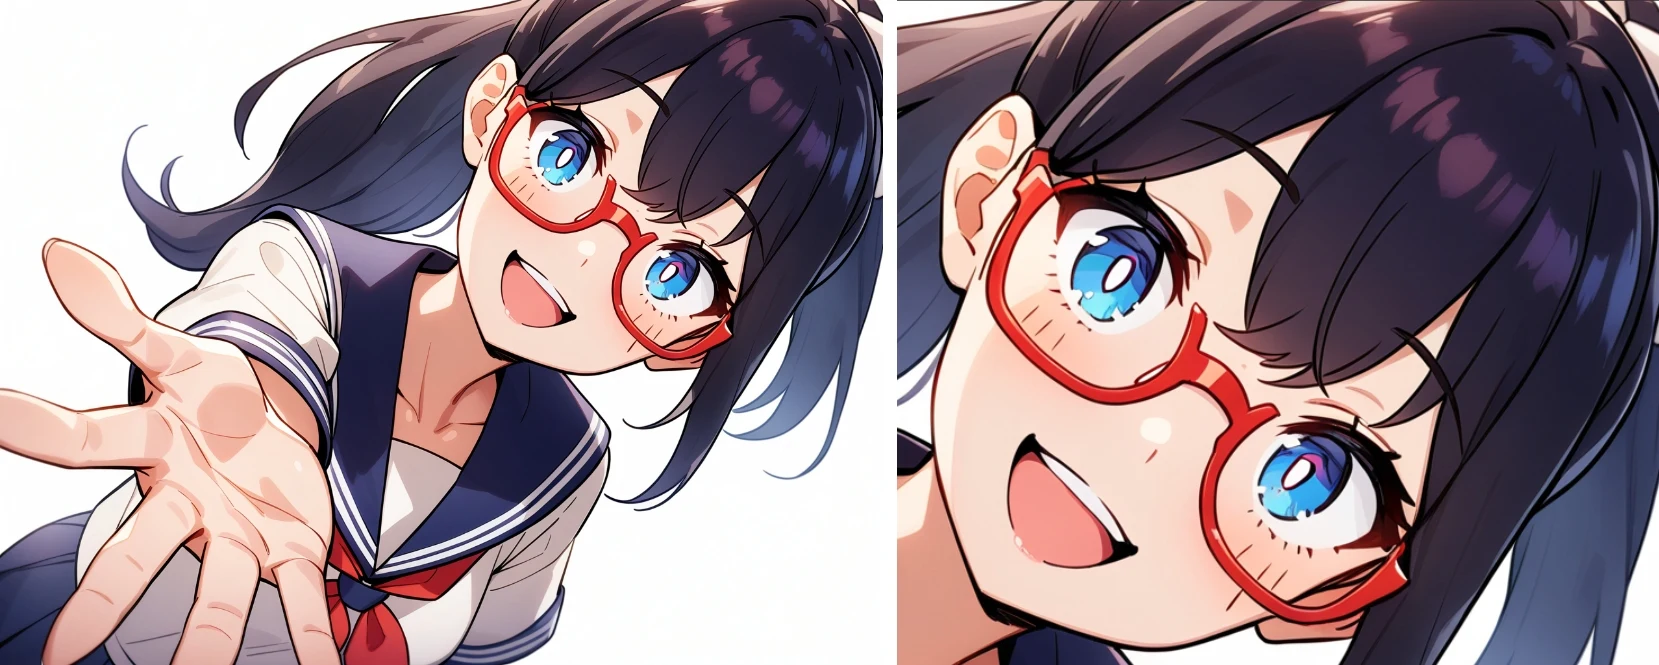
▲同じ画像でもアップにしてデータセットを水増しできる。このままだと目が溶けて見えるので、加筆するか、アップスケールして綺麗にしてから学習させましょう。
【コラム】AI絵をデータセットにするには?
ウェブ上にあるイラストではなく、自分で生成したAI絵をデータセットにしても問題ありません。先日紹介した「CoppyLoRA webUI」を使えば、一貫性のあるオリジナルキャラクターを多数作ってデータセット化することも可能です。
CoppyLoRAは、全く追加学習の知識がなくても画像を1枚用意するだけで簡易LoRAが作れるところが画期的だったわけですが、バストアップの画像1枚だけから作るので、被写体の全身の再現や構図・ポーズの応用力には限界がありました。しかし、簡易LoRAで多数生成したAI絵の中から数十枚をチェリーピックし、データセット化して追加学習することができれば、簡易LoRAからスタートしてより本格的なオリキャラLoRAや自分画風LoRAを作ることが可能になります。
★さまざまなバリエーションのオリキャラ画像を作ろう
ポイントはさきほど解説したとおり「質のよいバリエーションをそろえること」なので、WildcardやDynamicPromptを使って、できるだけさまざまな表情・角度・ポーズ・構図の画像を取りそろえるとよいでしょう。背景は白背景固定で構いません。この検証記事では、CoppyLoRAで作った簡易LoRAで再現したオリジナルキャラクター「更木ミナちゃん」のAI絵でデータセットを作ることにします。そこで、下記のようなランダムプロンプトを組みました。
PP:<lora:zarakimina:0.5>1girl,solo,sidelocks,red glasses,{looking at viewer|looking away},{full body,navy pleated skirt,black pantyhose|upper body|close up|from side|from behind,back view},__emotion__,__pose(body)__,blue eyes,white pupils,school uniform,serafuku,ponytail,short sleeves,shiny skin,black hair,white bow,red neckerchief, masterpiece, best quality, very aesthetic, absurdres,, white background, simple background
まずはCoppyLoRAで作った簡易LoRAで画風とキャラデザを固定。dynamic promptで視線や画角、ポーズにバリエーションを出しています。瞳の色が指定されているので、真後ろからの画角などは再現されにくいのですが、これである程度大量生成して良い画像をピックアップし、足りない画角は自分で指定してそろえるのが良いかなと思います。
(※パースの利いた画像が出ないよう、looking upやfrom above、from belowは封印しています。うまくタグ付けができないと、異様に顔が大きかったり、逆に小さかったりする人間だと誤解されるからです)
実際には背後と横からのイラストが上手にできなかったため、プロンプトを再調整してその画角のみガチャをやり直しました。
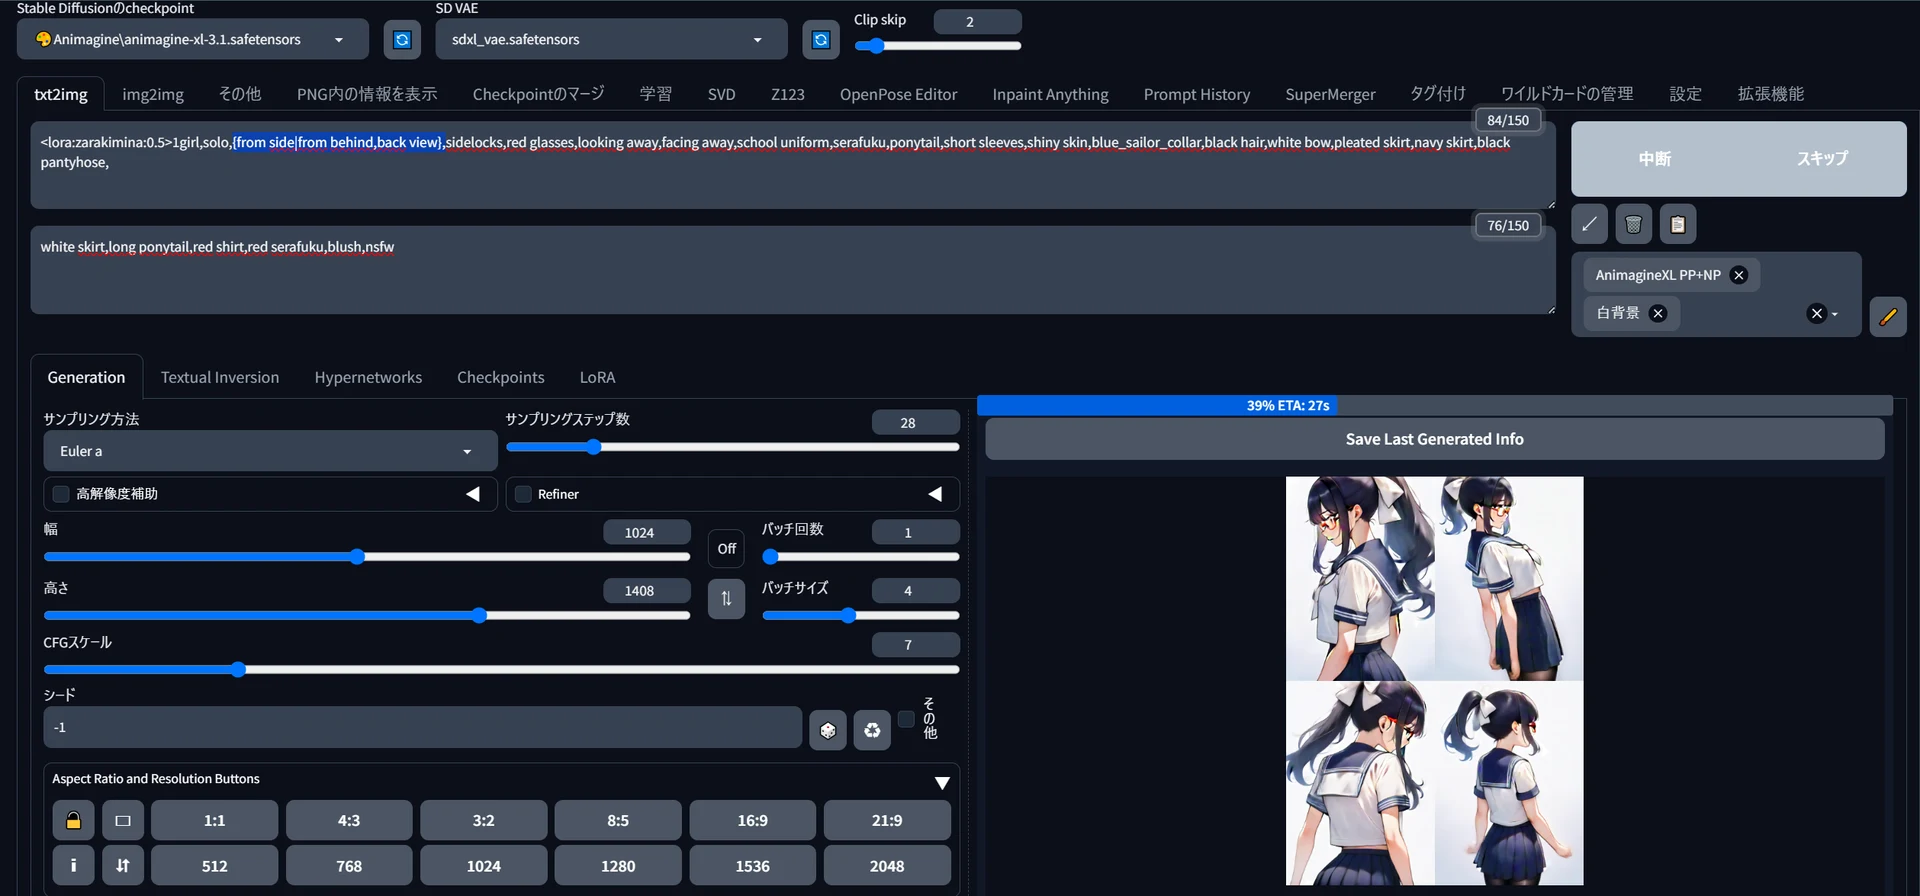
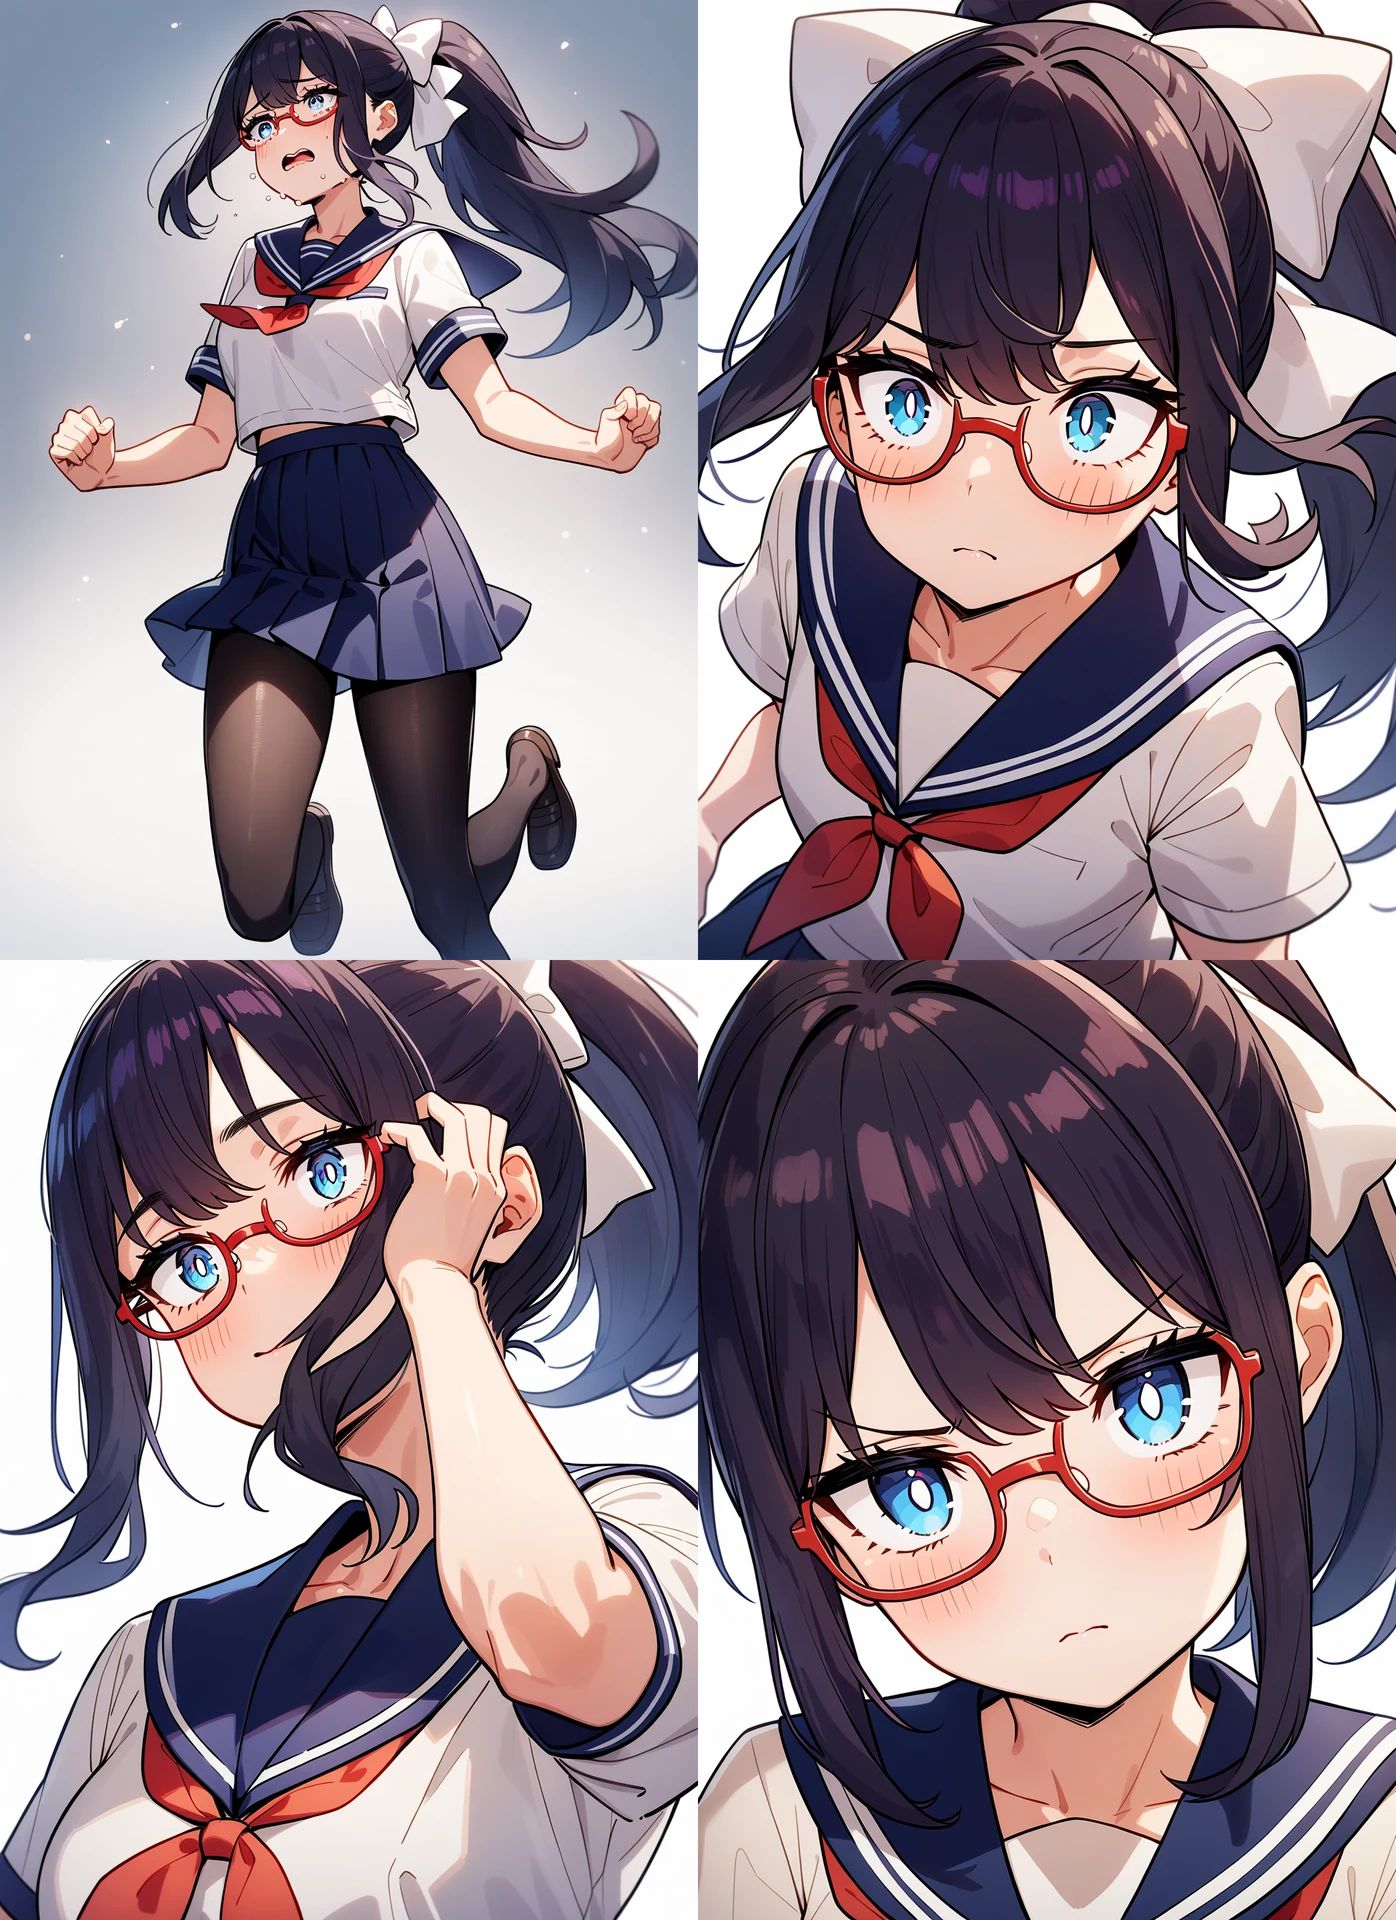
こちらが生成例。やはりバストアップの簡易LoRAで作ったので、下半身や腕部が映り込んたり、ポーズをとったりさせると崩壊しやすいです。チェリーピックや加筆によってなんとかバリエーションを用意し、こうした低劣化が起きない高品質なLoRAが作れるとよいですね。
表情やポーズのランダム化に使用したwildcardは、プロンプト超辞典の該当項目で配布していますので、どうぞご使用ください。
※より詳しい自分画風LoRAの作り方については、こちらの記事を参照のこと。
画像はどこに保存する?
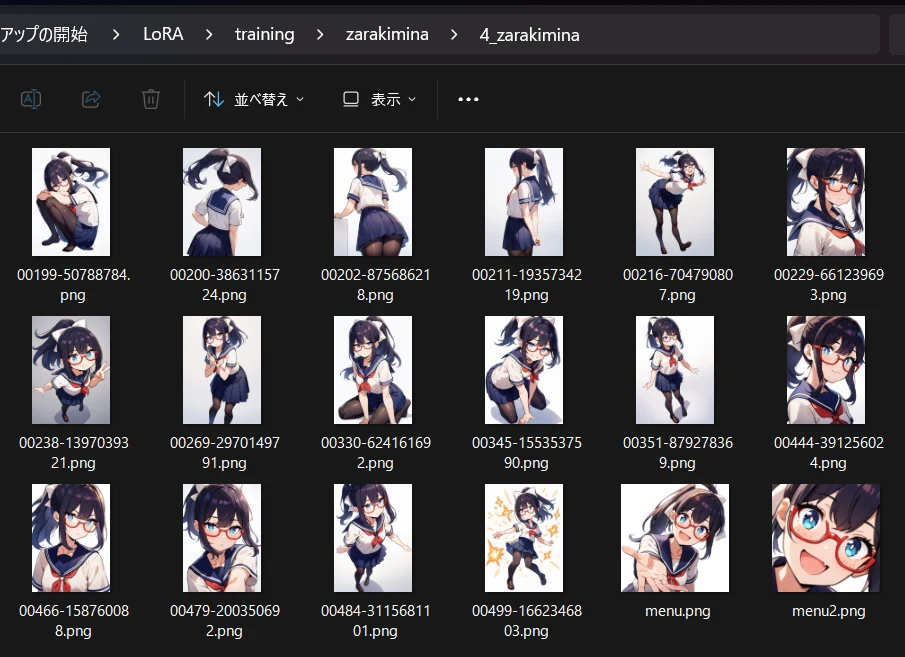
さて、収集もしくは生成した画像を集めるフォルダの構造は少しややこしいです。まずは好きな場所にルートフォルダ(例:LoRAフォルダ)を作り、その中にトレーニング画像フォルダ(例:training)を作るのがおすすめ。さらにその中に、これから学習するLoRAごとのフォルダを作るわけですが、画像を保存するのはさらにもう一つ下のフォルダになります(下図では10_zarakiminaと4_sakakiioが画像保存先)
LoRA/ ←ルートフォルダ(名前はなんでもよい)
└ training/ ←学習データを入れるフォルダ(名前はなんでもよい)
├ zarakimina/
└ 10_zarakimina/ ←ここに画像を保存する
└ sakakiio/
└ 4_sakakiio/ ←ここに画像を保存する
画像を保存するフォルダの冒頭の数字が、画像1枚あたり何回学習するかの指示になります。回数が多すぎると学習に時間がかかり、やりすぎると「過学習」が起こって失敗LoRAになってしまいます。ここの数字をどう考えて設定すべきかはあとで説明しますので、ここでは何も考えず、「用意した画像が20枚くらいなら10」「50枚くらいなら4」としておいてください(かけ合わせたら200になる数字を入れる)。この記事では今後、この数字つきフォルダを「画像保存フォルダ」と呼びます。
つまり、こんな感じのフォルダ構造になっていればOK。必ず「trainingフォルダの下は2重構造」「画像保存フォルダの冒頭は数字とアンダーバー」のルールを忘れないようにしてください。
今後別のLoRAを作る場合は、
「...\training\zarakimina\10_zarakimina」
「...\training\yamadataro\8_yamadataro」
「...\training\satohanako\4_satohanako」
というように、trainingフォルダ内部にディレクトリを増やしていきましょう。
画像のサイズ・ファイル名をそろえるには
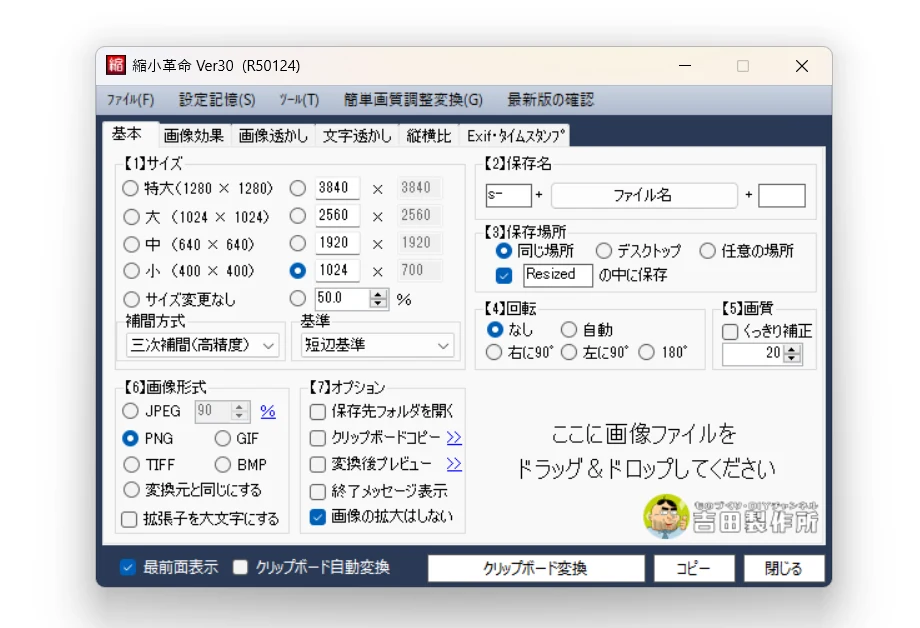
画像のサイズはすべて同じに揃える必要はありませんが、極端に大きすぎたり、縦長や横長過ぎるとリサイズ/トリミングされてしまう恐れが生じます。画像生成でアップスケールするか、フリーソフトなどで1024x1024pxの正方形からさほど離れていないサイズに縮小しましょう。おすすめツールはこちらの「縮小革命」。
操作は簡単で、このように「1024x〇〇」を選び「短辺基準」「回転なし」「PNG」としておき、右下に画像ファイルを複数選択してドラッグ&ドロップすると、「保存場所」で指定した場所に指定通りのサイズに変更された画像がドッと生成されます。「Resizedの中に保存」にチェックを入れておけば、ファイル名の頭に「s-」がついた画像がResizedフォルダ内に一括生成される仕組みです。
(※縦横比のタブで"アスペクト比調整を有効にする"にチェックが入っていないことを確認しましょう。チェックされていると画像がトリミングされてしまいます)
これで、集めた画像群をすべて「短辺1024px」にそろえることができます。ついでに、ファイル名も「Namery」などのリネームソフトを使って「〇〇〇01.png」「〇〇〇02.png」...と半角英数にそろえてしまいましょう。 日本語など余計な文字種が混じっていなければ学習できますので、必ずしもLoRA名や連番数字が振られている必要はありませんが、こうしておくとテキストファイルとペアにするときに見やすいです。
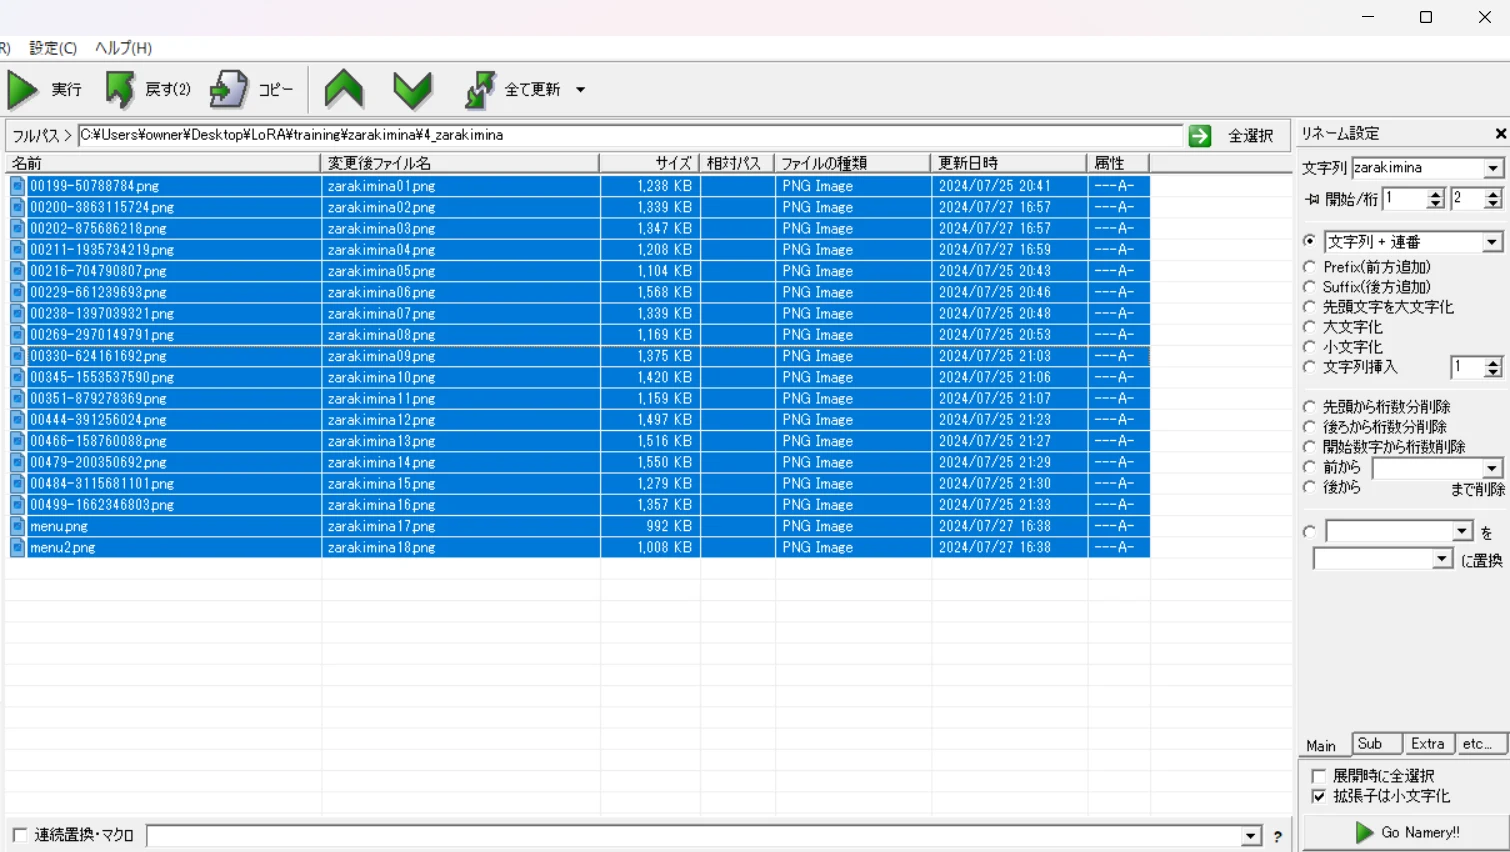
▲Nameryは昔からあるリネームソフトですが、直感的に使いやすいので重宝しています。右側のメニューから「文字列+連番」を選んで文字列を「zarakimina」にすれば、選択したファイルをこのように一括リネームできます。
背景の消し方
背景LoRAを作りたい場合は別ですが、キャラクターや服などの「前景」を追加学習させたい場合、背景を削除してしまったほうが品質がよくなります。こちらの拡張機能「RemBG」を使うのがオススメ。
インストールはこちらのURLを「URLからインストール」に放り込むか、拡張機能リストの中から「stable-diffusion-webui-rembg」を見つけてインストールするだけです(Forgeも対応しています)。
インストールすると、「その他(Extra)」タブにこのようなメニューが追加されています。一番左のプルダウンメニューで、背景削除に使用するモデルを選択しましょう。アニメ調イラストから切り抜くなら「isnet-anime」がおすすめです。
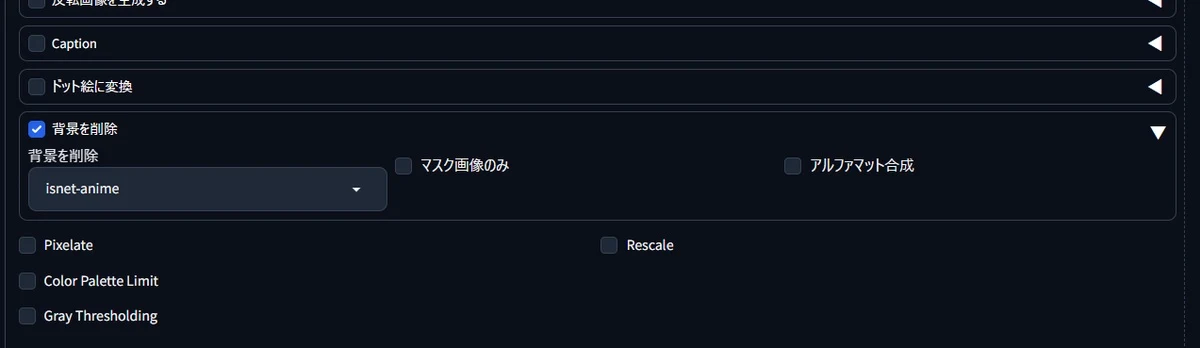
あとは「その他」タブの「ディレクトリからバッチ処理」で、画像保存フォルダを入力ディレクトリに指定すればOK。背景がある絵とない絵が混ざるといけないので、出力ディレクトリは適当な別の名前にしておきましょう。
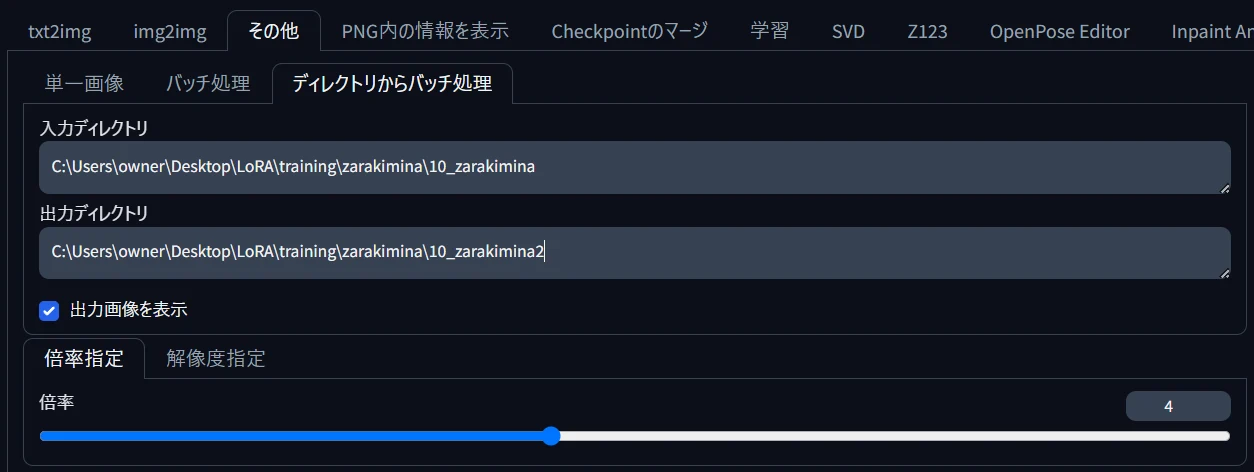
このように背景が一括削除されました。たまに失敗して残すべきところが消えたり、背景が残ってしまったりしていることがありますので、よくチェックしておきましょう。
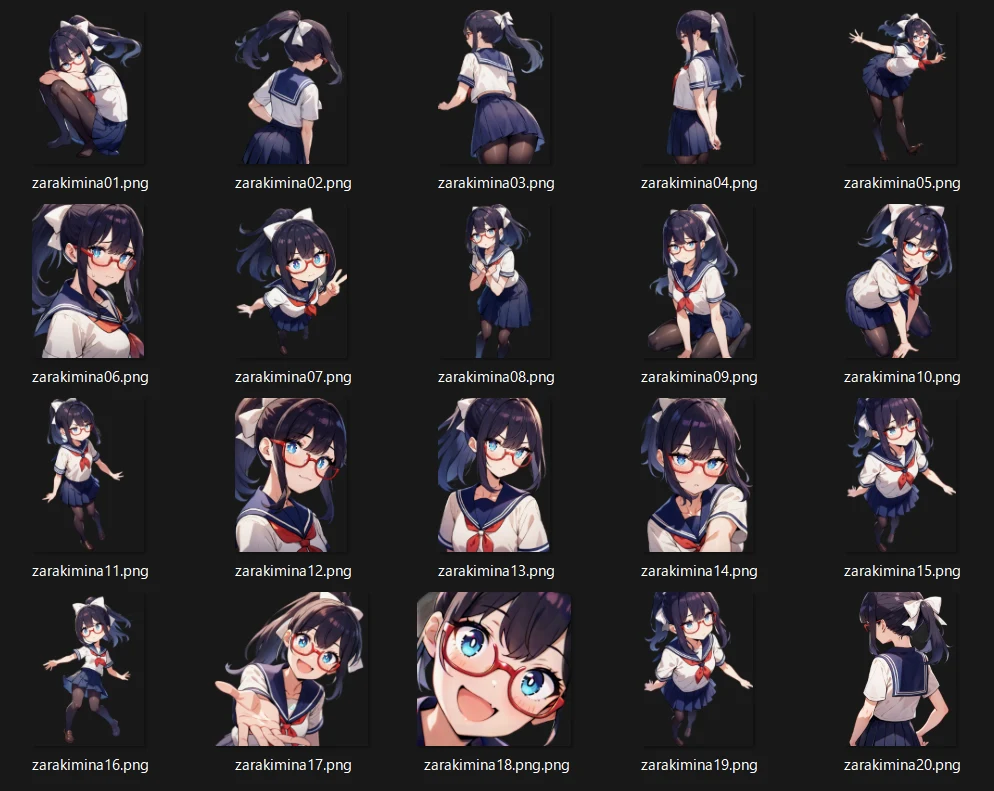
問題なければ、もともとあった「10_zarakimina」フォルダはどこか別の場所へ移し、この「10_zarakimina2」フォルダを「10_zarakimina」フォルダにしてしまいましょう。「zarakimina」フォルダの下には、透過画像の入った「10_zarakimina」フォルダしかない状態であることを再確認してください。
<なんでそんな面倒なことするの?>
「10_zarakimina2」フォルダなど作らず、はじめから「10_zarakimina」に透過画像を上書き生成すればいいじゃないかと思うところですが、RemBGはたまに透過に失敗してしまうので、いったん人間の目でチェックできる段階を挟んだ方が無難です。きれいに透過できなかった画像はデータセットから除去するか、自分で消しゴムするか、透過前のオリジナル画像をそのまま使いましょう。
【コラム】容姿にバリエーションがある場合は?
ここでちょっと脱線。1人のキャラでも、複数の髪型/服装バリエーションがあることってありますよね。髪を結ったり下ろしたり、「ウマ娘」で言えば勝負服だったりトレセン学園の制服だったり体操着だったり。その場合、教師データにそれらのバリエーションが混在していて構わないのでしょうか?
答えは
「①どれが通常状態かを決めて、タギング(タグ付け)をしっかりしましょう」
「②難しい手法を使えば、複数パターンを切り替えられるLoRAも作れます」
です。
例えば、オリジナルキャラの容姿を「zarakimina」というタグの概念としてLoRA学習させるときに、タギングによってセーラー服姿の概念だけ学習させれば、「1girl,zarakimina」と指定するだけでセーラー服姿のミナちゃんが生成されるLoRAにできます。もしさまざまな別衣装の画像がデータセットに混じっていても、タギングによって除去して「zarakimina」タグに集約させなければよいわけですね。
ちなみに、複数のバリエーションをきちんとフォルダ分けして学習し、トリガーワードをそれぞれに作ることで、複数の衣装を覚えさせることも可能です。ただ、きちんとタグ付けの概念を理解していないといけないので、やや上級者向けの方法となります。
例えばこのように、「miorine_rembran」で通常時の制服ミオリネさん、「3ylatermio」で短髪バージョンのミオリネさん、「suitmio」でビジネススーツ姿のミオリネさん、「bosarine」でぼさぼさ頭のミオリネさんを、一つのLoRAで再現することができます。
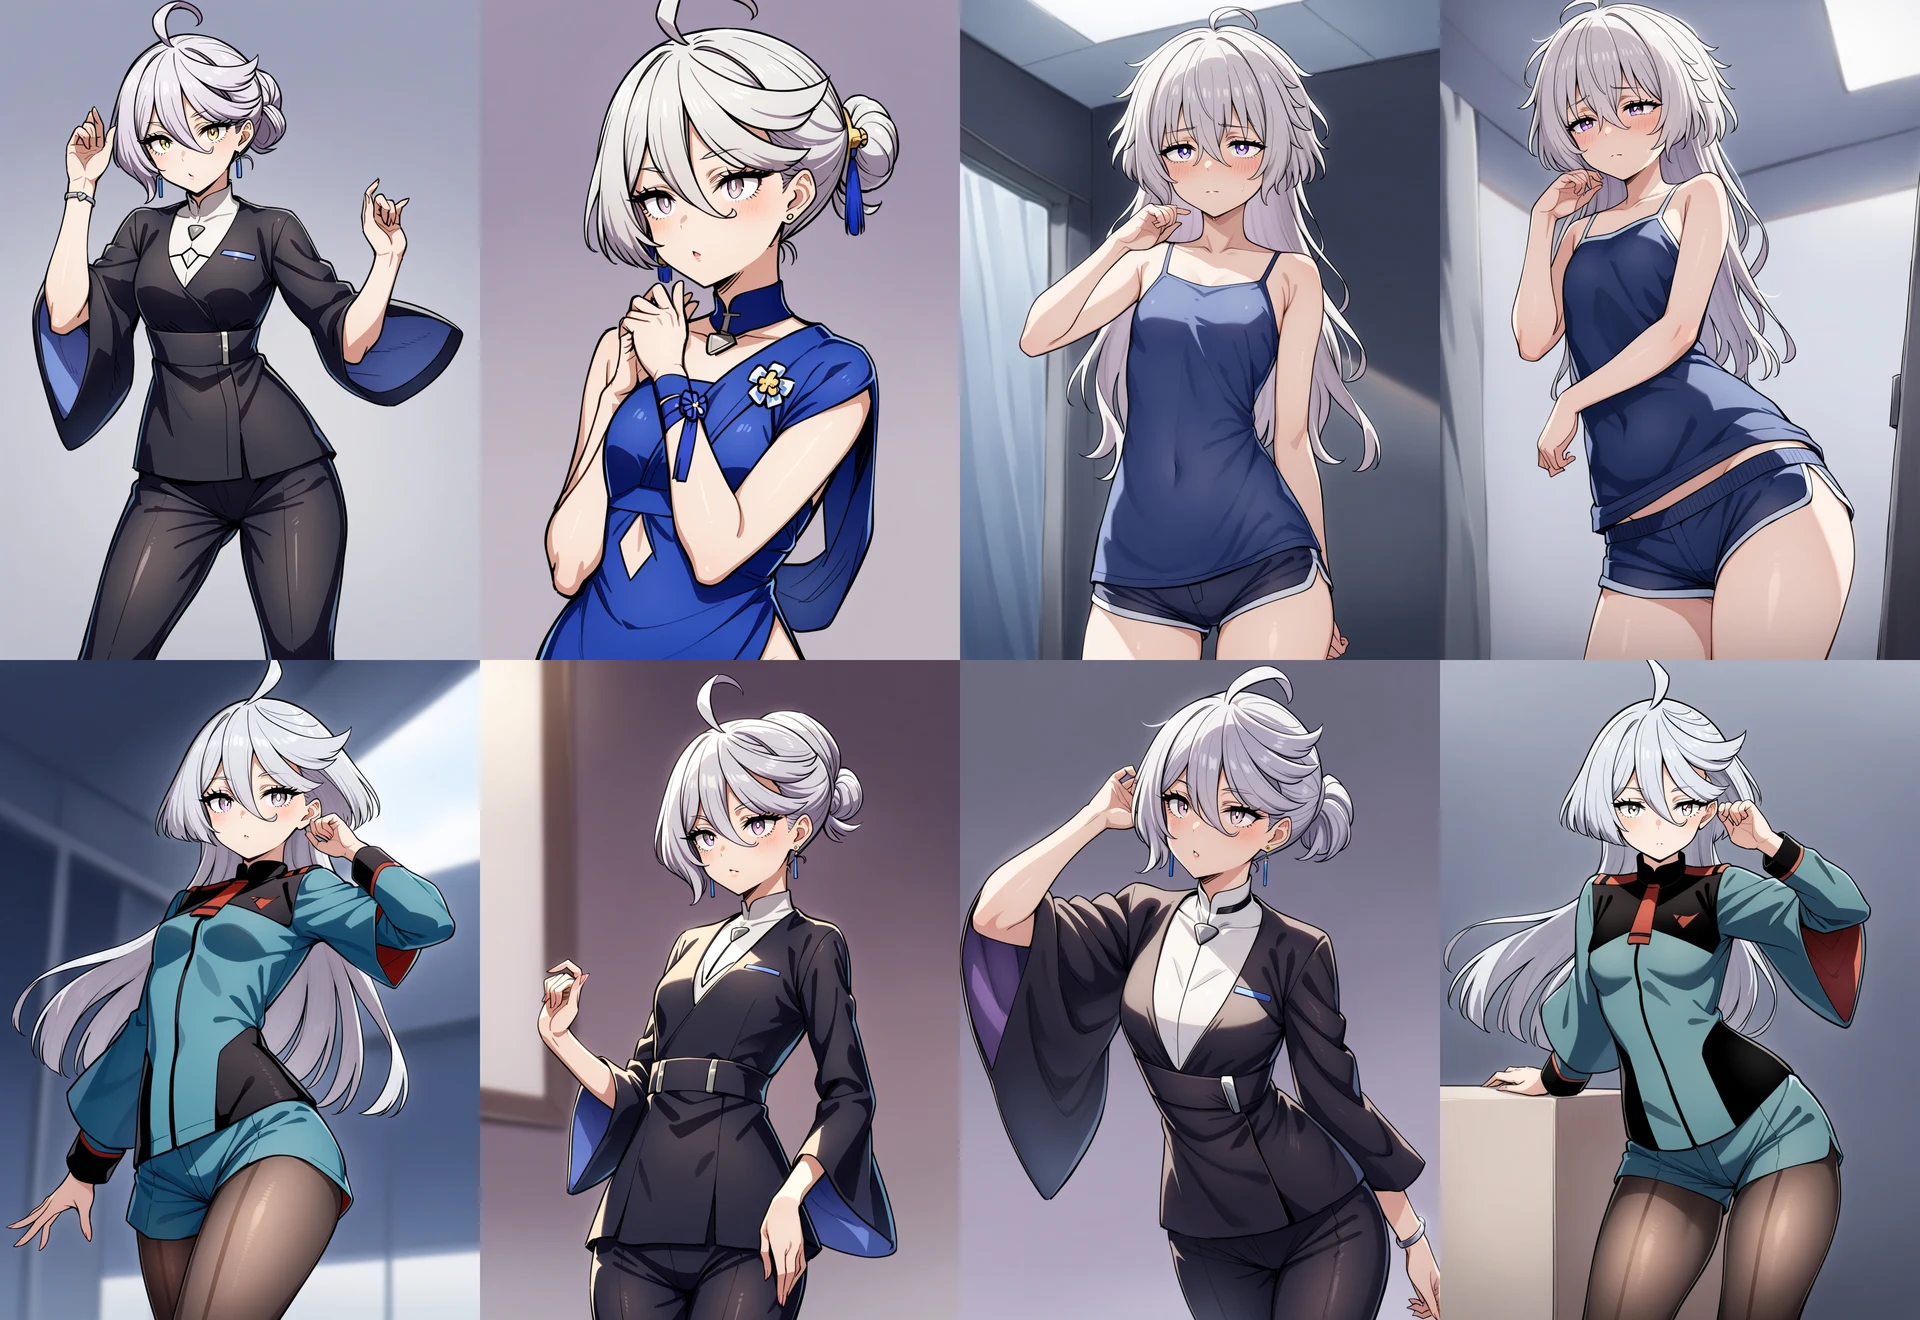
詳しいやり方はこちらの記事にまとめてありますので、LoRA学習に慣れてきたらぜひ挑戦してみてください。
タグ付け(タギング)って何?
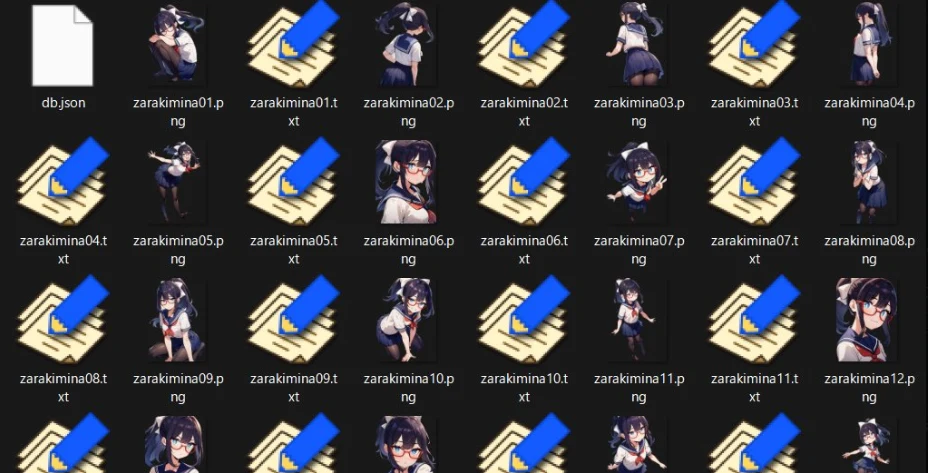
さて、画像生成AIのデータセットは「セット」というくらいですから、画像だけではなくそれに対応した説明文(テキストデータ)が必要です。いま学習用のフォルダ内に「uchinoko01.jpg」「uchinoko02.png」...と20枚の画像が並んでいるとしたら、上の画像のように「uchinoko01.txt」「uchinoko02.txt」...と20個のテキストファイルも並んでいないと学習することができません。
テキストファイルの中身はこんな感じで、最初にトリガーワードが書かれ、その概念(この場合は再現したいキャラ)がどこで何をしている画像かがそののちに続きます。
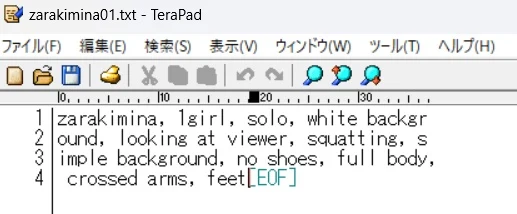
さきほども書きましたが、ここが非常に重要なポイント。「zarakimina」だけなら、画面内にある全てをAIは学んでしまいますので、この画像が「zarakimina」がどこで、誰と、どんな格好で、何をしている、どんな画風で描かれたイラストなのかをタグで指定してあげる必要があります。逆に言えば、ここで「指定しなかった」要素は全て「zarakimina」の概念として集約され、LoRAに刻まれるわけです。
「タグ指定しなかった要素が学習される」というのが近い理解ですが、より正確に言うなら「タグ指定しなかった要素が冒頭のトリガーワードに"集約"される」と考えてください。例えば「black hair,ponytail」を除去すればzarakiminaは黒髪ポニーテール、「serafuku,blue sailor collar」と除去すれば襟の青いセーラー服という概念が「zarakimina」に集約されます。
逆に、服装や髪型のタグを維持した場合(残した場合)、髪色や服装をプロンプトによって操作しやすいLoRAになります。serafukuを残せば「これはzarakiminaがセーラー服を着ている状態なんだよ」と教えることになるので、「zarakimina」にセーラー服概念が集約されず、別衣装に着替えさせやすくなるというわけです。(除去した場合はT-shirtと指示してもなんとなくセーラー服っぽいTシャツになりがち)
つまり、タギングは画像の中の学習対象を取捨選択できる重要パートというわけ。例えば、上のタグから「looking at viewer」や「squatting」を間違って除去すると、「zarakiminaは常にしゃがんでこっちを見ている存在なんだな」と勘違いされてしまい、視線操作や姿勢操作が難しくなります。
★「1girl」は残すべき?
ここで応用問題。「1girl」や「2girl」「solo」といったタグは消した方がいいでしょうか?
これは残しておくのが正解です。消してしまうと、「この画像は女の子であるzarakiminaが1人でいるところ」という概念指定・人数指定がしにくくなってしまいます。すると、生成時に「1girl,solo」と指定しても複数キャラが生成されてしまいやすくなってしまうのです。
★タギングしにくい要素は「画像から」消そう
「タギングすれば学習対象から排除できる」ということは、つまり「タギングしにくい概念は必ず混入してしまう」ことでもあります。さきほどのび太とキテレツの例で説明しましたが、例えば車やビル、木々や雑踏、文字など非常に込み入った背景の画像が学習データに混じっていた場合、タギングですべて除去するのは難しくなります。
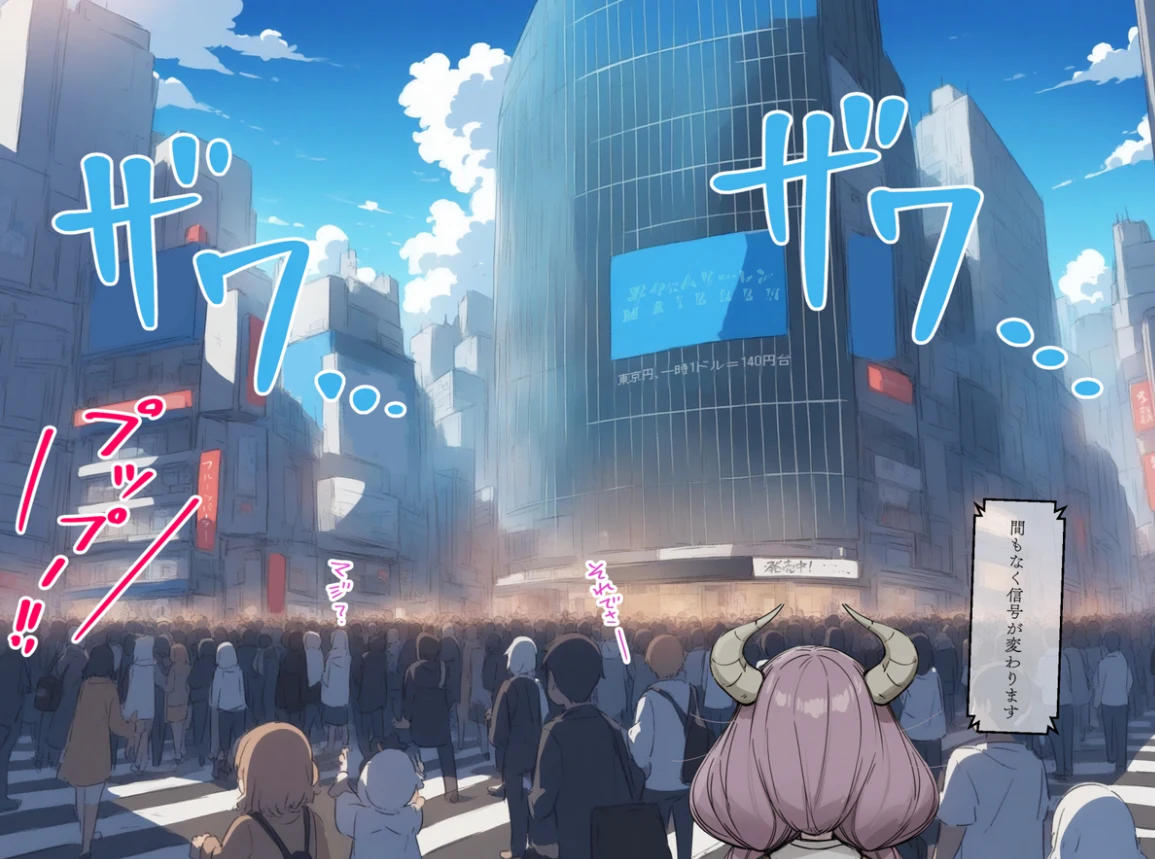
さきほど背景をRemBGで一括削除したのはこういうわけで、ポーズや表情はタギングで排除するしかありませんが、タギングで排除しにくい要素は、そもそも画像から消しゴムしてしまったほうが良いわけです。上手に消せない場合は、そもそもその画像をデータセットから排除してしまった方が結果的に良いLoRAができるでしょう。
一括タギングできるTaggerを導入しよう
さて、手打ちで何十枚もの画像にテキストデータをいちいち整えるのは大変なので、SDwebUIの拡張機能「wd14-tagger」をインストールして、自動判別でdanbooruタグを抽出してもらいます。
★「wd14-tagger」のインストール方法
StableDiffusion webuiのExtensionタブの一覧から「stable-diffusion-webui-wd14-tagger」を探してインストールしても、下記のURLを「Install from URL」タブで貼り付けてインストールしても、どちらでもOKです。
UIを再読込すると、txt2txtなどのタブに並んで「Tagger(タグ付け)」のタブが追加されています。
★高性能な「wd-swinv2-tagger-v3」を入手しよう
さて、wd14-taggerではさまざまなタグ付け用モデルがプリインストールされているのですが、より高性能なタグ付けモデル「wd-swinv2-tagger-v3」を導入しましょう。
「AI-Assistant」に画像を読み込ませてタグ付けボタンを押すと、秒でめちゃくちゃ高性能なタグ付けをしてくれて驚くのですが、あれはこの「wd-swinv2-tagger-v3」が内蔵されているお陰なのです。
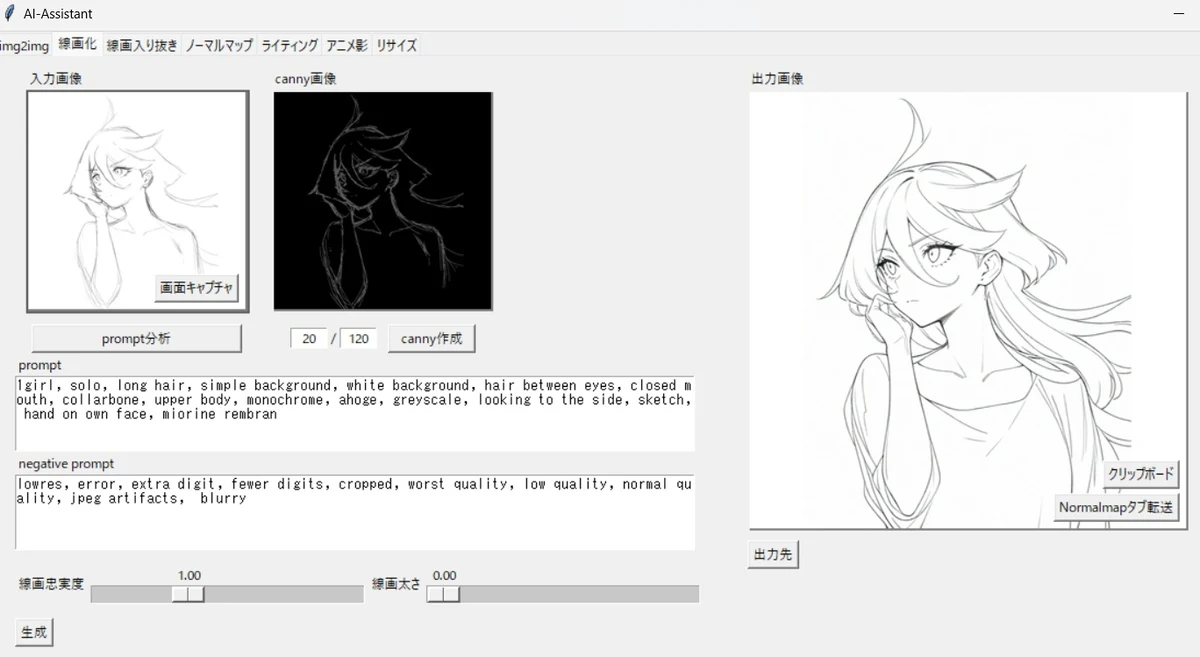
モデルはこちらなのですが、普通にDLしてフォルダに配置するやり方では導入できませんので、次の方法でインストールしてください。
①「extensions\stable-diffusion-webui-wd14-tagger\tagger」フォルダ内にある「utils.py」というファイルをテキストエディタで開きます。
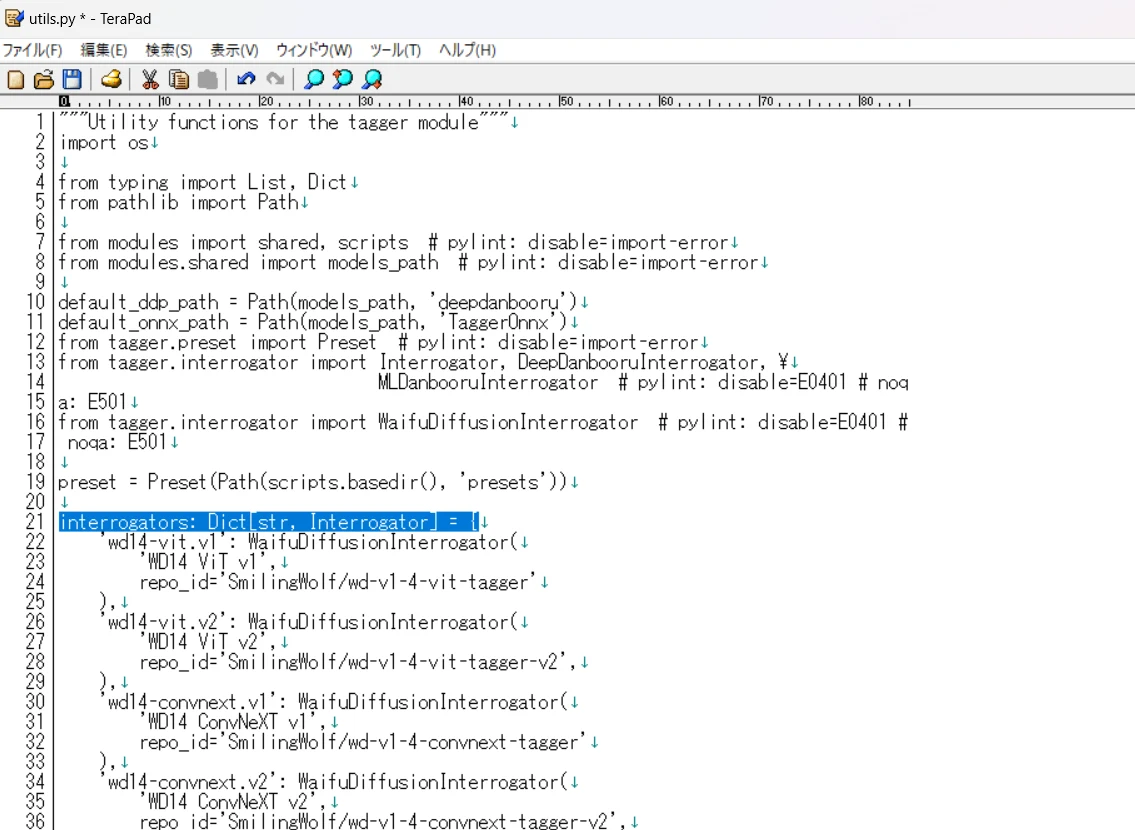
②21行目(※記事執筆時点。アップデートで変更される可能性があります)にある interrogators: Dict[str, Interrogator] = { から改行して、以下の4行を挿入します。行の冒頭に4つ、または8つ半角スペースが入っていますが、これをそのままコピペしてください。pythonではインデント(行下げ)が揃っていないとエラーが起きるので、他の行と見比べて、行が揃っているか確認してください。
'wd-swinv2-tagger-v3': WaifuDiffusionInterrogator(
'WD Swinv2 tagger v3',
repo_id='SmilingWolf/wd-swinv2-tagger-v3'
),
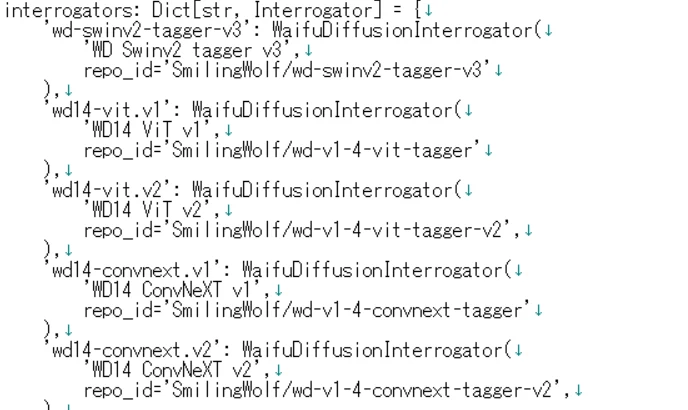
④該当部分が次のようになっていればOK。挿入した各行の位置が他の行と揃っていることを確認できたら、テキストエディタ上で「上書き保存」し、webUIを再起動しましょう。
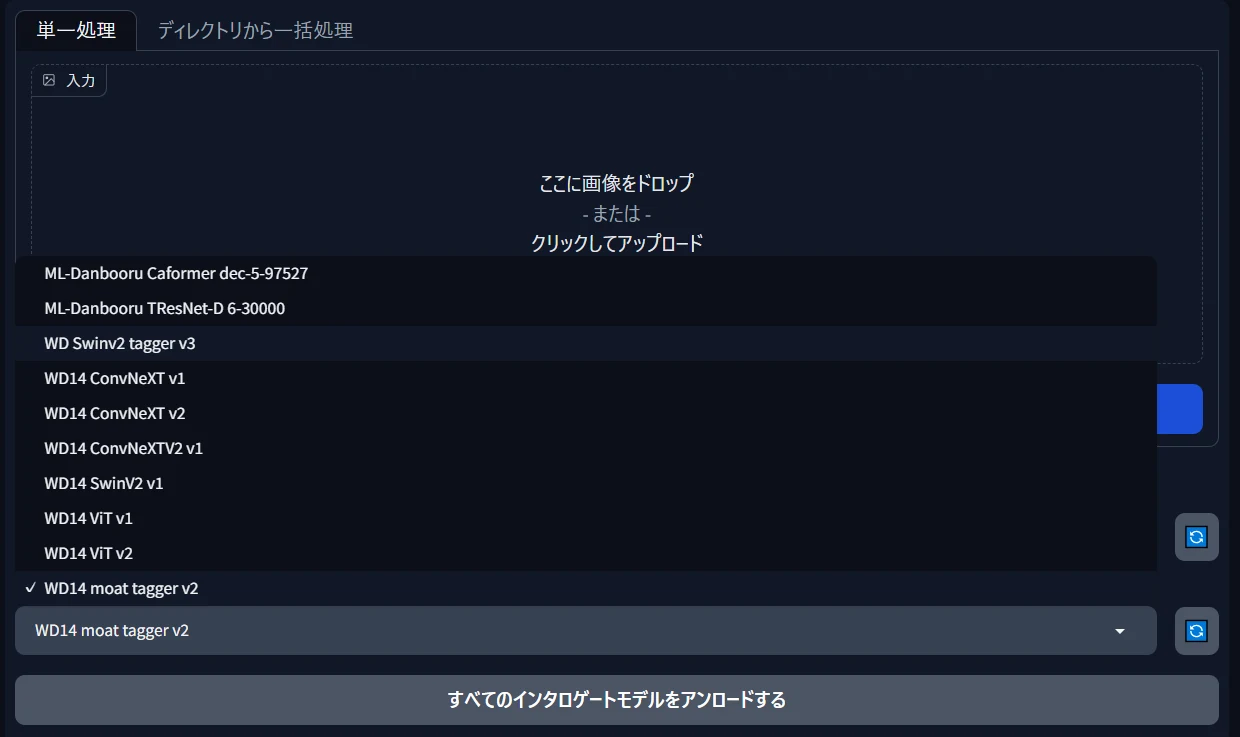
⑤「タグ付け(Tagger)」のタブを開き、画面左側にある「インタロゲーター」のプルダウンメニューに「WD Swinv2 tagger v3」が追加されていれば成功です。
【2024/08/24追記】その後、さらなる後発モデル「WD EVA02-Large Tagger v3
」が登場しています。
こちらを利用したい場合は、先ほどの位置に以下の4行を挿入すればOKです。
'wd-EVA02-Large-v3': WaifuDiffusionInterrogator(
'wd-EVA02-Large-v3',
repo_id='SmilingWolf/wd-eva02-large-tagger-v3',
),
こちらも各行冒頭のスペースが揃っているか上書き前に確認してください。太字にしたモデル名とリポジトリのIDを入れ替えば、今後も新モデルのTaggerがリリースされるたびに同じ方法で導入できますので、覚えておきましょう)
一括タギングの方法
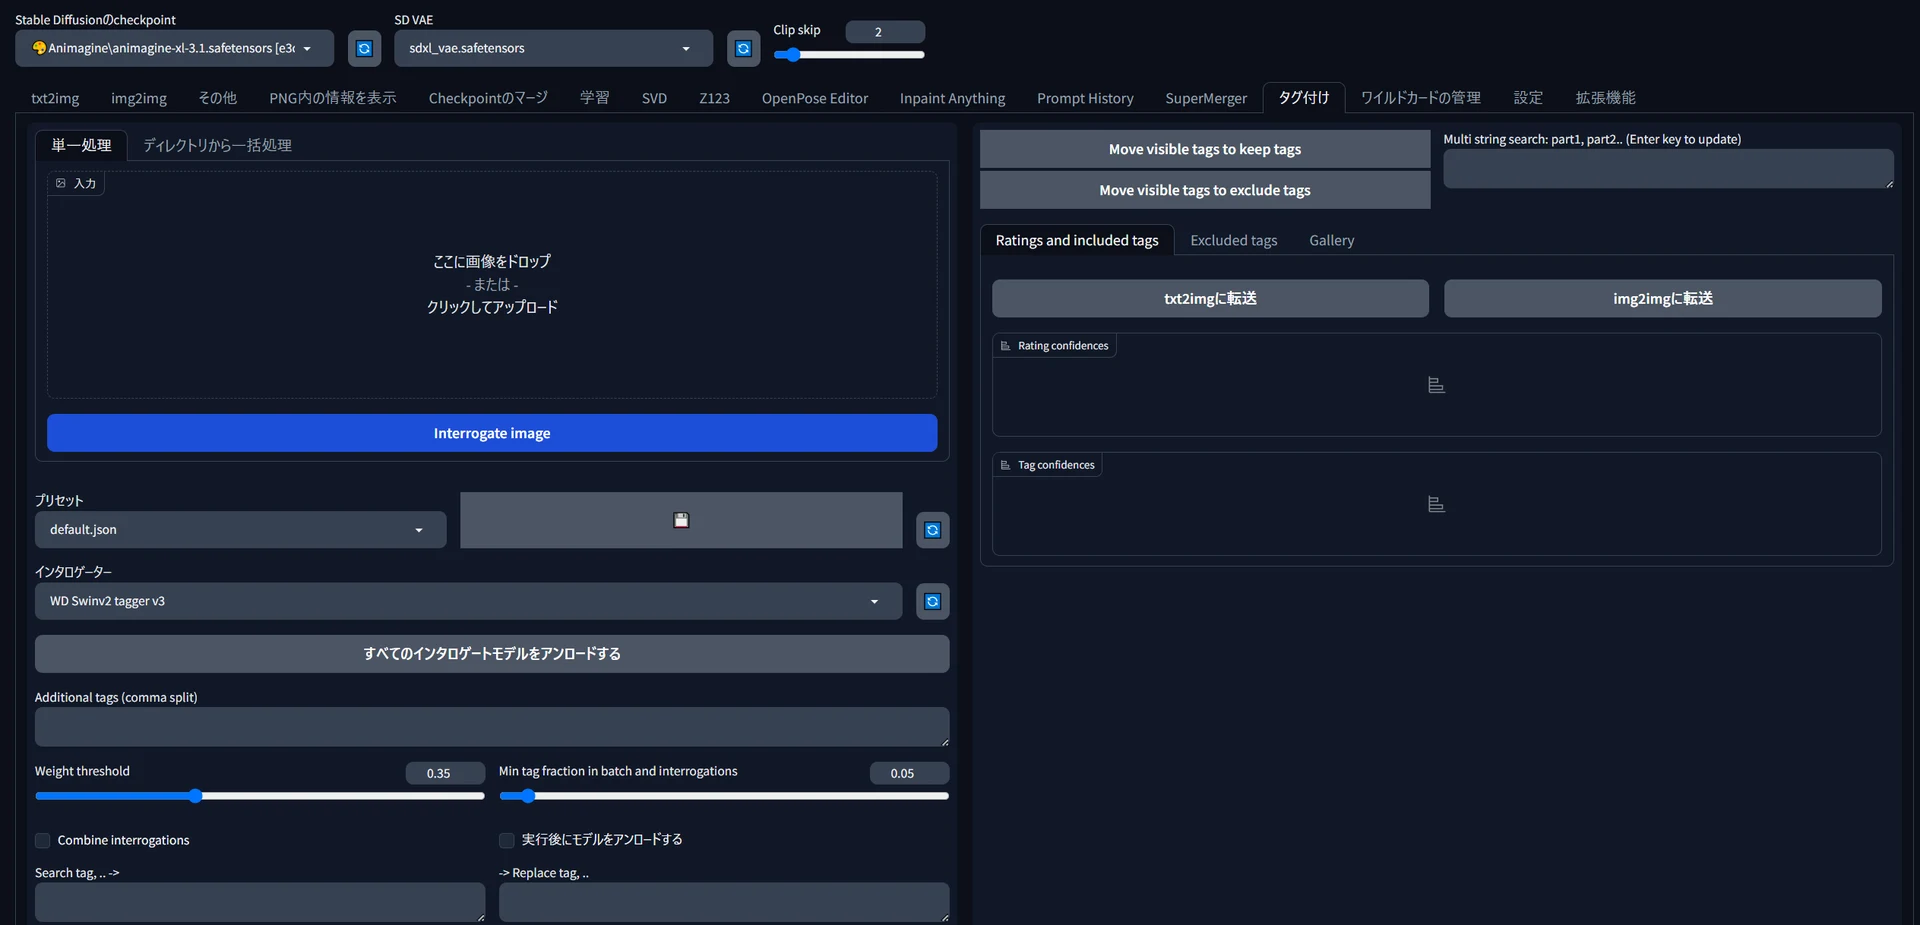
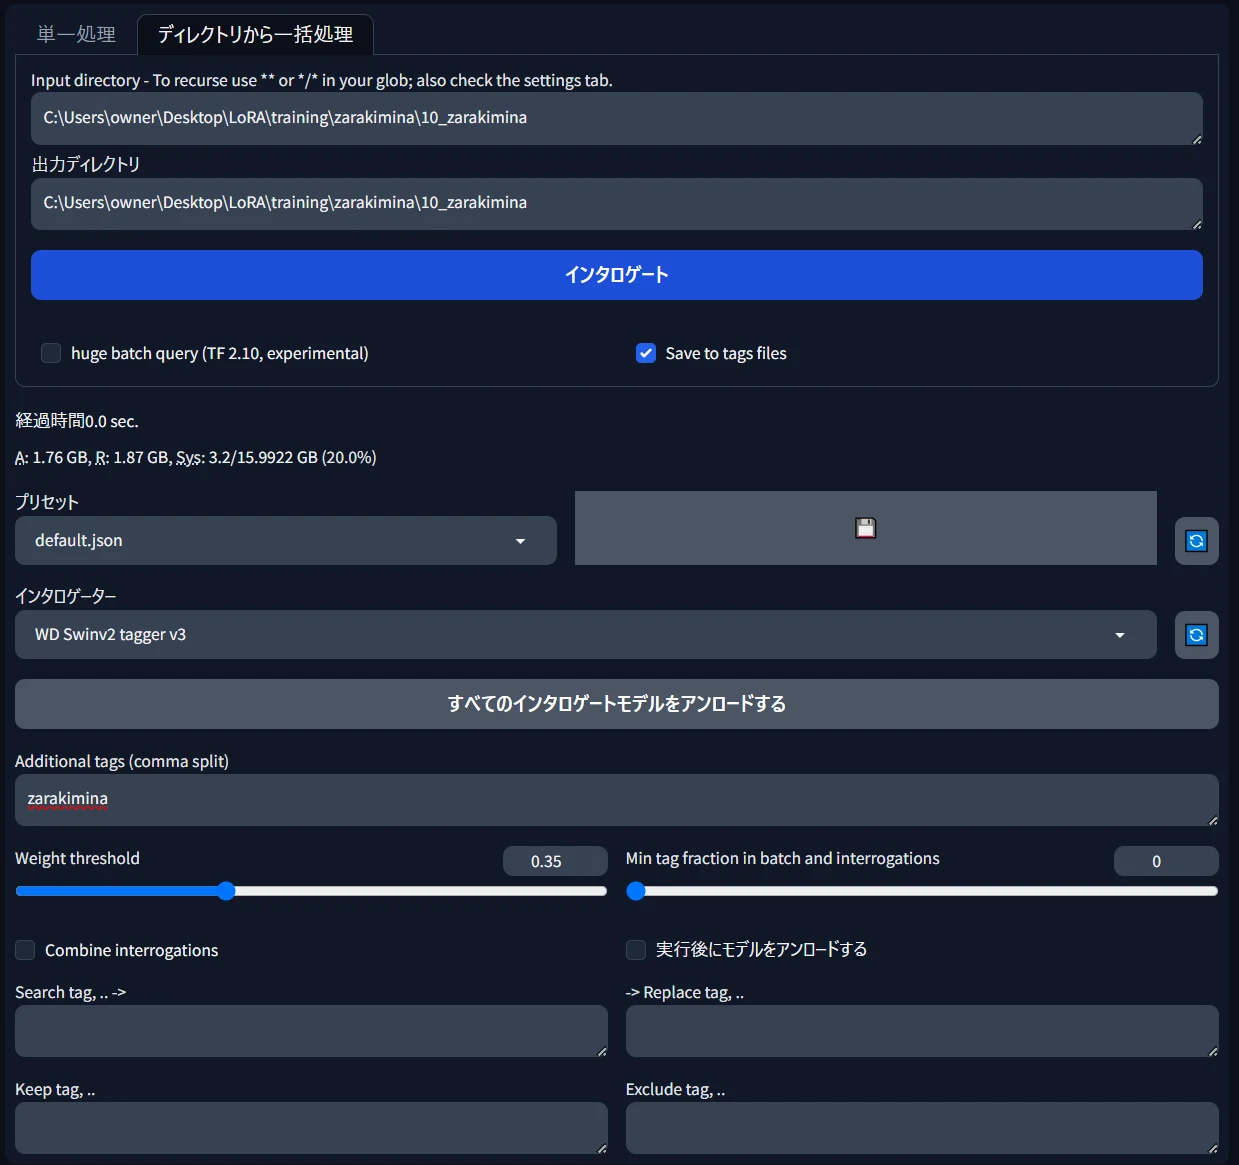
では、タグ付けタブからさっそく用意した画像群にタギングをしていきましょう。このタブでは画像1枚からタグ抽出することもできますが、「ディレクトリから一括処理」タブをクリックすることで、あるフォルダに入っている全ての画像にタグ付けをしてもらうことができます。
各欄の意味と入力すべき値は次の通りです。
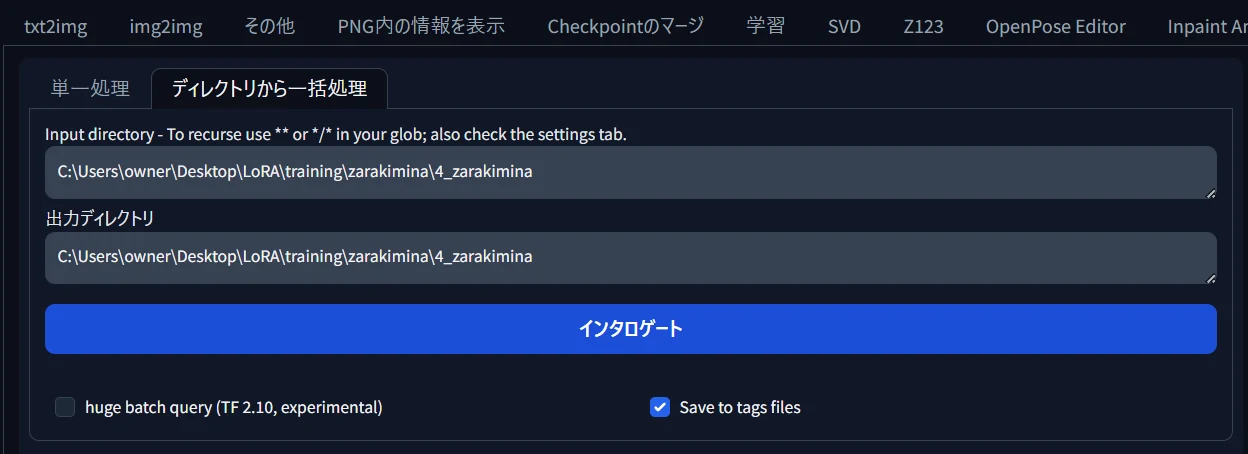
・ディレクトリから一括処理▶「入力ディレクトリ」Input directory
「入力ディレクトリ」(タギングしたい画像データの場所)の入力欄に教師画像を入れたフォルダをフルパスで指定します。フォルダのアドレス部分を右クリックして「アドレスをテキストとしてコピー」して貼り付けでOK。ここで指定するのは「training」フォルダやその直下のフォルダではなく、画像を入れたフォルダ(頭に数字がついている画像保存フォルダ)ですので、間違えないようにしましょう。
・ディレクトリから一括処理▶「出力ディレクトリ」output directory
ここにも「入力ディレクトリ」と同じフォルダのフルパスを挿入します。(ここを空欄にしておくと同じフォルダにテキスト生成されるはずなのですが、私のForge環境では失敗してしまうことがあったので、同じフォルダ名を入れておいた方が無難です)
・「インタロゲーター」interrogator
何のタグ付けモデルを使ってタギングするかです。各モデルは初回実行時にダウンロードされ、モデルによってタグ付け結果が微妙に変わります。さきほどインストールした「WD Swinv2 tagger v3」を選びましょう。初回はモデルのDLが行われるので読み込みに時間が掛かります。いま何%DLされたか進行度合いが表示されないのでやきもきしますが、気長に待ちましょう。
・「追加タグ」Additional tags
この入力欄に入れたタグは、全てのテキストの冒頭に書き加えられます。ここにLoRAのトリガーワードにしたい単語を入れます。既存のタグにはない、短めでオリジナルなワードがいいでしょう。例えばミナちゃんなら「zarakimina」などです。画風LoRAを作る場合はトリガー不要です。
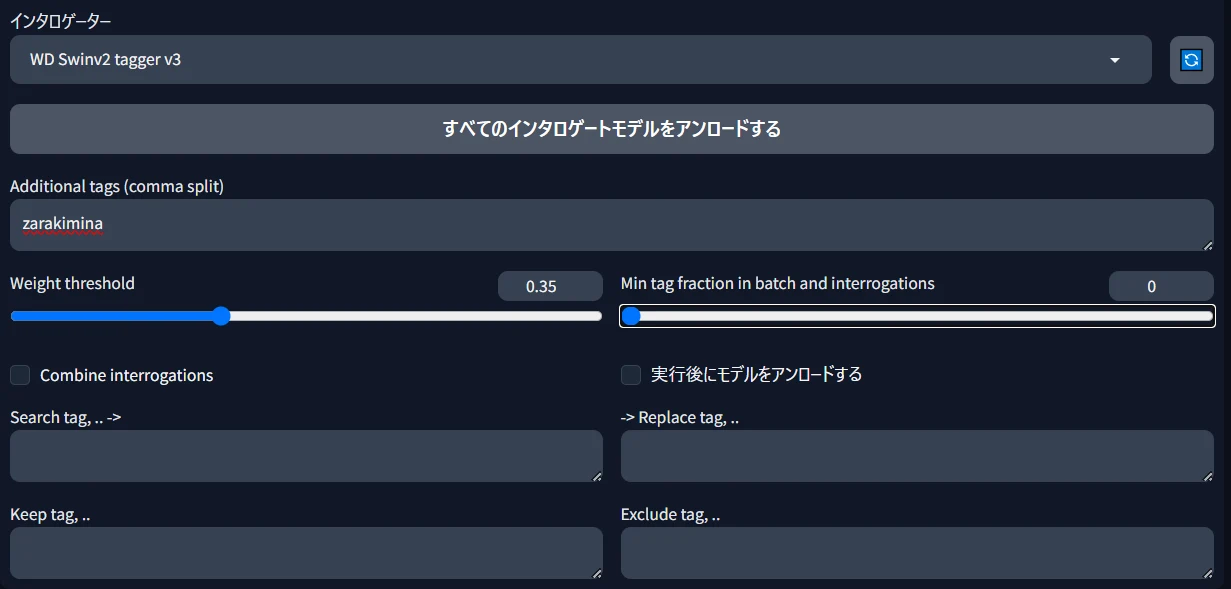
・「しきい値」Weight threshold
抽出するタグのしきい値調整ができます。下げると「間違っちゃうかもしれないけどたくさんタグ付けするね」、上げると「間違いないタグだけを付けるね」の意味になります。抽出結果を見て調整しましょう。デフォルトは0.35(35%以上)となっていますが、基本的にタグは多いほうがよいので、全く関係ないタグが出ない程度に下げておくのをおすすめします。私はたいてい0.28くらいにすることが多いです。
・「最低抽出率」Min tag fraction in batch and interrogations
保存するタグの最低抽出率です。デフォルトは「0.05」となっており、抽出されたタグの数が全体の5%未満の場合、そのタグは間違いの可能性が高いとして除外される設定になっています。この処理によって「希少で重要なタグ」が抜け落ちてしまうとLoRAの品質に関わるので、私は0にすることが多いです。
・「除外タグ」Exclude tag
ここに入力したタグは、テキストから除外されます。ミナちゃんを作る場合、「zarakimina」に「red glasses」とか「ponytail」といった概念を凝縮して覚えてほしいので、それらのタグをここに入力して除外することになりますが、まずは空欄でOKです。※「red_glasses」のようにタグ内のスペースを半角アンダーバーにすると効かなくなるので注意してください。(webUIの"設定"タブから変更可能)
・「検索タグ・置き換えタグ」 Search tag & Replace tag
抽出されたタグを何か別のタグに置き換えたいときはこのウィンドウを使います。今回はいじりません。
★入力例
さて、さきほどのミナちゃんの画像群で「zarakimina」LoRAを作るためのタギングをやってみます。除外タグは空欄でよいので、下記のように入力したら、「インタロゲート」ボタンを押してしばらく待ちましょう。
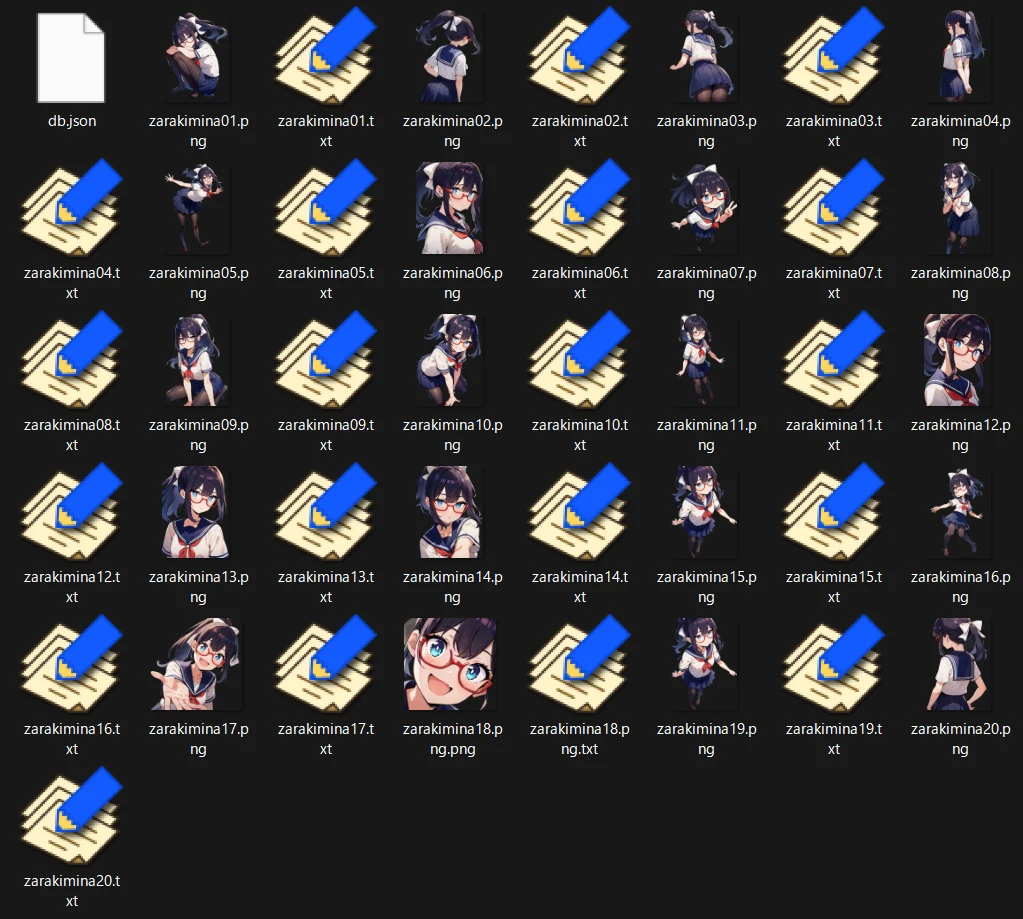
するとこのように、「10_zarakimina」フォルダ内に画像と同じ数のテキストデータが出力されます。(db.jsonというファイルも生成されますが、気にしなくてOK)
テキストデータを開いて中身を確認しましょう。例えば左の画像「zarakimina01.png」なら、このようなテキストデータ「zarakimina01.txt」が出力されています。冒頭に「追加タグ」に記入したトリガーワード「zarakimina」が入っていることを確認しましょう。間違っているタグはあるでしょうか?
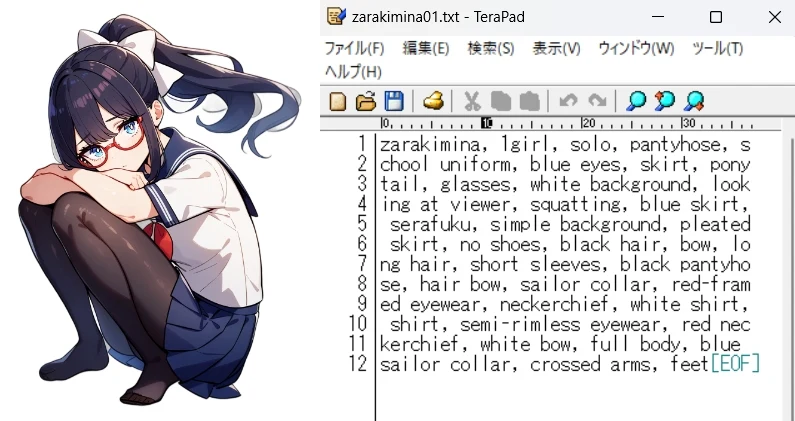
ぱっと見た限りでは、ほぼ適切なタグ付けがなされているようですね。ちゃんと「no_shoes」もあって、さすがwd-swinv2-tagger-v3です。
目的に合わせてタグを「除去」しよう
今度はここから、ExcludeTag欄を使って「学習したい要素」を削除していきます。キャラLoRAを作るのであれば、キャラクターの「操作できない容姿」部分を表現したタグを削除しましょう。一方、画風タグであれば、すべての画像に共通する要素を学習してほしいので、特にタグは除去しなくてよいということになります。ただ「重複する要素」「誤検出されたタグ」「何を指定しているか判然としないタグ」はLoRAの精度を落としますので、除去しておくようにしましょう。
ここがつまづきポイントですので再度確認しますが、ポニーテールの人物のキャラLoRAを作りたい場合は「ponytail」を削除します。つまり、各テキストデータには、「そのキャラとセットで学んでほしくない概念」が並ぶのが正解です。例えば、教師データが全部笑顔の画像だったとしたら、「smile」を入れておかないと、笑顔の画像ばかりが出力されるLoRAになってしまいますし、「1girl」や「solo」は残しておかないと、複数キャラが生じやすくなってしまいます。
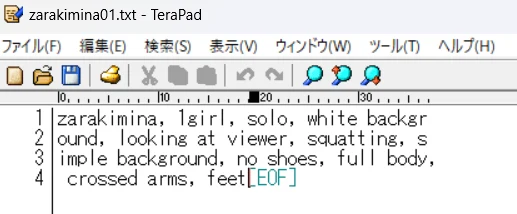
ポイントは「zarakiminaを構成する要素は消す」「zarakiminaがどんな状況で何をしているところかだけを残す」イメージ。上の画像なら、「zarakiminaが白い背景の前でしゃがんでこっちを見ており、靴は履いていない。全身や脚が映っていて腕は組んでいる」わけですから、いま記した文章に対応するタグは残し、「ponytail」や「blue eyes」「glasses」を消したいということです。
タグ付けタブの右側を見てみましょう。このように、画像群から抽出されたタグが割合順に並んでいます。
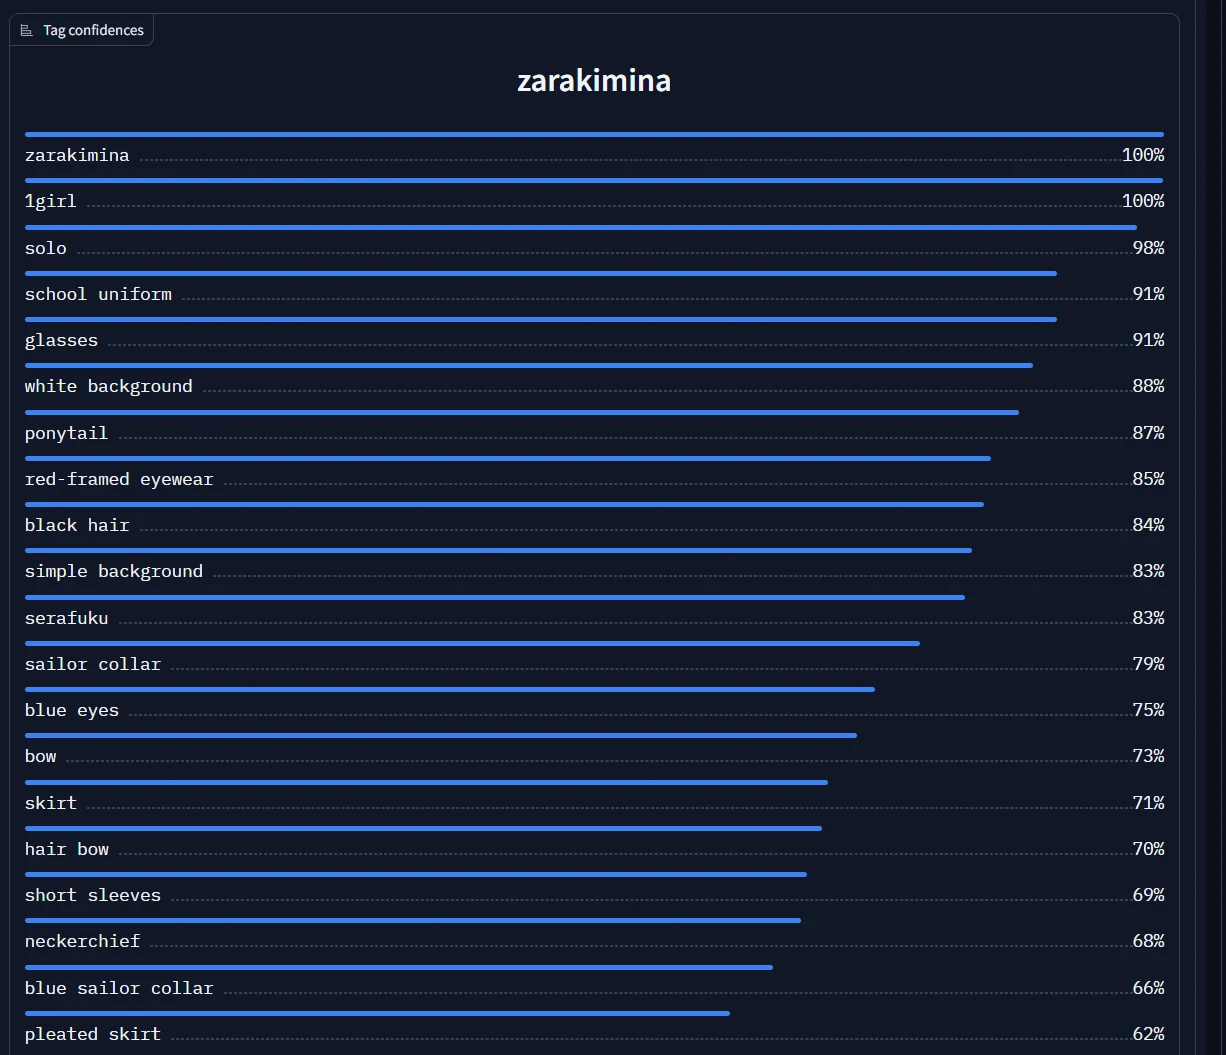
このうち、zarakiminaを構成する要素(学習させたい要素)のタグを探し、除外タグ(Exclude Tags)の欄に入れていきます。単にタグ名をクリックしていくだけで、隣の「Keep tag」の欄に自動入力されますので、最後にまるっとカットアンドペーストするのがおすすめです。再確認ですが、1girlとsoloは残すこと!
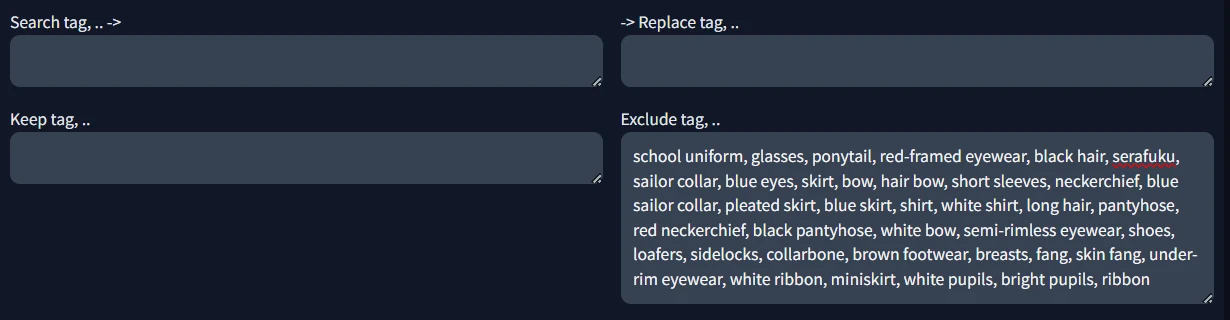
「,」で区切ればいくつでも追加できますので、あらかた放り込めたら再度「インタロゲート」すれば、さきほど生成されたテキスト群の中身が瞬時に書き換わります。何度でも確認とインタロゲートを繰り返してタグを整えましょう。
さきほどの「zarakimina01.txt」を開いてみてみると、ここまでタグが減っています。Exclude tagに入っている「zarakiminaを構成する要素」が除外され、「この画像はzarakiminaがこうなっている状態の画像」と説明できていればOKです。
★必ずテキストを開いてチェックを!
「しきい値」の設定が低すぎると、一見タグ付けがうまくいっているように見えて、実際は全く的外れなタギングをしていることがよくあります。必ず出力されたテキストデータをいくつか開いて、該当する画像と見比べて、正しくタギングできているかをチェックしてください。関係のないタグがいくつも混入していたら、「しきい値」をぐっと上げてインタロゲートし直しです。
例えば、水星の魔女の「suletta_mercury」が1人で映っている画像を読み込ませているのに、しきい値が低いと勝手に「miorine rembran」と書き加えられていることがよくあります。これは、タガーが学習内容を基に「確率で」タグを推測しているために起こる現象。タグ付けモデルが「この二つはよく一緒に描かれているから、画像と違うかもしれんけど一応入れとくか」と判断してしまうのですね(wd-swinv2-tagger-v3がこの2人のことをよく知っているということでもあります)。
しきい値が高すぎるとタグ数が全然スカスカになってしまうので、ちょうどよい数値を探りましょう。0.25~0.4くらいが良いでしょうか。収集した画像群が教師データとして高品質かどうかと、ここのタグ付け作業の精度によって、LoRAの出来は大きく変わりますから、ここは集中して作業したいところです。
★Keep tagsの使い方
Additional tags、Keep tags、Exclude Tagsにいずれも同じタグ(※スペースと"_"は区別されるので注意)を入れると、そのタグが必ずタグ群の一つ目に配置され、2個目以降に同じタグが重複しないようにできます。
一つ目のタグに概念を集中させたいが、そのタグが自動検出されてしまってうまく一つ目に配置できないときに使うテクニックです。その場合、Additional tags、Keep tagsにはそれぞれ一つだけタグをつけ、「,」を入れないように気を付けましょう。
例えば、「empty eyes」は目の光を失わせる効果がありますが、あまり効きがよくないので、良質な虚ろ目画像をたくさん集めて「よく効くempty eyes LoRA」を作りたいとします。その場合、Additional tagsに「empty eyes」と入れると、おそらくタガーも「empty eyes」をデータセット画像から毎回検出するので、「empty eyes,1girl,solo...empty eyes,smile...」と二度タグが出てくることになってしまいますよね。そういうときにKeep tags、Exclude Tagsにも「empty eyes」を入れておけば、重複を避けつつ1つめにトリガーワードをセットできるというわけです。
Kohya Lora param GUIの操作方法
良質な画像と適切なタギングができたデータセットが用意できたら、もうあとは学習を始めるだけです。次の手順で学習準備を進めてください。
1.最初に、Kohya Lora param GUIのReadmeで配布されている「サンプルプリセット」をDLします。こちらのリンク先(mega.nz)にアップロードされています。
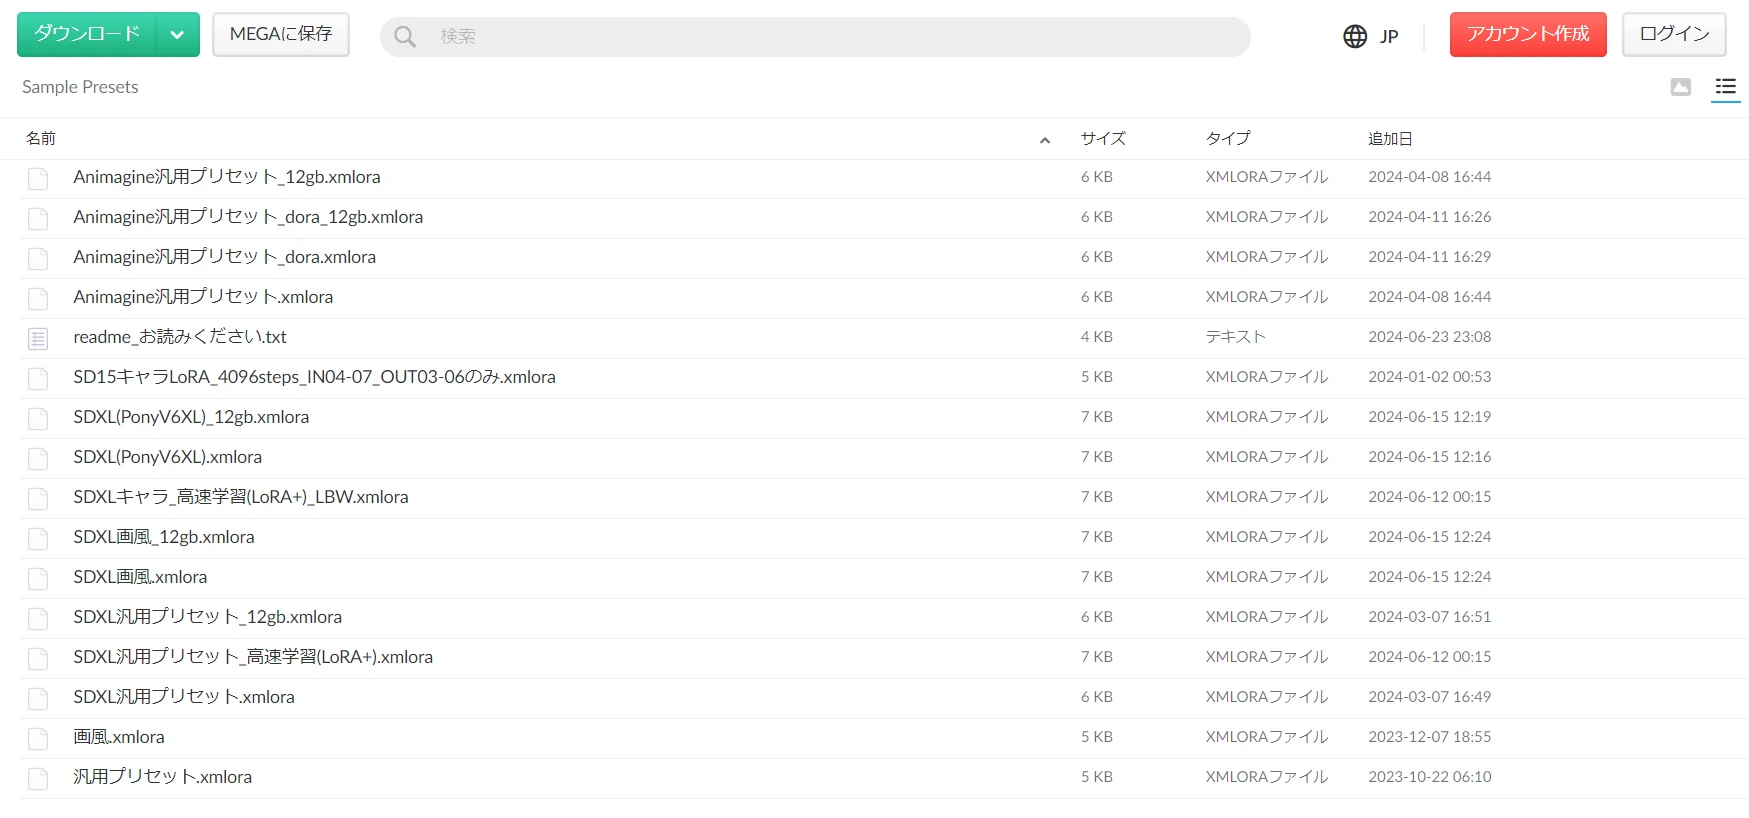
2.アクセスできたら、「ダウンロード」からこれらを任意の場所にDLしておきます。私はすぐ呼び出せるよう、trainingフォルダの中に「preset」フォルダを作って放り込んでいます。readmeファイルを熟読しておきましょう。
3.Kohyas LoRA GUIをexeファイルをダブルクリックして起動。このメニューが出るので、まずは「プリセットの読込」ボタンをクリックし、今回は「Animagine汎用プリセット.xmlora」を選択します。(他にもPony用やSD1.5用、画風用など、さまざまなプリセットが用意されています。使い分けは先ほどのreadme参照のこと)
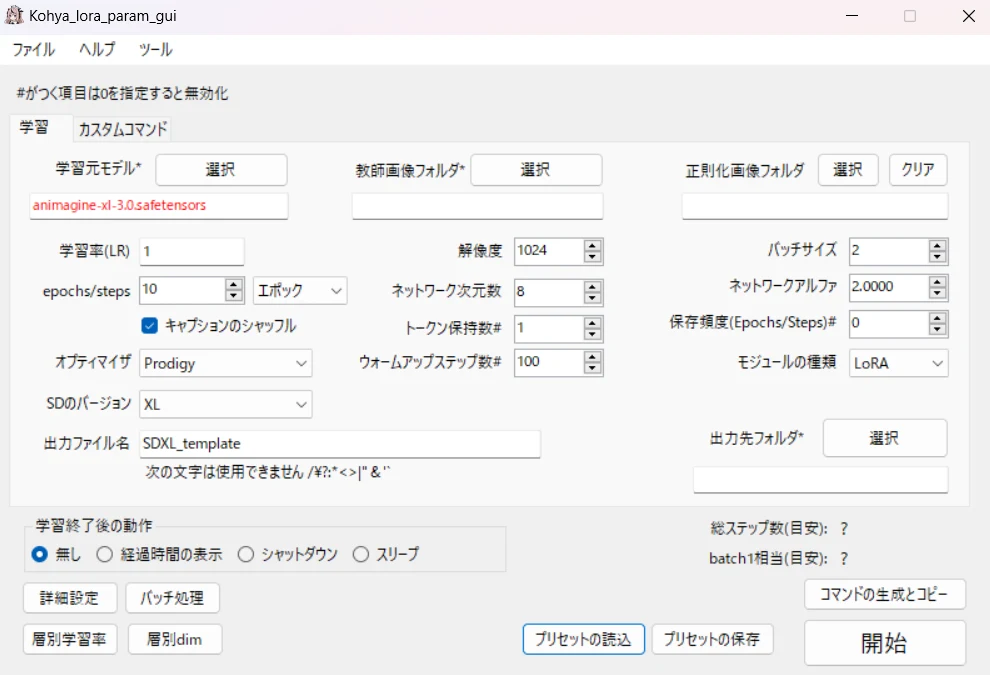
4.プリセットによっておおむね空欄が埋まりましたが、以下の項目は手動で設定します。(赤字が出たら入力ミス。上の画像ではanimegineXL3.0が指定した場所にありませんよというエラーが起きています)
「学習元モデル」
今回はAnimagine用LoRAを作りたいので、PC内にあるAnimagineXL3.0.safetensorsかAnimagineXL3.1.safetensorsを選択します。フルパスに半角英数以外の文字種が混じっていないことを確認しましょう(フォルダ名に絵文字や日本語を使ってモデルを整理している方はエラーが出ます。別の場所にコピーして選択しましょう)
★意図しない画風の変化を避けたい(キャラクター概念だけを学び、LoRA適用時もCheckpoint本来の画風で生成したい)場合、AnimagineXLではなくこちらのLoRA学習用モデル「GenimagineXL」を指定しましょう。画風LoRAを作りたい場合は通常のAnimagineを使えばOKです。
なぜGenimagineを使うと画風変化が減るのかはこちらで解説されています。関心のある方はどうぞ。
「教師画像フォルダ」
画像を保存したフォルダではなく、その一つ上のフォルダを指定します。「10_zarakimina」フォルダが入っている「zarakimina」フォルダを選択するということですので、お間違えなく。画像を保存したフォルダを間違って選択すると、「間違ってますよ」と教えてくれます。
「正則化画像フォルダ」
空欄のままでOKです。正則化画像についてはさまざまな意見があるのですが、個人的には「手間を掛けるほどの意味はない」という説を支持しています。
「epochs\steps」
最重要。ここの数値が多すぎると過学習が起きてしまいますので、料理の成否を分ける「焼き加減」にあたる数値だと考えましょう。
画面右下の「総ステップ数」と「batch1相当」の数字をご覧ください。
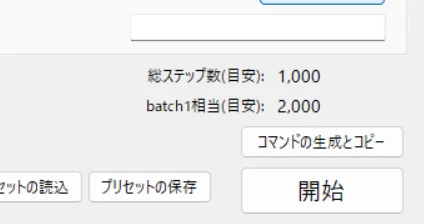
「epochs\steps」の数値を上下させると、「batch1相当」の数値が上下することが分かります。画像の枚数×繰り返し数(画像保存フォルダの冒頭の数字)×エポック数(何セットやるか)=「batch1相当」のステップ数という計算です。
readmeの説明にある通り、「batch1相当」の数字が2000~3000の間になるように調整してください。画像20枚×「10_zarakimina」×???=2000~3000にしたいわけですから、ここではepochs\stepsを12としました。つまり、batch1相当=2400となります。これは「20枚の画像を10巡するのを1エポックとします。今回はそれを12エポック、つまり計2400ステップの学習をこれから行ってくださいね」という指示となります。
※ちなみに、「総ステップ数」が「batch1相当」の半分になっているのは、後述するバッチ数が「2」に指定されているため。「2400ページの宿題をこれからするけど、2人で手分けしたら半分の時間で終わるね」という程度の意味です。
「キャプションのシャッフル」&「トークン保持数」
これは、txtファイルで画像ごとに割り振られたタグの順番をシャッフルするか?順番をシャッフルする場合は1つめのタグ(多くはトリガータグになる)を含めてシャッフルしてよいか?を尋ねる項目です。
例えば「zarakimina,1girl,solo,smile...」と続くtxtの場合、キャプションのシャッフルをONにすると内部的にタグの順番がランダマイズされた状態で学習されます。こうすることで、前方によく出てくる頻出タグが強烈に覚えられ、後ろに回りがちなタグの印象が薄れるのを避けることができます。ただ、せっかくつけたトリガーワードが1番目でなくなると困るので、その場合は「トークン保持数」を1にしましょう。1つめのタグだけランダム順にならず、常に先頭に維持されます。(2にすれば冒頭の二つ目までが維持される)
トリガーワードが必要なキャラLoRAの場合は「シャッフルON、保持数1」、必要ない画風LoRAの場合は「シャッフルON、保持数0」でOKです。
「出力ファイル名」
LoRAのファイル名を決めます。ここでは「zarakimina1」としました。失敗したら「zarakimina2」を作り、最終的に成功したもののみを残して「zarakimina」に改名するのがよいでしょう。新しいLoRAを作るときにここのファイル名を変え忘れても「このままだと上書きされちゃうけど本当にいい?」というメッセージが出てくれます。
「出力先フォルダ」
どこでも構いませんが、普段LoRAを入れているフォルダを指定すればすぐ生成できるので便利です。
「保存頻度」
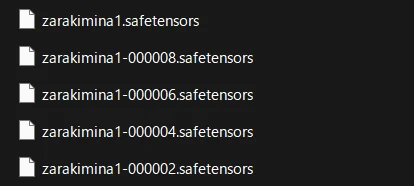
ここを「1」にすると、10エポックなら10個のLoRAが順番にできていきます。zarakimina00001,zarakimina00002....といった具合にできて、10個目に「zarakimina.safetensors」ができます。初めての生成は1か2ずつにしてみて、各バージョンの生成結果がどう変わるか確かめてみるとよいでしょう。「0」だと、完成するまで途中経過のLoRAは生成されません。
LoRAの追加学習は「パイを焼くようなもの」だと思ってください。しっかり焼いたつもりが過学習になってしまったとき、焼き加減の段階が進むごとに全部LoRAを残していたら、コゲるちょっと手前の焼き加減のLoRAが手に入るので便利ですね。逆に、焼きが足りないと、ぼんやり髪や目の特徴が似ているキャラが出る…程度のダメダメLoRAになってしまいます。(▼焼きが足りない例)
以上を入力すると、画面上はこのようになっているはずです。エラーの赤字が出ていないことを確認してください。
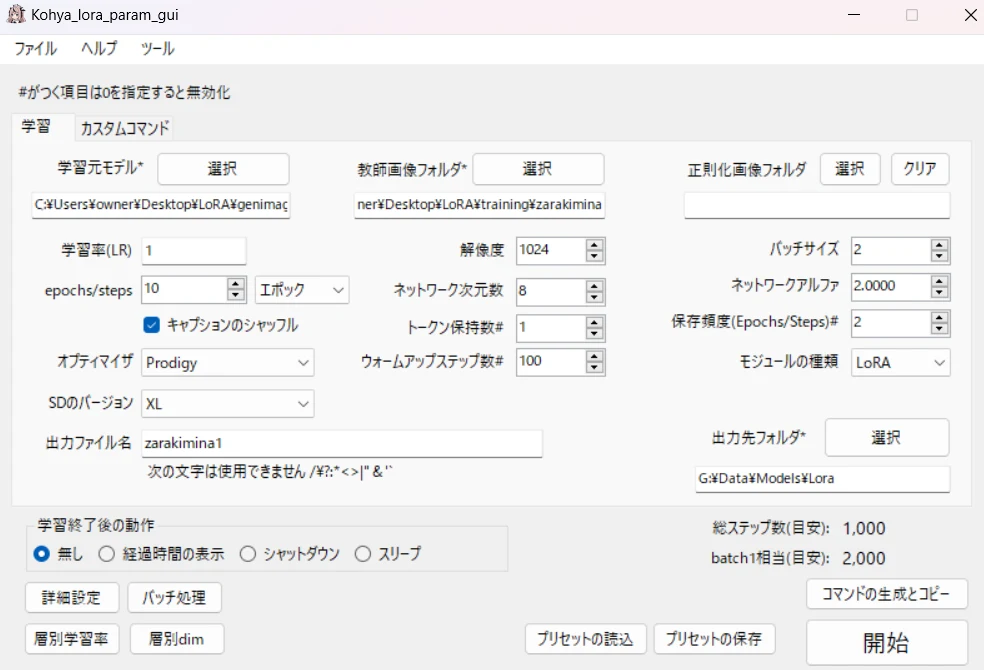
「プリセットの読込」で自動入力された欄はいじらないようにしましょう。以下に、それぞれが意味する内容を紹介しておきます。
・学習率(LR)
追加学習を一気にやるとモデルが他の絵が描けなくなる(=過学習)ため、わずかずつ進めていく必要があるのですが、この数値はその「どれだけわずかずつか」を示す数値。後述するオプティマイザーによって最適な数値は変化しますので、ここのレシピがLoRA学習の難しいポイントです。今回使う「Prodigy」の場合は1を選ぶのが基本です。
・解像度
教師データをどれくらいのサイズで学ぶか。SDXL用のLoRAですので、1024とします。SD1.5用のLoRAに比べて高性能になりますが、やはりVRAMは大量に消費しますので、グラボの性能と相談しましょう。
・バッチサイズ
学習作業をいくつ同時並行するかを示す数値。2なら2倍の早さでLoRAが完成しますが、GPUの負荷も大きくなります。高倍率だと学習率が落ちてしまうので、時短すればよいというものではありません。今回は2400ステップの学習をバッチサイズ2で行うので、半分の1200ステップ分の時間で学習を終えられるはずです。
・ネットワーク次元数(重要)
いわゆる「dim」と呼ばれるもの。この数値が多いほど学習情報をたくさん保持でき、教師データの再現度が上がりますが、余計な情報まで学習してしまう恐れが強まります。8、16、32、64、128を選んでいるLoRAをよく見かけます。dimを高めるほどにLoRAの学習には時間がかかりますが、データセットの画像の共通する特徴をしっかり覚えることができます。
VRAMが16GB以上ある場合は、「dim32/alpha16」や「dim64/alpha32」にしてみると、よりしっかりとデータセットの特徴を覚えてもらえますが、再現してほしくないほどデータセットに忠実になり、かえって生成の自由度が下がってしまう恐れもあります。個人的には、衣装の細かな部分までしっかり覚えてほしいキャラLoRAの場合、できるだけdimもalphaも高くした方がよいと考えています。
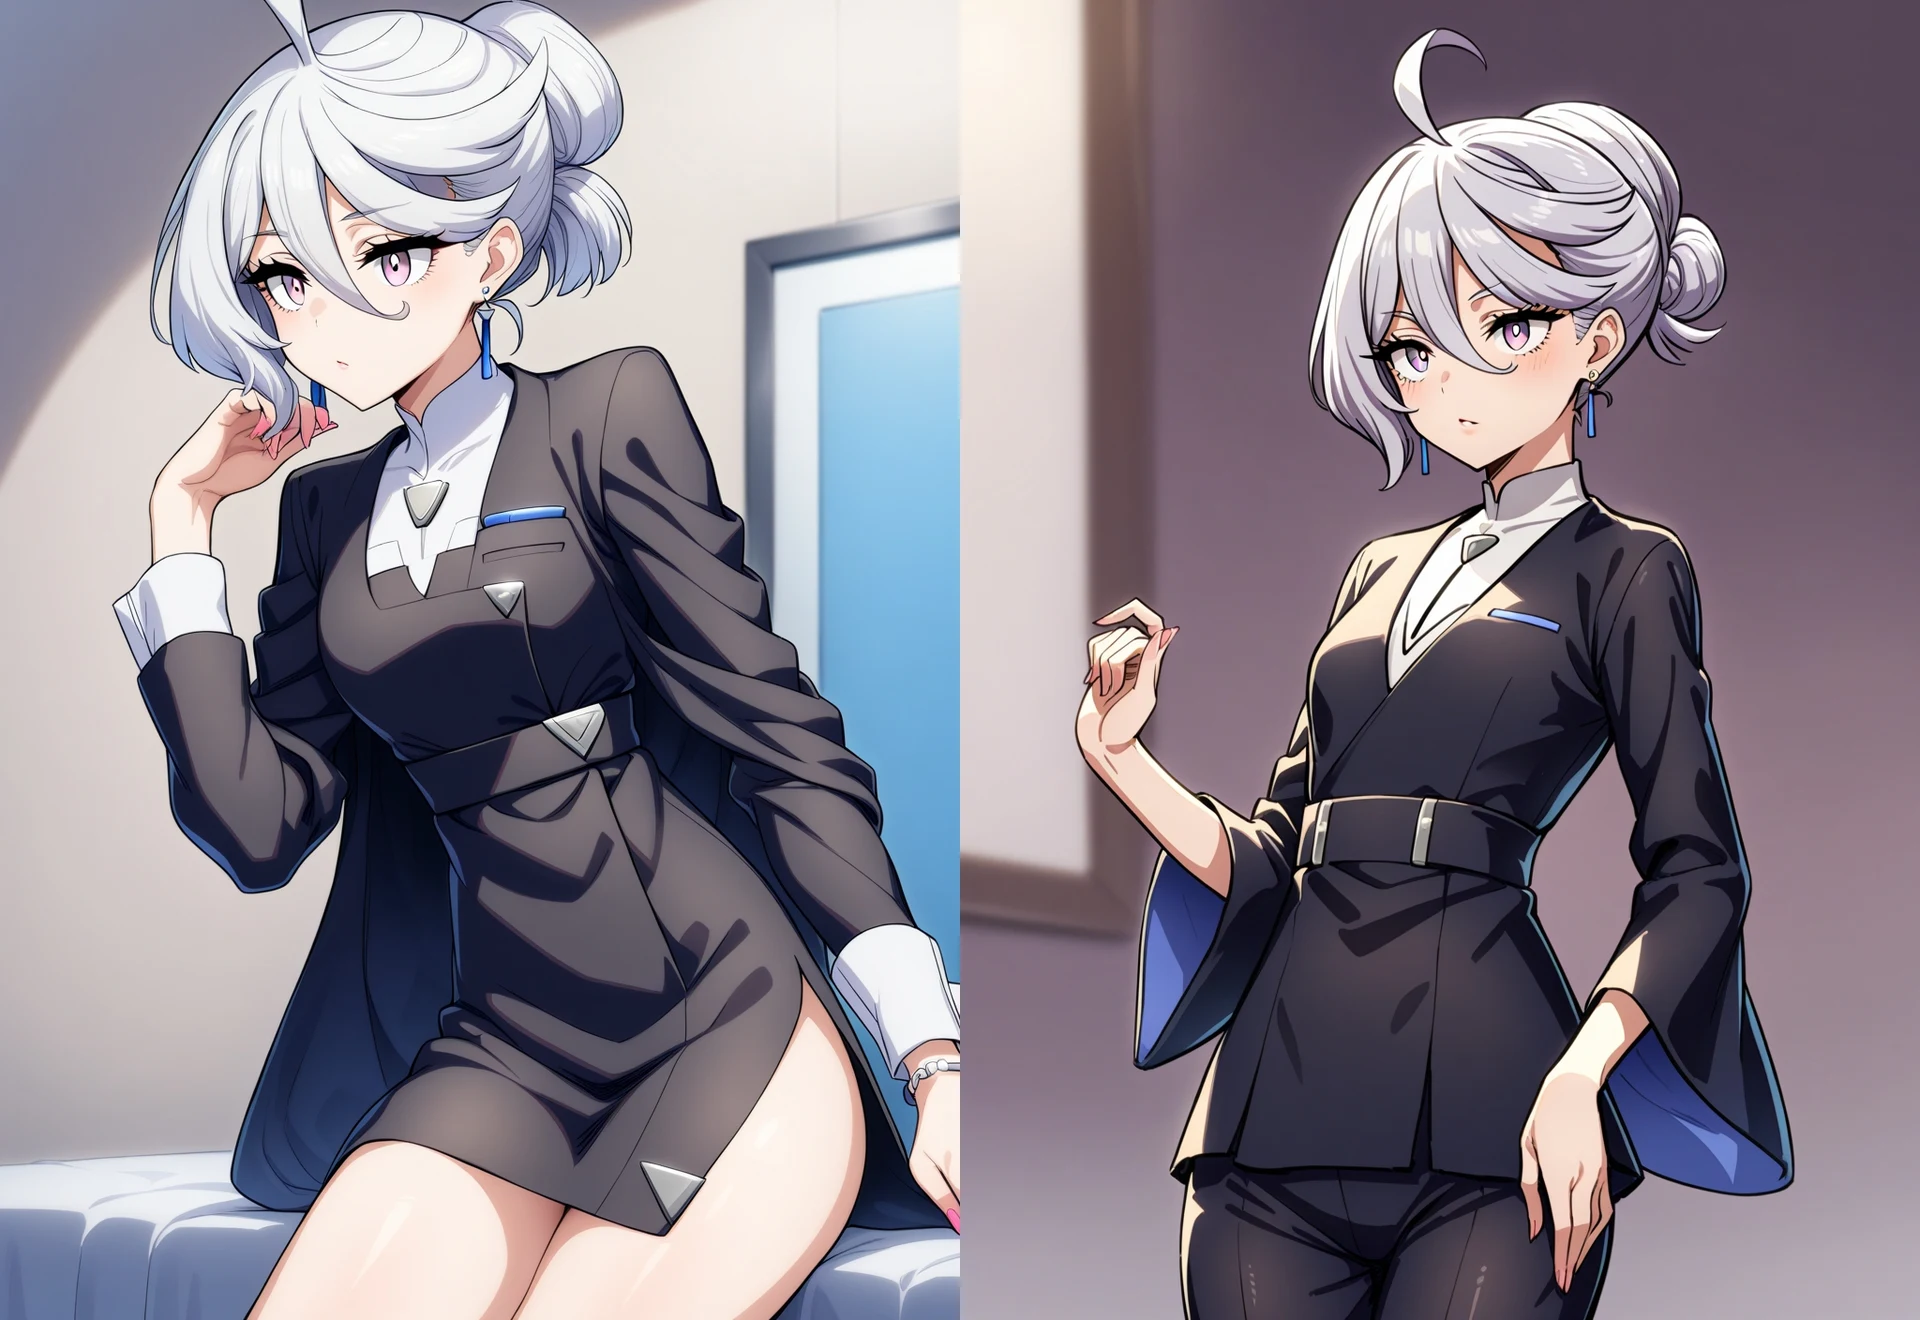
▲左がdim8/alpha3、右がdim64/alpha32で同じデータセットを学習させたもの。左は細部の再現がいろいろと怪しいことが分かる
・ネットワークアルファ(重要)
いわゆるalpha。LoRAが元のモデルにどの程度影響を与えるかを制御します。1に近づくほどLoRAの影響が強くなり、かわりに安定性が低くなります。1より大きい値にするほど、影響が弱まるかわりに安定性は高まります。
「ネットワーク次元数(dim)」とのバランスが非常に重要な数値で、dimが大きくなるほどアルファの数値も上げてLoRAの影響を抑えないと過学習を起こしてしまう恐れが高まります。経験値として、だいたいdimの半分くらいにするのが良いとされています。(dim8ならalpha4、dim32ならalpha16が目安)
・オプティマイザ
LoRAのデータを処理するアルゴリズムのことで、手動型と自動型があり、それぞれ最適な学習率が異なります。「AdamW」がスタンダードな手動型、「AdamW8bit」はAdamWのVRAM使用量を抑えつつ同等の精度を再現したもの。「prodigy」や「Adafactor」は学習の進み具合に応じて学習率を自動で調整してくれる便利屋さんです。自動型の方が一般に高品質なLoRAができますが、時間が掛かるのが難点と言われています。
・モジュールの種類
ここを操作すると、学習の仕組みや効率がLoRAと異なる「LyCORIS」などを作ることもできます。
学習を始めよう
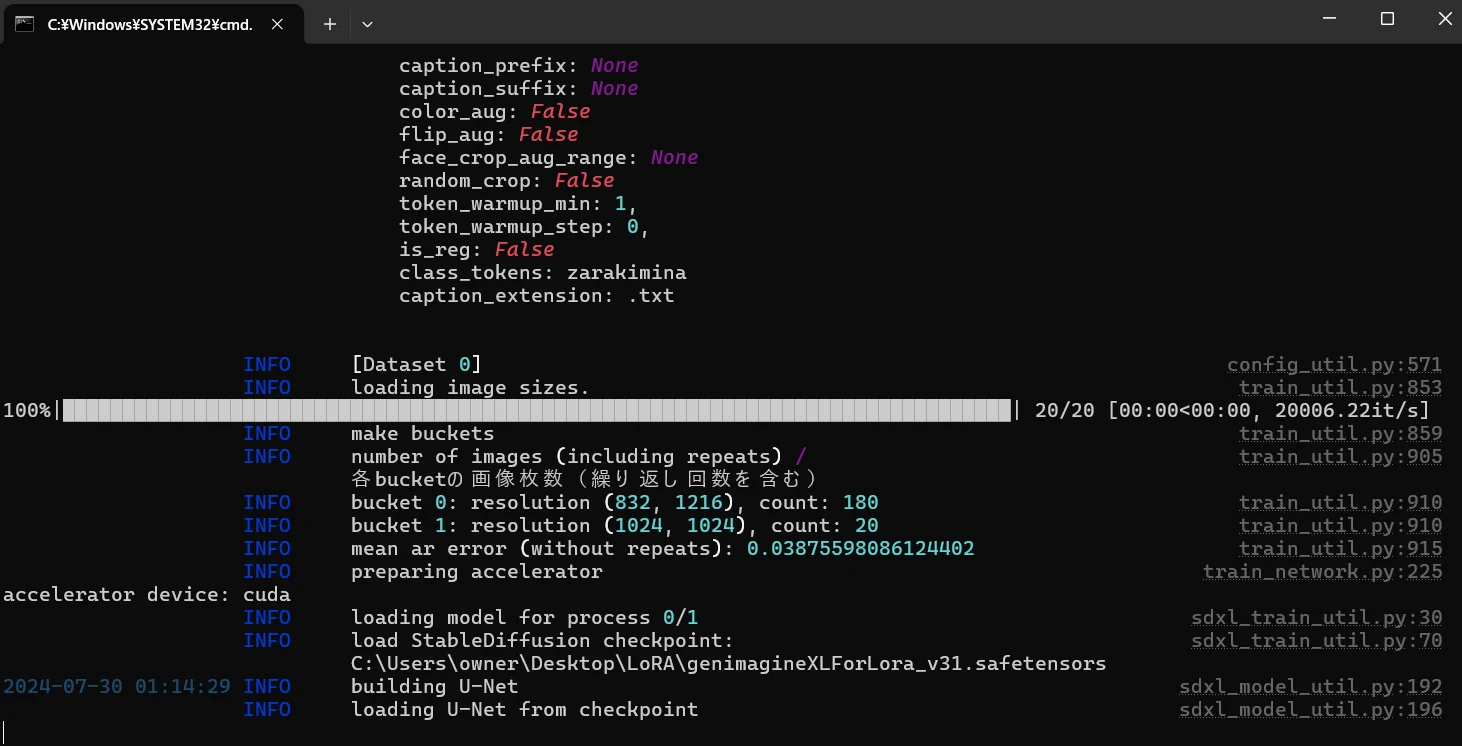
必要事項が入力できたら「学習開始」を押しましょう。黒いコマンドプロンプト画面が立ち上がり、上記の設定通りに学習が始まります。VRAMを大量に喰いますので、あらかじめVRAMに負担のかかるアプリは終了させておくようにしましょう。
しばらく待つとこのように、インジケータが左から右に徐々に満ちていく様子が表示され、学習終了までの見込み時間も表示されます。下の図は「1000ステップ中15ステップまで学習が進行中で、残り39分ほどで学習終了する」という表示です。
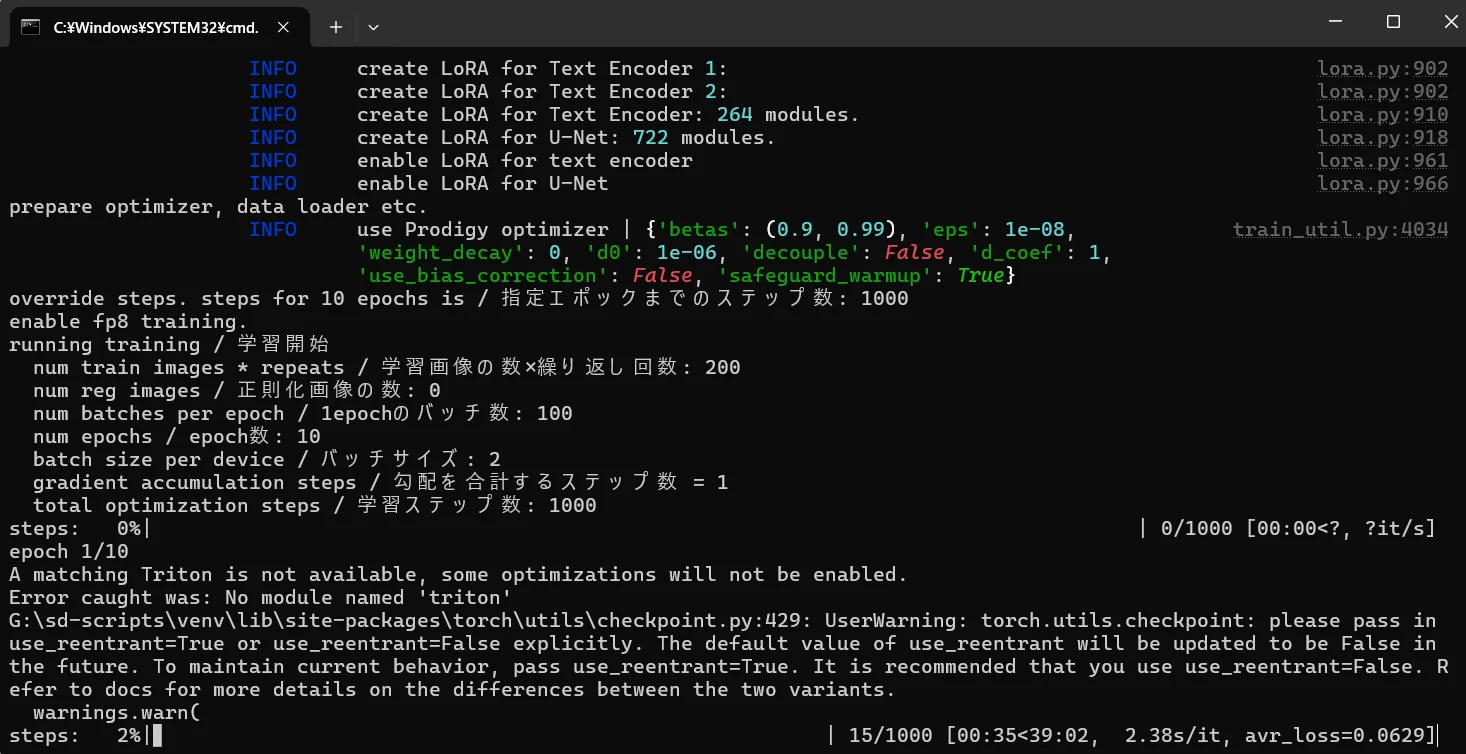
インジケータの少し上に「Triton」に関するエラーが見えますが、これは気にしなくてOKです。
★学習中はお静かに!
学習している間は、重い動画ファイルを開いたり、ゲームをしたり、ローカルでの画像生成をしたりするのはご法度。SDwebUIが起動しているだけで追加学習にかかる時間がとても伸びてしまいますし、万が一CUDA OUT OF MEMORYエラーが起こってしまうと、その時点で学習は失敗し、はじめからやり直しになってしまいます。
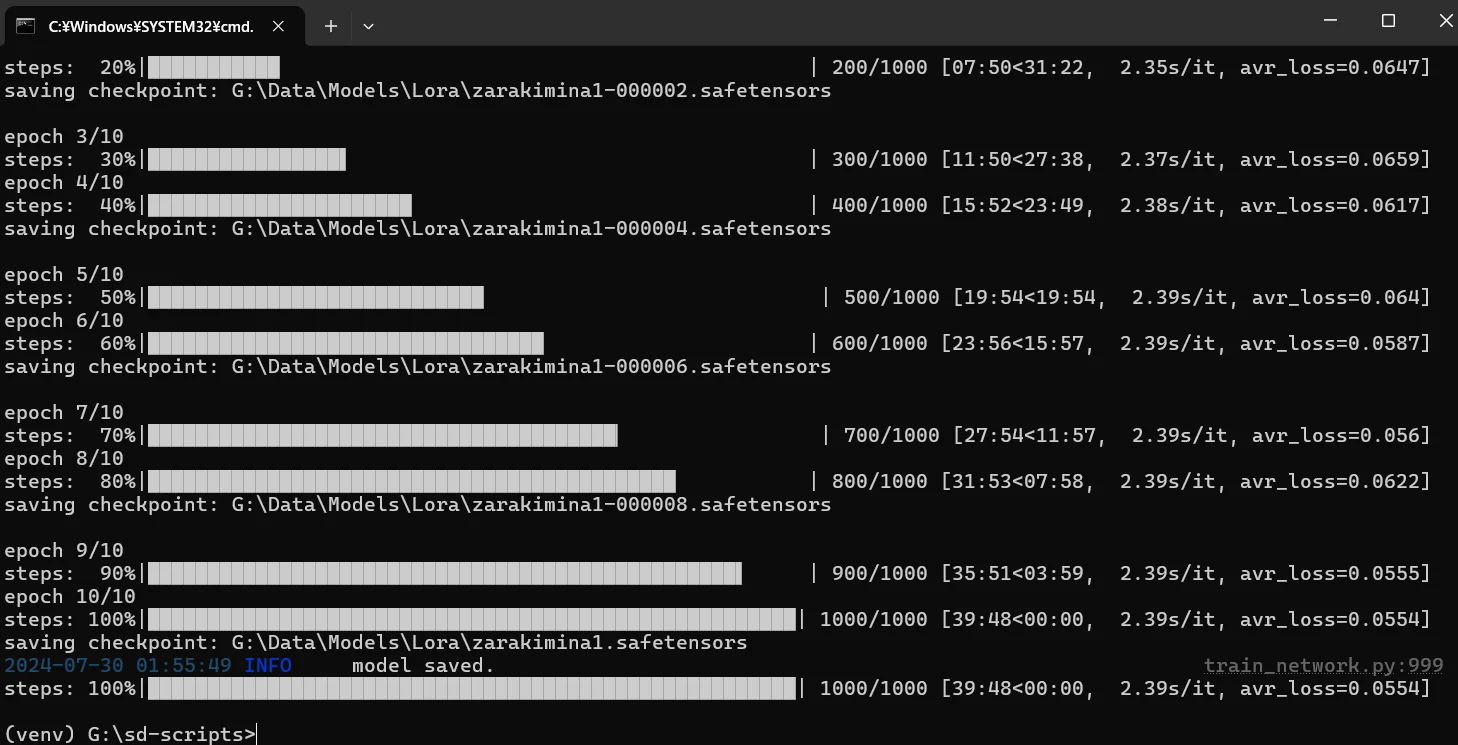
さて、40分ほどでAnimagineXL用のミナちゃんLoRAが完成しました。最後の行に(venv)●●:sd-scripts>と表示されたら「学習中止」を押して画面を閉じて大丈夫です。
出力先に指定したLoRAフォルダを確認してみると、以下のようなLoRAファイルが生成されています。今回は10エポックの工程のうち2エポックずつ保存してもらったので、5つのLoRAができています。焼き上がりの「zarakimina1.safetensors」が焼きすぎなら000008を試せばOK。焼きが足りない場合はやり直しです。
できたLoRAで生成してみよう
さっそく初めてのLoRAができたら、専用のトリガーワードで画像生成してみましょう。AnimagineXL3.1を使い、「PP:1girl,zarakimina,smile,indoor, <lora:zarakimina1:1>+クォリティタグ」で生成してみます。
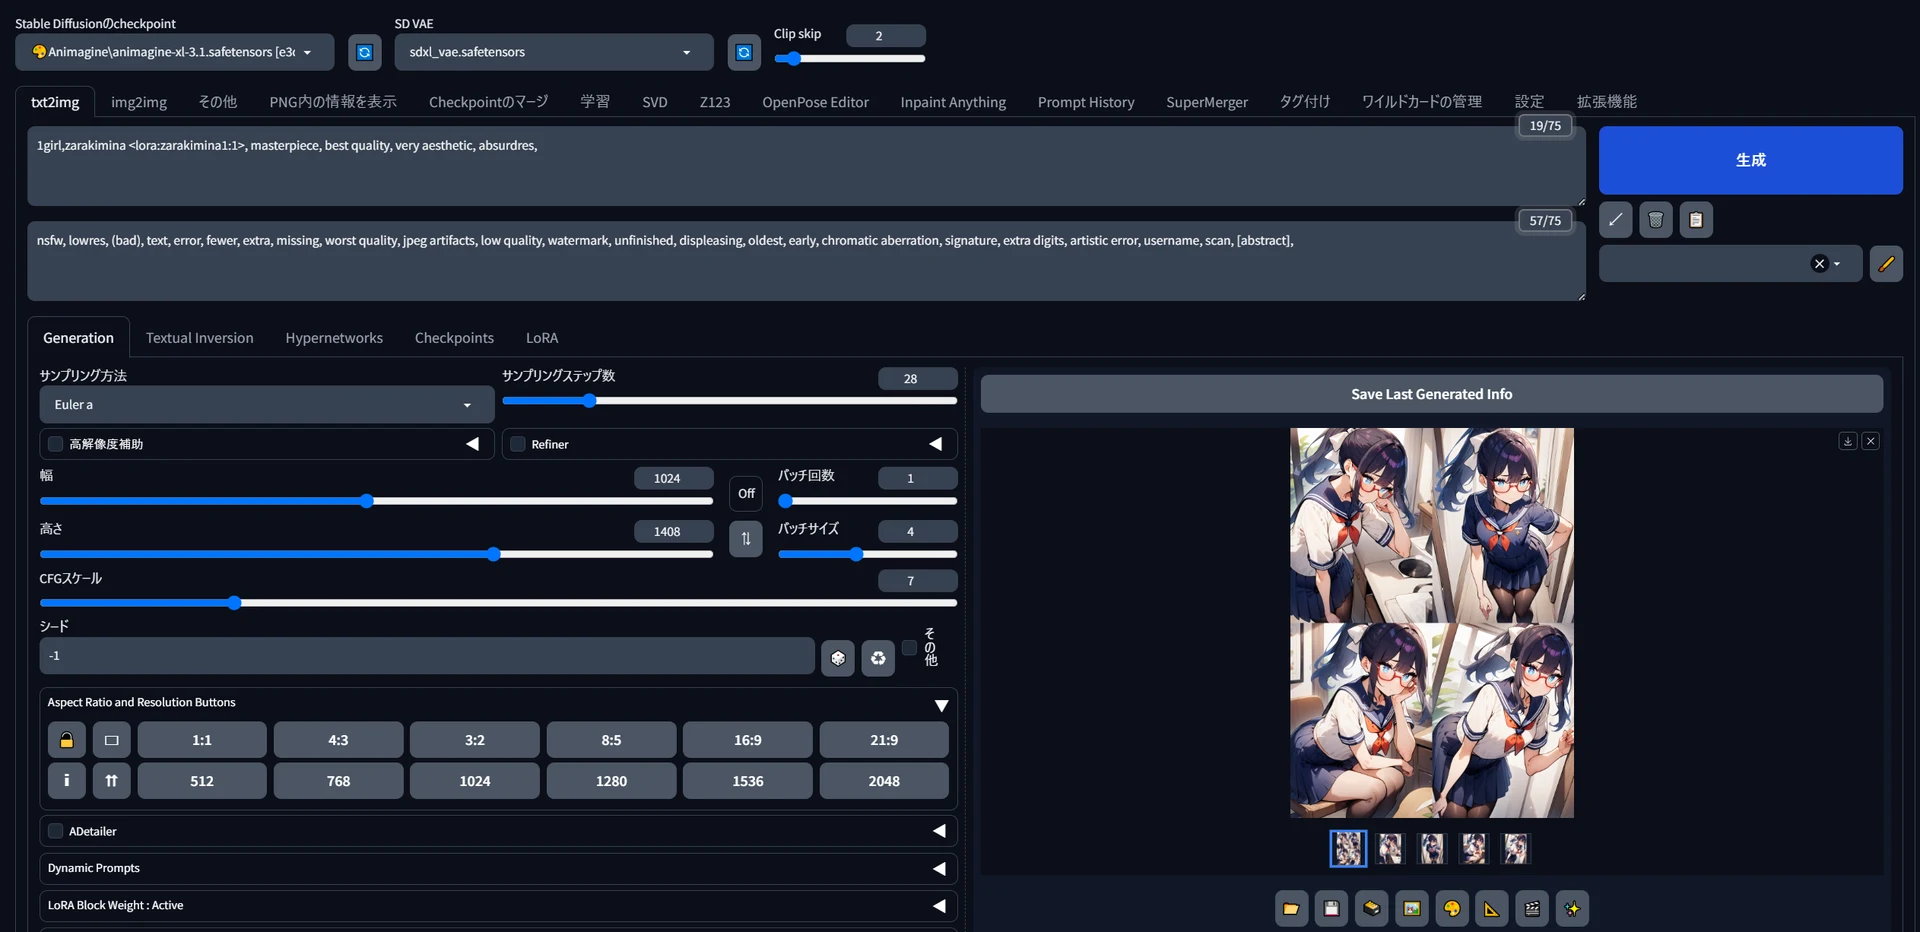
serafukuやponytailなどのタグを使わないのは、それらの概念がきちんとzarakiminaに集約されているかを確認するためです。
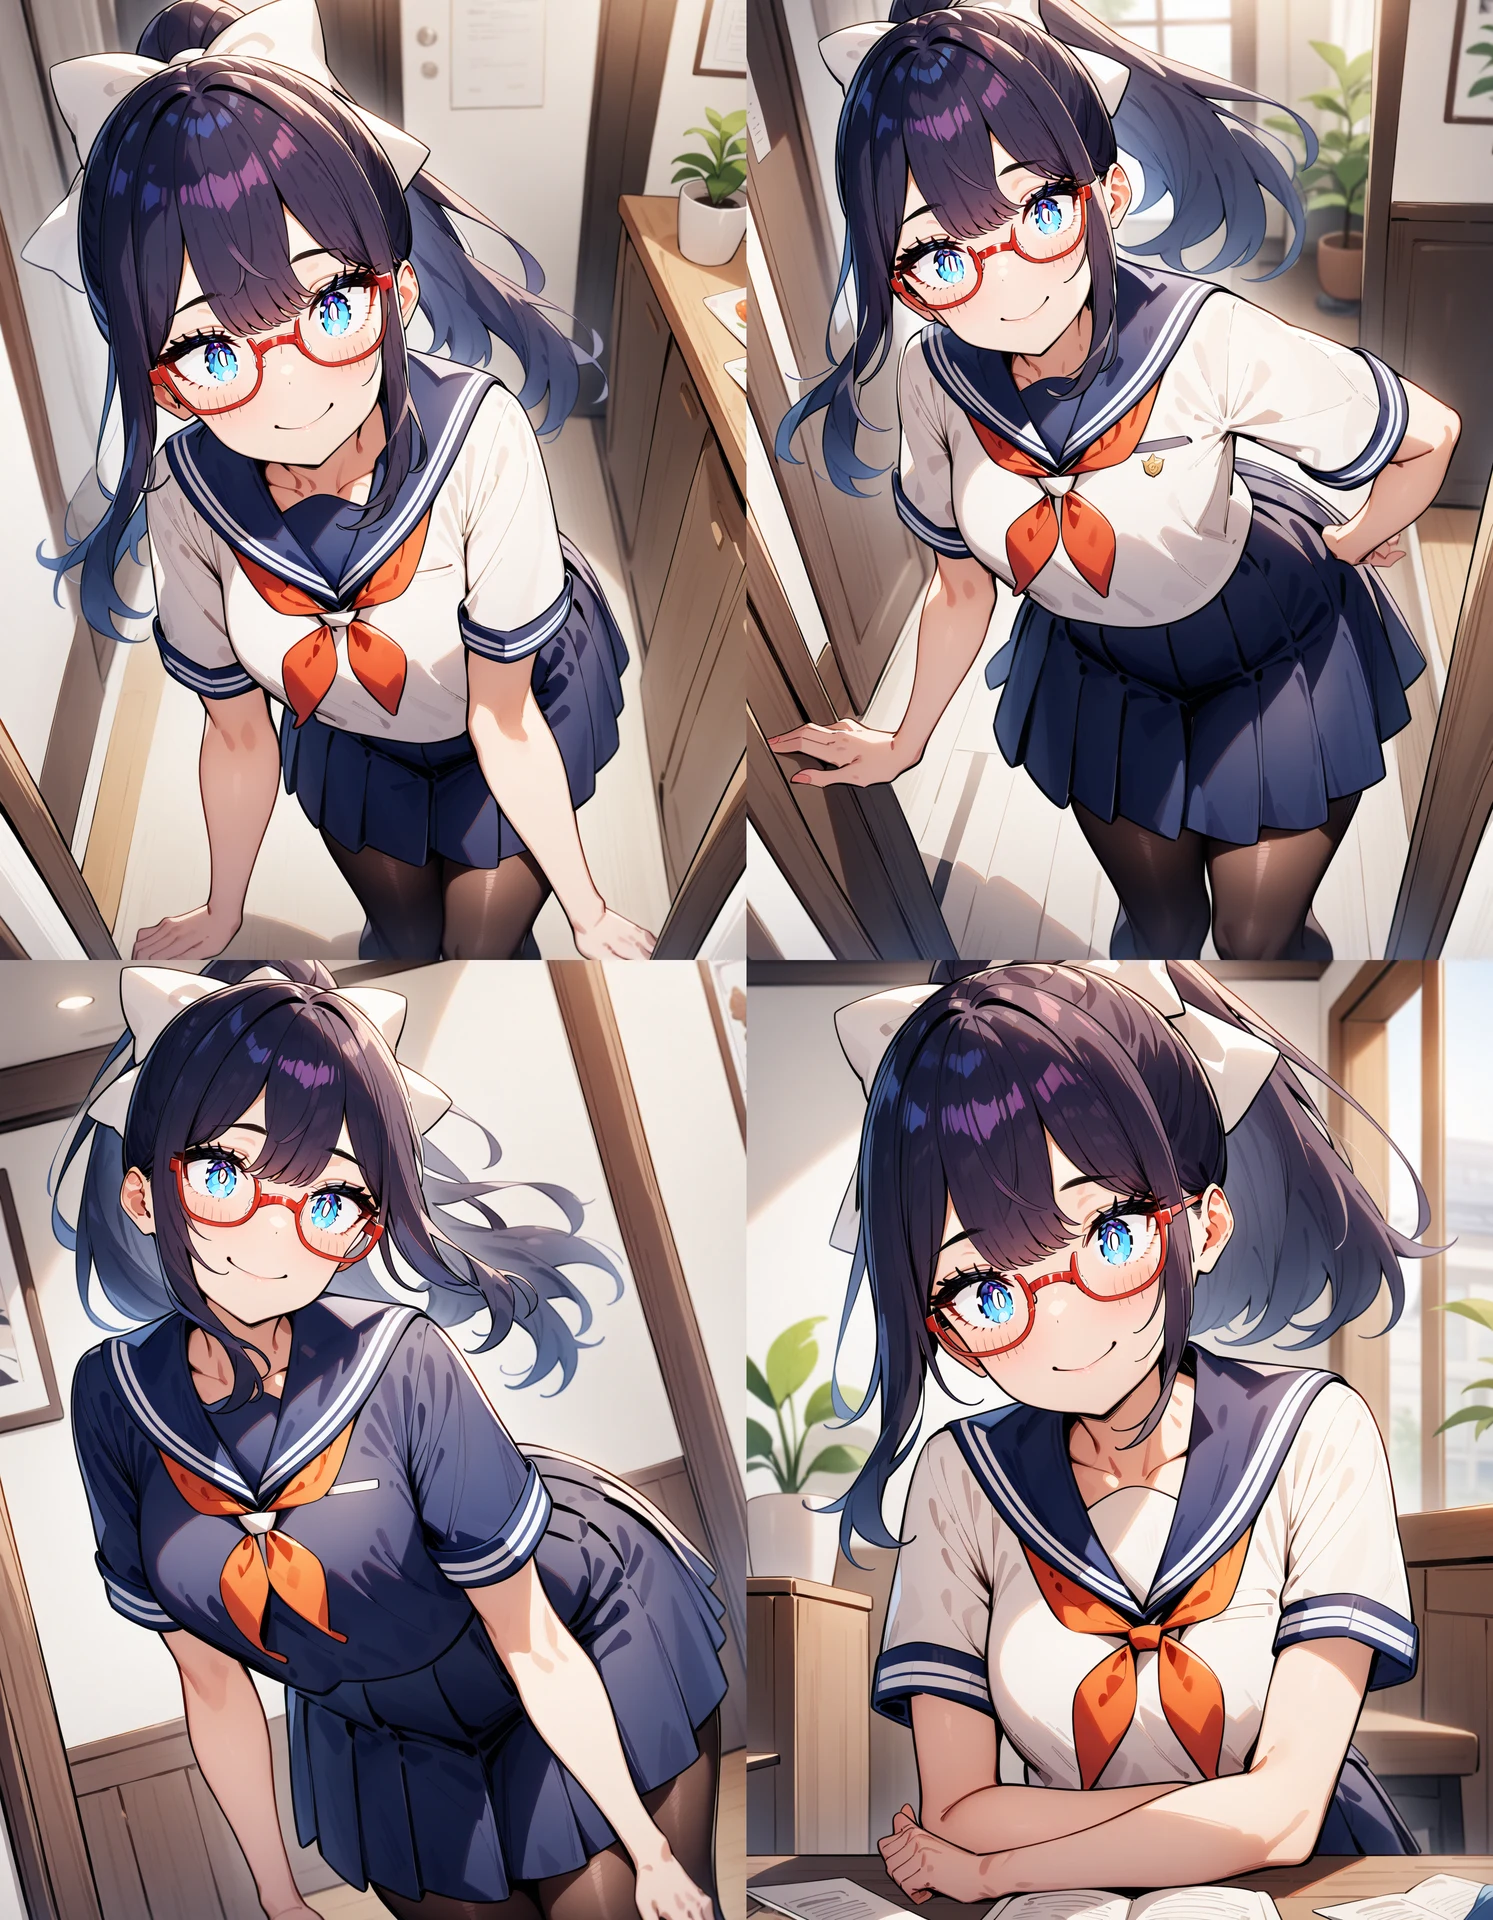
こちらが生成結果。プロンプトでは服装や眼鏡、目の色などを指定していませんが、おおむねzarakiminaLoRAに集約できているようですね。ただ、低確率でセーラー服が紺色になってしまうことがありました。
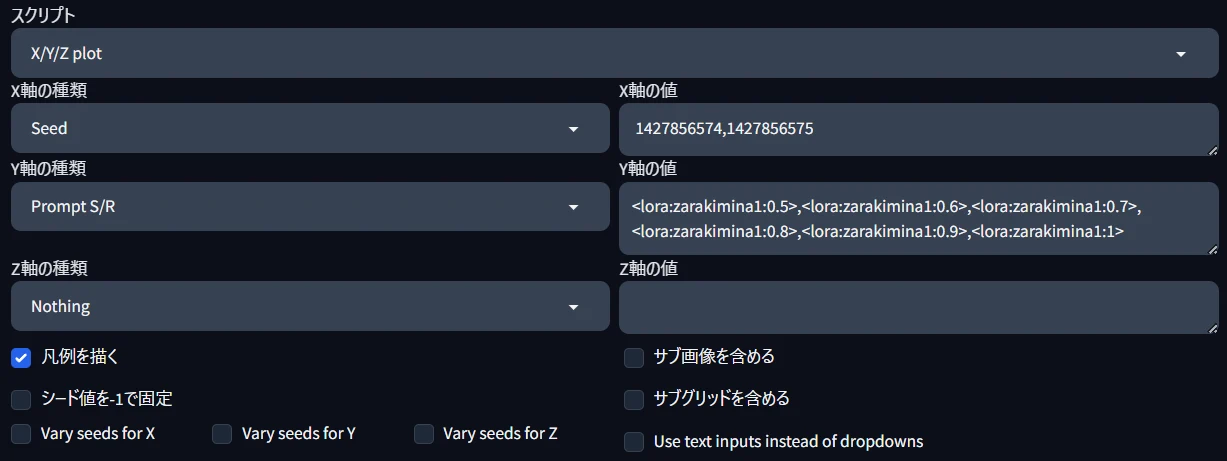
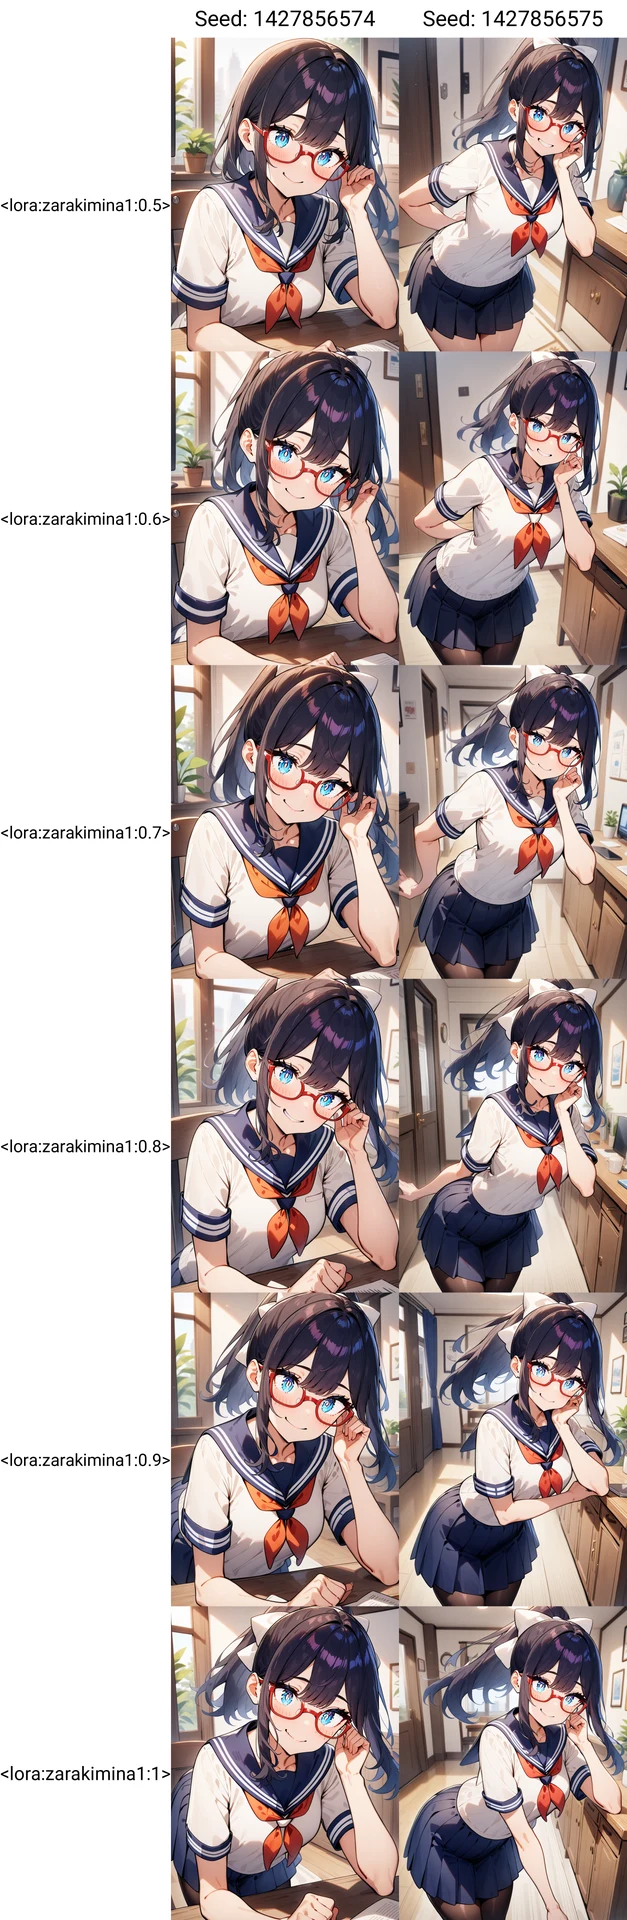
出来栄えを確かめるには、XYZ Plotで次のように設定して、比較実験を行うのがオススメ。まずはLoRAの重みを0.5~1までで比較してみます。
こちらが比較結果。0.5だと弱すぎて髪型が再現できず。1だと目が溶けているので、0.7~0.8くらいがちょうどよさそうに見えます。
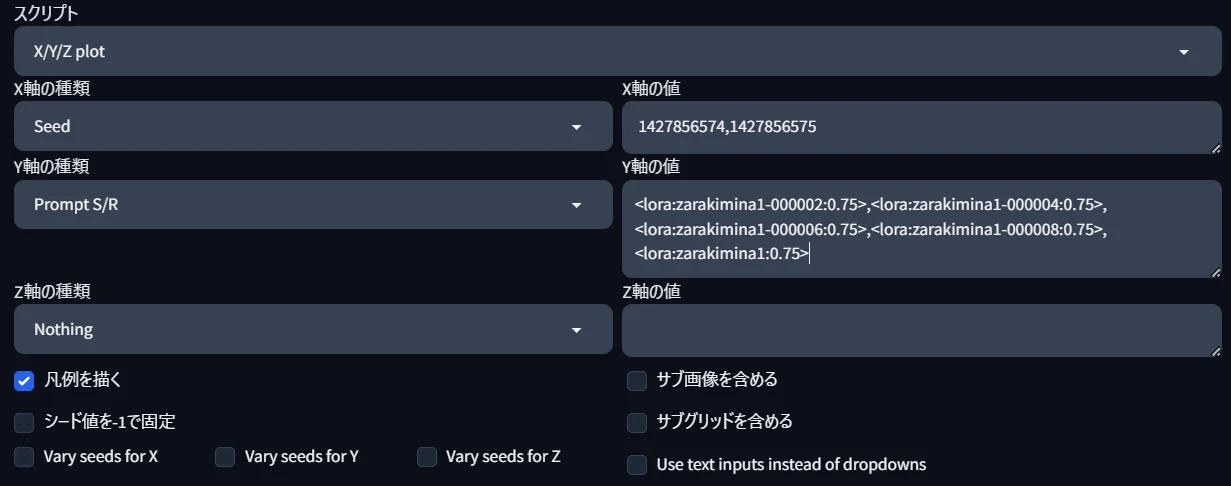
さて、今度は途中の2~8エポック段階で生成されていたLoRAもテストします。LoRAの重みは0.75で統一してみましょう。
こちらが生成結果。6エポックまでは制服の細部がバラバラなのが分かります。
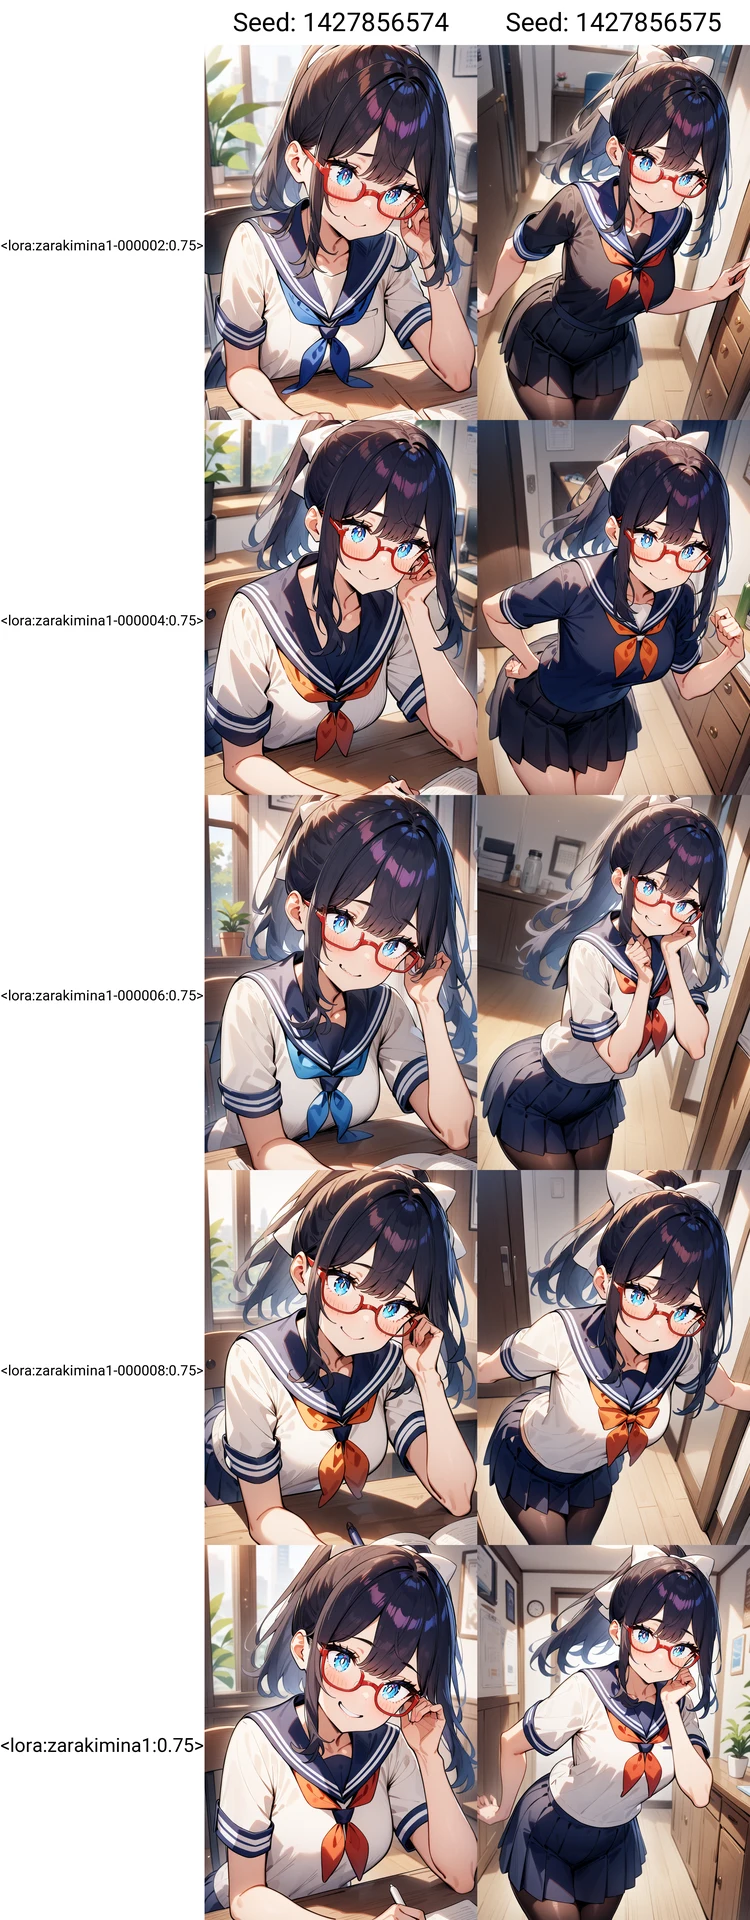
8エポックと10エポック(完成)では甲乙つけがたいように見えますが、10エポックでは手が崩壊しているのがやや気になりますね。(2エポック刻みで保存ではなく、1エポック刻みにしておけばよかったです)
さて、ここまでは「zarakimina」概念がどれくらい学習されているかを確かめましたので、ミナちゃんを示す要素タグも使って、プロンプト指示で容姿を補強してみます。
PP:<lora:zarakimina1:0.8> 1girl,zarakimina,serafuku,red eyewear,flat eyes,pleated skirt,sidelocks,red neckerchief,open mouth,white shirt,white bow,blue eyes,white pupils,blue sailor collar,upper body,smile,outdoor,sky,looking at viewer+クォリティ
こちらが生成結果。おおむね良いのではないでしょうか。
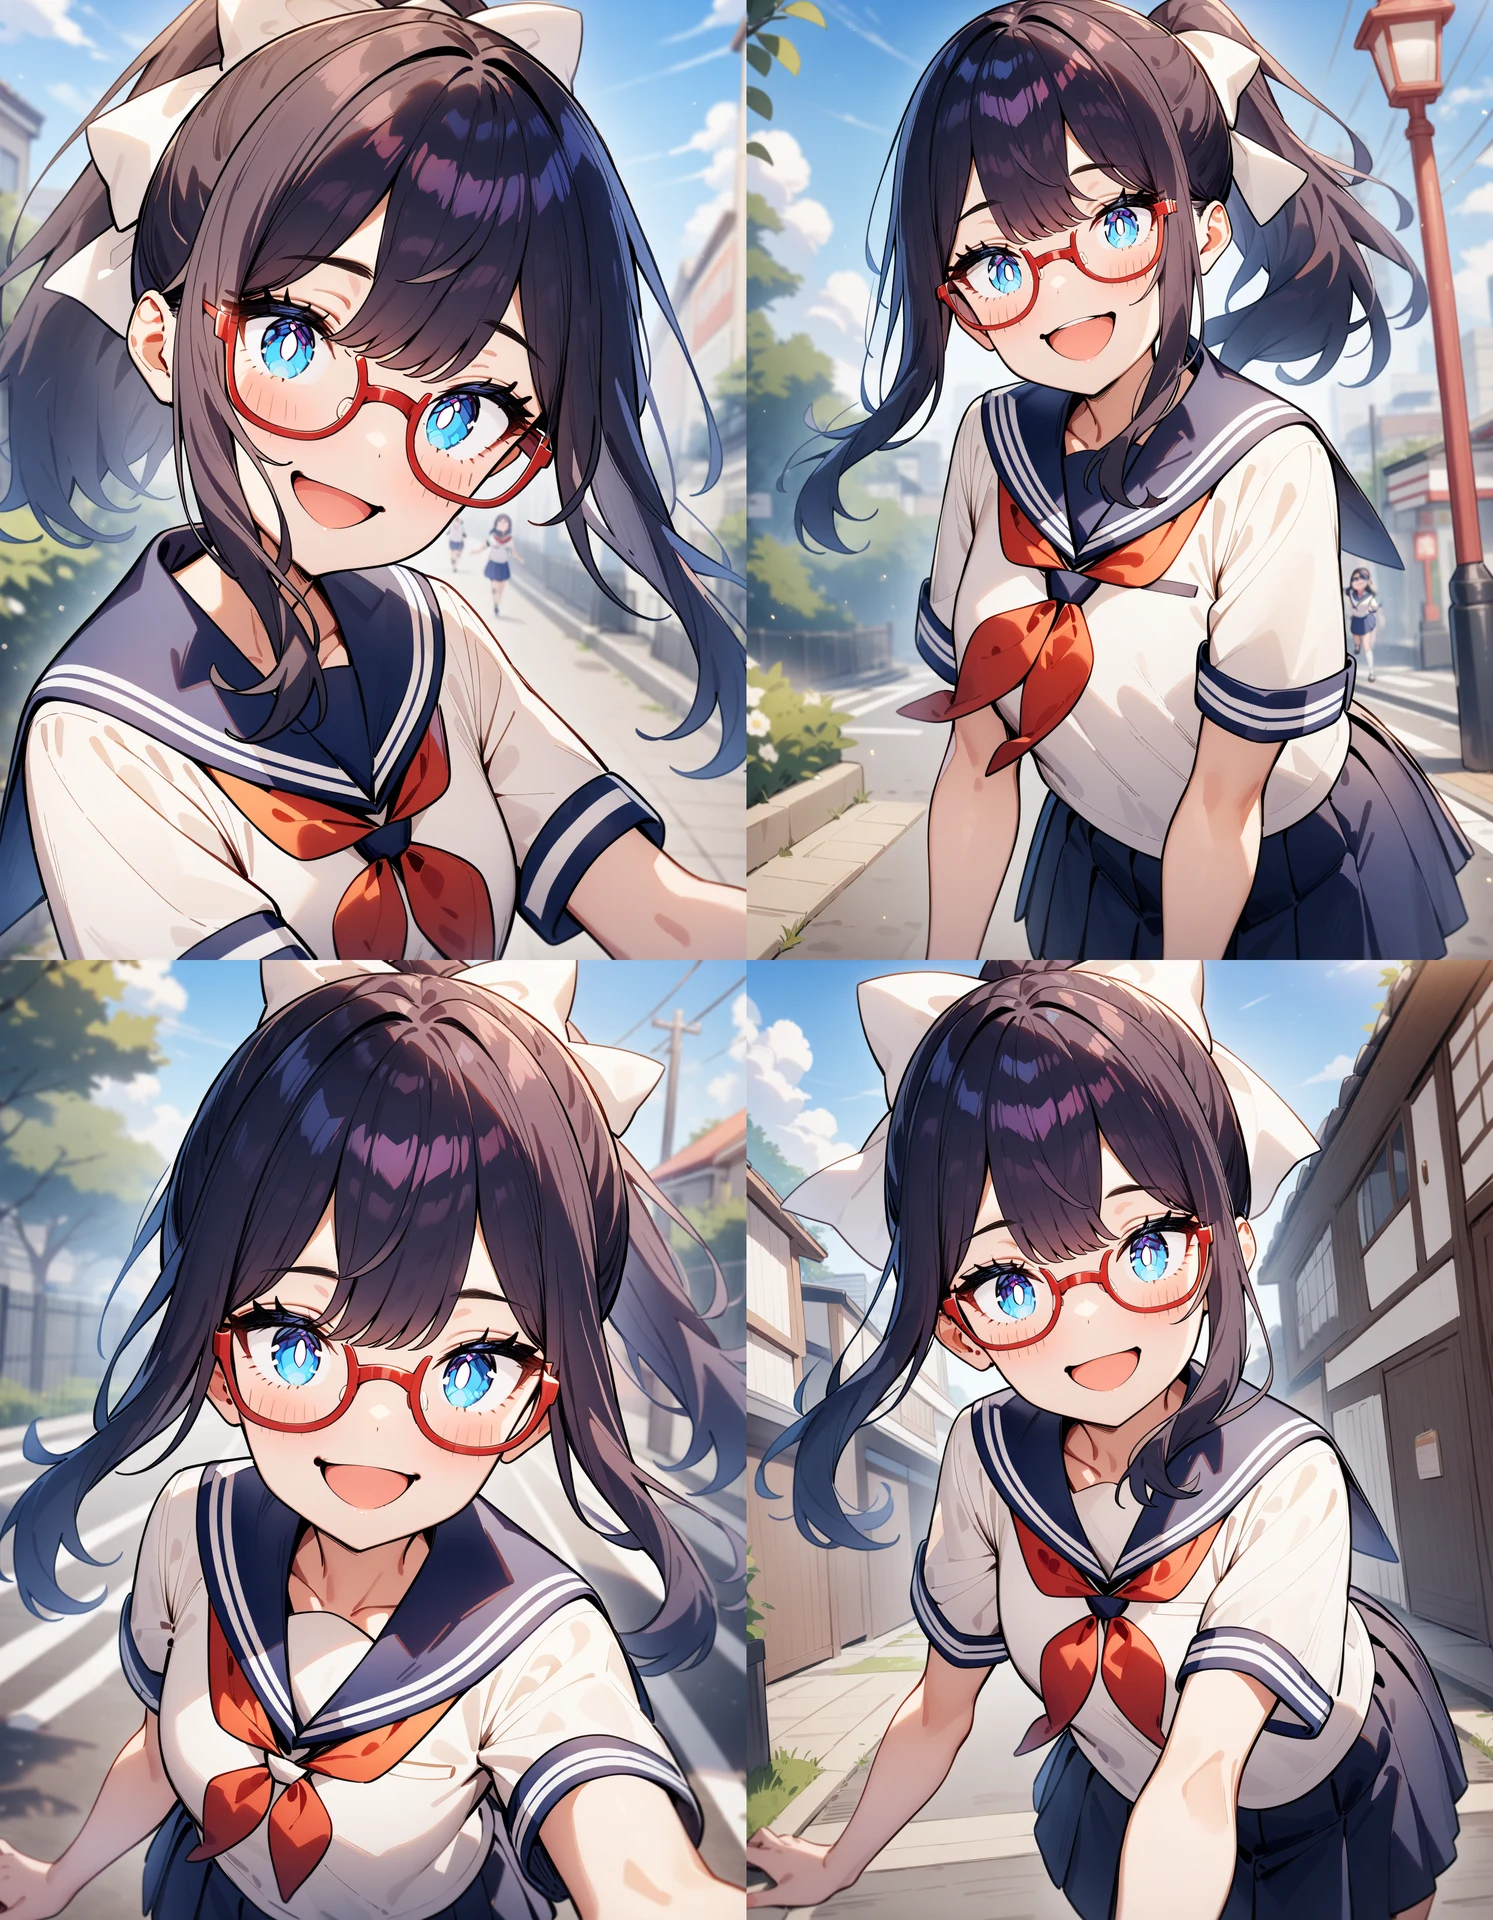
更木ミナLoRAの反省点
さて、20枚のAI絵で作った更木ミナLoRA、おおむね良い出来ではありますが、反省点もいろいろあります。
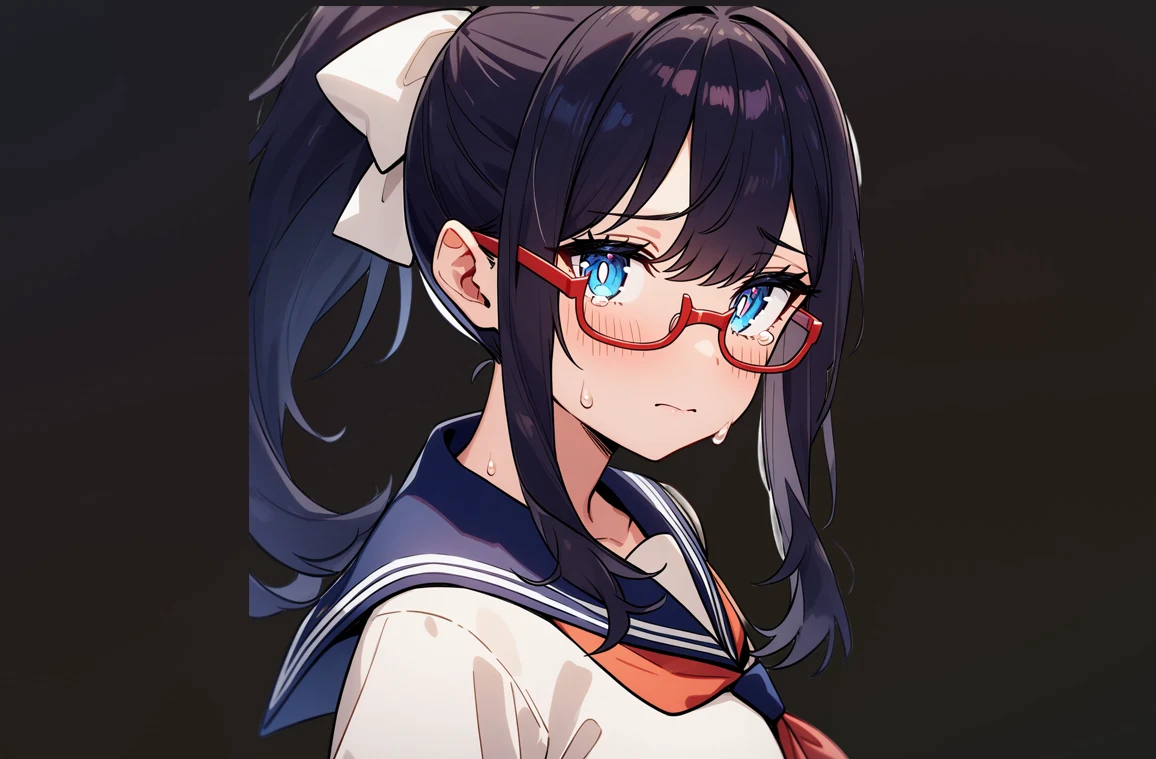
①目が溶けがち
まず、無加筆のAI絵20枚を基にしたことから「目が溶けがち」というのが最大の難点。学習データセットの中に、このように目が溶けている画像が複数入っているため、完成したLoRAにも影響してしまっています。
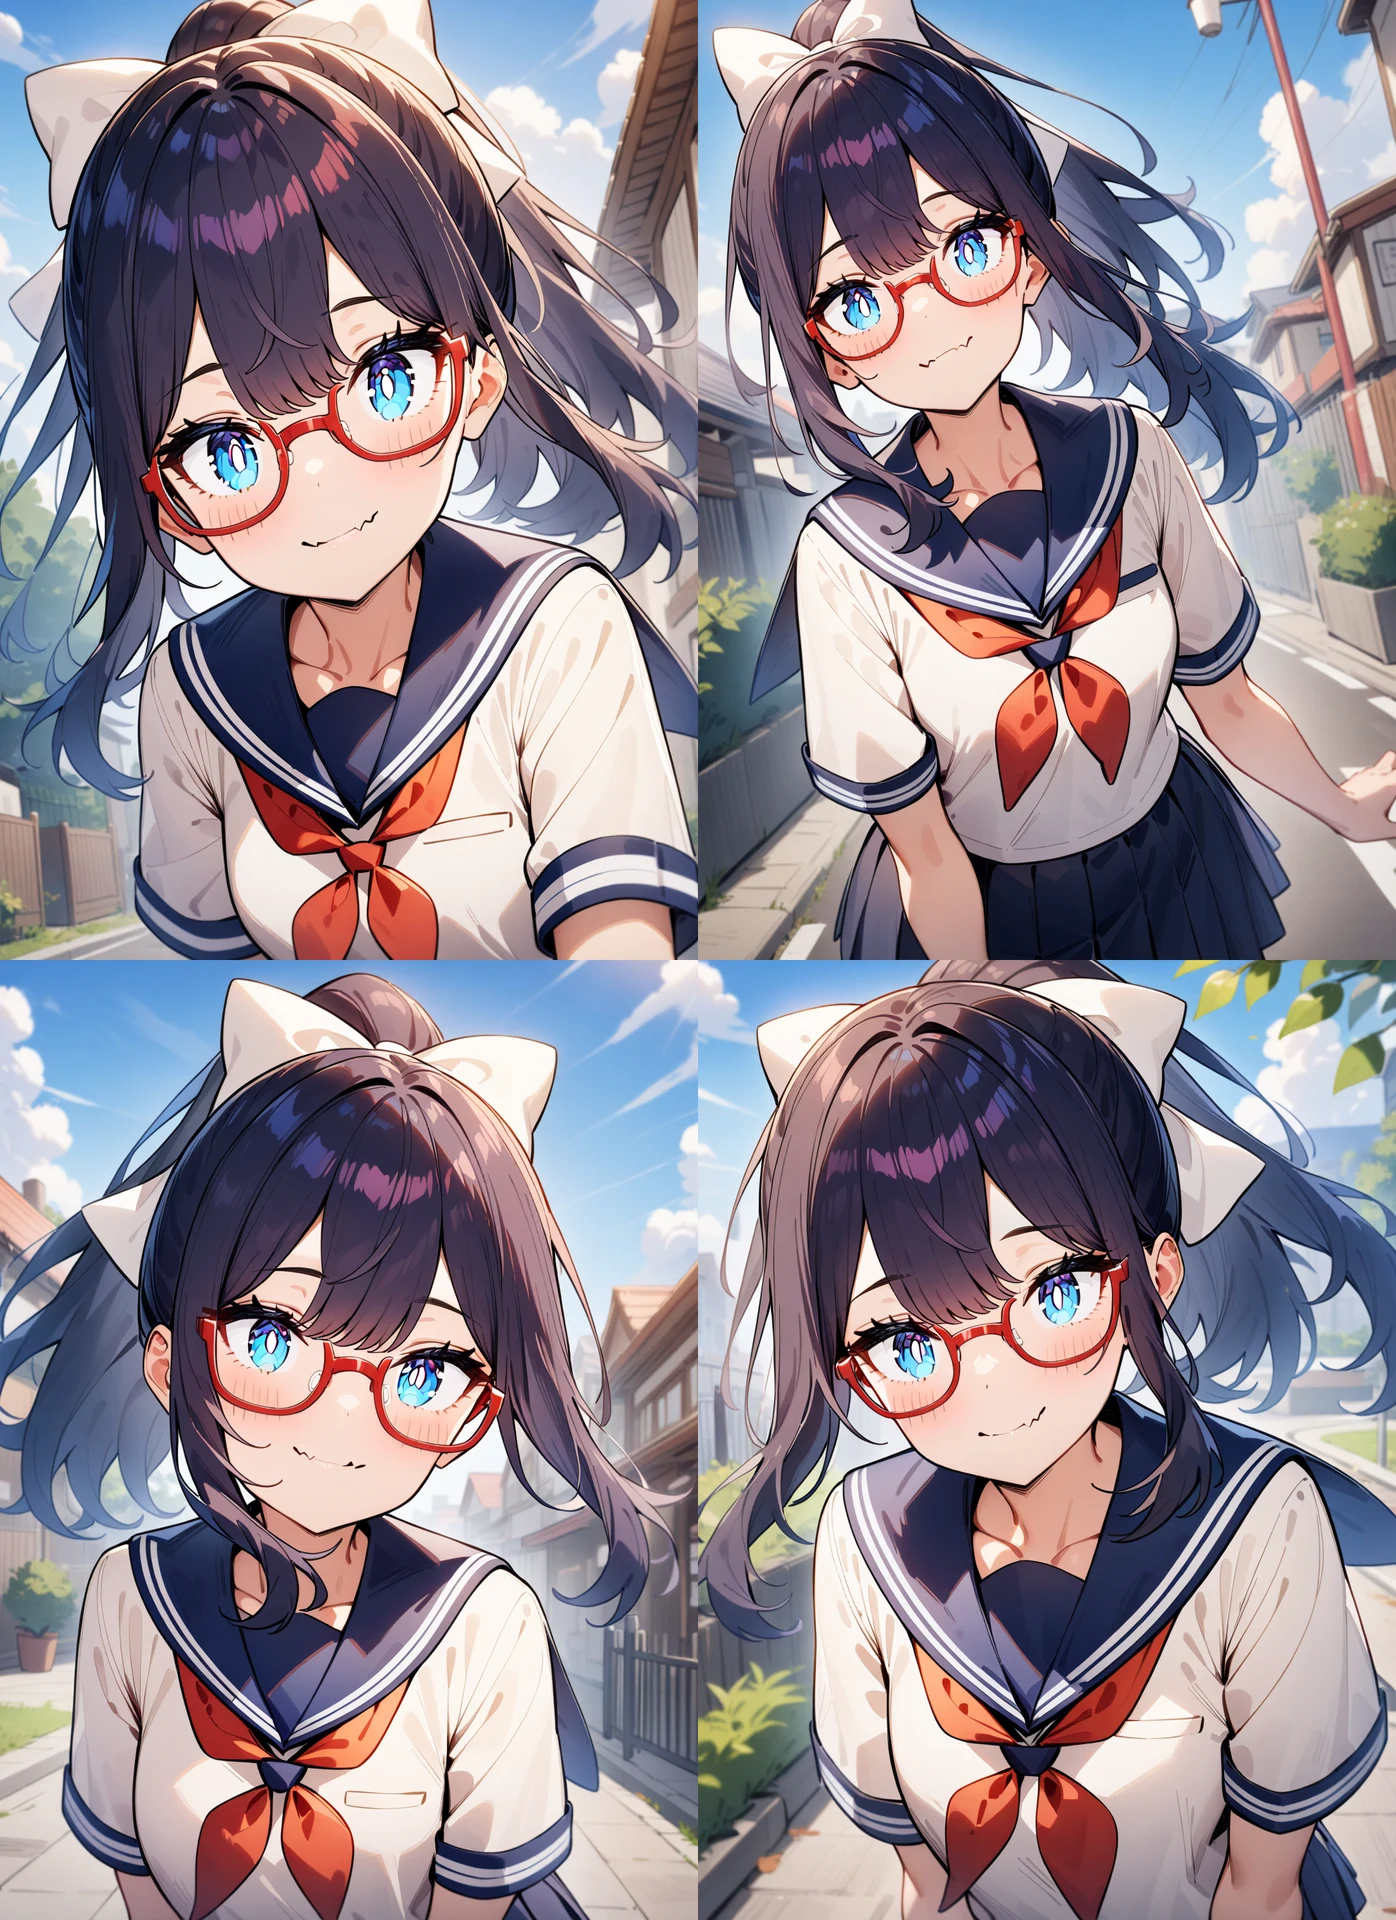
②八重歯の無駄学習
もう1点は、1枚だけ八重歯表現のあるイラストがあり、かつ「skin fang」タグを除去していたために、常に八重歯が見えるキャラと学習されてしまったこと。こんな感じで、口のラインがギザギザになりやすいLoRAになってしまいました。常に八重歯が描写されるべきキャラでないなら、本来は除去してはいけないタグでした。
③本来の服装と異なる
これも無加筆のためしょうがないのですが、本来、ミナちゃんの服装は下図のような感じにしたいところ。セーラー服のデザインは青地に一本線であり、赤いリボンも中央の結び目が紺色ではありません。胸の白い三角部分に柊のマークも入れてほしいところです。
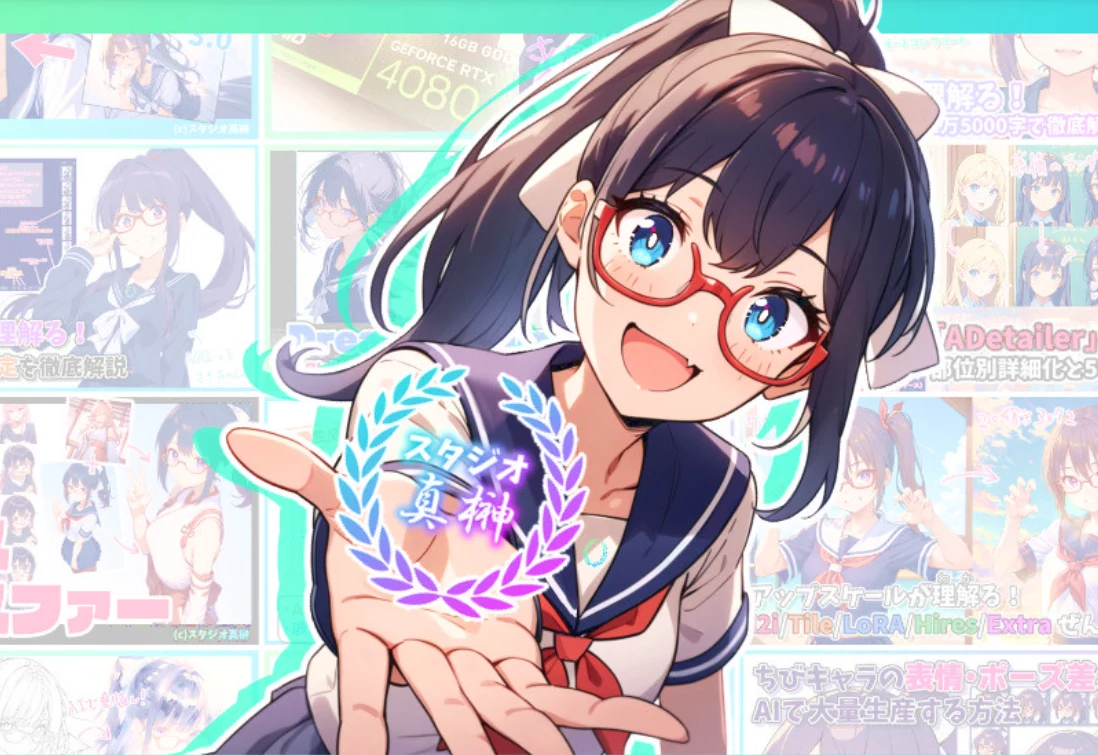
これはそもそも学習データセットがきちんと線の加筆をしていない(ほとんどの画像が2本線になっている)ため、必然の結果と言えます。こちらのタイトル画像はしっかり加筆したものですので、目の感じもだいぶポン出し画像とは異なりますね。
どうやって改善するか?
常に袖や襟のラインが一本線で、目が溶けたり、八重歯が常に描かれたりしないLoRAを作るためには、データセットに描かれているすべての制服デザインやミナちゃんの容姿が一貫していることが求められます。今回は生成で作った20枚のデータセットで試作したわけですが、オリジナルキャラの細部の統一感にこだわる場合は、より枚数を増やし、加筆を徹底するなど入念な準備が必要となるでしょう。
顔のアップや制服の細部のアップも加え、目の溶けていない50枚程度のデータセットでやり直せば、より良質なLoRAを作ることができるはずです。また、今回はdim8/alpha3とやや低めの次元数で学習させたため、安定性が高い代わりに容姿のルールをそこまでしっかり覚えられていないようです。dim64/alpha32やdim32/alpha16あたりで試すと、制服の細部のミスは減るのではないかと思います。
トラブルシューティング
できたLoRAがうまく動作してくれなかったときは、画像収集・フォルダ構成・タグ付け・学習設定・生成設定のいずれかの段階でミスがあったことが考えられます。以下に、よくある失敗と対処法をまとめました。
・指示していない背景が出てくる
余計な背景を学習した画像が複数ある可能性があります。背景を透過するか、その画像をデータセットから除外して学習をやりなおしましょう。
・衣装が安定しない
キャラを衣装付きで学習させたい場合、1girl+LoRAトリガーのみで生成してもうまくいかないことが多いです。着せたい衣装を示すようなタグを補って誘導してみましょう。または、次元数が低かったり、学習ステップが十分でなかったりしていることも考えられます。
例えば、データセットの中に「制服姿」「普段着姿」「軍服姿」の3つのバリエーションが混在していた場合、タギングをしっかりしないと3つの服が合体したかのような衣装が出てしまうことがあります。制服姿だけを覚えさせたい場合は、制服姿の画像だけでデータセットを準備するのが一番良いのですが、それでは枚数が足りない場合、普段着と軍服バージョンの画像にしっかりタギングをして、概念除去を行うことが必要です。
・表情やポーズ、構図が偏る
タギングによる概念の除去が甘いか、画像のバリエーションが足りないのではないでしょうか。同じような表情、ポーズ、構図の画像で学習してしまったために、「そのキャラは常にそういうポーズや表情で描かれるべきキャラ」と誤解されている可能性があります。データセットが全て笑顔だと、いかにsmileとタグ指定しても、このキャラは常に笑顔のキャラなんだと思われてしまうということですね。
例えば、座っている画像には「sitting」、横からの画像には「from side」、上半身のイラストには「upper body」を入れないと、それぞれの構図のイラストばかりが出てしまいます。必要なタグが抜け落ちているなら、最新のTaggerを導入するか、タグ検出のしきい値を下げましょう。
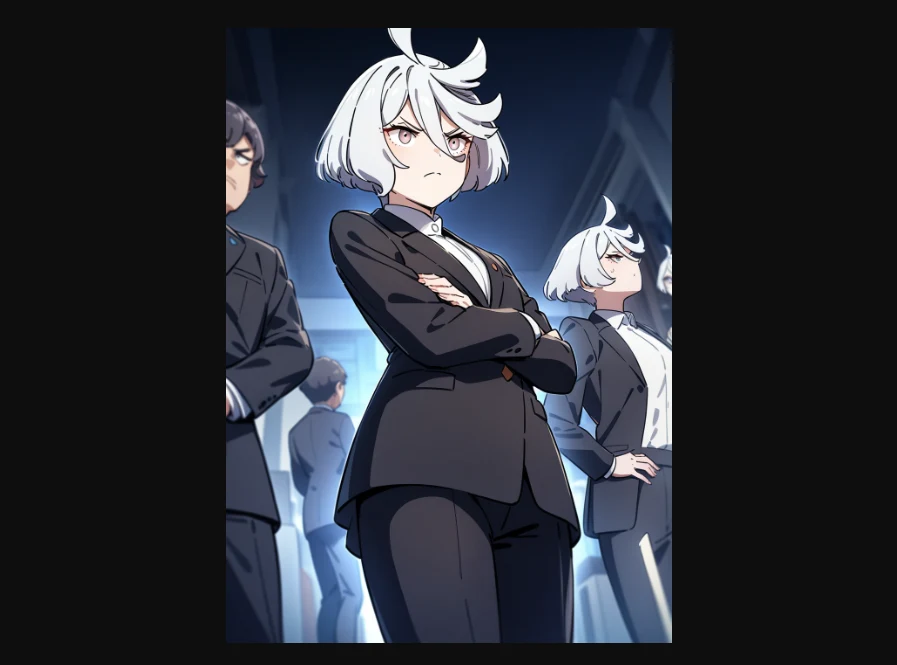
・1girlと指示しているのに別キャラが出ることがある
タギングで「1girl」や「solo」を除去してしまった可能性があります。除去していないし、「1girl,solo」と指示しているのに下図のような画像が出てしまう場合は、データセットの画像に映り込んでいる他のキャラがトリガーワードに集約されてしまっています。画像編集ソフトで余計なキャラの映り込みを消すか、他キャラのいる画像をデータセットから除外して学習をやり直しましょう。
・オレンジがかったり、青みがかったイラストばかりが出る
夜のシーンや夕方のシーンのイラストを多く学習させた影響で、通常状態のキャラクターの色味を覚えられていない可能性があります。CLIPSTUDIOなら「色調調整→カラーバランス」フォトショップなら「画質調整→レンズフィルター」を使って、逆方向の色味のフィルターを掛けて、色味を調整すると良いです。
ポイントは、本来なら白いところ(シャツや白目)が何色に変化しているかを確認すること。青く変化していたら暖色系のフィルターを、逆なら寒色系のフィルターを掛けるとよいでしょう。あまりに明るすぎたり、暗すぎたりする画像も教師データには向きません。
・四肢がおかしくなる
まずはプロンプト上でLoRAの適用強度を下げてみましょう。0.5-0.6程度まで下げても四肢がおかしくなるようなら、過学習が起きてしまったか、もしくは全身が描かれたイラストが不足している可能性があります。バストアップで手の映っていない画像ばかりだと、このキャラクターが人間型の体型なのかどうかもAIには分かりません。全身画像が手元にない場合はNovelAIのV3インペイントなどでなんとか作りましょう。
・複数のキャラLoRAを適用すると画像がおかしくなる
単独ではうまく動作するキャラLoRAでも、同時適用すると崩壊することがあります。そうした場合はそれぞれのLoRAの重みを0.5程度に弱めて試してみましょう。
※単純に使用しているCheckpointが複数キャラの絡みが苦手である可能性もあります。AnimagineXLよりもPony系の方がキャラ同士の絡み(ありていに言ってしまえばHシーンなど)は上手に生成できることが知られています。
・キャラが全然似ない/思ったような効果が感じられない
プロンプトをもう一度確認して、正しくトリガーワード(loraのファイル名ではなく、タグ付けされたテキストの冒頭に入っているタグがトリガーワードです)やLoRA名を設定できているか確かめましょう。正しくLoRA適用できているはずなのにうまくいかない場合は、学習不足かもしれません。ネットワーク次元数とネットワークアルファを上げてみるか、繰り返し数や画像の枚数、エポック数を増やして、もっと徹底的に教え込みましょう。
・線がガビガビ/塗りが波打っている/画像が低劣化や崩壊を起こしている
過学習を起こしている可能性があります。LoRAの重みを0.6~0.8程度に弱くしてみると、きれいに表示されるかもしれませんが、弱めるとキャラクターの印象も弱まってしまい、良いバランスにならなければ学習失敗です。
エポックごとにLoRAを生成する設定にしていたなら、完成品以外にも途中段階のLoRAファイルが出力されているはずです。X/Yプロットを使って、同じSeed値でいくつかを比較してみると、過学習/学習不足でどのように絵柄が変化するのか理解できると思います。(次の章"過学習が起きてしまったら"も参照のこと)
・ほとんどよくできているが、衣装の一部が間違っている
キャラLoRAでよくあるのが、衣装の一部がちょっとだけ間違えてしまうというケース。例えばこちらのキャラは、生成するたびに腹部の黄色のラインや袖のデザインがぶれるので、その周辺の学習があやふやなことが分かります。
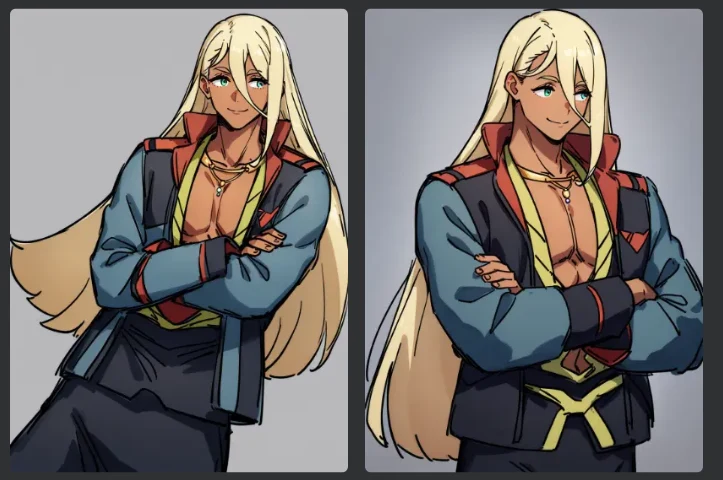
オリジナルキャラや普段着ならともかく、エヴァのプラグスーツのように正しいデザインが決まっているものを間違えられると「分かってないな」という感じの画像になってしまうので困りますね。間違えられる理由はまず適切に学習できていないということですが、
・詳細に覚えられるだけの枚数が足りない
・細部までしっかり描かれた画像がない
・間違って描かれた画像が混入している
・次元数や学習ステップが足りていない
…といった可能性もあります。
例えば手首周辺のデザインが頻繁に間違えられるとか、プラグスーツの胸の数字がきれいに描かれない場合は、手首や胸の周囲が大きくはっきり描かれている画像を増やし、タグで「どこそこのクローズアップ」と指示(つまり概念除去)すると良いでしょう。画角の概念を除去しないと、部位のアップばかりが描かれる恐れが強まります。
過学習が起きてしまったら
作ったLoRAを重み1で適用したとき、プロンプト指示がうまく効かないときがあります。他にも、線が震えていたり、目などの詳細部分が溶けてしまったり、学習したイラストのある特徴を異様に強調するようになったり、フラットに塗られるべきところにガタガタした謎の模様ができたり、背景に謎の光が生じたり…。これは「過学習(overfitting)」といって、学習データに対してLoRAが過剰に適応してしまい、本来の汎用性を失ってしまったことを示す現象です。
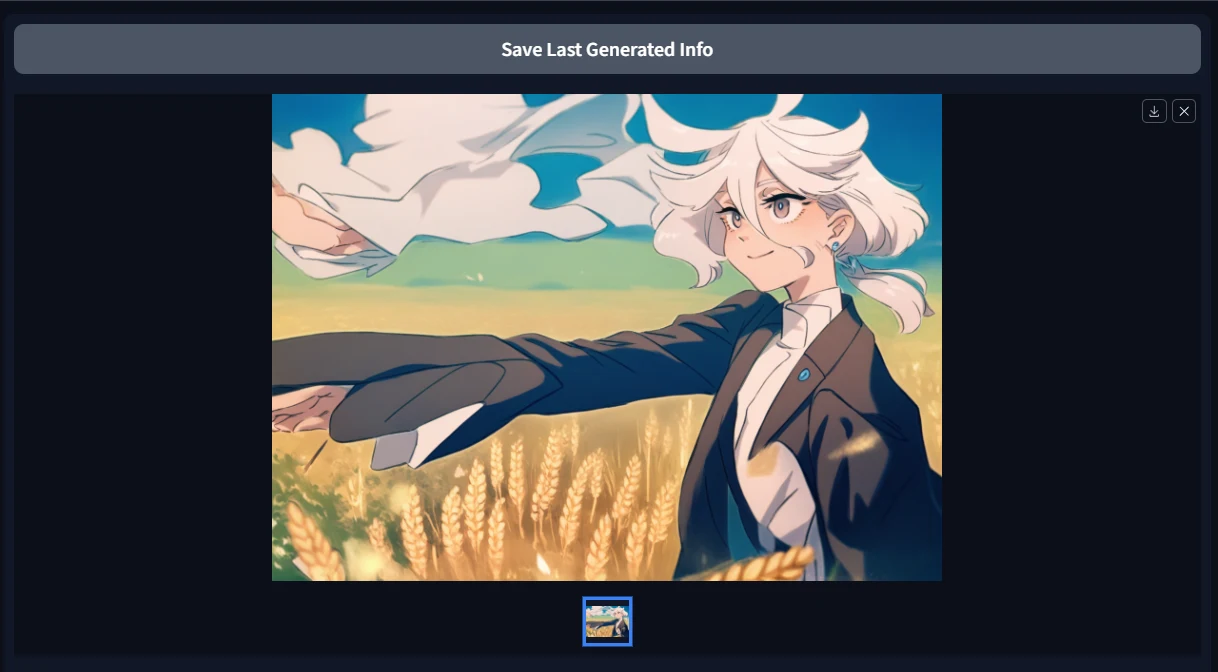
▲焼きすぎるとこうなる
過学習は主に「データセット不足」「画像のバリエーションの偏り」「学習の反復しすぎ」によって起こるものですので、データセットを見直し、学習のやり方を見直すことで改善が見込めます。プリセットにはそれぞれ推奨されるBatch1相当のステップ数がありますが、やや多めにエポック数を設定しておいて、保存頻度を「1」にすれば、ちょうどよい焼き加減のLoRAをあとから探すことができるのでオススメ。どの焼き加減でもうまく生成できなかった場合は、準備した食材(データセット)の方に問題があると思われます。
過学習の反対は「学習不足」で、エポック数や繰り返し数が足りなかったり、学習度(lr)の値が適切でなかったりすると、上手に「概念」を学べず、再現度の低いLoRAになってしまいます。エポック数や繰り返し数、学習率などのパラメータを調整して、過学習を起こす一歩手前までしっかり学習させるのがよいLoRAにするコツです。
良質LoRAに学ぼう
既にみなさんのほとんどはPCの中にお気に入りのLoRAを溜め込んでいると思いますが、webUI上でLoRAのカード一覧を開き、右上の「i」ボタンをクリックすると、学習情報を閲覧することができます。
ss_optimizer(オプティマイザー)
ss_network_dim(ネットワーク次元数)
ss_network_alpha(ネットワークアルファ)
ss_learning_rate(学習率)
ss_num_train_images(教師画像の総学習枚数)
n_repeats(繰り返し数)
img_count(画像の枚数)
ss_num_epochs(エポック数)
ss_max_train_steps(総ステップ数)
...などの設定を見て、良質なキャラ再現LoRAがどんなオプティマイザーと学習率を採用し、データセットはどれくらいの枚数で学習しているかを勉強させていただくのがよいと思います。優れたキャラ再現LoRAは、やっぱり枚数が多いのが特徴ですね。タギングの除去のやり方なども読み取れるので、お気に入りの高性能キャラLoRAがある方はじっくり学ばせてもらいましょう。
タギングの概要もわかるので、データセットの中身をなんとなく想像することもできます。何を除去して何を除去していないか想像してみると、勉強になることが多いと思います。
★キャラLoRA以外を作るには?
画風LoRAやポーズLoRA、構図LoRA、背景LoRAなど、さまざまな種類のLoRAがありますが、基本的には今回紹介した手法の応用で作ることができます。キャラLoRAと違うのは、主に用意する画像の種類と、除去すべきタグの部分ですが、良質な画像を集めて、トリガーワードに集約させたいタグを除去するのは同じ。どんなLoRAであっても、お手本となる同種のLoRAをCivitaiから探し、どういったタグ付けをしているか、何枚くらいの画像をデータセットとして用意しているかを学ぶと、作り方のヒントになります。
例えば画風LoRAであれば、できるだけたくさん一貫した画風のイラストを用意しておき、タガーで検出したタグを何も除去せず学習させれば、それら画像に共通した概念(画風)をLoRAそのものが学習します。いろいろな考え方があるようですが、いろいろ実験した結果、画風LoRAの場合はトリガーワードをあえて設定しない方が良いように思っています。(詳しくはこちらの記事を参照のこと)
終わりに
今回はAnimagineXL3.1でのLoRA学習法を紹介しました。プリセットを使用したので、キャラLoRAであれば初心者の方もさほど問題なく作れたのではないかと思います。次回はよりピーキーなPony系LoRAの作り方を見ていきたいと思います。
SDXL普及の嚆矢となったのは、やはりAnimagineXL3.0の功績が大きかったと思いますが、現在Civitaiを見ていると、Animagine系よりもPony系LoRAの方が数多く投稿されているように見受けられます。Pony系の強みは、なんといっても独自のタグ付けによる精度の高さと、複数キャラの絡みが得意なこと。オブラートに包まずに言えば、H系のプロンプトの効きがAnimagine以上に強いです。ただ、クォリティタグの煩雑さやプロンプトルールの違い、画風の安定しなさなど、NAI系の取り扱いに慣れたユーザーにとっては取り回しが難しいのが短所と言えます。
別々のキャラLoRAを同時適用して複数キャラクターを1枚のキャンバスに描くのはSD1.5時代から非常に難しいことでしたが、ベースモデルの機能向上によってどれほど改善しているのか、AnimagineXL用LoRAと作り方はどう違うのかなどについて検証がまとまり次第、記事にしたいと思っています。
それでは今夜はこのへんで。スタジオ真榊でした。
//////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////
LoRA関連記事
//////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////