
こんばんは、スタジオ真榊です。今回はLoRA学習アプリ「Kohya LoRA Param GUI」を使ったAnima向けキャラLoRAの学習設定を深掘り検証した大型特集です。主にSDXLで学習経験のあるユーザー向けに、「どう学習したらどうなったか」を多角的に報告し、層別学習の概要を掘り下げる内容となっています。
AnimaとSDXLは構造から全く異なるモデルなので、SDXL時代の設定や常識をそのまま持ち込むと、思ったような結果にならないことがあります。この記事では、Animaの構造をかんたんに整理したうえで、LoRA学習を層別で止めた比較や、正則化用画像、固有衣装タグの検証を通じて、失敗例や成功のポイントを詳しく紹介していきます。【約2万4000字】
(※今回紹介するのは、数十~数百枚の画像とキャプションからなるデータセットを用意する従来型の追加学習法です。1枚絵から画風やコンセプトを抜き出す「コピー機学習法」はこちらの記事をご覧ください)
検証環境:学習は「Kohya LoRA Param GUI」26.6.6.1 Latest、検証画像はForgeNeoでAnima base v1.0を使用し、高速化LoRAを使い生成。グラフィックボードはRTX4080(VRAM16GB)を使用しています。
はじめに:Animaはどんなモデル?
Animaはご存知の通り、Danbooruタグと自然言語両方のプロンプト指示に対応できる次世代ローカル画像生成モデルです。NSFW生成や追加学習が可能で、高速化LoRAを使えば1枚10秒程度で整った画像が生成できるため、SDXLの後継モデルとして期待されています。Comfy UIかForge neo上で動作し、reForgeなどには対応していません。ForgeNeo上での基本的な使い方はこちらを参照のこと。
<SDXLとは構造から異なるモデル>
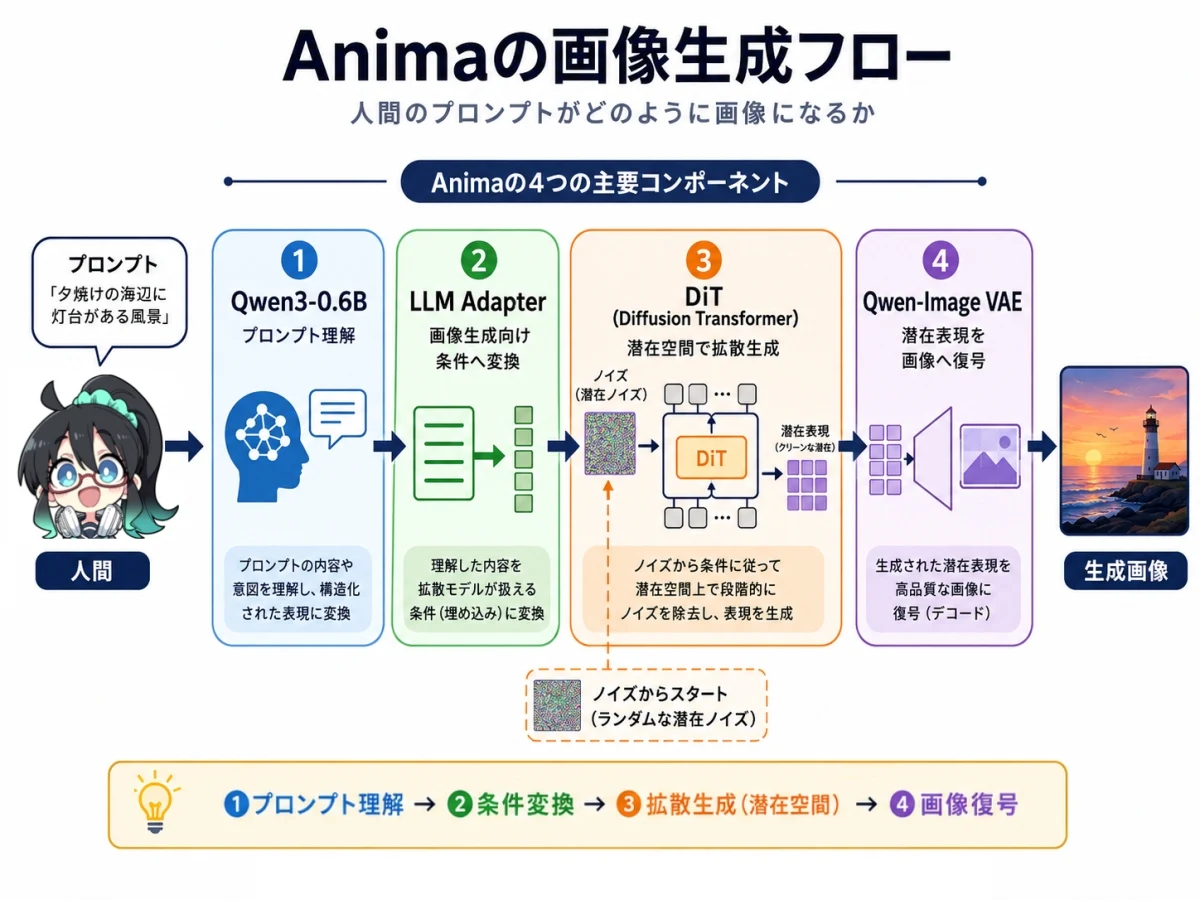
Animaは大きく分けて、以下の四つの部品でできています。
・「DiT(Diffusion Transformer)」…画像生成を行う本体
・「Qwen3-0.6B」…人間のプロンプトを読み取るテキストエンコーダ
・「LLM Adapter」…Qwen3の出力をDiTに橋渡しする翻訳役
・「Qwen-Image VAE」…潜在空間でできたものを目に見えるピクセルに変換
SDXLの本体は「U-Net」という構造でしたので、画像生成の仕組みからして全く異なるモデルであることを最初に理解する必要があります。
ざっくりイメージで伝えますと、まず人間がプロンプトをLLM(大規模言語モデル)であるQwen3-0.6Bに入力しますね。するとQwen3-0.6Bがそれを適切な形に変換・出力し、さらにLLM AdapterがDiT本体の読める形式に翻訳し、DiTがノイズから絵を組み立てて、VAEが人間の見える画像に変換する──というのがAnimaにおける画像生成の流れです。
<DiTの内部構造>
このときDiTの内部では、画像を小さなパッチ(タイル)に切り分けてトークンの列にし、まったく同じ構造の「Transformerブロック」というものを何十段も積み重ねて処理するということが行われているそうです。SDXLのU-Netはその名の通り「U字」の構造をしていましたが、DiTはこのブロックの層が重なったミルフィーユのような構造をしています。
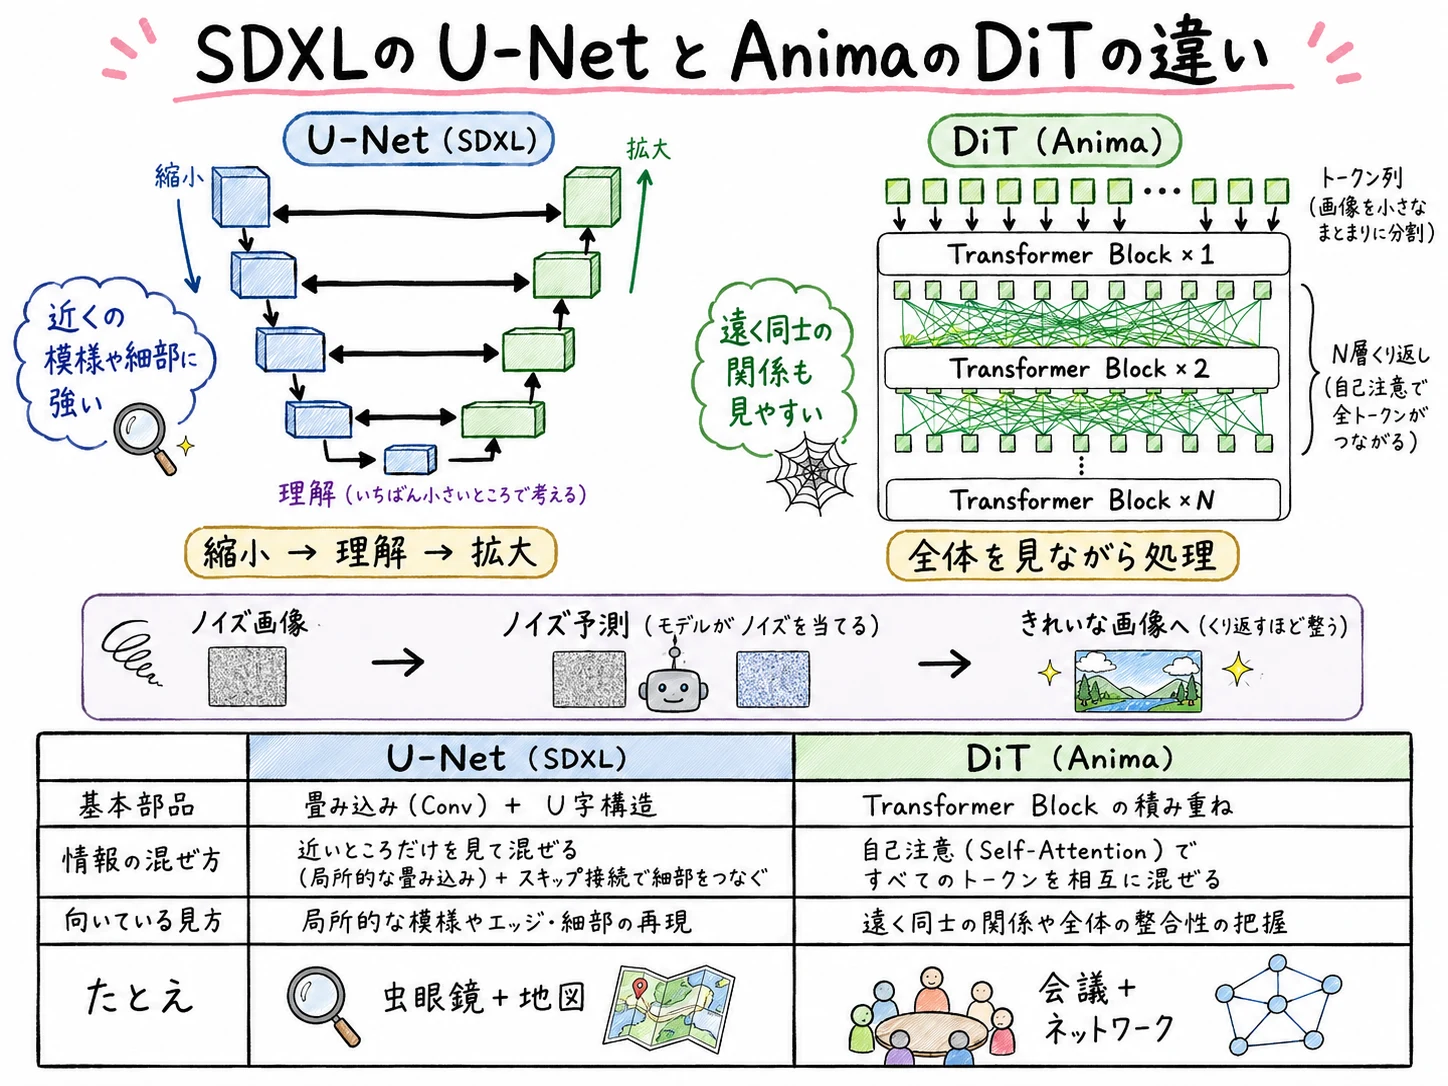
このミルフィーユの層(各Transformerブロック)は、以下の3点セットのモジュールによって構成されています。
・「セルフアテンション」: 画像パッチ同士がお互いをチェックするモジュール
・「クロスアテンション」: 画像パッチがテキスト(プロンプト)をチェックするモジュール
・「MLP」:各パッチの情報を変換するモジュール
既にややこしいですね…。しかし、Anima向けLoRAの設定を理解するうえで一番大事なのがここなので、ふんわり理解でいいので詳しく見ていきましょう。
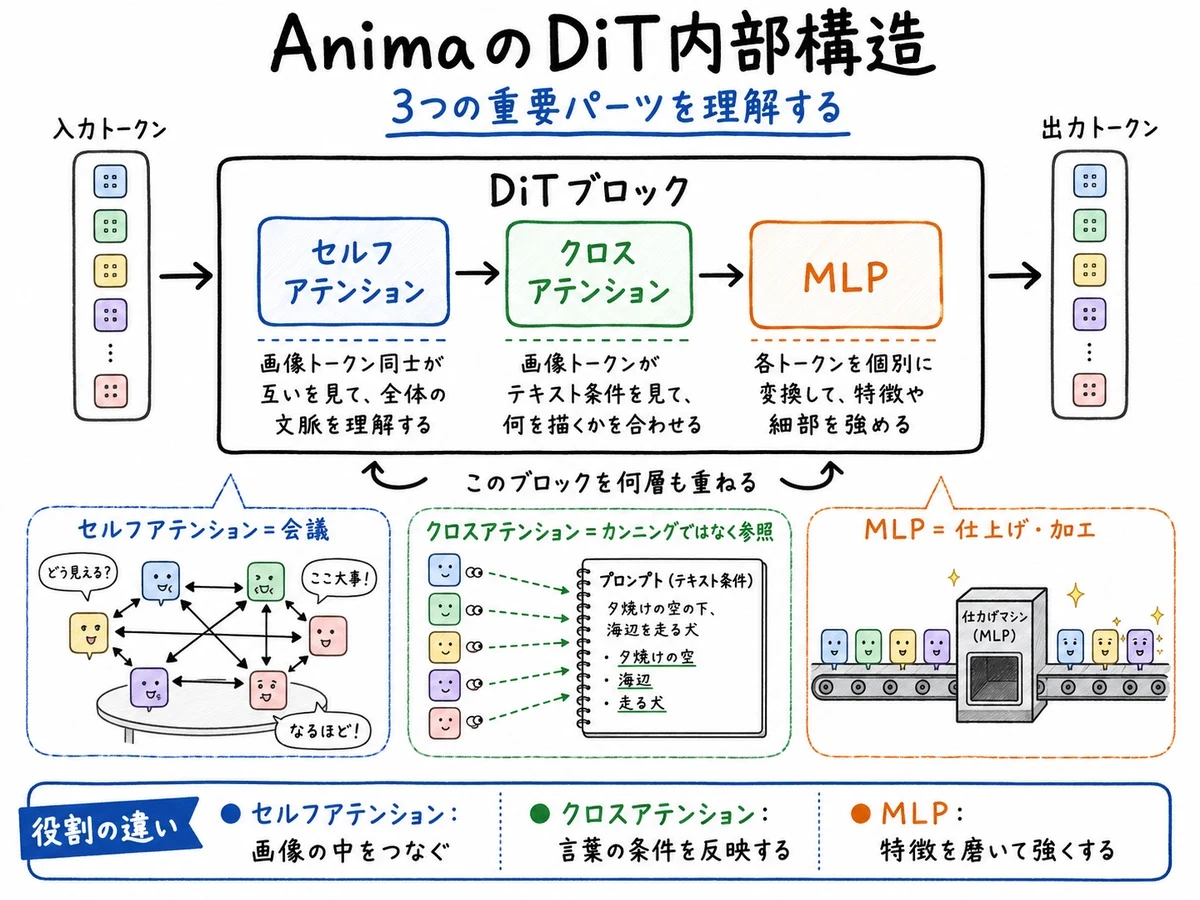
「セルフアテンション」では、「お隣のパッチは髪を描いているから、自分はその続きの毛先を描こう」というように、お互いがお見合いをしながら絵全体の文脈や整合性を保ちます。ユーザーがいちいち指示しなくても、自動的に自分たちでマスゲームをして、「まともに見える絵」にしてくれるイメージです。
「クロスアテンション」では、お隣のパッチではなくテキスト、つまりユーザーの指示を参照します。「blue eyesっていうタグがあるから、僕が担当する目のパッチは青くしよう」という感じで、テキスト条件を画像に反映させる経路なので、新しい言葉(キャラLoRAのトリガータグ)を学習させる場合は重要になります。
「MLP」は二つのアテンションの後で各パッチの情報を仕上げる層です。「アニメ塗りの肌はこういう色の乗り方」とか「線はこういうタッチ」といった見た目の変化を強めるため、画風LoRAでは特に重要な学習先です。
SDXLのLoRA学習にも層別学習はありましたが、基本的には「U-Netの学習率(LR=Learning Rate)」一つだけで学習をどう行うか決めていましたよね。それがAnimaでは「SelfAttnLR / CrossAttnLR / MlpLR / LLMAdapterLR」といったように、それぞれの層が司る内容ごとに学習率をかんたん設定することができるようになっています。では、まずキャラLoRAではどの層をどのように設定すると良い結果になるのだろうか?ということを、今回の記事で検証していくわけです。

TextEncoderの学習はどうすべき?
先ほどAnimaは四つの部品で構成されると説明しましたが、このうちテキストエンコーダであるQwen3の学習はどうすべきか?ということについて触れておきます。
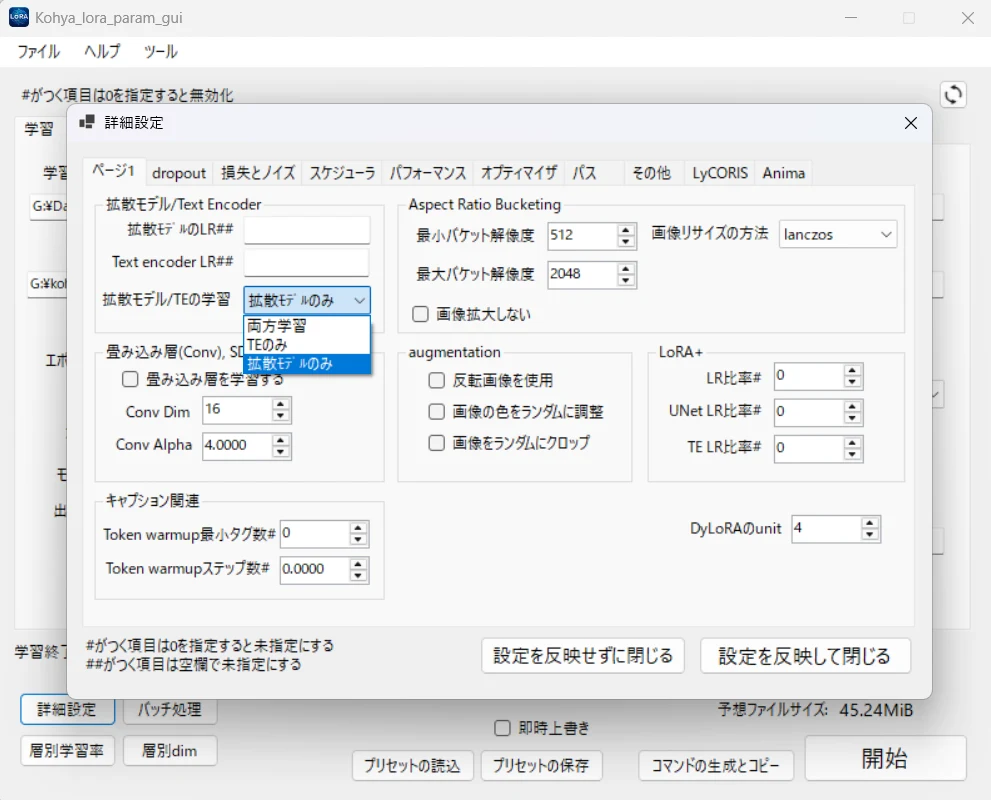
▲どれにすべき?
これまでSDXL向けのLoRA記事でも触れてきましたが、SDXL時代は本体である「U-Netのみ」よりも「Text Encoder(TE)込み」で学習することで、キャラなどの再現度が上がるノウハウがありました。一方で、ヘタに学習させるとせっかく整っていた「言葉の地図」が崩れて副作用が出てしまうこともありました。では、AnimaでもTextEncoderであるQwen3-0.6Bの学習を行うべきなのでしょうか?
本記事では、いったん「学習しない」で統一して検証することにします。Anima向けLoRAの学習はSDXLより重いのですが、Text Encoderを学習しない場合、プロンプト処理結果を事前計算する「TextEncoderキャッシュ機能」(後述)によって学習負荷を大きく下げられるというのがまず第一。あれこれ試したところ、数十〜数百枚規模の一般的なキャラ・画風LoRAなら、DiT側だけでも十分な効果が得られることも分かってきたので、まずはDiTのみの学習方法で検証します。
同じように、「四つの部品」のうちQwen3とDiTの間にいる翻訳者である「LLM Adapter」についても、この記事では学習率0とします。こちらも学習自体は可能ですが、プロンプト全体に予想しない悪影響を及ぼすリスクがとても大きく、Anima公式も学習は非推奨としています。
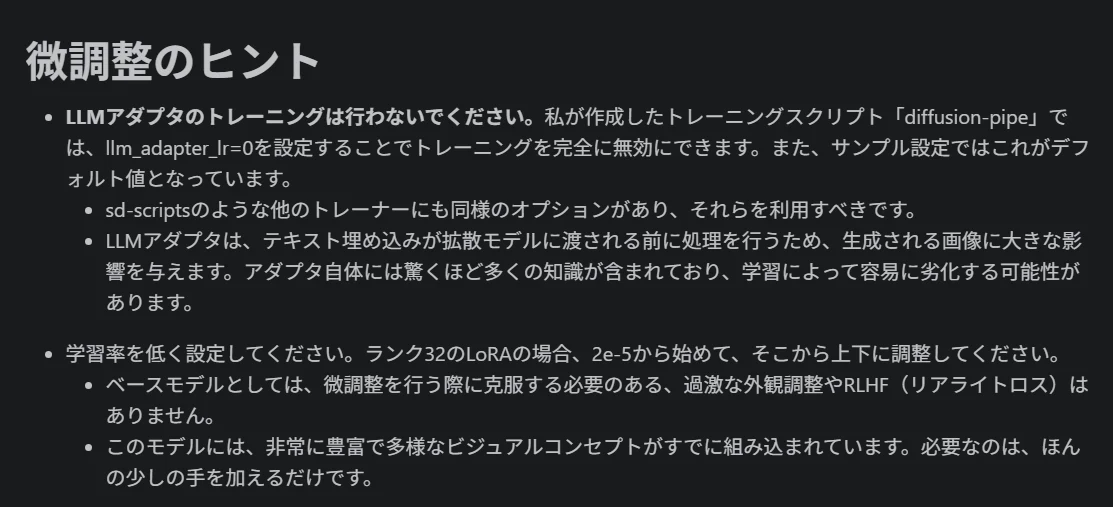
(https://civitai.com/models/2458426/anima よりスクリーンショット引用)
というわけで、あれこれ難しい話から入ってしまいましたが、まずは「Qwen3とLLM Adapterは学習率0にし、DiTだけを学習するのが基本」「DiT内部のブロックに3つずつある層に、どれくらいの学習率で覚えさせるかで効果を調整する」と理解しておけばよいかと思います。

キャラLoRAの学習検証
基礎理論は十分なので、ここからは実践編。まずはAnima向けキャラLoRAをどう学習すべきか考えてみましょう。毎度おなじみ鬼怒川さんのデータセットでキャラLoRAを試作します。
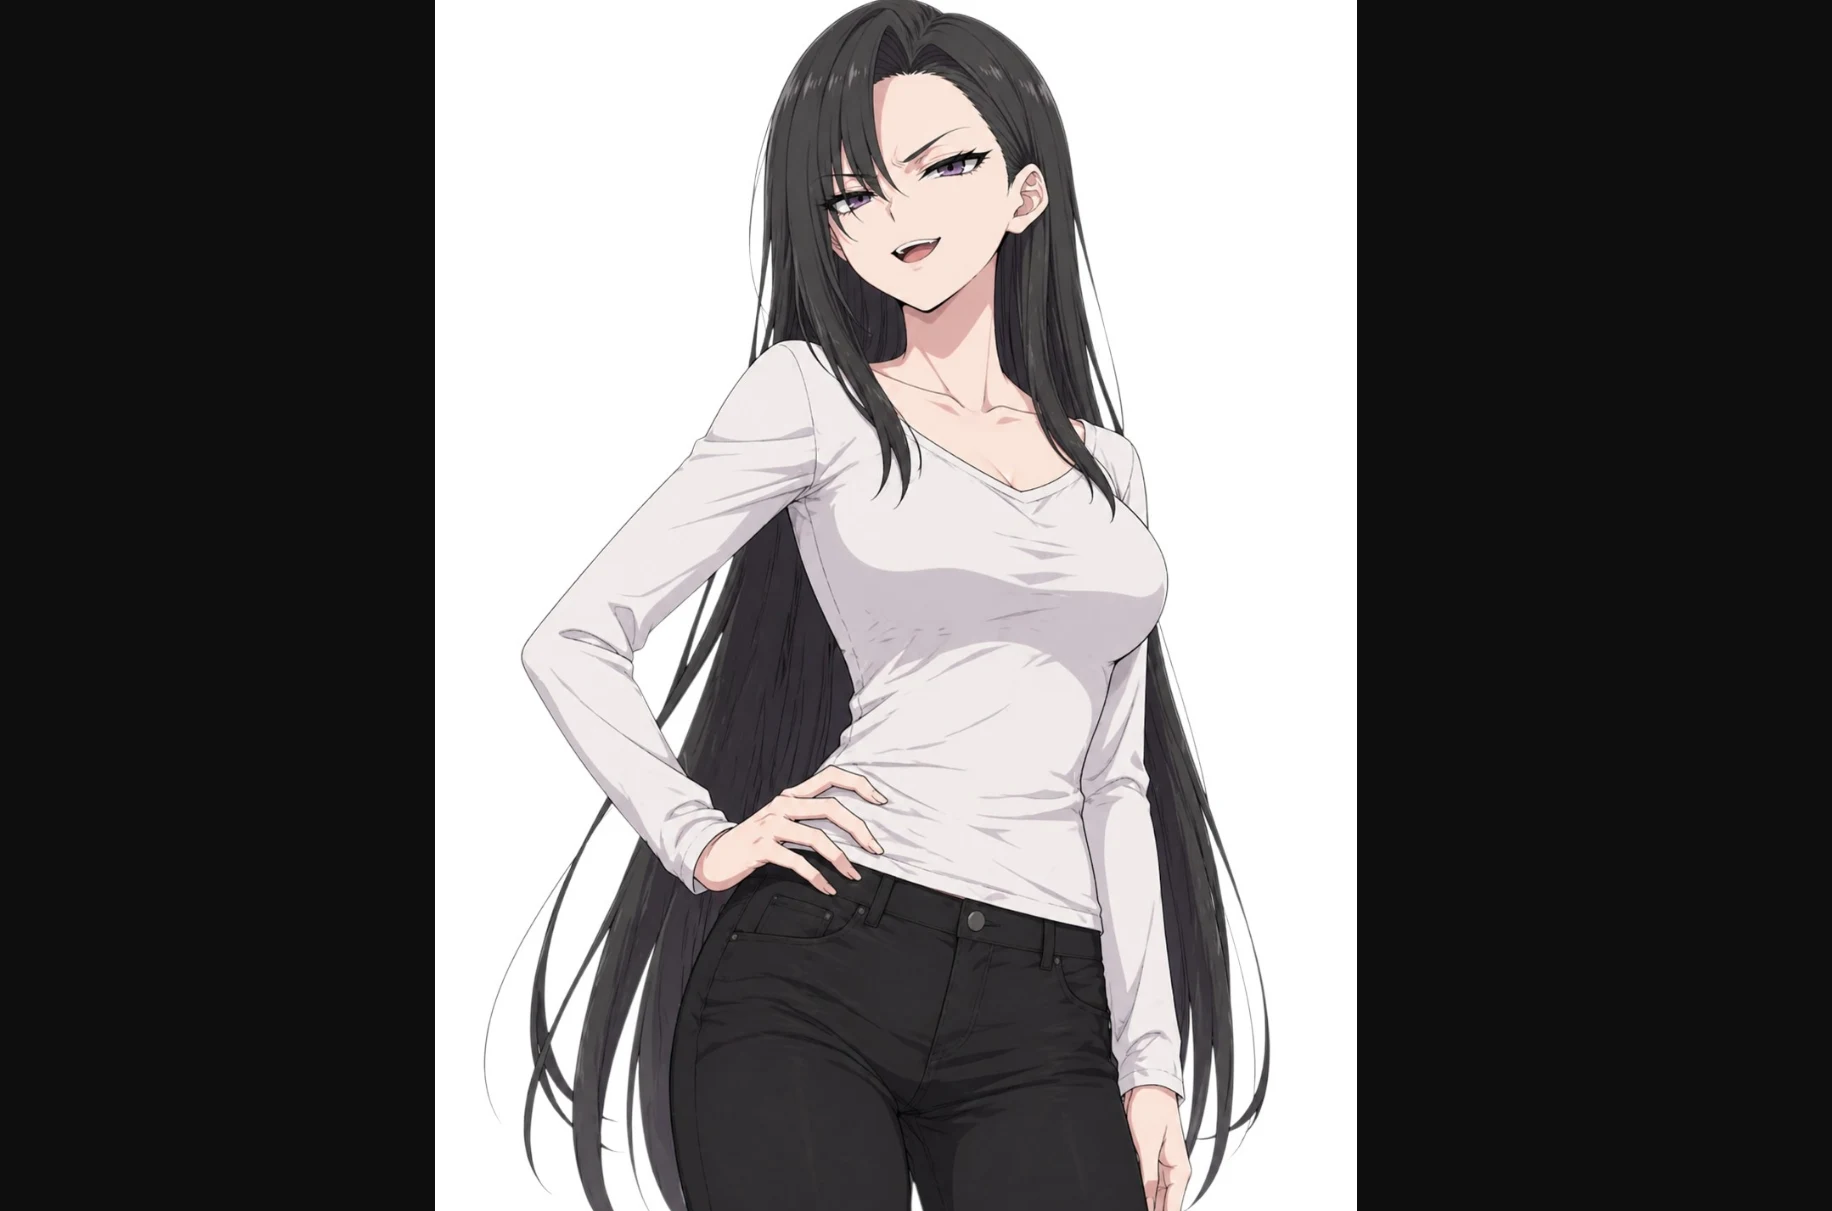
データセットの作り方やタグ付けの方法はSDXLと変わりません。タグの区切りに「black_hair」のようにアンダーバーを使わず、「black hair」などと半角スペースを使うことにだけ注意すればOKです。
1枚絵しかない状況なら、ChatGPTなどに「このキャラクターを8方向から描いた画像を生成してください。白背景。3:4。n=8」「このキャラクターの日常を描いたバリエーションを10枚生成してください。シチュエーションに応じたポーズや表情にすること。3:4。n=10」「このキャラの表情バリエーションを10枚生成してください。白背景。3:4。n=10」などと指示してバリエーションを作るとよいでしょう。
(※Kohya LoRA Param GUIを使ったローカルLoRA学習が初めてで、導入方法やデータセットの作り方から覚えたい方はこちらの記事を先にお読みください)
<キャラLoRA学習設定の基本的考え方(仮説)>
キャラLoRAの本質は「トリガータグを入れたらそのキャラが正確に出る」ことですから、例えば「anna kinugawa」という言葉と「目つきの悪い黒髪ロングヘア白ロンT人妻」という容姿の対応付けがうまくでき、データセットにない行動(例:両手にバナナを持って初音ミクとダンスする)を指示してもきれいに再現できれば学習成功ということになります。
そして、Animaにおいてその対応付けを担うのはクロスアテンションでしたよね。ですから、キャラLoRAではクロスアテンションを0にせず、控えめな学習率で生かすとよい効果が出そう…というのが最初の仮説です。
これを踏まえて、今回の実験で最初に試すキャラLoRA向け学習設定はこちら。

ベースモデル:anima_baseV10.safetensors
いろいろやりましたが、Animaで一番素直な結果になるのはAnima-Base v1.0をベースに学習させ、できたLoRAもそのままAnima-Base v1.0に適用するやり方。Copitaで学習した画風LoRAをWAI ANIMAなど別のマージモデルに適用しても、モデルのマスピ画風と混じってきれいに出てこないことが多かったです。(もちろん、お気に入りのマージモデルをほどよく調整して新しい画風を作りたいならそれでOKですが)
network_dim / alpha:16 / 8
小さいほど過学習しにくく、大きいほど多くの要素を覚えられる。複雑な衣装などを細部まで正確に再現したい場合は32/16。
learning_rate:6e-5 (※つまり0.00006)
全体の基準値となる学習率。層別学習率に空欄がある場合はこれが採用されるが、今回の設定ではSelf-Attentionに4e-5、Cross-Attentionに2.5e-5、MLPに6e-5と直接指定しているため、ここの記述は実質飾り。Anima公式は「dim32の場合、LRは2e-5(0.00002)くらい弱めから調整して」としているので、これは3倍強気の設定。
self_attn_lr:4e-5 (※つまり0.00004)
セルフアテンションの学習率。0.00004。キャラの容姿に対して、構図への影響を控えめにしたい狙い。
cross_attn_lr:2.5e-5 (※つまり0.000025)
クロスアテンションの学習率。0.000025。今回の重要ポイント。キャラクターのタグと容姿の紐付けをここで覚えてほしい。
mlp_lr:6e-5 (※つまり0.00006)
つまり0.00006。髪の質感や顔立ち、服のディテールはここが覚える重要な層なので、全体LRと同じ強さ。(というより、今回3層とも指定しているので全体LRの指定は飾り)
llm_adapter_lr:0
鬼怒川さんをAnimaの辞典に加えるだけで、辞典全体はそのままにしたい。
batch:2
同時に2枚学習する設定。ここはSDXLと同じで、各々のVRAM容量に応じて増減しよう。
scheduler:cosine_with_restarts (4サイクル) + warmup
LoRAの「焼き加減」を時間とともに変化させるスケジューラ。過学習を避けながら効率的に学習が進められる。何を選ぶかは流派や「オプティマイザ」との相性があり、決まった答えはない。
解像度 1024 (bucket 512–2048)
ここはSDXLと同じでOK。Animaも基本は1024px前後で学習します。

<タグ付けについて>
SDXLでは、目の色や髪型のようにキャラの不変の特徴をタグ付けから外すと、トリガーワードに集約する動きをしました。ただ、あの挙動はTextEncoder込み学習に大きく助けられていたもの。TEの学習なしでも、同じ「タグ集約」現象が起きるのかどうか、実験で見ていきます。
なお、Animaはタグ中のアンダーバーの使用が基本的に御法度です。LoRAのキャプション(タグ付け)も生成時も、半角スペースを使うことを忘れないようにしましょう。特にトリガーワードは重要なので、「anna_kinugawa」ではなく「anna kinugawa」となっているか確認しておきます。
<ステップ数の計算>
データセットによりますが、総ステップ数はbatch1換算で1,500〜2,000程度が目安のようです。1エポックごとにLoRAを保存して、生成実験で出来具合を比較するのが確実です。ポーズや構図まで教師画像そっくりになったり、細部が溶けたり、プロンプト指示を聞いてくれなくなったら過学習のサイン。dimを下げるか、学習率を下げるか、エポックを減らすか、データセットのバリエーションを増やす必要があります。
<データセット>
キャラLoRAの場合、20~50枚くらいが目安かと思いますが、枚数・バリエーションが豊富なほど余計な学習を抑制できます。今回はこちらの画像57枚のデータセットで学習してみます。
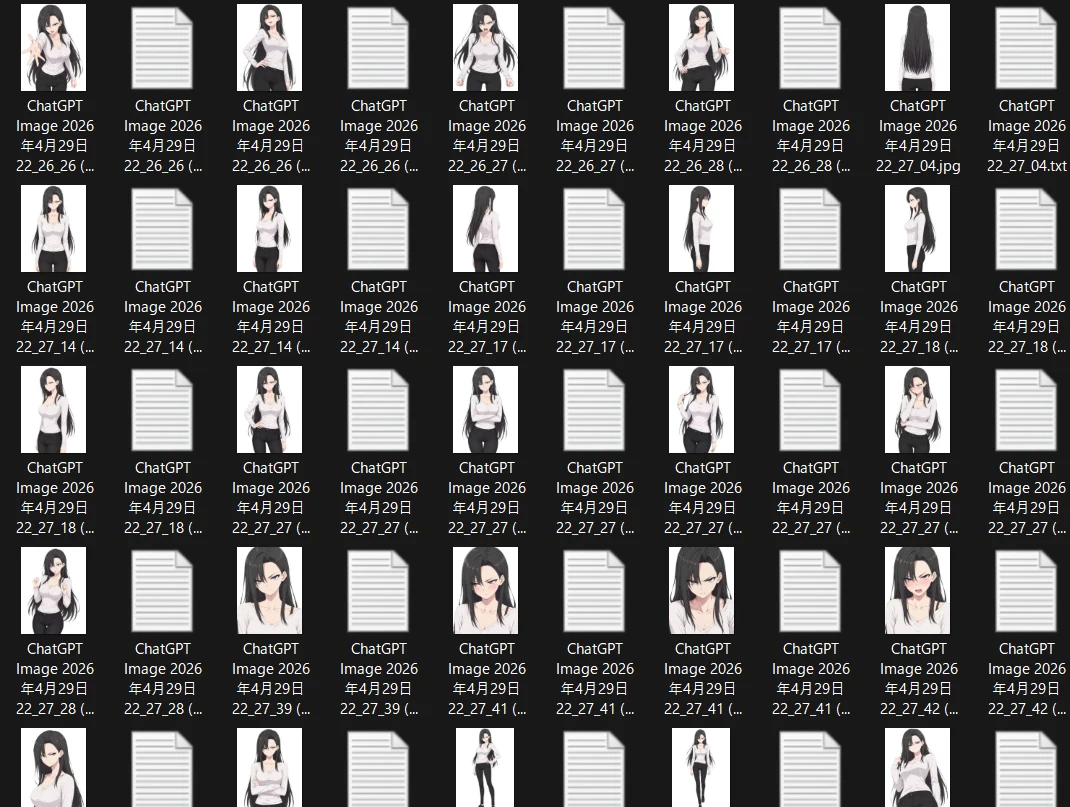
オリジナルキャラ鬼怒川さんの1枚の立ち絵を基に、主にChatGPTでバリエーション生成したものです。ほとんど白背景で、全身、太ももから上、上半身、後ろ姿がバランスよく混じっており、このほかにNSFW画像やイベントCG風の背景ありショットも少量混ぜています。
タガーは好みですが、今回は「WD EVA02 Large Tagger v3」を使用しました。例えばこちらの画像なら、トリガーワード「anna kinugawa」を頭にしてこのようにタグ付けしています。
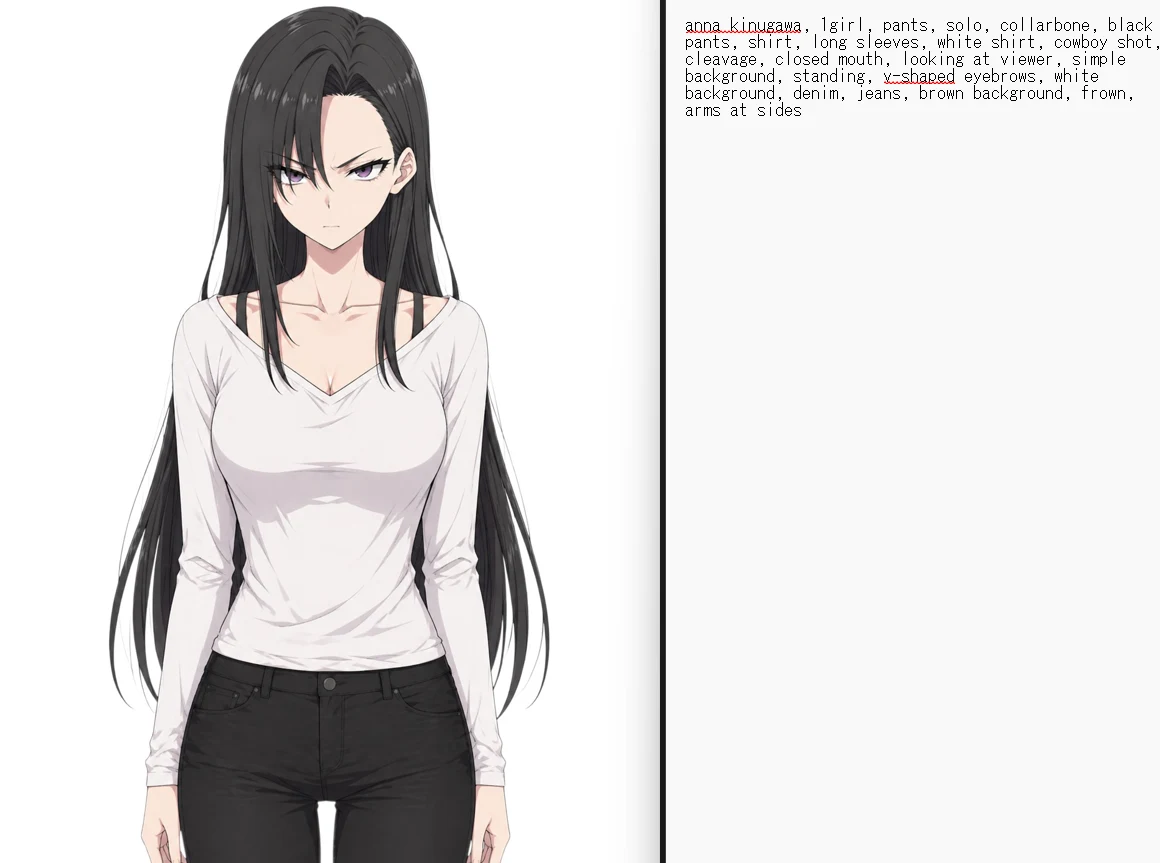
black hairやpurple eyes、large breastsといった固有の要素は削除しましたので、「anna kinugawa」に集約される(常に黒髪ロング紫目で描かれる)ことを期待したいところですが、今回はTextEncoderの学習をしないので、どうなるかがポイントです。

Kohya LoRA Param GUIを起動
このデータセットを使って、Kohya LoRA Param GUIで学習していきます。設定を手入力すると大変なので、公式リポジトリの一番下にある「サンプルプリセット」をリンク先からダウンロードして使うのが手っ取り早いです。
解凍すると出てくる中の「Anima」フォルダ内にAnima用のプリセットが保存されています。READMEを読みつつ、今回はキャラクターを学習させたいので「人物」を選びましょう。(そのまま使ってもきちんとしたLoRAができます)
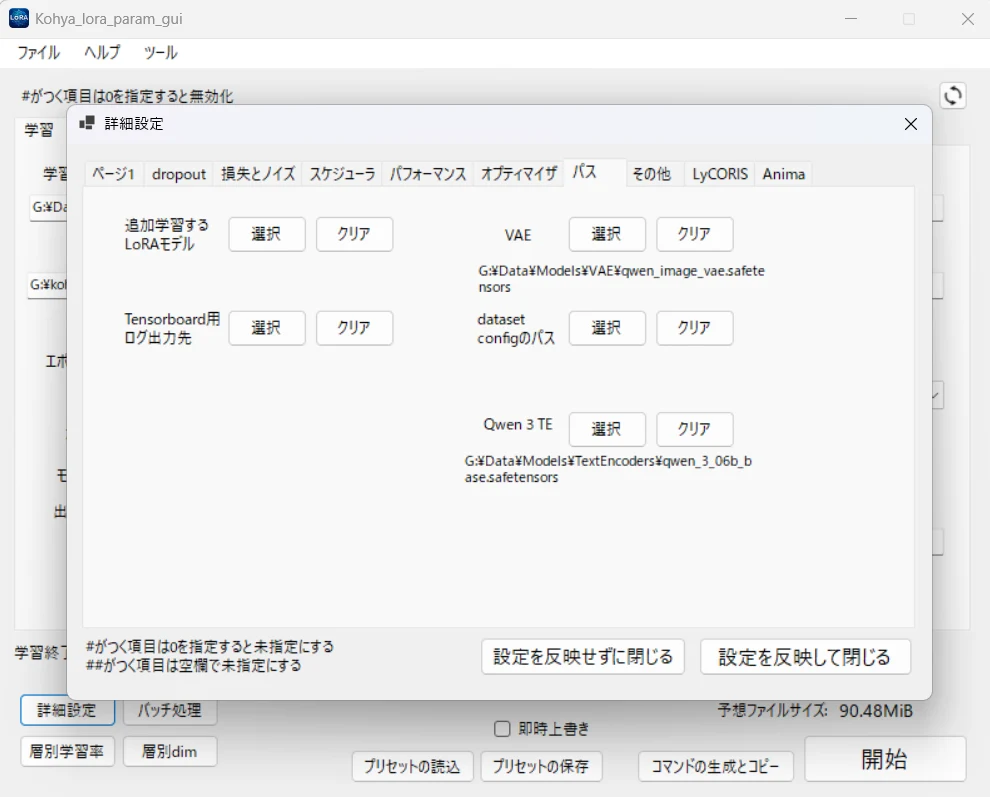
次に、「詳細設定▶パス」で、普段Animaで生成するときに使っているqwen image vaeとqwen 3 06bのパスを指定する必要があります。Models/TextEncodersとModels/VAEにあるはずです。
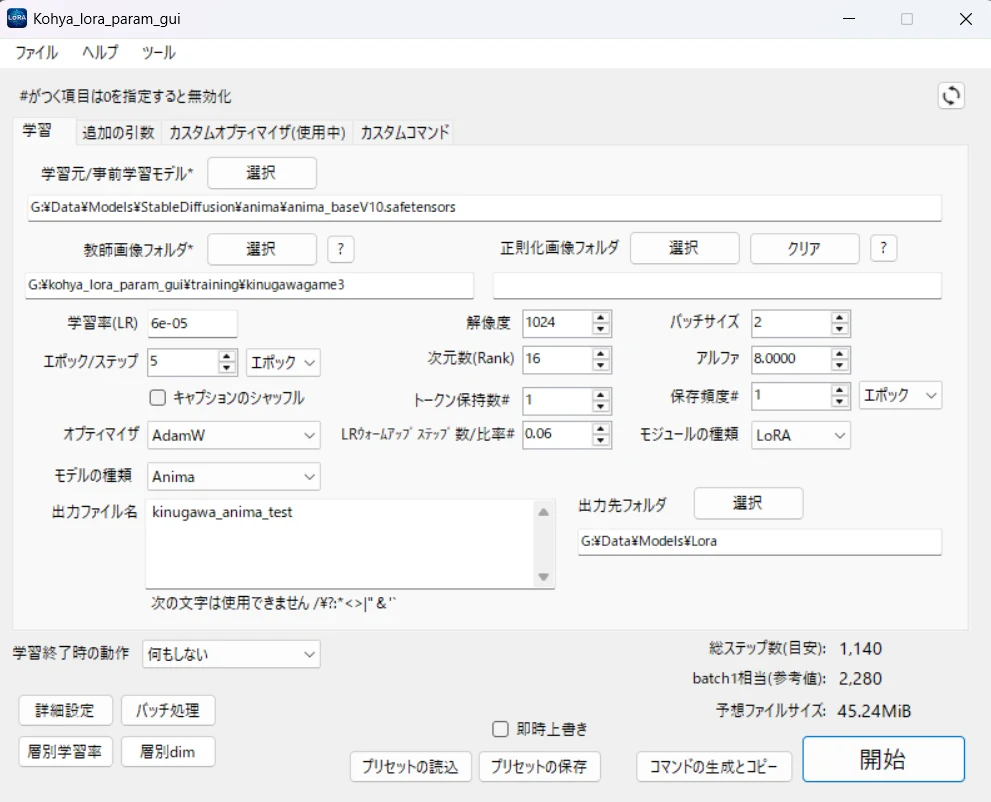
今回はDiTの三つの層の働きを理解するのが目的なので、サンプルプリセットをそのまま使うのではなく、書き換えて学習します。設定はこちらのzipを解凍すると出てくるxmloraをGUIで読みこむと私と全く同じものがコピペできますので、ご確認ください。(ただし、完成版ではなく最初の実験に使った暫定版です)
配布ファイルはPixivFANBOX限定ですダウンロードはFANBOXの記事からどうぞ。PixivFANBOXの記事を開く
学習率は6e-5(つまり0.00006)。学習の全体サンプル数は57枚×repeat8×5epoch=2280サンプルです。バッチ2(2枚同時学習)にしたので、実際には半分の1140ステップで終了します。オプティマイザは今回最も基本的なAdamWを選択しましたが、ここは流派がいろいろあろうかと思います。(Kohya LoRA Param GUIの既定プリセットだとCAMEをチョイスしていますね)
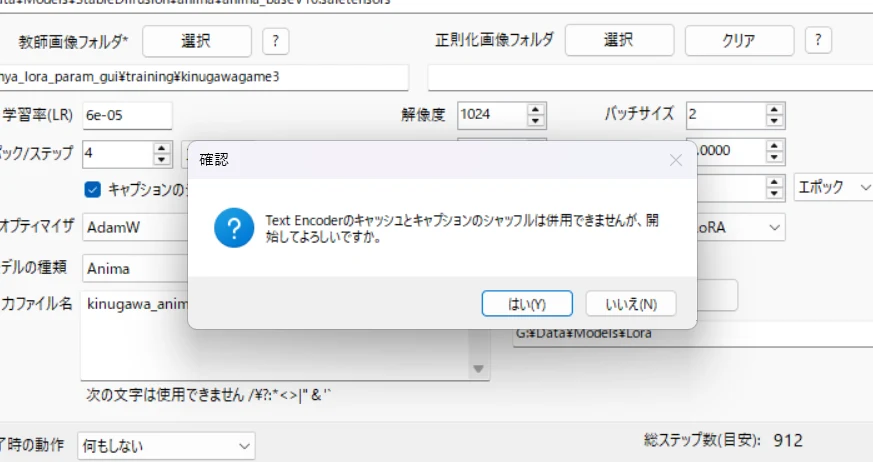
詳しくは後述しますが、このセットでは「TextEncoderのキャッシュ」機能をオンにして高速化・省メモリ化を図っています。その代わり、プロンプトの処理結果を事前に計算して固定してしまうため、SDXLで定番だった「キャプションのシャッフル」が使えません。チェックしていると学習開始時にこのような告知が出るので、外しておきます。(シャッフルは「前のほうのタグばかり重視される」のを防ぐための機能ですが、トリガーワードを先頭に置く運用なら実害は小さいので、キャッシュによる高速・省メモリ化を優先します)
<詳細設定タブ>
左下のボタンから「詳細設定」を開くと、このように拡散モデルのみ(AnimaではDiTのみ)の学習設定になっていることが確認できます。
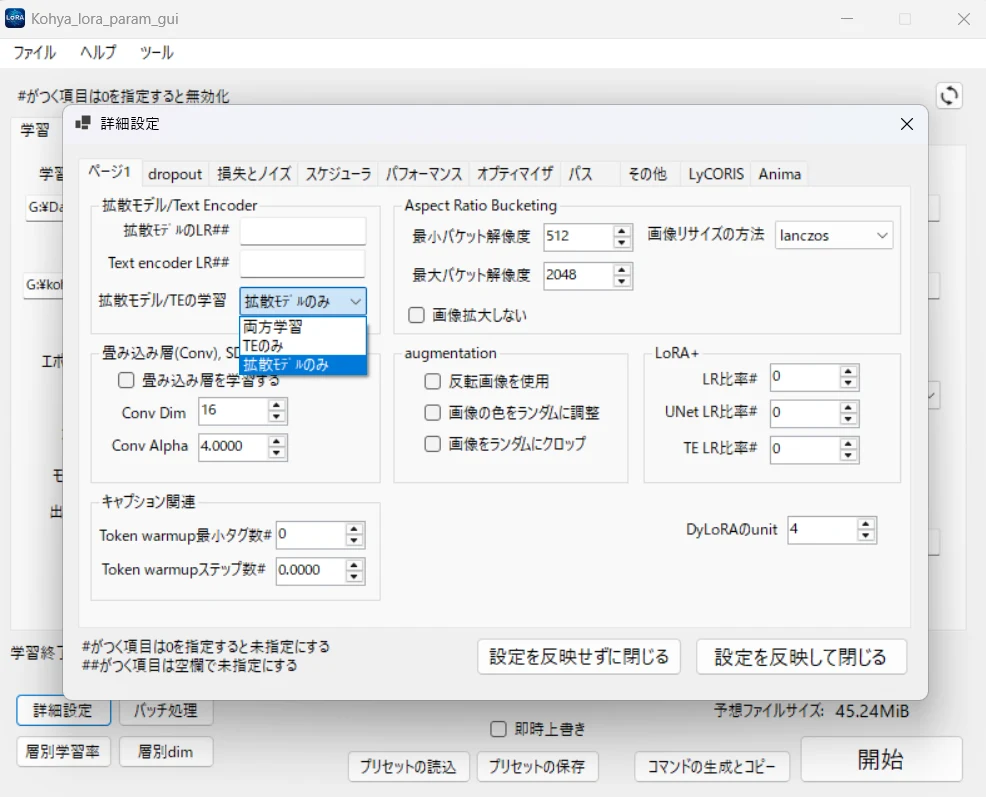
「詳細設定▶Anima」から、このようにさきほどの層別LR(学習率)が設定できます。4e-05などの表記は分かりづらいですが、4e-5は「4×10のマイナス5乗」、つまり0.00004のこと。一番下の数字とゼロの数を書いていると覚えておけば問題ありません(4e-05と4e-5は同じ意味です)。今回はこのように、クロスアテンションを低めの0.000025で学習する設定になっています。空欄だと全体の学習率がそのまま適用され、0と書くと一切学習されませんので、LLM AdapterのLRは0にしてあります。
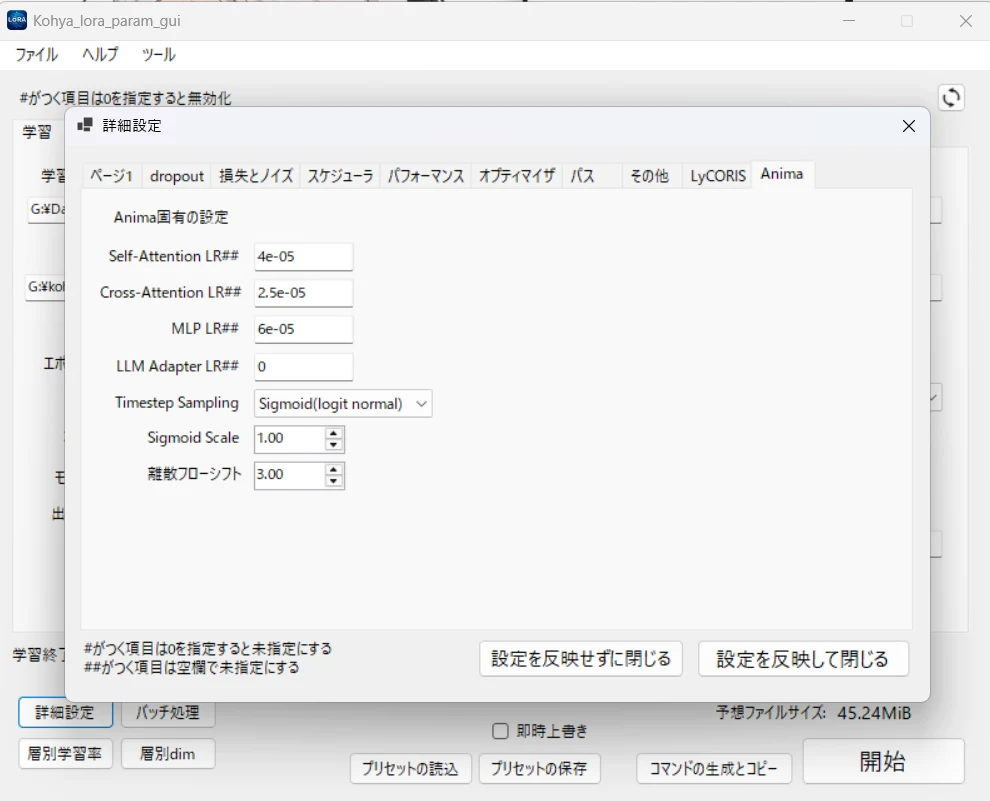
すごくざっくりした理屈では、MLPを0にすると画風が、セルフアテンションを0にすると構図が、クロスアテンションを0にするとプロンプト応答性が、それぞれ変化しにくくなるはずです。(実際はそう簡単ではなかったのですが…)
<パフォーマンスタブ>
「詳細設定▶パフォーマンス」タブで主にグラフィックボード環境に合った学習設定を行います。Animaはかなり学習負担が重めなので、先ほど触れたテキストエンコーダのキャッシュ機能などを活用して学習時間を短縮する必要があります。今回はこちらの設定で学習を進めていきます(RTX4080-VRAM16GB環境)。
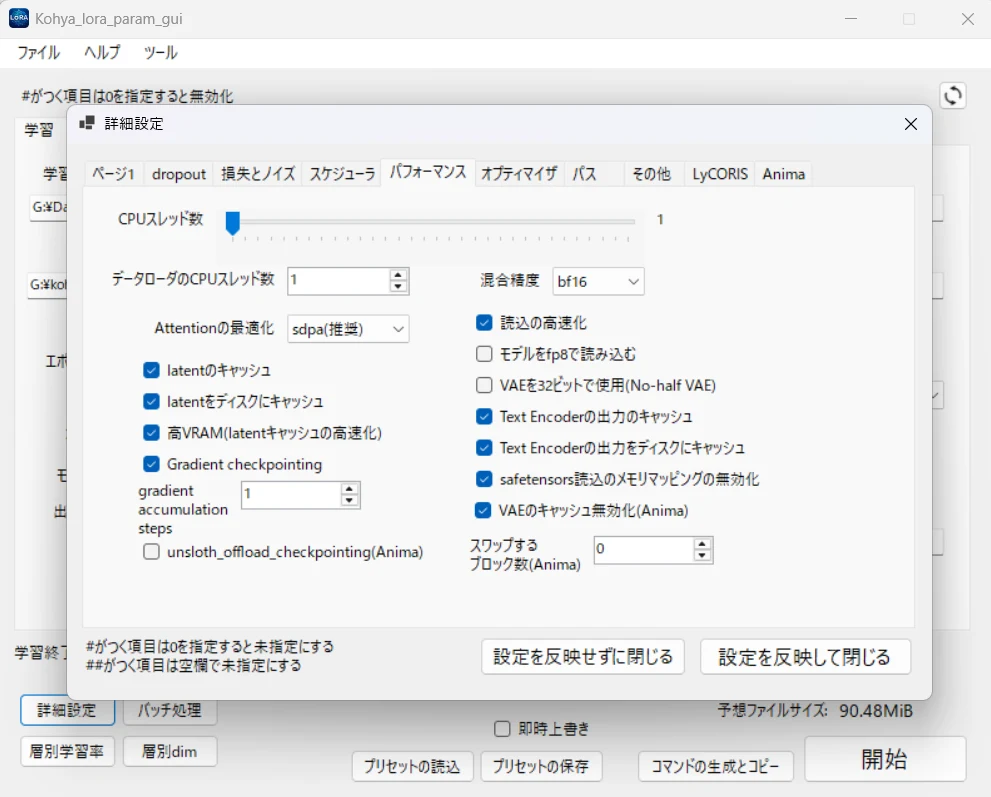
Anima向け学習はVRAM8GB以上のグラフィックボードで対応していますが、低VRAM環境の場合相当な学習時間が掛かりますし、適切に設定しないとOut of memoryエラーが出ます。10GB未満のVRAMの場合、「スワップするブロック数」を8以上、8GBなら13にしてCPUを活用するのが推奨されています。
速度を犠牲にVRAM消費を抑える「モデルをfp8で読み込む」はanima非対応。「GradientCheckpointing」を外すと大幅に高速化しますが、VRAM負担が爆増します。学習中の計算精度やVRAM負担などに関わる「混合精度」は、animaではbf16推奨。
<TextEncoderキャッシュとは?>
これをオンにすると、最初に一度だけQwen3でデータセット内の全キャプションを読み込み、画像ごとに「~_anima_te.npz」というキャッシュファイルを作ります。よって、初回だけ「キャッシュ作成時間」が掛かりますが、これを先にやっておくとその後の学習ループ中にいちいちQwen3を動かさずに済むので、学習が速く・軽くなるという便利機能です。("latentのキャッシュ"では同じように学習中のVAEによる処理を省くことができ、省VRAM&学習時間短縮につながります)
2回目以降は、すでに「~_anima_te.npz」が画像ごとにあるので、Qwen3での下準備(キャッシュ作成時間)すらスキップされ、さらにスムーズになります。枚数が大量にあるほど速度アップにつながります。
ただし、一点だけ注意!タグをあとから書き直して再学習する場合、データセット内に古いanima_te.npzが残っていると、そちらが優先されて書き換え前のタグ設定で学習されてしまいます。タグを書き直したら、必ず古いanima_te.npzを削除する癖をつけておきましょう。フォルダ内で「te.npz」で検索して削除すればOKです。(画像の枚数と同じ数だけ検索ヒットしたかちゃんと確かめましょう)
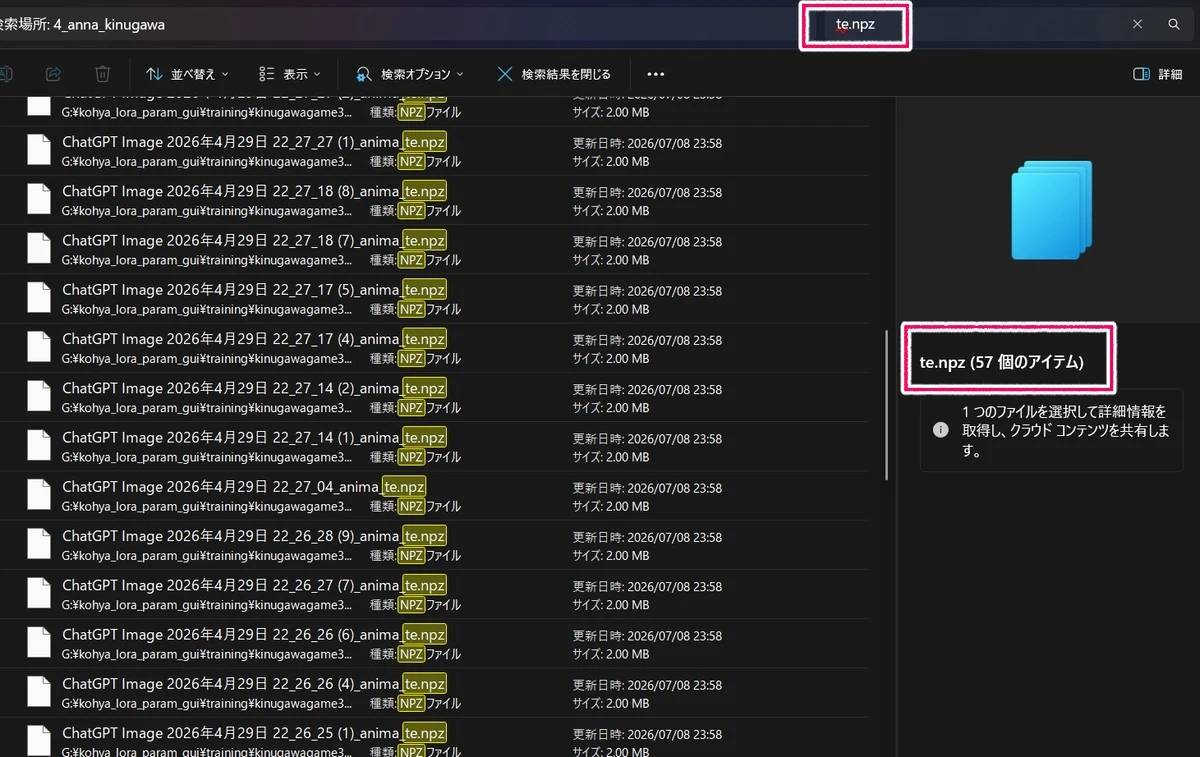
▲「te.npz」で検索したところ。画像57枚のデータセットなら57個あるはずなので、ちゃんとファイル数が一致しているか確認した上で、Ctrl+Aで全選択して削除しよう

学習開始
以上の設定で学習開始すると、RTX4080環境では5エポックが約1時間で終了しました。あれこれキャッシュして高速化を図っていますが、2枚同時学習で実質1140ステップなのに1時間というのはSDXLに比べてかなり重めに感じますね。
<生成テスト>
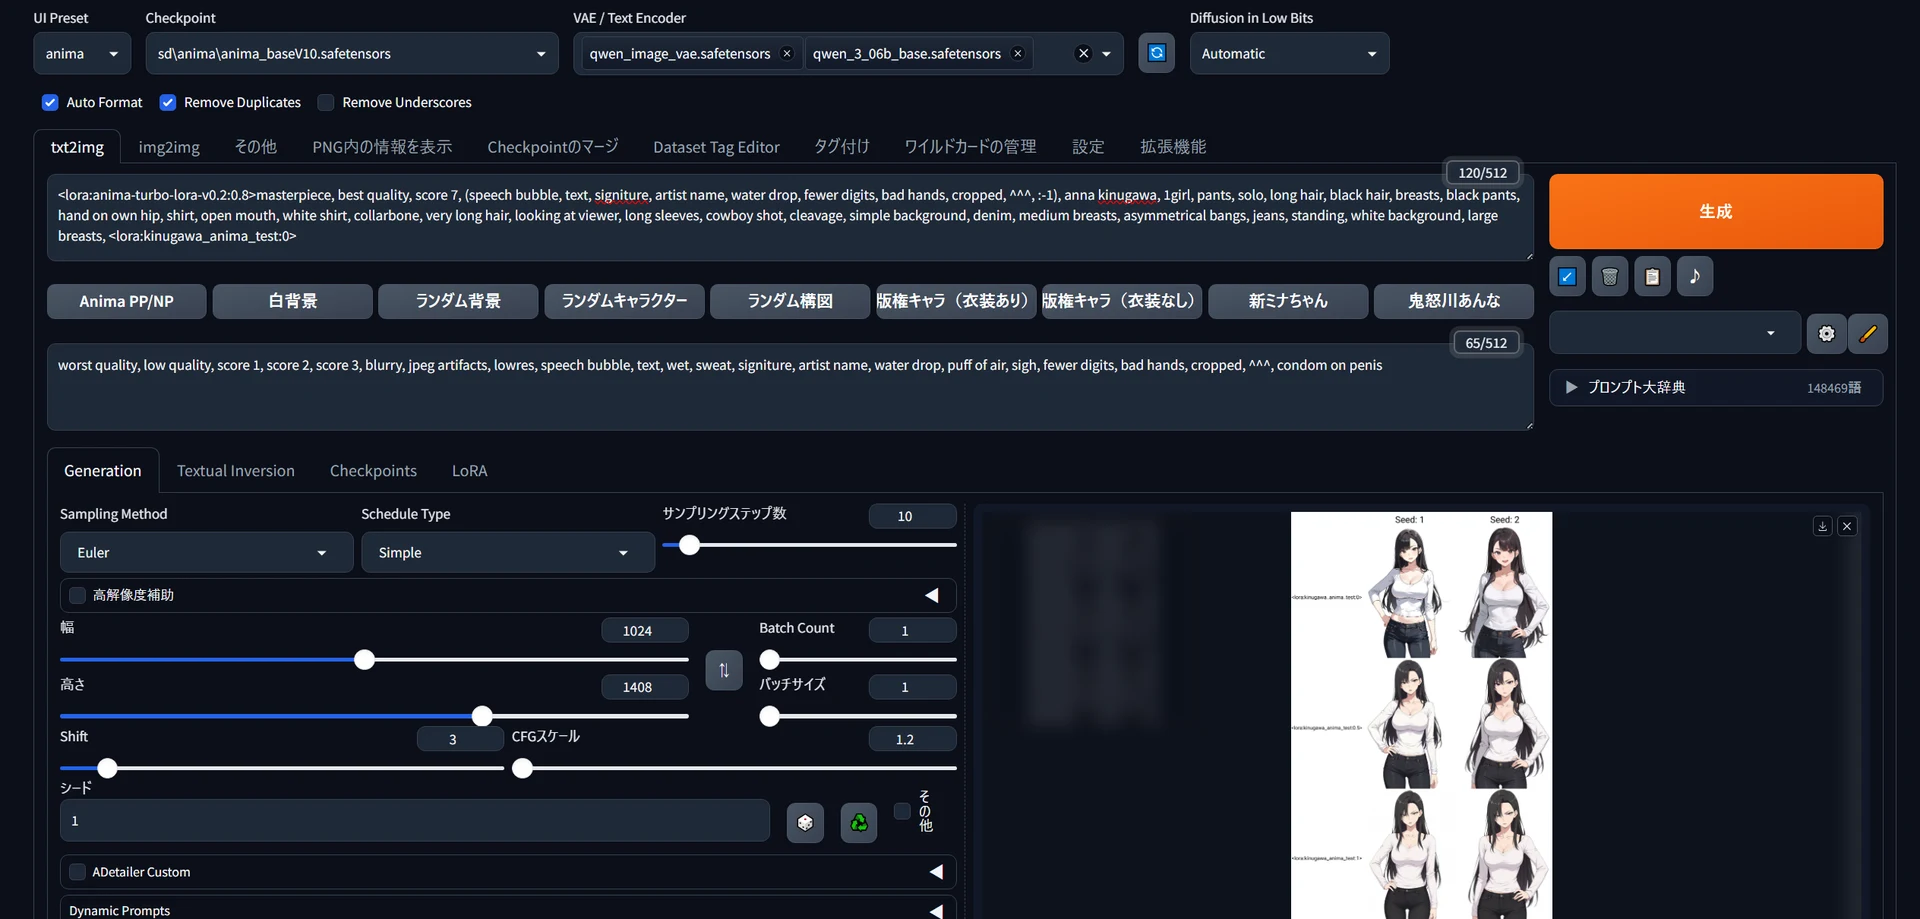
できたLoRAでXYZ plot比較してみましょう。適用するモデルはAnimaのベースモデルそのまま。プロンプトは以下のようにしました。前半が高速化LoRAとクォリティタグ、NegPiPで、トリガーワードの「anna kinugawa」以降で容姿を指示しています。基本的にはデータセットで使用したタグをそのまま使いました。
PP:<lora:anima-turbo-lora-v0.2:0.8>masterpiece, best quality, score 7, (speech bubble, text, signature, artist name, water drop, fewer digits, bad hands, cropped, ^^^, :-1), anna kinugawa, 1girl, pants, solo, long hair, black hair, breasts, black pants, hand on own hip, shirt, open mouth, white shirt, collarbone, very long hair, looking at viewer, long sleeves, cowboy shot, cleavage, simple background, denim, medium breasts, asymmetrical bangs, jeans, standing, white background, large breasts, <lora:kinugawa_anima_test:0>
こちらが結果。一番上がLoRA未適用の状態で、下に行くほど効果が強まります。
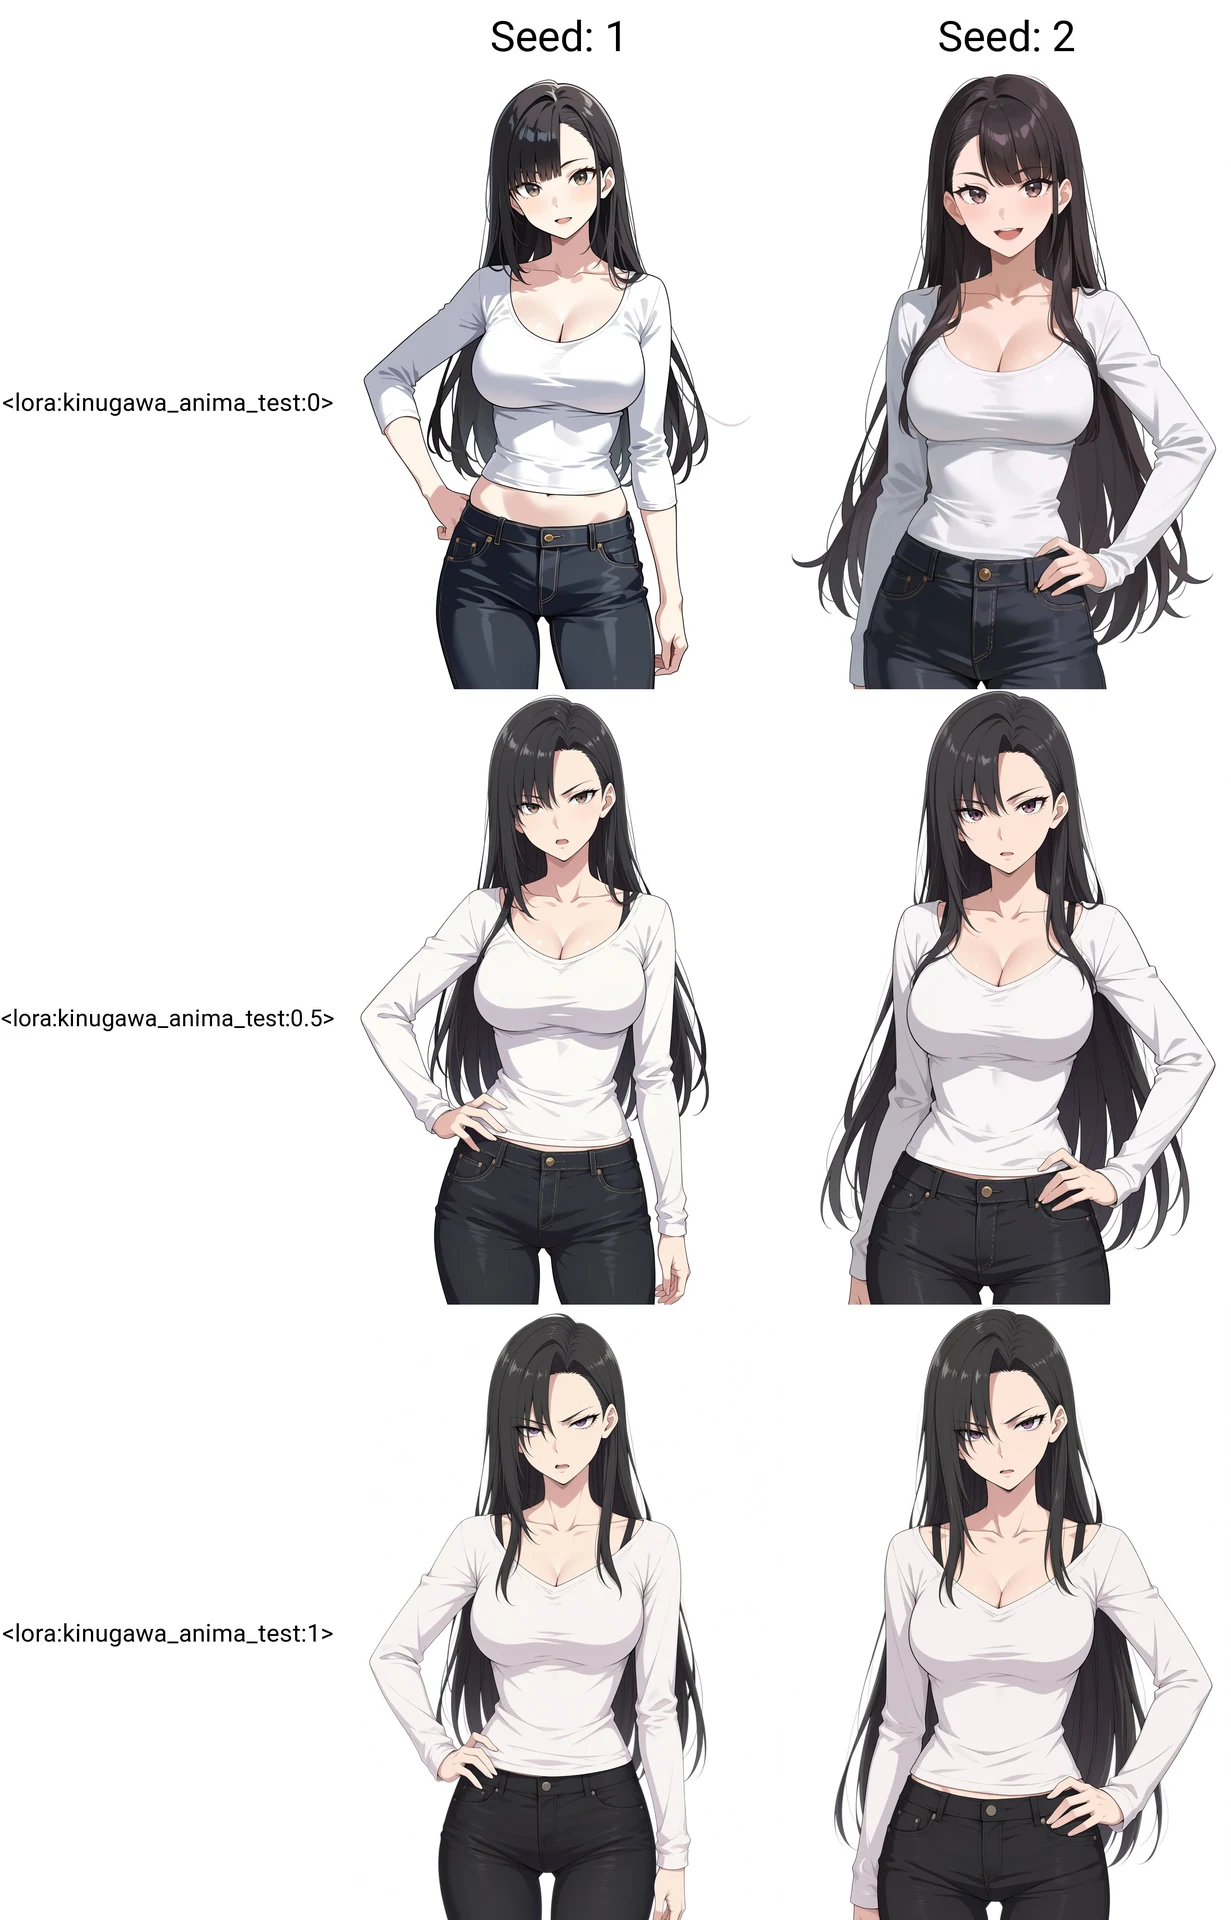
おおむねデータセットそのままのキャラクター容姿が覚えられましたね。せっかくですので、Anima系の別のモデルでも使ってみましょう。
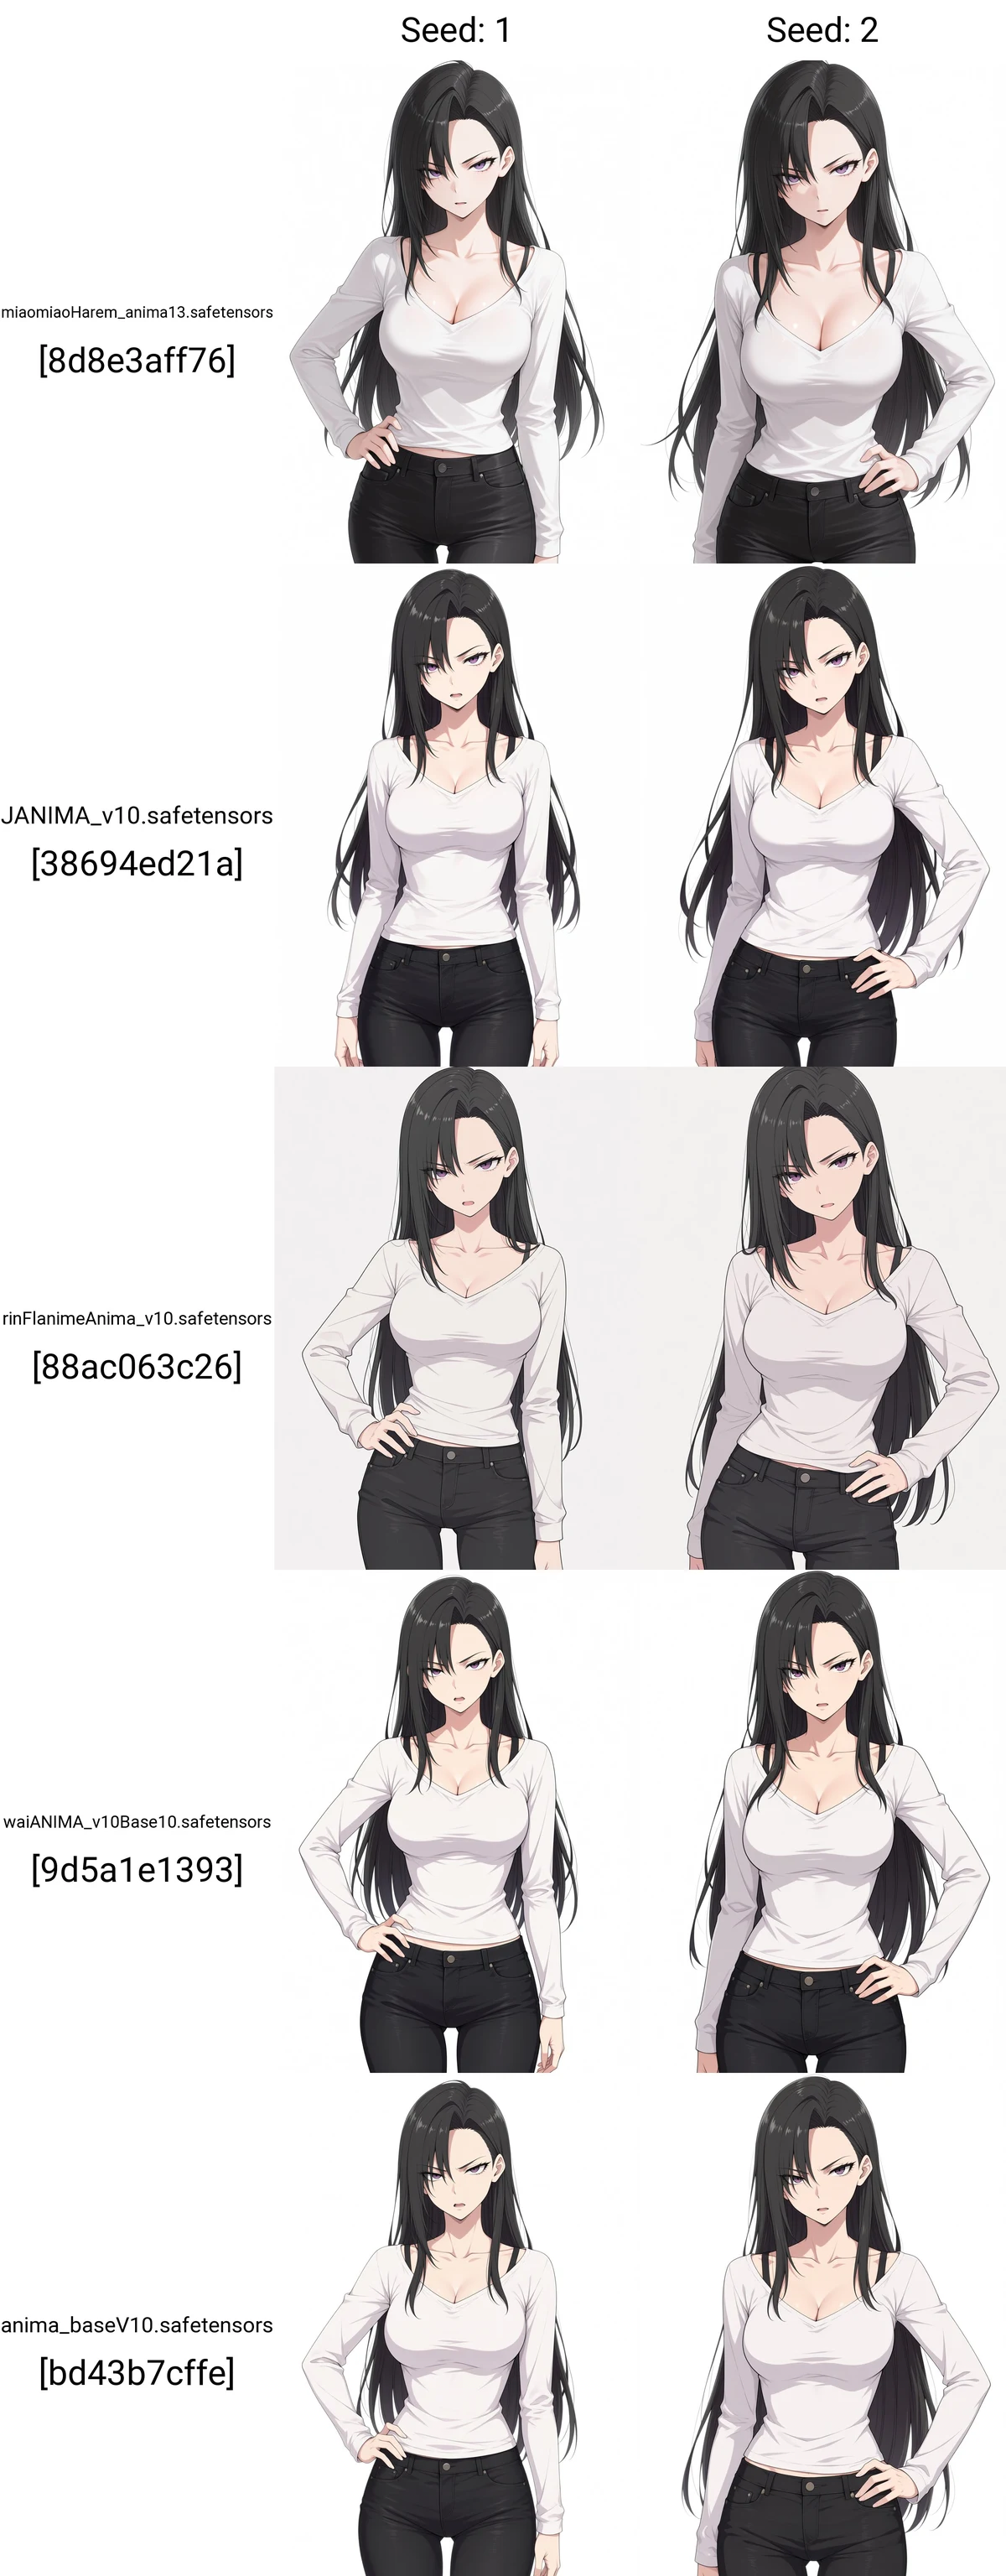
このように、だいたいのキャラデザは共通しつつ、それぞれのモデルの画風がにじむ結果となりました。鬼怒川さんは記号(ミナちゃんの赤眼鏡のようなトレードマーク)が少ないので、目つきまで似ないと本人には見えないのですが、どれも「だいたい同一人物」と言ってよい結果になったのではないでしょうか。
いつもの自然言語指示も問題なく効きます。
このLoRAはやや多めに2280step(batch1当たり)回した5エポック目のものなので、1~5エポックごとにどのように学習が進んでいったかもチェックしましょう。一番上が1エポック目で、一番下が完成品の5エポック目です。(適用モデルはAnima-Base v1.0、強度はいずれも1)
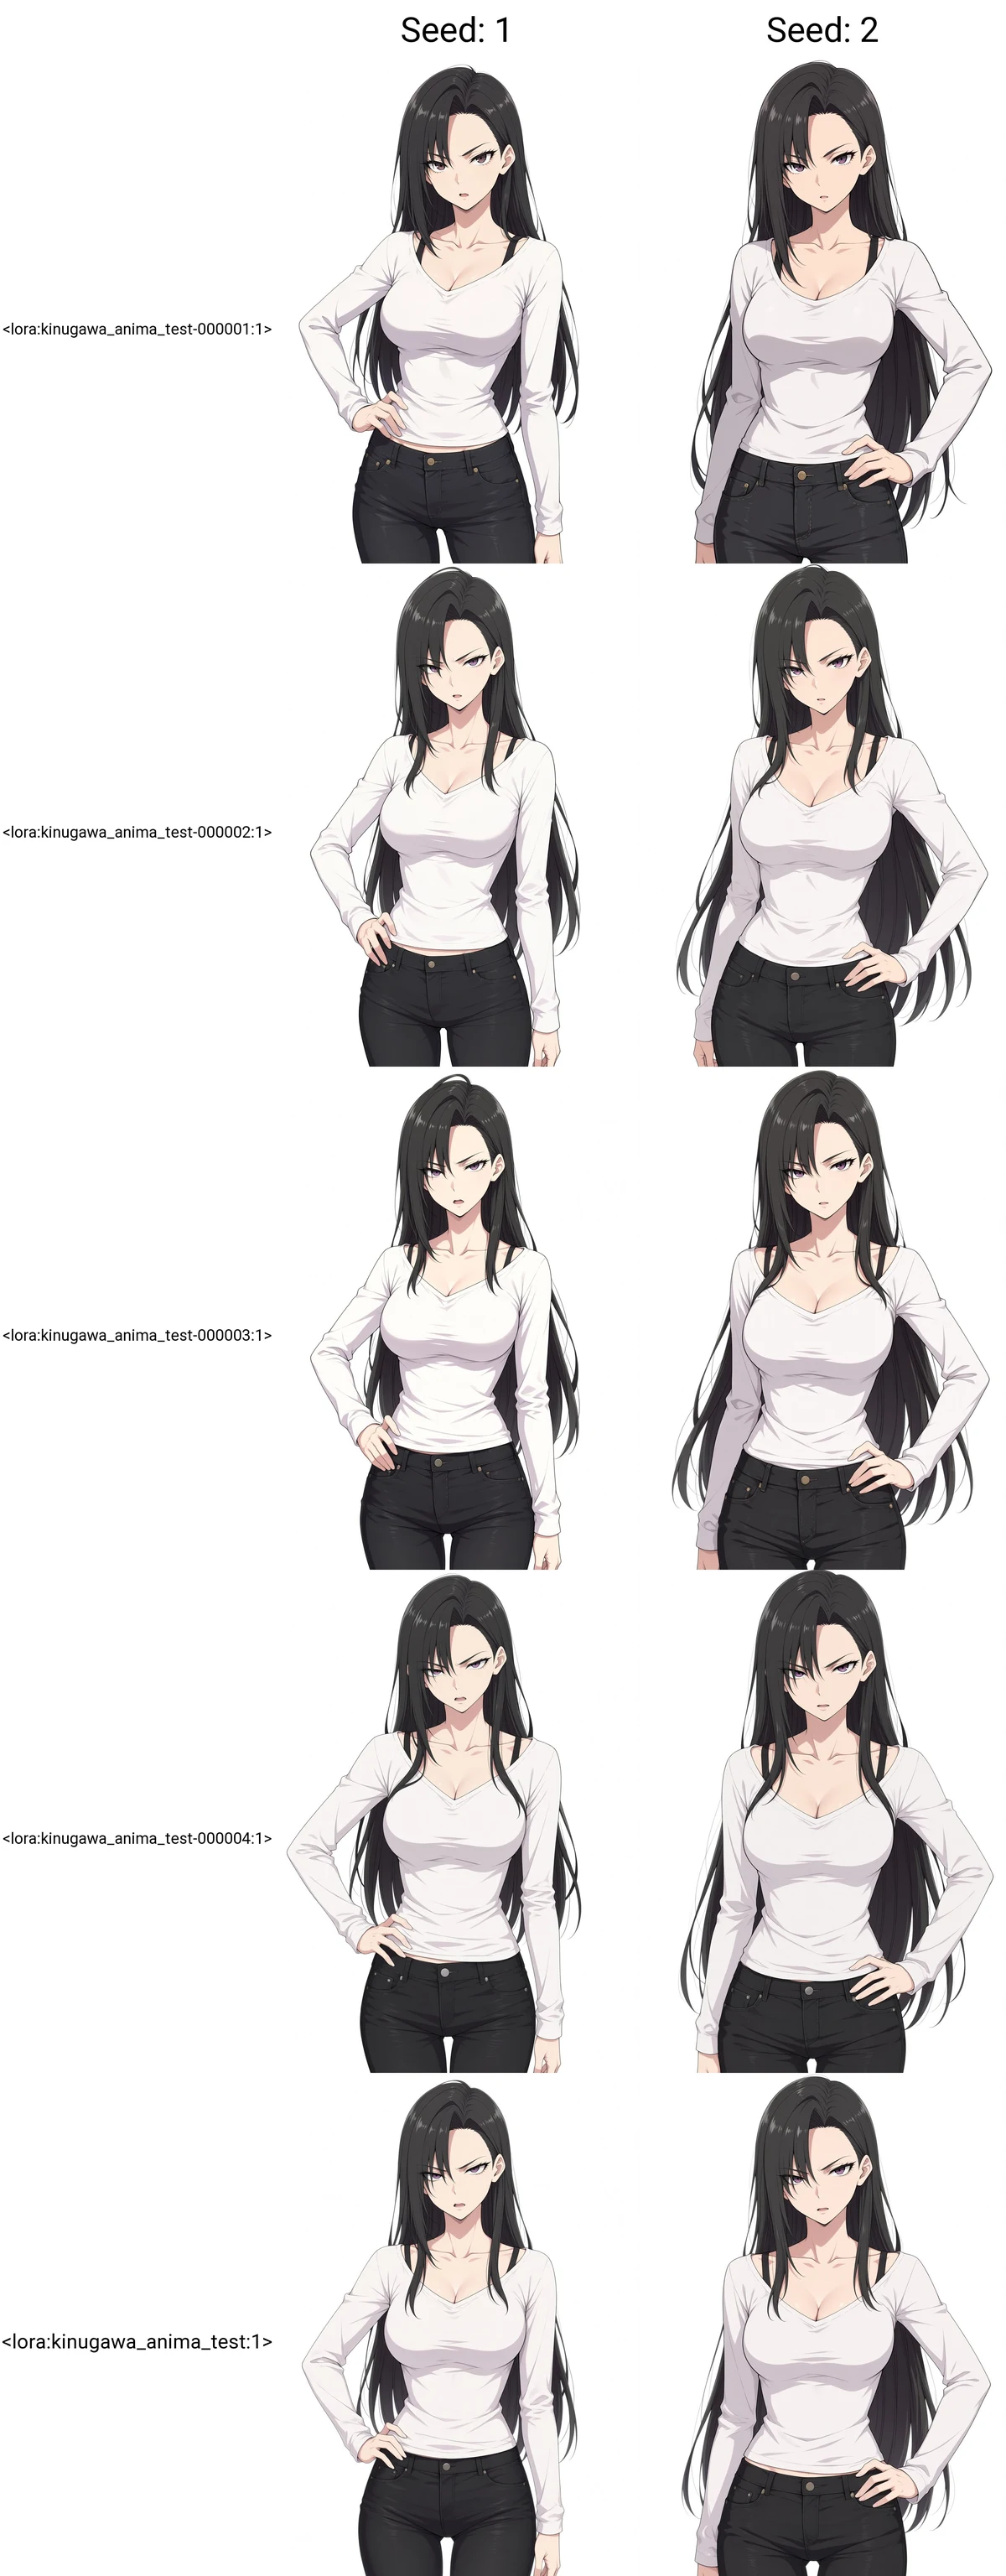
1epoch目からかなり特徴は捉えられていますが、まだちょっとニセモノ感がありますね。個人的には4epoch目から「本物の鬼怒川さんだ」という感じ。収束の速さはキャラデザの特徴がどれくらい詳細か、dim/alphaはどう設定したか、オプティマイザは何を選んだかでも変化しますが、この設定なら4epochでも十分だったように見えます。
<キャラの"色抜け"現象>
ただし、このLoRAで生成する際に指示から「black hair」や「white shirt」を抜くと、このように色が抜けてしまう現象が確認できました。このLoRAは「anna kinugawaはこういう見た目のキャラ」と顔立ちや服のデザインまでは先行して覚えているのですが、色の学習は後回しになっており、プロンプト指示せずに強制的に再現するには学習が足りなかったようです。
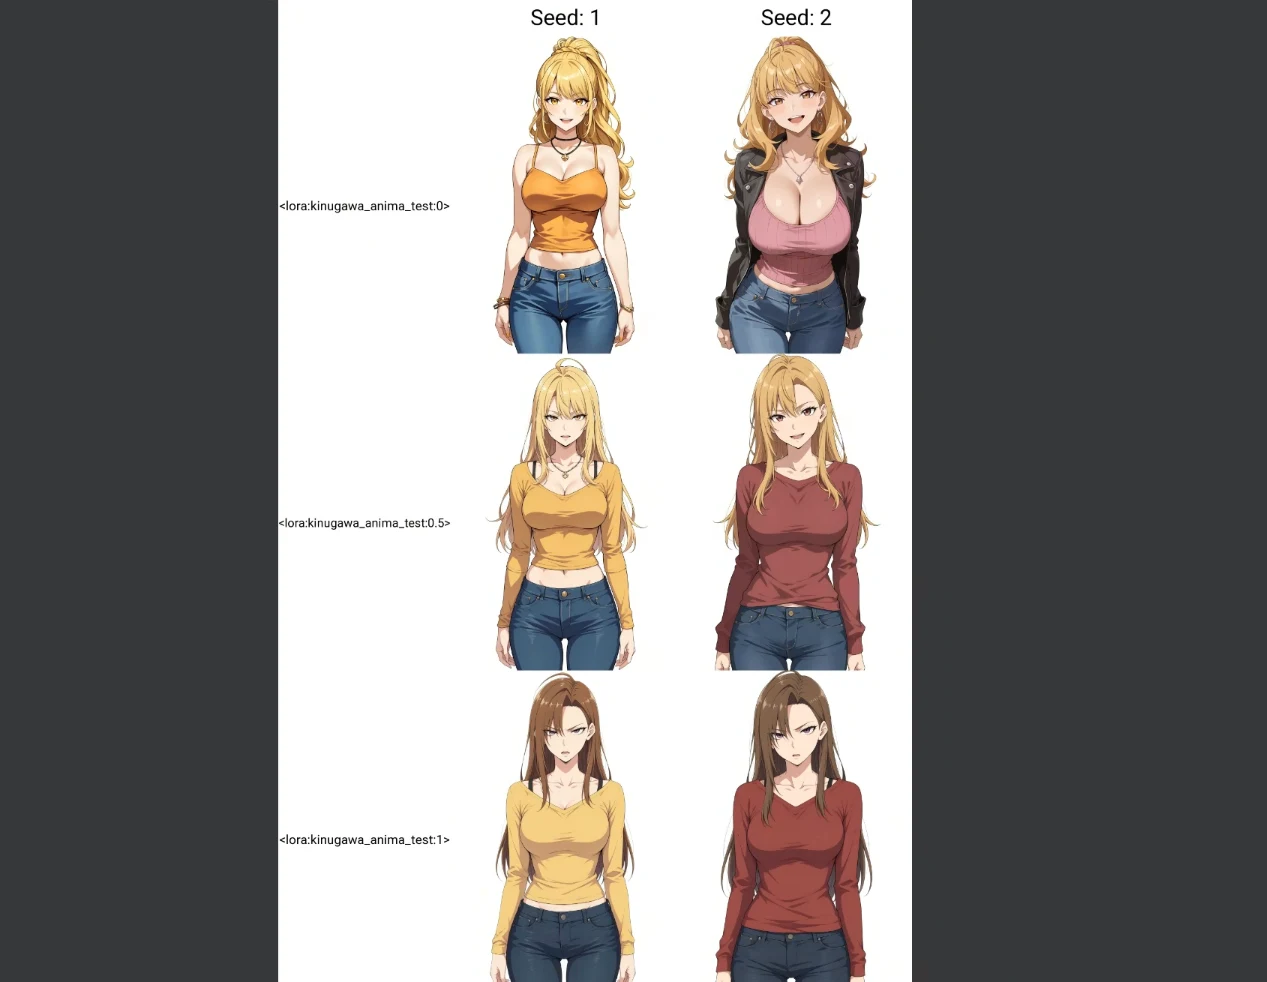
こうした「色抜け」は他のキャラ学習でもよく見られました。髪などの色をプロンプト指示すれば普通に使えるので別に構わないのですが、どうしてもキャラ名のタグだけですべてのカラーリングまで学習させたい場合は、学習率をより上げ、過学習を起こさないように慎重に学習を進めるか、TextEncoder込みの学習を試すかということになると思います。