
こんばんは、スタジオ真榊です。今回は、先日公開した差分LoRA学習アプリ「Copita」のv1.2開発中に徹底検証したスライダー系LoRAの実験記録をまとめてみようと思います。
今回作ったのはAnima向けのBold LoRA。単に線を太くしたり細くしたりするだけでなく、「絵の中身はできるだけ変えず、線の太さだけを変えるLoRA」の作り方を各種検証しました。こちらが完成したBold LoRA。(CivitaiでどなたでもDLできます)
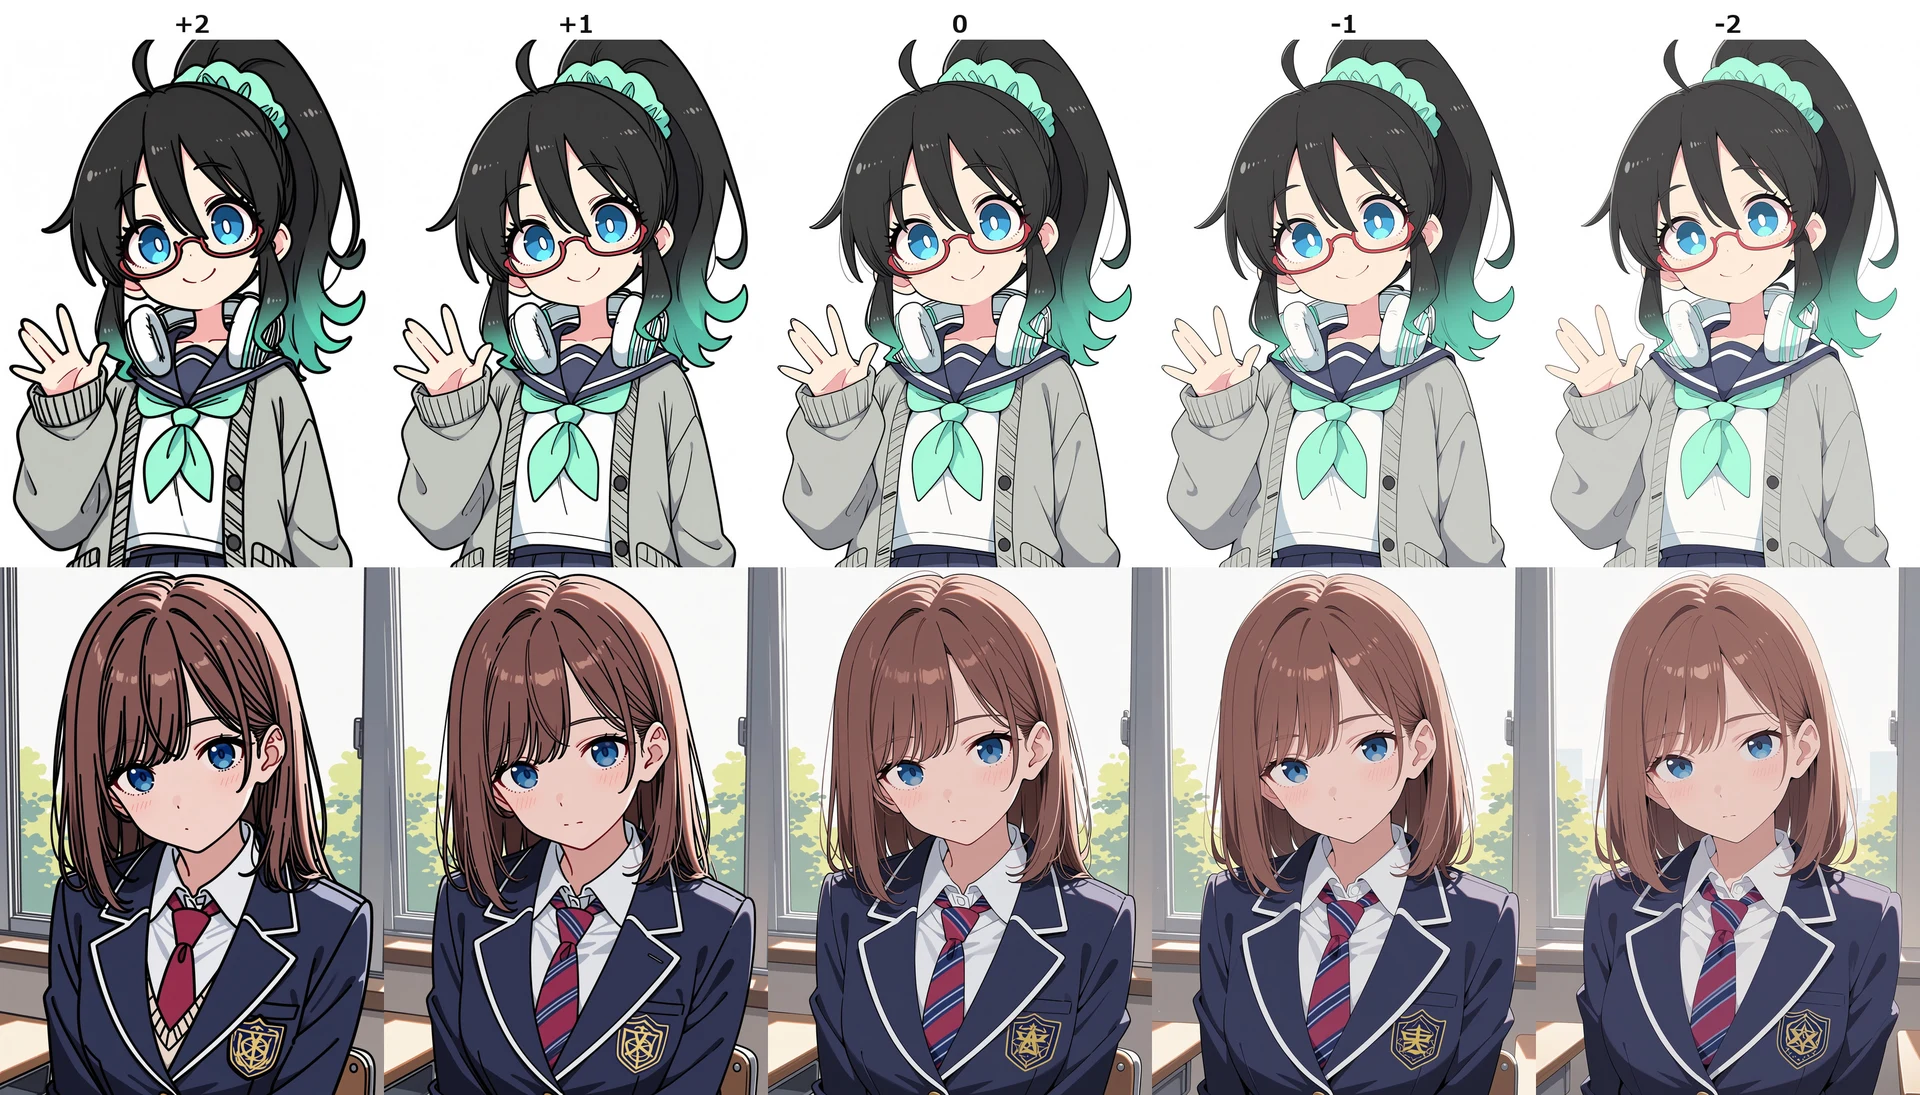
最も有効だったのは、学習対象をセルフアテンションに絞り、複数のLoRAから副作用の少ないものを選んでフュージョンする方法でした。絵の内容が1ミリも変わらない完璧なLoRAまでは作れませんが、それに向けて精度を高めていくやり方はおおむね理論通りになったかと思います。
「試したけどダメだった失敗例」もできるだけ多く記録しておきますので、描きこみ量を操作するFlat LoRAや体型を操作するLoRAなど、別の調整系LoRAを作る参考としてお使いください。
【ダウンロード】
はじめに
Copitaはご存じの通り、以下のようなフローでペア画像の「差分」を学習するアプリです。
①学習させたい画像(例えば、線が太い絵)をユーザーが1枚用意する
②内容が同じで、その要素だけが違う画像(例えば、線が細い絵)を画像生成などで作る
③それぞれから「その画像しか描けないLoRA(コピー機LoRA)」をCopitaが学習
④片方からもう片方を引き算すると、狙った効果のLoRAになる
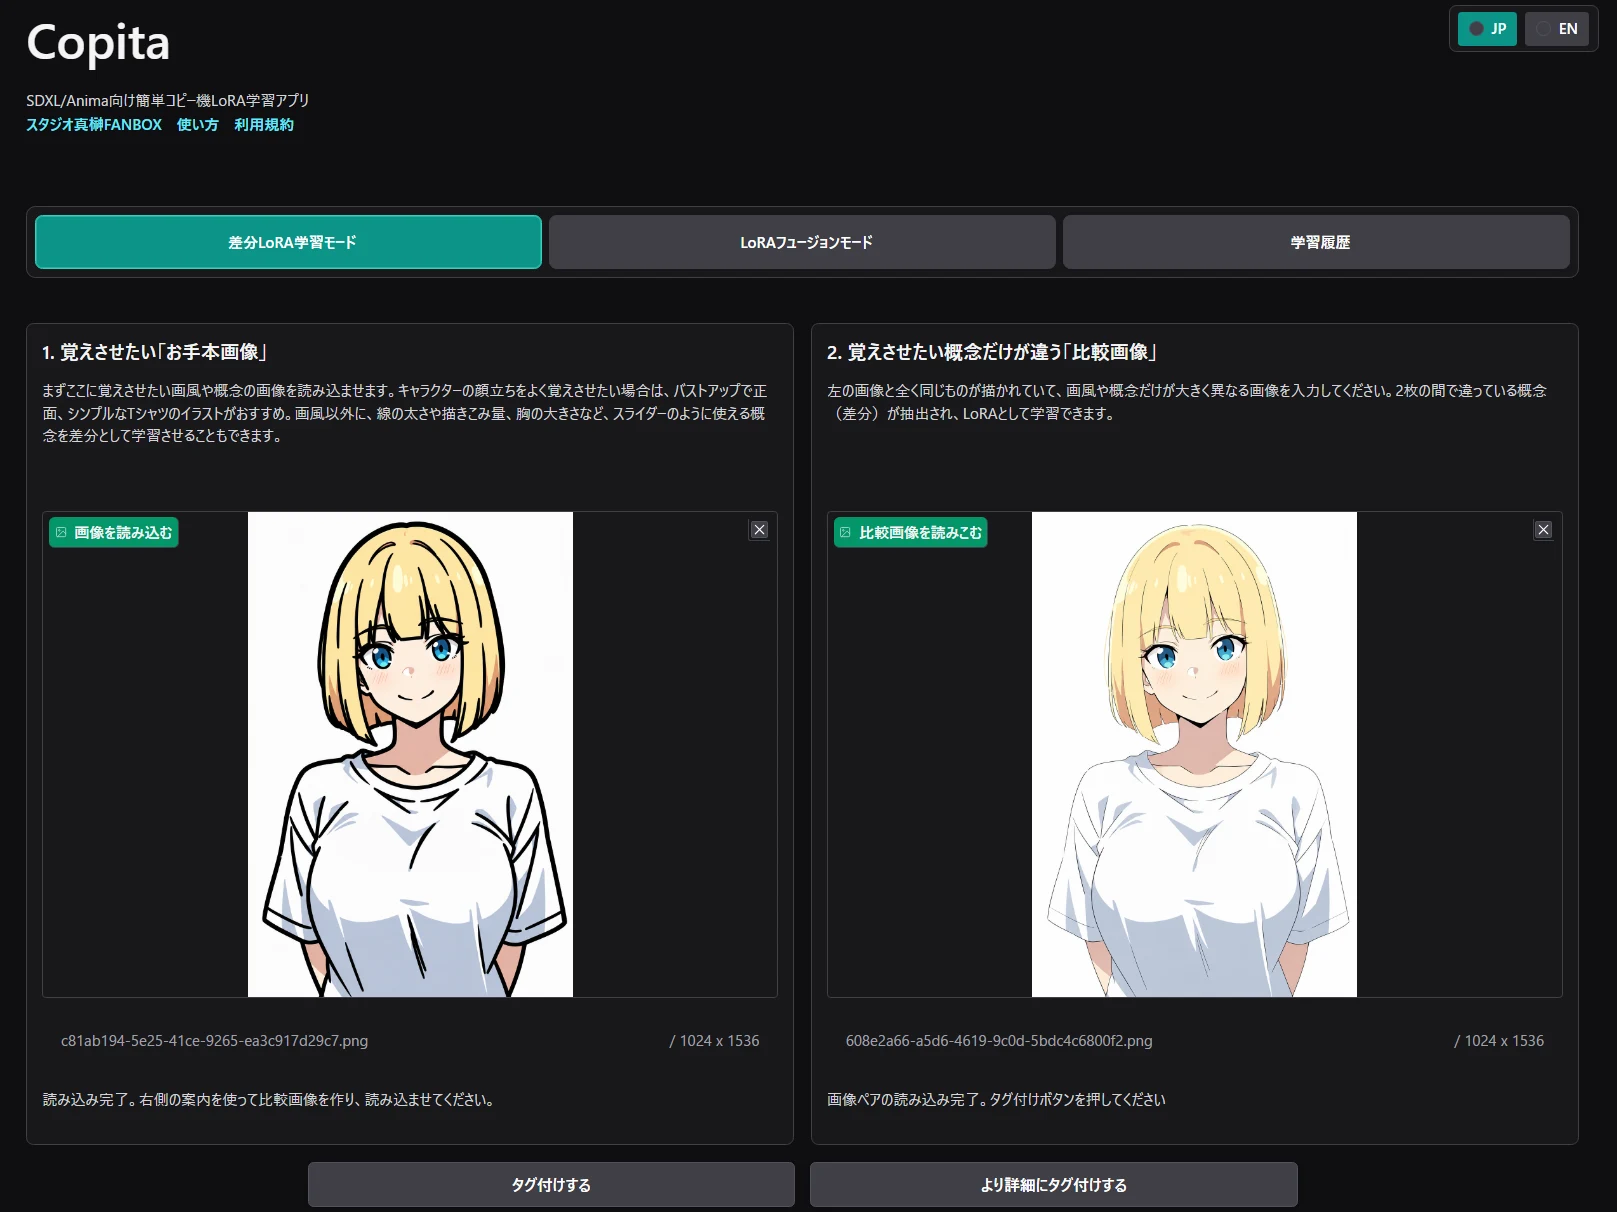
引き算をすると、2枚に共通している要素、つまり人物や服や構図が互いに打ち消し合うので、ペア間で違っている部分だけが残るーというのが基本的な仕組みです。ただし、実際には完全に打ち消し合うことはできず、「カス」のようなものが差分として残って予期せぬ副作用を生じさせることがままあります。そういうときは、「LoRAフュージョンモード」を使って同種のCopitaLoRAを複数融合することで純度を高めることができます。
詳しい使い方や学習例はこちらの記事をご覧ください。

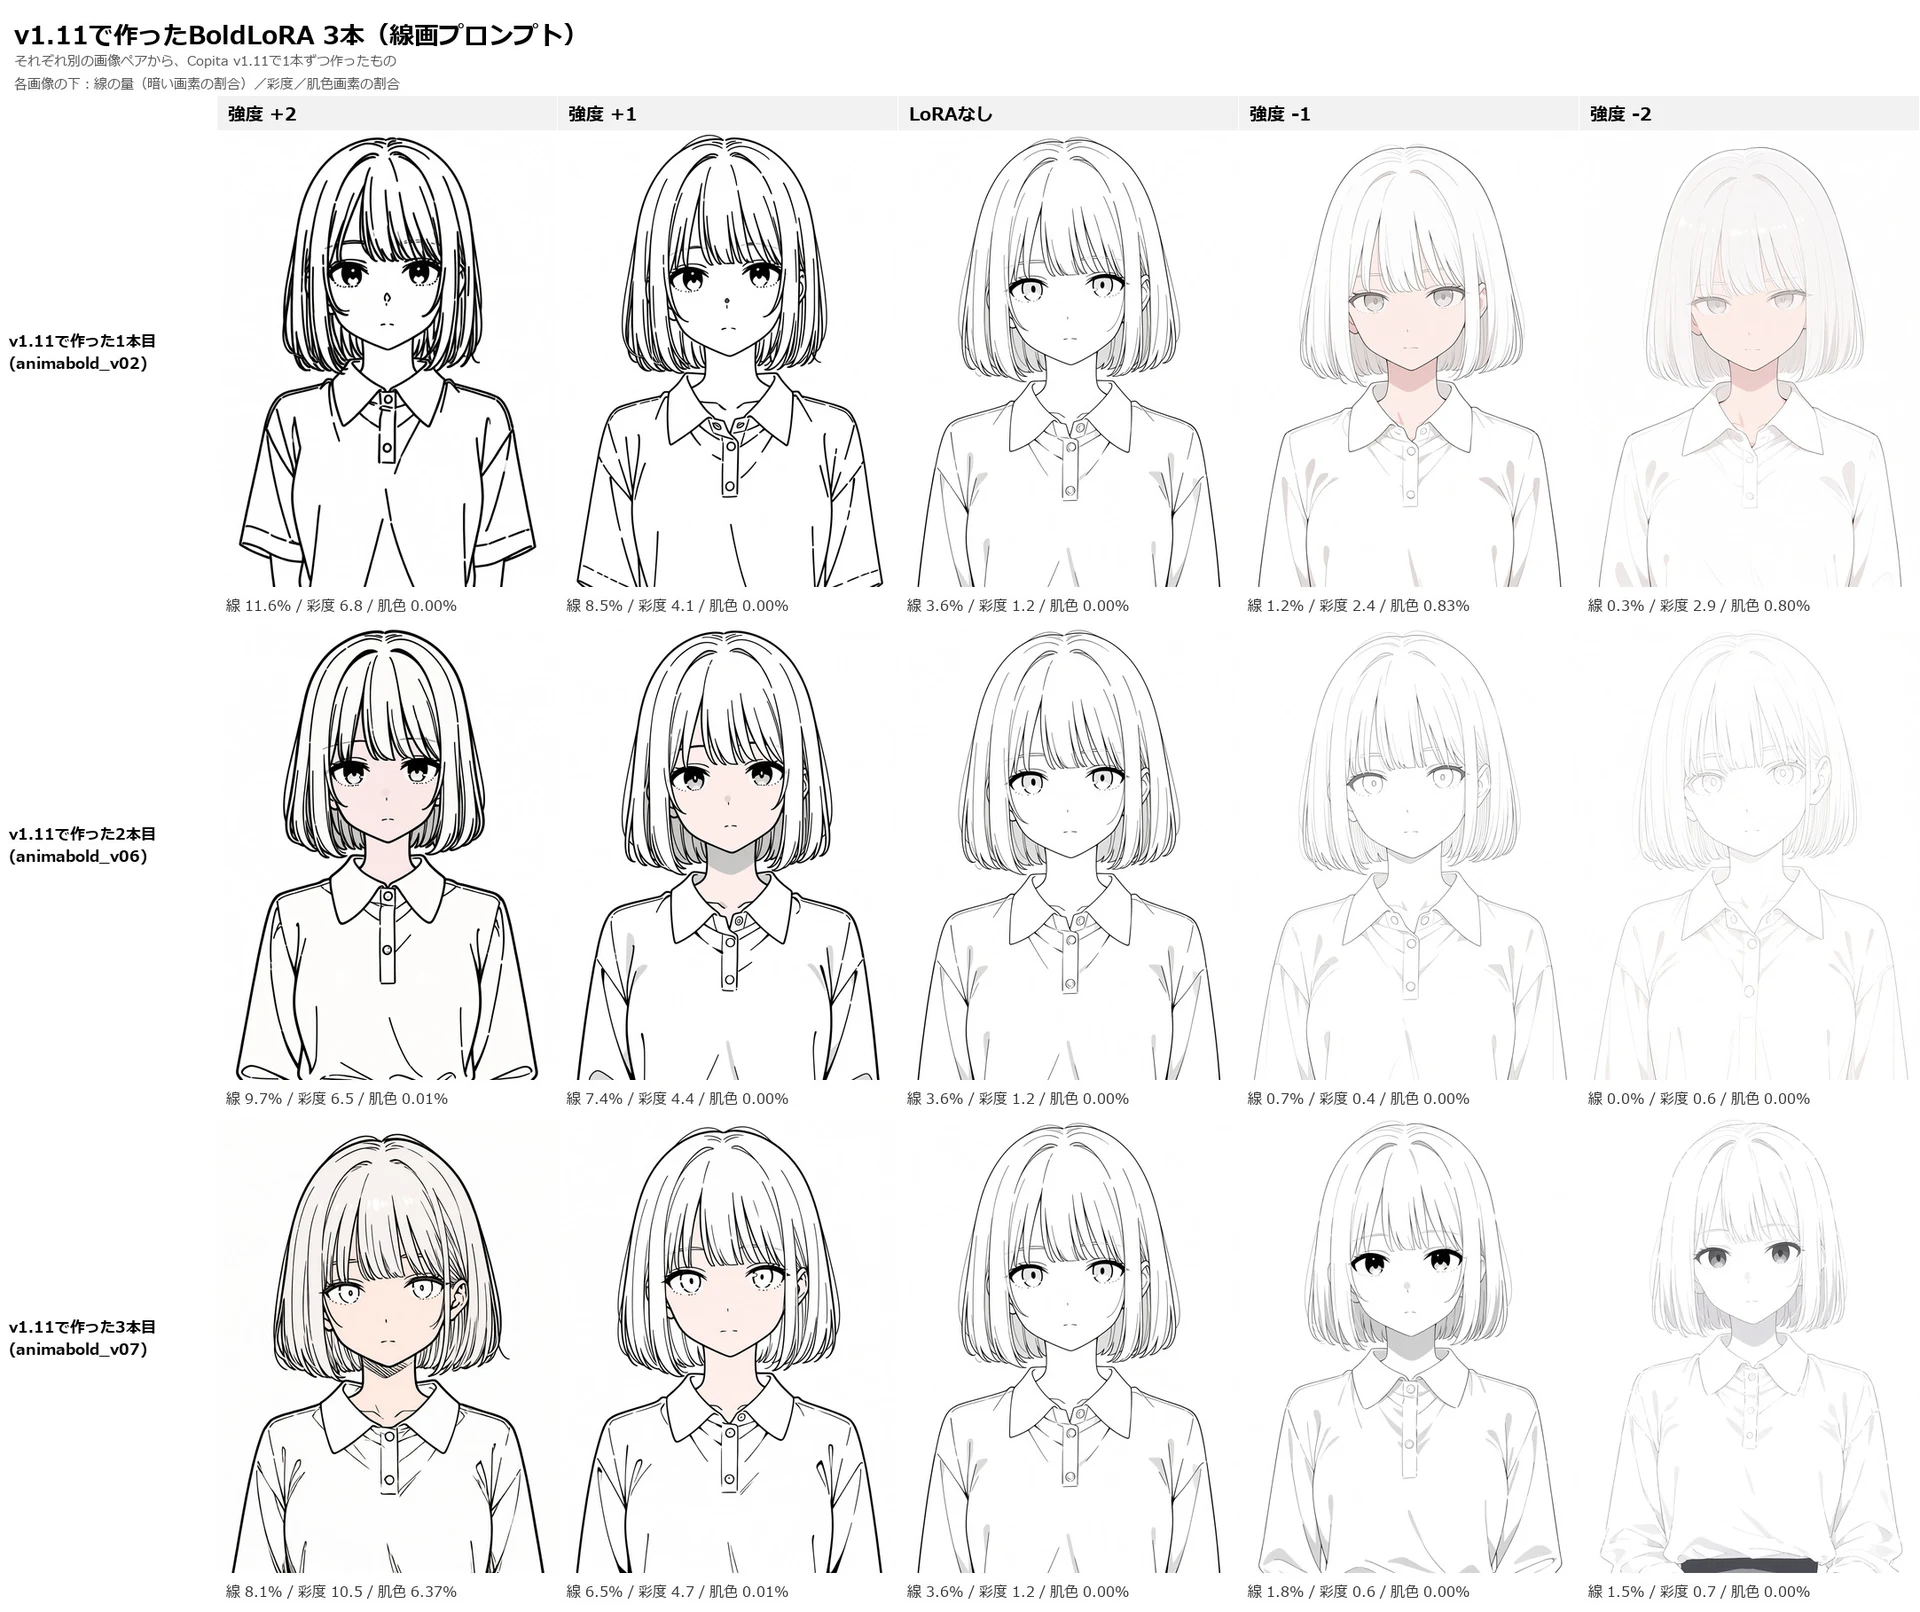
旧バージョンで学習したBold LoRA
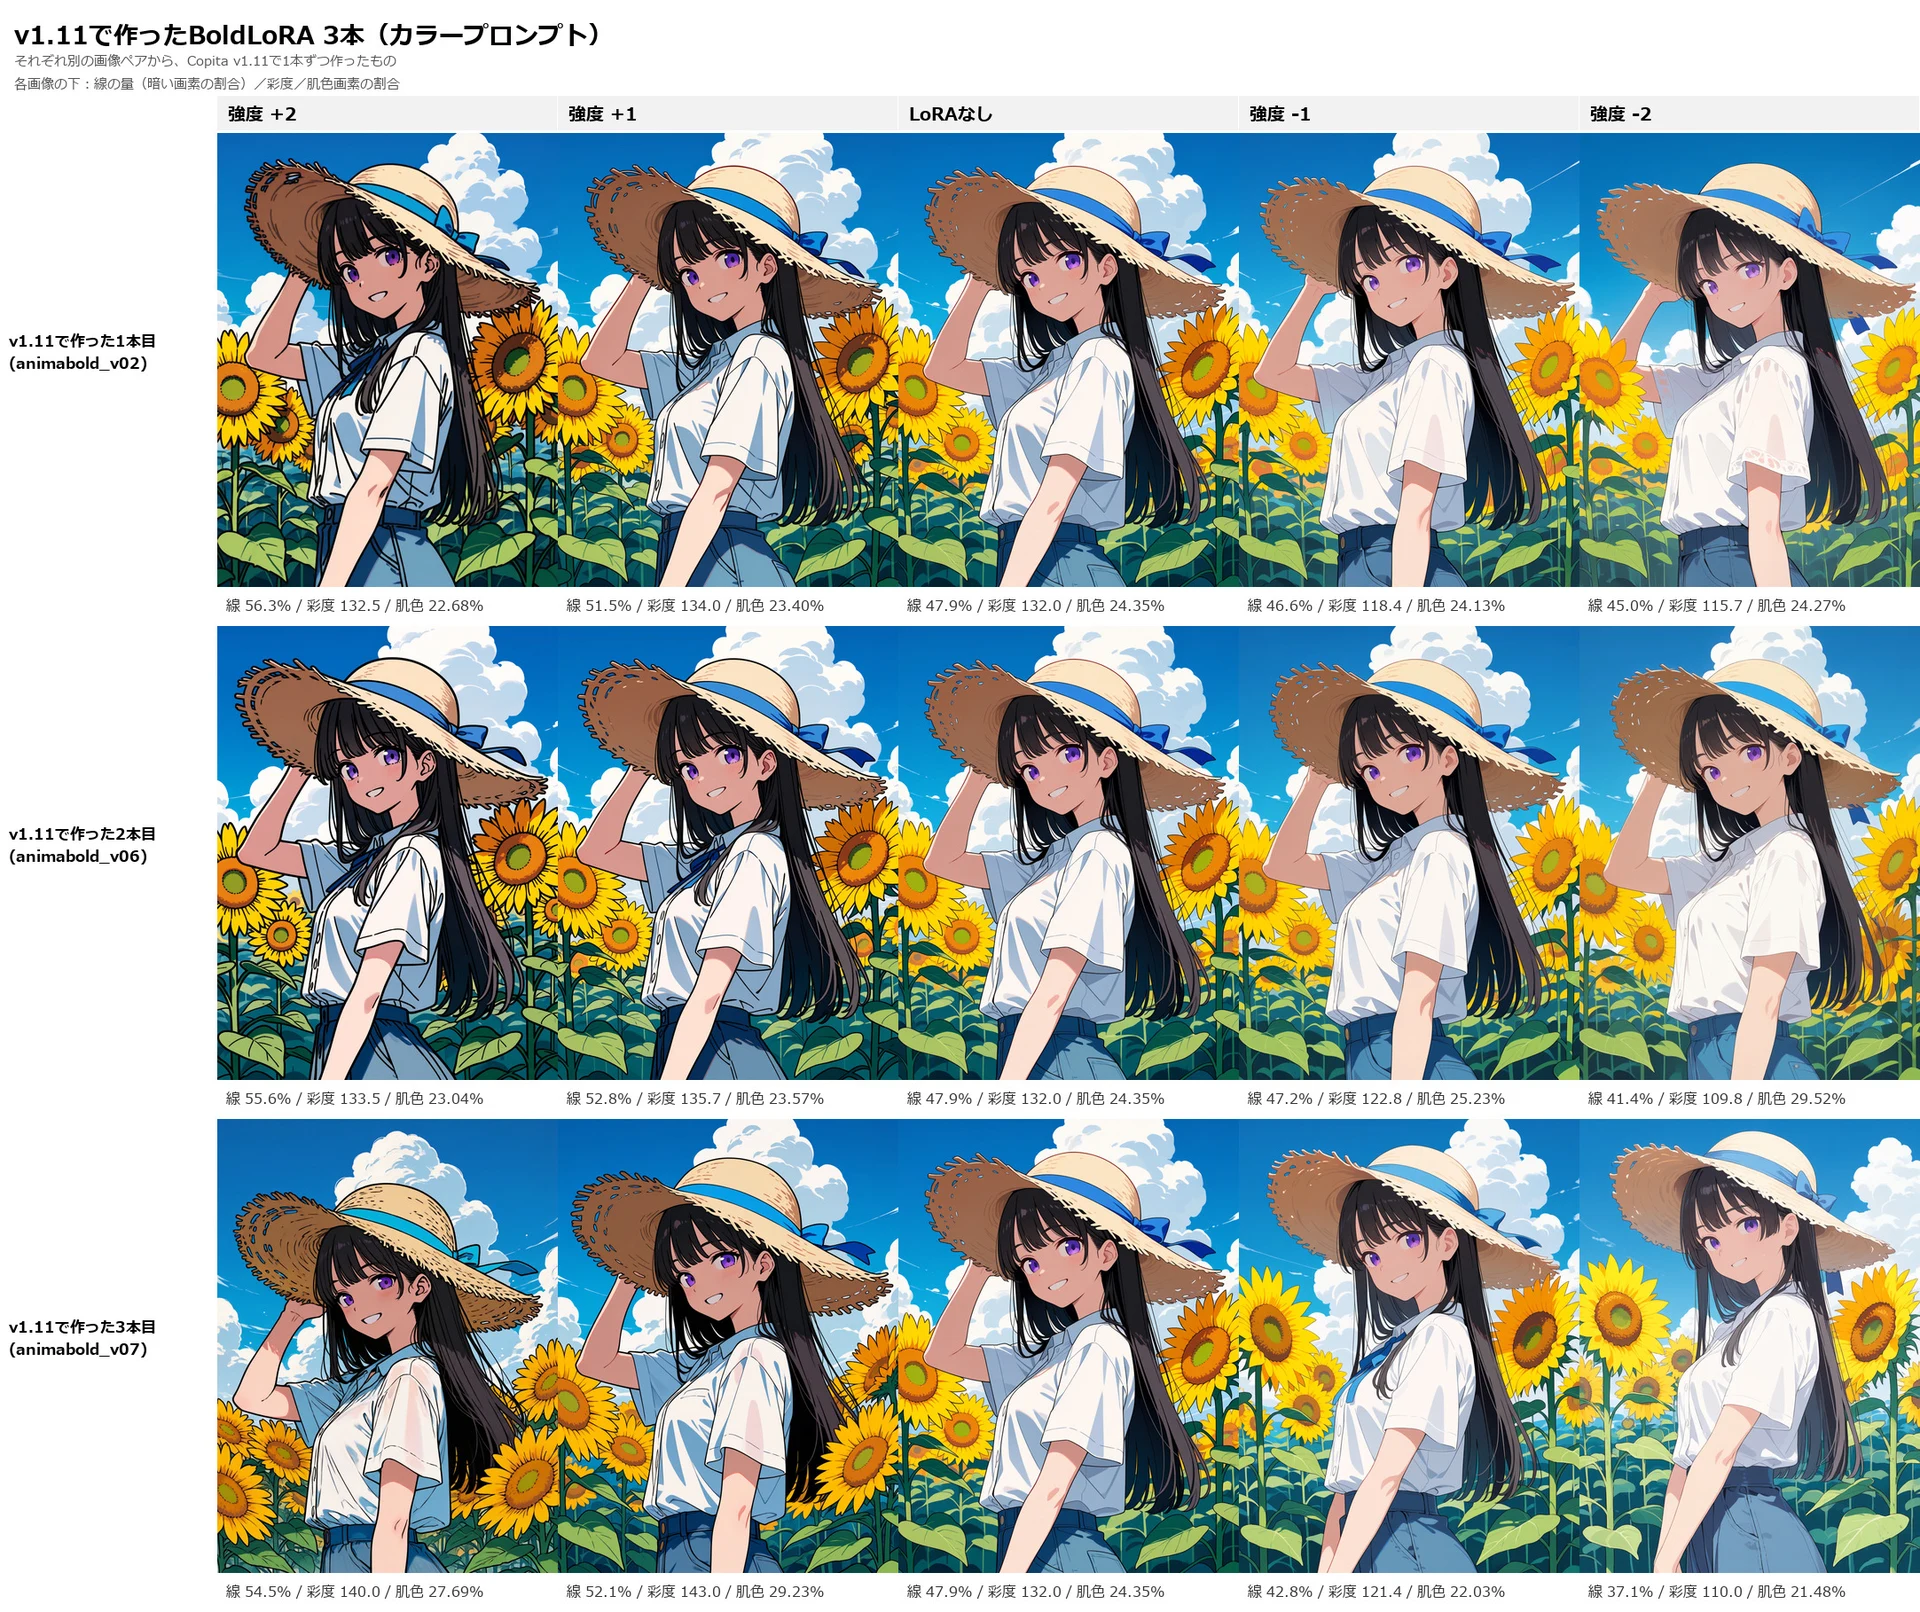
こちらは、アップデート前の「v1.11」を使って学習した3種類のBold LoRAです。中央の1枚から左(プラス方向)に行くほど線が太くなり、右(マイナス方向)に行くほど細くなりますが、御覧の通り指示していない肌色が生じたり、容姿が微妙に変化してしまったりといった「副作用」が生じています。
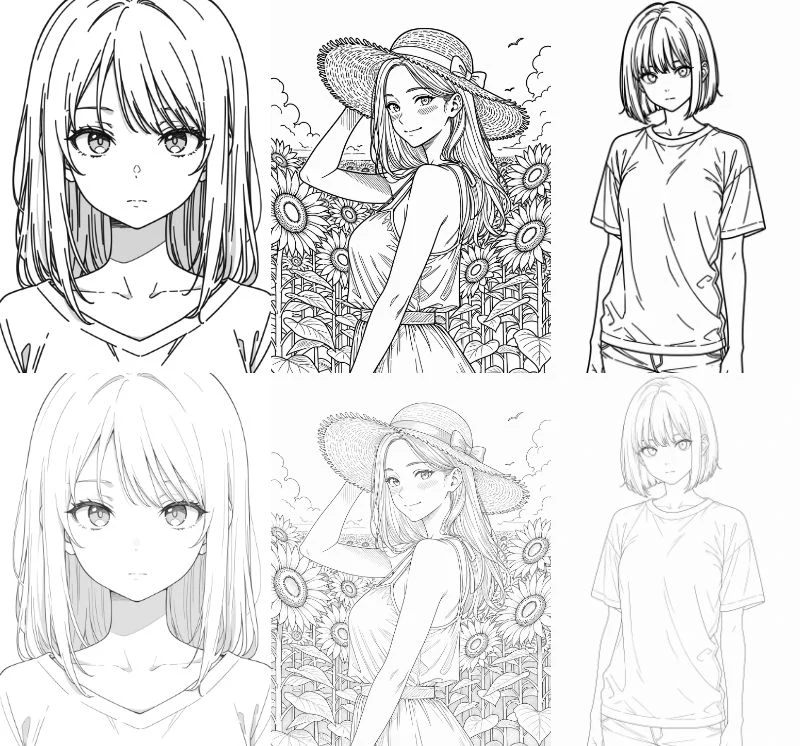
学習に使用したのはこちらの3ペアです。線画の太さだけを変更したつもりですが、例えば影のグレー部分の濃さに上下で差があるなどしており、こうした差分も「ごみ」としてLoRAに混入した可能性があります。
線画ではなく、カラーのひまわりイラストでも同じ3本の比較をしてみました。こちらも、帽子の質感や背景のひまわりの位置、少女の背の高さなどがまちまちに変わっているのが分かります。(手前にある腕の角度だけを見比べると分かりやすいです)
これでもBold LoRAとしては使えないことはありませんが、より精度の高いLoRAを作れる「v1.2」を作るにはどうしたらいいか探っていきました。まずは既にある「LoRAフュージョンモード」を使って3つのLoRAを融合してみます。
<LoRAフュージョンモード>
Copitaには、メインの「差分LoRA学習モード」のほかに「LoRAフュージョンモード」というタブがあり、できあがった同じ効果のLoRA同士を合成して、より精度を高めることができます。さきほど別々のペアで3本のBold LoRAを作ったわけですが、これらを混ぜて平均化すれば、肌色になったりポーズが変わったりする副作用が弱まり、線を太く(細く)する効果だけを残しやすくなります。
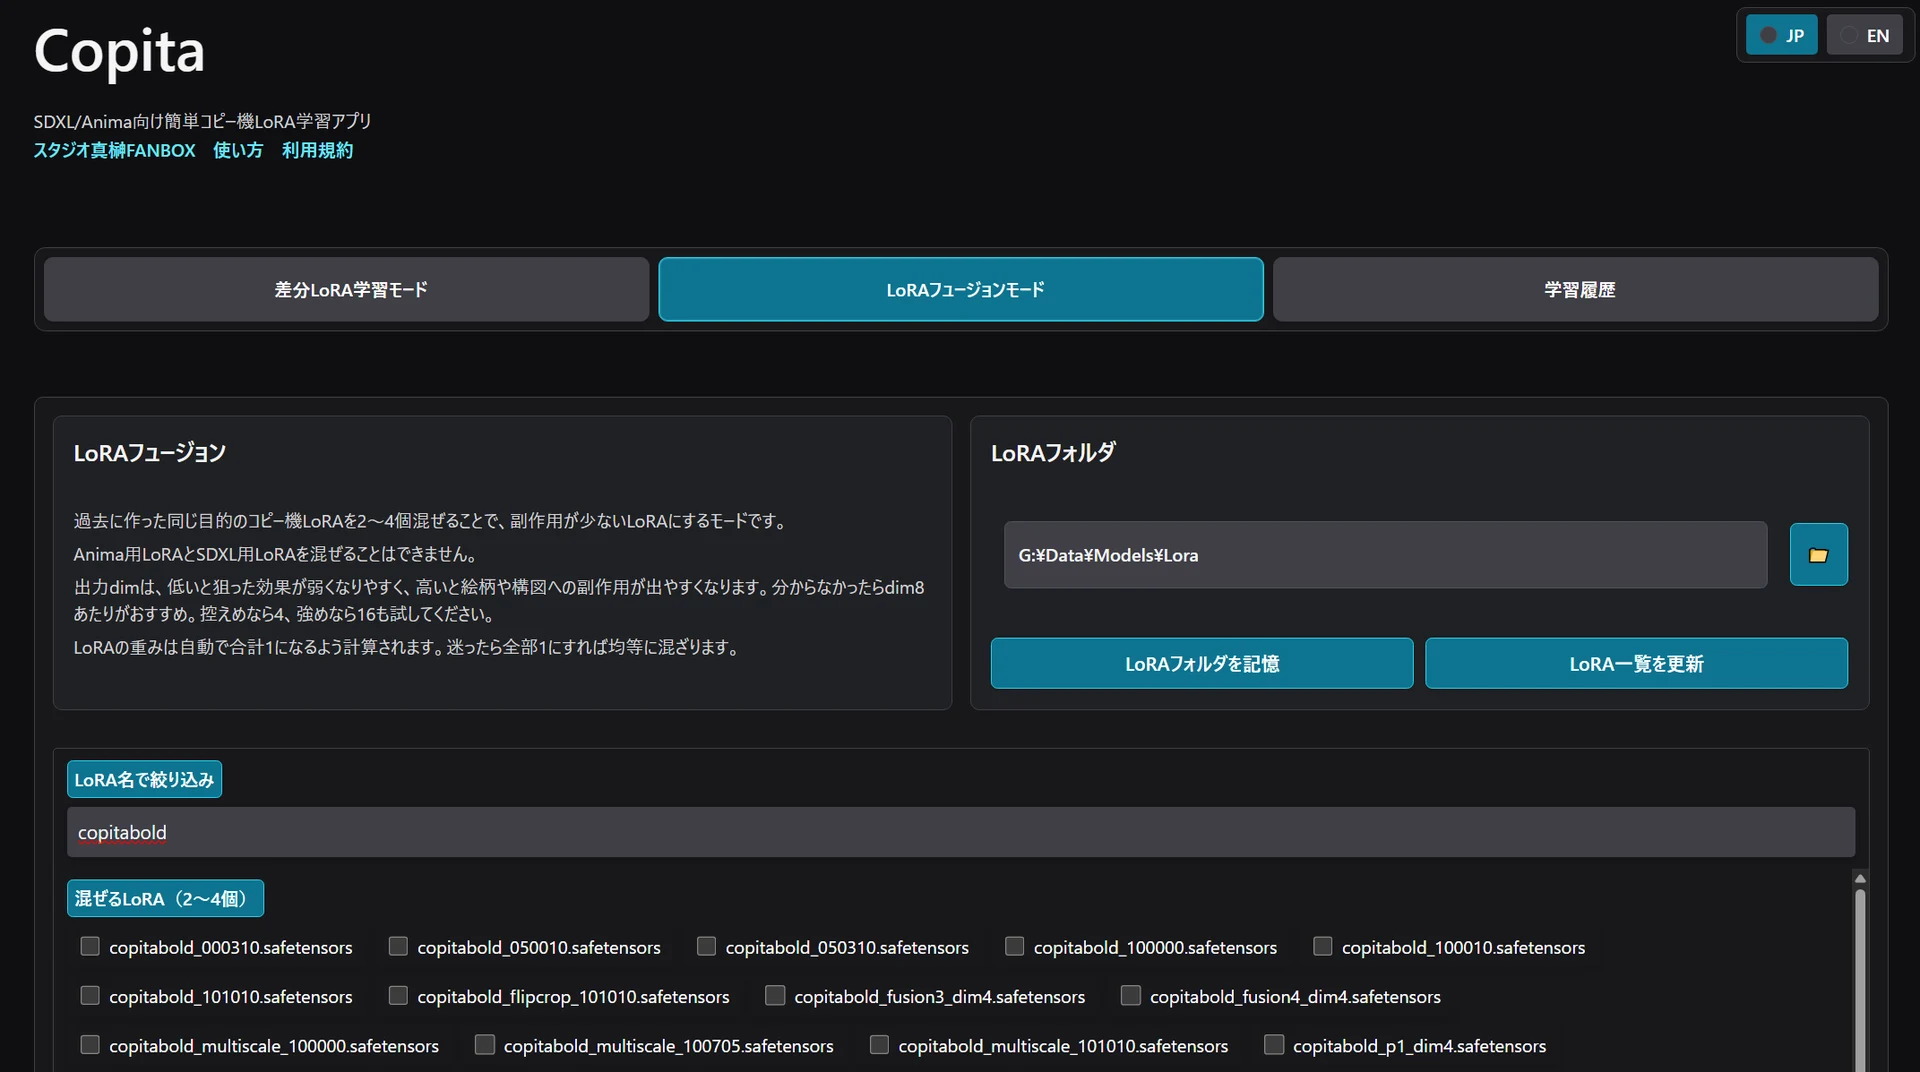
このように、先ほど作ったBold LoRAを三つ選び、2:1:1の割合でフュージョンします。(一つ目を他の倍の重みにしたのは、プラス方向で肌色が生じないなど効果が安定していたため)
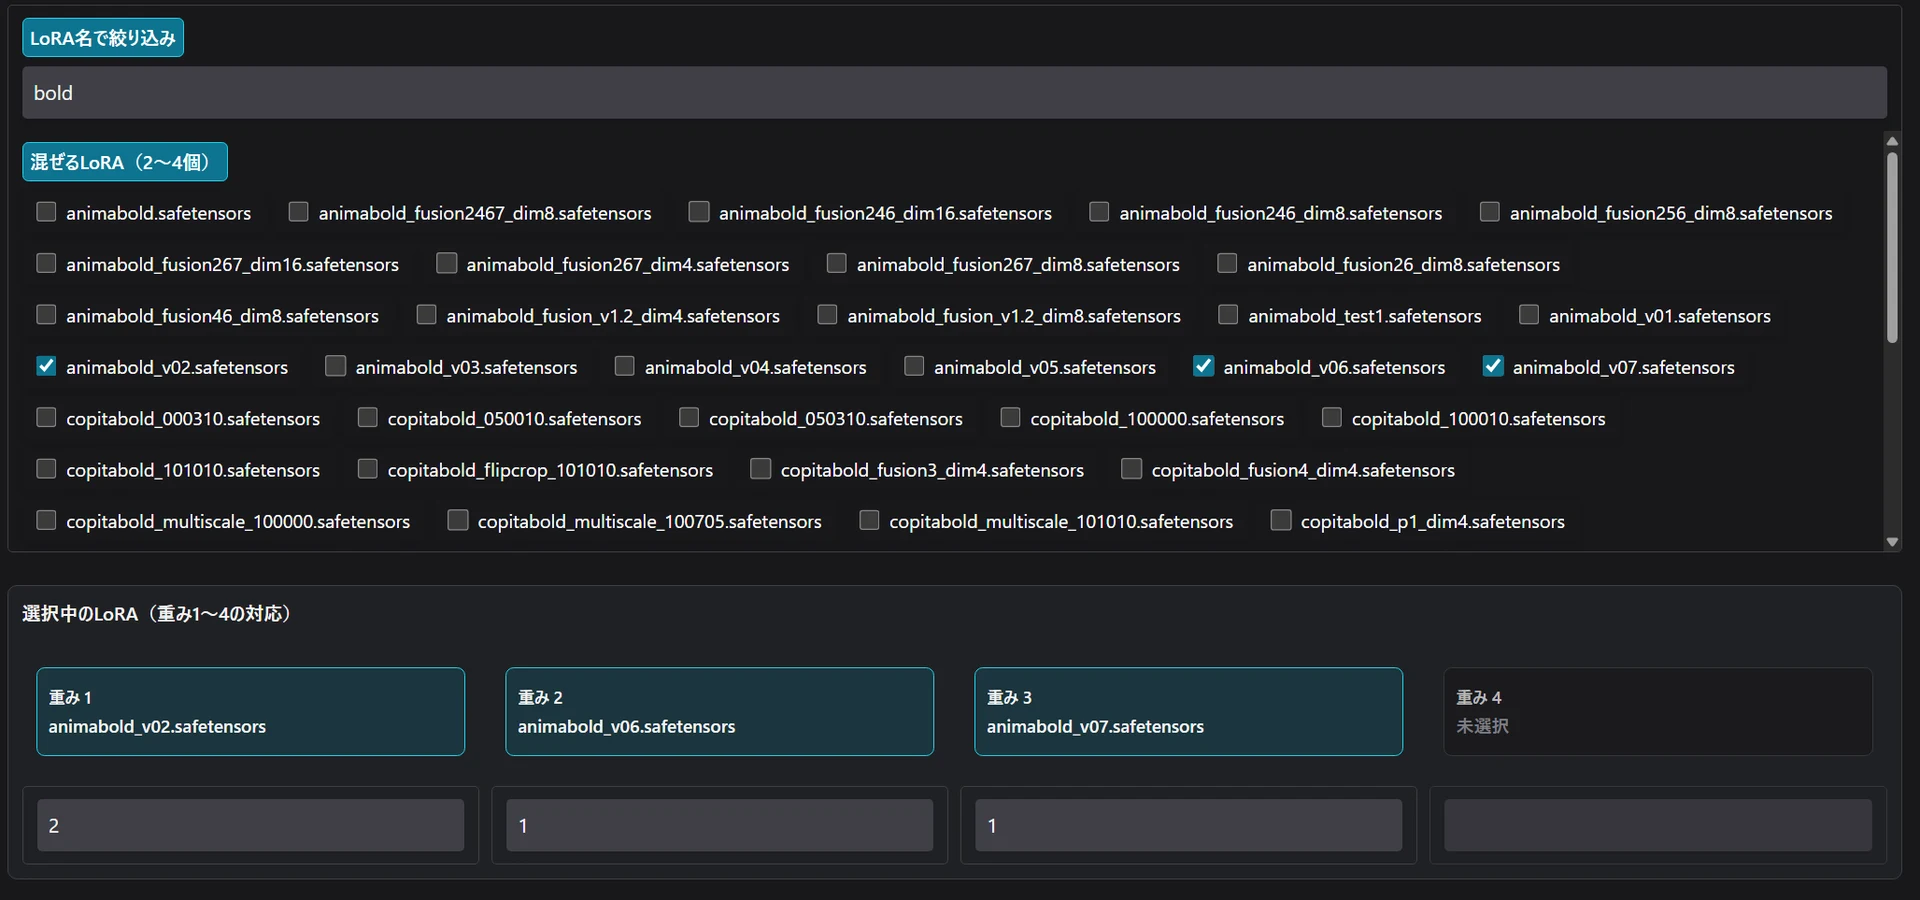
こちらが比較図。さっきと同じ3段の下に、新しく4段目として、3本を混ぜたフュージョンLoRAの生成結果を並べました。
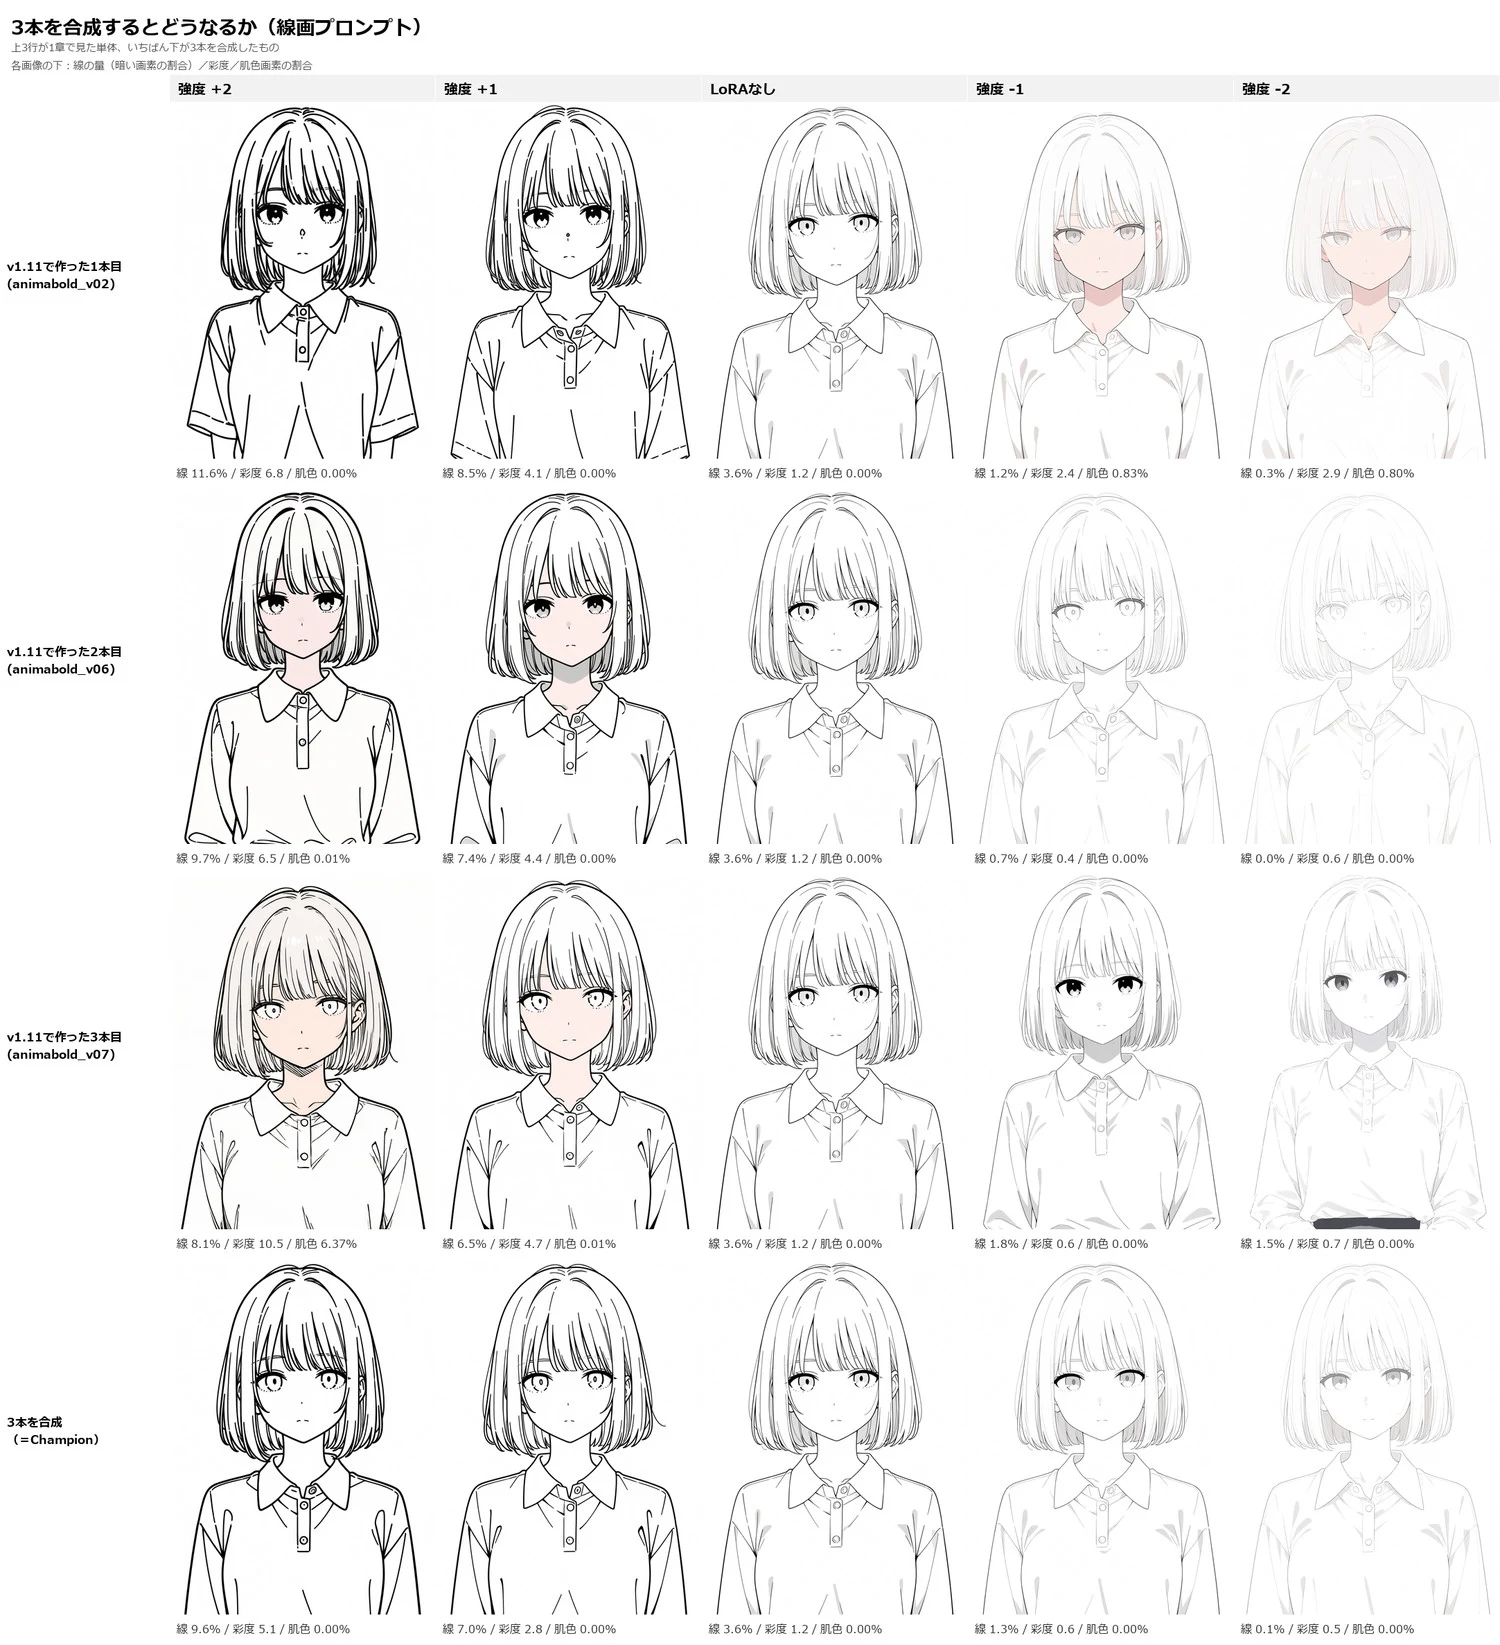
お分かりのように、上の3段では肌色になったり位置が変化したりする副作用があったのに、最下段のフュージョンLoRAではきれいに消えています。線画を太く(細く)する効果も上の3段と比べて弱体化していないようです。
線画でなく、カラーのひまわりイラストでも試してみます。
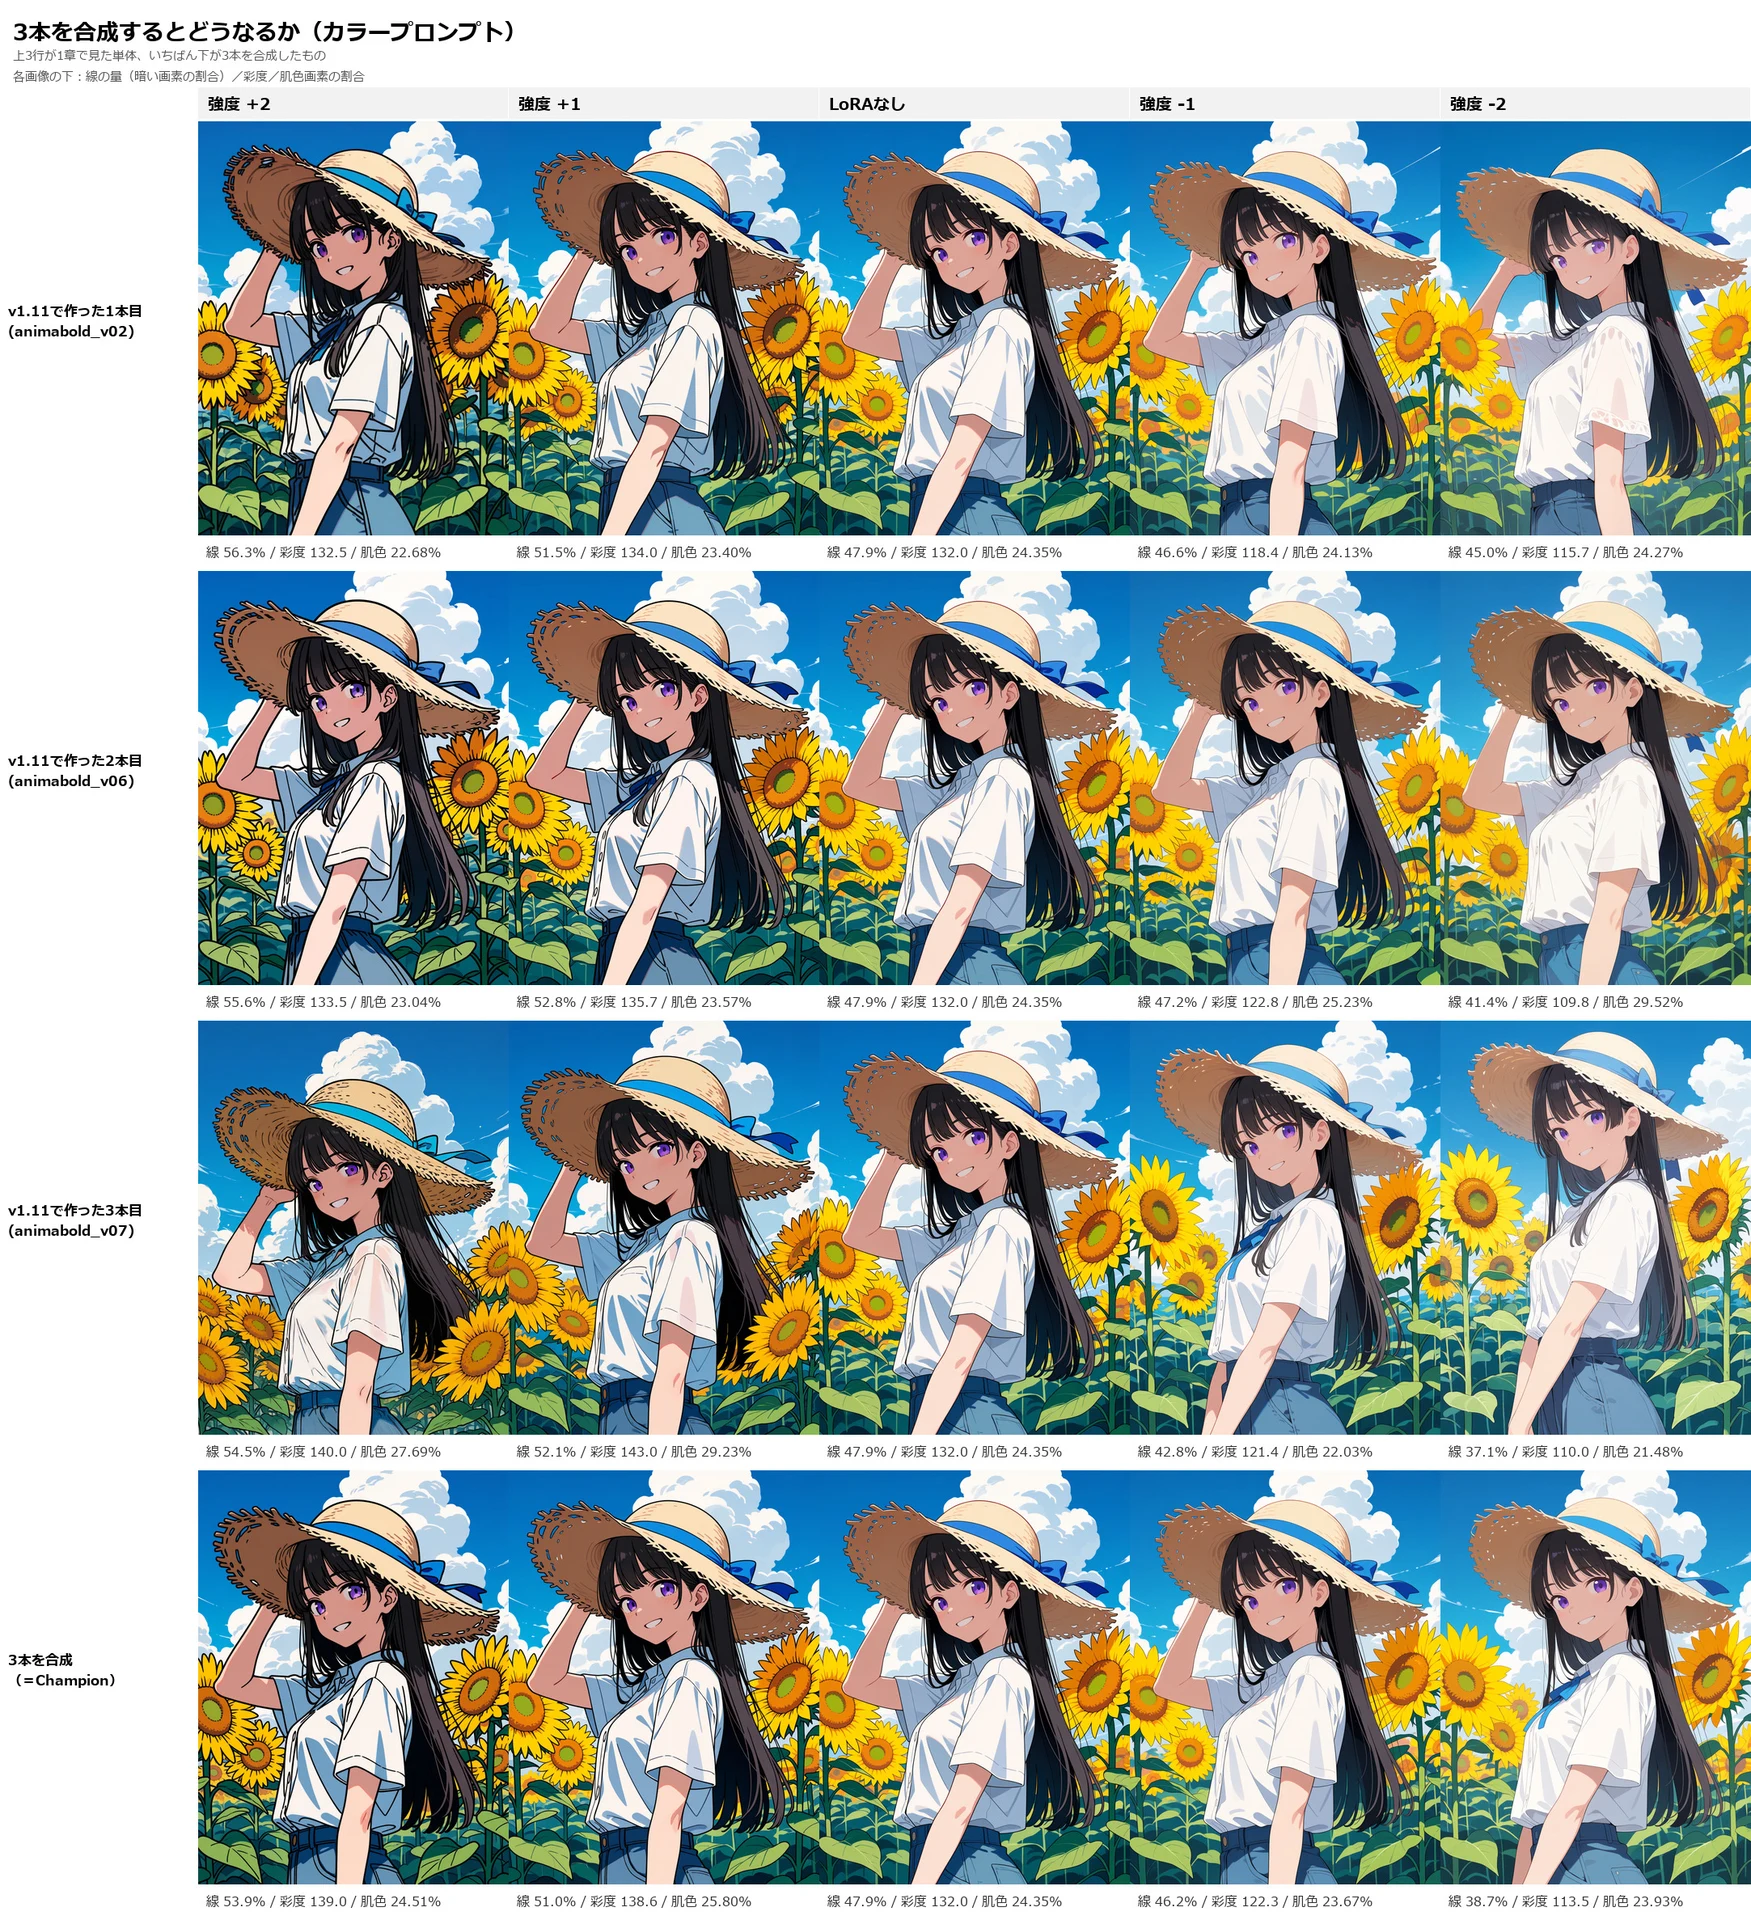
こちらはやや分かりにくいですが、右下のひまわりの葉(葉脈)に注目してみると、上の3段よりも最下段は変化が少なく、正確に描画できているように見えます。(ただ、右手が下がったり、リボンの形状が変化したりといった副作用が一部継承されてしまっています)
v1.11時点で一番よい結果だったのがこの合成版でした。以降このLoRAを「Champion」と呼ぶことにし、これを上回る精度のLoRAを作るやり方を探っていきます。

改良実験①:白帯加工をやめる
さて、先ほどのChampionをより精巧に学習できるよう、v1.2ではいろいろな改善策を試しました。まずトライしてみたのは、入力画像の前処理です。
v1.11までのCopitaは、入力された画像が縦長でも横長でも、いったん正方形になるよう白い「余白」を足してから学習していました。最後に「引き算」されるとはいえ、これだと余計な要素が混じってしまいますし、学習してほしいメイン要素がキャンバスに対して狭い範囲になってしまいます。そこで、Codexを使って元の縦横比のまま学習できるように改良しました。
ところが、この状態でBold LoRAを作ってみると、こうなりました。上段がさきほどフュージョンモードで作った「Champion」で、下段が「白帯加工をやめた版」の新しいLoRAです。
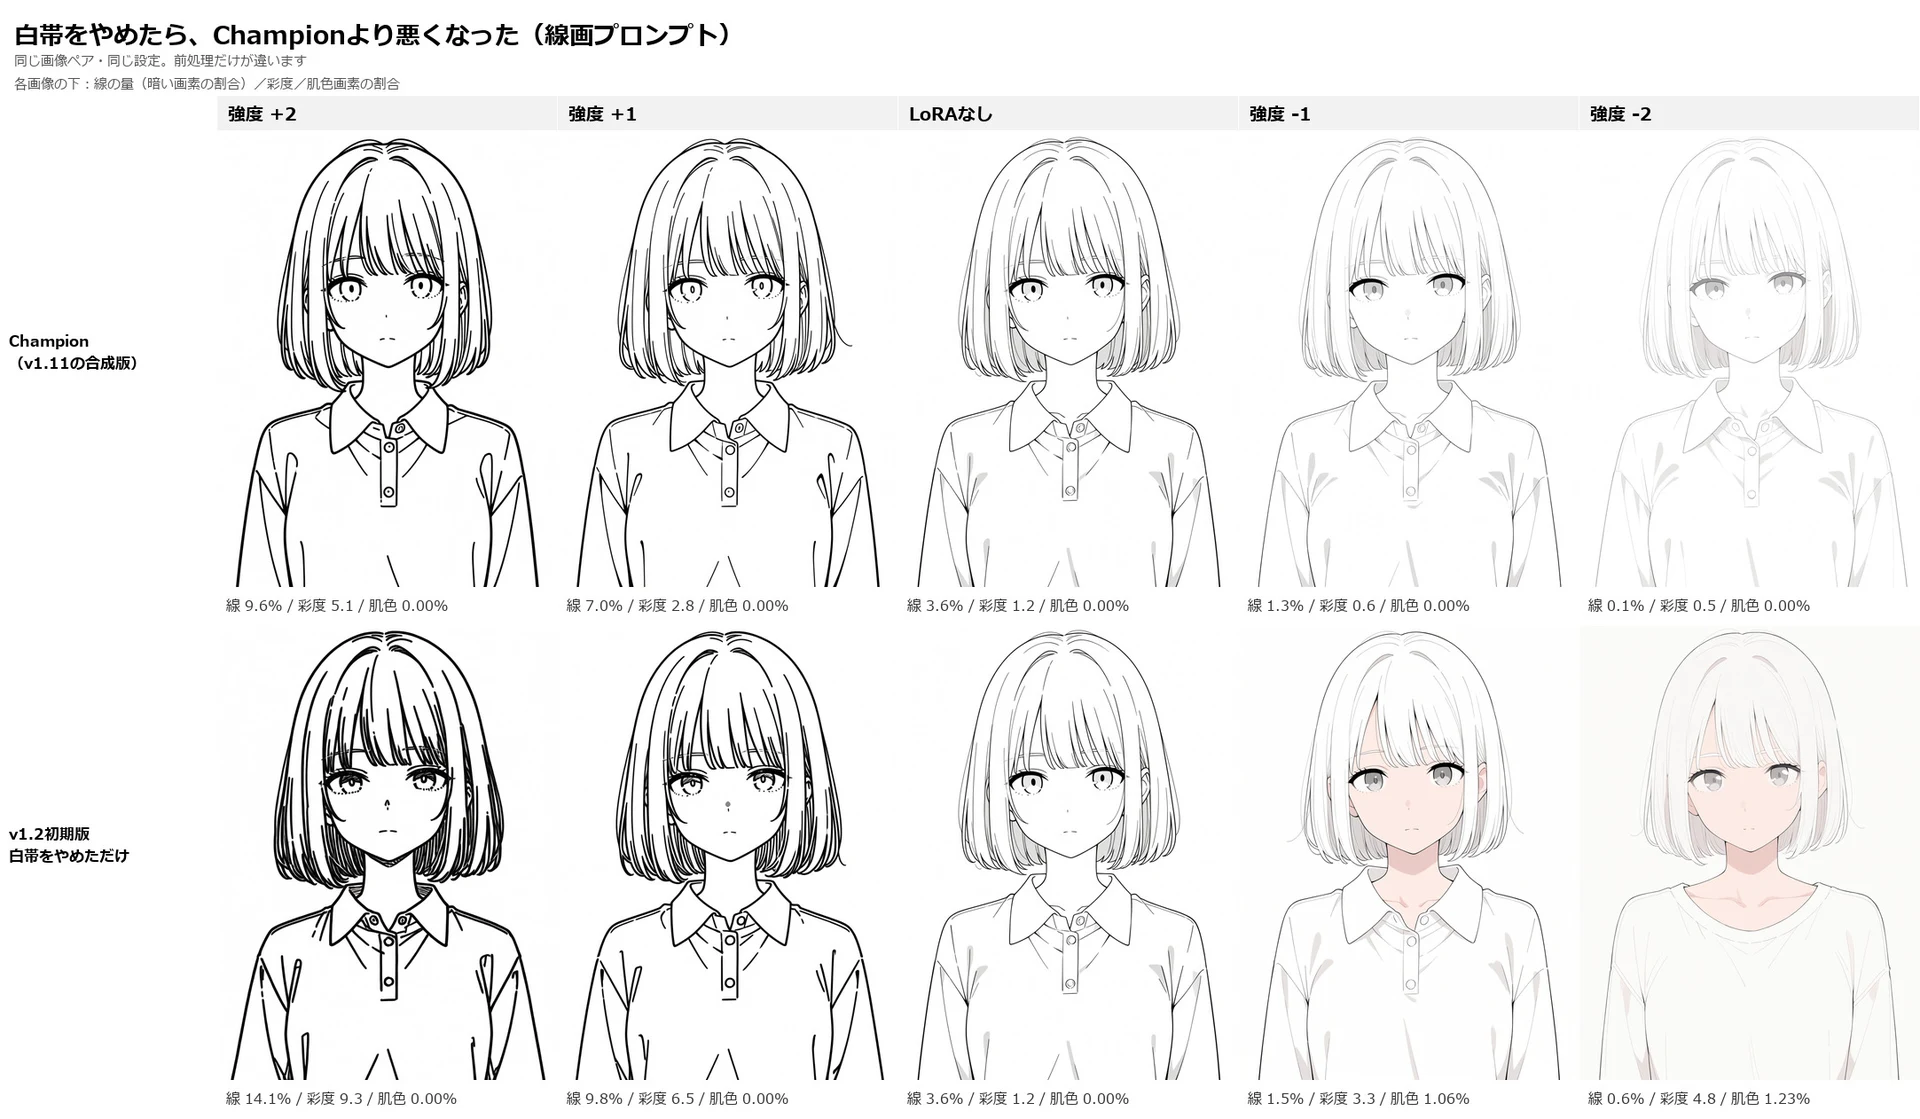
さきほど作ったフュージョン前のLoRAと同様に、目の形が変わったり肌色が出たりしていますね。理屈では学習効率が改善したはずですが、「フュージョン不要」と言えるほどの抜本的解決とはなりませんでした。

改良実験②:「悪い過学習」対策
次に考えたのが「悪い過学習」対策です。Copitaはたった1枚の画像を300回も400回も繰り返し勉強して、わざとその画像を丸暗記させるのですが、やりすぎると「線が太い」という概念を覚えるのではなく、「この画像のこの場所にこの線がある」という「悪い過学習」になってしまいがち。そうした過学習の悪影響で、肌色などの副作用が起きてしまうのではないか?と考えました。
そこでv1.2では、入力した学習画像を内部的に「鮮明度の違う3枚」に増やす仕組みを作りました。
つまり、入力画像が
①原本
②0.7倍に縮小してから元のサイズに戻したもの(わずかにぼやける)
③0.5倍に縮小してから元のサイズに戻したもの(ちょっとぼやける)
の三つに増えるということです。
ぼかすと筆致やハッチングといった細かい情報は消えてしまいますが、「線が太い」という情報だけは残ります。この3枚に共通するものだけを学ばせれば、丸暗記を防ぐことができるはずだ、というのが狙いです。
こちらが比較図。さきほどの2段に、新しい3段目として試作LoRAを並べました。
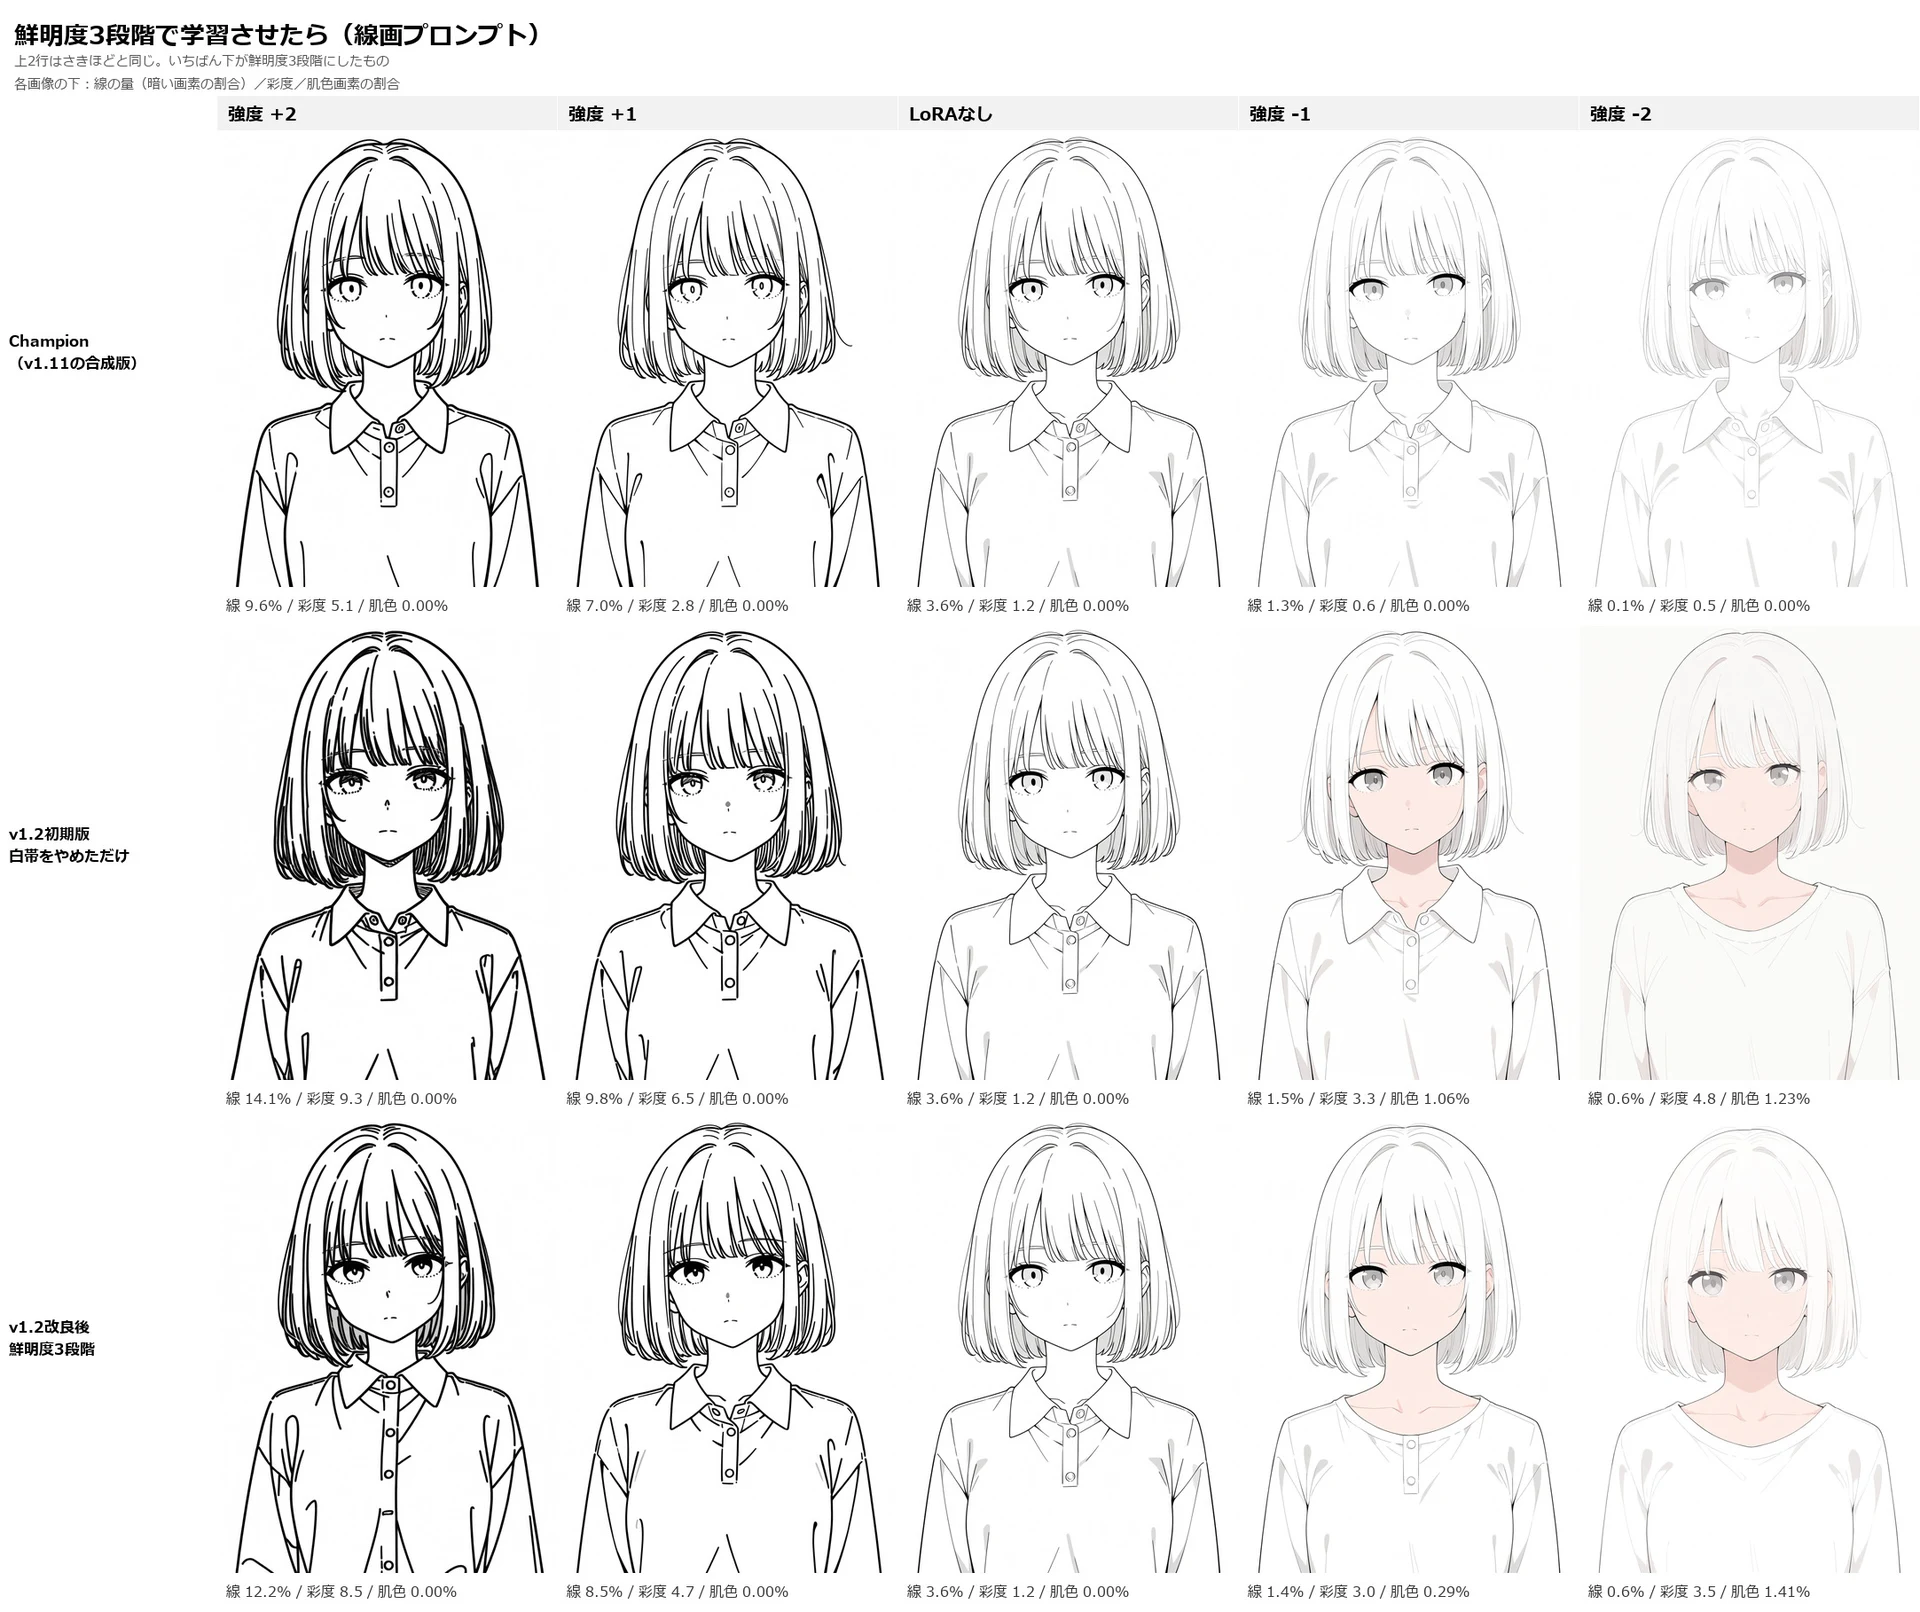
下段では、顔立ちの変化が多少弱まったようにも見えますが、+2ではシャツのデザインが変わってしまっています。マイナス方面では肌色の混入も避けられていませんし、襟のデザインも変わってしまっているので、目立った成果はありませんでした。
こちらはカラーイラストで同じ実験をしたもの。
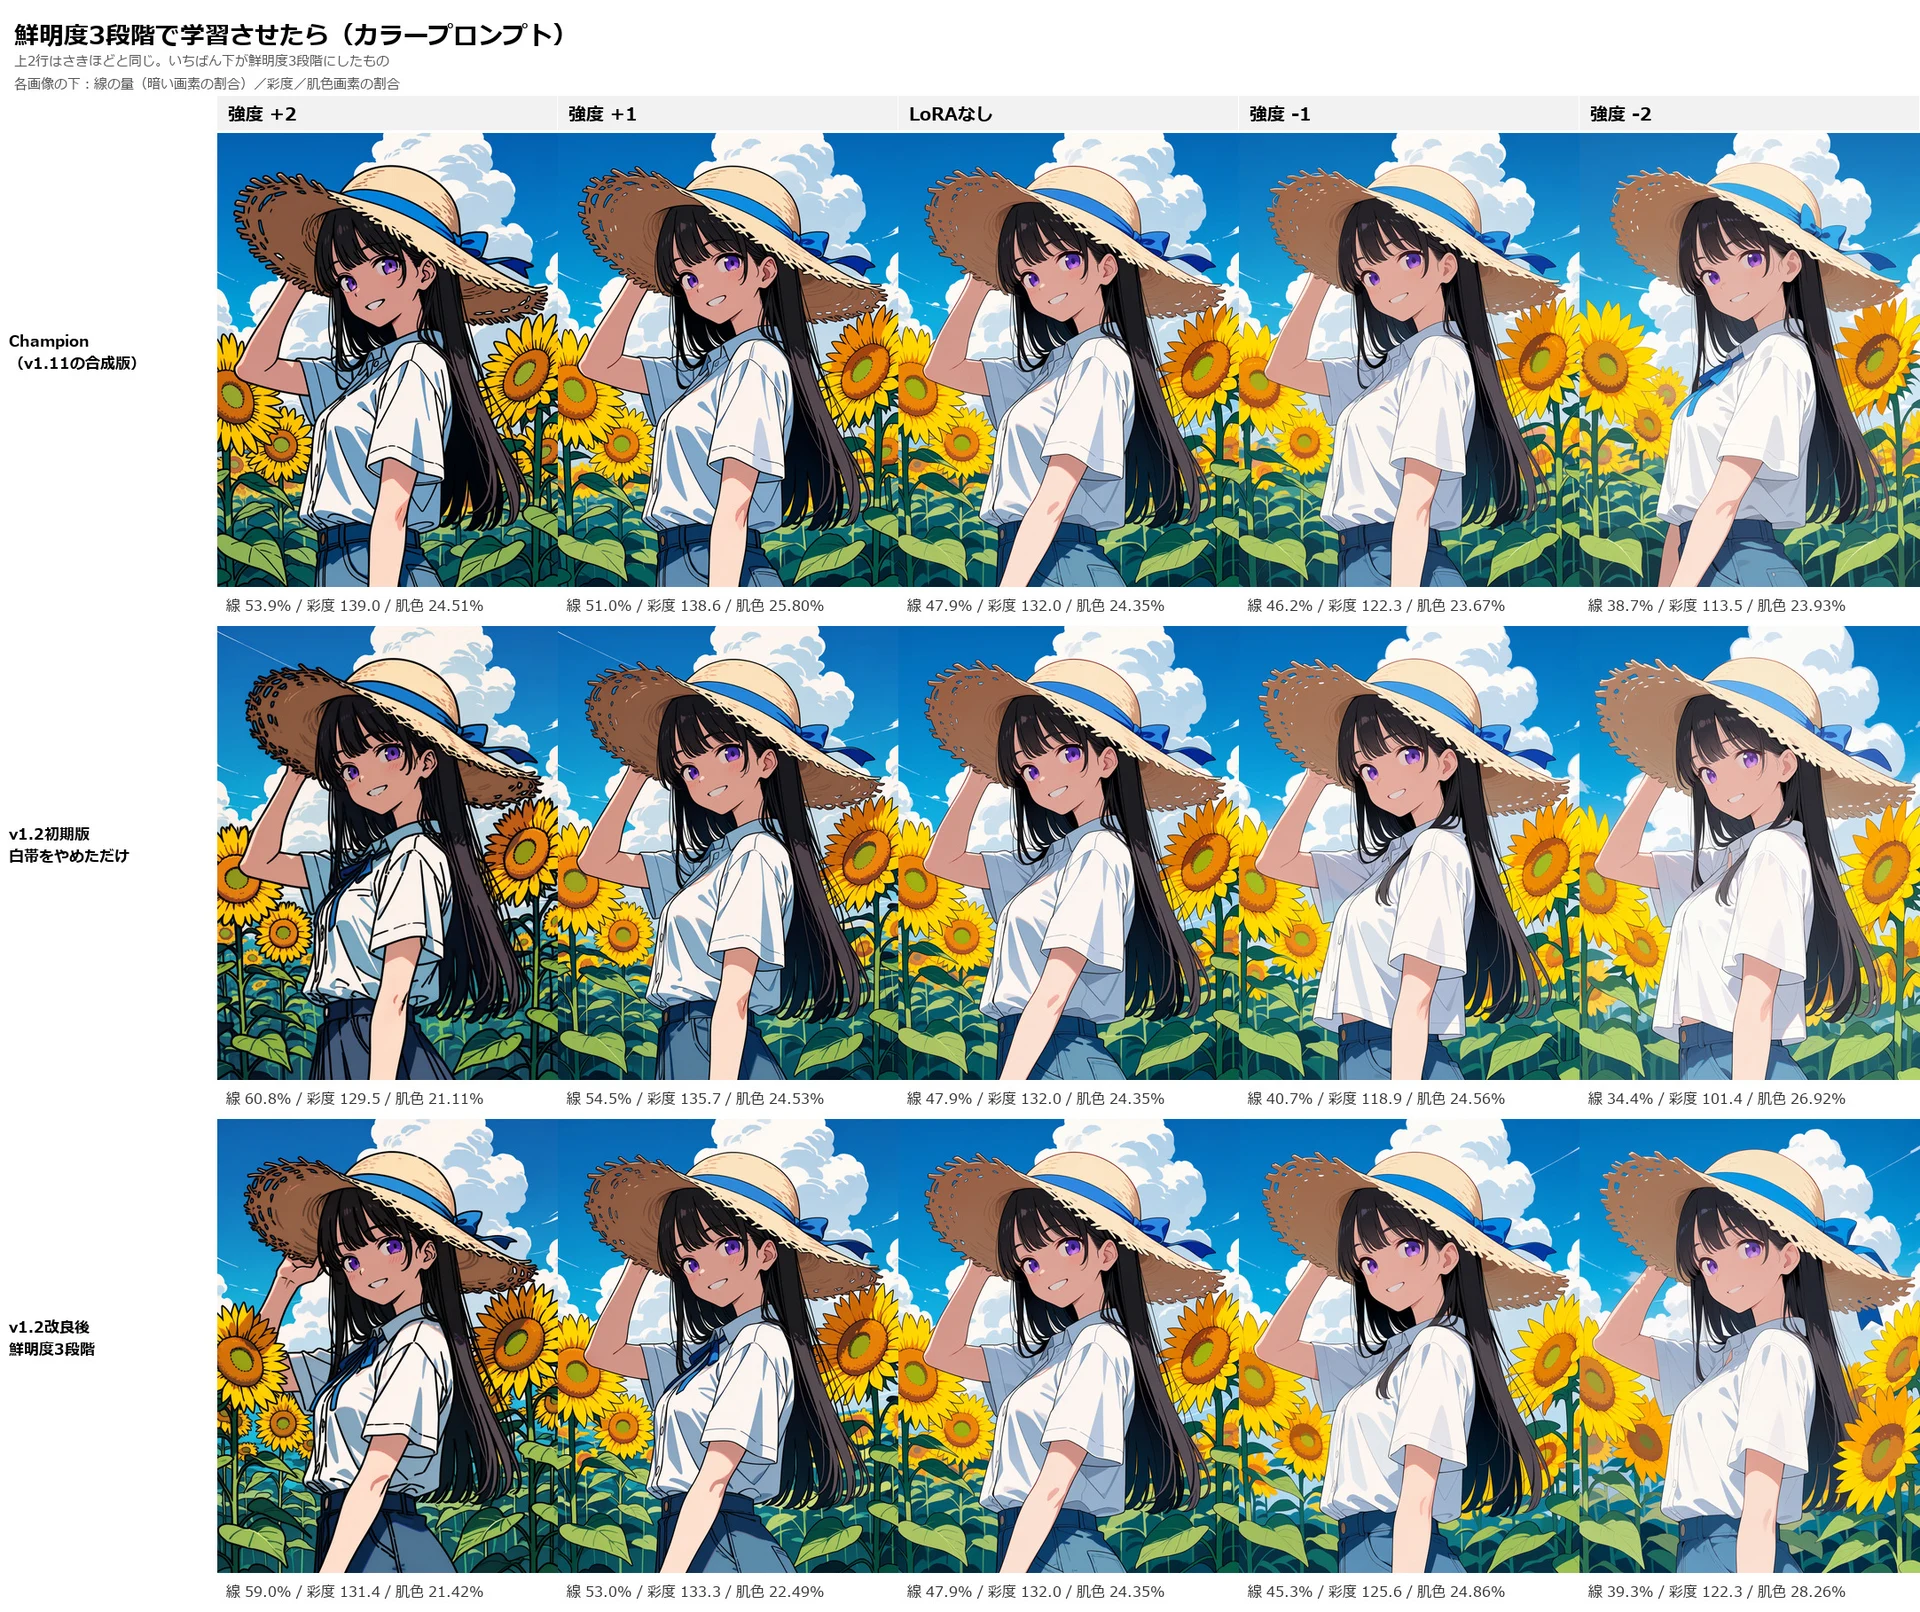
分かりやすいのはマイナス側です。よい効果としては、中段は彩度がかなり落ちてしまう(132%→101%)効果があったのが、鮮明度を3つに分ける手法を使った下段では122.3%で踏みとどまっていること。一方で、下段の+2を見ると、右手の肘がひまわりの手前ではなく奥側に回りこんでしまっていることが分かります。
カラーの変化を抑制できる効果があったとしても、描かれている内容の変化が強まってしまうのでは、良い改修とは言いにくいですね。画風LoRAの学習にはポジティブな効果があったので、いったんv1.2では採用しましたが、この前処理法は今後のアップデートでオミットする可能性が高いです。

改良実験③:データセットの更なる水増し
そこで今度は、入力画像をぼかすのではなく、左右を反転させたり、クロップする位置をずらしたりして、データセットを18枚まで増やしてみることにしました。つまり、Copitaの画面上でいうと左の画像を18枚に増やしてLoRAを学習し、右の画像も18枚に増やして学習し、さらに差分を取る、という工程を試したわけです。
結果はこちら。絵の変容度が抑制できた印象はありますが、線を太くする効果が薄まってしまいました。
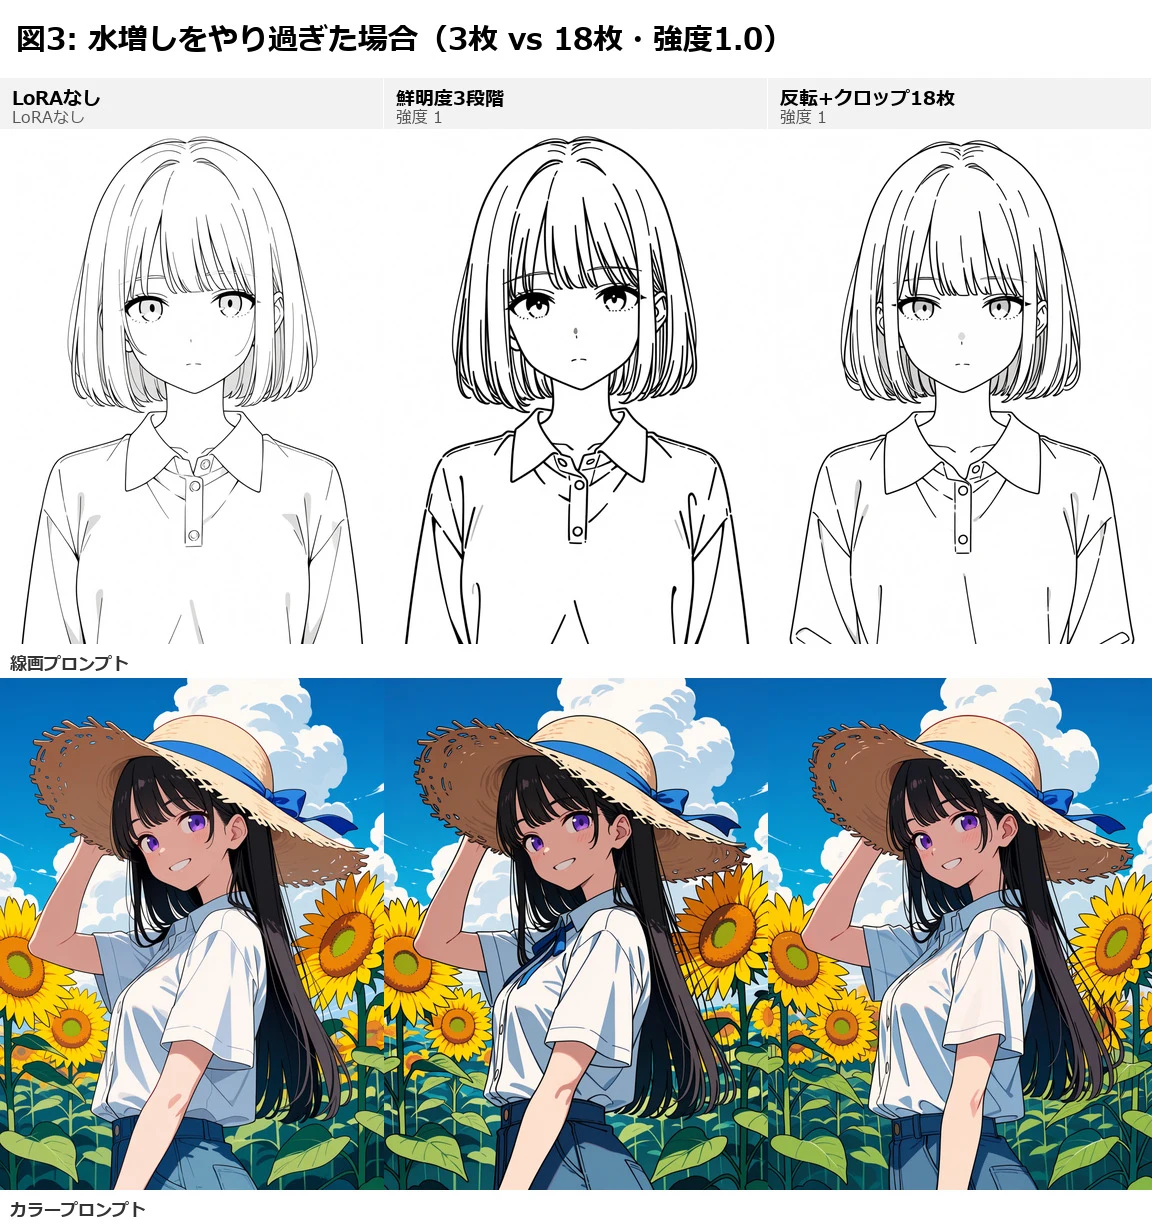
300ステップを単純に18枚で割ると、1枚あたり17回しか勉強できませんから、「どの画像もちゃんと写せていない雑なコピー機LoRA」が2つできてしまい、そうした雑なコピー同士を引き算しても、結局誤差が差分に混ざってしまう…ということなのかなと思います。内部処理で入力画像を左右反転すると、左右の概念がある入力画像を覚えさせたいときに混乱が生じることも考えられるので、この改修は結局まるごとボツにしました。