こんばんは、スタジオ真榊です。今回は、2025年10月時点のキャラLoRA作りについての知見をまとめた4万字超の特集記事です。スタジオ真榊ではこれまで、1枚しかないイラストからデータセットを量産してキャラLoRAにしたり、着替え可能なタギングについて掘り下げたりといったLoRA特集をたくさん連載してきましたが、いったんそれらを総まとめして、キャラLoRAの学習に必要な知識を網羅的に理解できる大型記事としました。
学習ではなく、「LoRAとは何で、どうやって使用するか」といった生成の基本はこちらをご参照ください。
この記事では最低限Stability MatrixでSDwebUI「reForge」を動かせる人向けに、ローカルにおけるLoRA学習の環境構築のやり方を解説しています。具体的には、人気のillustriousXL系モデルの学習を念頭に、
①学習用のキャラ画像を数枚~数十枚準備して、
②「WD1.4tagger」と「Dataset tag Editor」という拡張機能を導入して「タグ付け」をし、
③「Kohya LoRA Param GUI」という学習用アプリを使って、
④この記事で配布するキャラ学習用プリセットで簡単学習する
…というところまでの流れと必要知識を一気通貫でまとめました。その上で、できたLoRAで生成実験を行い、LoRA学習時のタグ付けや各種設定をどのようにすべきかなどを考察してみたいと思います。
1.キャラLoRAの基礎知識
LoRAにもいろいろありますが、最もメジャーで誰もが利用したことがあるのがキャラLoRAでしょう。キャラLoRAはその名の通り、あるキャラクターの容姿を学習しているLoRAで、既存モデルが学習できていない新しい作品のキャラクターや、マイナーなキャラクター、オリジナルキャラクターなどを安定的に再現するためのものです。
有名作品のキャラは基本的にCivitaiですぐに流通する(▲)ので、わざわざ自分でデータセットを用意してまで作らなくてもよいかもしれませんが、そこまで有名でないキャラクターやオリジナルキャラクターを一貫性を持って再現できるようにしたい場合、自分で追加学習をするしかありません。
・「学習段階」の著作権侵害ポイント
キャラLoRA作りで初めて画像生成AIの学習に触れるユーザーが多いと思いますので。改めて注意ポイントをおさらいしておきます。(こちらの記事のかんたん振り返りです)
まず、学習でなく生成段階での著作権侵害ポイントから振り返っておくと、こちらは「類似性」と「依拠性」の両方を満たした画像になっていないかということでした。すなわち、既存の著作物(他者の著作権で保護されているもの)に意識的に依拠して、表現上の本質的特徴が類似したものを作る行為は、手描きでもAIでも著作権侵害になる…というのが基本です。一方、今回問題になる学習段階でやってはいけないことを理解するには、日本の著作権法における「享受」の概念を理解する必要があります。
享受というのは、著作権法第30条の4にある"著作物に表現された思想又は感情の享受"という部分のこと。文化庁は以下のように説明しており、享受目的が併存していた場合、著作権者に許諾を取らないと画像収集行為が違法になるという整理をしています。
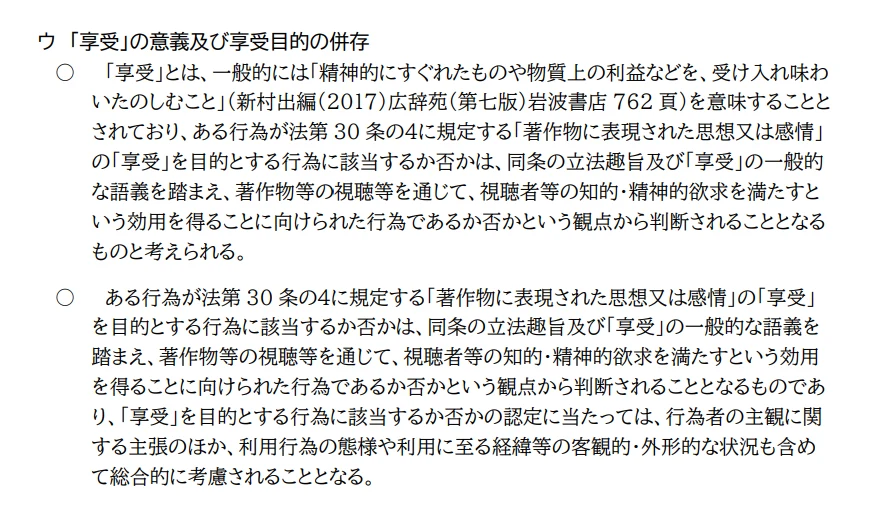
(▲文化庁「AIと著作権について」10pより引用)
詳しくは「AIと著作権について」を熟読していただくとして、理解しておきたいのは「AI学習のための画像収集を無断でやっていいのは、学習した著作物と同じものを出すのが目的ではない(生成物に"変容性"がある)から。学習元の著作物がまんま出てくる(変容性がなく"享受"できる)ようなものを無許諾で作れちゃ当然まずいよね」ということです。極端なことを言えば、ドラゴンボール全巻を学習していて、注文すると1ページずつそのまんま生成できるモデルがあったとしたら、それはもうドラゴンボール全巻を無断で配っているのと同じだよねということですね。
先日OpenAIのSora2が日本のアニメをそのまんま出せることで物議を醸し、結局すぐにナーフされましたが、このように国内の権利保護団体から抗議声明が出される事態となりました。
記事本文には「Sora 2のように特定の著作物が出力として再現・類似生成されている状況においては、学習過程での複製行為そのものが、著作権侵害に該当し得る」という団体の見解が書かれていますが、「し得る」というところがポイントで、じゃあ出力がどこまで「そのもの」だったら権利侵害で、どこまでが無許諾でOKなラインなのかは裁判所が判断するところです。
しかしながら、我々学習をこれからするユーザーにとっては、裁判所で勝てるかどうかよりもまず「訴えられないこと」が最重要。つまり、あからさまに学習した原作そのものなタッチだったり、原作のシーンをそのまんま再現してしまうようなLoRAを作った場合、そのデータセットの収集行為そのものが違法になる恐れがあるーというのはまず理解しておきましょう。
このあたりは文化庁の「AIと著作権に関するチェックリスト&ガイダンス」によくまとまっています。以下の③ですね。
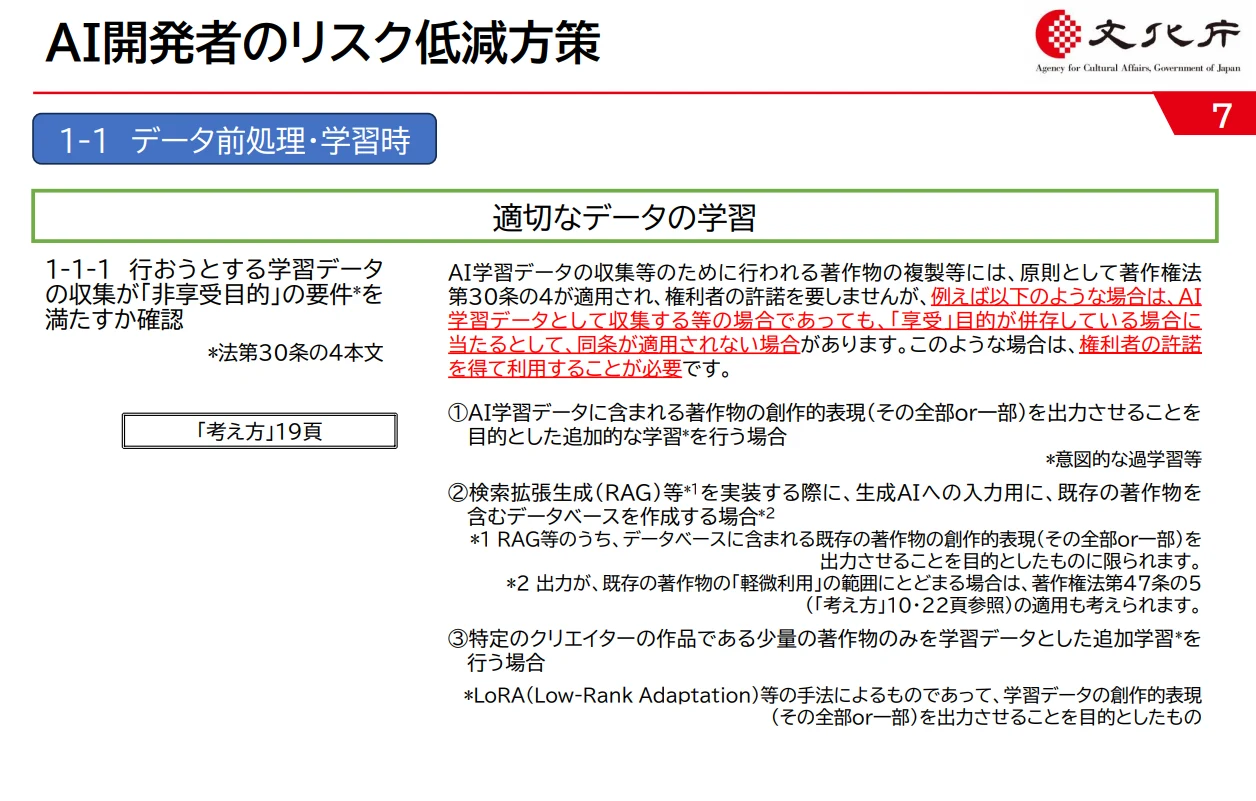
いわゆる「狙い撃ちLoRA」を学習する場合、「作風だけではなく創作的表現まで出力することがあり、そうしたLoRAを作る目的での無許諾学習(に伴う画像複製行為)は享受目的が併存していて違法ですよ」ということが書かれていますので、自分のこれからやるデータセット収集はどういうLoRAをつくる目的なのか、今一度よく確認しておきましょう。
・学習に必要な機材
自分のパソコンを使った学習には、生成以上にパワフルなVRAM容量を備えたグラフィックボードがほしいところです。具体的に言うと、RTX3000番台~4000番台、VRAM12GB以上の製品から、ストレスなく学習を楽しめるようになるという感覚です。シンプルなキャラLoRAであれば、RTX3060(VRAM12GB)で30~40分程度、RTX4080(VRAM16GB)で20~30分程度で学習できます。
現在流通しているグラボでいうと、ハイエンドはRTX 5070Ti(VRAM16GB、12万円台~)以上、ミドルクラスでRTX 5060Ti(16GB、7万円台)あたり、低予算ならやはりRTX3060(12GB、3万円台後半)が選択肢かと思います。初めてで予算が限られているなら3060一択ですが、AIイラストは学習ができるようになるといよいよ楽しくなってきますので、ここを読んでいるならちょっと頑張って16GBを選択することをおすすめします。年末には24GB搭載の新型「RTX 5080 Super」や「5070 Ti SUPER」が投入されるという噂もありますので、悩ましいところですね。

2.データセットを作ろう(画像集め編)
では、さっそくキャラLoRAの作り方に入っていきます。まずは「何のキャラLoRAをどんなバリエーションで作りたいか」を考えるところからです。オリジナルキャラクターであれば自分の手で描くか、画像生成で少なくとも1枚はそのキャラクターの全身デザインが分かるイラストを準備する必要がありますし、既存のキャラクターであれば、その容姿を捉えた画像をウェブ上から収集することになります。また、複数の衣装や髪型バリエーションを持つキャラクターの場合、そのバリエーションを学習するかも問題になります。
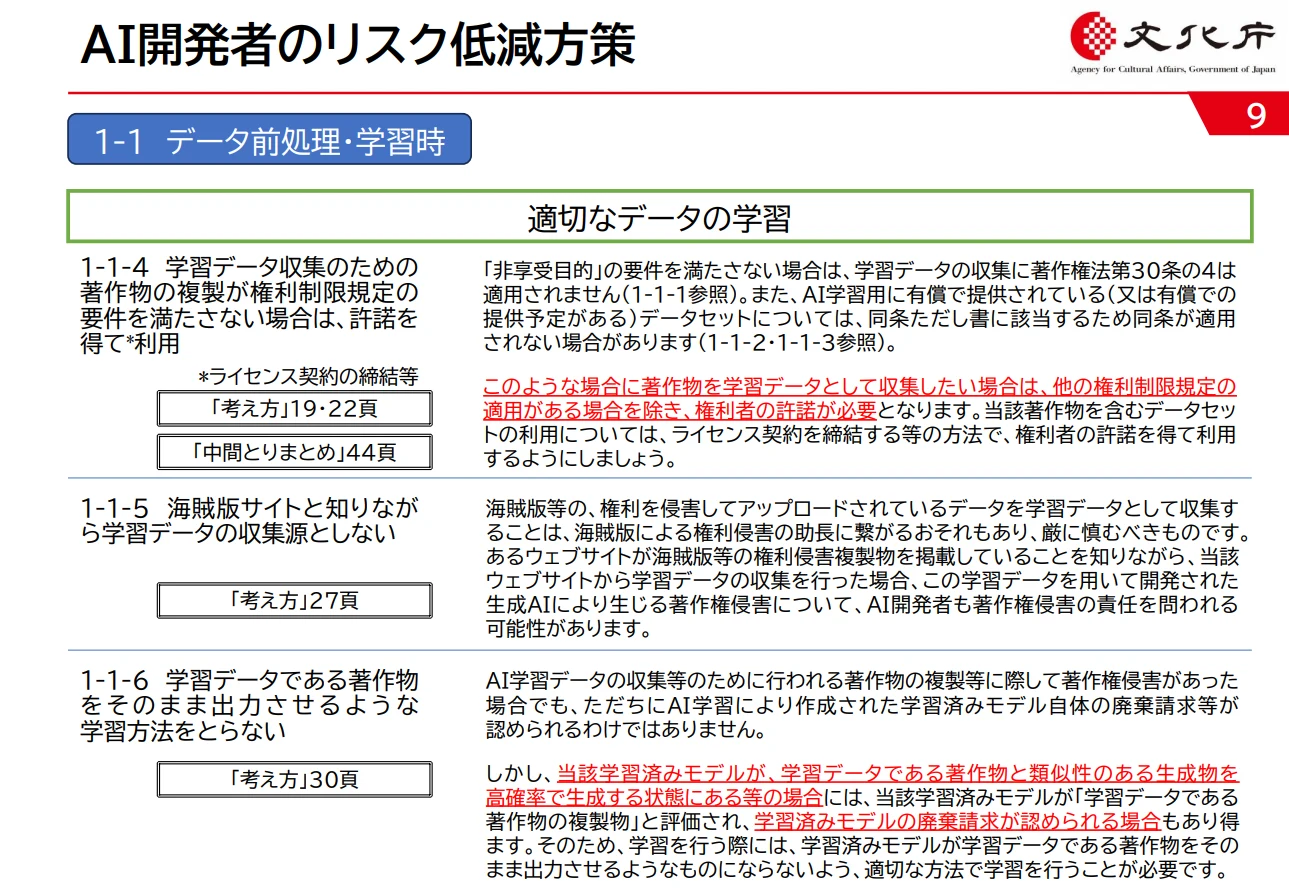
後者の場合、文化庁の「ガイダンス」の下記ページを参考に、リスクの高いデータセット収集は行わないよう気を付ける必要があります。特に、生成結果を見たら「誰が権利を持つ何を学習させたか一発で分かってしまう」ような場合は高リスクとなります。Sora2は思いっきり日本の公式アニメを学習させていることが絵柄や音声、背景などから丸わかりでしたね。
・キャラLoRA学習に適したデータセットとは
画像収集のポイントは次の5つ。
①追加学習させたい被写体・概念が大きく鮮明・共通に描かれていて、
②学習させたくない「余計な概念」が映り込んでおらず、
③角度や表情、性別などさまざまなバリエーションがある画像を、
④できるだけたくさん集めること。
⑤迷ったら量より質!(最重要)
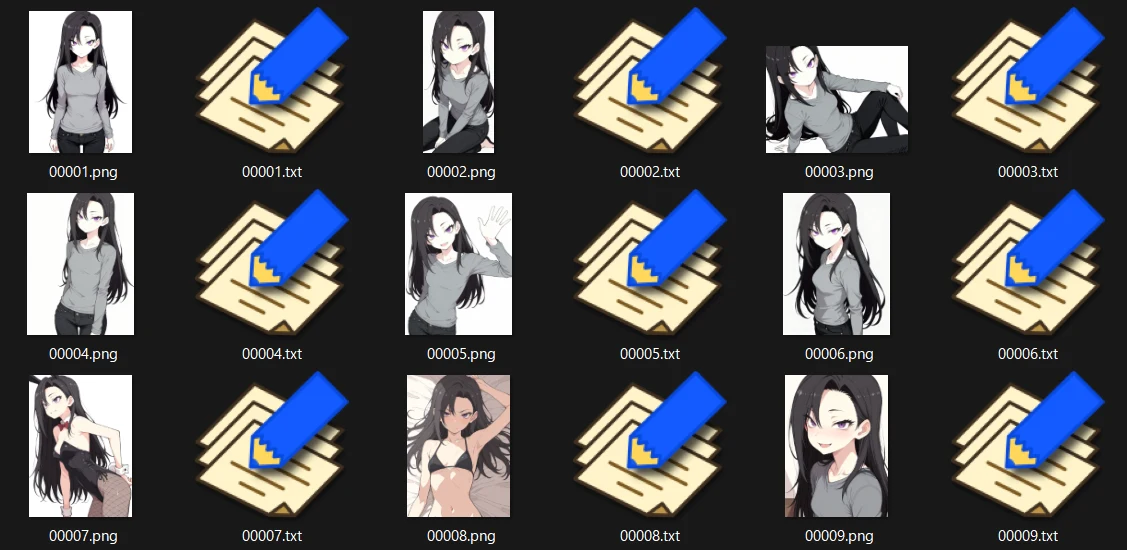
▲キャラLoRA用データセットの例
キャラLoRA学習は1枚からでも行うことができますが、全身の一貫性があり、ポーズ変更や表情変更などいろいろなプロンプト指示にきちんと応えられるまともなLoRAにしたい場合、15枚くらいは欲しいところです。また、背景にも影響するLoRAにはしたくないので(例えばのび太くんを生成するたびにふすまや机のある彼の部屋が生成されると困る)、大半は学習前に切り抜いて白背景にしておくのが基本です。キャラLoRAの場合、他のキャラが映り込んでいる画像も悪影響を及ぼすので取り除きましょう。
LoRAは、ベースモデルに指定したcheckpoint(例:illustriousXLやWAI SDXL等)と
データセットに入れた画像を見比べて、「差異」をタグとともに学習するものです。例えば、1girlとだけ書かれた女の子の画像をデータセットとして与えると、「1girlってこういうものだと思ってたけど(ベースモデルの概念)、このLoRAが適用されて1girlって言われたらこういう風(データセットの概念)に補正するね!」という仕組み。よって、キャラLoRAを作る際に背景が全て海だと、「キャラ+海背景LoRA」になってしまいやすいわけですね。タギングをうまくやることで多少はましになりますが、基本的に「データセットに共通するものは学習される」という認識を持っておきましょう。
つまり、顔のアップが大半を占めていると、顔がやたらアップで描かれやすいキャラLoRAになってしまい、普段使いが難しくなってしまいます。こちらのスクリーンショットは、「cowboy shot」指示をするとほとんどこの画角になってしまう失敗LoRAの例。full bodyなら全身が、cowboy shotなら腰から上が、portraitなら胸から上がきれいに指示通り出るLoRAにしたいので、それらのバランスが取れたデータセットにする必要があります。
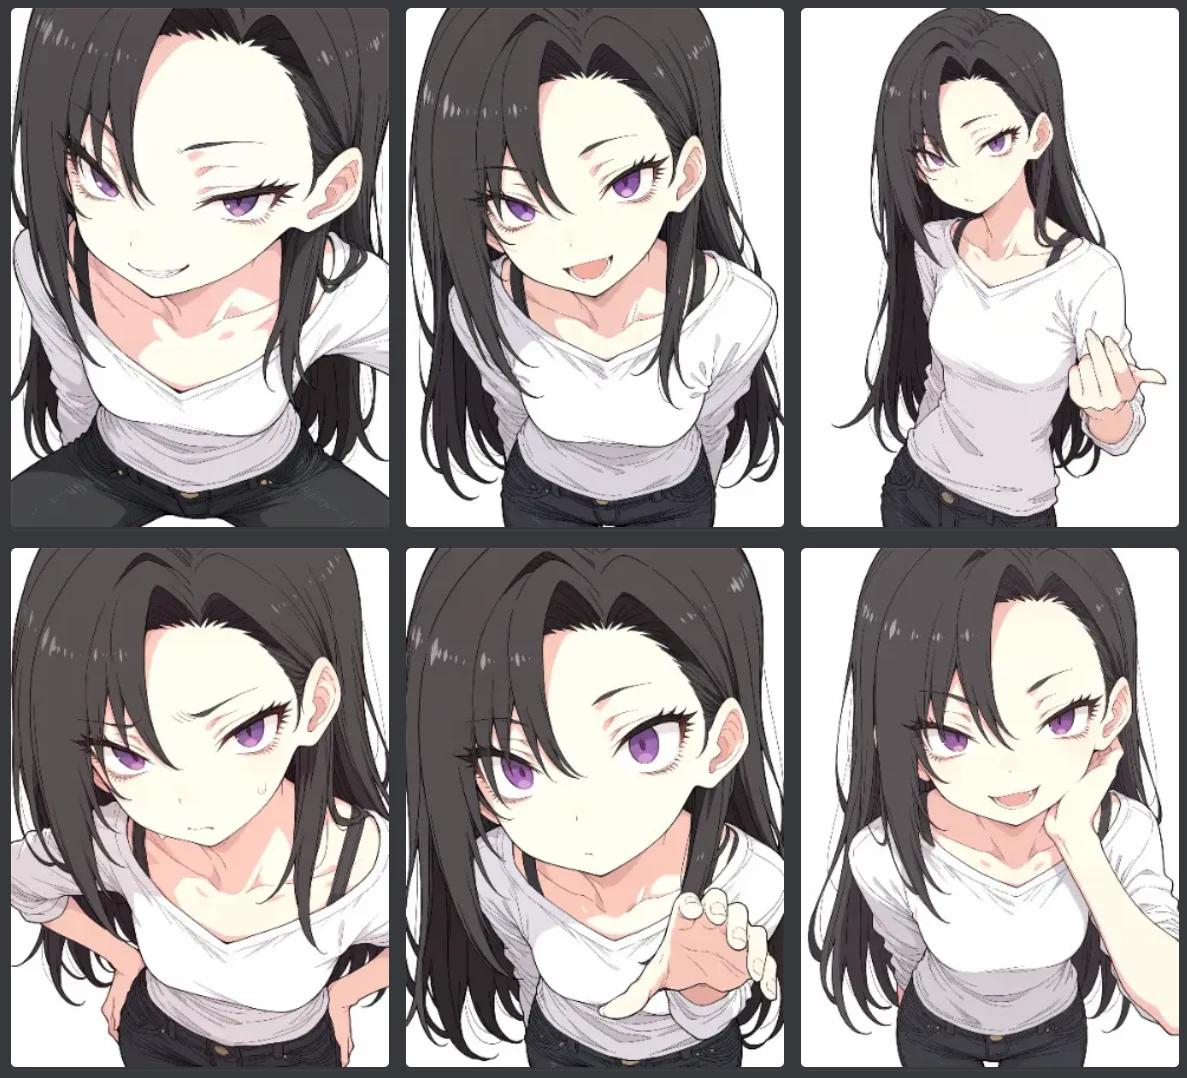
また、上の画像のようにすべて黒デニム+白T+ブラ紐見えの服装だと、生成時もその服装で描かれやすいLoRAになります。常にその服装で描いてほしい場合はそれが正解なのですが、プロンプト指示で別衣装に着替えさせたい場合は、データセットもできるだけバリエーションのある服装で準備したほうがよいでしょう。
・画風も覚えるか?覚えたくないか?
最初に意識しておきたいのは、「これから作るキャラLoRAには画風も覚えてほしいのか?」「それとも画風はいっさい覚えてほしくないのか?」ということです。皆さんそれぞれローカル生成で使っているcheckpointは違うと思いますが、せっかくできたLoRAがデータセットの画風に引っ張られていると、そのキャラLoRAを使ったときだけ普段使いのcheckpointと違う画風になってしまって困りますね。では、画風はすべて排除したほうがいいのでしょうか?
ここでちょっと、ドラゴンボールの悟空のキャラクターデザインを思い出してみましょう。悟空のあの特徴的な目は、果たしてキャラクターデザインなのでしょうか?それとも、故鳥山明先生の画風なのでしょうか?
さまざまな有名作家さんの手によるこちらのイラストを見ていると、鳥山先生の絵に大きく寄せたものもあれば、ご自身の普段の絵柄で描いたものもありますね。もしこのように、ツンツンした髪の毛や山吹色の胴着などは共通しているけれども、顔立ちや頭身などはバラバラの画像群でLoRAを学習させたら、我々が悟空と感じるキャラLoRAではなく、そのモデルの素のキャラクターが悟空のコスプレをしていると感じるLoRAになるでしょう。
このことを突き詰めていくと、キャラクターによって、画風と強固に印象が結び付いたキャラクターと、そうではないキャラクターがいることにも気付きます。例えば初音ミクはさまざまな画風で描かれることが多く、原作と全く違う画風だったとしても髪型やニュアンスで「ミク本人だ」と感じてもらいやすいキャラクターですね。一方、クレヨンしんちゃんのように画風とキャラデザが強固に結び付いたキャラは、画風や頭身がちょっと変わっただけで「別人」に見えてしまいそうです。
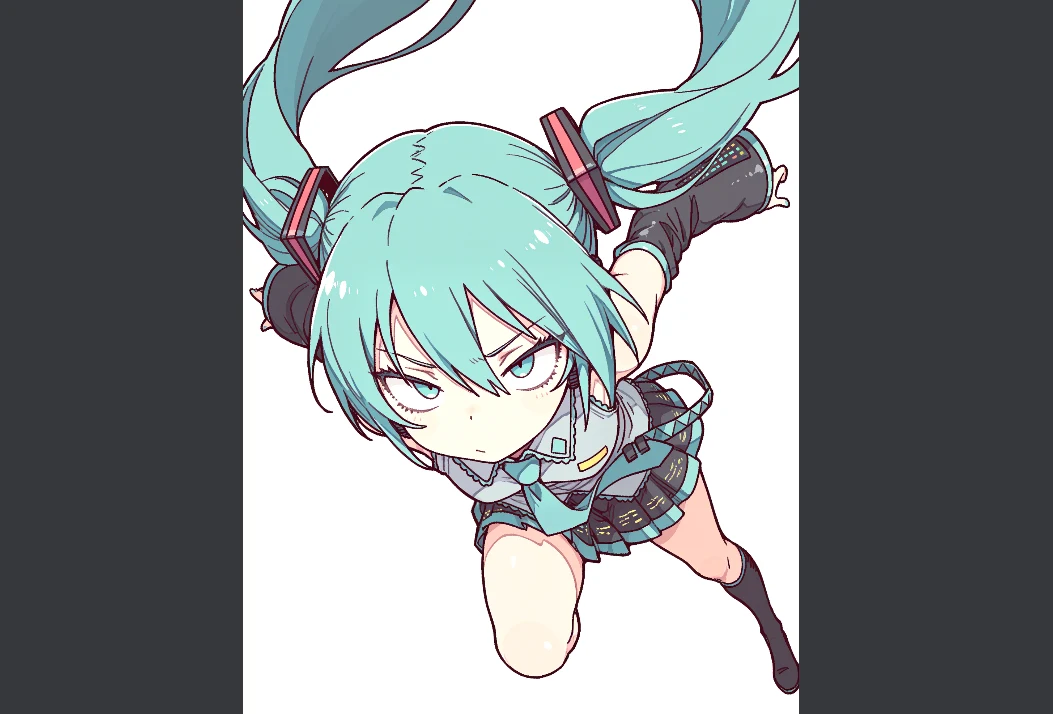
AIはキャラクターも画風も背景も区別がつかないので、学習時は人間がデータセットによってその違いを教えてあげないと、思ったようなLoRAを作ることができません。キャラLoRAを作る場合は、顔立ち以外の髪型や服装だけを似せる「コスプレLoRA」程度でよいのか、それとも顔立ちも含めてがっつり原作に寄せる「本人LoRA」にするのか、もしそうならどれくらい「寄せる」のかを考えてデータセットを準備する必要があります。
有名作家たちの悟空のように画風をばらけさせたものを覚えさせれば前者に、すべて公式の悟空で覚えさせると後者になります。そしてSora2を見ていると分かるように、後者は「取り扱い注意」ということになります。

では、どうやって白背景かつバリエーション豊かで、普段のcheckpointの画風に影響の少ないデータセットを準備するべきでしょうか。作りたいのが既存キャラの場合と、オリジナルキャラの場合で分けて考えてみます。
①既存キャラクターの場合
既存キャラの場合は、そのキャラクターがきれいに描かれた全身図をまず入手すべきです。データセットはウェブから収集したものだけで構成してもよいのですが、すべて公式画像だけで集めた場合、「キャラLoRA」ではなく「公式絵柄+キャラLoRA」になってしまうので、絵柄はできるだけばらけさせたほうがよいとされます。よって、イラストサイトなど無料で公開されている(誰でも見られる)ものから収集することになりますが、ウォーターマークなどで「AI学習禁止」と明確に意思表示されているものは避けたほうが良いでしょう。
日本の著作権法上、「AI学習禁止」と掲示することで著作30条の4が認める無許諾学習を違法にできるかどうかはこの際関係なく、キャラLoRAを作るにあたって、そうしたリスクを冒す必要はさほどないのが理由です。いまはリファレンス機能によってある程度似通った画像(同キャラ別ポーズ)を出すことができますし、いったんできたLoRAの性能がいまいちだったとしても、その不完全なLoRAでデータセットを水増しすることも簡単にできるようになりました。
NovelAIのリファレンス機能「キャラ参照」についてはこちら。絵柄が多少ぶれるので、むしろ絵柄への影響を少なくしたいキャラLoRA作りには向いています。
ちなみにSeedream4やNanoBananaも1枚の画像からさまざまなバリエーションを作ることができますが、NovelAIと違って規約上、生成画像を別のモデルの学習に使うことが禁じられていますのでご注意ください。
キャラLoRA用にウェブ上から画像を収集する際は、特に「余計な概念」の写り込みに気を配りましょう。背景は以下の方法で消したほうがよいですし、他のキャラクターが映り込んでいる画像は1枚も入れないようにします。別キャラ部分をトリミングするか、不採用にすべきです。データセット全てが1girl(もしくは1boy),soloの状態であるのがキャラLoRAの基本です。
・背景の消し方
画風LoRAや背景LoRAを作りたい場合は別ですが、キャラクターや服などの「前景」を追加学習させたい場合、背景を削除してしまったほうが品質がよくなります。Photoshopの「背景を削除」機能は非常に高性能でオススメですが、Adobe納税者ではない方はこちらのSDwebUI拡張機能「RemBG」を使うとよいでしょう。導入方法はこちらのURLを「URLからインストール」に放り込むか、拡張機能リストの中から「stable-diffusion-webui-rembg」を見つけてインストールするだけです。
インストールすると、「その他(Extra)」タブにこのようなメニューが追加されています。一番左のプルダウンメニューで、背景削除に使用するモデルを選択しましょう。アニメ調イラストから切り抜くなら「isnet-anime」がおすすめです。
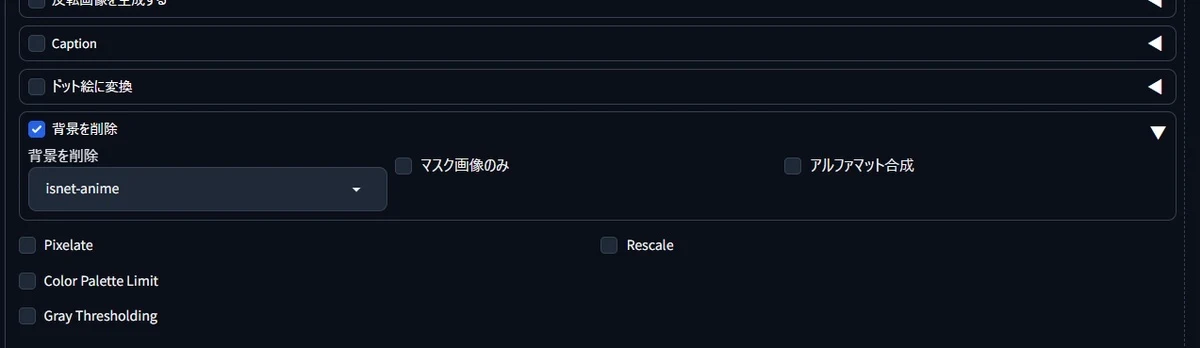
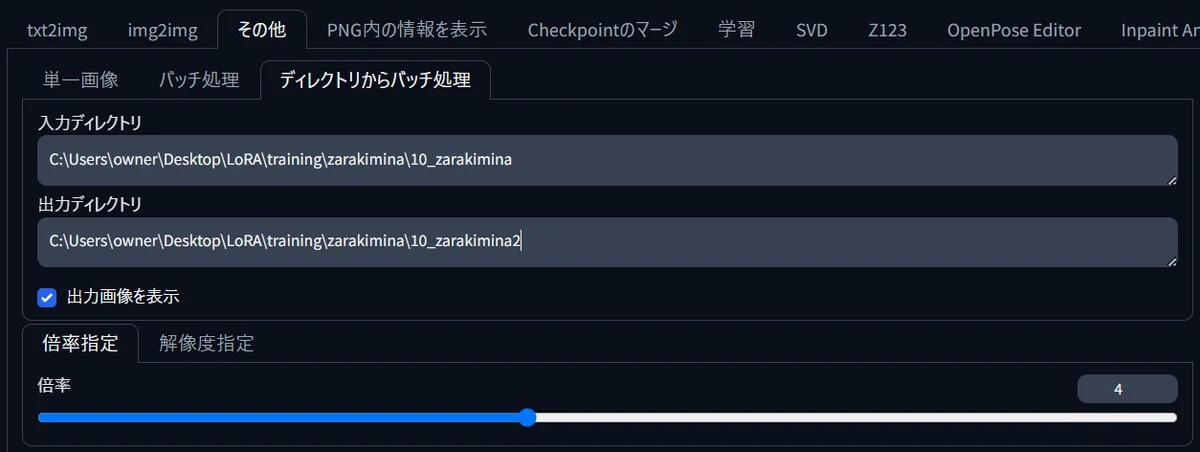
あとは「その他」タブの「ディレクトリからバッチ処理」で、画像保存フォルダを入力ディレクトリに指定すればOK。背景がある絵とない絵が混ざるといけないので、出力ディレクトリは適当な別の名前にしておきましょう。(存在しないフォルダを指定するとそこにその名前のフォルダが作られます)
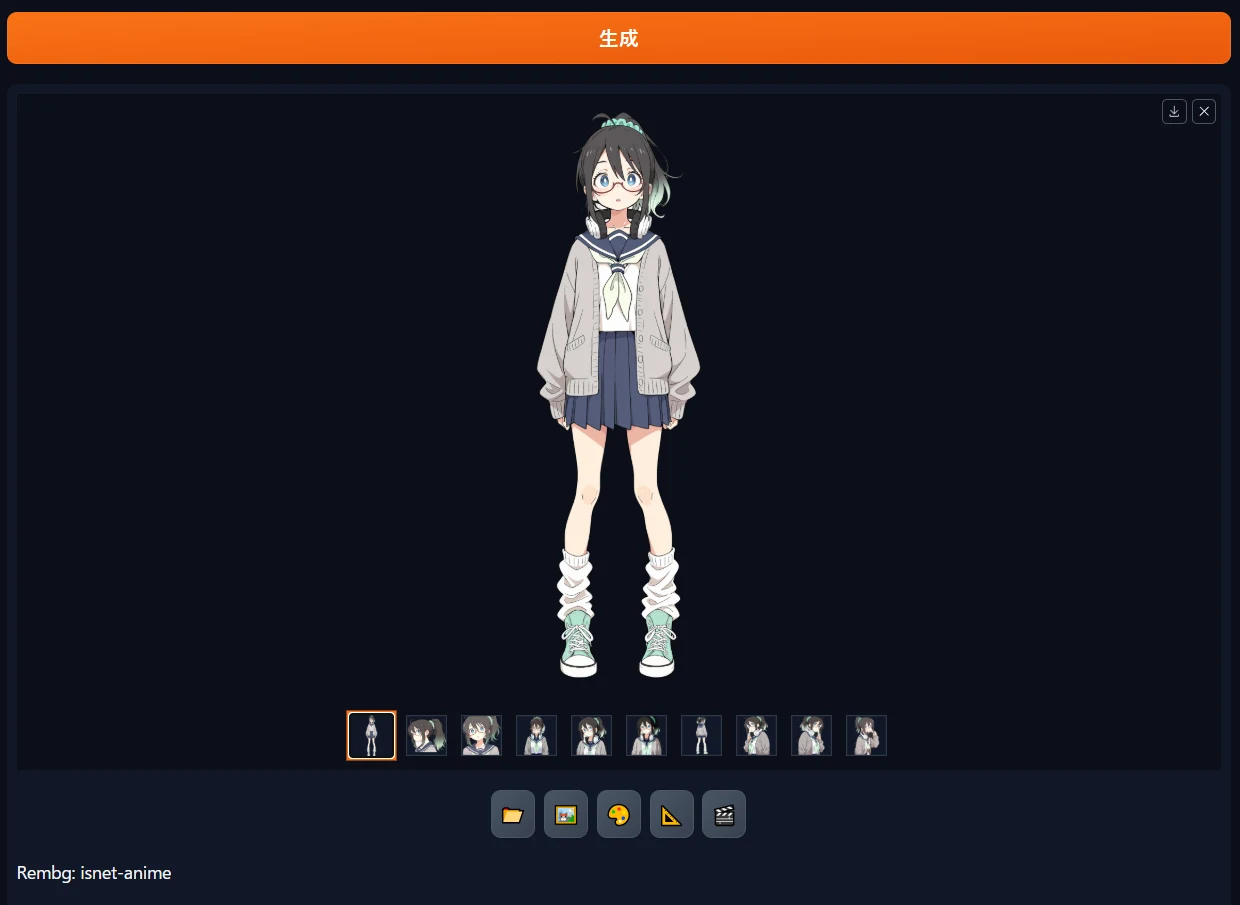
このように背景が一括削除されました。たまに失敗して残すべきところが消えたり、背景が残ってしまったりしていることがありますので、よくチェックしておきましょう。残ってしまった場合は自分で除去するのが手っ取り早いです。
②オリジナルキャラクターの場合
有名キャラクターはすぐにCivitaiなどでLoRAが共有されるので、主に自分で学習したいキャラLoRAといえばオリジナルキャラクターの方が多いでしょう。たまたま生成できたキャラデザをいつでも固定して再現できるようにしたい、というケースも多いと思います。
スタジオ真榊には更木ミナちゃんという赤眼鏡+ポニーテールの女の子のオリキャラがいますが、彼女はふだん次のようなプロンプトで再現されています。
PP:1girl, solo,headphones around neck,white headphones, ponytail, black hair, red-framed eyewear, cardigan, glasses, dark blue sailor collar, blue eyes, looking at viewer, neckerchief, bright pupils, white pupils, ribbon,long sleeves, school uniform, grey cardigan,light green neckerchief,mint scrunchie, hair scrunchie,white shirts, upper teeth only, blue pleated skirt,open clothes, semi-rimless eyewear, under-rim eyewear, open cardigan, medium hair, oversized cardigan,sidelocks,hair between eyes,sleeves past wrist,gradient hair, mint hair,ahoge,oversized sneakers, mint sneakers,converse, loose socks
ただ、タグ指示だけで細部の一貫性を保つのは無理があり、セーラー服やヘッドホンのデザインは基本的に毎回変わってしまいます。彼女はスタジオ設立初期から「時期によってデザインが変わる概念上の存在」という設定なのでこれでよいのですが(笑)、漫画などで一貫したデザインで描きたい場合はさすがにキャラLoRAが必要になります。
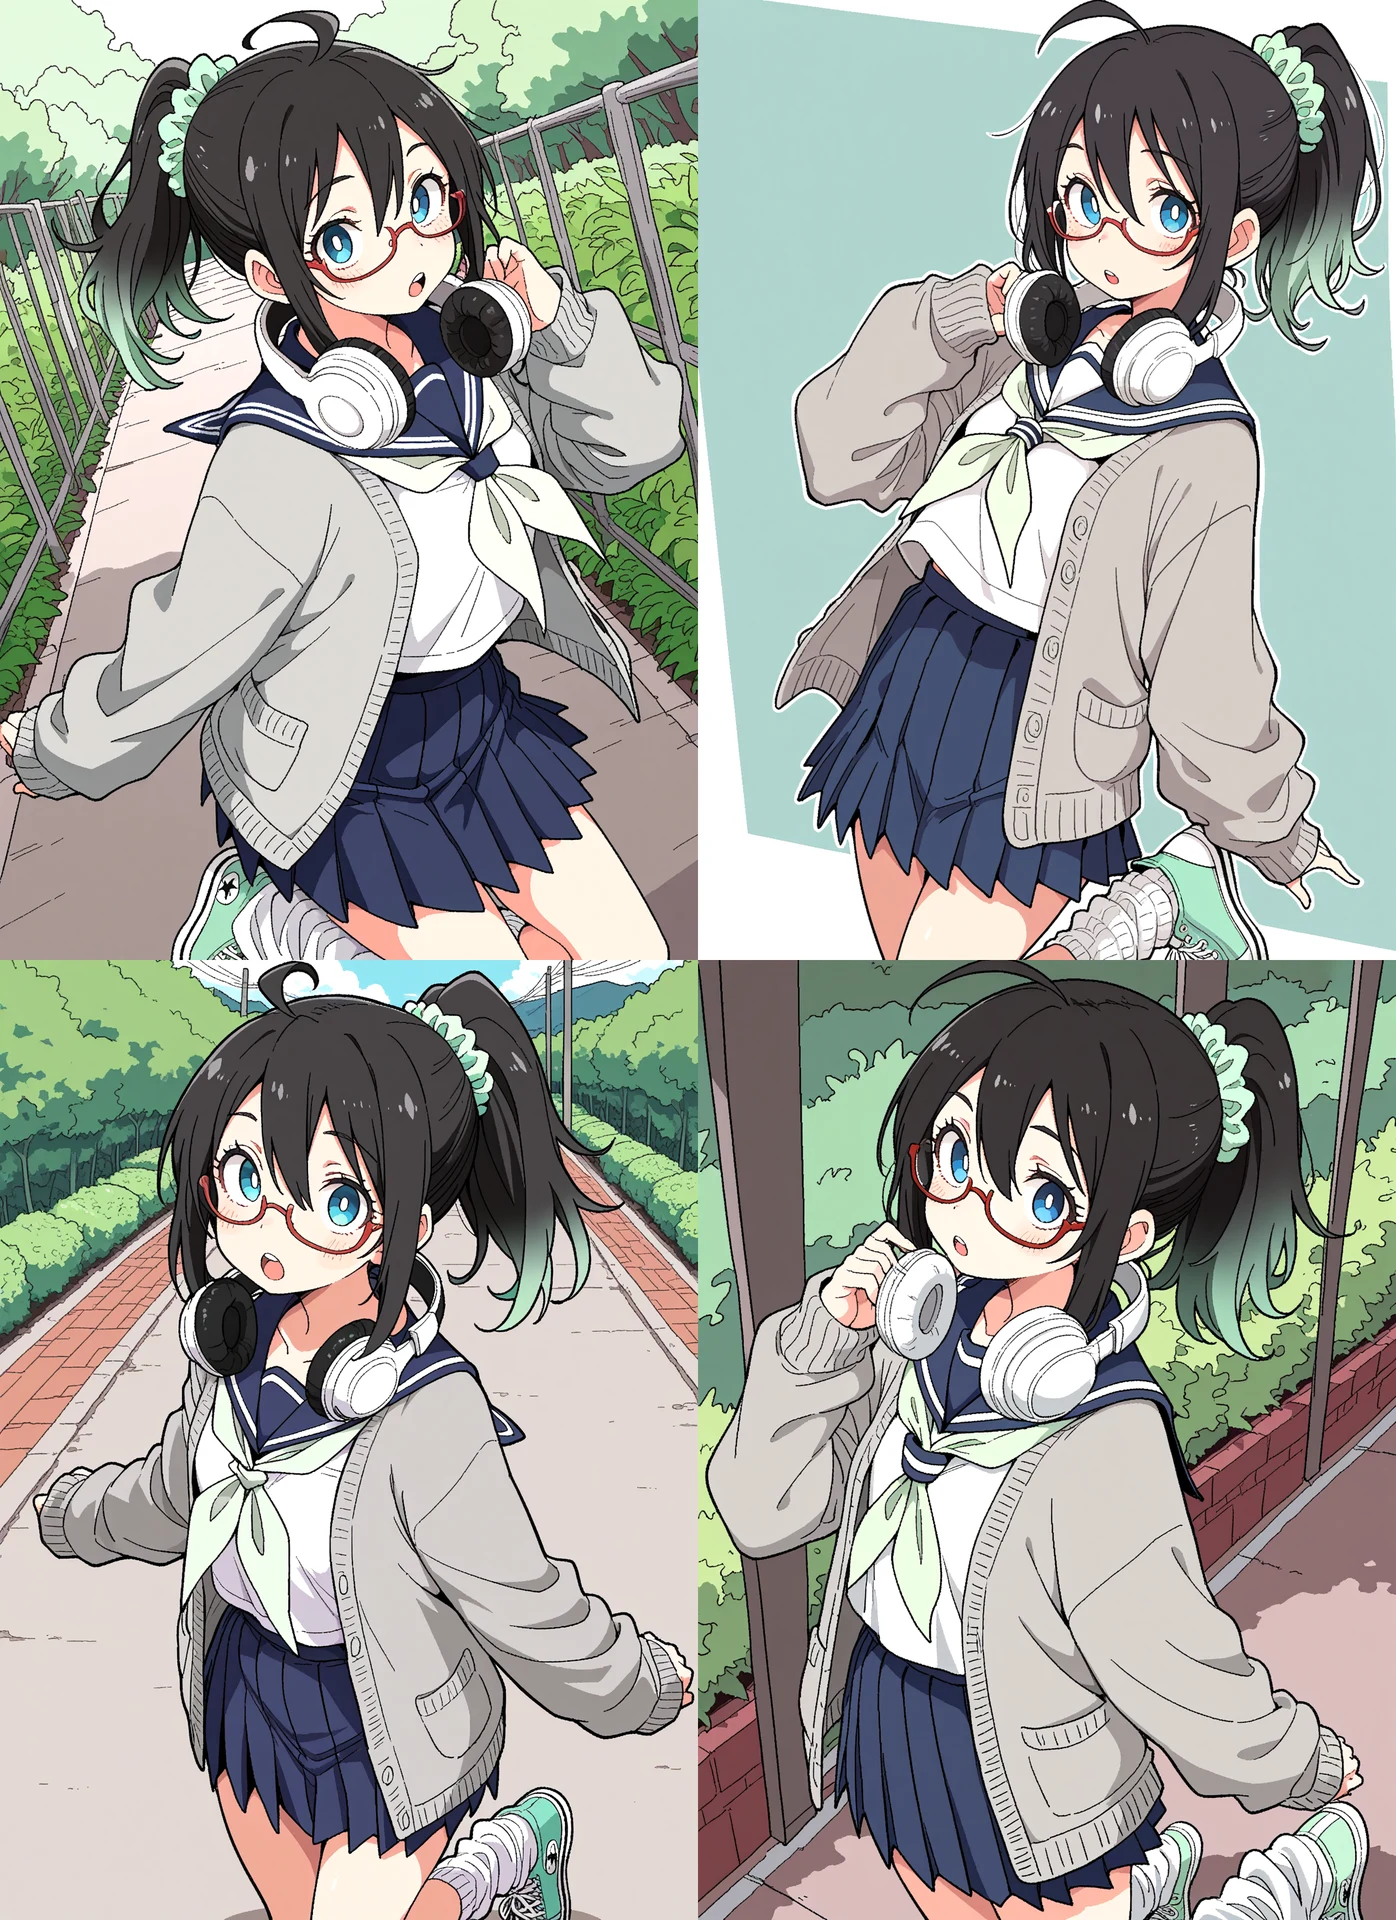
こちらの4枚では、よく見ると胸のリボンの結び目やヘッドフォンのデザイン、カーディガンのボタン位置などがブレてしまっていますね。これをキャラLoRAで確定させたい場合、枚数が少なくなったとしてもかまわないので、できるだけ一貫したデザインで準備する必要があります。1枚でもデザインの違う画像が混じると、誤ったデザインが記憶されてしまうからです。
<まとめ>
・既存キャラをウェブ上から収集した画像で学習させる場合は、画風の偏りと「余計な概念」の除去に気を配ること。特に背景や別キャラの写り込みに注意
・オリジナルキャラを手描き絵やAI絵から学習させる場合は、キャラデザの統一が一番重要。色や衣装などの細部が間違っていると、それもしっかり学習されてしまう
3.画像はどこに保存する?
さて、どういう画像を集めるかが決まったら、データセットにする画像を収納する専用フォルダを準備します。まずは好きな場所にルートフォルダ(例:LoRAフォルダ)を作り、その中にトレーニング画像フォルダ(例:training)を作るのがおすすめ。さらにその中に、これから学習するLoRAごとのフォルダを作るわけですが、画像を保存するのはさらにもう一つ下のフォルダになります(下図では10_zarakiminaと4_sakakiioが画像保存先)
LoRA/ ←ルートフォルダ(名前はなんでもよい。)
└ training/ ←学習データを入れるフォルダ(名前はなんでもよい)
├ zaraki_mina/ ←下のフォルダ以外は空っぽ
└ 10_zaraki_mina/ ←ここに画像を保存する
└ anna_kinugawa/ ←下のフォルダ以外は空っぽ
└ 4_anna_kinugawa/ ←ここに画像を保存する
画像を保存するフォルダの冒頭の数字はリピート数といって、「画像1枚あたり何回学習するか」の指示になります。回数が多すぎると学習に時間がかかり、やりすぎると「過学習」が起こって失敗LoRAになりやすくなります。画像を入れるフォルダを複数に分けて、「このフォルダは重点的に学習して」「このフォルダは軽めに覚えて」と傾斜をつけることもできます。
ここの数字をどう設定すべきかはあとで説明しますので、ここでは何も考えず、かけ合わせたら200前後になる数字を入れることにしましょう。用意した画像が20枚くらいなら10、50枚くらいなら4ということです。この記事では今後、この数字つきフォルダを「画像保存フォルダ」と呼ぶことにします。必ず「trainingフォルダの下は2重構造」「画像保存フォルダの冒頭は数字とアンダースコア(_)」のルールを忘れないようにしてください。
4.「正解」のバリエーションを作るには
さて、版権キャラの場合でもオリキャラの場合でも、データセット画像は白背景で「全身・腰から上・肩から上」「正面、斜め、横から」のバランスが取れていて、キャラデザが全てきちんと一致しており、複数の表情バリエーションがあるものが経験上好ましいと感じています。つい可愛く描かれているアップの絵を選びがちなのですが、足先まで描かれた水平からの全身図は多めにしたほうがよく、俯瞰やアオリの画像はできるだけ少ない方がよい結果になります。
背後からの画像もできればあったほうがよいのですが、多すぎるとやたら背面の描かれるキャラLoRAになってしまうので、ごく少なくてOKです。手の描写も覚えてほしいなら、手がきちんと描かれている画像を混ぜましょう。逆に、手が映った画像がデータセットの中に一枚もないと、ベースモデルが覚えている手の画風になります。
・学習失敗につながる要注意画像
先ほども触れましたが、キャラLoRAにおいてやらかしやすいミスが、こういった顔がアップになっていて、下半身がforeshorteningになっている俯瞰画像をデータセットに入れてしまうことです。
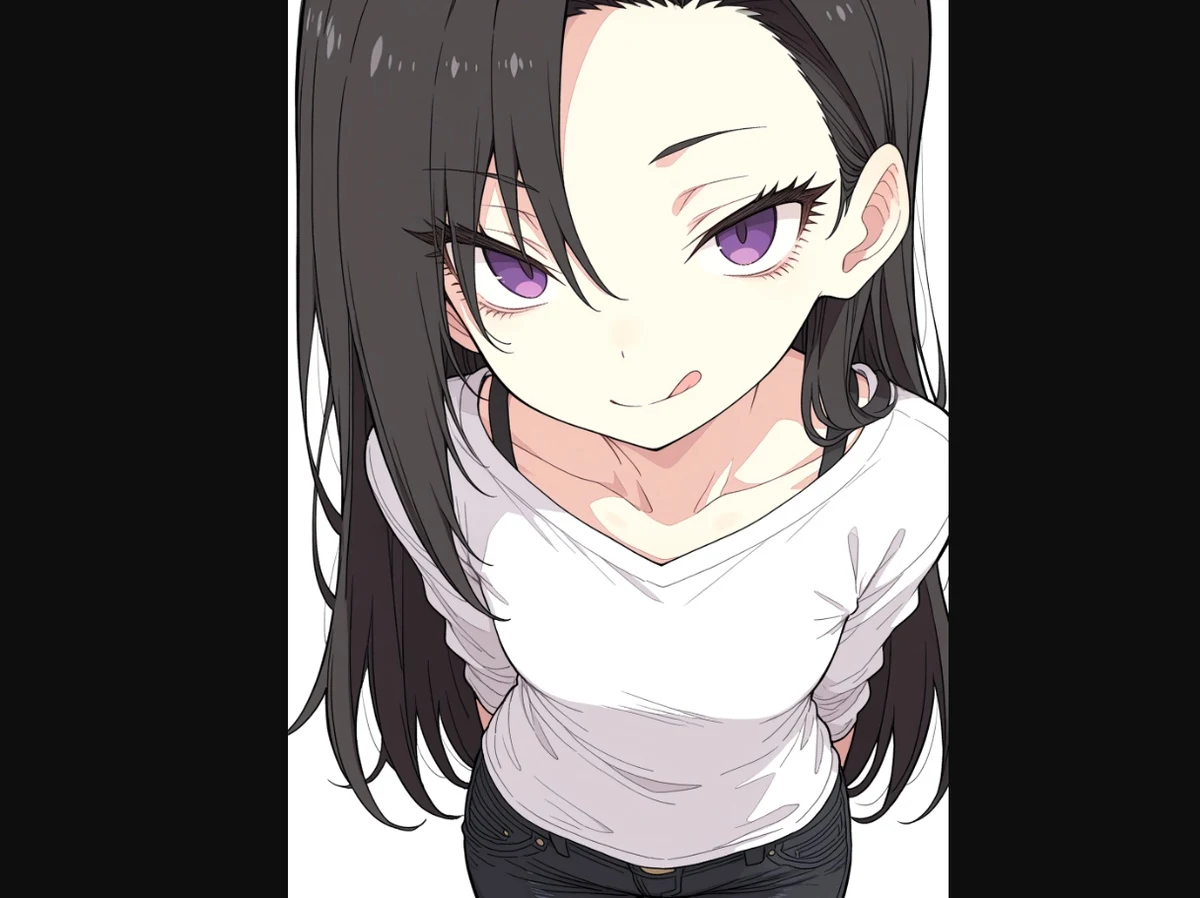
こういう画像は「頭が大きいキャラクター」「手前に前傾するキャラクター」という印象を強く呼び起こすようで、full body指定でもcowboy shot指定でもやたらこの構図で生成する「前傾アップキャラLoRA」に仕上がりがち。慎重にタギングしても悪影響が大きいので、遠近法や俯瞰、アオリが強めに利いた画像はできるだけデータセットに入れないようにしましょう。
そのほか、別のキャラが少し映り込んでいる画像などもキャラLoRAには不向きです。「1人の画像だけだと他のキャラと絡ませられなくなってしまうのでは?」「白背景しか生成できなくなるのでは?」と心配になりますが、そんなことはありませんのでご心配なく。
・「正解」が一枚しかないときは?
生成中にたまたま出てきた素敵なキャラクターを、ぜひまた再現したいと思うことは多いと思います。しかし、手元に一枚しかそのキャラの画像がない場合、データセットをどのように準備すればよいでしょうか。
動画生成AIを使って別カットを作る手法も一貫性保持力は高いのですが、絵柄がほどよくばらけてくれるNovelAIを使うのが現状では良いように思います。さきほども紹介したこちらの記事でやり方を詳しく解説しています。
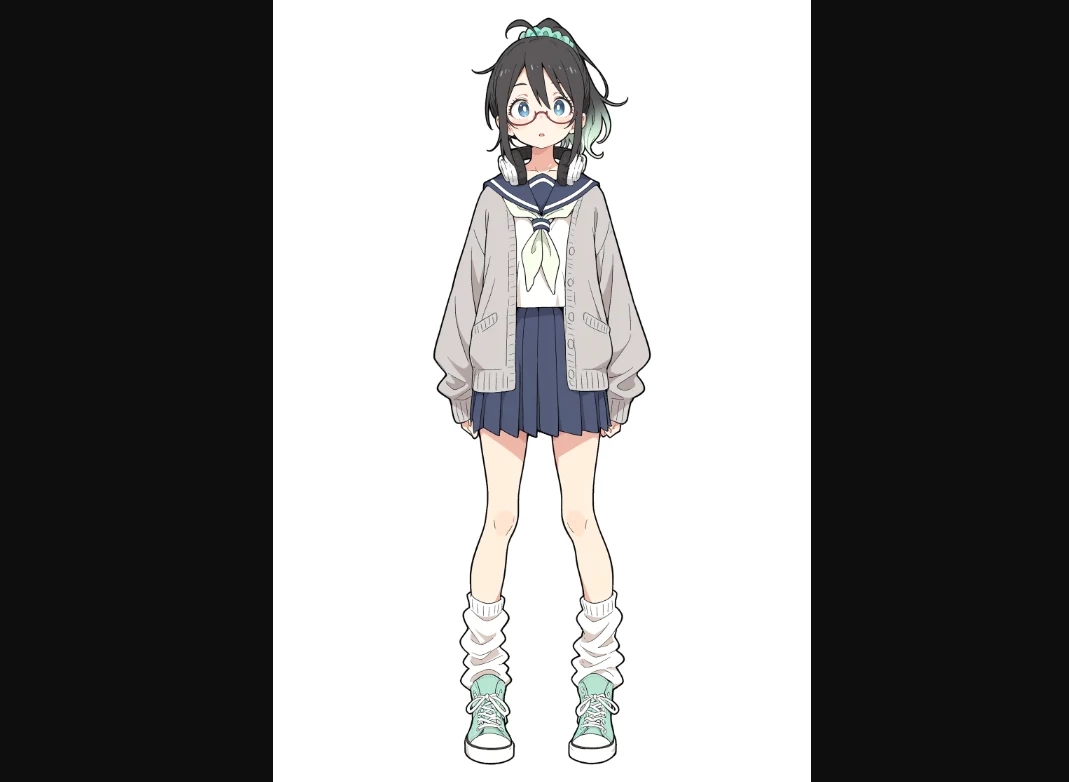
例として、こちらのキャラクター(ミナちゃん)のキャラLoRAを作ってみます。全身像のデザインは、これが「正解」ということにしましょう。さらに、細部を再現できるようなバリエーションを用意する必要があります。
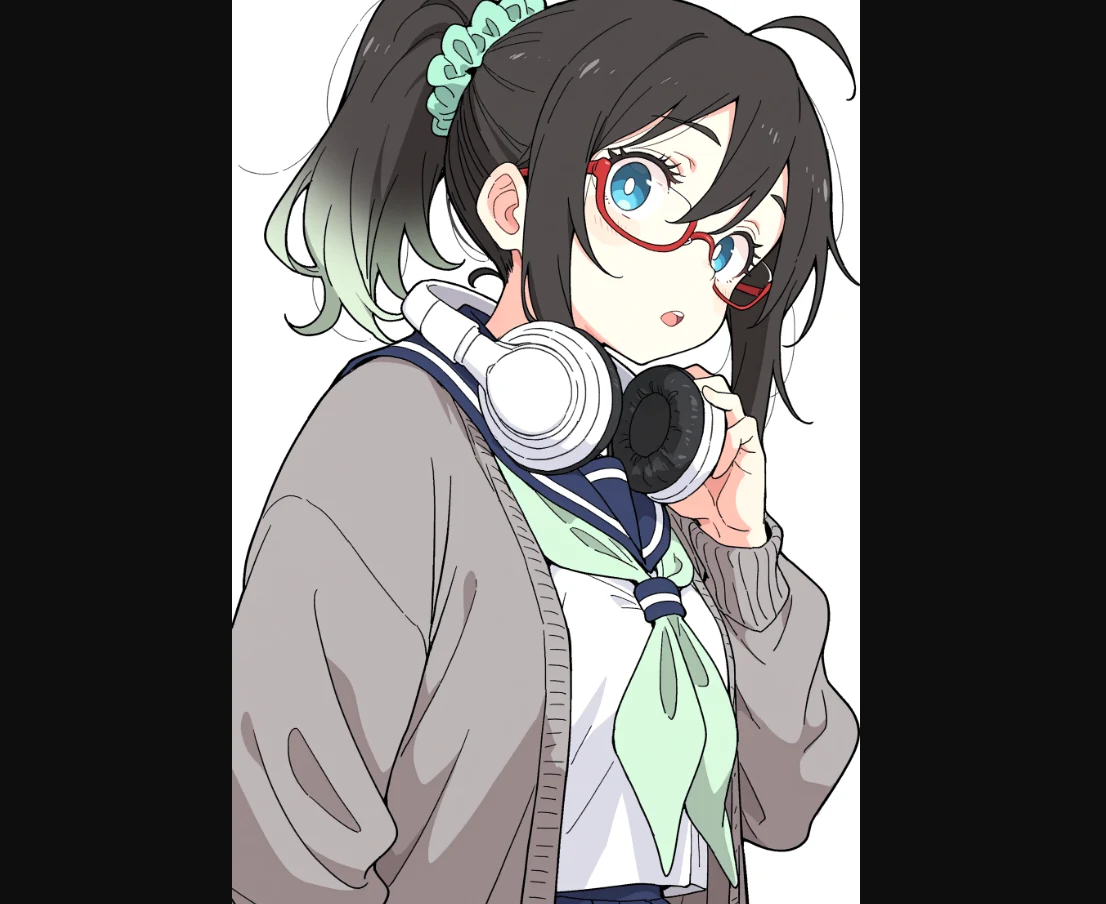
こちらが左から見たアップのミナちゃんです。リボンタイの結び目の色やセーラー服の肩ラインがちゃんと上の画像と同じ一本になっていることを確認します。違っていたら生成やり直し。もしくは加筆、インペイントで直します。その上で、ヘッドホンにマークを付けてみます。
このように、スタジオ真榊のマークを画像編集ソフトでいれてみました。これでは向こう側がどうなっているか分からないので、左右反転したものも入れておきましょう。
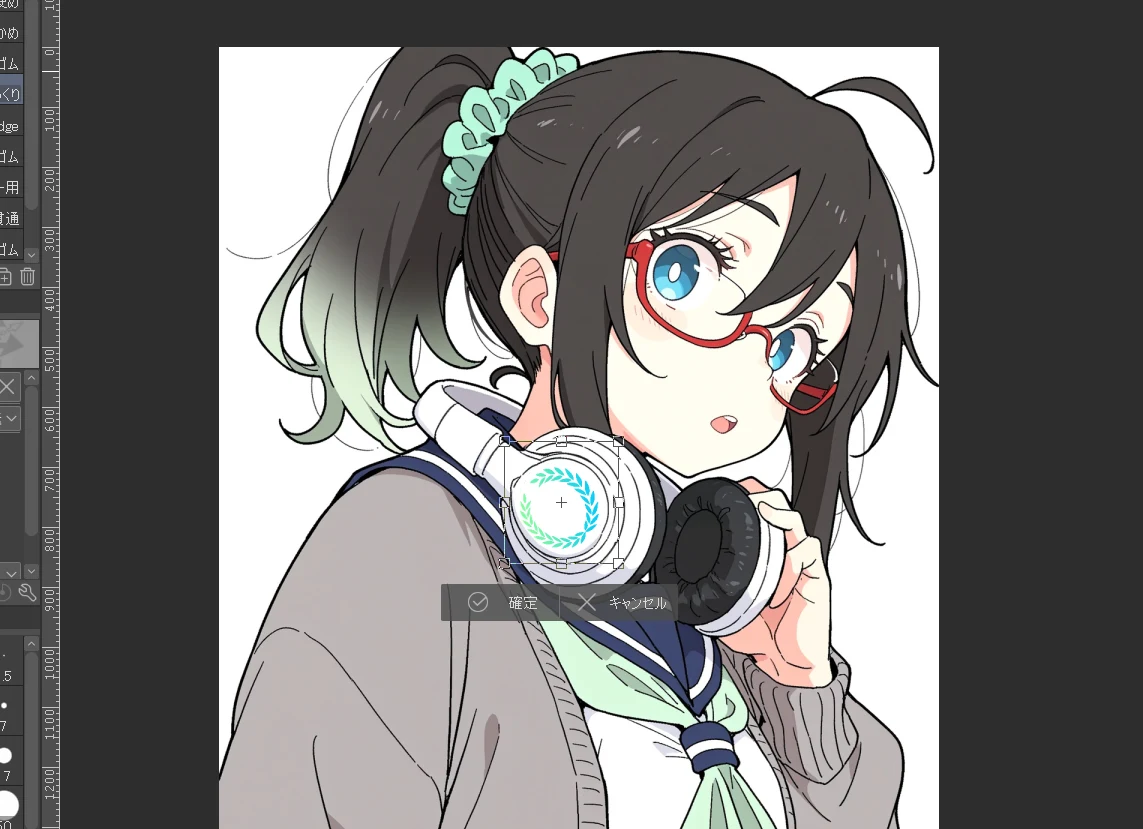
いまどきはデフォルトの写真アプリでも簡単に左右反転できますね。
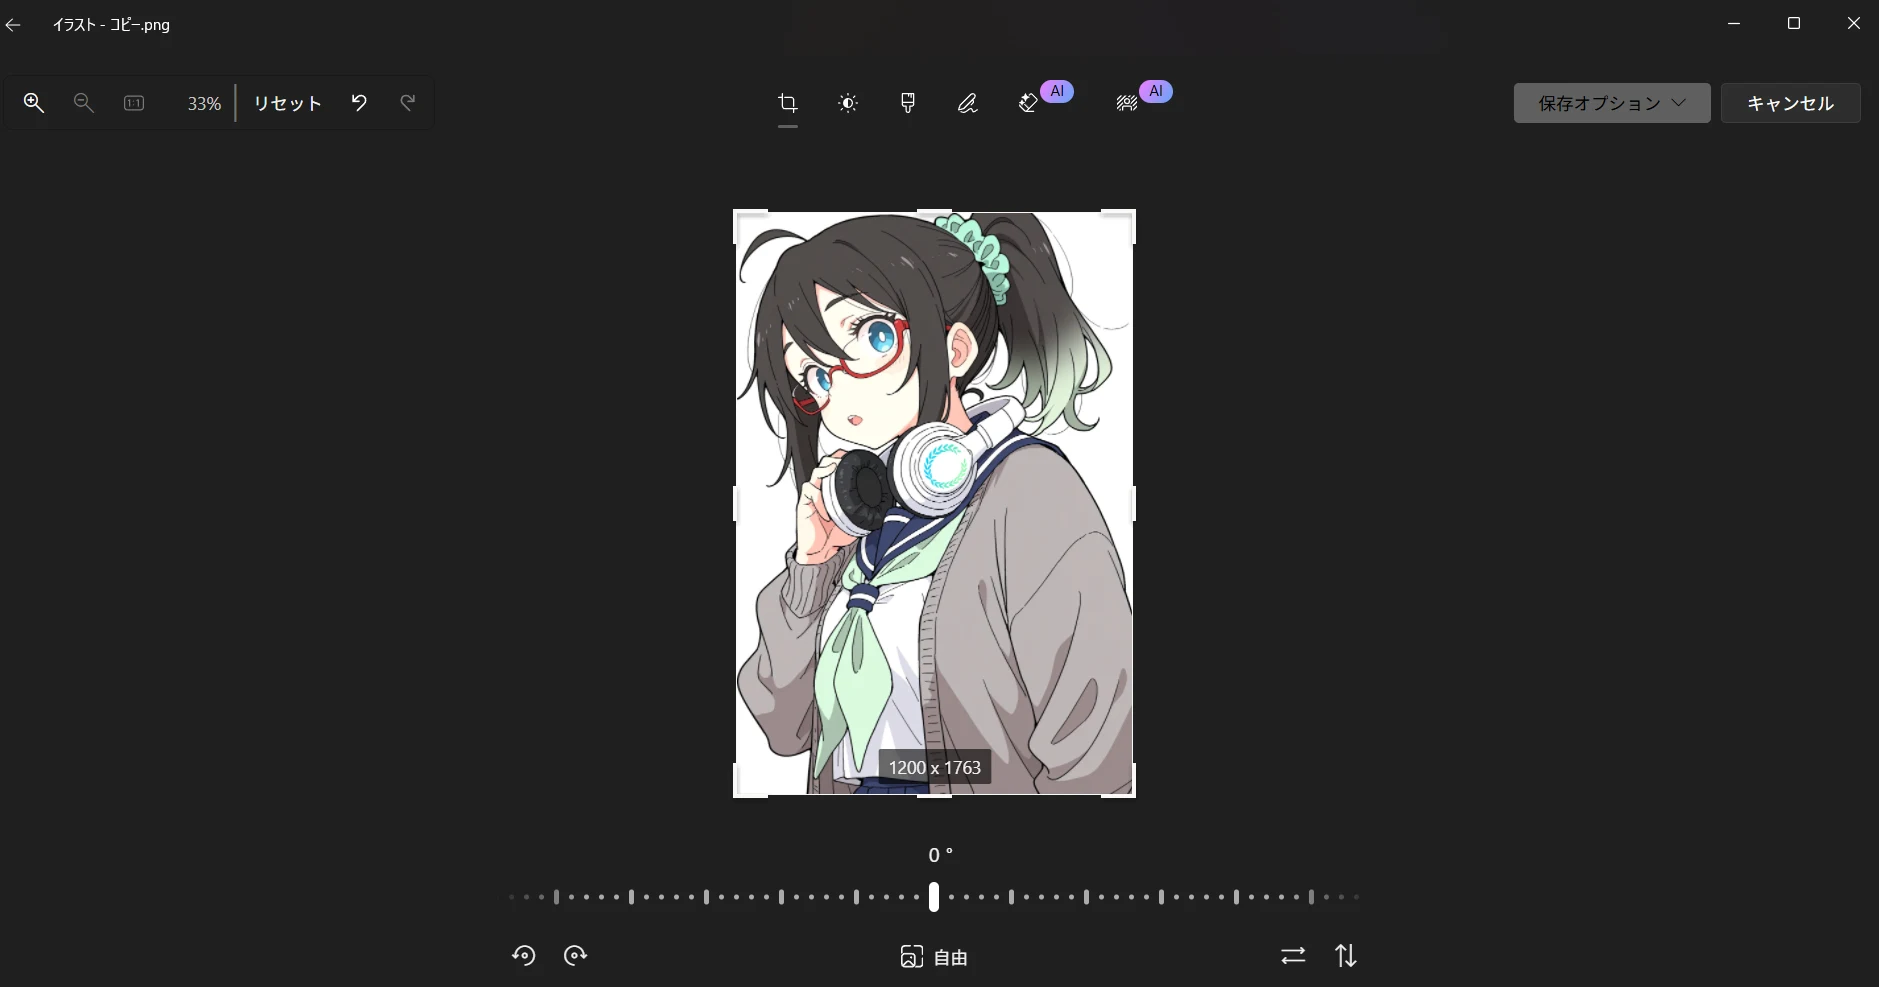
はなはだ雑ですが、LoRAで再現したいミナちゃんの見た目は最低限確保できています。もう少しバリエーションを増やしたいので、NovelAIのキャラ参照機能を使ってみましょう。
このようにモデルにしたい画像を読み込ませ、「1girl, solo,straight-on,headphones around neck,white headphones,smile」としてupper bodyの正面図を出してみます。「絵柄参照」はOFFにしています。別作家に描いてもらったミナちゃんという感じで、キャラデザは維持しているが顔立ちが少し違っている感じにできました。
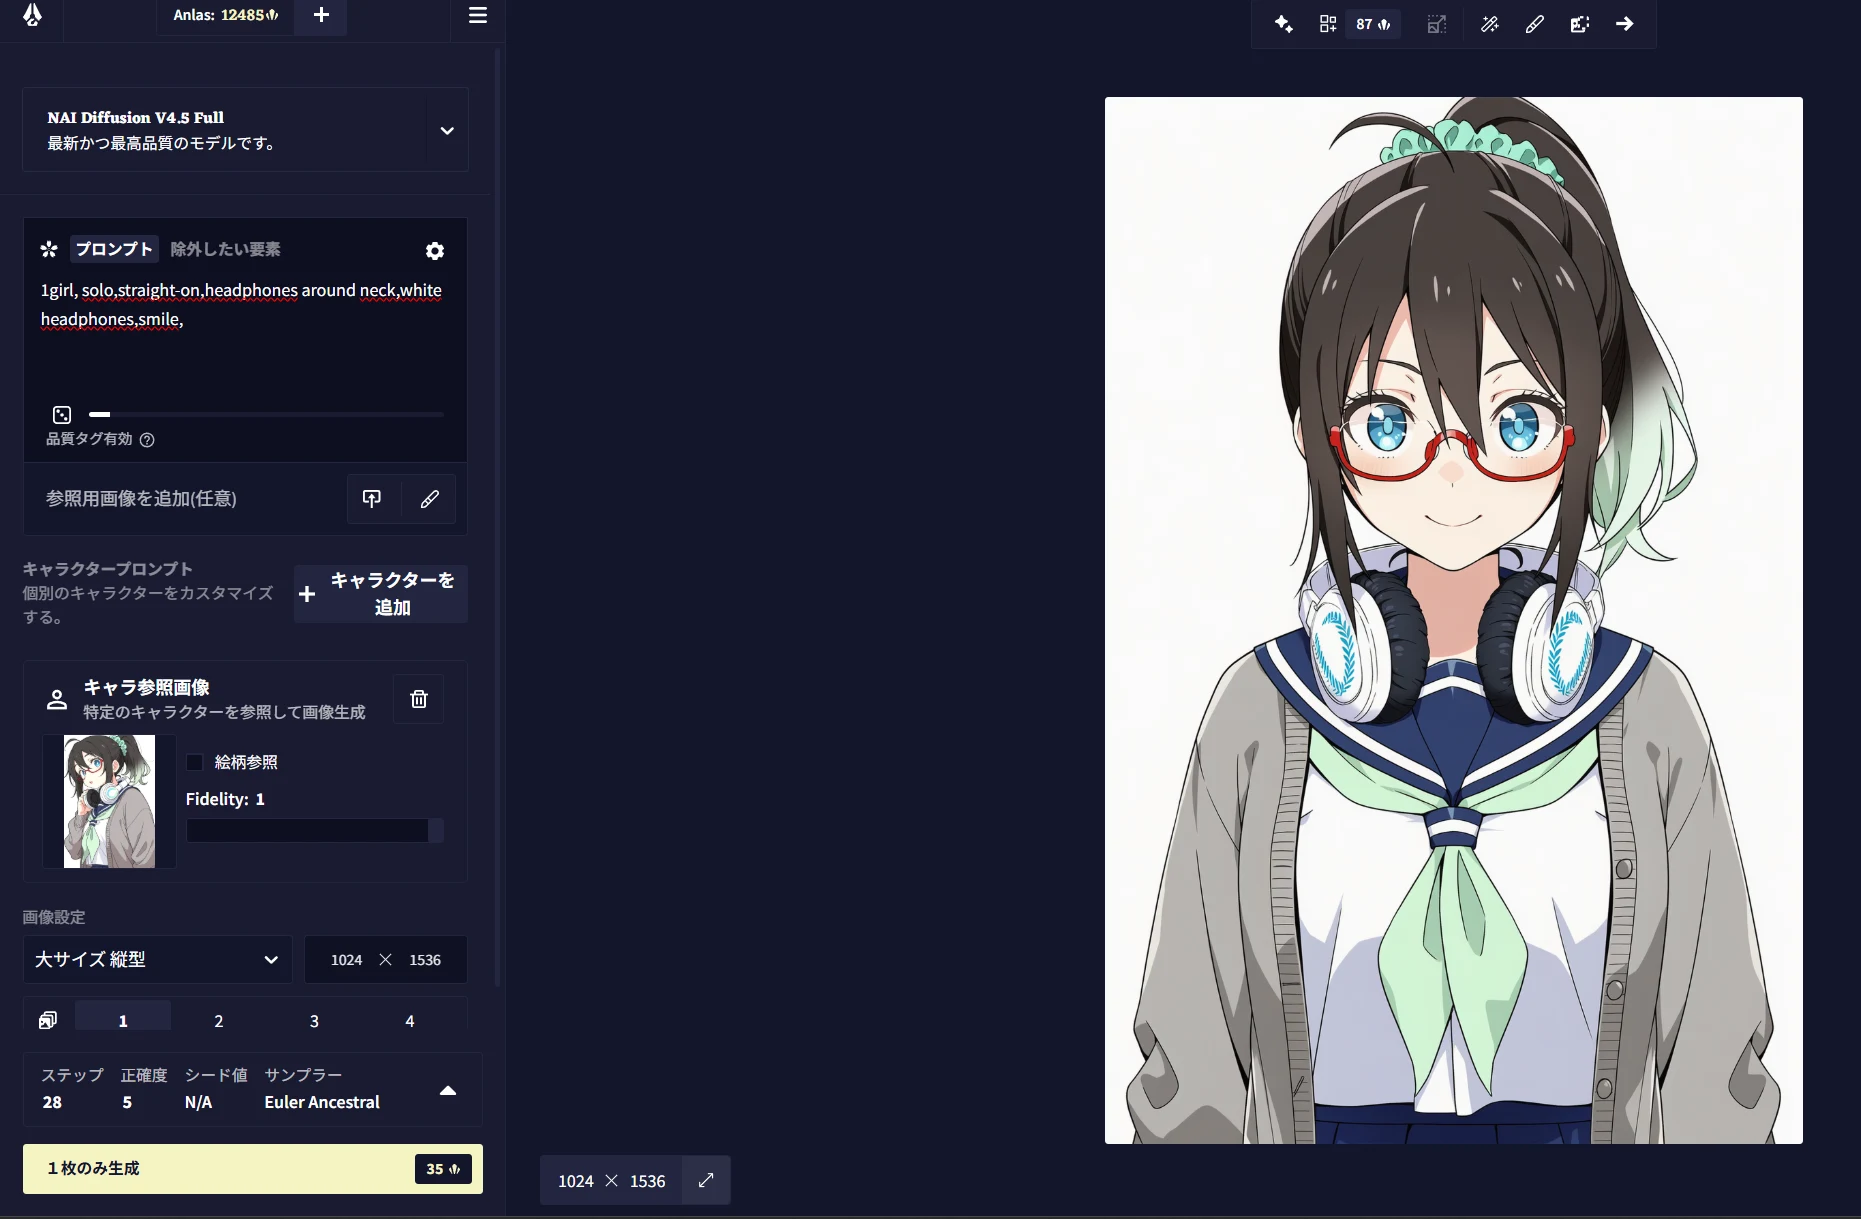
もしも顔立ちまで学習したい場合は「絵柄参照」をオンにするか、もしくは普段のcheckpointで頑張って一枚一枚同じデザインにして、「正解」のデザインのミナちゃんを十数枚用意する必要があります。ここは作りたいLoRAの内容によって作業内容が変わってくるところかと思います。作りたいのは「ミナちゃんコスプレLoRA」なのか、それとも「ミナちゃん本人LoRA」なのかをよく考えて、データセットの画風も決めるようにしましょう。
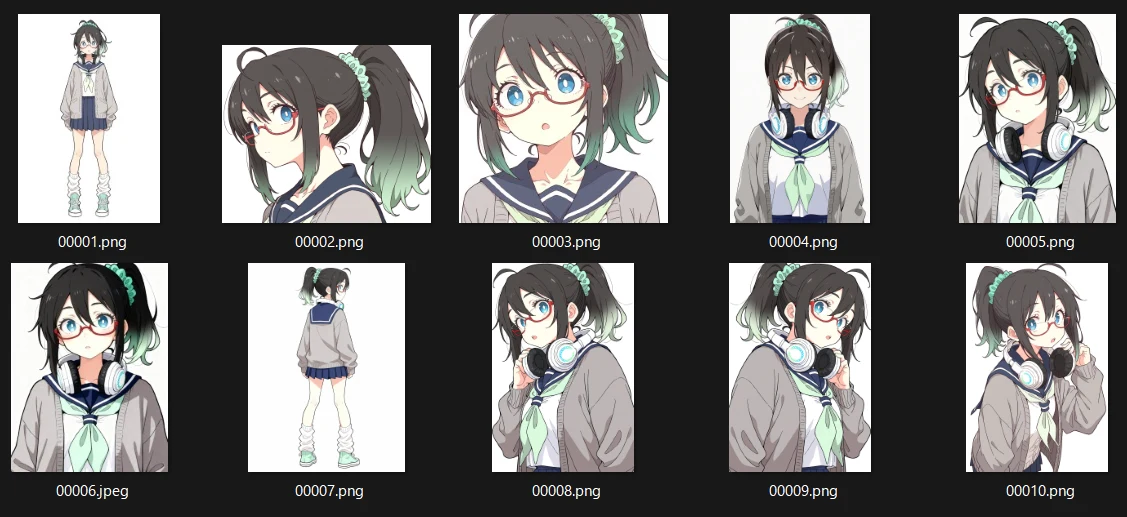
さて、ここからはちまちまと正解バリエーションを増やしていくところなのですが、全部が全部ヘッドホンや胸元の正確さを求めると面倒すぎて心が折れてしまうので、ヘッドホンなしの画像も含め多少絵柄にばらつきは持たせつつ、このようなバリエーションを用意しました。これで完成でもよいですし、不十分ならできたLoRAでなお水増しを図ればOKです。
5.画像のサイズ・ファイル名をそろえるには
画像のサイズはすべて同じに揃える必要はありませんが、極端に大きすぎたり、小さすぎたり、縦長や横長過ぎると自動でリサイズ/トリミングされます。画像生成でアップスケールするか、フリーソフトなどで1024x1024pxの正方形からさほど離れていないサイズに縮小しておくと、予期せぬ変更が防げます。一括リサイズにおすすめなツールはこちらの「縮小革命」。
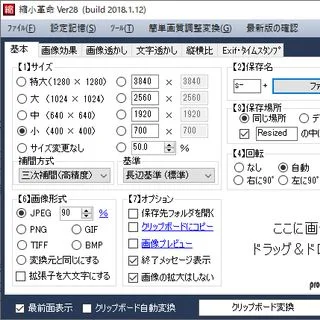
操作は簡単で、このように「1024x〇〇」を選び「短辺基準」「画像の拡大はしない」「PNG」としておき、右下に画像ファイルを複数選択してドラッグ&ドロップすると、「保存場所」で指定した場所に指定通りのサイズに変更された画像がドッと生成されます。
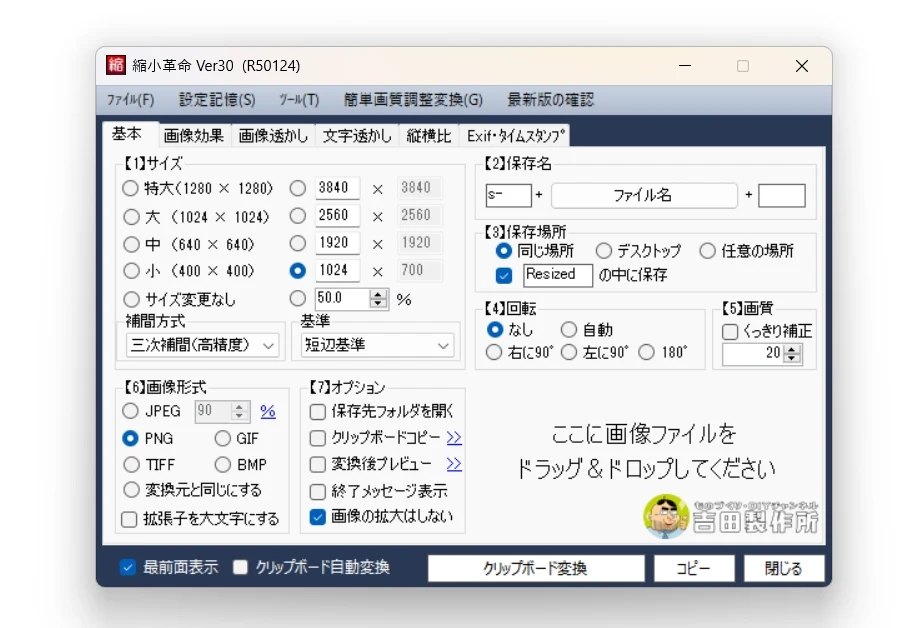
右上の「ファイル名」とある部分をクリックすると、リサイズ画像の保存名を連番数字で出力する設定にできます。 画像のファイル名に日本語や全角文字が入っていても学習はできますし、連番数字が振られている必要もありませんが、こうしておくとテキストファイルとペアにするときに見やすくて便利です。
「Resizedの中に保存」にチェックを入れると、同じ場所に生成された「Resized」フォルダ内にファイル名の頭に「s-」がついた画像が一括生成される仕組みです。リサイズを縦横比のタブで"アスペクト比調整を有効にする"のチェックが外れていることを確認しましょう。ここにチェックがされていると画像がトリミングされてしまいます。集めた画像群をすべて「短辺1024px」にそろえることができたら、次に進みます。
6.タグ付けの方法
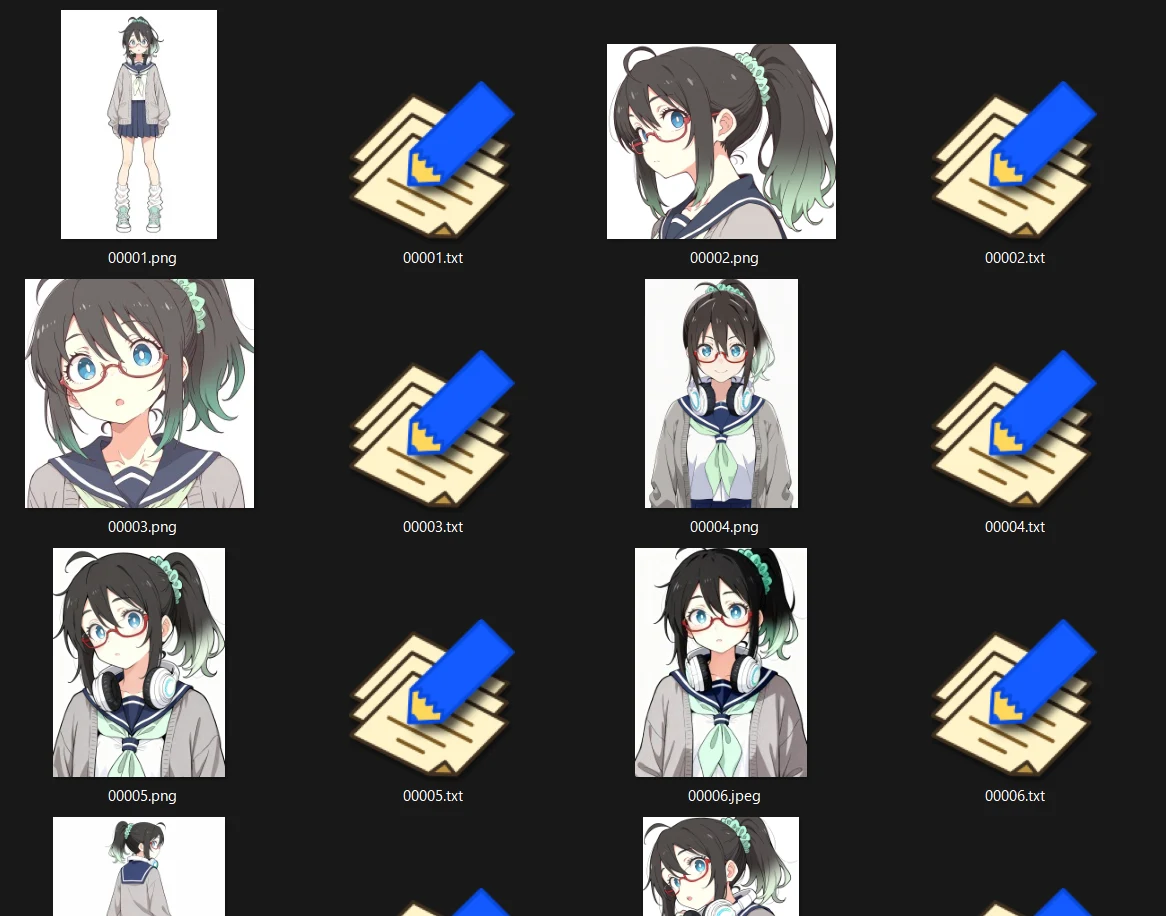
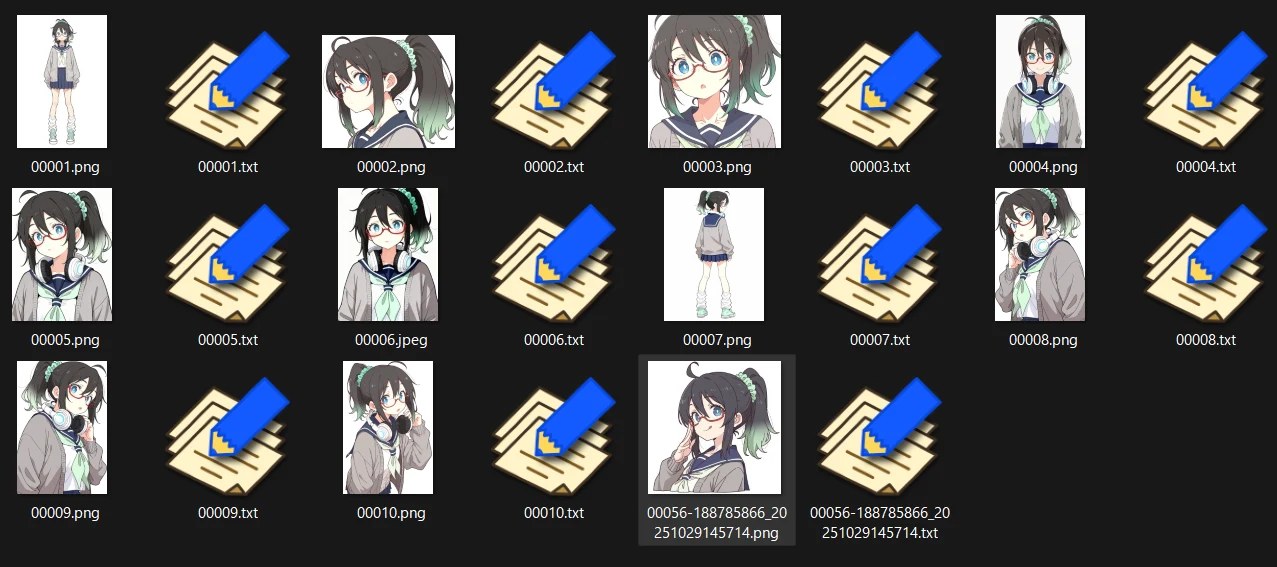
データセットは「セット」というくらいですから、学習には画像だけではなく、それに対応した説明文(テキストデータ)が必要です。いま学習用のフォルダ内に「00001.jpg」「00002.png」...と20枚の画像が並んでいるとしたら、このように「00001.txt」「00002.txt」...と20個のテキストファイルを並べる必要があります。(テキストを用意しない場合、データセットの格納フォルダの名前のみが紐づけられて学習されます)
キャラLoRAにつけるテキストファイルの中身はこんな感じ。最初にトリガーワードが書かれ、その概念(この場合は再現したいキャラ)がどこで何をしている画像かがそののちに続いています。語順が重要で、最初にトリガーワードが来るように「タグ付け」しないといけません。
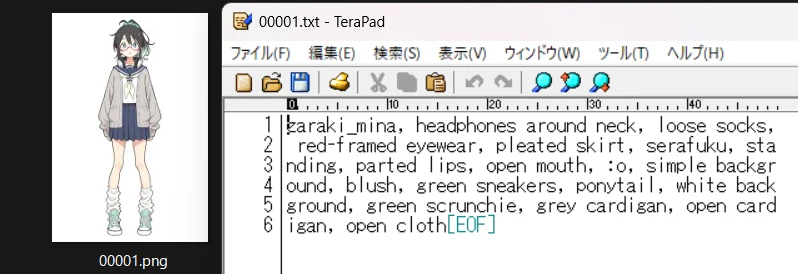
こちらのタグ付けによって、AIは「zaraki mina,headphones around neck,loose socks...」と全く同じプロンプトを指示されたら、このような画像を出力するのが「正解」なんだと学び、複雑な計算式を解いて、ベースモデルをどう補正するとよいかを考えます。手がかりになる画像とテキストのペアが豊富にあり、上手なペースで学習出来れば、データセットにない角度や表情で生成できるLoRAができますし、失敗すれば、覚えた画像の印象が強すぎてプロンプト指示通りに動かせないカチカチのLoRAになってしまいます(過学習)。
・一括タギングできるTaggerを導入しよう
さて、手打ちで何十枚もの画像にテキストデータをいちいち整えるのは大変なので、SDwebUIの拡張機能「wd14-tagger」と「Dataset Tag Editor」をインストールして、自動判別でdanbooruタグを抽出してもらいます。
導入方法は、「URLからインストール」に下記のURLを入れてインストールボタンを押すだけ。Forge Classicは対応していませんので、reForgeやA1111版SDwebUIにインストールするのがおすすめです。
wd14-taggerではさまざまなタグ付け用モデルがプリインストールされているのですが、より高性能なタグ付けモデル「wd-EVA02-Large-v3」を最初に導入しましょう。インストールフォルダ内のテキストをちょこっと書き換えるだけです。
・高性能タガー「wd-EVA02-Large-v3」導入法
①「extensions\stable-diffusion-webui-wd14-tagger\tagger」フォルダ内にある「utils.py」というファイルをテキストエディタで開きます。(右クリックして"メモ帳で開く")
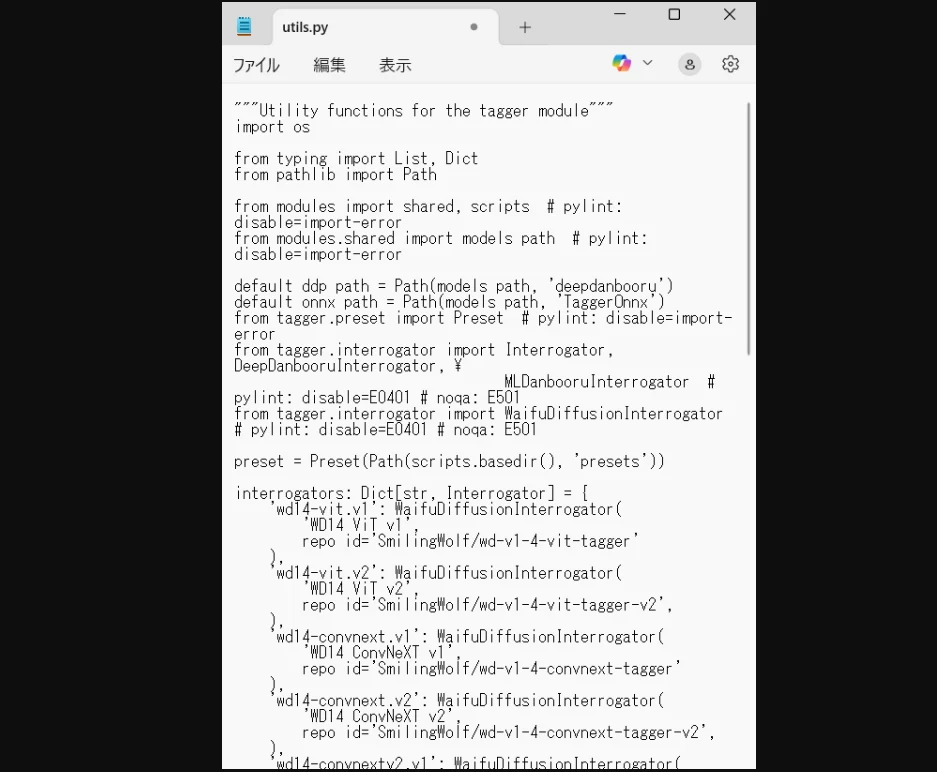
②21行目(※記事執筆時点。アップデートで変更される可能性があります)にある interrogators: Dict[str, Interrogator] = { から改行して、以下の4行を挿入します。行の冒頭に4つ、または8つ半角スペースが入っていますが、これをそのままコピペしてください。pythonではインデント(行下げ)が揃っていないとエラーが起きるので、すぐ下のwd14-vit.v1...などと書かれている行と見比べて、行が揃っているか確認してください。
'wd-EVA02-Large-v3': WaifuDiffusionInterrogator(
'wd-EVA02-Large-v3',
repo_id='SmilingWolf/wd-eva02-large-tagger-v3',
),
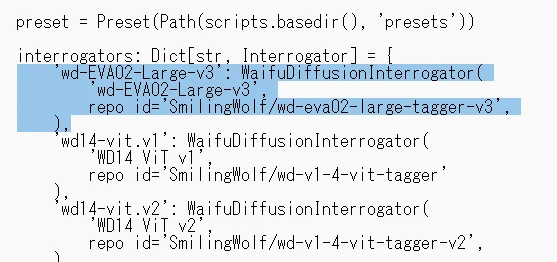
④該当部分が次のようになっていればOK。挿入した各行の位置が他の行と揃っていることを確認できたら、テキストエディタ上で「上書き保存」し、webUIを再起動しましょう。
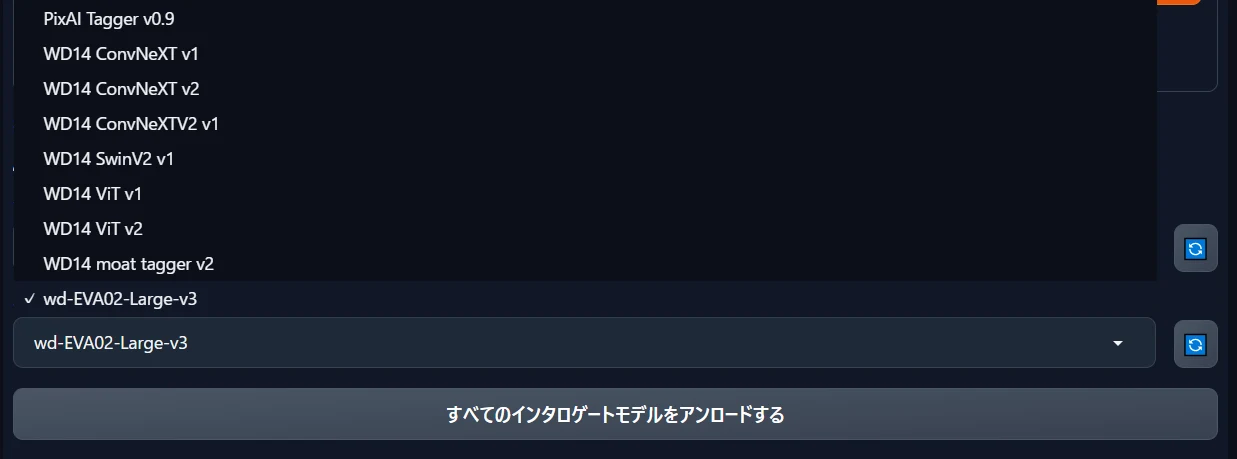
⑤「タグ付け(Tagger)」のタブを開き、画面左側にある「インタロゲーター」のプルダウンメニューに「wd-EVA02-Large-v3」が追加されていれば成功です。
7.WD1.4taggerの使い方
インストールできていれば、「タグ付け」というタブが上部にできているはずです。こちらが起動画面。
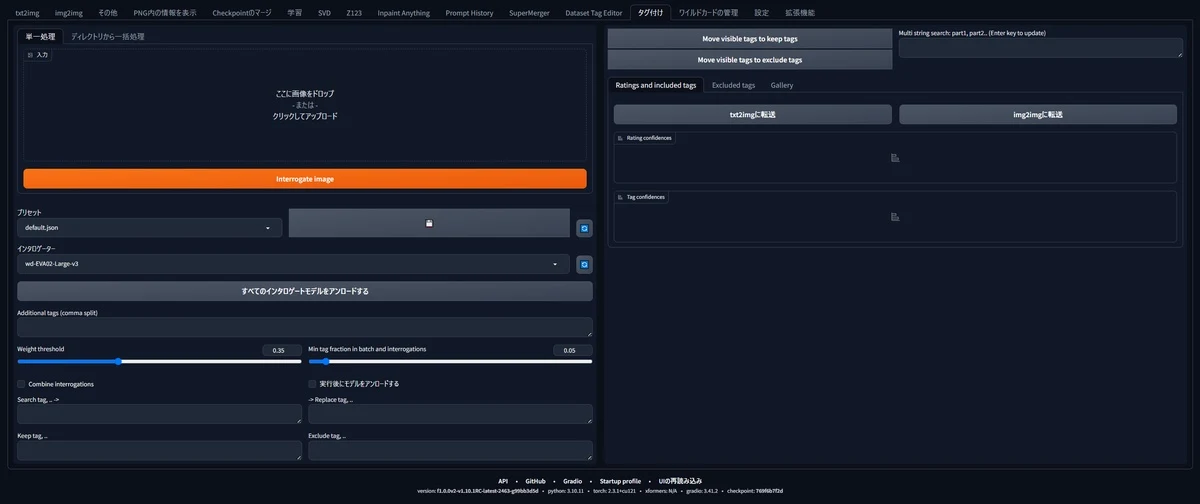
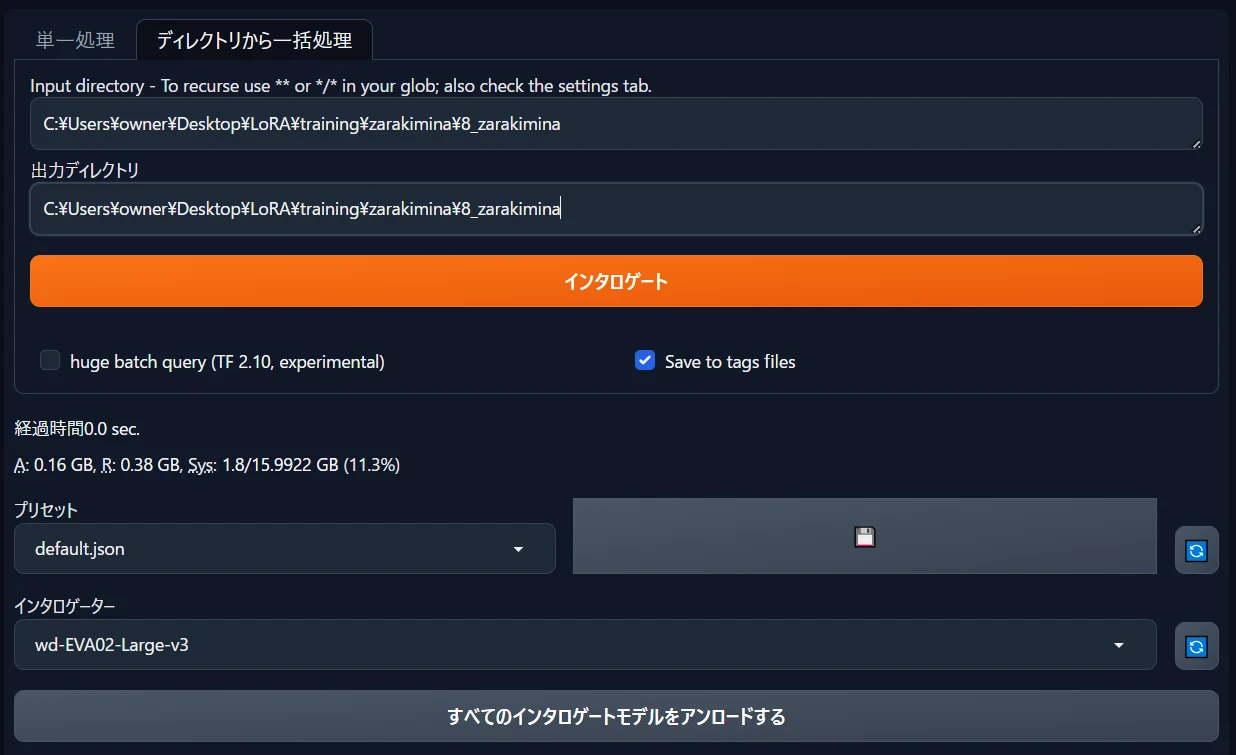
こちらのように、タグ付けしたい画像データが入っているフォルダ場所をフルパス指定します。インタロゲーターは先ほど導入した「wd-EVA02-Large-v3」を選んで「インタロゲート」。
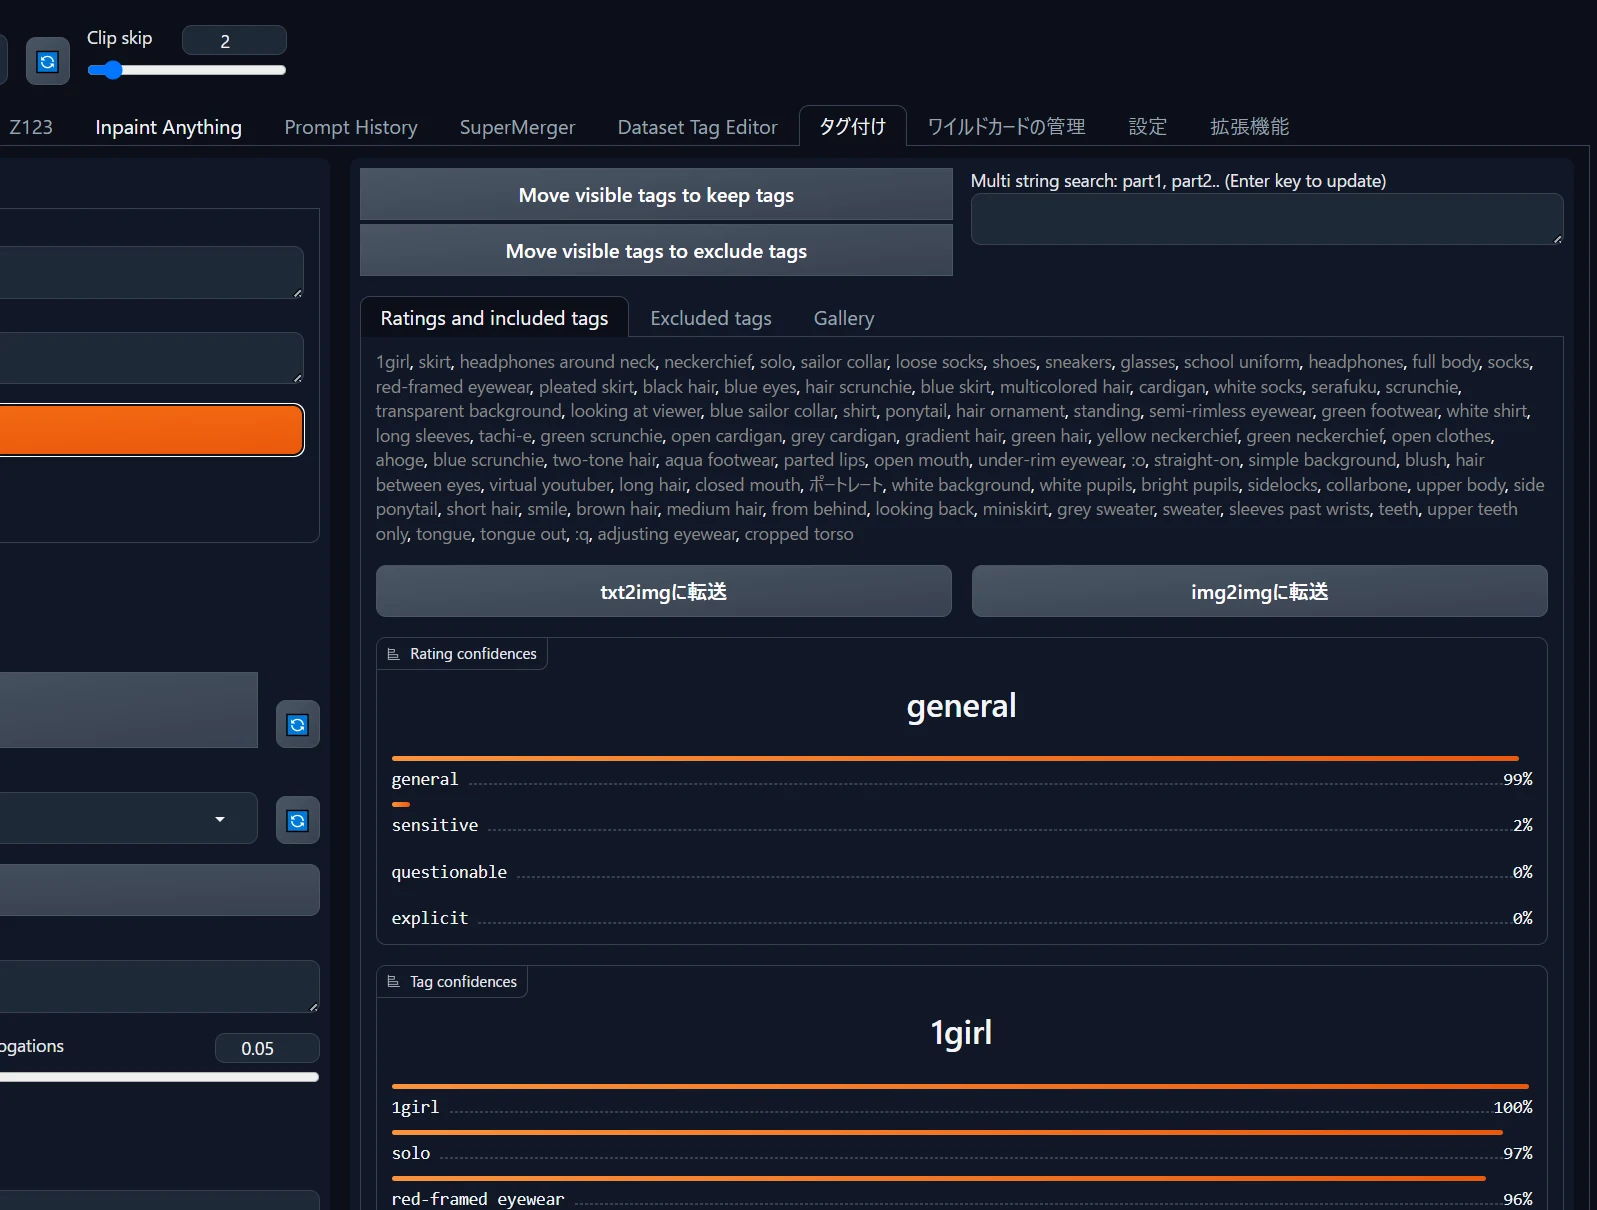
しばらく待つと、画面右側にそれぞれの画像から抽出されたタグがランキング形式で並びます。なかなかタグ付けが終わらない場合は、StabilityMatrixの画面を最前面に持ってきましょう。重いのは一回目のタグ付けだけで、そこからの追加や削除は一瞬でできます。
この時点で既に、さきほどのフォルダにもテキストが出力されています。それぞれのテキストは同名の画像に対応しており、何が描かれているかが記入されています。
さて、これを学習用に一括で書き換えていきます。具体的には、一番最初に彼女を一発で呼び出せる「トリガーワード」を設定しましょう。今回は「zaraki mina」としたいので、Additional tags (comma split)にそう記入して「インタロゲート」します。(さきほどフォルダ名は「zaraki_mina」とアンダースコアを使いましたが、タグ付けの際は半角スペースで区切るようにしましょう。のちのちできたLoRAで生成するときも1girl,zaraki minaで生成します)
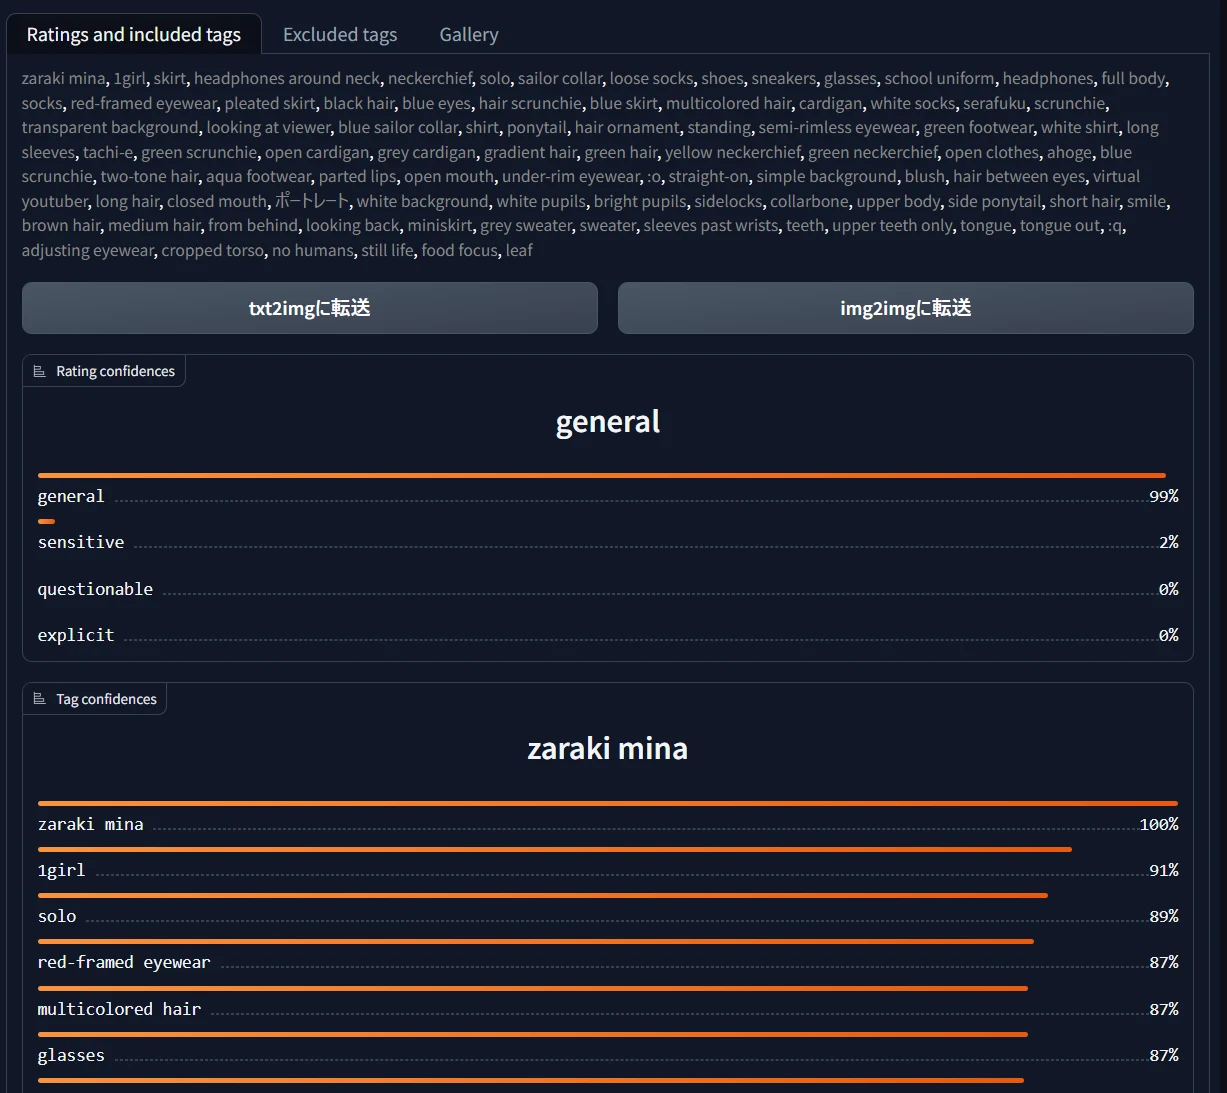
今度は一瞬で、全部のテキストの一番はじめに「zaraki mina」が追加されました。
<各パラメータの意味>
画面左下で、検出の感度やタグの一括追加・一括削除ができます。一応各パラメータについて意味を解説しておきますが、ごく簡易的な機能ですので、細かくいじりたい場合は次に説明する「Dataset tag Editor」を使いましょう。
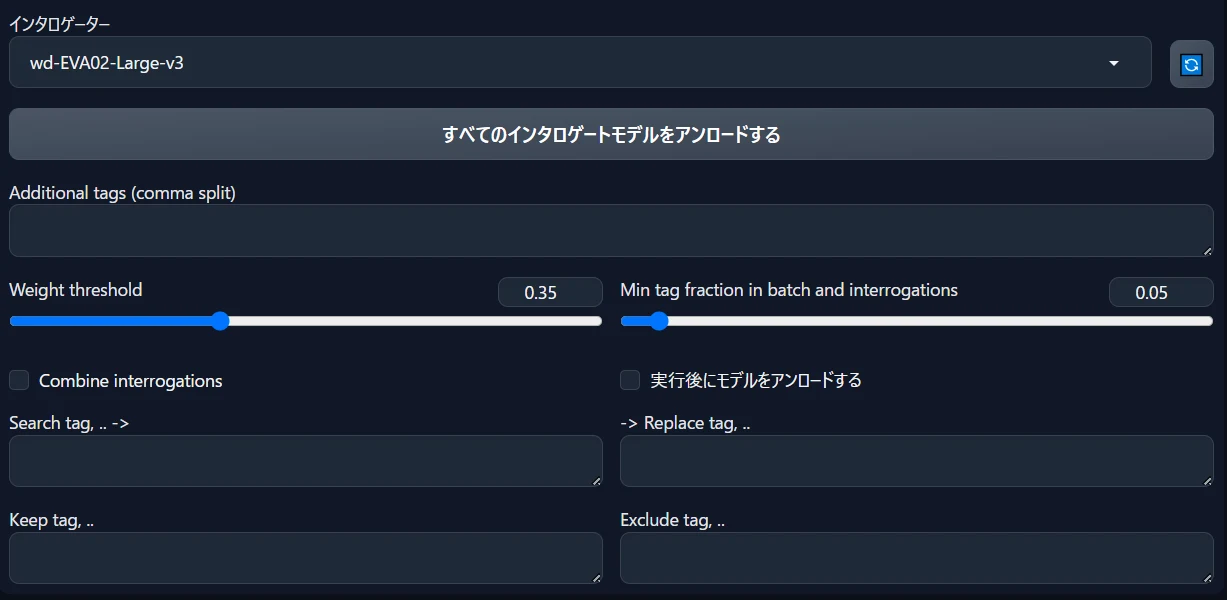
・「追加タグ」Additional tags
この入力欄に入れたタグは、全てのテキストの冒頭に書き加えられます。ここにキャラLoRAのトリガーワードにしたい単語を入れます。既存のタグにはない、短めでオリジナルなワードがいいでしょう。例えばミナちゃんなら「zaraki mina」などです。学習時も生成時も、トリガーワードやタグ付けにアンダースコア(_)は使わず、タグ間のすきまは半角スペースに統一することをおすすめします。
(※ちなみに、zaraki minaはBLEACHのzaraki kenpachiと似ているので、既存概念と競合してしまうよくないトリガーワードではあります。"m1na zarak1"などと暗号化すれば避けられますが、つづりをすぐ忘れてしまうので、悩ましいところです)
・「しきい値」Weight threshold
抽出するタグのしきい値調整ができます。下げると「間違っちゃうかもしれないけどたくさんタグ付けするね」、上げると「間違いないタグだけを付けるね」の意味になります。抽出結果を見て調整しましょう。デフォルトは0.35(35%以上)となっていますが、私はたいてい0.28くらいにすることが多いです。キャラLoRA学習時は正確で精選されたタグ付けが重要です。間違ったタグは学習の失敗に直結するので、絶対に混入しないようしきい値を調整しましょう。
・「最低抽出率」Min tag fraction in batch and interrogations
保存するタグの最低抽出率です。デフォルトは「0.05」となっており、抽出されたタグの数が全体の5%未満の場合、そのタグは間違いの可能性が高いとして除外される設定になっています。私は最初0にすることが多いですが、結果を見て調整します。除外されたタグは、右上の「Exclude tags」タブから閲覧でき、除外してほしくない場合は「keep tags」に記入することで救出できます。
・「除外タグ」Exclude tag
ここに入力したタグは、テキストから除外されます。さきほども触れましたが、「red_glasses」のようにタグ内のスペースを半角アンダースコア(_)にすると、検出されたワードと合致せず、除去できなくなるので注意してください。(webUIの"設定"タブから変更可能)
右側のランキング上でタグをクリックすると、「Keep tag」の欄にそのタグがコピーされていきますので、それをExclude tagに移して「インタロゲート」すると、それらのタグが除去されます。
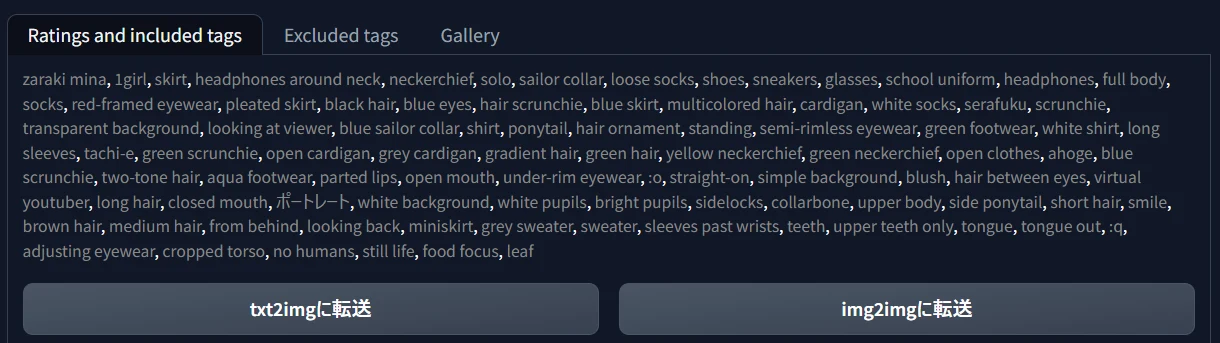
・「検索タグ・置き換えタグ」 Search tag & Replace tag
抽出されたタグを何か別のタグに置き換えたいときはこのウィンドウを使います。あまり使いやすくないので、今回はいじりません。