こんばんは、スタジオ真榊です。今回は、illustrious系の人気モデル「WAI NSFW v14」(現名称はWAI-illustrious-SDXL)をベースに自分好みの「マスピ顔」LoRAを学習し、「自分画風」のオリジナルモデルを作る方法について、2025年10月現在の知見と検証内容をまとめました。LoRAとは何か、絵柄はどう学習すべきかから掘り下げた、2万3000字超の大型特集です。
今回紹介するのはいつものCoppyLoRA法(1枚絵から画風を抽出するかんたん追加学習法)と、自分で数十枚~のデータセットを用意する従来の追加学習法とを組み合わせて、構図やプロンプト応答への悪影響を最小限にする手法です。具体的には、
①好みの1枚絵を作り込み、CoppyLoRAを作成。ベースモデルにマージして、「中間ベースモデル」を作る
②ランダムプロンプトを活用して数百枚のデータセットを自動生成
③WD1.4 taggerやDataset tag Editorを使って独自のタグ付け
④Kohya LoRA param GUIで中間モデルをベースに学習(調整LoRA)
⑤CoppyLoRAと調整LoRAの適用強度を調整、ベースモデルにマージして完成
…という感じです。これによって、CoppyLoRA単体や通常の学習に比べ、悪影響が少なく、より表情豊かで狙った通りの画風を再現できるモデルをオーダーメイドしよう、という試み。特にタグ付けの部分はこれまでの考えと全く違うアプローチができ、再現性も高いはずですので、きっと何かの役に立つと思います。
【序文】二つの「画風LoRA学習法」
さて、実際に作業工程を見ていく前に、まずは画風LoRAとは何で、どうやったら好みの画風を覚えさせることができるのか、というところから入っていきたいと思います。
「自分画風LoRA」を作る方法は大きく分けて二つあります。一つ目は、コピー機学習法が簡単にできる「CoppyLoRAwebUI」を使って2枚の画像ペアから画風LoRAを差分抽出する方法。もう一つは、自分で十数枚~100枚以上の画像とタグのデータセットを用意して学習させる従来の追加学習方法です。
①CoppyLoRA
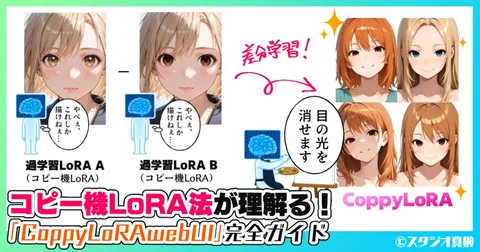
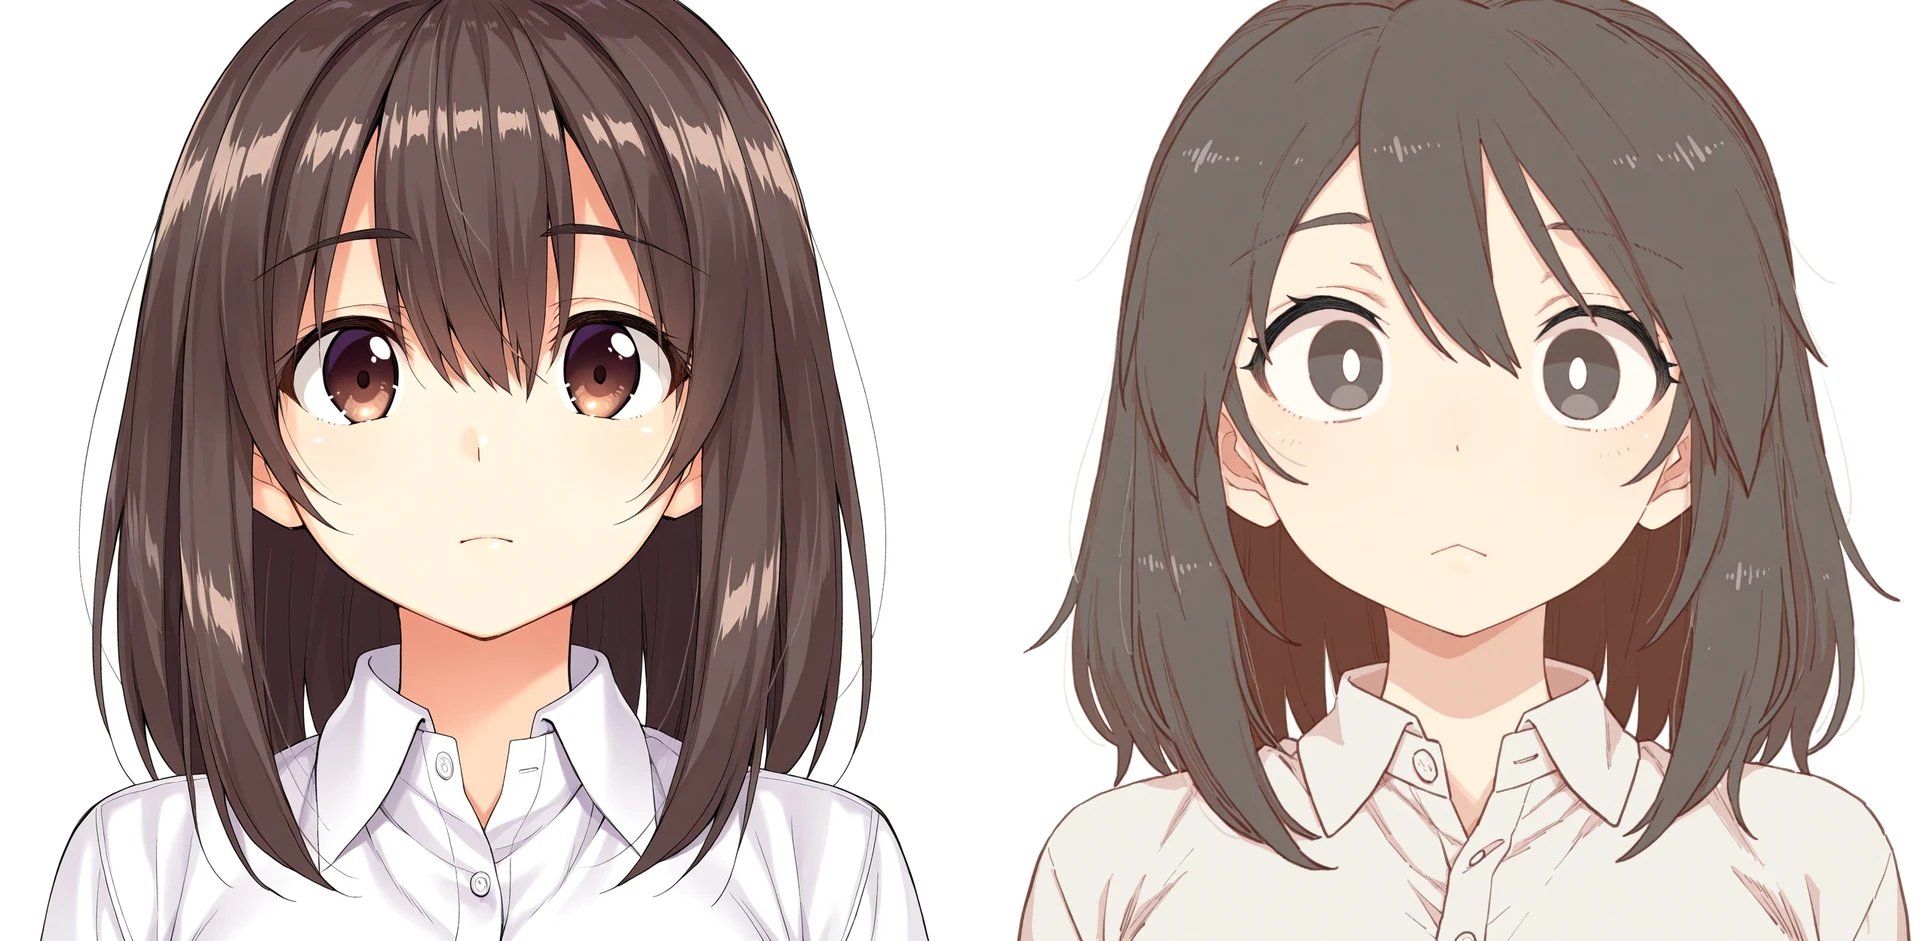
左の画像から画風を抽出すると、右のような画像が出せるLoRAが簡単に作れるのがCoppyLoRAです。「コピー機LoRA法」という、わざと過学習させたLoRAから差分を抽出することで、狙った概念をピュアに学習できる、非常に優れた学習法です。
本来、コピー機LoRA法は設定や技術理解のハードルが高く、上級者向けの差分抽出法なのですが、とりにく(@tori29umai)さんの無料アプリ「CoppyLoRA webUI v3」を使えば誰でも予備知識なしで作ることができます。(※詳しい使い方はこちらから)
このように、狙った画風の画像を下段に入力し、上段にはそれをめちゃくちゃにimage2imageして画風を「破壊」した画像(ただし、描かれているものや位置は全く同じにする)を入力することで、2枚の差分…つまり、下のイラストの画風をLoRAとして抽出することができます。
できたCoppyLoRAで「1girl」を生成するとこんな感じ。たった1枚の画像から、だいぶ画風の特徴をつかめていますね。勝手に金髪緑眼になったり、前髪に編み込みが生じたりもしません。
ただ、のび太の画像1枚だけでは、ドラえもんもジャイアンもいる藤子不二雄先生の画風を網羅できないように、画像1枚だけで画風を構築するのには無理があります。人間が描く絵にはポーズや画角やパース一つにもクセがあり、色んなところに個性が宿るもの。たった1枚(と破壊した画像のペア)から画風を抽出するのでは、そうした表情やポーズのバリエーションに宿る個性まで覚えさせることはできない…というのが、CoppyLoRAの弱点です。
その代わり、CoppyLoRAは画風概念のみをピンポイントで抜き出して学習できるので、LoRA適用時に構図やタグへの反応がおかしくなることをほぼ抑えることができます。まとめると、「思ったようなポーズや表情にまではさせられないが、悪影響のほとんどない顔立ちLoRAを誰でも簡単にすぐ作れる」のがCoppyLoRAの特徴と言えるでしょう。
②従来の追加学習法
画風LoRAを作るもう一つのやり方は、数十~数百枚の画像データセットを自分で用意して、適切にタグ付けし、それらの画像に共通する概念(この場合は画風)をLoRAとして学習させる従来の追加学習です。こちらはCoppyLoRA法と違って、さまざまな画像から多彩な表情や表現を幅広く覚えさせられる一方で、必要な工程が長く、複雑な点に留意が必要です。
画風が共通していて学習に適性のある画像群を自分で用意する必要がある上、細かな学習設定が非常にピーキーなため、「画風が似たけど、なぜかやたらとアップの画角になる」とか「顔が崩れてしまう」「妙な布が出現する」といった予想外の失敗が起こりやすいのがデメリットです。
③今回の記事の趣旨
今回は、CoppyLoRAに比べてハードルの高かった追加学習についていろいろと試してみた結果、失敗が少なくプロンプト応答への悪影響も少ない学習設定やタグ付け方法が分かってきたので、これをまとめたいと思います。具体的には、このような画像群を自分で用意することで…
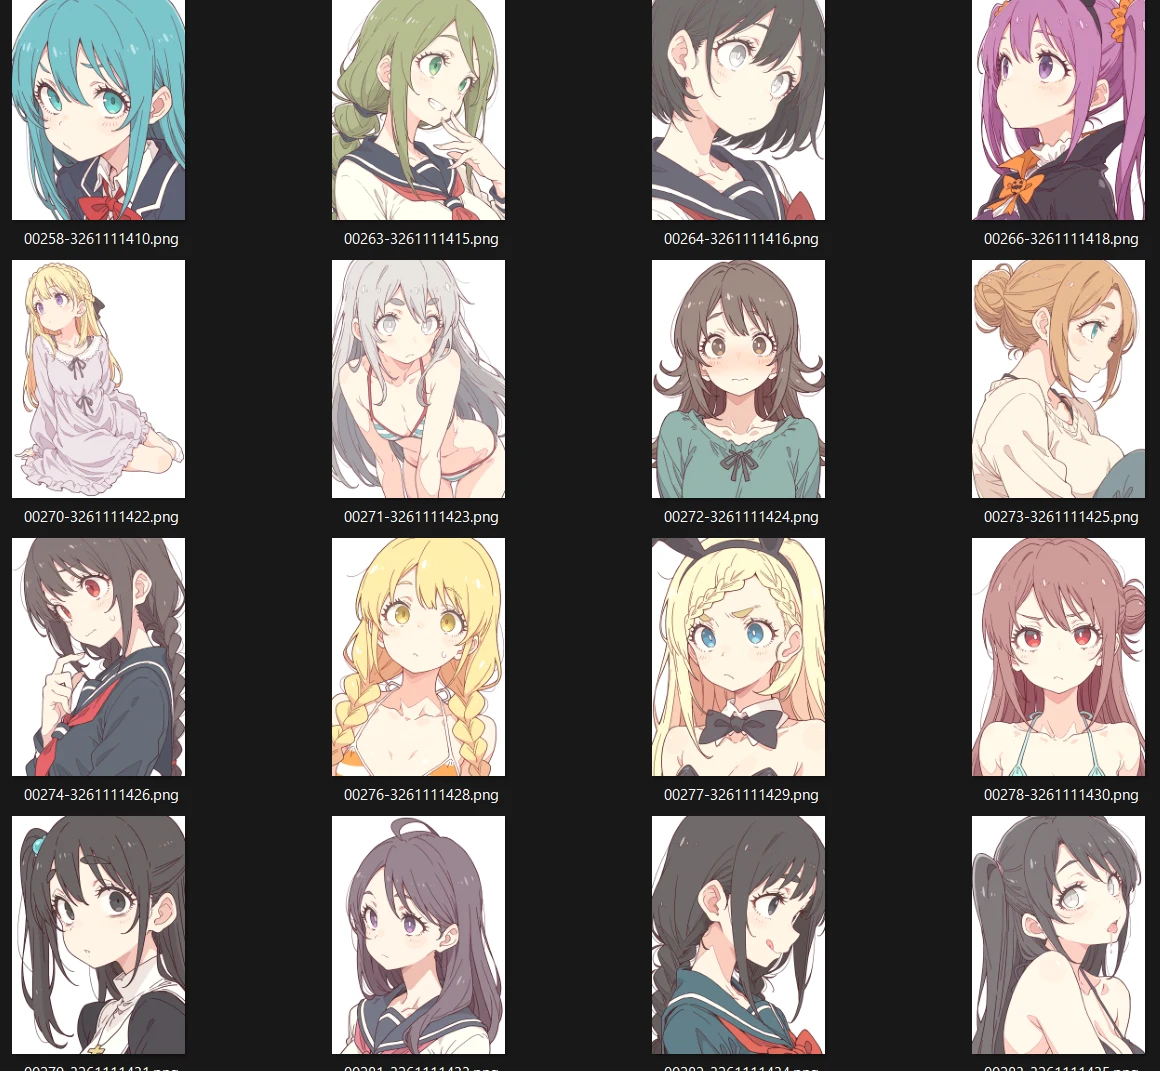
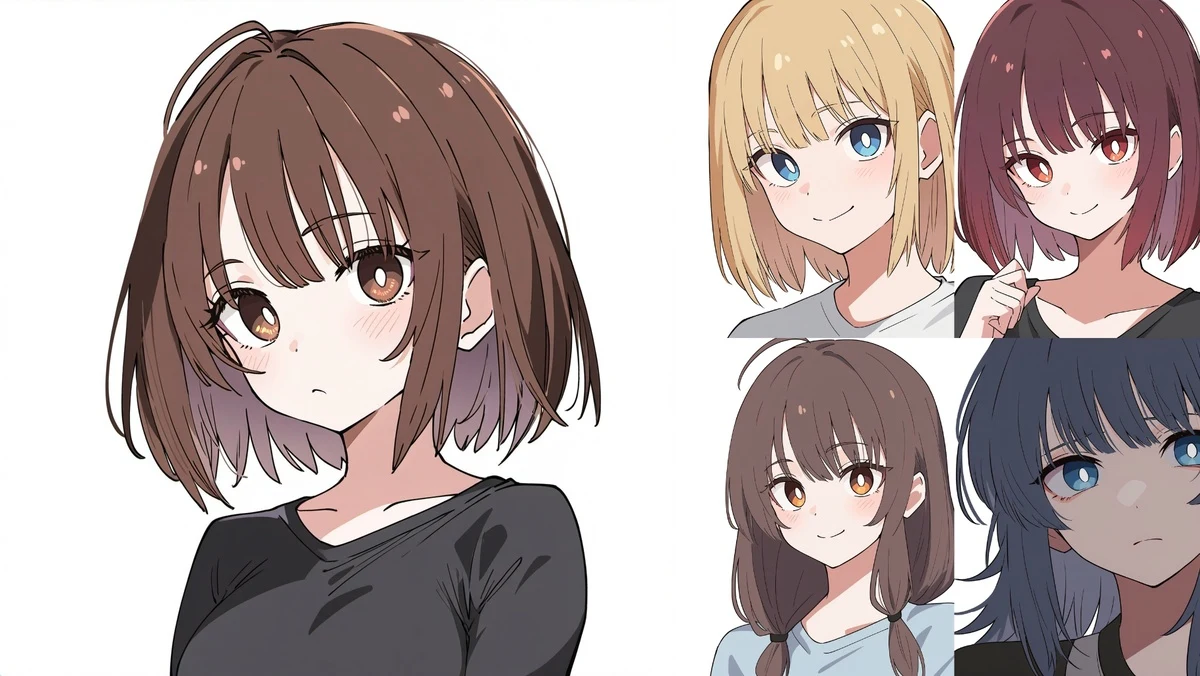
「1girl」(髪型・色ランダム指示)でこのような画風が生成できるLoRAを作り、WAI NSFWv14にマージして、取り回しがよく表情豊かな自分モデルにすることができました。
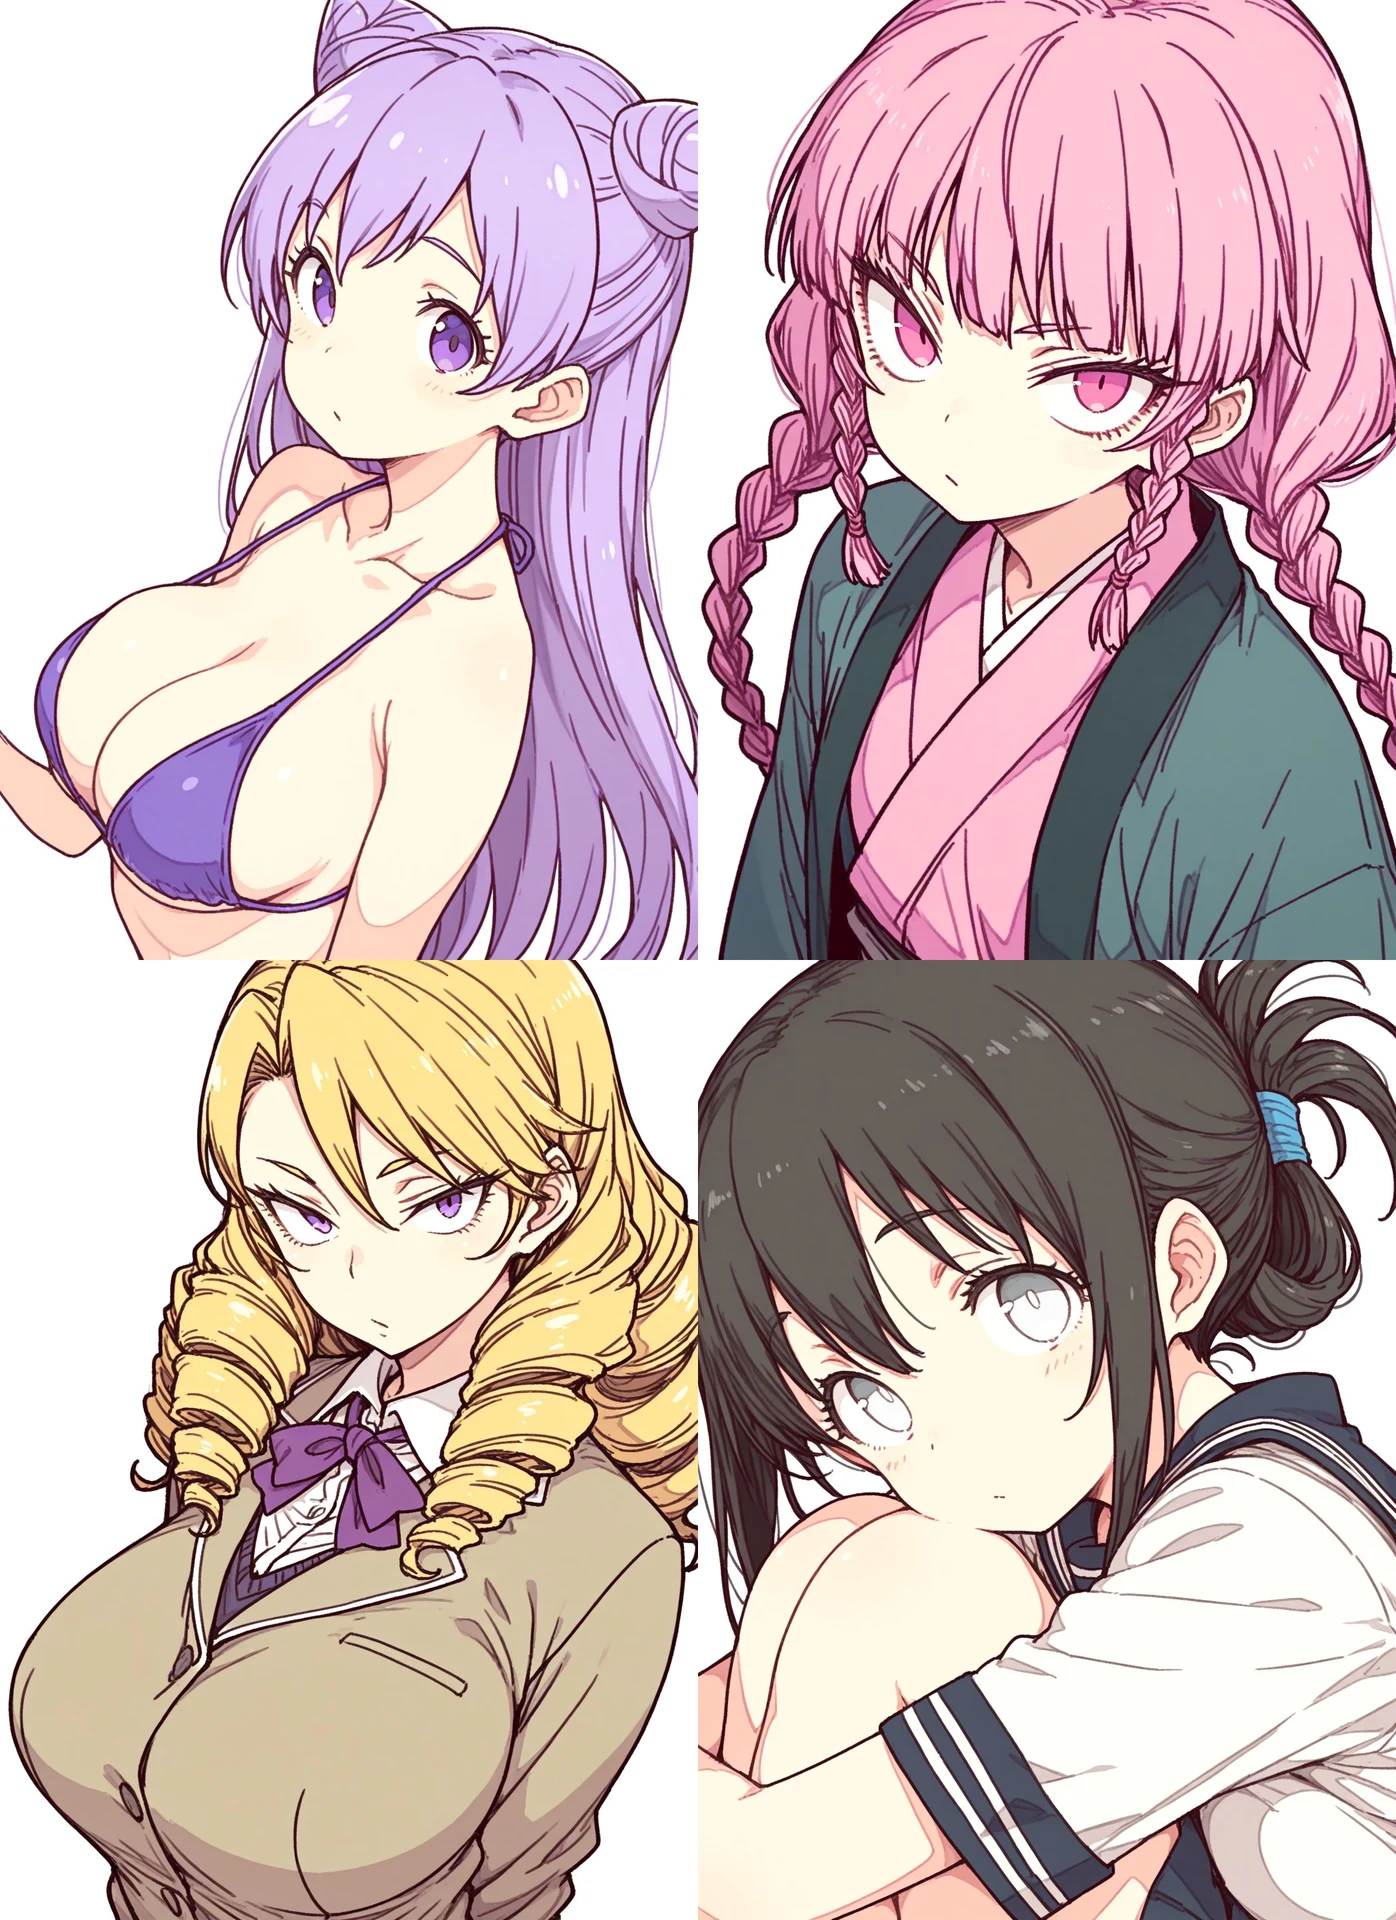
特にこだわったのが、「たれ目」「ツリ目」「年上属性」のオンオフをプロンプトでできるようにしたことです。一つのモデルで、「tareme」と指示するとこのような顔立ちになり、
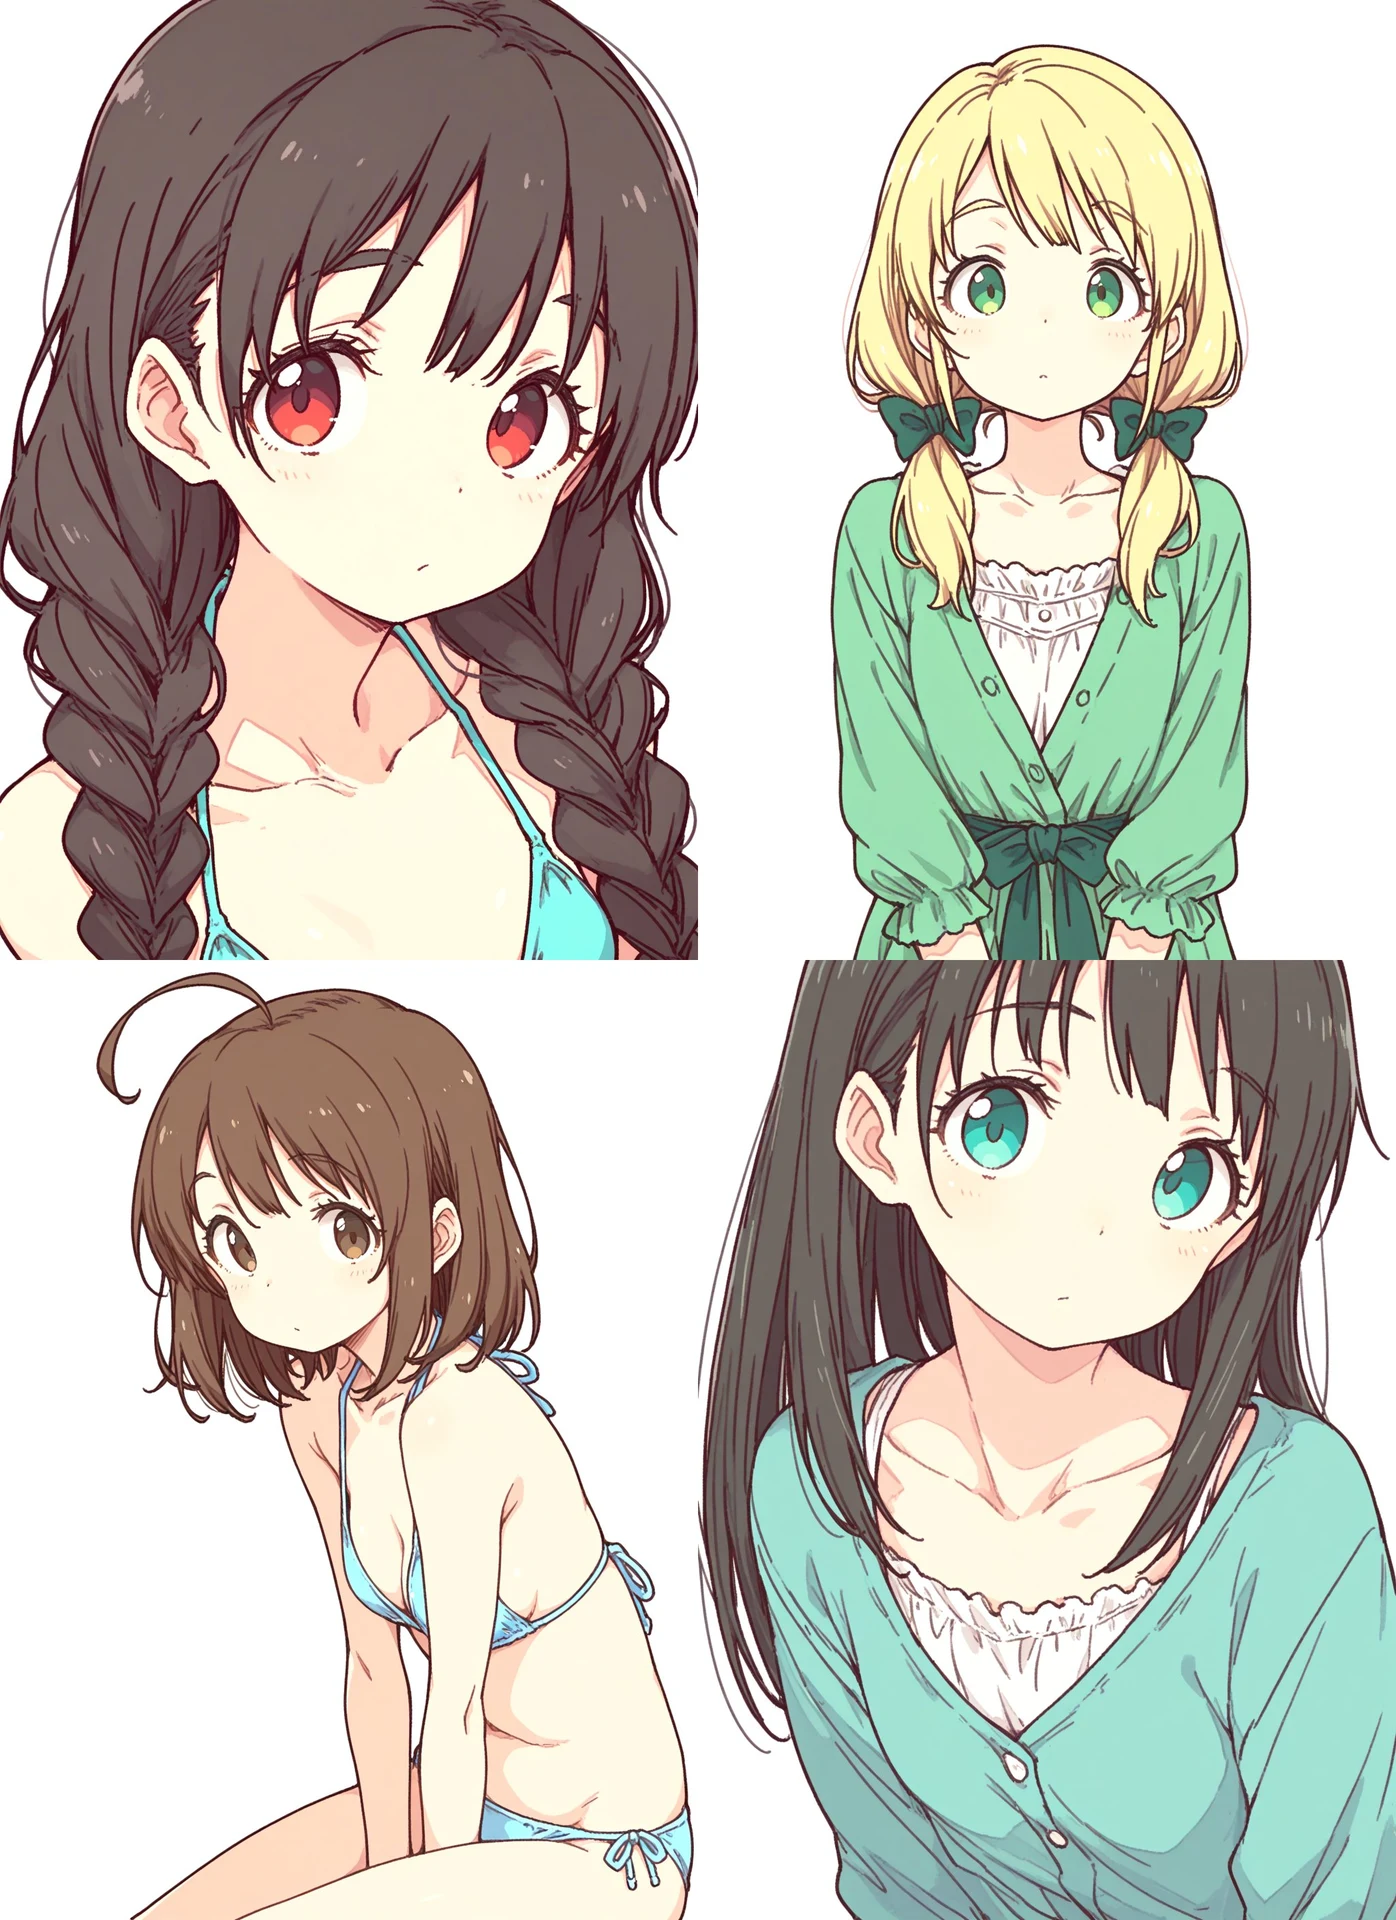
「tsurime,sanpaku」と指示すればこのような瞳のデザインになります。たまたまそうなるのではなく(適用強度やプロンプトにもよりますが)学習させた顔立ちにちゃんとなりました。もちろんベースモデルであるWAIv14も「tareme」「tsurime」指示でこのような描き分けができますが、それぞれのタグに自分好みの顔立ちを設定し直せるイメージですね。
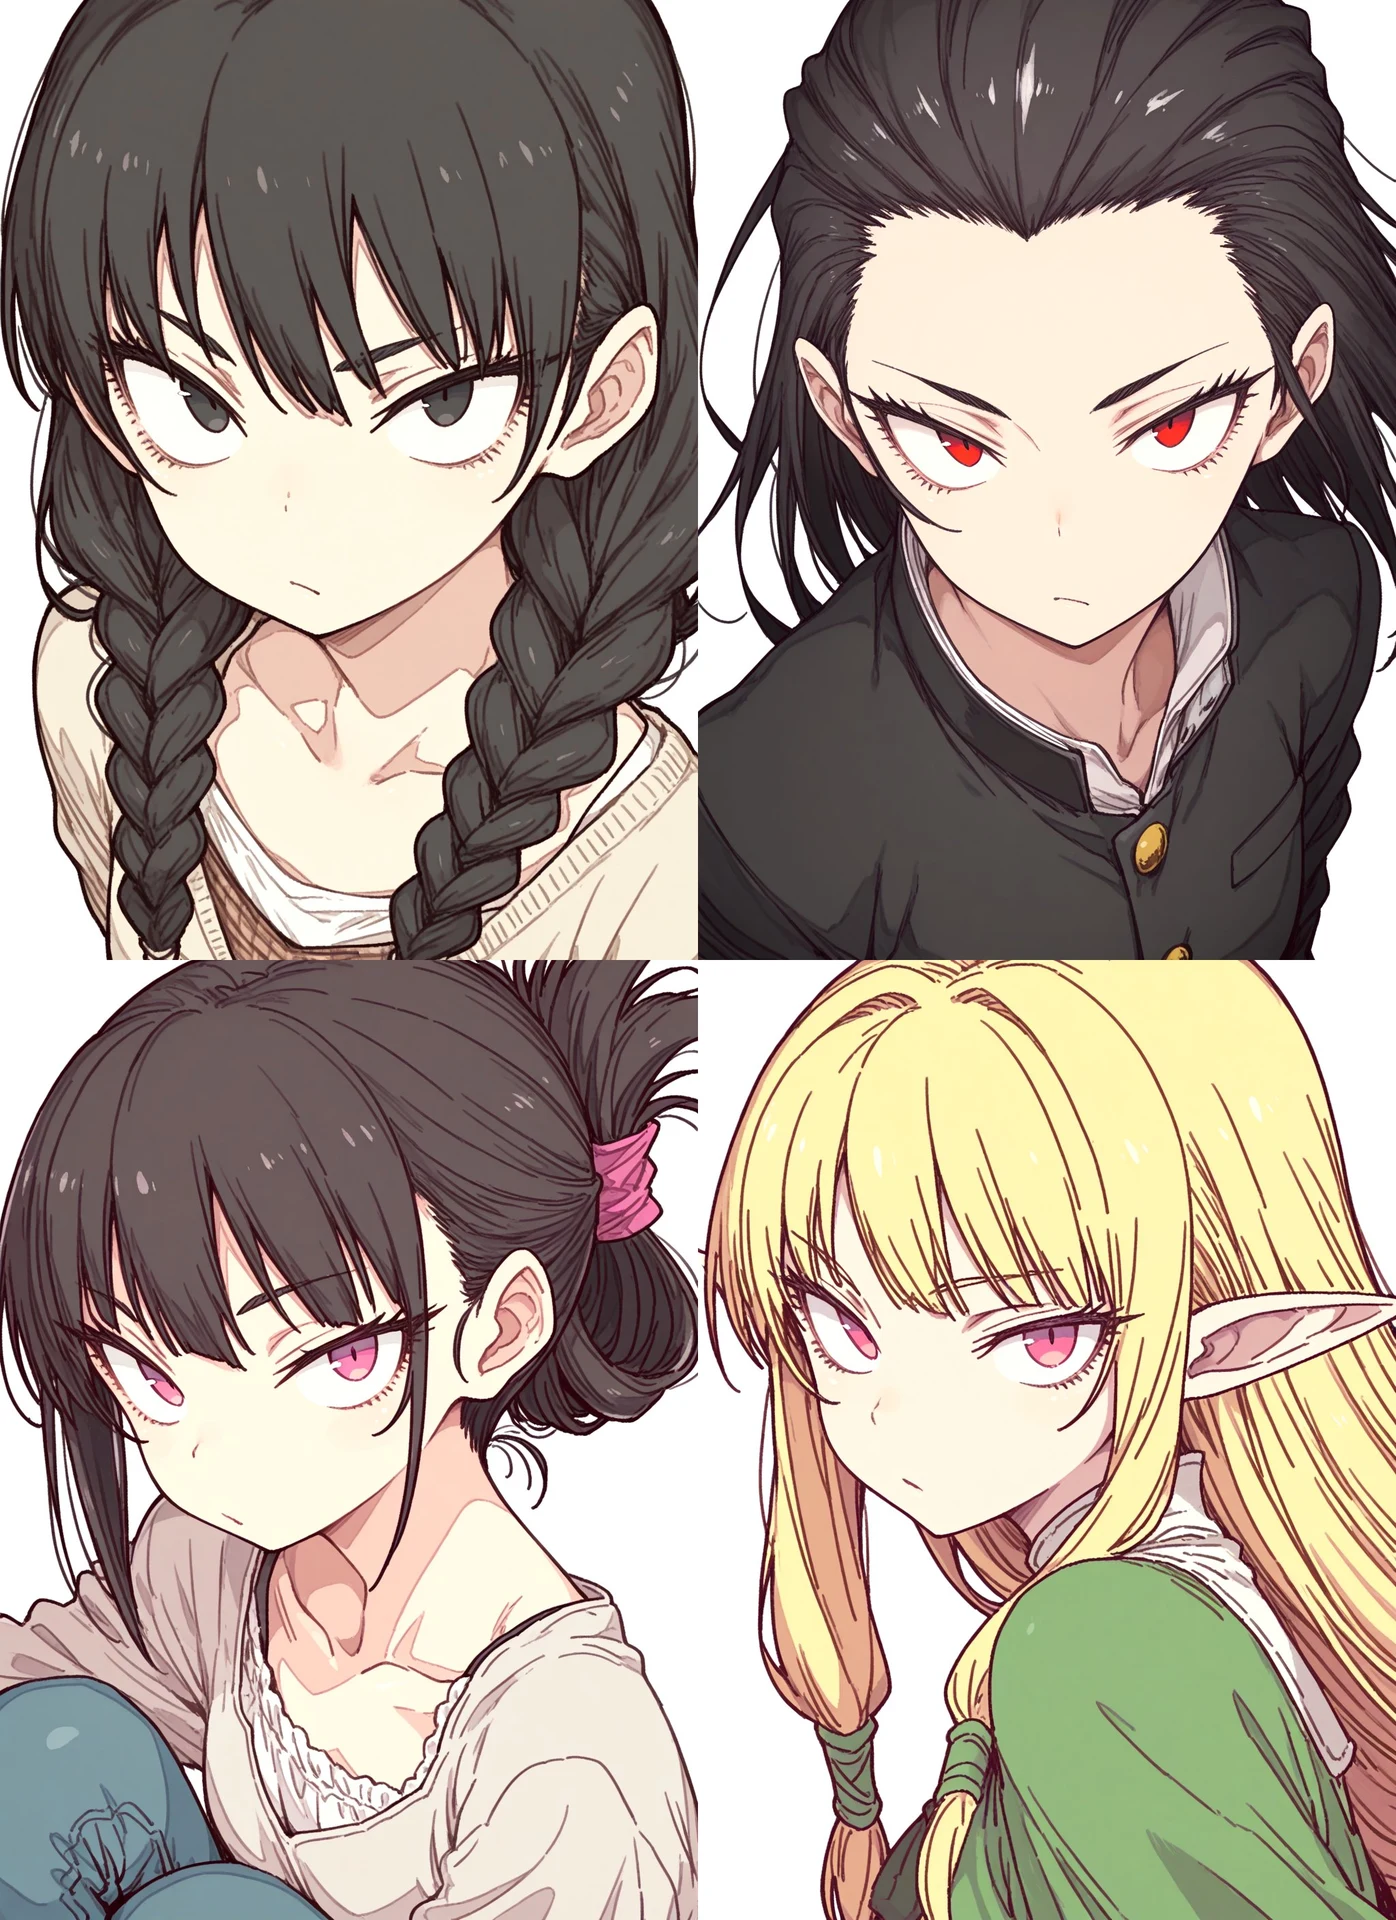
さらに「mature female」を指示するとこのように年上キャラの顔立ちが描き分けできます。いずれもtsurimeを指示しており、統一感のある画風にできていると思います。
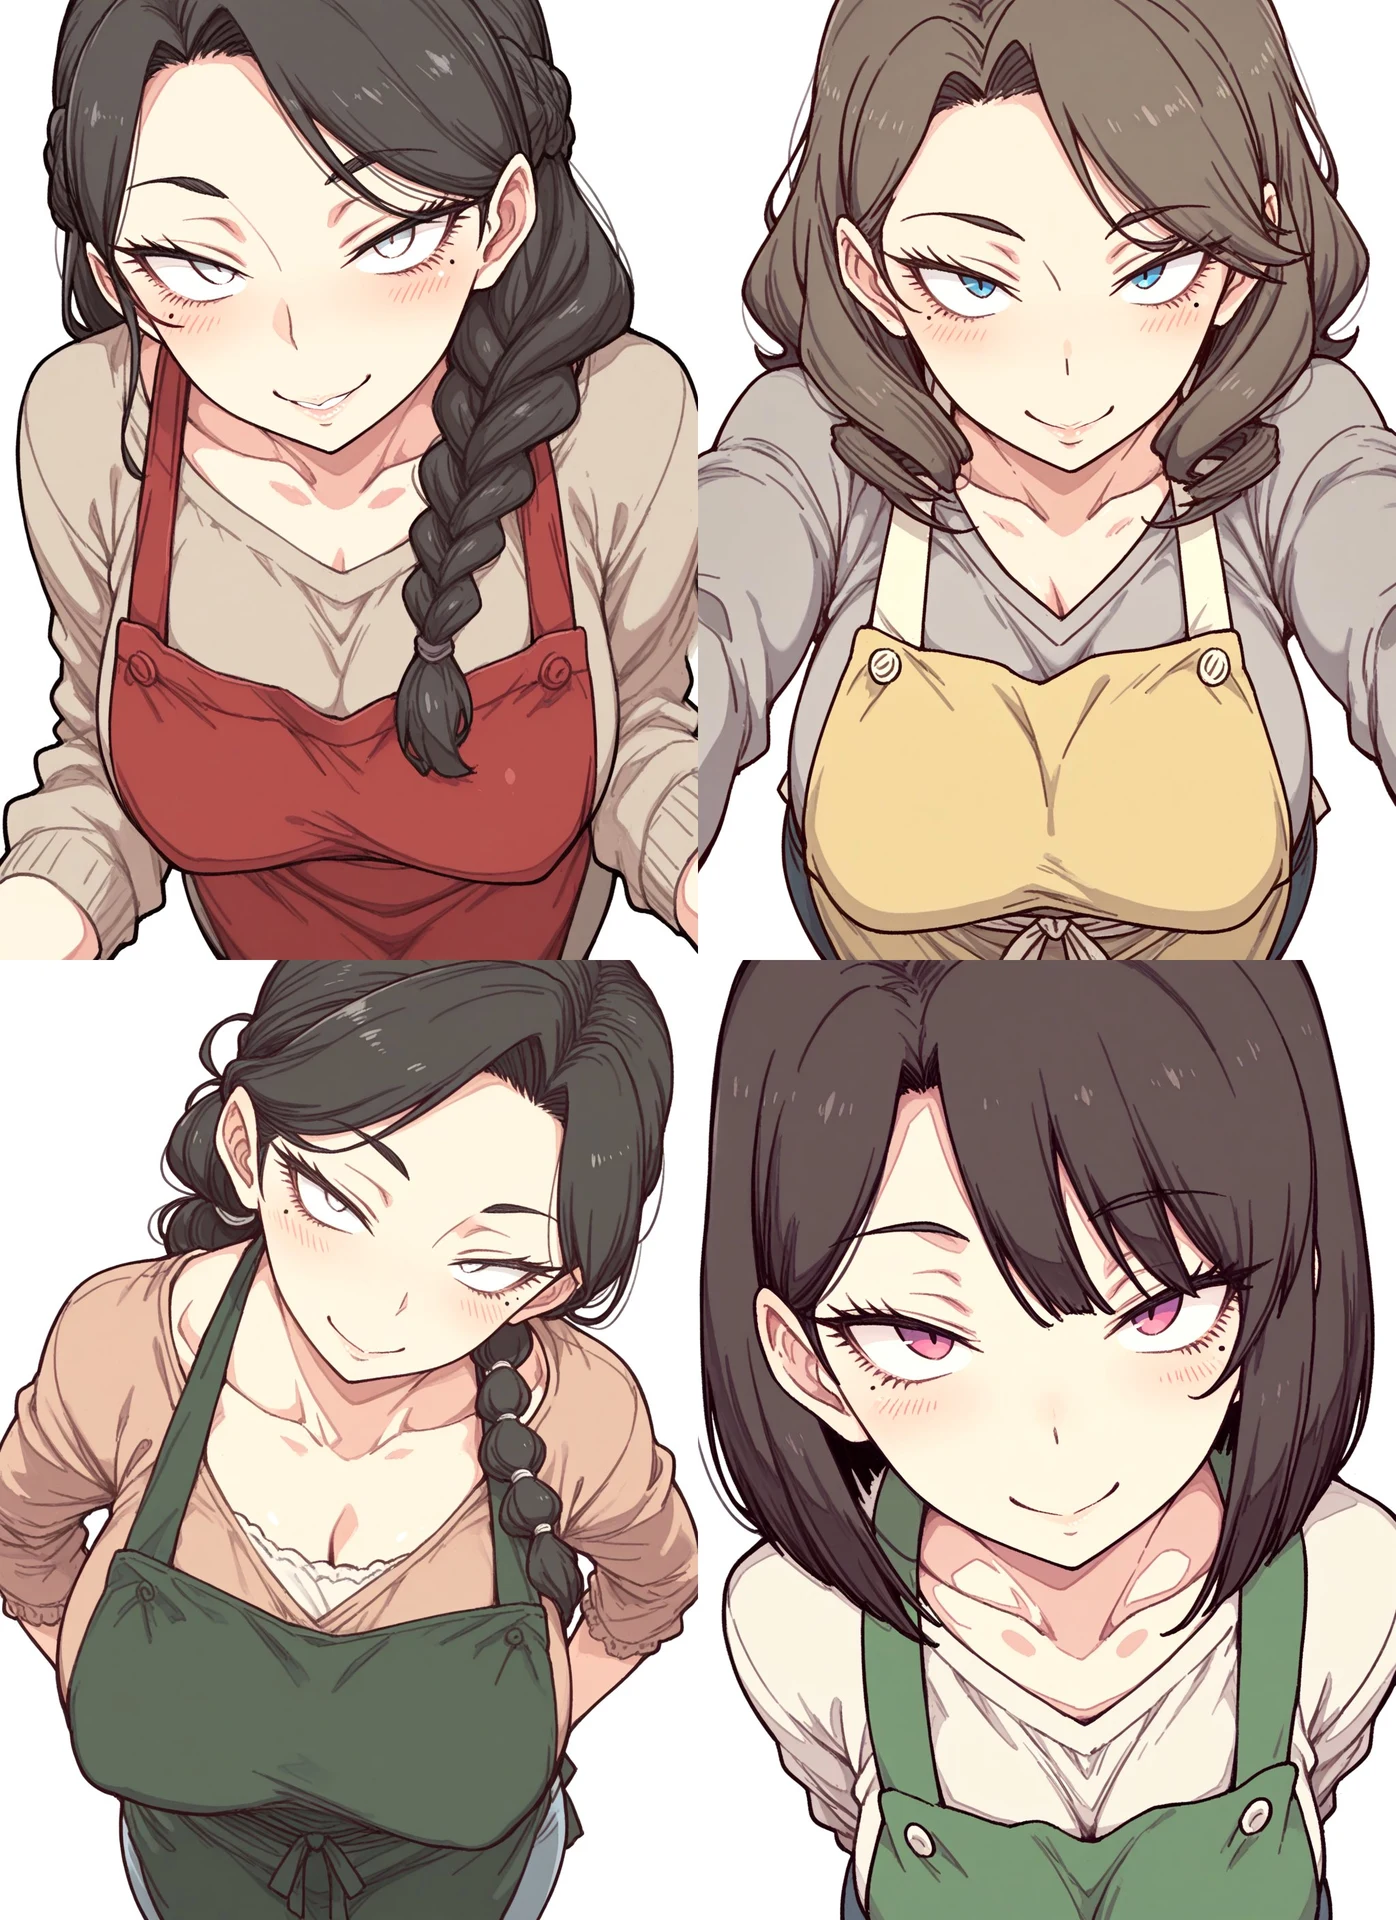
1枚絵のペアで学習させるCoppyLoRA法は非常に手軽なのですが、こうした任意の学習がなかなかうまくいかないのが悩みのタネでした。タグ付けのやり方などをイチから見直したので、改めてローカルLoRA学習の基本記事として書いていきたいと思います。

1.自分の「好みの画風」はどんなもの?
実際の工程をみていく前に、まずは「自分の好みの画風」を探るところから始めなくてはなりません。自分の手描き絵の画風を再現するのであればよいですが、私のように自分の手で理想の絵を描けない場合は、自分の「好き」ってどんなのだろう?という命題と向き合う必要があります。リアルタッチかデフォルメ強めか、頭身はどれくらいか、書き込み量は多いか少ないか、フラットな塗りかそれともグラデが効いているか、瞳の大きさやデザインは?幼め?人妻風?髪や瞳や肌のハイライトはどんな感じ?などなど、いろんな選択肢がありますね。
もちろん、好きな作品や作家さん、イラストレーターさんの画風を軸に考えるのもよいかと思いますが、実在するクリエイターの作品を集中学習させた「名指しタグ」や「名指しLoRA」は炎上と隣り合わせで、単独で使うのは非常にトラブルフルです。そこで、タッチや画材、線の太さ、書き込み量などを調整できるさまざまな調整系タグ・LoRAと複雑に組み合わせて、誰の絵にも似ていない「オリジナルAI画風」を作ってしまおう!というのが今回の企画なわけですね。
・好みの画風を組み上げていく
今回私が作った画風LoRAのテーマは「表情が豊かに出せる」「たれ目キャラとツリ目キャラではっきり顔立ちを描き分けられる」「たれ目は甘く可愛く」「ツリ目は鋭くクール」「年上はエッチに」「線は手描き風に少しジャギーな感じ」「色彩は豊かでポップ」「髪のハイライトと瞳のデザインに特徴を持たせる」「リーニュクレール風の塗り表現」といったところ。
ハイライトや瞳のデザインは、これまで作ってきたCoppyLoRAを複数組み合わせて表現しました。このような画像ペアの差分でできたLoRAが手元にたくさんあるので、これらを強度を強めたり弱めたりしながら適用して、ちょっとずつ好みの画風に寄せていきます。
その結果たどり着いた、スタンダードに「好み!」と言える画像がこちらです。茶髪より画風の色選びがはっきり出る金髪緑眼のキャラクターを被写体にしました。ピースサインを映り込ませたのは、指や爪の描き方も学習させるのが狙いです。
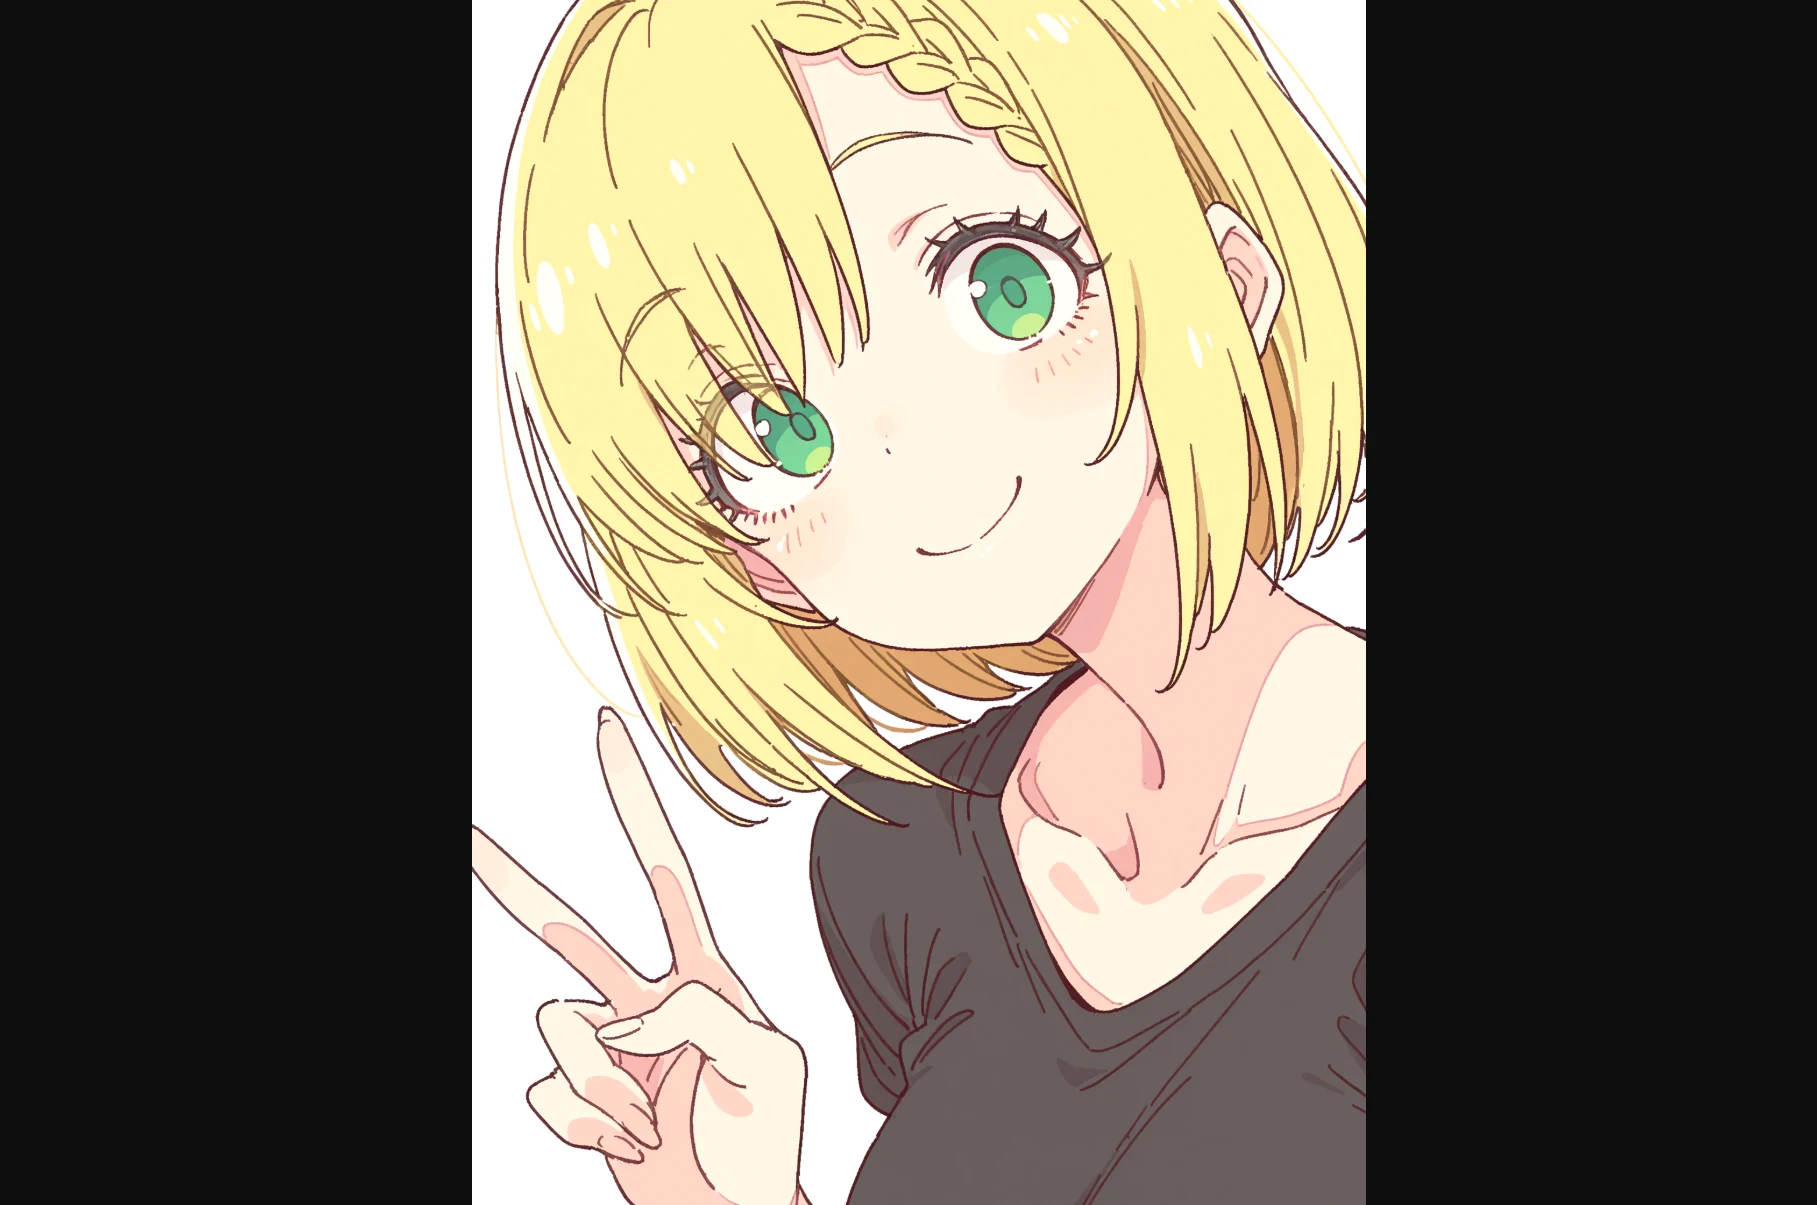
ジャギーな線、まつげの豊かさ、リーニュクレール(色をフラットに描いて、影を実線で縁取る手法)などはプロンプトで再現しました。jaggy linesやlong eyelashes、ligne claireといったタグを強度調整して組み合わせ、既存クリエイタータグも非常に弱めに、かつ複数掛けています。特定のイラストレーター風に顔立ちが寄っては意味がないので、これはごく弱めに、瞳のデザインを少し動かす程度に使っています。
2.CoppyLoRAをサクっと作る
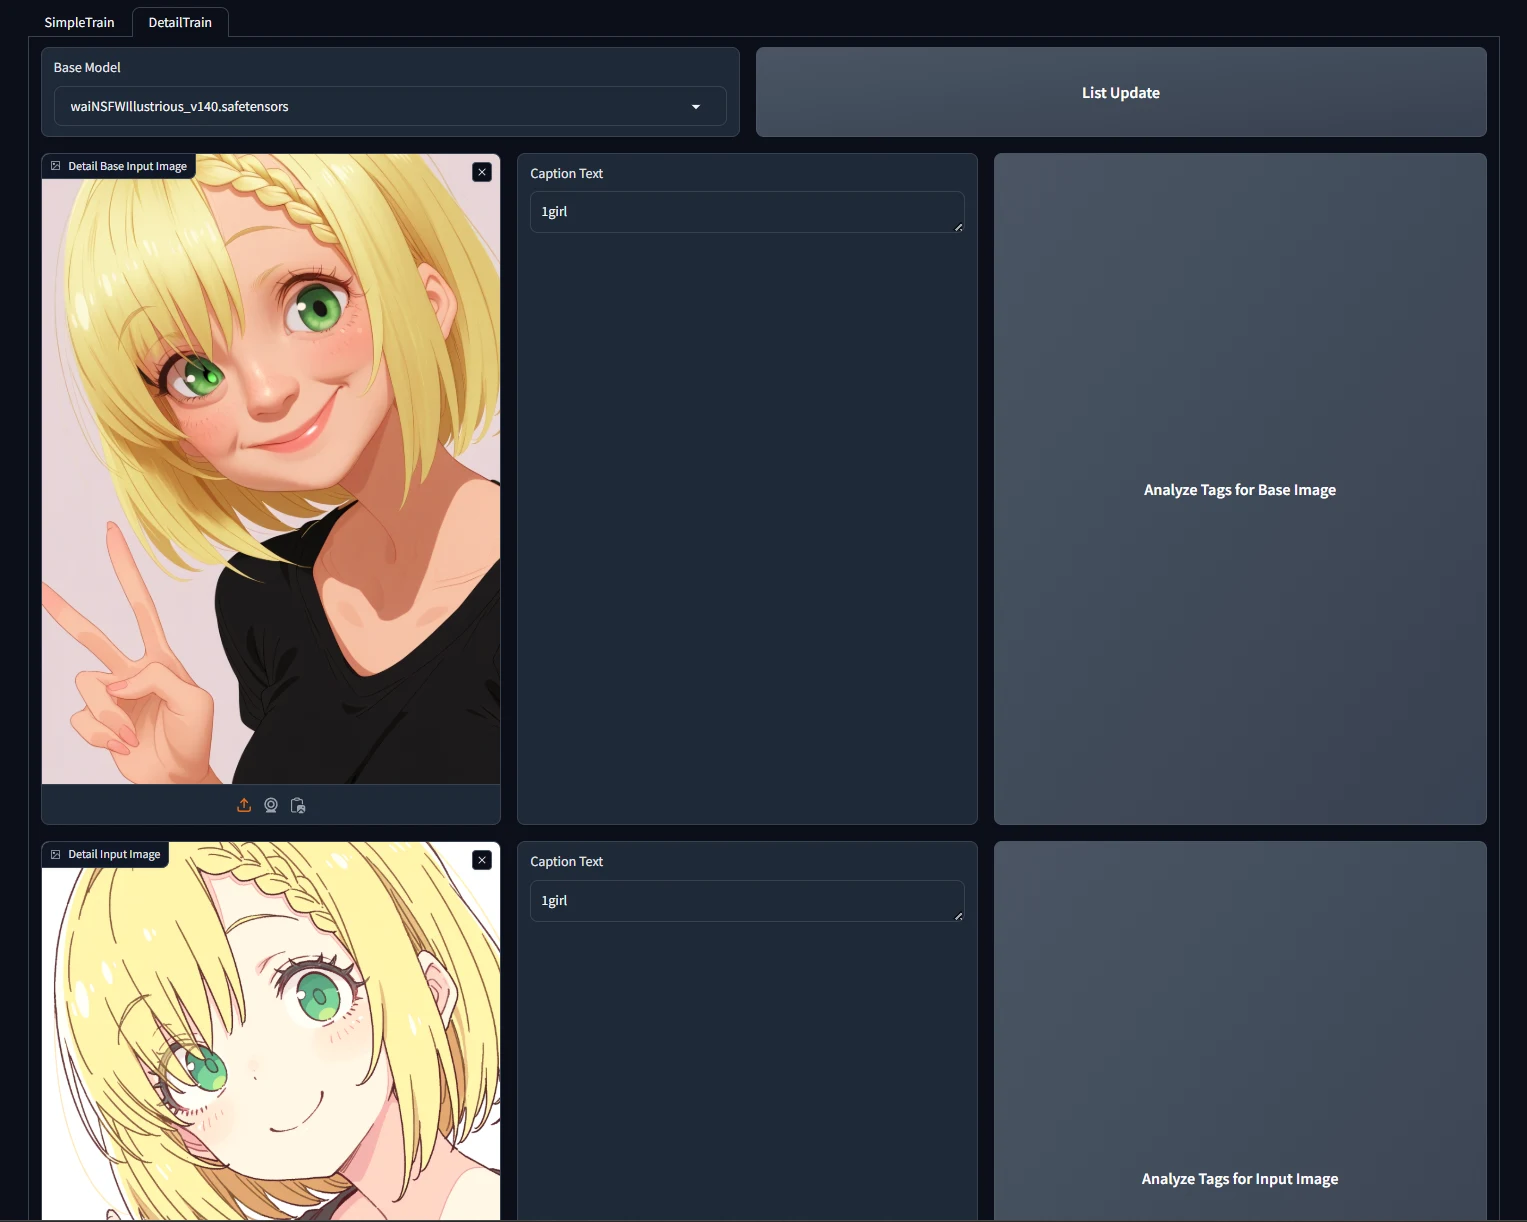
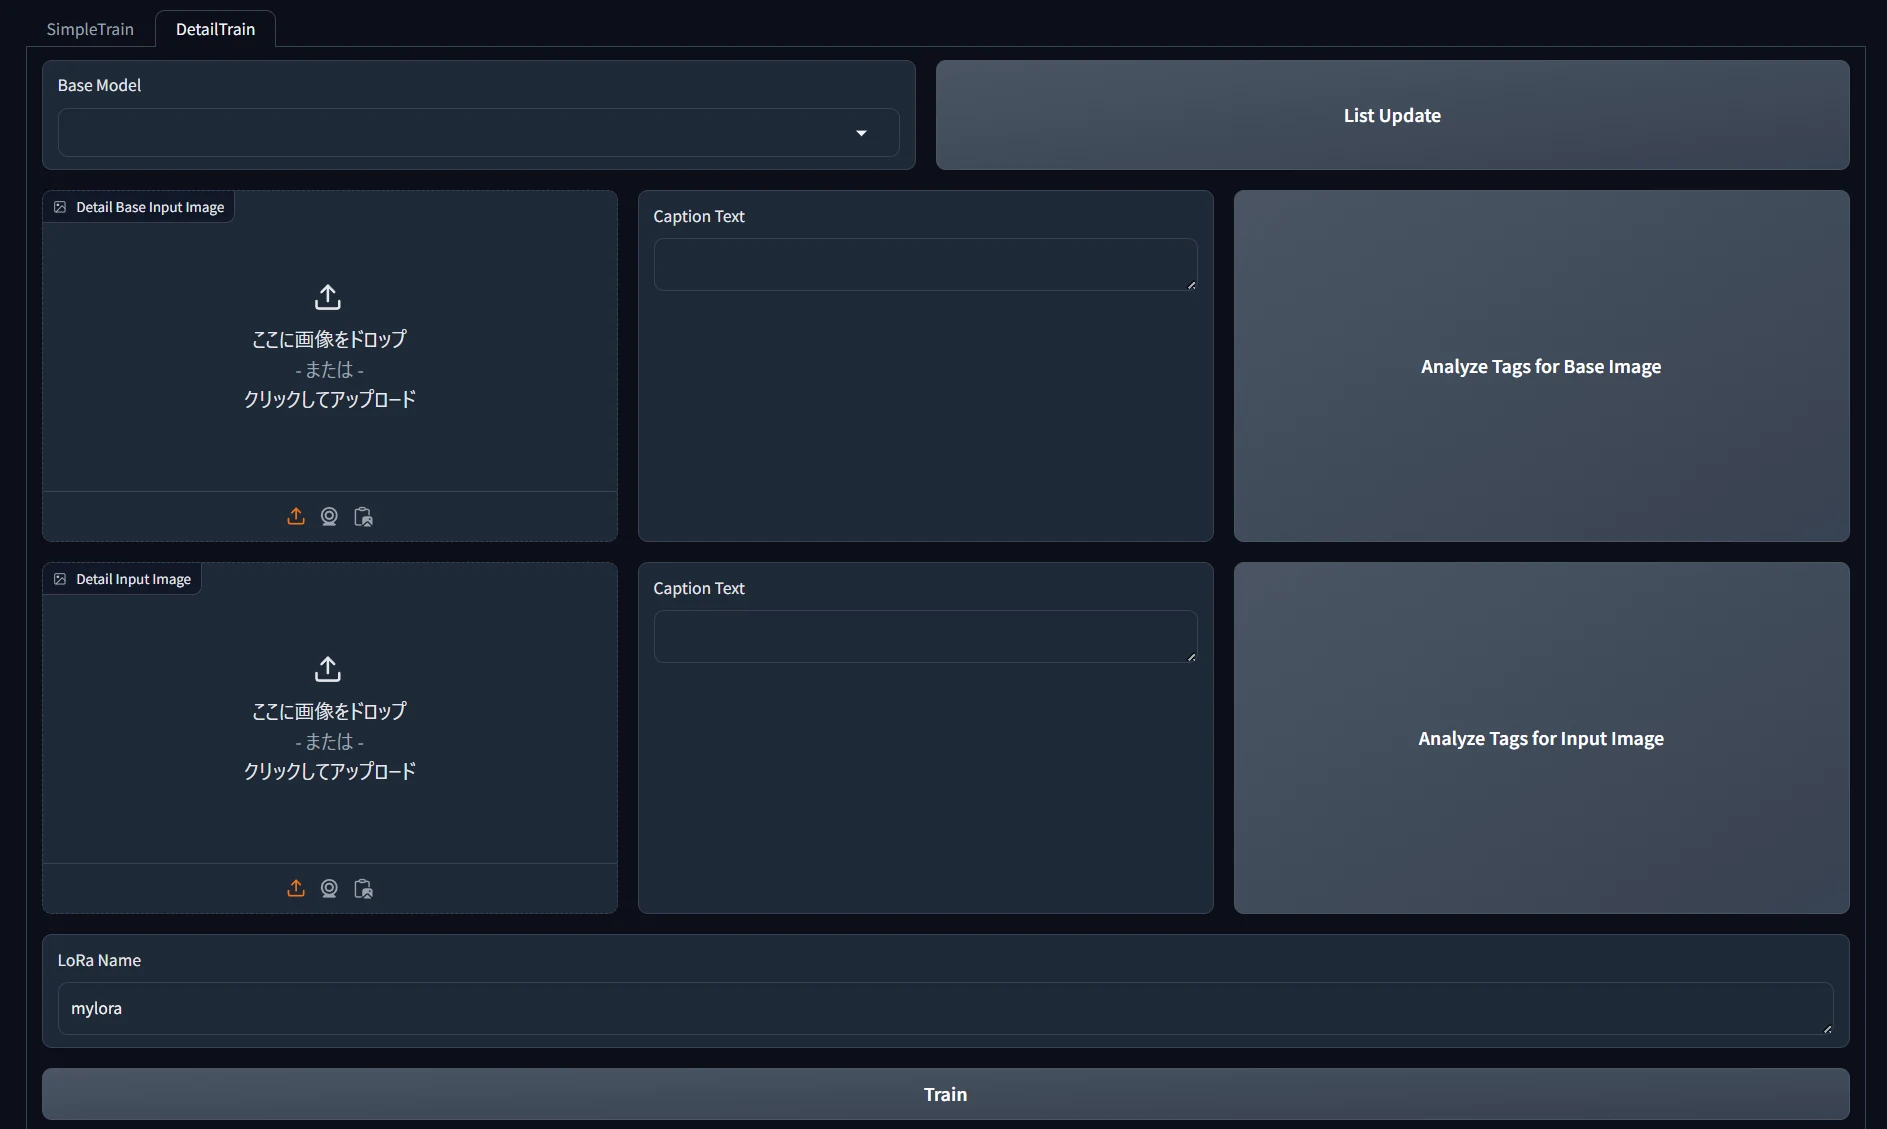
画風の「ベース」となる理想の1枚ができたので、こちらをCoppyLoRAwebUIでLoRAにします。やり方はごく簡単。CoppyLoRAwebUIを起動して、左上からDetailTrain(詳細学習)モードを選択し、さっきの1枚と、それを「画風だけ破壊」した1枚を入力するだけです。
画風破壊は、描かれている被写体の位置やアウトラインはそのままに、タッチだけを大きく突き放す必要があります。いろいろなやり方がありますが、私は元画像のアウトラインをanytest v3で保持しつつ、実写系モデル(juggernautXL)を使ってこのように突き放すのをよくやります。
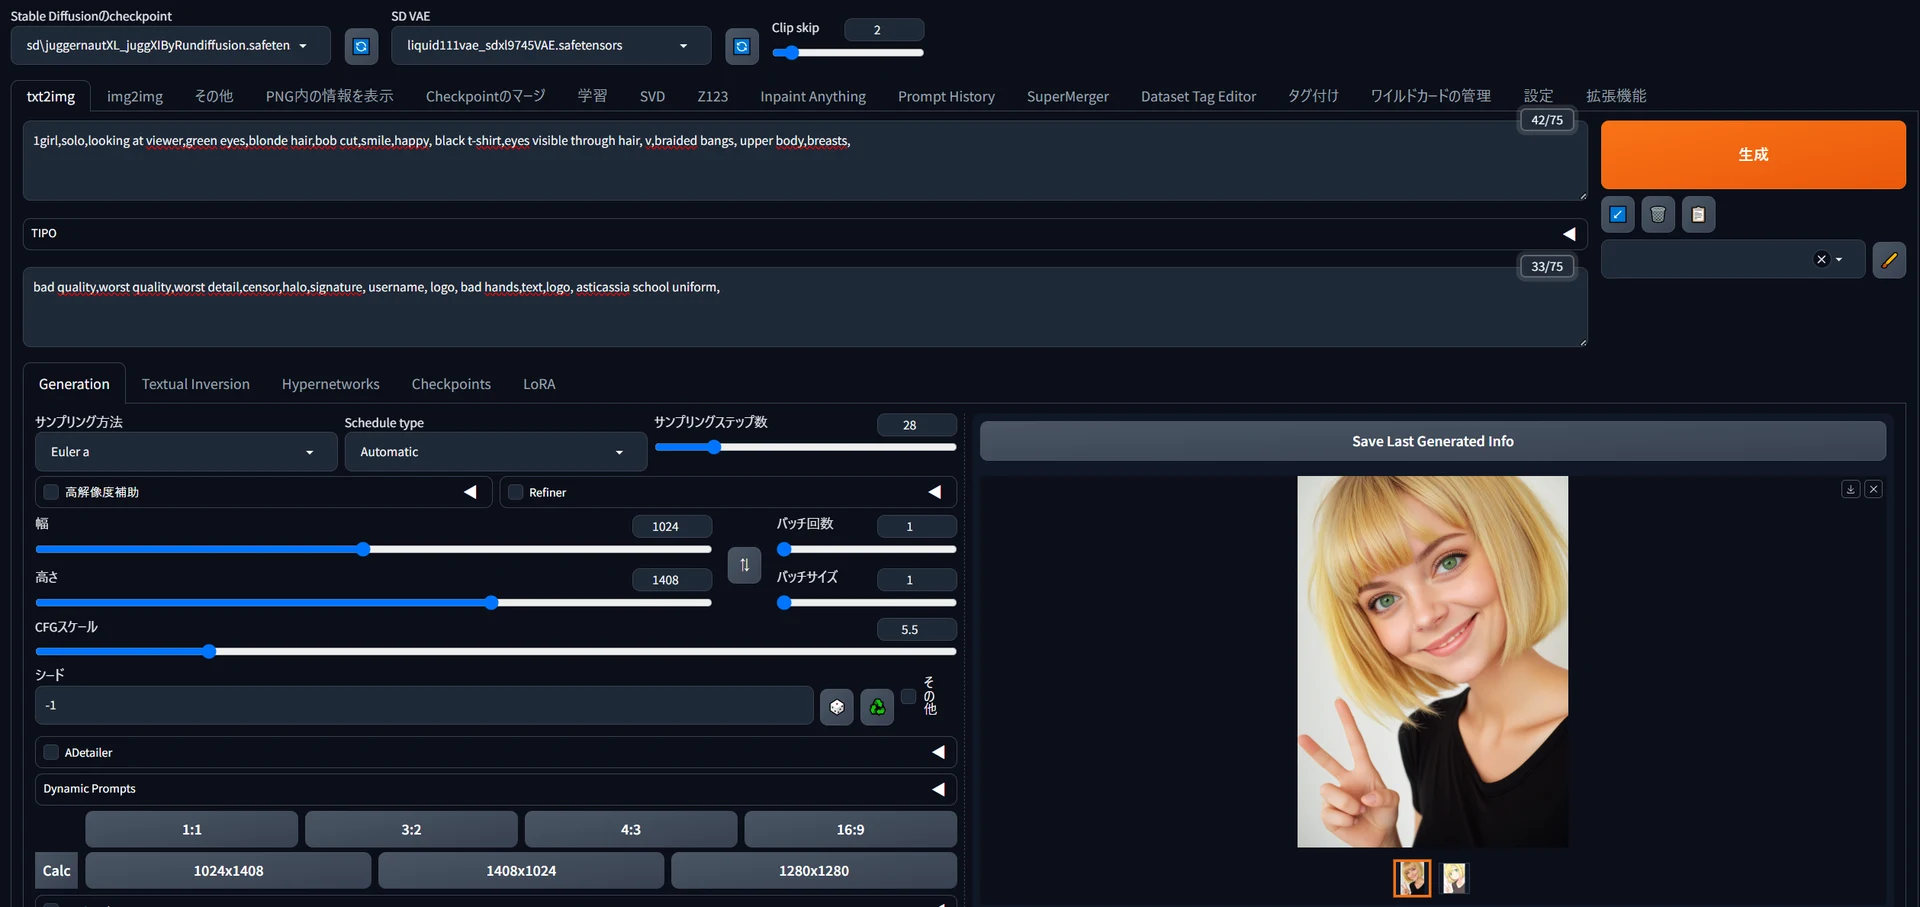
大事なのは、手や顔や視線や髪の色など、描かれているものは全く同じにすること。二つのペアで、異なっているのが画風だけにしないとなりません。破壊した画像の目が大きくなりすぎると、その差分も抽出されて「目を小さくするLoRA」の性格が強くなってしまうので、あくまで画風だけを突き放したいところ。
ですので、完全に実写調にするのではなく、ほどほどに瞳の大きさも揃えることで、このようなペアにしました。この調整は、Anytestの強度やステップ範囲を調整することで実現しています。
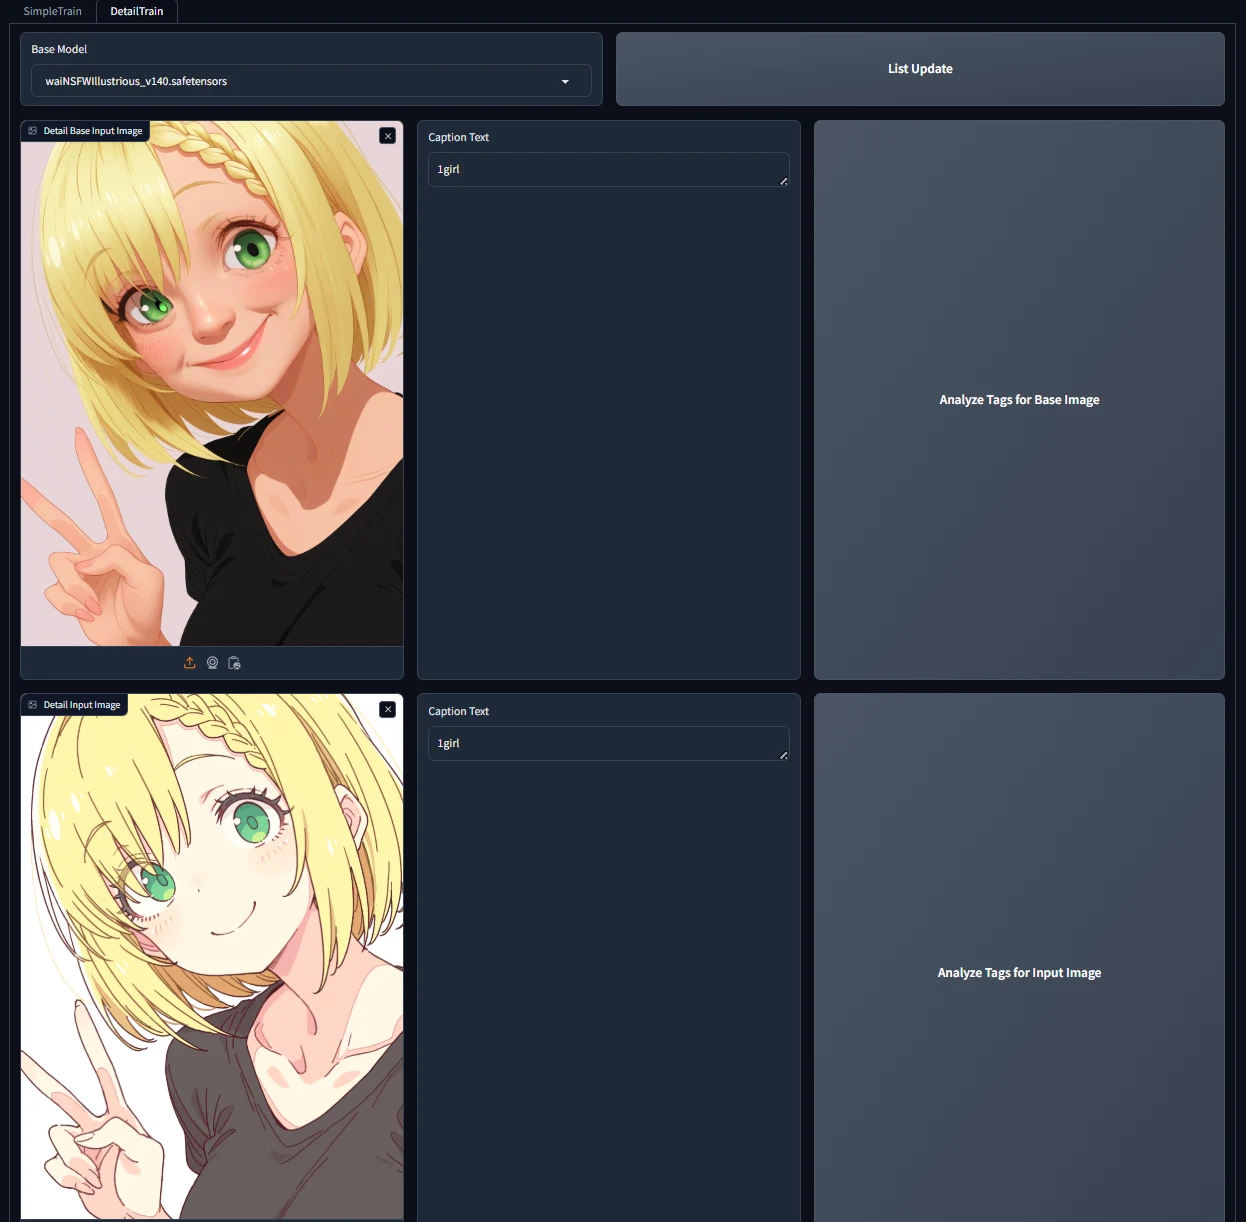
あとは上のスクショのように、ベースモデルを選んで、キャプションを記入し、LoRAの名前を適当に決めて「Train」ボタンで学習開始するだけ。ちなみに、キャプションは右の「Analyze」ボタンで自動抽出できますが、別にblonde hairやgreen eyesと書かなくても「1girl」のみで十分うまくいくことが分かりました。
//////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////【2025/11/14追記】CoppyLoRAのキャプションについて
1girlのみでもこのように画風の学習が可能ですが、コンセプトLoRA(特定の部位のみに効果を利かせたい場合など)の学習時は、きちんと髪型や目の色などのタギングをしたほうが侵襲性の少ないLoRAになることが分かっています。侵襲性が少ないというのは、LoRAをOFFで生成した画像と同一Seed同一設定でLoRAを適用した場合、生成結果に狙っていない変化が起きにくいということです。
CoppyLoRAのキャプション付けはやや難しく、場合によっては予想外の結果を呼ぶことがあります。例えば今作っている画風LoRAのペアを版権キャラで生成した場合に「souryuu asuka langley」タグなどを入れていると、そのキャラを生成したときにしかうまく利かない画風LoRAになってしまうことがありました。
この記事では1girl生成したときはこういう差分を再現してほしいんだよということを強調したかったので1girlタグのみで差分を取りましたが、侵襲性を低くしたい場合にはAnalyzeボタンを使って通常のタギングのようなキャプションにしたほうが良い結果になることが多いです。(その場合、shirtとwhite shirtのような重複タグが出やすいので、片方を削除するとより正確性が増すようです)
コンセプトLoRAにおけるCoppyLoRAのキャプションについては、こちらの記事をご参照ください。
//////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////
さて、さきほどの「1girl」のみのキャプションでペアの差分を学習させたところ、40分ほどでLoRAができました。プロンプト「1girl」で生成してみると、このような画風で生成できるLoRAとなっていました。
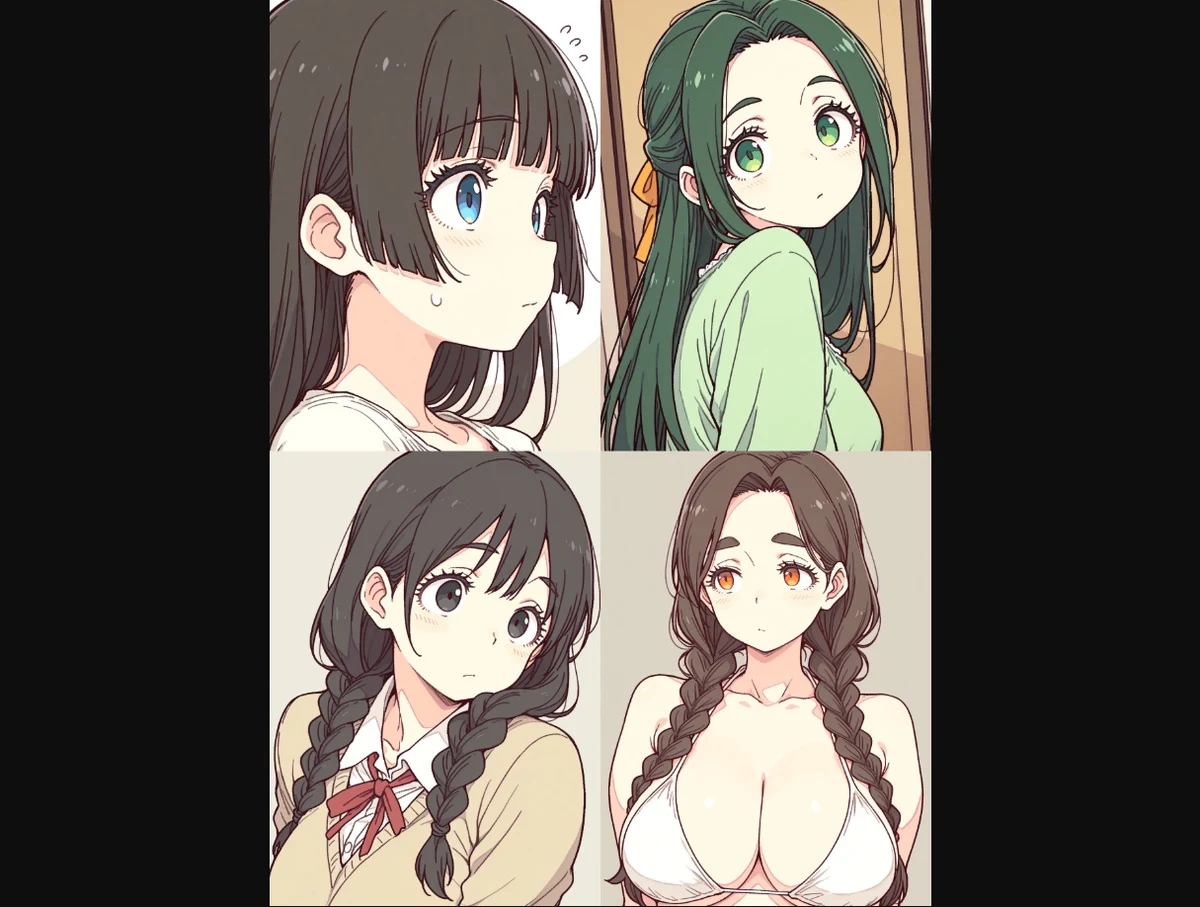
え、もうこれで十分じゃない!?
…と一瞬なるわけですが、今回作りたいのは、笑ったときや怒ったとき、釣り目や年上を表現したいときにどんな画風になるかも細かく自分で指定できるLoRAです。例えばこのモデルに「1girl,tsurime」と指示すると、とたんに今覚えさせた画風のそれらしさが失われて、ベースモデル(WAI NSFW)の素の画風が出てきてしまいます。
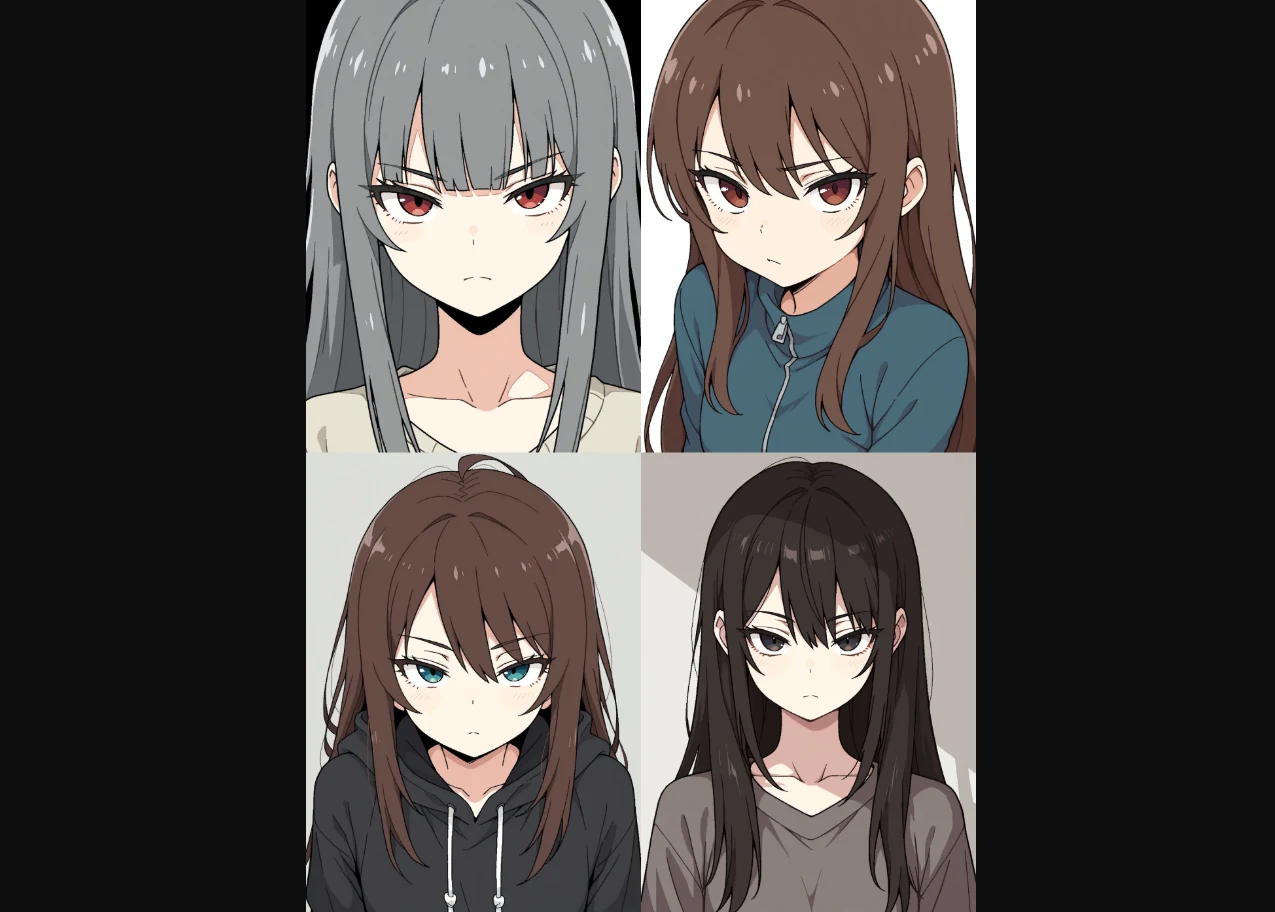
▲コレジャナイ…
そこで、このCoppyLoRAとベースモデル(WAI NSFW v14)を単純マージして「中間モデル」を作り、それをベースに釣り目やたれ目を覚えさせた「調整LoRA」を作って、二つのLoRAをWAI NSFWに混ぜて理想のモデルを作る…という工程をこれからやっていきたいと思います。イメージとしては、新幹線(CoppyLoRA学習)でおおざっぱにガッと目指す場所に近づいてから、各駅(従来LoRA学習)に乗り換えて正確に狙った地点に到着するーという感じです。CoppyLoRAは侵襲性が低く、大きく画風を動かしてもプロンプトの混乱が起こりにくいので、まずはそれでだいたいの位置まで画風を寄らせて、侵襲性がたかく失敗しやすい従来学習で細かく調整するーというのが今回の狙いですが、うまくいくでしょうか。
さきほど金髪緑目の女の子を生成したときのプロンプトでは、さまざまな画風LoRAや画風タグをごった煮にして、このような画像が生成できるようにしていました。いま「tsurime」で生成したCoppyLoRAの生成結果と見比べると、やはり色合いのポップさや表情のかわいらしさが再現できていませんね。これから、こうした「お手本」をたくさん作っていきます。
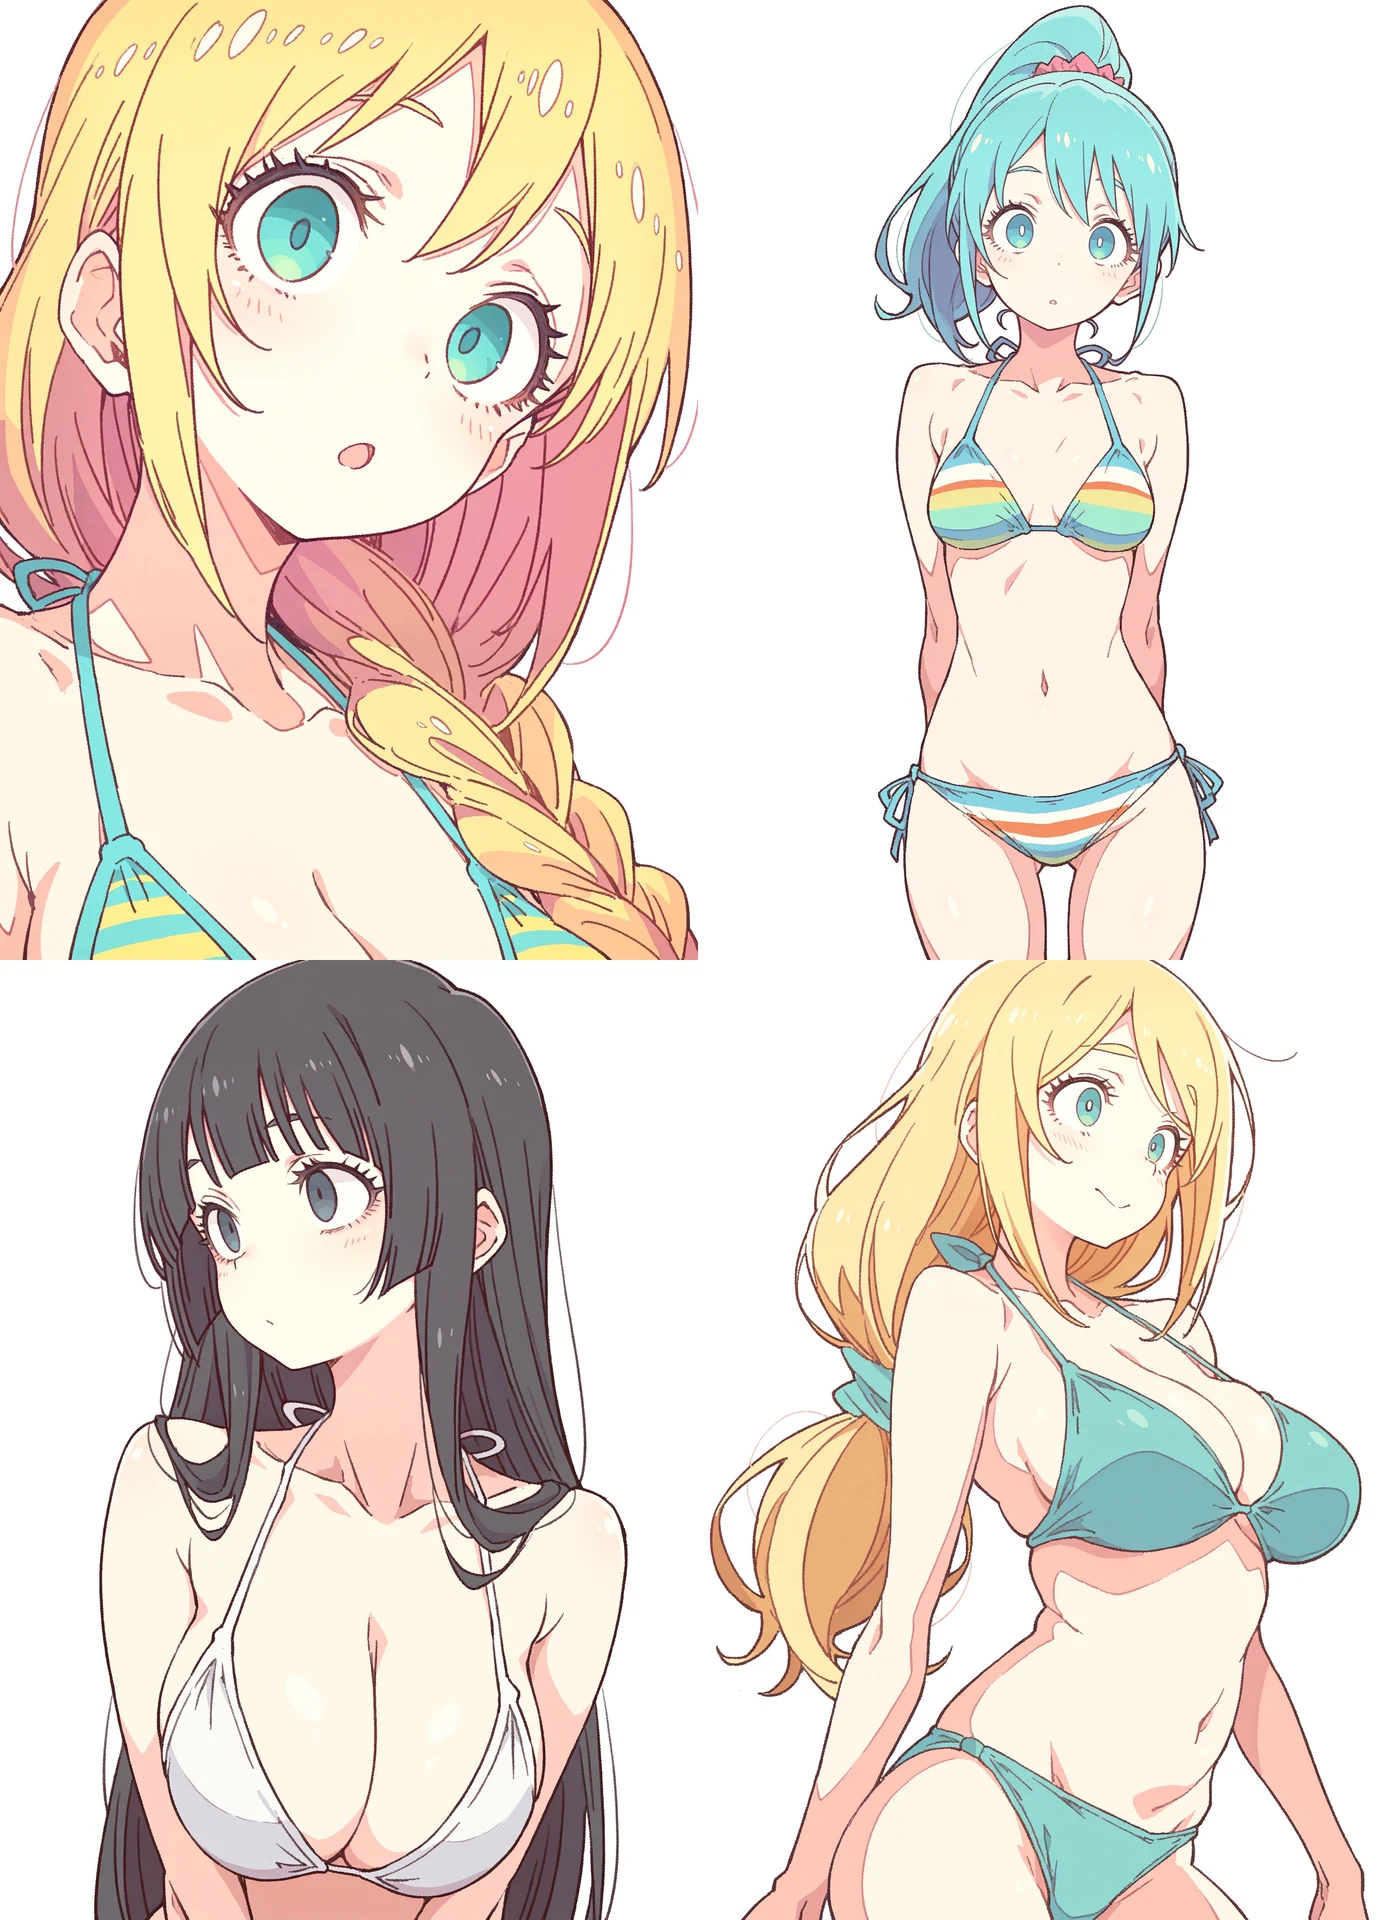
さらに、「tsurime」や「sanpaku」といったタグや別の画風LoRAを強度調整しながら適用して、釣り目顔の画風も作ってみます。「constricted pupils」などのタグと組み合わせて黒目の大きさをいじるなどして、これくらいが好み!という釣り目顔を作っていきました。
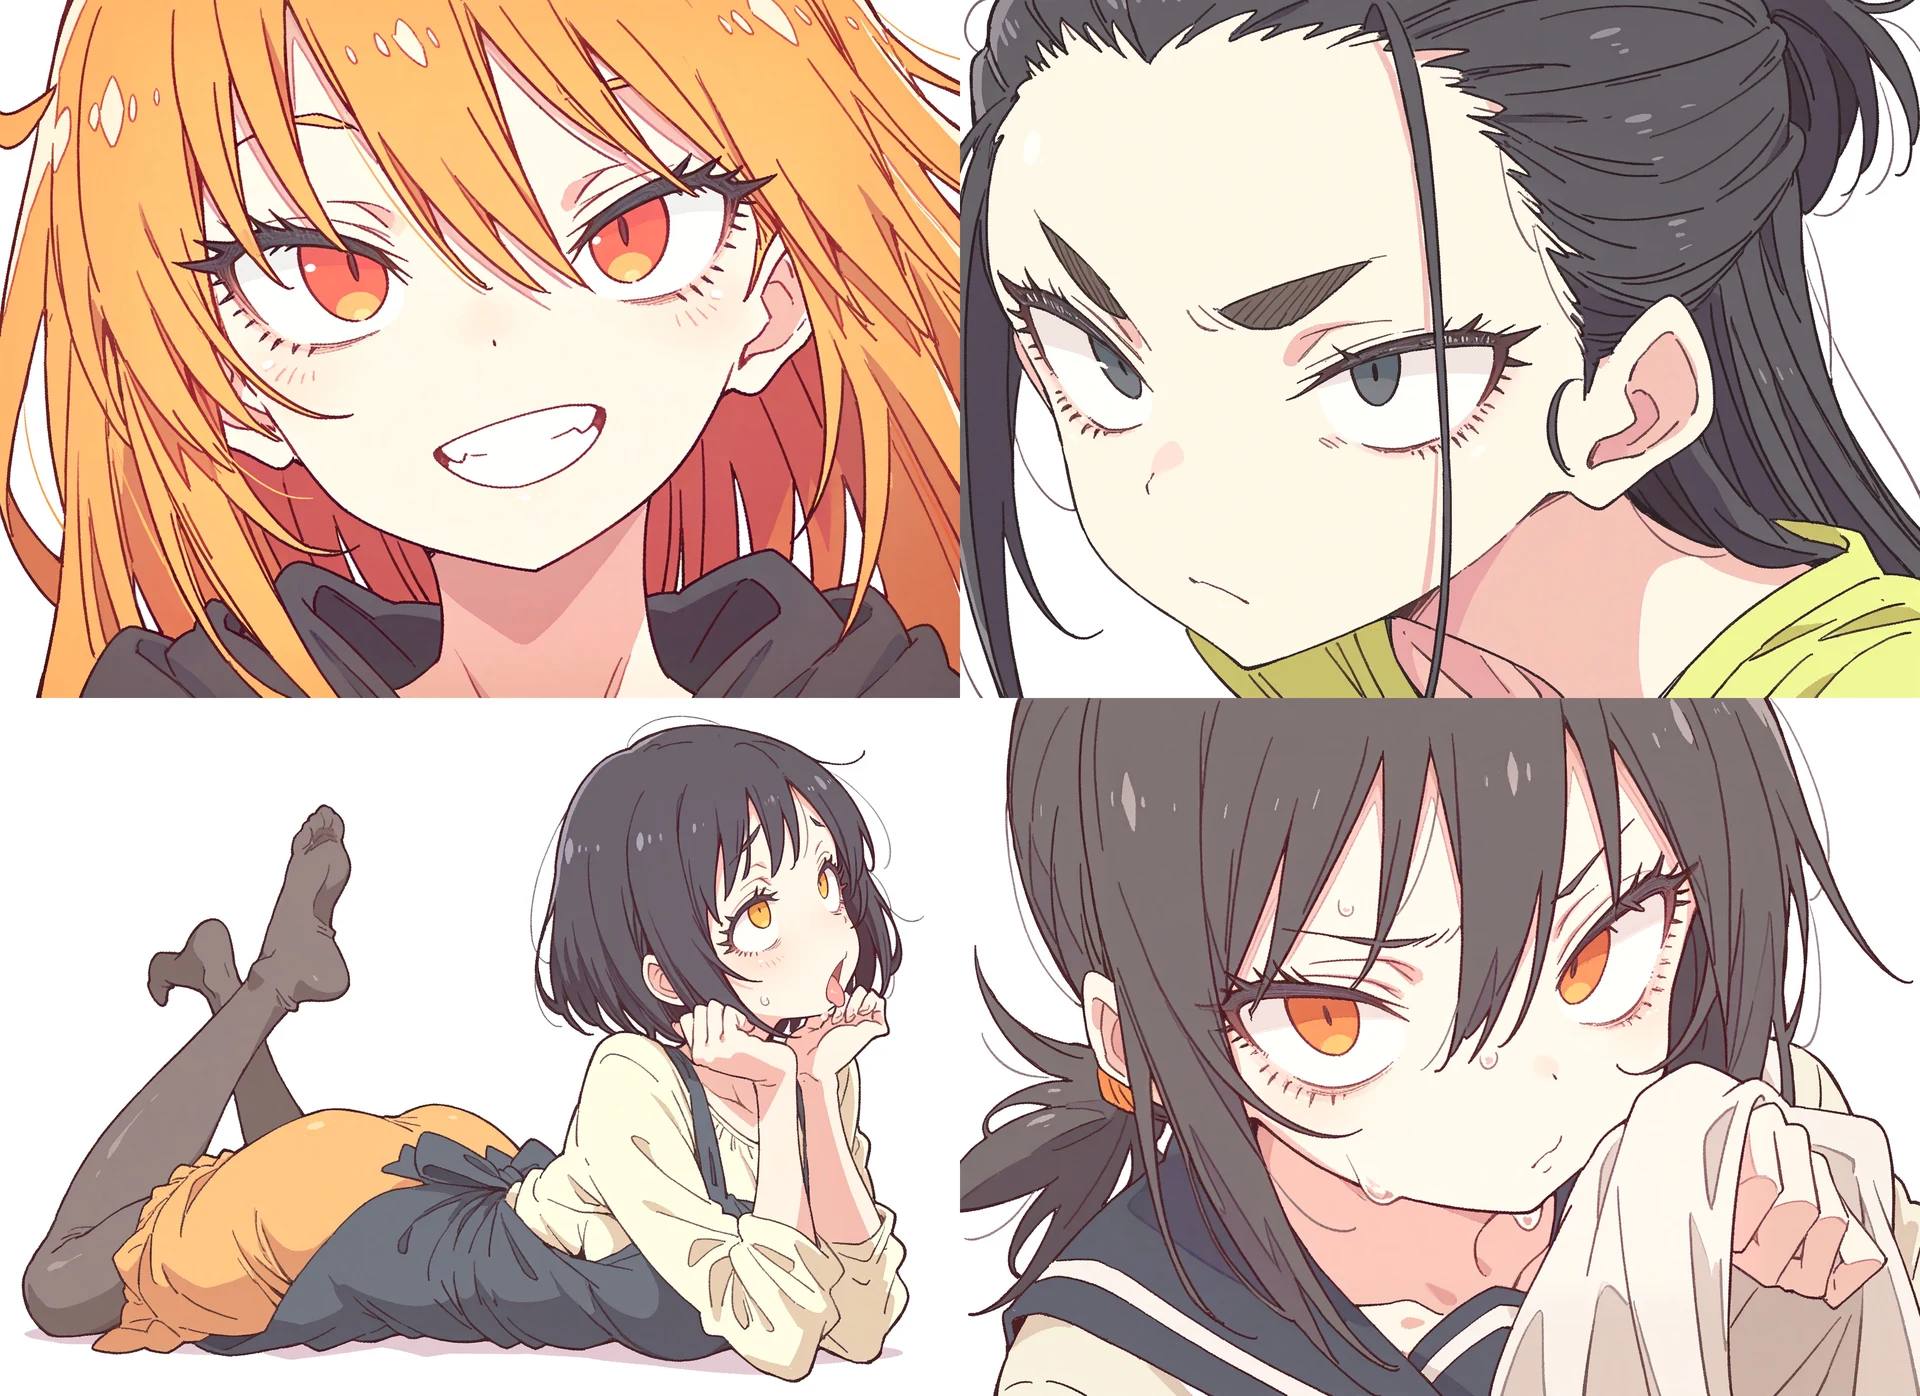
同様にして、好みの「mature female」画風も作っていきます。「mature female」でWAI NSFWで生成すると基本胸の大きい人妻風になるのですが、それでよいのか、それとも違う感じにしたいのか、自分の好みに尋ねてみて、好みの「mature female」が出るプロンプトを考えていきます。
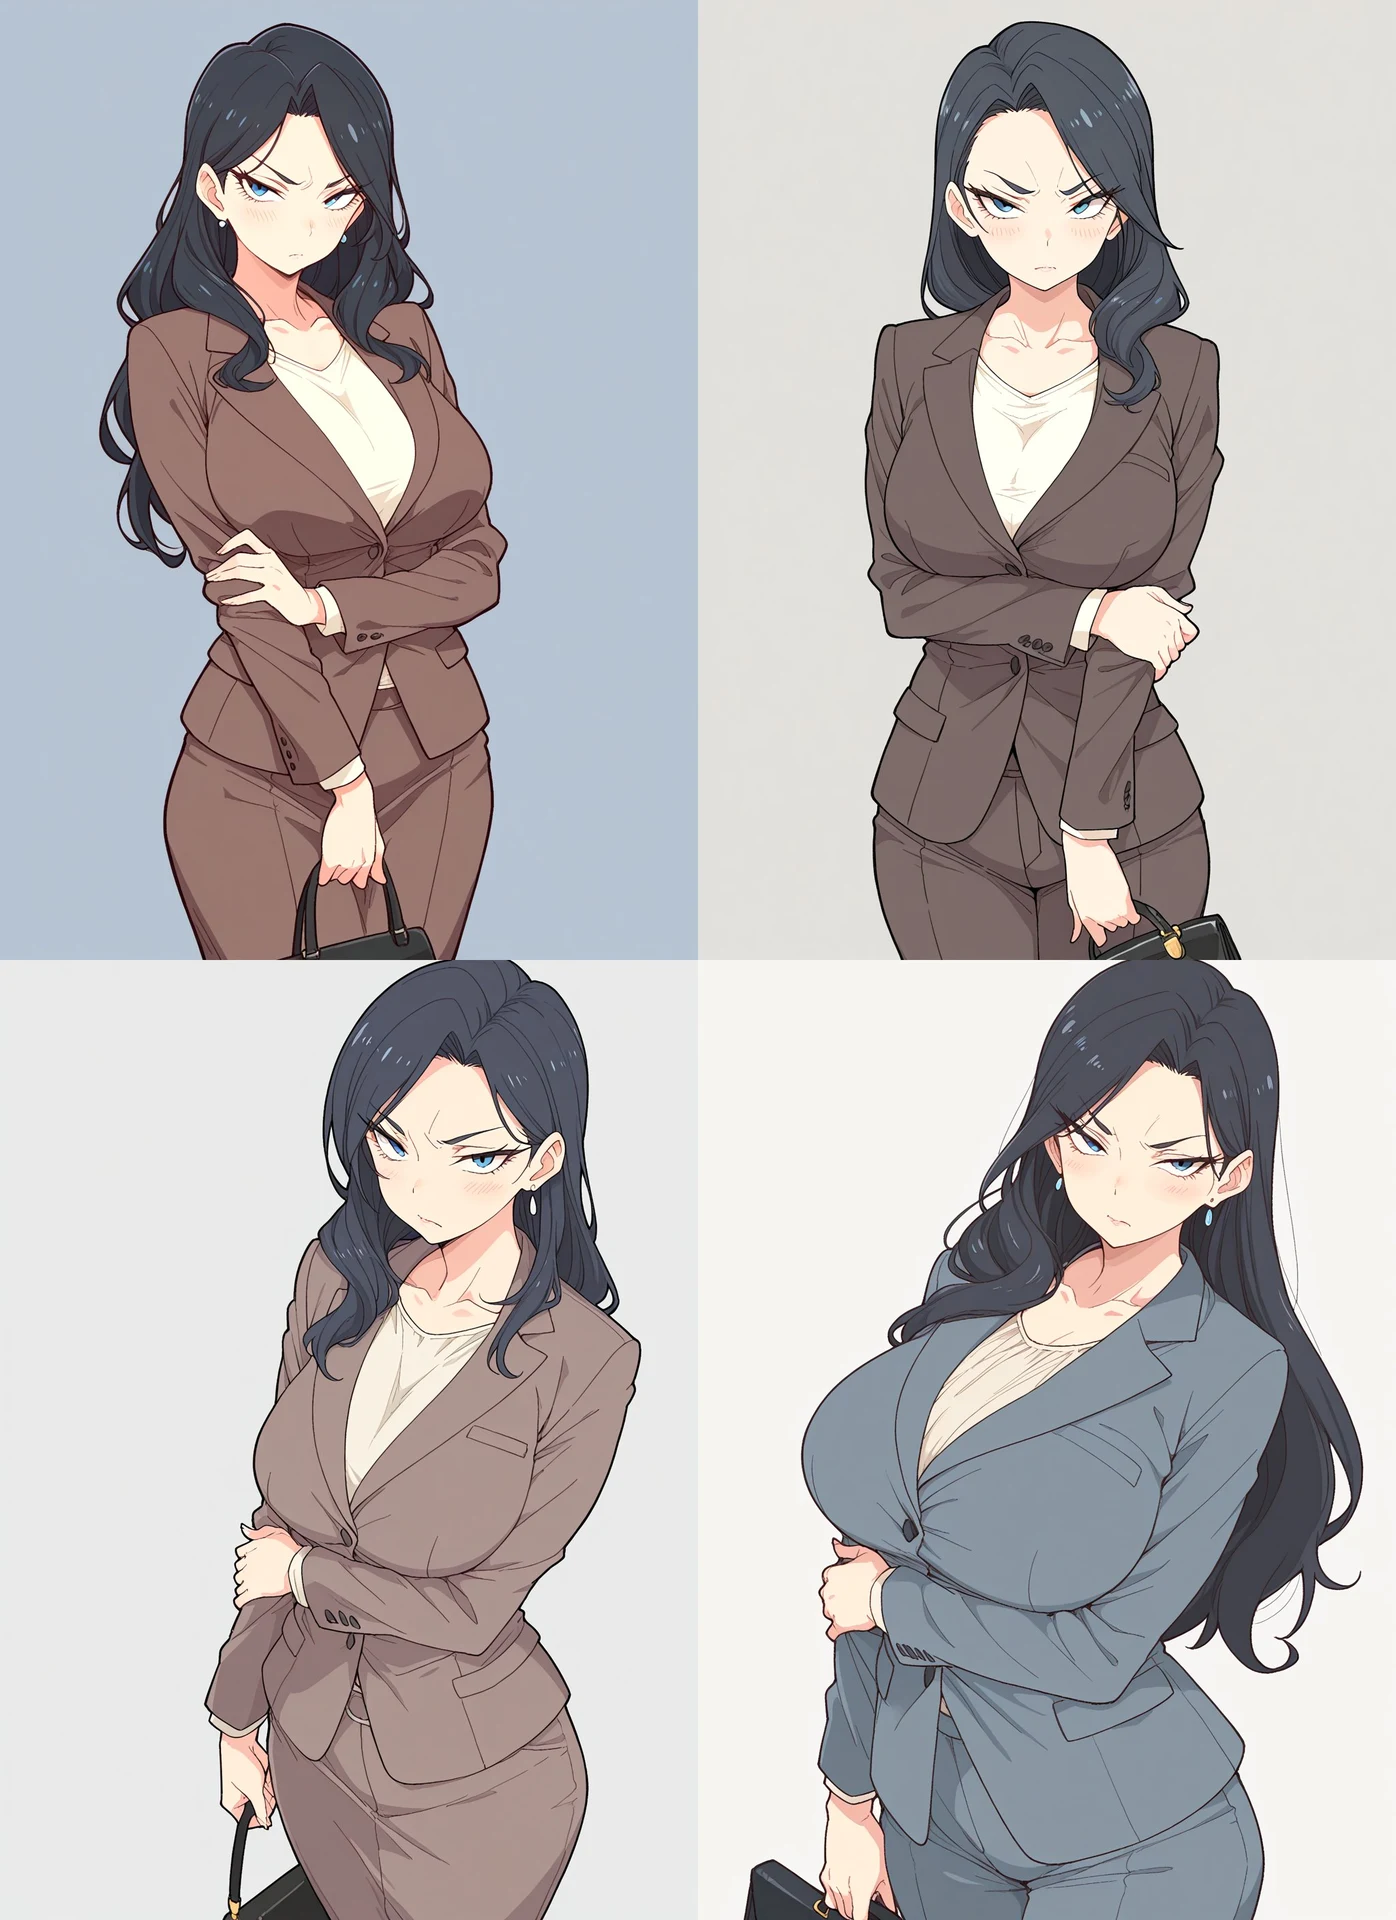
▲私はこういうのが好き
要するに、これからデータセット用に大量の学習用画像を生成するにあたって、「tsurime」「tareme」「mature female」それぞれが確実に好みな感じ(これから学んでほしいお手本)になるプロンプト三種を準備するわけです。既にCoppyLoRAによってある程度ゴール地点に近いところまで画風を寄せられているので、1枚の画像からでは抽出しきれなかった色使いや目のデザイン、表情といった重要な最終調整を数百枚の画像で学んでもらおうということですね。
3.データセット用にランダム要素を加える
LoRA学習用のデータセットでは、できるだけバリエーション豊かな画像を用意する必要があります。バストアップの画像ばかりで学習させると「この画風はバストアップにするんだな」と誤ったメッセージとして伝わってしまい、「full body」と指示しても上半身のアップばかりが出るLoRAになってしまうためです。今回のやり方では「各駅乗り換え法」を使ってこうした悪影響をタグ付けや設定で軽減しますので、そこまで厳密にバリエーション化させる必要はありませんが、やはり偏りは悪影響のもとですので、できるだけ均等化を意識しましょう。
wildcardとランダムプロンプトについてはこちらの記事を参照のこと。
簡単に言えば、「__服装__」のような指示をすると、あらかじめ用意しておいた服装タグ群から一つランダムにピックアップしてプロンプトに加えてもらえるのがwildcard。{smile|angry|sad|happy}のように指示すると、喜怒哀楽のどれかがランダム採用されるのがランダムプロンプトです。
今回は「表情」「ヘアスタイル」「年齢」「アングル・構図」「眉の太さ」「服装」「構図」「ツリ目かたれ目か」「髪や目の色」「視線の向き」といった要素をランダム化させたいので、このようなwildcard+ランダムプロンプトを組みます。
__expression_all__,{upper body|from side|cowboy shot|full body},{tareme|tareme|tsurime,sanpaku},{|||thick eyebrows}, {casual wear|school uniform|bikini| __cosplay__},{looking at viewer|looking ahead|looking away||},__eyes-color__,{||mature female},__hairstyle__,__eyecolor__,__haircolor__
hairstyleなどのwildcardは「プロンプト大辞典」で配布しているものを基に、不要なもの(例えば角刈りなどの髪型)を削除して使いました。こちらからDLできます。
配布ファイルはPixivFANBOX限定ですダウンロードはFANBOXの記事からどうぞ。PixivFANBOXの記事を開く
{|||thick eyebrows}や{|||mature female}のように組むと、4回に1回の頻度で太眉や年上キャラが混じります。このあたりは自分の好みでバリエーション頻度を調整すると良いと思います。
準備が整ったら、とりあえず何回か生成してみて、「思った通りの自分画風画像」が自動で量産できるようになるまで、プロンプトを微調整します。目が大きすぎるとか、手足が崩壊しやすいとか、もうちょっとまつ毛描写が欲しいとか、生成結果を見るとさまざまなことが分かるはず。例えば「表情が硬いな」と感じたら、__expression_all__を1.3倍強度で適用してみるなど、自分の好みと需要に従って最後の微調整を行いましょう。
今回は閉じた目をさほど用意しませんでしたが、閉じ目・半とじ目の表現も凝りたい場合は{open eyes|open eyes|open eyes|closed eyes|half closed eyes}などとしてもよいです。open eyesを増やすことで閉じ目ばかりになるのを防げます。
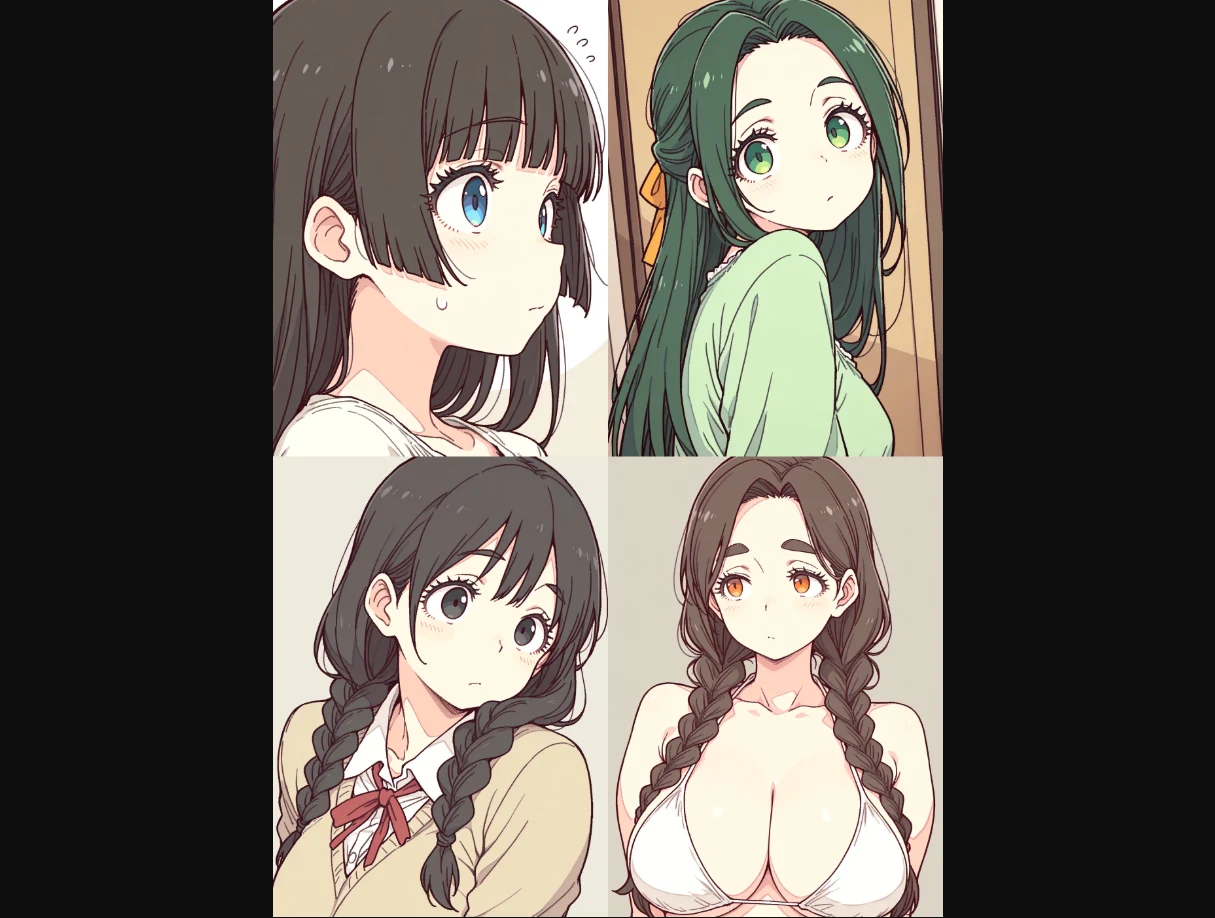
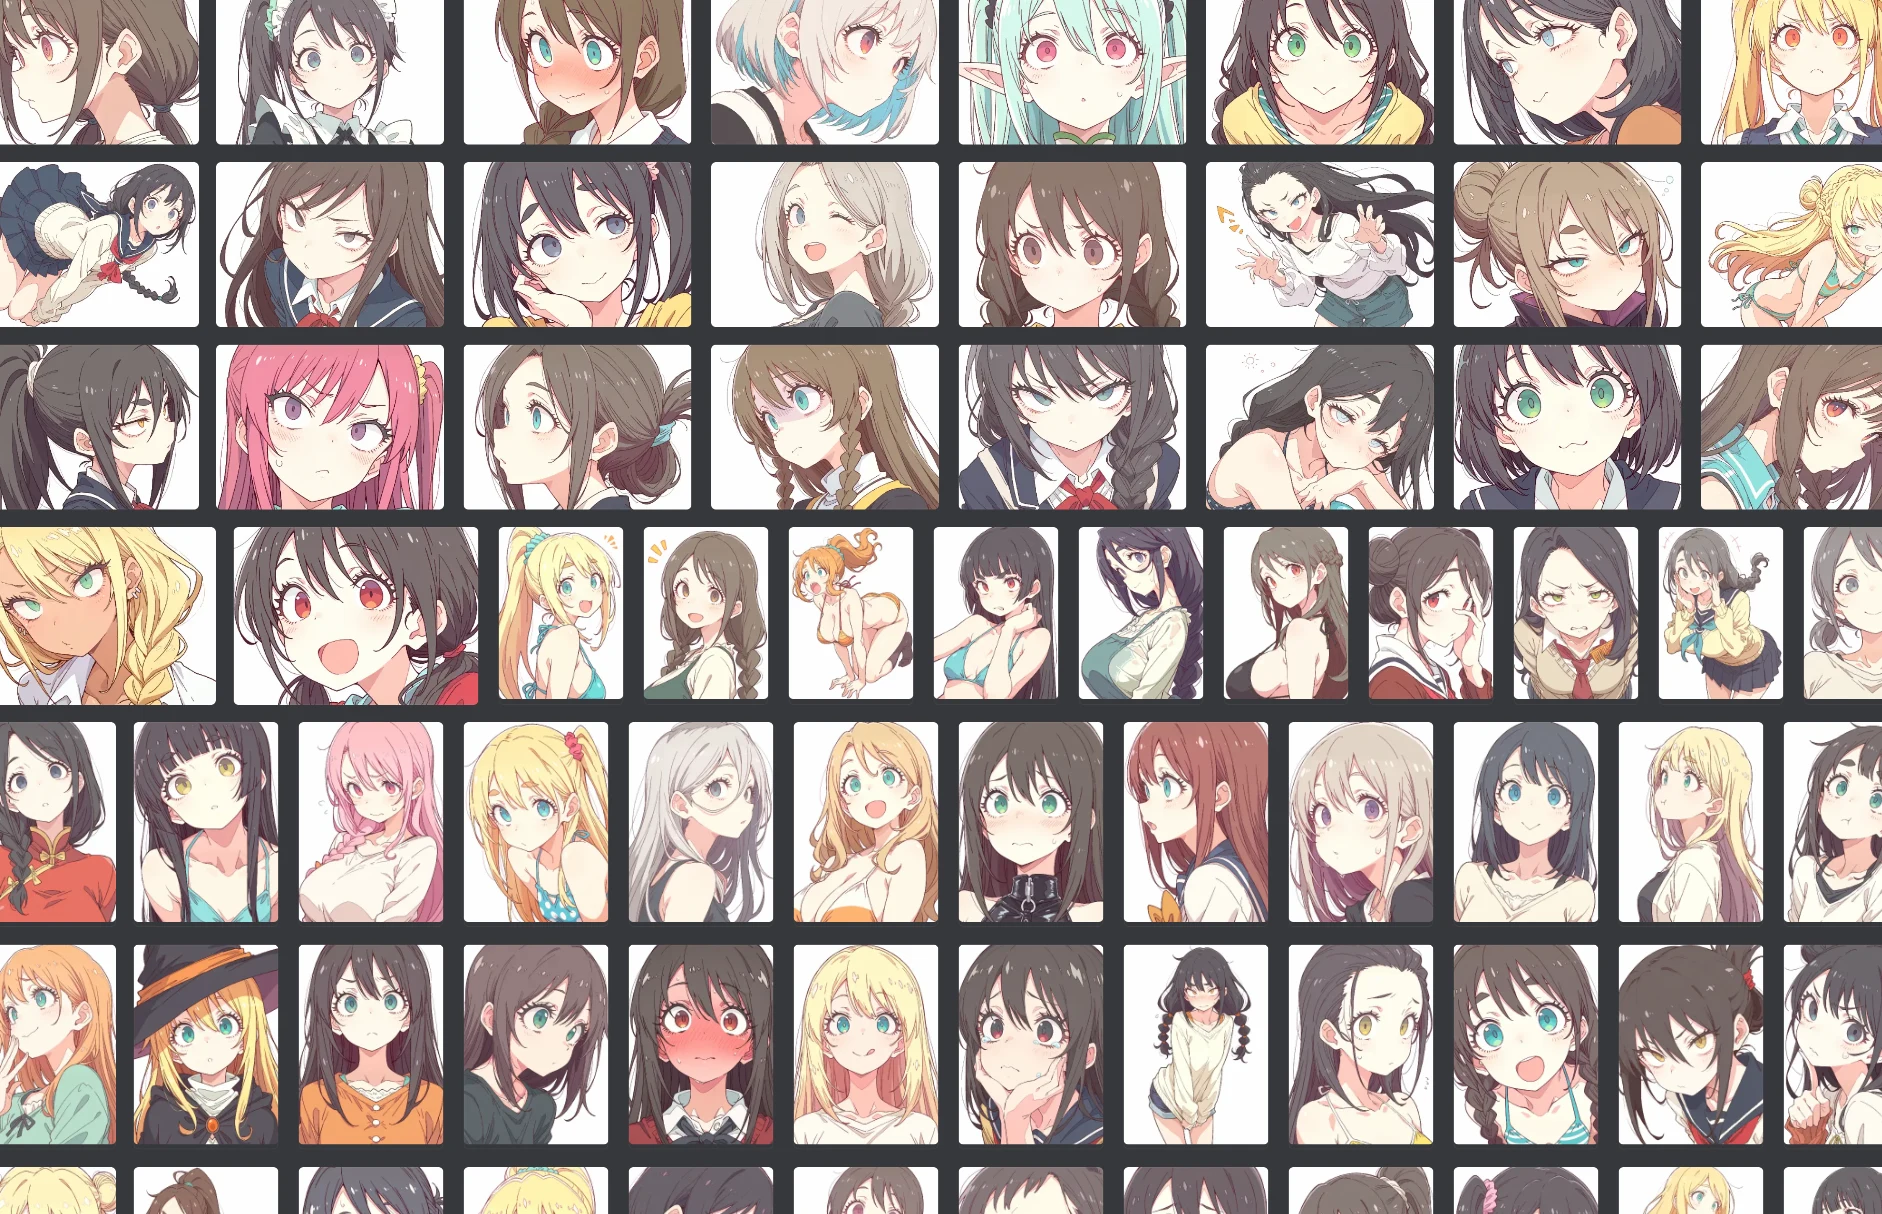
十分理想の画風でランダム生成できるようになったら、いよいよ本番の連続生成を開始します。できたプロンプトで縦400枚、横400枚が連続生成されるよう指示したら、あとはやることがないので就寝。翌朝、このような画像群がちゃんとできていました。
・縦横それぞれ400枚生成するやり方
ちなみに、400枚生成を2連続で行うにはこのような感じで指示します。
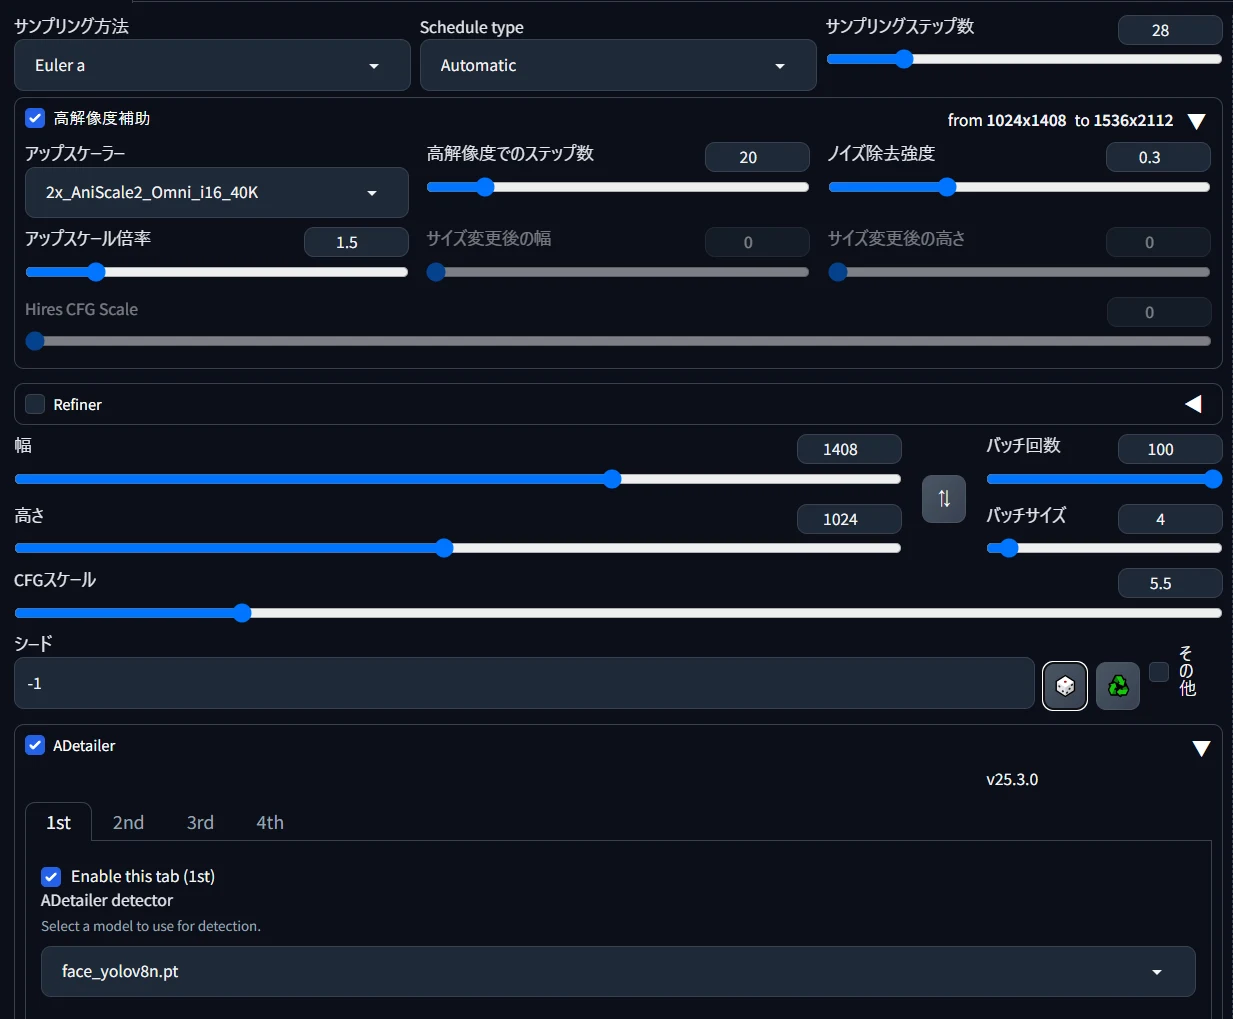
4枚同時生成+アップスケーラー+ADetalier適用で100回生成する設定でまず生成開始し、生成が始まったら「幅・高さ」を逆転させて(つまり縦長に変更して)、プロンプト欄でShift+ENTERを押すと、キュー(順番待ち)できます。これで放置しておけば、横長画像を400枚生成したあと、続いて縦長画像が400枚できているはずです。
・選別してフォルダにまとめる
生成できた800枚の中には、六本指などのミス生成や、学んでほしくない表現の画像も相当数混じっているはずです。これらを全部覚えさせると低品質な画風LoRAになるので、800枚の中から使えそうなものをピックアップしていきます。手・指が崩壊していたり、細部がおかしくなっている画像は除き、こういう絵にしたいんだ!という好みの画像を数十枚~数百枚ピックアップしてフォルダに放り込んでいけばOK。
データセット枚数に特に決まりはないので、自分の気合・体力と相談しましょう。枚数が多いことより、きちんと共通性、法則性があってミスのない画像群であることが重要。できるだけバリエーションを多く、均等にばらけさせるのもコツです。upper bodyばかりでfull bodyが少ないと、アップになりがちなモデルができてしまうからです。
フォルダ構成は以下のようになります。
LoRA/ ←適当な浅い場所にルートフォルダを置く(名前はなんでもよい)
└ training/ ←学習データを入れるフォルダ(名前はなんでもよい)
└ mystyle/ ←データセットの親フォルダ(これを学習させる)
└ 1_mystyle/ ←ここにピックアップした画像を保存する
好きな場所にルートフォルダ(例:LoRAフォルダ)を作り、その中にトレーニング画像フォルダ(例:training)を作るのがおすすめ。さらにその中に、これから学習するLoRAごとのフォルダを作るわけですが、画像を保存するのはさらにもう一つ下のフォルダになります。
このようなフォルダ構造になっていればOK。必ず「trainingフォルダの下は2重構造」「画像保存フォルダの冒頭は数字とアンダーバー」のルールを忘れないようにしてください。
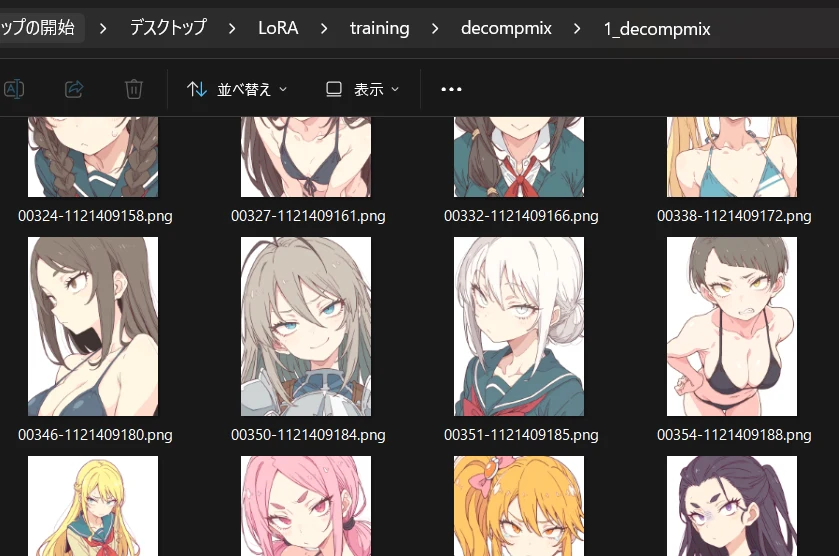
画像保存フォルダの頭の数字(上の画像では1)は、画像が少なめな場合にリピート(複数周回)する回数です。100~200枚ほど画像があるとよいわけですが、例えば20枚しかなかった場合に、5~10とここに記入しておくと、同じデータセットをその回数だけ繰り返し学習するので、100~200枚分の学習量に水増しできるわけですね。今回は数百枚画像を用意したので、繰り返しする必要はありません。
・画像を一括縮小
画像のサイズはすべて同じに揃える必要はありませんが、1024px基準で学習する場合、大き過ぎたり小さ過ぎたりすると勝手にリサイズ・トリミングされますので、フリーソフトなどで1024x1024pxの正方形からさほど離れていないサイズに縮小してしまうのがよいです。おすすめツールはこちらの「縮小革命」。
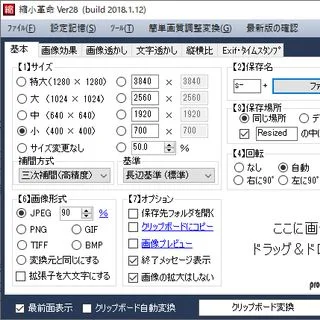
操作は簡単で、このように「1024x〇〇」を選び「短辺基準」「回転なし」「PNG」としておき、右下に画像ファイルを複数選択してドラッグ&ドロップすると、「保存場所」で指定した場所に指定通りのサイズ(短辺1024px)に変更された画像がドッと生成されます。「Resizedの中に保存」にチェックを入れておけば、ファイル名の頭に「s-」がついた画像がResizedフォルダ内に一括生成される仕組みです。
(※縦横比のタブで"アスペクト比調整を有効にする"にチェックが入っていないことを確認しましょう。チェックされていると画像がトリミングされてしまいます)
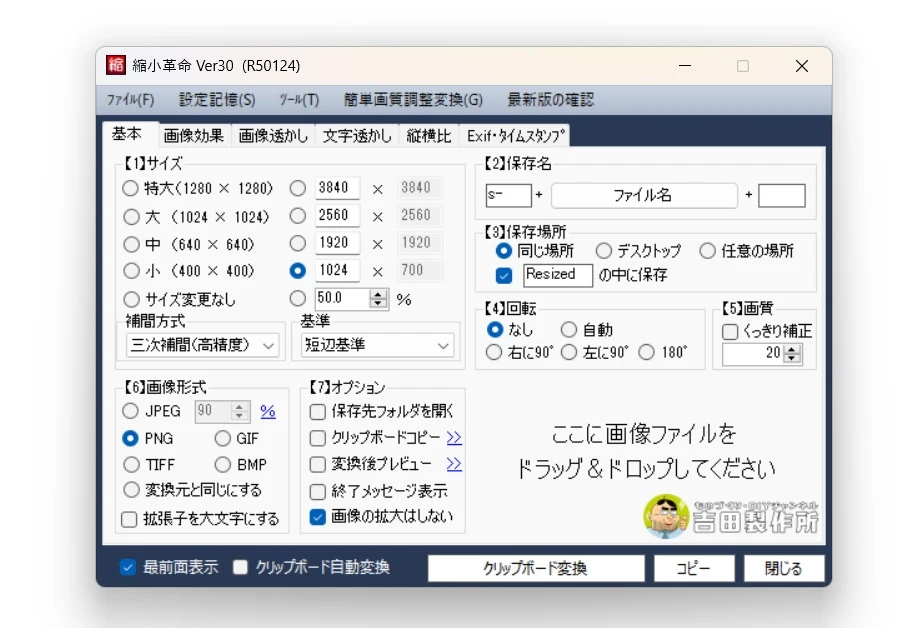
「ファイル▶その他設定」では、「変換元ファイルへの上書きの許可」をオンにできます。こうしておくと、読み込ませた画像そのものをリサイズできますが、縮小前のサイズにはもう戻せなくなるので、適宜バックアップを忘れないようにしましょう。