こちらの記事は2025年9月当時の最新モデルだった「NanoBanana」を使った漫画作りの特集です。現在は「NanoBananaPro」など最新モデルが登場しているので、記事内容は既に古くなったものと思ってお読みください。
こんばんは、スタジオ真榊です。今回はGoogle製画像生成AI「NanoBanana」(正式名称:gemini 2.5 flash image)を使った漫画作りについての大型特集です。キャラ画像とだいたいのコマ割り情報のテキストを与えてNanoBananaに「ページごと丸投げ」する方法と、自分のネームを基に1コマずつ丁寧に作り込む方法の両方を検証しました。【約2万500字】
※基本的な使い方やイラストへの活用方法は過去2回の特集をご参照ください。
さて、先日投稿したこちらの4p漫画は、NanoBananaを大いに活用して作ったものです。
NanoBananaを主体的に使って作ったわけではなく、人物部分はほぼ普段のローカルモデルを使用して、1コマずつ仕上げました。かといって、NanoBananaをちょっとした支援程度にしか使わなかったわけではなく、「NanoBananaのおかげでできた表現」が随所に盛り込まれています。
これまでなら非常に手間が掛かったポーズや背景、一貫性を保ったアイテム描写、illustriousにプロンプト指示してもなかなか作れない構図などが、自然言語指示で簡単にできるようになりました。「生成できなくはないけど大変だから、展開を変えてごまかすか…」とか「ほんとはこういうアイデアもあったけど、そこまで面白くなるわけでもないのに手間がかかるからやめとくか…」となっていた部分で躊躇わずに進行できるようになったと感じています。
一方、1コマずつ漫画を作りこむのではなく、1ページ全体のアイデアをNanoBananaに「丸投げ」して、15分たらずで3~4コマの漫画を作ることもできました。こちらが作例。
いずれの方法でも、やり方を間違えると無限に時間が吸われてしまうので、NanoBananaにできること・できないことをしっかり見極めることが非常に重要。安定した指示の方法や、ローカル生成と併用した一貫性の出し方も含めて、現時点で得られた知見を紹介していければと思います。
<※NanoBananaの生成環境>
今回の検証も、前回に引き続き無料で使える「GoogleAIStudio」を使用しています。他にNanoBananaで生成できる環境としては、Gemini公式や、Freepikのように有償でより早くNanoBananaを使った生成ができるApi系のサービスなどがあります。プラットフォームによって生成時の反応や動作が異なる可能性がありますので、記事を閲覧の際はご注意ください。
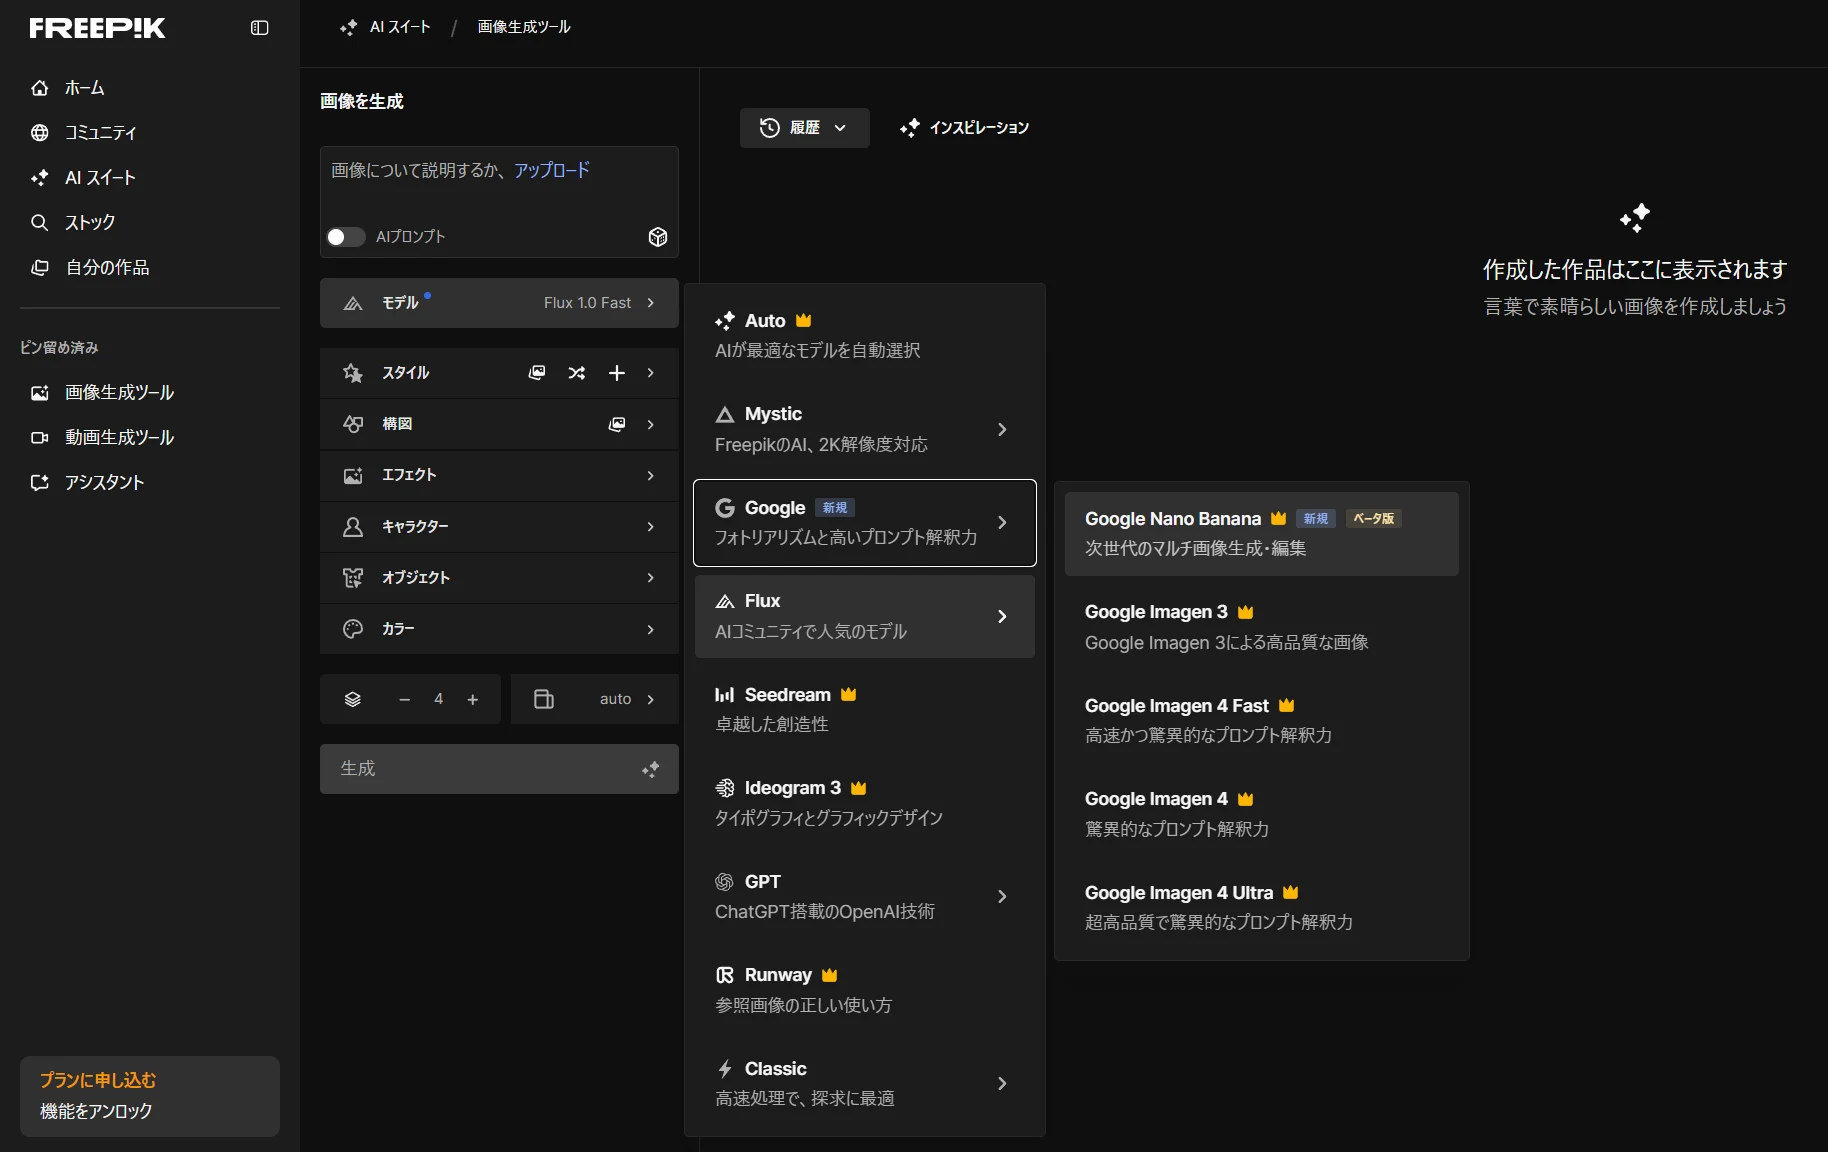
▲Freepikの生成画面
1.何を作るか / どう作るか
まずは、どんな漫画を作るかを決めるところからです。今回は、かなり前にノートに書きためて死蔵していたネームの中から、こちらをNanoBananaで作画してみることにしました。
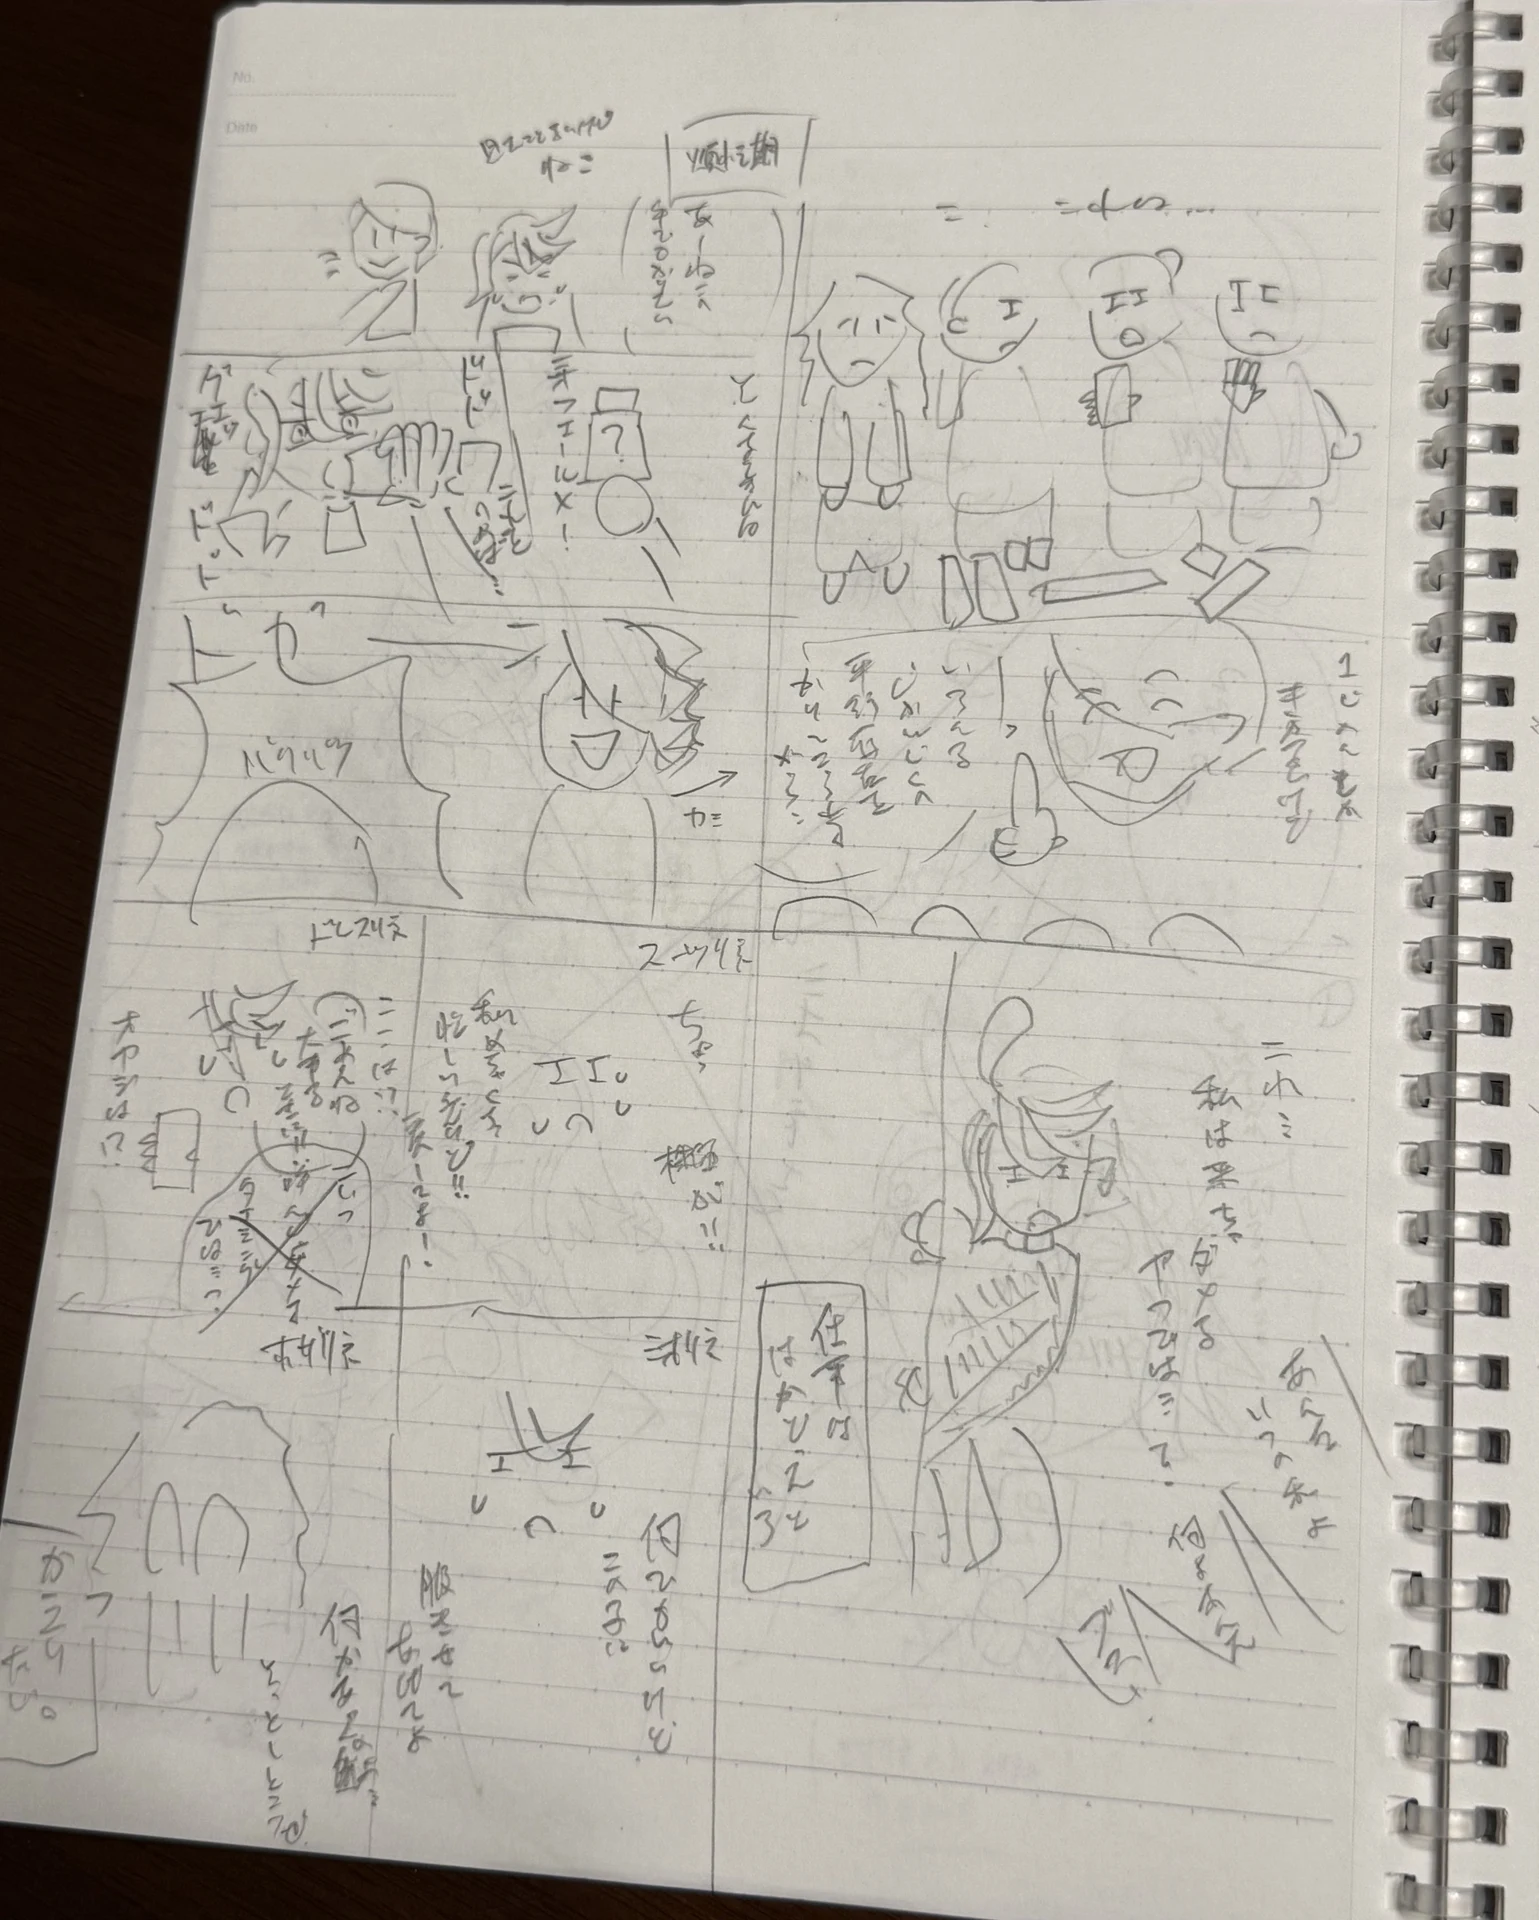
3p目まではほぼ今回作ったものと同じでしたが、オチ(右下)はAI作画を進める中でイメージが膨らんだので、コマを増やしています。問題は、これをどのような形式でNanoBananaに見せ、作画してもらうかです。
・NanoBananaにどう指示するべきか?
25年3月に突然画像生成機能が大幅アップしたChatGPT4oは、文字情報で展開を指示するだけで、それなりに漫画らしいものをでっち上げてもらうことができました。画像を入力しないので、つまりはtext to manga(t2m)ができるモデルだと言えるでしょう。
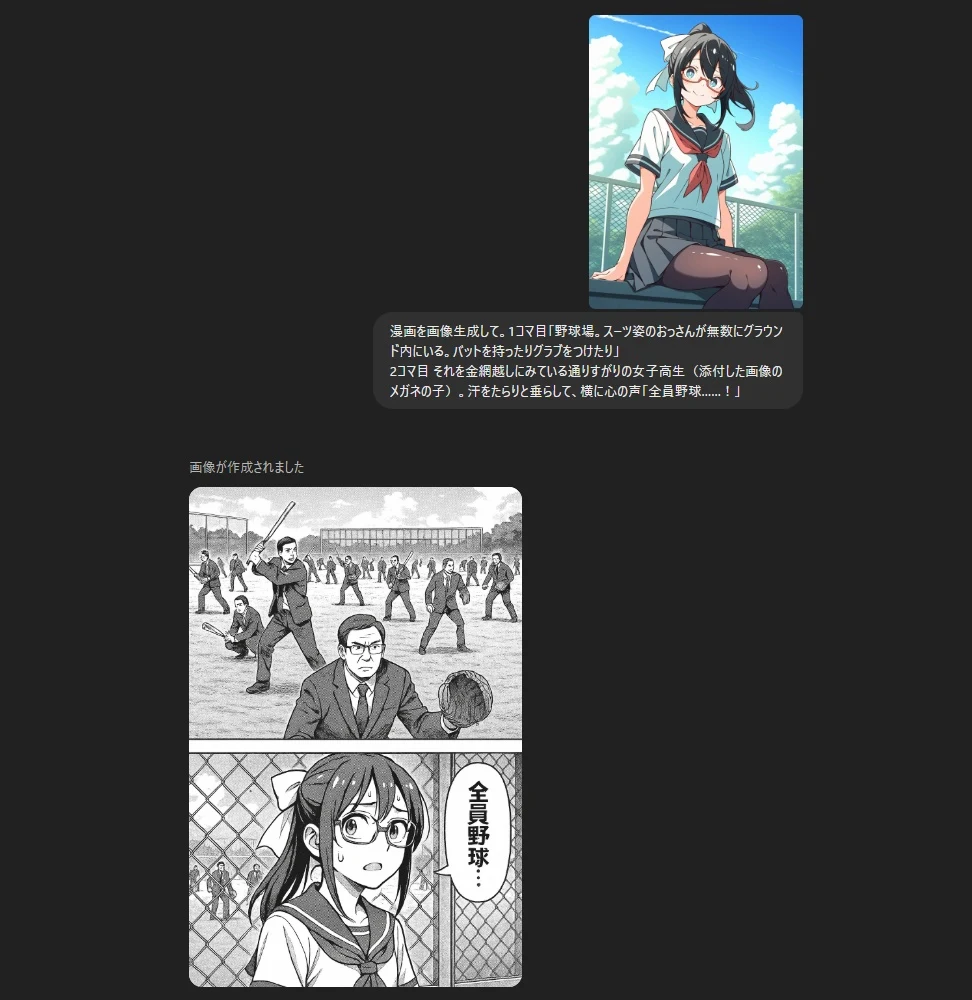
こちらは当時、ChatGPT4oで漫画を作った生成画面のスクリーンショット(再掲)。2コマ漫画程度でしたらこのようにキャラクターの容姿を画像で渡して、各コマの内容を指示するだけでそれなりに意図したものを作ることができました。しかも日本語の吹き出しまでそこそこ正確に入れられたので、これは本当に衝撃的な進化でした。
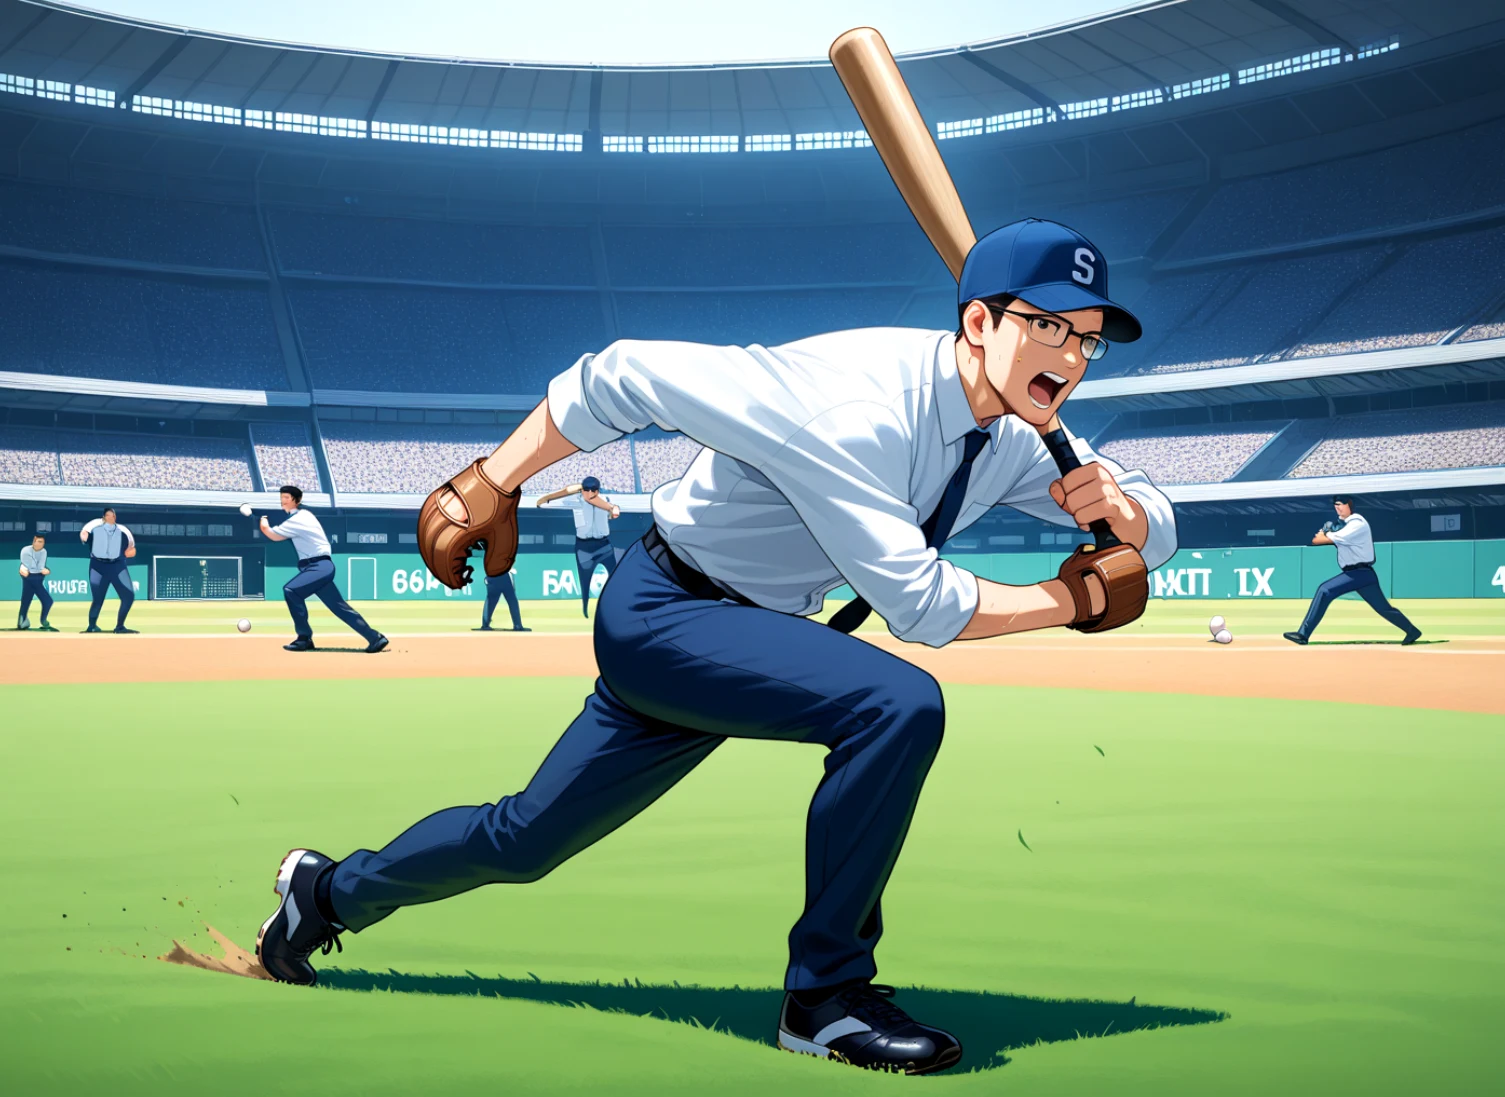
illustriousをはじめとした人気ローカルモデルの多くは、基本的に女の子の容姿をかわいらしく(またはエッチに)描くことに特化しているので、「スーツを着たおっさんが無数に野球場でプレーしている」のようなマンガ的な指示をすると、このようにかなり破綻が目立つものしか作れません。
一方で、「4o漫画」は指示した画像の画風を維持したり、追加学習したりすることができないので、キャラクターの見た目は基本的に4oお任せの「マスピ画風」になってしまう弱点があります。「ではNanoBananaではどうだろうか?」というところから、検証を始めていきましょう。
・1ページ丸ごと?それとも1コマずつ?
NanoBananaで漫画作りを始めるにあたって、まず確かめておきたいのは「1ページ丸ごと生成」が可能かどうかです。つまり、コマの画像を1つずつ作るのではなく、コマ割りも含めて一発で1ページ全体を画像生成するということですね。4oと違って日本語のレンダリングはできないものの、NanoBananaの一貫性保持力とGemini由来の理解度の高さがあれば、もしかしたらけっこう良いものができてしまうかも…と考えました。
そこで、まずNanoBananaに読ませる用に、非常に簡単なポンチ絵をこのように用意しました。さきほどのノートを基にクリスタでコマ割りを作り、ぱぱっと殴り書きしたものです。
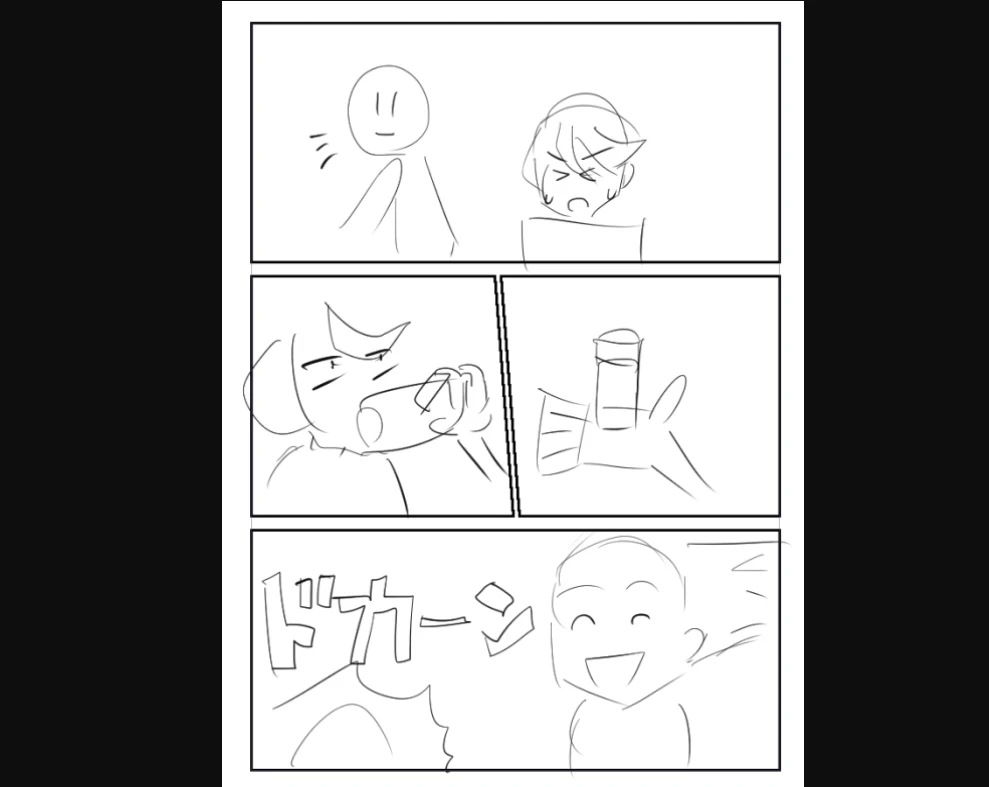
ただ、NanoBananaは初音ミクさんくらい有名なキャラでなければキャラクター容姿を再現できません。NovelAIと違い、プロンプトで「これはどの作品の何というキャラクターです」と指示しても再現できませんし、どんな画風にすればいいのかも分かりません。つまり、まずは主要人物の容姿を画像資料として渡さなくてはならないということです。
2.キャラクター設定画を作る
というわけで、NanoBananaに渡すキャラクターの設定画をサッと作ります。生成したい漫画にキャラの全身が出てこない場合、正面・バストアップの画像だけで問題ありませんが、背面や下半身が映るシーンが出てくると適当な描写になってしまいます。AIで出せるキャラクターならプロンプト指示(①)で、手描き勢の方はNanoBananaに作ってもらう方法(②)で、キャラクター設定画を用意しておくと、のちのち作業が楽になります。
①AI生成で「三面図」を作る
普段使いのローカルモデルで生成・量産できるキャラクターなら、以下のようなプロンプトで生成すれば手っ取り早くキャラクター資料ができます。
PP:1girl(1boy),white background, simple background,turnaround,reference sheet, from side,from behind,straight-on,multiple views( + キャラ容姿タグ)
こちらはタテ型のキャンバスで生成したものです。左右方向のキャンバススペースが足りず、正面と背後だけになってしまいました。
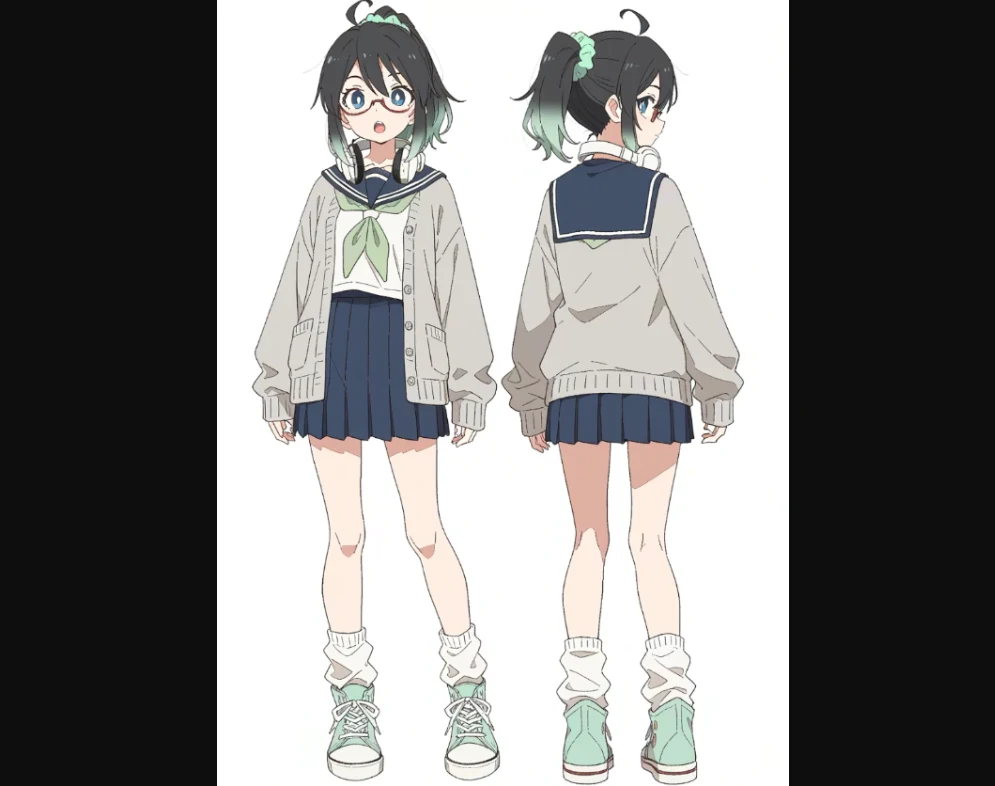
プロンプト通り、横からの画像もあるちゃんとした「三面図」にしたい場合は、このように正方形~ヨコ型のキャンバスで生成すると良いでしょう。その代わり、カメラが引いて画質が落ちますので、Hires.fixやADetailer、i2iアップスケールなどで品質を保全してあげましょう。
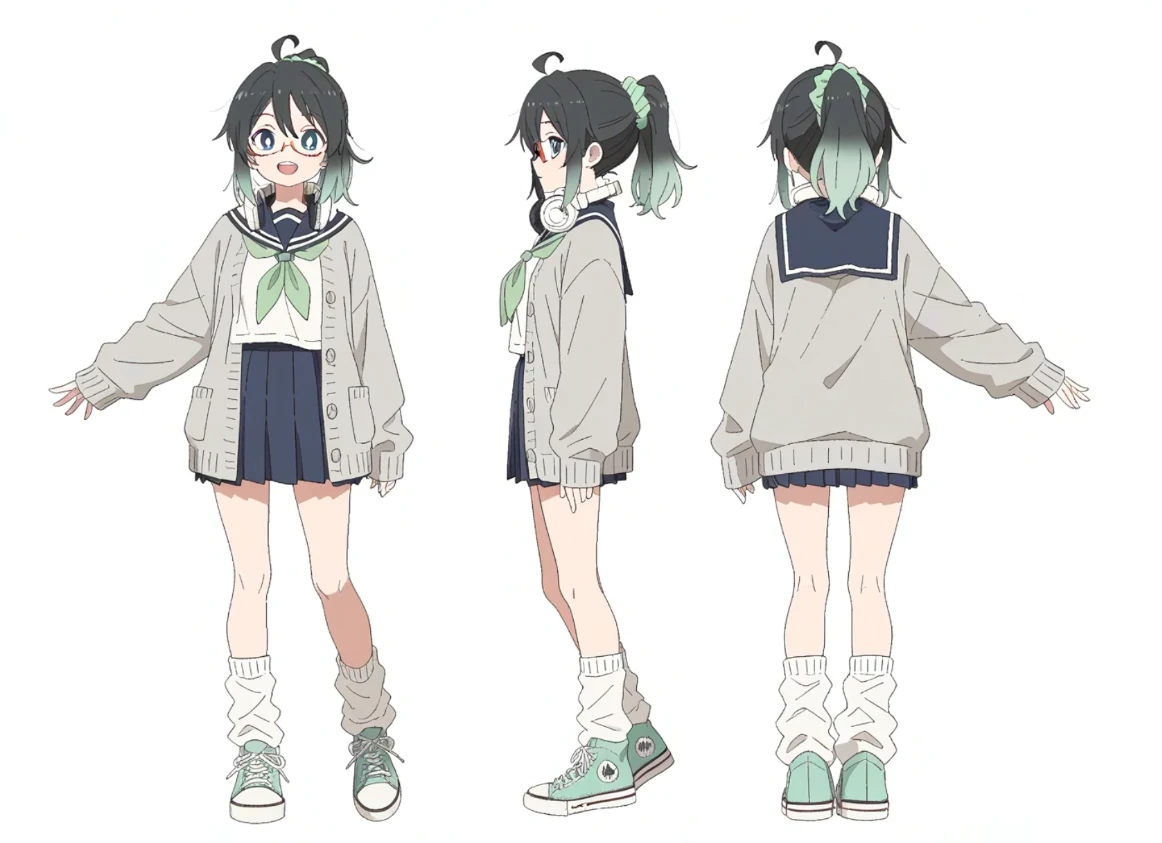
Hires(2x_AniScale2_Omni_i16_40Kで1.5倍、強度0.4)+ADetailerをかけると、このようにきれいになります。
②NanoBananaに依頼して三面図を作る
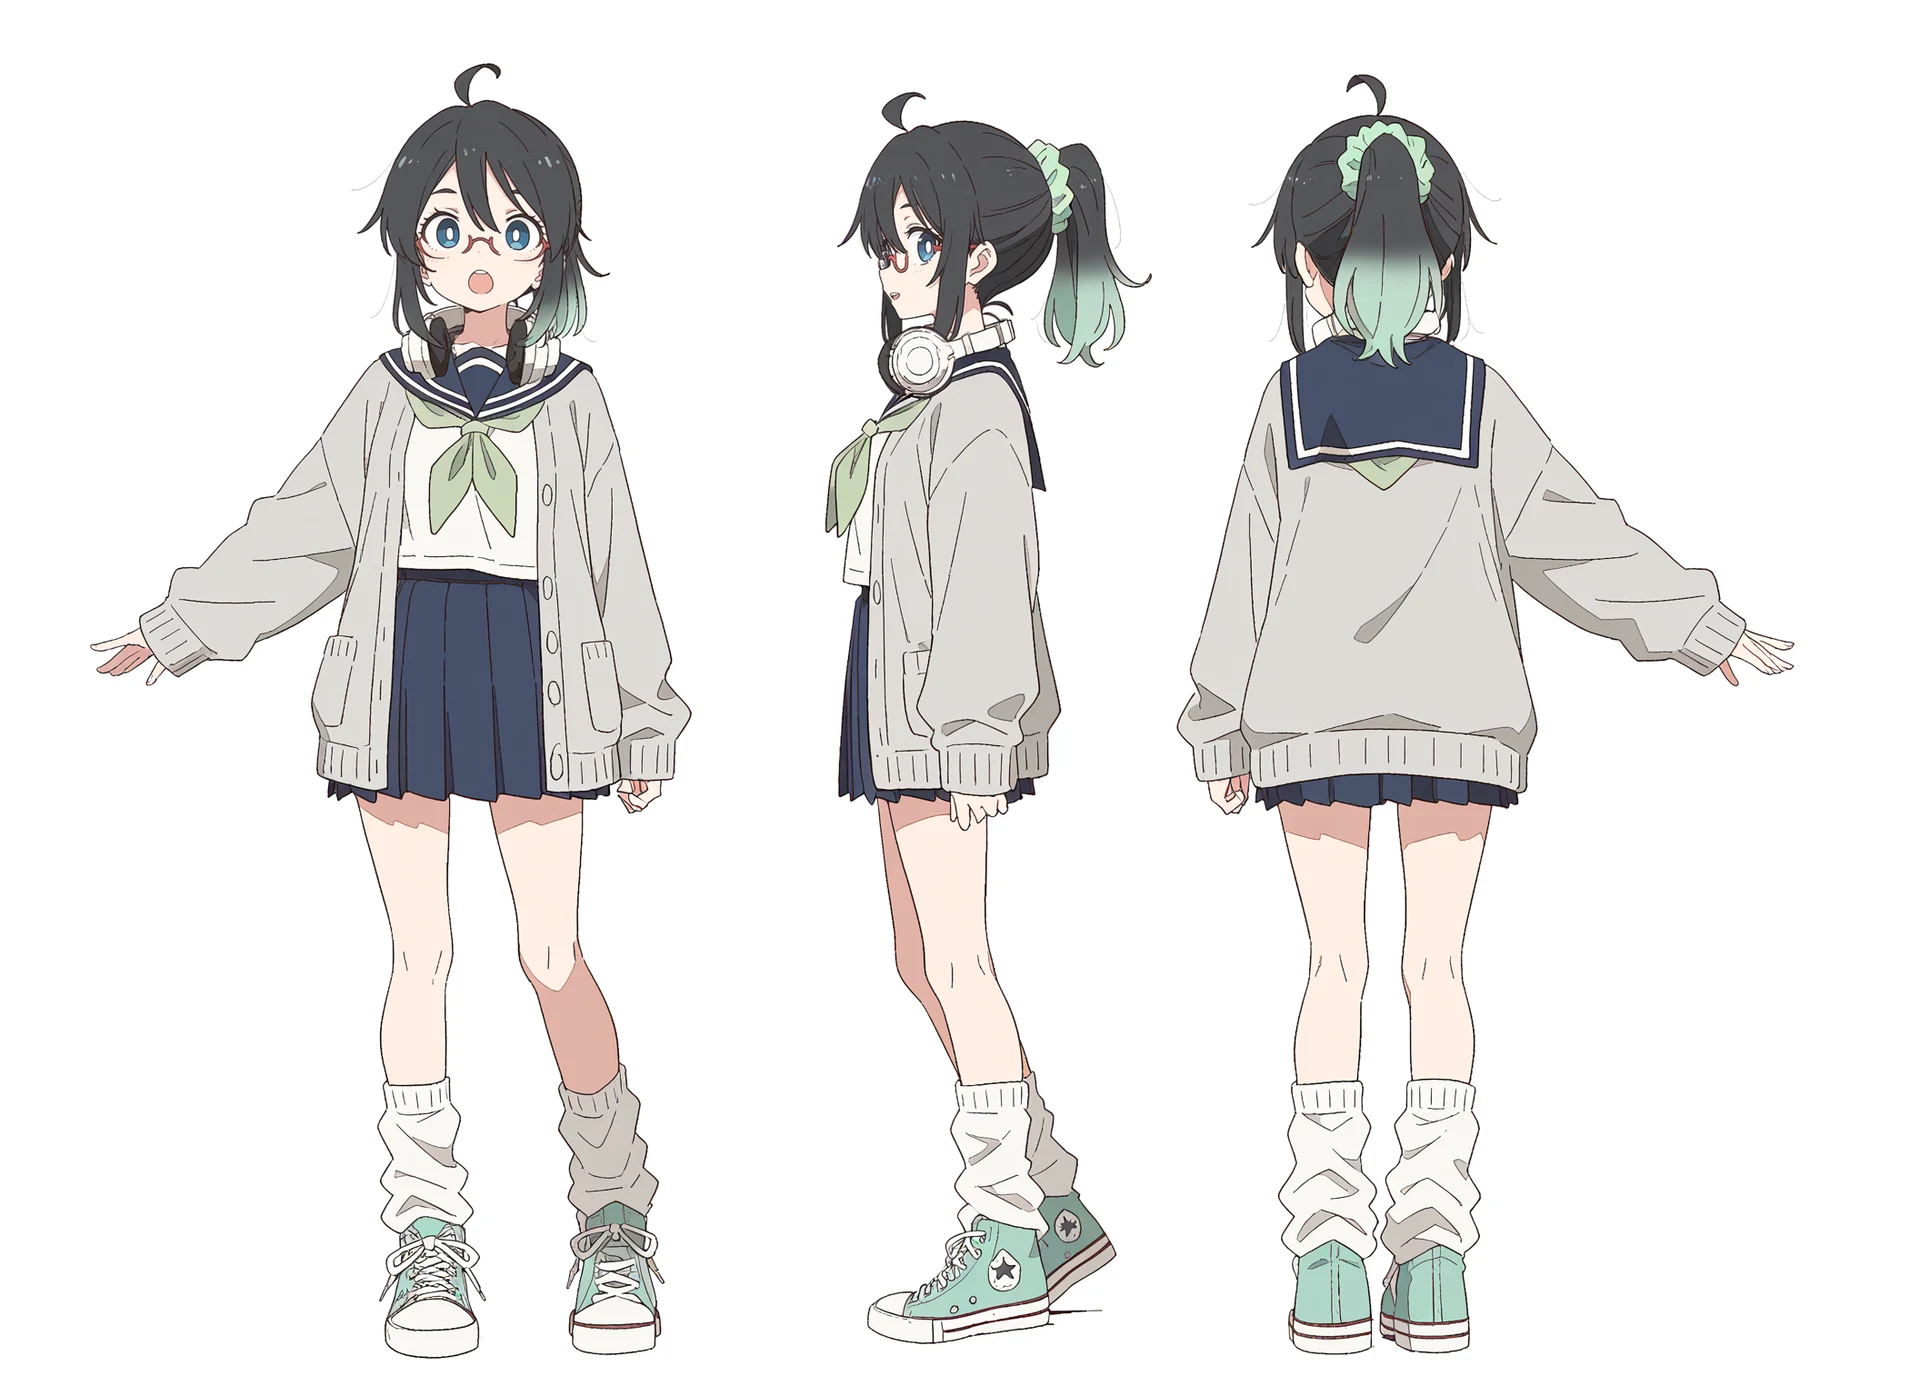
手元に1枚しかそのキャラクターの絵がない場合や、モデルが学習していないオリジナルキャラで漫画を作りたい場合は、NanoBananaに頼んで三面図を作ってもらうと良いでしょう。このように、キャラクターの画像をNanoBananaに渡して、三面図をリクエストします。
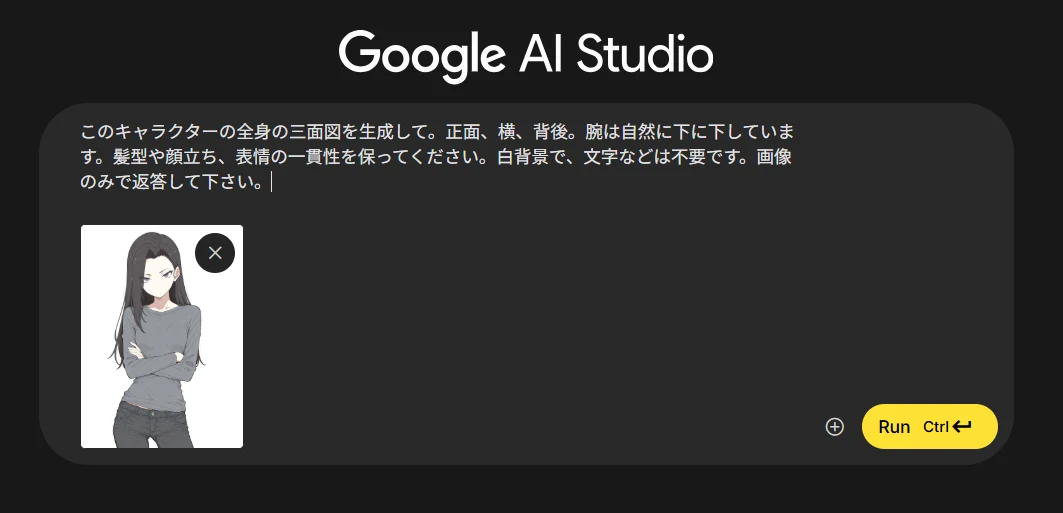
指示:このキャラクターの全身の三面図を生成して。正面、横、背後。腕は自然に下に下しています。髪型や顔立ち、表情の一貫性を保ってください。白背景で、文字などは不要です。画像のみで返答して下さい。
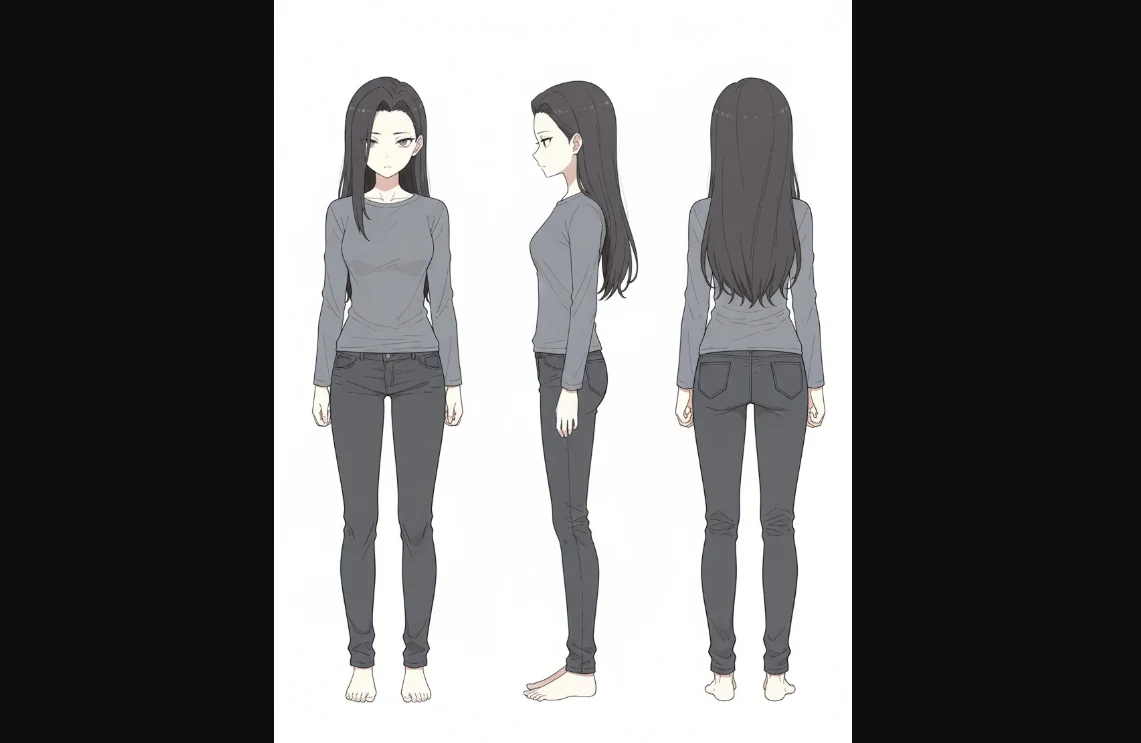
このような感じで、簡単に三面図を推論してもらえます。ちなみに、NanoBananaが「はい、生成します」と答えるだけで画像生成をしてくれない問題は、当初は指示を英語にGoogle翻訳して回避していましたが、末尾に日本語で「画像のみで返答して下さい」とつけるだけでほぼ回避できることが分かりました(Google AI Studioでの実践)
ただ、上の三面図をよく見ると、正面・背後はともかく、横からの推論図がイマイチであることに気付きます。左右非対称の髪型なので、本当は顔の奥側に垂らした髪が映るはずなのですが、省かれてしまっていますね。顔立ちも、かなり似ているとはいえ「本人感」があまり感じられません。
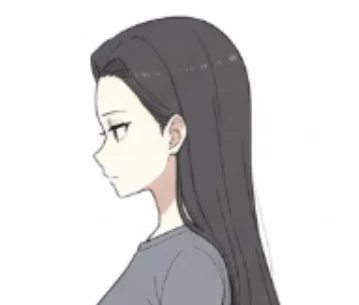
NanoBananaは4oに比べて一貫性を保つ力が強いのですが、毎回完璧に保たれるかというと「場合による」としか言えないので、あまり過信しすぎないようにしましょう。再現度は読み込ませた参考画像の出来やプロンプト指示の内容によってかなり変わりますし、最初に参考画像を入力したあと対話回数(つまり生成回数)が増えるほど、だんだん一貫性は落ちていくようです。
【実験1】「1ページ丸ごと生成」はできる?
さて、キャラクター資料ができましたので、これを使って「1ページまるごと生成」ができるか試してみました。まずはネームなしで、次のようなプロンプトだけで指示してみます。
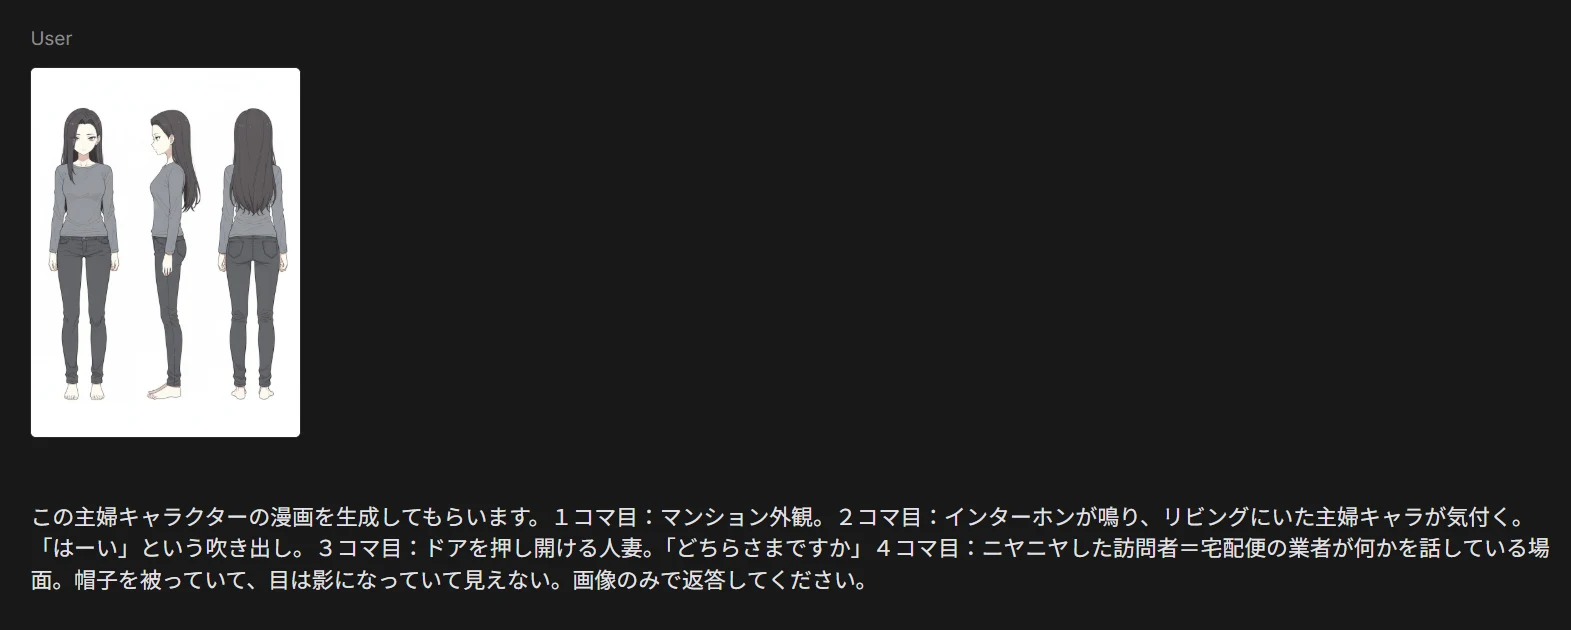
指示:この主婦キャラクターの漫画を生成してもらいます。1コマ目:マンション外観。2コマ目:インターホンが鳴り、リビングにいた主婦キャラが気付く。「はーい」という吹き出し。3コマ目:ドアを押し開ける主婦キャラ。「どちらさまですか」4コマ目:ニヤニヤした訪問者=宅配便の業者が何かを話している場面。帽子を被っていて、目は影になっていて見えない。画像のみで返答してください。
こちらが生成結果です。
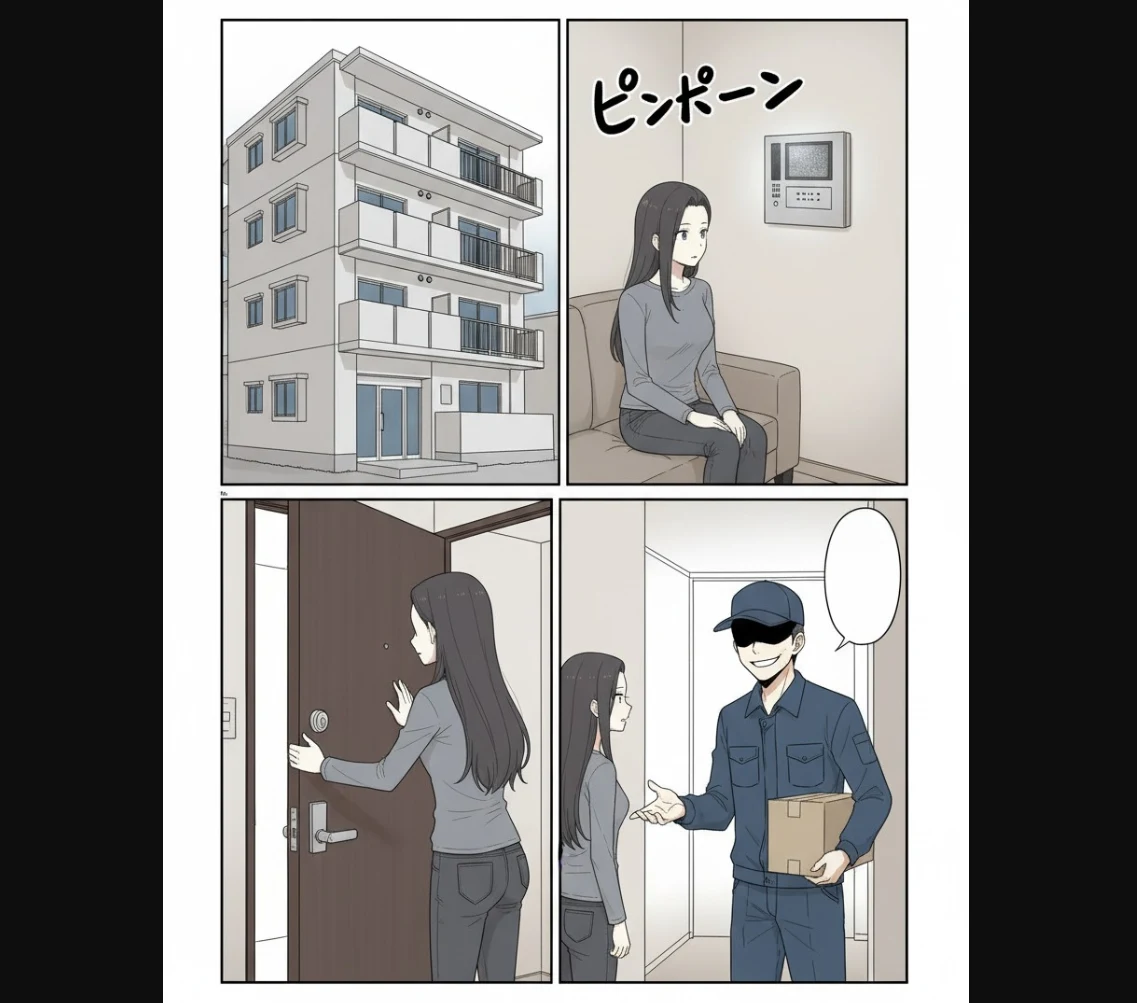
全体の印象としては、4o漫画よりもプロンプトの再現度・一貫性保持力が高いように思えます。ただ、「完璧な画風再現ができている」とは言いにくいかなと思います。
英語圏の漫画の読み順(左上から右下へ)になっているのも4o漫画と同じ特徴ですね。これを回避するためには、「2コマ目。向かって右にキャラAが立っていて、左にいるキャラBに向かって『〇〇』と話し掛ける。不思議そうな表情」などと、具体的かつ細かく指示してあげる必要があります。
全体にややシンプルな画風になっていてリッチさが足りないように感じますが、これは入力画像が白背景の三面図だけだったのと、1ページ丸ごと生成だったことが影響していそう。よりキャラクターの生き生きした雰囲気が出ている完成品のイラストを参照させたほうが、表情やカラーなども引き継がれますし、1コマずつ生成したほうが使えるキャンバスサイズが大きくなるので、より高品質になるようです。
ランダム生成の結果かもしれないので再度ガチャりましたが、このように大差のない結果になりました。NanoBananaは全体に、ガチャし直してもそこまで大きく生成結果が変わらないことが多いように思います。
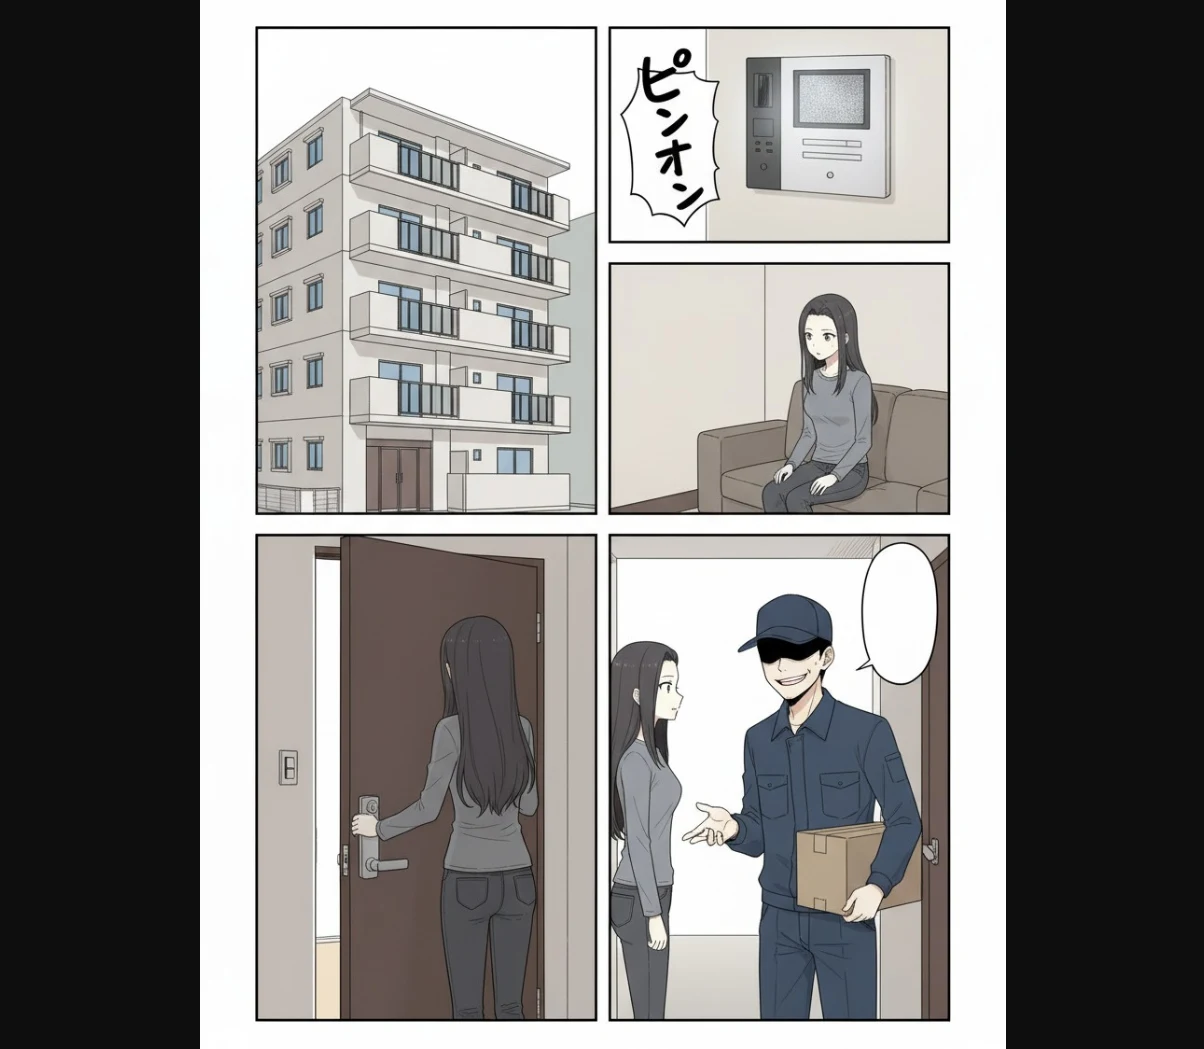
【実験2】「1コマずつ別生成」はできる?
「1ページ丸ごと」だと品質がイマイチなら、プロンプトをいじって、「ビジュアルストーリー」のように1コマずつ別生成にしてもらうとどうでしょうか。以下、太字にしたのが改良した部分です。
指示:この主婦キャラクターを計4枚のビジュアルストーリーにして。1枚目:マンション外観。2枚目:インターホンが鳴り、リビングにいた人妻キャラが気付く。3枚目:ドアを押し開ける主婦キャラ。4枚目:ニヤニヤした訪問者=宅配便の業者が何かを話している場面。帽子を被っていて、目は影になっていて見えない。1枚目、2枚目、3枚目、4枚目と連続生成してください。
(※画像のみで返答するよう指示すると1枚の画像にまとめられるので注意)
回答:承知いたしました。以下のビジュアルストーリーを作成します。「マンションの外観」「リビングにいる主婦キャラクターがインターホンに気づく」「ドアを開ける主婦キャラクター」「ニヤニヤした宅配便業者と話す主婦キャラクター」こちらがビジュアルストーリーです。
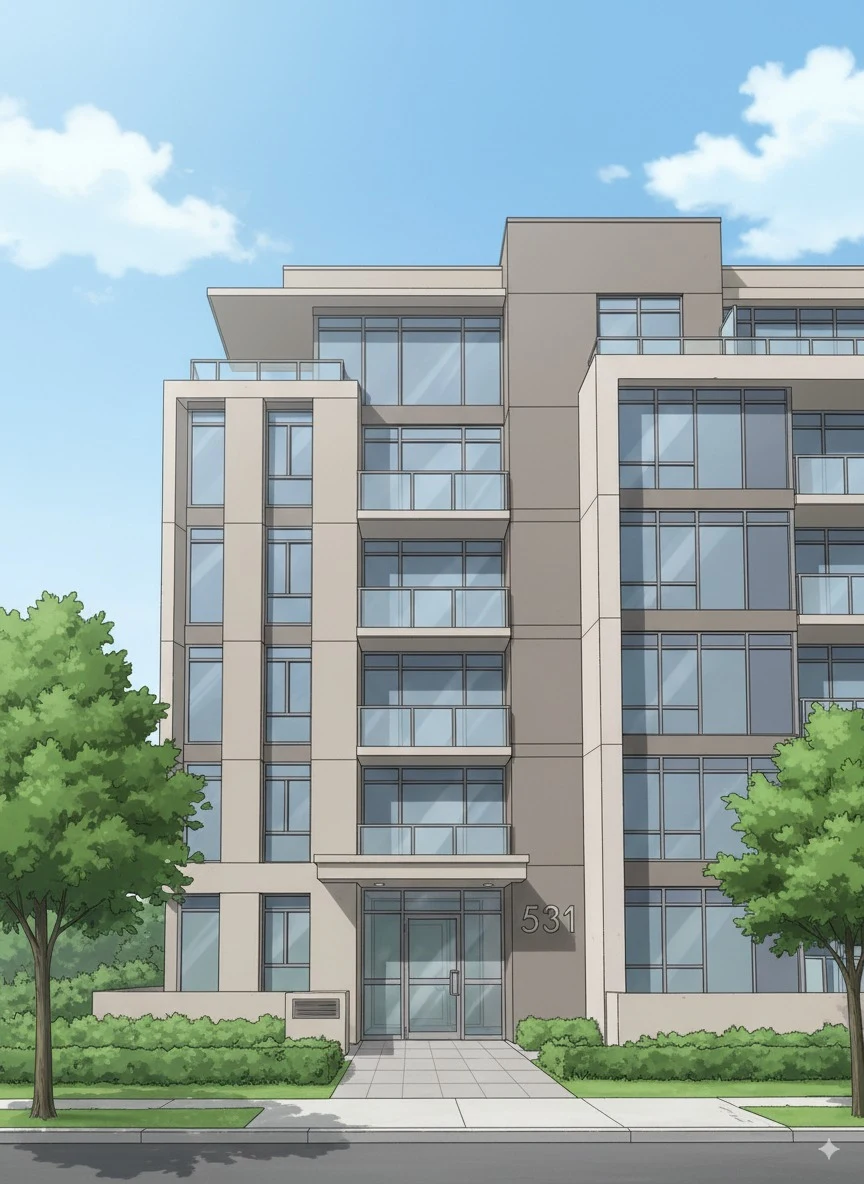
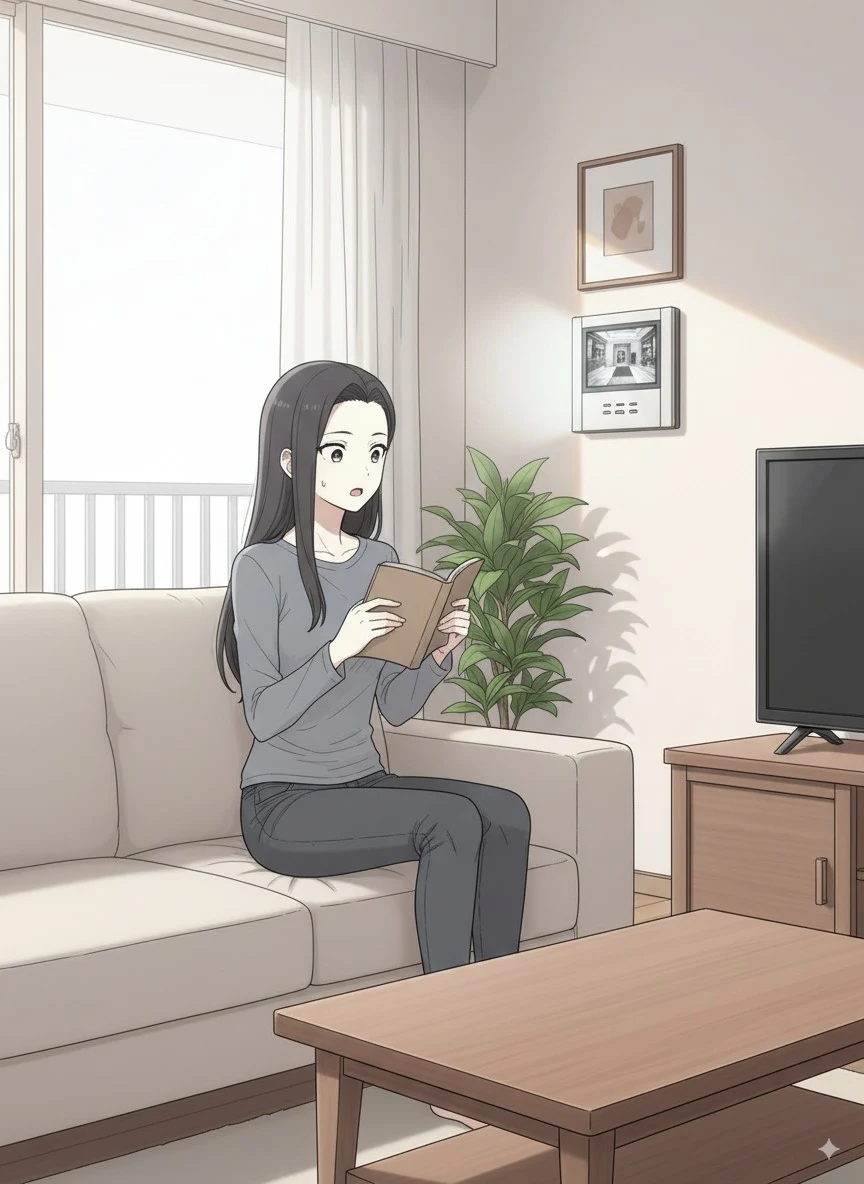
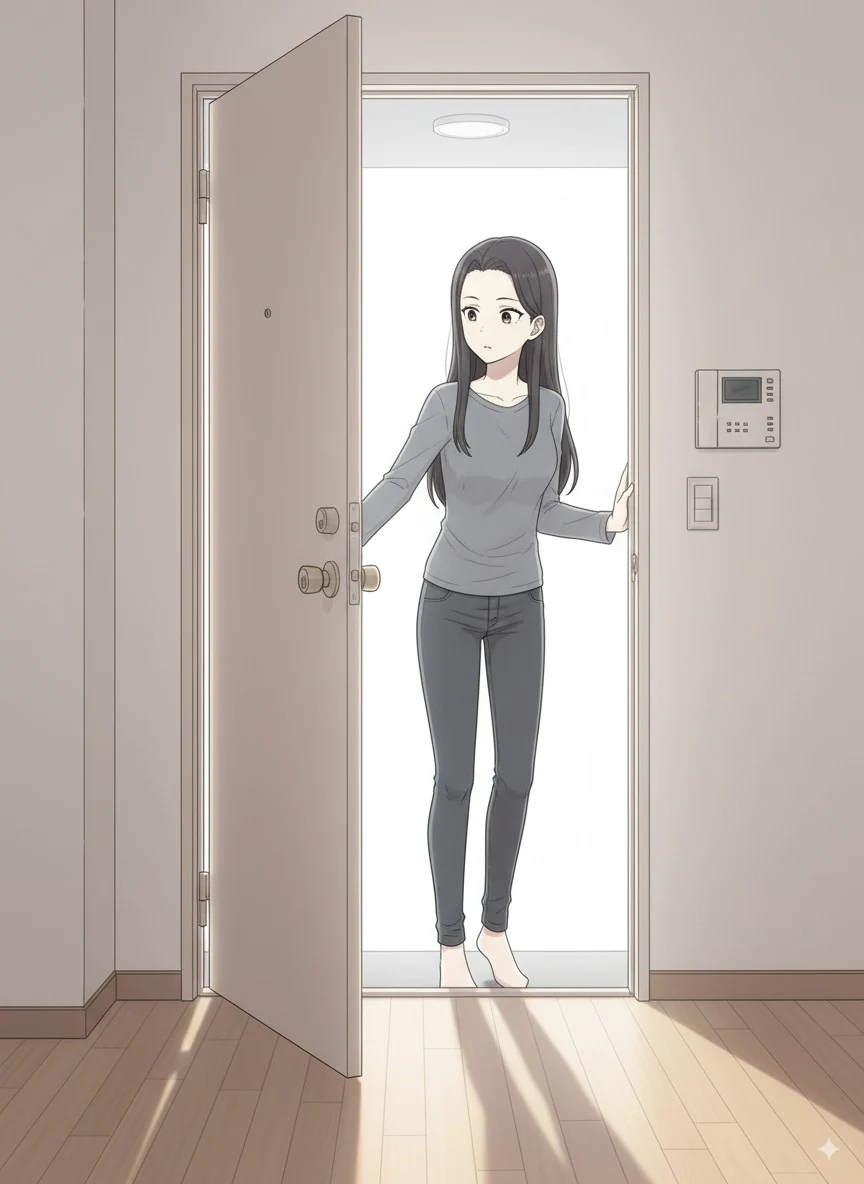
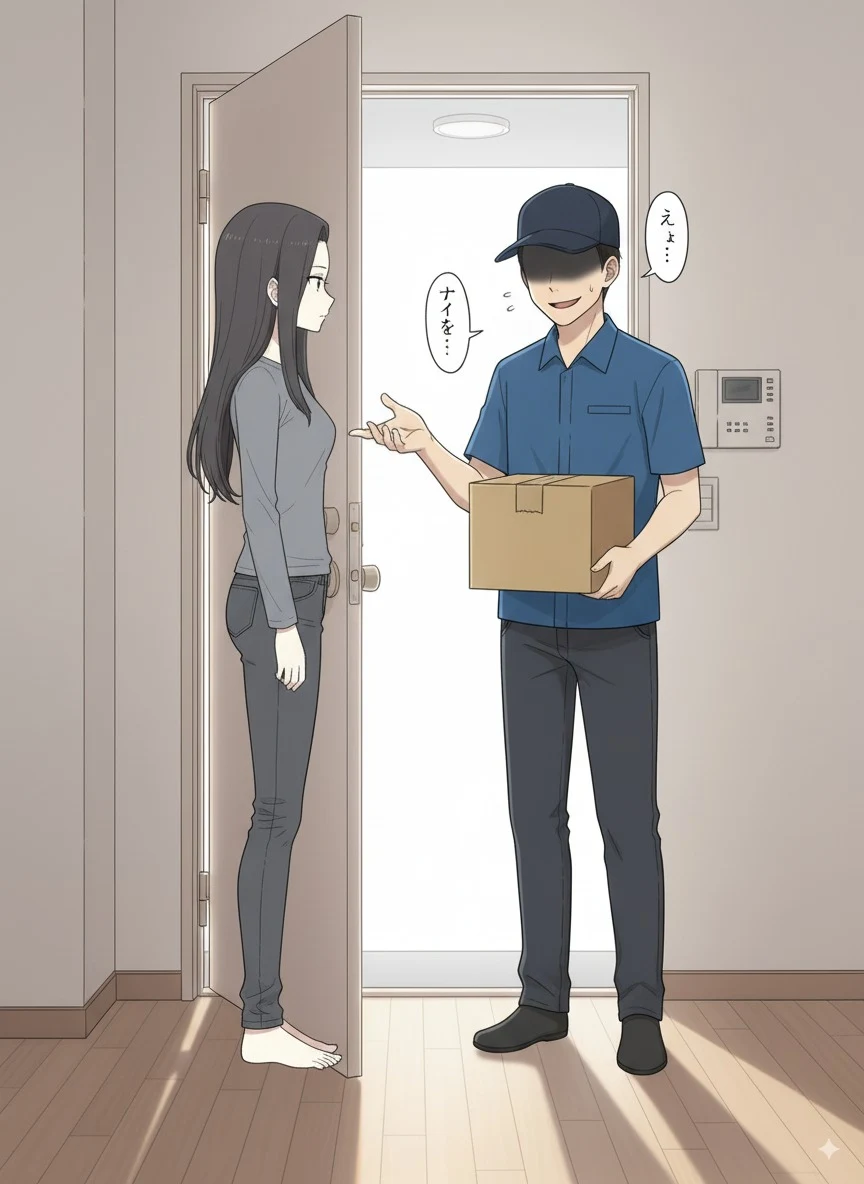
さきほどの1ページまるごと生成よりも品質がよくなったのが分かるかと思いますが、やはりキャラクターの容姿は一貫性が保てていません。このビジュアルストーリー手法は一気に複数枚の連続画像を文脈を保って生成できるメリットがあるのですが、キャラクターの一貫性については後ろの画像になるにつれてどんどん抜け落ちていく傾向がみられます。
・参照画像を増やして一貫性を保つ
一貫性を保ってほしいときは、参照画像を増やし、ストレートに事情を説明すると結構聞いてくれることがあります。次のように入力情報を変更しました。
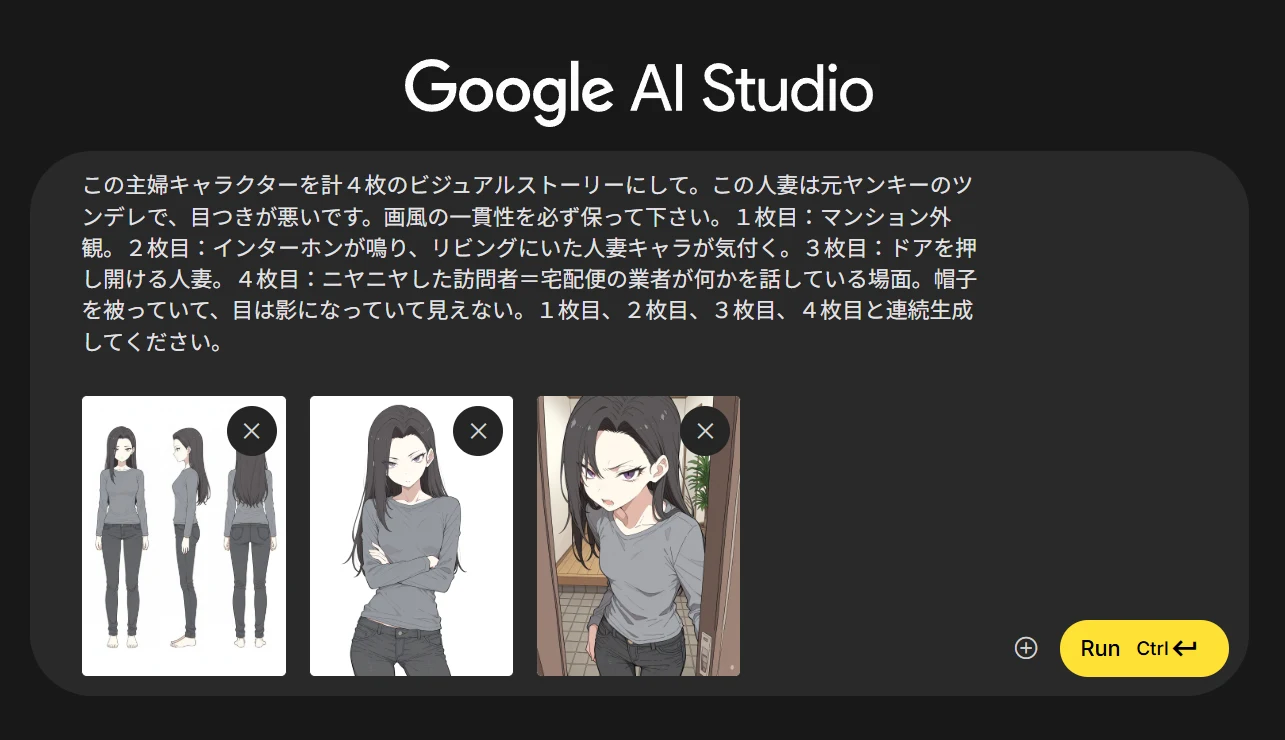
・指示:この主婦キャラクターを計4枚のビジュアルストーリーにして。この人妻は元ヤンキーのツンデレで、目つきが悪いです。画風の一貫性を必ず保って下さい。1枚目:マンション外観。2枚目:インターホンが鳴り、リビングにいた人妻キャラが気付く。3枚目:ドアを押し開ける人妻。4枚目:ニヤニヤした訪問者=宅配便の業者が何かを話している場面。帽子を被っていて、目は影になっていて見えない。1枚目、2枚目、3枚目、4枚目と連続生成してください。
こちらが生成結果。
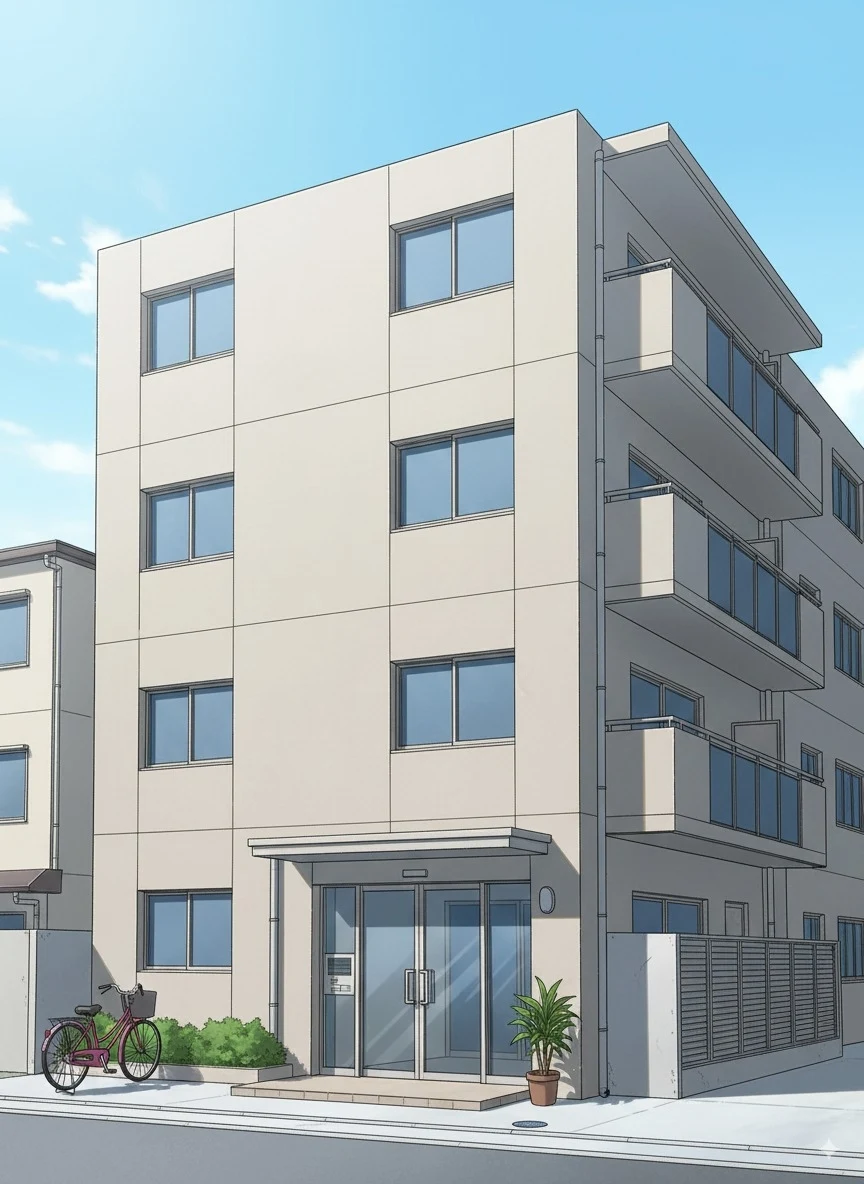
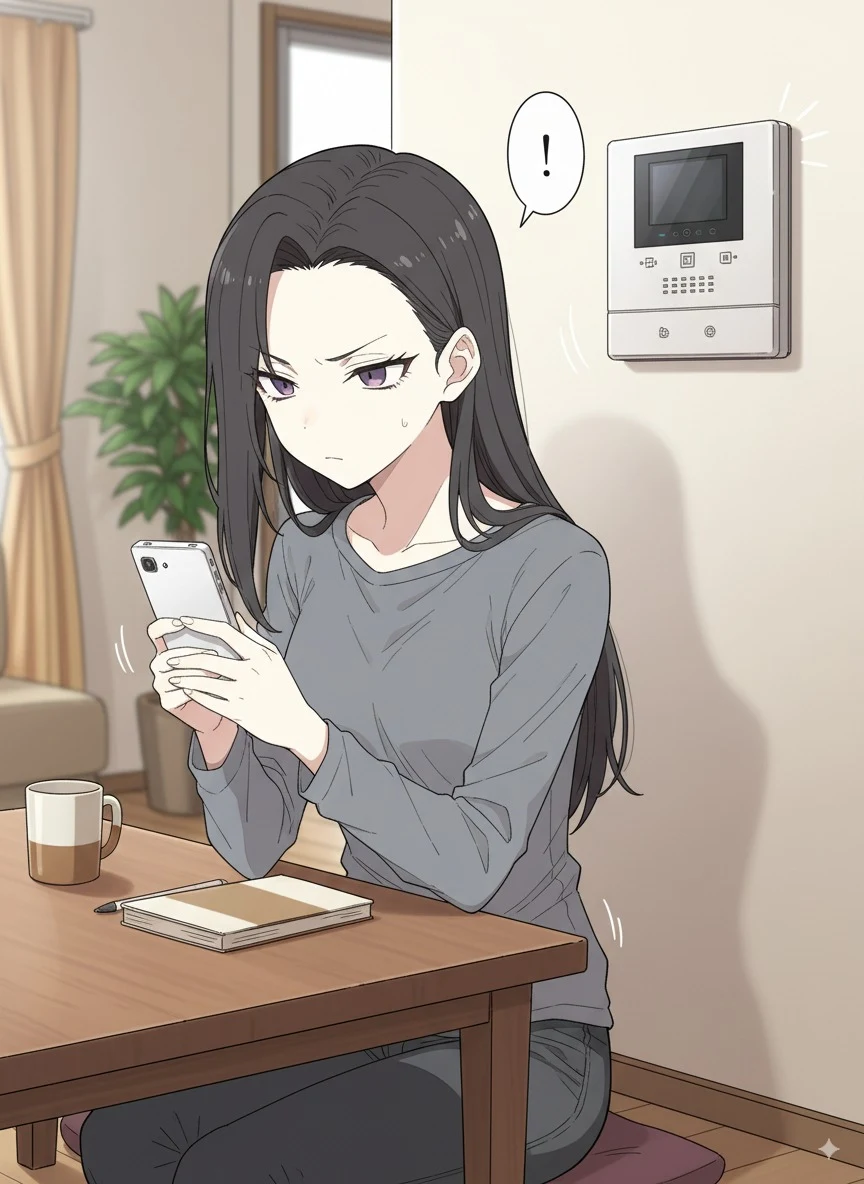
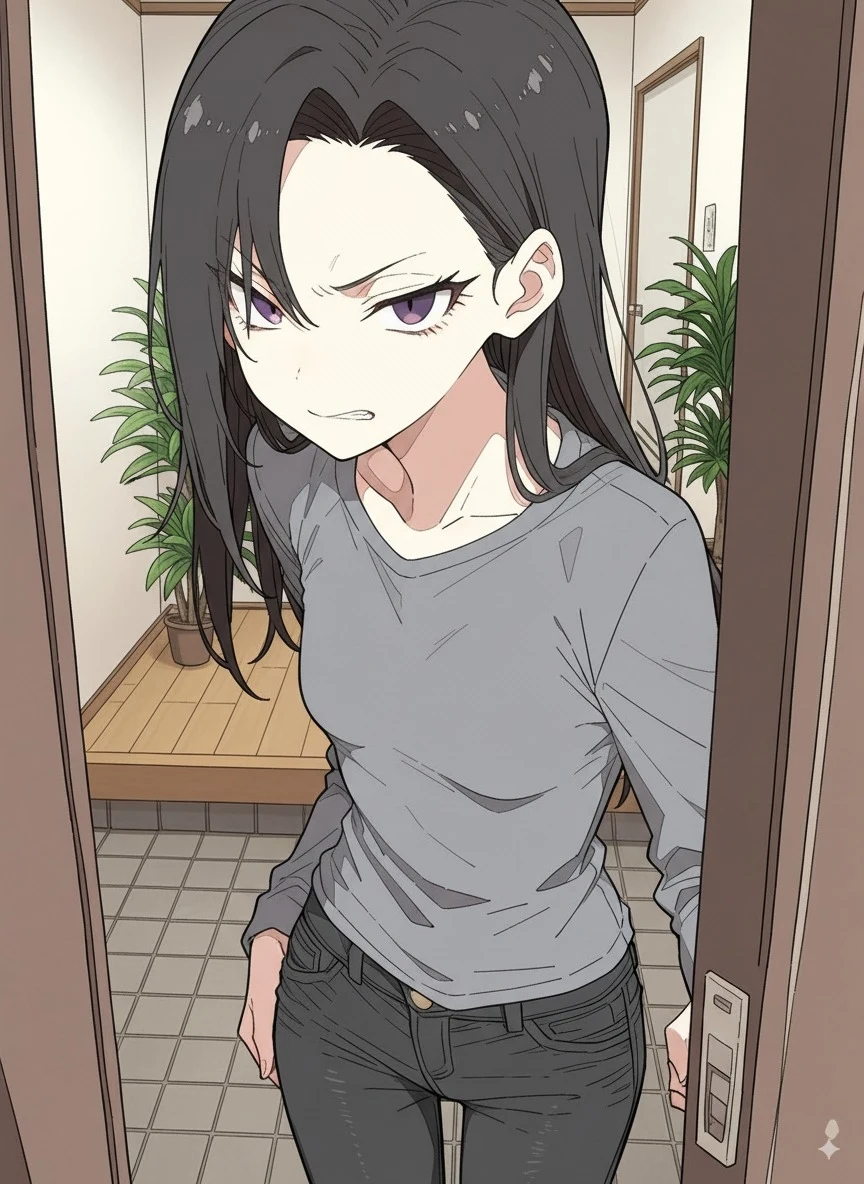
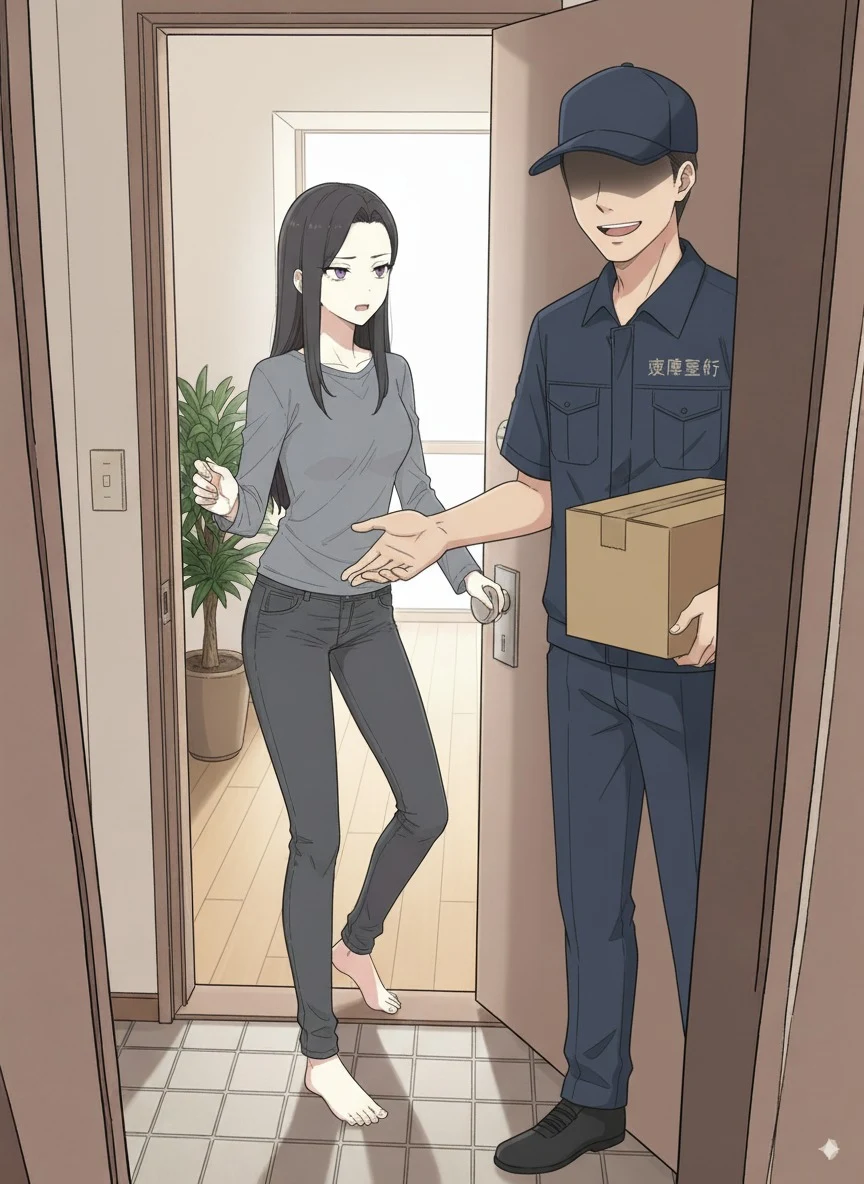
画像を増やし、画風維持を指示したことで、今度は画風がある程度保たれました。しかし、やはり枚数を追うごとにやや一貫性が落ちています。3コマ目は、入力した画像をそのまま一部加工して使ったようですね。
1コマずつ連続生成するとそれなりに品質は向上しますが、各コマをどんなポーズ・表情・構図・カラー・雰囲気で描けばよいかはかなりNanoBanana任せになっている印象があります。よりコントロール度を上げるために、自然言語でなく「YAML形式」で指示する方法を試してみました。
【実験3】YAML形式で漫画情報を渡すとどうなる?
YAMLは、プログラムで扱うデータをテキスト表現するために使われる記述方法のこと。例えばこのような感じで、人間にとってもAIにとっても読みやすい形式になっています。
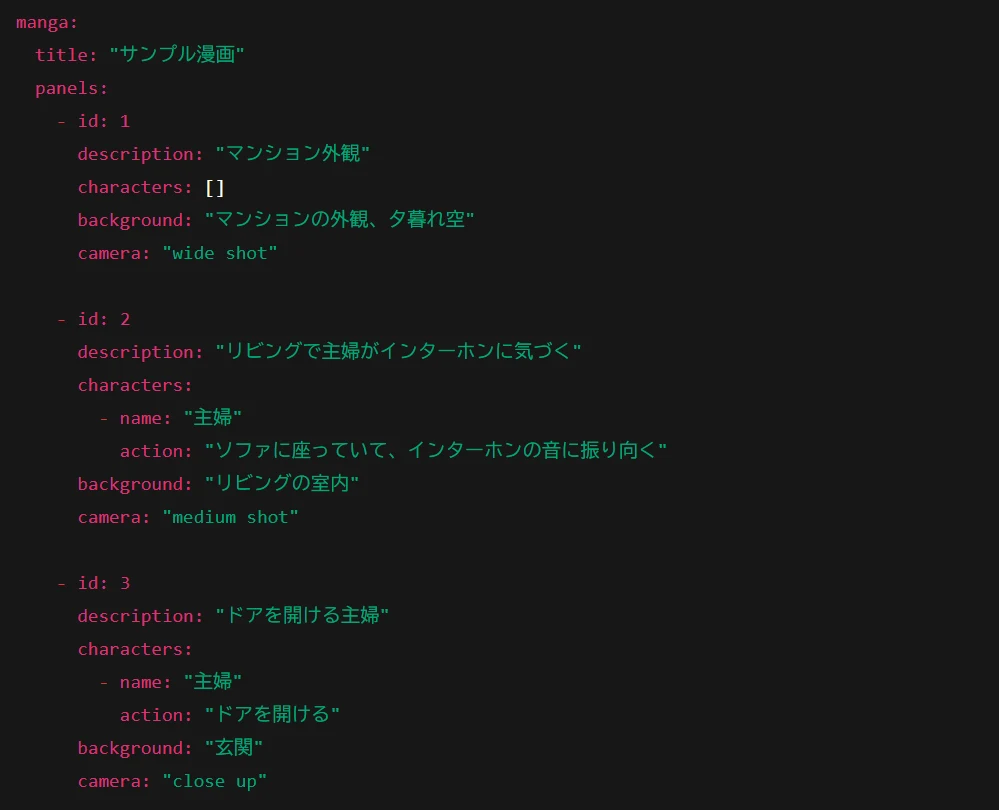
自然言語で指示するよりも機械可読的(AIが誤解しにくいかたち)な状態で情報を入力することができますが、御覧の通り文章量が単純に増えるため、手打ちするのは非常に大変。そこで、ChatGPTで「NanoBanana用漫画プロンプター」というGPTsを作って自動化することにしました。
(※リンク先からどなたでも利用できるようにしましたが、実験用に作ったものですので完成度・実用性ともに低いです)
このGPTsにコマごとの情報を自然言語で入力すると、こちらのスクリーンショットのように自動で登場キャラの情報を冒頭文+YAMLのかたちで整理する動作をします。(テキストなしで出力するような冒頭文になります)
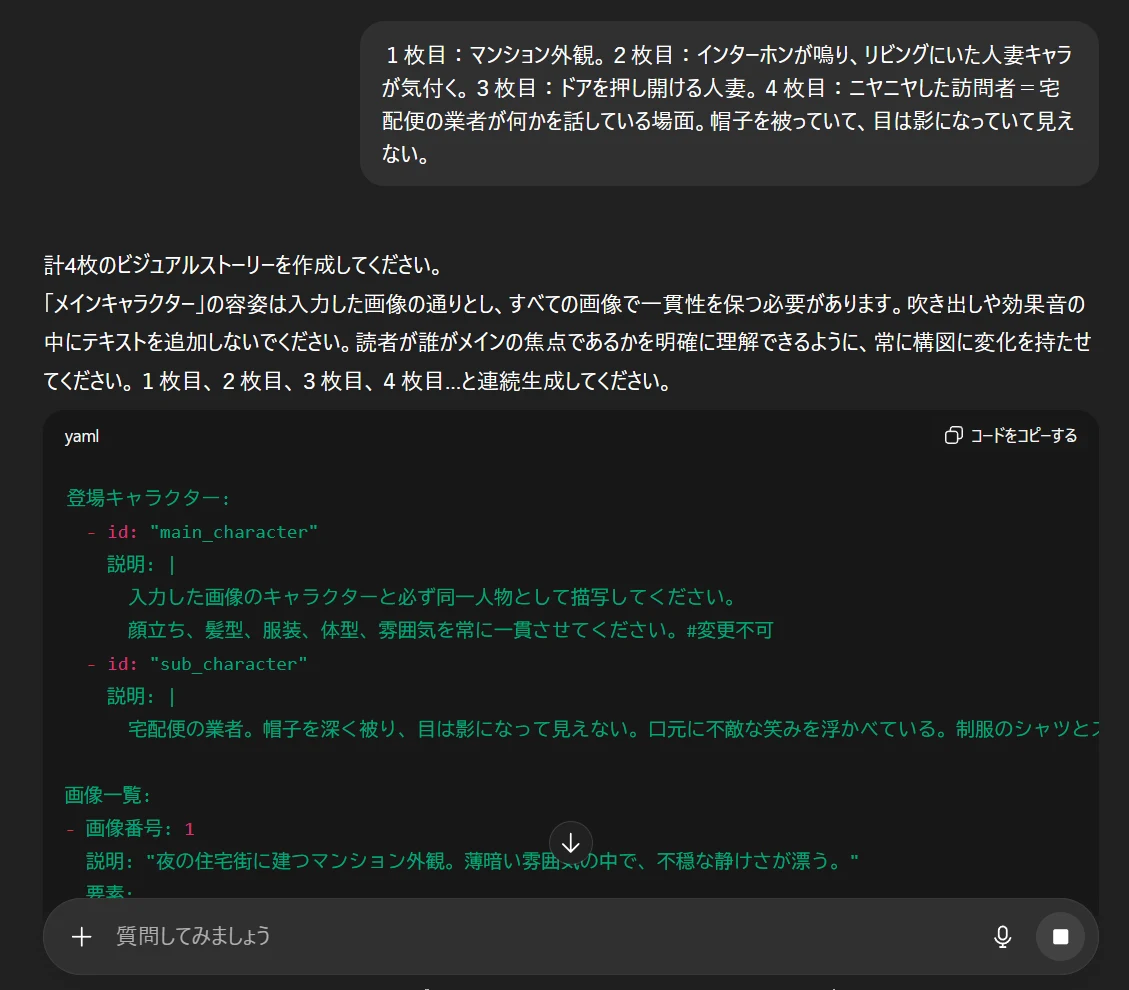
さっそく、GPTsに作成してもらったプロンプトをNanoBananaに渡してみます。入力画像は以下の3枚とし、冒頭文+YAMLをそのまま指示文として打ち込みました。
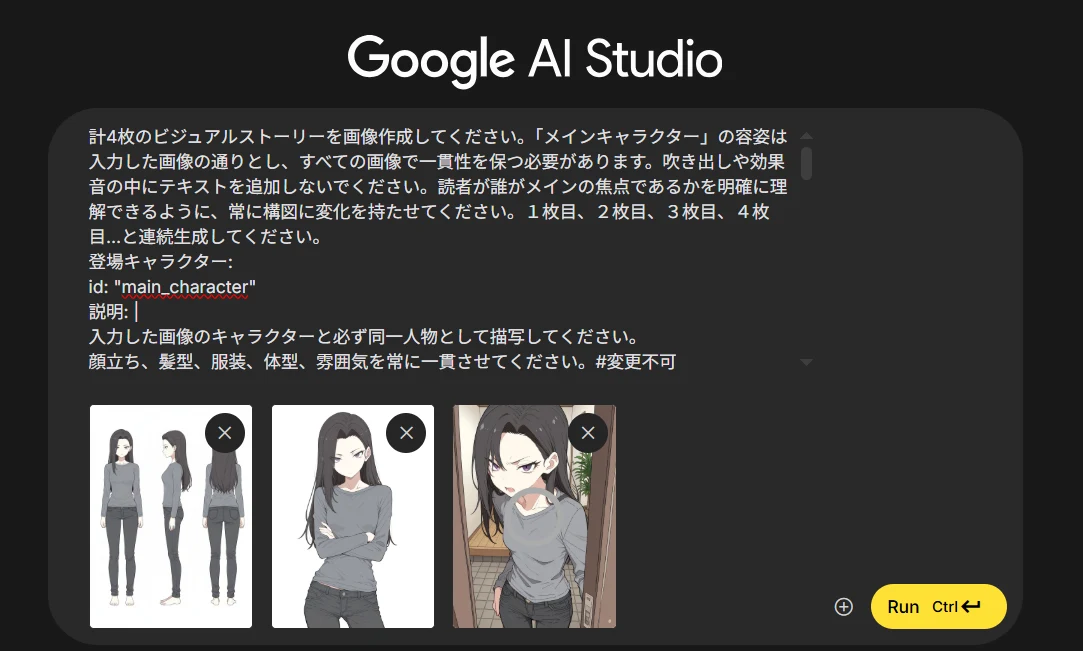
冒頭文:計4枚のビジュアルストーリーを作成してください。
「メインキャラクター」の容姿は入力した画像の通りとし、すべての画像で一貫性を保つ必要があります。吹き出しや効果音の中にテキストを追加しないでください。読者が誰がメインの焦点であるかを明確に理解できるように、常に構図に変化を持たせてください。1枚目、2枚目、3枚目、4枚目と連続生成してください。
YAML部分:登場キャラクター:
- id: "main_character"
説明: |
入力した画像のキャラクターと必ず同一人物として描写してください。
顔立ち、髪型、服装、体型、雰囲気を常に一貫させてください。#変更不可
- id: "sub_character"
説明: |
宅配便業者の男性。帽子を被っており、つばの影で目元は隠れている。制服風の作業着を着用。口元に不気味な笑みを浮かべている。
画像一覧:
- 画像番号: 1
説明: "マンション外観。"
要素:
- 種類: "背景"
外見: "現代的な中層マンション、夕方の雰囲気"
表情: ""
行動: ""
スタイル: "リアル寄り"
アングル: "少し下から見上げる視点"
詳細: "外壁の質感、バルコニーの手すり、玄関エントランスを見せる"
内容: "舞台となるマンション全体を印象的に描写"
- 画像番号: 2
説明: "リビングで主婦キャラがインターホンの音に気付く。"
要素:
- 種類: "キャラクター"
参照: "main_character"
外見: "入力した画像と同じ容姿"
表情: "少し驚いた表情"
行動: "ソファに座っていて、インターホンの音に気付き顔を上げる"
スタイル: "漫画調"
アングル: "リビング全体がわかる中距離視点"
詳細: "室内の家具や日常感を背景に描く"
内容: "インターホン音に反応する主婦"
- 画像番号: 3
説明: "玄関のドアを押し開ける主婦。"
要素:
- 種類: "キャラクター"
参照: "main_character"
外見: "入力した画像と同じ容姿"
表情: "少し緊張した表情"
行動: "玄関のドアを押し開けている"
スタイル: "漫画調"
アングル: "玄関の内側から外を見た視点"
詳細: "ドアノブ、外の光が差し込む表現"
内容: "訪問者に対応する場面"
- 画像番号: 4
説明: "宅配便業者がニヤニヤして何かを話す。"
要素:
- 種類: "キャラクター"
参照: "sub_character"
外見: "宅配業者の制服、帽子、目元は影で隠れている"
表情: "口元に不気味な笑み"
行動: "玄関前に立ち、何かを話しかけている"
スタイル: "漫画調"
アングル: "主婦の視点から見上げるようなアングル"
詳細: "玄関の外、業者の体格と制服の質感"
内容: "不穏さを感じる訪問者の描写"
こちらが生成結果です。1枚目はプロンプターが「スタイル: "リアル寄り"」と記述した影響で、写真風になってしまいました。このように、このGPTsは自由な発想で指示文章をふくらませるので、アングルや行動などにイメージと異なる部分があれば書き直しましょう。
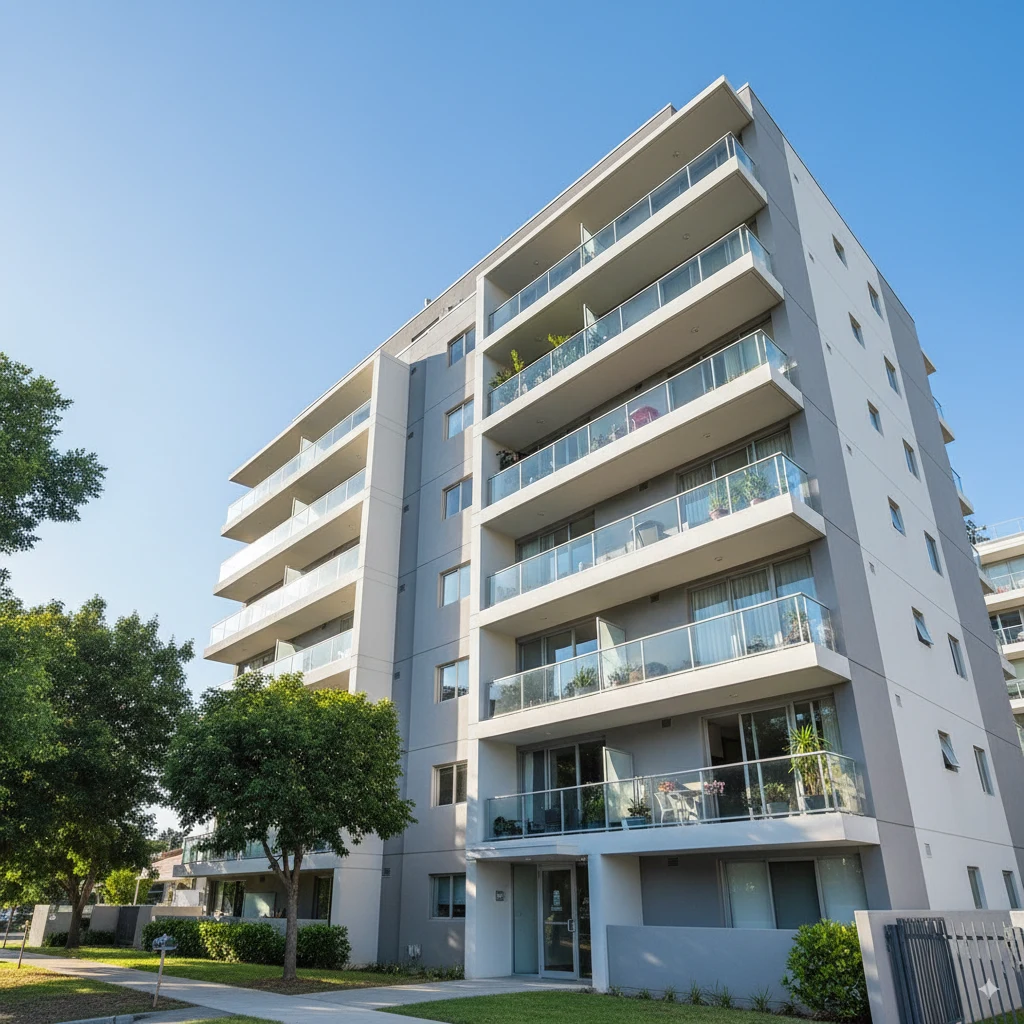
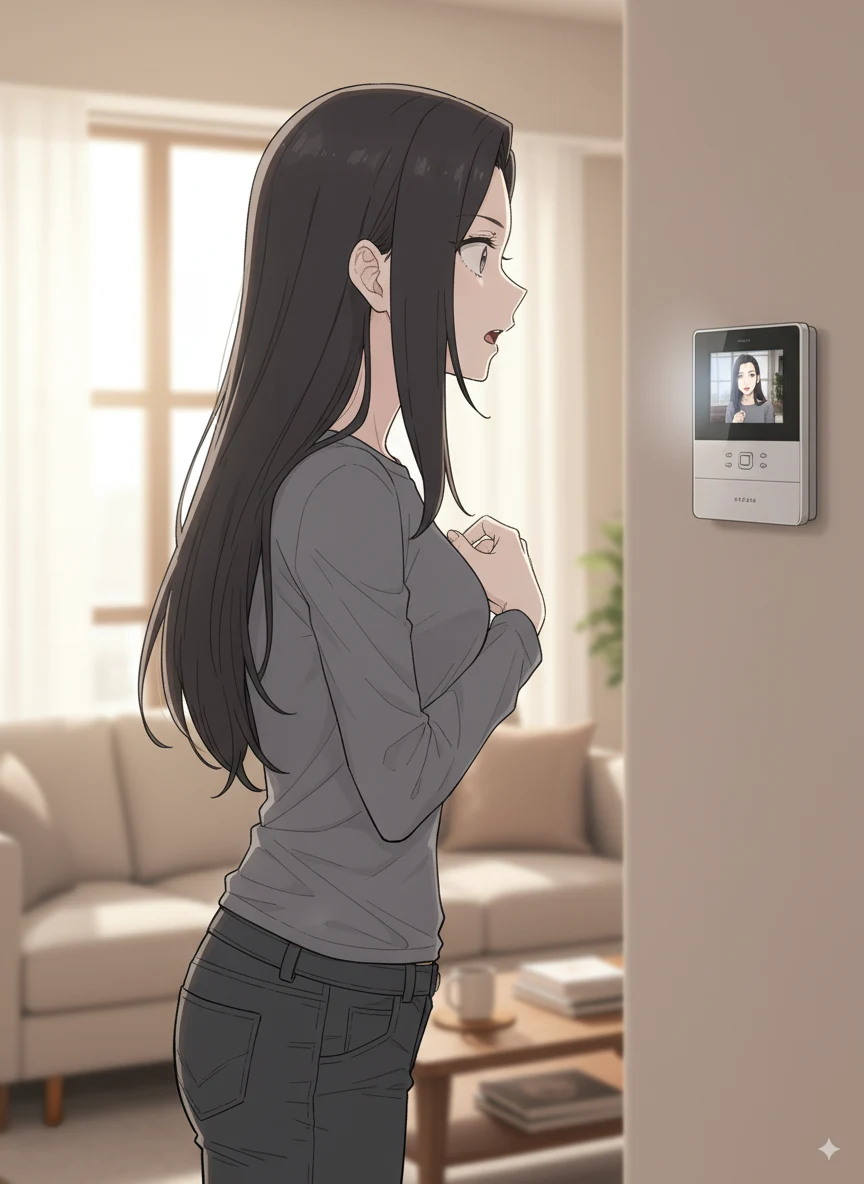
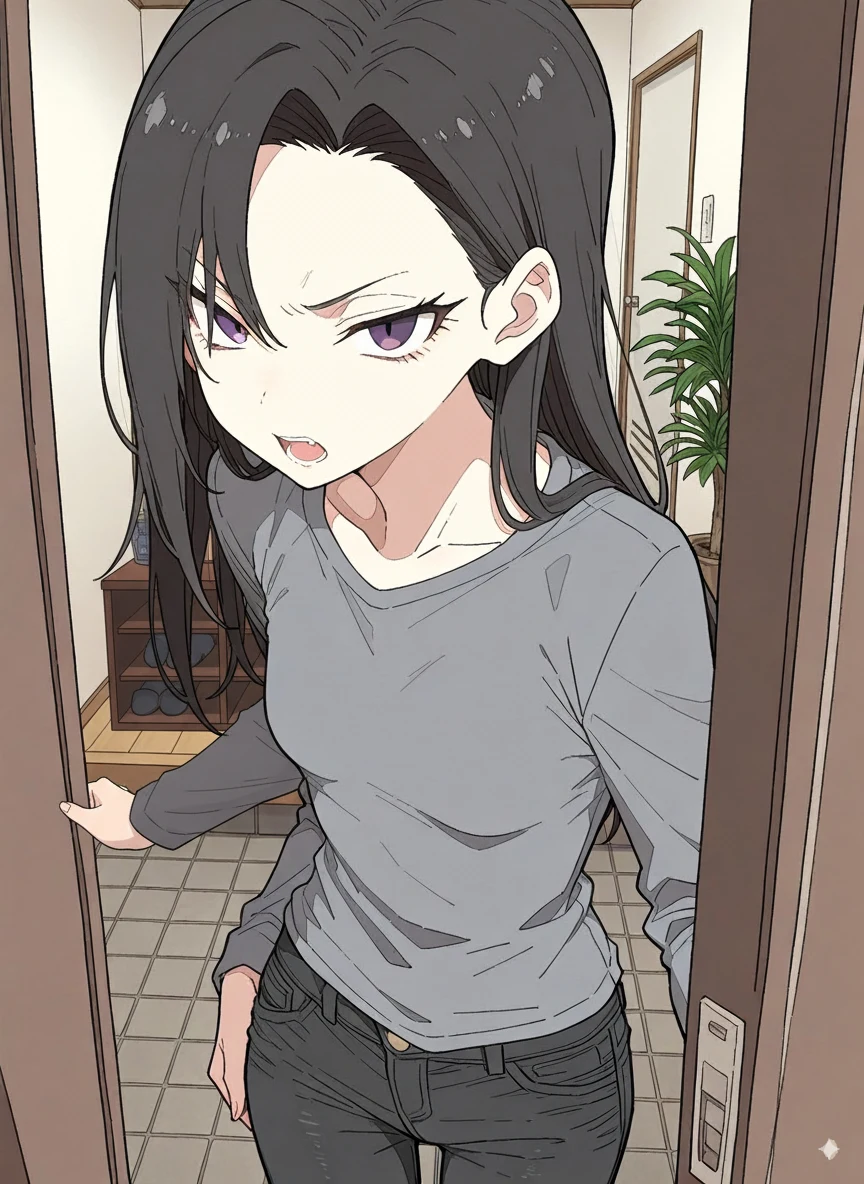
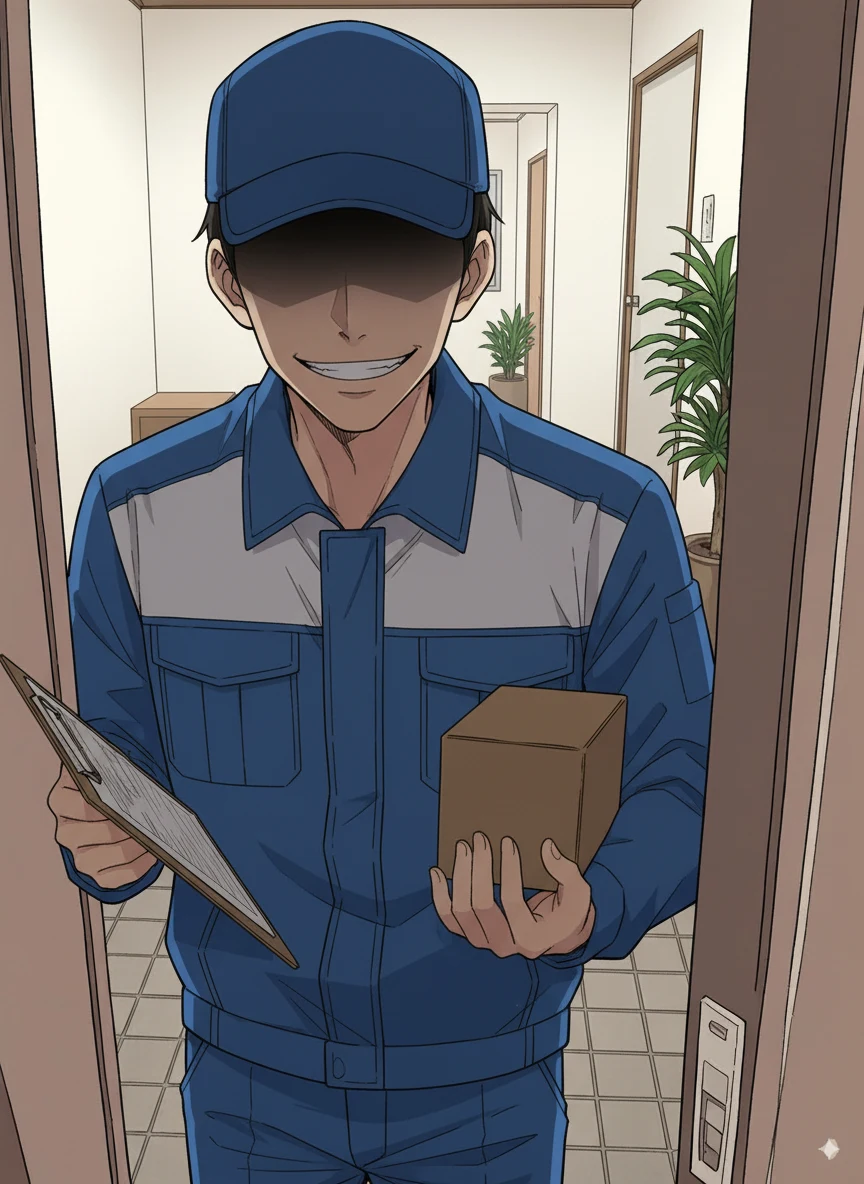
以上です。先ほどの自然言語指示バージョンと比べて、どう感じたでしょうか。
個人的感想ですが、指示をわざわざYAML形式にして時間と手間を消費しただけの価値があるかといえば、正直あまり差は感じにくいように思います。直感的に考えたことを自然言語で指示しても、ほとんど誤解なくgeminiは理解できるからです。
また、そもそも連続生成が失敗してしまい、下図のように1枚だけの画像で4コマの情報がまとめて生成されてしまう失敗も多く発生しました。
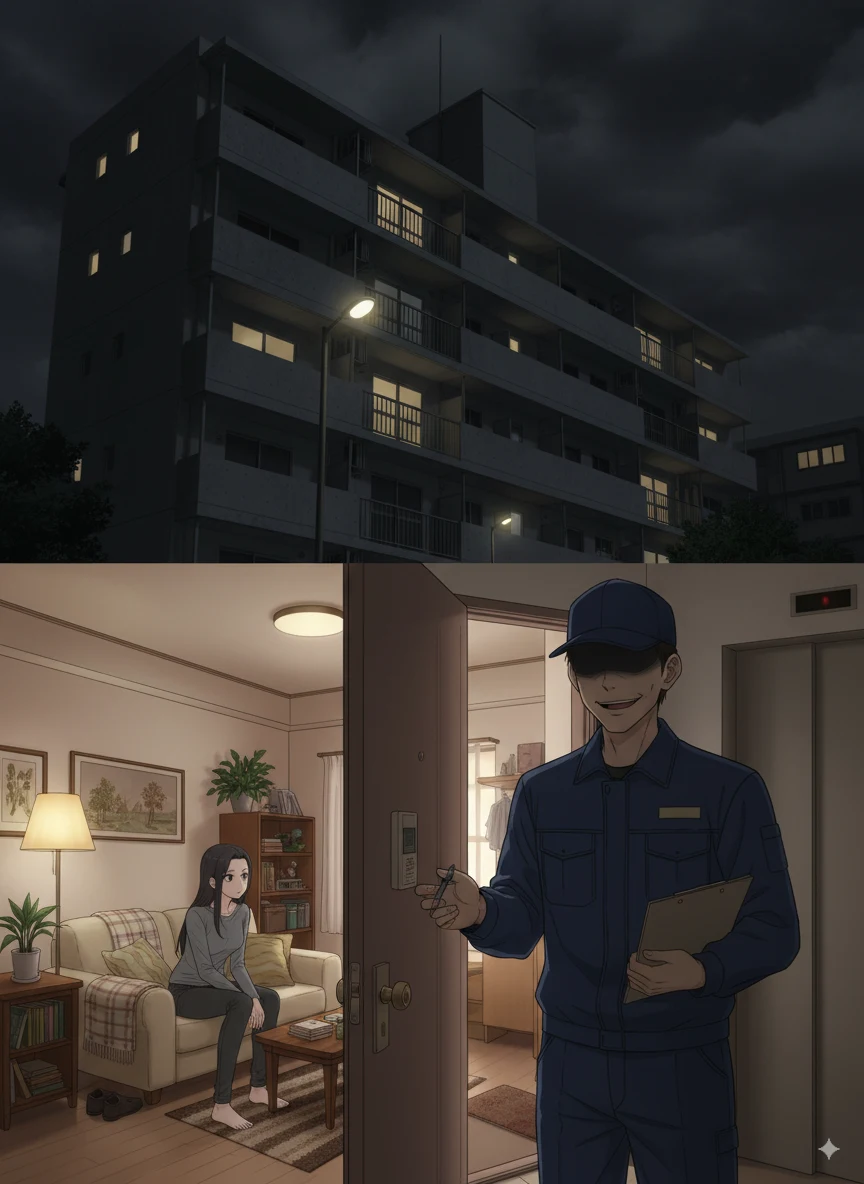
事前にキャラクター資料も作っているのですから、最低でも7~8割くらいの打率で思った通りの画像が作れないと、全体の作画時間がどんどん伸びてしまいます。NanoBananaに頼んだ方が時間を無駄にしてしまうようでは、作画支援どころではありませんよね。