こんにちは、スタジオ真榊です。10月に入り、早いものでNovelAIの登場からほぼ丸一年が経過しましたね。
本日は、Microsoftの検索エンジン「Bing」に搭載されたことでTLを騒がせているOpenAI社の深層学習モデル「DALL-E3」(ダリ3)についての記事です。簡単なチュートリアルとともに、StableDiffusionを主に触ってきた画像生成AIユーザーから見てどのように凄いのか、何が変わるのか、そして何に使えるのかについて、さまざまな角度から検証してみたいと思います。
「DALL-E」とは?
DALL-Eシリーズは、ChatGPTで知られる米OpenAI社により開発された画像生成用の深層学習モデル。画像とテキストのペアを無数に学習することで、文字(プロンプト)を入力すると適切が画像を生成できるようにした「text2image」と呼ばれるモデルの一つです。2021年1月にファーストモデルが、2022年2月にセカンドモデル「DALL-E2」が発表されていました。
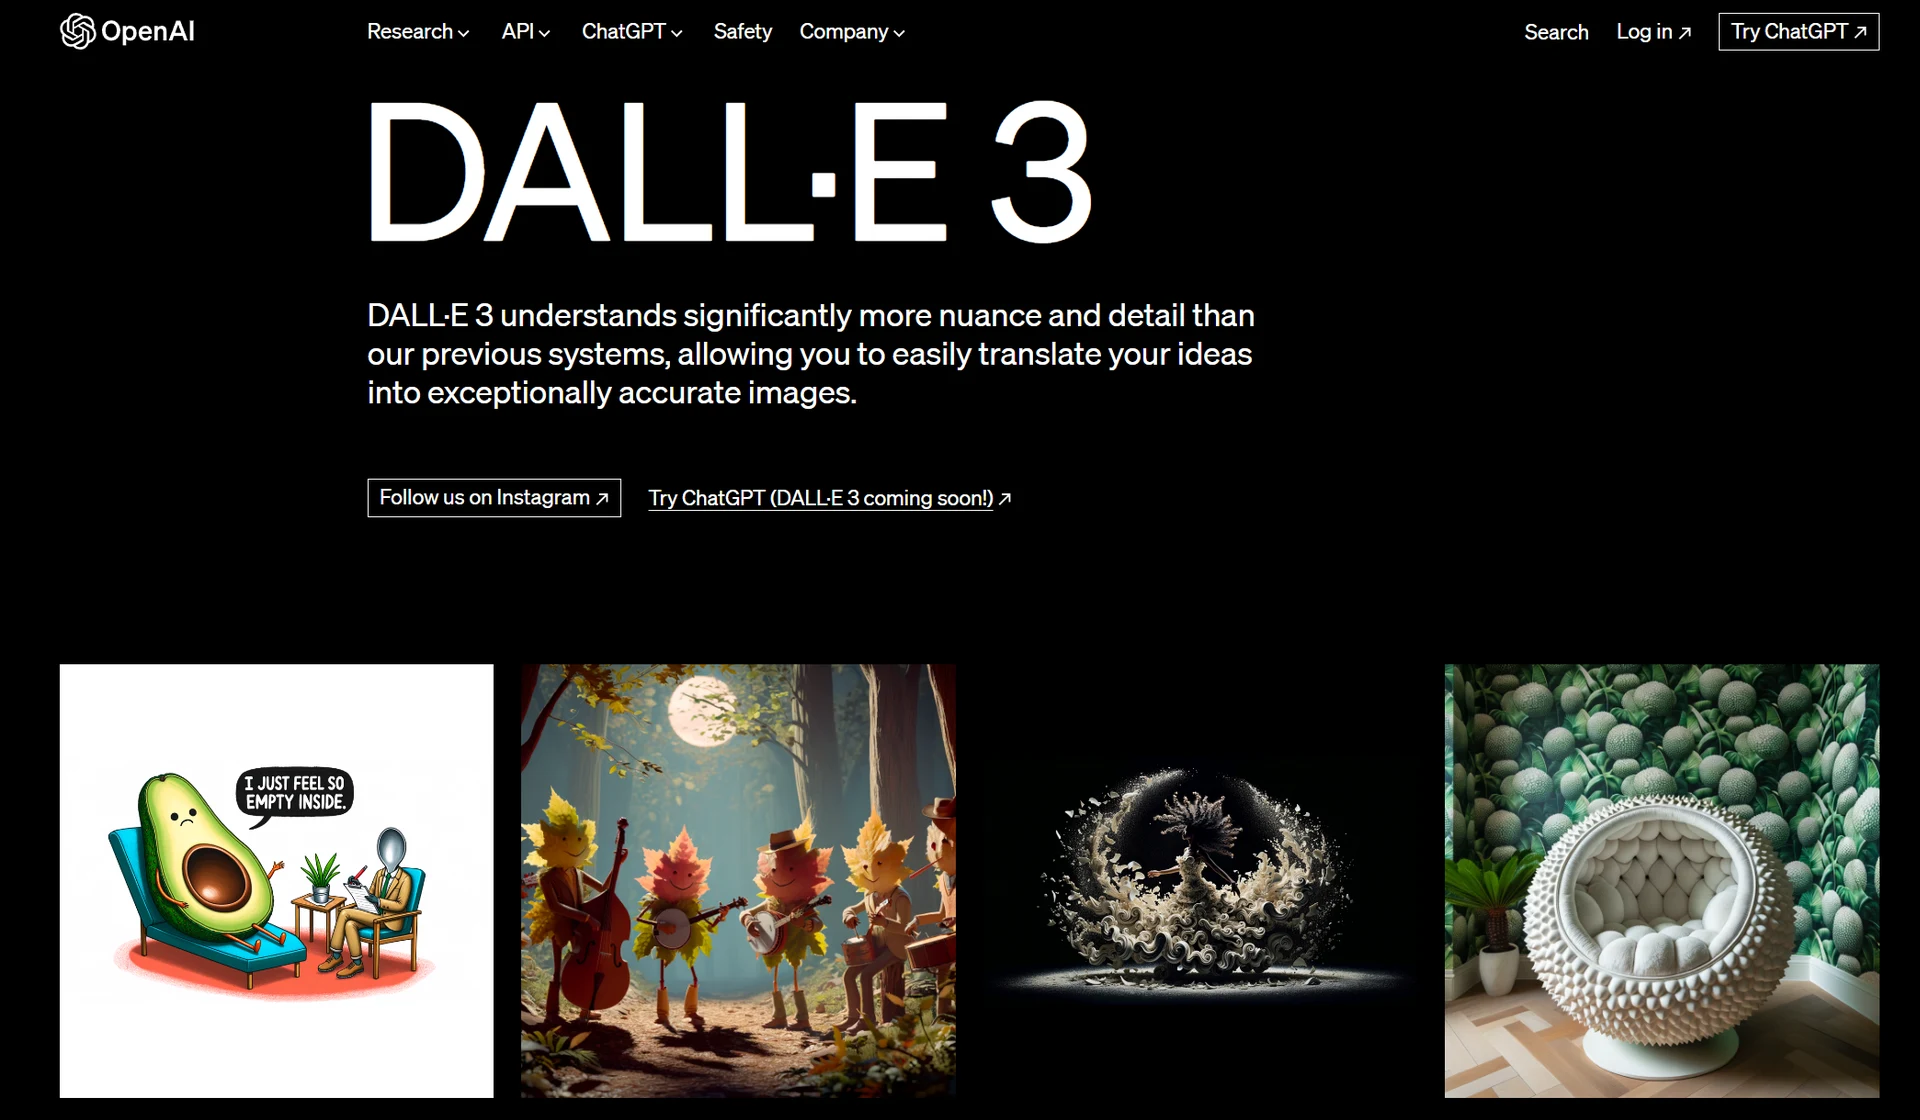
(https://openai.com/dall-e-3 よりスクショ引用)
23年9月20日に発表された「DALL-E3」は、よりプロンプトに忠実な画像が生成できる新モデル。これに伴い、Microsoftの検索エンジン「Bing」上で使える画像生成AI機能「Image Creator」がアップデートされ、DALL-E3ベースでのより高品質な画像生成が可能になったわけです。Image Creatorは、直接Bingにアクセスして使う方法のほか、ChromeかFirefoxを導入するのに主に使われるMicrosoftの不遇ブラウザ「Edge」ではサイドバー機能として使うことができます。
OpenAIのモデルですから、当然DALL-E3はChatGPT上で使用することが前提となっており、23年10月初旬にはChatGPT Plus(有料プラン)のユーザーなどを対象に機能が開放されるとのことです。
「DALL-E3」はどう始めるか
AIによる画像生成をするまでに、自分のPC上での環境整備やプロンプトなどに関する知識を覚えることが必要な「StableDiffusion」と異なり、Microsoftアカウントを持っていれば、ほとんど手間を掛けずにDALL-E3での画像生成を始めることができます。
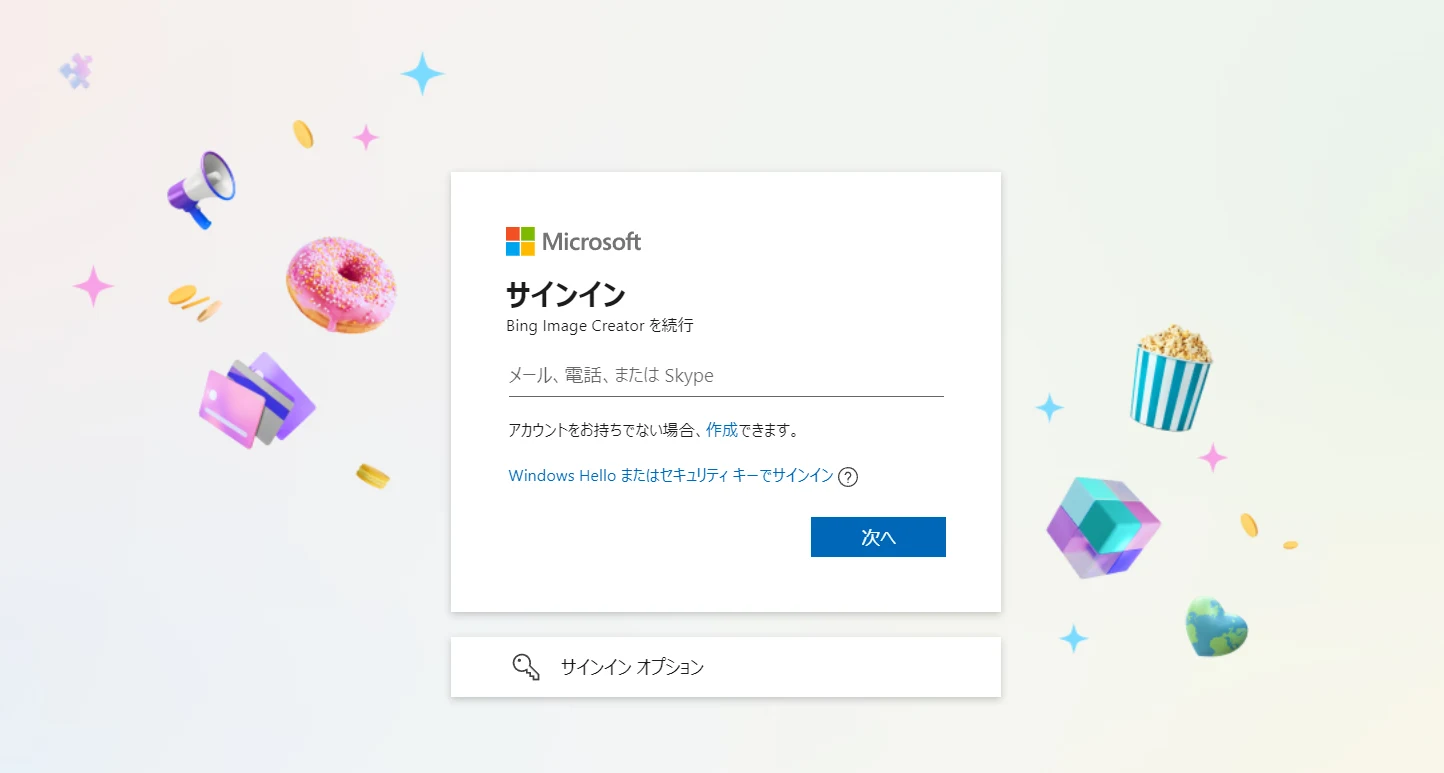
「Edge」をわざわざ起動しなくても、こちらのURL(▲)から「Bing image creator」の画面に遷移し、microsoftアカウントでログインすれば、無料ですぐに画像生成を始めることができます。
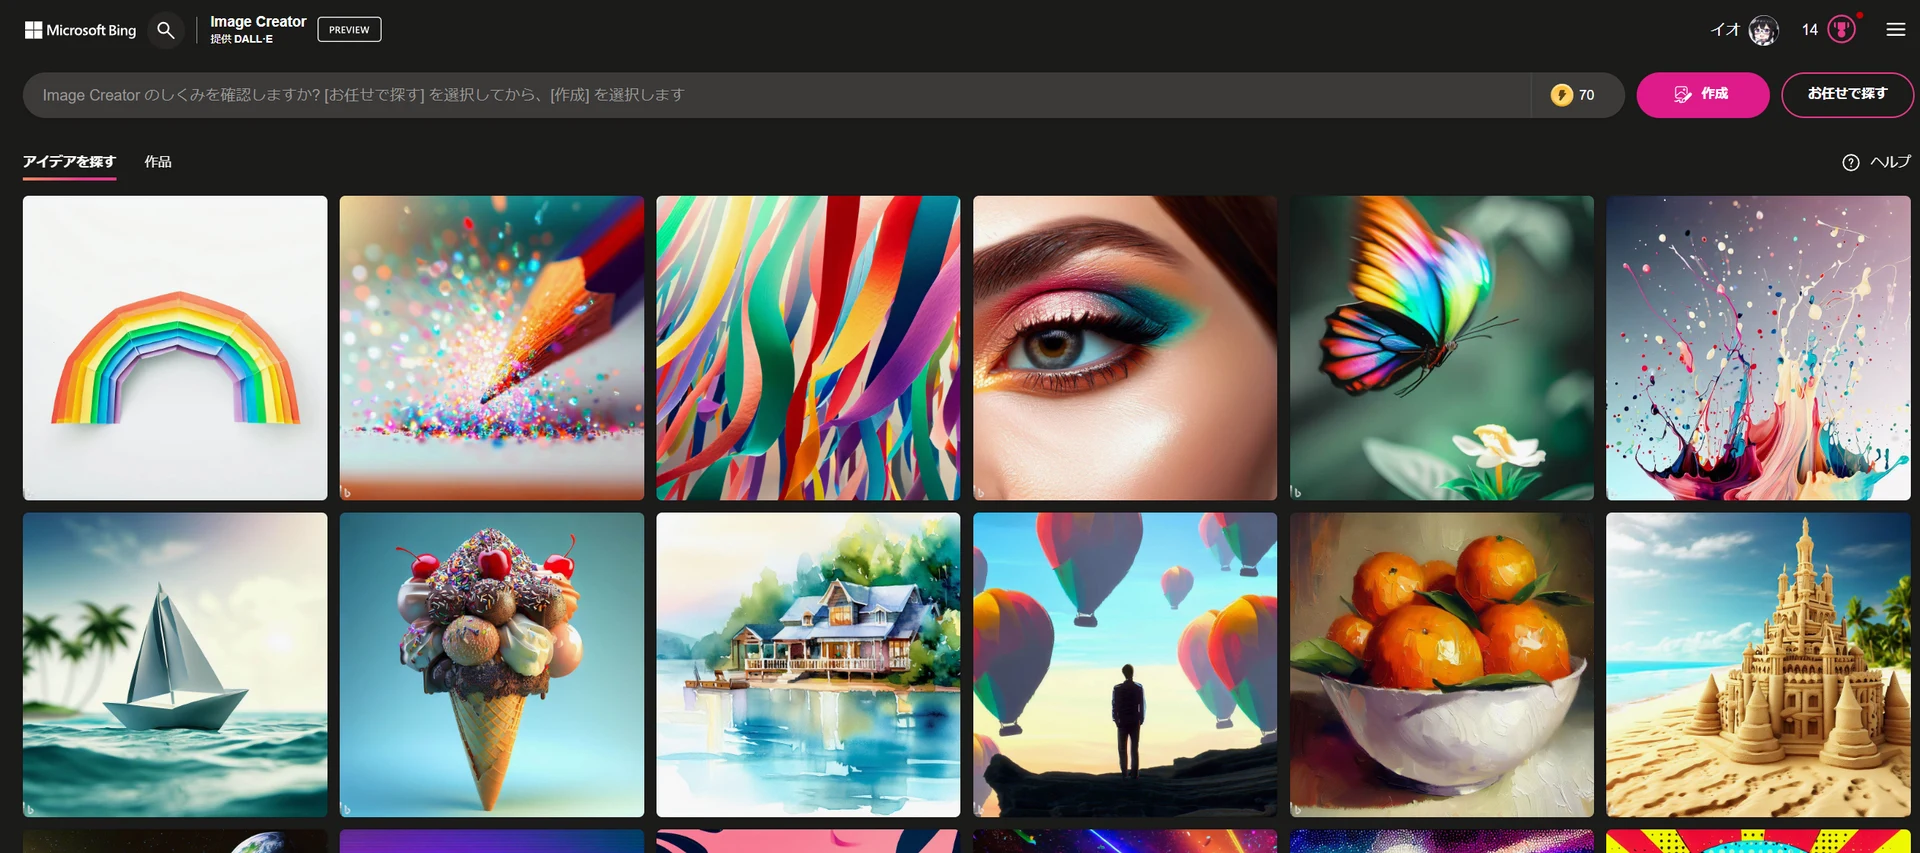
これが「Image Creator」のトップ画面。上部の入力欄に生成したい画像について自由に打ち込むことで、すぐに画像生成を楽しむことが出来ます。
画像生成AIのモデルは英語ベースで学習されることが多く、StableDiffusionなどは英語でプロンプト(AIへの指示文章)を入力する必要がありましたが、Image Creatorでは日本語で打ち込んでも問題ありません。ただ、内部的に英語に自動翻訳されてから読み込まれているようなので、翻訳過程で意味が変容しそうな日本語は使わないほうが良いでしょう。
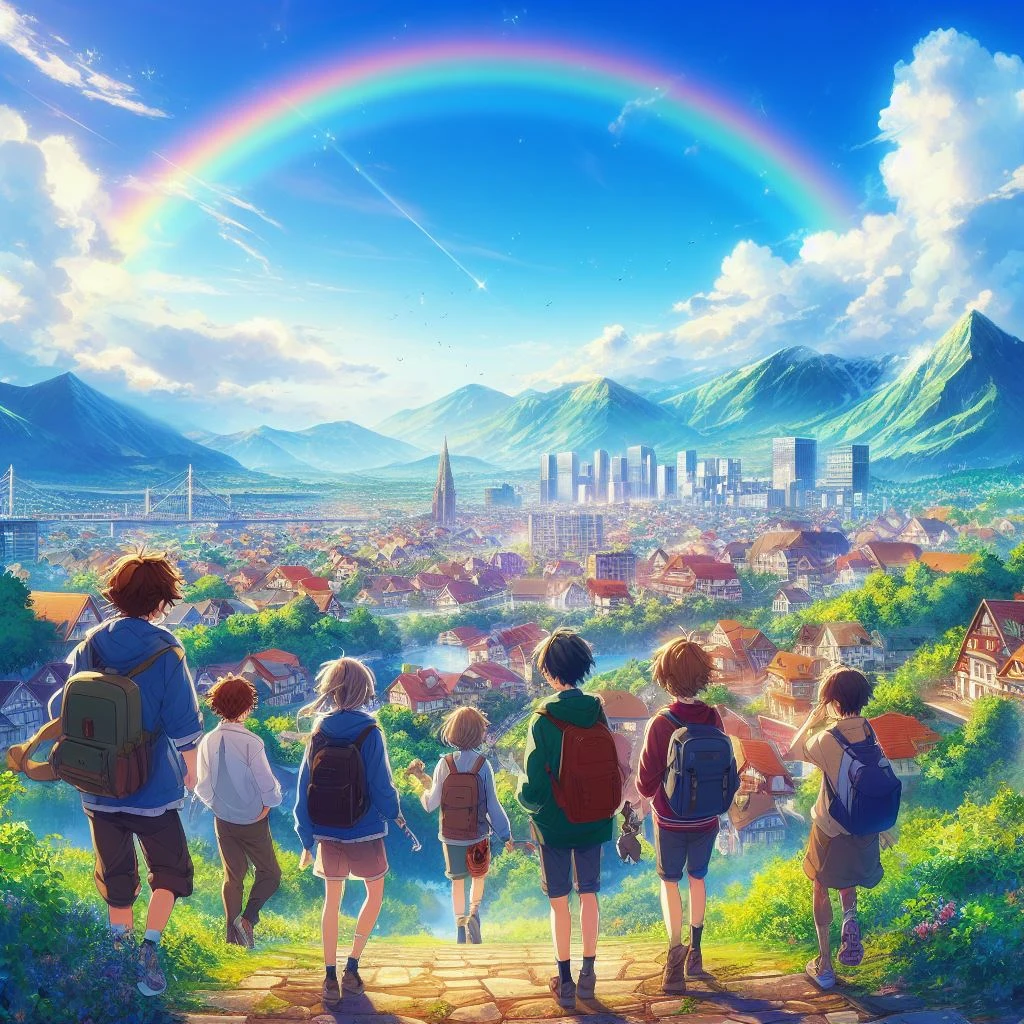
試しに、「アニメ、美しい風景、都市、山、虹、美しい青空、少年少女たちの後ろ姿、HQ」というプロンプトを打ち込んでみると、10秒ほどでこのような4枚が生成されました。
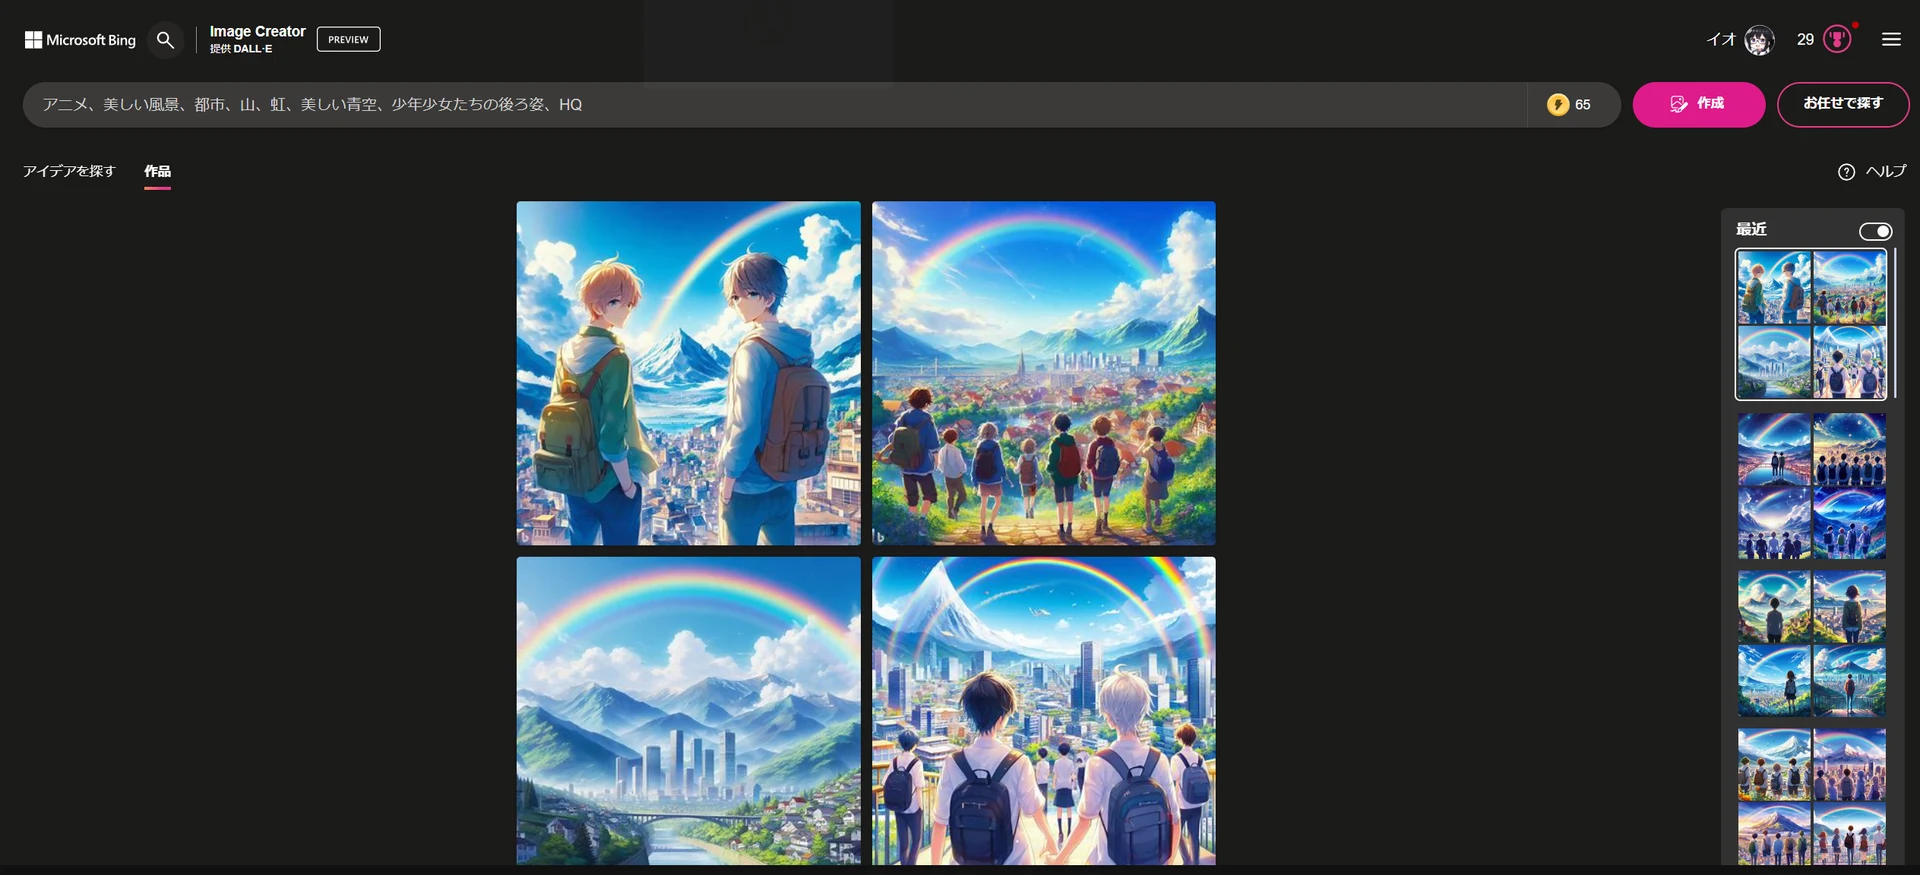
画像サイズは1024px✕1024pxで、Niji journeyのように「アップスケール」(高精細化)をしなくても、始めからこのクォリティで生成することができます。
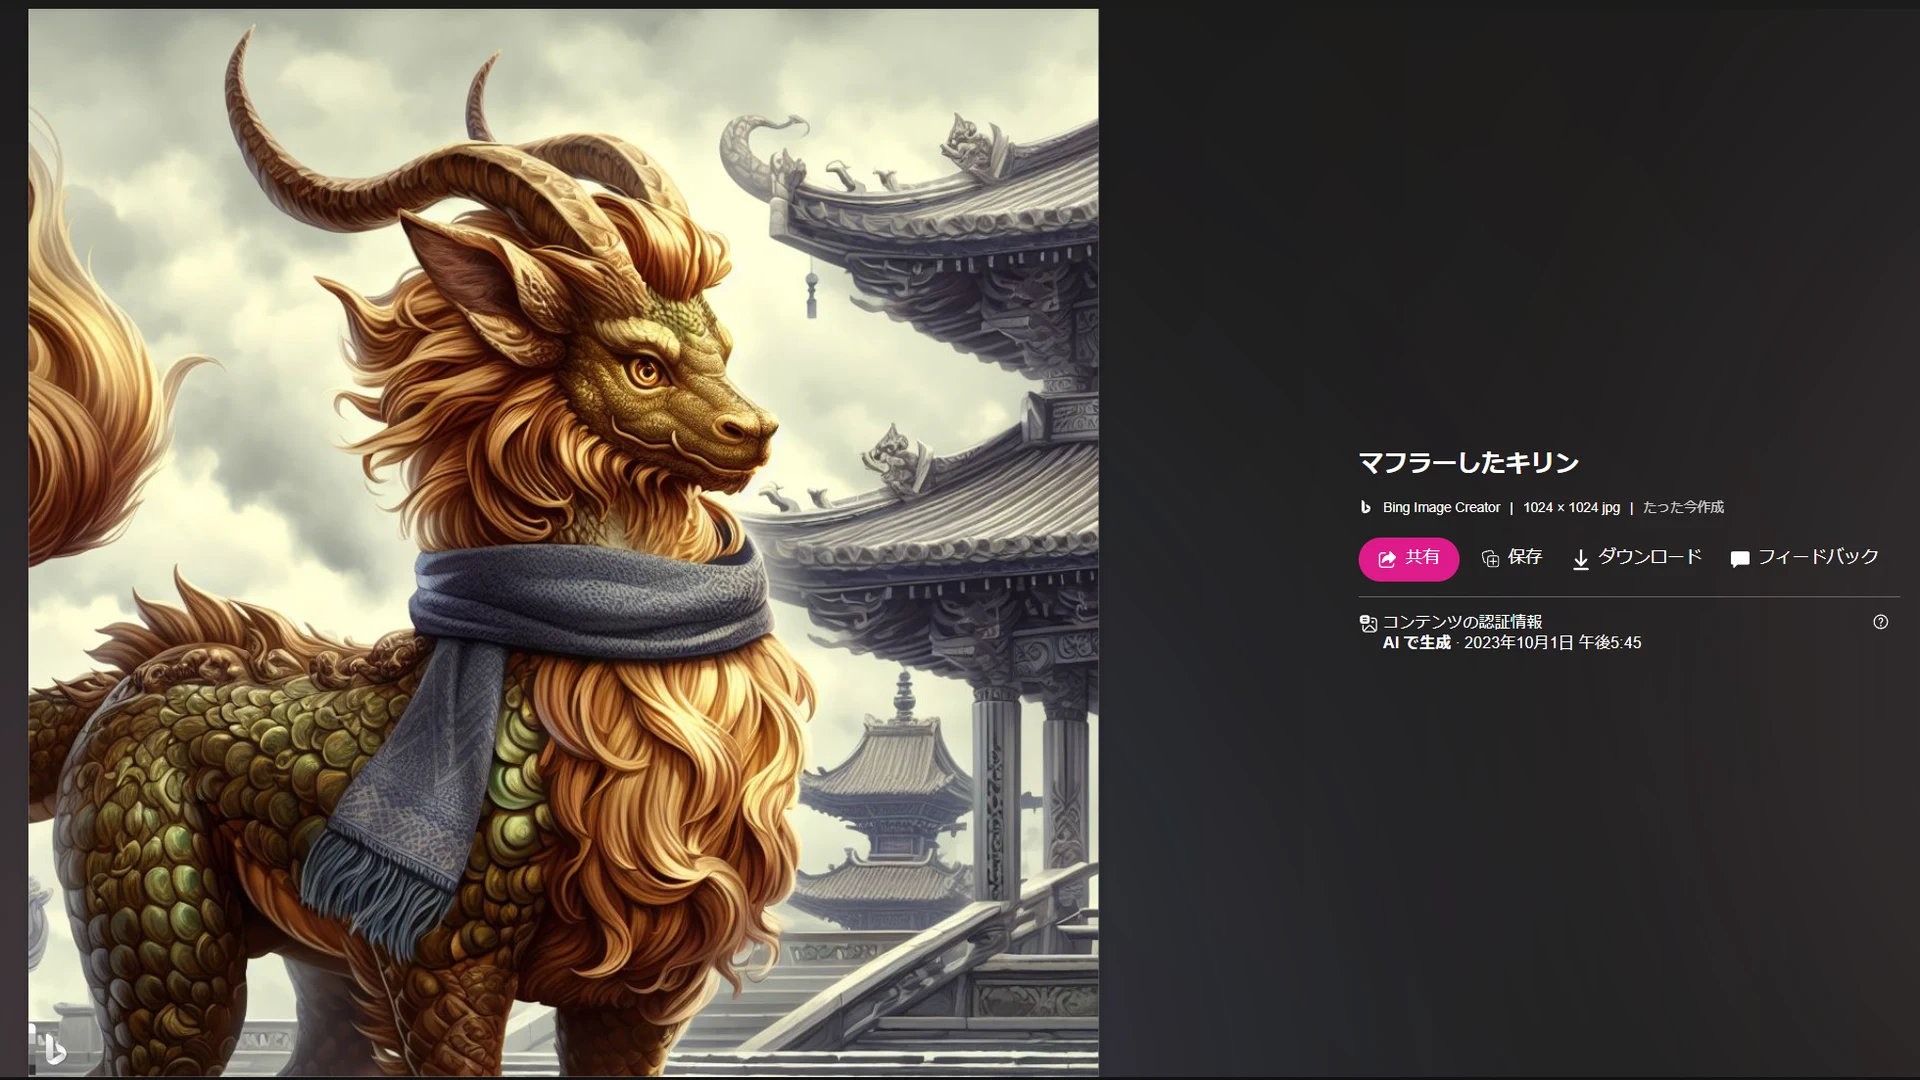
ちなみに、「マフラーしたキリン」だと、ジラーフのほうではなく麒麟の方が出てしまいます。こういう場合は英語で入力する必要があるでしょう。
「ブースト」とは
プロンプト入力欄にはこのように「⚡」マークつきの数字が表示されており、100から生成ごとに「1」ずつ減っていきます。これは「ブースト」とよばれるシステムで、このポイント数が枯渇しても画像生成を続けることはできますが、生成速度が制限されるとのことです。
ブーストが不足した場合は、Microsoftアカウントに紐付けられているポイント「Microsoft Rewards」を利用して追加のブーストを得ることが可能です。
プロンプトのコツは?
前述のように日本語で認識してくれるのですが、公式ヘルプによると「記述的であるほど効果的」「形容詞や場所、さらには "デジタルアート "や "フォトリアリスティック "などの芸術的なスタイルなど、クリエイティブな詳細を追加したほうがよい」とされています。
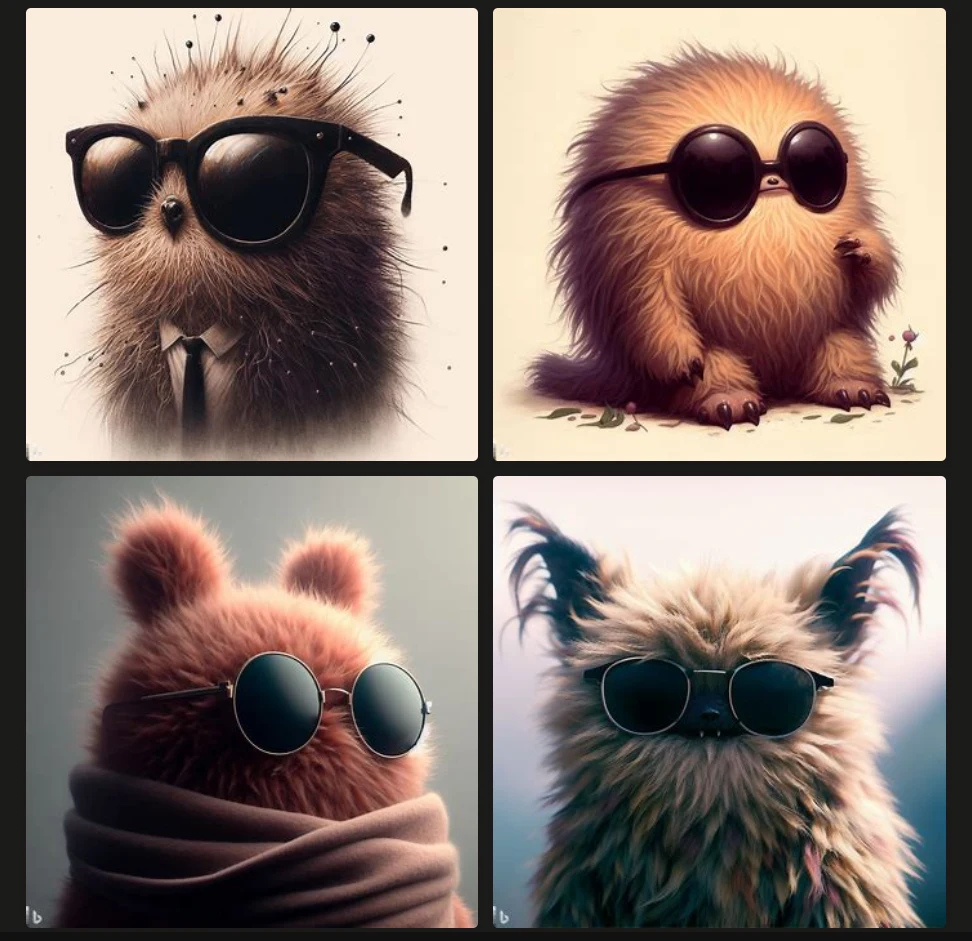
例えば"creature(クリーチャー)"という単純なプロンプトだけではなく、"fuzzy creature wearing sunglasses, digital art(サングラスを掛けたもこもこしたクリーチャー、デジタルアート風)" といった細かいプロンプトのほうが高品質になる(▲画像参照)とされており、基本的には「、」もしくは「,」で区切って形容詞や名詞などを並べていく手法で問題ないようです。
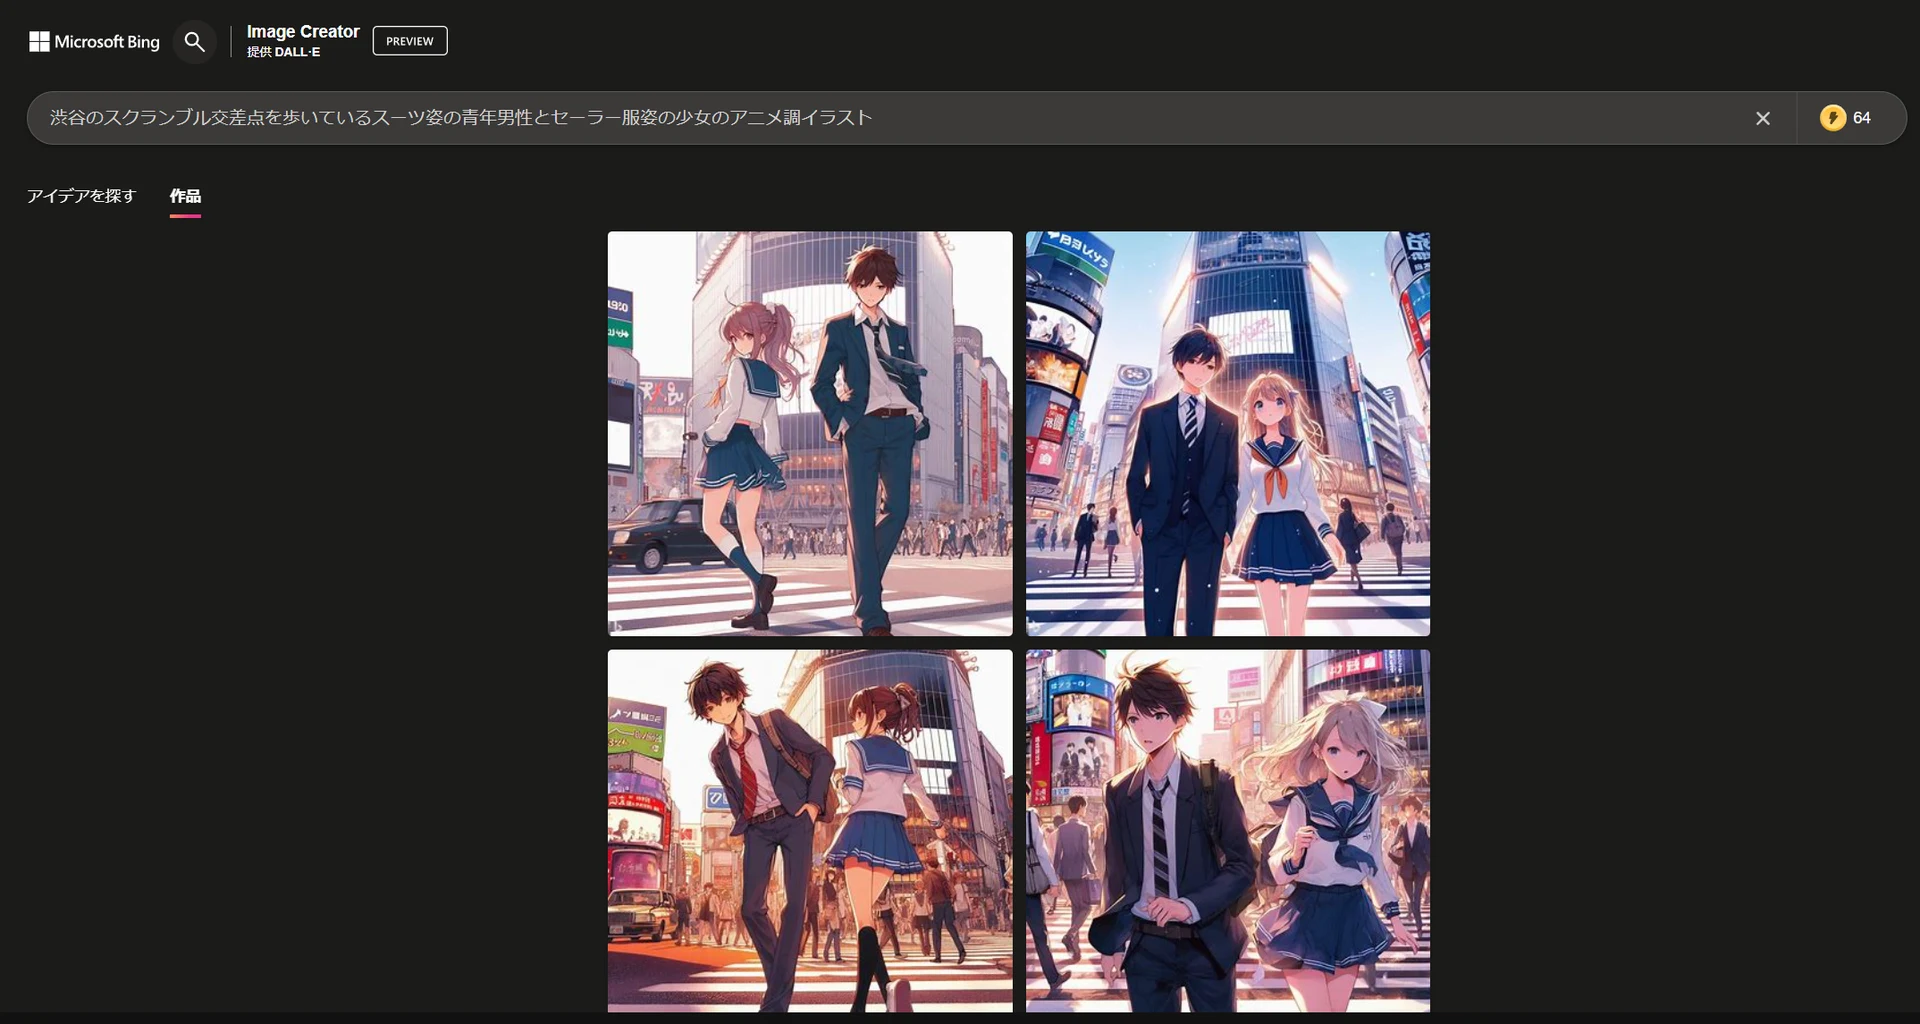
もちろん、「、」で区切らない自然言語的な文章でも問題なく生成することができます。「渋谷のスクランブル交差点を歩いているスーツ姿の青年男性とセーラー服姿の少女のアニメ調イラスト」と指定するとこのようなイラストが出ます。
一方、こちらの画像は「渋谷のスクランブル交差点、歩いている男女、スーツ姿の青年男性、セーラー服姿の少女、アニメ調イラスト」としたもの。多少文脈の変化があるため、被写体の内容だけでなくタッチまで変わっています。どちらが優れているというよりは、どちらが誤解なくAIに伝わるか、を考えて指示したほうが良いのかもしれません。
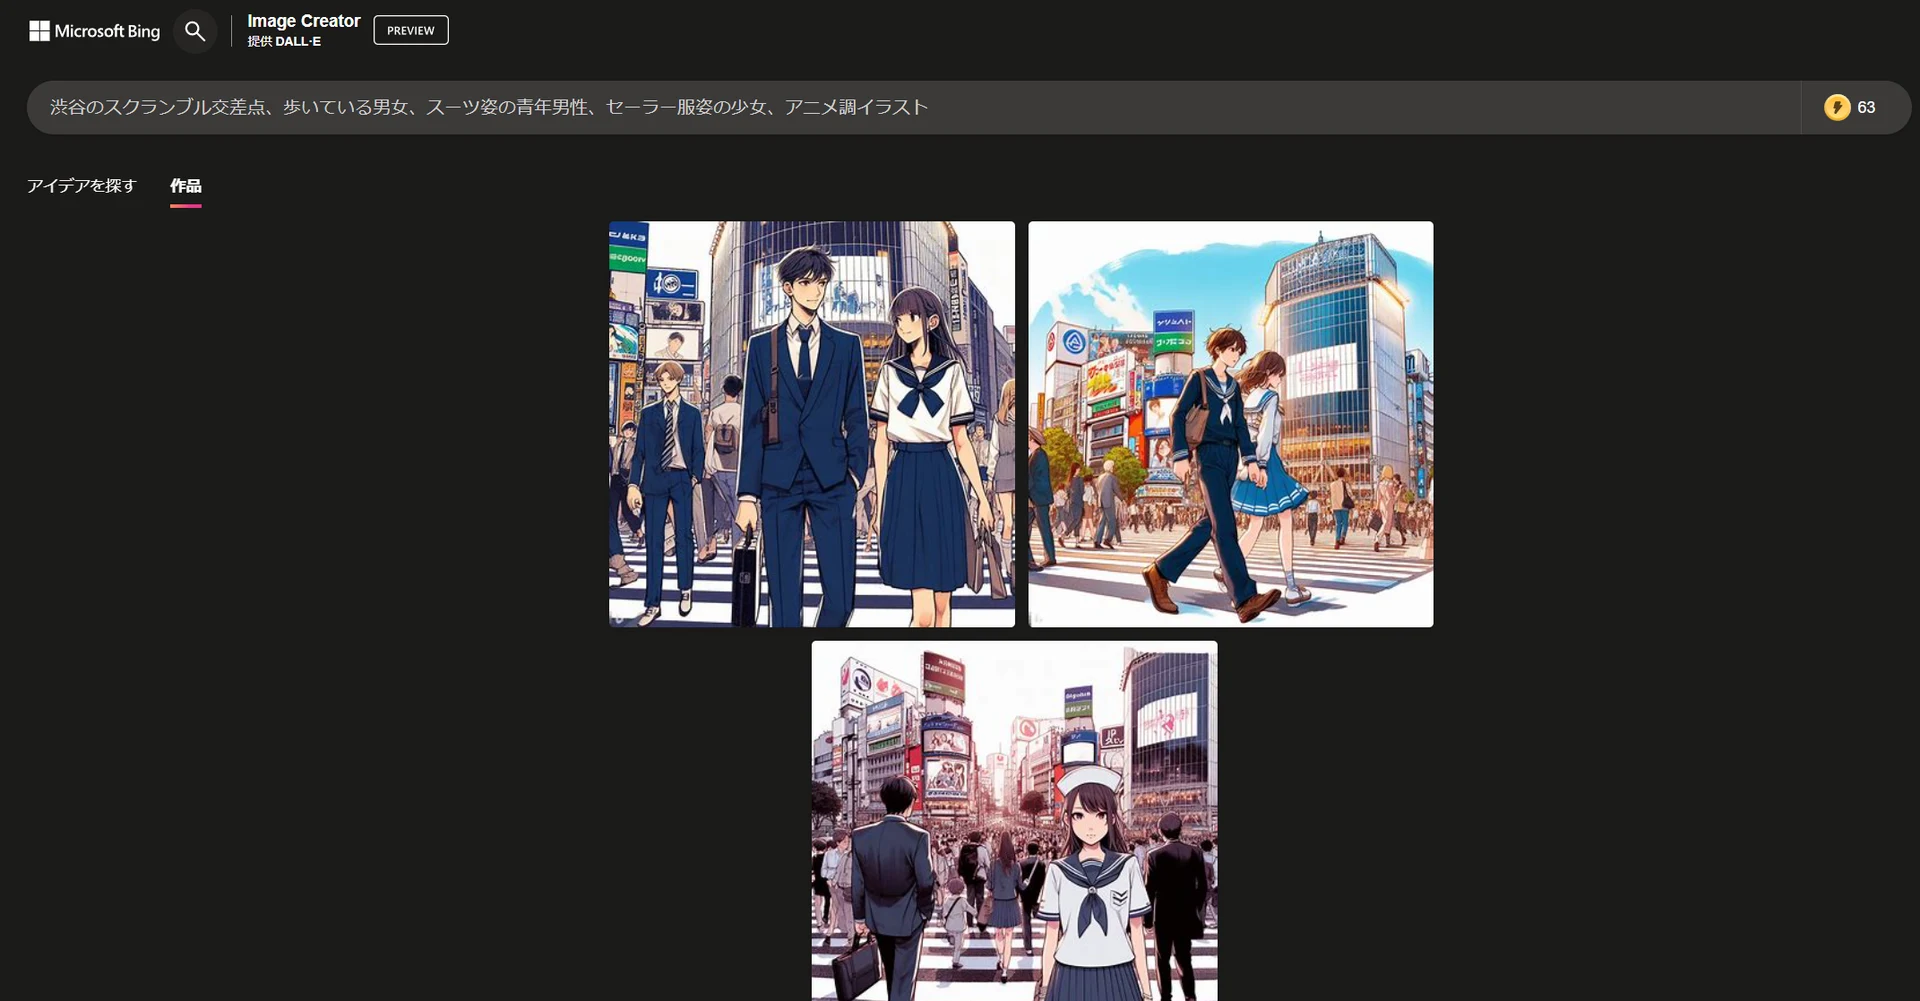
(※このプロンプトでは3枚しか画像が表示されていませんが、理由については次の項目で考察します)
「DALL-E3」で生成できない画像は?
Microsoftのヘルプによれば、OpenAIとの協力のもと、ImageCreator上では「有害な画像や安全でない画像の生成を制限するための管理策」が導入されているとのこと。プロンプトから有害な画像の生成される可能性が検知されると、プロンプトが「ブロック」され、ユーザーに警告が表示されるとされています。
例えば、このようにセンシティブな画像が生成されそうなワードはそもそも入力時点で弾かれ、画像生成に進むことができません。
また、画像生成に進むことができても、たまたま不適切な画像が生成されてしまった場合はその画像だけが表示されない、という二段構えのシステムになっているようです。基本的に画像は1プロンプトで4枚生成されるのですが、場合によっては1~3枚だけしか表示されないことがあり、その場合は内部的に不適切な画像(成人向けや暴力的コンテンツというだけでなく、単に破綻した画像も含まれるかもしれません)が生成されてしまった可能性があると考えられます。
さきほどのスクランブル交差点のイラストでも、2回めの生成では3枚しか画像が生成されませんでした。「セーラー服姿の少女」というワードが敏感に反応した可能性があります。
Bingのコンテンツポリシーは以下の通り。
アダルトコンテンツ、自殺と自傷行為に関するもの、テロ、暴力、グロテスクな描写、ヘイトスピーチ等々の生成が禁止されています。このコンテンツ ポリシーに何度も違反していると、Image Creatorの使用ができなくなる恐れがあるとのこと。異議申し立てもできるようですが、場合によっては完全に「BAN」されるケースもあるとのことですので、興味本位でセンシティブなプロンプトを繰り返し試すのはやめておいたほうがいいでしょう。