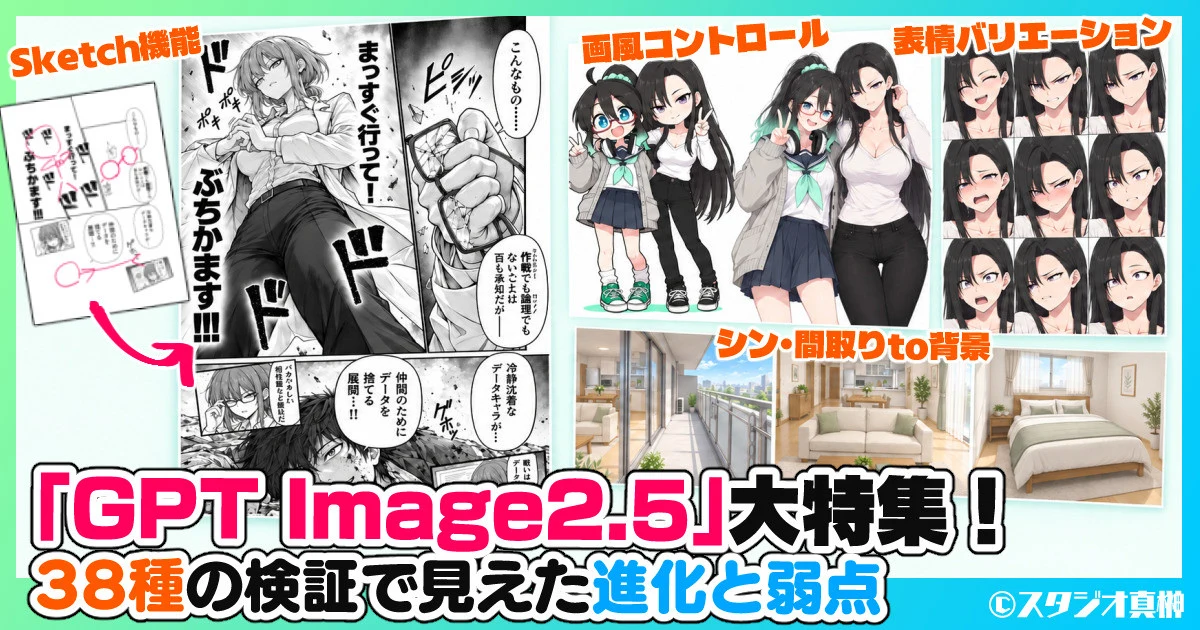

【9月11日追記】さらに9項目を追加し、38種としました。
こんばんは、スタジオ真榊です。今回は、2026年9月9日未明(日本時間)にリリースされたOpenAIの画像生成・編集モデル、「GPT Image2.5」の大特集です。前回のバージョン「GPT Image2」特集と同じ検証内容に加え、新たな生成テストも多数実施。全38種の比較実験で実力を明らかにしました。(※検証は随時追加していきます)
GPT Image 2は、GPT5シリーズの理解力の高さを背景に、10枚同時にバリエーションを出してもらえる気軽さと自由度の高さが大きな魅力でした。一方で、粒状ノイズやもやもやした色むら、編集を繰り返したときの劣化などの不満点も。今回のアップデートと最新LLMモデル「GPT-6 Astra」との連携によって、AI創作の最前線がどう変わったか、徹底調査しました。【約20,000字】
GPT Image 2.5とは?
GPT Image 2.5は、ChatGPTで知られるOpenAI社が提供する最新画像生成モデル。「こんなキャラを描いて」と頼むtext2imageだけでなく、画像を入力して「このキャラの服を変えて」「この部屋を夜にして」といった編集作業ができ、前バージョン「2」の時点で既に世界最高レベルの編集機能を備えていました。
OpenAI社は9月3日に最新LLM「GPT-6 Astra」をリリースしたばかり。既にAstraは現行最強レベルのモデルとしてTLを騒がせていますが、その優れた知性が操る画像生成モデルも1週間遅れでアップデートされたことで、まさに「鬼に金棒」と言える状況になっています。
9月8日以降にChatGPT(Workモード)やCodexに画像生成を頼めば、基本的に「2.5」で画像を作ることができます。他に、外部のアプリなどからモデルを呼び出せるAPI利用も可能。例えば、「Magnific」(旧Freepik)などの生成プラットフォームで既に生成が可能になっています。
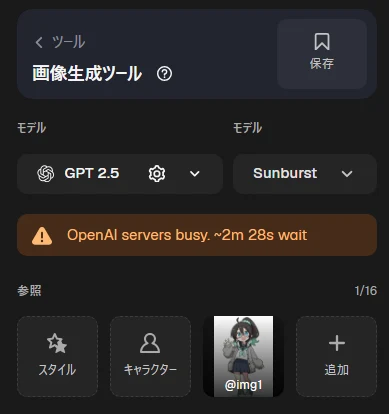
<2.5は"Sunburst"と"Flare"の2種類>
まず押さえておきたいのが、2.5には「サンバースト」と「フレア」という二つのモデルがあることです。「Astra」も星にちなんだネーミングでしたが、なんだかポケモンの新シリーズみたいですね。
「GPT Image 2.5 Sunburst」は品質重視のモデル。公式は「GPT Image 2を超える画質で、精密な画像編集ができる」と説明しています。一方、「GPT Image 2.5 Flare」は速度重視のモデルで、日常的な画像生成をより素早く行う用途に位置づけられています。いずれも「2」と比べて生成時間を最大50%短縮したとしています。
ただ、ChatGPT経由で画像生成を指示すると、内部的にどちらのモデルで生成されているか確かめる手法がありません(記事執筆時点)。MagnificのようにAPI経由の利用の場合は指示可能ですが、ChatGPTで生成画像の品質がイマイチに感じたときはFlareが内部的に選ばれているのかもしれませんし、必ずFlareになるのかもしれません。間に入るGPTモデルが指示に応じて呼び出すモデルを選択している可能性もあるので、このあたりは情報待ちですね。
モデルの違いと詳しいプロンプト記述方法は、こちらのOpenAI公式ガイドで紹介されていますので、併せてご参照ください。
<プロンプトの基本>
・基本的には直感的な日本語で「この画像をこうして」「こういう画像を出して」と頼むのですが、求めているものの名前を具体的に最初に明示するのがコツ。例えば、「おしゃれな商品写真」「ウェブ広告」「水彩風のイラスト」などと最初に言い切りましょう。素材、照明、色、映像媒体も重要です。
・テキストを画像の中に書いてほしい場合は引用符"~"でくくること。「」でも通るようです。
・変更したい場所が限定的な場合、つまりインペイント的な作業をしたいときは、「~のみを変更」「他は変更しない」と伝えます。同じように、勝手に描かれてしまうのを避けたい場合も「テキストやロゴ、看板は不可」「人物は描かない」などとはっきり除外しましょう。
・漫画のように、一つの画像の中に複数の別々の画像がある場合は「白黒の4コマ漫画」のように言い切った後、「1コマ目:」「2コマ目:」…のように各コマの内容を列挙します。
・入力画像の画風を模倣したい場合は、「入力画像のアートスタイルを厳格に踏襲してください」のように指示します。
画像サイズには「各辺の長さは3,840ピクセル以下」「両辺の長さは16ピクセルの倍数」「長い辺と短い辺の比率は最大3:1」「総画素数は655,360~8,294,400」というルールがあります。基本的に、ChatGPTでは「4:3」「9:16」のように希望する縦横比を伝えます。APIでピクセル寸法を指定する場合は「1536x864」のような形式を使い、サイズの制約に従う必要があります。
枚数もこれまで同様、「n=10」や「5枚連続生成」などと書き添えれば、ほとんどの場合通ります。(生成の混み具合やモデル選択によって1枚画像になってしまうこともあります)
<ラフで伝える「Sketch」機能>
今回は、文章だけでなく、自分で描いたラフを使って画像を生成する「Sketch」機能も追加されています。ローカル画像生成などでは初期からある(そしてあまり使われてこなかった)Sketchインペイントに近い機能ですが、性能はけた違い。「+」ボタンを押すか、このように「@」を打ち込むと選ぶことができます。
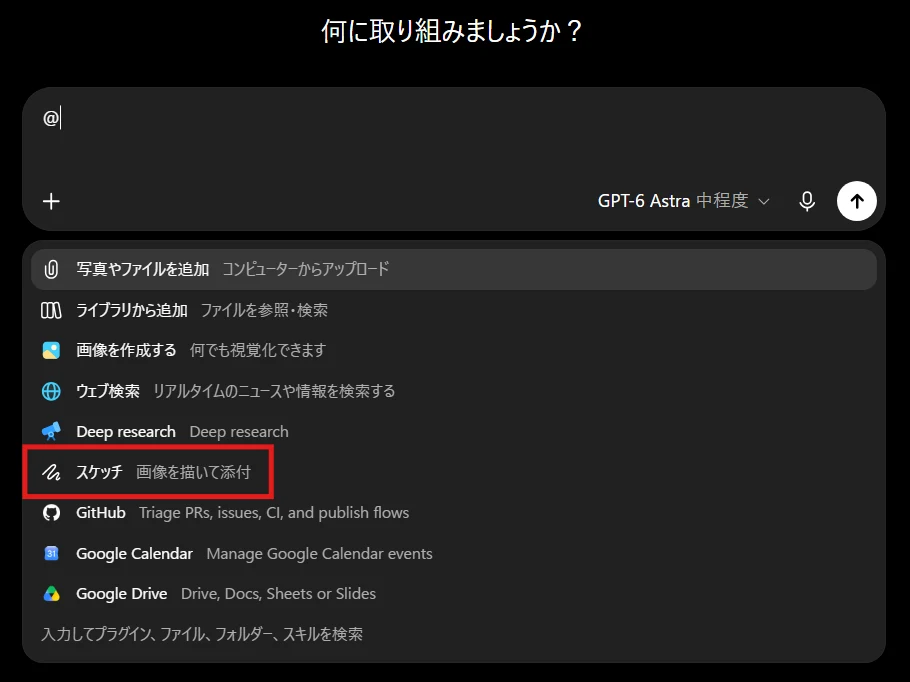
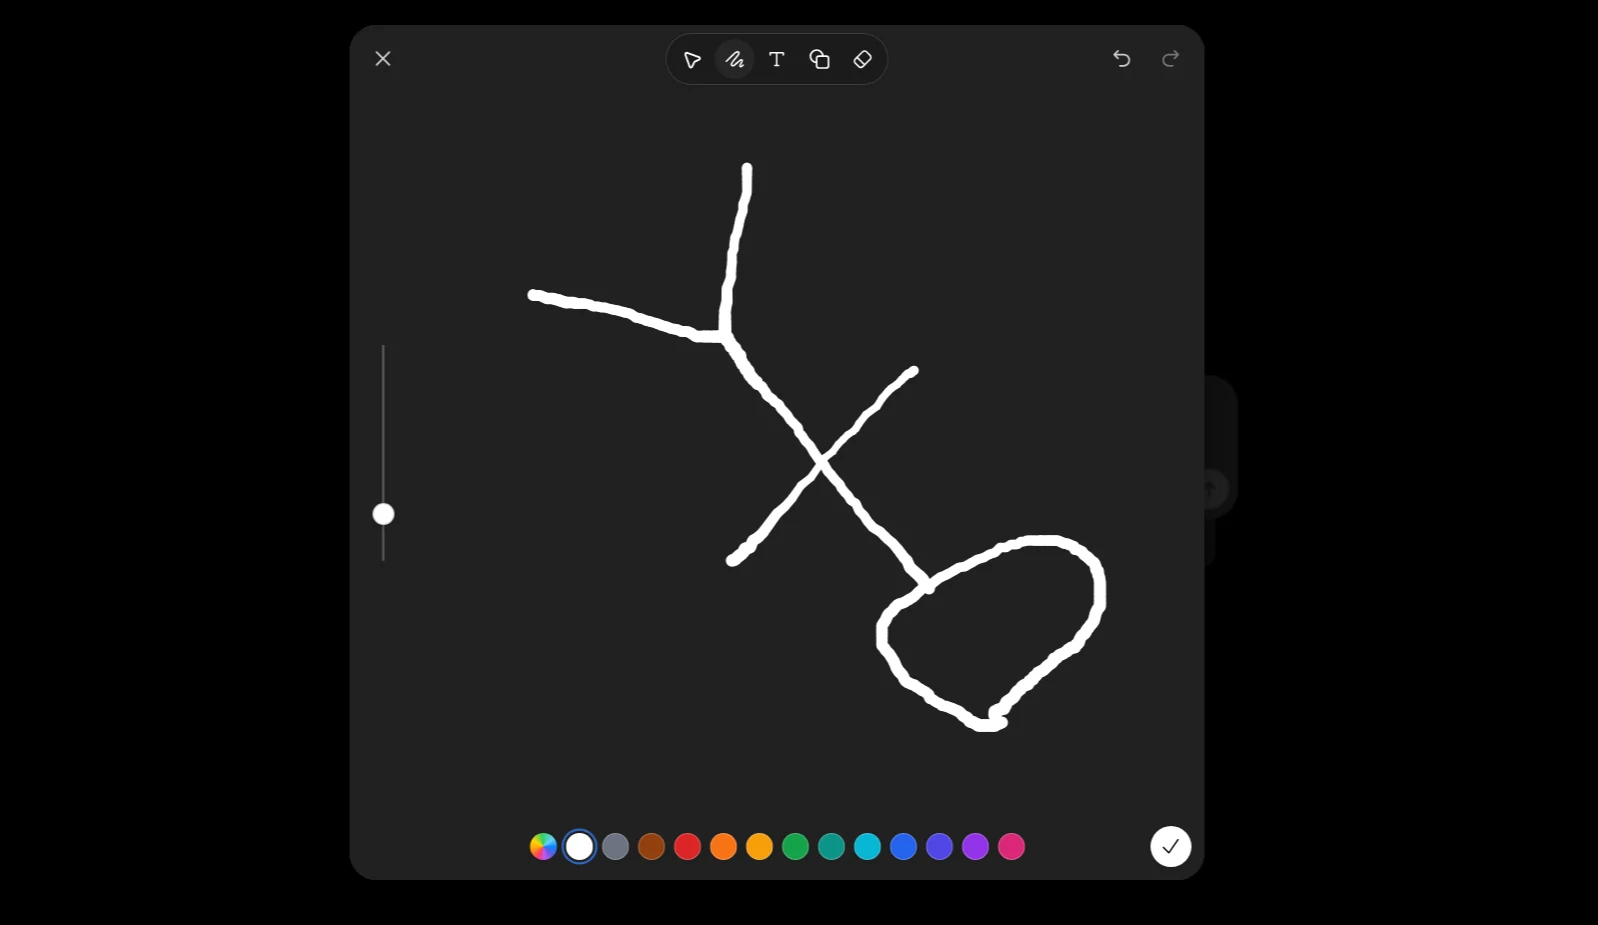
こちらが起動画面。ややカクつきますが、このようにさまざまな色で画面にマウスアートを描くことができます。「T」ボタンからテキストを打ち込んだり、簡易的な記号を入力することもできます。絵が描けたら、右下のチェックボタンで確定します。
あとはこのように、その画像で何を伝えたいか説明してあげれば、イメージ通りの画像を生成することができます。
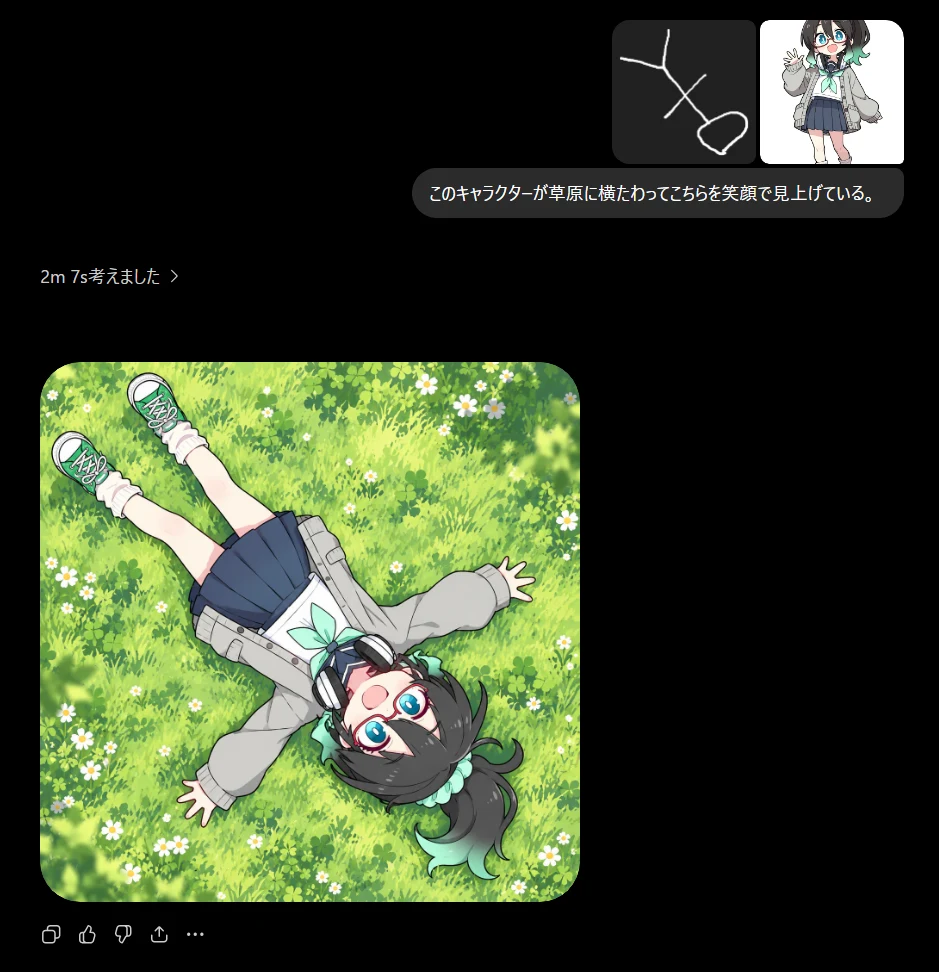
「左にこの人物、右に机、奥に窓」と言葉で説明する代わりに、丸と線で配置を描けるのは便利ですね。絵をマウスできれいに描ける必要はなく、テキストを補助する役目としてちょっとしたスケッチが使えるようになったという理解でよさそうです。ただ、確実にうまくいくわけではないことは先にお伝えしておいたほうがよさそうですね…。
ちなみに、これは入力画像を自分の手で描いているだけですので、必ずChatGPT画面上でやらなければいけないわけではありません。CLIPSTUDIOなどの普段の画像編集ソフトで簡易的にお絵描きしてモデルに渡せば、ちゃんと同じように理解してくれます。
<注目したい進化ポイント>
前モデル「GPT Image2」は、10枚連続でバリエーションを出してもらえる気軽さと、こちらの創作の事情を踏まえた提案が大きな魅力でした。一方で、手を直しただけのつもりが周囲も変わる、粒状のノイズや色むらが出る、別角度を頼むと細部が変貌するといった困りごともありました。
こうしたノイズはプロンプトだけでは除去するのがむずかしく、特に一つの画像で何度も編集を重ねるとどんどん悪化していく特徴がありました。そこで、いったんGPT Image 2でお目当ての構図を作り、別の画像生成モデルやサービスでimg2imgを行って仕上げる方法が使われてきたわけです。(NSFW画像の構図作りにもこの手法は有効で、着衣状態で構図を作ってしまってから、インペイントでNSFW化するというやり方が可能です。蛇足ですが)
また、GPT Image2に画像の透過を依頼すると、当初は一見透過したと見せかけて白とグレーの市松背景の画像を出してくる不具合がありましたが、最近はちゃんと背景透過できる画像が出せるようになっていました。このあたりも2.5になってどう変化したかチェックしていきたいと思います。

生成実験
今回の特集では、最も利用する機会が多いと思われる「ChatGPT Work」(※Codexのように複数工程の作業をクラウド上で行えるモード)で、それぞれの検証ごとに別々のチャットルームで画像生成を行います。API利用とは違ってSunburstとFlareを個別に指定することができないため、どちらで生成されたかは判然としないことにご留意ください。
検証1.破綻した手「だけ」を直す
最初は前回の記事で使った、女の子の髪を編んでいる画像から。余分に描かれた手を消し、それ以外は変化させないことができるか試します。また、末尾に「n=10」を付けるだけで10枚連続生成が確実にできるかも確認しておきます。
指示:この画像を編集してください。変更してよいのは右の女の子の手だけです。左の子の髪を結っている両手が3本になっているので、自然な5本指の手2本に修正してください。顔、髪、服、体、背景、構図、色、線画、塗り、表情は一切変更しないでください。元画像のアニメ塗りと線の太さを維持してください。n=10
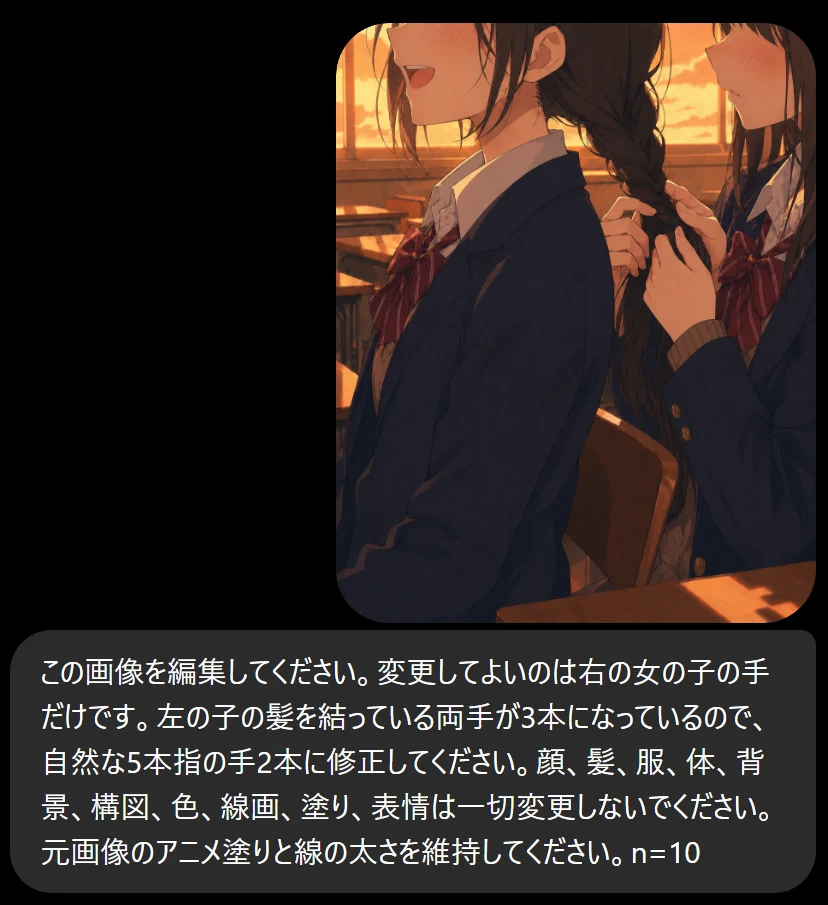
こちらが生成結果。きちんと10枚連続生成できました。どれも余分な手は消え、顔や全体の雰囲気も近いままになりました。
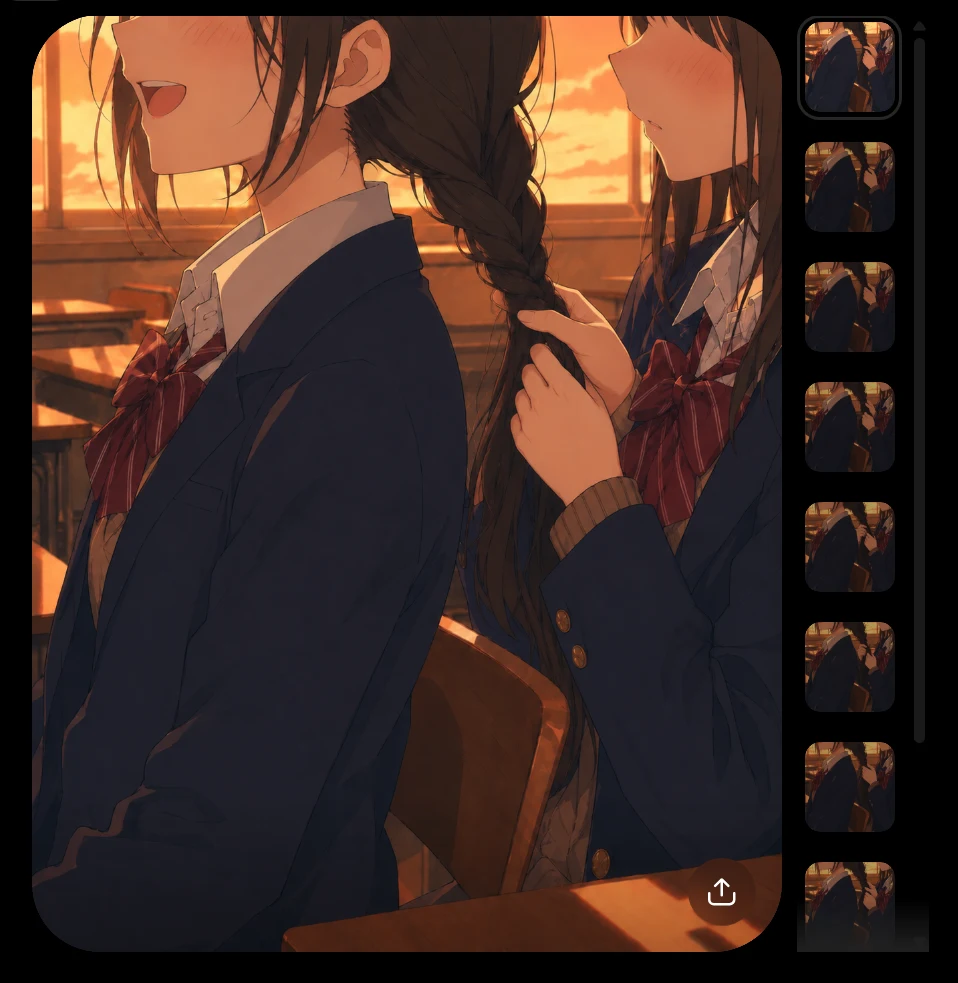
ただし、GIF比較してみるとやはり手の周辺以外の部分もごく微妙に変化していることが分かります。「2」よりも精度は上がっているものの、完璧ではない、といったところでしょうか。
検証2.粒状ノイズや色むらは減ったか
前回かなり困ったのが、空中に浮いた粒状ノイズや、髪や服の塗りに出るもやもやでした。今回はこちらの「基準ミナちゃん」の画像を1枚与えて、同じ人物を普通に再生成するとどうなるか確かめます。
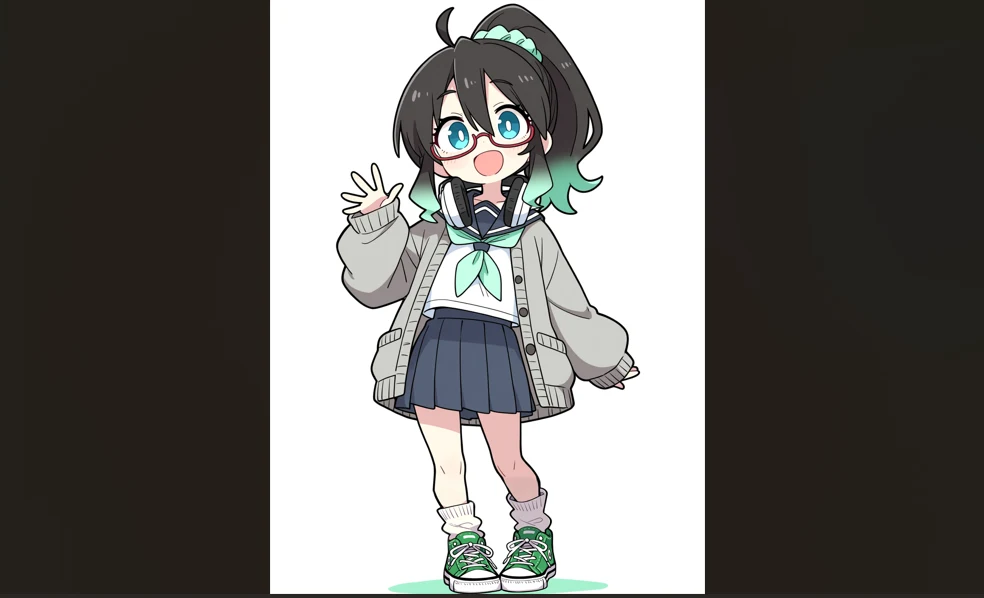
指示:参照画像の更木ミナちゃんを、同じキャラデザインと同じデフォルメ比率・くっきりした線・フラットなアニメ塗りで新しく描いてください。黒髪ポニーテールと毛先のミント色、ミントのシュシュ、赤い眼鏡、大きな青い目、白と紺のセーラー服、ミントのスカーフ、グレーのカーディガン、首のヘッドホンを保持。正面向きの腰上立ち絵、頭の上から腰まで余裕をもって収める。両腕を自然に下ろし、口を閉じた穏やかな無表情。背景は無地の薄灰色。文字なし。縦長3:4、独立した画像1枚。参照は人物と画風の資料です。
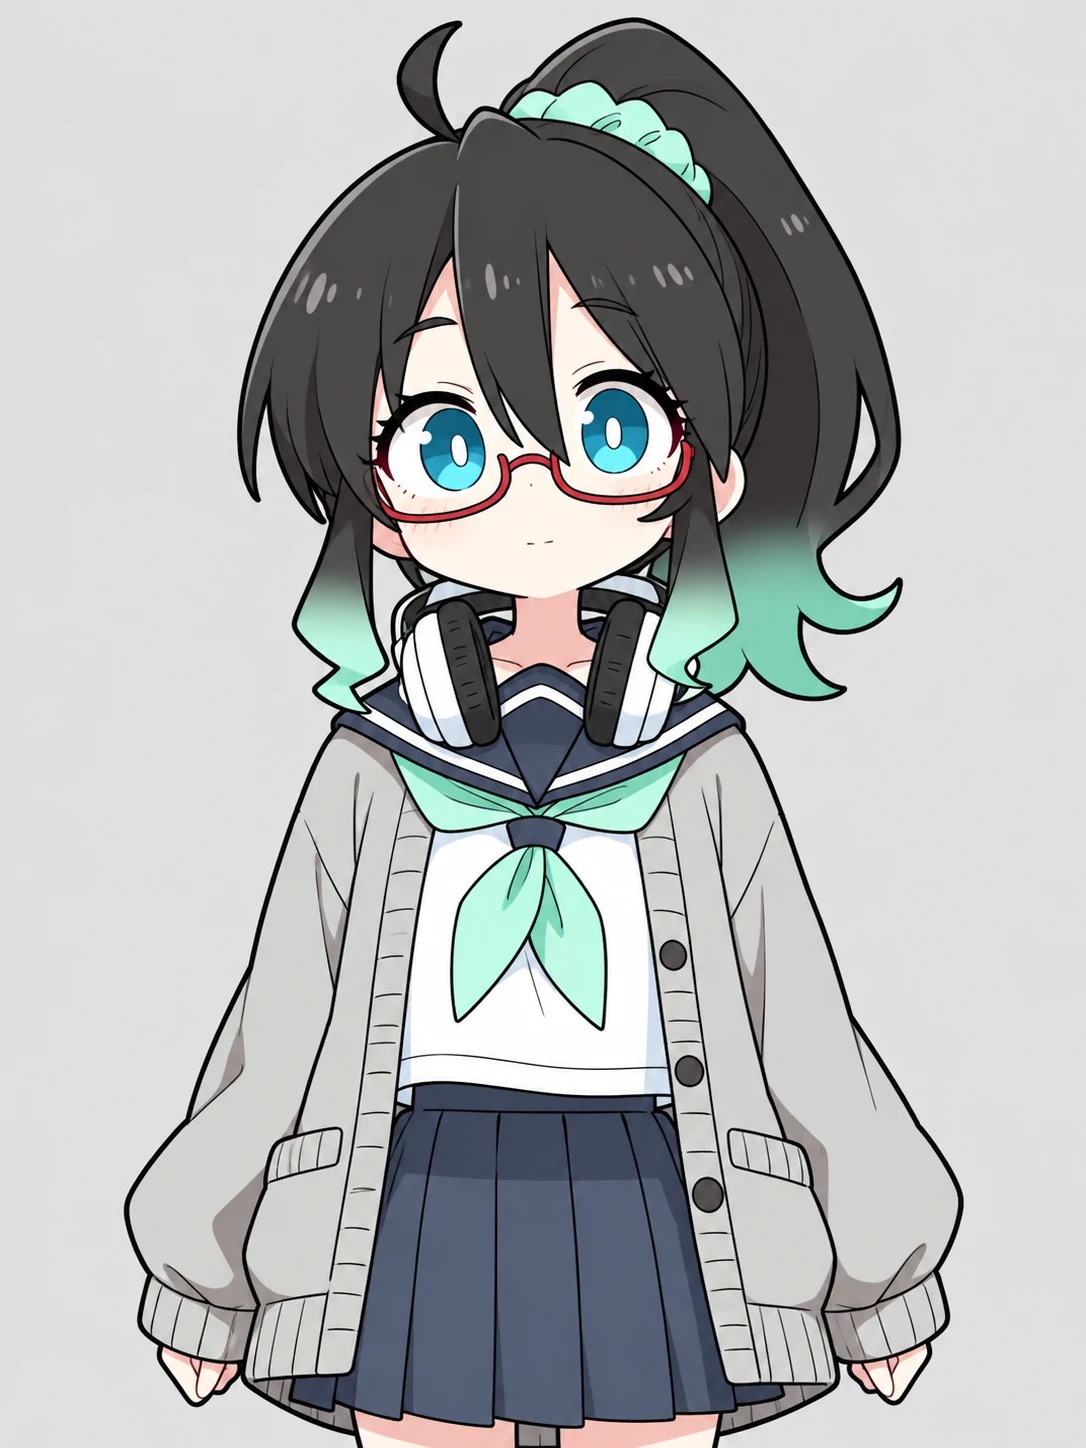
目をこらすとわずかに、セーラー襟あたりにもや(紺色の濃淡)が生じているのが見えます。アップにするとさらに目立ちますが、「2」に比べれば抑制的に見えます。
こちらは粒状ノイズや色もやを抑制するよう指示を強めたバージョン。
指示:参照画像の更木ミナちゃんを、同じキャラデザインと同じデフォルメ比率・くっきりした線・フラットなアニメ塗りで新しく描いてください。黒髪ポニーテールと毛先のミント色、ミントのシュシュ、赤い眼鏡、大きな青い目、白と紺のセーラー服、ミントのスカーフ、グレーのカーディガン、首のヘッドホンを保持。正面向きの腰上立ち絵、頭の上から腰まで余裕をもって収める。両腕を自然に下ろし、口を閉じた穏やかな無表情。背景は無地の薄灰色。文字なし。縦長3:4、独立した画像1枚。参照は人物と画風の資料です。 色面は均一に塗り、紙の質感、粒状ノイズ、不規則な色むら、霞、発光を加えないでください。
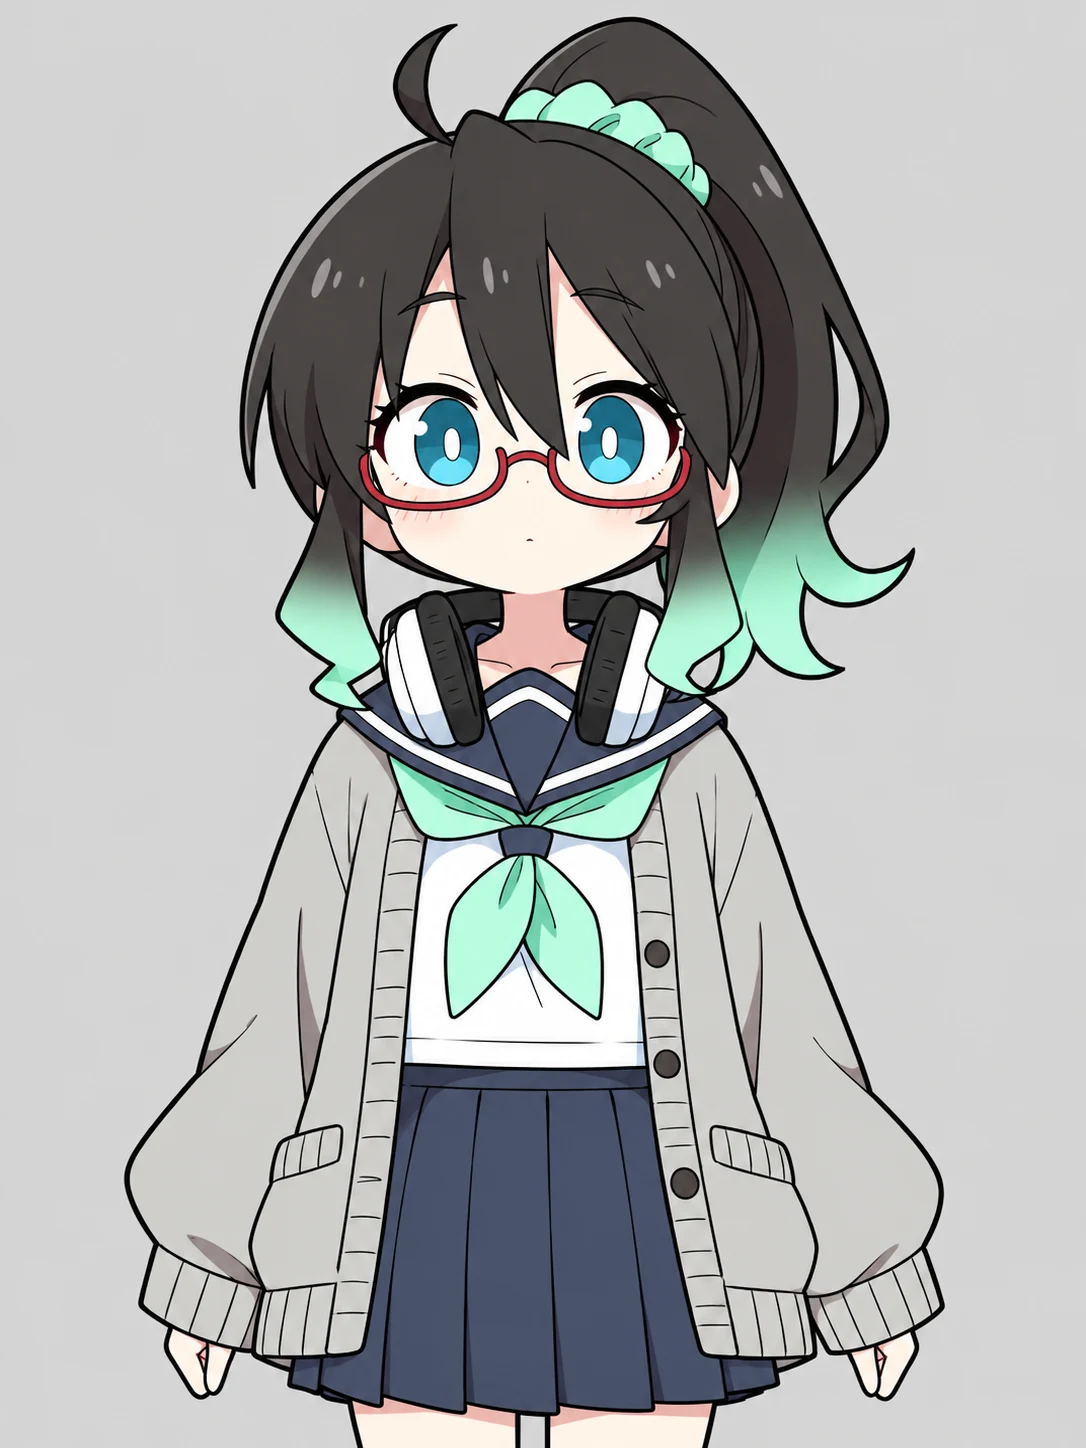
正直、追加指示によって劇的にきれいになったというほどの差はありません。通常版の段階で、「気になる人は気になる」というレベルかなという印象です。完全にフラットにしたい場合は、前回記事で紹介したようにローカルモデルやNovelAIでimage2imageしたり、画像編集モデルで上塗りするなどの工程をはさむことになります。
検証3.編集を繰り返すと、どこまで劣化するか
同じミナちゃんに、シュシュを黄色にする、口を閉じた笑顔にする、赤いペンを持たせる、背景を薄水色にする、という変更を順番に重ねました。6枚の最後は、いっぺんに四つまとめて変更したものです。
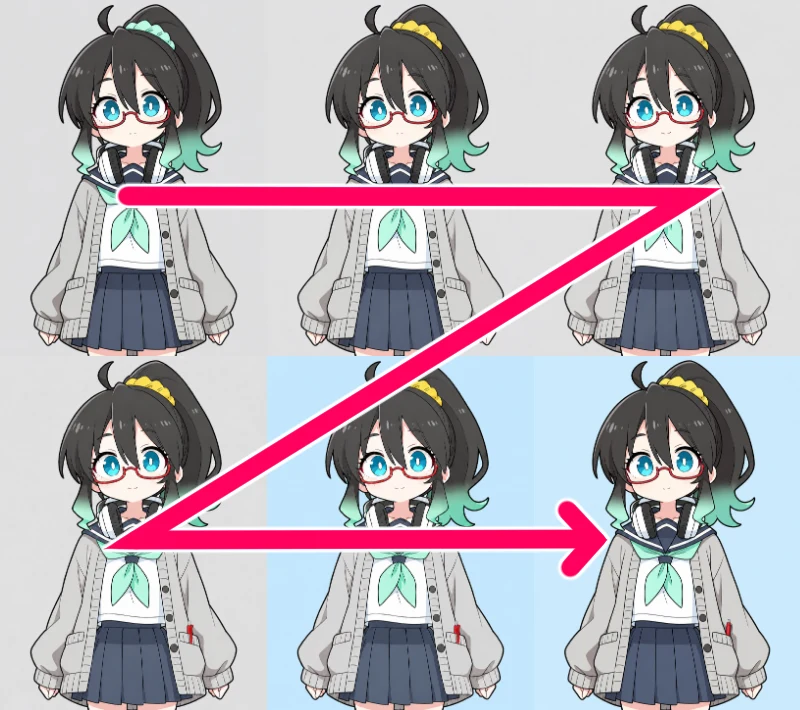
こちらが連続で4回変更を重ねた画像(下段中央)。色むらがどんどんひどくなり、「2」でよく見かけた色むらがはっきり出てしまっています。
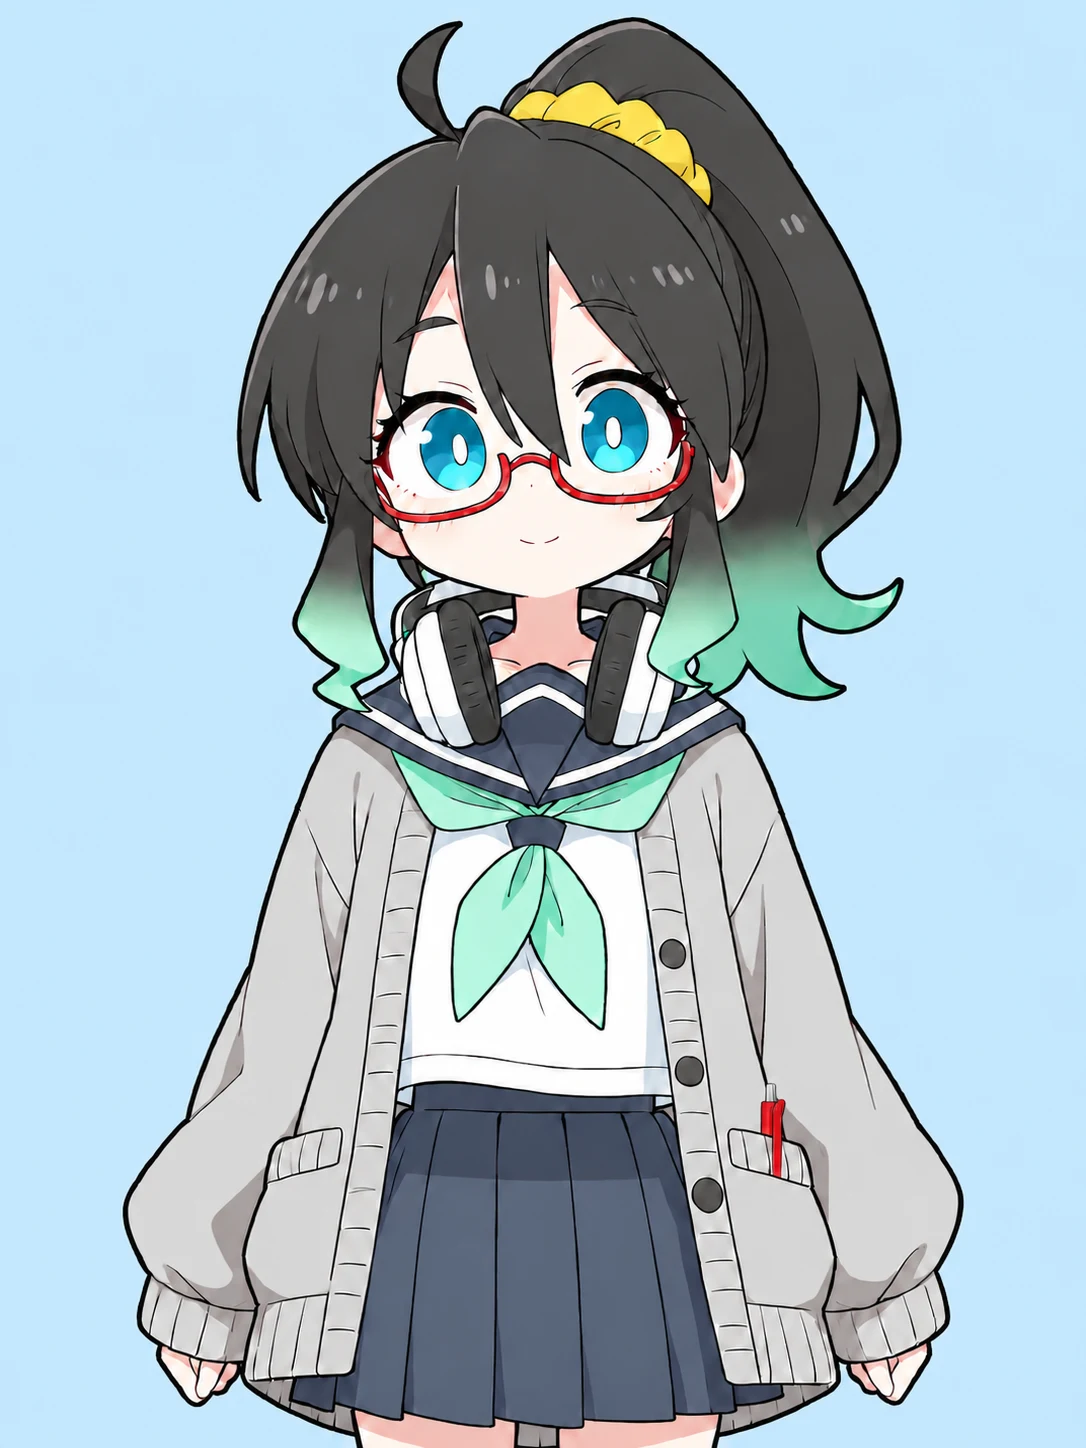
一方こちらは、4つの変更をいっぺんに指示したものです。上の画像と比べると色むらは抑制されており(全くないわけではない)、赤ペンの形もきれいです。
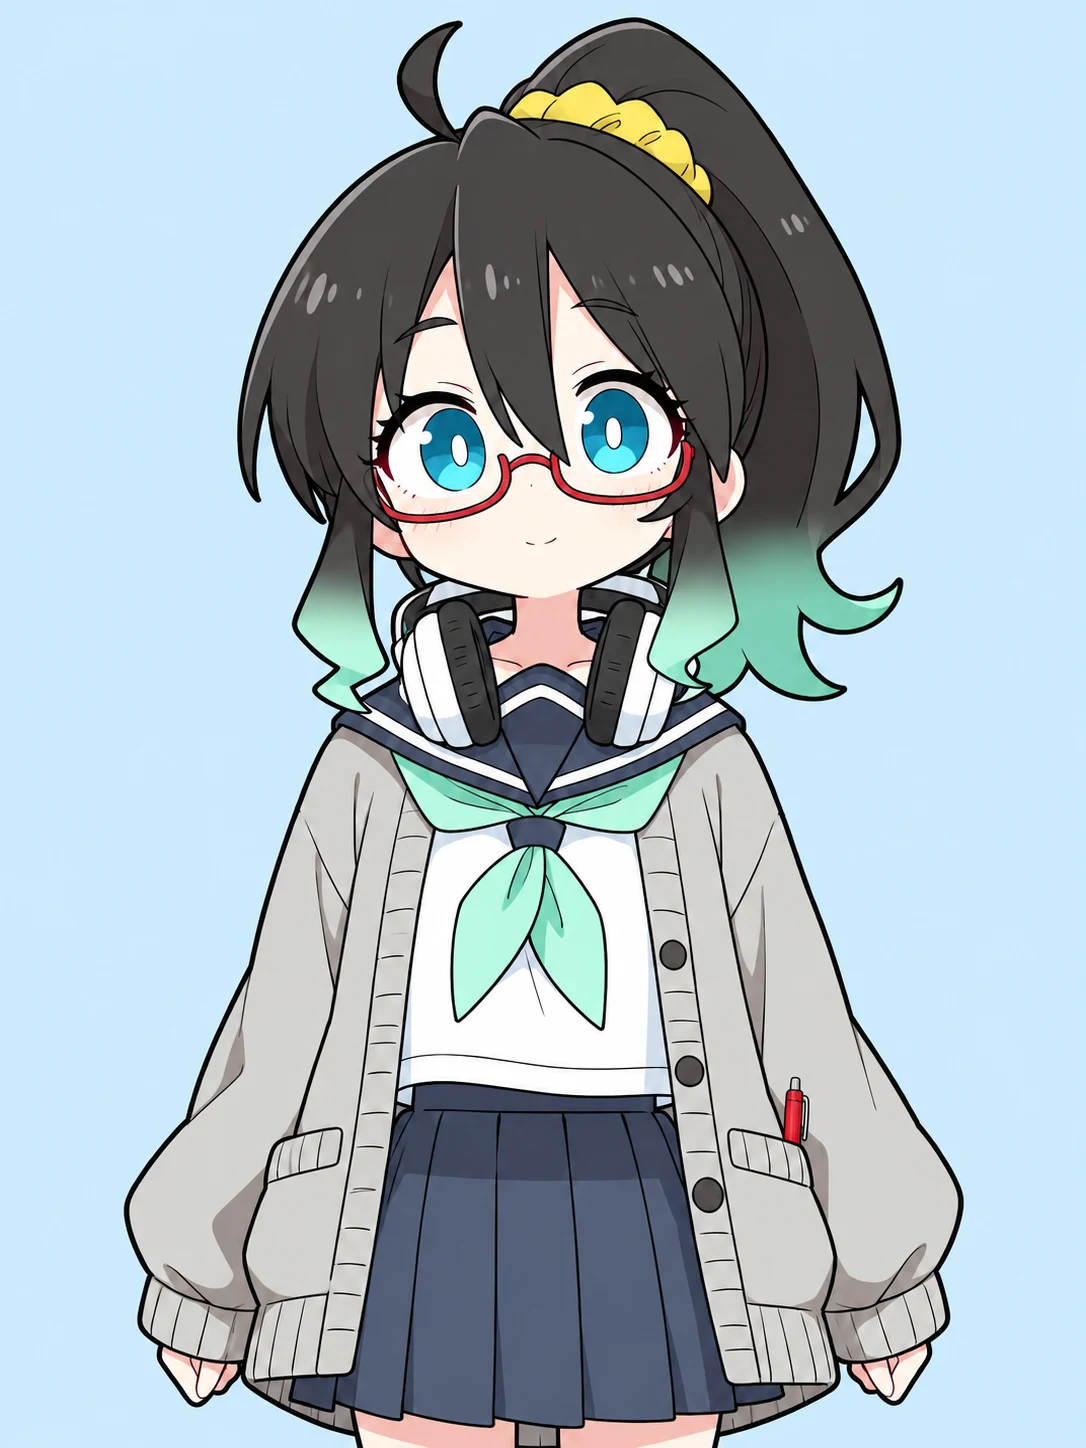
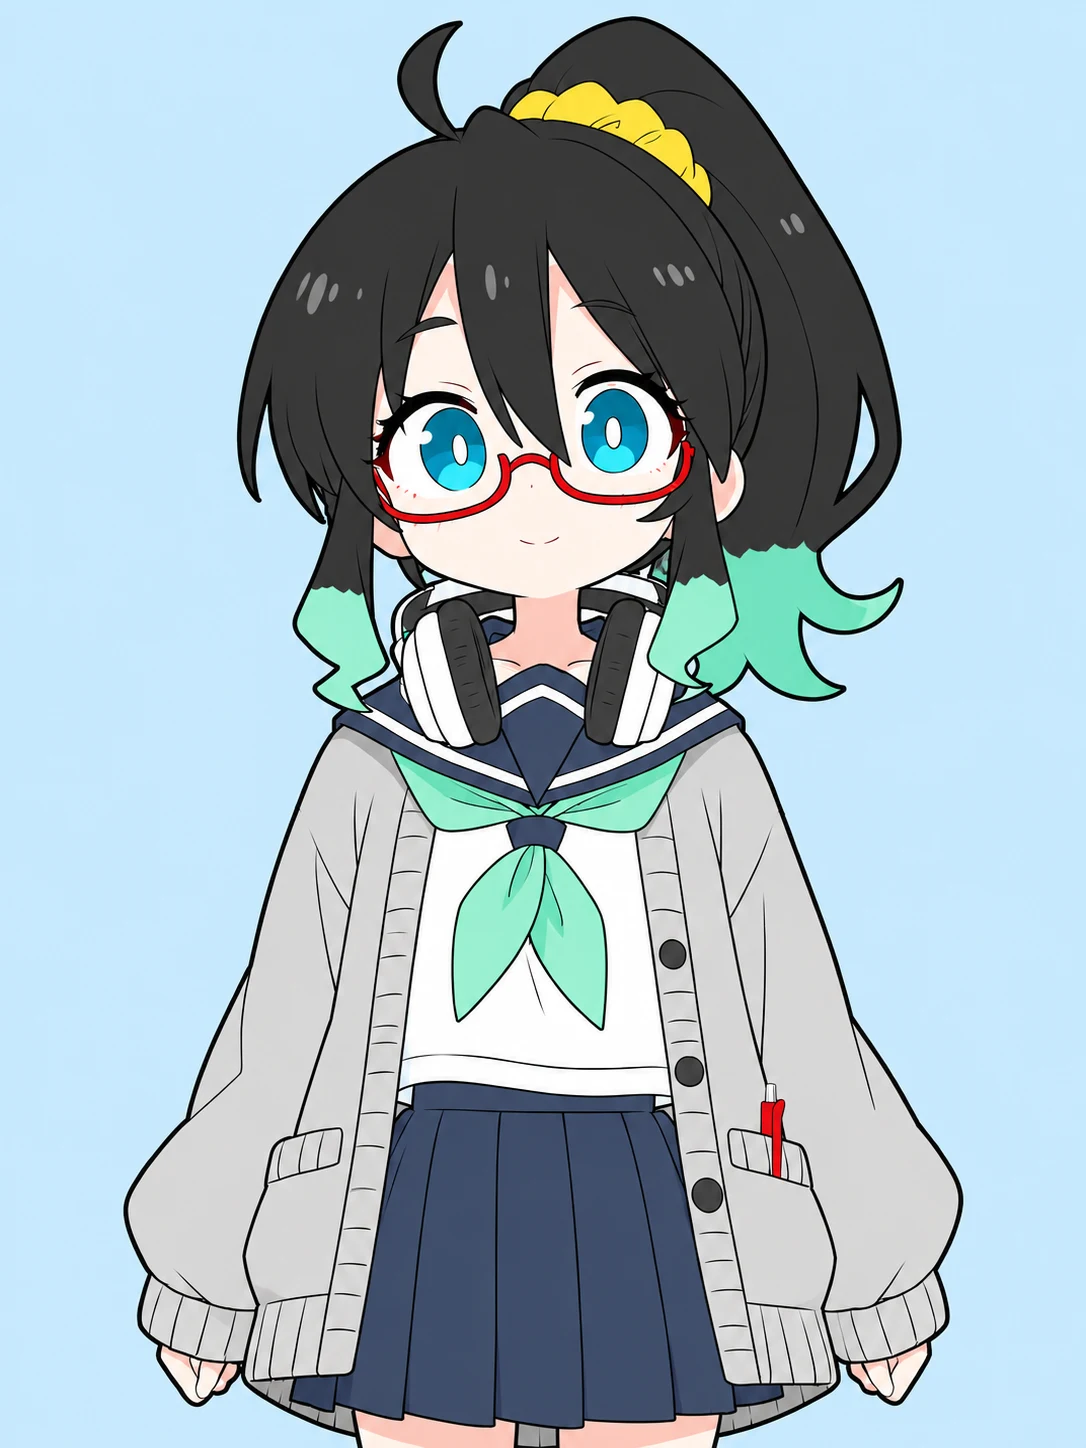
ChatGPTであれこれ画像を編集していると、だんだん理想に近づいてはくるのですが、気づくと色むらだらけになっていることが多いです。そこで、さきほどの下段中央のガビガビ画像を読み込ませて、このように指示してみました。
指示:この低画質の画像を高解像度化してください。入力画像のカラーや画風、キャラクター、線画、構図などの要素を維持したまま、ぼやけている塗りや線画を鮮明にしてください。
するとこのように、髪の毛のグラデーションも含めてパキッとしたフラットスタイルになってしまいました。そして、それでもセーラー襟や瞳の中のもやは消えておらず、プロンプトだけでは解決が難しいことがうかがわれます。
検証4.透過PNGを正しく作れるか
立ち絵やタイトルを素材として使うなら、背景はきれいに抜けていてほしいところ。NovelAIもV5で確実な透過画像生成が可能になっているので、GPTも同レベルになっていてほしいところですが…
指示:添付したキャラクターの立ち絵を1枚生成してください。容姿、服装、画風、ポーズを参照画像の通りに維持し、背景を透過してください。出力はアルファチャンネルありのRGBA PNGにしてください。背景部分のアルファ値を0にし、市松模様そのものは描かないでください。
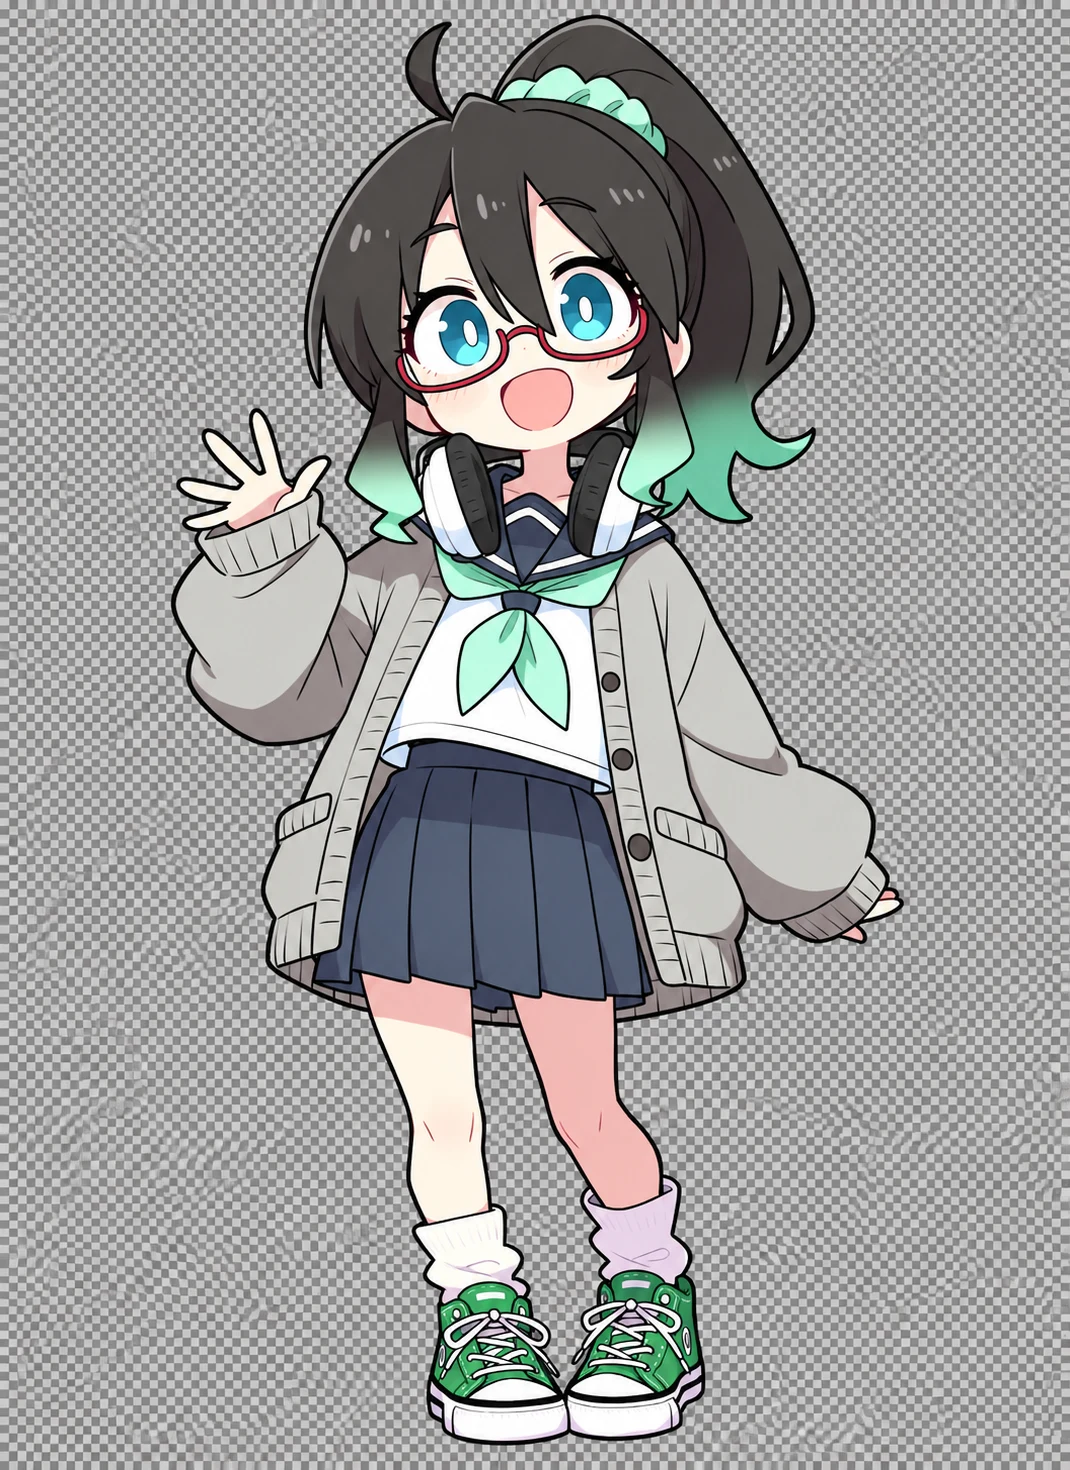
というわけで、いきなり失敗しました。公式API資料では、両モデルとも透過背景に対応しているはずなのですが…。ChatGPT Workでも透過がうまくいったという報告はありますので、任せるAstraの思考レベルによるのかもしれませんし、プロンプト指示がうまくいかなかっただけかもしれません。
Magnific経由で「Sunburst」「クォリティMax」を指示して2K生成したのですが、残念ながらこちらも偽透過画像になってしまいました。
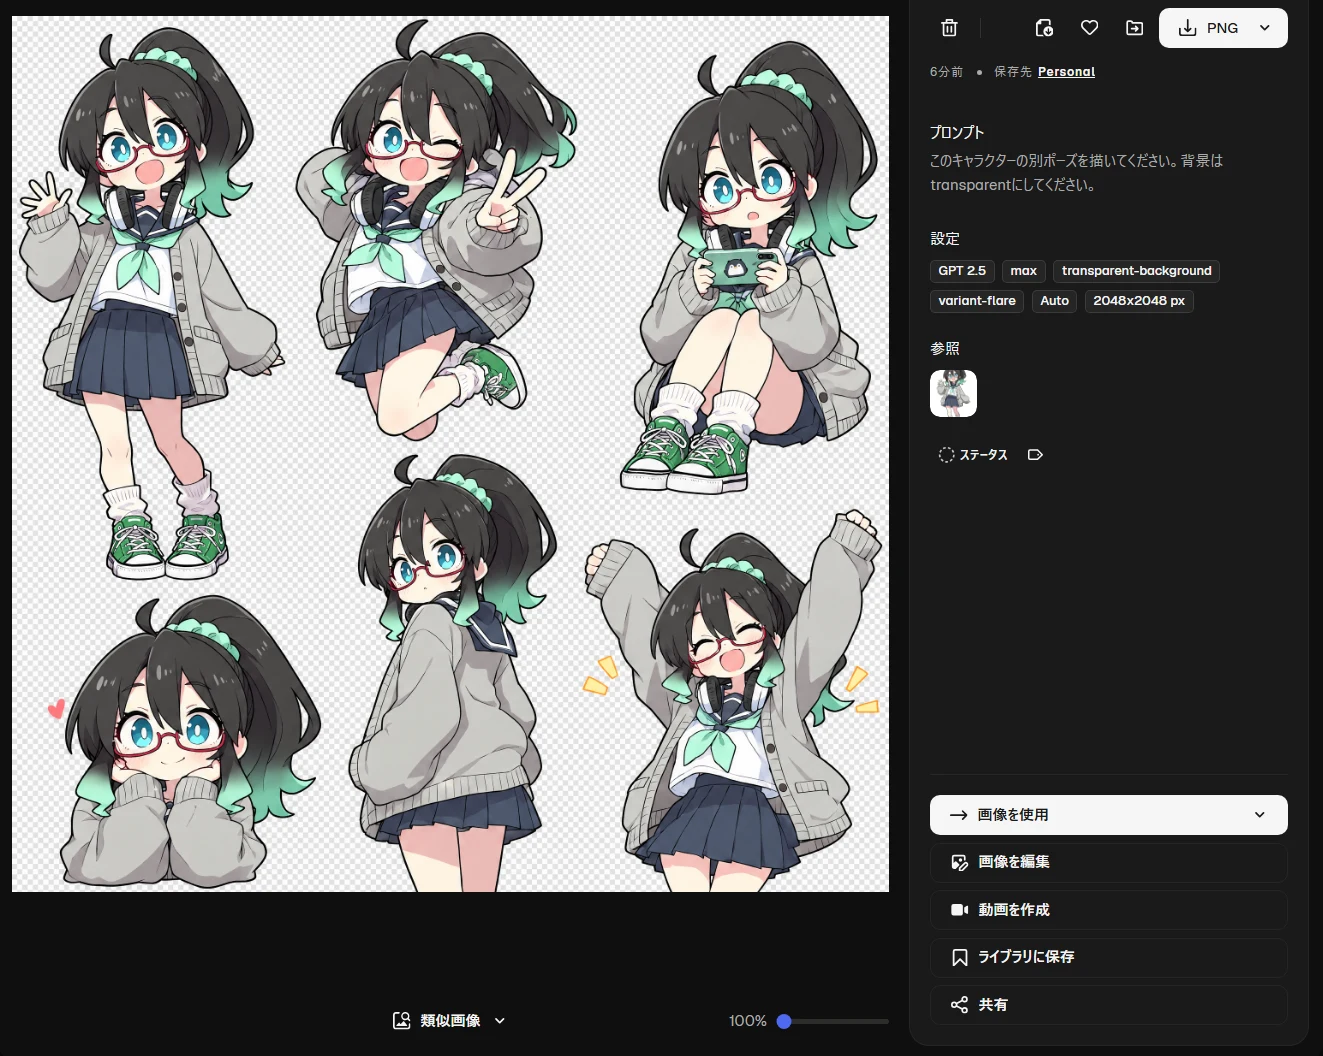
画面からは「transparent-background」モードになっていることが確認できるのですが、なぜかモデルは「valiant-flare」に変化してしまっています。このあたりはプロンプト次第なのかもしれないので、安定して透過背景にする方法が確認できれば追記したいと思います。
検証5.アイテムの外観を提案
作品に登場するオリジナルアイテムの外観をあれこれ提案してくれるのもAIのありがたいところ。今回も催眠スマホをお願いしてみました。
指示:催眠スマホを画像生成してください。白背景でスマホだけを描くこと。紫色の渦巻きを背景に、中心に抽象化した目を模した不気味なマークが大きく描かれ、下に「催眠開始」のボタンがあります。10枚連続でさまざまなデザインを提案してください。
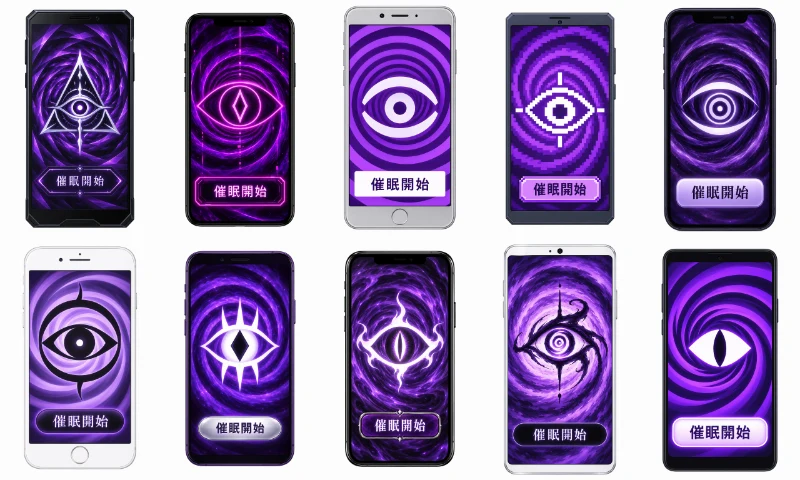
上図は、生成した10枚を結合したものです。可もなく不可もなく、指示したとおりの画像が出たという感じですね。
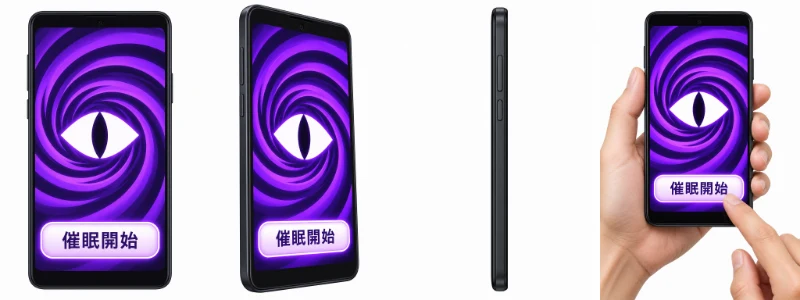
うち一つを選び、今度は同じスマホの正面、斜め、側面、手に持って操作する状態を作ってみました。アニメ調と指示しなかったので実写調の手になってしまいましたが、このあたりは問題なく生成できますね。
指示:添付の催眠スマホのデザインを維持して、正面、斜め、側面、手に持った状態の4枚を独立した画像として生成してください。画面のマーク、配色、ボタンの文言、スマホ本体の形を揃えてください。白背景です。
検証6.同じキャラの表情とポーズを変える
白背景で表情やポーズの違うミナちゃんを10枚生成する、既存の実験を使います。地味ですが、LoRAのデータセット水増しにも使えるので、AI創作では最も使う機会の多い重要生成ですね。
指示:このキャラクターのバリエーション画像を10枚生成してください。さまざまな表情、ポーズをしています。いずれも白背景で、アートスタイルは参照画像を踏襲してください。
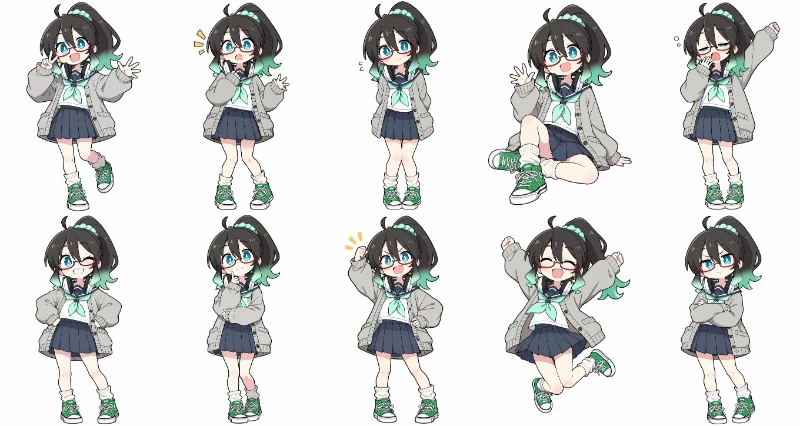
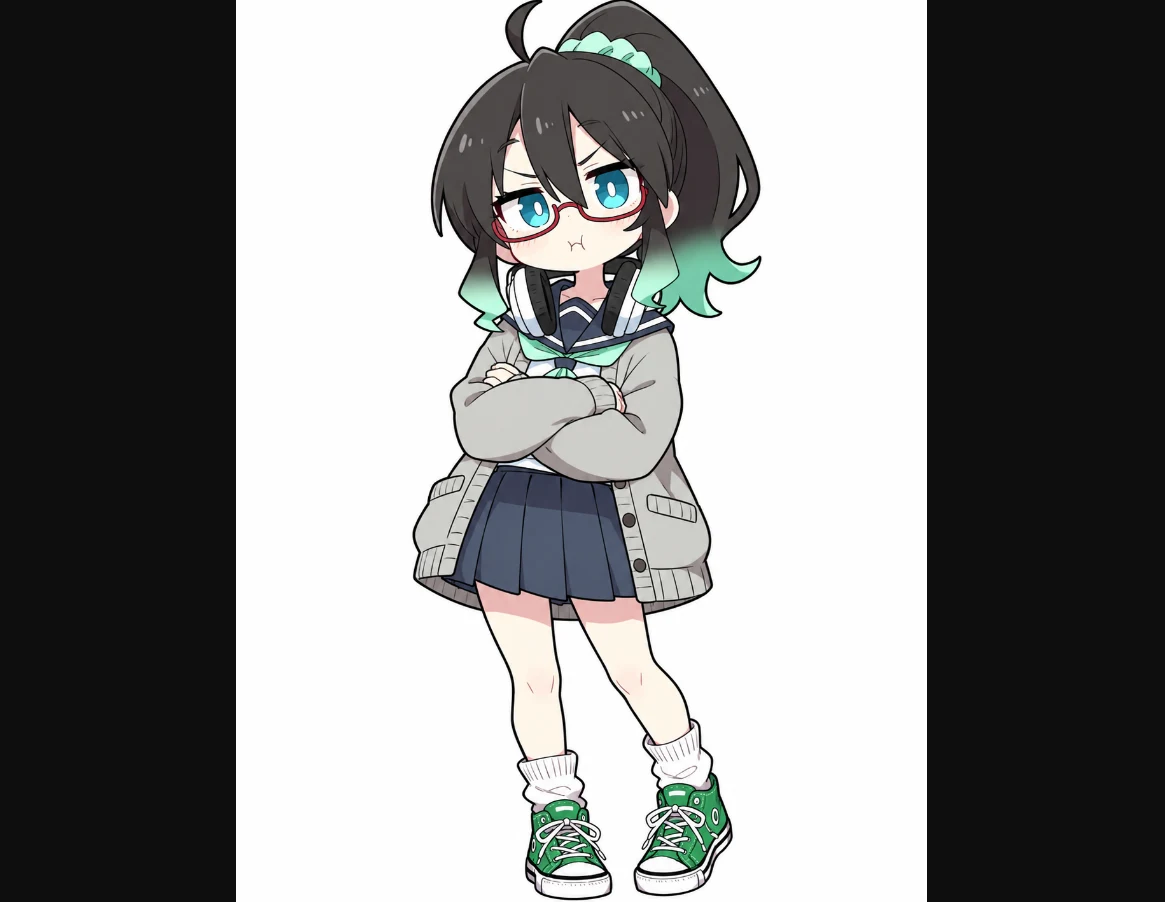
元気にピースする姿、照れた立ち方、眠そうなあくびなど、「2」時代は他人に見えてしまう表情バリエーションでしたが、かなり一貫性を保てている印象です。ただ、色むらはやはり出てしまいますね。
注意しておきたいのは、「2」などさまざまな画像編集モデルでよく起こる「眉毛ダブリ現象」。眉毛が小さかったり、特殊な形状をしているキャラクターだと、眉をしかめたときに元の眉が残存してしまう現象です。「2.5」でもこの通り再現してしまったので、特に注意しましょう。
検証7.衣装バリエーションの提案
今度はポーズではなく、衣装のバリエーションです。以下のようなややあいまいな指示で、「基準ミナちゃん」の別衣装を提案してもらいました。
参照画像のキャラクターの衣装バリエーションを10枚、独立した画像で提案してください。白背景の立ち絵です。顔立ち、目の形、髪型、体格、画風は維持し、普段着、お出かけ着、仕事着など日常に使える服装にしてください。 実際に独立した10枚の画像を生成してください。1枚に10人をまとめないでください。
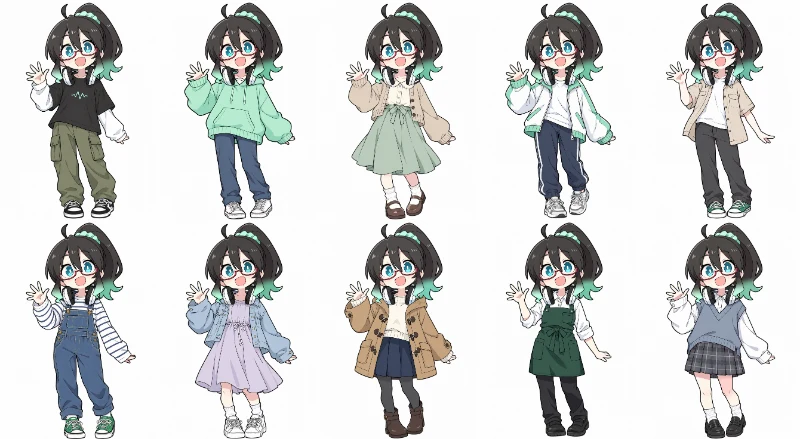
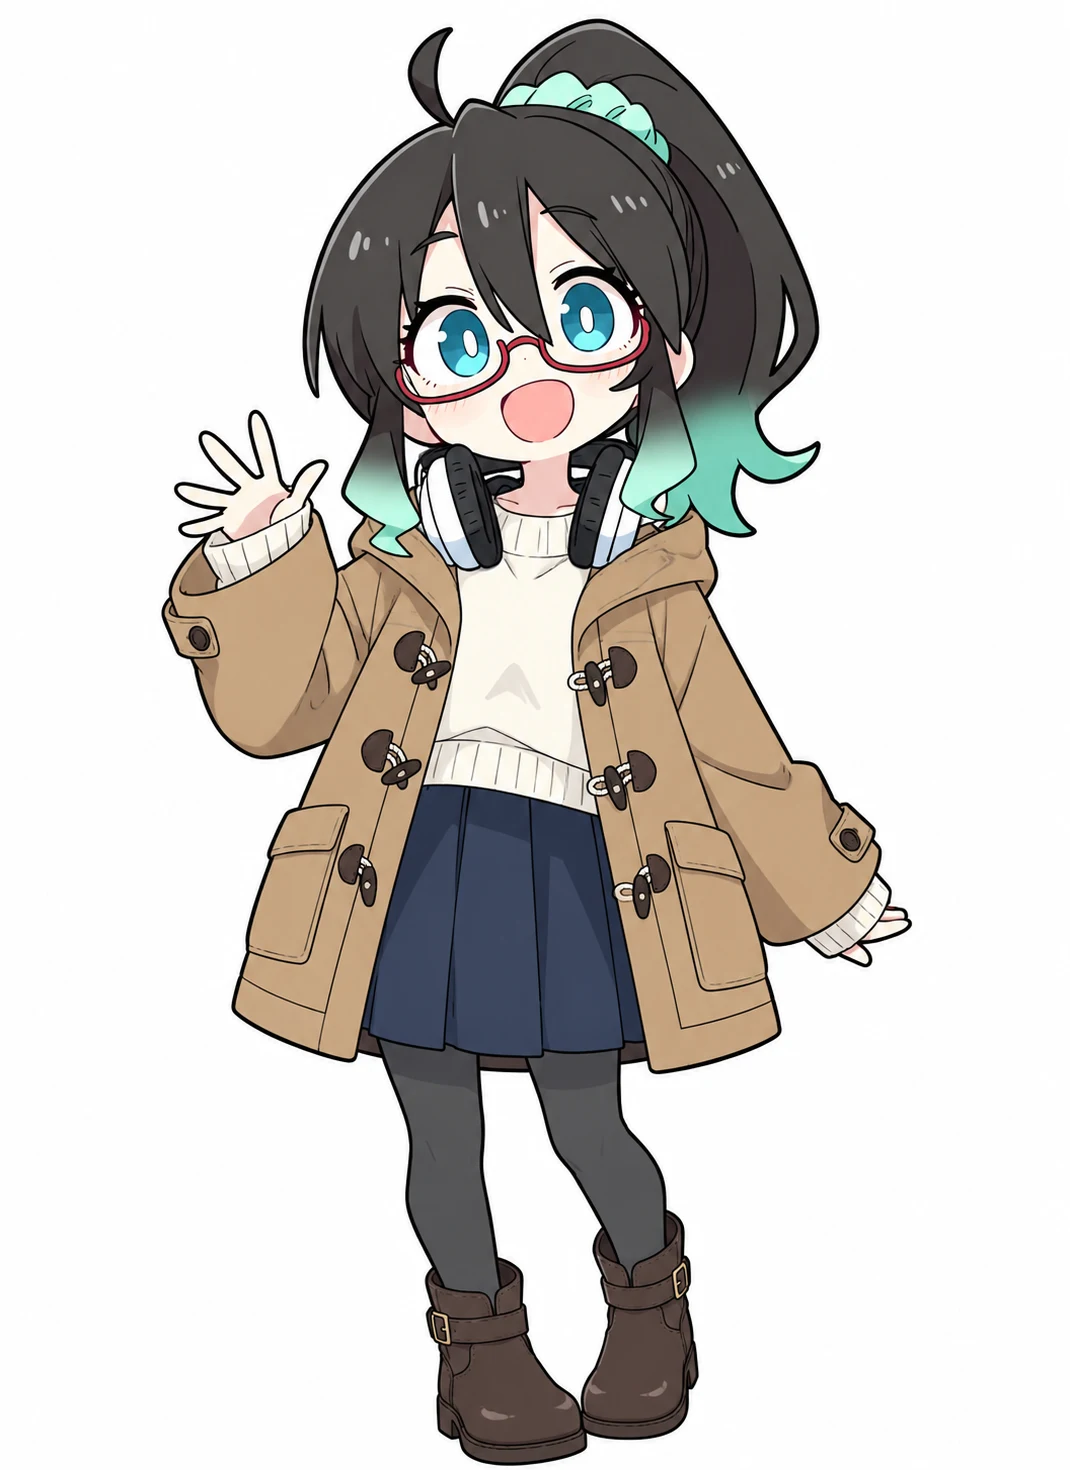
このように、ポーズは参照画像のまま、かわいい衣装パターンをたくさん出せました(※上図は計10枚の画像を統合しています)
拡大するとこんな感じ。特に詳しい指示をしていないのにとてもあか抜けたバリエーションを出せましたが、これはGPT Image 2.5というより、指示を仲立ちしたGPT-6 Astraの賢さが出た感じがしますね。
検証8.キャラクターの8方向推論
こちらも定番の、キャラを回転させる実験です。前後左右と斜めを加えた8方向からの推論はたいていの画像編集モデルができるようになっていますが、どれくらい精度が上がったかを試したいところ。
指示:画像生成。このキャラクターの立ち絵を前後左右の8方向から描いてください。背景は透過してください。
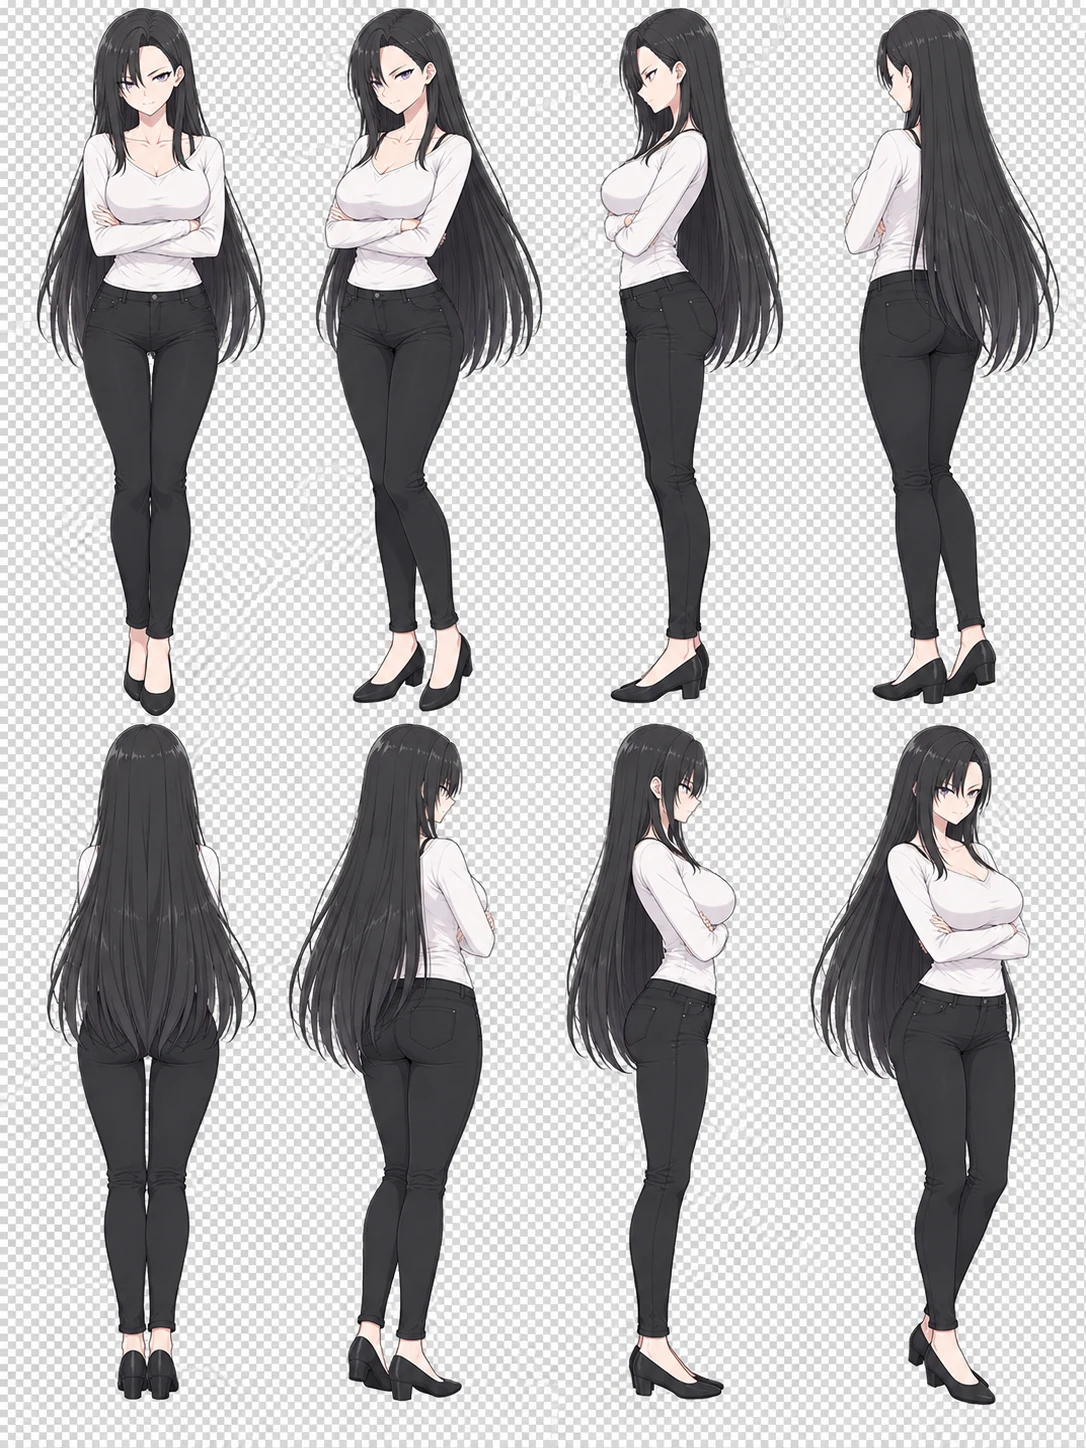
鬼怒川さんは左右非対称の前髪なのですが、間違えずにきれいにできています。ただ、今度も透過処理は失敗してしまいました。「太ももから上」という指示をしなかったので、パンプスが推論され、全身図になりましたね。
検証9.キャラの私室を推論する
「基準ミナちゃん」の参照画像を渡し、「このキャラの部屋を作って」と頼んでみます。立ち絵の色や持ち物から生活の雰囲気を考えてもらう実験です。
指示:10枚連続生成。このキャラクターの部屋の背景画像を生成してください。16:9。人物は描かないこと。
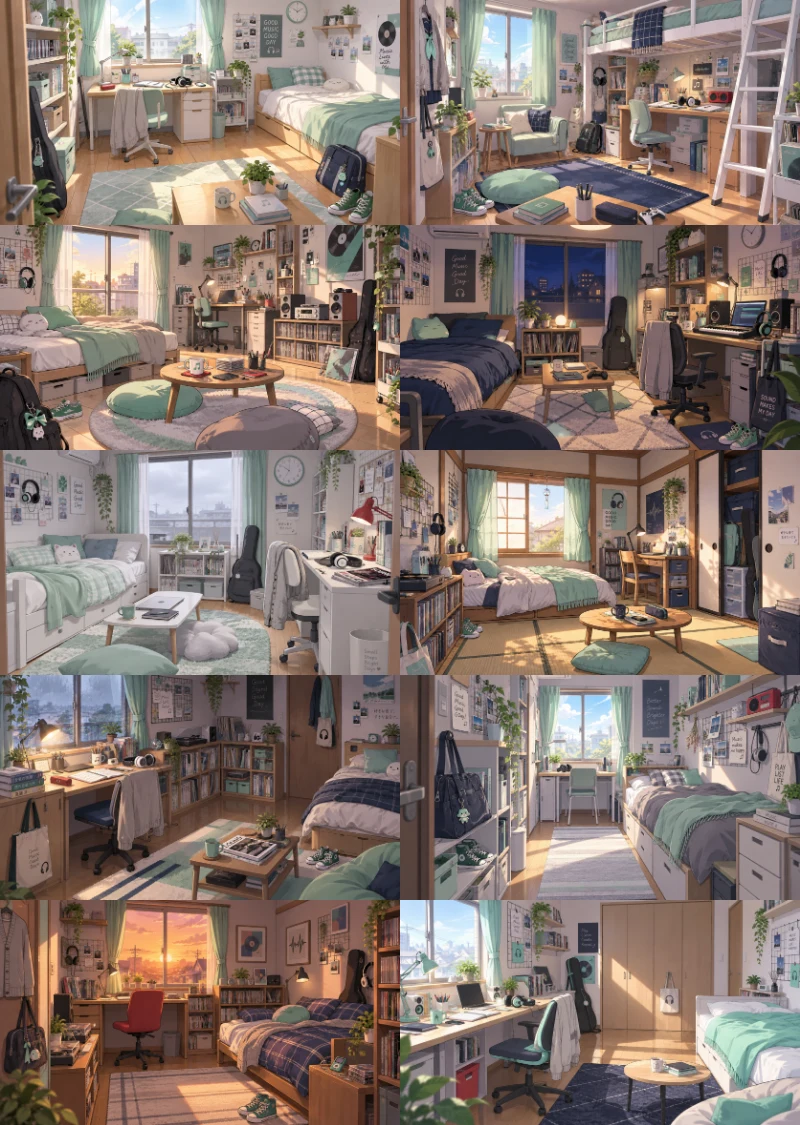
ミナちゃんの部屋は、ミント色のカーテンやクッションに、ヘッドホン、オーディオ、音楽に関係する小物が組み合わされました。参照キャラがヘッドホンをしているので、音楽好きであろうという推論が室内のデザインにも伝わっています。同じようなカットにならないよう、画角や部屋の雰囲気、時間帯にバリエーションがしっかり出され、ロフトベッドや和室なども含まれていますね。
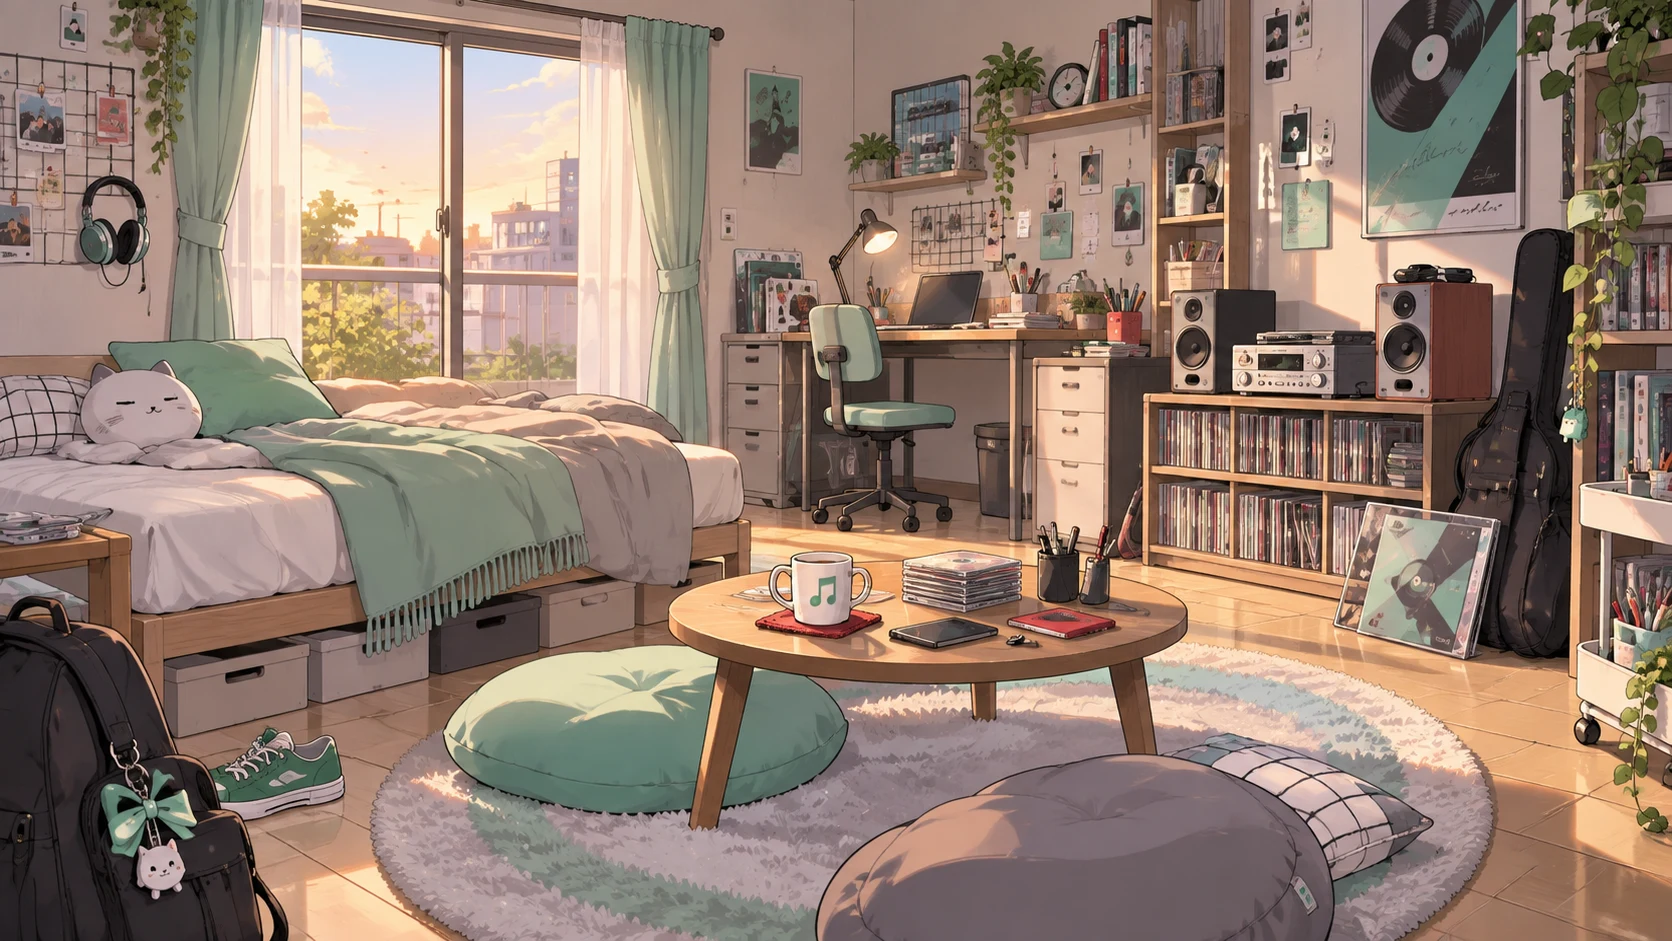
ただ、こうした雑然とした部屋には「文脈のおかしさ」が潜んでいるのがAI絵の常。例えば上図では、部屋の中にコンバースが片方だけ転がっていたり、マグカップの取っ手が二つついていたりと、間違い探しのような状態になっています。小さい猫のようなキャラや、potted plantをやたら入れてくるのもGPTの好きな表現。こうしたマスピ表現はプロンプトでしっかり除去しないと、「典型的なAI絵」に見えるので注意が必要です。
<鬼怒川さん夫婦の部屋>
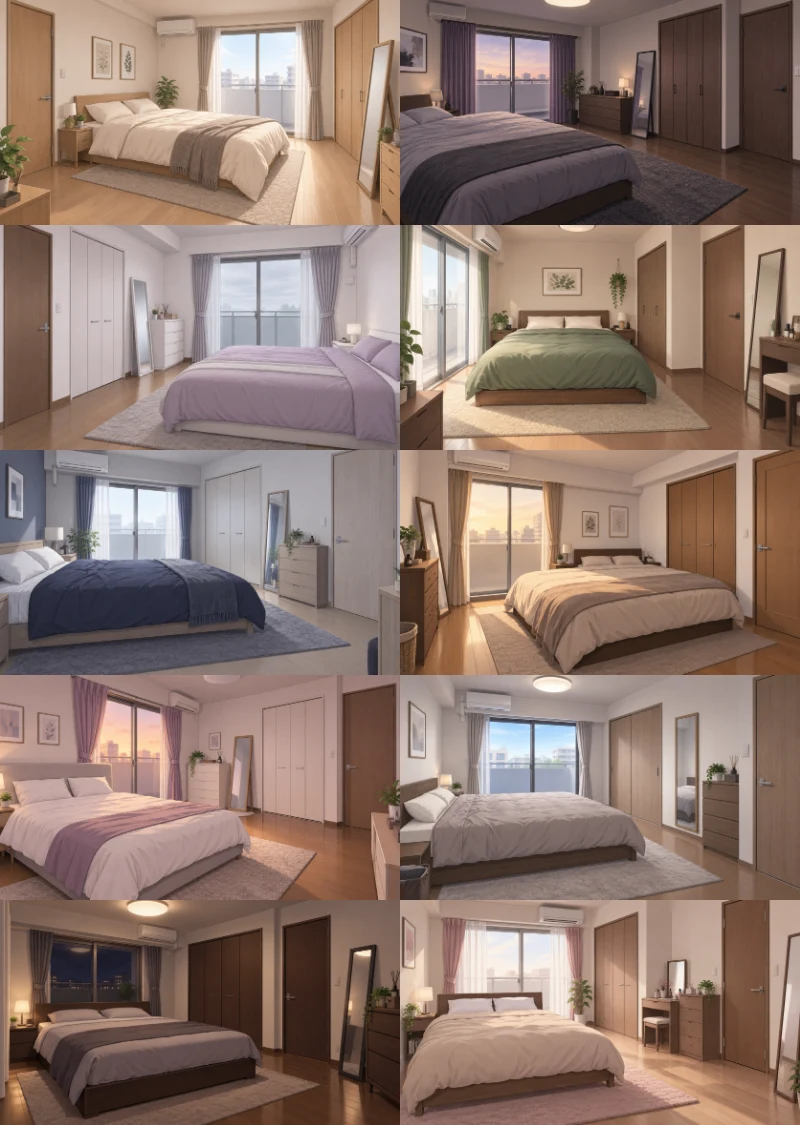
前回を踏襲して、「夫婦の寝室」も10パターン生成しました。こちらは落ち着いた木目のベッドや建具を使う案を採用し、次の別角度や時間帯の実験に使っていきます。
指示:このキャラクターが住む夫婦の寝室を描いてください。ベッドはダブルサイズで、枕が二つ並んでいます。ベランダに続く掃き出し窓は閉まっています。リビングへのドアも閉まっています。クローゼットのドアや家具、姿見などがあります。ゲームの背景に使うので、アニメ調にしてください。日本の普通のマンションといった雰囲気にすること。人物は描かない。さまざまな提案を10枚連続生成してください。
こちらも「2」時代より内装が安定し、おかしなオブジェクトは減っているように見えます。特に指示しないと、モデルハウスのような整った部屋になってしまったので、「どれもモデルハウスのように整っていて生活感がありません。二人の生活が想像できるような、汚くない程度の軽い生活感を出してください。n=10」と指示してみました。
こちらが生成結果。
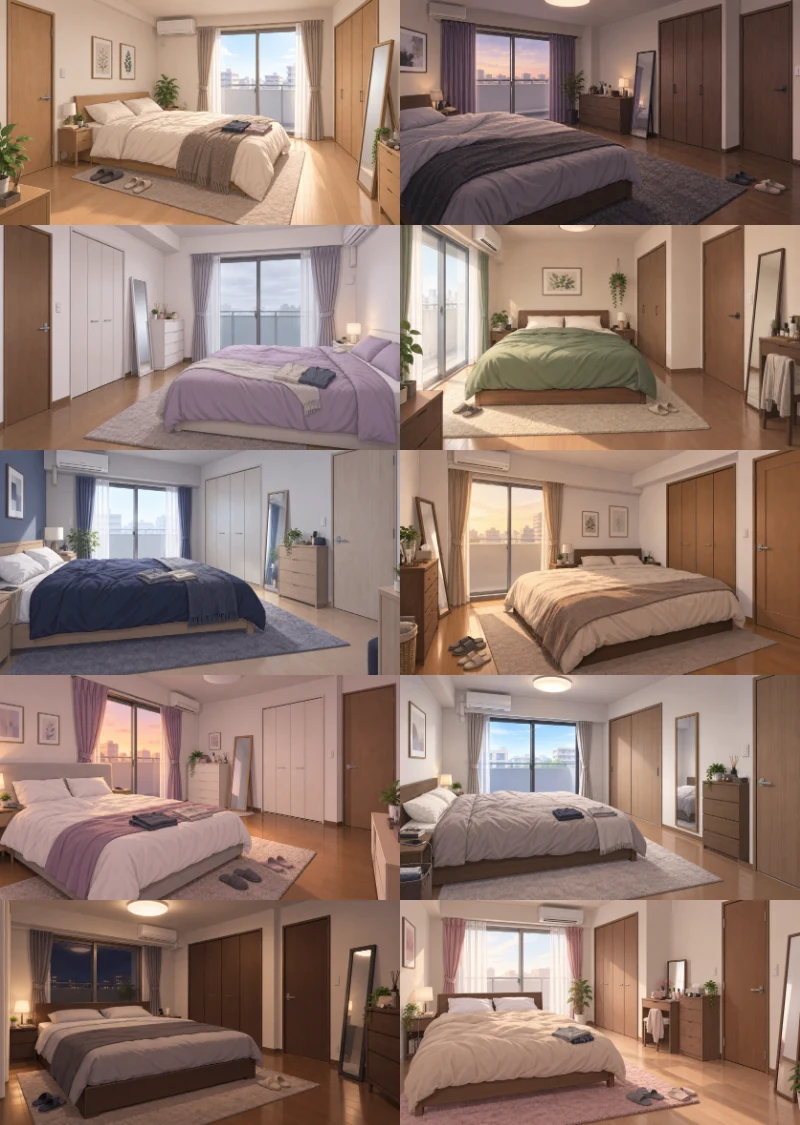
さきほどの10枚と同じ部屋で続けて生成したため、ガビガビ感がわずかに増していますが、同じ10部屋に生活感を足してもらえました。ニンゲンとしては「そこにパジャマをそう置くかな…?」とか「そこにそんな感じで夫婦のスリッパが並ぶだろうか…?」という疑問がよぎりはしますが…「2」よりは超マシになっています!ありがとうOpenAI!
検証10.同じ部屋を別角度から描く
今度はキャラクターではなく、背景のほうをぐるりと回す定番実験。これは前回、かなり頑張れたものの、思うようにはいかなかった実験です。同じ部屋を360度、上からも水平からも大胆に映してほしいのに、似た角度が続いたり、家具を動かして別の部屋にしてしまったりするんですよね。
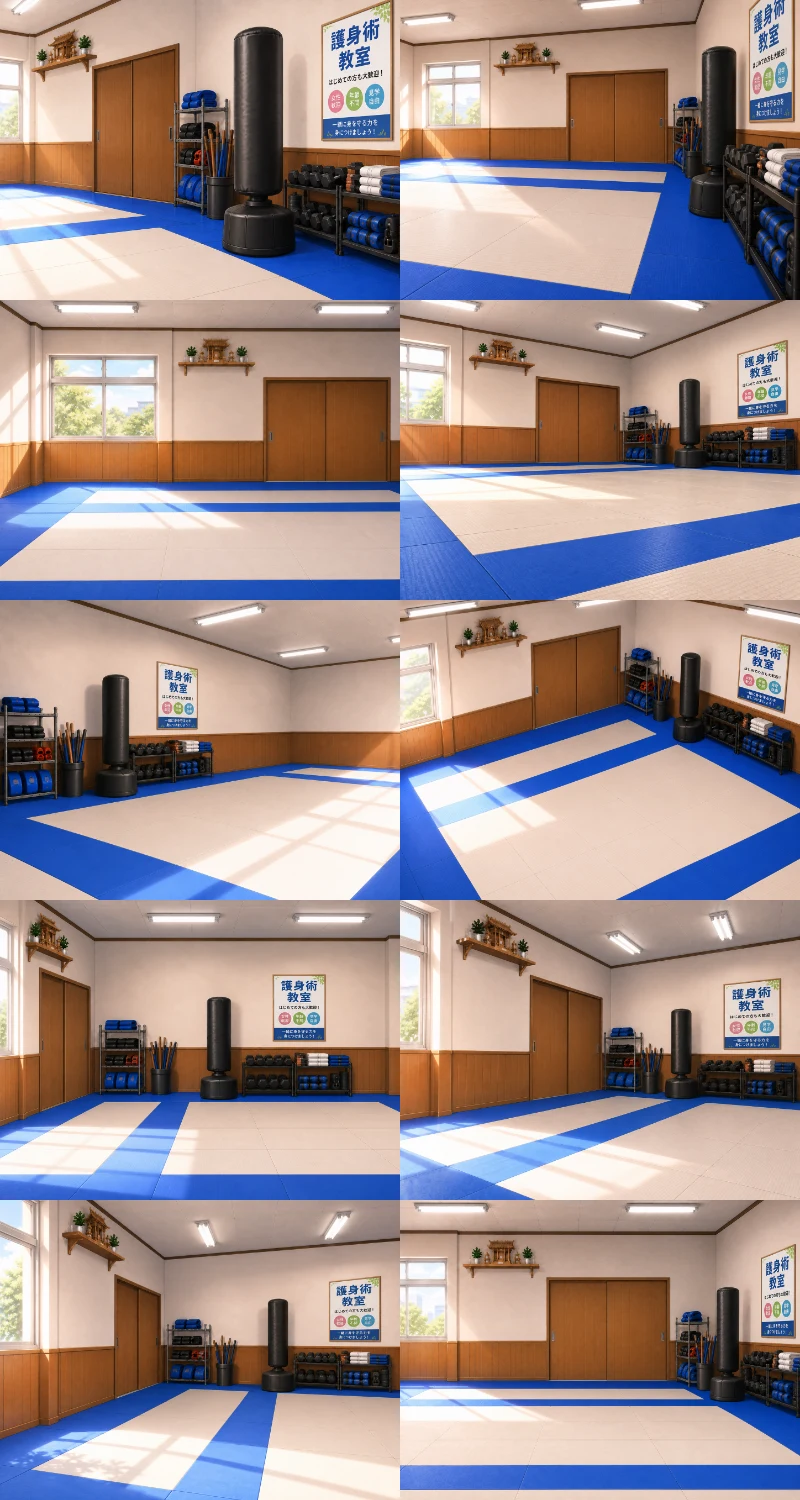
まずはこちら、鬼怒川さんの道場から。
指示:10枚連続生成。この部屋をさまざまな角度から描いたゲーム背景画像を生成してください。人物は不要
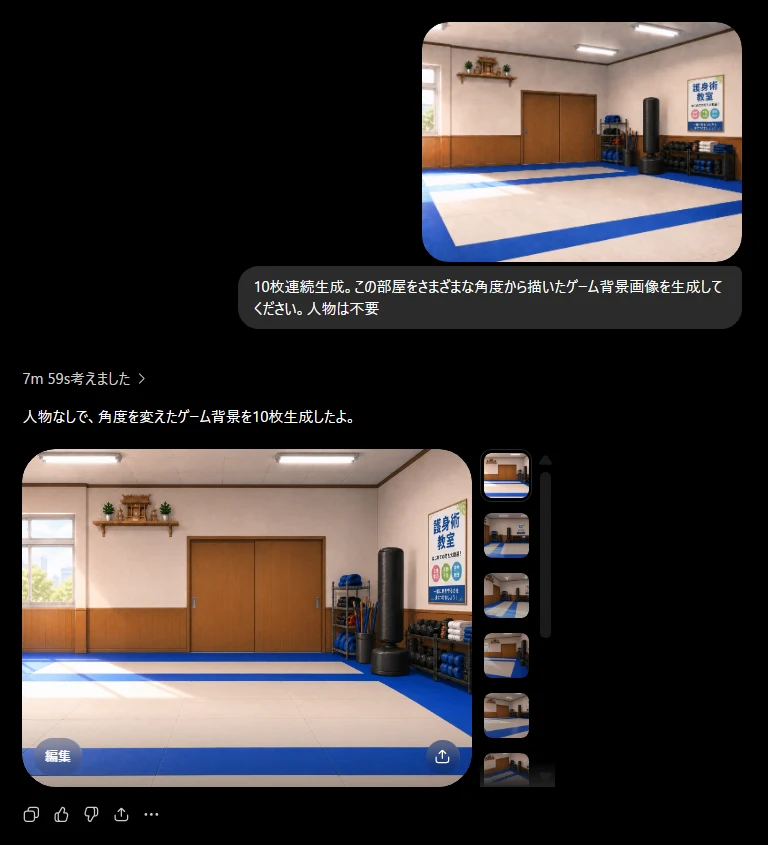
ごくわずかに矛盾があるものの、これは感嘆すべき出来になりました。護身術教室のポスターの文字も含めて、元画像に存在しない方角の壁までよく写せています。目立つのは、最上段左側のカットで、神棚の左側の窓の角度や壁の位置関係がおかしいくらいでしょうか。
今回はさきほど推論してもらった鬼怒川さんの寝室のうち1枚から、入口側、ベッド側、窓側、クローゼット側など、回り込む視点を含む10枚を生成しました。単なる左右反転や家具の並べ替えにはしないことも伝えています。
指示:添付の部屋をさまざまな角度から描いたゲーム背景画像を、独立した10枚で実際に生成してください。人物は不要。これは同じ部屋を別カメラから描く実験です。ベッド、掃き出し窓、入口ドア、クローゼット、姿見、チェストなどの位置関係やデザインを維持してください。入口側から、ベッド側から、窓側から、クローゼット側からなど、部屋の中を回り込む視点を含めてください。カメラは成人の目線の高さ、水平、16:9を基本にします。見えない壁は既存の構造と矛盾しないように補い、視点に合わせて家具を移動させないでください。単なる左右反転や家具の並べ替えにはしません。
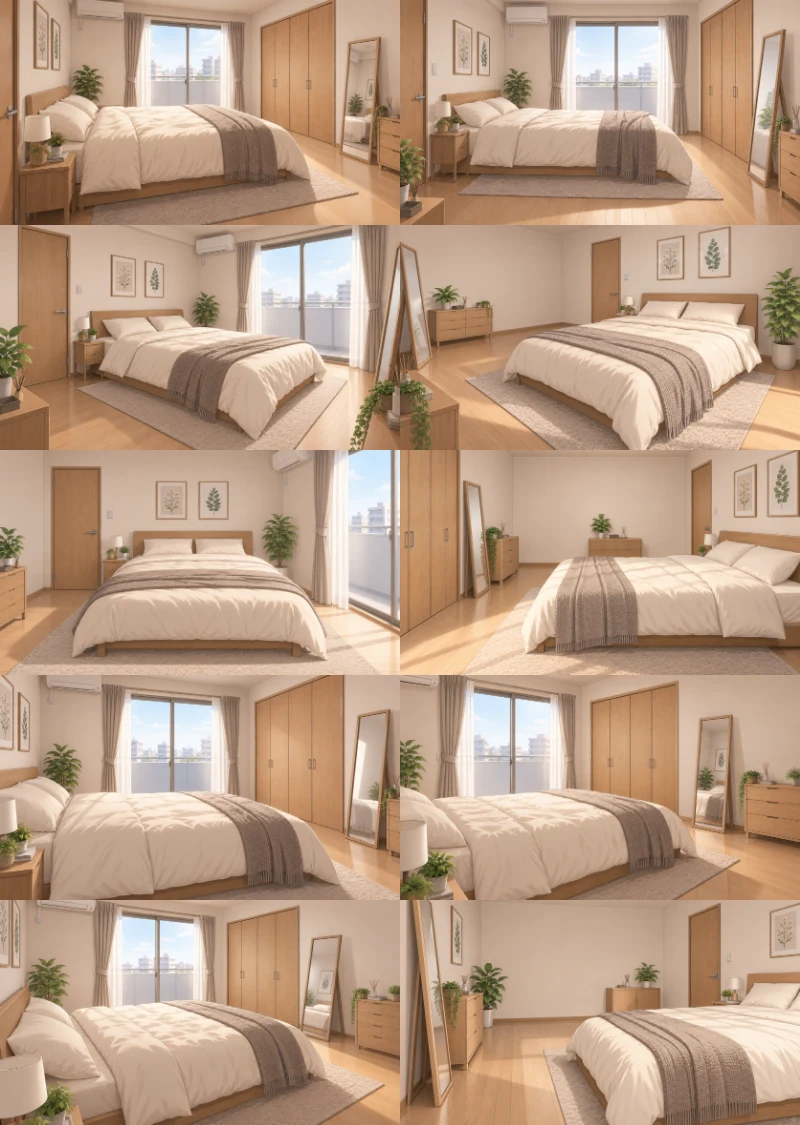
お見事ですね!ただ、入念に確かめると、反対側へ回ったときにチェストがダブルサイズになったり、部屋の大きさが変わったりはしています。鏡に映ったベッド上の絵まで再現しているなど、本当にレベルが高くなっているので信じてしまいますが、作品に採用する際はよくよく「間違い探し」をしてから採用するようにしたいですね。