こんばんは、スタジオ真榊です。アップスケールの概念を覆した「Tile」に続き、新たなControlnet1.1の新技術「ReferenceOnly」が界隈を騒がせていますね。この機能、入力した画像を構成する「スタイル」を読み取って、同じテイストの別のイラストを生成するというものなのですが、特徴の再現力が半端ない。LoRAの代わりになる!と言うといささか言い過ぎかも知れませんが、「うちの子」の画像を読み込ませるだけで簡単に似たイラストを量産できてしまいます。
そんなわけで今回は、これまでと全く異なるアプローチでキャラクターやタッチの再現ができる「ReferenceOnly」の使い道についての特集です。一体どんなことができるのか?3種あるプリプロセッサの違いは?複数キャラの再現や色移り防止は可能なのか?いろいろ実験しました。
「ReferenceOnly」の導入方法
まずはインストール方法からですが、基本的には記事執筆時点の最新版「v1.1.171」以降のsd-webui-controlnetを導入するだけでOK。プリプロセッサ一覧に「ReferenceOnly」など3種が追加されていれば成功です。
※Controlnet1.1の導入、もしくは1.0からのアップデート方法についてはこちらをご参照ください。
これまでのControlnet(CN)技術は、CN用の各種学習済みモデルが本体としてあり、モデルが読み込めるように元画像を「下処理」するプリプロセッサと組み合わせて使うのが普通でした。例えば、モデル「LineartAnime」を使って線画を継承したイラストを生成したい場合は、元画像をプリプロセッサ「LineartAnime」に読み込ませて、いったん黒地に白線で描かれた線画にしてから読み込ませる必要がありました。
「ReferenceOnly」はこうした「モデルが主、プリプロセッサが従」の関係ではなく、プリプロセッサのみで動作する全く新しいControlnet技術です。つまり、モデル本体を新たにダウンロードする必要はありません。
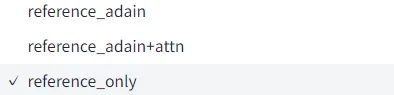
アップデートに成功していれば、プリプロセッサ欄に上記の三種が追加されています。こちらのうち一つを選ぶと、モデルを選ぶ欄が消失するので、あとはテイストを参照するモデルとなる画像を読み込ませればOKです。
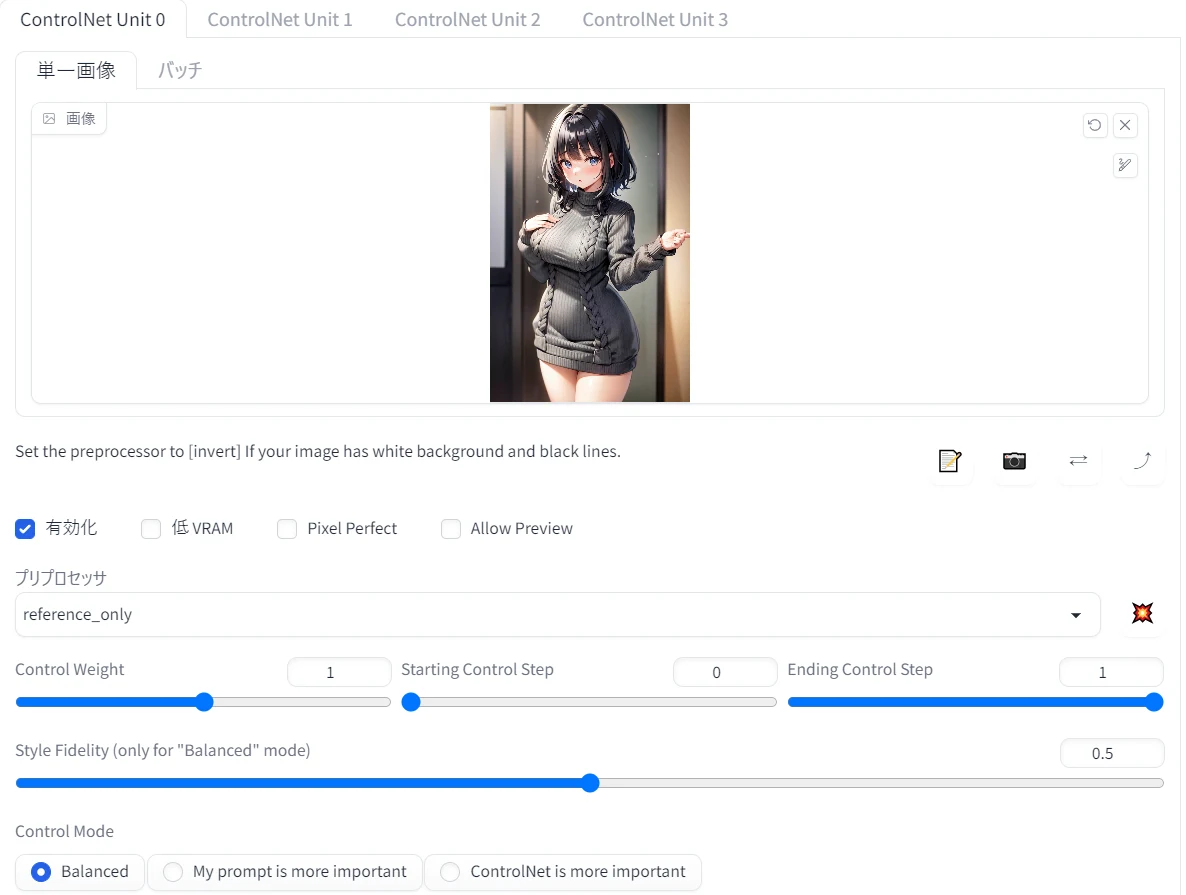
こちらがControlnetの操作画面。
「Style Fidelity」はスタイルの忠実度を示す値で、0.5がデフォルトです。1に近づくと、AIは元画像のスタイルをより忠実に再現しようと試みます。ただ、この忠実度操作はControlモードが「Balanced(バランス)」モードであるときしか使えず、「プロンプトが重要」「コントロールネットが重要」モードではスタイル忠実度を操作することはできないとされています。(入力すること自体はできるようですが、意図した結果にならない)
具体的に何ができるのか?
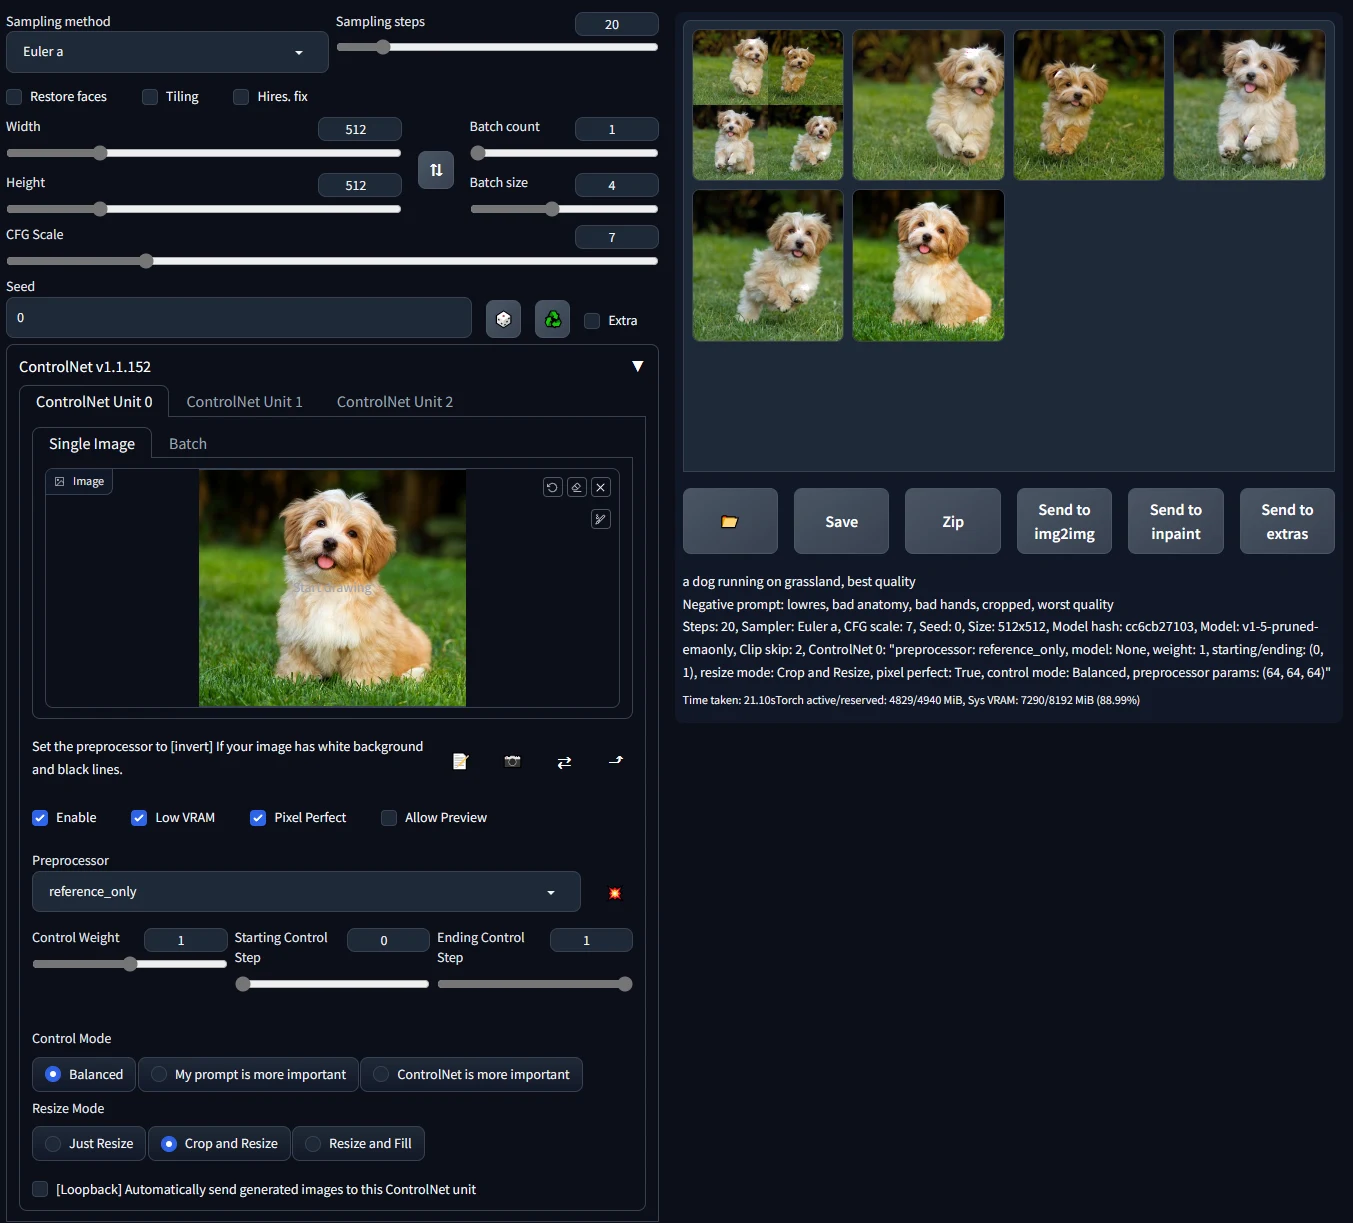
(引用元:https://github.com/Mikubill/sd-webui-controlnet/discussions/1236)
公式の例では、おなじみの犬の画像をReferenceOnlyで読み込んでプロンプトを「草原を"走る"犬」に変更し、元画像と似た犬の別カット(に見えるもの)を生成することに成功しています。全く同じ犬かと言われると微妙ではありますが、被写体だけでなくキャンバス全体の雰囲気をよく保持しつつ、「コピー」や「再生成」に近いimage2imageとは別アプローチで画像の変更を試みていることがよく分かる例です。
こちらはアニメ調イラスト。製作者のlllyasviel氏(以下イリヤスフィール氏)によれば、CNモードを「バランスモード」とし、 「Style Fidelity」(スタイル忠実度)最大の1.0 を使用したとのこと。この技術の登場により、「同じキャラクターを少し変更して描く」ことがより現実的になったとしています。
また、学習済みモデルを必要としないことにもメリットがあるようです。例えば、Controlnetには「Shuffle」やT2I Adapter「Style」といった画像のテイストを継承する技術が他にもありますが、こうした技術に使われる学習モデルには教師データによって実写が得意とか、アニメ調イラスト向きといった差異が生じてしまいます。イリヤスフィール氏は、ReferenceOnlyには学習モデルを必要としないため、そうした得手不得手なく利用できると説明しています。
「こういうやつ描いて」「でも元画像を書き写さないで(no i2i)」というのがreference onlyの本質。まさに「参照だけ」させる技術なのですね。設定も非常にシンプルで、使いやすさは抜群。誰でもバリエーションが簡単に出せるので、LINEスタンプ風のアイコンなんかも作れてしまいます!

プリプロセッサ3種の違い
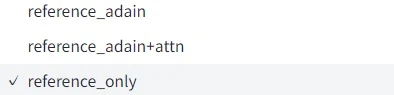
さて、追加された3つのプリプロセッサは、それぞれモデル画像からどうやってスタイルを参照するかの手法が違うため、それぞれスタイル再現の忠実度も異なります。それぞれの特徴は以下の通り。
①reference_adain
「AdaIN」(Adaptive Instance Normalization)というモデル画像のスタイルを高速・高精細に転送する技術を使用して、画像のテイストを継承できるプリプロセッサ。忠実度が低いが元画像に引っ張られにくい特徴がある。
②"reference_adain+attn
attnはAttentionLink、つまり③の「reference_only」の技術を指す。①と③の技術を合わせた混合タイプで、3種の中で最も再現度が高い。
③reference_only
モデル画像をStableDiffusionのAttention層に直接リンクすることで、モデル画像のスタイルをSDに参照させる技術を使うタイプ。バランスタイプ。
製作者のイリヤスフィール氏によると、現時点では「reference_adain+attn」をStyle Fidelity1.0で読み込ませるのが「最先端かつ最良の方法」だそう。ただ、この組み合わせは「場合によっては強力・堅牢すぎるため、デフォルトとして使用することはお勧めしない」とした上で、通常は「reference_only + Style Fidelity=0.5」を使用するのが良いと説明しています。
ReferenceOnlyの使い方
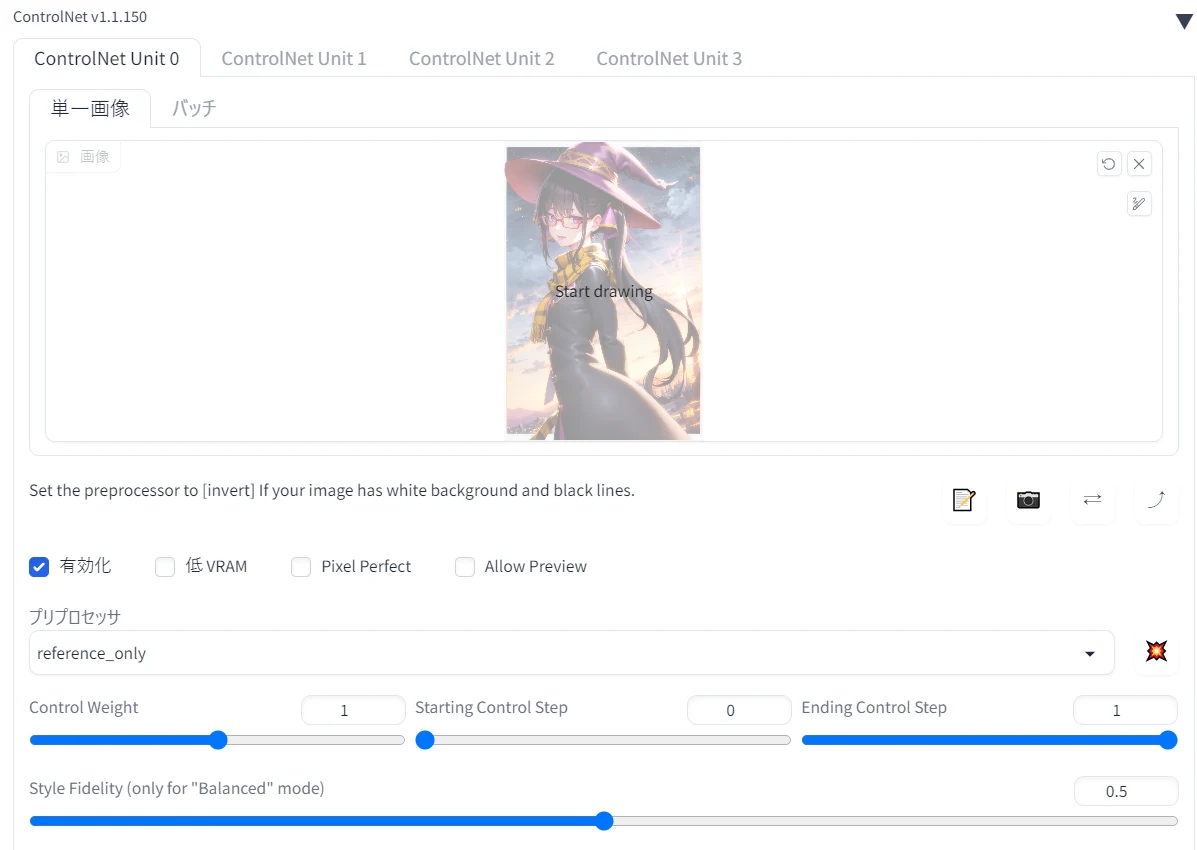
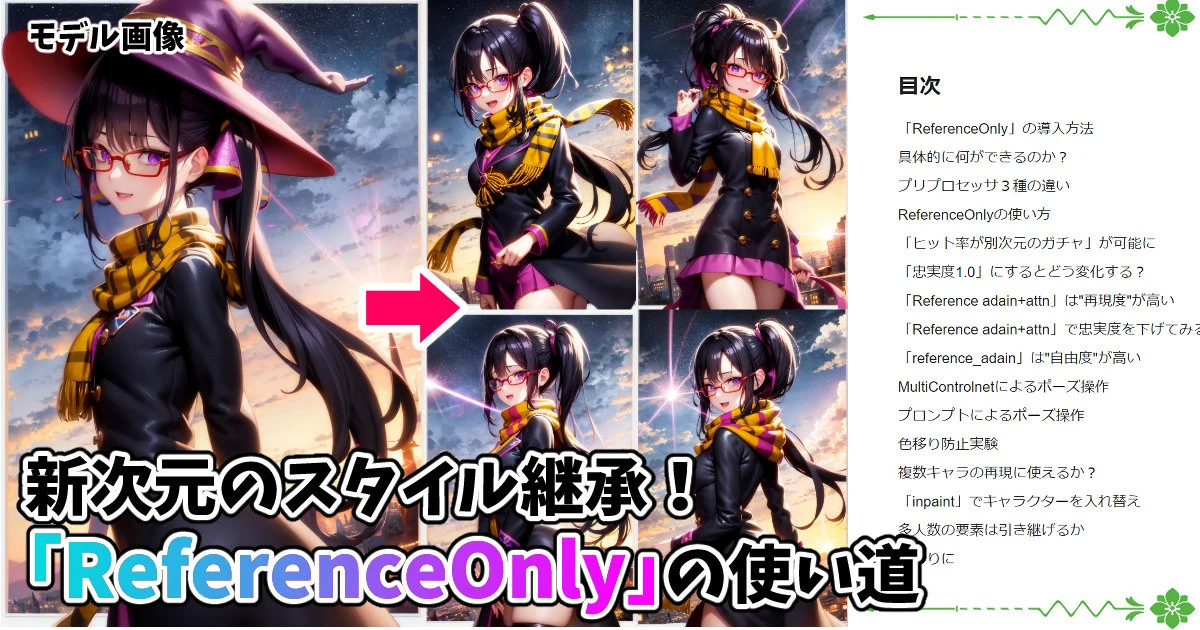
使い方は非常にシンプルで、プリプロセッサを選んでスタイルを継承したいイラストを読み込ませるだけです。上の画像はこちらの魔女子さんのイラストをreferenceOnly、バランスモードで読み込みませたところ。忠実度はイリヤスフィール氏のおすすめするデフォルト値「0.5」としました。768x512pxに高解像度補助を1.5倍で掛け、プロンプトは元画像と全く同じもの、Seed値はランダムです。
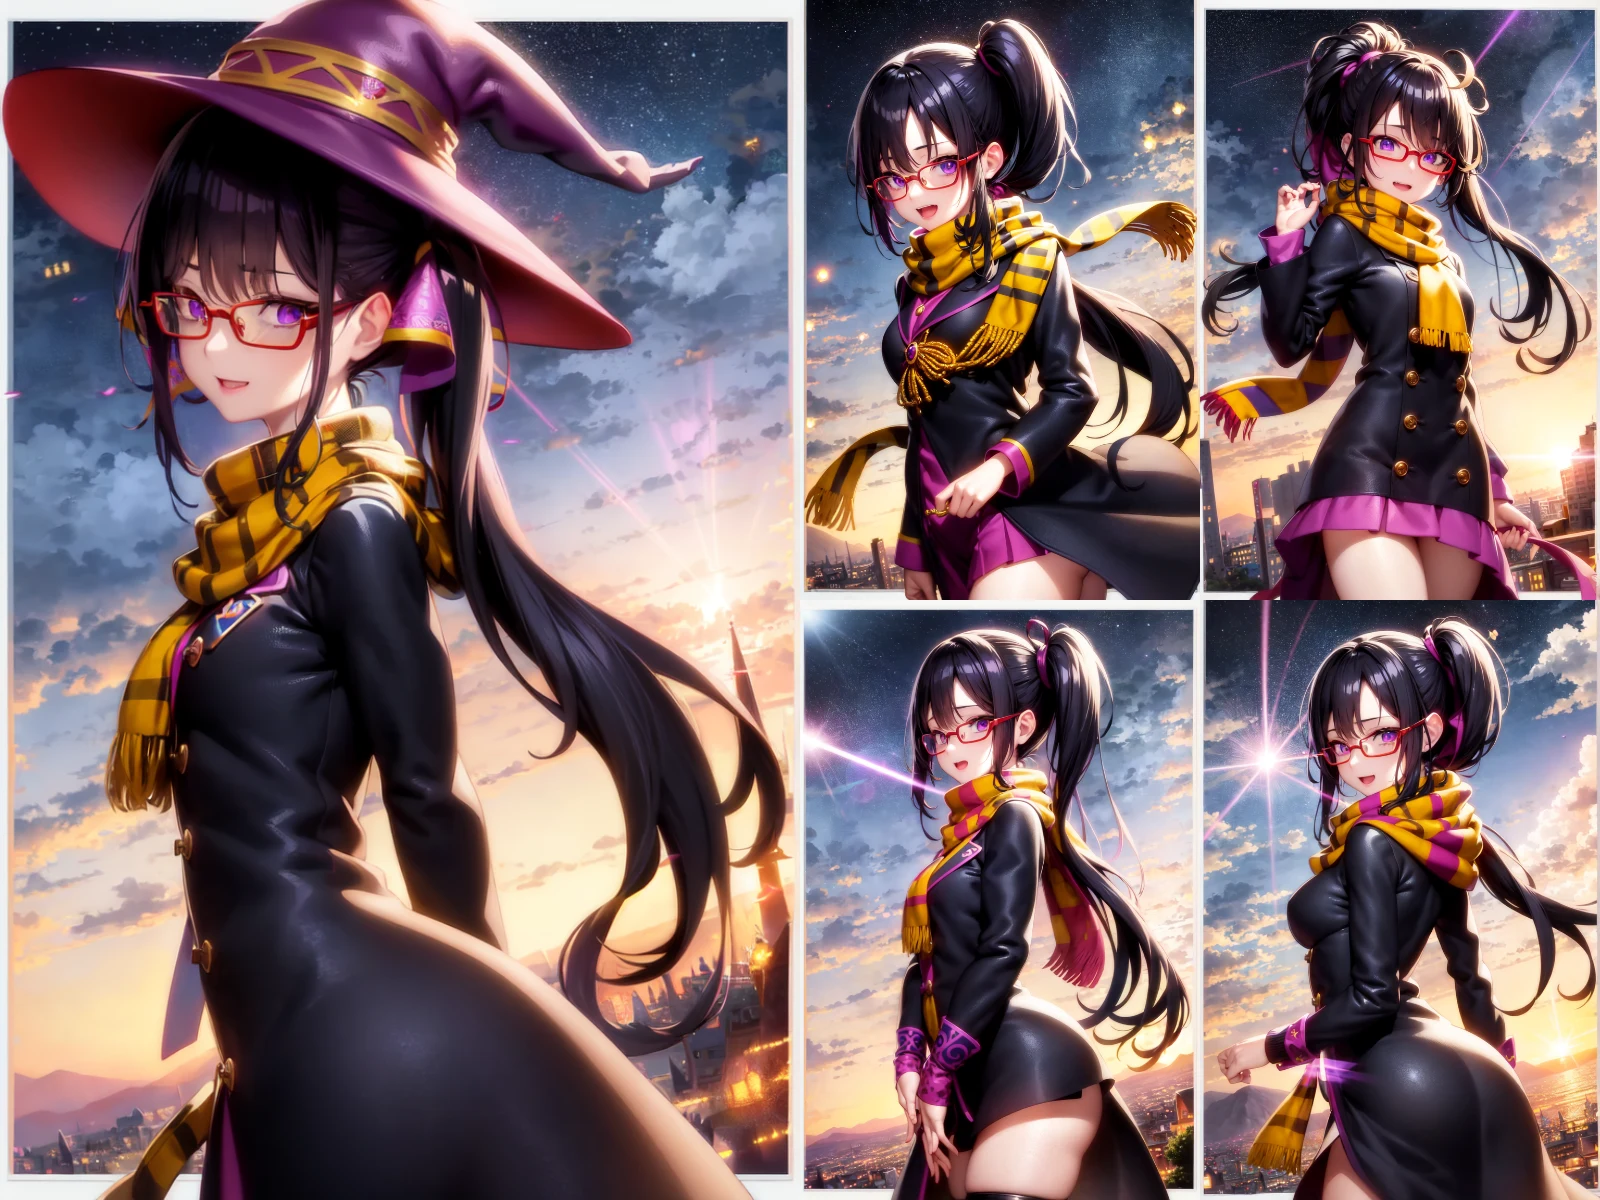
左が元画像、右の4枚が生成結果です(チェリーピックなし一発出し)。プロンプトは以下の通り。
「(anime color:1.2),open mouth,shiny black hair,side ponytail with purple ribbon, wearing glasses,sideburns, beautiful purple eyes, (red and yellow border pattern Scarf:1.2),black long coat,witch,holding tree branch,harry potter,BREAK magic school,zettairyouiki,32 years old,high resolution,masterpiece,best quality,extremely detailed CG,official art,(overlooking fantasic panorama view:1.2),beautiful sky,smile,light particles,light rays,strong light,lens flare,beautiful sky,cinematic lighting,dynamic lighting」
プロンプトにもともと「witch hat」がなかったので魔法の帽子が出ませんでしたが、ほかは概ねキャラクターの特徴が概ね継承されていることが分かると思います。これだと「確かに似ているけどただプロンプトが強いだけなんじゃないの?」と思われてしまうので、同一SeedでCNをOFFにして再生成してみましょう。
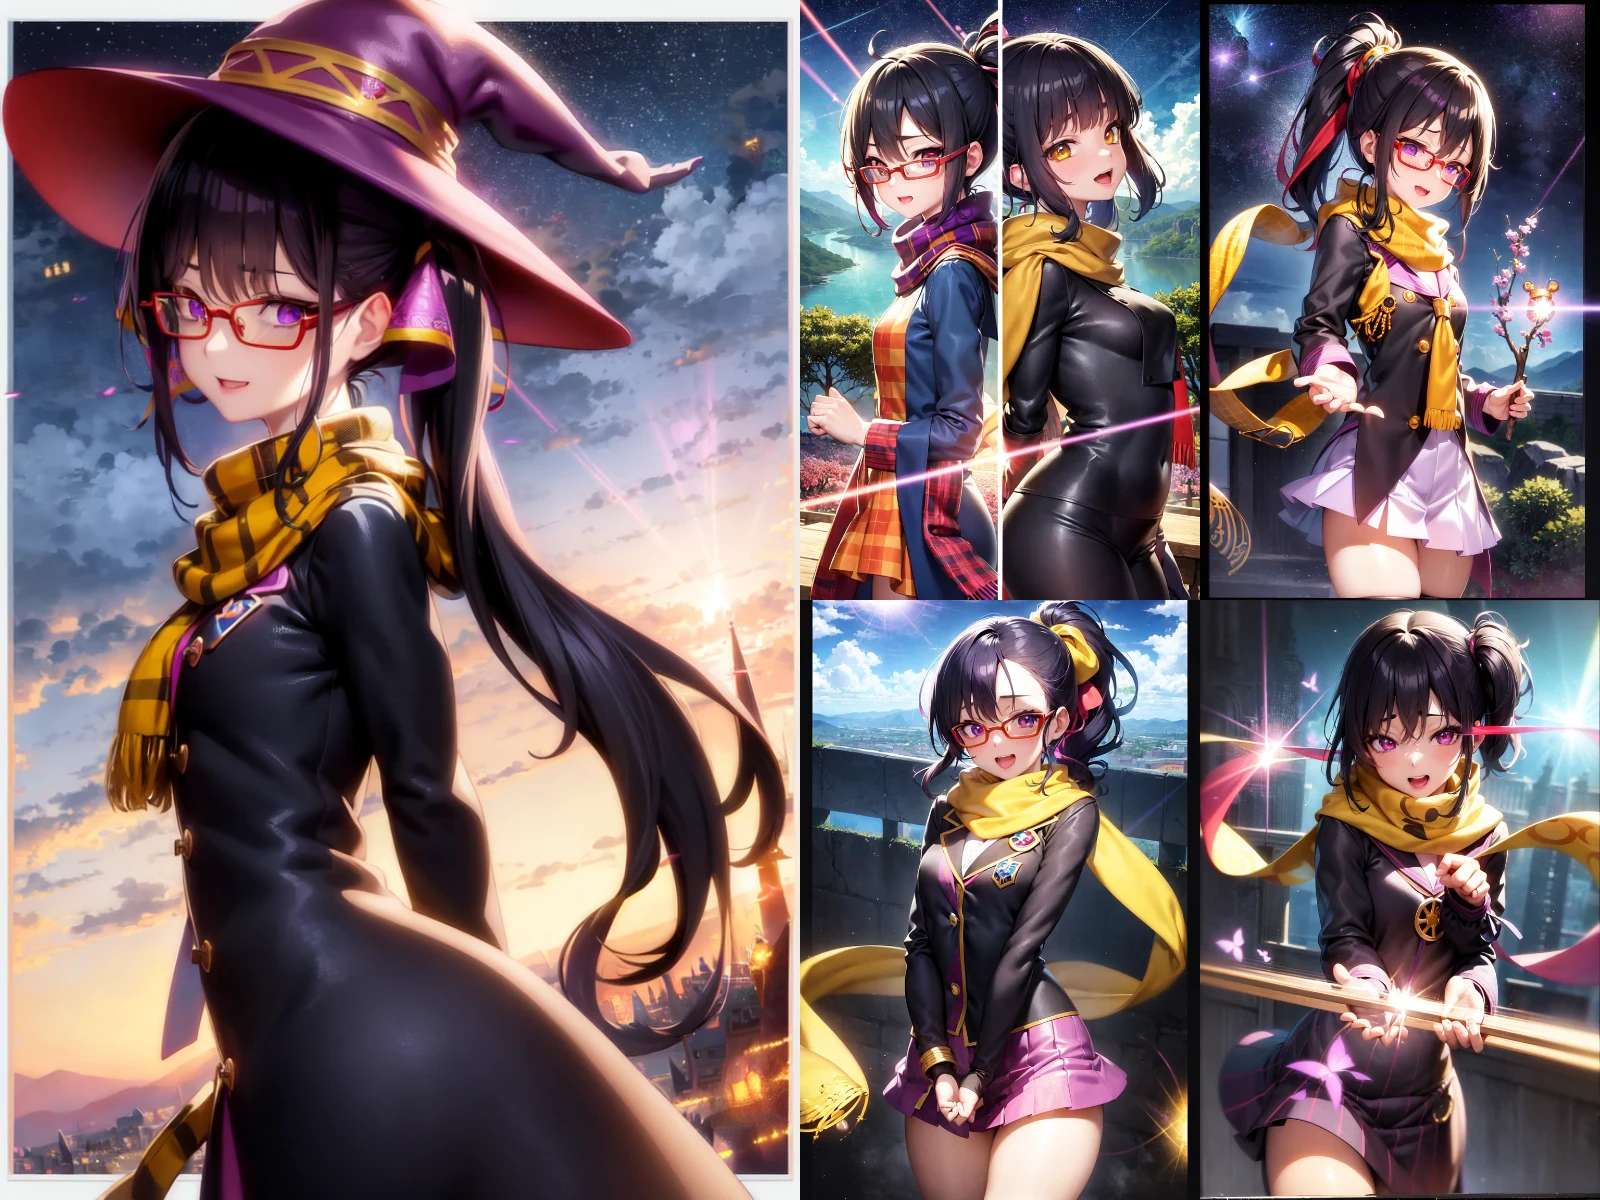
さきほどと比べると、まずボーダーのマフラーが失敗しており、紫のリボンも安定していません。メガネが消失したり、2人になってしまったケースも。桜の枝をつかんでしまっているのは、ハリーポッター作品っぽい魔法の杖を出すために入れた「holding tree branch(木の枝を持っている)」が誤解されたものです。CNありと見比べると効果は歴然としていますね。
・「ヒット率が別次元のガチャ」が可能に
ReferenceOnlyが凄いのは、i2iでも同一Seedのバリエーションでもない形でキャラクターの特徴を維持することができる点。これによって、これまでにない高精度のガチャが簡単にできるようになりました。
そもそも、左のモデル画像自体がこのプロンプトからよくできた生成物(賢木の意図したものにたまたま沿ったもの)をチェリーピックしたものです。その最良の結果をもとにバリエーションを生成できるわけですから、さきほどCNをオフにしたときのような色移りやプロンプトの誤解、キャラクターの分裂や要素の混線といった事故を最小限にとどめながら、正解しかない「ヒット率が別次元のガチャ」を繰り返すことができるわけです。
これまでは「プロンプト指示→多数の結果の中からベストのものをチョイス→加筆やアップスケールでブラッシュアップ」だったのが、「プロンプト指示→多数の生成結果の中からイメージ通りのものをチョイス→reference onlyで意図を維持しながらより高精度な生成を繰り返す」ことが可能に。従来はプロンプトの混ざりやAIの勘違いを減らすために、同じSeed値でプロンプトを工夫してみたり、ポーズをCNで固定してみたり、BREAK構文や「sd-webui-cutoff」を使って色移りを防いでみたりと、さまざまな試みをしてきたわけですが、ReferenceOnlyによって「自分はこういうものを求めているんだ」と直接AIに指示できるようになったことは大変画期的と言えるでしょう。