
こんばんは、スタジオ真榊です。今回は、SDXLの後継モデルと目されつつあるイラスト調画像生成モデル「Anima」と、最新SDwebUI「ForgeNeo」についての特集記事です。
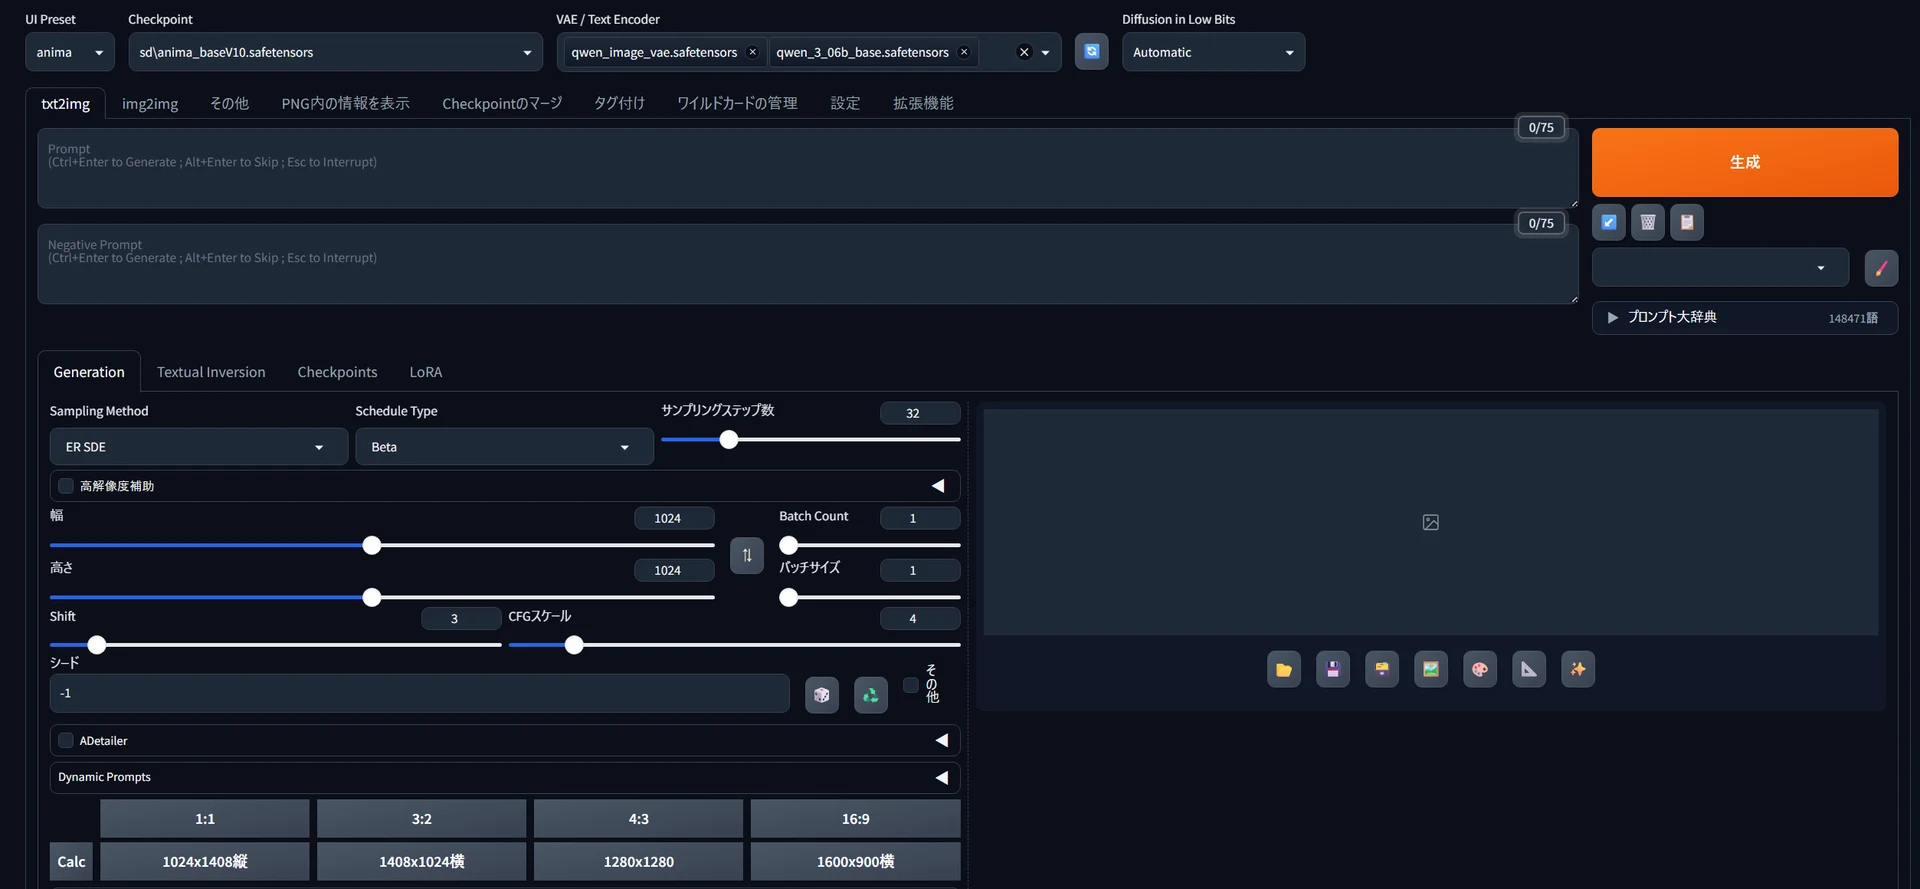
Animaは、英語による自然言語指示やNSFW生成、LoRA学習に対応した、次世代ローカル画像生成モデルの有力候補です。ただし、SDXL用のLoRAやControlNetをそのまま流用できないことや、ComfyUIなど新しい生成環境を整備しないといけないのがネック。今回の特集では、いつものForge系の操作感でAnimaを扱える「ForgeNeo」(下図)を使った生成方法を分かりやすく解説します。
導入方法から基本設定、注意すべき権利関係やNSFWの実力検証などもしっかり行って、ユーザーがそれぞれ新環境に「引っ越し」するかどうかを見極められるように書いていきたいと思います。ForgeではQwenImageEdit2511など他の最新モデルも使えるので、創作の幅がかなり広がるはずです。【約3万字】
1.ForgeNeoとは?
ForgeNeoは、ForgeClassicを開発したHaoming02氏が開発しているForge系WebUIです。ForgeClassicは不要なソフトウェアを一切排除したシンプル&快速な開発思想が特徴でしたが、ForgeNeoはその思想を引き継ぎつつ、AnimaやQwenImageEditといった新モデルに対応したWebUIとなっています。
AnimaやQwenImageEditの生成といえば、最初に想定されるプラットフォームはComfyUI。ただ、ノードをつないでワークフローを組むやり方はやはりとっつきにくく、A1111やForge系に慣れている人にはややハードルが高めでした。ForgeNeoで生成できるようになったことで、Animaの生成はぐっと身近になったと言えます。
<reForgeに比べると「尖った」webUI>
reForgeの後継候補として指名されたForgeClassicは、とにかく画像生成が早く、起動も軽く、余計な機能を思い切って切り捨てているのが特徴です。よって、WD1.4 TaggerやSupermergerが使えないなど、reForgeなどに比べて拡張機能の汎用性が低いのが弱点でもありました。
ForgeNeoはこのClassicをさらに発展させ、AnimaのようなSDXLとは異なる構成のモデルを扱うための機能を高速性と両立させたもの。つまり、位置づけ的には「ForgeClassicの別ブランチ(派生)」ですので、Classicと同様に使えない拡張機能があります。ヘタをするとwebUIごと起動しなくなってしまうこともあるので、導入時は注意しましょう。

2.Animaとは?
一方Animaは、画像生成AIの研究チーム「CircleStoneLabs」がComfyUIのComfyOrgと共同開発したローカル向け画像生成モデルです。従来の「U-net」ではなく「DiT」という新しい画像生成手法を採用しており、SDXLよりもパラメータ数はやや軽量ながら、プロンプト追従性が高く高解像度補助(Hires.fix)なしでも正確な描画ができるのが特徴。プレビュー版の時点で性能の高さが話題になっていましたが、2026年5月14日に正式版「anima-base-v1.0」が公開され、一気に利用が広がっています。
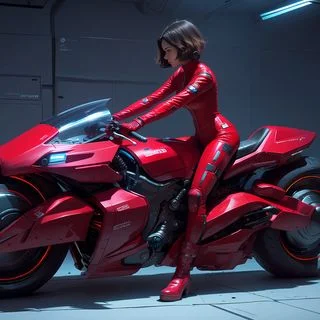
中国Alibabaの「Qwen3」系のテキストエンコーダを使っているため、Danbooruタグだけでなく、GPT-Image2やNanoBananaProのような自然言語指示での複雑な指示が可能。例えばこんな感じで、Danbooruタグでは混乱してしまいがちな要素を上手に整理することができます。(※英語のみで日本語指示は不可)
Animaがとりわけ大得意なのは、NSFW生成。詳しくは記事後段で解説しますが、ベースモデルそのままでも、例えば「事前→事後」のような複数コマの画像を自然言語で生成することができます。
Qwen由来の画面構築力と正確性があり、NanoBananaproやGPT Image2ではできないNSFW生成や追加学習が自由にでき、出力画像の商用利用もできるAnimaは、次世代の覇権ローカルモデルとしての資格十分。コピー機法で画風LoRAを作ればSDXLの画風をおおむね移植できることも分かってきたので、「そろそろ触っておきたいモデル」になってきたのは間違いありません。
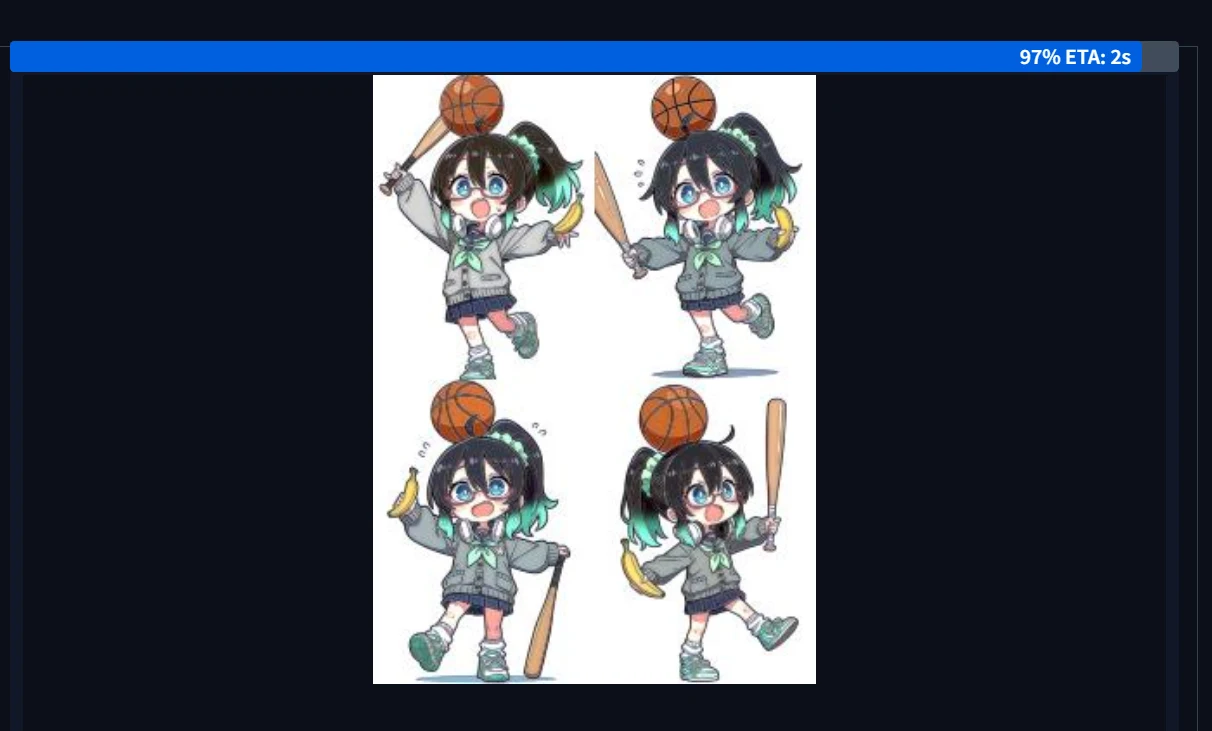
▲コピー機法で学習した画風LoRA。SDXL画風のちびミナちゃんを再現できた
ただし、いいところばかりでもありません。アップスケールなしでかなりきれいな画像が生成できる代わりに、画像生成速度はSDXLよりかなり重め(体感で1.5倍から2倍くらい。ただし高速化は可能)ですし、自然言語指示も英語のみ対応なので、ちょっと取り回しが面倒ではあります。プロンプト追従性が高いのもいいことばかりではなく、矛盾したタグを無視できず大まじめに指示されたものを再現しようとしたり、プロンプトが同じだとSeed値が違ってもかなり似た構図が出たりするところに使いにくさを感じます。
ForgeNeoもAnimaも記事執筆時点では発展段階ですので、SDXLのように成熟した覇権モデルになれるかどうかはこれからの話。LoRAやControlnetなどの周辺技術の整備もまだこれからですし、「SDXLの完全上位互換」とまでは言えないように感じます。今回の検証を通じて、そのポテンシャルを確かめていきましょう。

3.StabilityMatrixでForgeNeoを導入しよう
記事執筆現在でForgeNeoを導入するなら、これまで通りStabilityMatrixでパッケージごと導入するか、AIエージェント「Codex」に導入作業を依頼するのがおすすめです。StabilityMatrixならいつもの操作ですぐに導入できるのでお手軽ですし、Codexが使える環境なら、導入だけでなくAnimaなどの必要ファイルのダウンロードや拡張機能の整備、生成速度の高速化といった面倒な作業まで「丸投げ」することができます。
①StabilityMatrixで導入するには
Animaで初めてStabilityMatrixを触る方は少ないと思いますが、これからインストールする場合はこちらの記事を参照のこと。
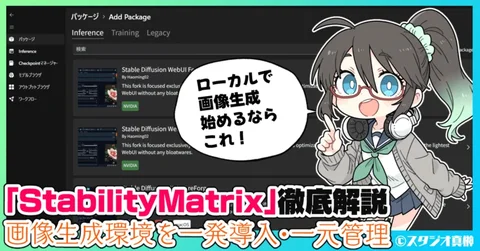
StabilityMatrixを起動したら、左側の「パッケージ」ボタンから、画面下部の「+パッケージの追加」をクリックします。一覧の中に「StableDiffusionWebUIForge-Neo」があるので、これを選択してインストールします。
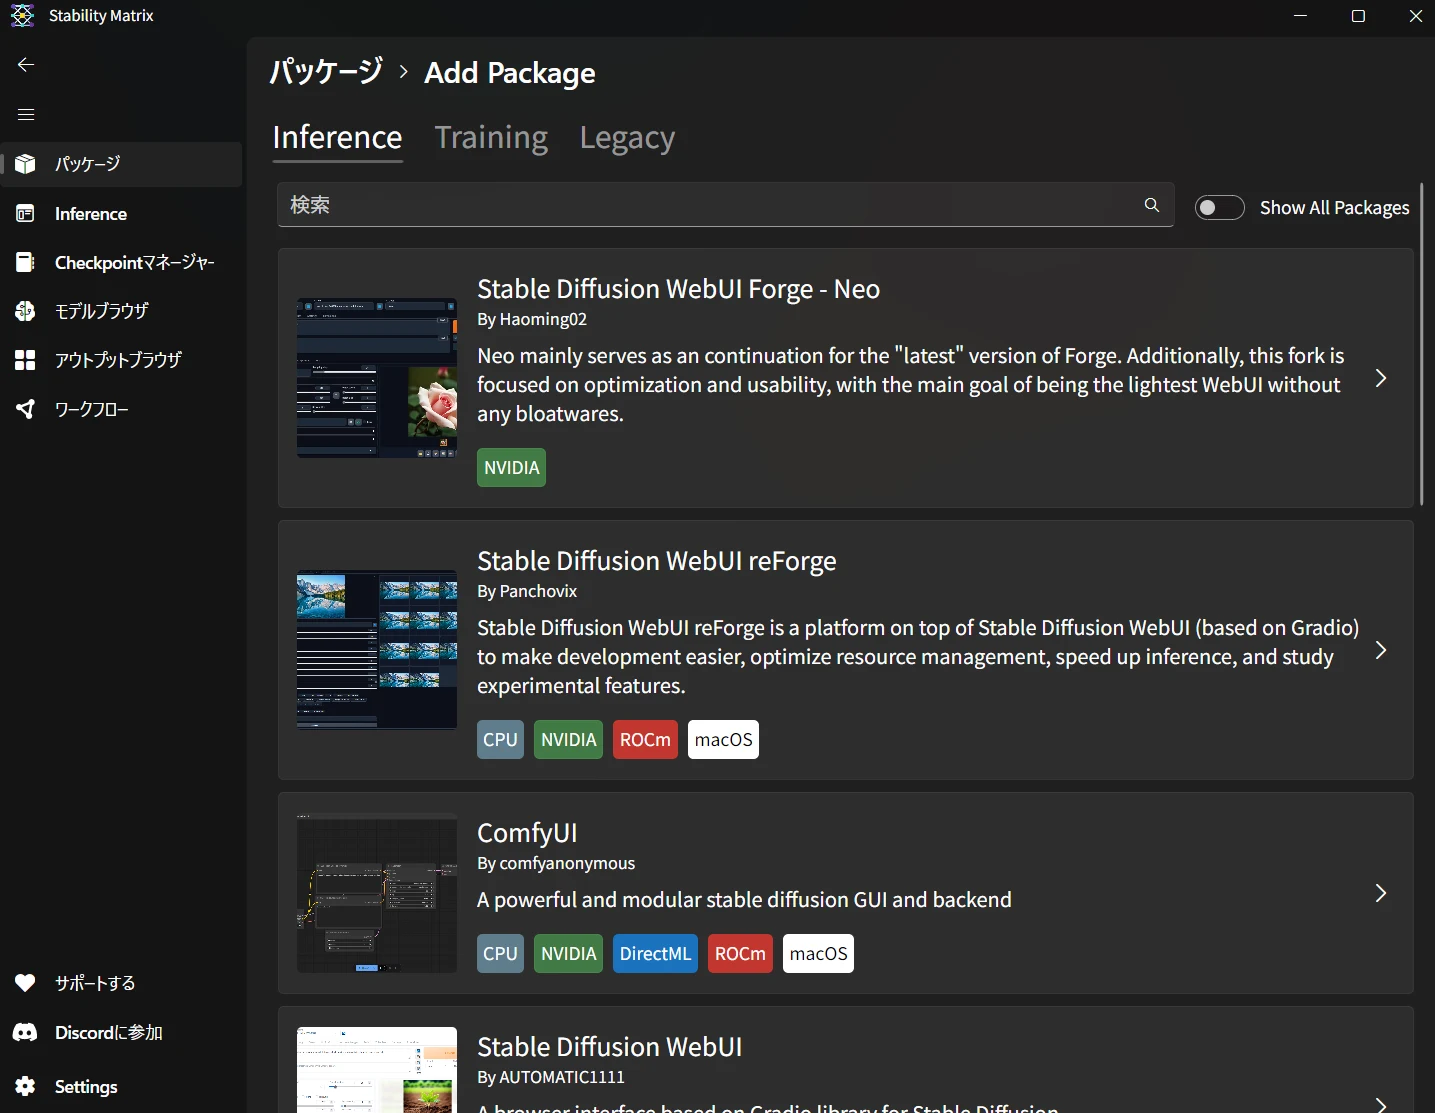
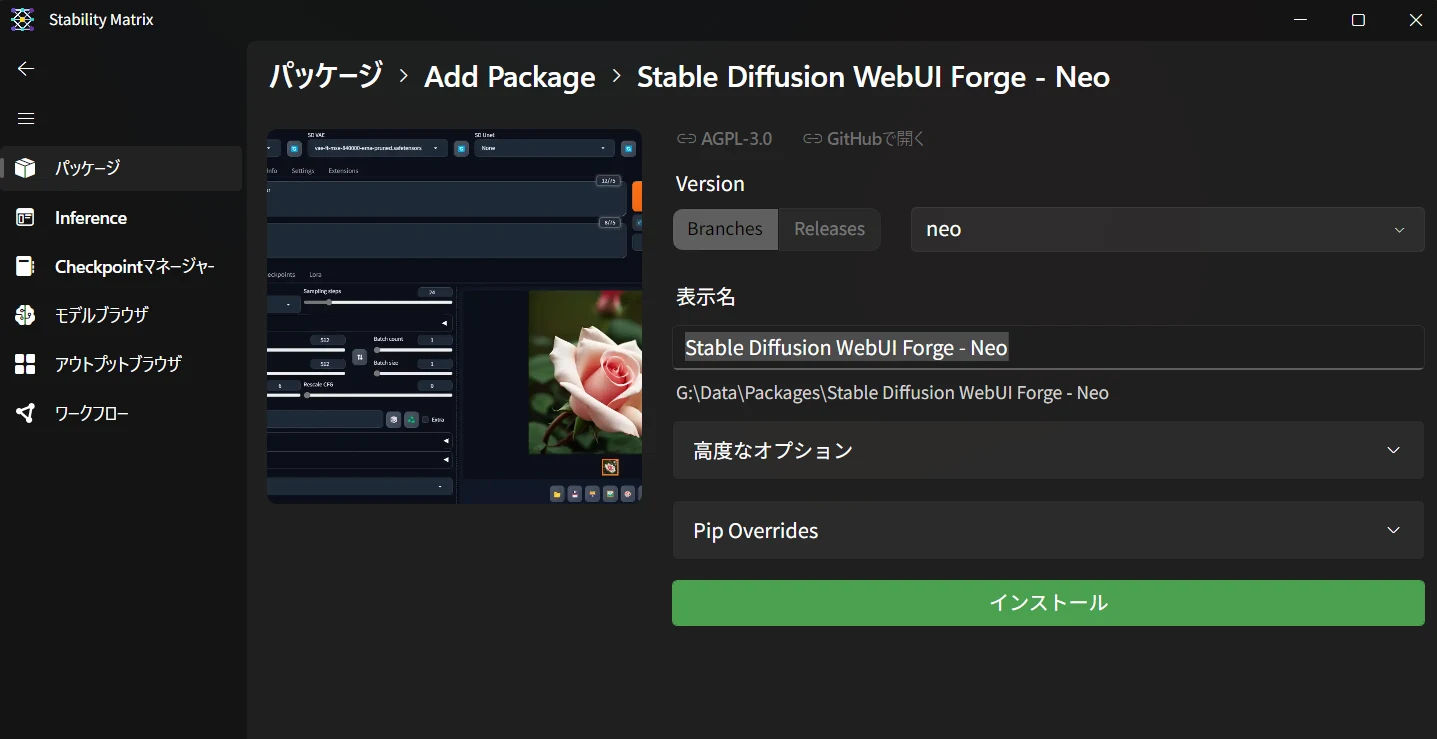
表示名はそのままだと長いので、「ForgeNeo」など短くしておくと分かりやすいです。ForgeClassic、reForge、A1111などを併用していると、パッケージ一覧がかなりごちゃごちゃしてしまいますからね。
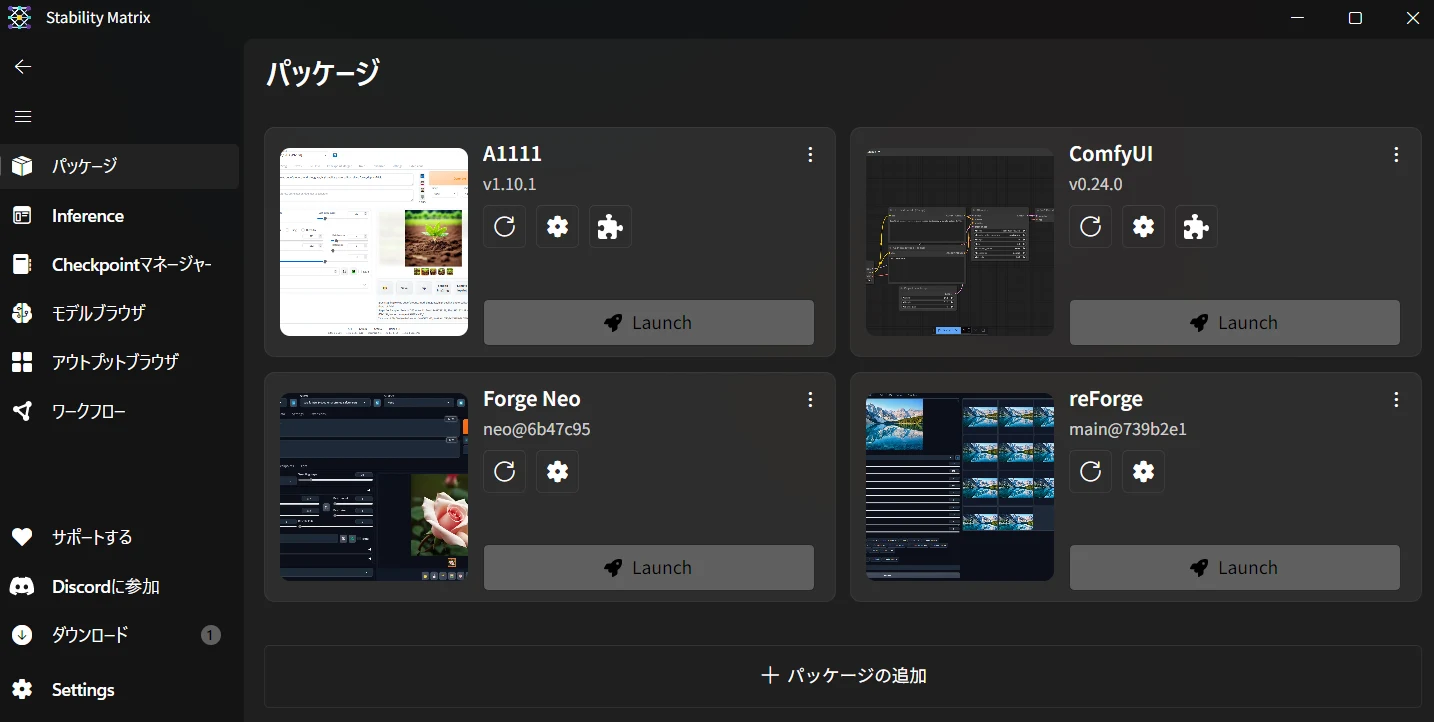
インストールが終わったら、パッケージ一覧にForgeNeoが追加されます。まずはそのまま「Launch」して、正常に起動するか確認しておきましょう。
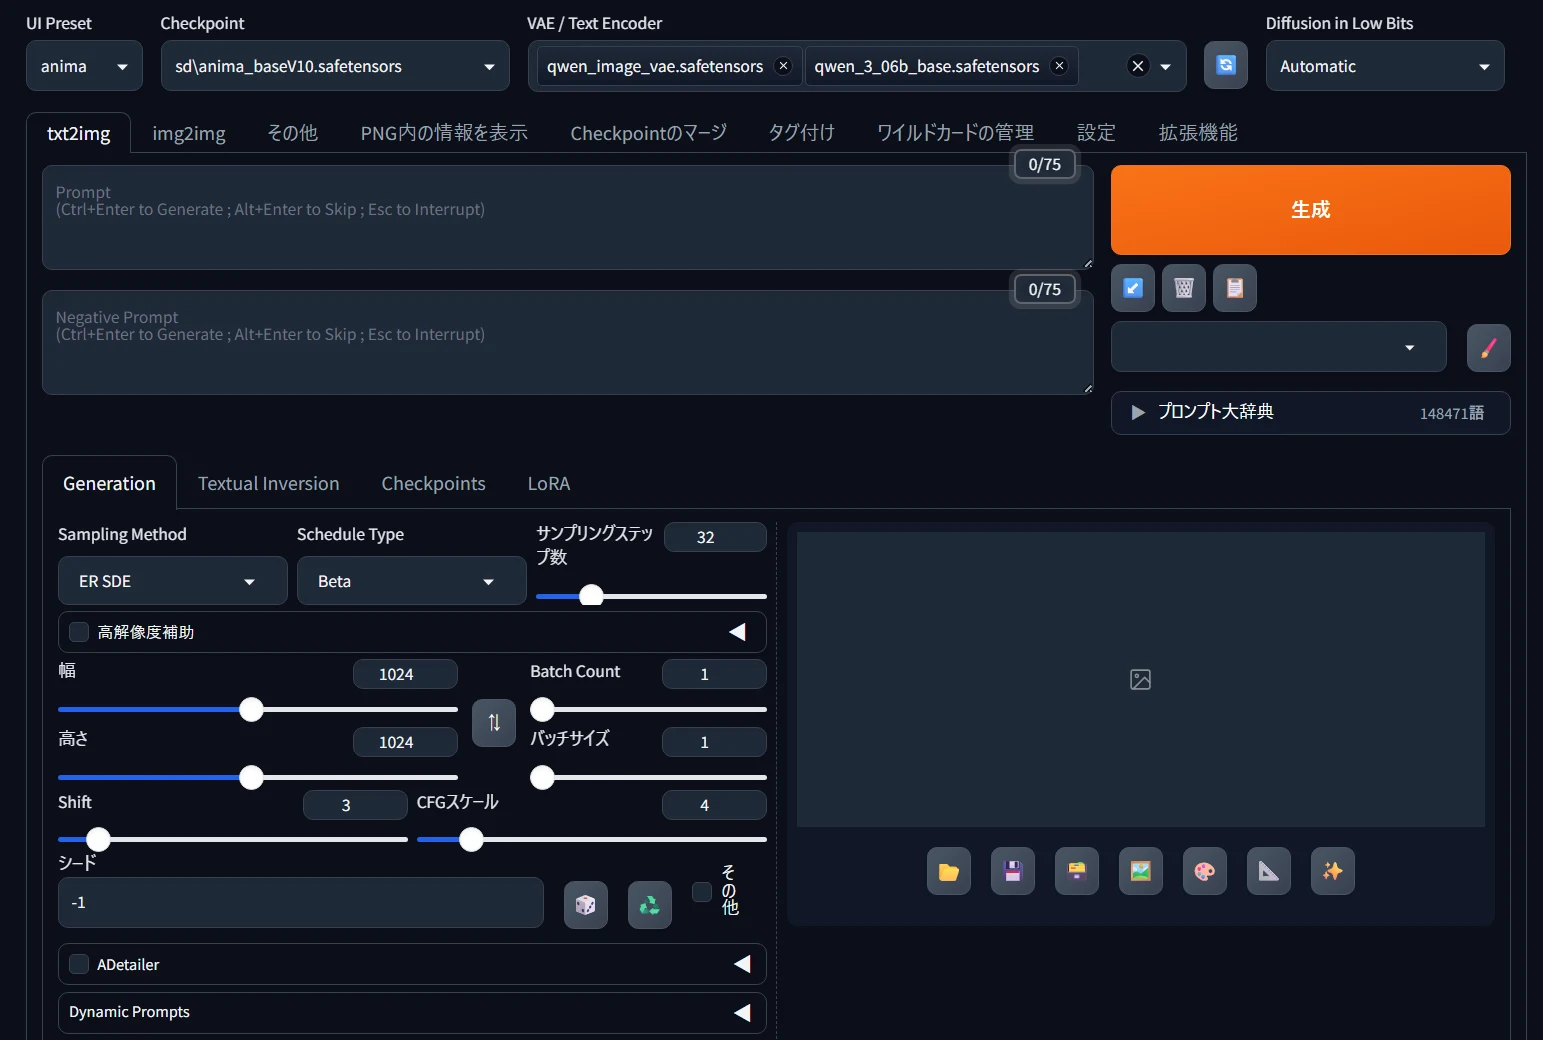
こちらが起動画面。見た目はかなり見慣れたWebUIですね。ただし、画面上部を見ると、従来のCheckpointだけでなく、UIPresetやVAE/TextEncoderなど、新モデルを使うための見慣れない項目が増えています。拡張機能のプロンプト大辞典もちゃんと動きます!(※v1.2に更新し、起動時にもたつく動作を改善したので、そちらもぜひご確認ください)
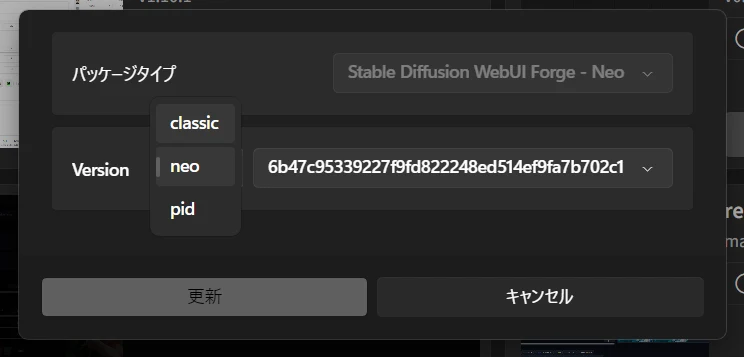
ちなみに、ForgeNeoはClassicと兄弟関係にあるので、StabilityMatrix上で既にClassicがインストールしてある場合、3点リーダボタンから「change version▶neo」をクリックするとClassic環境をそのままNeoにすることもできます。個人的には、せっかくなので別に新しく入れ直す方がよいかなと思います。

②Codexで導入するには
ForgeNeoは環境がForgeClassicよりもさらに新しく、普段使っている拡張機能をぽんぽん入れていくと互換性の問題であっさり起動しなくなることがあるので、環境整備からCodexやClaudeに丸投げしてしまうのも手です。Codexの始め方はこちらの記事参照のこと。
適当な場所に空のフォルダを作って、その場所でCodexを呼び出すかたちでもよいですし、StabilityMatrixのDataフォルダで呼び出してもOK。「ForgeNeo(https://github.com/Haoming02/sd-webui-forge-classic/tree/neo)をインストールして。Animaで画像生成できるように必要ファイルもダウンロードして」などと雑に指示すれば、てきぱきと作業を進めてくれます。
いつもreForgeで画像生成しているなら「reForgeと同じように画像生成できるよう、初期設定や拡張機能をできるだけ再現して」と頼んでもよいでしょう。
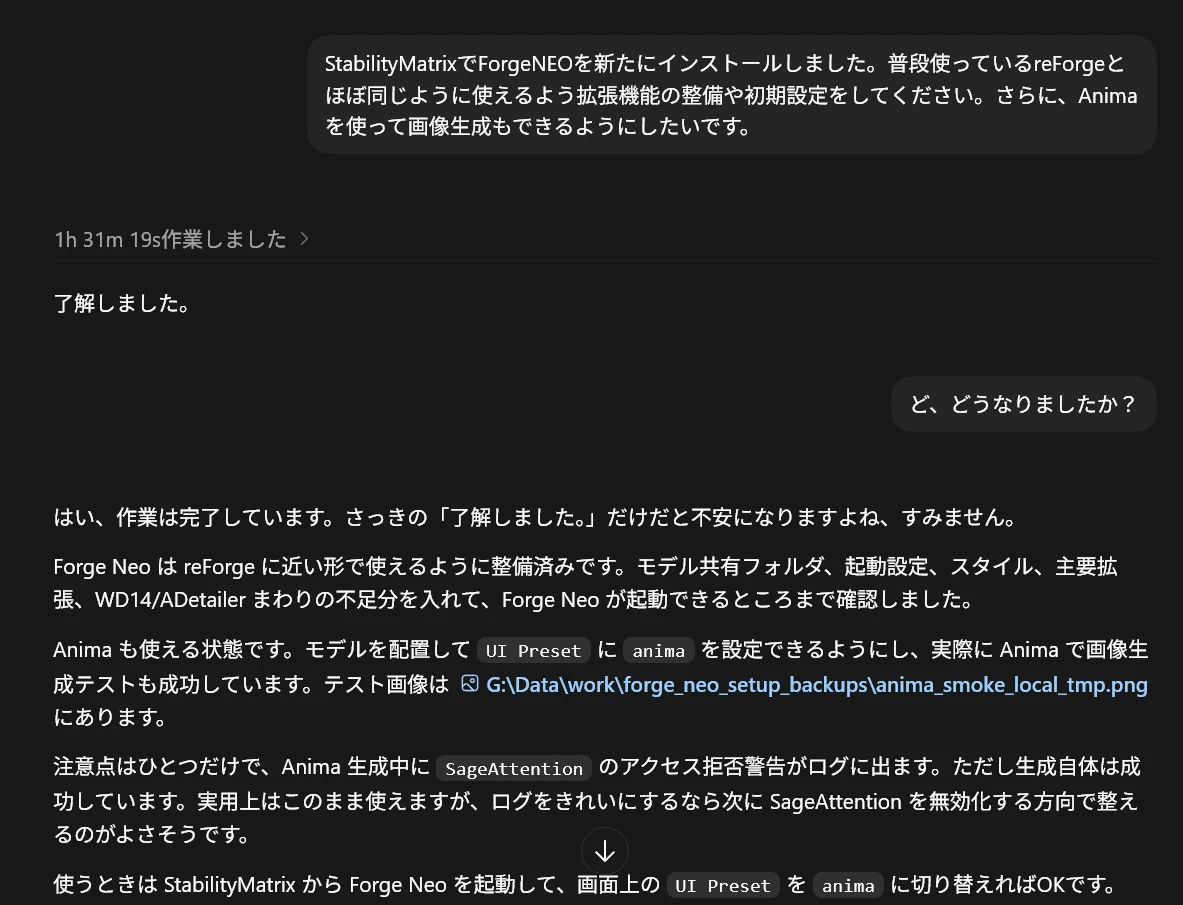
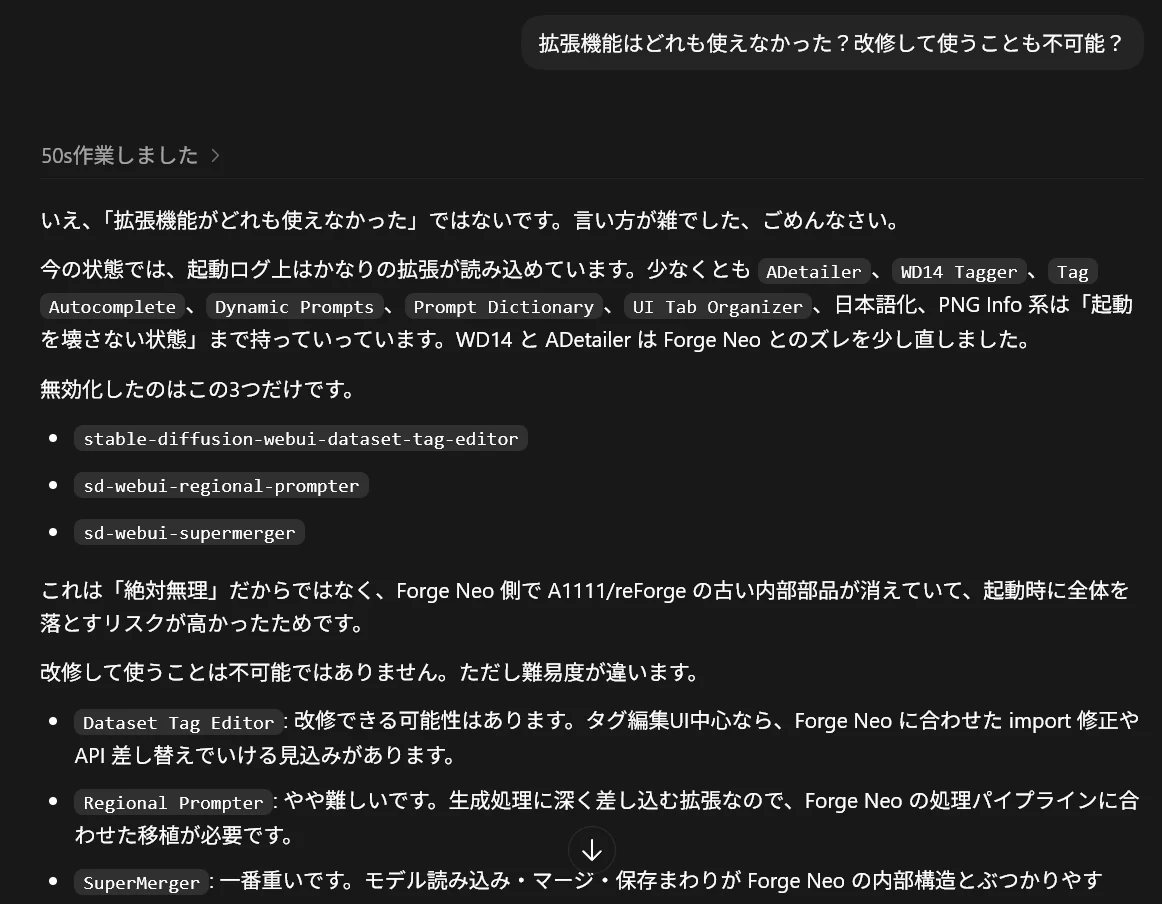
ただ、reForgeとForgeNeoは見た目は同じでも構造がかなり異なるため、reForgeで使っていた拡張機能をそのまま動かそうとするとさまざまなトラブルが多発し、Codexも対応に苦慮している様子でした。インストール後もそのままだとwebUIが起動しなかったので、StabilityMatrix画面のエラーログを貼り付けてこのように頼むのを何度か繰り返して、普通に使えるようになる…という感じでした。
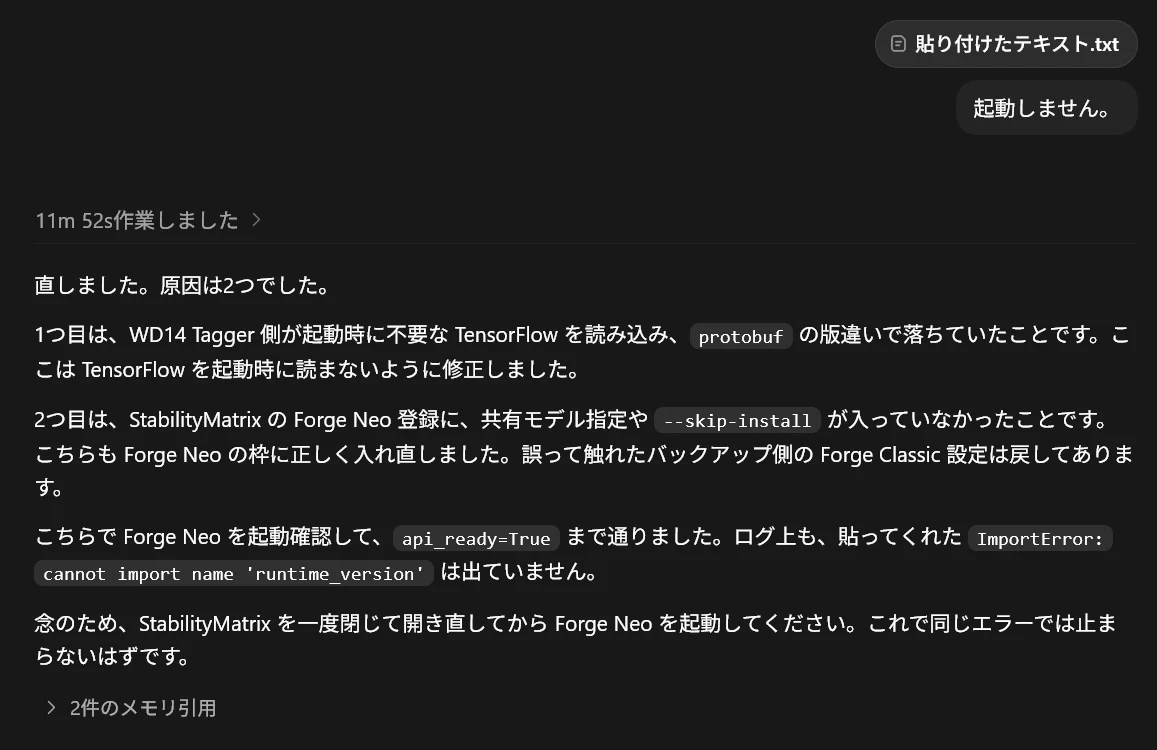
「dataset tag editor」や「supermerger」といった拡張機能はやはり一部使えず。このあたりの導入方法についてはあとで詳しく説明しますが、ForgeNeoに対応しているフォーク版(本家から枝分かれした別バージョン)を探して代わりに使うか、Codexで改修する必要があります。

4.Animaモデルをダウンロードしよう
StabilityMatrixでForgeNeoを入れただけでは、Anima生成はまだできません。モデルにテキストエンコーダとVAEが同梱されており、checkpointを一つ読み込めばすぐ生成できたSDXL系と違い、Animaに必要なファイルは3種類あります。全部で5.6GBほどのサイズです。
・anima-base-v1.0.safetensorsなど:モデル本体。マージモデルも各種あり
・qwen_3_06b_base.safetensors:テキストエンコーダ。SDXLより高性能
・qwen_image_vae.safetensors:VAE。推論結果を人間が見える絵に変換する
<ファイルのダウンロード先>
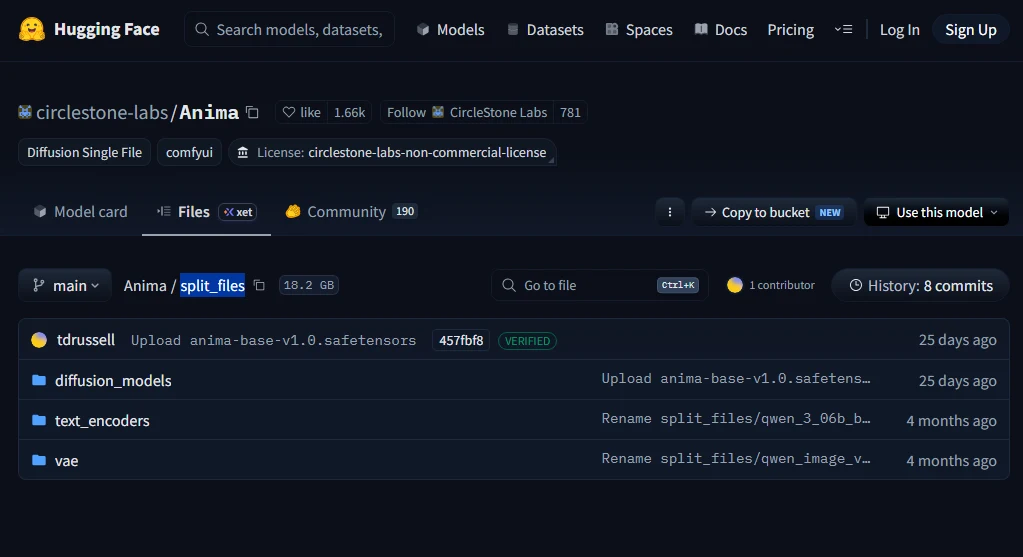
三つのファイルはいずれもこちらの公式HuggingfaceからDLすることができます。
画面上部の「Files and versions」を開き、「split_files」をクリックすると下図のような画面が表示されます。あとはそれぞれのフォルダに「anima-base-v1.0.safetensors(4.18GB)」、「qwen_3_06b_base.safetensors(1.19GB)」「qwen_image_vae.safetensors(254MB)」が収められていますので、それぞれDLしましょう。
(※既にComfyUIなどでQwen系の画像生成をしていて、qwen_3_06b_base.safetensorsやqwen_image_vae.safetensorsを入手している場合、重複してダウンロードする必要はないので、既存ファイルを流用しましょう)
<各ファイルの保存先>
StabilityMatrixでForgeNeoを導入した場合、webUI固有のModelsフォルダは「StabilityMatrix\Data\Packages\ForgeNeo\Models」です。AnimaをForgeでしか使わない場合はこちらに保存してもよいですし、別のwebUIでも使いたい場合は、StabilityMatrixで導入した各パッケージで共有するモデルフォルダ「Data\Models」を使います。Modelsフォルダの中に「StableDiffusion」「LoRA」「Controlnet」などのフォルダが小分けになっていますので、3つのモデルを以下のフォルダにダウンロードしてください。
・anima-base-v1.0.safetensors
→models\StableDiffusion
・qwen_3_06b_base.safetensors
→models\TextEncoders
・qwen_image_vae.safetensors
→models\VAE
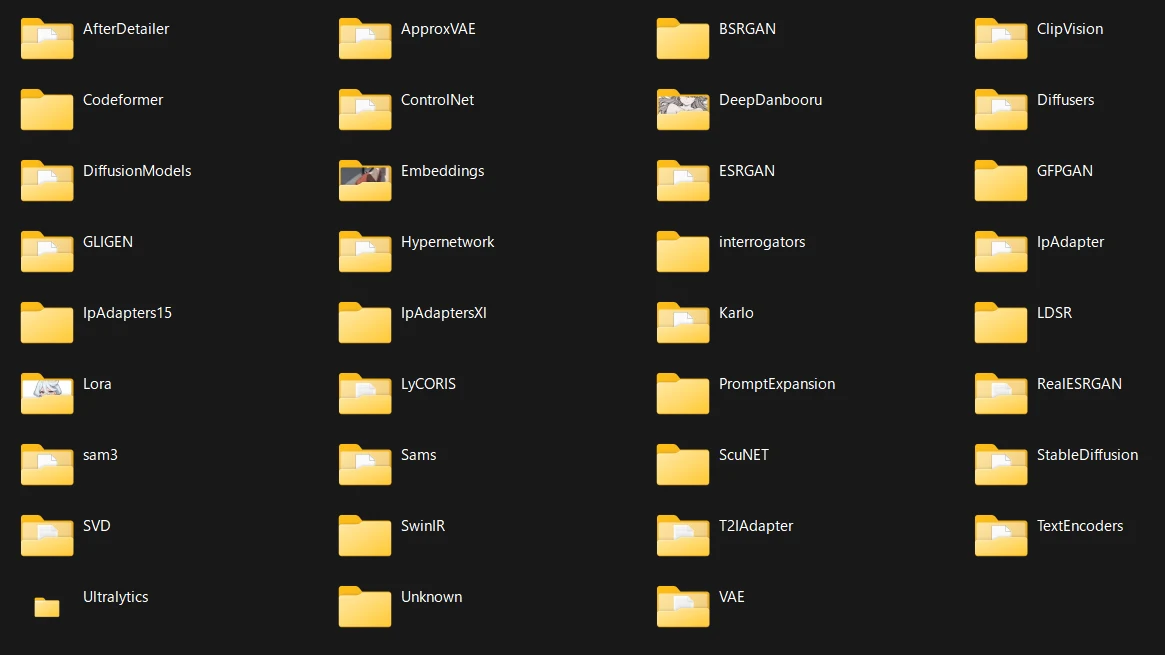
環境によってはその名前のフォルダがModelsフォルダ内に準備されていない場合がありますので、その場合は自分で同名フォルダを作成してください。
<マージモデルも登場>
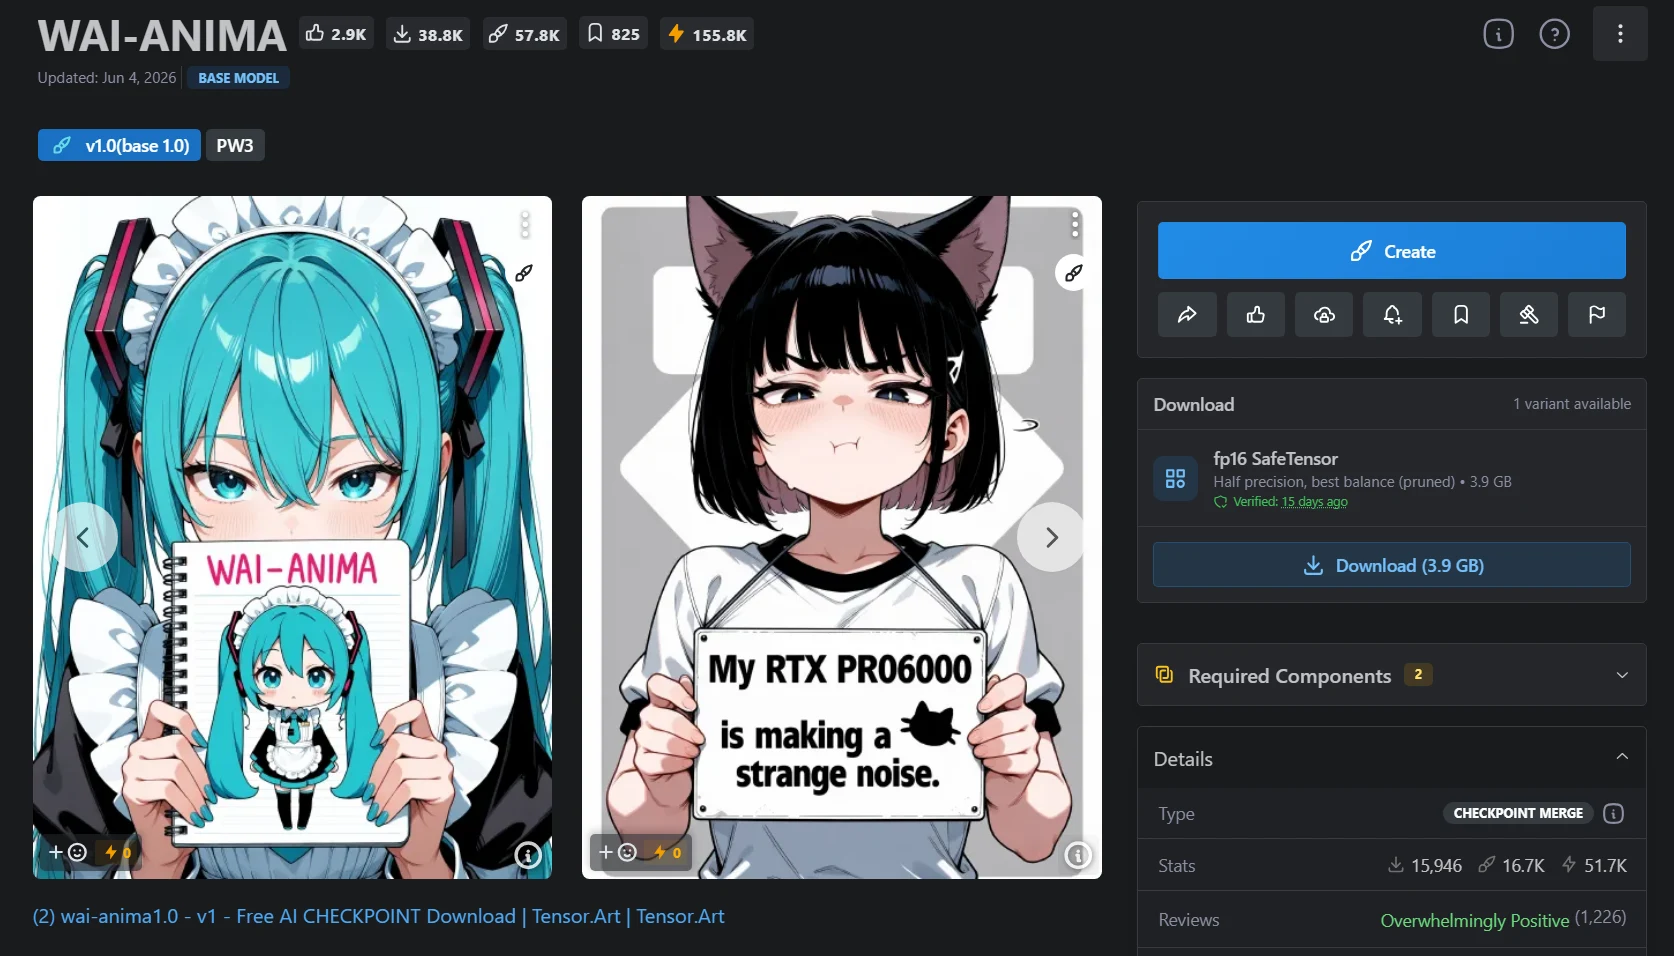
ベースモデルのanima-base-v1.0をさまざまなスタイルにファインチューニングしたA派生モデルもCivitaiなどで流通し始めています。anima-base-v1.0は画風が暴れがちなので、一貫性のある画風で生成したい場合は以下のようなマージモデルを試してみるのもよいでしょう。
【WAI-WANIMA v1.0】
SDXLで人気だった「WAI」シリーズのAnima版。WAI-illustrious-SDXLに似たパキッとした高精細なアニメスタイルで、ベースモデルに比べ安定した画風での生成が可能です。
【JANIMA v1.0】
anima-base-v1.0と同じステップ数で、より精細で正確な画像を生成できるよう調整されたモデル。WAIと異なり一定の画風に調整していないので、LoRAを適用するためのベースとしてもうまく機能するとのこと。

5.Animaは「非商用ライセンス」
Animaを利用する前に、こちらのライセンスを必ず熟読しておきましょう。最初に確認しておきたいのは、
①Animaは「非商用」を前提としたモデルである
②ただし、出力した画像の商用利用は可能である
…というポイントです。
当初、Animaの権利表記は商用利用禁止の及ぶ範囲が分かりにくかったのですが、ライセンスが先日「CircleStoneLabsNon-CommercialLicensev1.1」にアップデートされ、より明確な内容になりました。
ライセンス本文はまず、「モデルをダウンロード、アクセス、使用、配布、または派生作品(マージモデルやLoRA等)の作成を行うことにより、本ライセンスの条項に同意したものとみなされる」ということを確認した上で、「モデル本体と派生物(マージモデルやLoRA等)に対するアクセスや使用、派生物の作成、配布は、非営利目的のみに限り許可する」としています(上記①)。
ただし、「生成物(outputs)は派生物には含まれない」とし、「CircleStoneLabsは生成物に対する所有権を主張せず、ユーザーはライセンス上明示的に禁止されている場合を除き、生成物を商用目的を含む任意の目的で使用できる」となっています(同②)。
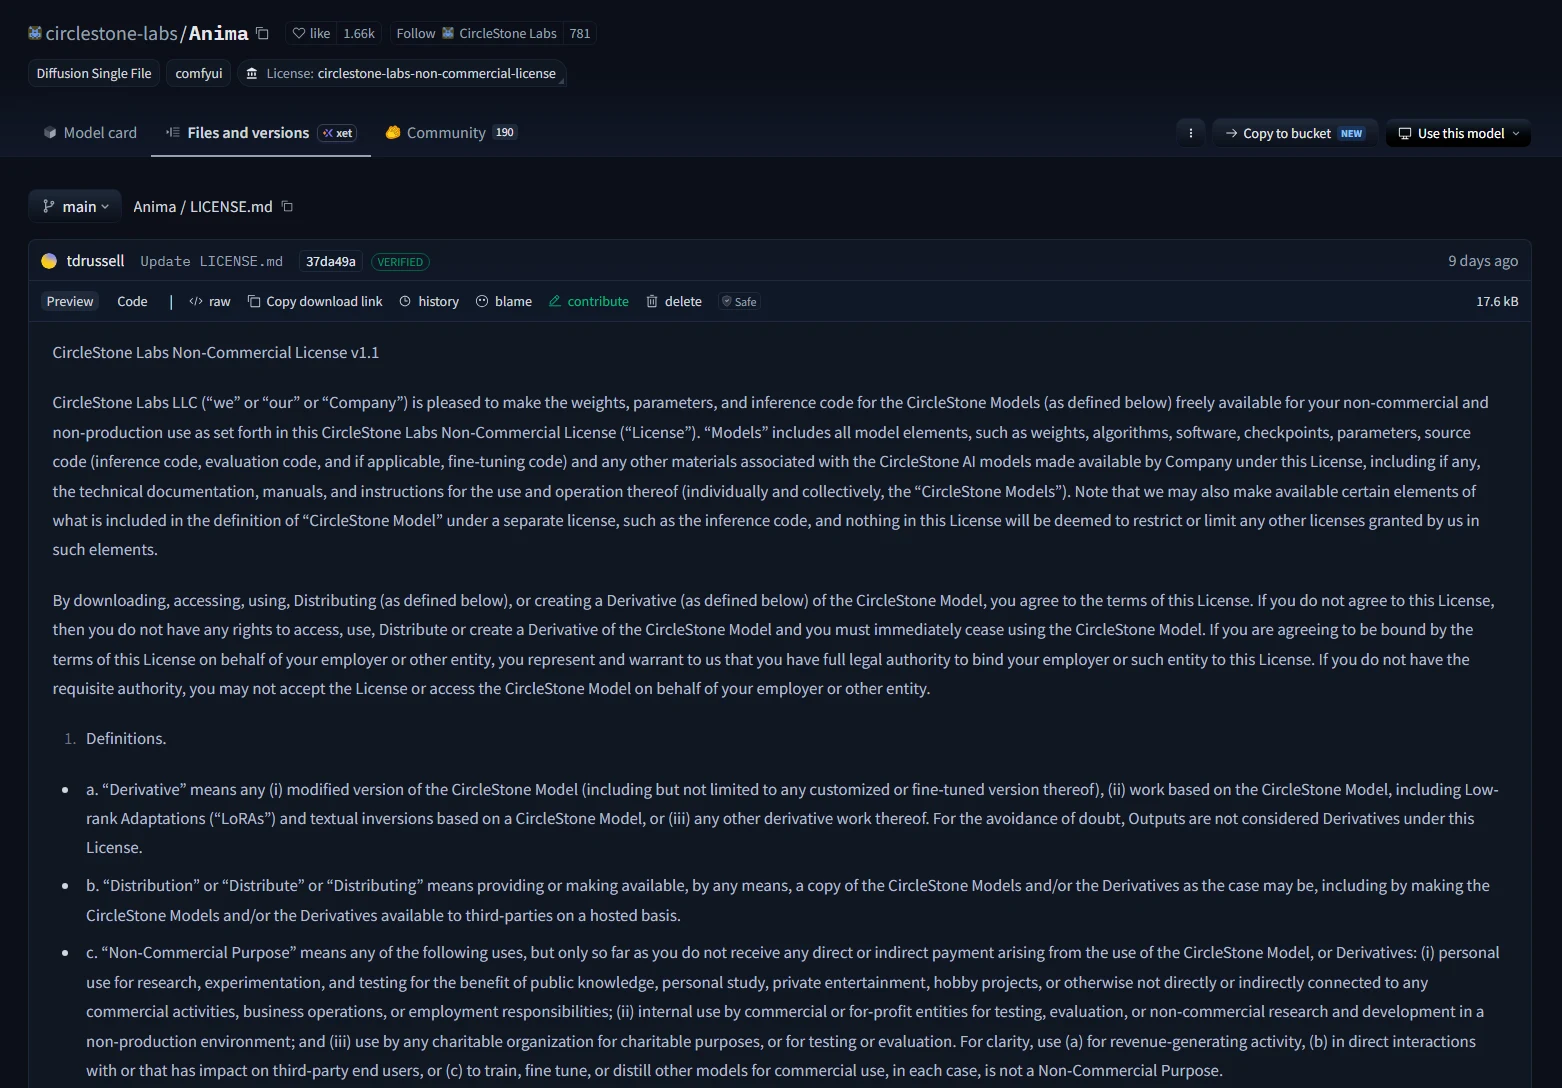
よって、商用販売する記事や漫画、ゲームなどにAnima生成画像を使うこと自体は、v1.1の文面上は許可されていると読めます。一方で、Anima本体やAnimaを改変した類似モデルを商用アプリに組み込んだり、Animaをもとに学習したLoRA、Controlnetなどを販売したりするのは禁止ということになります。
専門家ではないので断言はできませんが、簡単にまとめると以下のように理解できそうです。
・Animaで生成した画像を販売、商用利用する(同人誌、ゲーム、書籍等)
→可能そう
・Animaの派生モデル・マージモデルを販売する
→不可と考えるべき
・自己使用用途のAnima用LoRAを作る
→可能そう
・Anima用LoRAを無料配布する
→非商用目的であれば可能そう(ライセンス表示などの条件を満たす必要あり)
・Anima用LoRAを販売する
→不可と考えるべき
このあたりは、SDXL系のオープンモデルとかなり感覚が違うので注意が必要です。また、ライセンスには生成物の利用について、第三者の権利侵害や違法コンテンツの生成をしないこと、適用法令を守ることなども当然求められています。これは他の生成AIモデルでも同じですが、商用利用可能だからといって、既存キャラクターや実在人物、商標、ロゴ、他人の著作物などに関するリスクが消えるわけではありません。
<マージモデルの利用は?>
さきほどWAI ANIMAの紹介をしましたが、マージモデルを利用する場合はその配布者によるライセンスの影響も当然受けますので、Animaのベースモデル規約とは別に参照しておくようにしましょう。
WAI-ANIMAはAnimaの派生モデルなので、Anima本体のCircleStone Labs Non-Commercial License v1.1を継承しています。機械翻訳ですが、Civitai上ではこのように表示されています。
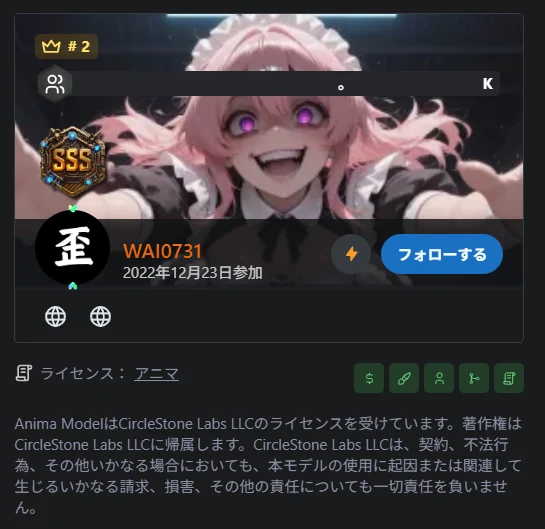
よって、「WAI-ANIMAというマージモデル自体を商用OKとして配布する」とか「WAI-ANIMAを有料生成サービスに組み込む」、「WAI-ANIMAをベースにしたマージやLoRAを商用利用可と表示して売る」といった行為はAnimaライセンスv1.1違反になると考えられます。ただし、WAI ANIMAの生成画像はAnimaのベースモデルと同様に派生物に含まれないので、商用利用可能と読むのが妥当かと思います。
商用・非商用の境目やライセンスに抵触するかどうかの判断は素人には難しいため、ここでは「~と読むのが妥当そう」程度の個人的感想にとどめます。Anima系モデルの商用利用をお考えの方は、まず専門家に相談することをおすすめします。

6.ForgeNeo上でAnimaを読み込む
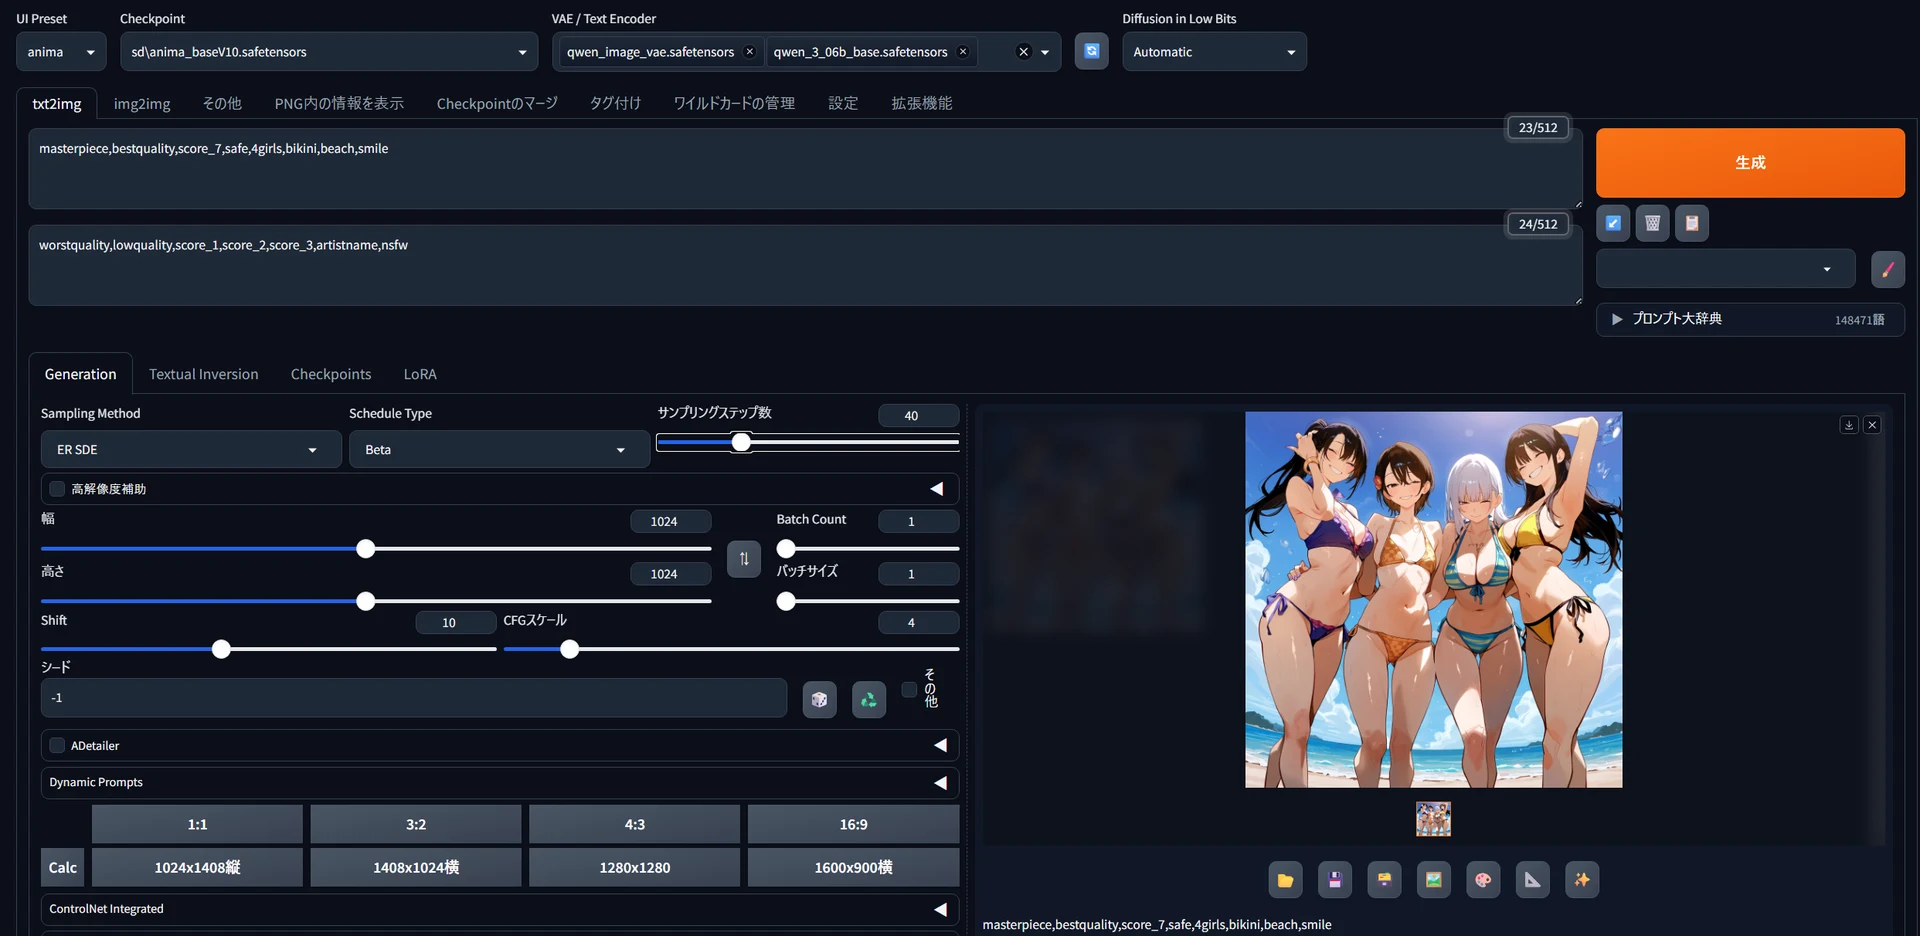
さて、ファイル配置が終わったら、ForgeNeoを起動します。画面上部にある「UIPreset」でSDXLやQwen系、Flux、Wan、そしてAnimaなどの生成画面を切り替えることができますので、ここでは「anima」を選択します。
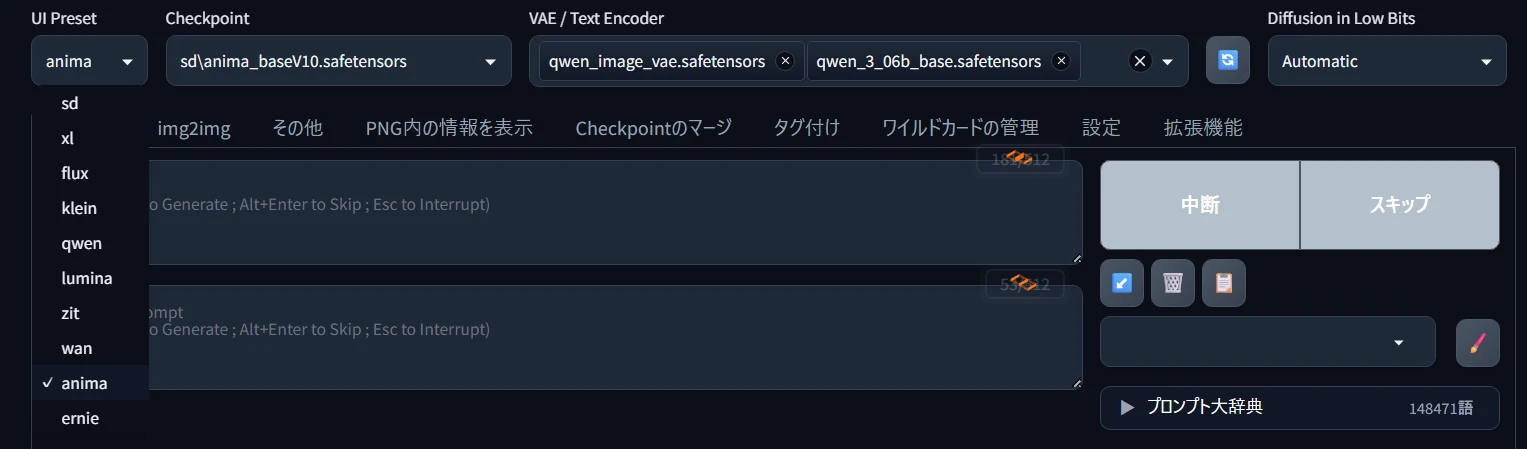
Checkpoint欄からanima-base-v1.0.safetensors(もしくはWAI ANIMAなどのマージモデル)を選択。さらに、VAE/TextEncoderの欄で、qwen_3_06b_base.safetensorsとqwen_image_vae.safetensorsを選択したら、これでAnima生成の準備ができました。まずはデフォルト設定のままで簡単なプロンプトを入れて、生成できるか試してみましょう。
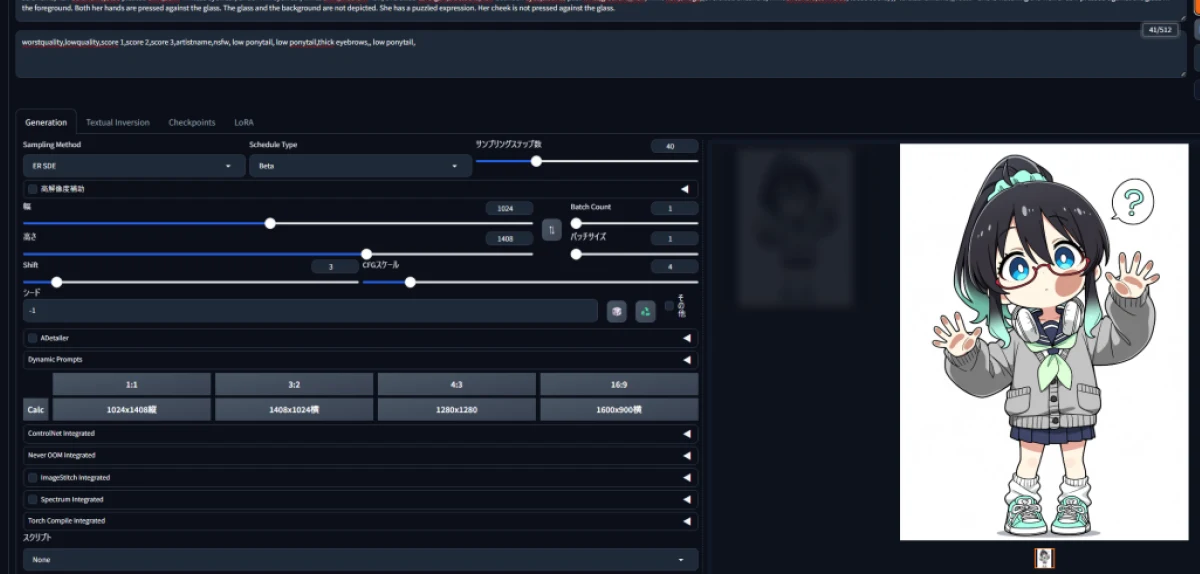
PP:masterpiece,best quality,score 7,safe,4girls,bikini,beach,smile
NP:worstquality,lowquality,score 1,score 2,score 3,artist name,nsfw
画像が出ればForgeNeo&Animaの導入は成功です。まずはお疲れさまでした!
<トラブルシューティング>
もし画面上部の一覧に必要なファイルが表示されなかったり、生成ボタンを押したあとにエラーが出たりした場合は、まず次の点を確認してください。
・保存したモデルとファイル名は正しいか
・保存先のフォルダ位置は正しいか
・左上の「UIPreset」がanimaになっているか
・画面上部のモデル更新ボタン(🔄️)を押したか
・VAE/TextEncoderに2つのファイルがちゃんと選択されているか(名前の似た別のQwen系モデルではないか)
・ファイルを配置したあと、ForgeNeoを再起動したか
ファイルを正しいフォルダに配置しているはずなのにWebUI上で表示されない場合は、いったんForgeNeoを完全に終了して再起動してみましょう。難しいエラーが出た場合は、animaではなくForgeNeo側のインストールミスの可能性もありますので、StabilityMatrixや黒いターミナル画面に表示されたログをChatGPTなどに貼って解決策を聞いてみるのがよいでしょう。

7.Animaの基本設定
AnimaはSDXL系とは推奨設定やプロンプトの書き方に違いがありますので、ここでまとめて解説します。基本的にはこちらの公式解説そのままです。
・解像度
公式では、512px四方から1536px四方程度までの解像度で動作するとされており、illustriousXL系と同じ感覚です。最初は、いきなり大きなサイズにせず、1024x1024、832x1216、1024x1408あたりから試すのがよいと思います。
・Steps / CFG
公式の推奨は、Stepsが30〜50、CFGが4〜5程度です。まずはSteps30、CFG4.5あたりを基準にして、好みに応じて調整するとよさそうです。AnimaはSDXLより生成に時間がかかるので、できるだけStep数は低めにして、本番生成の時だけ上げるのが良いと思います。後述する高速化LoRAを使うと、10ステップ程度で収束させることも可能です。
・Shift
これは生成プロセスの序盤と終盤、どちらに処理の配分を多く割くかを調整するForgeNeoの機能です。
高い値(14〜24など)にすると、 序盤の「大まかな構図を決める工程」に時間をかけるので、解像度が高いイラストでも全体像が安定しやすくなります。逆に、細部の描画をきれいにしたい場合は低めにします。デフォルト値は3なので、細部の描画に時間を掛ける設定になっています。
・サンプラー(sampling Method)
Animaでは複数のサンプラーが使えますが、デフォルトの推奨サンプラーは「ER SDE」。ほかに「Euler a」や「dpmpp 2m sde gpu」も公式推奨ですが、後者はForgeNeoに未導入のようです。
こちらが簡単な比較画像。er_sdeはニュートラルで線がシャープになりやすく、標準設定として扱いやすい印象。euler_aは少しやわらかめで、線が細くなる印象があります。
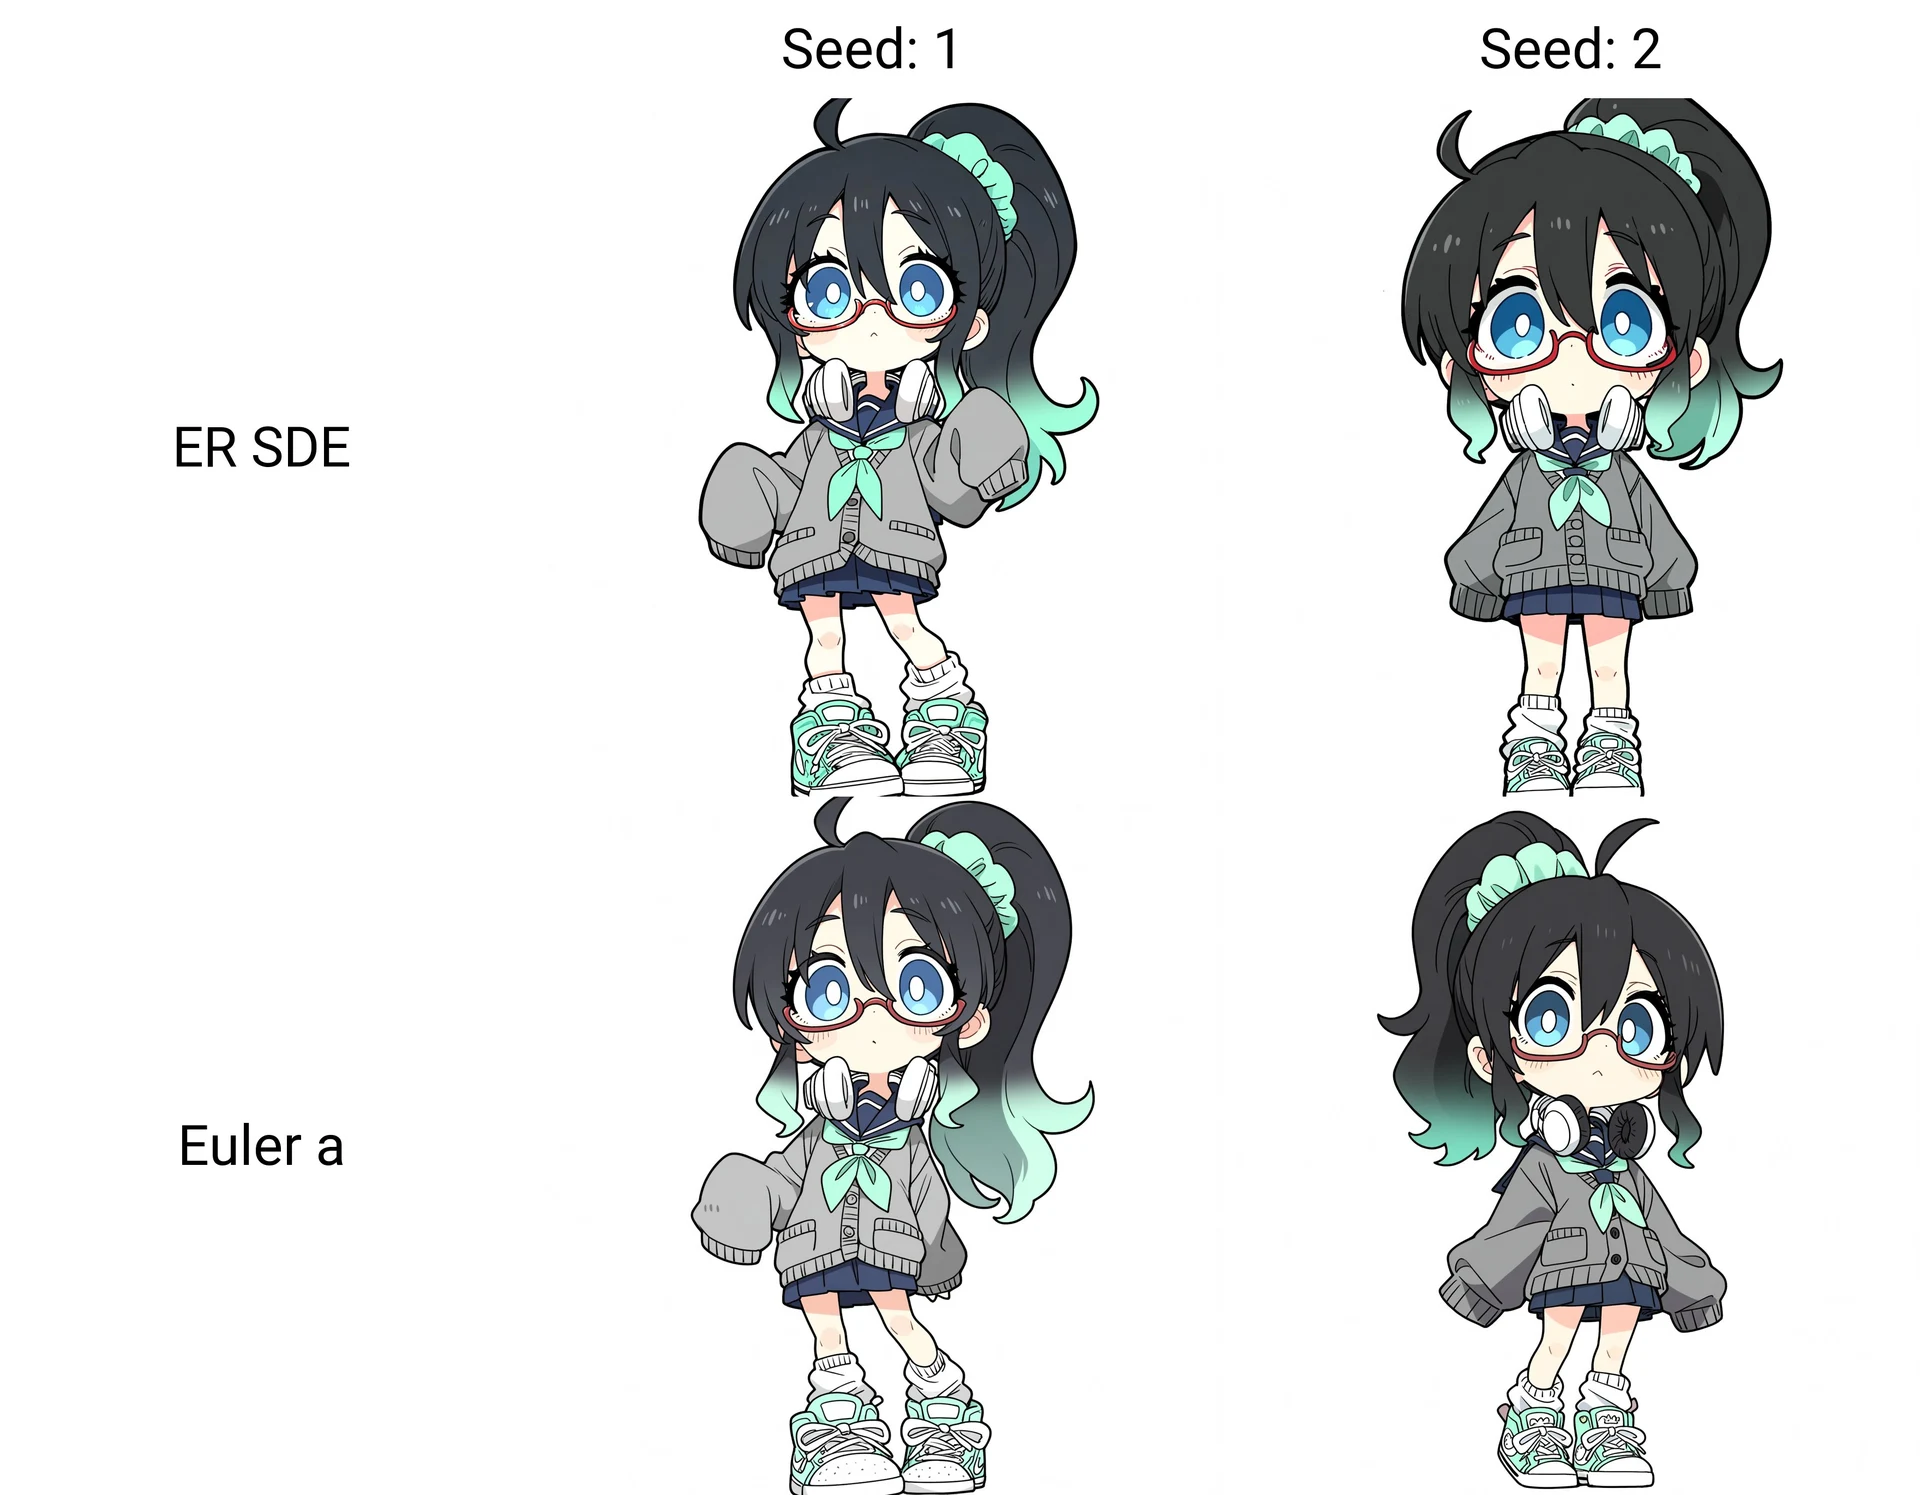
とはいえ、これだけじゃ何もわかりませんね。まずは同じSeedであれこれサンプラーを切り替えて、描線や色味の違いを見てみるのがよいでしょう。
・スケジューラ(Schedule Type)
サンプラーのノイズ除去のペース(スケジュール)を調整する機能。Animaでは基本的に「Simple」か「Beta」あたりがおすすめ。サンプラーとの組み合わせによっては破綻してしまうので、あまり冒険しないほうがよさそう。
・Hires.fix(高解像度補助)
アップスケールの基本、Hires.fixも普通に使うことができます。WAI ANIMAのおすすめ設定をそのまま紹介しますが、サイズは1.5倍程度が推奨で、ステップ:20、アップスケーラー:R-ESRGAN 4x+ Anime6B、ノイズ除去強度:0.35~0.5あたりが基本。SDXL時代と同様、lanczosやAniScale2_Omni_i16_40Kなど、好みのものを代わりに使うのもよいでしょう。
ForgeNeoにはreForgeなどと同梱されているHiresアップスケーラーの種類が違います。R-ESRGAN 4x+ Anime6Bが同梱されていない場合は、こちらから「RealESRGAN_x4plus_anime_6B.pth」をDLし、「ForgeNeo\models\ESRGAN」に追加しておきましょう。
画像サイズを大きくしすぎたり、ノイズ除去強度を高くしすぎたりすると、細部が破綻したりノイズが逆に増えたりするのでご注意を。
<TIPS①:高速化について>
通常、Animaモデルできれいな絵を得るには30〜50ステップ必要ですが、公式から高速版チェックポイント「Anima-Turbo」が公開され、8〜12ステップ程度で生成結果が収束するようになりました。公式も「画質低下はAesthetic比でわずかなので、まずTurboから試すのがおすすめ」という立場です。ただし、CFGを1にする関係で基本的にネガティブプロンプトが使えなくなる上、生成内容はBase使用時とは違うものになります。
ファイルはBaseと同じ公式Huggingfaceの「split_files▶diffusion_models」から「anima-turbo-v1.0.safetensors(4.18GB)」をDLし、Baseと同じmodels\StableDiffusionフォルダに保存してください。
LoRAと違ってプロンプト欄への記述は不要で、Checkpoint欄でBaseの代わりにTurboを選ぶだけ。VAE/TextEncoderの2ファイルはそのままでOKです。使用時の設定はSteps:8〜12、CFG:1。サンプラーはer_sdeやEuler aなどが公式推奨です。
・高速化LoRAについて
公式による高速化LoRA「Anima Turbo LoRA」を使うことでも、10ステップ程度で生成結果が収束します。上記高速化モデルの公開に伴って現在は古い手段となりつつありますが、使い慣れたマージモデルを高速化したい場合は、高速化LoRAを適用する方式が引き続き唯一の選択肢です。
LoRAの配布先はこちら。普段のLoRAと同様、いつものmodels/LoRAフォルダに保存してください。
あとはプロンプト欄に<lora:anima-turbo-lora-v0.2:1>と記入して適用するだけです。ただし、使用する際はCFGを「1」にすること。サンプラーはEulerもしくはEuler aが推奨されています。
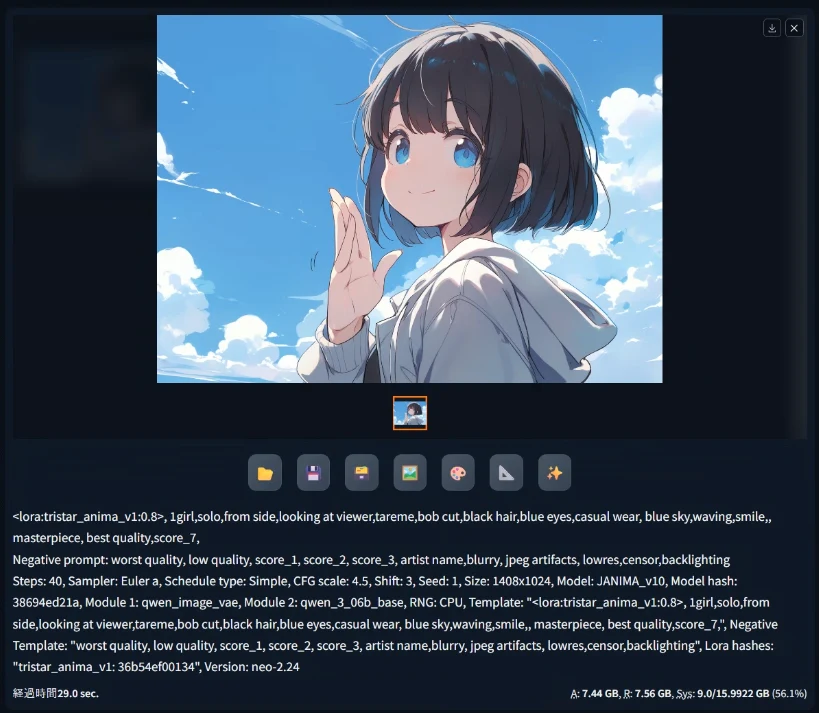
実際にやってみましょう。まず、LoRAなしで40step回すとこんな感じの画像が生成できるとします。生成時間は左下にある通り、29秒。
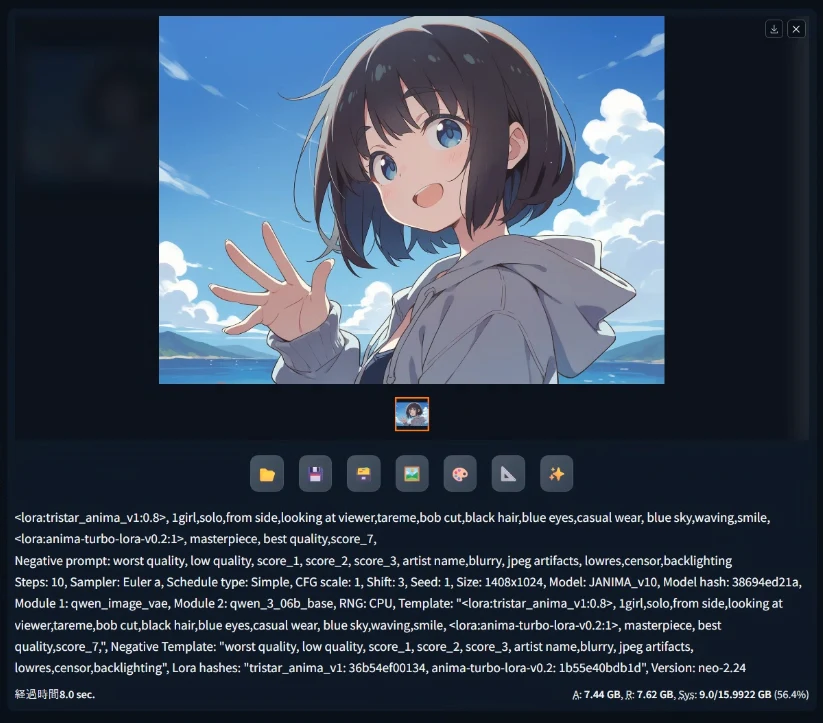
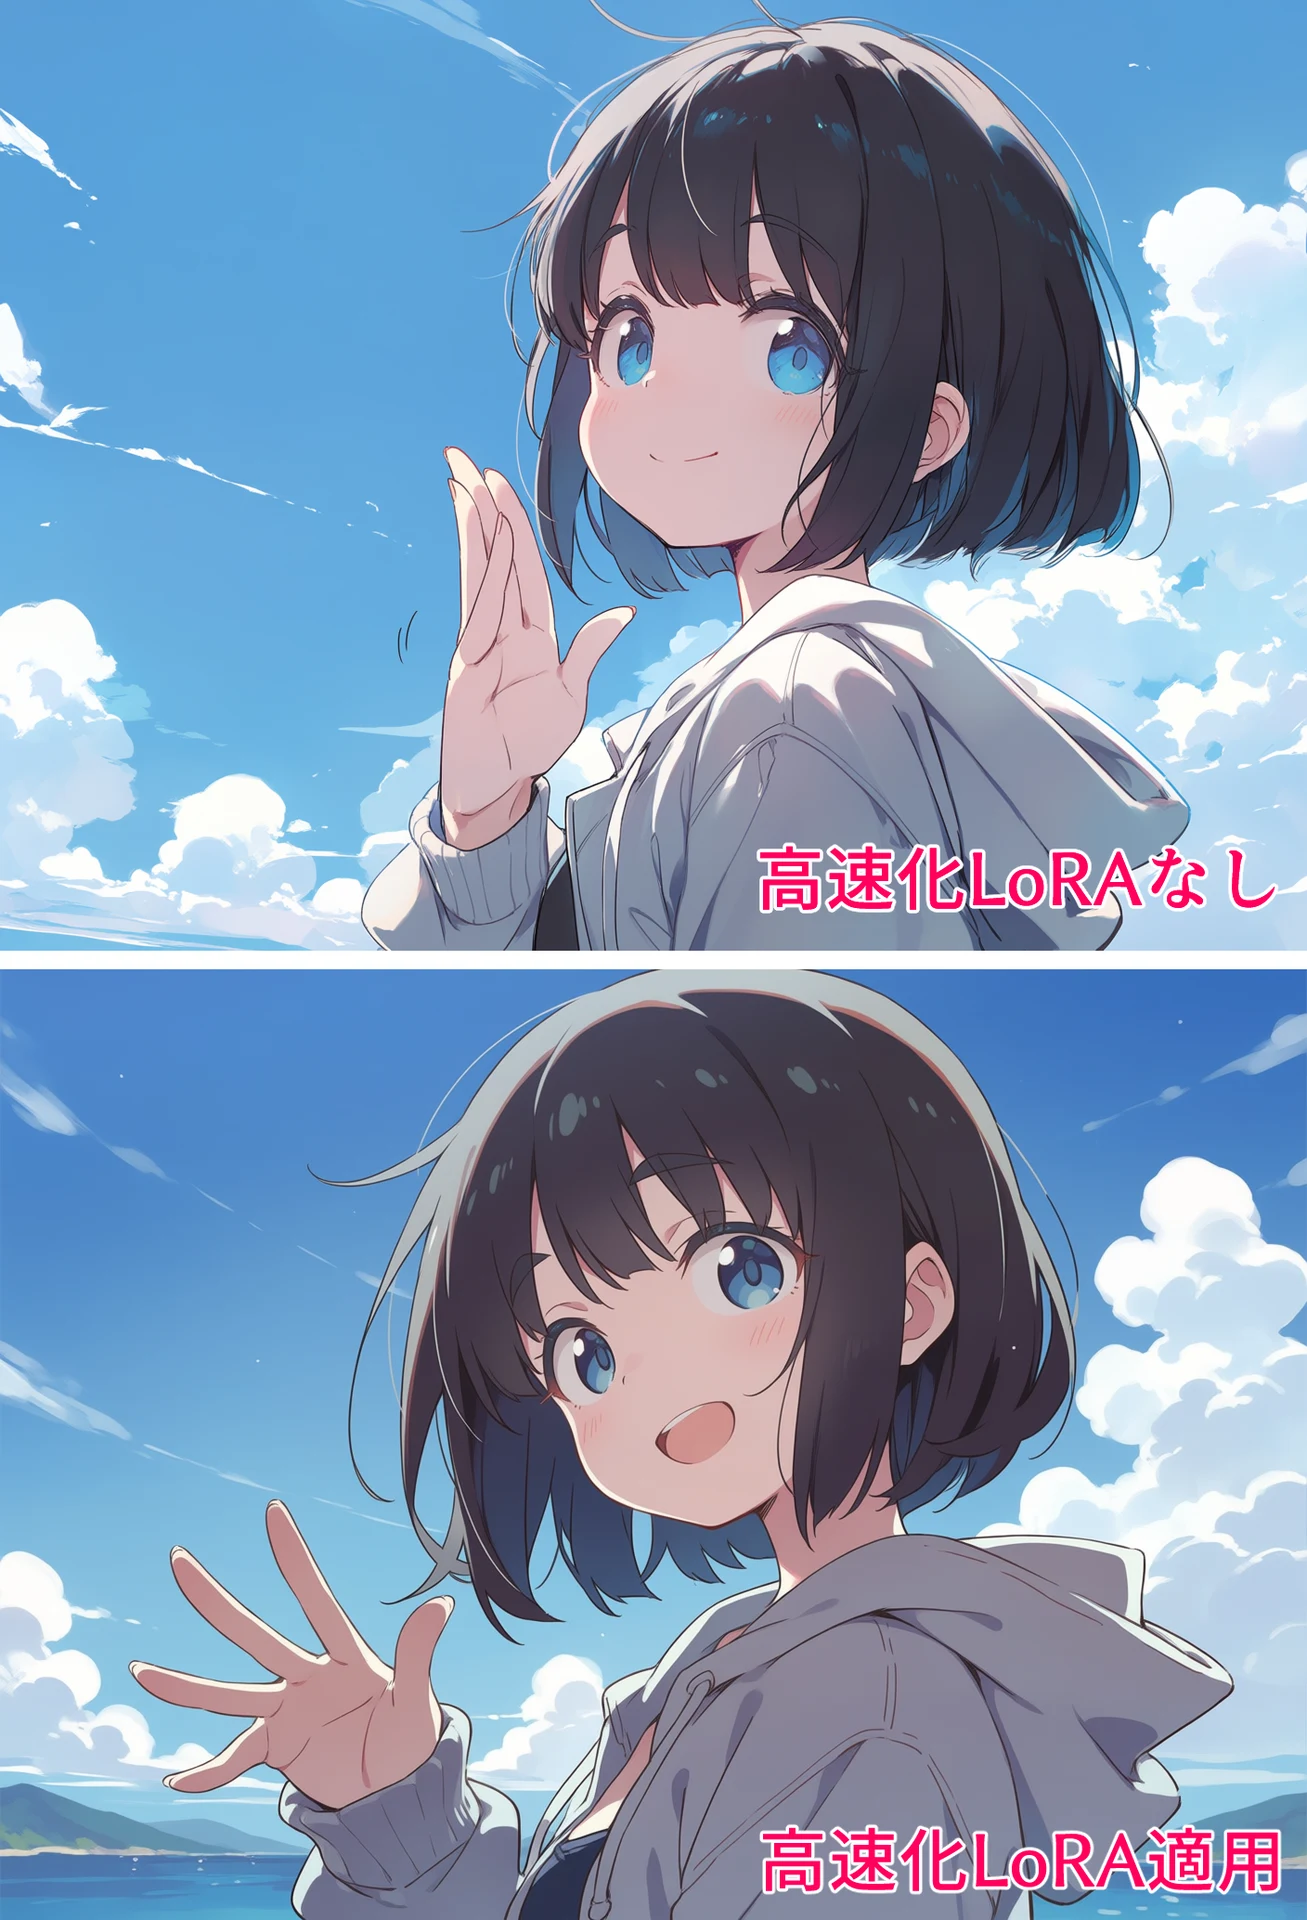
プロンプトなどは全く同じのままで、高速化LoRAを適用してみます。CFGを4.5から1に変更し、プロンプト欄に<lora:anima-turbo-lora-v0.2:1>を追記。すると、こちらが8秒程度で生成できました。高速化LoRAなしだと40ステップで29秒掛かったので、3~4倍早いですね。(ネガティブプロンプトが記入されていますが、生成結果に反映されません)
生成結果は当然高速化しない場合に比べて変化するので、Animaに触りたてでとにかくいろいろ試してみたいときに使うとよいでしょう。プロンプトが決まって本番生成するときは外したほうが高品質になります。(CFGとステップを元に戻すのを忘れずに!)
<TIPS②:高速化LoRAに関する現時点の知見>※随時更新
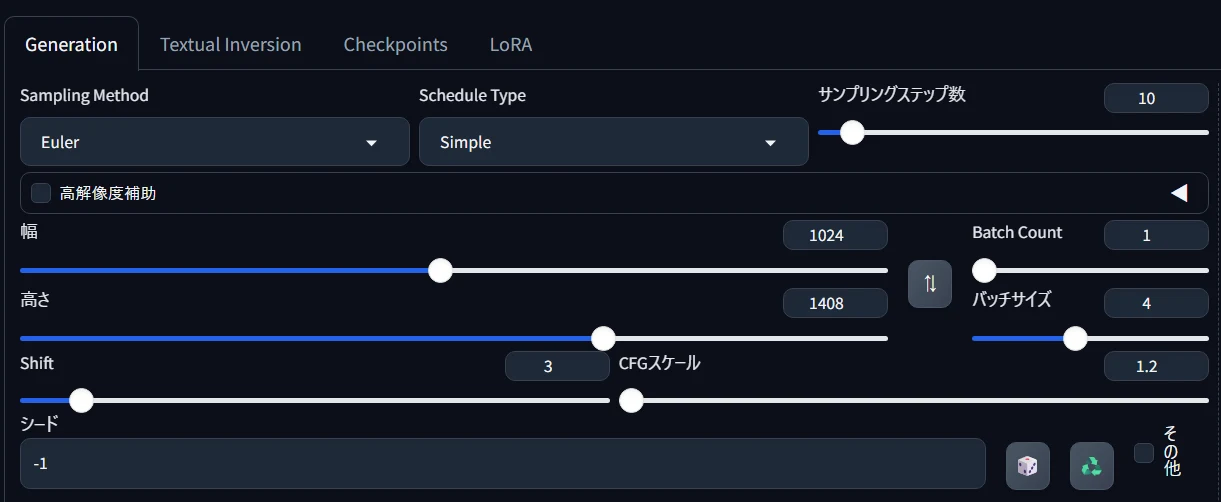
高速化LoRA適用時はCFGスケールを大幅に下げないと、彩度が高すぎて焼き付いたような絵になります。しかし、CFGを最低の1にするとネガティブプロンプトが利かなくなるため、予想しないオブジェクトが生じやすいAnimaがさらに扱いづらくなってしまいます。あれこれ試したのですが、CFGを1.2~1.5程度に、高速化LoRAの適用度を0.8程度に下げることで、高速化しつつネガティブプロンプトも多少効くようにする、というテクニックが通じるようです。
<TIPS③:設定が定まったら初期値を更新しよう>
しばらく触っていると、だいたいいつも使うであろうサンプラーやスケール、ステップといった設定が見えてきます。そうしたら、忘れずに「設定▶その他▶Defaults」でそのパラメータを初期登録しておきましょう。特に、Hires.fix(高解像度補助)は初期設定が「Latent・2倍・ノイズ除去強度0.7」というSD1.5仕様なので、無難なデフォルト設定に変更しておかないとガビガビにアップスケールされてしまいます。
デフォルト値変更のやり方はこちらの記事の1番目に記載していますので、やったことがない方はご参照ください。
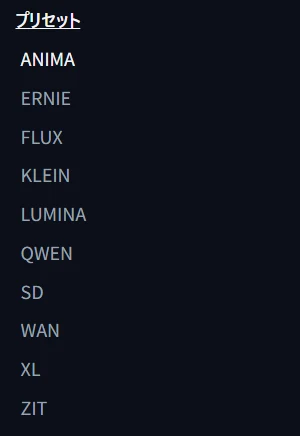
また、ForgeNeoでは設定画面にある「プリセット」メニューから、各モデルごとの初期値を設定することができます。
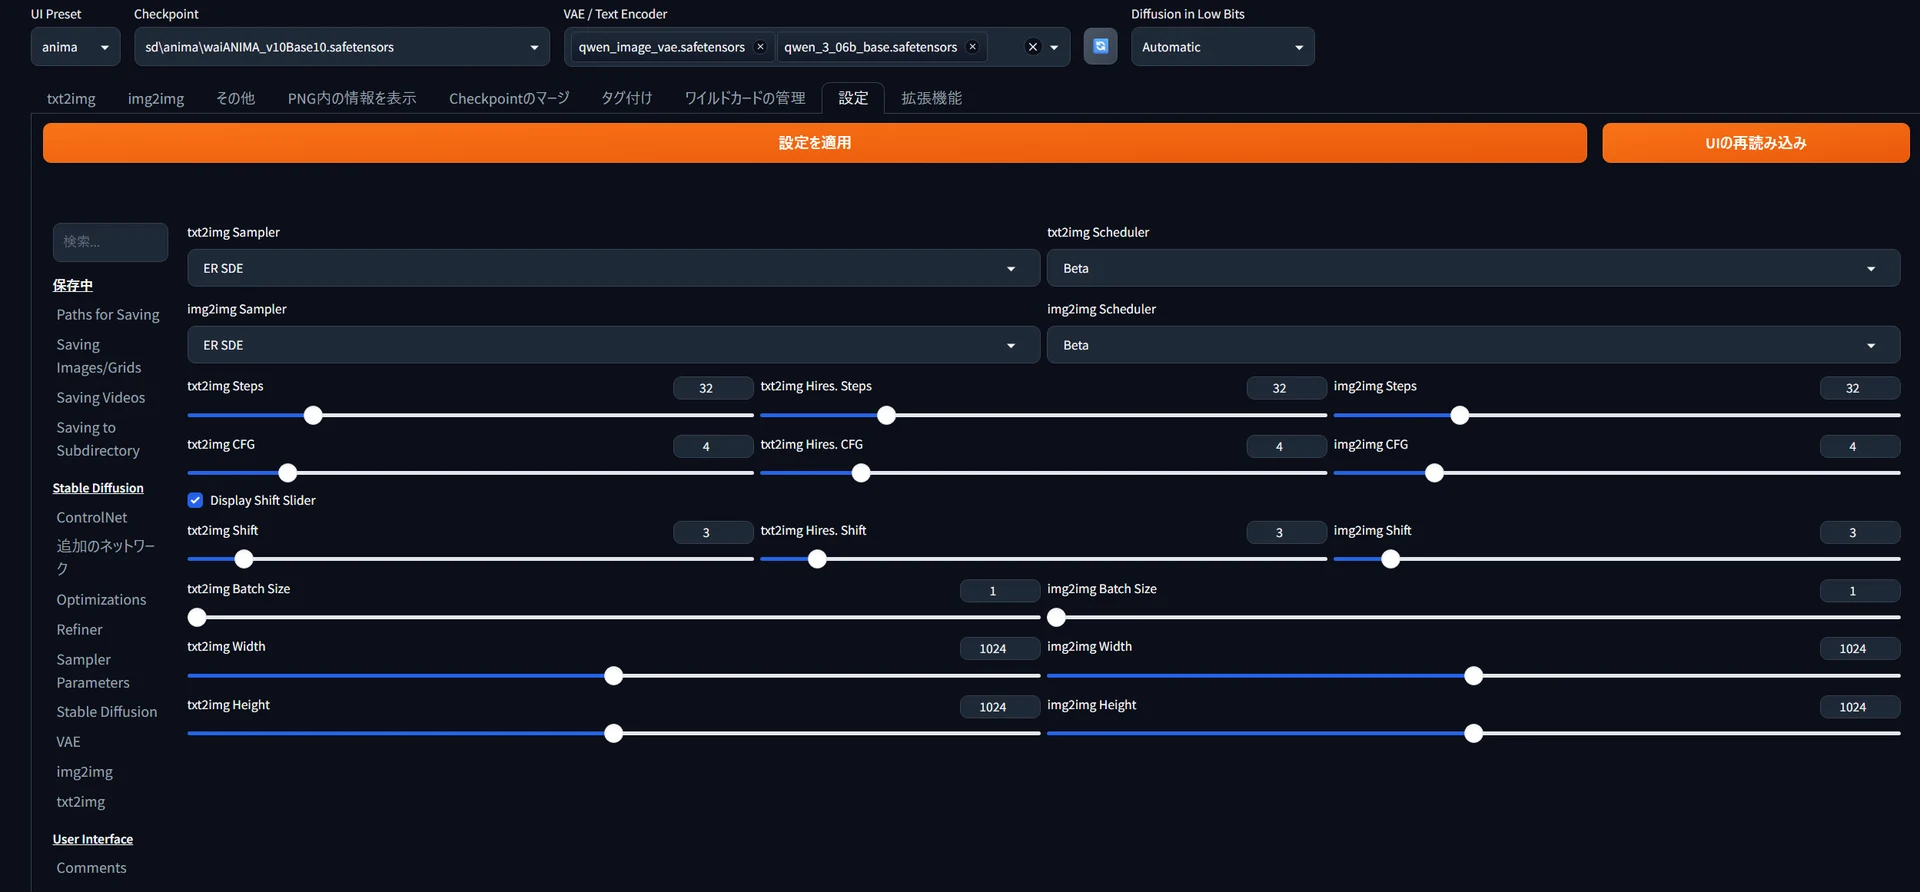
このように、最初に表示されてほしいパラメータを入力して「設定を適用▶UIの再読み込み」をするだけですので、Defaultsからいじるよりこちらの方が簡単かもしれません。

8.Animaのプロンプト記述法
AnimaはDanbooru風タグと自然文の両方に対応しており、併用も可能です。Qwen系のテキストエンコーダを使っているので、illustrious系よりも遥かに自然文指示が通りやすくなっています。
<注意1:アンダースコアと半角スペースが重要>
Animaでは半角のアンダースコア「_」ではなく、半角スペースで区切ったタグが推奨されています。「black_hair」ではなく「black hair」とするのが正式ということですね。また、Danbooru式ではタグ同士の間をカンマで区切りますが、カンマの後に半角スペースを入れないとさまざまな不具合が起こります。
つまり、「1girl,black hair,ponytail,」と詰めるのではなく「1girl, black hair, ponytail, 」とすべきということです。自然言語の場合は、「2girls are standing in the classroom.」ではなく「2 girls are...」になる点に注意が必要です。
この半角スペースルールを守らないと、自然言語プロンプトと混同されたり、別の特徴量を呼び出したりして、指示していない挙動をする恐れがあります。例えば、「1girl, solo, looking at viewer~」と半角開けるべきところを「1girl,solo,looking at viewer~」と詰めてしまうと、solo focusと内部的に誤認するのか、Animaはメインキャラ以外に小さい動物や人物の写り込みを描こうとします。
・プロンプトを自動整形してくれる「Prompt Format」
とはいえ、手打ちで完璧に記述するのは難しいので、ここは拡張機能に頼るのがオススメ。Haoming02氏のこちらの拡張機能を入れると、カンマや半角スペースの誤記述を自動で整形してくれます。webUIの「URLからインストール」でhttps://github.com/Haoming02/sd-webui-prompt-formatと入れるだけです。
生成開始ボタンをクリックするたびに、重複したスペースやカンマを削除してくれます。アンダースコア(_)を置き換えることもでき、設定の「Prompt Format」欄からオンオフできます。black hairが二つあるようなケースでも片方を自動で消してくれます。
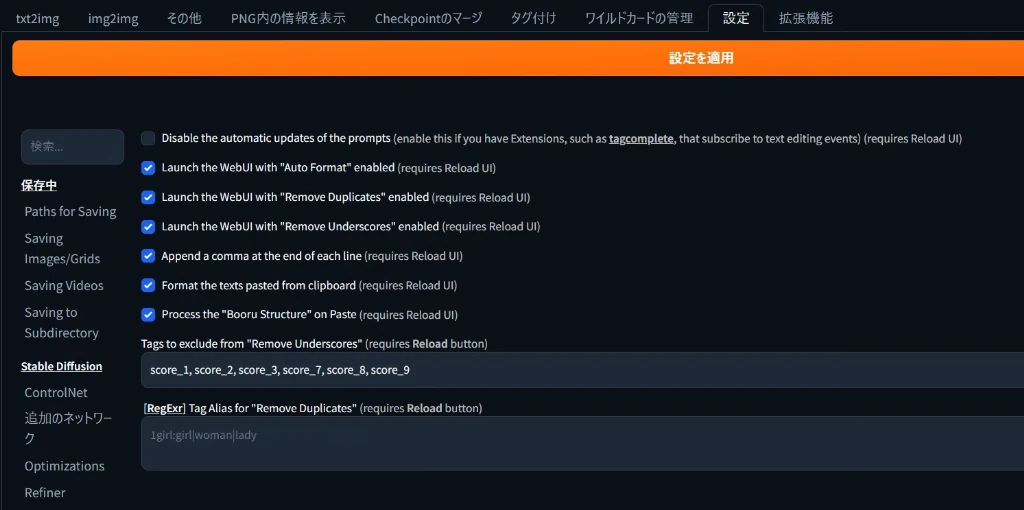
Animaは「score_9」などのクォリティタグだけアンダースコアを使用するルールのため、上の図のように「Tags to exclude from "Remove Underscores" 」に入れておけばこれらのタグだけは置き換え対象外となります。
wildcardを呼び出すときに__wildcard__のように記述しますが、このときはちゃんとアンダースコアを除去せず残してくれます。ただ、wildcard名に「__wild_card__」のようにアンダースコア含みだと、「wild card」というタグとして整形してしまう現象が起こります。wildcard名にアンダースコアを使わないか、Codexなどで改修するとよいでしょう。
<注意2:Animaは短文指示だとエロくなる>
最初に注意しておきたいのは、SDXLのノリで「1girl」だけで生成すると、Animaはsafeを入れようがなにしようが、やたらムチムチ♡なエロ画像を放出してくるということです。WAI illustrious SDXLもそういう感じでしたが、safeやgeneralといったタグでは制御し切れないほどHにする傾向が強いです。(下図でもかなり抑えたほう)
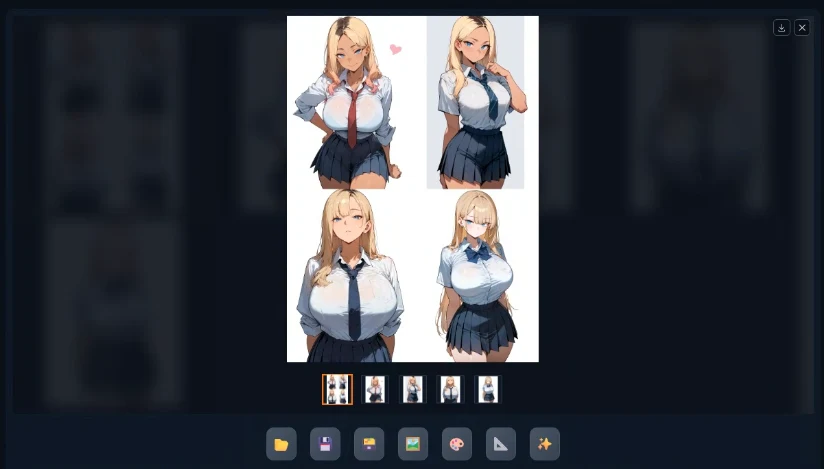
公式の説明では、「純粋な自然文で書く場合は、短すぎるプロンプトよりも、2文以上で具体的に書いたほうがよい」とされており、手がかりが少なすぎると「女の子といえば…エロでしょ!」と学習内容通りに生成してしまうということのよう。もう少し何を生成したらいいか判断できるよう、「standing,tachi-e,white background,shirt,skirt」とか「She's a blonde, blue-eyed girl wearing a school uniform and looking at the viewer.」などと指示してあげるとよくなります。
<プロンプトの語順>
Danbooruタグだけで書くなら、次のような順序が基本。おなじみの「1girl,solo...」よりも、品質や年代タグが前に来るのが推奨設定です。といっても厳格にこれを守らなくてはいけないわけではなく、入れ替えてもそこまで大きな悪影響はないようです。
品質タグ、年代タグ、センシティブタグ、人数、キャラクター、作品名、作家タグ、一般タグ
例:masterpiece, best quality, score 7, newest, safe,@sakaki io, 1girl, smile,looking at viewer, long hair, school uniform, white background
年代タグはyear 2025やnewest, recent, mid, early, oldといった、時代ごとの流行のタッチを呼び出すもの。「score 〇」というのは、学習データセットを美的にカテゴリ分けし、それぞれの共通概念を参照するpony diffusion方式のクォリティタグです。「score 9」が最高、「score 1」が最低で、低いランクのタグはネガティブプロンプトとして使うことができます。クォリティタグとして使う場合、公式は最高の9ではなく「score 7」の使用を推奨しています。
<Danbooru + 自然言語>
Danbooru形式か自然言語形式のどちらかを選ばないといけないわけではなく、「混ぜ書き」しても普通に通じます。例えば以下のような、前半がDanbooru形式、後半の「She is...」以降が自然文形式というハイブリッド形式が可能です。(前後が逆でももちろんOK)
PP:masterpiece,bestquality,score 7,safe.An anime girl is standing in a classroom.She has long silver hair and blue eyes.She is wearing a modern school uniform and looking at the viewer with a gentle smile.hand in hair,one eye closed
(アニメ調の女の子が教室に座っている。銀髪に青い目で、現代風の制服を着ており、こちらを見て静かに笑っている。髪をかき上げてウィンクしている)
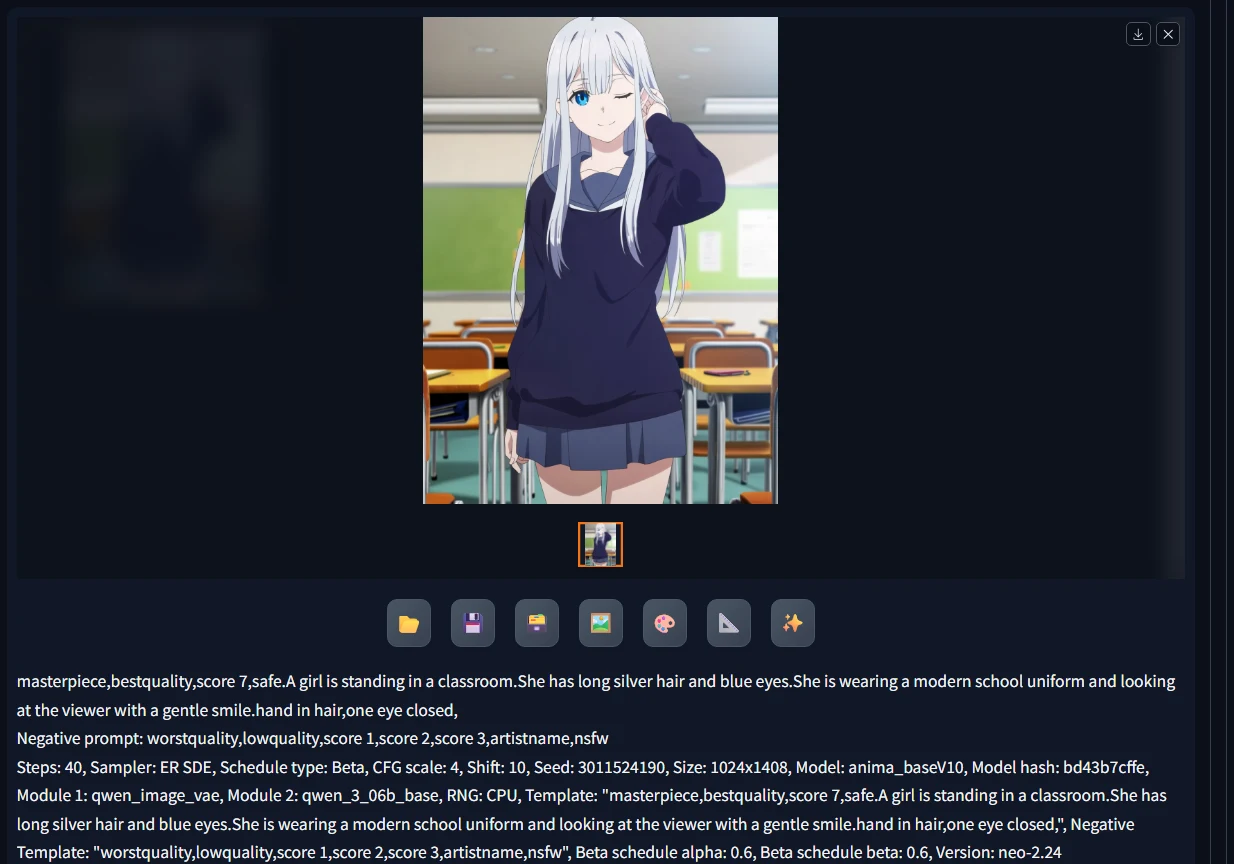
おすすめの記述法は、ふだんはSDXLと同様にDanbooru形式で記述し、それでは誤解が多発して成功画像の打率が下がってしまったときに、補助的に自然文を使用すること。日本語では認識しませんので、機械翻訳などでぱぱっと英文を作って入力するのがよいでしょう。
<複数キャラの指示>
自然言語を使った複数キャラの描き分けは、例えば以下のようにします。(見やすくするため行替えしています)
masterpiece, best quality, score 7, safe,
Three girls, all wearing the same uniform, are walking happily through the city.
The girl on the left has blonde hair and blue eyes, and is using her smartphone.
The girl in the middle is tall, has black hair, and seems quiet. She is talking to the girl on the right.
The girl on the far right has short red hair and green eyes. She is drinking a beverage.
(同じ制服を着た3人の女の子が楽しそうに街中を歩いている。
左の女の子は金髪で青い目、スマホをいじっている。
中央の女の子は背が高く、黒髪で大人しそう。右側の女の子と話している。
右の女の子は赤いショートヘアで緑の目。ドリンクを飲んでいる。)
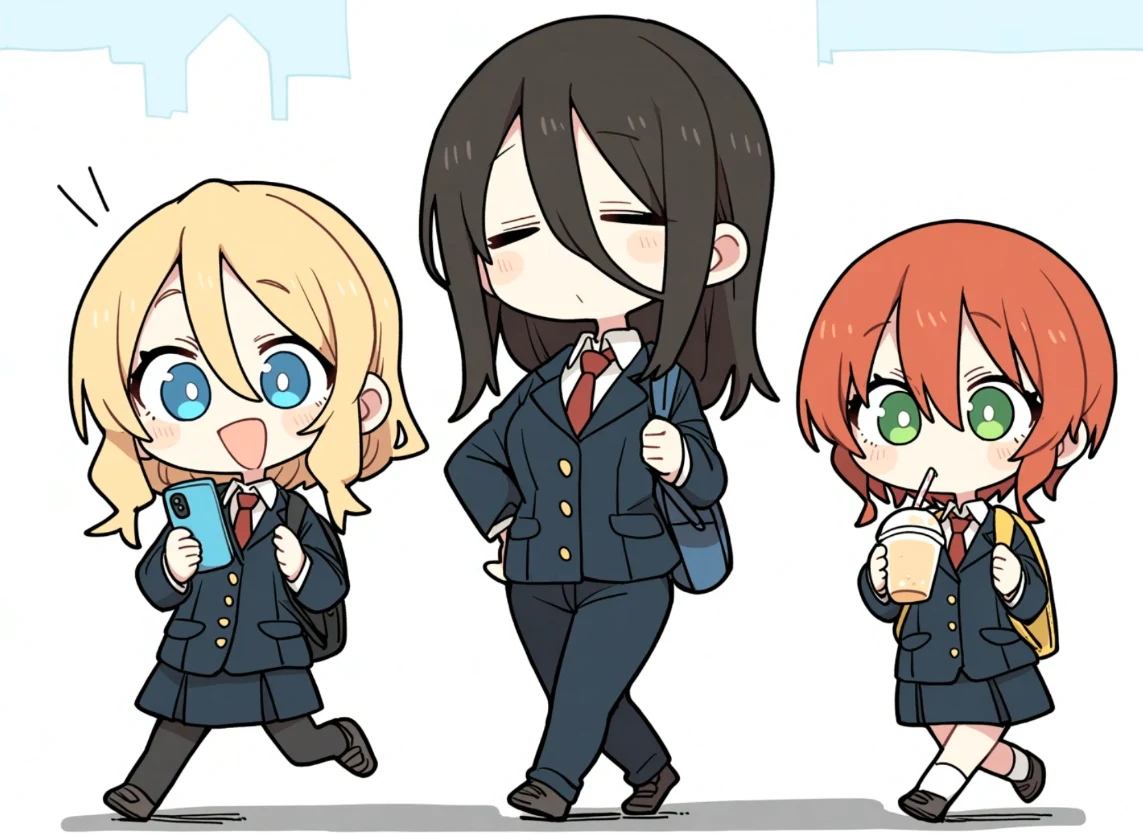
完璧とはいきませんが、髪色や背の高さなど、かなりの精度で再現ができているかと思います。「She is talking to the girl on the right.」だけ無視されましたね。
<プロンプト強調も使用可能>
Animaでも、丸括弧などを使ったSDXLと同じプロンプト強調構文が使用できます。ただし、Animaでは通常のSDXL系モデルよりも強めの重みが有効。SDXLでは「1.1~1.3」程度が主流で、それ以上にすると破綻しがちだったのですが、Animaでは(chibi:2)などとかなり強めに指示するのがよいようです。
こちらが比較表。
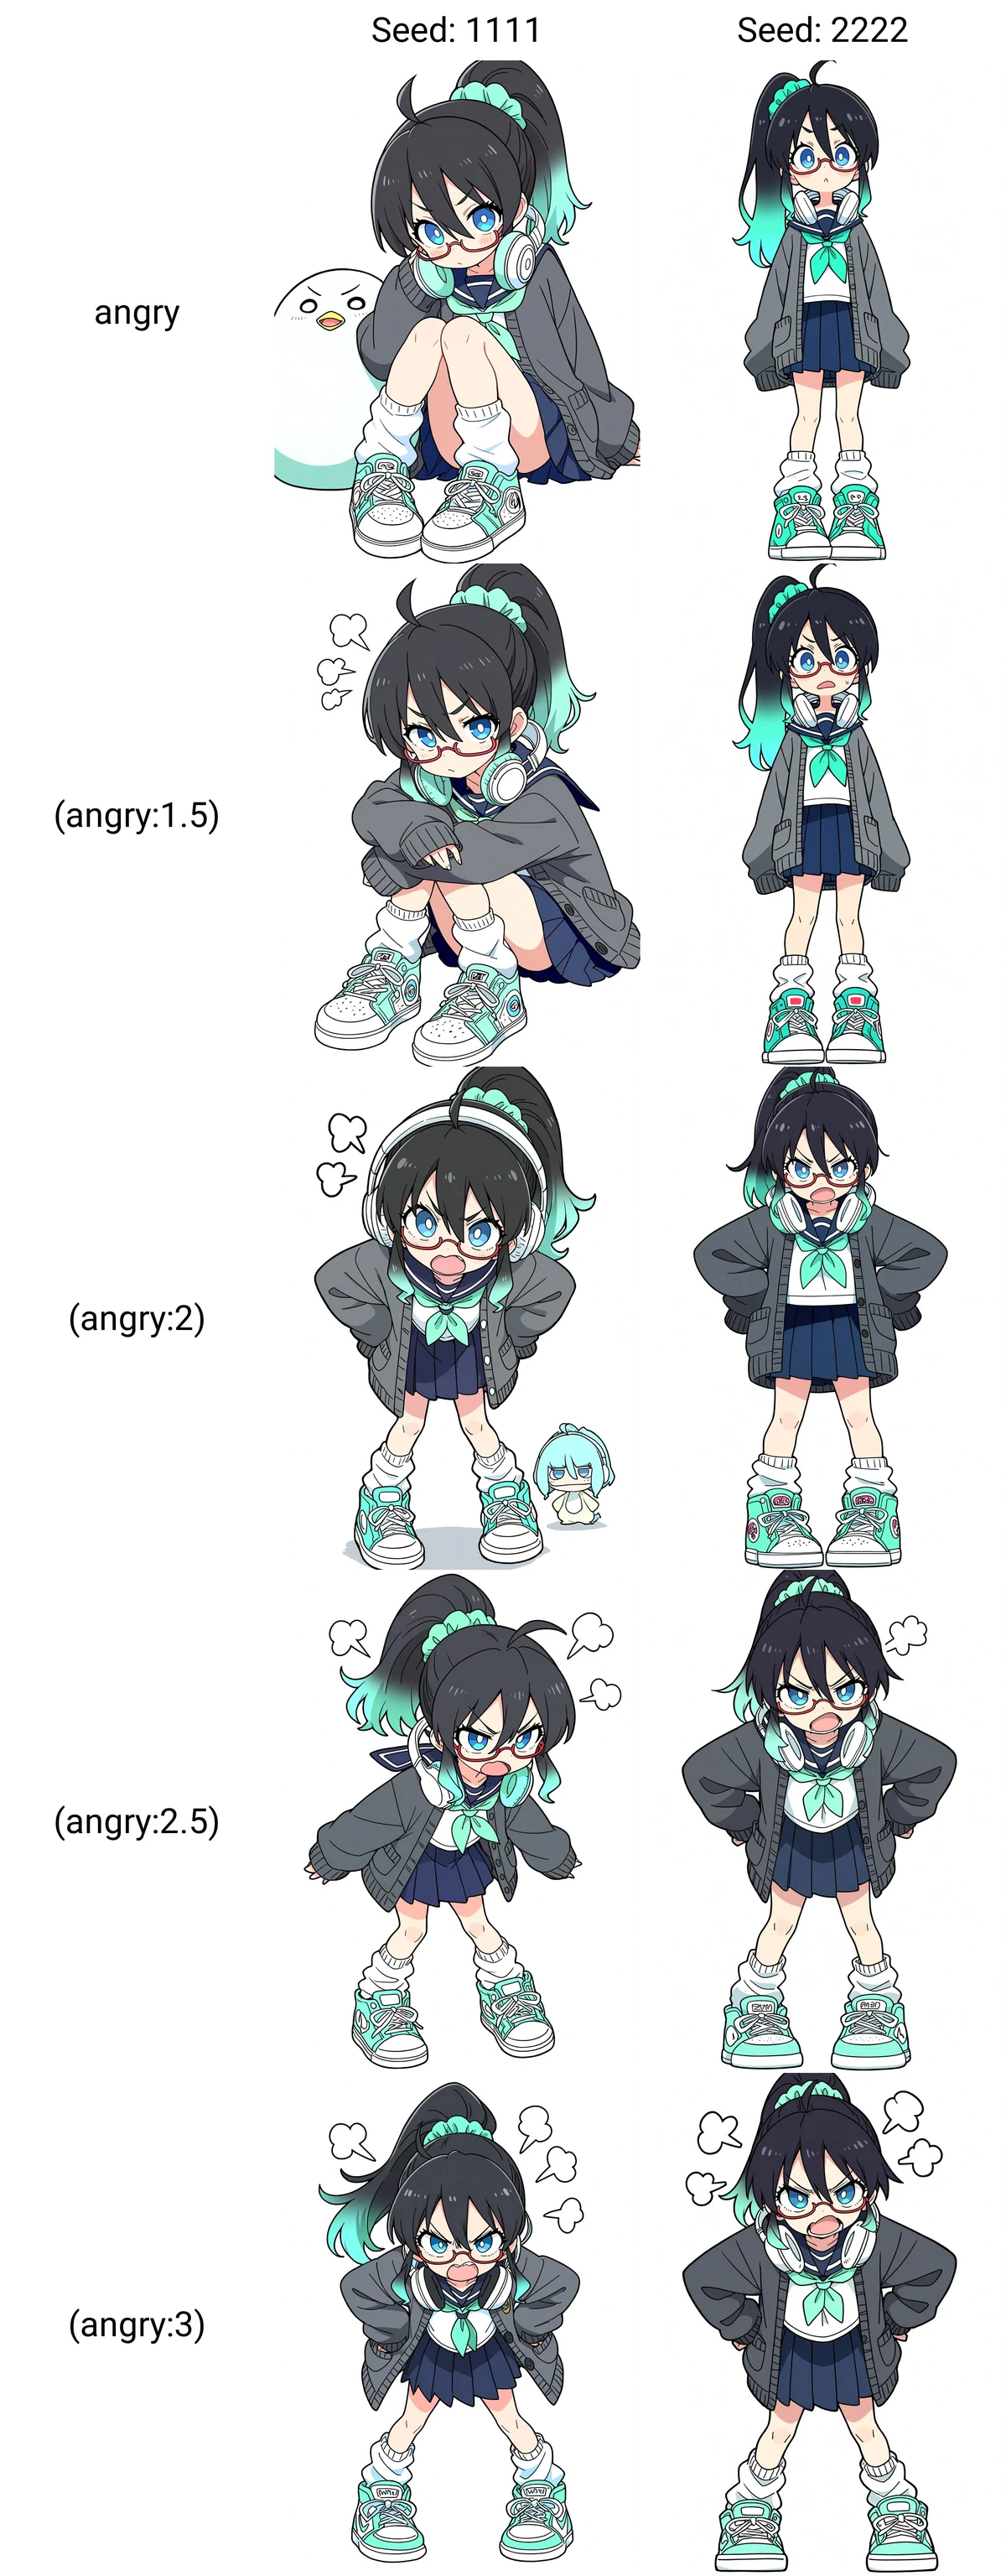
SDXLでは2を超えると破綻していましたが、Animaでは2.5あたりから頭打ちになるような挙動ですね。1から1.5では雰囲気程度しか変わらないので、強調したいときは2がデフォルトでもよいかもしれません。ちなみに((angry))のような括弧重ね式も一応効くようですが、このようにAnimaでは相当強度の高い強調が必要なので、((((((((((((((angry)))))))))))))))くらいにしないと意味がなさそうですね。
<DynamicPromptsを使うには>
{a|b|c}などと記述してプロンプトを一部ランダム化できる「DynamicPrompts」を使うこともできます。
ただし、記事執筆時点では、通常のDynamicPromptsがForgeNeoの更新後に起動エラーを起こすケースが報告されています。こちらのフォーク版を使うことで回避できるようです。(もしくは、通常版をCodexに頼んで改修してもらう形です)
インストール後、ForgeNeoを再起動し、txt2img画面にDynamicPromptsの項目が表示されれば成功です。これでAnimaでも従来通り、 {black|red|yellow|blue} hairのようなランダム差し替えができます。
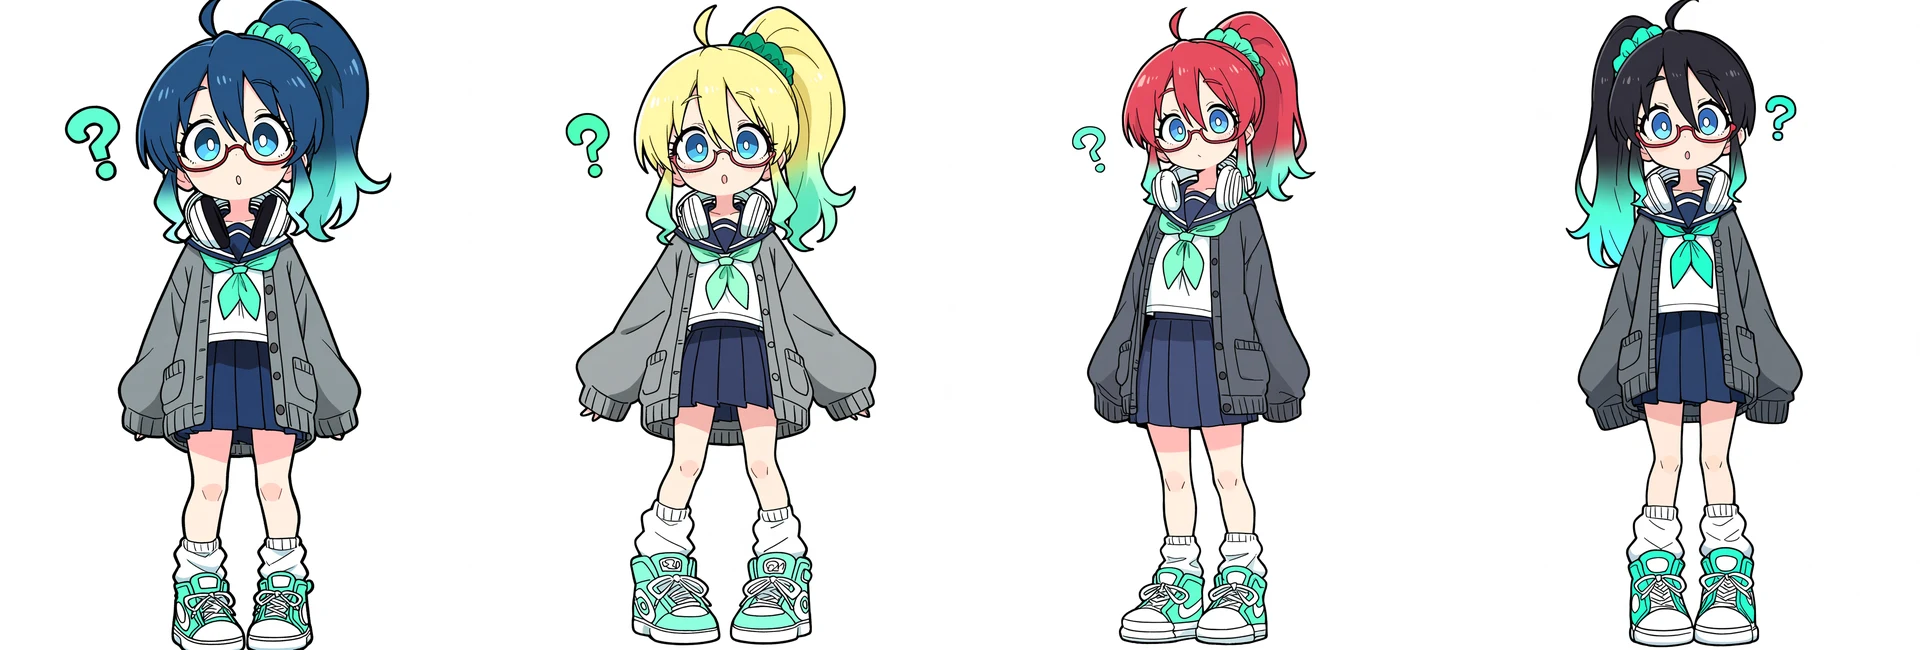
<作家名タグには@が必要>
Animaでは、画風を再現する作家名タグの前に@を付ける方式が採用されています。例えば「1girl,solo,@sakaki io」のような形式で記述することになります。(@sakaki io:2)や(@sakaki io:0.5)のように、画風に強弱を付けることが可能なほか、ネガティブプロンプトとして使うことで絵柄をコントロールすることもできます。(※フラットな塗りを避けるなど)
いつもの注意喚起ですが、画風は著作権保護されないからと言って精巧に誰かの画風を模倣した作品を公開していると、なりすましや嫌がらせ、営業妨害などと受け取られて突如大きなトラブルに発展することがあります。画風(アイデア)だけでなく既存作品の「表現」(表現上の本質的特徴)まで模倣していた場合、発信者情報の開示が認められ、提訴に至る恐れも十分あります。
自分の身は自分でしか守れませんので、特に単独の作家タグを使って画風を再現するのはリスキーだと覚えておきましょう。
<TIPS:余計なオブジェクトを排除するには>
Animaは自然言語指示が効く一方で、danbooruタグへの反応がSDXLと異なり、予想しないオブジェクトを連れてくる現象が頻発します。「難しい注文はこなせるけど、簡単な注文がこなせない」というやや上級者向けのモデルという印象です。例えば下図のように、ただ1girl,soloの白背景立ち絵を指示しただけで、注文していない謎の吐息や吹き出し、白青の小動物、エフェクトなどが大量発生することがあります。
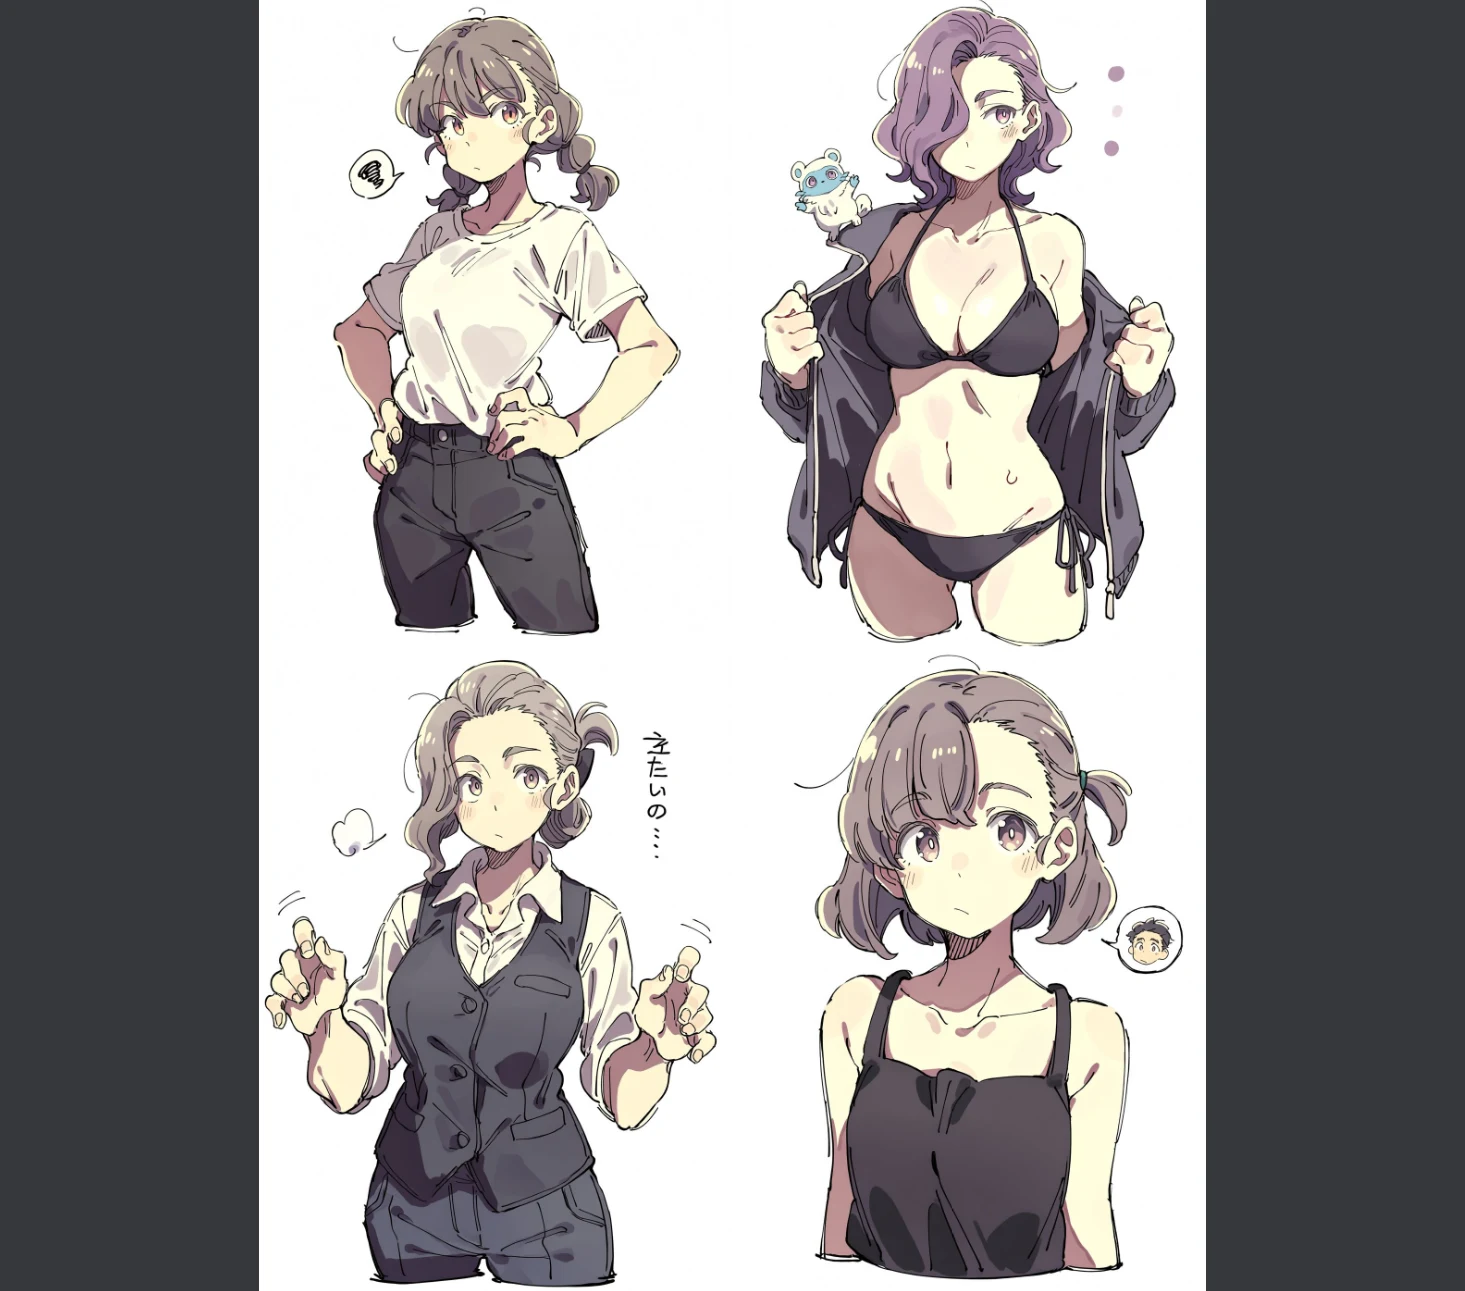
こうした余計なオブジェクトを排除するには、まずは基本の「半角スペースルール」を守っているか確認します。タグ間の半角スペースをアンダーバー「_」にしていたり、カンマのあとの半角空けが抜けていないかチェックしてください。問題がないようなら、次はネガティブプロンプトで排除を試みます。やたら胸をバインバインにしてきたり、何かを脱ぐような動作をしたりもよくするので、私は次のようなタグを入れています。
NP:worst quality, low quality, score_1, score_2, score_3, blurry, jpeg artifacts, lowres, censor, chibi, kawaii, animal, cat, (text:2.0),dripping, signature, commentary, sound effects, commentary request, undressing, heavy breathing,(^^^:1.5), sketch,sweat,comic,speech bubble, sparkles, sparkle, decorative marks, comic symbols, manpu, motion lines, emphasis marks, floating symbols, floating shapes, abstract decorations, doodle, stylized effects, visual effects, bubbles, notice lines,large breasts,cropped torso, talking,
ただし、Anima TurboやLoRAで高速化したときにScaleを最低の「1」まで下げてしまうと、ネガティブプロンプトが使えなくなります。1.2~2くらいまでなら上げても色合いに悪影響が少ないので、ネガティブを利かせたい場合は少しScaleを上げてみるとよいでしょう。
もう一つ効果的なのが、「solo」を1.5~2倍に強調すること。こちらはただの「solo」だと4/4で小動物が乱入してきたケースですが、強調することで排除することができています。
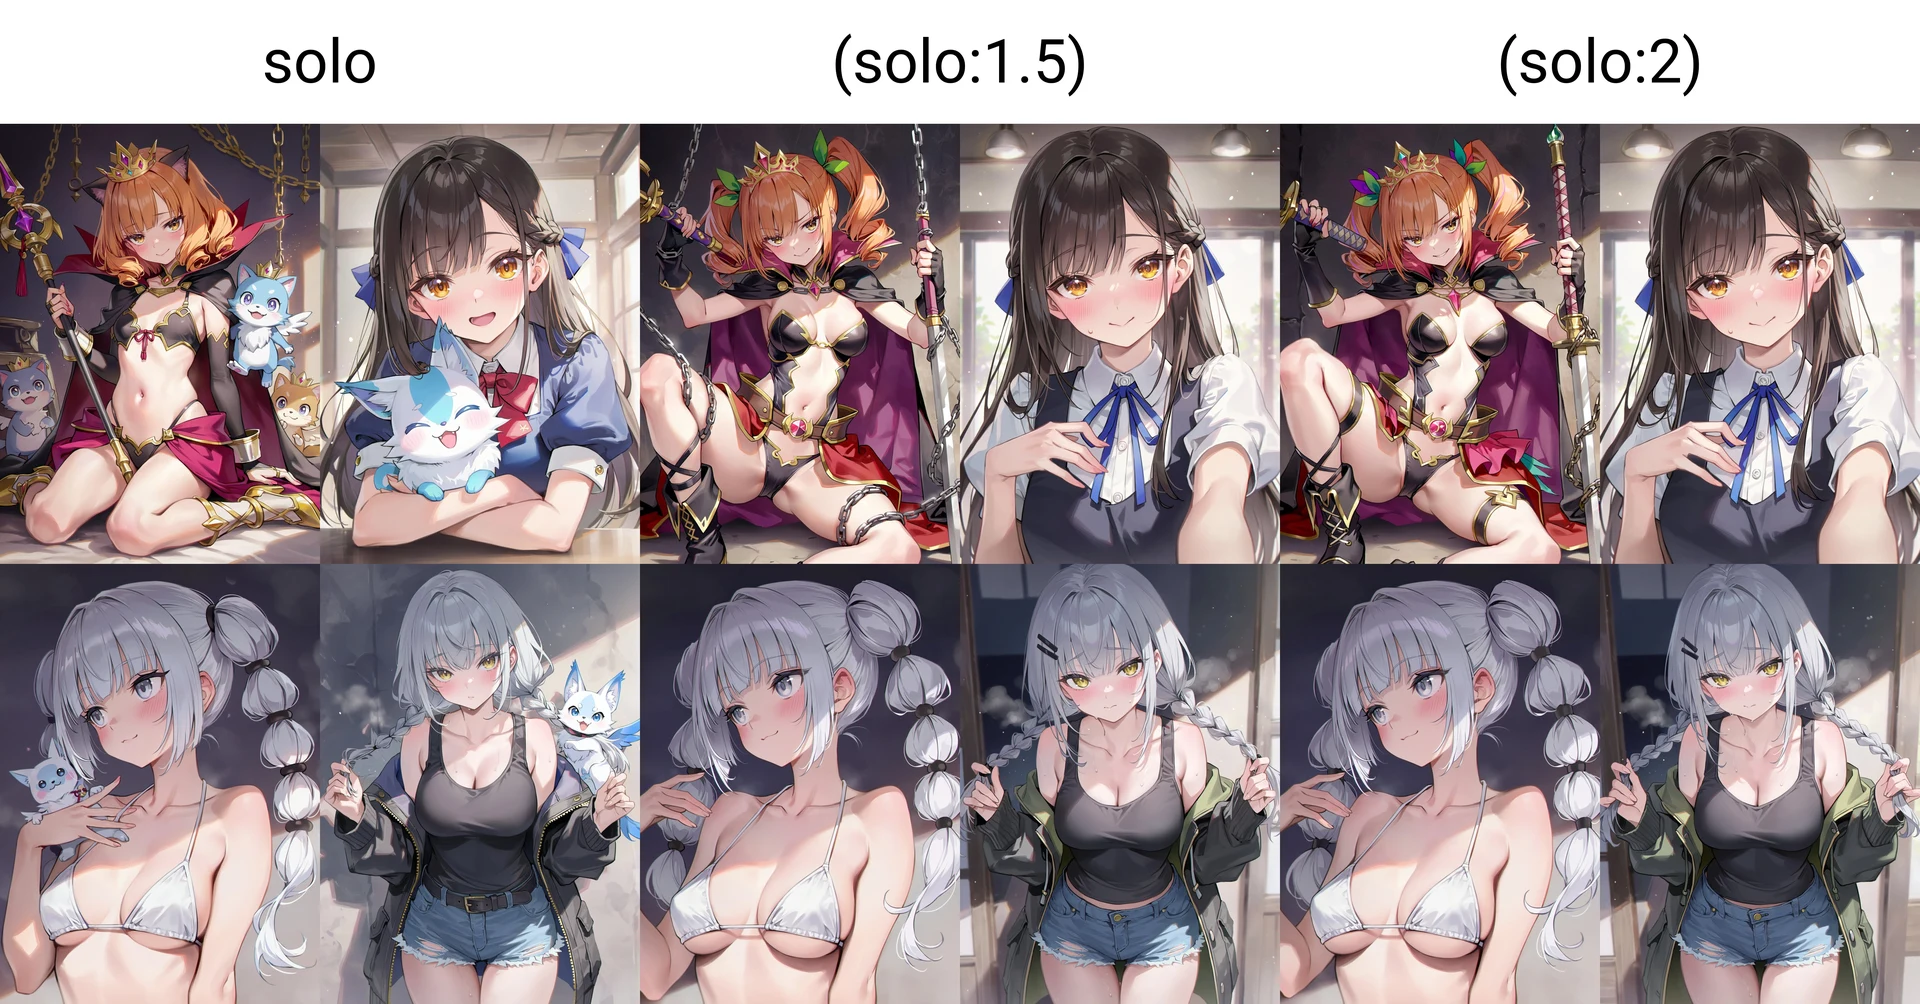
フキダシやハート、キラキラ(✨)のようなエフェクトを排除したいときは「white background」「simple background」を強調すると効果がありました。
<TIPS:頑固な要素はNegpipで排除しよう>
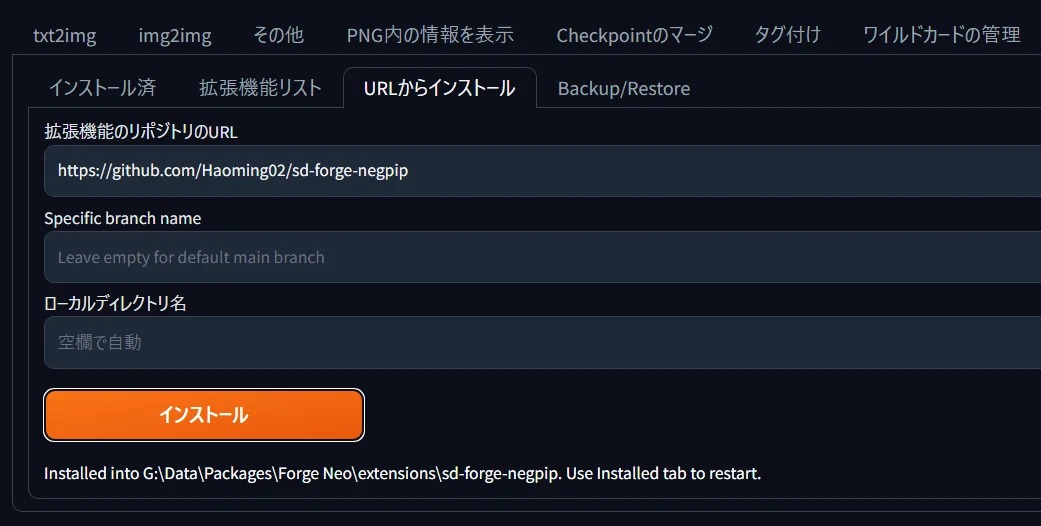
プロンプトの見直しやネガティブ指示でも排除しきれない場合は、ポジティブプロンプト内でタグのマイナス適用ができるようにする拡張機能「Negpip」を使います。通常のhakomikan氏版は使えないようなので、ForgeNeo開発者のHaoming02氏版をインストールしましょう。
上記URLを「URLからインストール」でForgeNeoに適用後、再起動します。
使い方は簡単。排除したい要素をネガティブプロンプトではなくポジティブプロンプトに記述して、(text:-1)や(speech bubble:-1.5)のようにマイナス方向へ強調するだけです。
例えば、こちらの左の4枚はネガティブプロンプトに「speech bubble, text, wet,sweat, water drop, puff of air,sigh」と記述しているのにそれらが表示されてしまっています。negpipをインストールし、ポジティブプロンプトの末尾に(speech bubble, text, wet,sweat, water drop, puff of air,sigh:-1)と入れたところ、右の4枚のように水滴や吹き出し、ため息などを消すことができました。
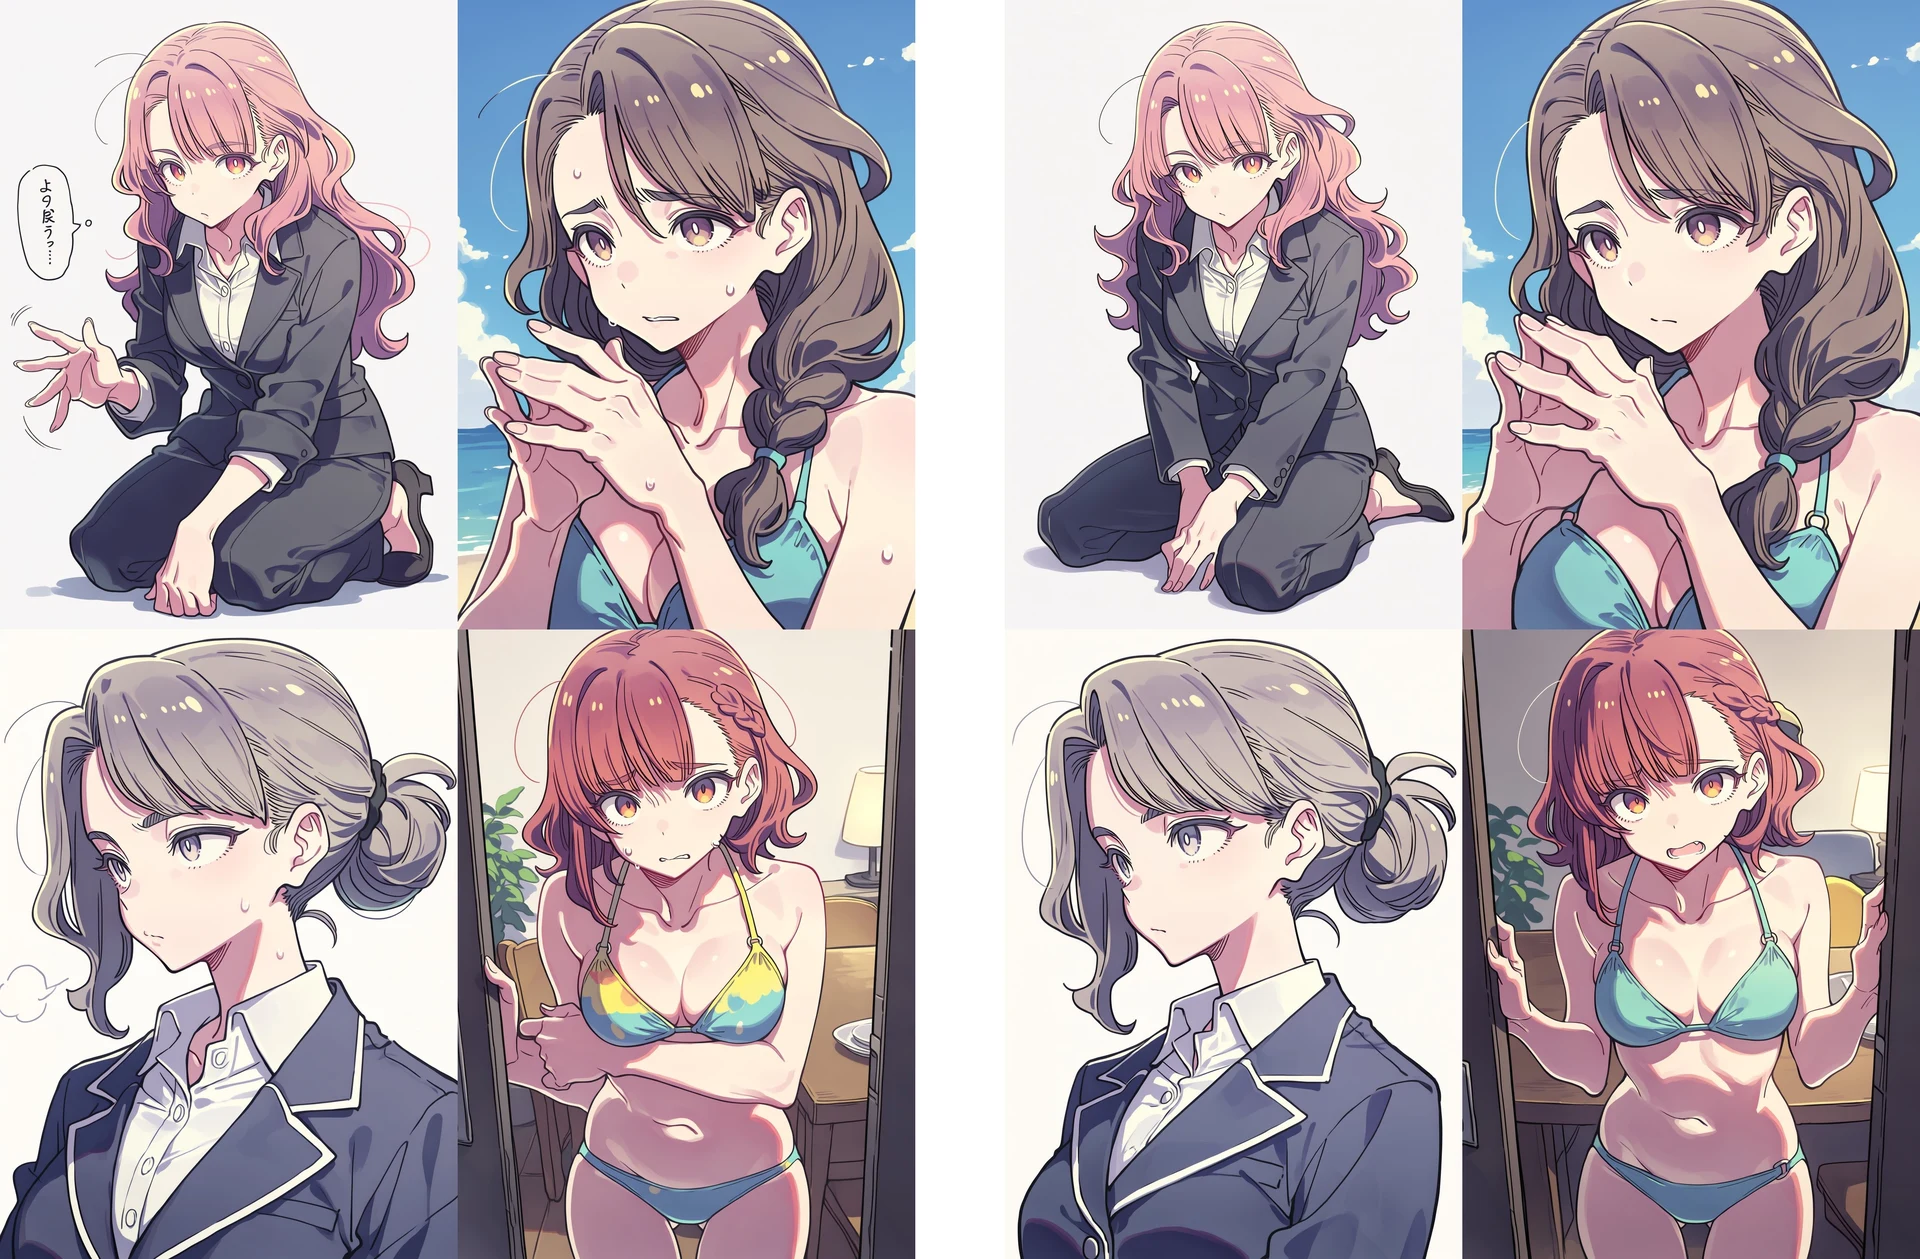
ただし、Negpipで指示していない要素にもわずかに変容は起きるので、あまりNegpipによるマイナス適用タグを盛り盛りにすると、予期しない悪影響が起こるかもしれません。上の画像比較では、手のポーズや水着の柄などに変容が起きているのが分かりますね。

9.ForgeNeoを「いつもの環境」にしよう
Animaで生成できるようになったら、次は「いつもの環境」に近づけていきましょう。
<日本語化>
まずはForgeNeoの日本語化からですが、基本的にはいつものForge系のやり方と同じなので、詳しくはこちらをご覧ください。
早口で説明すると、「Extension」タブから「ja_JP Localization」を探してInstallし、画面を再読み込みし、「Settings」タブから「Localization (requires reloadUI)」の「None」を「ja_JP」に変更したら、Apply settingsを押したあとReloadUIすれば日本語化されます。
<拡張機能導入>
次は拡張機能のインストールです。主立った拡張機能のうち、日本語化以外で手元環境で動かせたのは以下の通り。
・ADetailer
・WD14 Tagger
・Tag Autocomplete
・Dynamic Prompts
・Prompt Dictionary
・sd-webui-ar
・Eagle PNGInfo
・プロンプト大辞典 on SDwebUI
ただ、ADetailerとWD14 Tagger、sd-webui-arはreForgeで使っていたそのままでは不具合が起きましたので、フォーク版を使うかCodexなどで改修する必要があります。
reForgeで普段使っているもののうち、「dataset-tag-editor」「regional-prompter」「supermerger」は動作せず、起動にも影響があったのでいったん無効にしました。
・Tag Autocomplete(タグ補完)
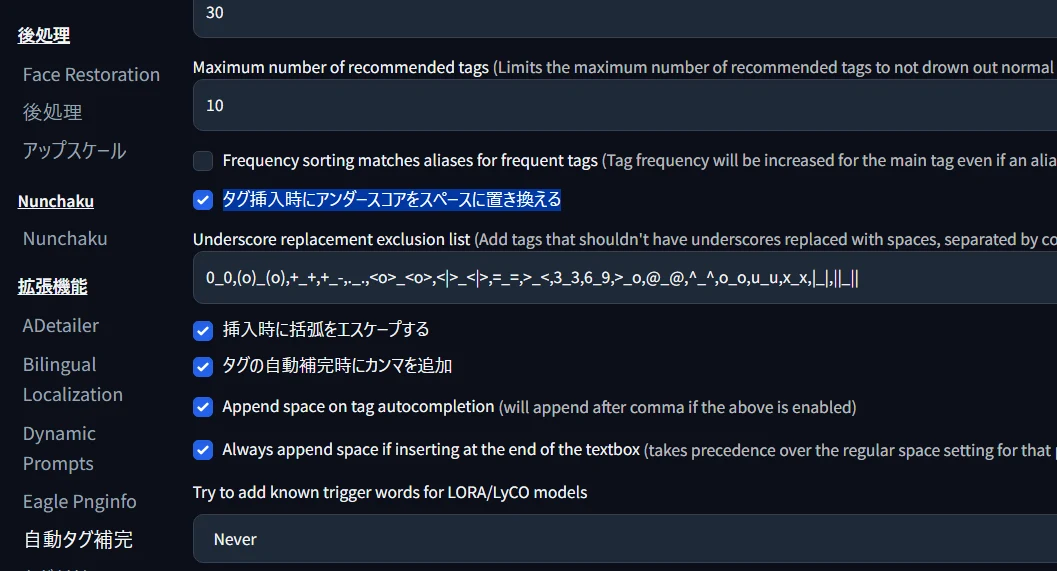
プロンプト欄でタグを予測変換してくれる「Tag Autocomplete」は普通に動きました。ただ、Animaでは半角のアンダースコア「_」ではなく、半角スペース区切りのタグが推奨されているので、ForgeNeoの「設定▶自動タグ補完」からオプションの「タグ挿入時にアンダースコアをスペースに置き換える」にチェックを入れておくとよいでしょう。
・フォーク版「ADetailer-Neo」
描画範囲が小さくなると破綻しがちな顔や手部分を切り出してi2iし、再び元に戻してくれる基本技術がADetailer。ただ、そのままインストールした場合、正常に動作しません。Haoming02氏がForgeNeo対応版の「ADetailer-Neo」を提供して下さっているので、こちらを代わりに使いましょう。
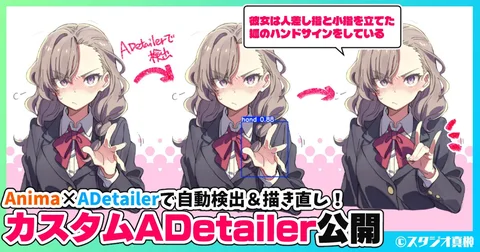
タイミングが前後してしまいましたが、スタジオ真榊でもオリジナルのAnima/SDXL向けカスタムADetailerを作っています。こちらの記事で解説していますが、ADetailerをAnimaと組み合わせることで、自然言語を使った局所的なイラスト修正ができるようになります。
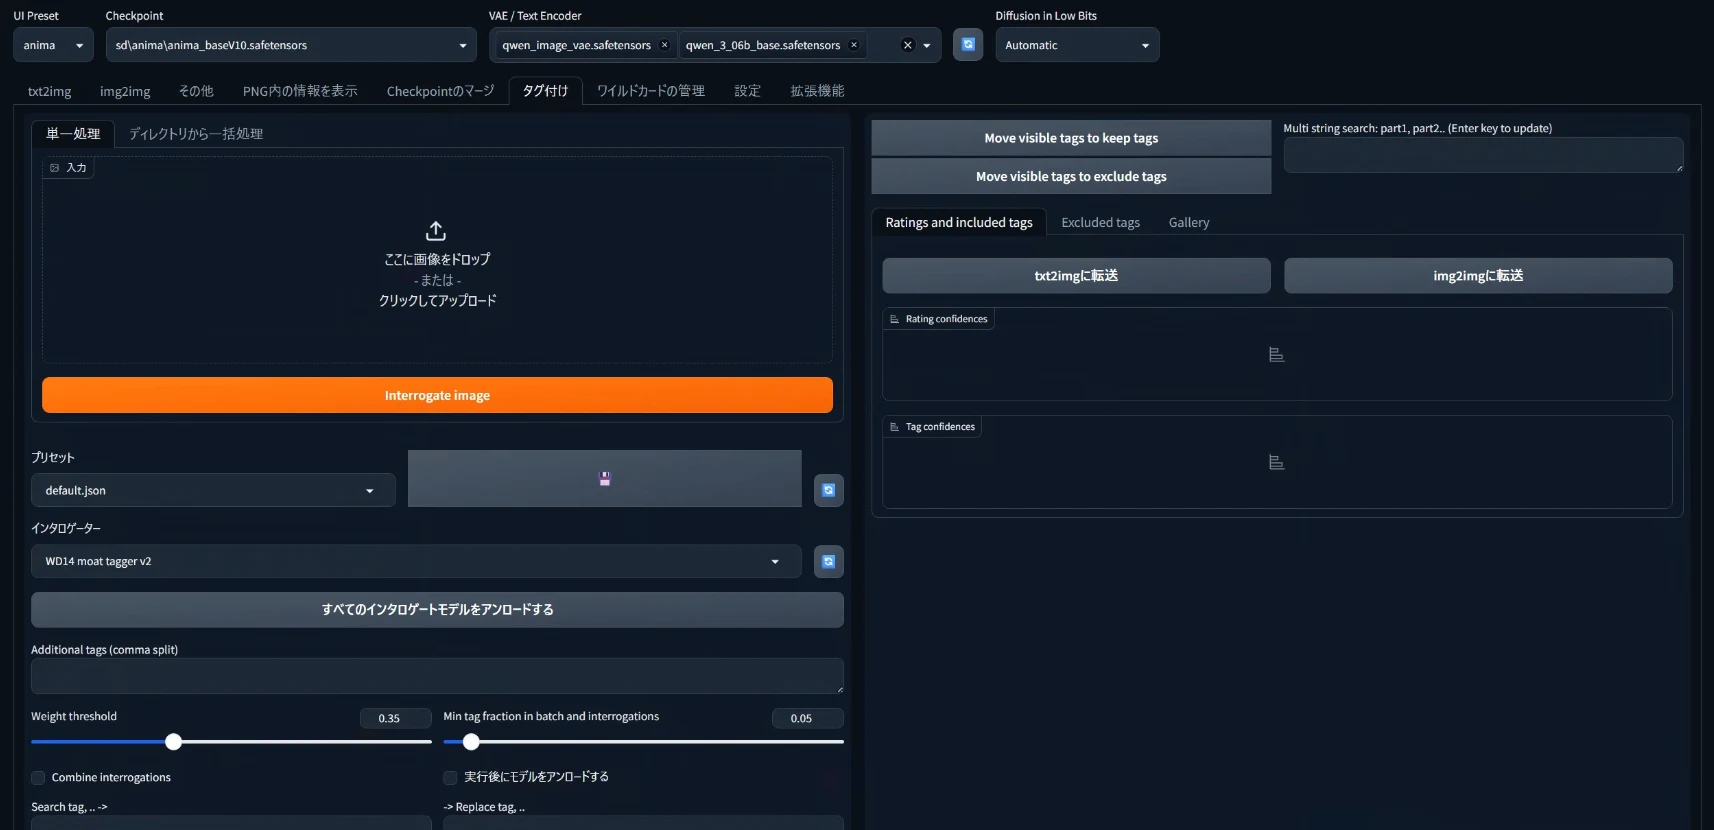
・WD1.4 taggerはCodexで直せるなら
画像のタグ付けに便利なWD1.4 taggerもそのままでは動かなかったので、Codexに改修してもらいました。ADetailerのように手作業での補修ができるほど簡単な状況ではないようでしたので、使いたい場合はCodexに補修をお願いしたほうがよいと思います。
・DatasetTagEditorはフォーク版を使おう
タグ付け済のLoRA用データセットを書き換えられる便利な拡張機能「DatasetTagEditor」はそのままでは使えないので、こちらのフォーク版(枝分かれした別バージョン)を導入しましょう。このフォークは起動時にopen-clip-torchを自動導入する作りですが、環境によってはうまく導入できないことがあるので、うまくいかないときはCodexなどに見てもらいましょう。
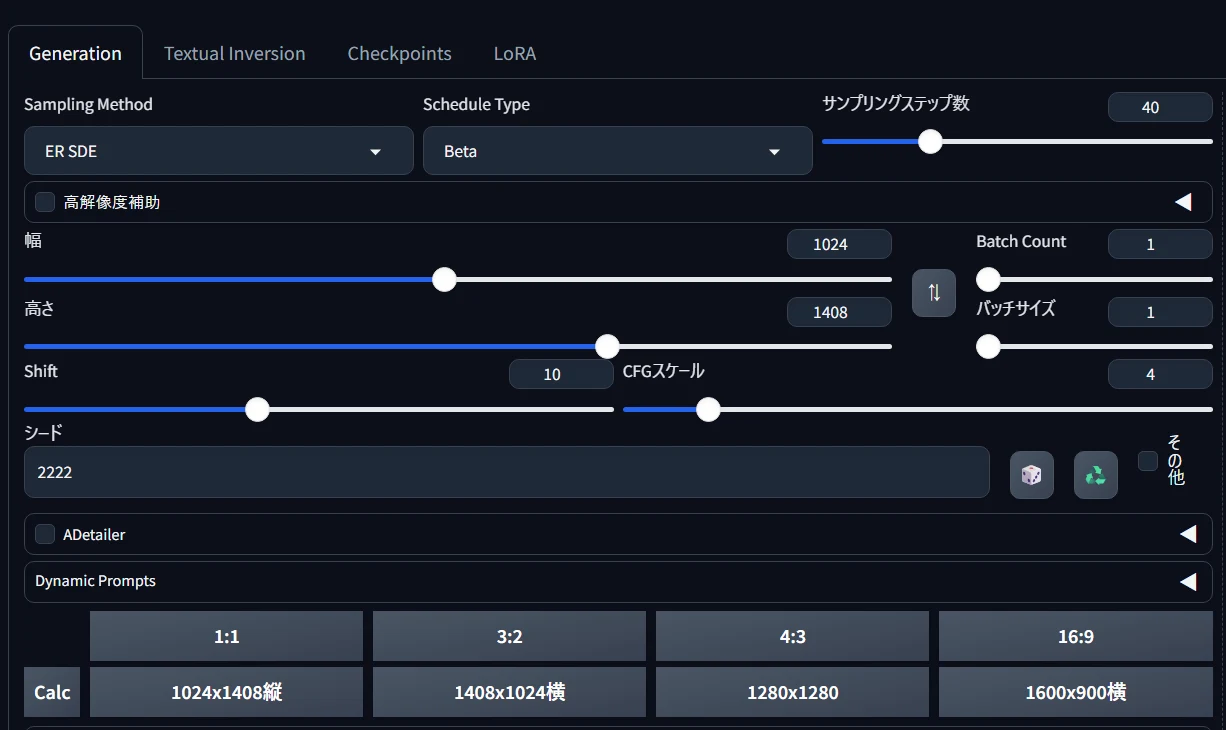
・sd-webui-arも要補修
キャンバスサイズをボタン一つで変更できる便利機能。私は下図のようにやや長めの文字列をボタンにしていたのですが、ForgeNeoのUI部品との相性でボタン文字が潰れて見えなくなる現象が起きました。
<ちょっと脱線>QwenImageEditを使ってみよう
ここまでAnimaの導入を解説してきましたが、せっかくForgeNeoを導入したので、Qwen-Image-Edit2511(QIE2511)の使い方にも触れておきます。QIE2511は既存画像の編集、文字修正、服装変更、背景変更、角度変更、スタイル変換などができる画像編集モデル。詳しくはこちらの記事を参照のこと。
基本的にAnimaと同様、それぞれのメインモデル以外にQwen用のテキストエンコーダとVAE、あとは使うなら高速化LoRAを準備して読み込むだけです。(かなり重いモデルなので、VRAM16GBないと厳しいです)
・qwen_image_edit_2511_fp8mixed.safetensors
→画像編集ができるQIE2511のメインモデル。bf16版は40GBあり、VRAMへの負荷もかなり重め。やや軽量なfp8版がメインの選択肢になろうかと思います。
・qwen_2.5_vl_7b_fp8_scaled.safetensors
→Anima向けより一世代前のテキストエンコーダを使う。models/text_encodersフォルダへ。(精度重視なら qwen_2.5_vl_7b.safetensorsでもよいが、そちらは16GB以上あって重い)
→VAE。Animaと同じものでOK。models/VAEフォルダへ。
・Qwen-Image-Edit-2511-Lightning-4steps-V1.0-bf16.safetensors
→QIE2511用の高速化LoRA。4ステップで収束する。models/LoRAフォルダへ。
ここでは簡単に、QIE2511に高速化LoRAを適用して入力画像の衣装チェンジをやってみます。左上の「anima」となっていたメニューで「qwen」を選び、画面上部から各モデルを読み込んだら、ノイズ除去強度「1」でimg2imgすればOKです。
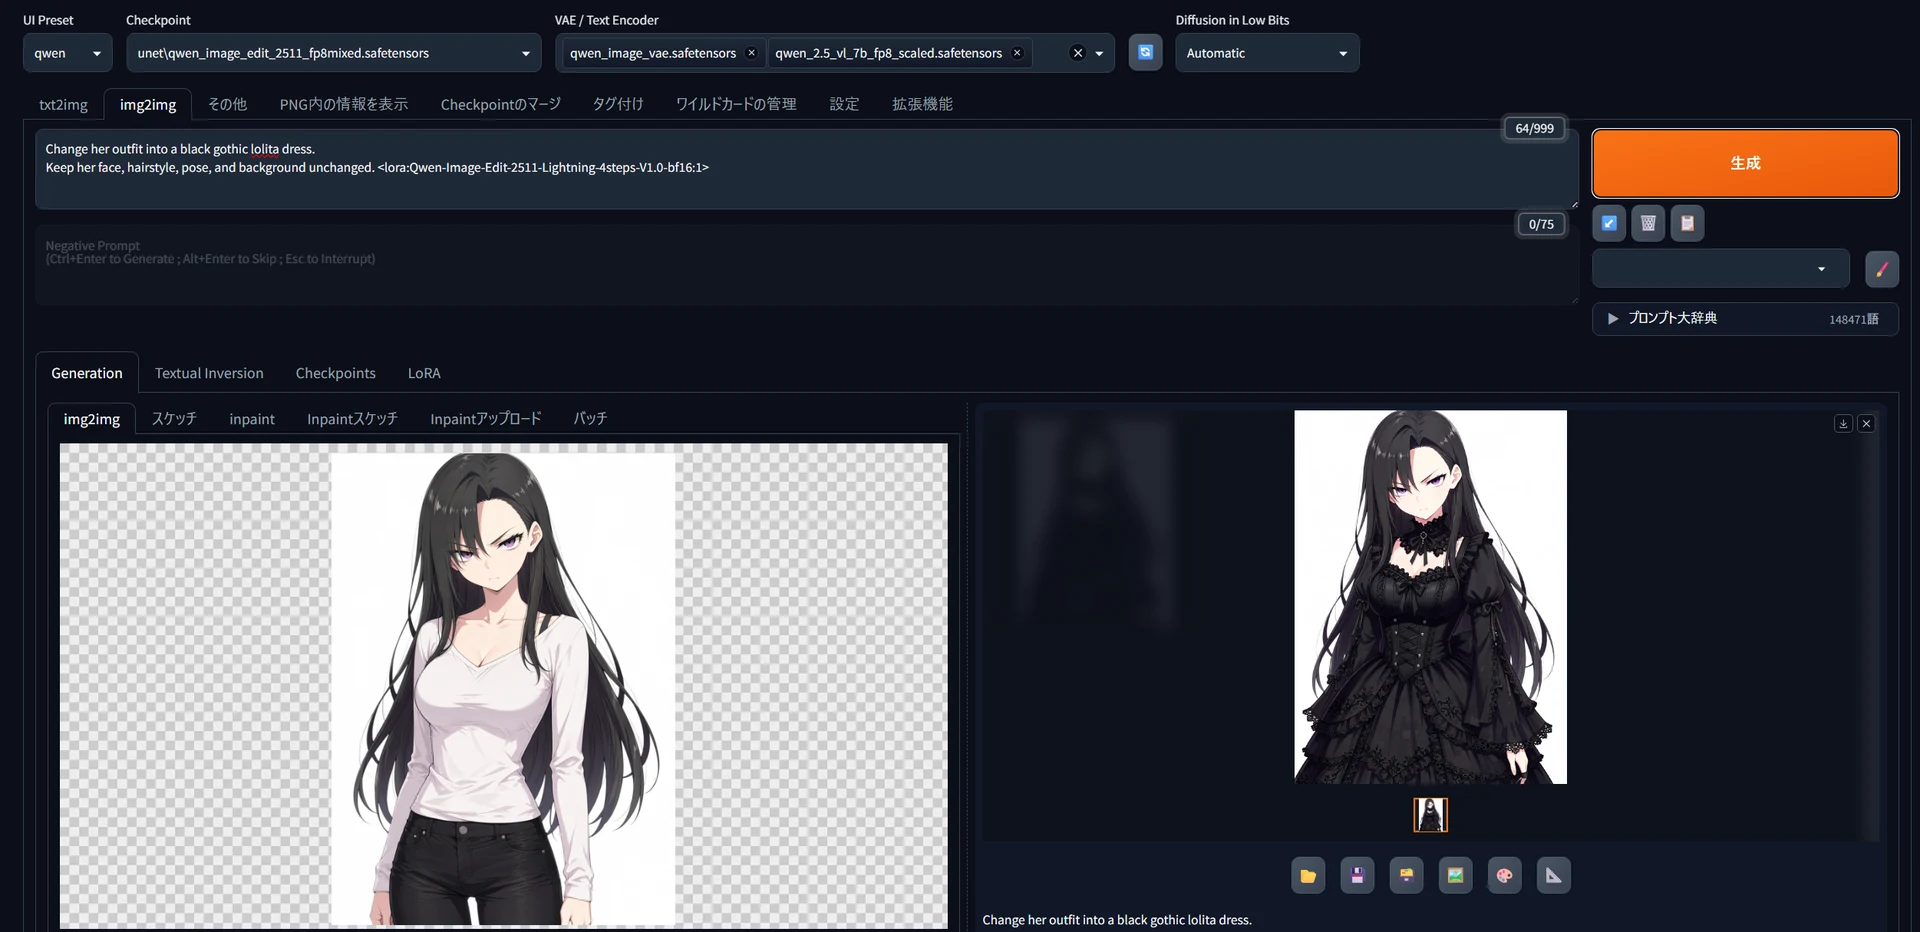
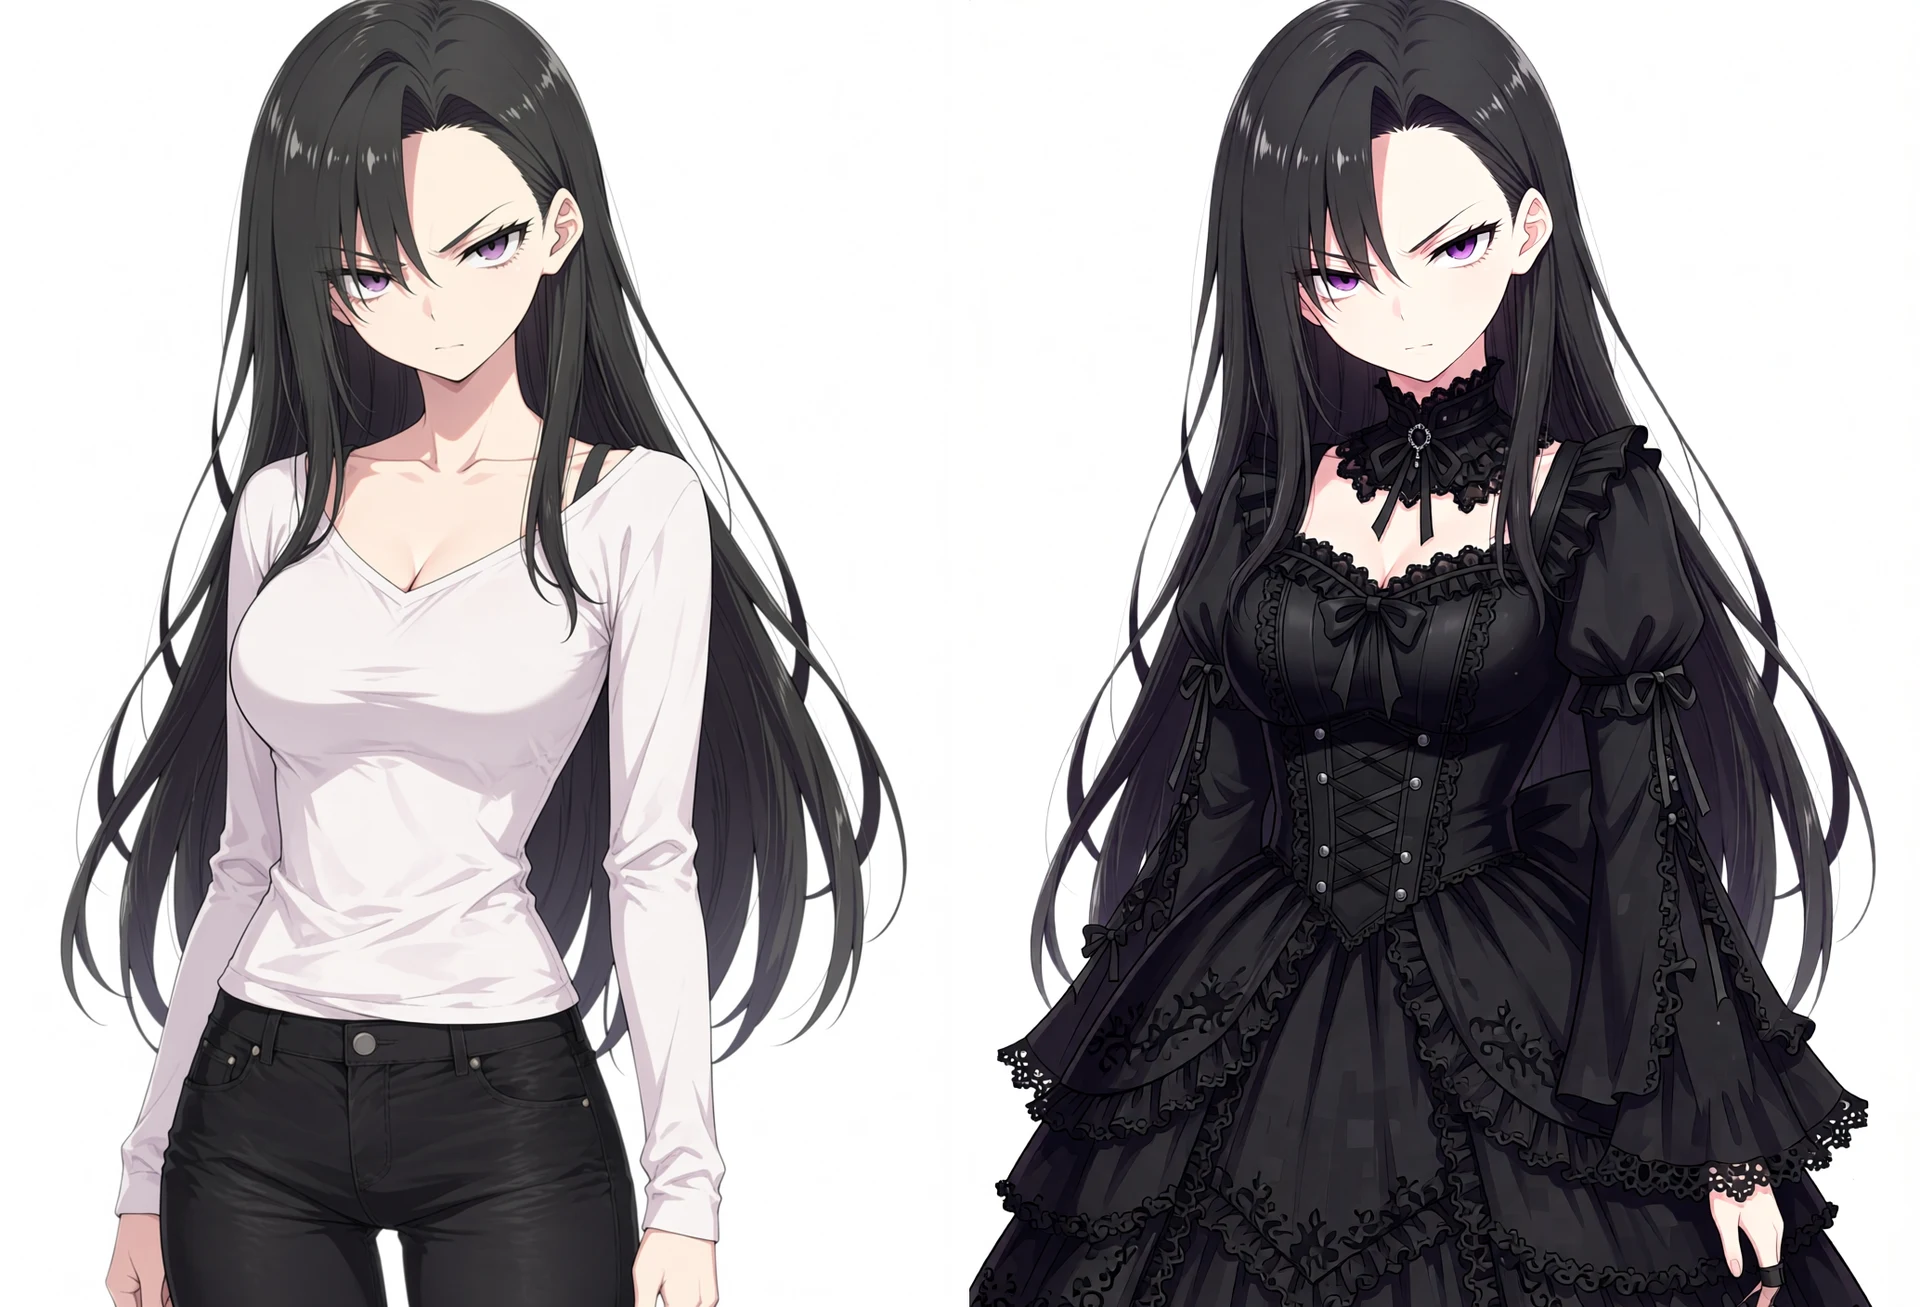
衣装を黒いゴスロリに変更してみたいので、プロンプトは「Change her outfit into a black gothic lolita dress.Keep her face, hairstyle, pose, and background unchanged. <lora:Qwen-Image-Edit-2511-Lightning-4steps-V1.0-bf16:1>」とします。高速化LoRAを使っているので、Steps:4、CFG Scale:1.0、Denoising Strength:1.0とし、サンプラーはEuler aなどを使用。
このように、ローカル環境でChatGPTやNanoBananaのような画像編集ができました。このような機械的な変更は可能ですが、表情を変更しようとすると顔立ちはかなり変容しやすいので注意。QIE2511にはアングルチェンジLoRAなどもあるので、いろいろ試してみると面白いです。
ForgeNeoではAnimaとQwenとSDXLが同じ画面でシームレスに切り替えられるので、Qwenで編集した画像をAnimaでADetailerして顔立ちを戻すなど、さまざまな応用ができるかと思います。

10.AnimaにおけるControlnet
SDXLにおけるControlnetには、線画を継承できる「Lineart」やポーズを抽出できる「OpenPose」などさまざまなモデルがありましたが、SDXL用のControlnetはいずれもAnimaに流用できませんので、Anima専用のCNモデルを入手して使う必要があります。
とはいえ、GPT Image2やNanoBananaProの登場で、SDXLでわざわざControlnetを使用するシーンはだいぶ減っていました。最近はほとんど月須和・那々さんの「Anytest」シリーズと「Noobai Inpainting」だけだな、という人も多かったのではないかと思います。(一応説明しますと、Anytestは入力画像の輪郭をおおむねトレースしつつ、プロンプト指示に従って変化させられるControlnetモデル、Noobai Inpaintingは周囲と調和のとれた高品質なインペイントを可能にしてくれるモデルです)
逆に言えば、「AnimaでもAnytestとInpaintが使えるなら、かなりお引越しのハードルは下がる」と言えそうですね。それぞれ、SD-scriptsで有名なKohyaさんがAnima用Controlnetを学習してくださっていますので、こちらを導入しましょう。
リンク先の「Files and versions」から各種ControlnetモデルをDLできますので、ローカルの「Models/controlnet」フォルダにそれぞれ配置しましょう。Controlnet画面の「🔄️」ボタンでControlnetモデル一覧に表示されるようになります。

「anima-lllite-any-test-like-v2」の使い方
anima-lllite-any-test-like-v2は、Anytestシリーズのように入力画像の輪郭を守りながら、プロンプト通りに変化させられるControlnetモデルです。
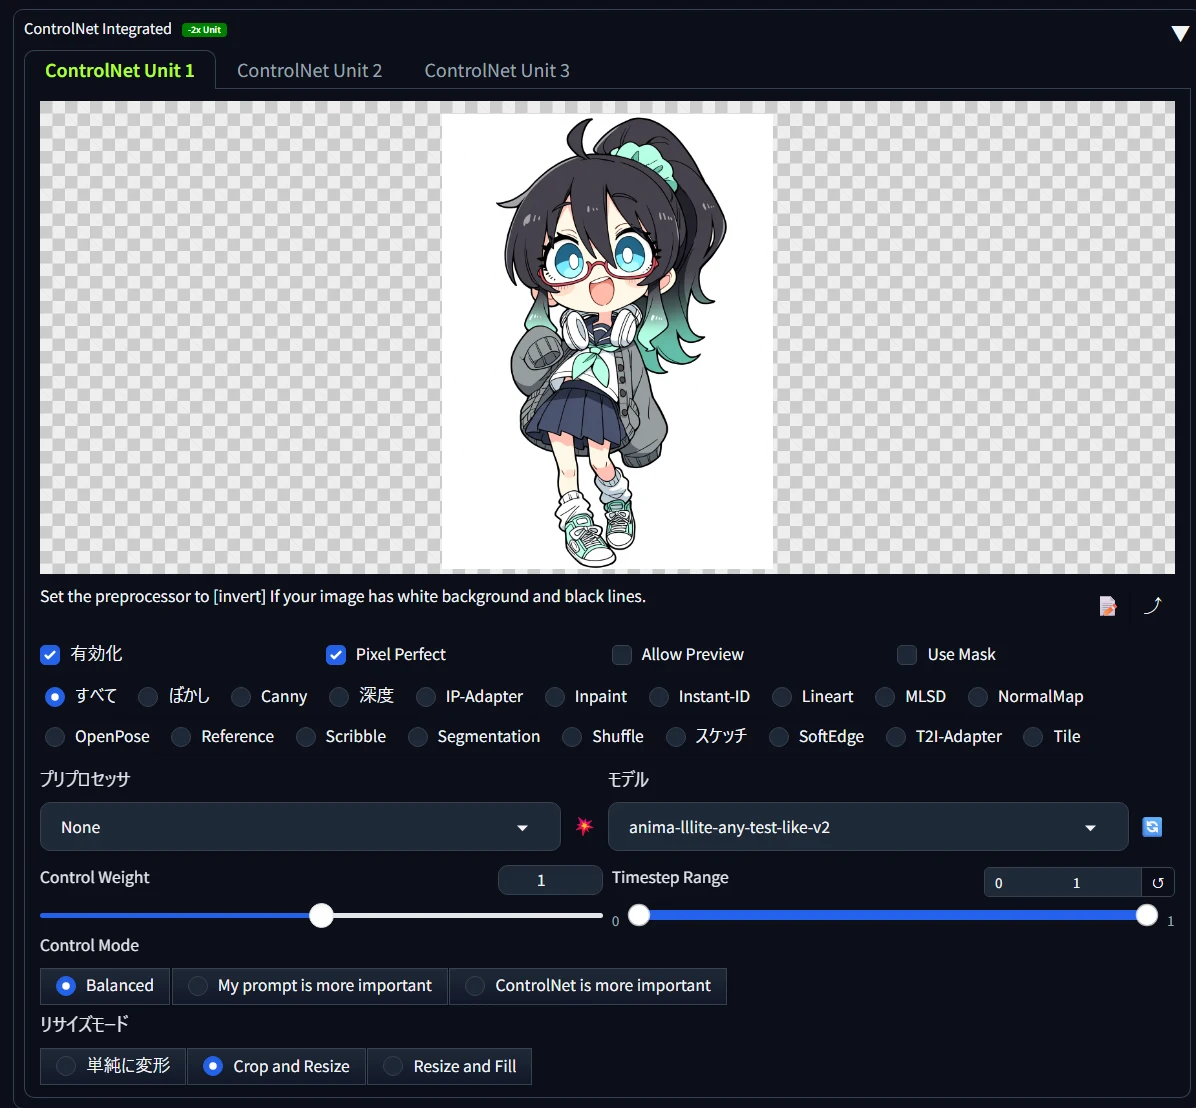
txt2imgかimg2imgの画面でこのように画像を読み込ませたら、「プリプロセッサ」をNoneにし、モデル欄から「anima-lllite-any-test-like-v2」を選ぶだけです。Control weight(Controlnetの適用強度)は1、Timestep range(ステップに影響する範囲)も0-1、つまり全体でOK。有効化とPixel perfectにチェックを入れるのを忘れないようにしましょう。
テストを行います。これは、ミナちゃんのプロンプトに「figure」というタグを足して生成したもの。入力画像の輪郭はしっかり守られつつ、Animaの描画力でフィギュア風に変換されています。
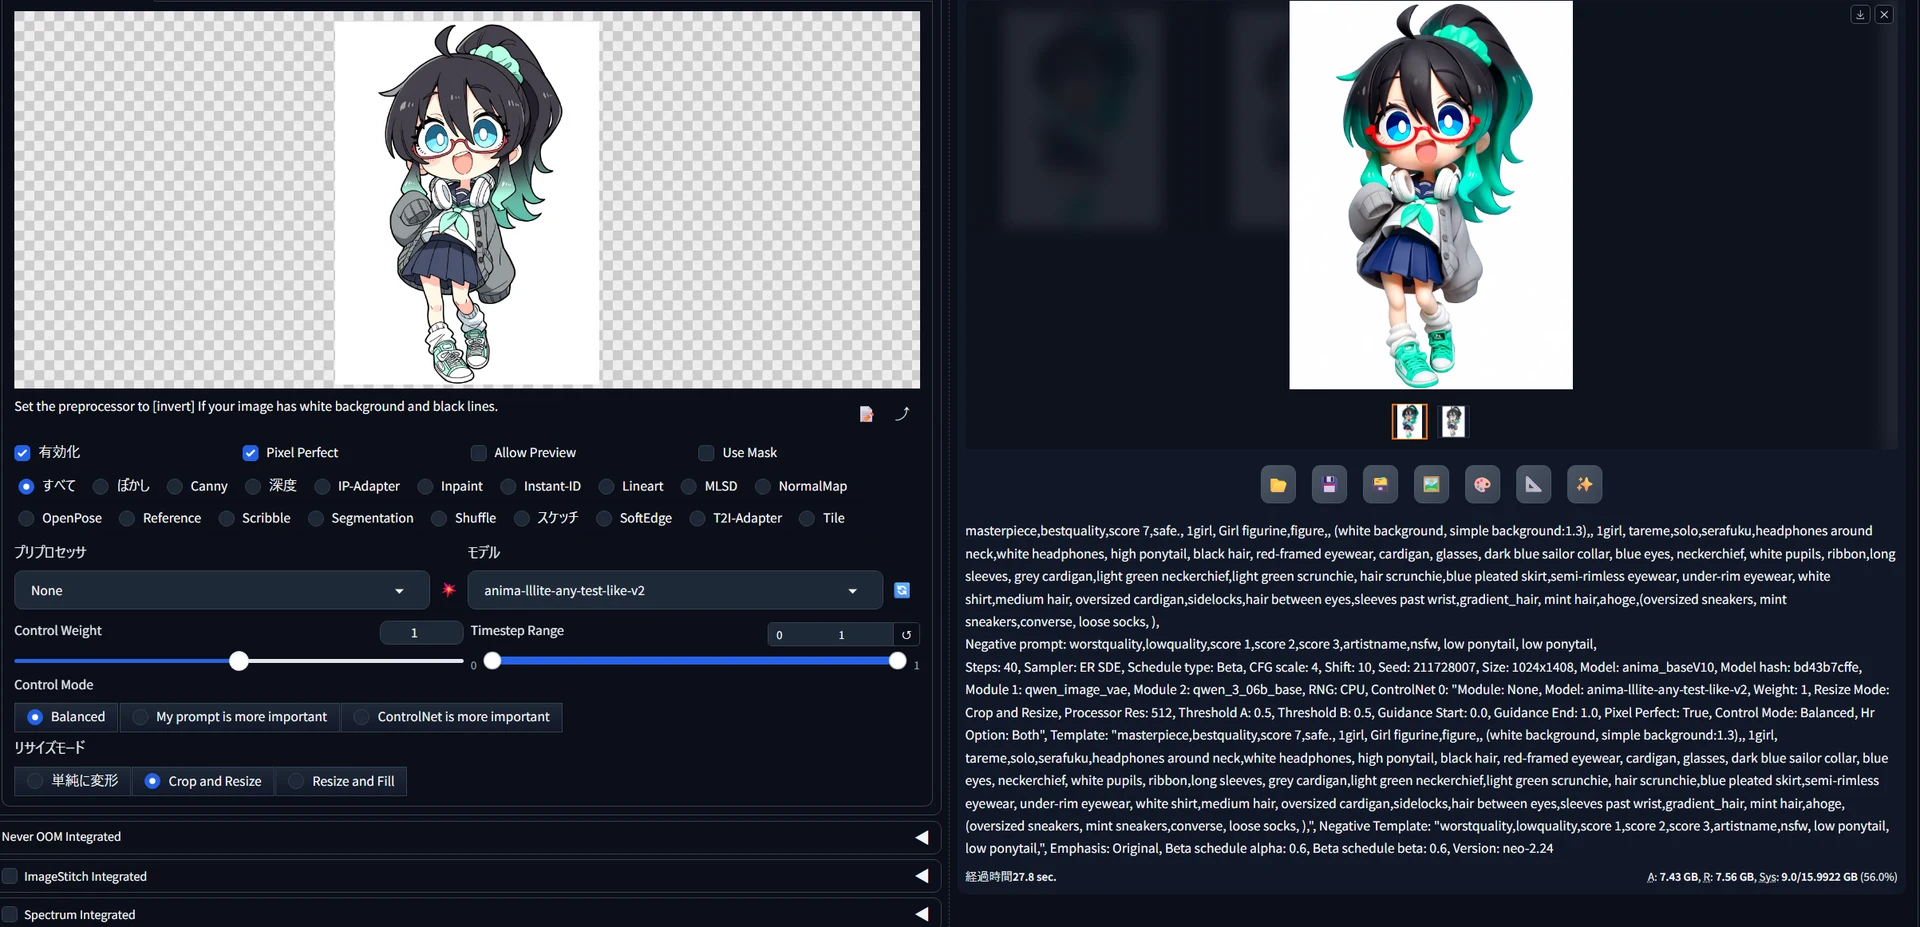
こちらがGif比較。(Animaは実写モデルではないので、3Dアニメチックになっています)
ミナちゃんの輪郭だけを保持するということは、逆に、ミナちゃん以外の部分を編集することもできます。「教室に立っていて同級生がいる。窓の外は青空」と自然文の英語で指示してみるとこうなります。
PP:masterpiece,bestquality,score 7,safe.A girl is standing in the classroom. There are many desks and classmates, and you can see the blackboard and the window. Outside, the sky is blue.(+ミナちゃんの容姿タグ)
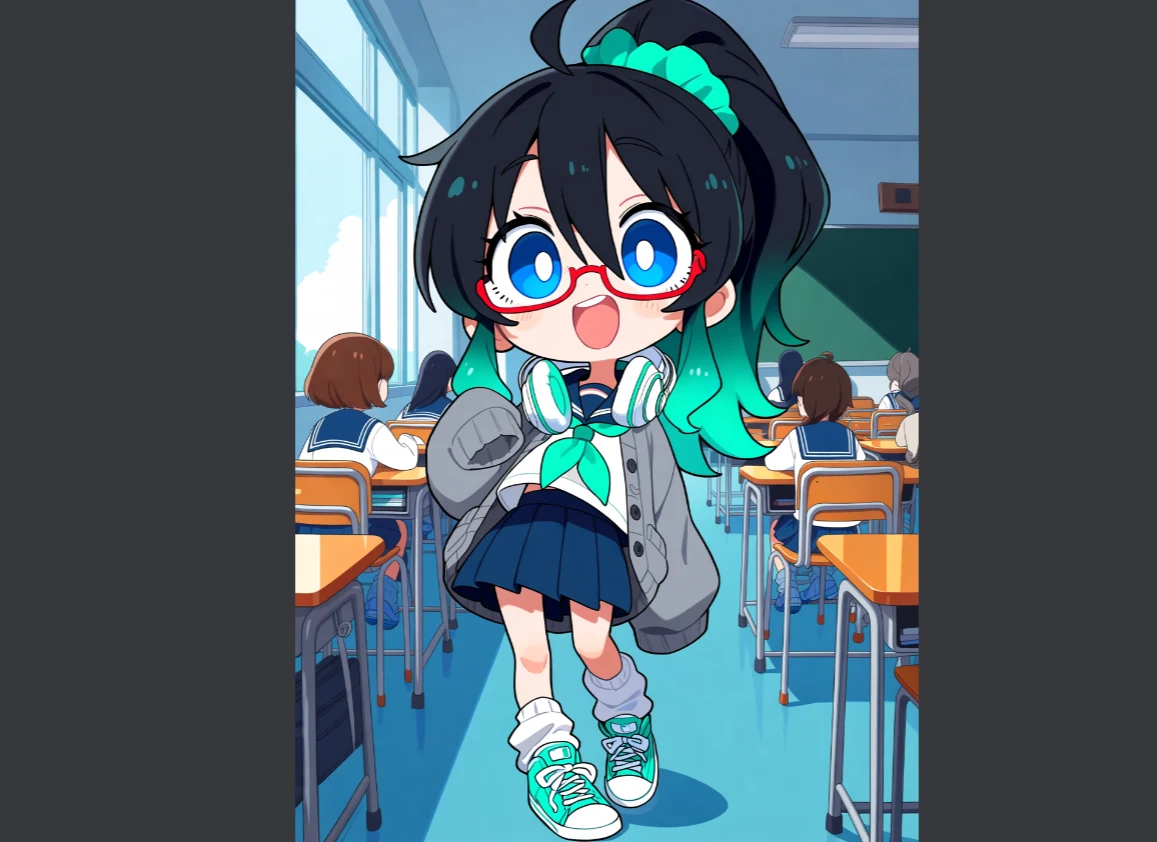
「輪郭を維持して別のものに変える」という仕組みなのですが、ある意味インペイントのような動きになっていますね。この応用力の高さがAnytest系の素晴らしいところです。

「anima-lllite-inpainting-v2」の使い方
Anytest likeでもインペイント風のことができましたが、こちらは純正のインペイントモデルです。ユーザーがマスクした範囲の内外を、プロンプト通りに「空気を読んで」繋げてくれる力があります。ポーズを一部変更したり、破綻部分を修正したり、表情を変えたりと、AIイラストにおいてはさまざまな用途に使える重要機能ですね。
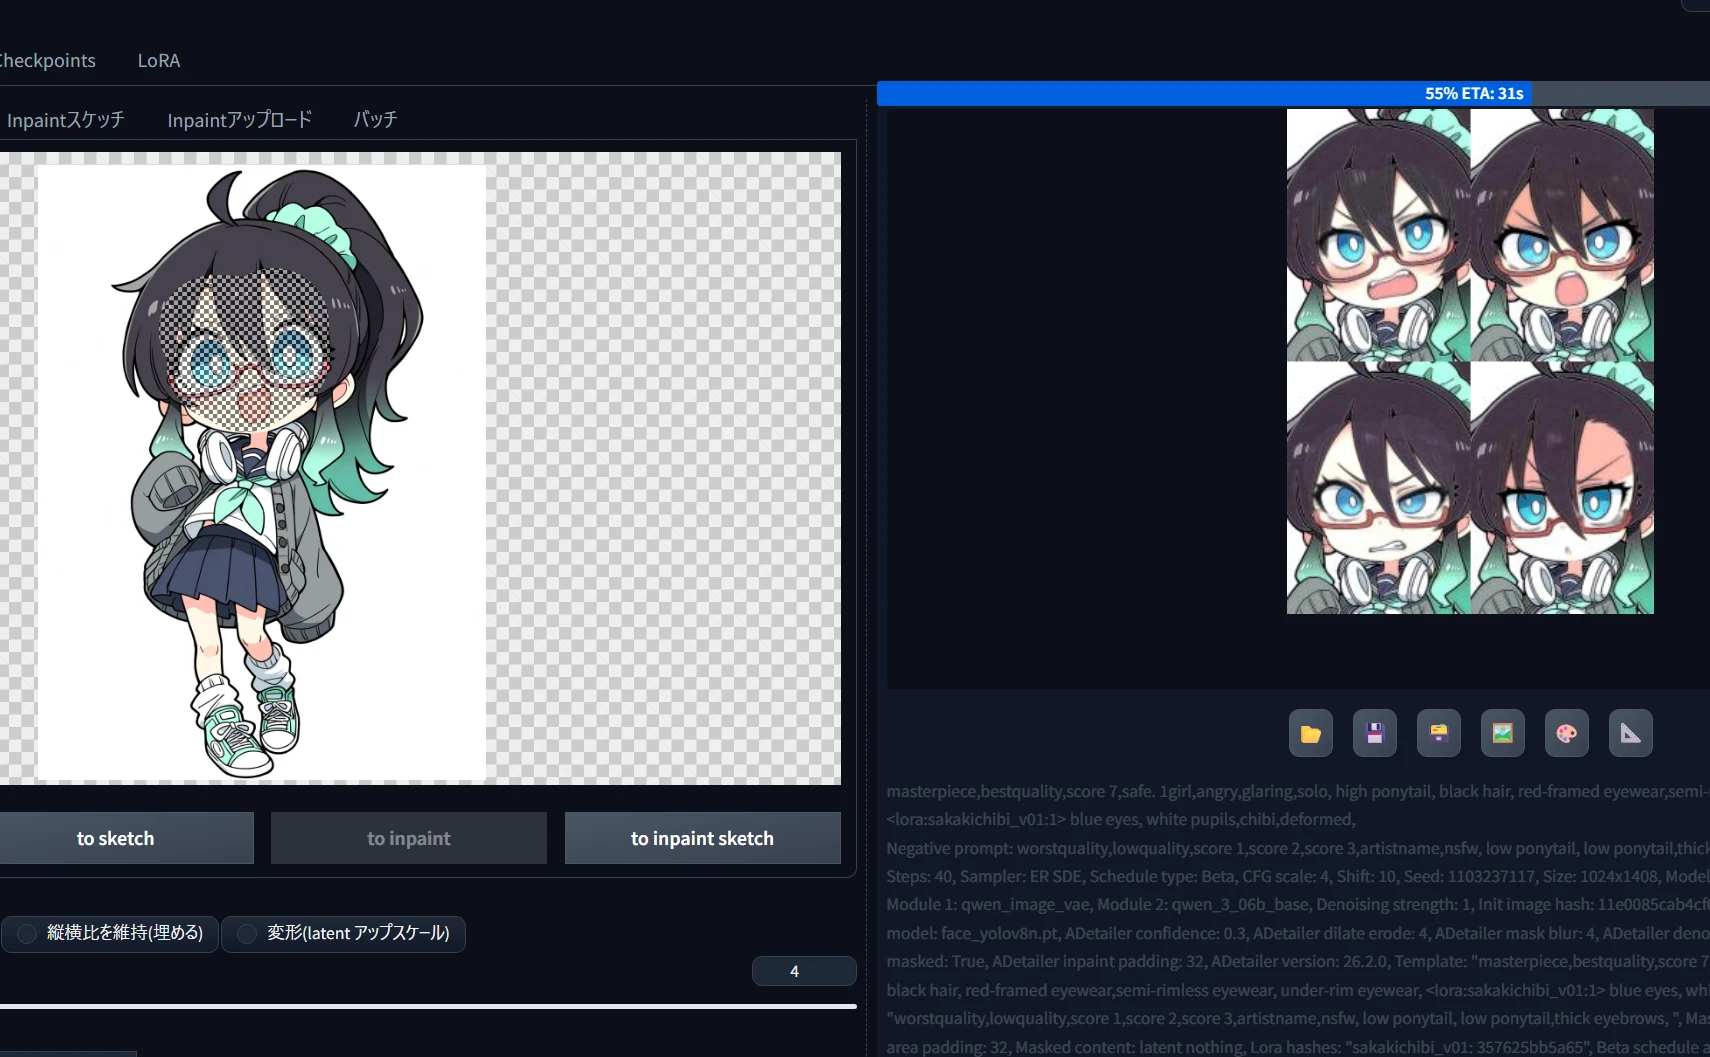
txt2img画面でも使えますが、入力画像に引っ張られてしまうため、img2imgのInpaintタブで使うのが基本。まずこのように、インペイント画面でインペイントしたい画像を読み込ませたら、顔を塗りつぶして表情変更を試してみます。
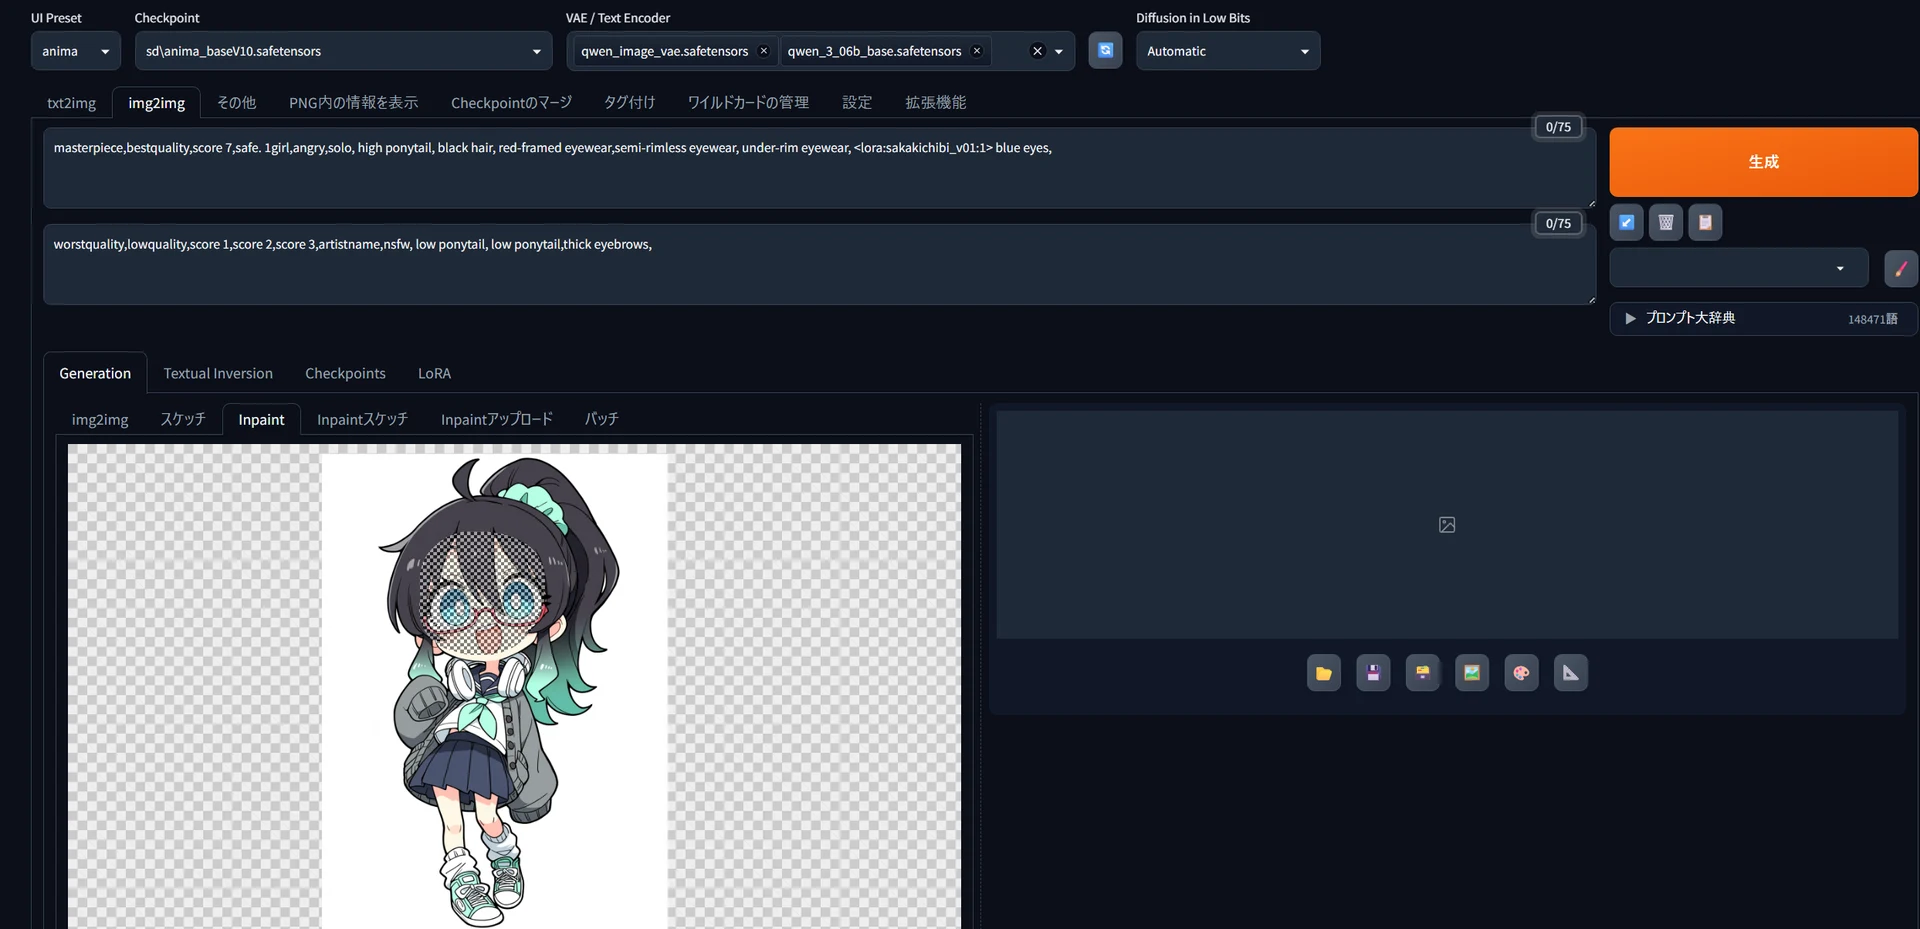
インペイント設定は以下のような感じ。表情をゼロから描き直したいので、「マスクされたコンテンツ」は「潜在空間における無」にします(入力画像をimg2imgしたいだけなら「元の画像」にします)。インペイントモデルはDenoising Strength(ノイズ除去強度)1が基本。画像サイズは1024サイズから大きく離れないようにしないと破綻します。
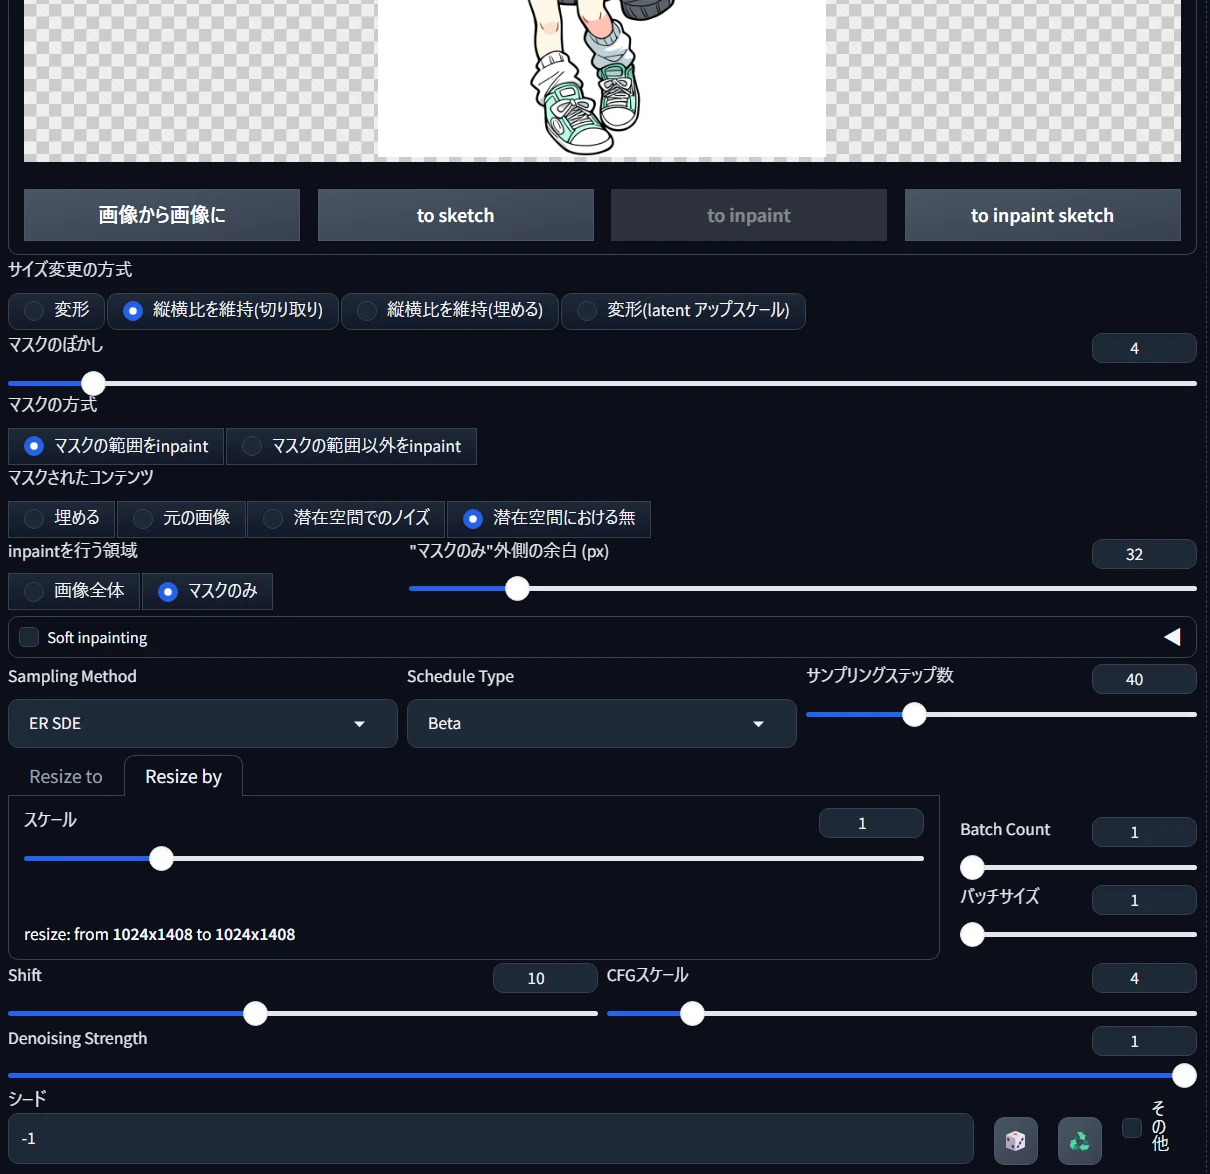
※このあたりの設定については「インペイントが理解る!」を参照のこと。
あとはControlnet画面でこのように指示。有効化とPixel perfectにチェックを入れておき、プリプロセッサはNoobai Inpaintingと違い「None」にするのがポイント。モデルは「anima-lllite-inpainting-v2」を選び、ほかはデフォルトのままでOKです。
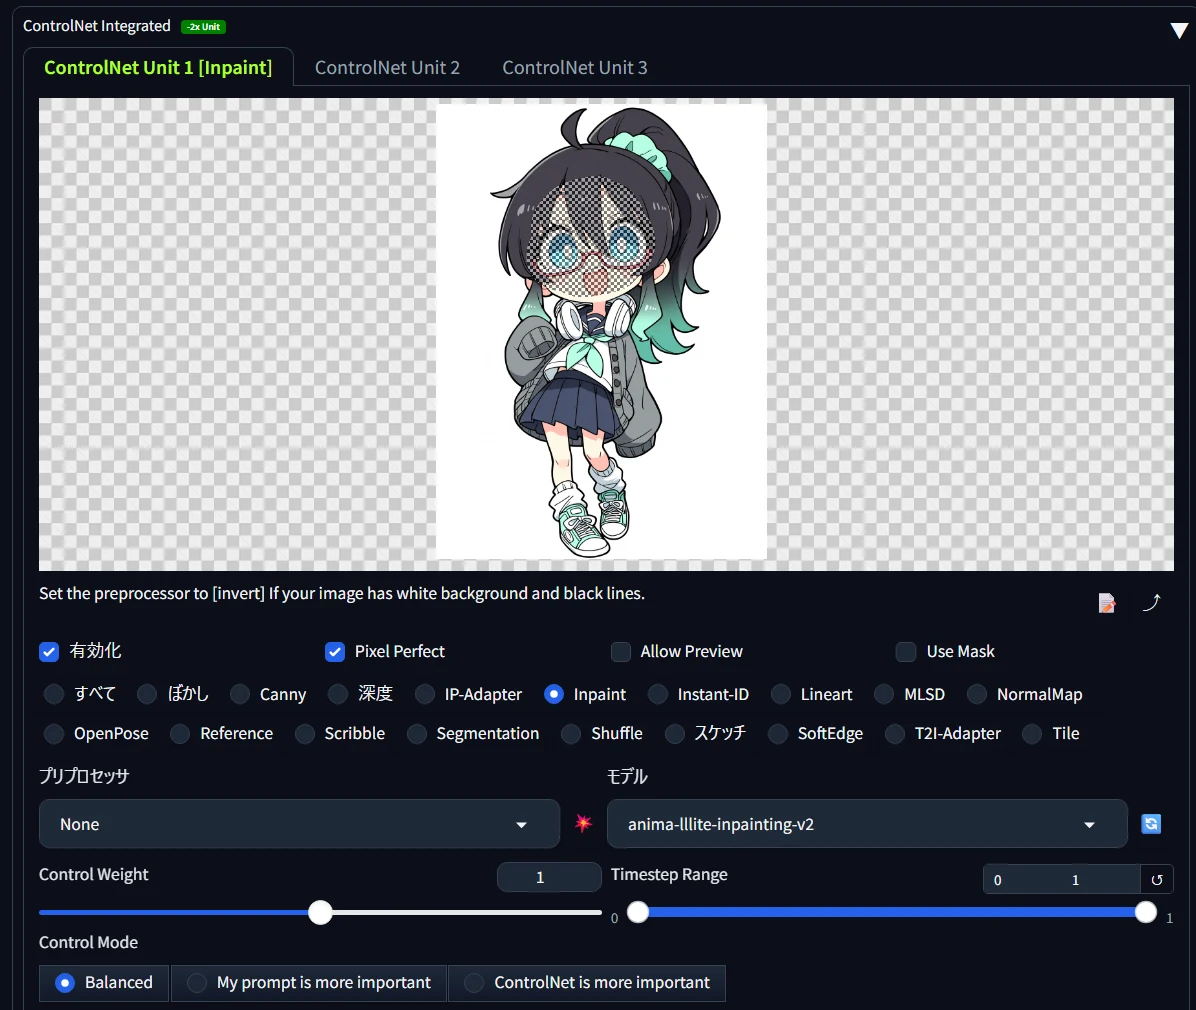
あとは「angry,glaring」と指示すると、選択部分だけが描き直されます。
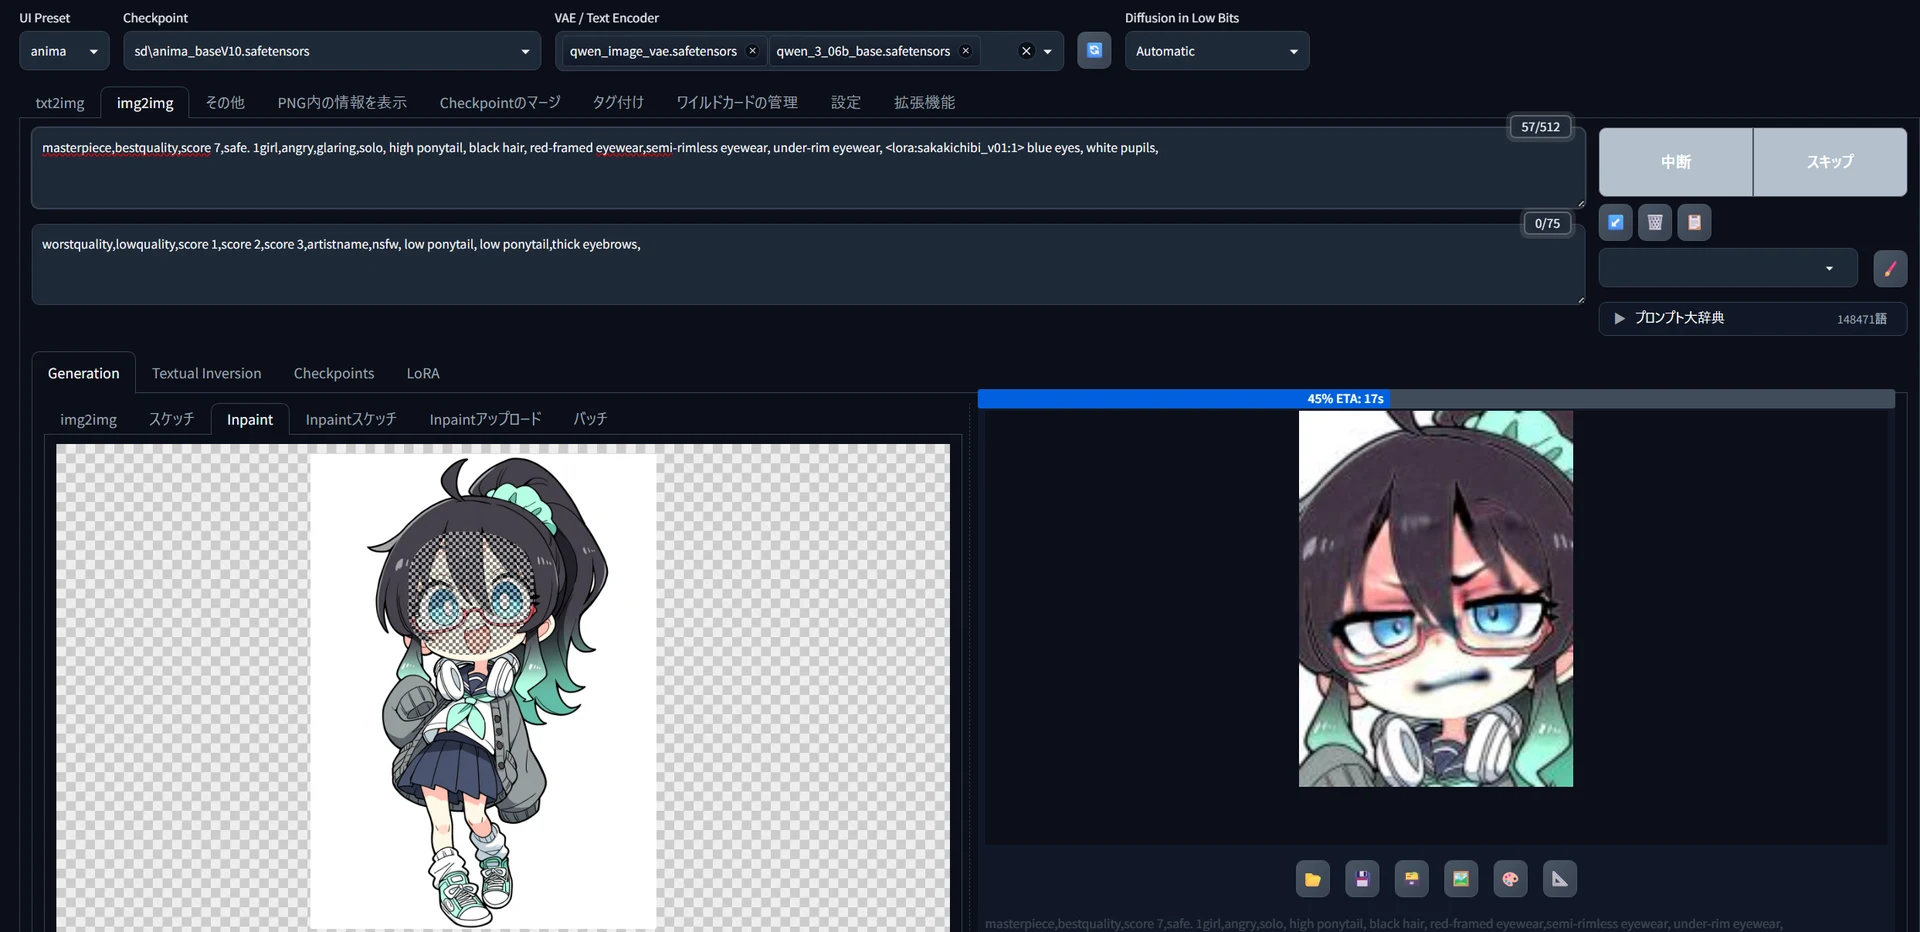
これは悪い例。眉毛の一部(右上)を塗りつぶしそこねているので、怒り顔の方で少し残ってしまっていますね。ちゃんと矛盾しないようにぬりつぶしておいて、最後にADetailerを重ね掛けするとより綺麗になります。
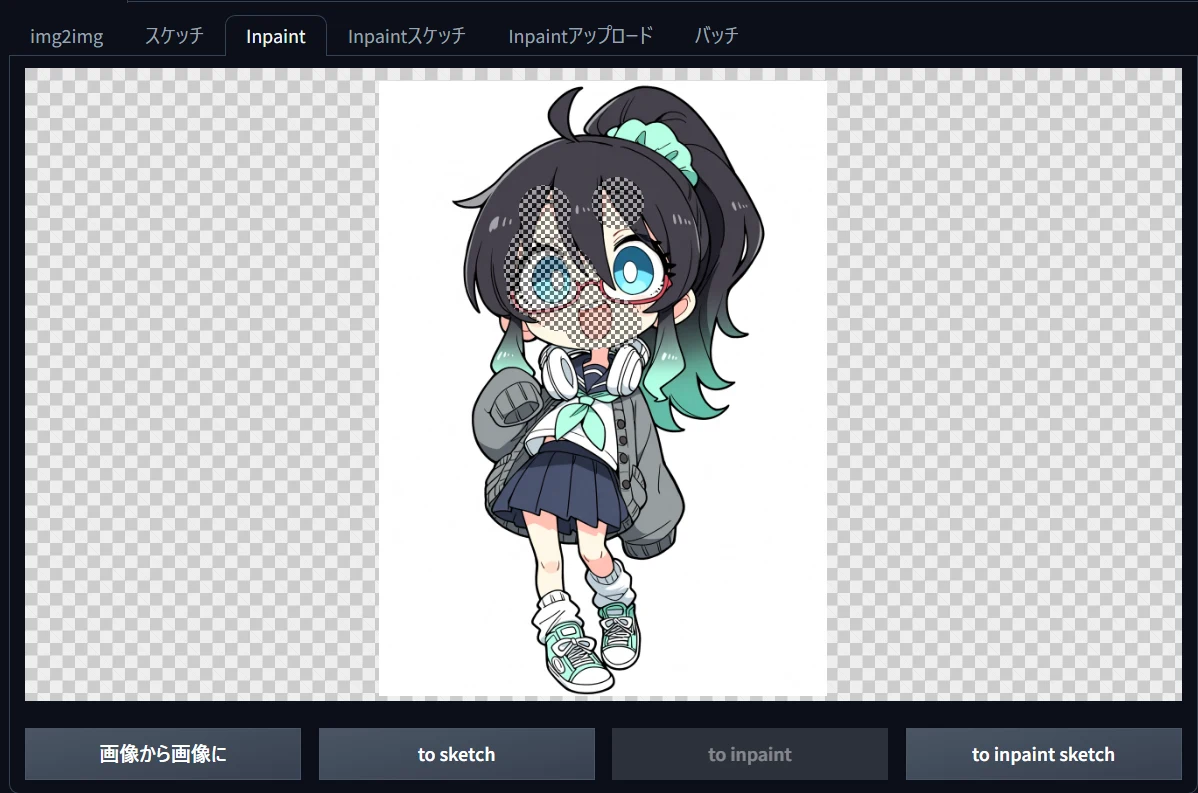
ちなみに、Controlnet適用なしでInpaintするとこのような感じになります。「空気を読んで」インペイント範囲の内外をつなげる力がないので、単純にそれっぽくimg2imgしてくっつけるような動作になり、髪型などが大きく変化してしまう(=別キャラになってしまう)わけですね。
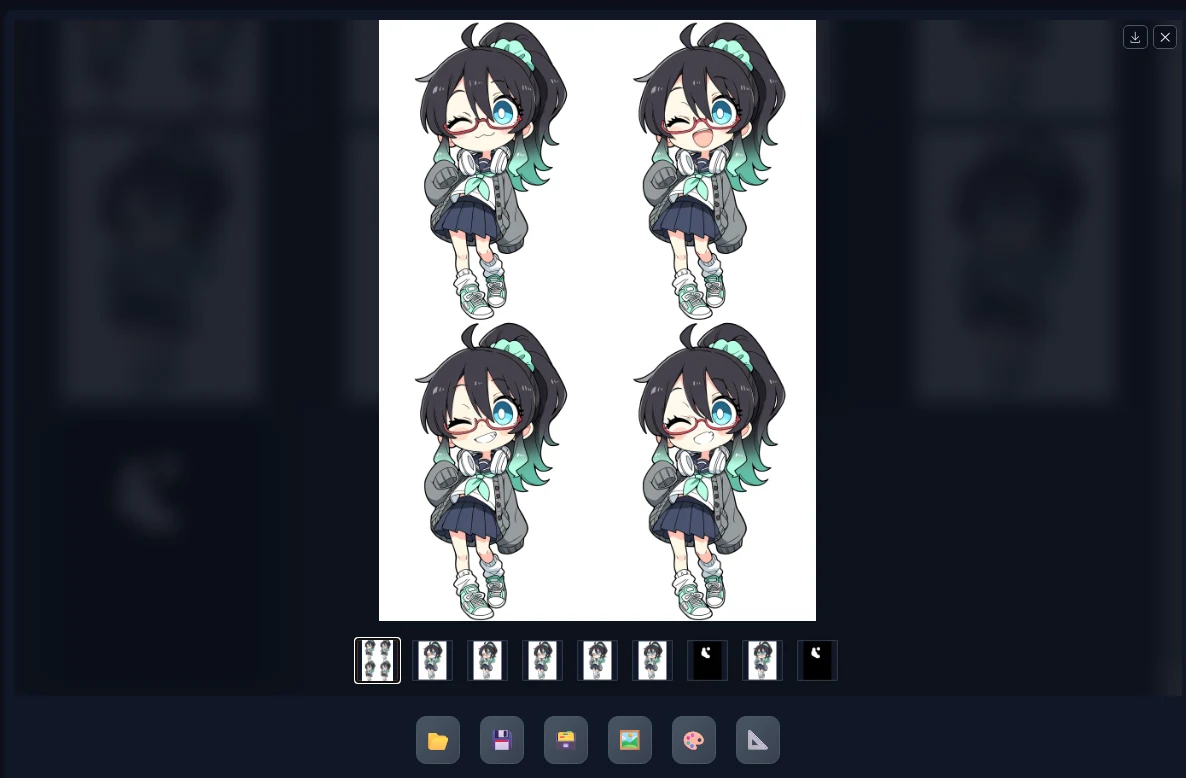
上手にやるコツは、できるだけマスク範囲を最低限にしつつ、取捨選択することです。例えばこのように囲って「one eye closed」と指示すると、
こんな感じでミナちゃんの顔の印象を崩さないままでウィンクさせられます。手足のポーズを変更してもいいですね。
インペイントが使えると使えないとでは、そのモデルでできることが全く変わってきます。とりわけ、自然言語で細かな指示ができるAnimaでインペイントができるようになると、表現の幅がかなり広がりそうですね。

さて、次は気になるNSFW生成についてです。Animaは基本的にドスケベモデルですので、アニメ調・漫画調のR-18画像生成がかなり自在にできます。今回は、4つのシチュエーション再現を通じてその実力を見てみたいと思います。(いずれもWAI-ANIMAを使用。モザイク部分以外は生成物そのままです)
R-18画像が複数掲載されますので、閲覧時は周囲にご注意ください。