【2026/04/15更新】「サブスクAnlasを使い切れなかったときは」を追記しました。
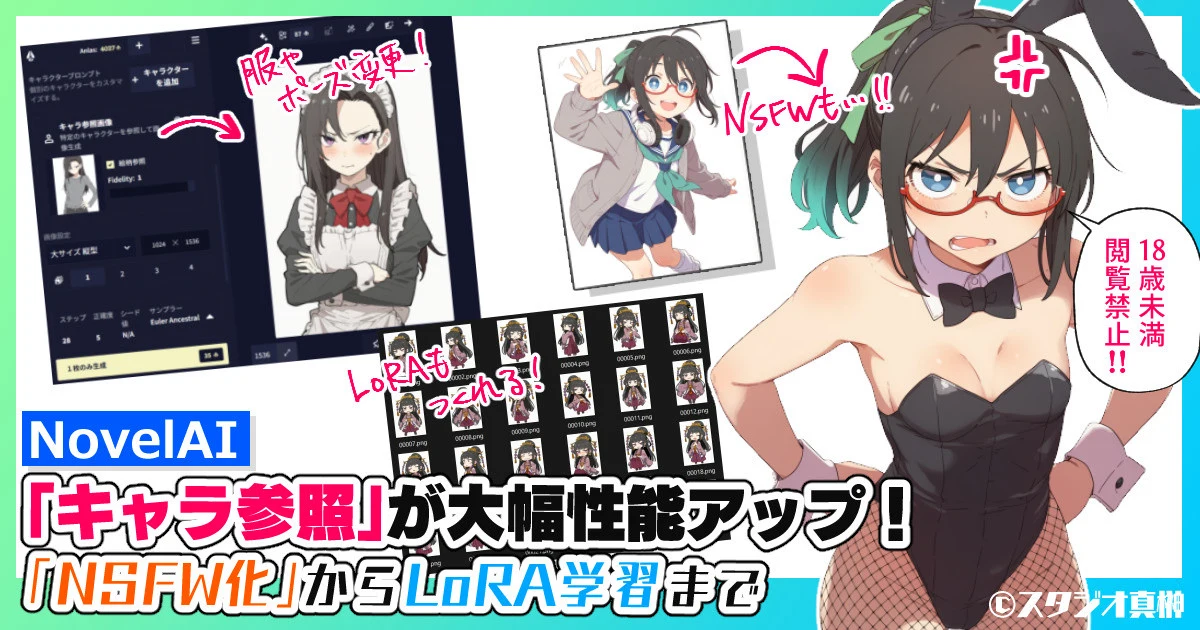
こんばんは、スタジオ真榊です。今回は、NovelAIの「キャラクターリファレンス(キャラ参照)」機能の大特集です。ちょうど1か月前の9月11日に試験実装された機能ですが、今回性能が大幅アップデートされ、NanoBananaやSeedream4のようにキャラクターの一貫性を保ちながら、アングルやポーズ、表情を自由に変更できるようになりました。
先日の特集では、Seedream4で1枚しかないキャラクター絵のバリエーションを生成し、キャラLoRAを作る手法を特集しようとしたのですが、規約で出力物の他モデル学習が禁止されていたため断念。しかし、NovelAIはご存じの通り、出力物のLoRA学習もNSFW生成も、規約上は明示的に禁止されていません。なんとおおらか!
そこで今回は、新生「キャラ参照」を使った各種性能実験に始まり、「このキャラを裸にして」「〇〇させて」といった「NSFW指示」を加えられるか、オリジナルキャラクターの容姿を学習させたLoRAを作れるかについて、2万字超の大ボリュームで徹底検証を行いました。NovelAIは初めてor久しぶりという方は、こちらに「v4」「v4.5」で導入された各機能がまとまっていますのでご覧ください。
(3章にはR-18画像が多数掲載されます。閲覧時は周囲にご注意ください)
1.キャラクターリファレンス(キャラ参照)とは
NovelAIのキャラクターリファレンス機能は、入力した1枚の画像から、キャラクターデザインと画風を読み取って出力結果に反映させるキャラ再現機能です。NovelAIの最新モデル「NAI Diffusion v4.5」のFullバージョン、もしくはCuratedバージョン(R-18機能制限版)で使用することができます。(前回記事はこちら)
似た機能として「ポーション」機能がありますが、これは読み込ませたイラスト全体の雰囲気や絵柄、カラーリング、構図などをざっくり参照する機能。「キャラ参照」はよりキャラクターの容姿・デザインを再現することに特化しており、表情やアングル、ポーズ、衣装、シチュエーションなどを任意に変更しやすい機能となっています。
使い方はごく単純で、img2imgのように画面上に画像をドラッグアンドドロップするか、画面左側の「キャラ参照画像」のボタンから画像を読み込むだけ。キャラクターデザインだけを参照するか、それとも絵柄まで参照するかをオンオフできるほか、今回のアップデートで「Fidelity(忠実度)」を調整することができるようになっています。
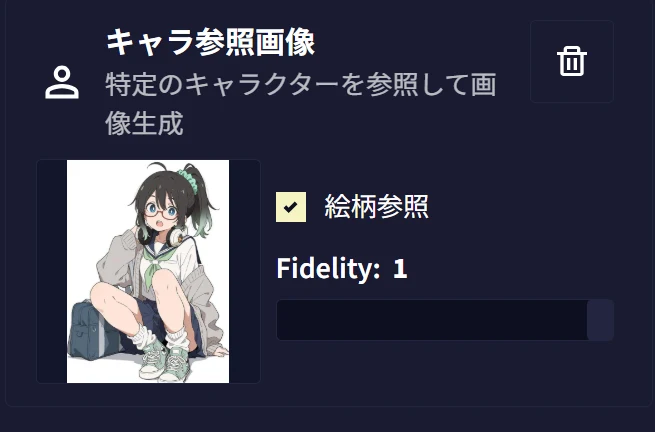
忠実度が最大の「1」だと、今回搭載された一貫性保持力が発揮され、忠実度「0」にするとアップデート前の挙動に戻るとのこと。よって、絵柄参照オン&忠実度「1」でキャラクターを再現するのが基本となりますが、「この画像のキャラを別の絵柄タグで再現したい」とか「普段の自分の画風に寄せたい」といった場合には絵柄参照をオフにしたり、忠実度をほどよく下げたりして調整する必要があります。
・入力画像選びのコツ
以下は、アップデート前の段階でNovelAI公式が示していた、キャラ参照させる画像選びについてのコツです。
①基本的には「シンプルな背景でニュートラルなポーズを取って立っているキャラクターの全身ショット」が望ましい。(※上半身だけを生成したいなら参照画像も上半身だけでOK)
②スケッチやラフ風の画像よりも、線や塗りがはっきりしたアニメ調のような画像のほうが参照しやすい。
③汎用性重視なら、そのキャラを複数の角度からとらえた三面図や設定画風の画像を入力する。画像の隅に顔のアップがあるとさらに効果的。
④なかなか似ない特徴がある場合は、その特徴を示すタグをプロンプトに追加する。(例:tsurimeやthick eyebrowsなど)
まとめると、可能ならこのような全身図とアップが混じった画像を参照させつつ、うまくいかないときは「grey cardigan」や「red-framed eyewear」「white pupils」などをプロンプトに足して誘導してあげる・・・というのが基本となります。
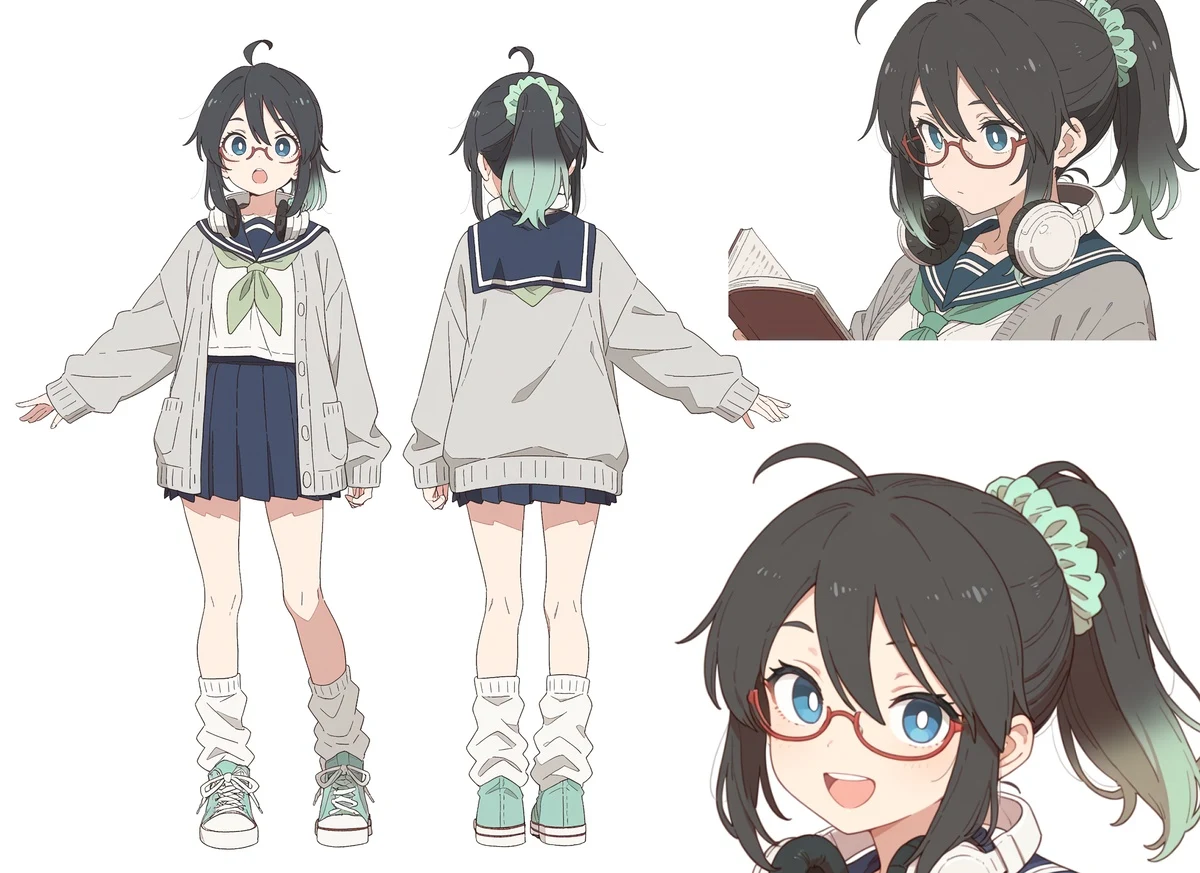
付け加えると、目をつぶっていたり、極端な表情をしていたりする画像だとキャラクターの特徴や画風をうまく似せられなくなる(例えば、目を開いたときにどんな目に描けばいいかわからない)ので、そうした画像は避けたほうがよいということになります。また、手や衣装の細かな描写などもかなり読み取ってくるので、どこかに間違いがあったり、角度的に4本指や6本指に見える画像を入力してしまうと、出力画像も描写が不正確になりやすいことも覚えておきましょう。
・大幅機能アップデート
今年9月に搭載されたばかりのキャラ参照機能ですが、10月7日にこのようなリリースがあり、キャラクター再現時の一貫性と精度が「飛躍的に改善」されたと発表されました。
アップデート前の「キャラ参照」の性能はこのような感じ。指の崩壊が目立つほか、衣装のデザインはかなり頑張れているものの、画風はかなり変更されている印象がありました。当時は公式も「髪型や服装、表情といったそのキャラクターらしさを決める特徴に集中して再現する」と説明しており、完璧な模倣ではないことを言外に認めていたように見えます。
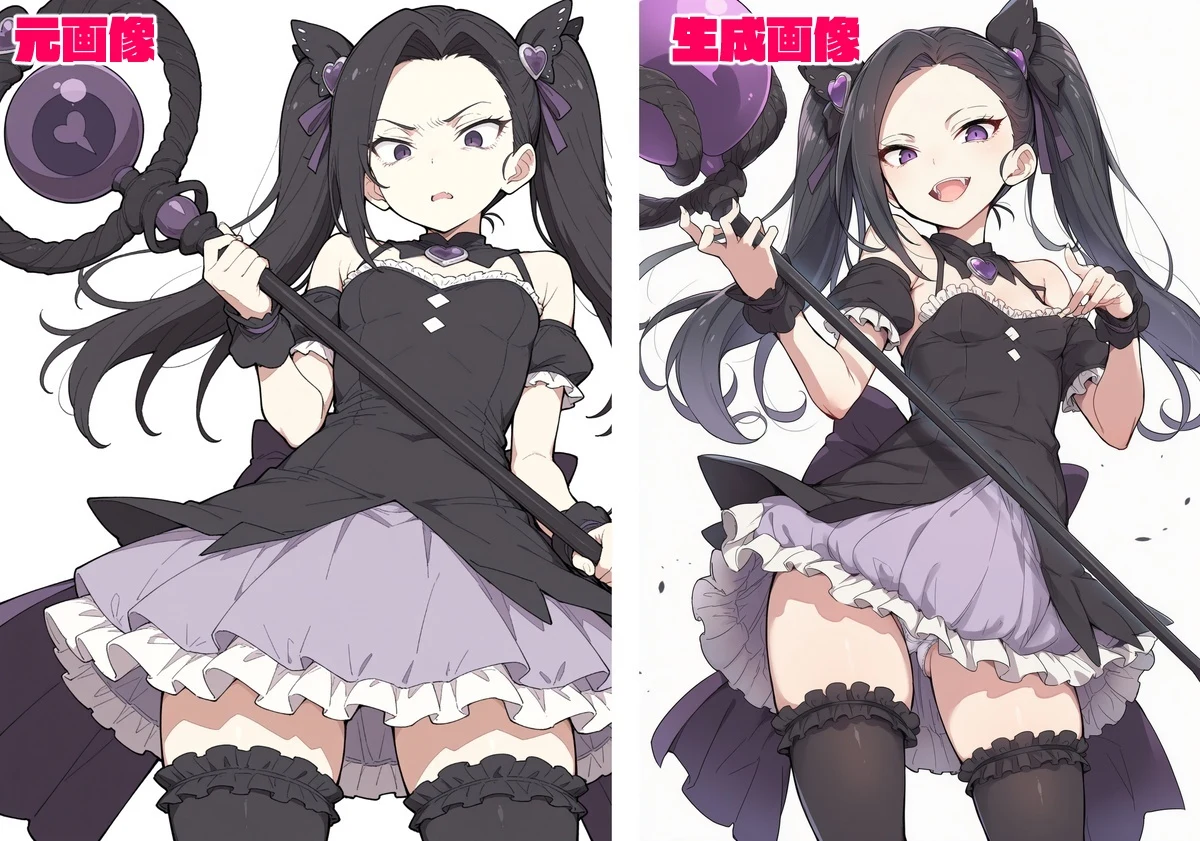
9月はNanoBananaやSeedream4などの高性能モデルが次々に登場していたタイミングでもあり、あまりNovelAIがキャラ参照機能で注目されることはなかったのですが、今回のアップデートでどのように変わったのか、さっそく見ていきましょう。
2.新生「キャラ参照」の実力を試す
絵柄参照をON・忠実度も最大の「1」の状態でテストを行います。プロンプトや入力画像を変更しながら試行を重ねましたので、とりあえず生成結果をご覧ください。
※以下、生成サイズは断りのない場合「大サイズ縦型(1024x1536px)」とし、ステップ28、正確度5、シード値はランダム、サンプラーはEuler Ancestralで生成しています。品質タグはON(very aesthetic,masterpiece,no textが追加)、除外したい要素プリセットは「強い」で行いました。
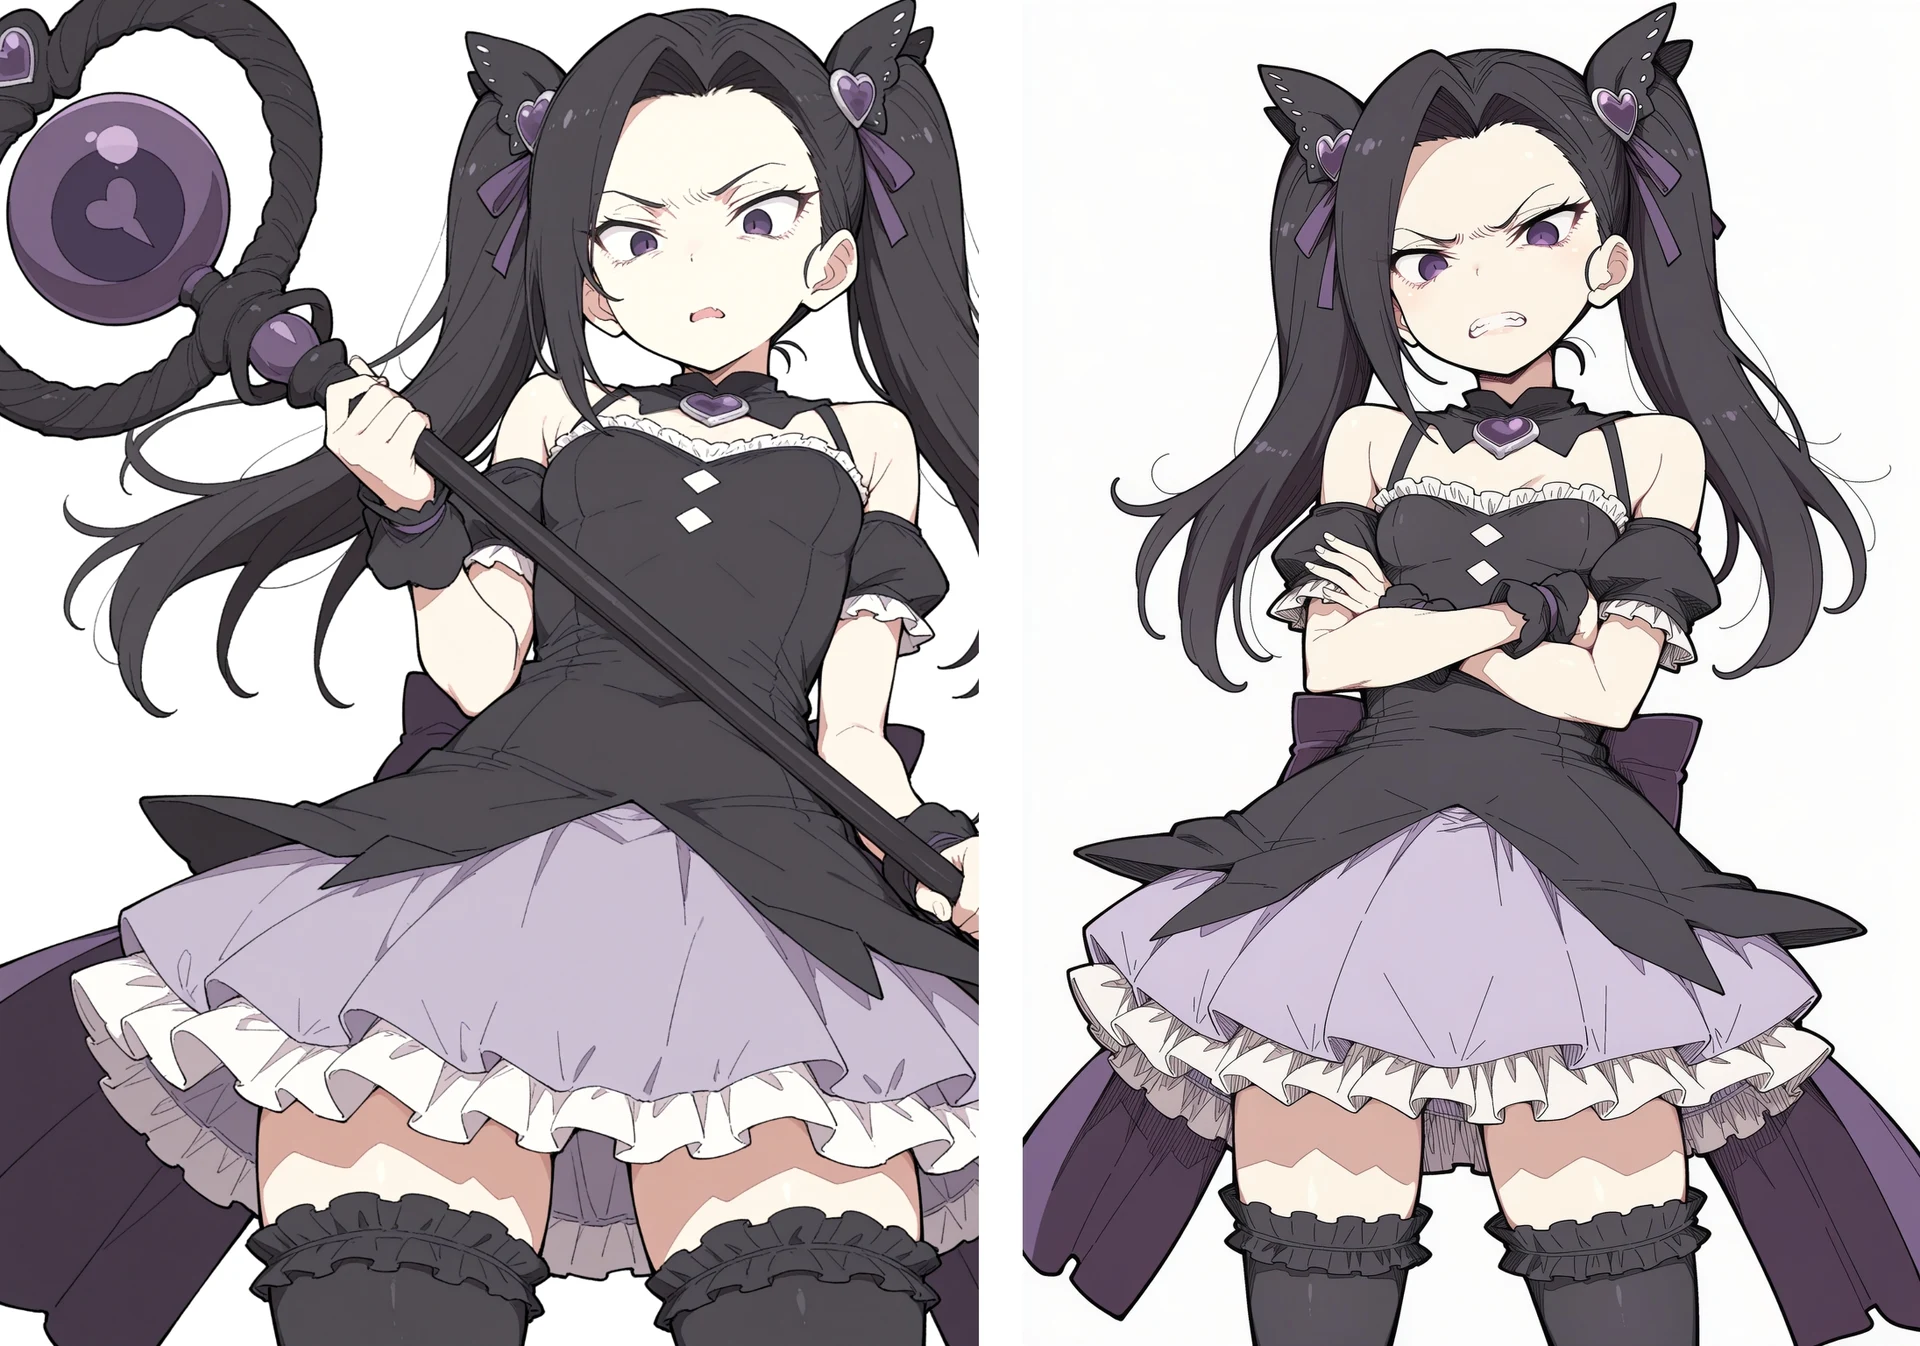
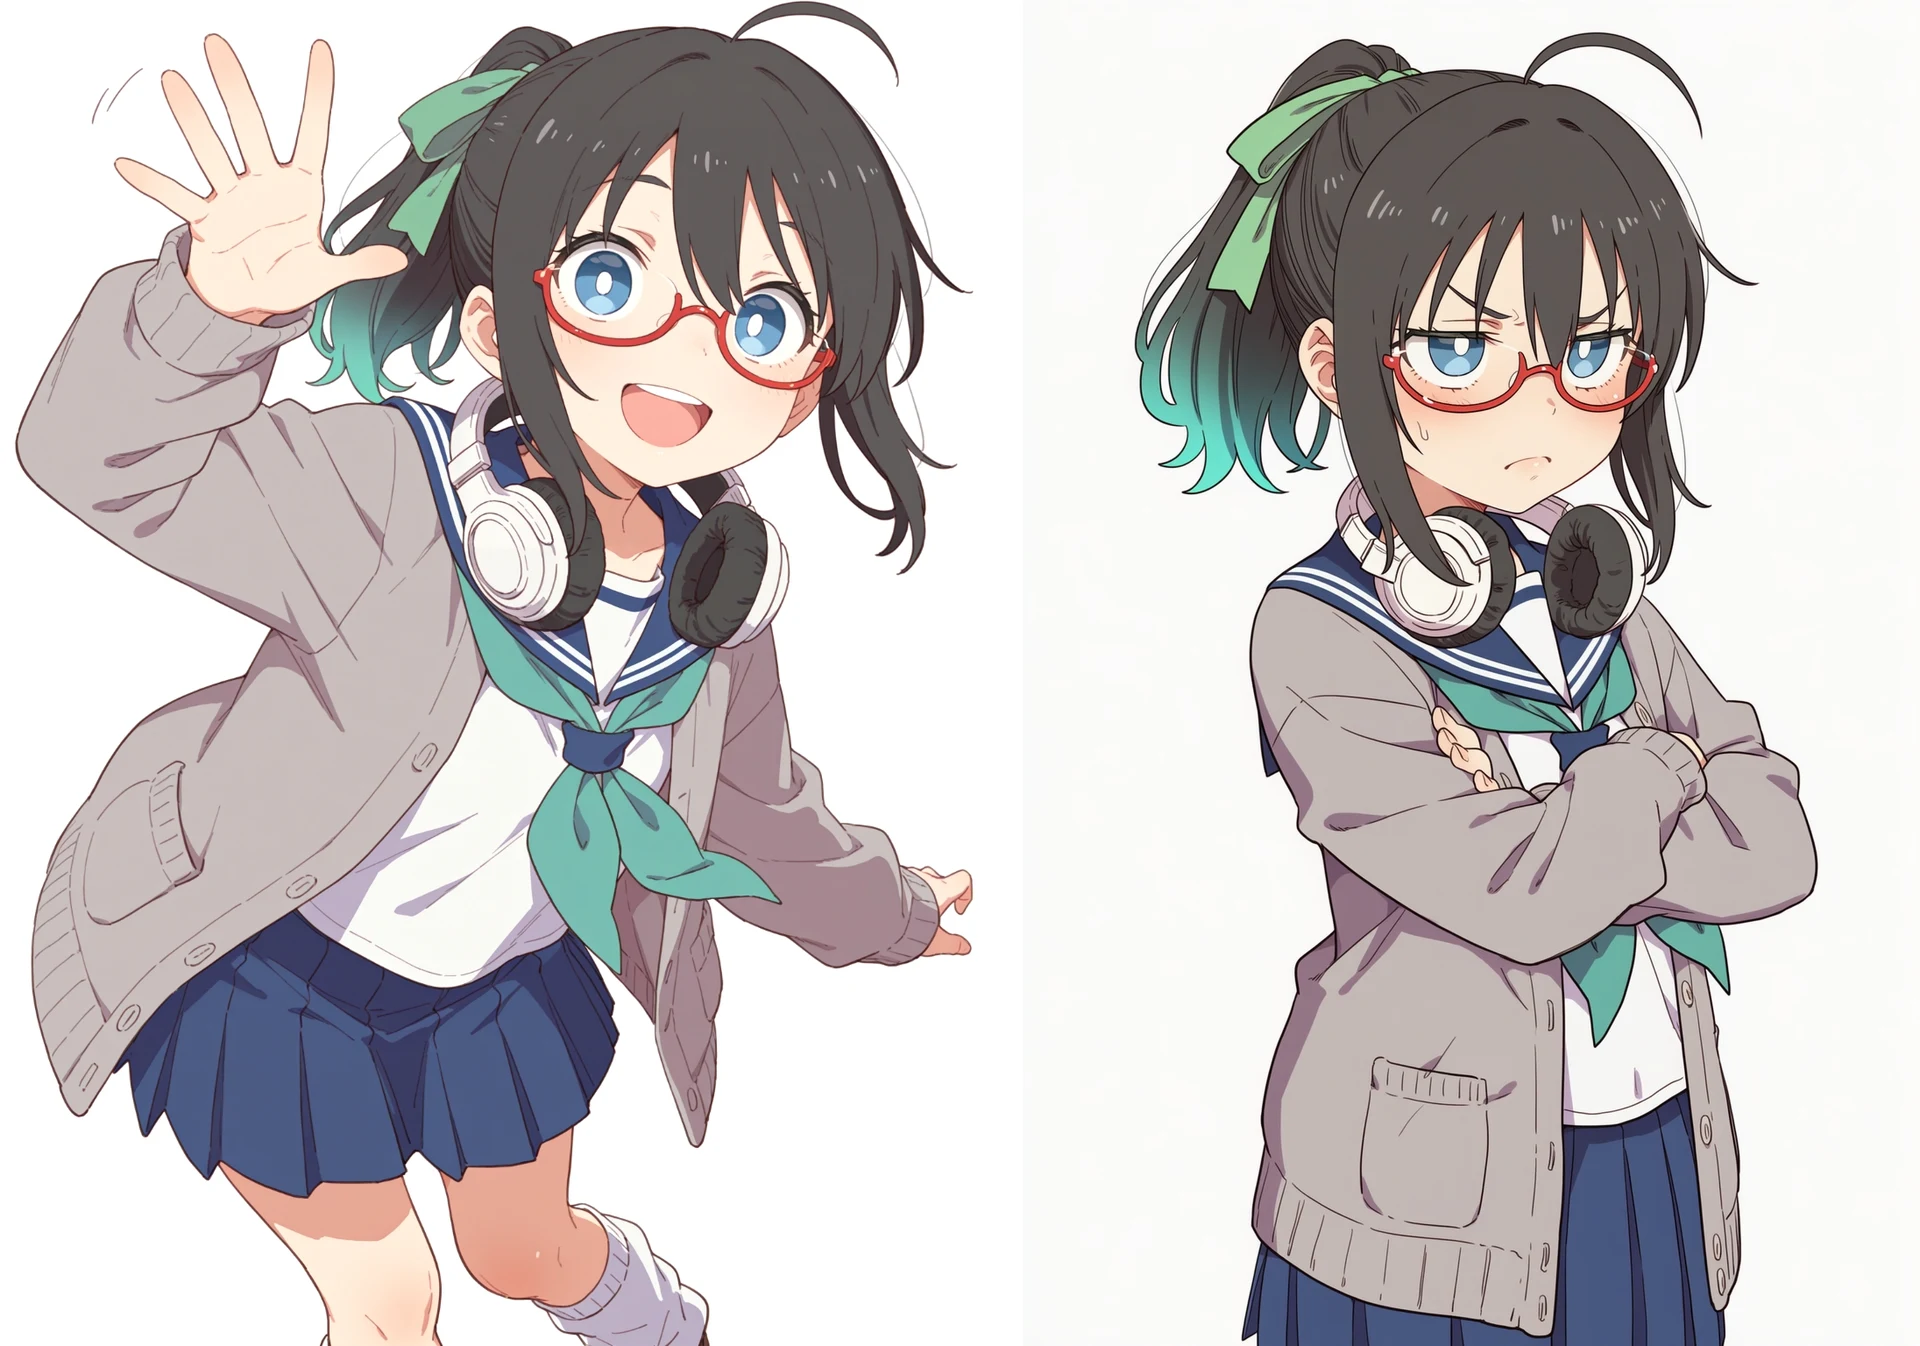
①怒り顔+腕組み
指示「1girl,angry,crossed arms」
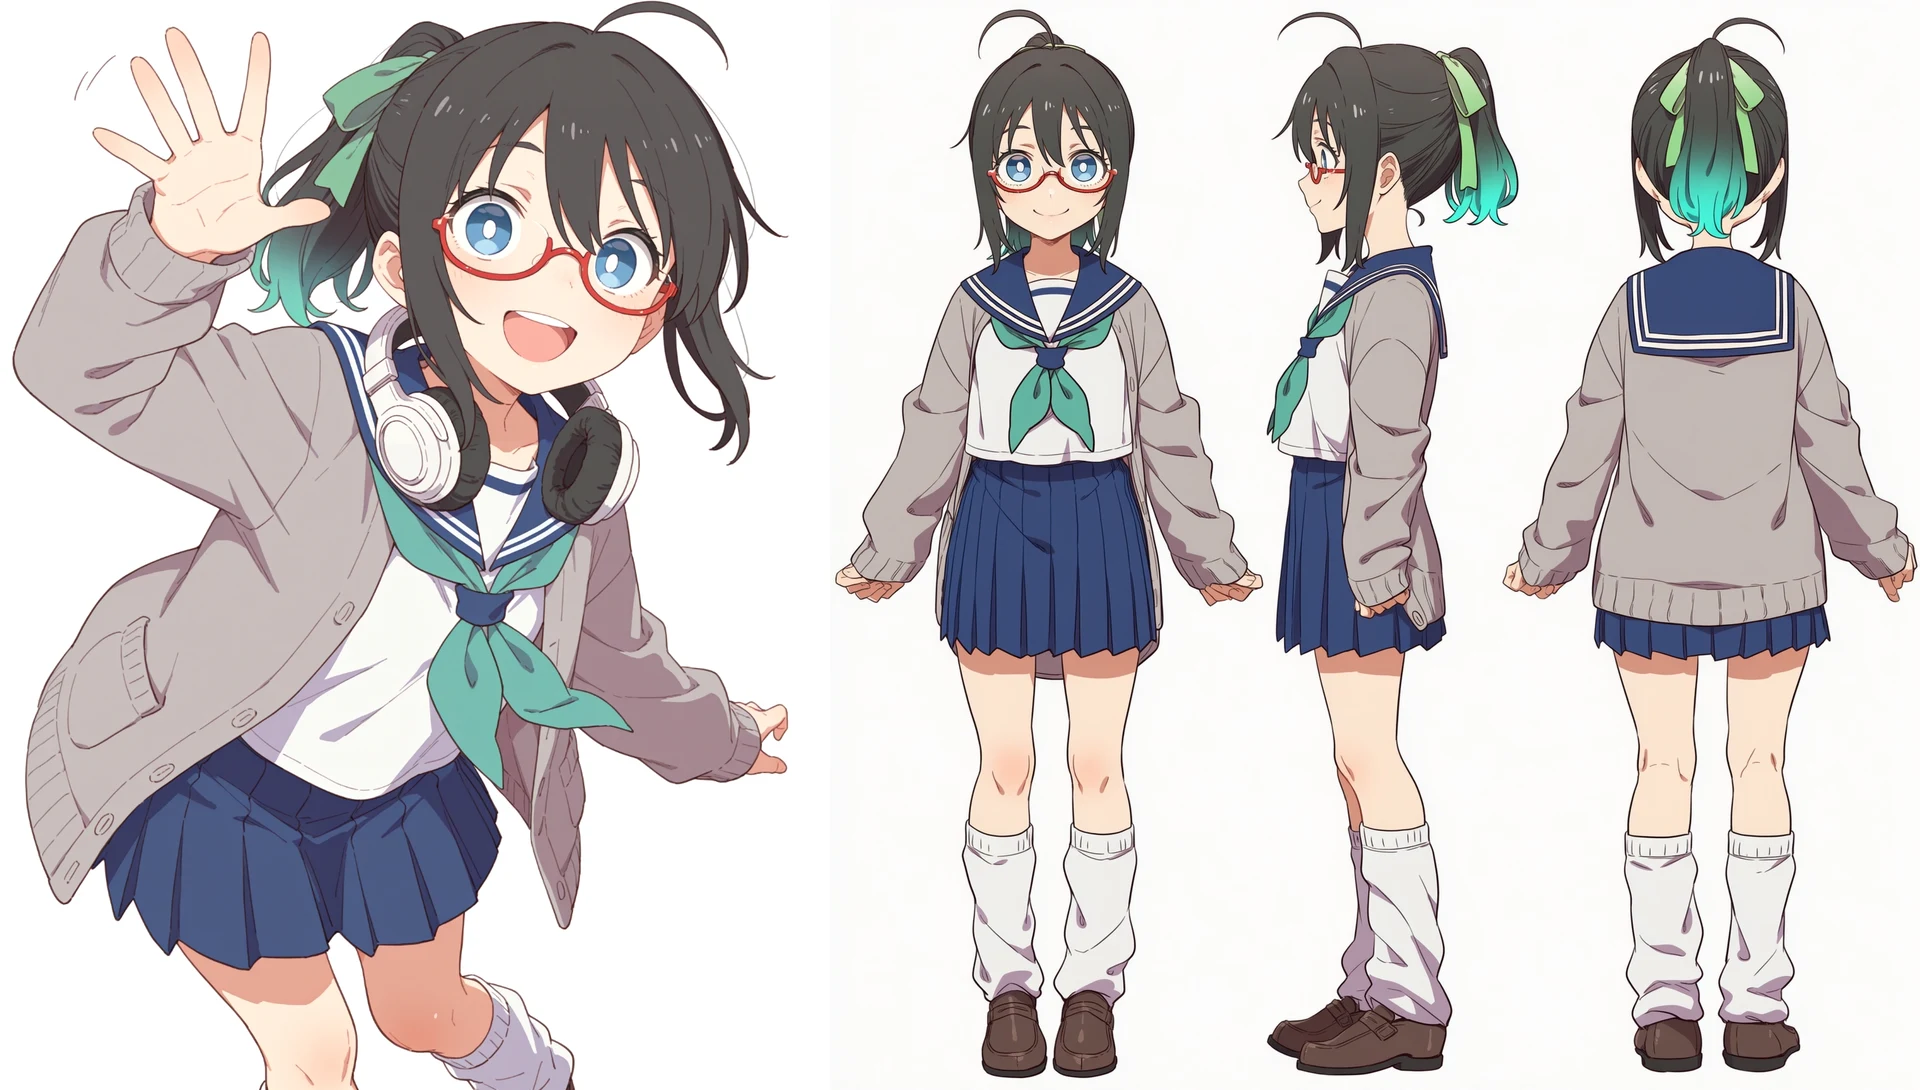
②キャラ設定三面図
指示「1girl,reference sheet,standing,from side,from behind,straight-on」(大サイズ正方形)
③バニーガール
指示「1girl,playboy bunny」
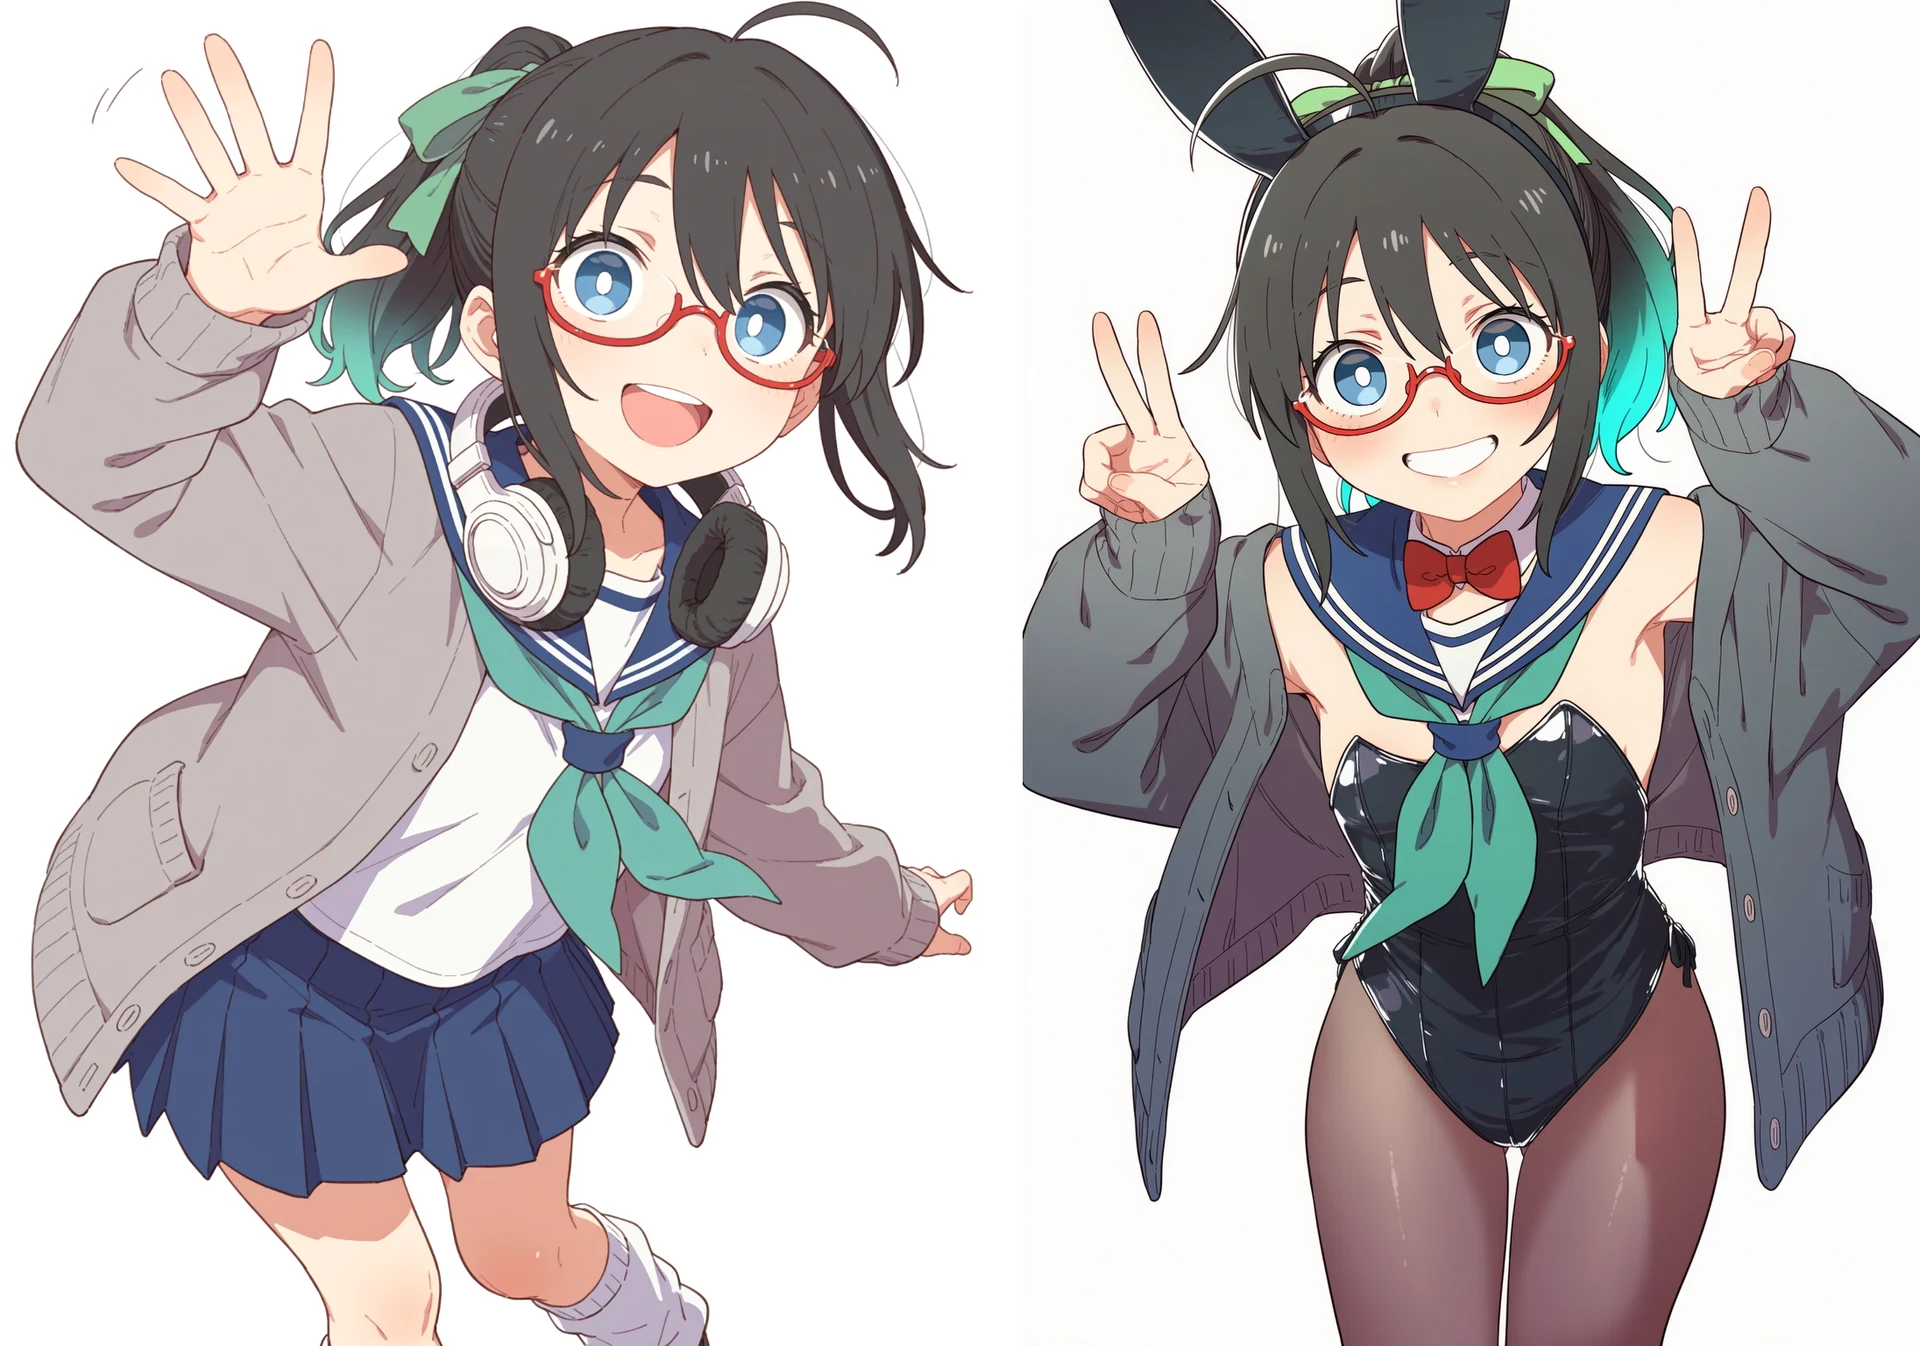
このように、プロンプトが単純すぎると変更しきれないことがよくありました。服装などが元画像に引っ張られる場合は、プロンプトをさらに詳しくして誤解が生じないようにするか、元画像の再現したくない要素(この場合はserafukuなど)をNPに入れると改善します。
指示「1girl,playboy bunny, bunny suit,black leotard,rabbit ears,glaring,hand on hip」
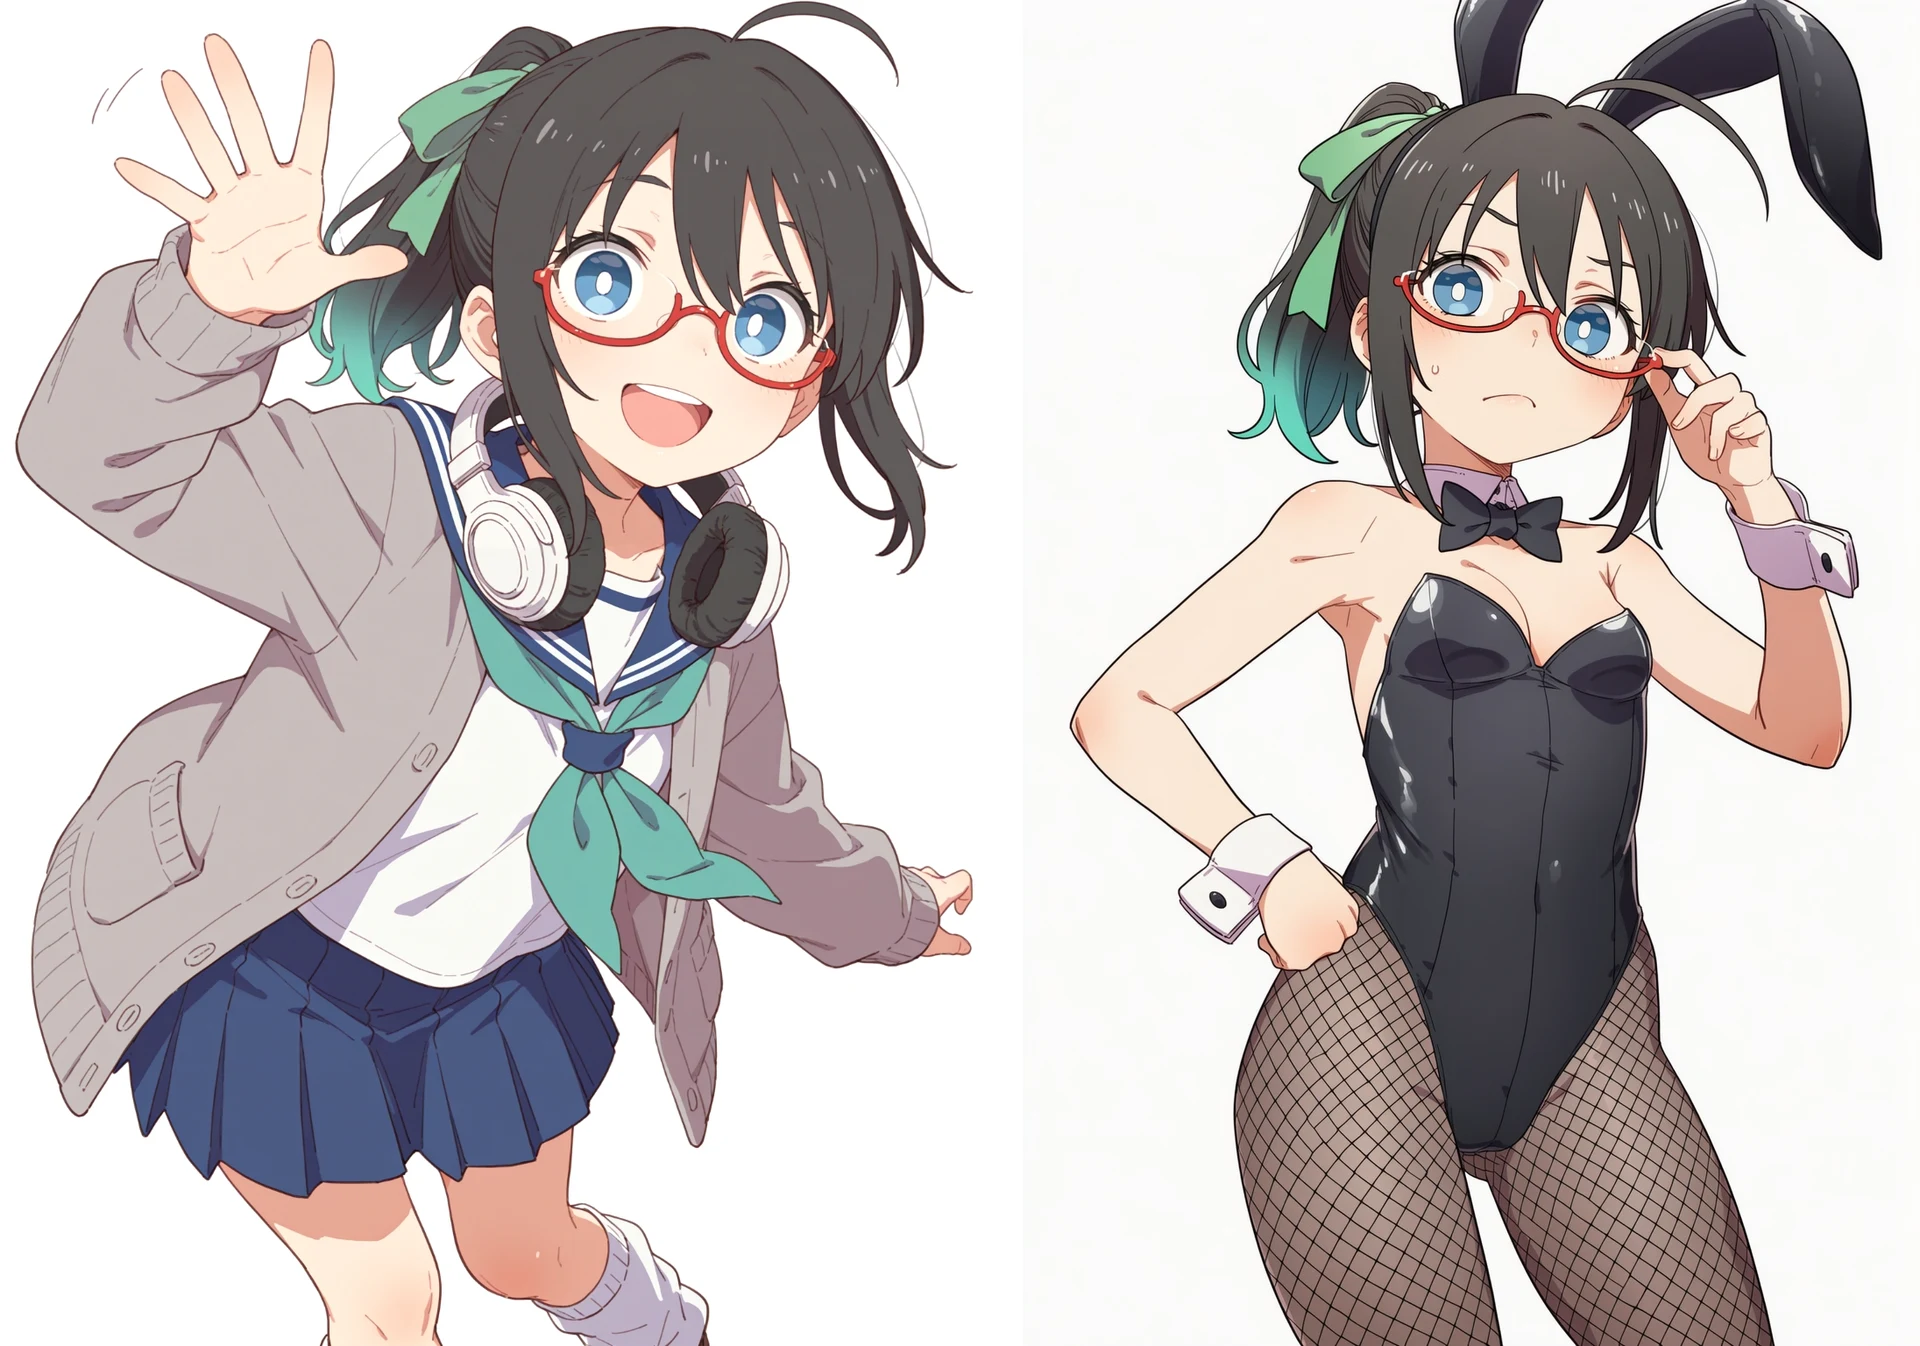
PPをこのように詳しくすると、ちゃんと着替えられました。
④ちびキャラ化
指示「1girl,chibi,full body,deformed」
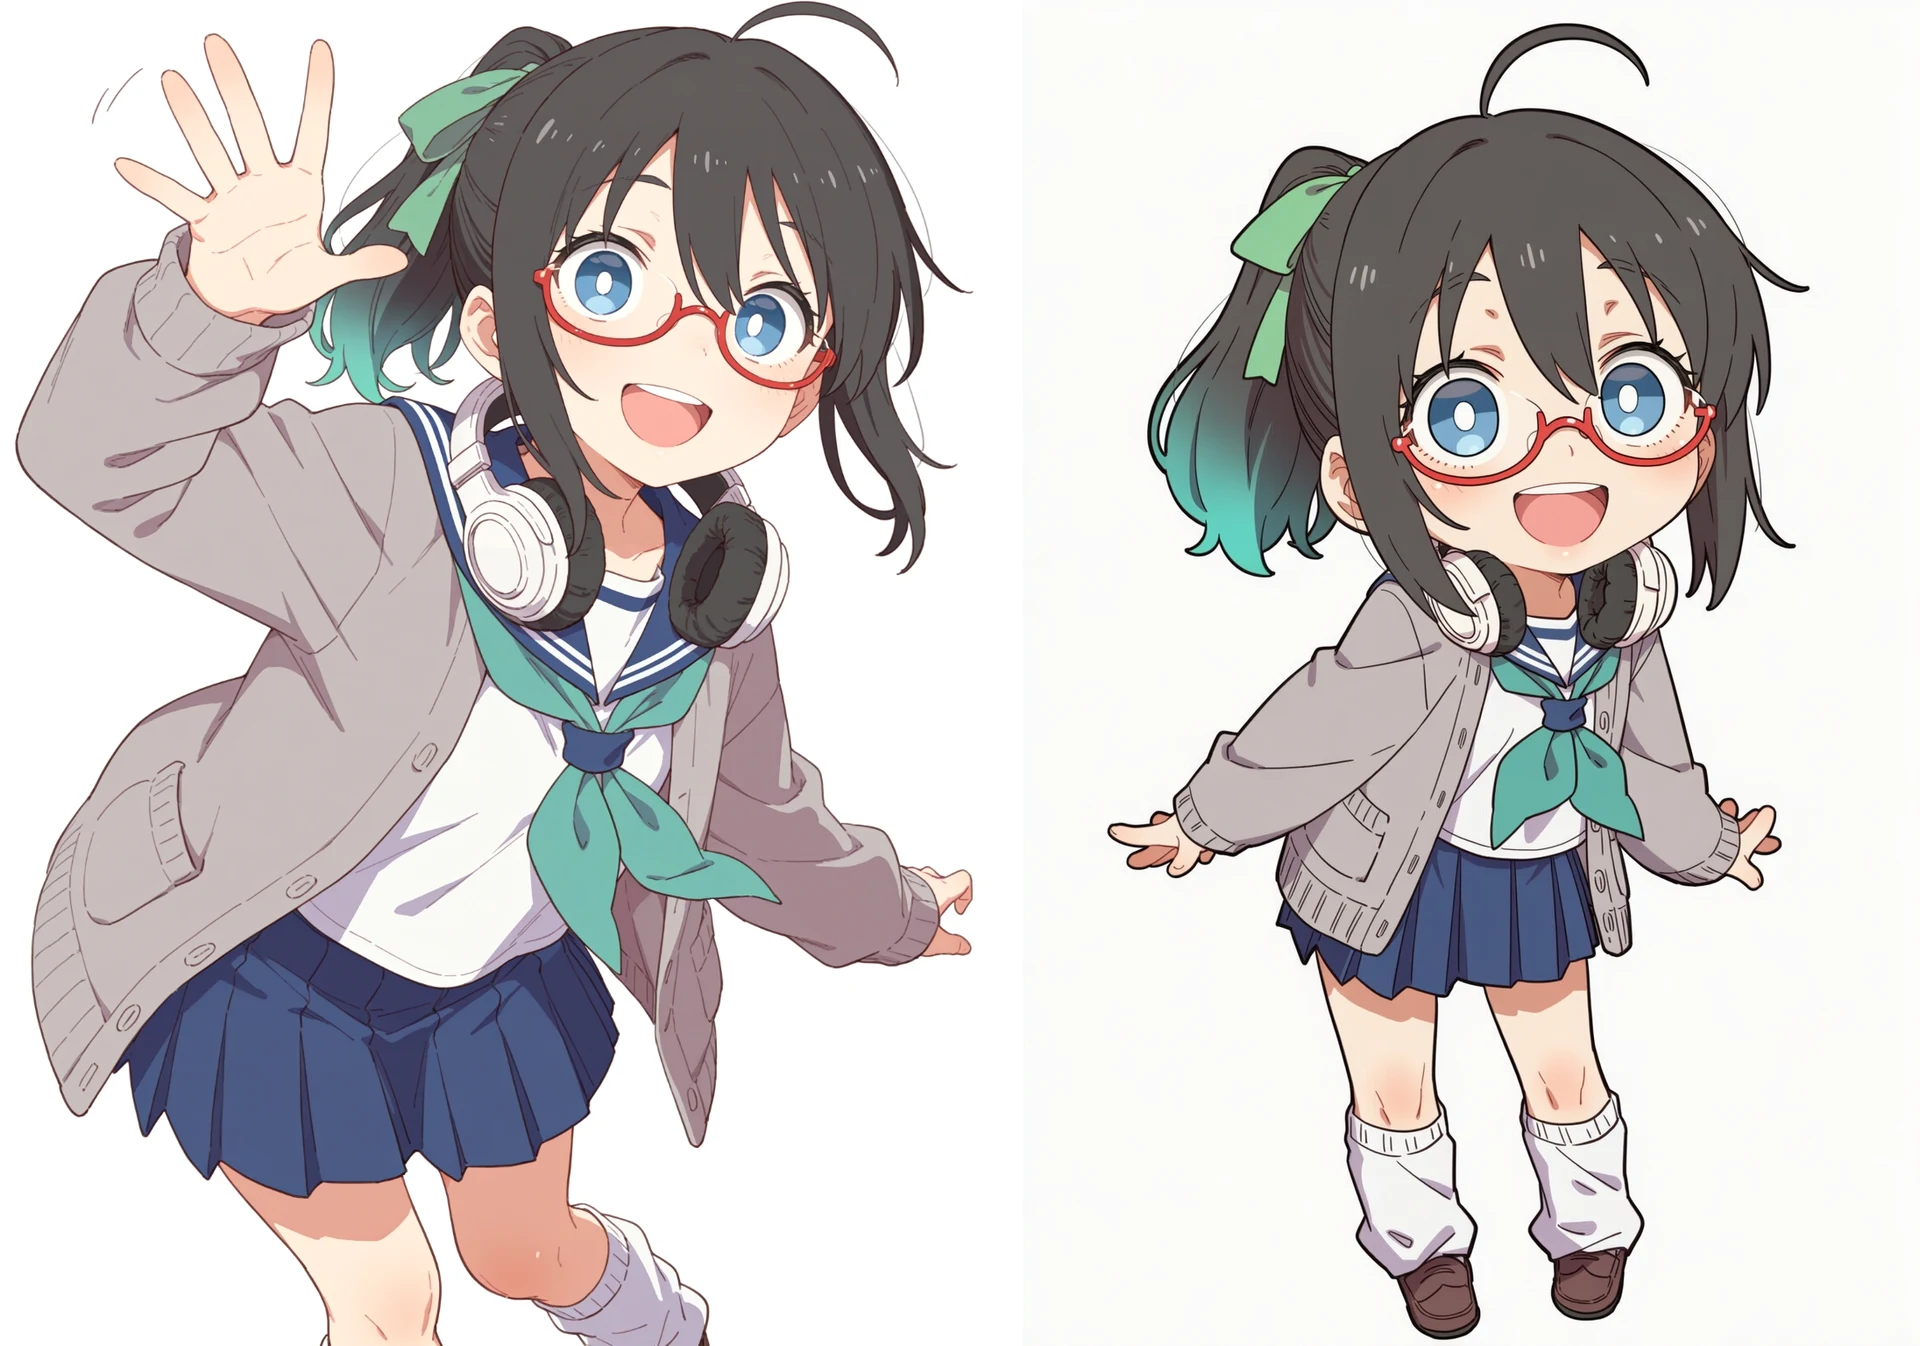
問題なくできました。ちび度合いはかなりランダムで、2頭身になったり3頭身になったりします。また、8頭身のキャラクターとちびキャラが共演する「chibi inset」になることもよくありました。避けたい場合はNPに入れたり、「solo」「chibi only」などのタグを使うと改善します。
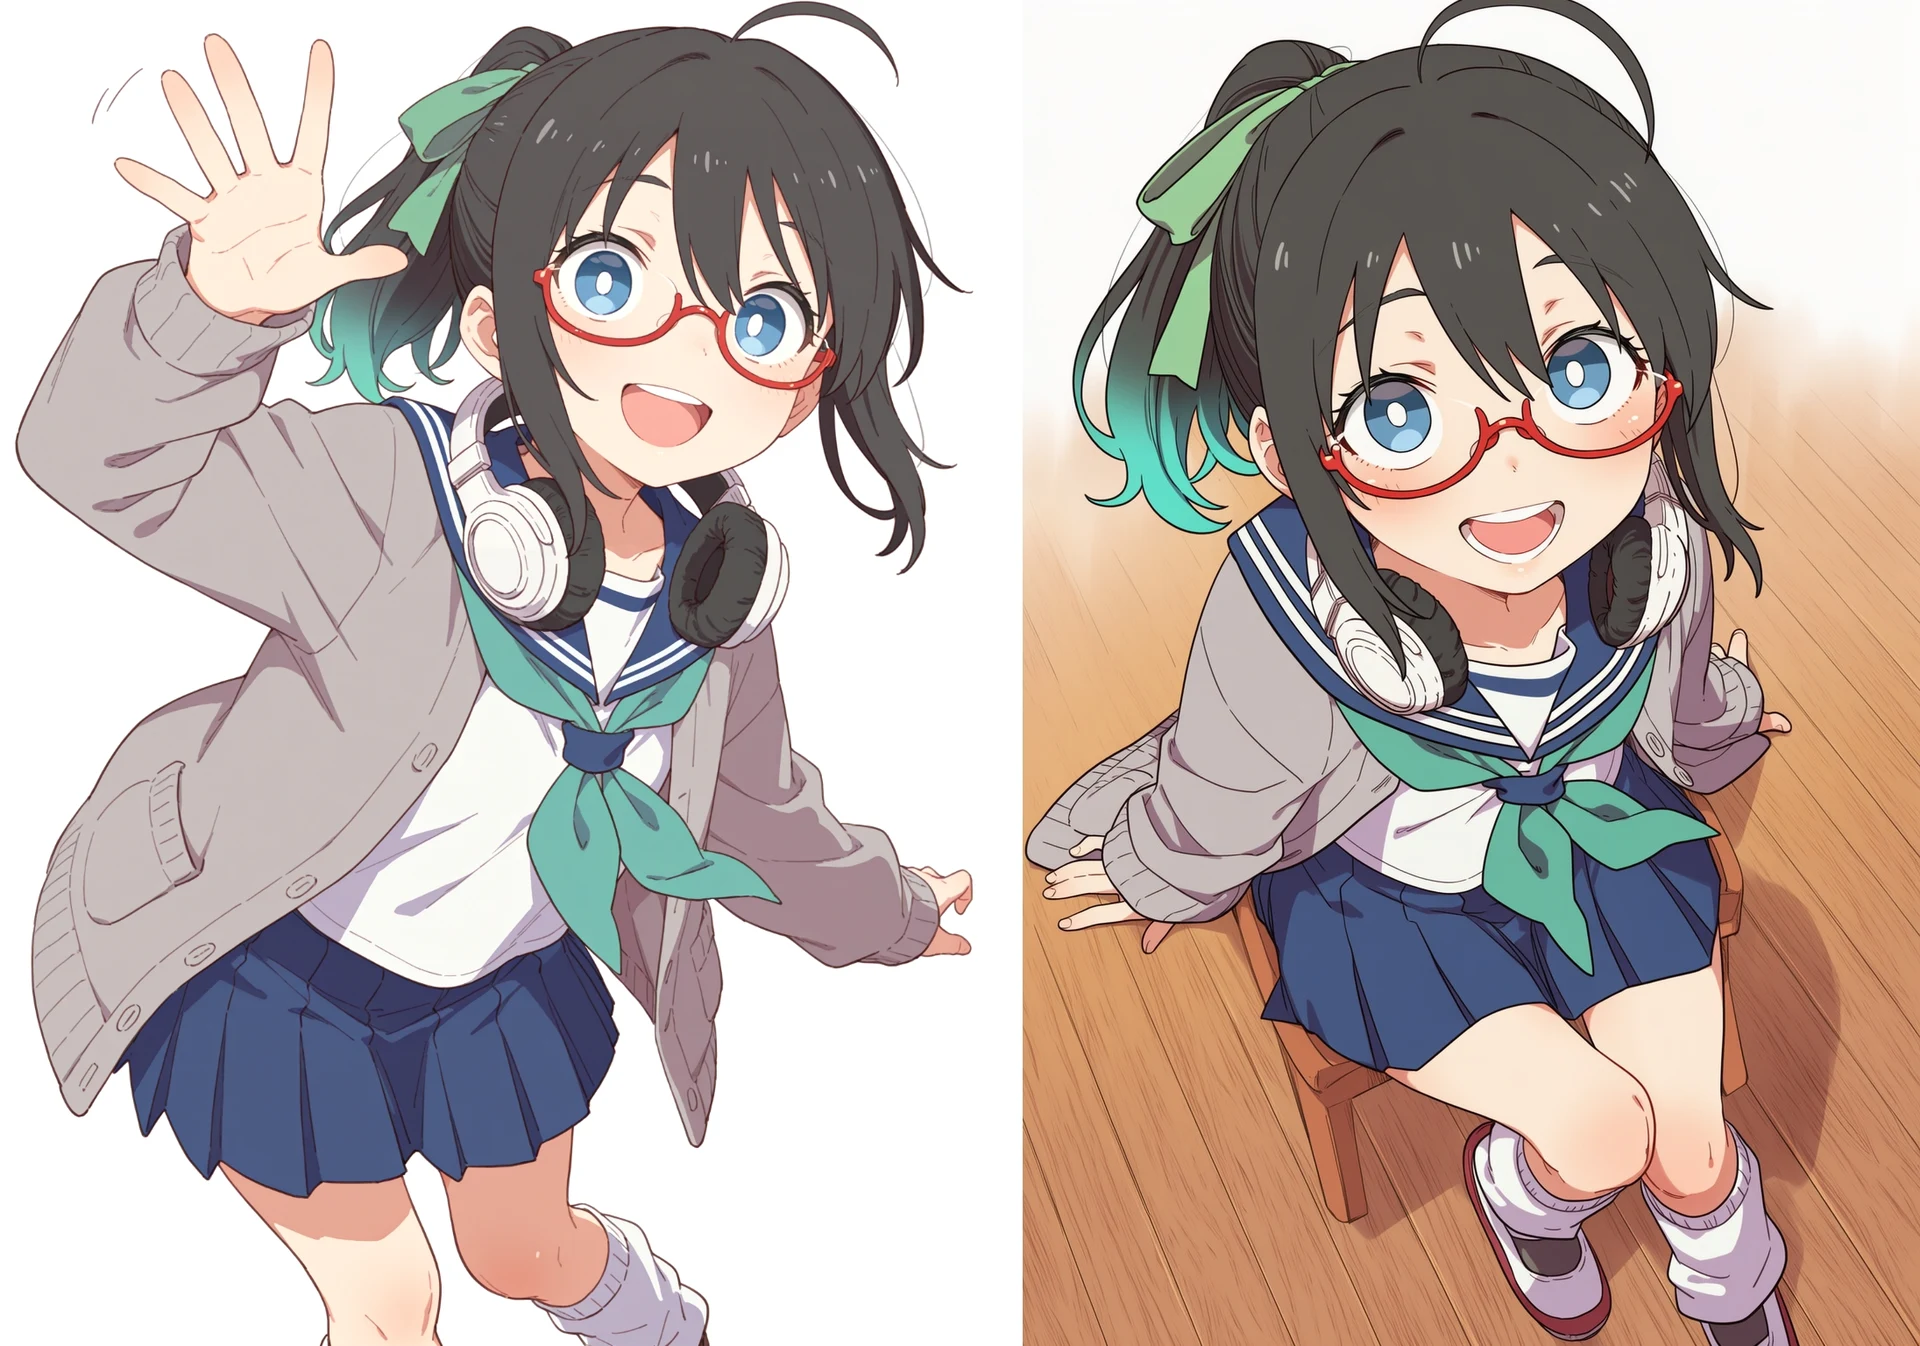
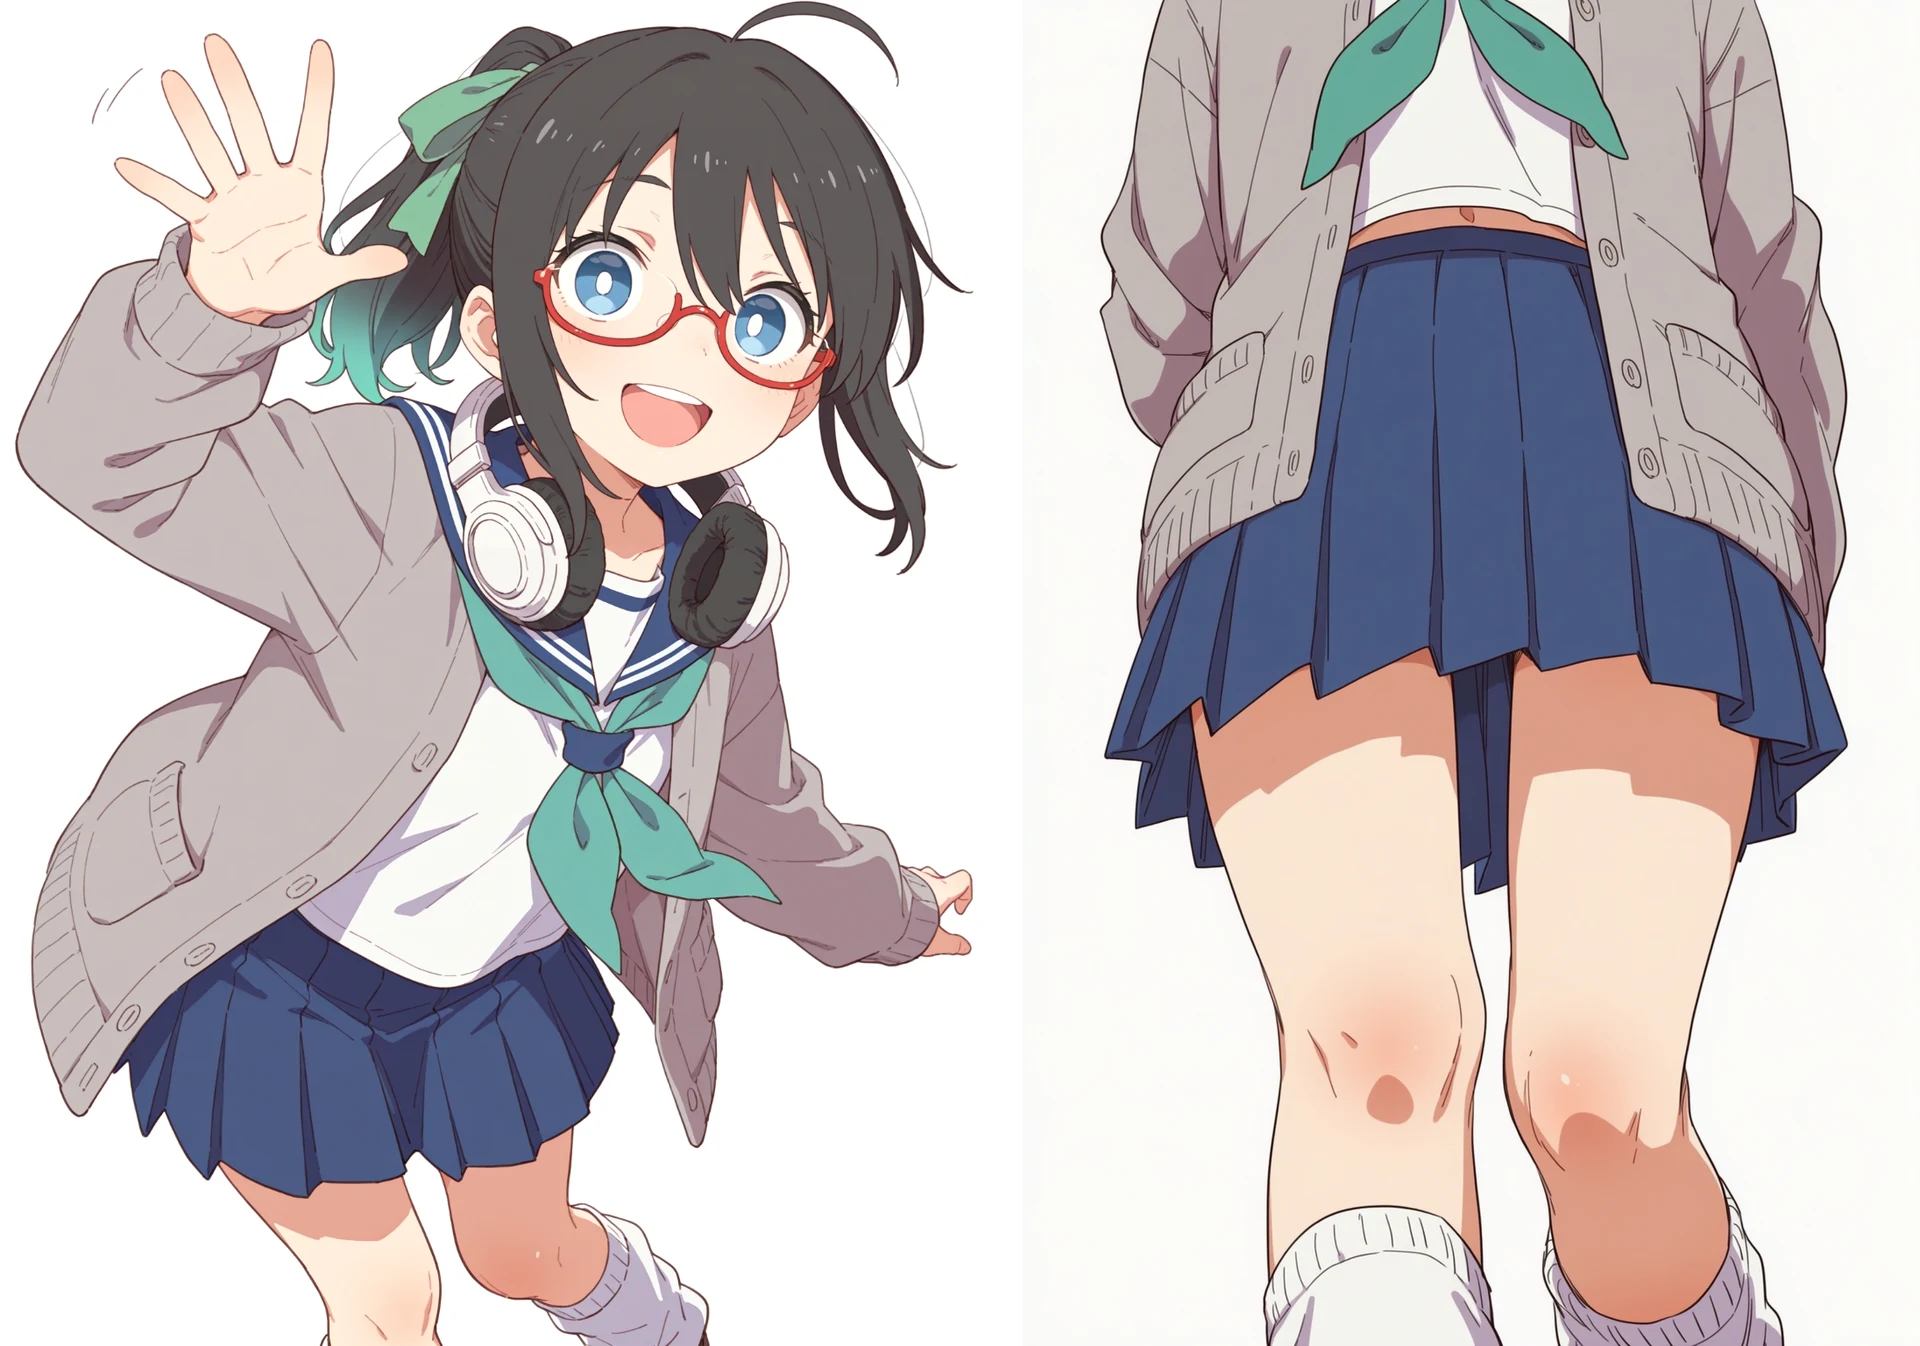
⑥アングル(カメラコントロール)
さきほどのreference sheetと同様に、カメラ位置を変更したり、部位をアップにしたりすることも安定してできました。
指示「1girl,floor,{{{from above}}}」
指示「1girl,lower body,head out of frame」
⑦ちびキャラのポーズ変更
指示「1girl,smile,waving hand,chibi,full body」
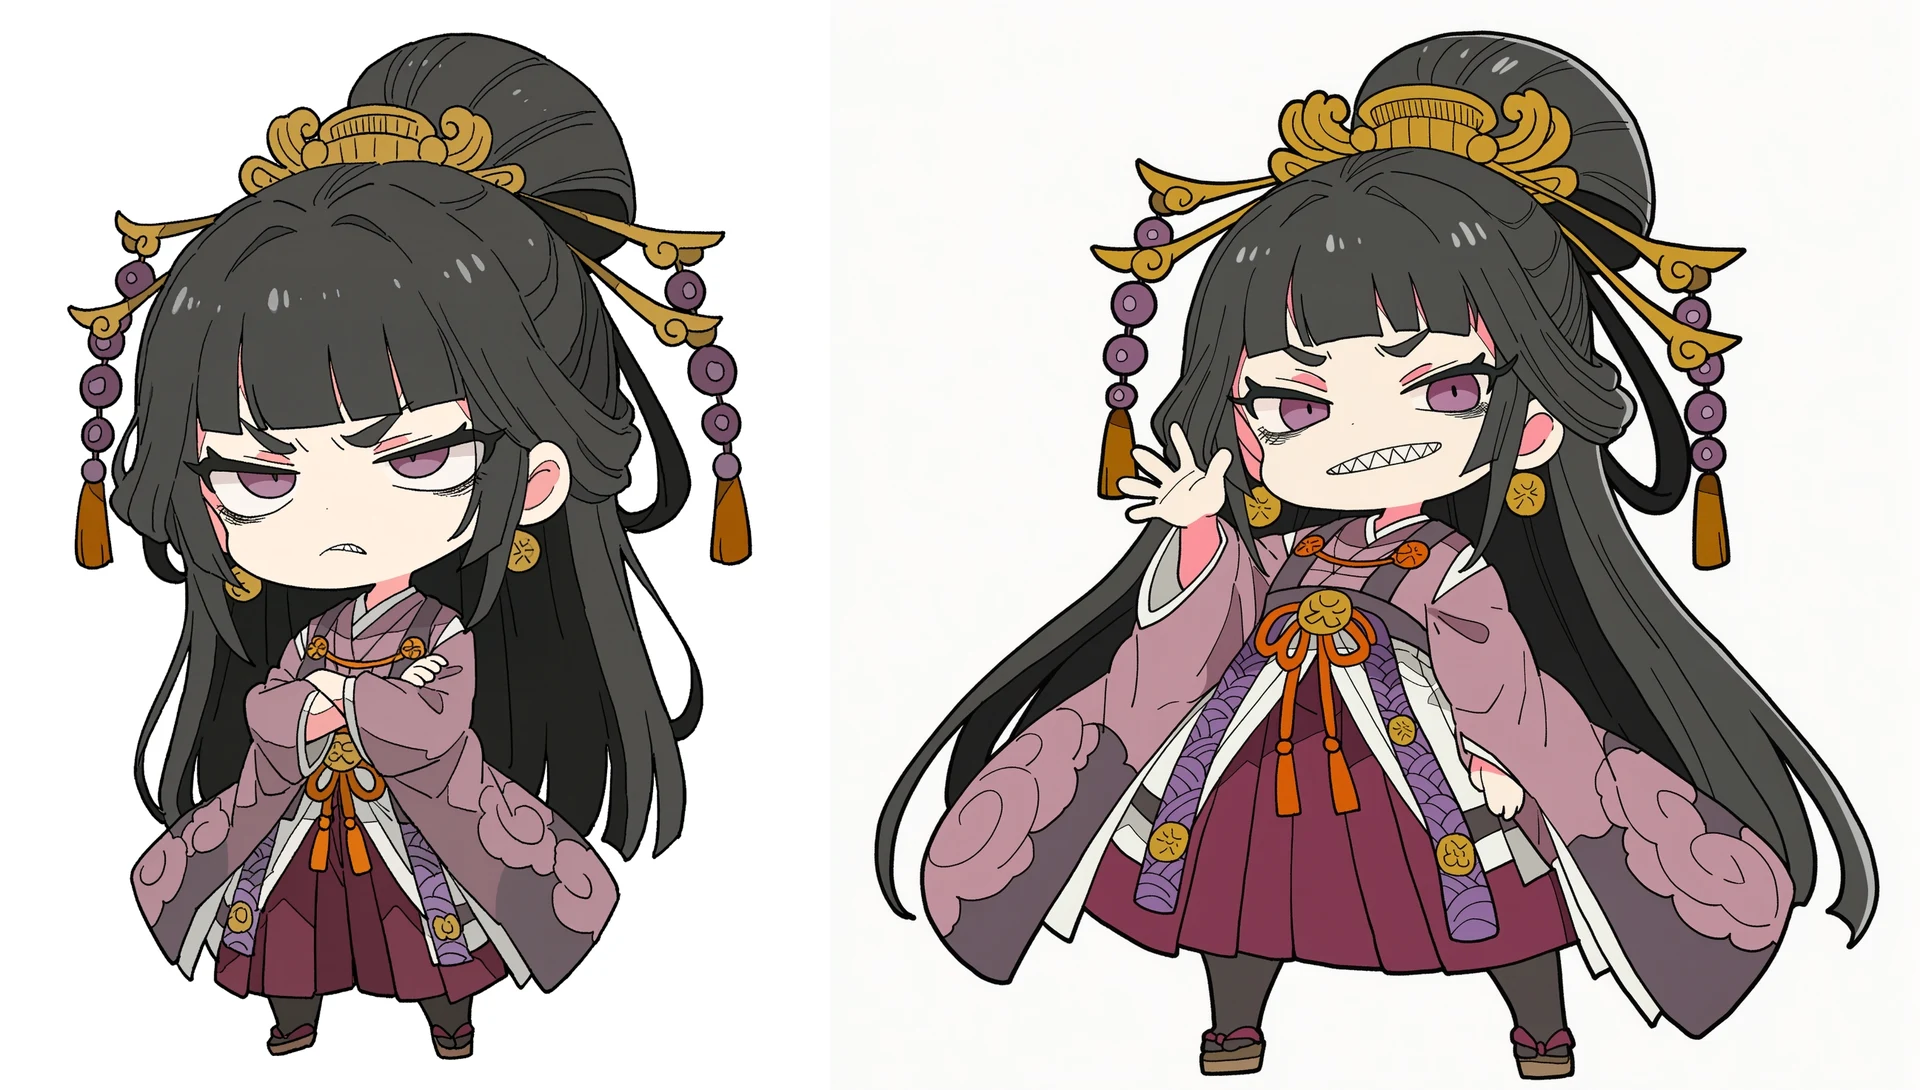
非常に高い再現度ですね。特に注目したいのが、入力画像にごく小さく描かれている「ギザ歯」をしっかり再現してくれたことです。凶悪そうな顔のままで笑顔にするのはNanoBananaには不可能でしたし、Seedream4でも失敗しがちだったのですが、難なくできていますね。
指示「1girl,scared,surprised,frying pan, holding,cooking,full body,chibi,fried rice」
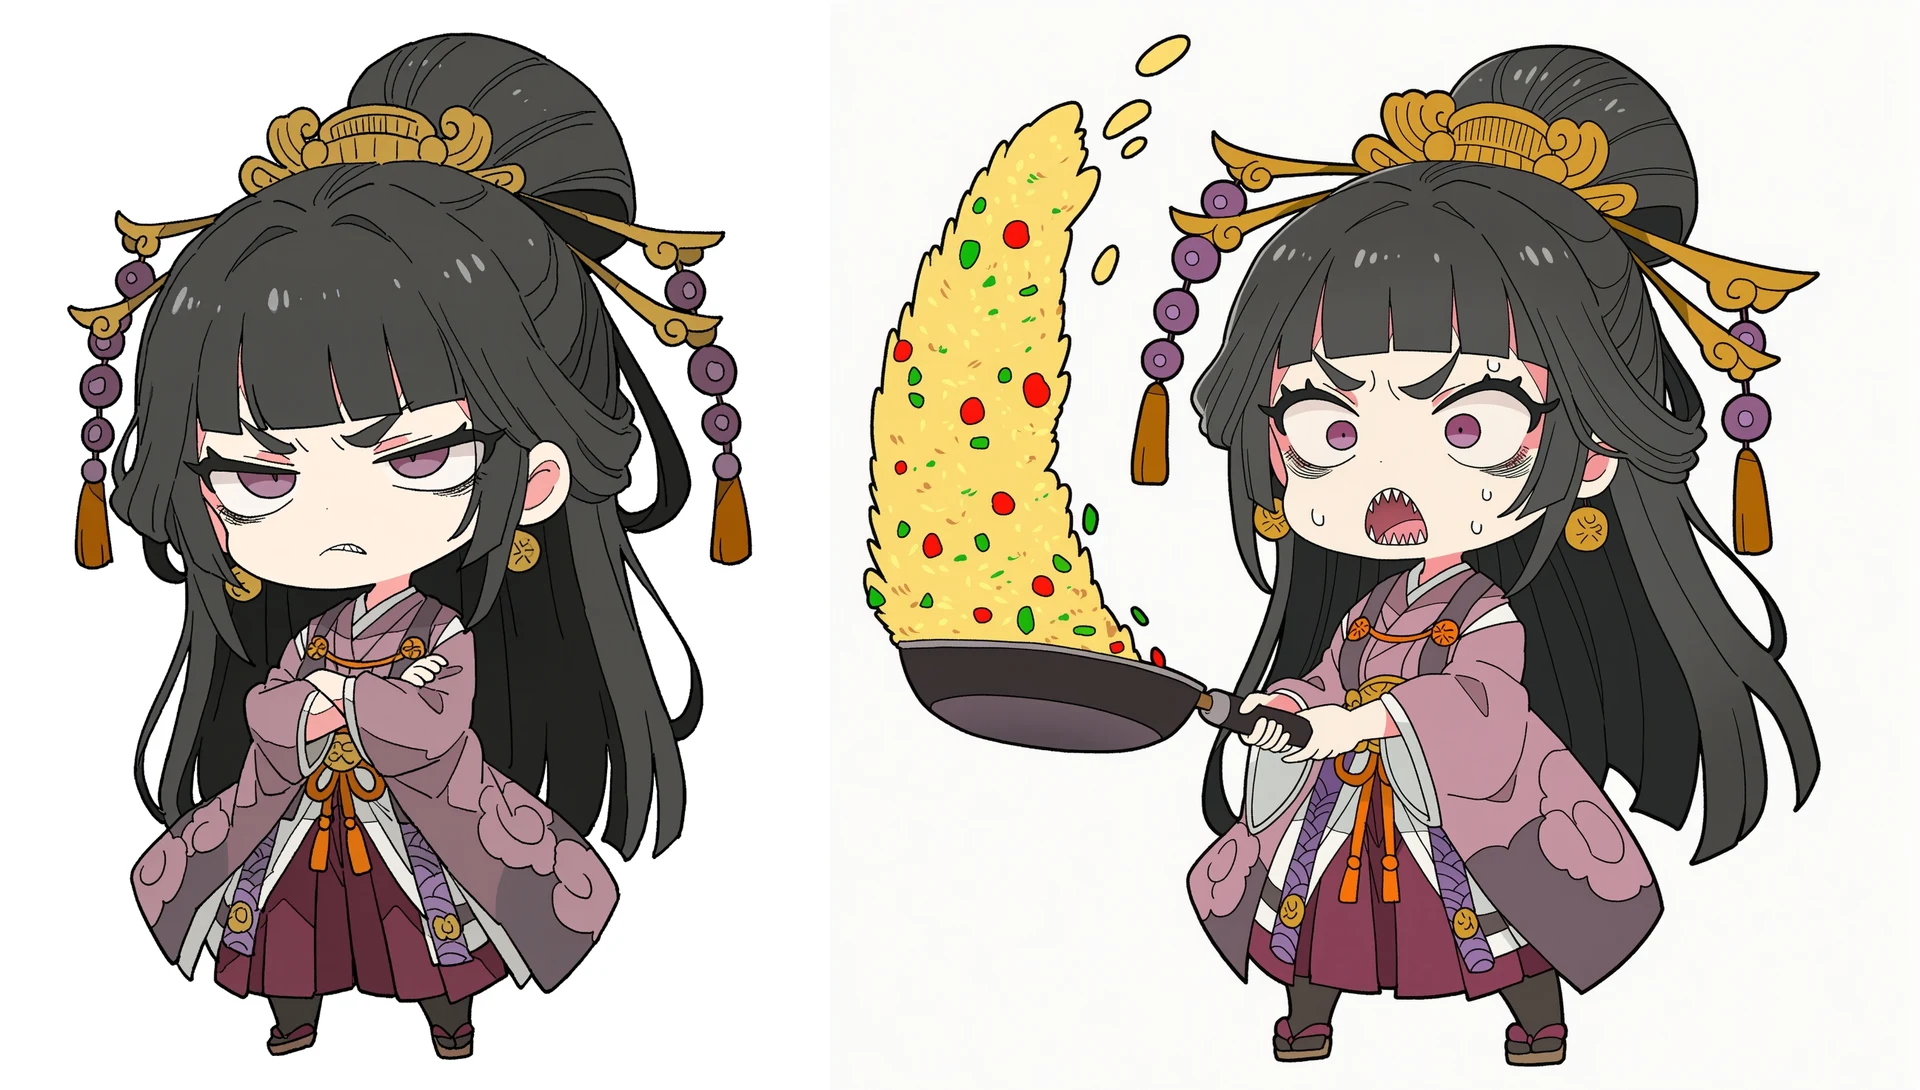
前回記事で実験したチャーハン料理変換。Seedream4よりもむしろ上手にキャラ模倣・コントロールできているように見えます。元画像の印象をほとんど壊さずに、ポーズや表情をいじれていますね。
ポイントとして、着物の花柄?模様をよく見てみると、完璧には再現できていないことがうかがえます。漫画などにしたときに矛盾が出てしまうので、このあたりは人間がよく見て修正する必要があろうかと思います。
⑧複数キャラ生成
入力画像のキャラクターと別キャラクターを共演させられるかも試しました。
指示「2girls,talking,white background」
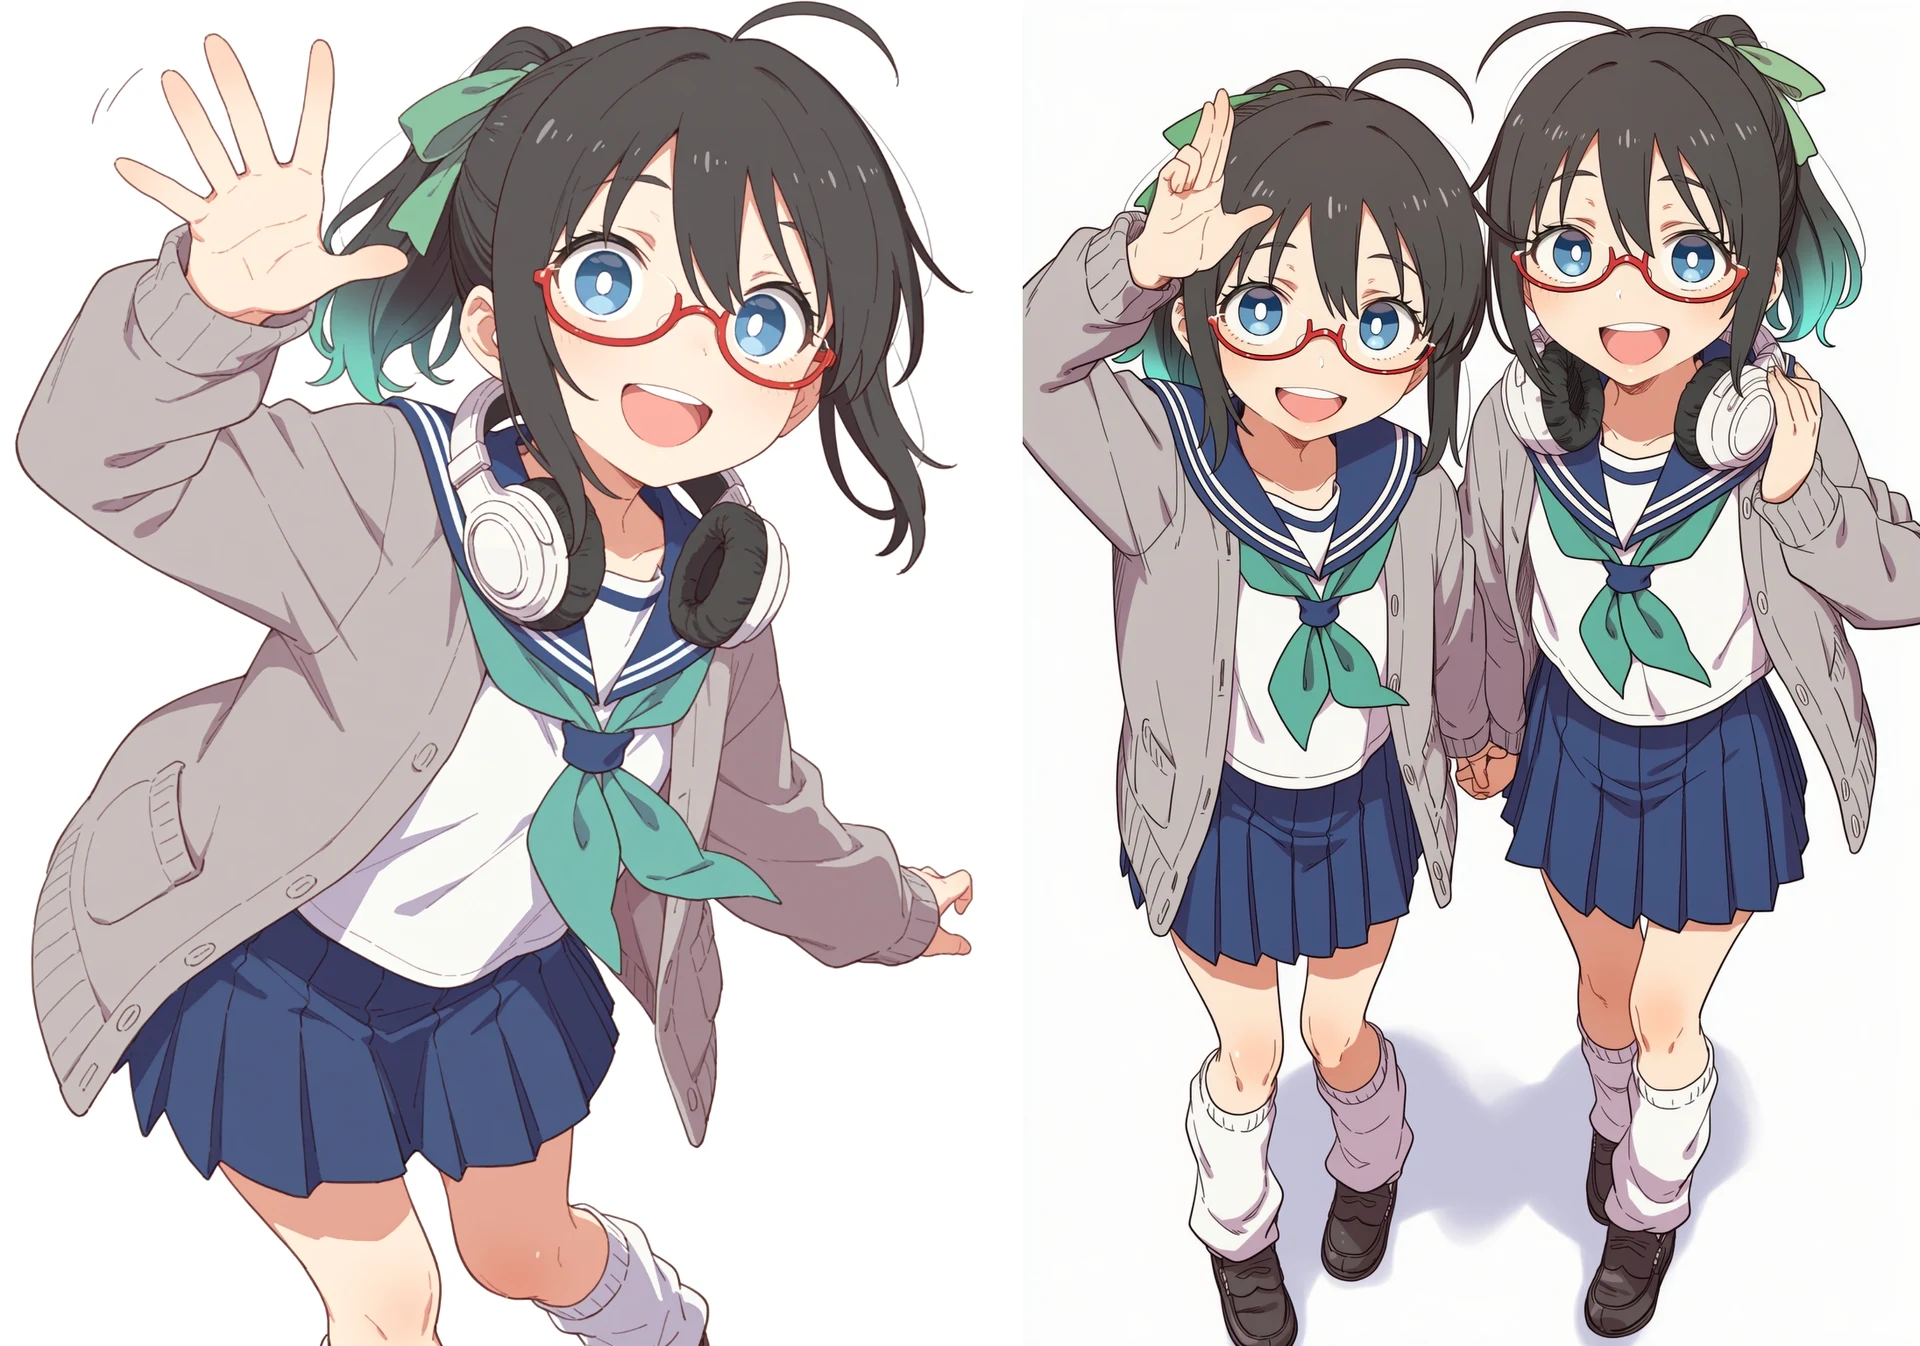
残念ながら、単一キャラの画像(左)を読み込ませて2girlsなどと指定すると、このようにそのキャラが双子化してしまうことがほとんどでした。では、2人のキャラが映った画像を読み込ませて2girls指示するとどうでしょうか。
指示「2girls,talking,white background」
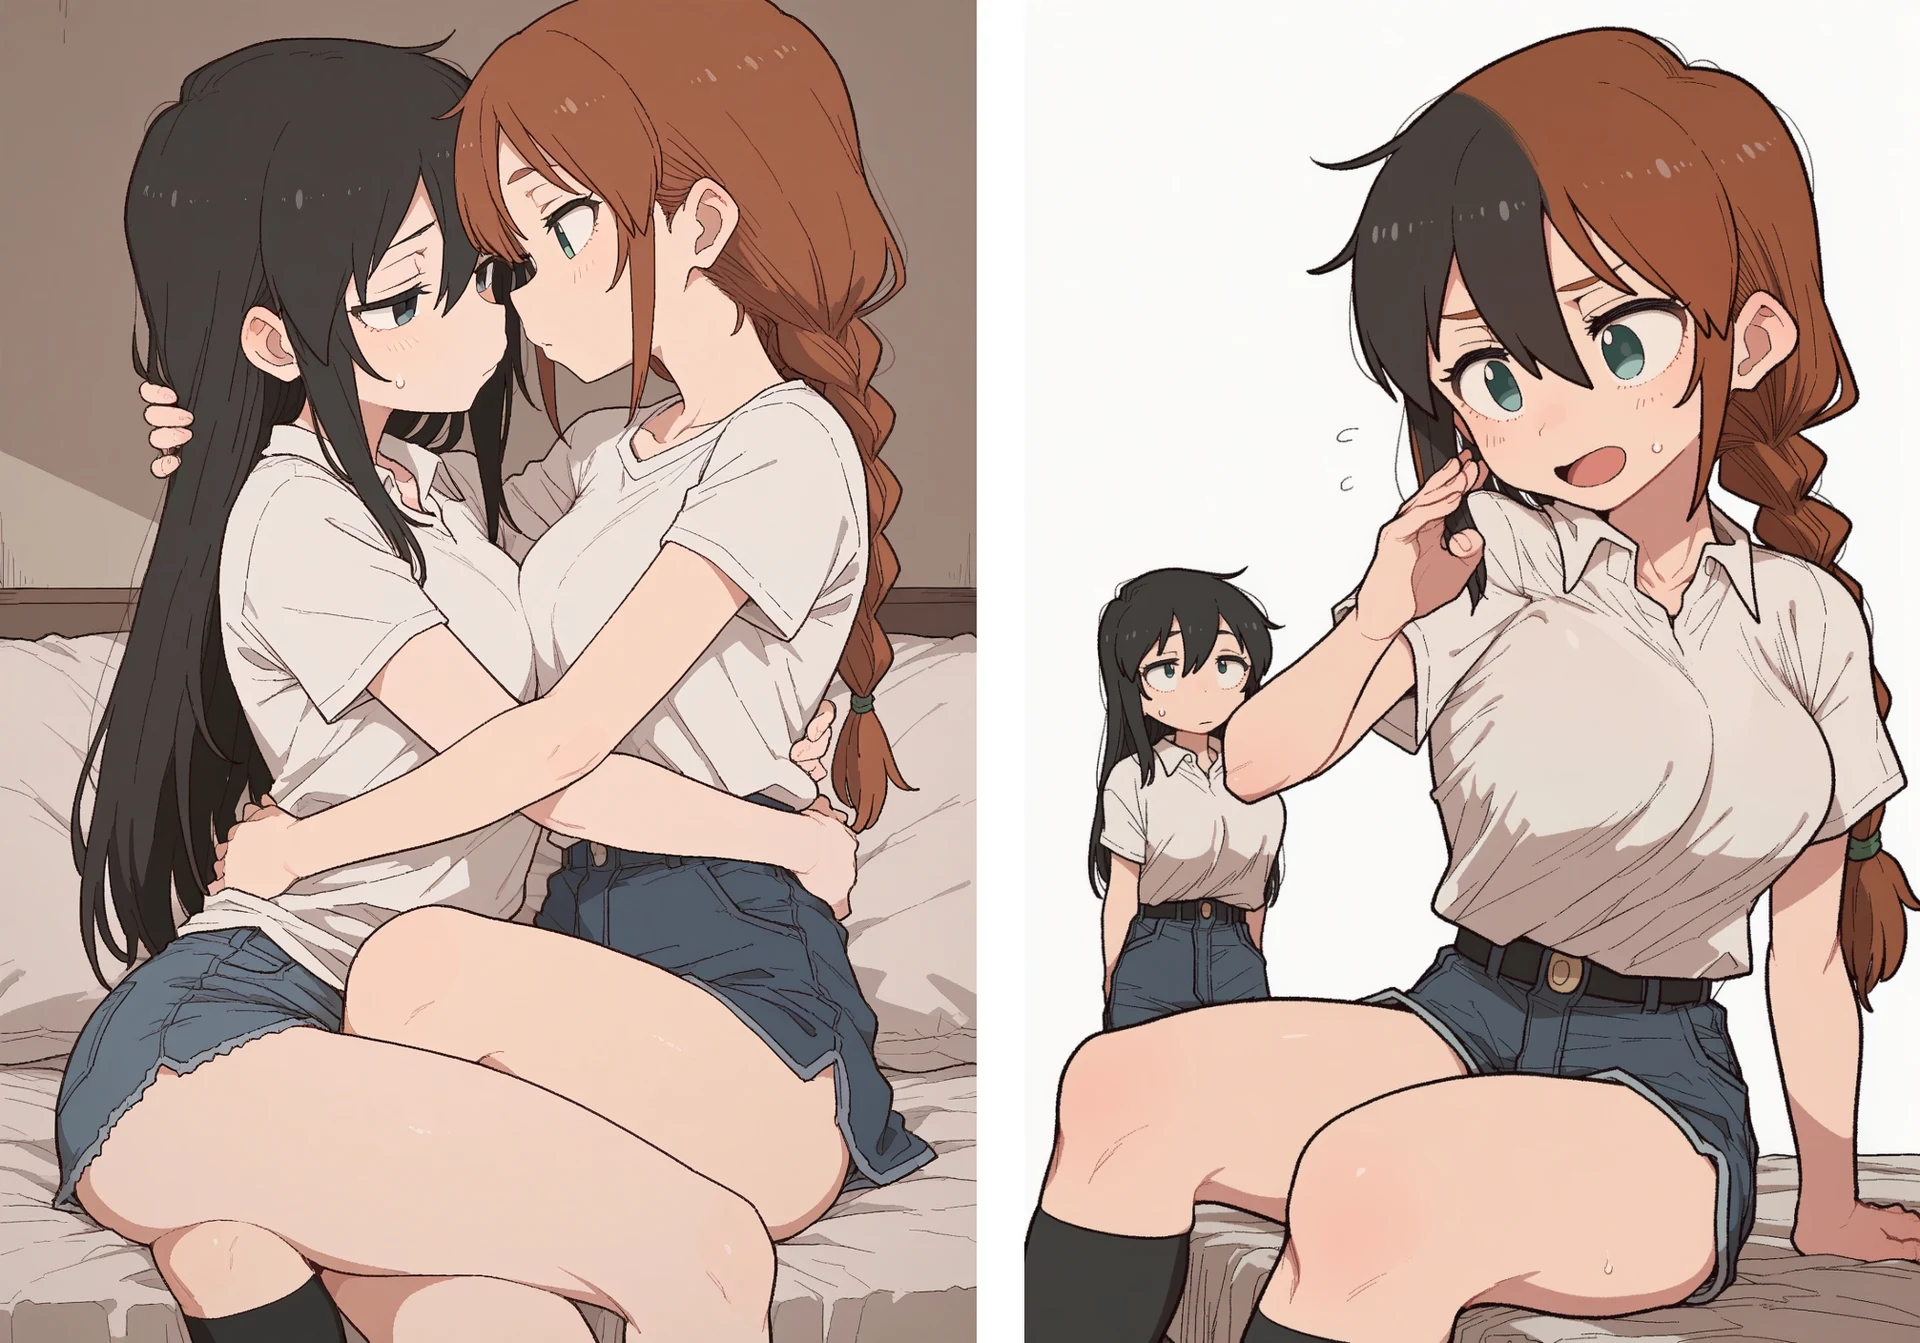
場合によりますが、このように特徴がフュージョンしてしまうことが多かったです。基本的に、入力画像と出力画像で1対1の関係を想定して学習されている機能のようですので、入力画像はキャラクターが単体で映っている画像にしましょう。
<全年齢編・小括>
正直申し上げて、予想以上の結果に驚きました。かなり細かいキャラデザインをしっかり拾ってくるだけでなく、顔立ちや印象もしっかり似せることができています。我々が慣れ親しんだdanbooruタグへの応答も上々で、{{{smile}}}などの強度調整も可能ですので、むしろ自然言語より思った通りに動かせる感覚がありました。
こちらのreference sheet変換では、髪の毛の左右の長さの違いやスカートのひだひだの自然さだけでなく、元画像にも指示にもない部分(この場合は足元のブーツ)もそれらしく補ってくれています。
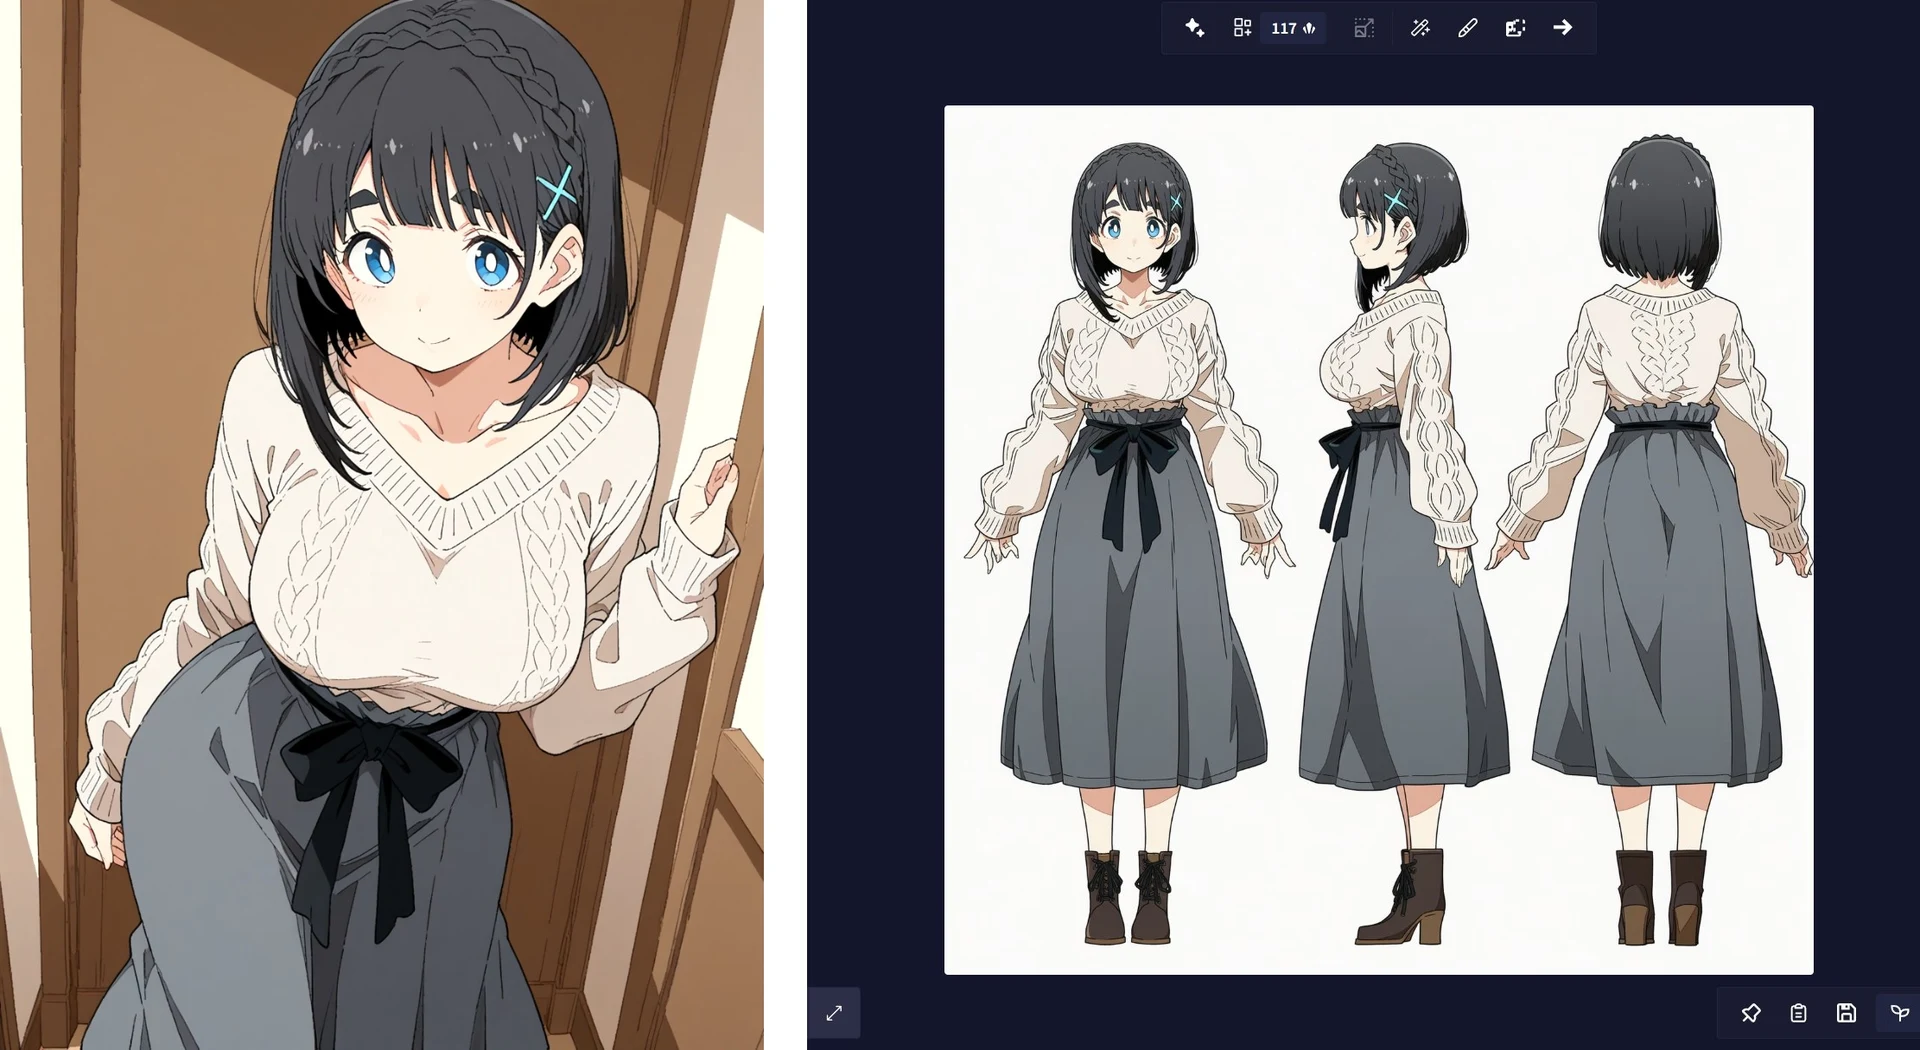
さきほどのギザ歯再現もすばらしかったですが、こうしたちょっとしたfang(八重歯)表現や、手の塗り、しわの表現、髪のハイライトも、非常にそれらしく変更できています。NSFWについては次の章で詳しく見てみますが、text2imageでできることは「ほぼなんでもできる」と考えてよさそうですね。
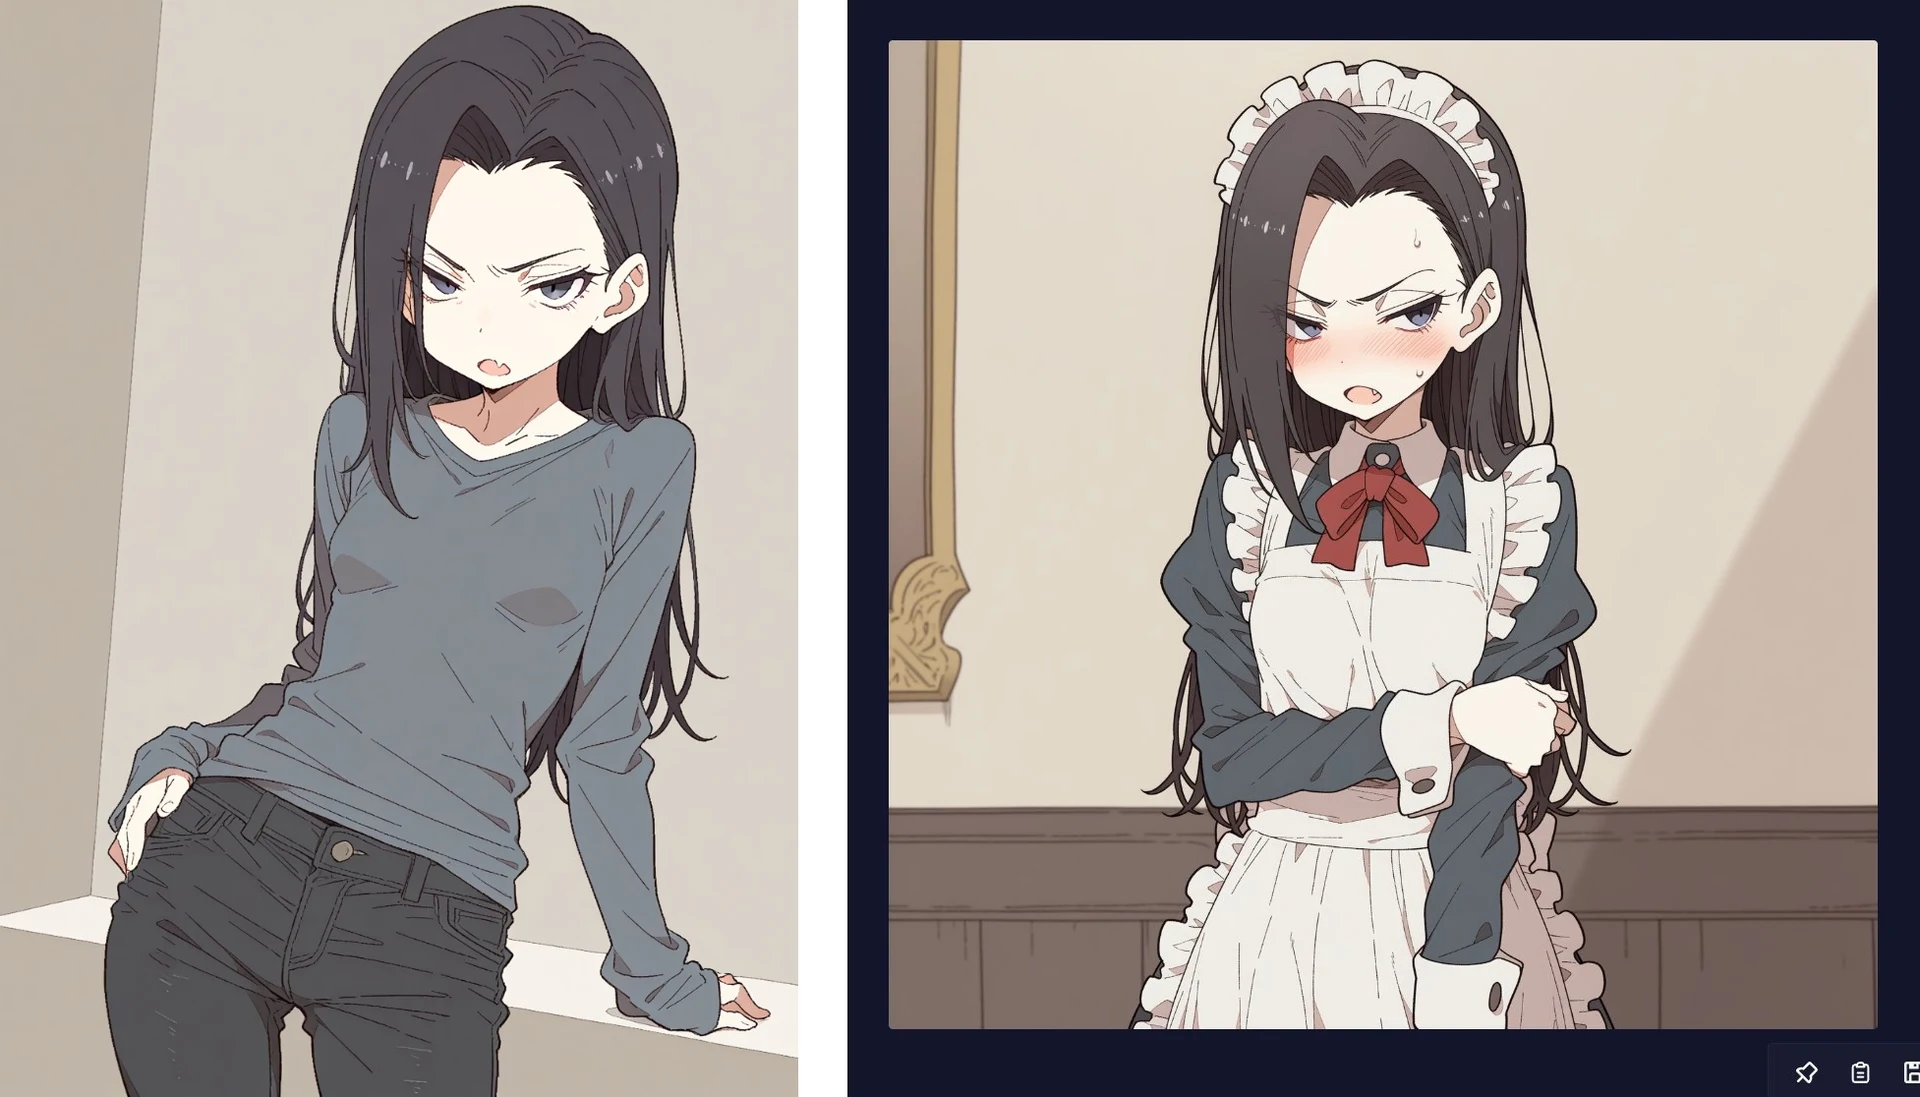
なんとなく感じられた弱点としては、さきほど触れた「入力画像に引っ張られすぎることがある」点と、「キャラデザインが細部まで完璧とは限らない」「画風再現が得意なキャラとそうでないキャラがある」あたりでしょうか。
キャラクターによって、似やすさに差がある(もしくは、私がそのキャラへのこだわりが強く、ちょっとした違いを大きく感じる)のもなんとなく感じられました。一枚しか参照させられないので、そのキャラ画像がたまたま普段の自分の画風よりもキュートよりだったり、セクシーよりだったりすると、生成結果もそうした雰囲気に強く引っ張られます。なかなかうまくいかないときは、同じキャラの別の画像を入力して試してみるとよさそうですね。