<【注】「Freepik」は2026年4月に「Magnific」へ名称変更しました>
サービス自体は同じものですが、この記事に載せている料金プラン・無制限の条件・クーポンの情報は2025年9月時点のものです。現在は体系が変わっていますので、契約の判断には使わないでください。
最新の料金と「その金額で何が何本作れるのか」は、こちらにまとめています。
また、比較に使っているSeedream4.0とNanoBananaは、それぞれ世代交代しています。

こんばんは、スタジオ真榊です。今回はNanoBananaに比肩する高性能画像生成AIとしてSNSで話題となっている「Seedream4.0」の実力検証です。
いずれも自然言語指示で高度な画像編集ができ、従来モデルよりもキャラクターの一貫性を保てることが特徴。漫画やイラスト作りにどのように役立てられるか、以前のNanoBanana検証と全く同じ作例で試すことで、実力や作業の向き不向きを検証してみます。
Seedream4.0を使う方法はいくつかあり、ローカル環境(ComfyUI)でもAPI料金を支払うことで生成が可能ですが、今回の検証では「Freepik」というオンライン画像・動画生成プラットフォームを月額課金して利用してみました。上位プランではSeedream4.0を始め、NanoBananaやWan2.2等を使った無制限のオンライン生成が可能なうえ、同時にいくらでもバッチ生成できる(生成完了を待たず複数枚生成がいくらでも連打できる)のが特徴です。その代わり、結構お高い…
スタジオ真榊ではForge系を使ったイラスト・漫画生成をメインで利用していますが、その補助としてFreepikがどれくらい使えるか、月額6000円近い高価なプラン加入の価値はあるのか、Seedream4.0とNanoBananaをどう使い分けるべきか、といったことが伝わるような企画にしたいと思います。
1.Seedream4.0とは
Seedream4.0はTikTokの親会社である中国ByteDanceが2025年9月9日にリリースした画像生成モデルです。語源は「See+Dream」ではなく「Seed+Dream」から名付けられたようですね。
テキスト指示による画像生成(t2i)や、入力画像を基にした編集機能にも秀でており、NanoBananaができないアスペクト比の指定や最大4Kの高解像度での生成が可能。特に複数の画像を参照させた場合に、デザインの一貫性を保ったり、スタイル(画風やタッチ)を維持したりできることが強みとされています。
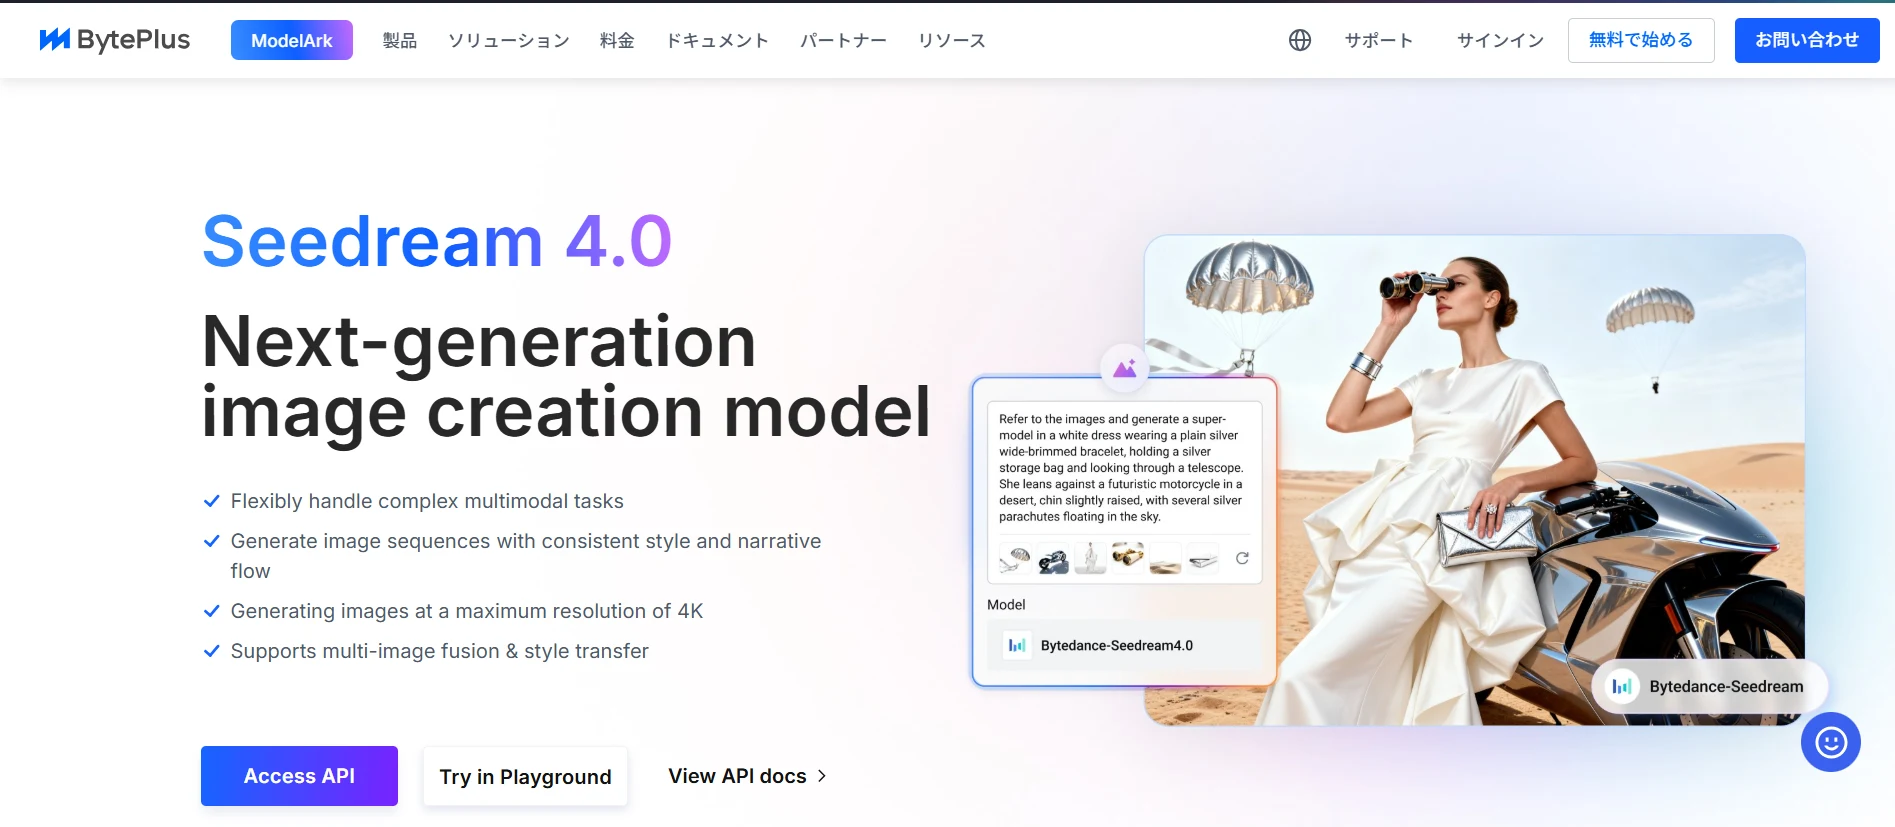
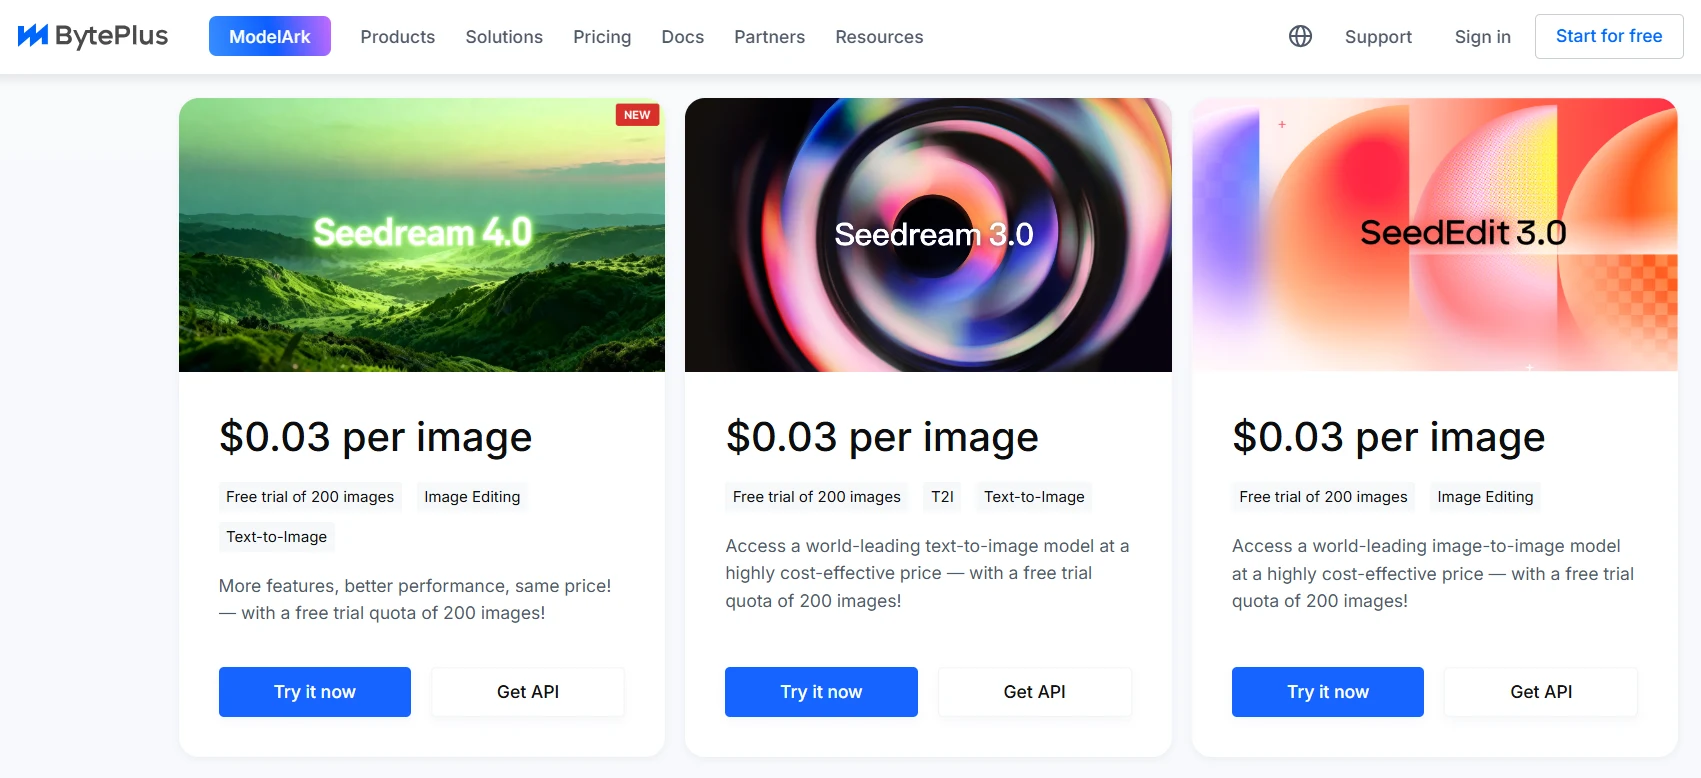
記事執筆時点では、APIの場合「1枚生成あたり0.03ドル(1,000枚生成で30ドル≒4,436円)」の生成費用が掛かるとされており、直接このAPI料金を支払うか、有償のオンライン生成サービスに契約して使用するのがメインルートとなります。
2.Freepikとは
今回Seedream4.0の生成に使うのは、こちらの「Freepik」という有償オンラインプラットフォームです。
運営するFreepik社はスペインに本社があり、もともとはAdobePhotostockのような画像素材を制作していた企業。動画生成系の企業やアップスケーリングのMagnific社などを買収して事業拡大し、AI生成のデパート的プラットフォームに行き着いたようです。
Seedream4.0以外に使える主なモデルとしては、静止画生成ではNanoBanana、Google Imagen3、Flux、Ideogram、Runway、GPT(ChatGPTの画像生成モデル)、動画生成ではVeo3、Seedance、Kling、Hailuo、Runwayあたりの有名どころがたいてい揃っています。Freepikが独自にトレーニングした「Mystic2.5」というモデルもあったりします。
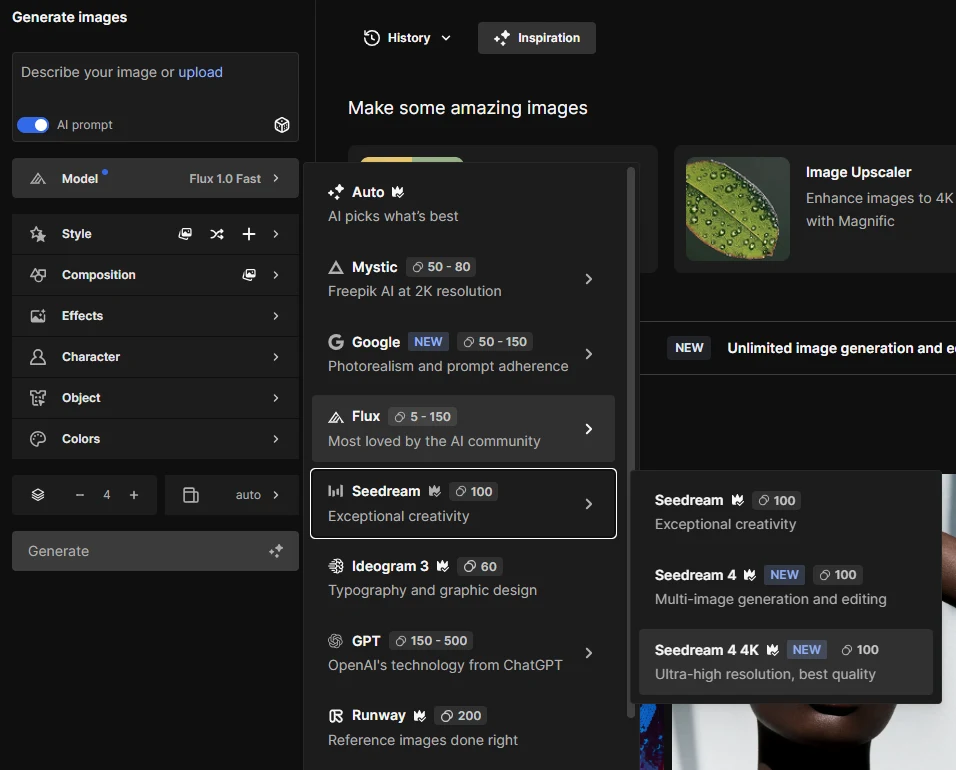
▲静止画生成で使えるモデル。それぞれの数字は消費する「クレジット」
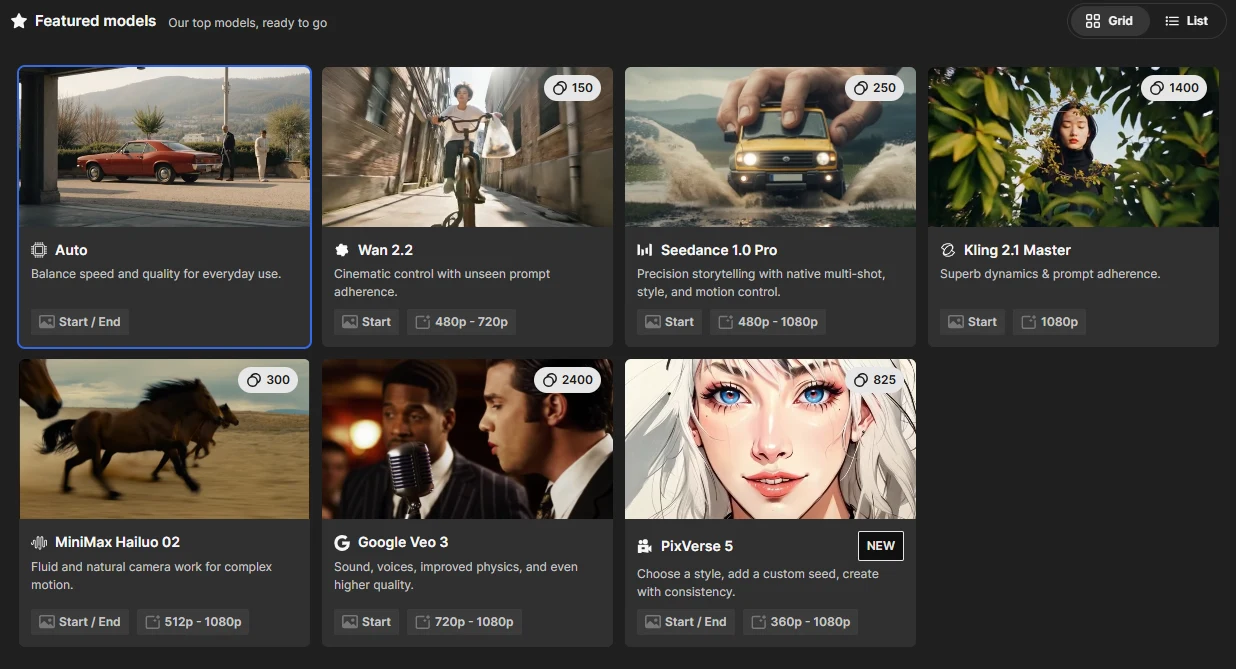
▲動画生成で使える主なおすすめモデル(過去のモデルも利用可能)
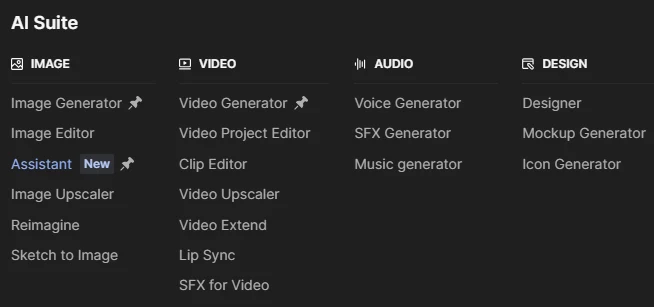
text to imageやtext to videoが中心ですが、他にもスケッチの画像化やアップスケーラー、リップシンク機能や音声生成、音楽生成、アイコン生成など、さまざまな機能が揃っています。現時点でこれら全てを試し切れていませんが、リップシンク機能や効果音生成などはまだ発展途上と個人的に受け止めていますので、これらが全部実用的とは思わないほうがよいかもしれません。(試してみると結構ガッカリすることが多い…このあたりは実用的と感じた場合、また記事で特集します)
・Freepikの料金設定は?
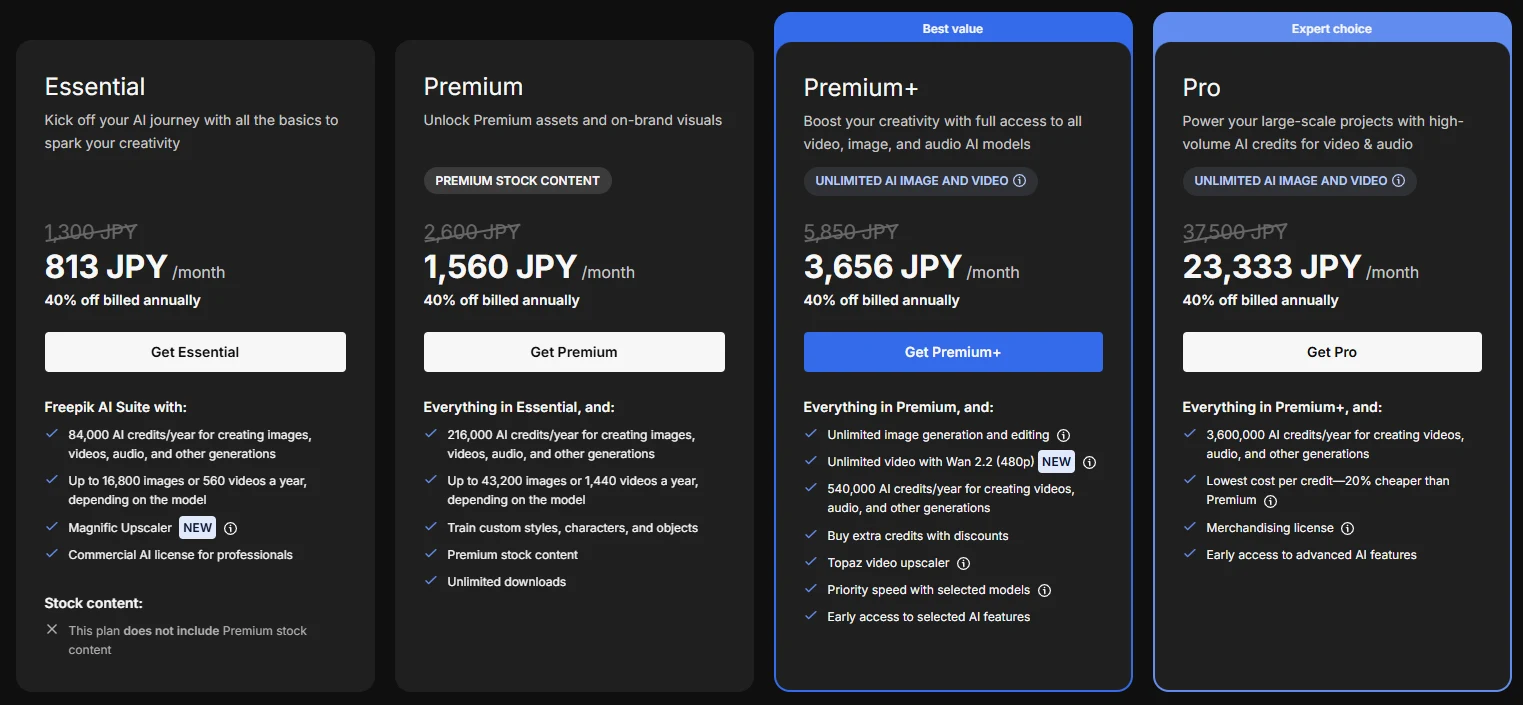
気になるのは「で、おいくらですの?」というところですね。料金表はこちらから確認できますが、NanoBananaやSeedream4.0で無制限生成ができるのはなんと月額5,850円のPremium+プランから。年払いだと下記のような40%のプライスダウン(月額3,656円)が受けられますが、それでも正直言ってかなり高額なイメージですね。
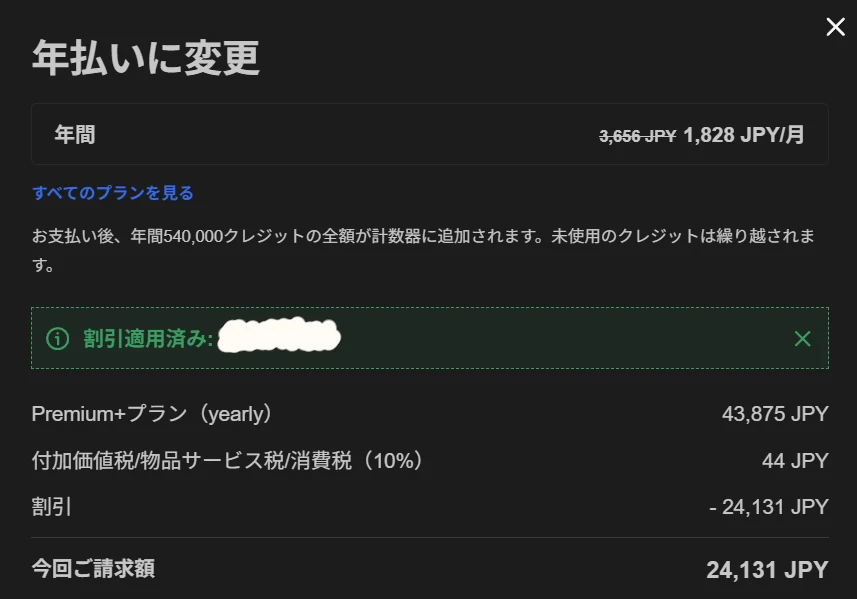
【09/25追記】年払いにして、かつ50%OFFクーポンコードを自力で探して入力すると、月額1828円までディスカウントすることができます。これでようやく適正価格というイメージですね。1年後に自動更新される際は普通に4万3875円請求されますので、解約を忘れないようにしましょう。(記事を通じて私がクーポン配布するわけにいかないので、大変心苦しいのですがコードのお問い合わせはご遠慮ください。ただ、ウェブ上で"freepik coupon"などで検索していくつか海外サイトを見ていくと、使用できるものがあるかもしれません)
<各プランの金額設定と内容>
詳しくはリンク先をお読み頂きたいところですが、記事執筆時点でざっくり各プランを解説すると、以下のようになります。
・お試し価格の「Essential」(月額1,300円)
画像、動画、音声生成などに使えるポイントが7,000クレジット配布されるプラン。Magnificアップスケーラーが有償使用できます。ちなみにSeedream4.0を使った画像生成は1枚100クレジットなので、月にわずか70枚だけ生成できる計算になります。NanoBananaは120クレジットなので、もっと少ない…。ケチ~!
年払い50%オフクーポン適用で月額1,828円なので、月1,300円で70枚ぽっちは物凄い割高に見えます。
・二倍の「Premium」(月額2,600円)
月ごとの配布ポイントが倍以上の18000クレジットに増加し、Seedream4.0だと月180枚生成できるようになります。加えて、同社の「プレミアムストックコンテンツ」が無制限にDL可能に。写真やイラスト、アイコン、ビデオ、効果音、フォント、テンプレートなどの素材が使い放題になるので、わざわざ生成するまでもないコンテンツ素材に活用できるかなと思います。
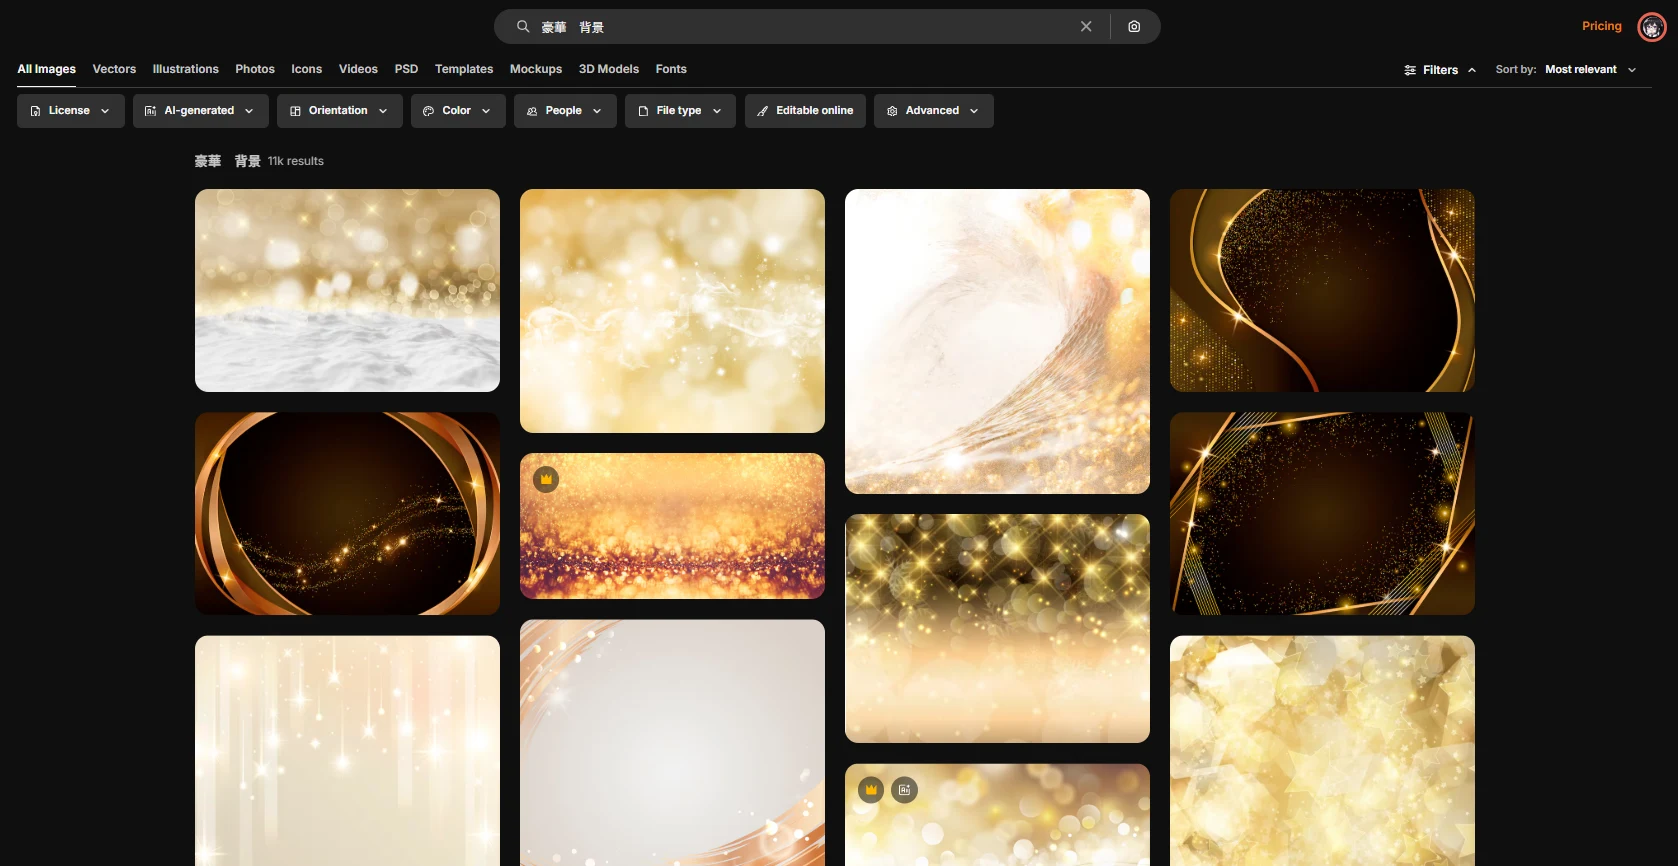
例えば、「豪華 背景」で素材検索するとこのような感じ。
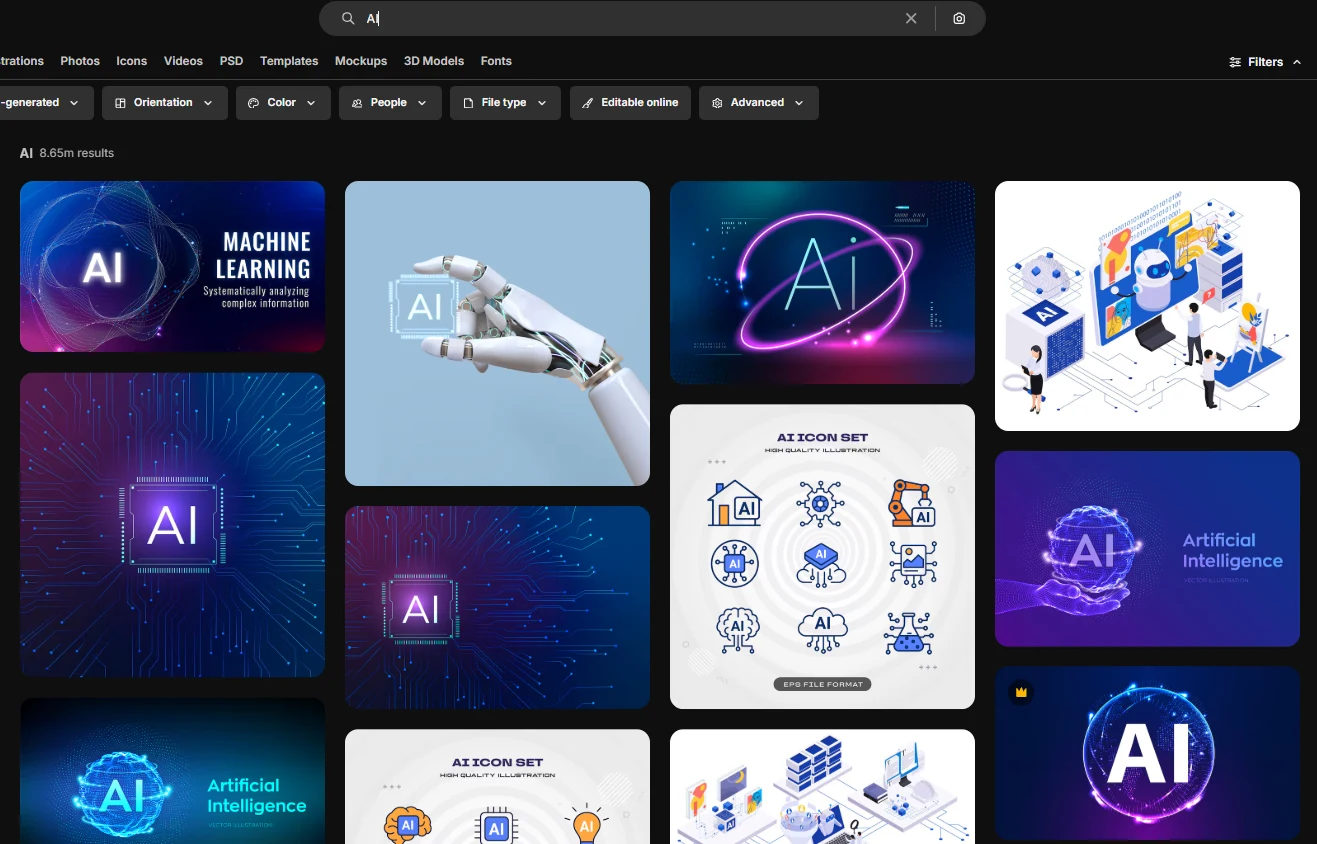
「AI」だとこんな感じです。人間のポーズ集なども多数ありますので、Controlnetの抽出元として使うのもありかもしれません。
・無制限生成が可能「Premium+」(月額5,850円)
このランクから画像生成(Seedream4.0、nanobananaなど)全体が、動画生成はWan2.2の480Pが使い放題になります。その他の動画生成、音声・音楽生成、その他の生成(アップスケールなど)には別途クレジットがかかりますが、月当たり45,000クレジットも配布されるので、めったに使い切ることはないかと思います。ついでにクレジットの追加購入も割引になります。
(これ以上のプランになると月額37,500円の「Pro」がありますが、手が出ない方がほとんどだと思いますので割愛します。記事執筆時とプラン条件が変更になる可能性もありますので、必ず公式サイトの説明を確認した上で契約するようにしてください)
・「Freepikあり?なし?」個人的感想
Seedream4の検証に入る前に、「私の普段の作品作りにおいて、Freepikを契約する価値があるか?」という個人的所感について書いてみます。
私にとって、Freepikを利用する価値は主にNanoBananaとSeedream4を無制限・快適生成できること。NanoBananaならFreepik未契約でもGoogle AI StudioやGeminiである程度無料生成できるわけですが、FreepikのPremium+プランだと同時複数枚の生成が無制限連打できるのが大変快適で、大きなメリットだと感じました。
マイナスポイントは、FreepikではどのモデルもNSFW生成が不可ということ。いかに便利なNanoBananaと言えど、エラーが出るのでR-18生成には使えません。そうなると、Wan2.2での生成はローカル一択ということになってしまいます。
私はSNSでご覧いただいている通り、二次創作やR-18を含む静止画生成と、せいぜいそれらをかんたんに動画化するワークフローが作業のメインですので、Freepikが主に使えるのは「漫画作りの際、illustriousでは作れない難しい構図をキャラの一貫性を保って生成する」とか「追加学習させないと再現できない衣装・背景・マイナーキャラの生成」といった場面に限られます。そんなわけで当初はPremium+の契約を見送り、とりあえずEssentialプランの範囲で画像生成を試していましたが、今回の検証を実施するにあたり、Premium+を月払い契約して臨むことにしました。
蓋を開けてみれば、ここから検証していく通り、Seedream4.0の実力はなかなかのもので、NanoBananaとの併用も非常に便利でした。
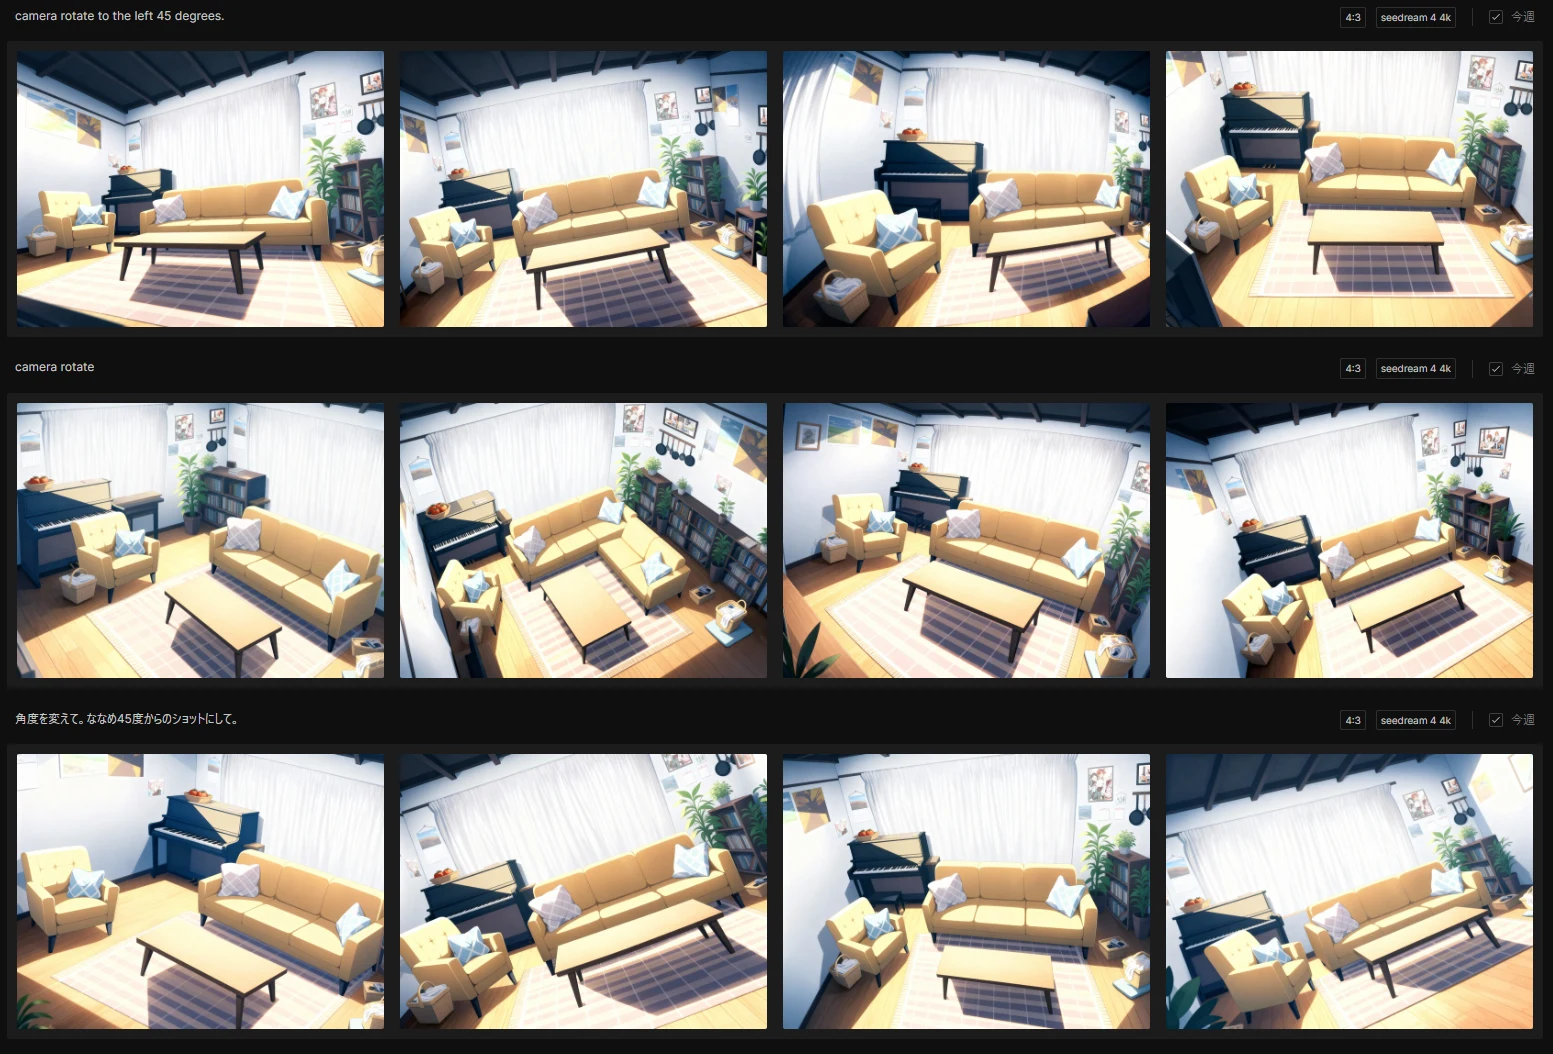
▲Seedream4.0でカメラアングルを変更してみたテスト
何より、両モデルで同時大量生成が遠慮なくできるFreepikの快適さはかなりのもの。月額5,850円はさすがに高額ではありますが、漫画などを日常的に作る人なら、その価値は十分にあるなと感じたのが正直なところです。(※いちおう書いておきますが、今回の記事はプロモ案件ではなく自腹です)
Premium+プランを契約する価値があるかどうかは、そのユーザーが月にどれだけ作品を作るか、どんな作品を作りたいかによりますので、今回の検証を見て頂いた上で、それぞれの事情に照らして検討して頂くのがよいかなと思います。
・生成画像のガイドライン
こちらからFreepikの生成画像ガイドラインを確認できますので、契約を検討されている方はよく読んでおきましょう。露骨な性的コンテンツはNGで、露骨な性的内容や未成年を性的文脈で描くことも禁じられています。扇情的なポーズとか水着とかは、ちゃんと局部が隠れていてもNG判定になりやすいようです。
AUP(利用許容ポリシー=Acceptable Use Policy)では、包括禁止事項として未成年の搾取、違法・有害行為の助長などを列挙しており、違反時はコンテンツ削除やアカウントBANなどがありえると明示されています。
全年齢イラストでも胸の谷間が強調されているだけで成人向けフラグが立って生成不可になったことがありますので、性交渉などの露骨な性的表現、ヌード、未成年の性的文脈(パンチラ等)は基本的に不可と考えておきましょう。
ちなみに「白い紙の上に載ったトマト」をNanoBananaで生成しようとしたところ、このように拒否されたことがありました。どういう想像をしたのか分かりませんが、こうした誤検知も結構ある印象です。(detect=生成拒否された場合、クレジットは返してもらえます)
3.FreepikでSeedreamを使ってみる
さて、ここからはFreepikの使い勝手についてです。こちらは月額1,300円の「Essential」プランを契約し、Image Generator画面を開いたところ。「Model」欄から使用したいモデルを選択し、画面左上のプロンプト欄に日本語で指示を打ち込んで「Generate」ボタンを押せば基本的にOKです。
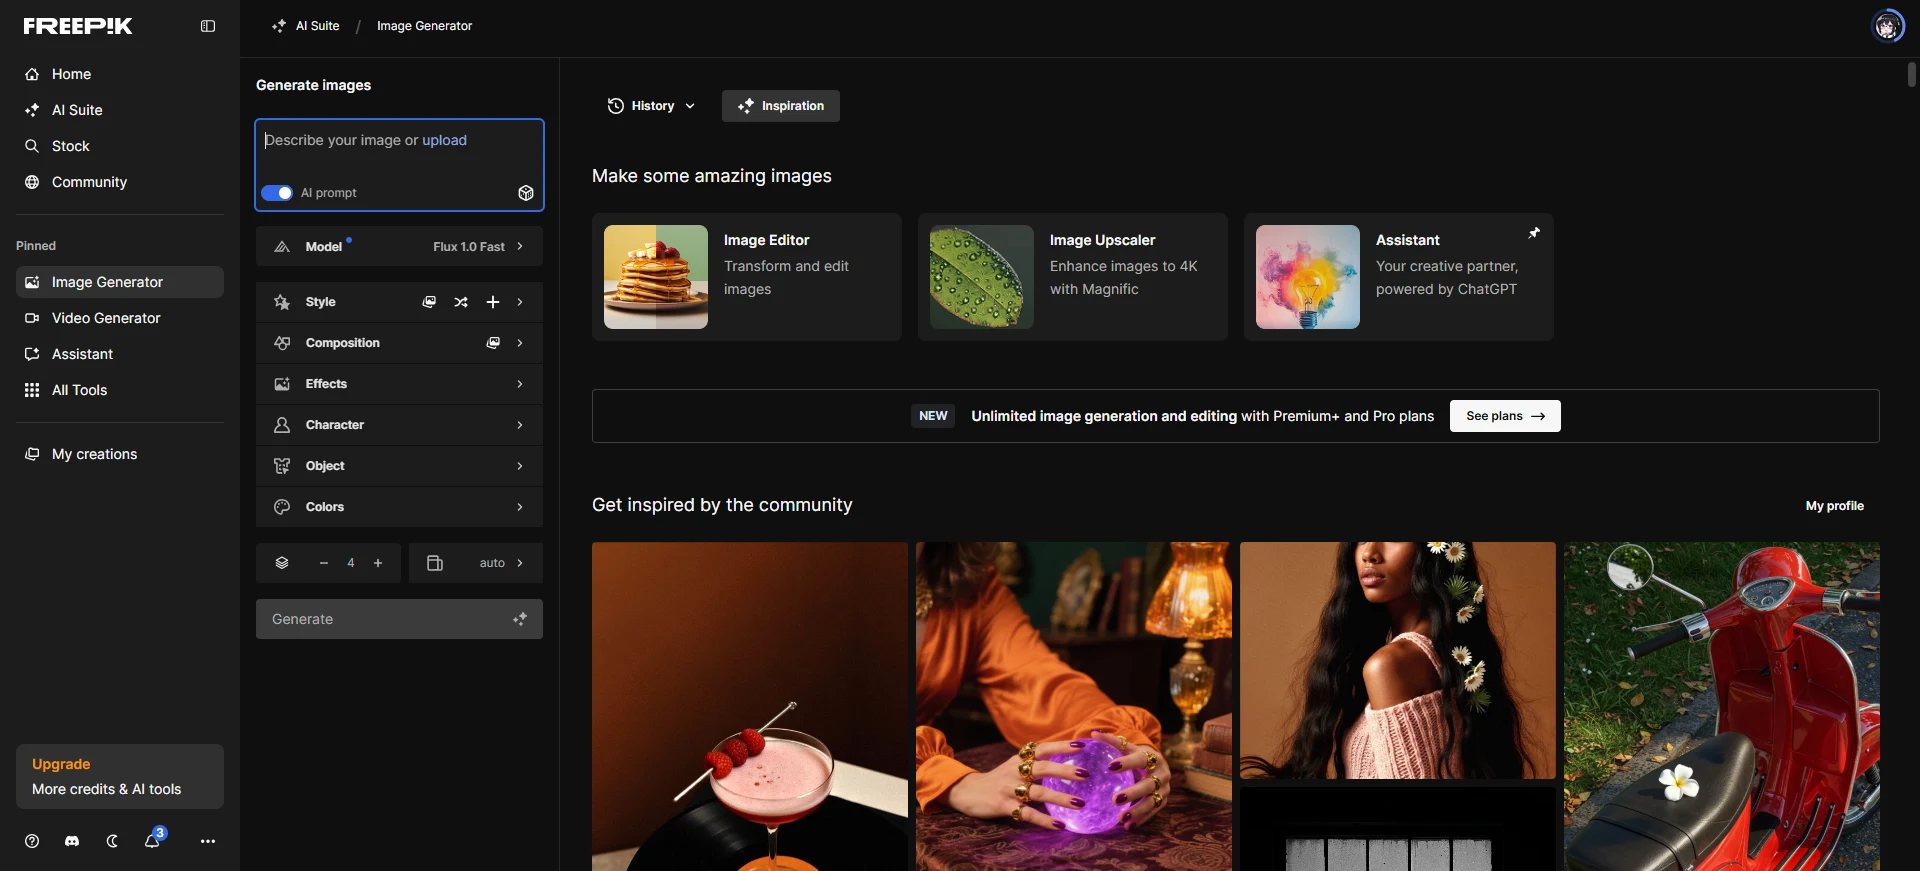
プロンプト欄の右下にはさいころボタンがあり、クリックするとランダムなプロンプトが入力されます。基本的に日本語入力で問題ないのであまり使うことはないでしょうが、どういう記述をすべきかのお手本になります。Seed値はデフォルトでは毎回ランダム変更されますが、双葉マークのカスタムシードボタン(▼)から自分で選ぶこともできます。
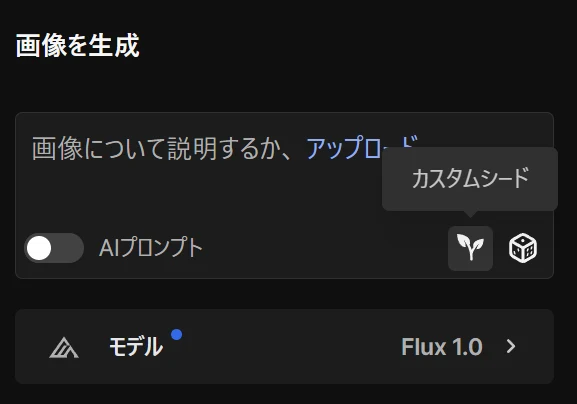
「AIプロンプト」のトグルはプロンプトの自動詳細化機能。オンにすると自動で短いプロンプトが詳しく書き換えられます。余計なものが描かれる可能性があるので、基本はオフで良いと思います。
「Style」以下の欄からは、生成したい画像の詳細を指定することができます。プロンプトでいちいち指示しなくても、初期登録されたエフェクトや画風、キャラクター、オブジェクト、カラーパレットから好みのものを選ぶことで、生成結果に反映されます。
例えば、カラーパレットからはこのように基本カラーを指定することができます、
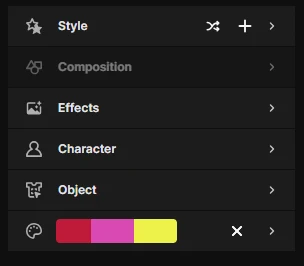
この状態で、NanoBananaで「地面の上に白い正方形の紙が置かれ、その上においしそうな赤いトマトが載ったアニメ画像」を生成すると、このようなカラーリングになります。
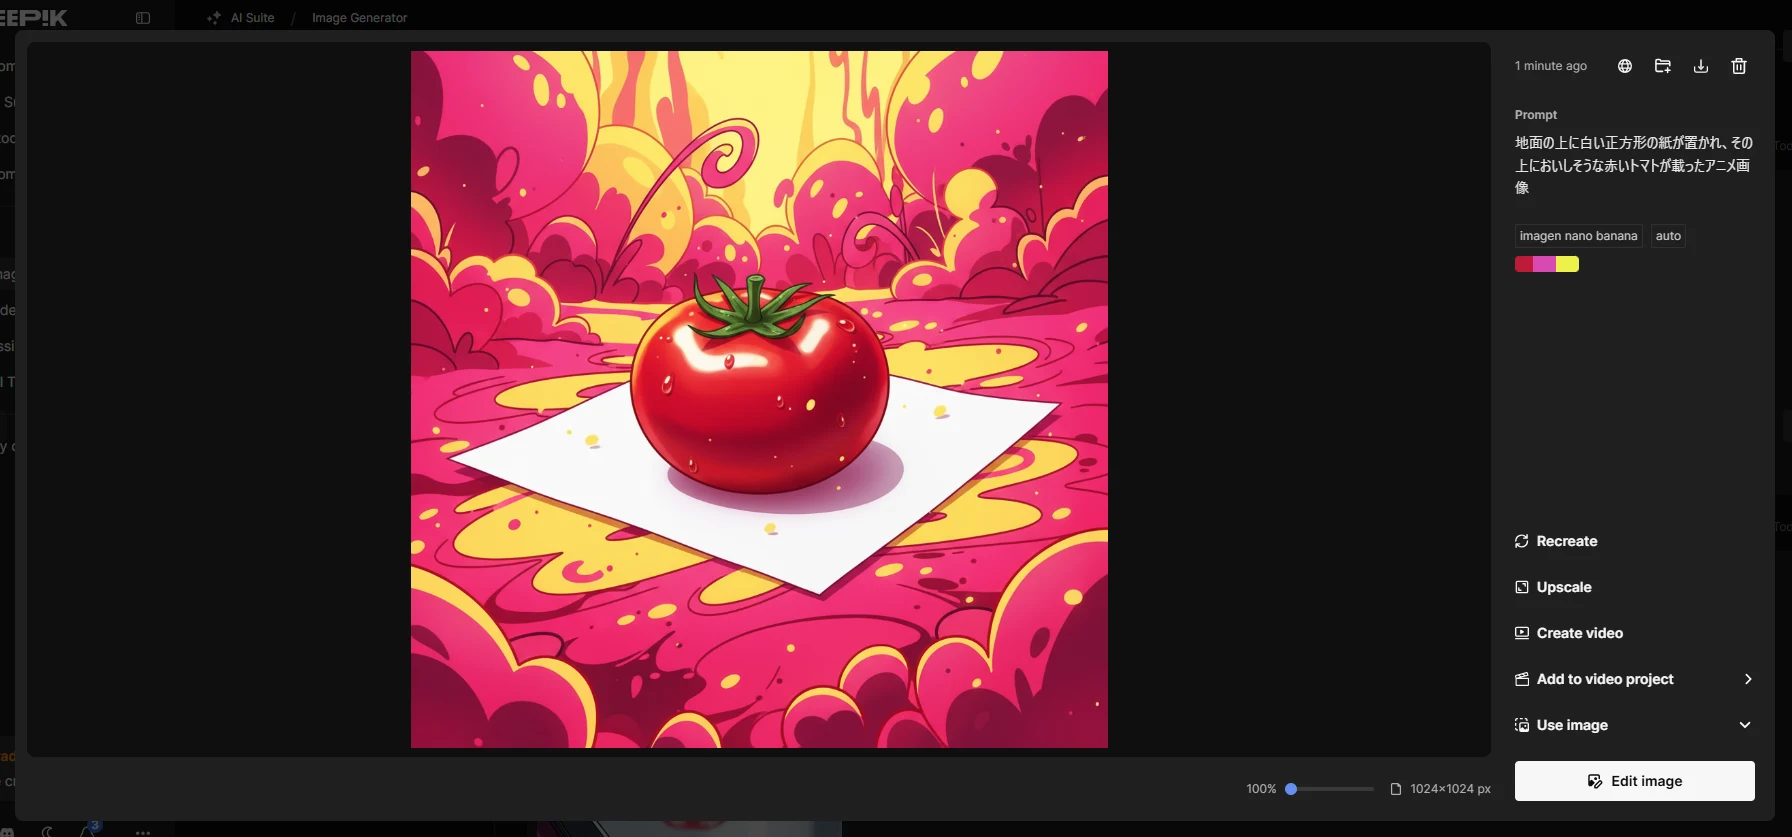
こちらは全く同じプロンプトでSeedream4.0で生成したもの。いずれもカラーリングが忠実に守られています。
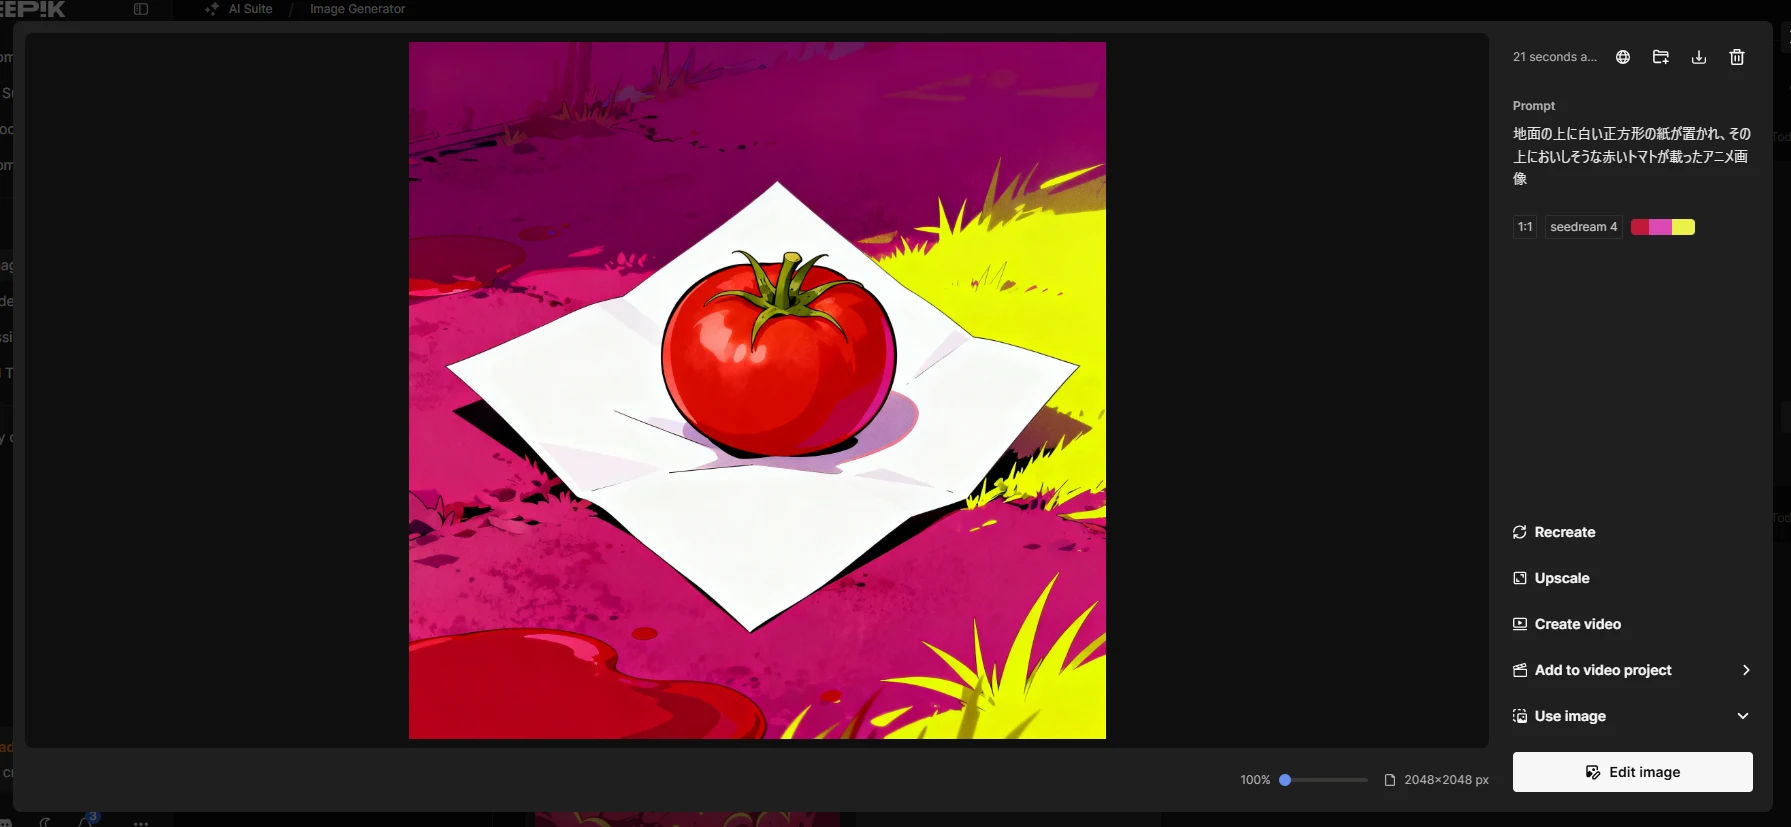
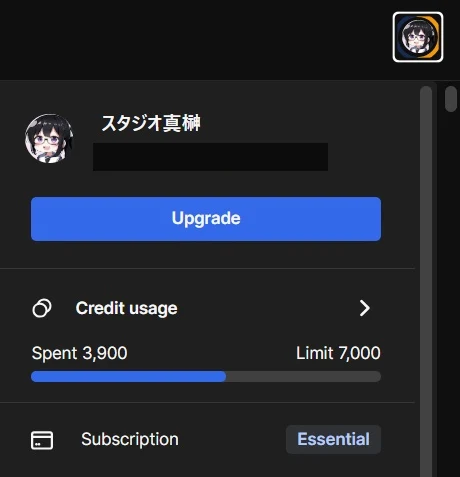
さきほど触れた通り、上の生成で100+120クレジット消費しますので、かなりお高い印象ですね。無制限ではないプランの場合、残りクレジットは右上のアイコンから確認可能です。
・一部モデルで「マイスタイル」も登録可能(高額プランのみ)
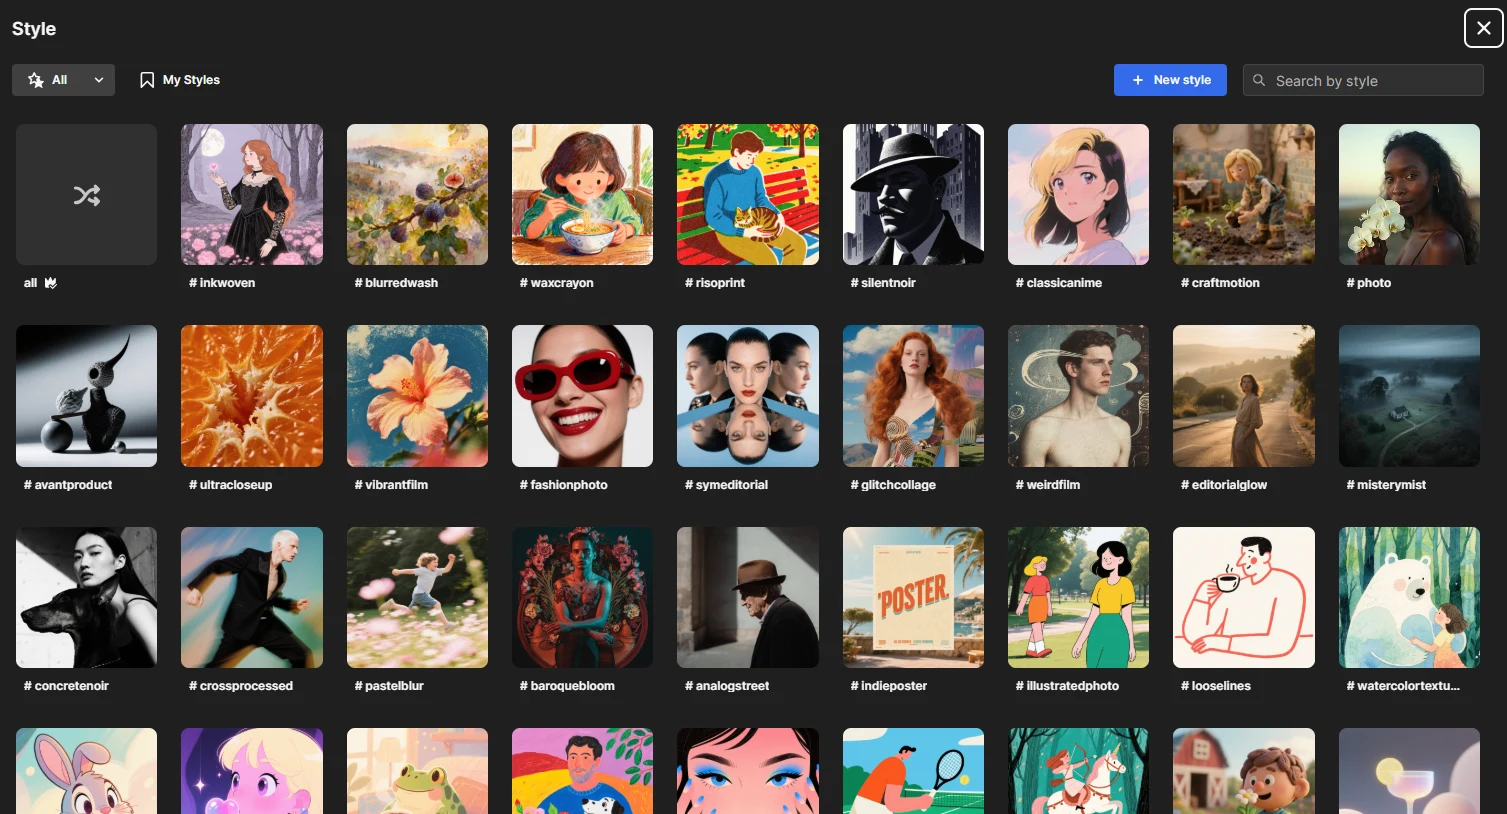
「Style」はこのような感じで、生成画像の画風を選ぶことができます。大きくわけて実写系とイラスト系があり、イラスト系の中にもさまざまな画風があることが分かります。個人的には、自分の生成したAIイラストや作品を読み込ませて画像編集することで画風を統一していますが、MysticとFluxでは自分の作品を10~50枚ほど登録することで、text2imageでも画風模倣が可能になります。(※プレミアムプラン以上で解放)
例えばこのように、一貫した画風のちび画像を数十枚用意して、アップロードすることで、「スタイル」を作ることができます。残念ながらNanoBananaやSeedream4.0では使うことができませんが、簡易的にFLUX用画風LoRAを作るような感覚です。できたスタイルは強度0~200%の間で適用できます。
ちなみに上記のデータセットで学習した「スタイル」はこんな感じ(強度100%)。
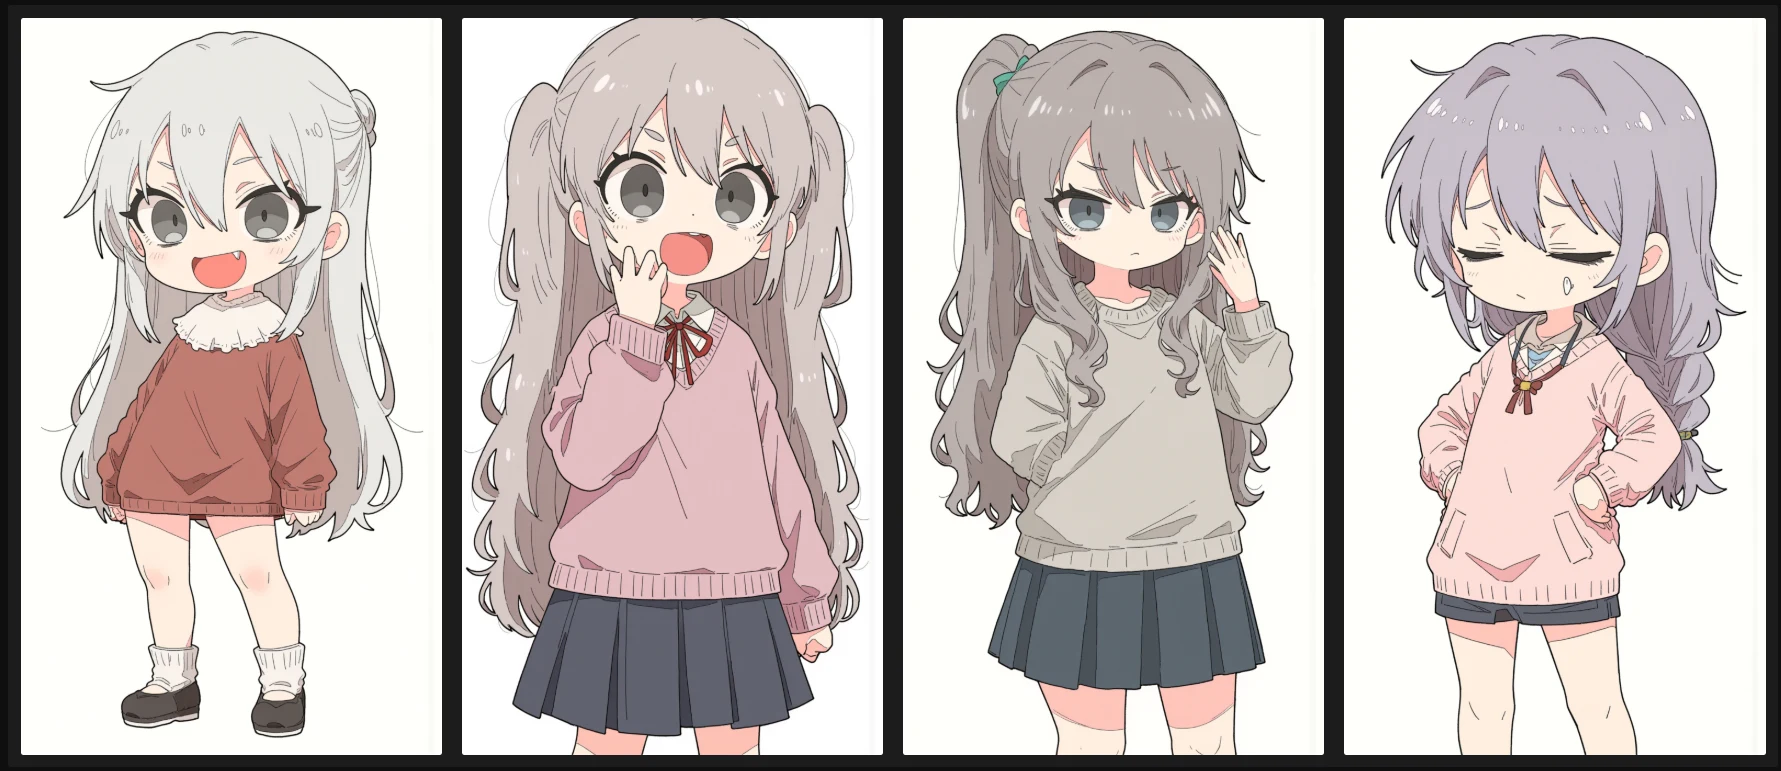
頭身は完璧ではありませんが、かなりテイストは似ています。ただこれ…「メイド服を着た女の子のイラスト」と指示して生成したものなんですよね。下図を見ていただくとわかるとおり、プロンプト対応力が全然なく、指などの破綻も大きいように感じました。
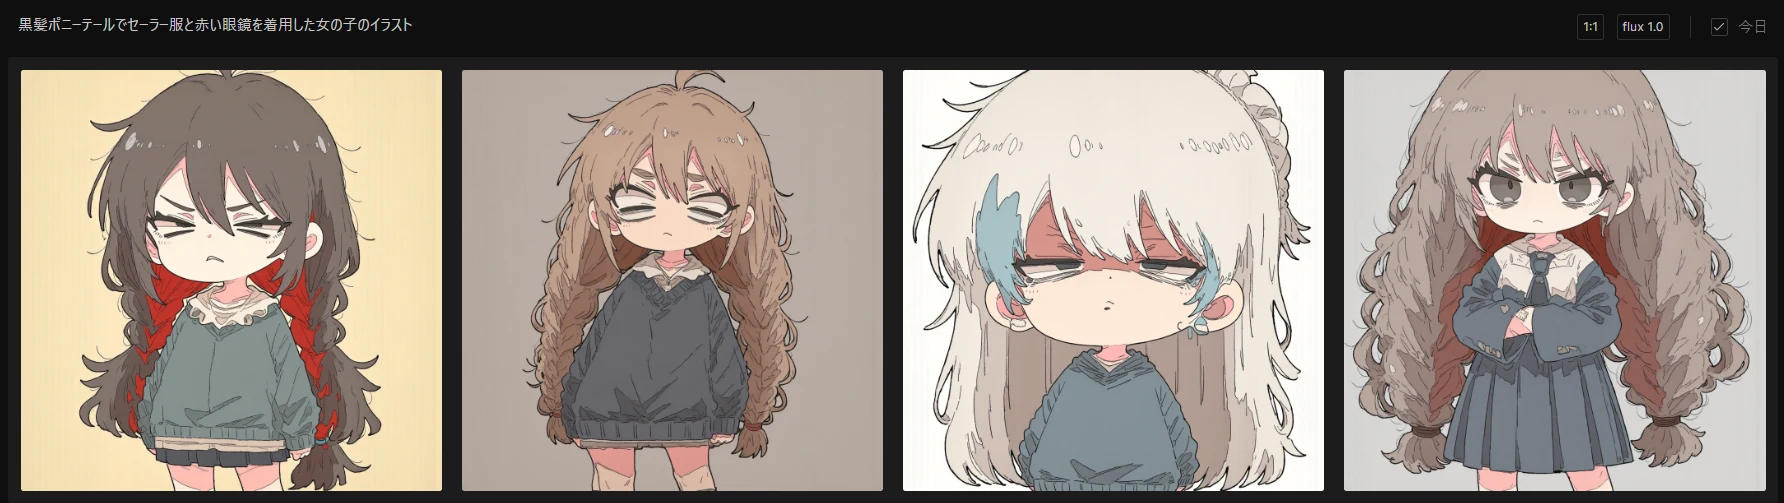
▲指示「黒髪ポニーテールでセーラー服と赤い眼鏡を着用した女の子のイラスト」
ただ、このスタイルは「画像の大きさを2000px以上にすべし」とあるところ、1024pxのデータセットで作ってしまったものなので、サイズを改善するとちゃんと使える「スタイル」になるかもしれません。いろいろと試してみないと実力はまだわかりませんが、ファーストインプレッションとしてはこのような感じでした。
・アスペクト比を指定可能
最下部からは、同時に生成する枚数と画像のアスペクト比を設定できます。デフォルトは1:1(正方形)で、「9:16」や「3:4」、「2:3」などさまざまな比率を選択可能です。
Seedream4.0はちゃんと守ってくれますが、NanoBananaは指示通りにならないことがあります。実際に、NanoBananaでアスペクト比を操作しようとすると、下記のように「NanoBananaは現在ベータ版のため、アスペクト比が正しく反映されない場合があります」と注意書きが出ます。
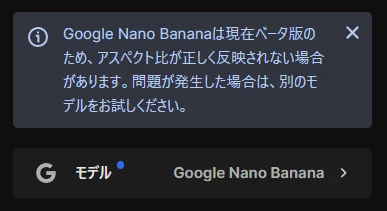
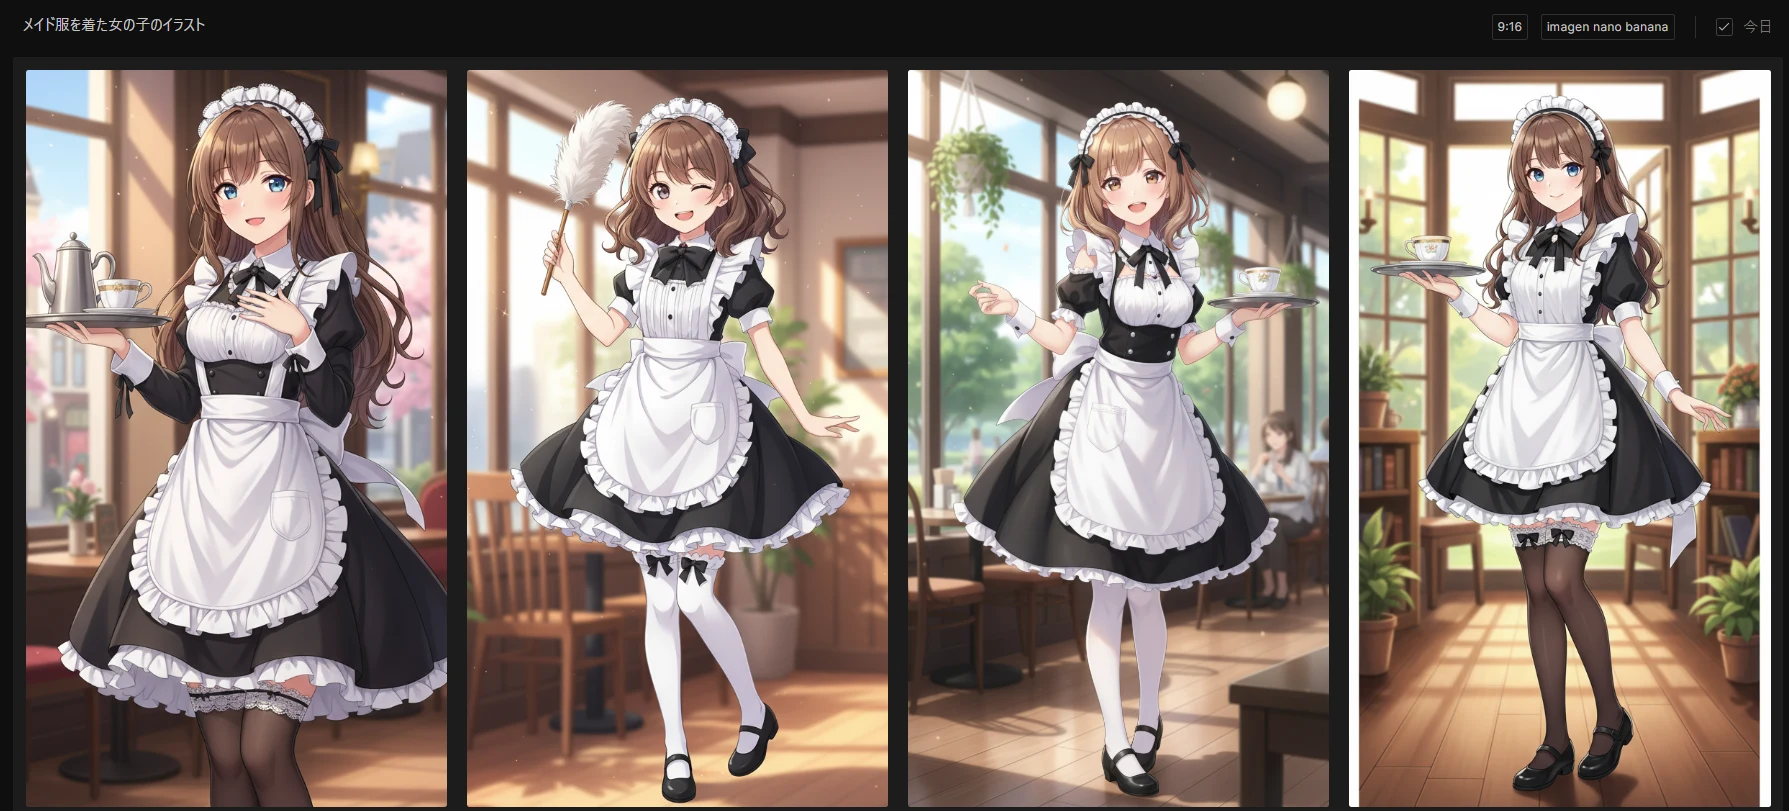
ただ、全くアスペクト比が思う通りにならないGeminiやGoogle AI Studioと違って、Freepikでのアスペクト比指定はそれなりにうまくいきます。こちらは縦型の「9:16」を選択してNanoBananaで生成したメイドさん。おおむね指示した通りになっています(一番右は白帯が出てしまいました)
4.実践
Seedream4.0とFreepikの解説はここまでで、さっそく実践に入っていきましょう。基本的には、こちらのNanoBanana特集で試した画像編集と全く同じ検証を同じ画像で試していくことで、実力差や得意不得意なジャンルをあぶり出してきたいと思います。NanoBananaの画像も載せると長大になってしまいますので、少し見づらいかもしれませんが、別ウィンドウで開いて左右に並べるなどして閲覧していただけると分かりやすいはずです。
検証1.ポーズ・表情・服装・背景を変更
まずはこちらの画像を連続で変更させていきましょう。
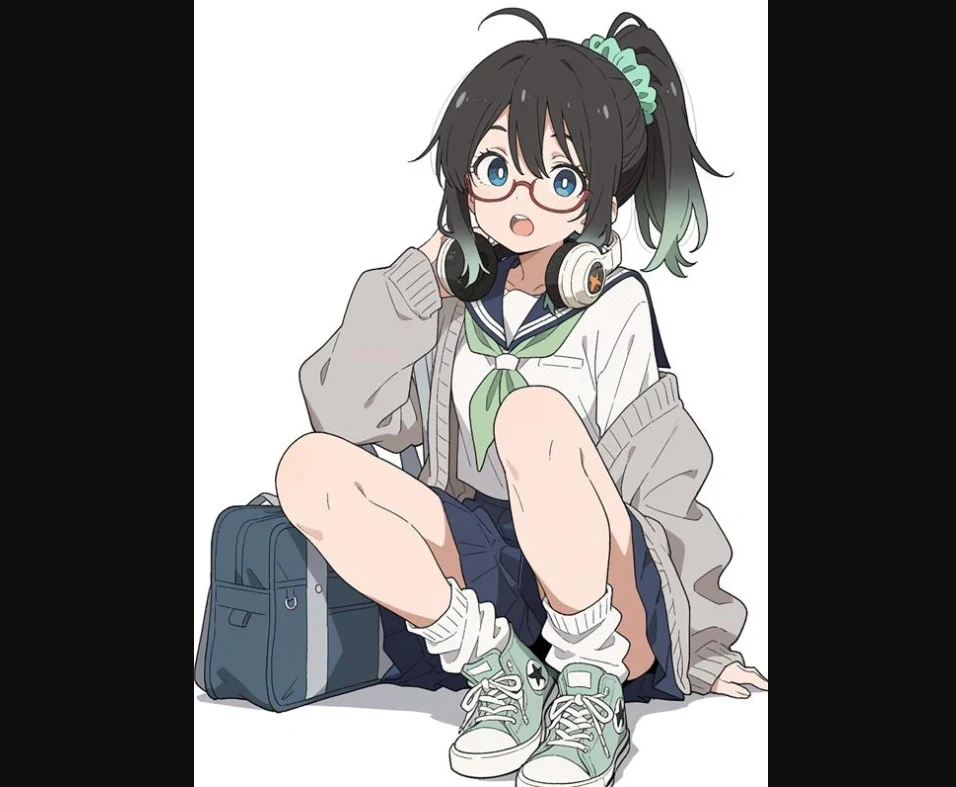
Seedream4.0はこちらの選択肢からアスペクト比を指定可能。今回は「3:4」の縦長を指示して生成してみます。
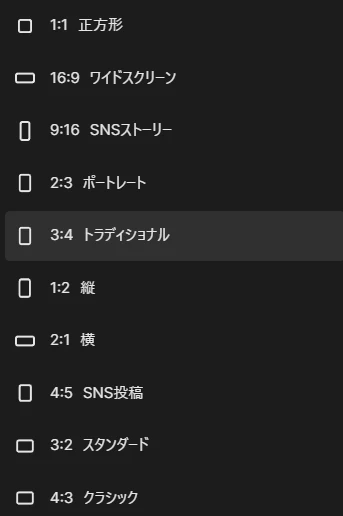
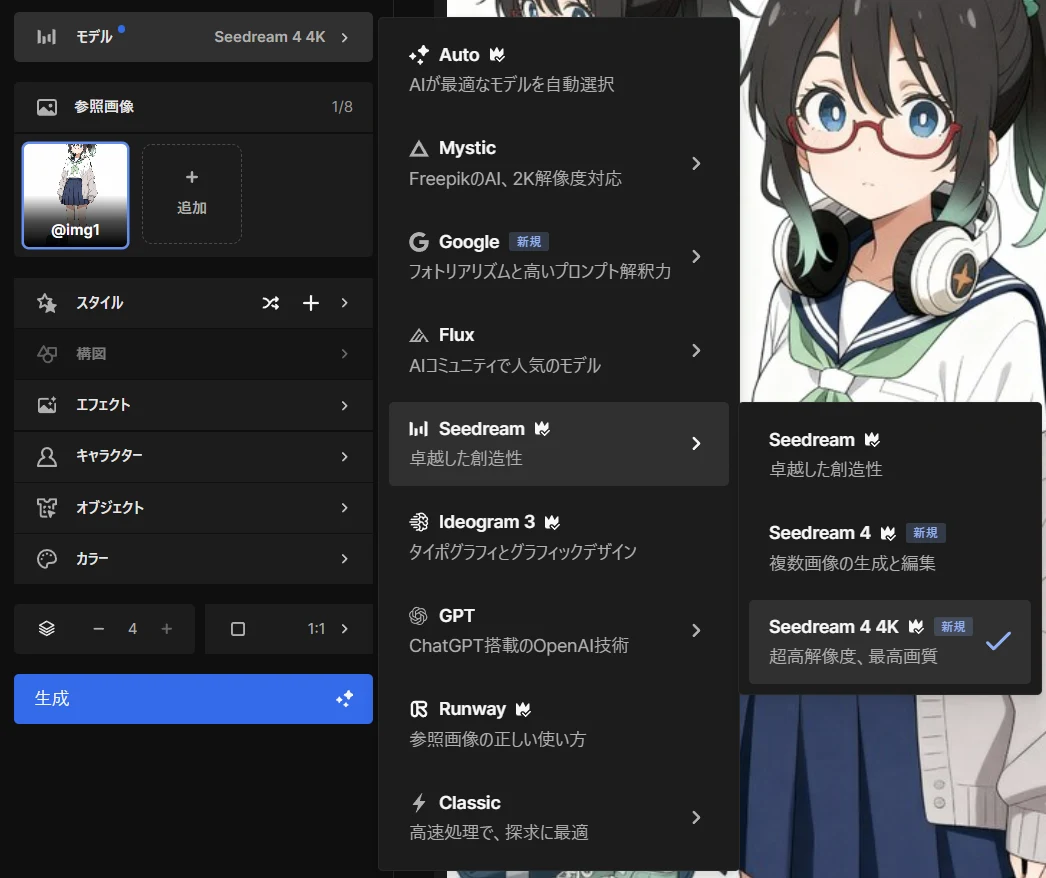
使用するモデルはせっかく無制限なので、「Seedream4」ではなく「Seedream4 4k」の方を使います。正方形なら4096x4096pxという超高解像度で生成できる最高モデルですが、Premium+プランならこちらも無制限に生成連打が可能です。
プロンプトはこちら。以降、この検証記事ではスタイルやカラー指示を一切していません。
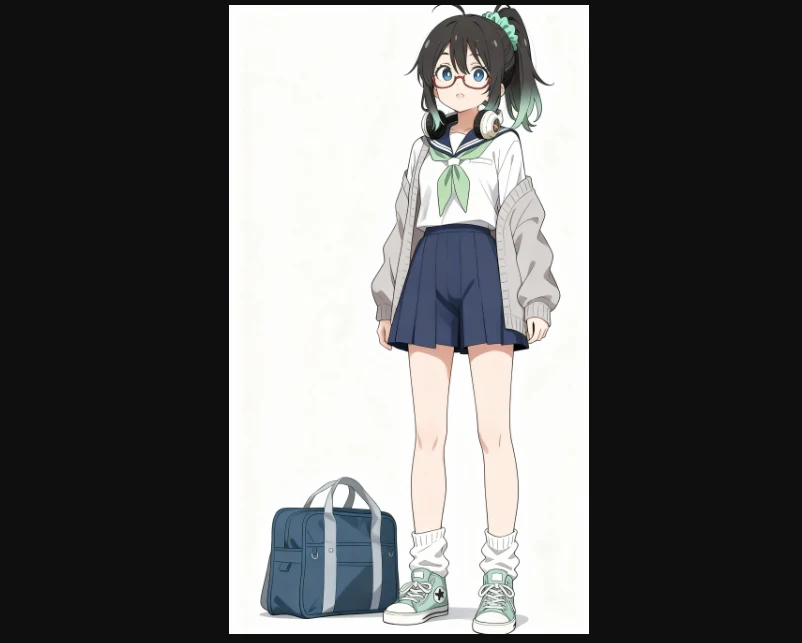
指示:「直立している全身図にして。正面から」
最初からなんだか寸足らずのボディサイズになりました。ずり落ちているカーディガンの肩部分もなんだか破綻していますが、顔立ちの維持だけは非常に高いレベルに感じます。
9:16の生成サイズでやってみると、このような感じ。もしかすると、アスペクト比が身長に影響してしまうのかもしれません。また、肩の破綻がまたも引き継がれていて、Seedream4.0は「整合性よりもともかく入力画像を再現しようとする力」が強いように見えます。この座っているミナちゃんのイラストを入力すると、基本的にこの破綻や足の長さの不自然さが引き継がれてしまいました。
さきほどの生成結果で一番よくできたように見えるこちらの画像を、新たな入力画像にしてテストを続けます。しかし、単体でみると正直、いつものillustrious系モデルで生成したのかと思うくらい普段のミナちゃんに見えますね。
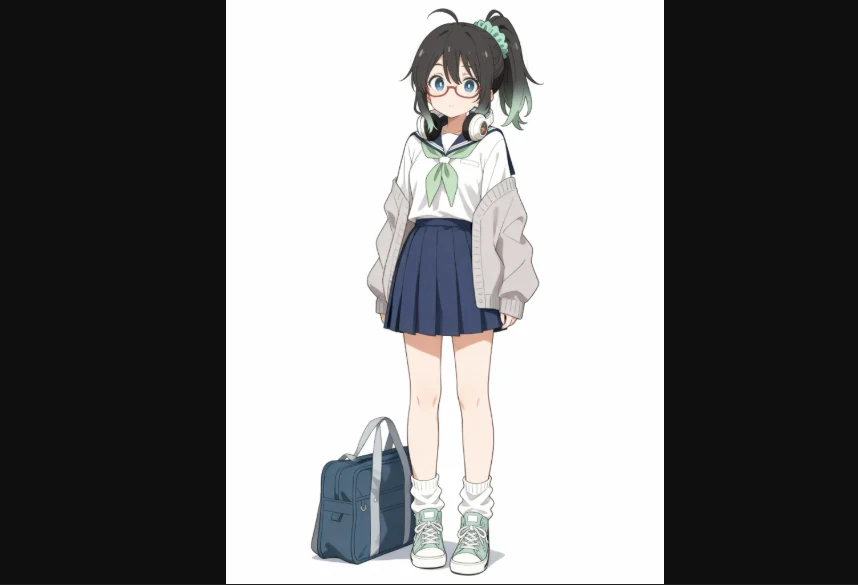
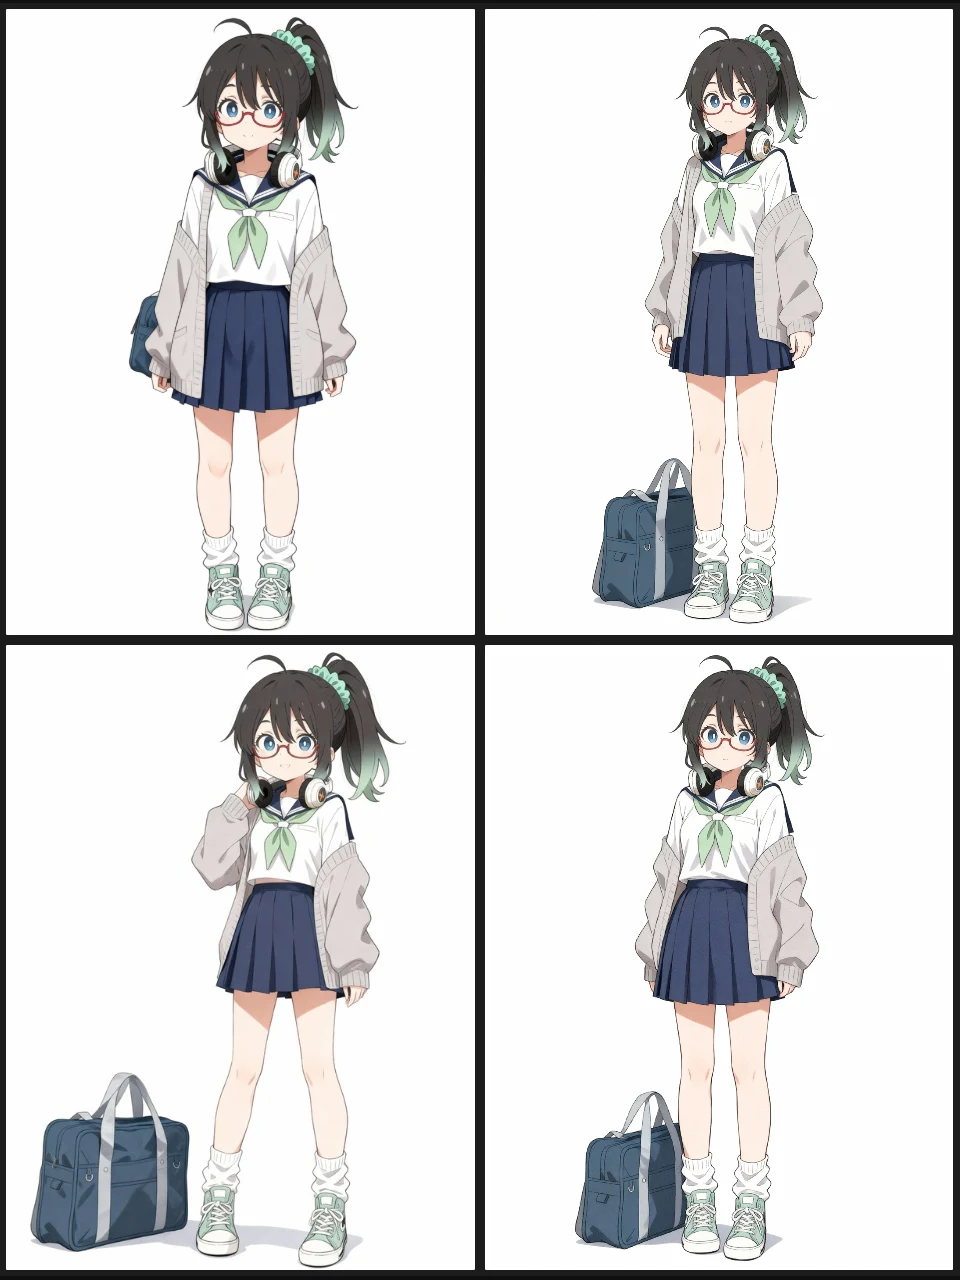
指示「この全身図を三面図にして。正面・横から・背後から。」(縦長3:4)
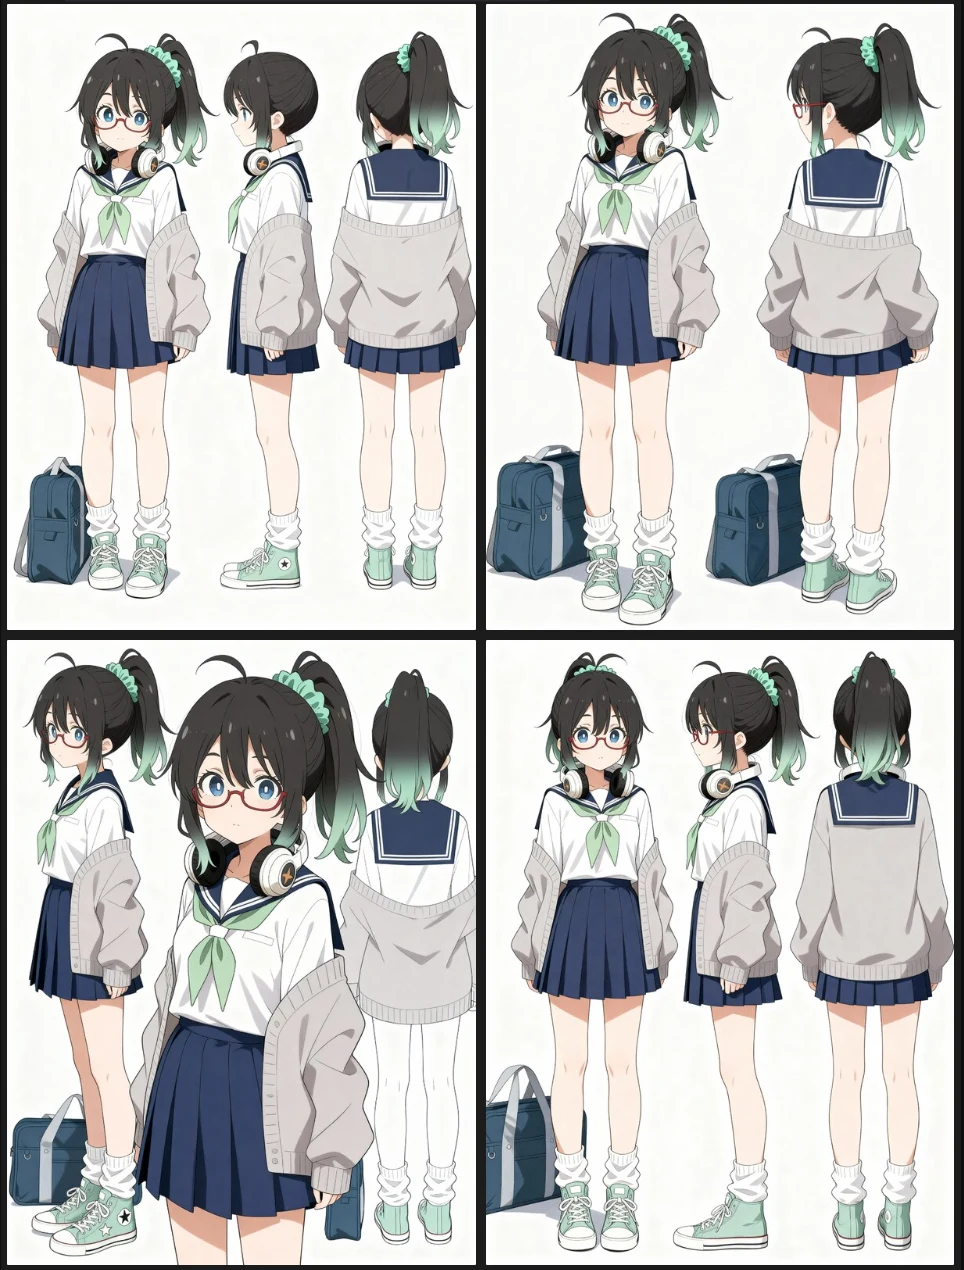
「3:4」のアスペクト比が守られた結果、どうも狭そうに見えます。右上の一枚は2カットしかおさまらなかったので、生成したい画像によってサイズ指示を考えたほうがよいことが分かります。
アスペクト比を正方形にしてやりなおすと、こちらのようになりました。
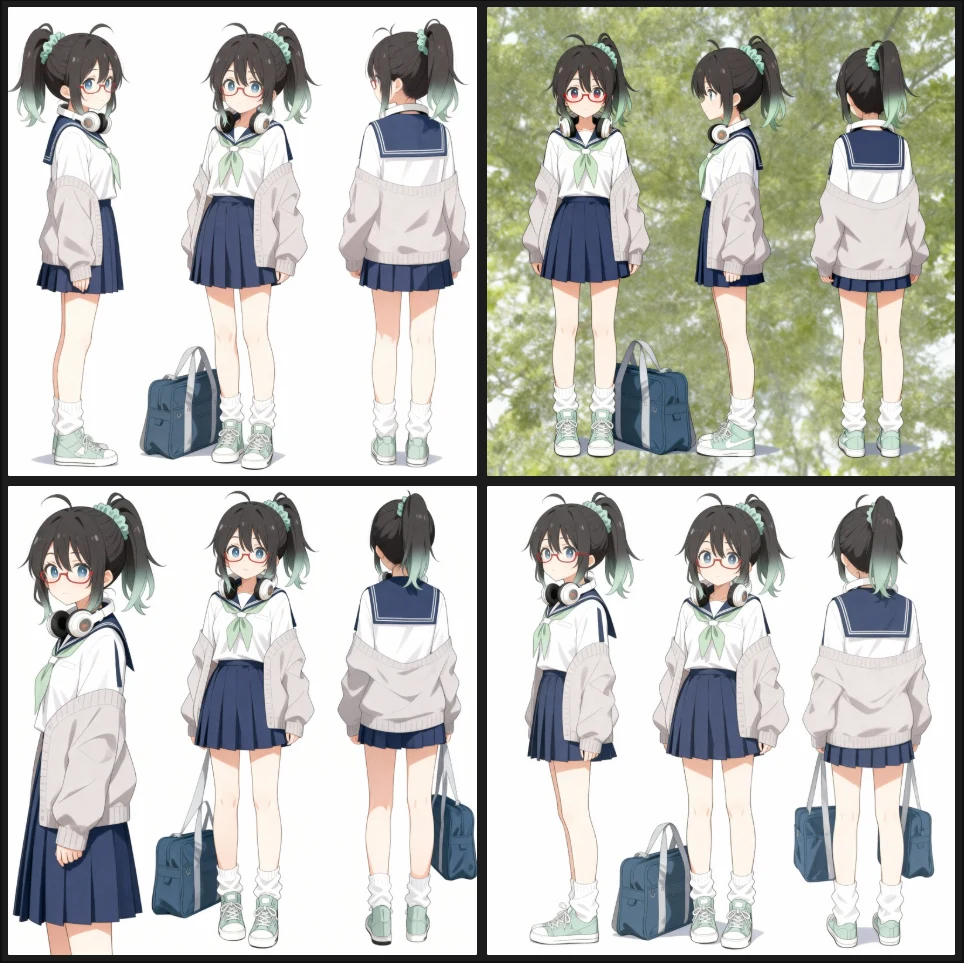
今度は、バッグをどうしたらいいか、背景をどうしたらいいかを迷っている感じが見受けられます。このように、Seedream4.0はあまりシンプルすぎる指示だと「迷い」が見られるモデルです。理想像が決まっている場合は、できるだけ詳しく書いてあげないと、入力画像に引っ張られてしまいます。
上のケースでは、入力画像と同じハンコ絵のような表情になっていますので、もう少し詳しくプロンプトを入力してみます。
指示「この女の子の全身の三面図を描いて。正面・横から・背後から。バッグは不要。視線は正面。背景は白。グレーのカーディガンが肩からずり落ちています。」
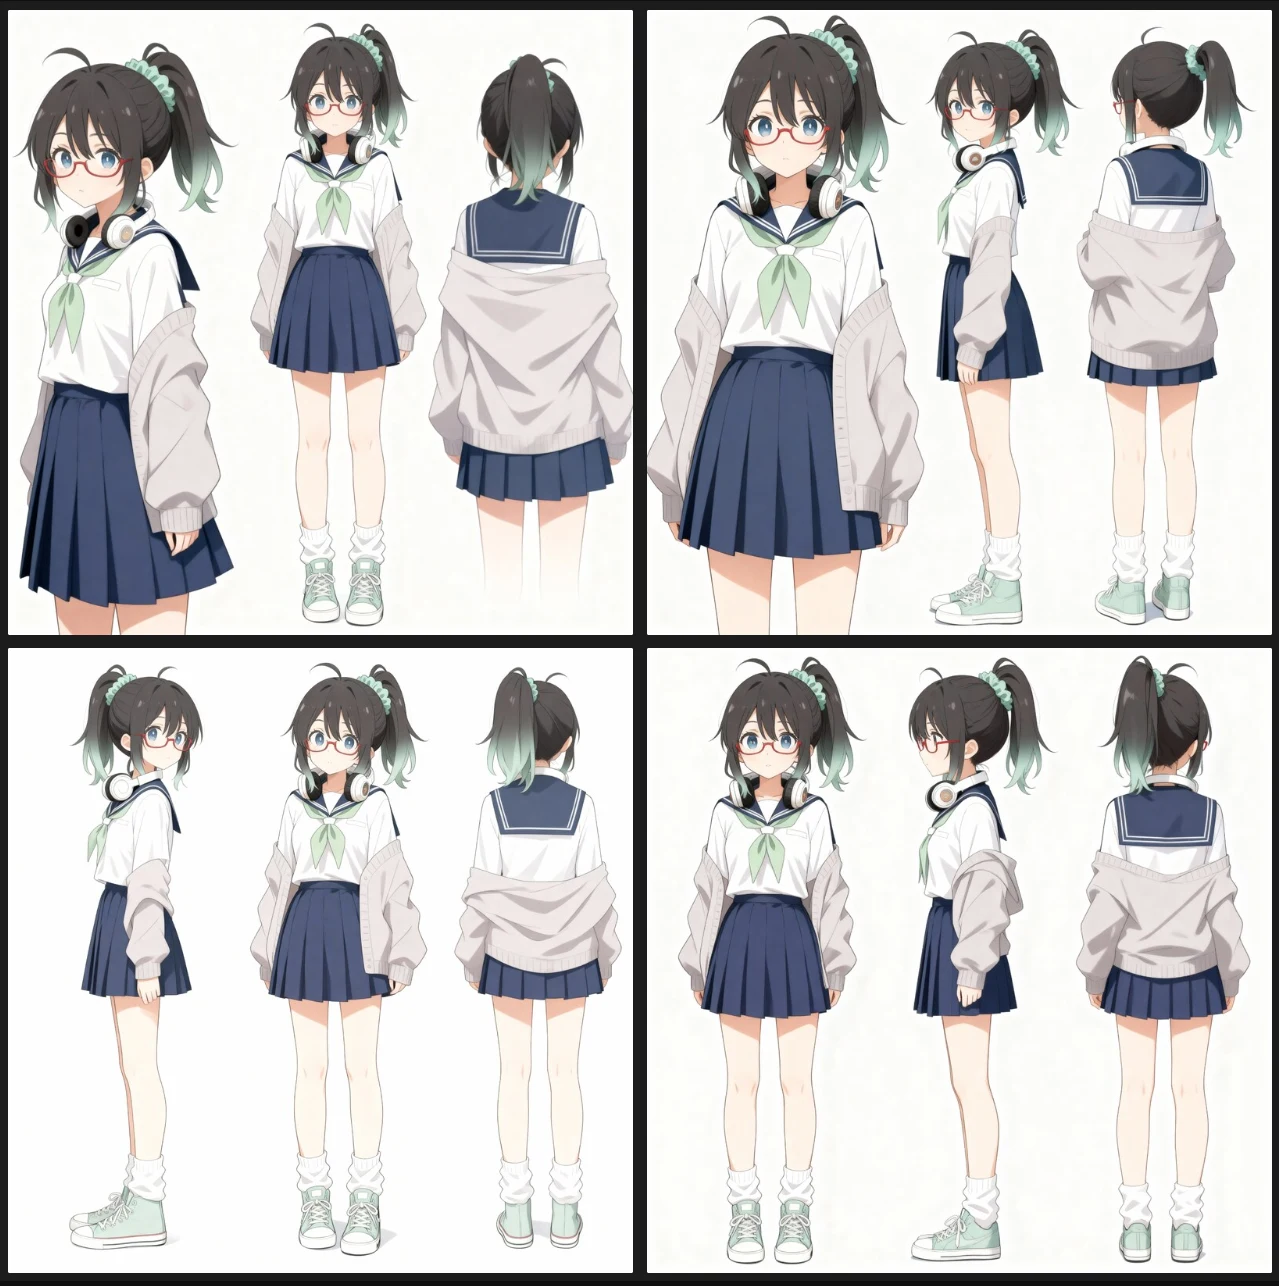
このようにするとやや安定します。ただ、左下は首が後ろを向いていますね…(笑) Seedream4はNanoBananaと比べて、結構こうした破綻が多いような気がします。
三面図のうち右下の一枚を入力画像にして、実験を続けます。
指示「腕組みをさせて、呆れた表情にして。」
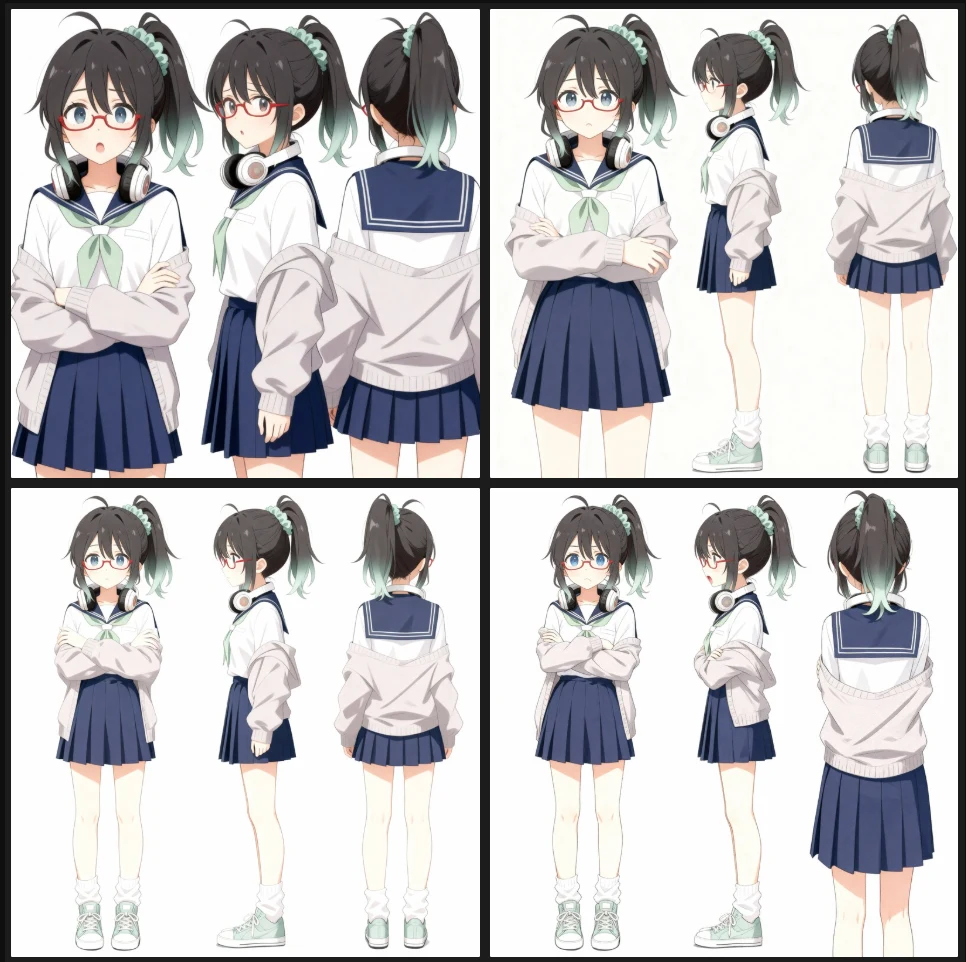
ここまでは読み込ませたキャラクターとほぼ同じ表情で印象をキープできていましたが、表情変更すると印象がだいぶ変わってしまいました。これは顔の描画サイズが小さいためかもしれません。入力画像が1枚だけで進めているので、顔のアップの画像も参照させたいところですが、Nanobanana実験と条件を合わせるためこのまま続行します。
指示:三面図のまま、バニーガールの服装にして。ポーズや表情はそのまま。
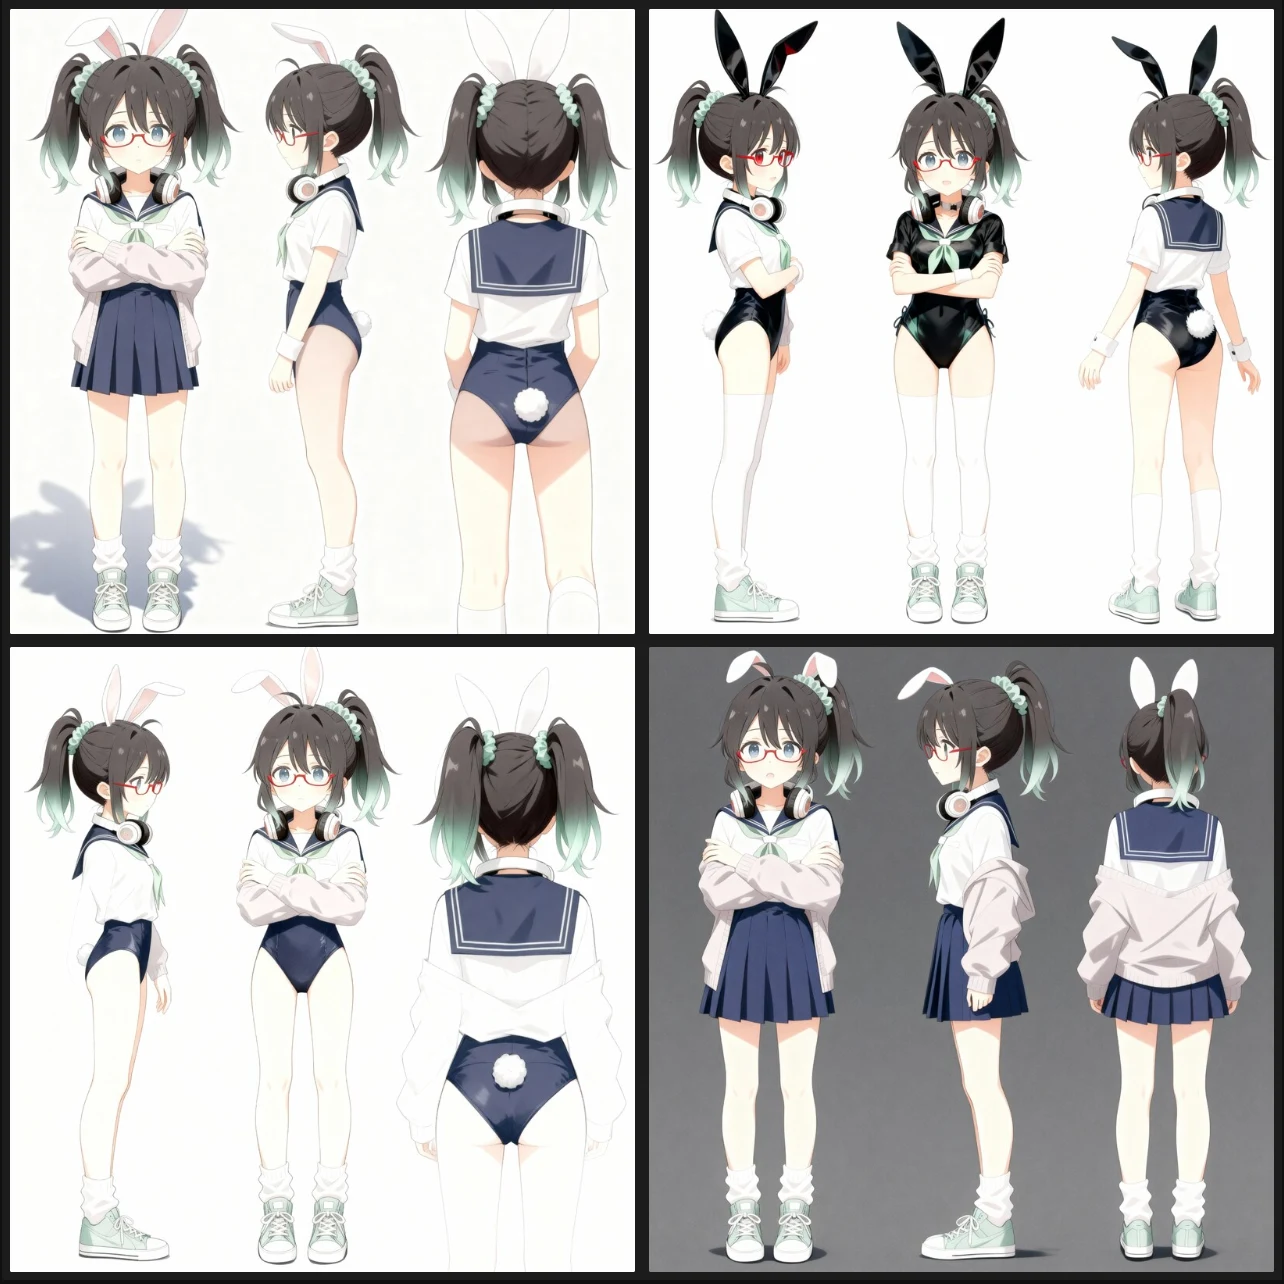
大惨事。なぜそんなマニアックなデザインに!?
どんどんおかしくなってきていますが、最後までやってみます。
指示「このバニー姿の女の子が、最も魅力的だと思われるポーズや背景を考えて、一枚の完成イラストにして。」(※アスペクト比は縦長3:4を選択)
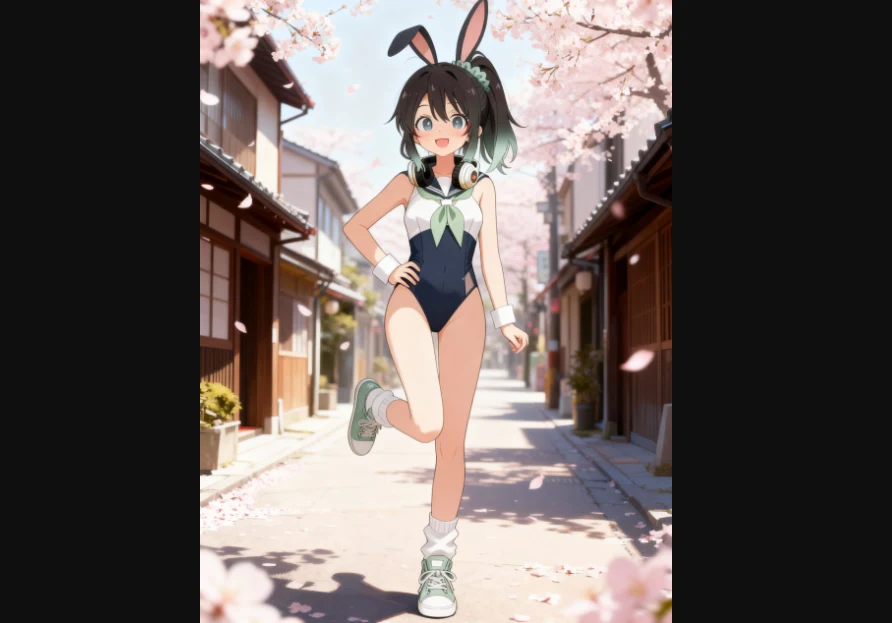
赤眼鏡が消えてしまいましたが、背景はなかなか素敵ですね。ただ、NanoBananaが豪華なパーティルーム風の背景でバニーガールとの整合性を取ってきたのに対し、春の京都風の背景はやや脈絡に欠けるかもしれません。
指示「この子がベッドの上で横たわってこちらを見ている主観イラストにして」(※アスペクト比は縦長3:4を選択)
NanoBananaは生成してくれましたが、Seedream4.0はここで初detect(生成拒否)がでました。生成自体はできたようで、うっすら背景に見えますが、生成した画像にNSFWフラグが立ってしまったようです。
Seed値によっては生成が通る可能性もあるかと考え、上の画面で「Retry」をクリックしてみるとー。
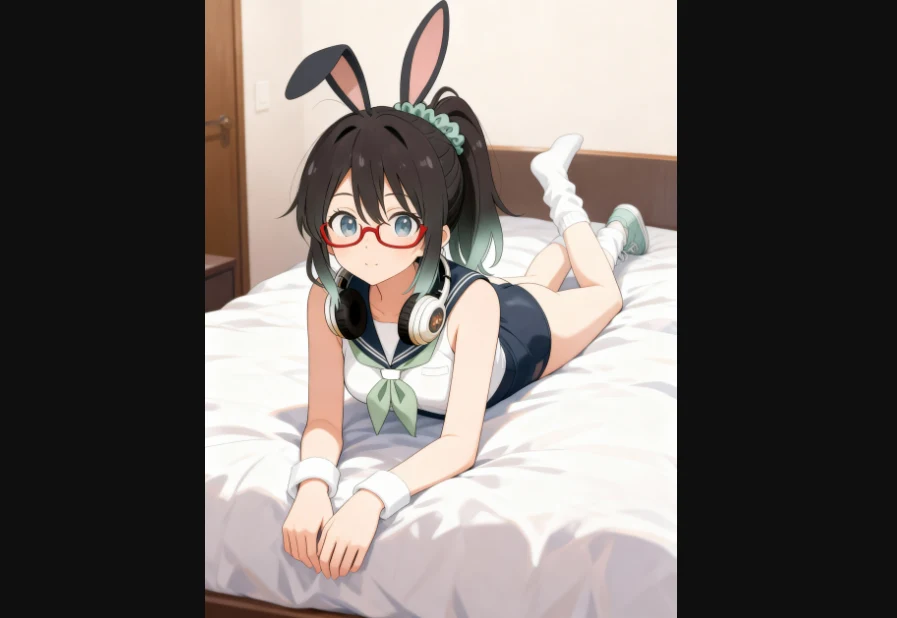
今度は生成できました。それなりに頑張ってくれていますが、足に破綻が見えますね。また、ここまでリレー形式で生成を繰り返すごとに、最初のミナちゃんとの整合性は少しずつそげ落ちていったように感じます。(Seedream4.0は複数枚の画像で一貫性を保てると説明されていますので、そこはあとで検証します)
再び、一番最初の座っているミナちゃんの画像を与えて、今度は4面図を指示してみました。
指示:Please create four-view illustrations of this character wearing a sailor uniform, a ponytail, and red glasses. The gray sweater is slipping off her shoulders and nearly falling off. The standing illustrations should be arranged side-by-side: front view, right side view, left side view, and back view. The full-body illustrations should have a white background. No bag is needed.(※アスペクト比は横長の4:3を選択)
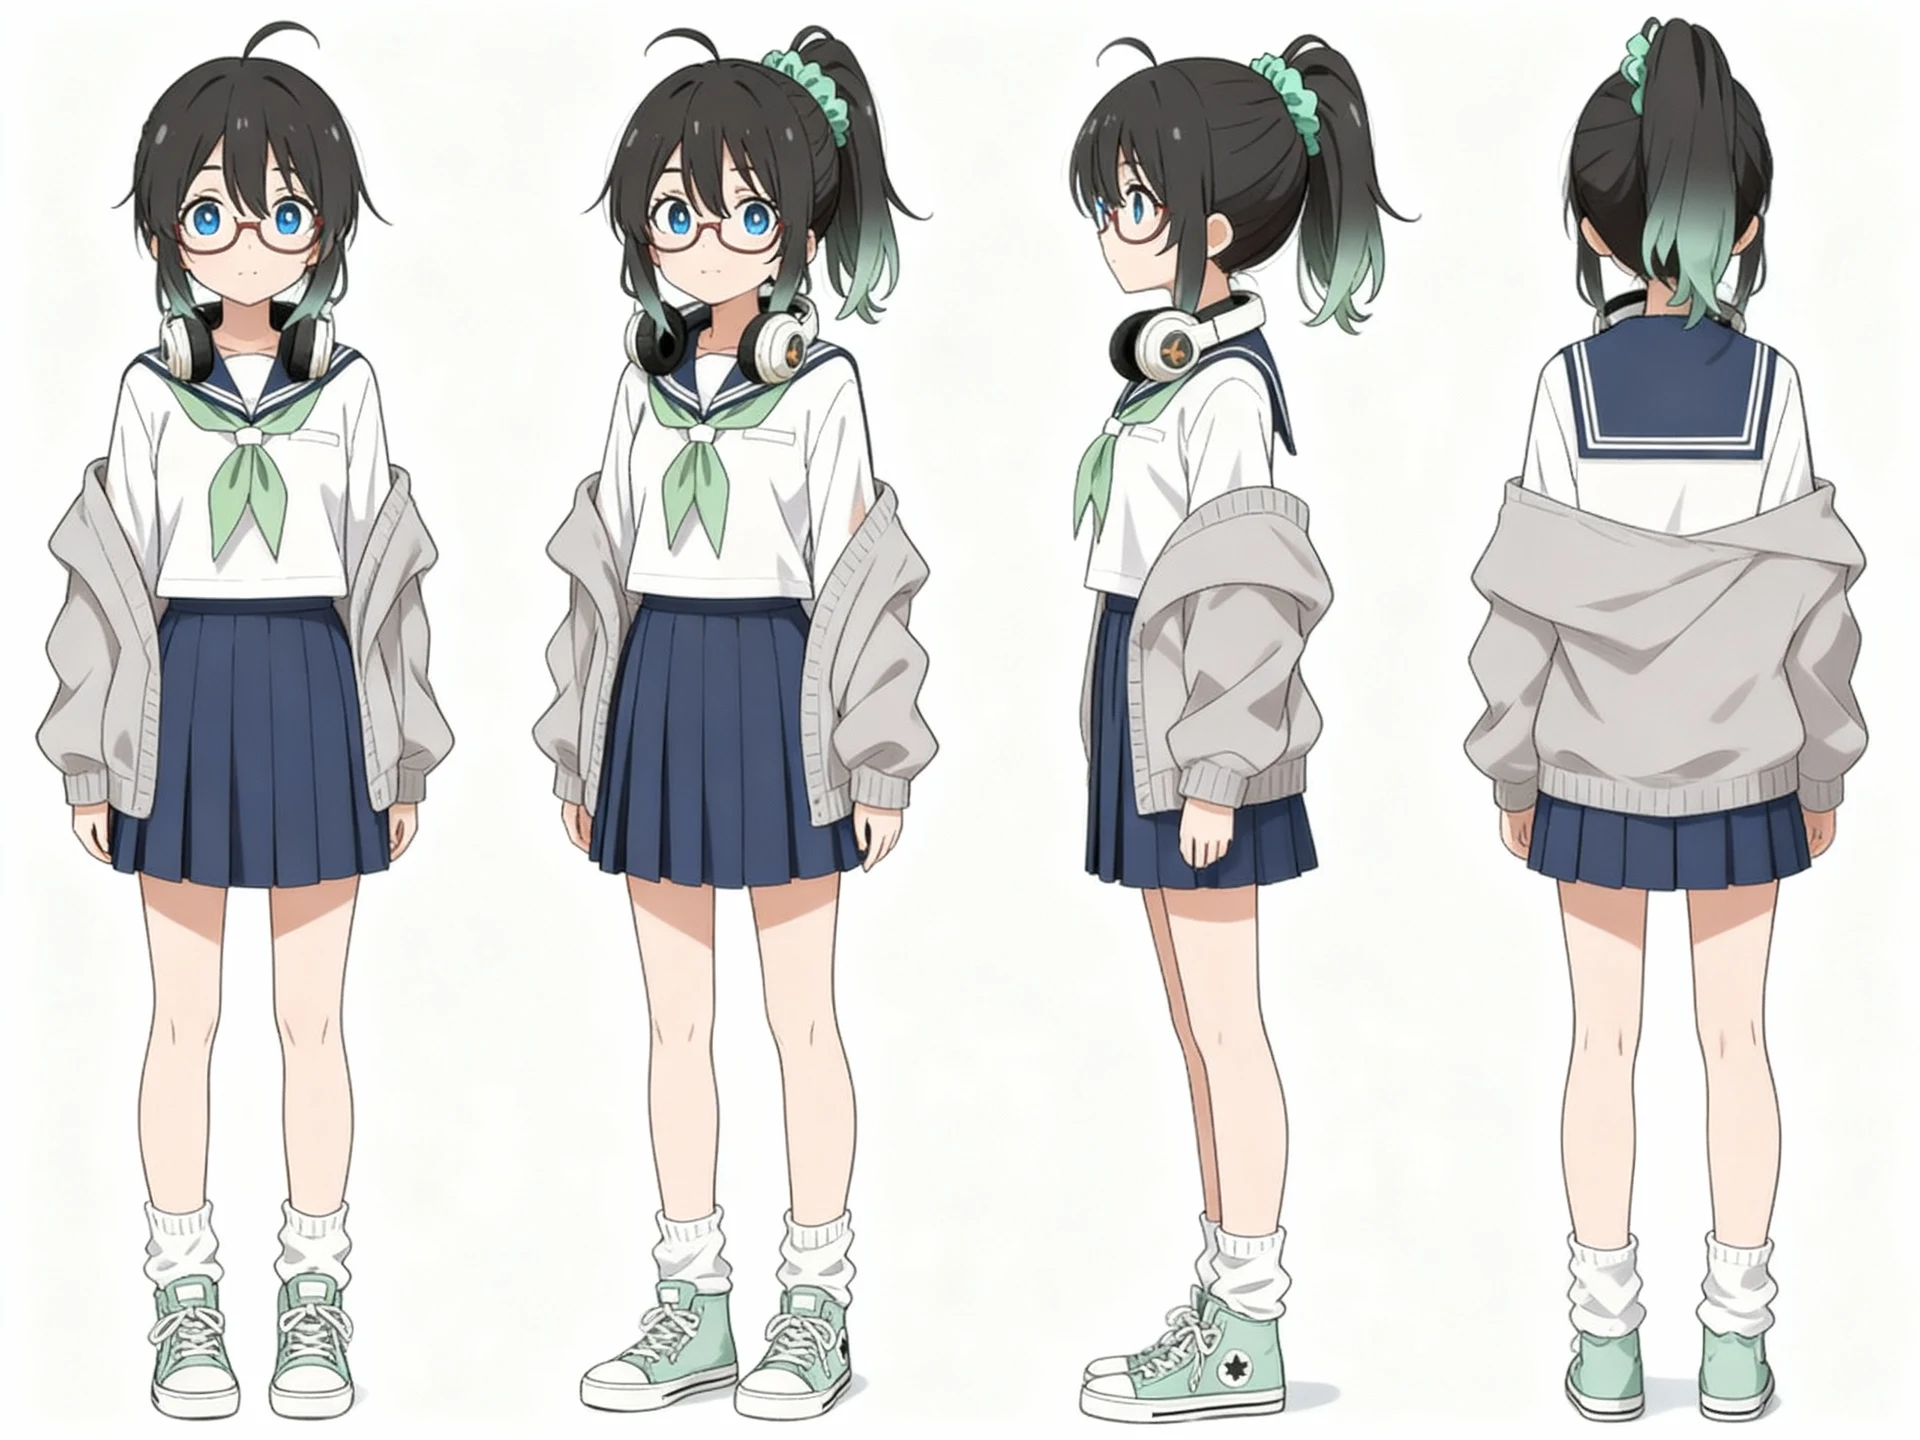
背後がやや整合性が取りきれなかったようですが、NanoBananaよりも自然にできているように感じました。ただ、正面・背後はよいとして、「右から・左から」の指示は守りきれず、斜め45度からの画像になってしまいました。
実験を続けます。
指示「白い背景を、コンビニの前に変更して。女の子は地面に座っている。」(※アスペクト比は横長の4:3を選択)
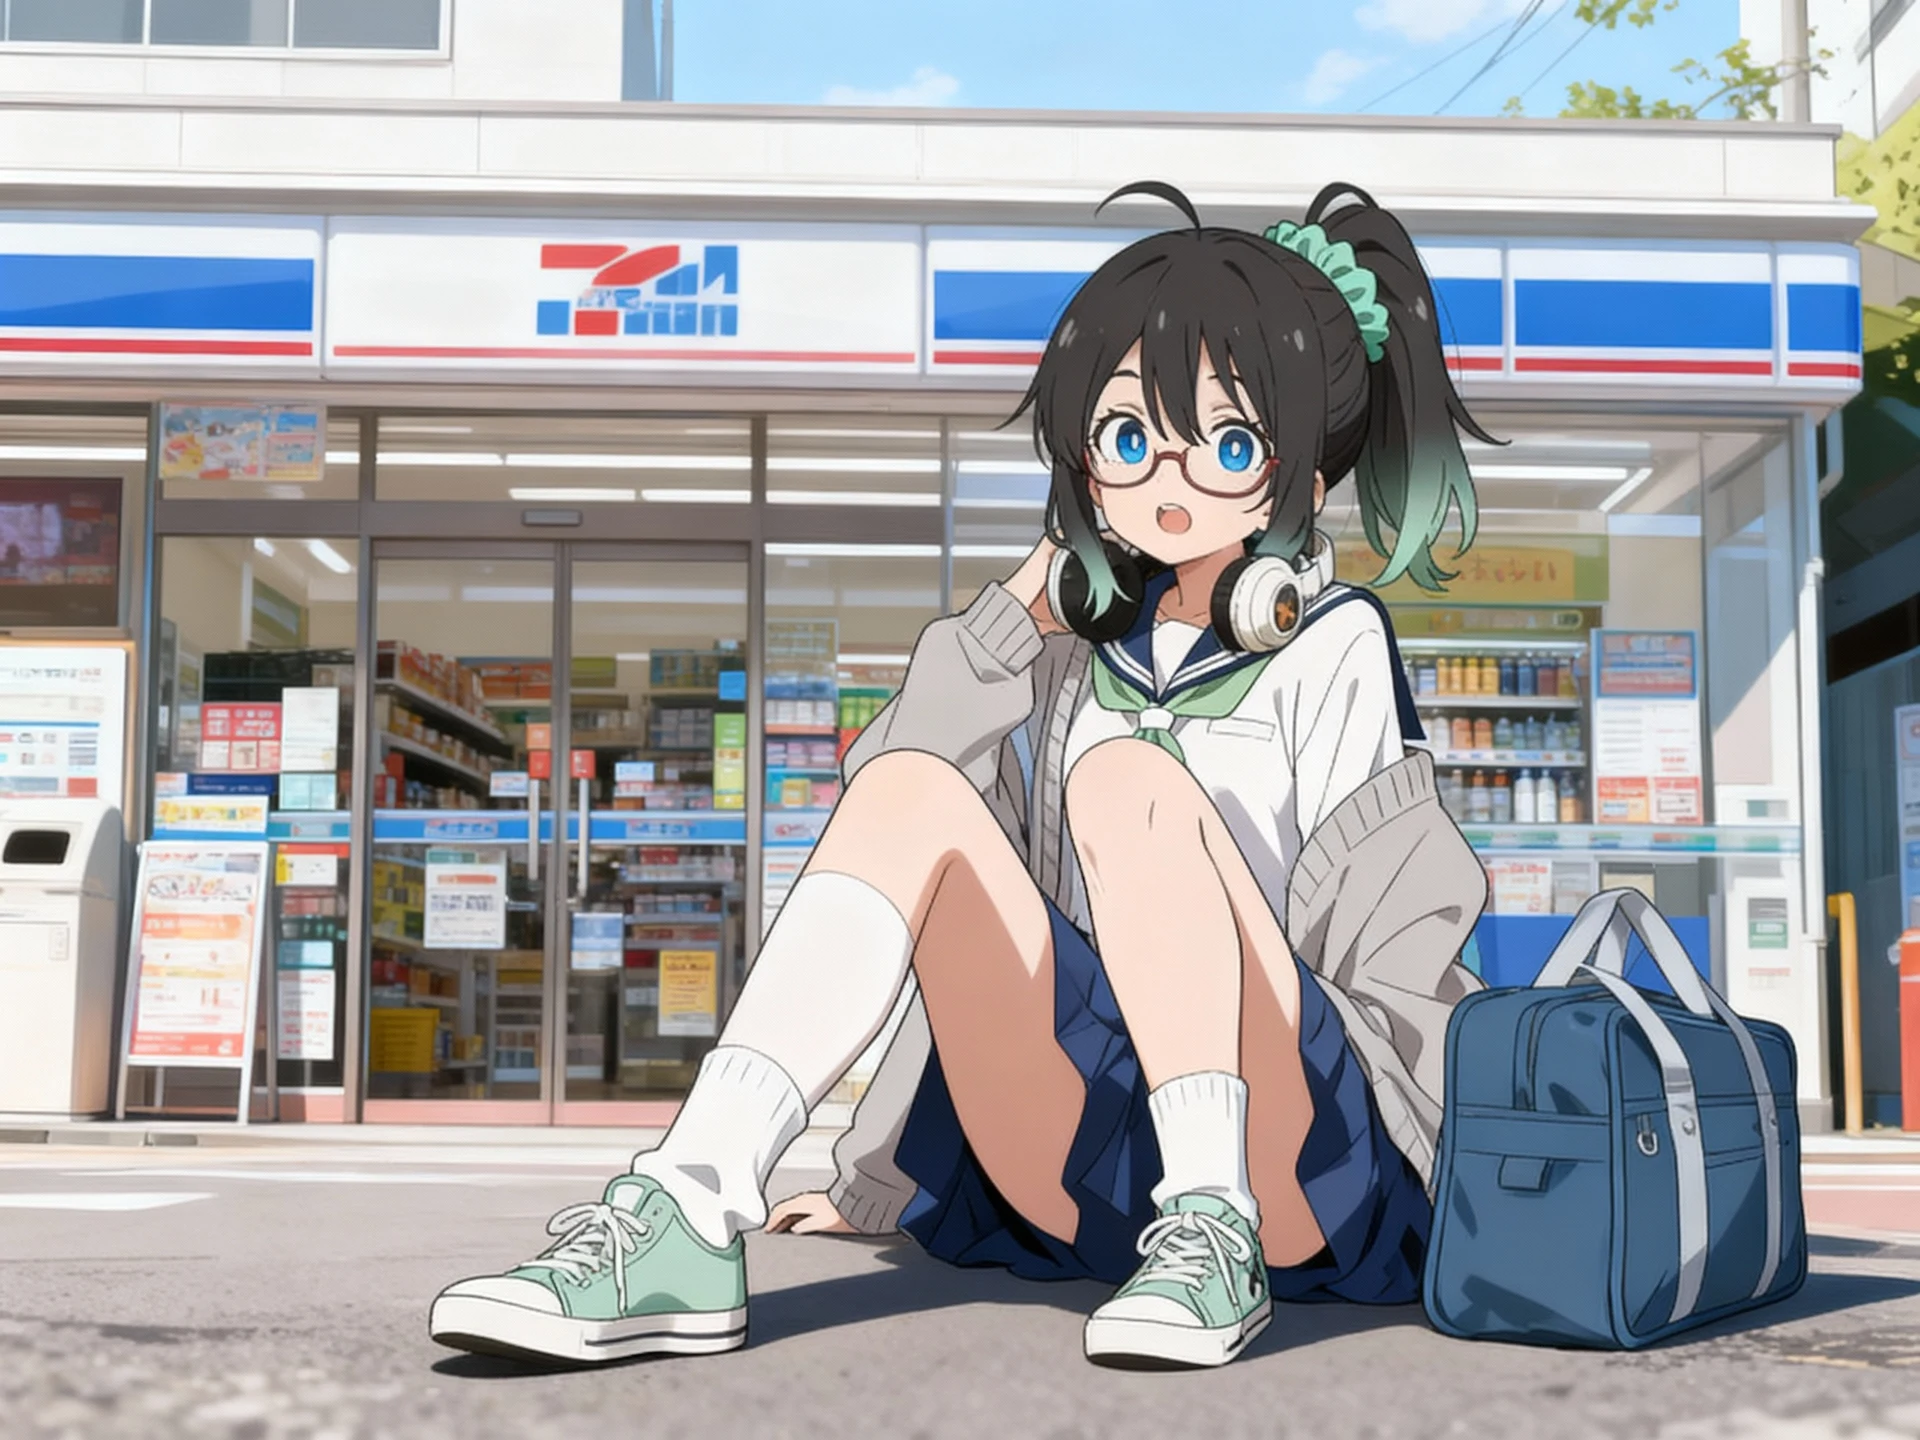
今度は意外な結果となりました。ロ〇ソンとセ〇ンが混じったようなコンビニになってしまうのはまあよくあるとして、読み込ませた画像とポーズがやや変わっています。
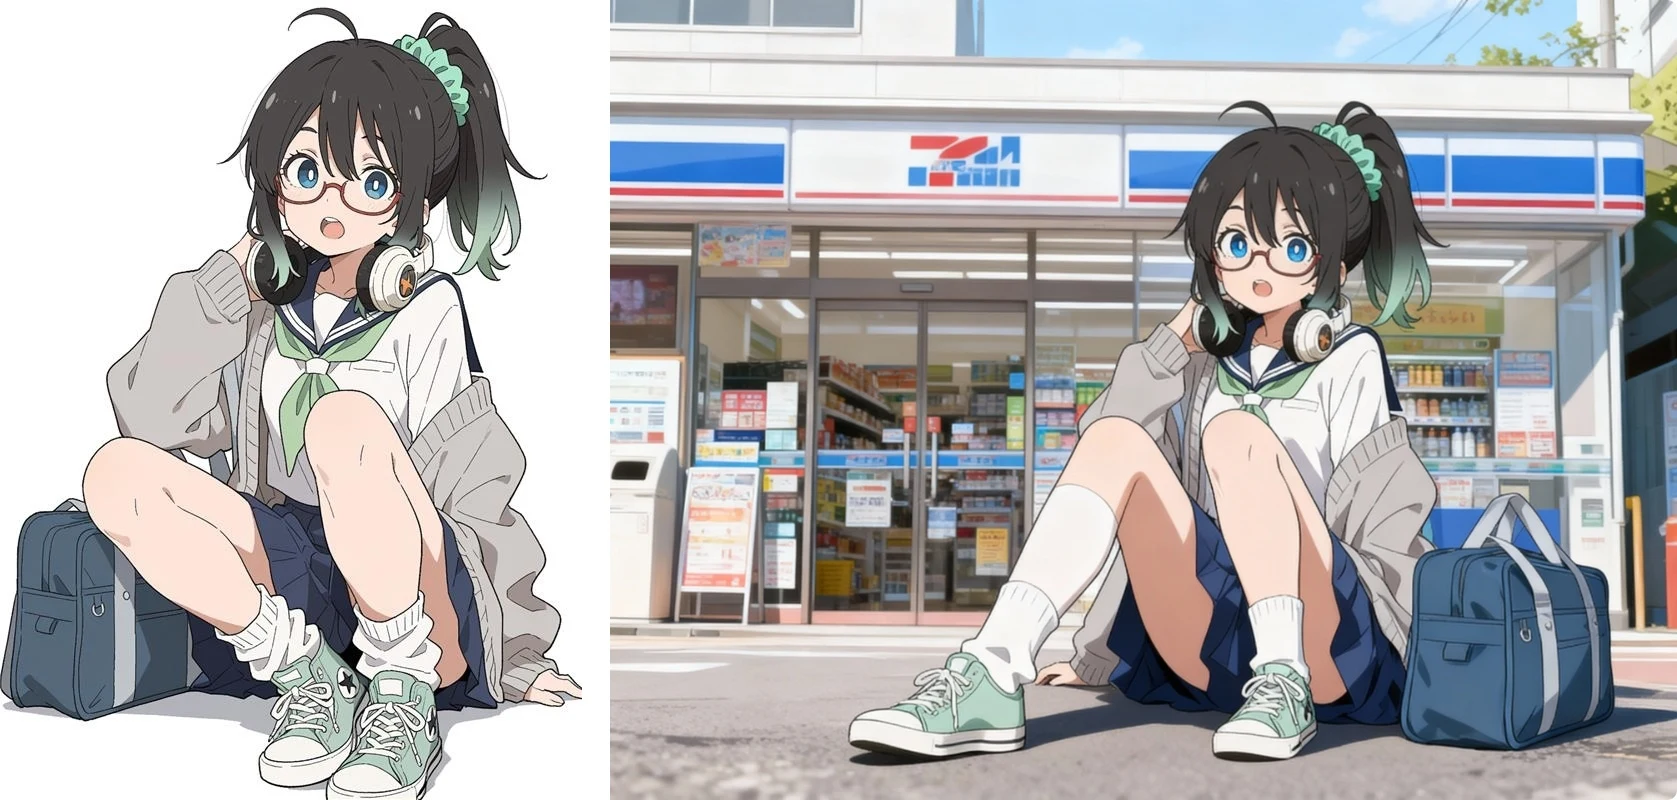
よく見ると、右手が二本になっている破綻も見えます。こうした現象はNanoBananaでは起きにくいので、あくまでここまでの感覚ですが、破綻はややSeedream4.0のほうが多い印象があります。
指示「セブンイレブンはよくない…架空のコンビニにして。」
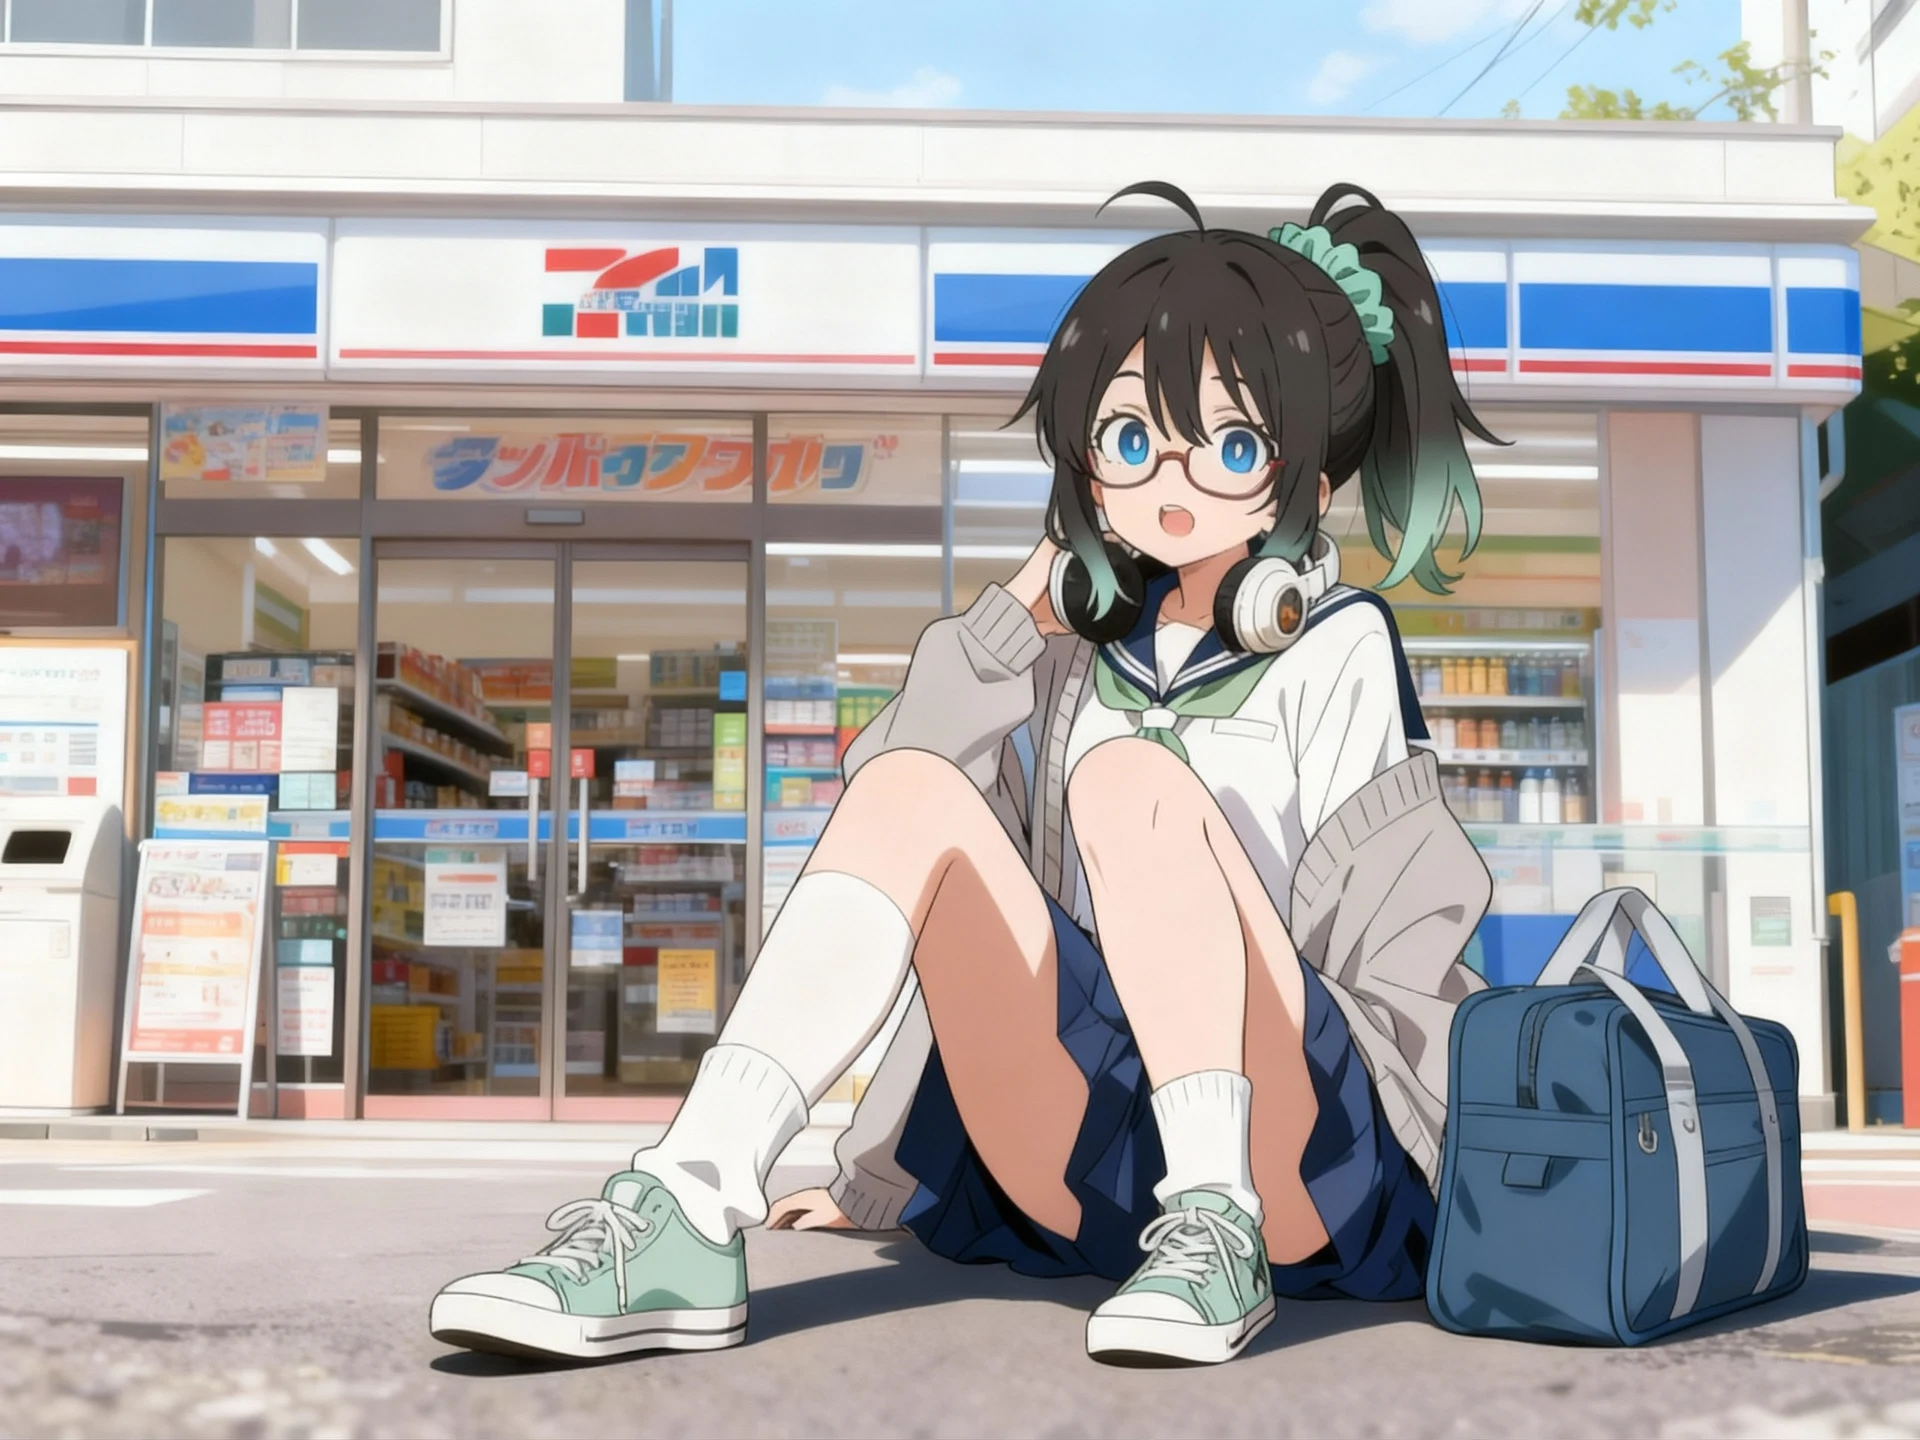
NanoBananaのときと同様のチャット式指示を試してみましたが、予想通りうまくいきませんでした。NanoBanana(Gemini 2.5 Flash Image)はチャット形式の対話ができ、かなり空気を読んだ生成ができますが、Seedream4.0に以前のやりとりを前提としたような頼み方をしてもなかなかうまくいかないのかなと思います。
検証2.ストーリーボード作成
順番から行けば、次は「この女の子の普段の日常を、計7枚のビジュアルストーリーにして。」という指示を試す段なのですが、チャット形式で生成指示できるGeminiと違って連作はSeedream4.0にはできない注文です。そこで、以下のようにミナちゃんのイラストを3種類読み込ませた上で、このようなプロンプトで「日常を描いたビジュアルストーリー」を4枚同時生成してみました。
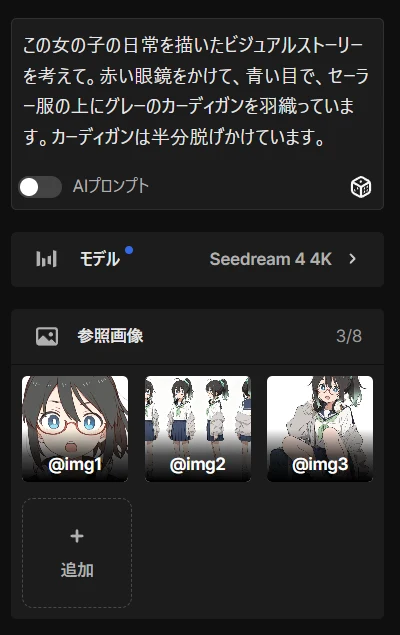
指示「この女の子の日常を描いたビジュアルストーリーを考えて。赤い眼鏡をかけて、青い目で、セーラー服の上にグレーのカーディガンを羽織っています。カーディガンは半分脱げかけています」
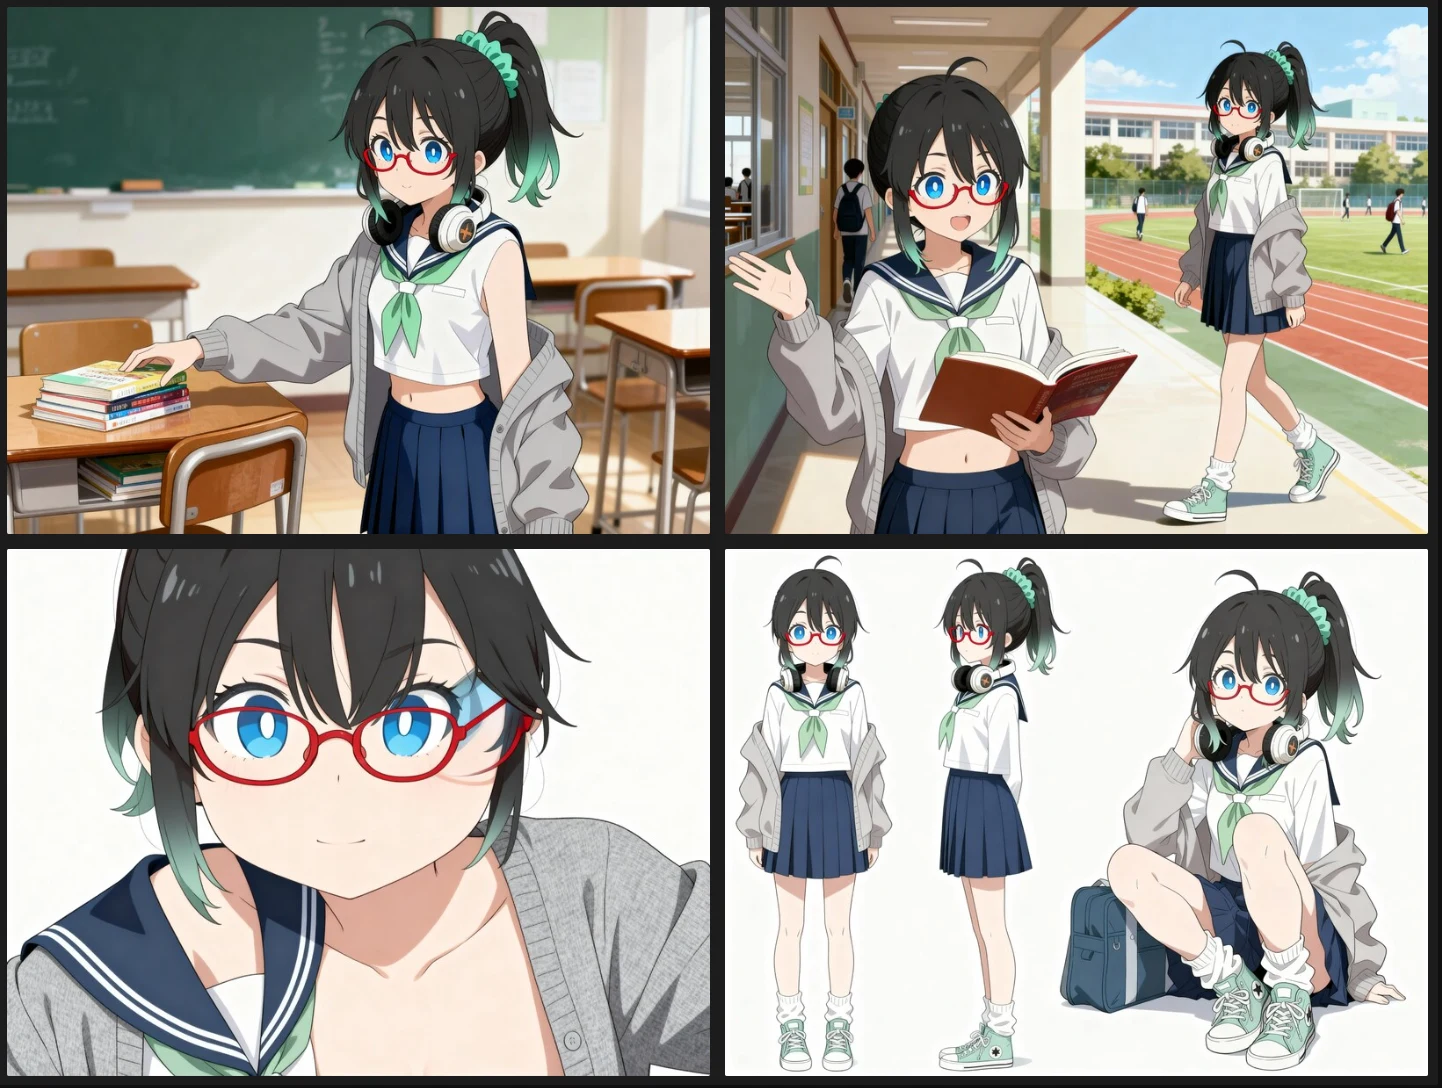
残念ながら破綻が見えてしまいました。どうも、入力した画像のうちの4面図に印象がひっぱられて「1画面に4人ミナちゃんを描かなくてはならない」と誤解してしまったように見えます。NanoBananaでは四面図の入力が効果的だったのですが、Seedream4.0はsoloで映っている画像を複数用意したほうが良いようです。そこで、このように1人だけで映っている入力画像に変えてみました。
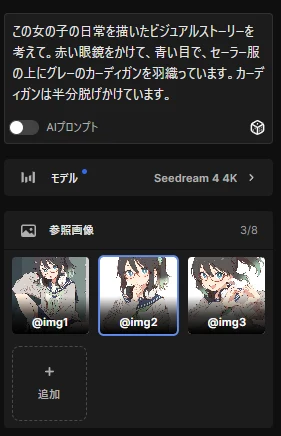
今度はこのような感じ。「半分脱げかけている」が悪い印象になり、へそ出し制服になってしまったようです。なかなか難しい。
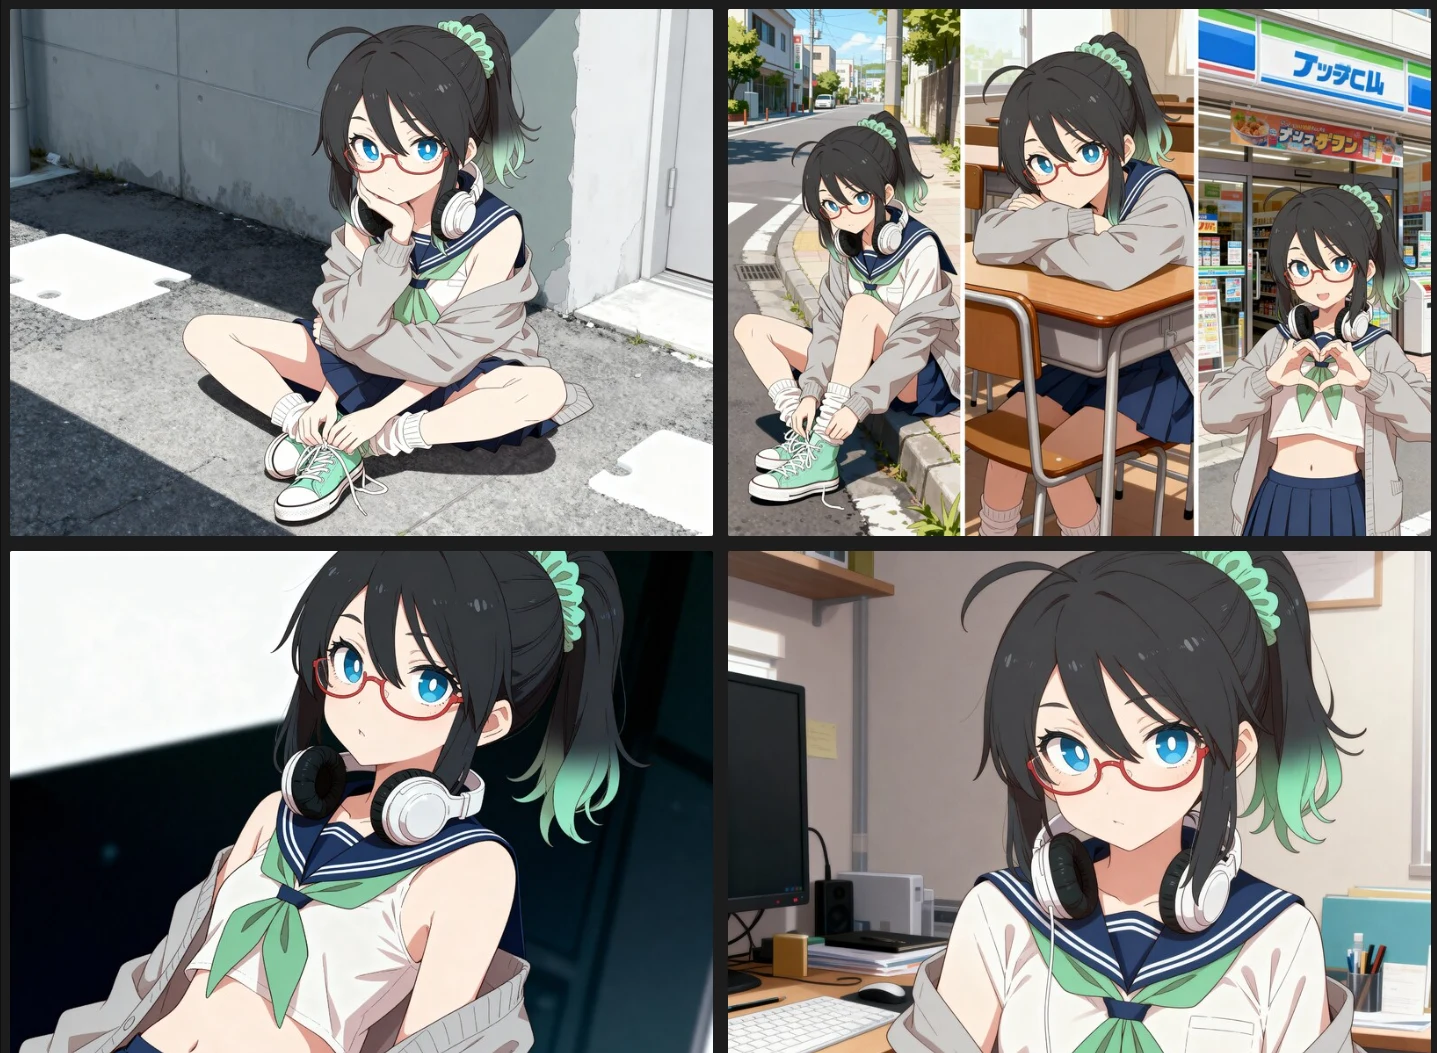
指示「この女の子の日常を描いたビジュアルストーリーを考えて。赤い眼鏡をかけて、青い目で、セーラー服の上にグレーのカーディガンを羽織っています。」
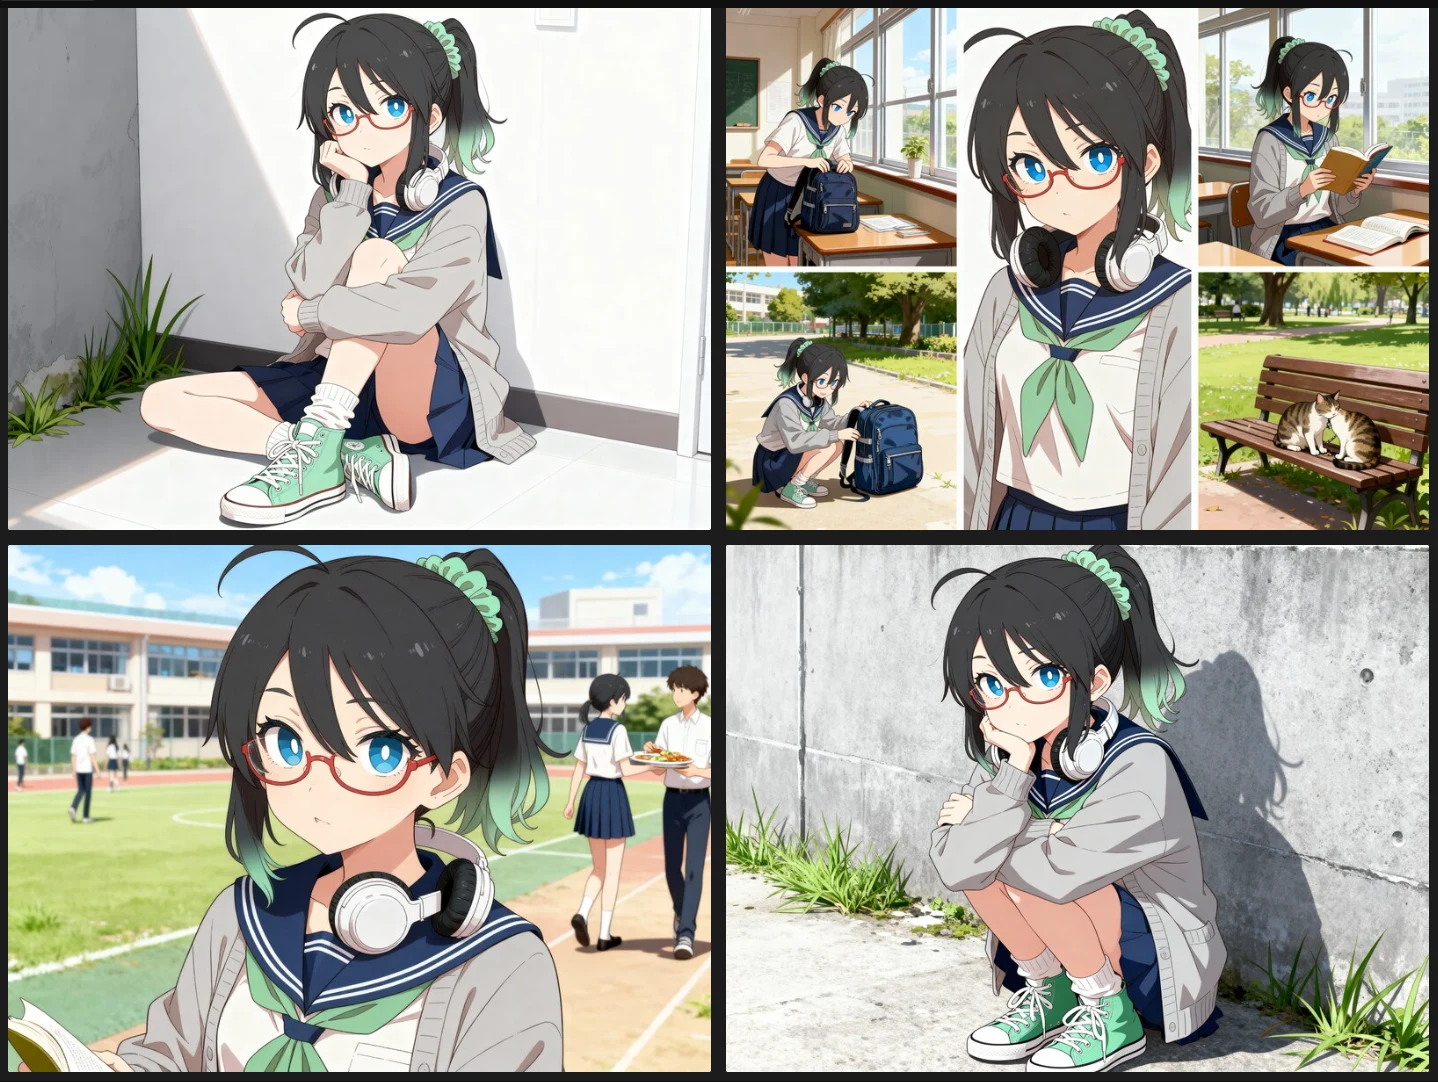
いろいろと調整するとこのようになりました。ヘッドホンに破綻が見えたり、眼鏡が外れたりしていますが、おおむね意図した「同キャラ別カット」が生成できたように見えます。
背景はやや実写調ではありますが、イラストとも調和しており、NanoBananaとはまた違った感じで悪くないですね。ただ、NanoBananaのように曖昧な指示で上手な生成ができないように見えますので、ユーザーができるだけ具体的に、どういうシーンにしてほしいか考えて指示したほうが良い結果になりそうです。
検証3.イラストの線画抽出
ここまではキャラクターを指示しての変容でしたので、今度は画像の線画を維持してのスタイルチェンジを試していきます。入力画像は始めと同じミナちゃんの画像です。
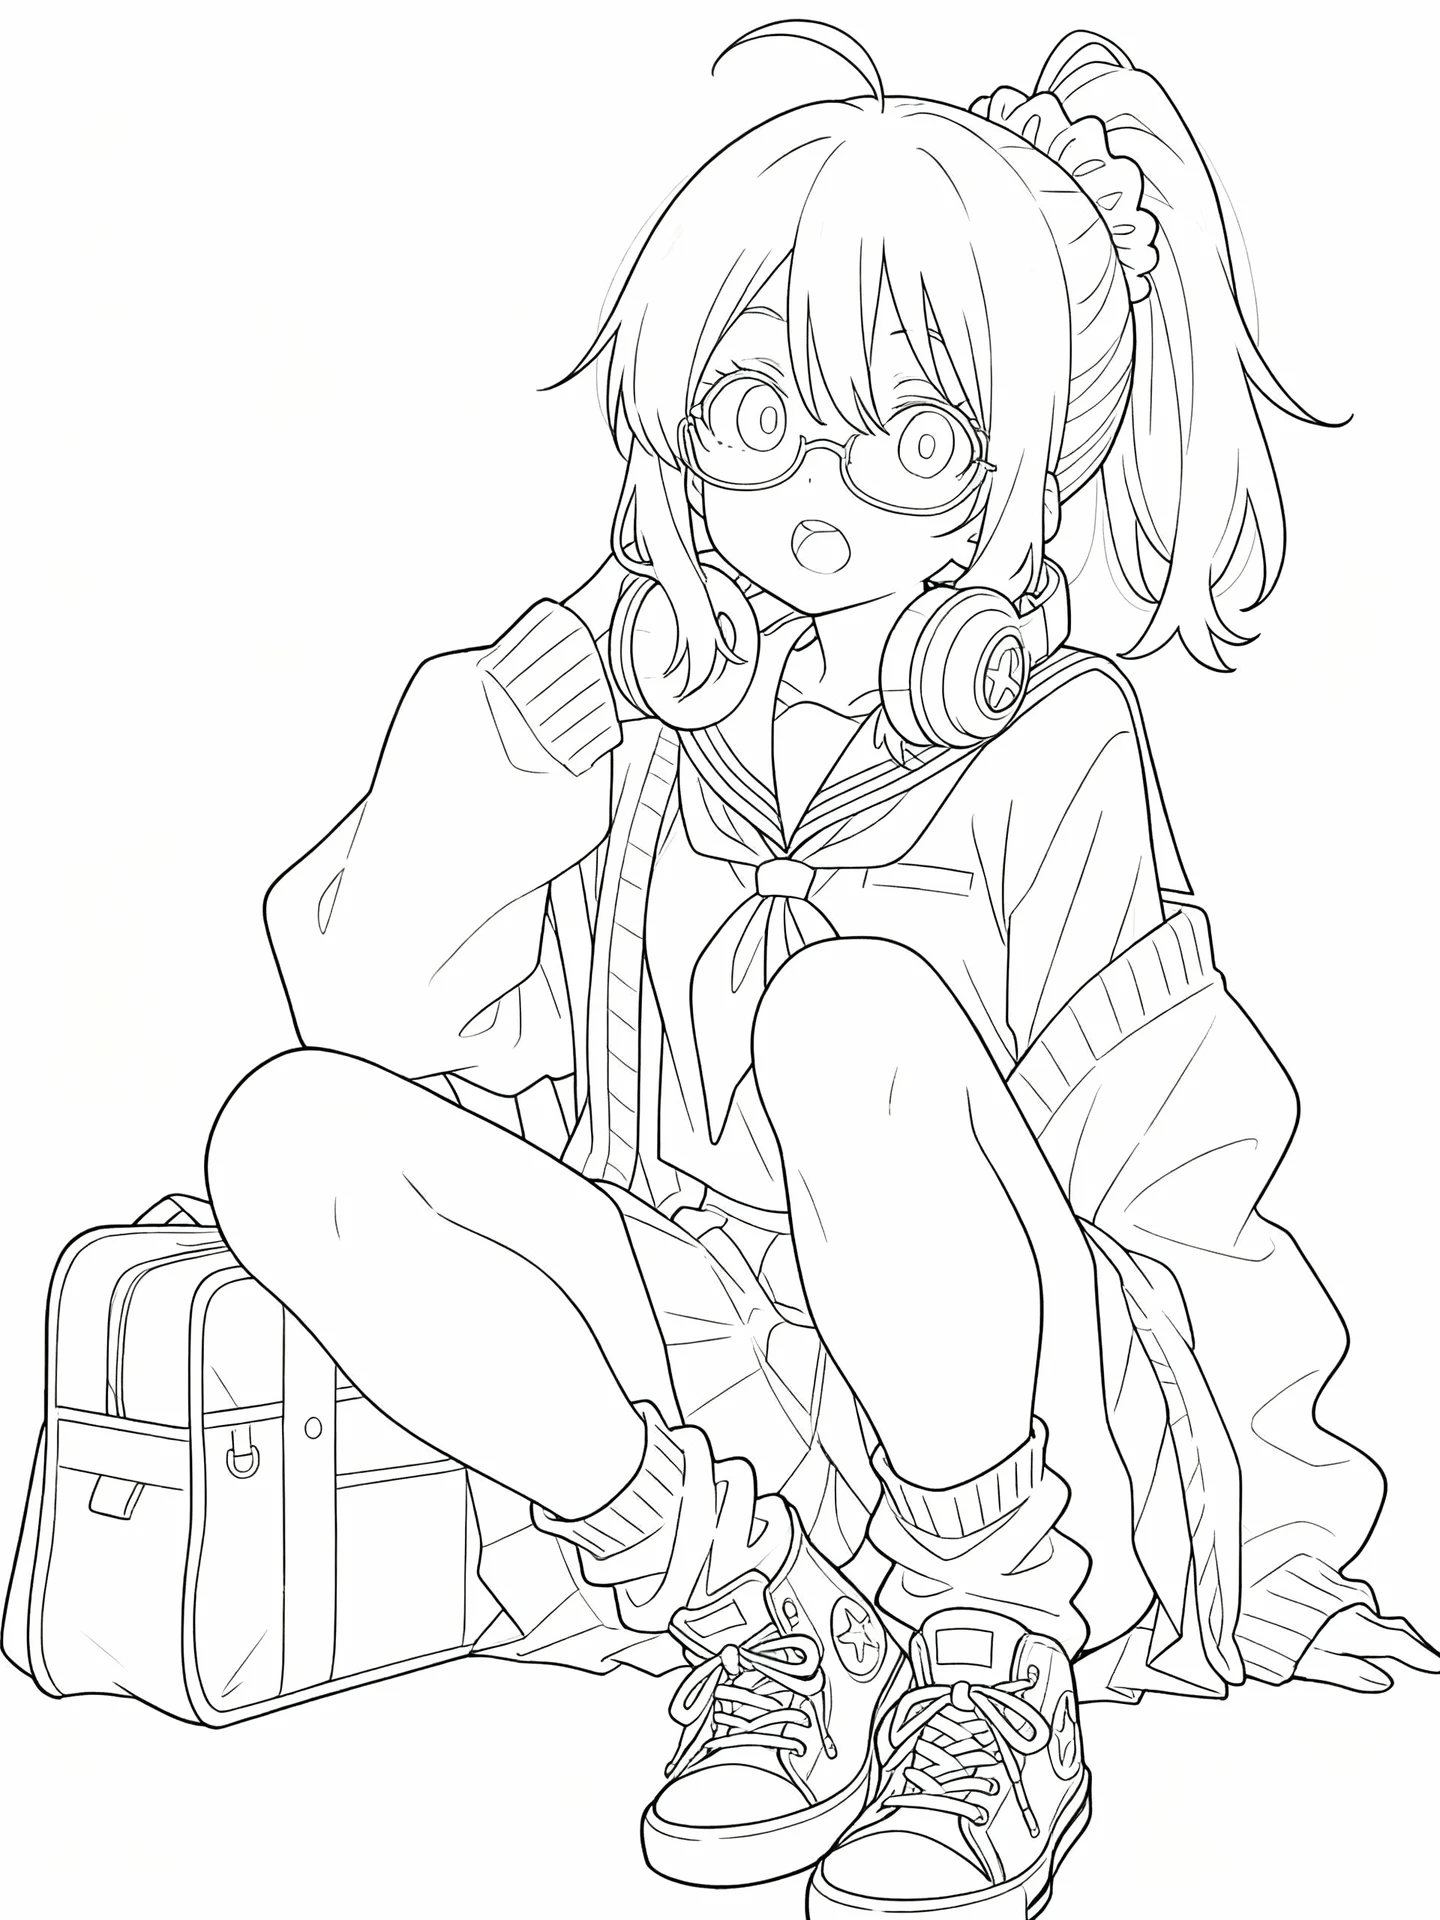
指示「線画にして」(縦長3:4)
検証4.線画の着色
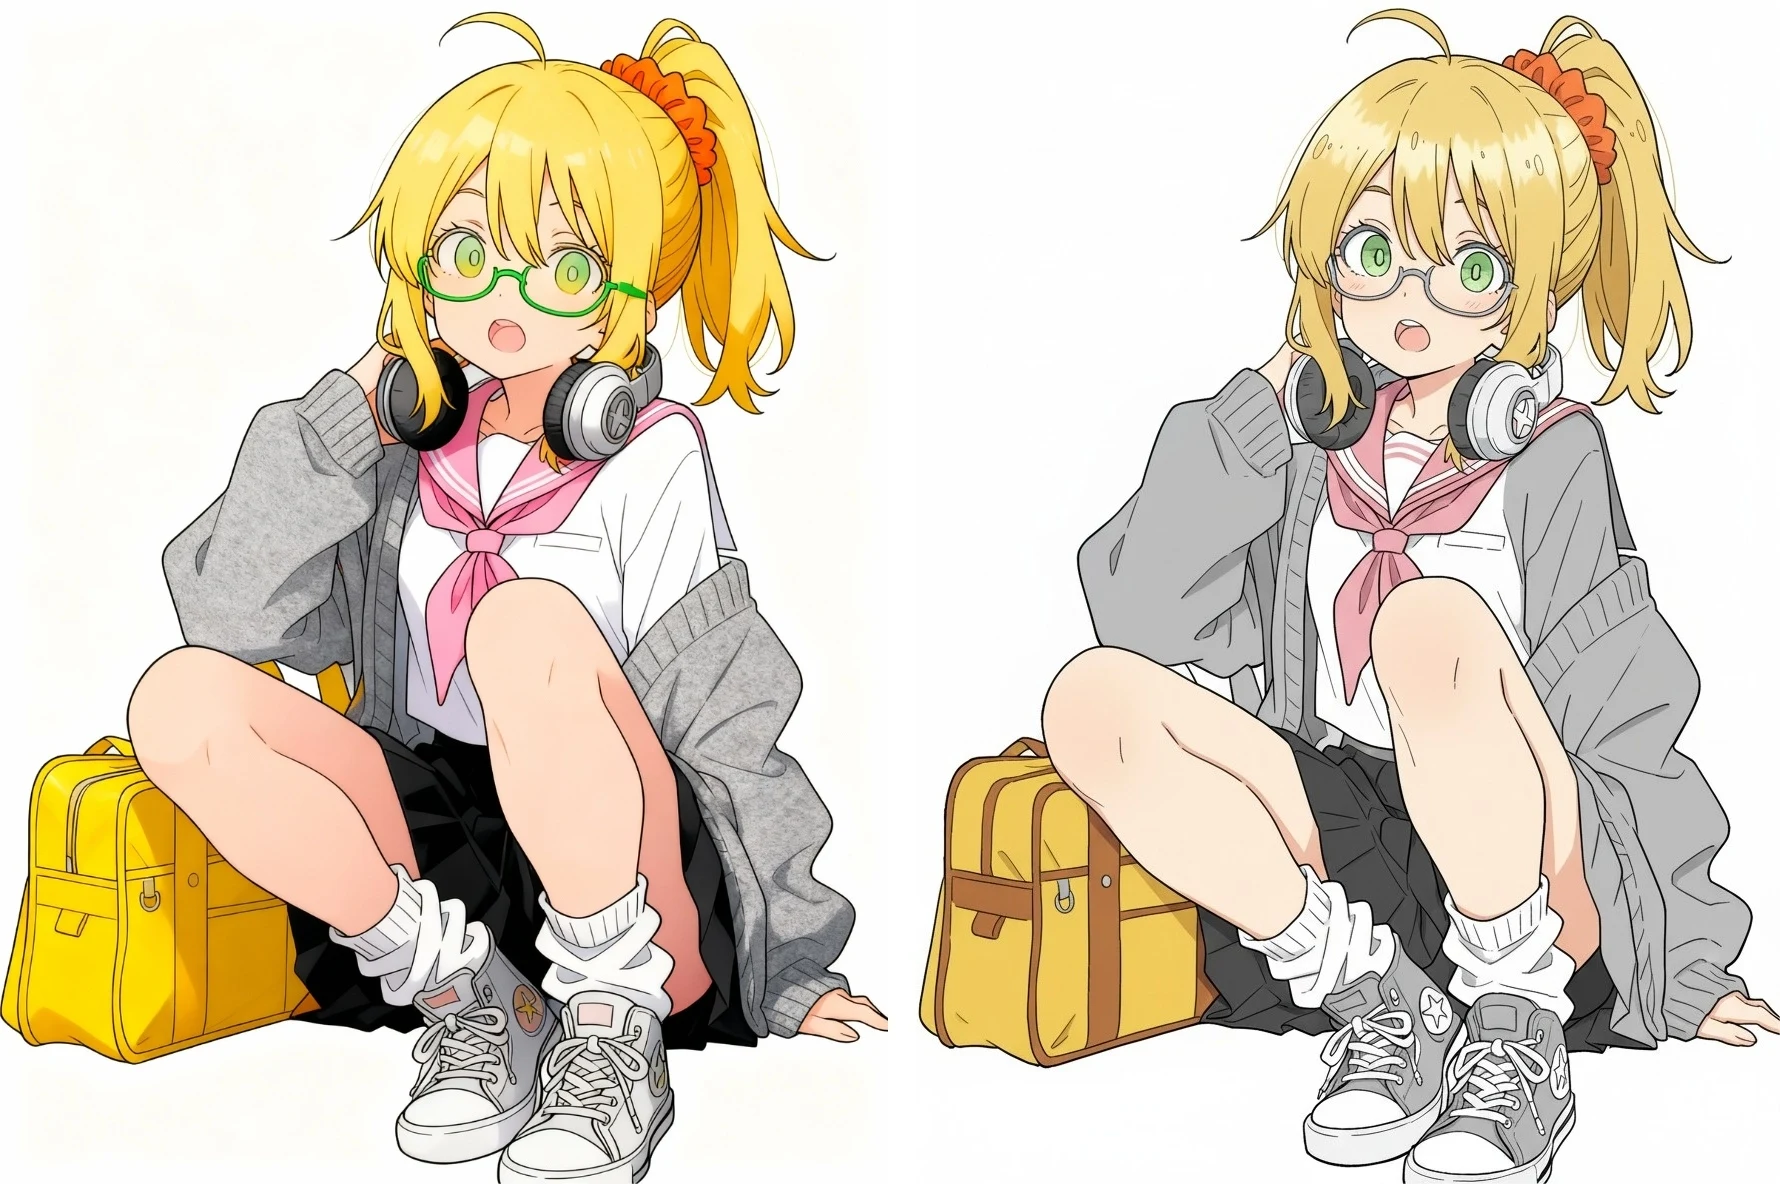
指示「この線画を着色して。背景は白、セーラー服は白、襟はピンクで眼鏡は緑、髪の毛は金髪。スカートは黒。バッグは黄色。髪留めはオレンジ。セーターはグレー」(縦長3:4)
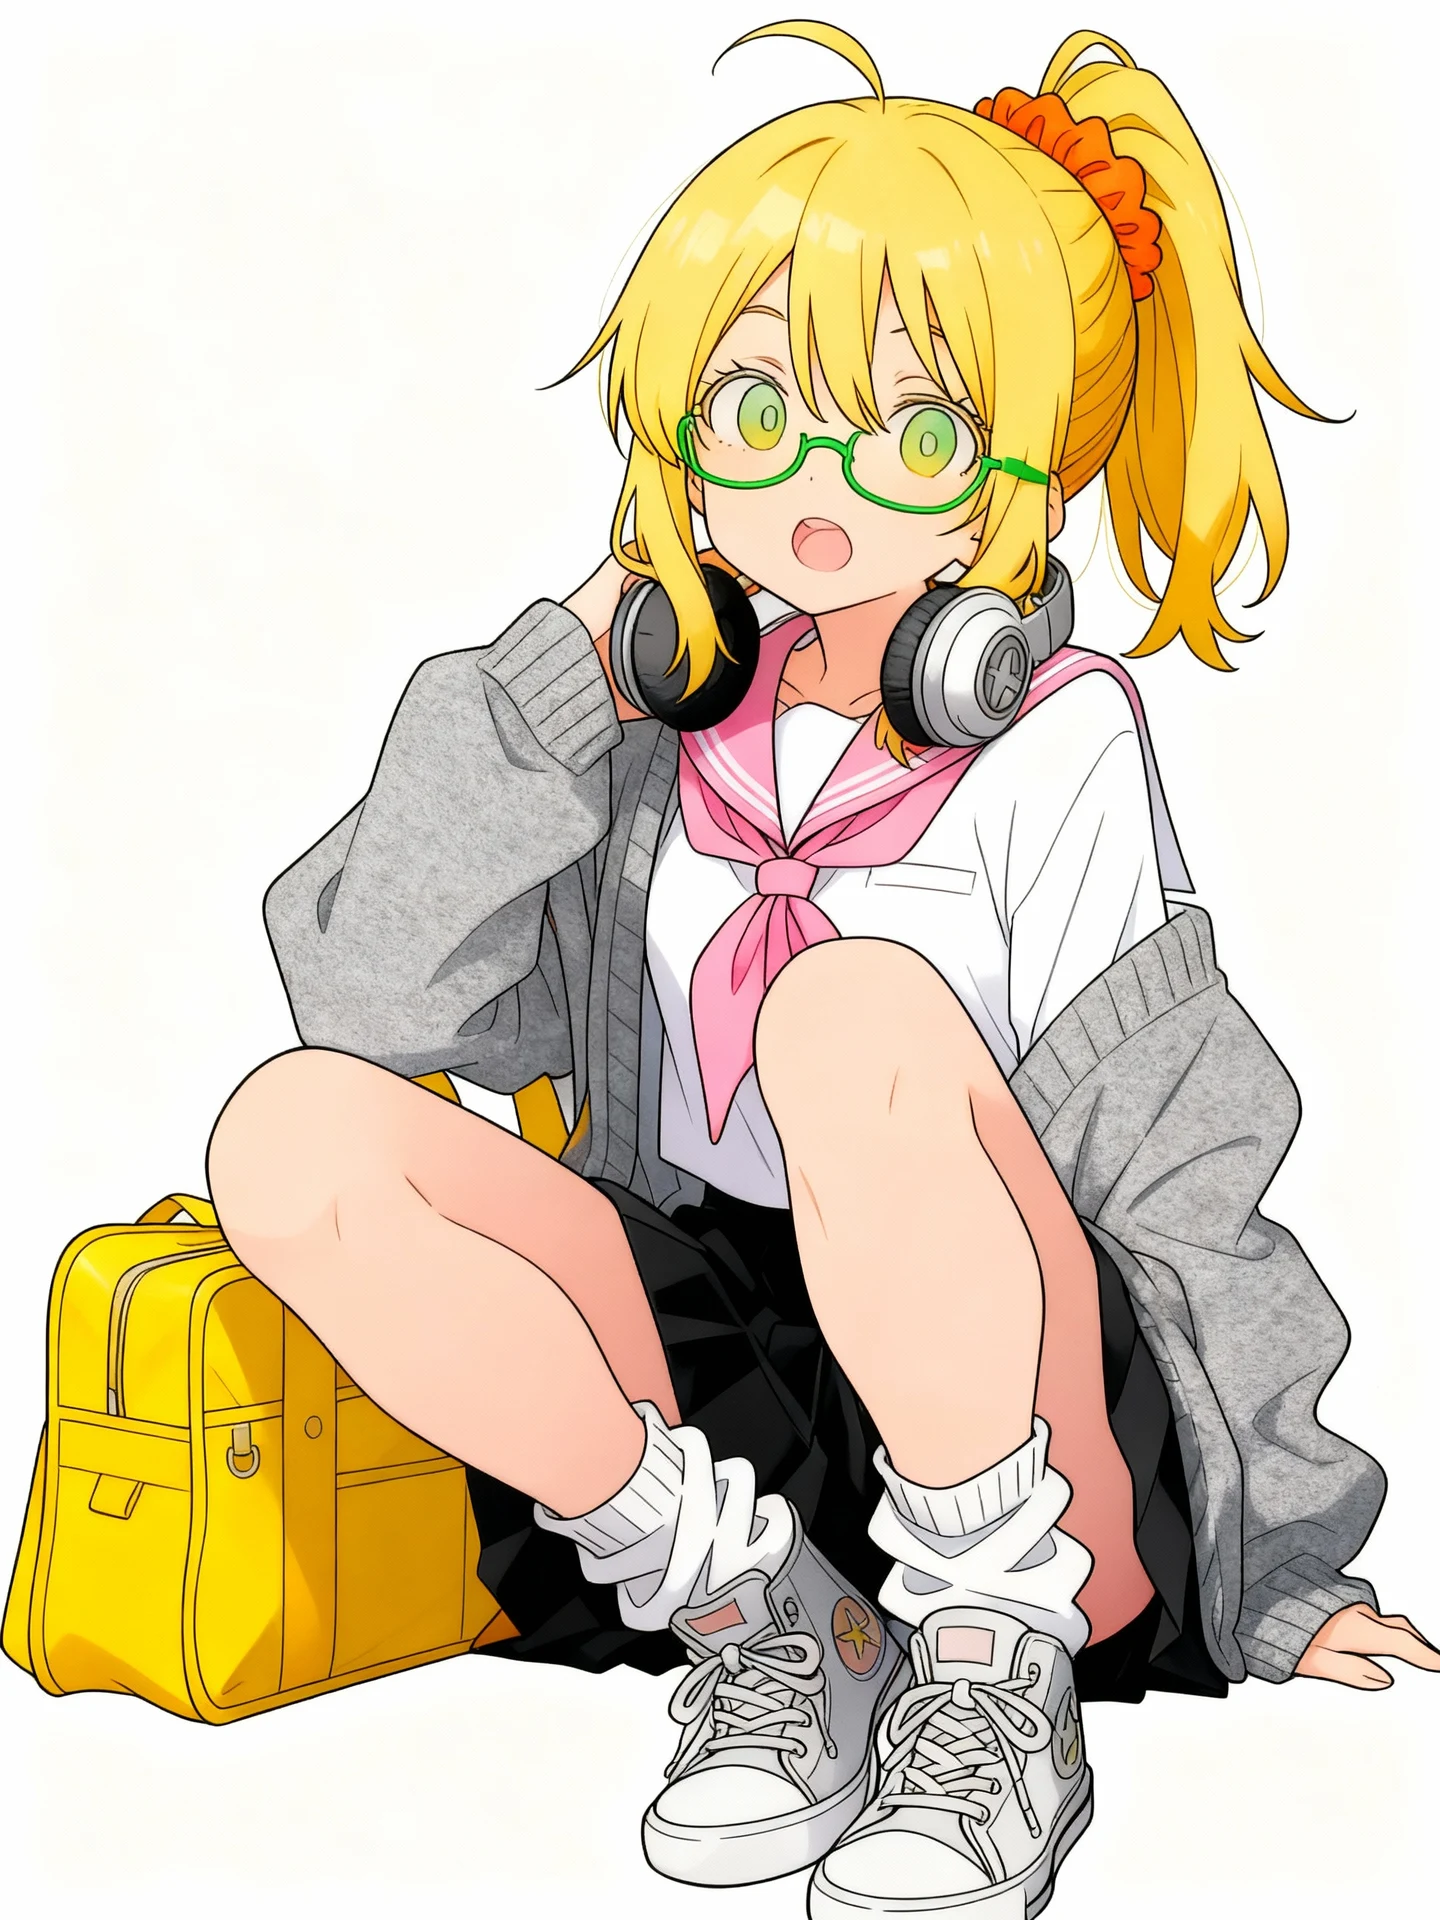
正確な塗り分けができました。左がSeedream4.0、右が以前生成したNanoBanana製です。
NanoBananaでも試したこちらの線画着色では・・・
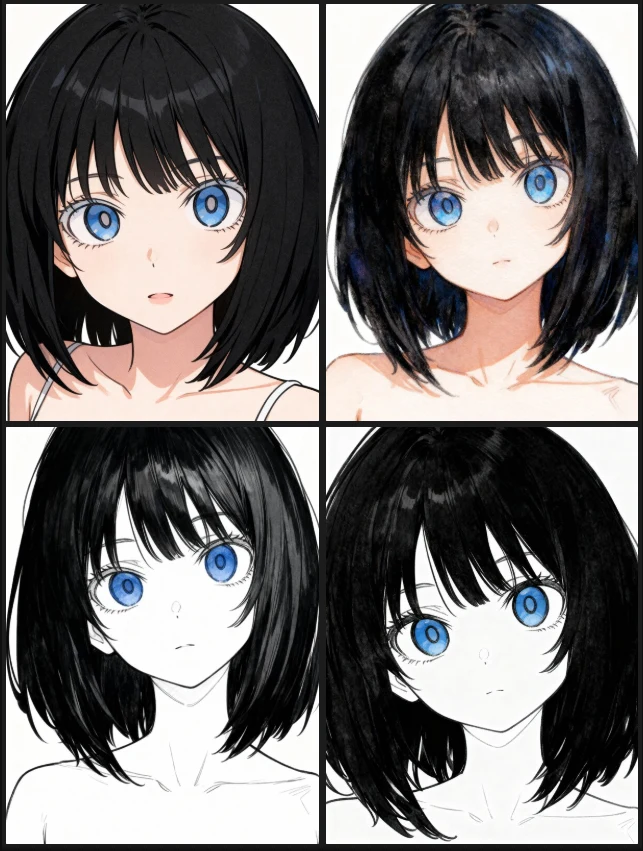
肌なども空気を読んで描画したNanoBananaと違い、指示したところのみが手描き風に着色されがちでした。また、どう塗るかも生成ごとに変わり、左上は線画を勝手に動かしてしまっています。Seedream4.0はあまり空気を読もうとはせず、言われなかったことはしない・・・という挙動が強いように思いますので、もう少し詳しくプロンプト指示します。
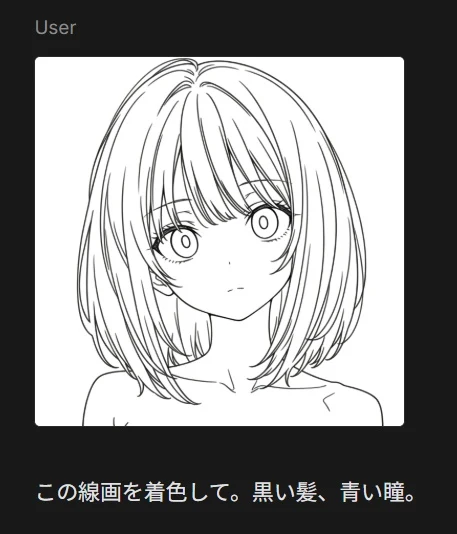
指示「この線画を美しいアニメ調に着色して。黒い髪、青い瞳。線画部分は動かさないでください。背景は白。」
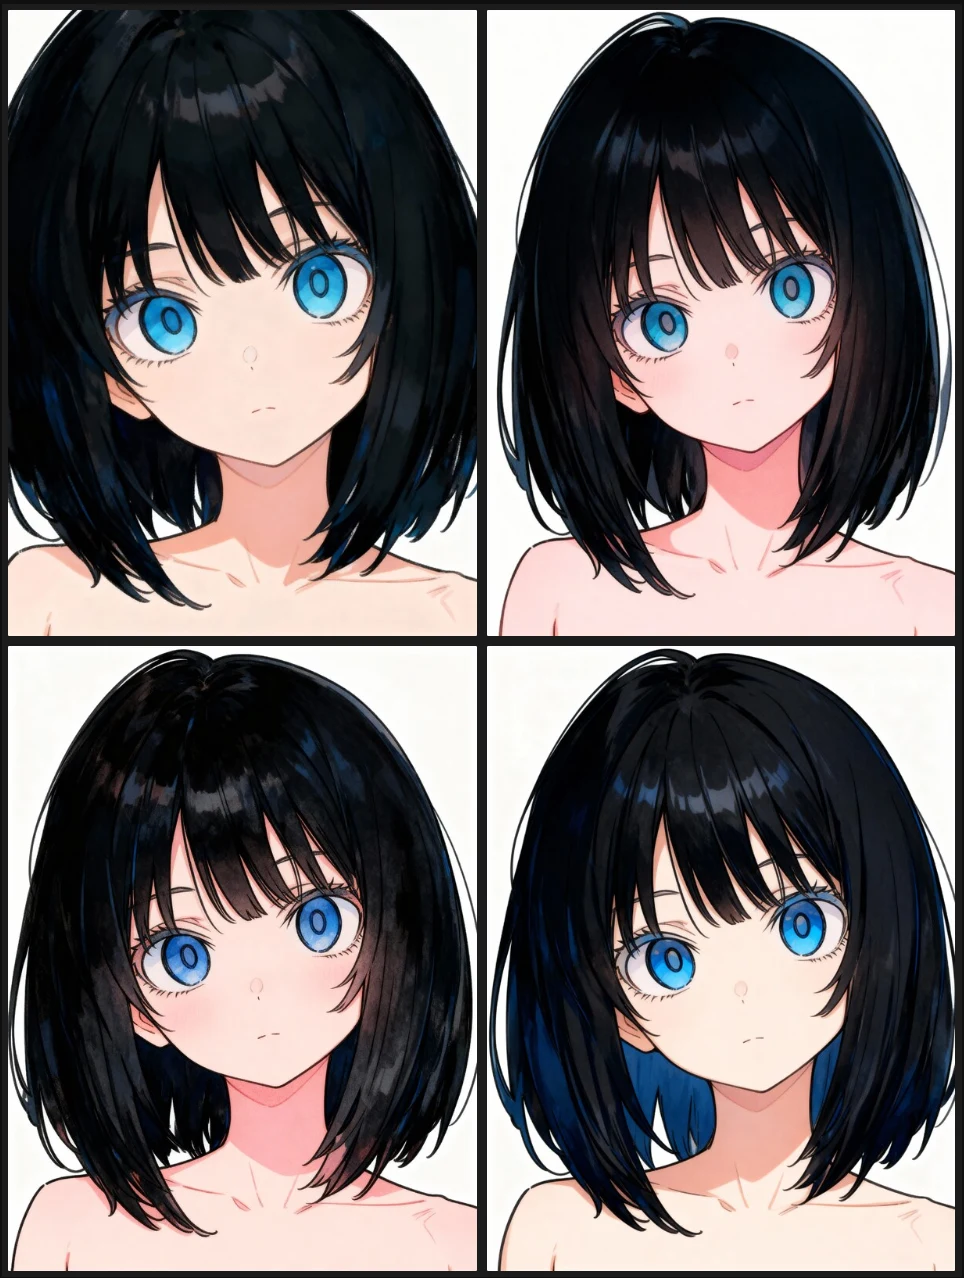
すると、比較的安定しました。ただ、アニメ調というよりかなりアナログ風の塗りに見えますし、左上はアップにしてしまっていますね。このあたりの安定性はNanoBananaの方が上かもしれません。
検証5.ラフの線画化
続いて、ラフの線画化を試します。
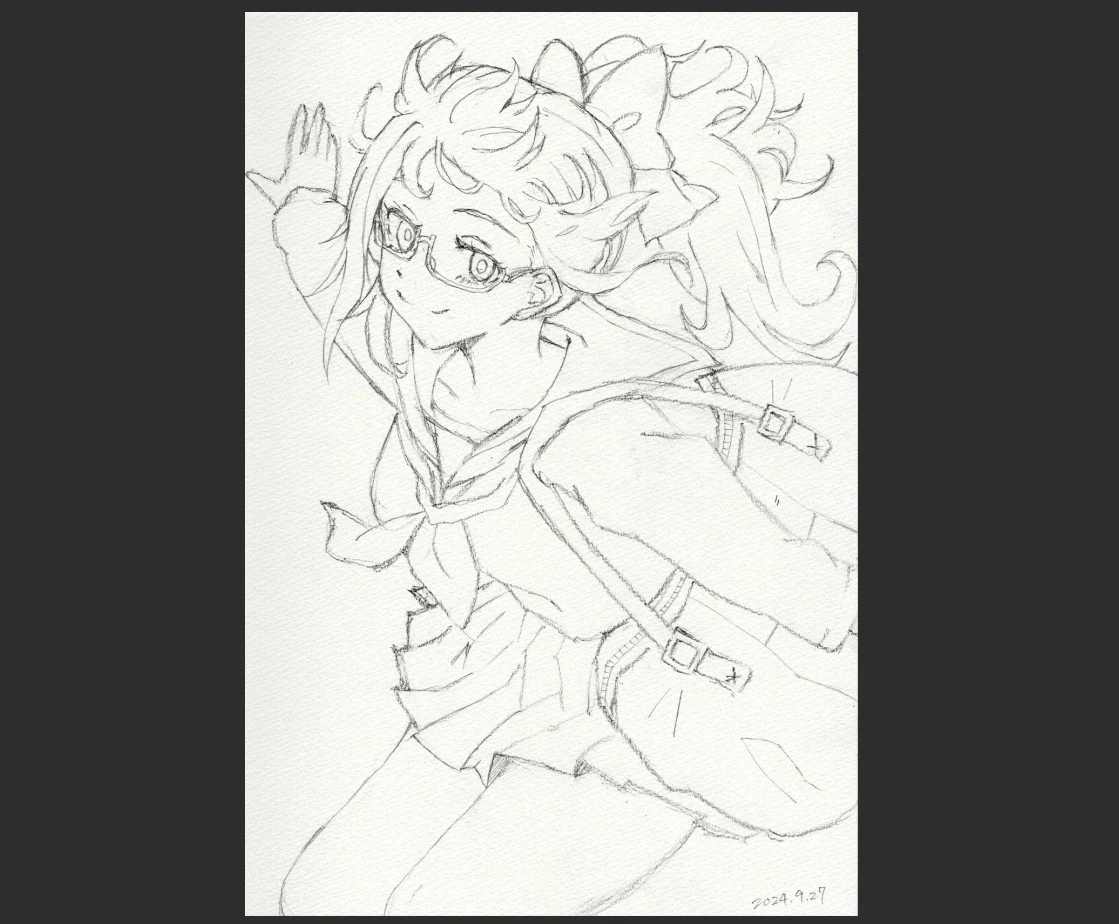
指示「このラフを線画化して」
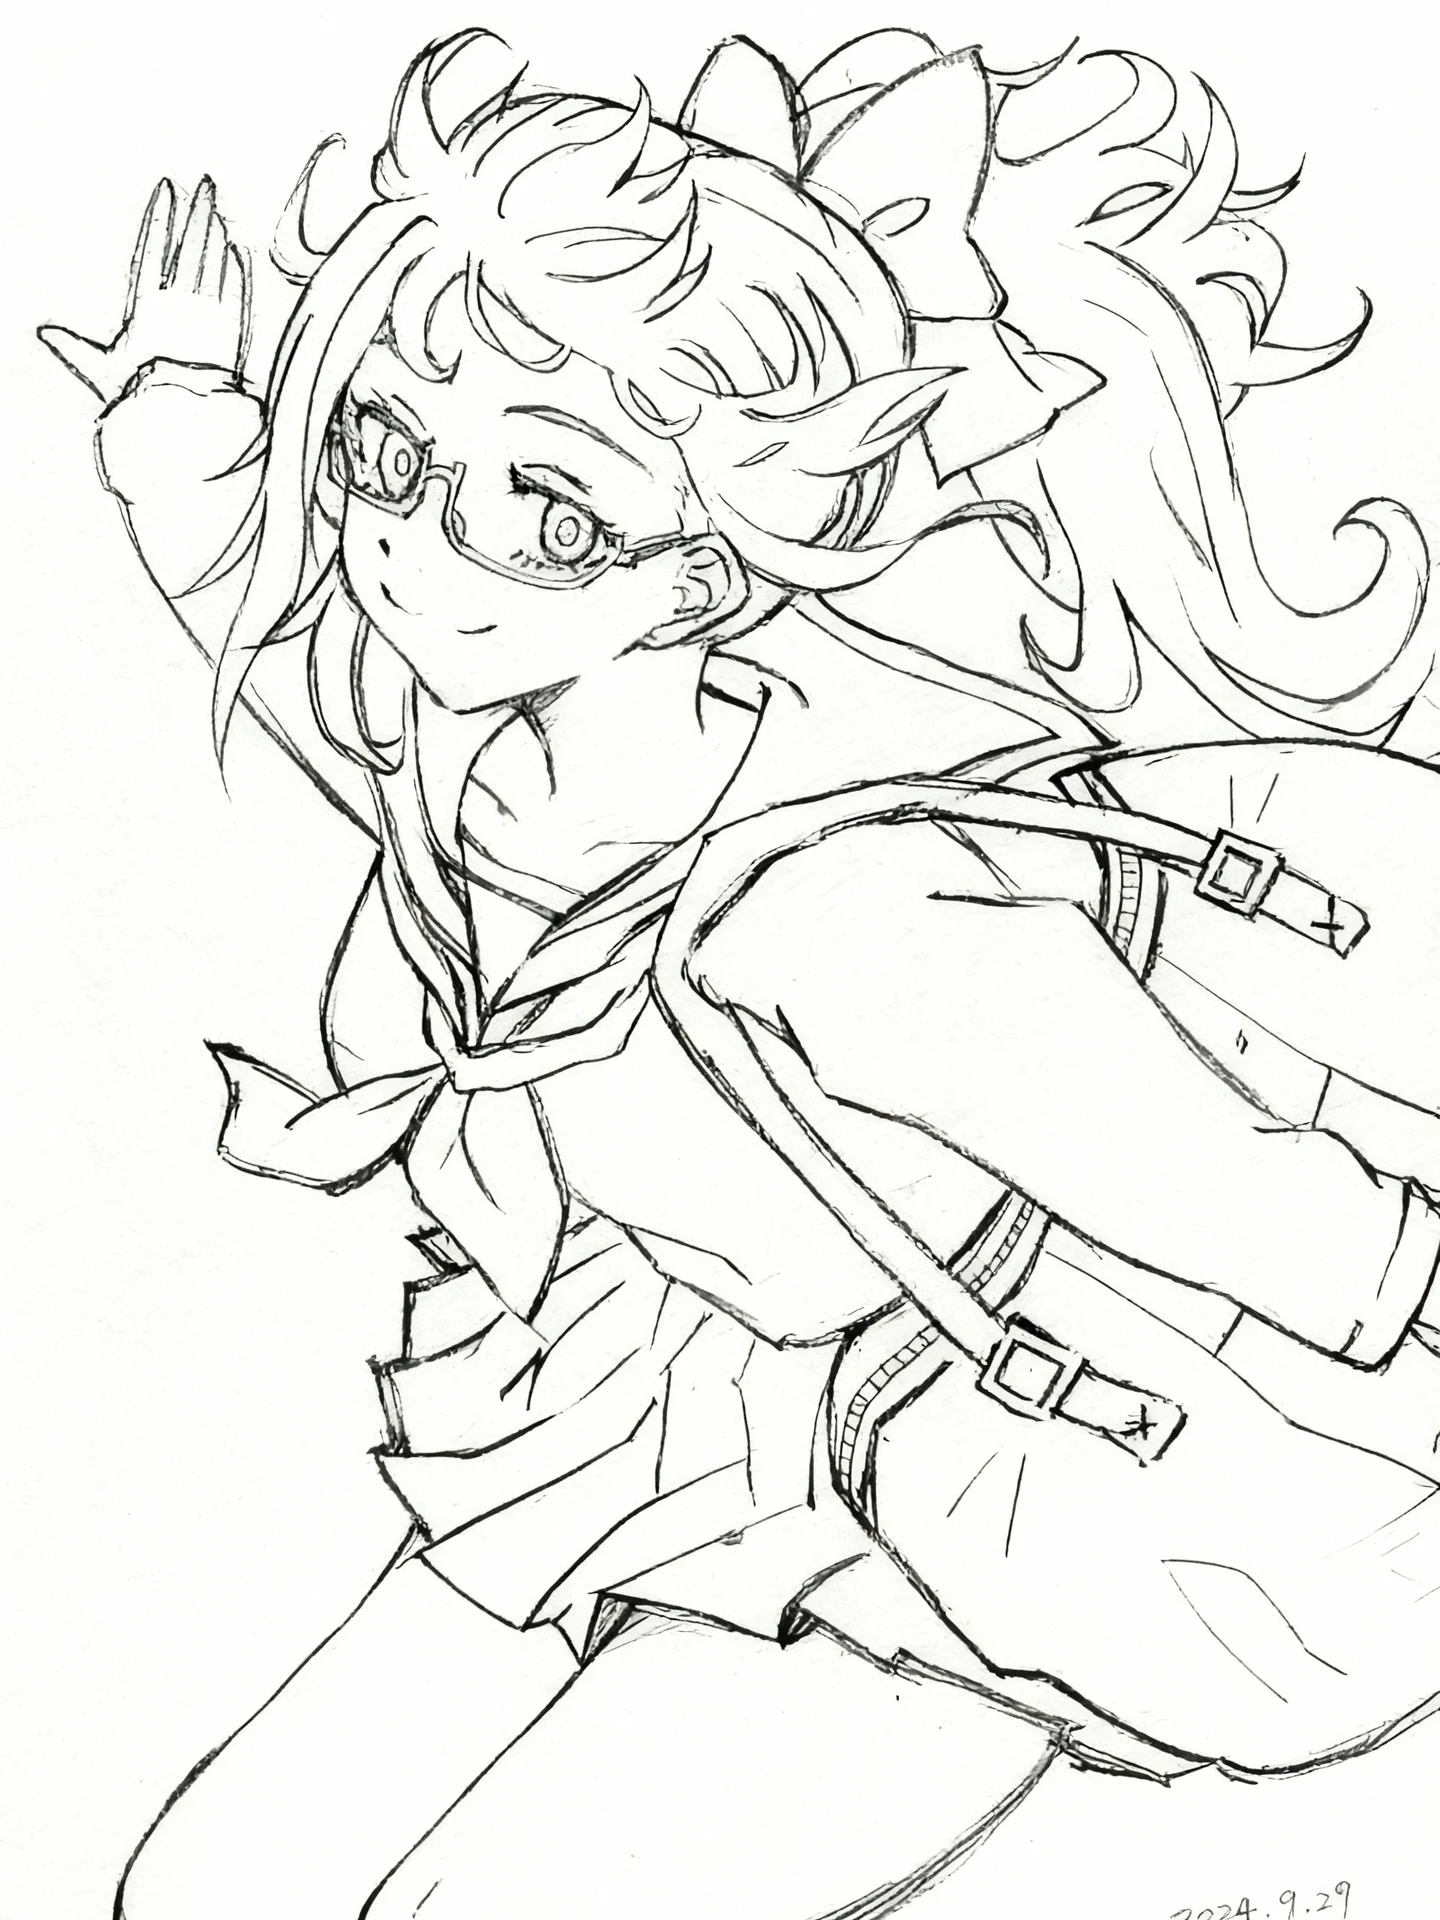
NanoBananaはラフから線を動かして整えようとする挙動がありましたが、Seedream4.0はこのように、スケッチブックをコピー機に掛けたような挙動になりました。迷い線もそのままになっていますね。これは、プロンプト上の言い回しやSeed値などによっても異なる結果になると思います。
自由に着色させるとこのようになりました。
指示「このラフ画像を着色してください。女の子は左右に手を伸ばしています。足は曲げています。遠近法で、奥の手は小さく描かれています。」
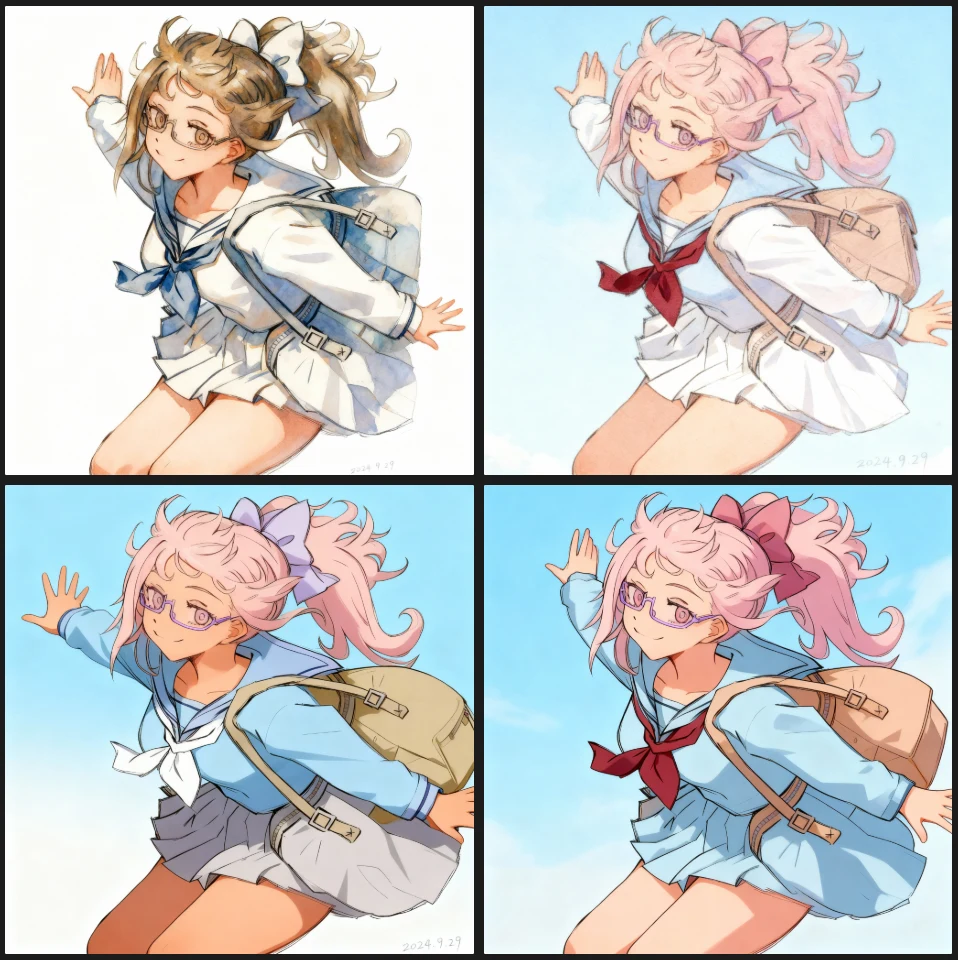
特に色指定はしていないので、自由に塗ったようです。左下の一枚は奥の手が勝手に描き直されていますね。また、バッグが下手すぎて何がなんだか分からなくなってしまったようです…無念。
検証6.複数画像による指示(@img参照)
Freepikでは、複数画像を読み込ませた際に、このように「@img1」「@img2」という番号が振られ、それをそのままプロンプト欄で使うことができます。「@」と打ち込むと選択ウィンドウが出ますので、そこから選ぶとこのように青い「@img1」などが出ます。(単に地の文で@img1などとしても通るようです)
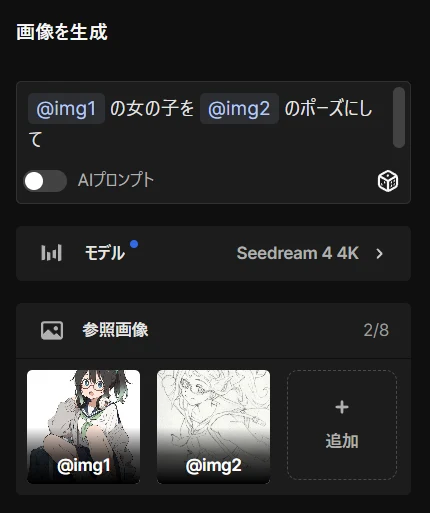
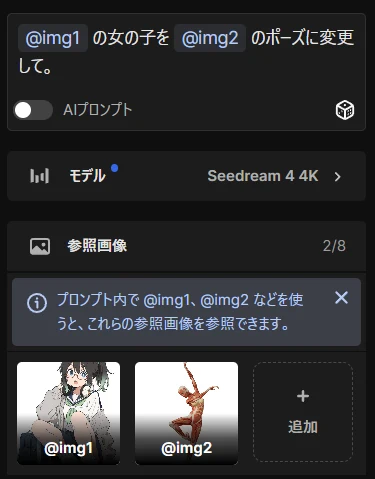
試しに、ミナちゃんの座っているイラストを、さきほどのラフのポーズに変更できるかやってみましょう。
こちらが生成結果。
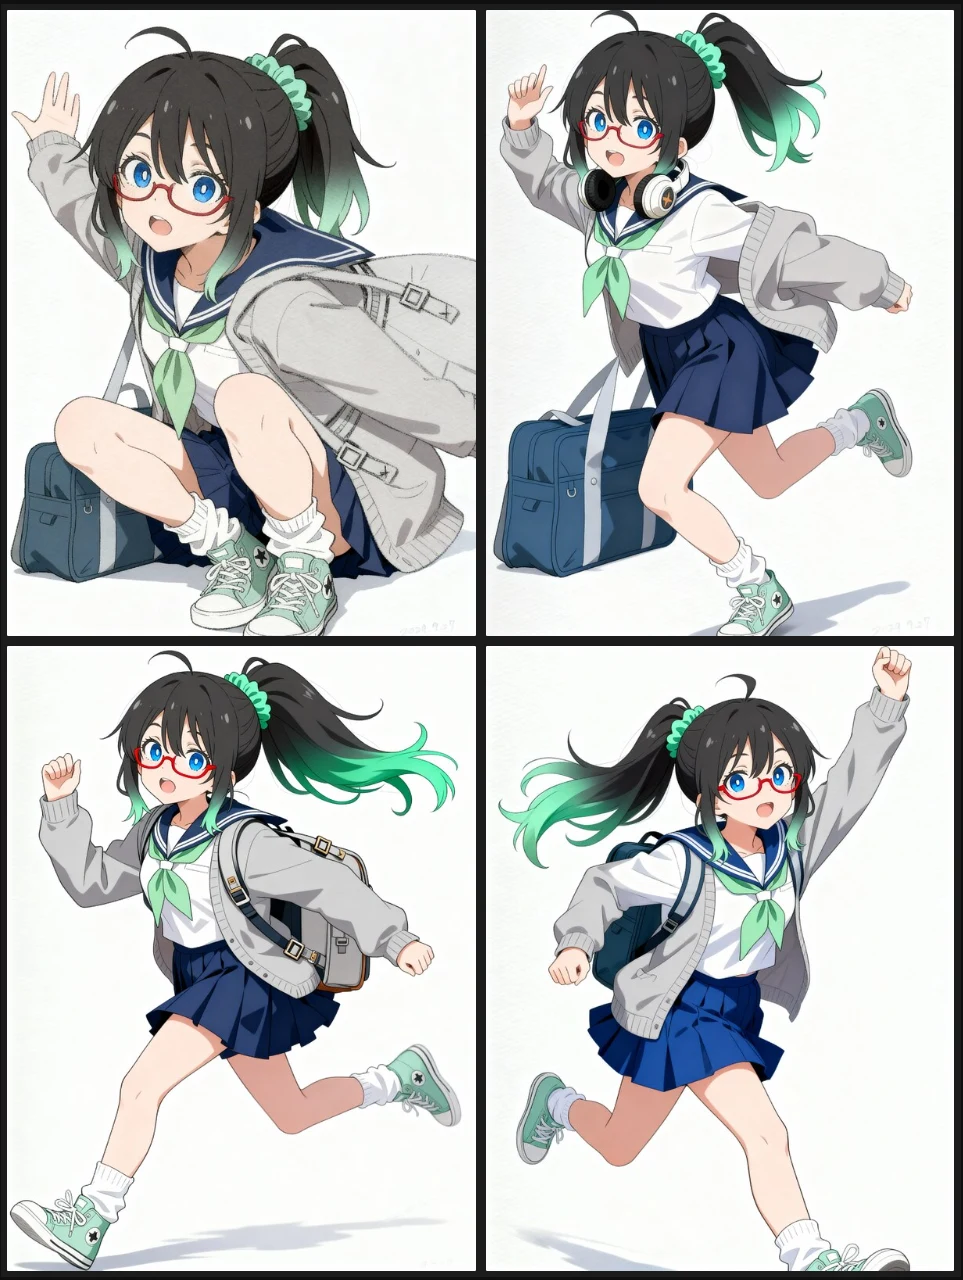
空を飛んでいる、ジャンプしているというよりは「走っている」シーンと理解されたようです。ラフのまったくそのままとはいきませんでしたが、向きなどはなんとなく、そのような感じになった感じはしますが…これではわざわざ図示した意味がありませんね。もう少しプロンプトで補助してあげるとどうでしょうか。
指示:@img2の女の子を@img1のポーズにして。セーラー服姿で、肩に学生バッグを提げて、両手を羽のように左右に広げています。表情は口を閉じた笑顔で、こちらを見つめています。
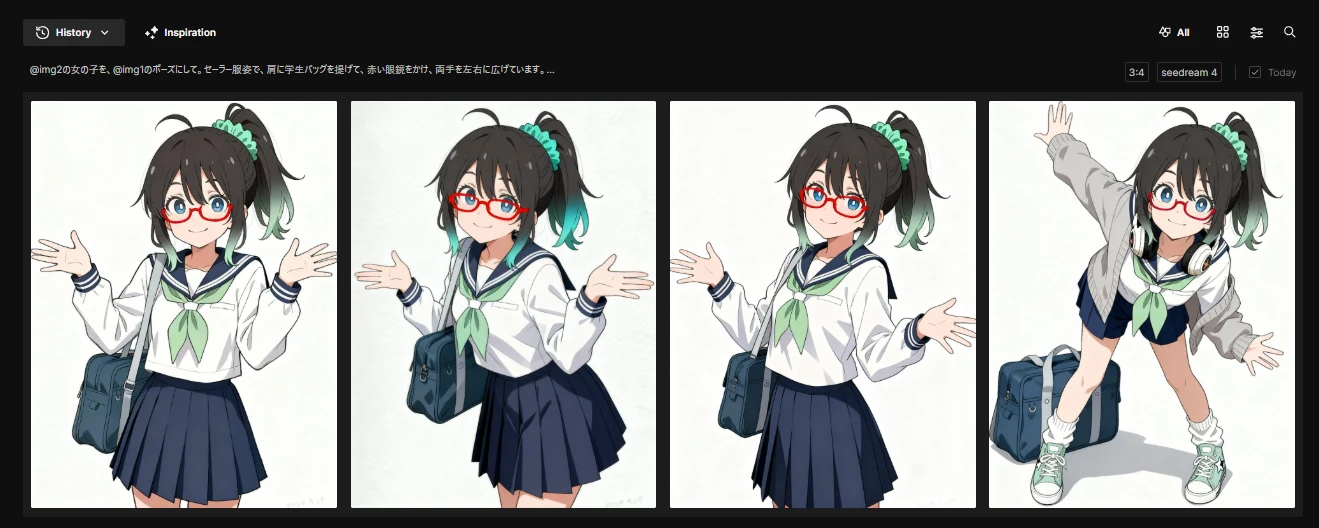
ところが、むしろラフ指示がほぼ意味を成さなくなってしまいました。
これはなぜそうなったのか考えてみますと、恐らくラフが下手すぎたのとプラスして、「ラフからプロンプトを抽出し、その文字列を使ってポーズ変更を行った」のかもしれません。Freepikではこのように、生成画像をプロンプト欄にドラッグアンドドロップすると、画像からのプロンプト抽出ができますので、ちょっと見てみましょう。
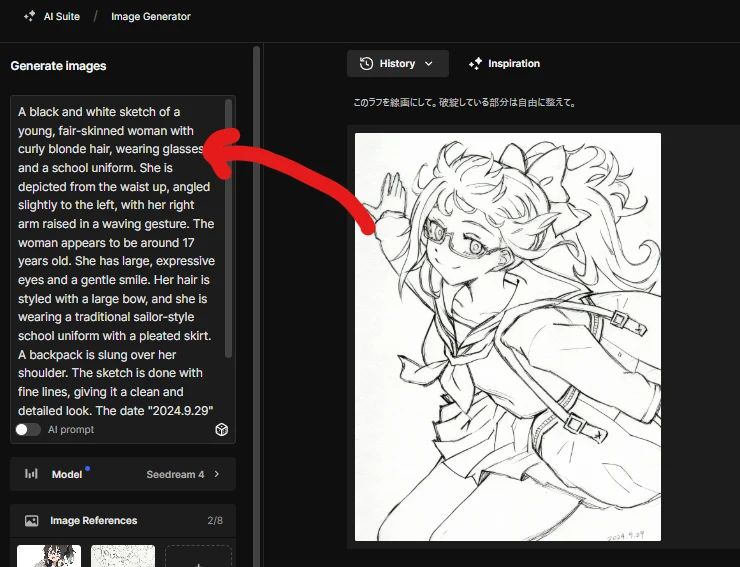
抽出PP:A black and white sketch of a young, fair-skinned woman with curly blonde hair, wearing glasses and a school uniform. She is depicted from the waist up, angled slightly to the left, with her right arm raised in a waving gesture. The woman appears to be around 17 years old. She has large, expressive eyes and a gentle smile. Her hair is styled with a large bow, and she is wearing a traditional sailor-style school uniform with a pleated skirt. A backpack is slung over her shoulder. The sketch is done with fine lines, giving it a clean and detailed look. The date "2024.9.29" is written in the bottom right corner. The style resembles a manga drawing.
翻訳:白黒のスケッチ。肌が白く、巻き毛のブロンドの若い女性が描かれている。眼鏡をかけ、制服を着用。腰から上のみが描かれ、やや左を向いている。右腕を上げて手を振っている様子だ。17歳前後に見える。大きく表現力豊かな瞳と優しい微笑みを浮かべている。髪には大きなリボンが結ばれ、プリーツスカート付きの伝統的なセーラー服を着用している。肩にはリュックサックが掛かっている。細い線で描かれたスケッチは、清潔で詳細な印象を与える。右下隅には日付「2024.9.29」が記されている。作風は漫画風の絵に似ている。
「走っている」とは抽出されませんでしたが、内部的にこのようなラフ画像からの誤解が起き、生成結果に影響した可能性はありそうですね。そこで、次のようにプロンプトを変更してみます。
指示:@img1のイラストを参照して、@img2のラフイラストを完成させてください。
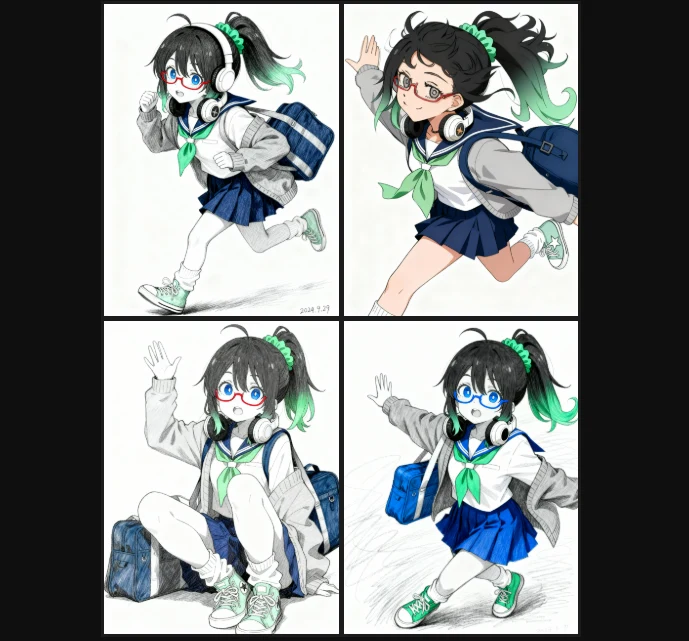
右上はやや意図を理解してくれましたが、やはりうまくいきませんね。ラフ画像からのサポートは(私のヘタな絵では)このような結果となりました。
・ぬいぐるみ合成
次は、こちらの1枚目に2枚目のぬいぐるみを合成するチャレンジです。
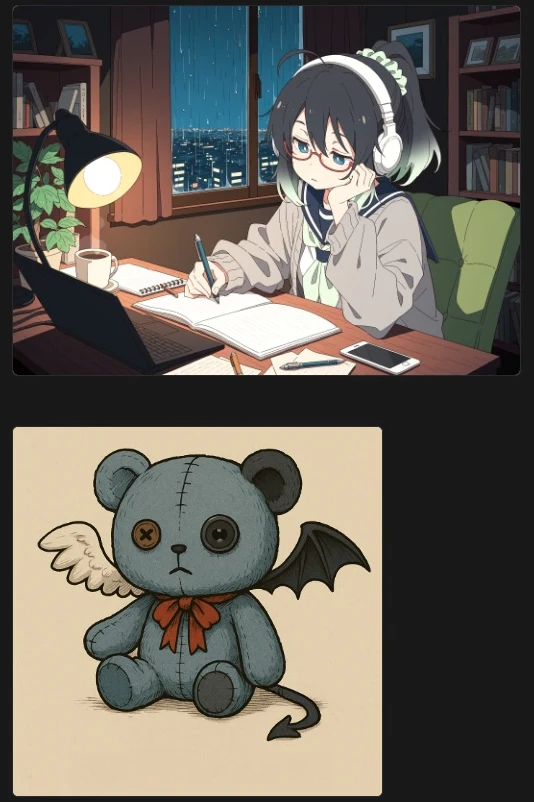
指示「@img1 の中に@img2のぬいぐるみを描いて。 」
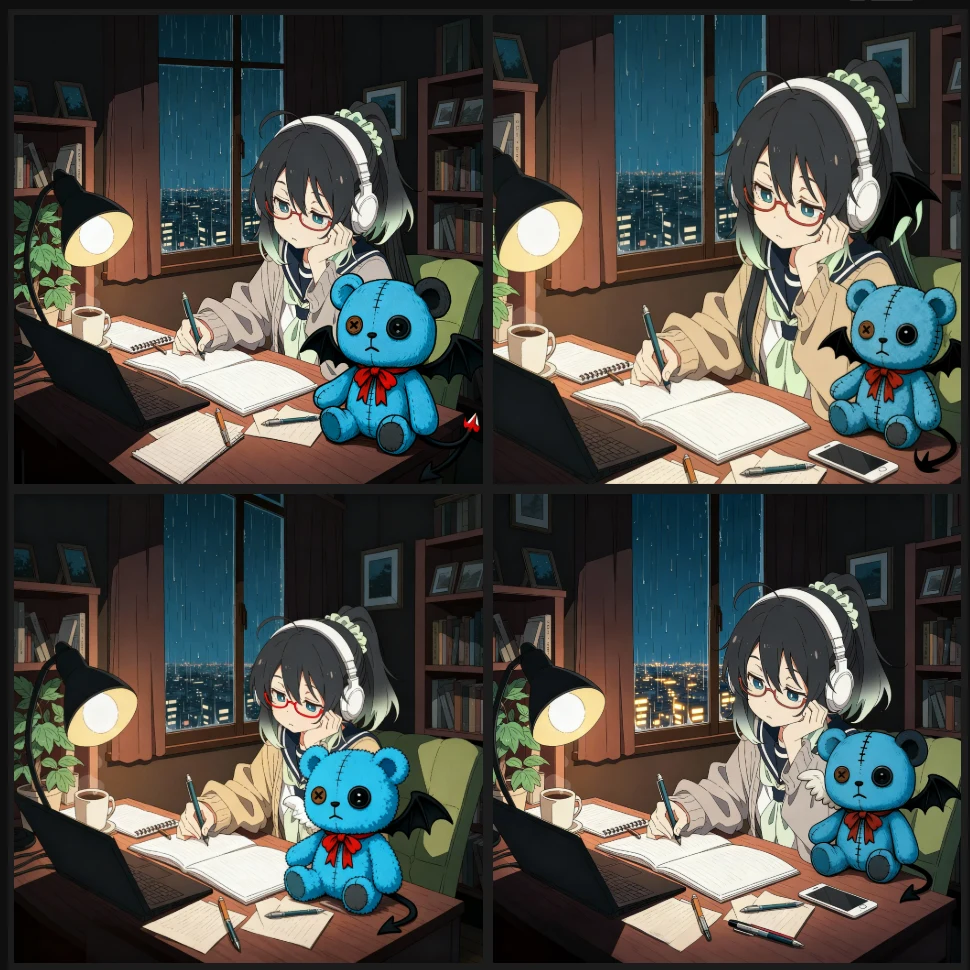
このような結果となりました。画風の違いをフィックスするために、ぬいぐるみの彩度を上げたように見えます。よく見るとアップの度合いが変更されていたり、背景の明かりが変化していたり、右上はミナちゃんにも黒い羽根が生えていたりと、微妙な違いも見て取れます。
NanoBananaはできるだけ元画像の色あせたカラーや質感のままに合成していたので、ここはテイストの違いがはっきり出ました。
・商店街バトル
次はこちらの二人が商店街でバトルを繰り広げている画像です。
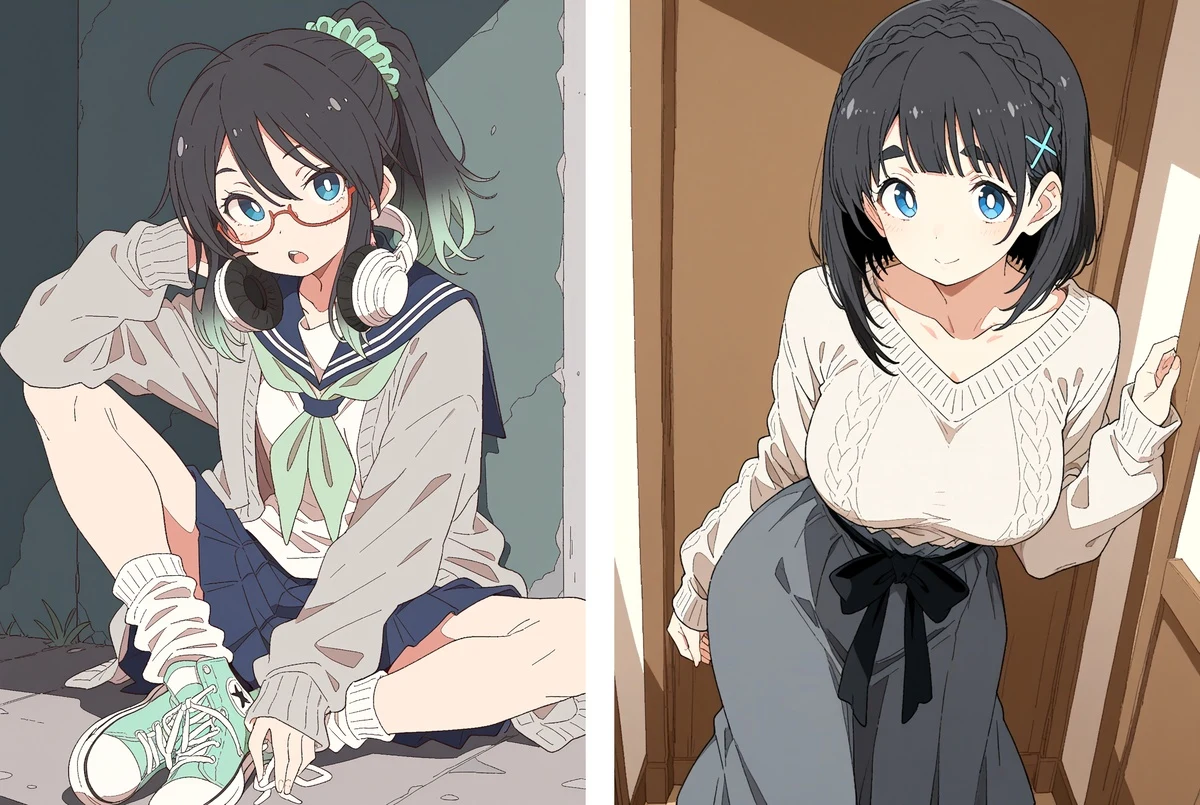
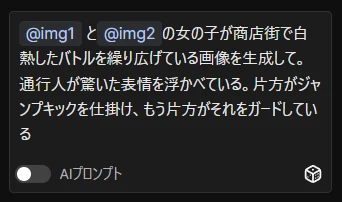
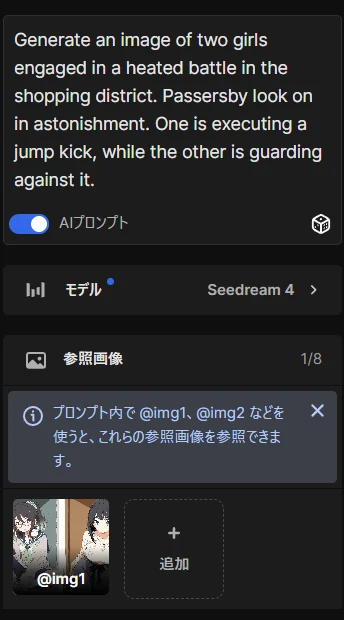
こちらのように指示しました。
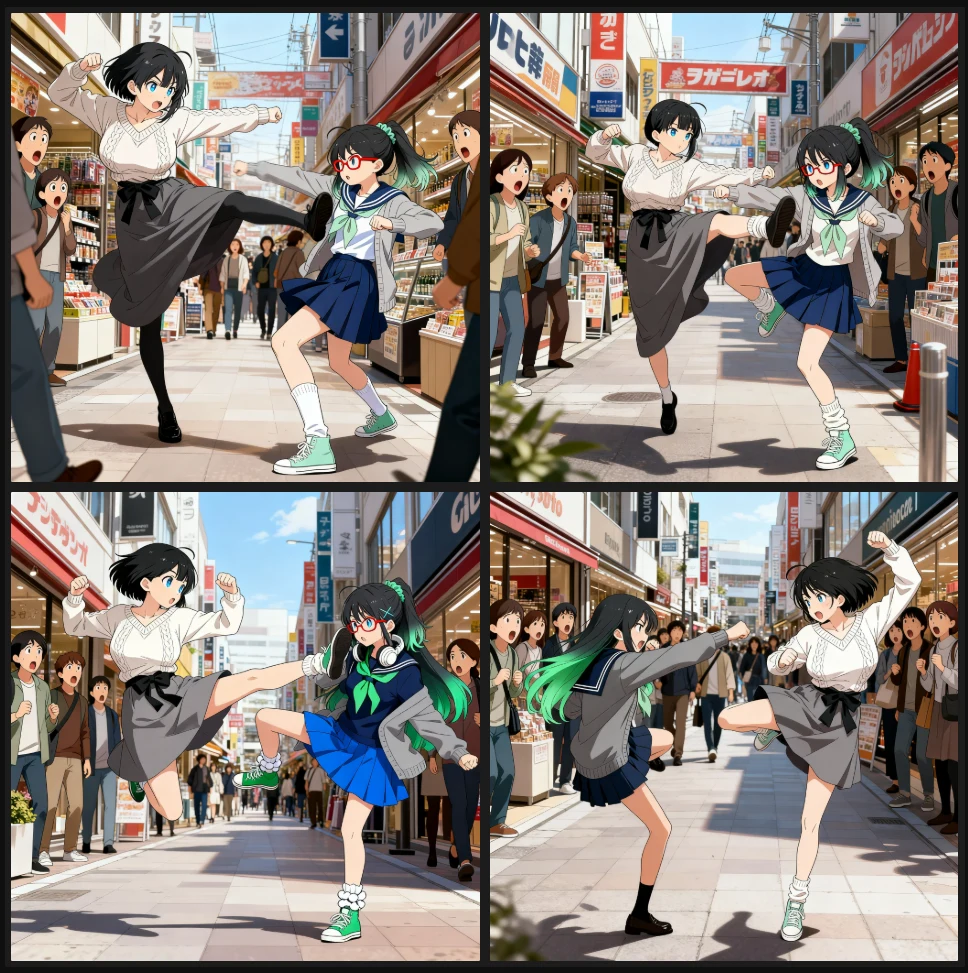
こちらが生成結果。残念ながら、かなり一貫性が削げ落ちてしまいました。
試しに、NanoBananaで改善が見られた「2人の画像を1枚に合成して渡す」と言う方法でやってみます。
合成にはフォトコンバインさんを使用しました。こちらが生成結果。
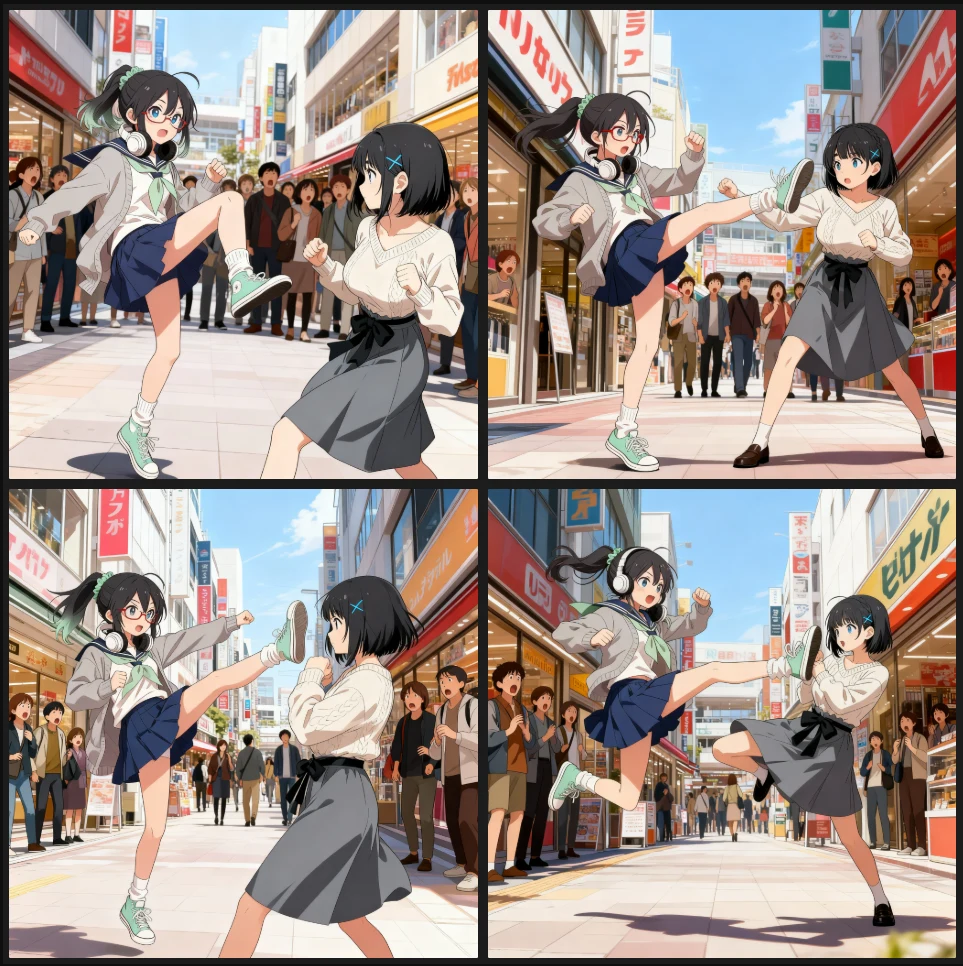
すると、先ほどよりも改善したように見えます。複数枚の画像を渡すと一貫性が向上するのは、それぞれが同じキャラクターだった場合だけなのかもしれません。
次は格闘ゲーム風に変更してみます。
指示「Fighting game screen. Generate an image of two characters engaged in a heated battle in a shopping district. One character launches a jump kick while the other blocks it. A health gauge and remaining time are displayed at the top of the screen, and a super combo gauge is displayed at the bottom. Hit effects are also displayed.」
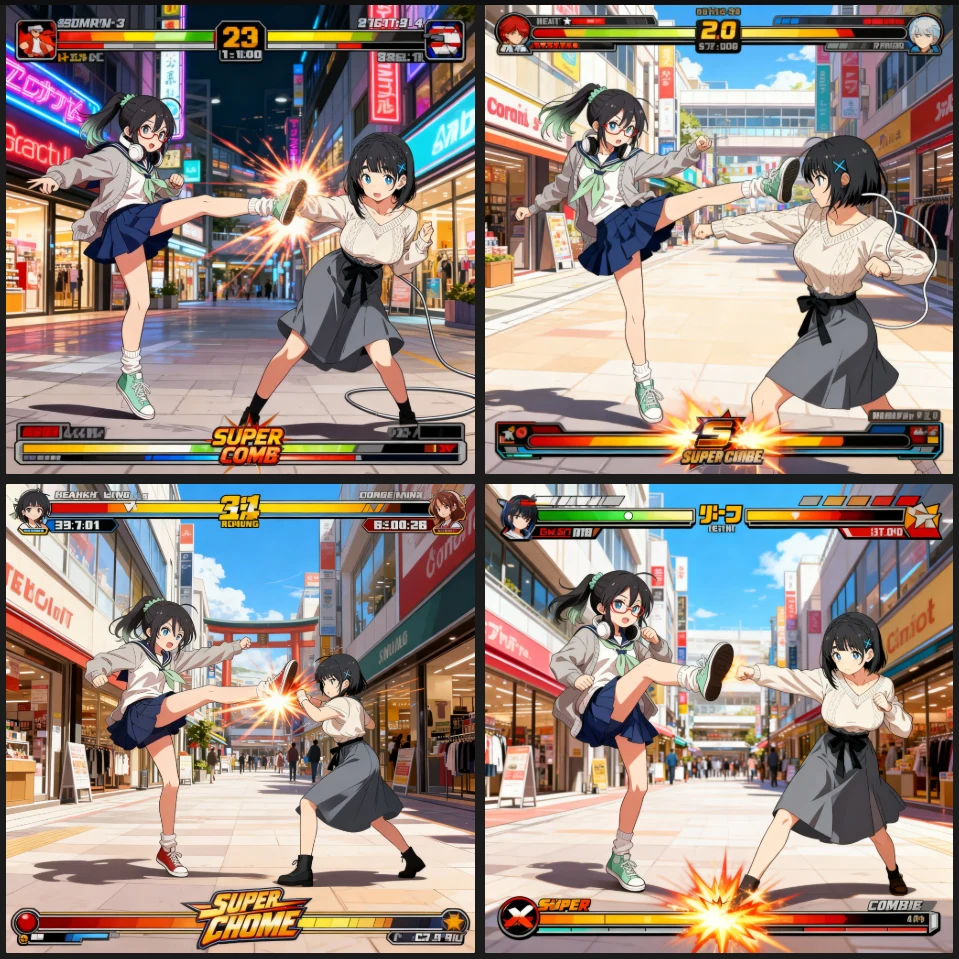
なんとなくそれっぽくはなりましたが、なぜか右のキャラクターにひもらしきものが足されていたり、眼鏡が消えたりと、完璧とはいきませんでした。文字も全体に安定せず、レンダリングしたというよりは学習内容に応じてなんとなくそれらしいものを生成した感じになっています。
検証7.実写背景との合成
次は実写背景にキャラクター絵を合成するテストです。
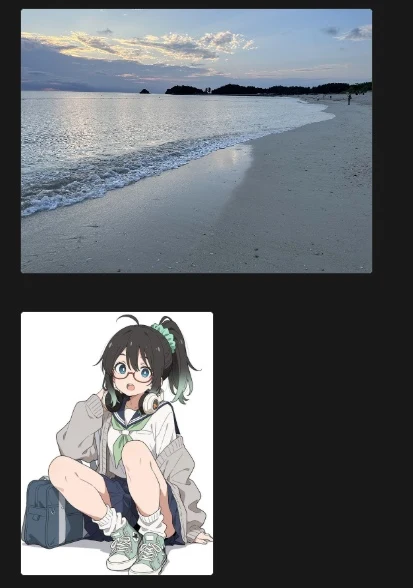
指示「2枚目の画像の女の子を1枚目の海辺の写真に合成して。女の子は楽しそうに手を広げている。」(横長4:3)
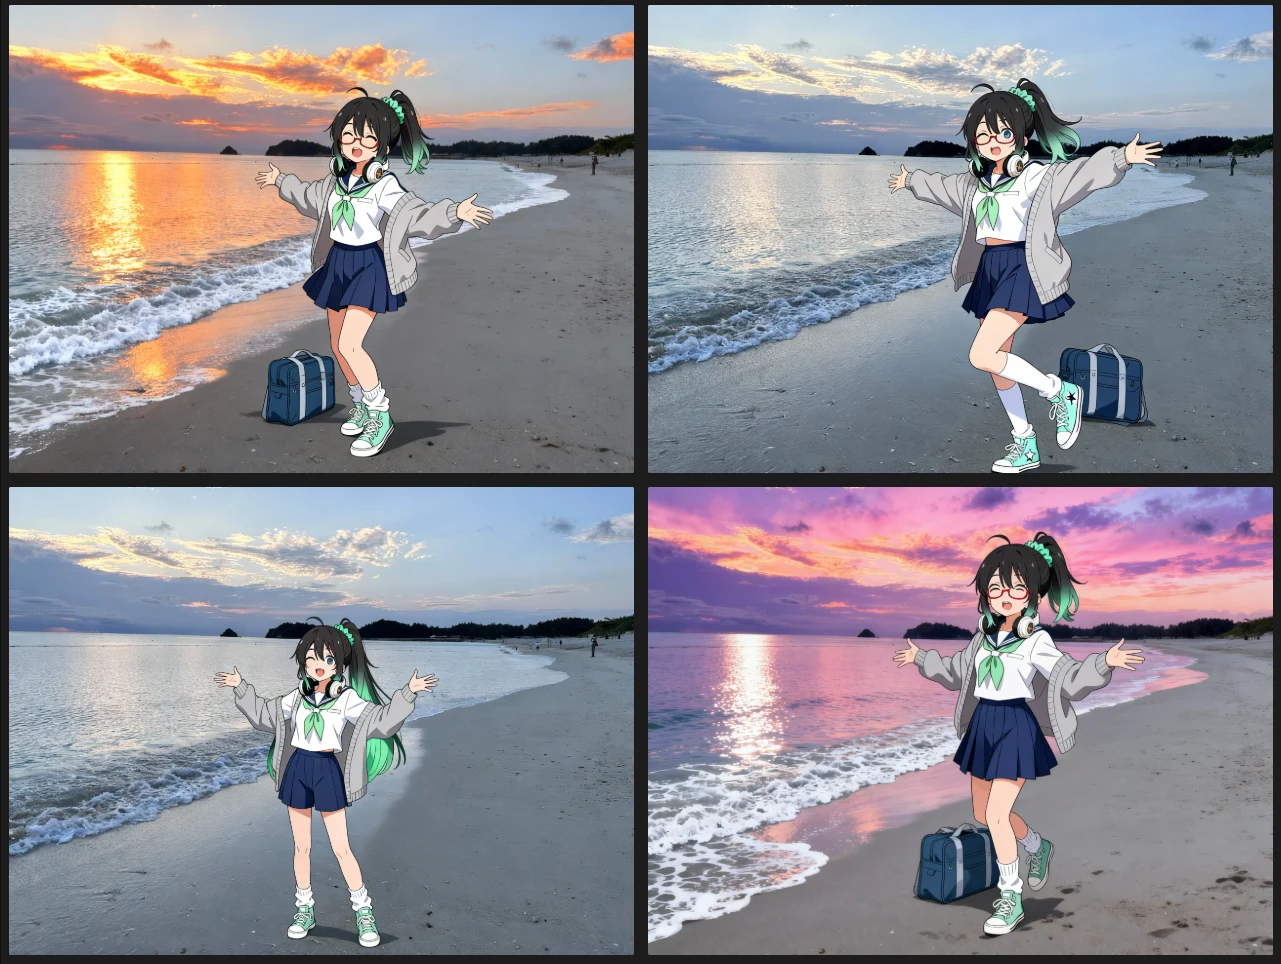
下段の2枚は崩れてしまいましたが、上段の2枚は悪くない感じですね。ただ、左上は時刻が夕方に勝手に変更されているのが気になります。
こちらはNanoBananaで同じ画像を生成したときのもの。浜辺の反射や元画像への侵襲性を考えると、やはり精度ではNanoBananaに一日の長があるようです。また、NanoBananaの方はガチャなし一発生成でこれが出てきた点も忘れてはいけません。
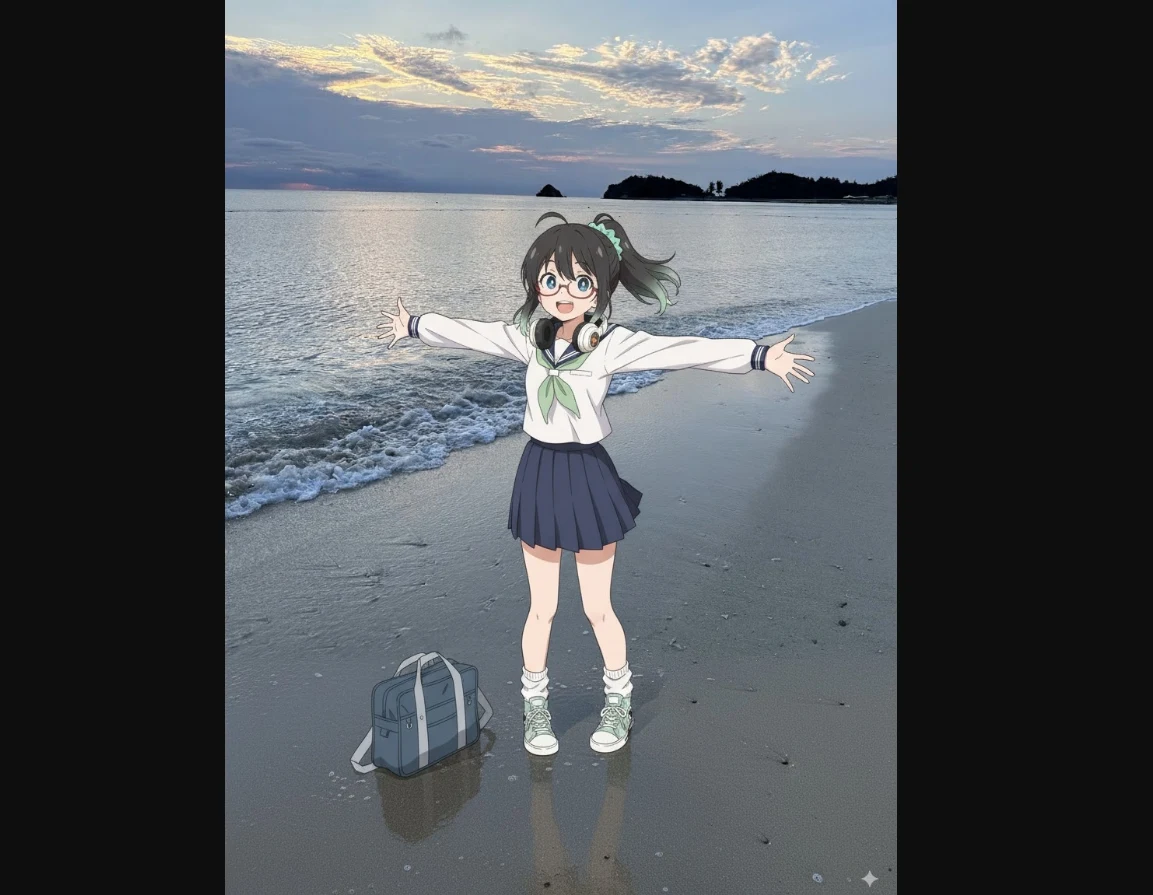
ただ、NanoBananaは勝手にアスペクト比を変更してしまっているので、その点に限ればSeedreamに軍配が上がりそうですね。それに、Seedream4 4kはNanoBananaに比べて解像度も4倍です。
続けて時刻変更とポーズ変更を試します。
指示「夕方にして」
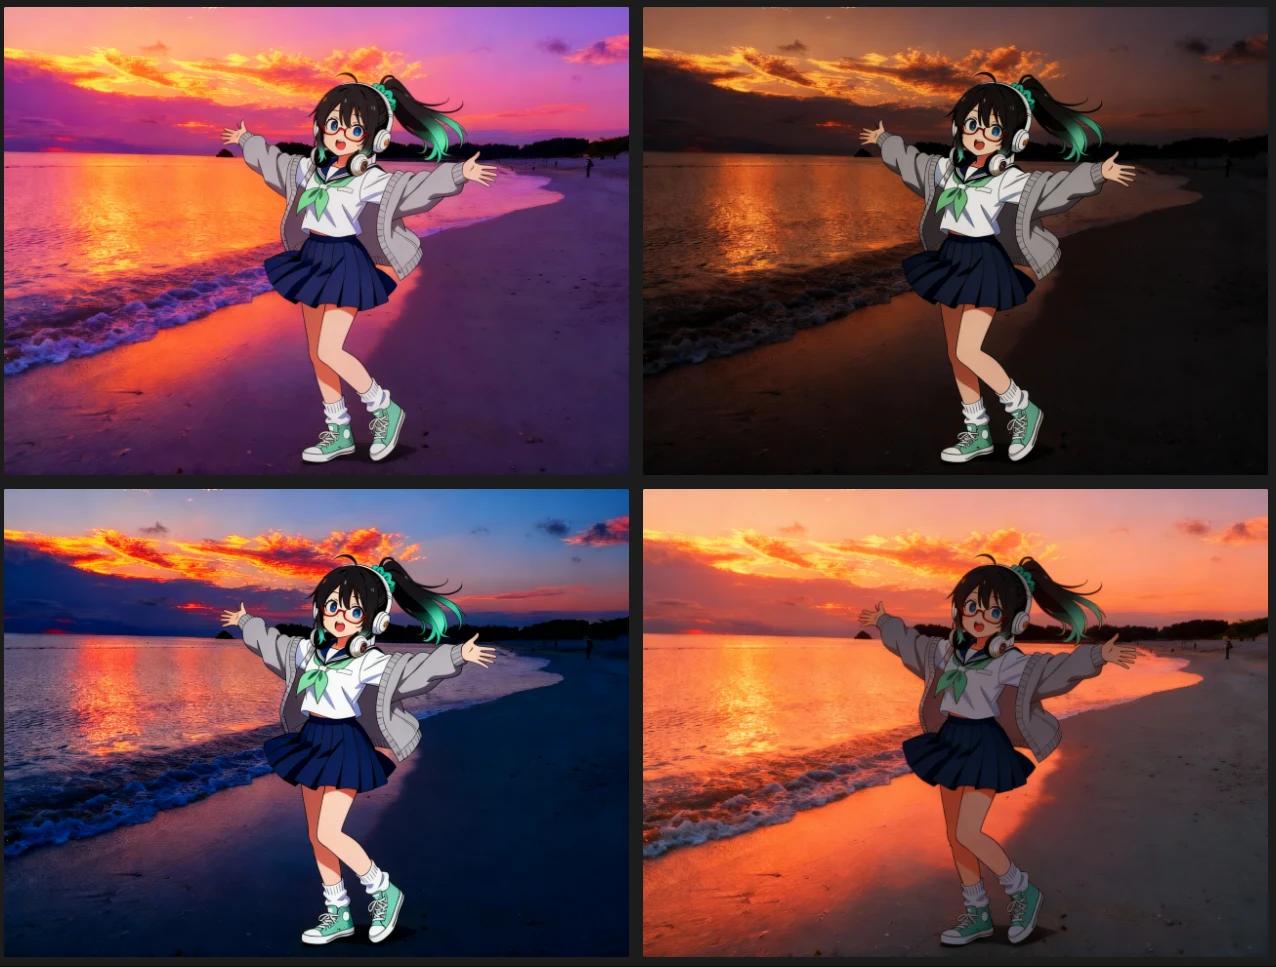
自然かどうかは微妙ですが、右下などは光源を考えてこちら側を影にできています。右下の1枚のポーズを変更してみましょう。
指示「女の子ははだしになって、カメラに背を向け、画面奥に向かって全速力で走って行く。」
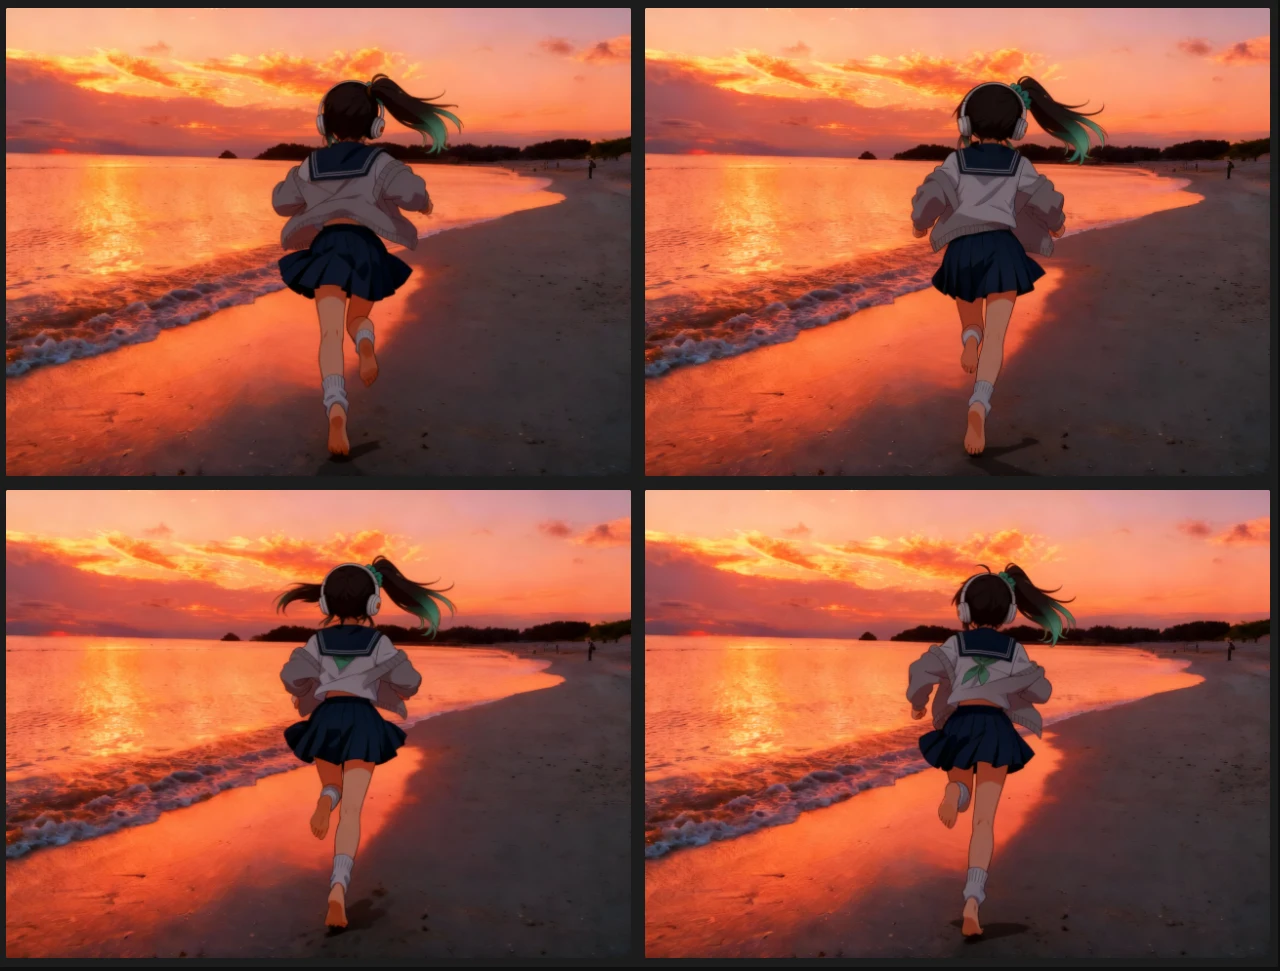
Seedream、ルーズソックスを知らない…? まあそこは差し引くとしても、リボンがあやしかったり、セーターの背後が微妙だったりと、あまり芳しい結果にはなりませんでした。
今度は、最初に生成した画像でこちらのポーズを要求してみます。
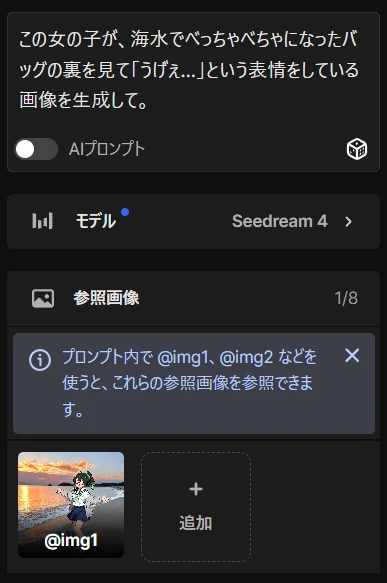
指示:この女の子が、海水でべっちゃべちゃになったバッグの裏を見て「うげぇ…」という表情をしている画像を生成して。
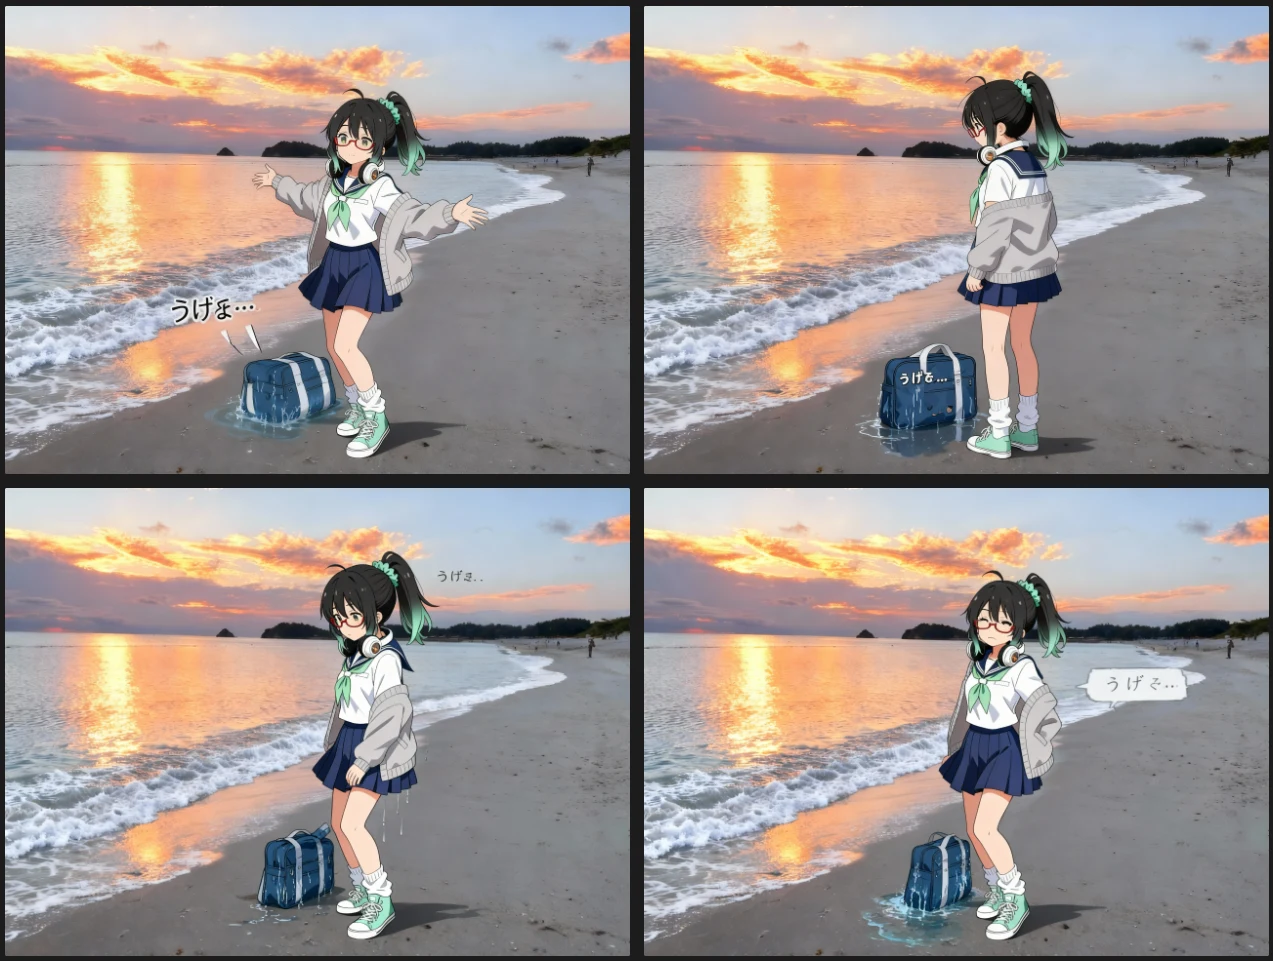
NanoBananaはこの注文の意図を上手に汲み取って、どういうポーズをしていたら「うげぇ…」というイラストに見えるかを考えてくれましたが(下図)、Seedreamはあまりそこまで工夫した感じは見られませんでした。
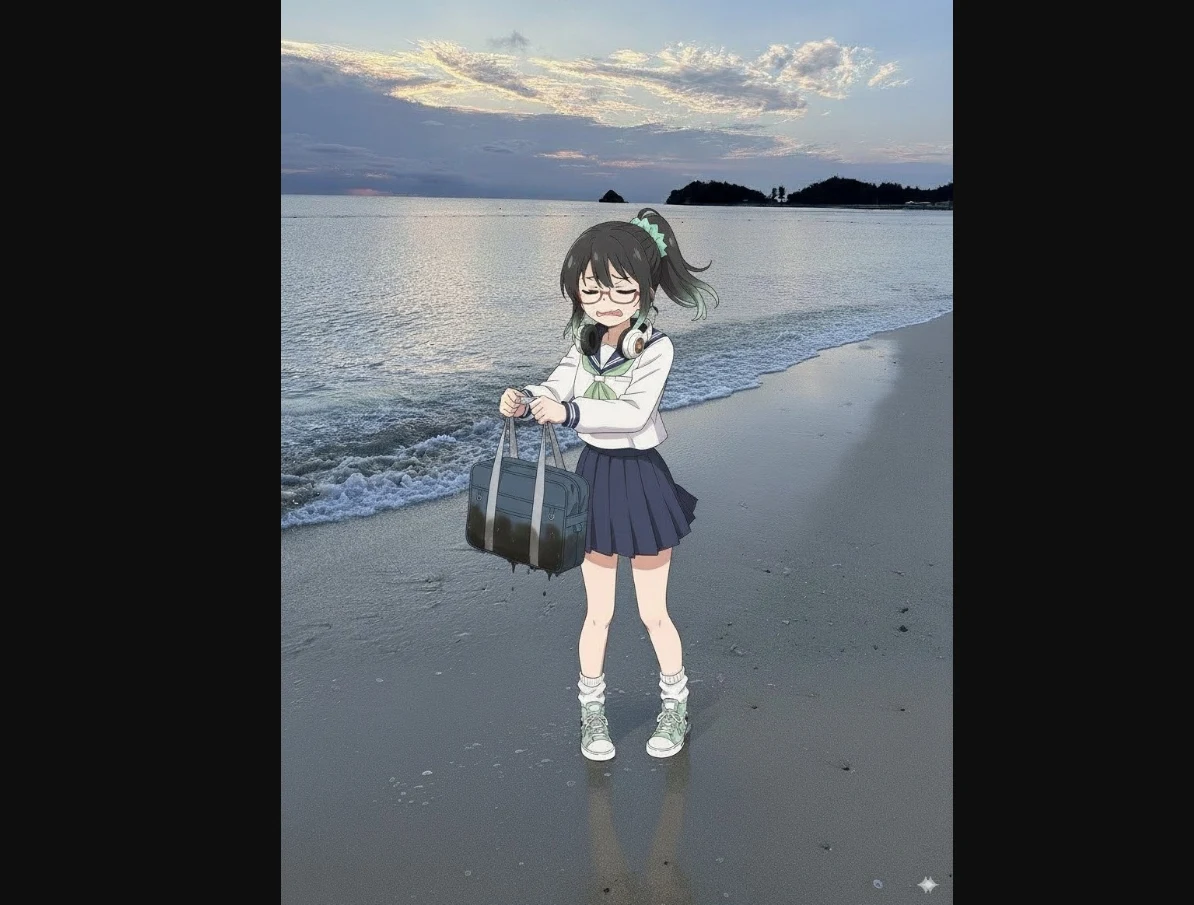
では、以前のようにGoogle AI Studioでなく、Freepik上でNanoBananaに指示するとどうなるのでしょうか。こちらは、全く同じプロンプトでNanoBananaに頼んだものです。
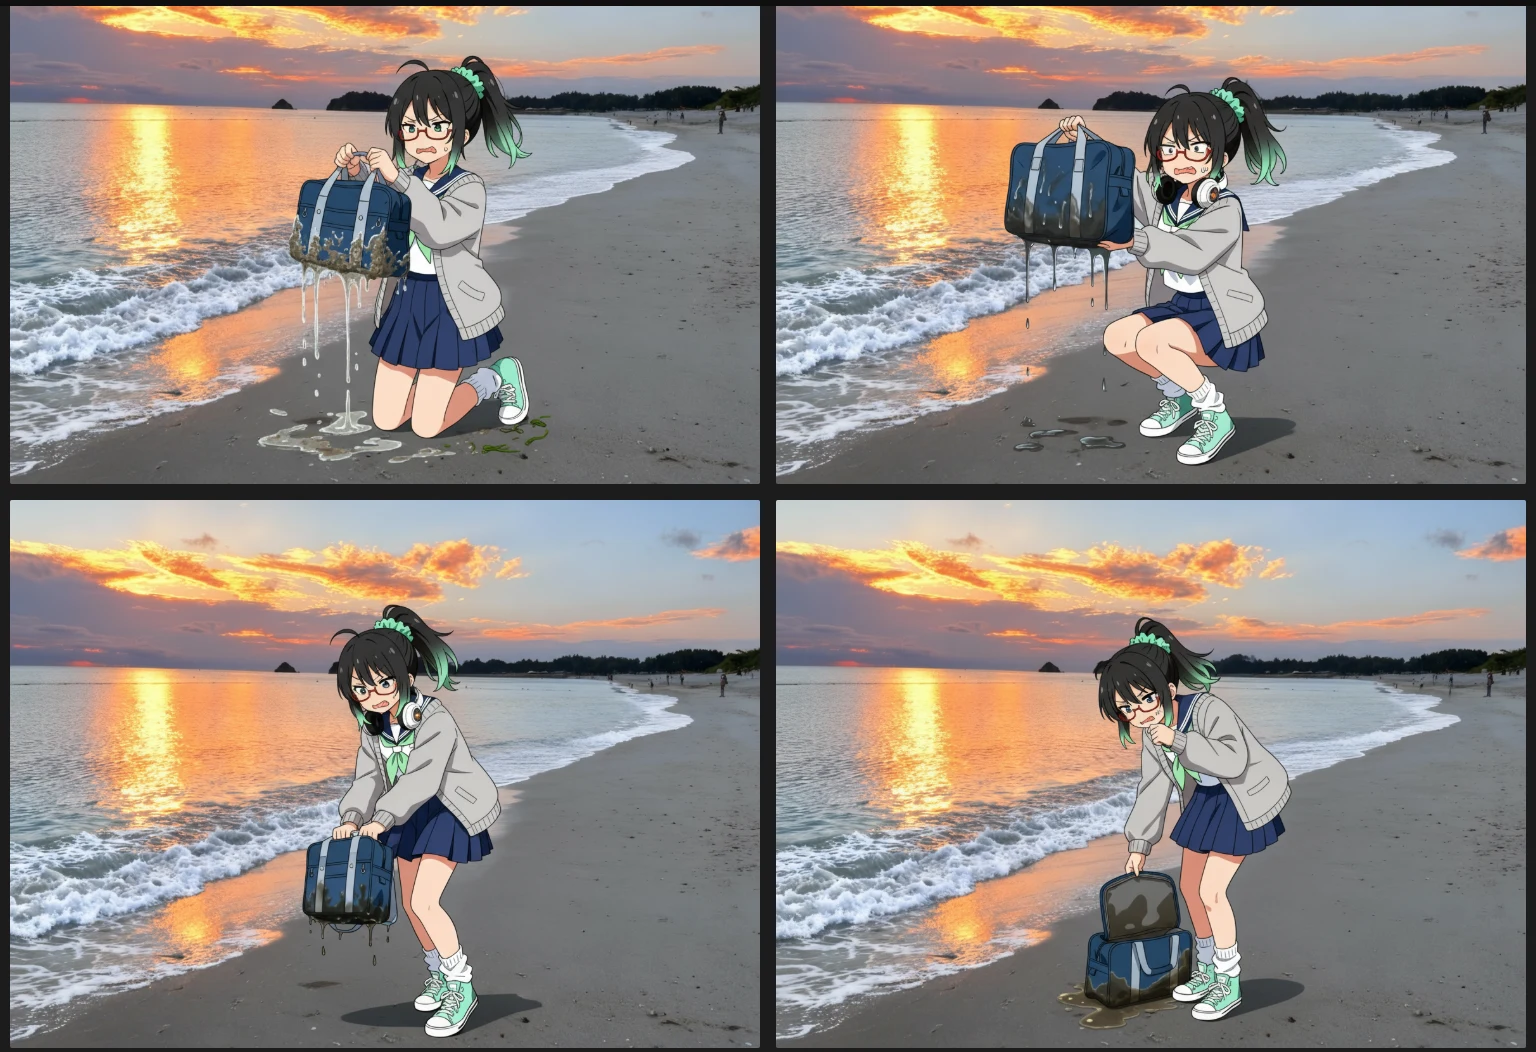
ちゃんとプロンプトの意図を読み取って、「濡れているところに置いてしまったため、底面が砂と海水でどろどろになってしまったことに今気づいたミナちゃん」を描けました。ここではむしろ、FreepikでNanoBananaを4枚同時無限生成できることに強い魅力を感じてしまいました。これができるなら、もう全部NanoBananaで良いのでは…?という考えが頭をもたげます。
検証8.消しゴムマジック
今度はこちらの写真から自然言語指示で男性を消すテストです。
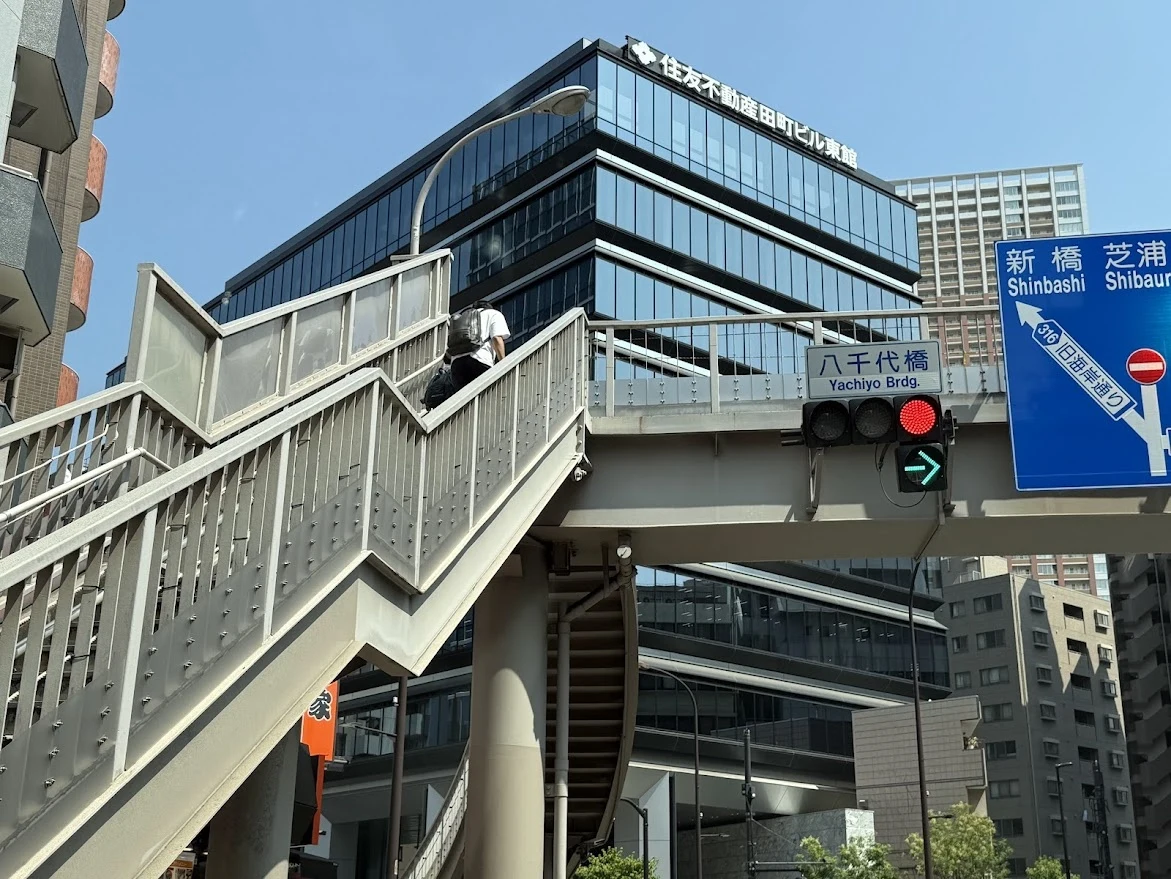
指示「男性を消して」(横長4:3)
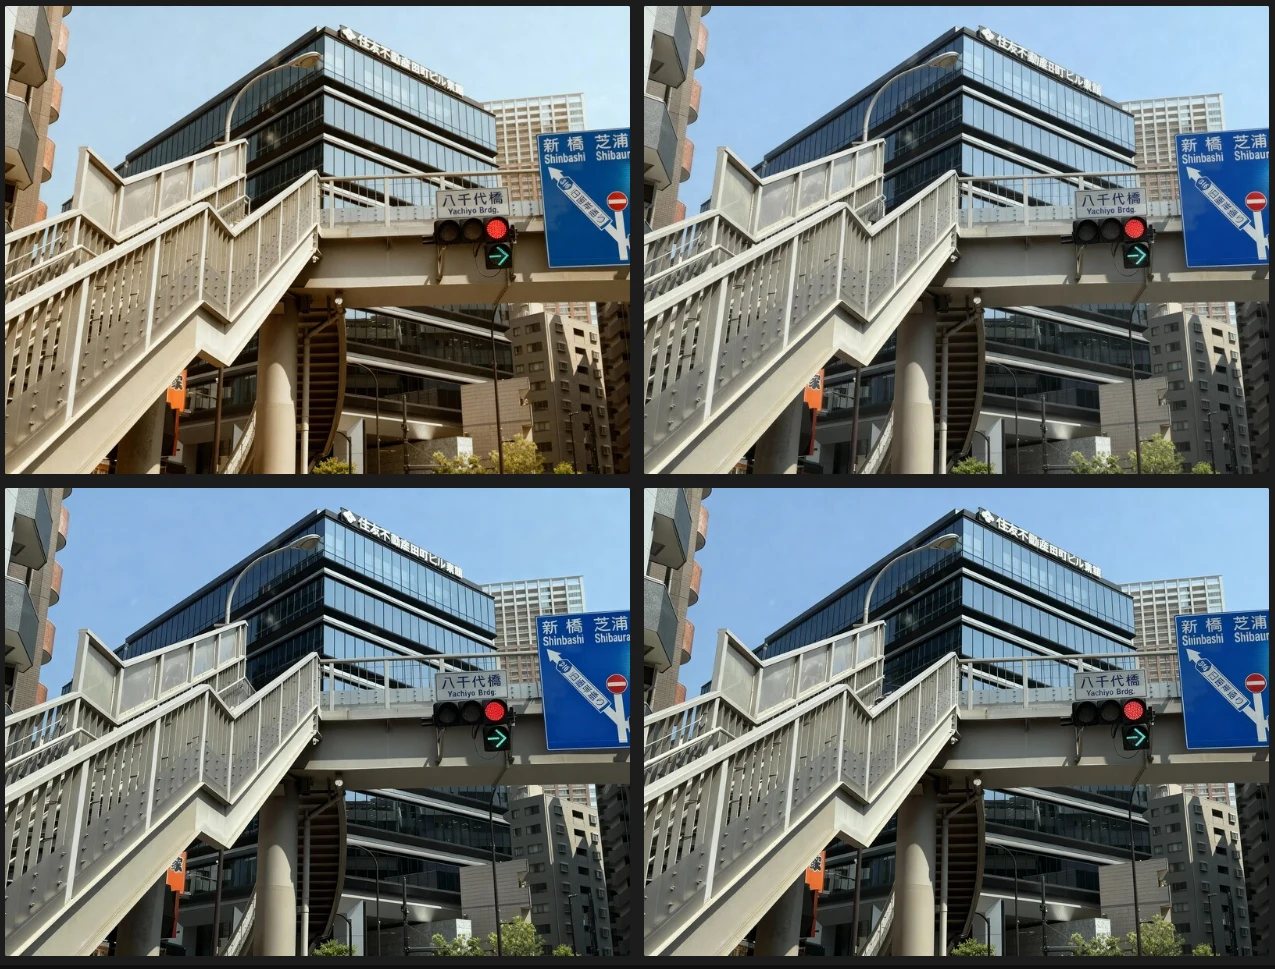
ごく小さいターゲットでしたが、おおむね綺麗にできました。左上はなぜかカラーがセピア調に変容していますが、ほかはさほど侵襲的ではなく思ったとおりの変更が加えられていますね。
今度はキャラクターを合成してみます。
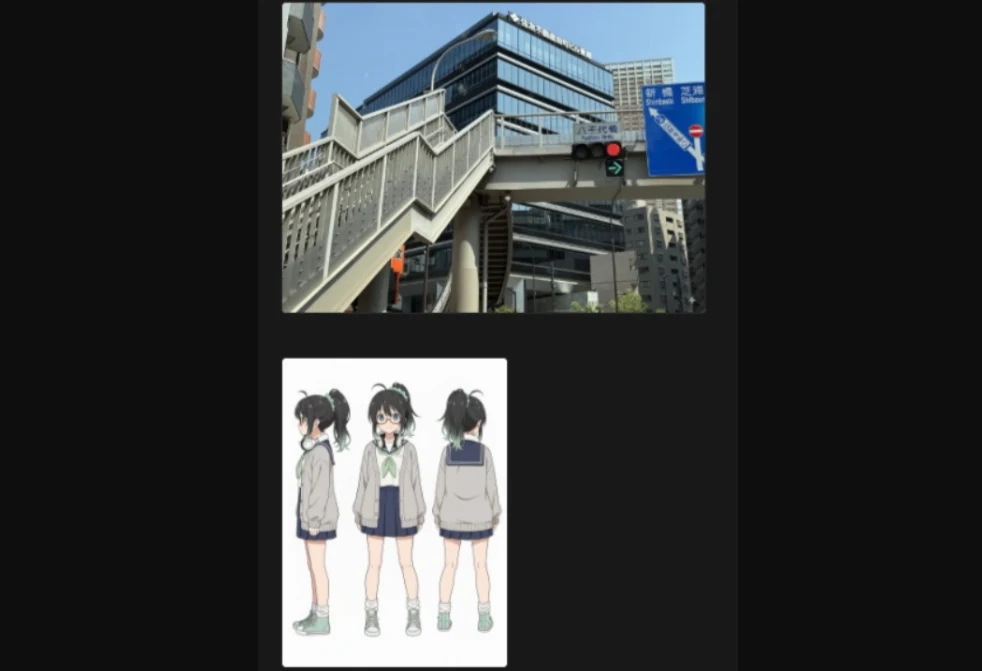
指示「@img1の歩道橋の上を、@img2の画像の女の子が歩いている画像を生成して。女の子は笑顔で、空を見上げています。」(横長4:3)
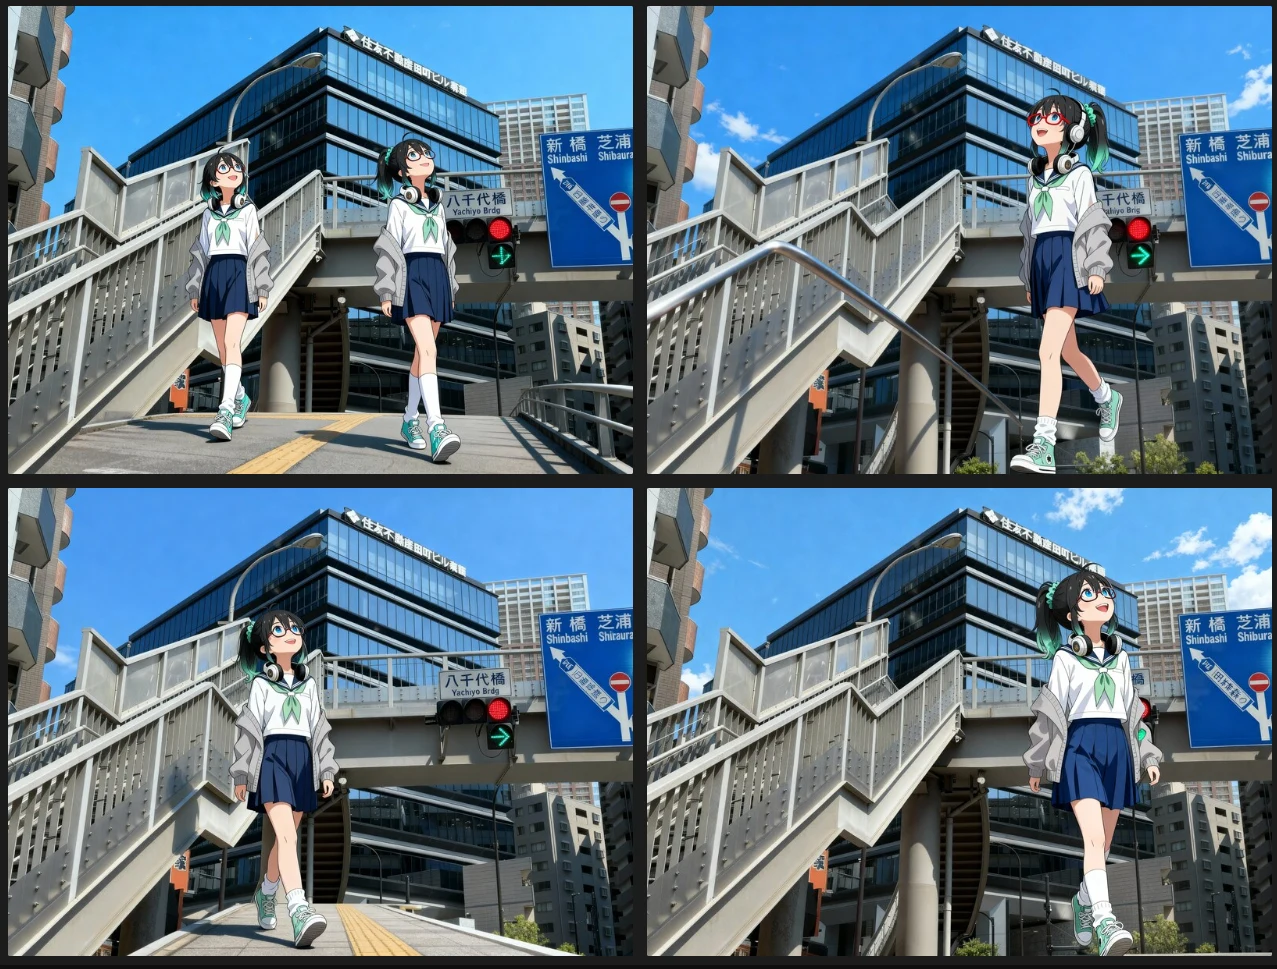
NanoBananaは歩道橋の上になんとか乗せることができましたが、Seedreamの方はどこが歩道橋の上なのかよく分からなかったようです。一貫性は保てているのですが、そこまで空気を読むことは難しいようですね。また、三面図にやはり引っ張られて、左上はキャラがダブってしまっています。
検証9.写真を漫画調・アニメ調に変換
では、さきほど人物を消した歩道橋の写真を漫画調に変換してみます。
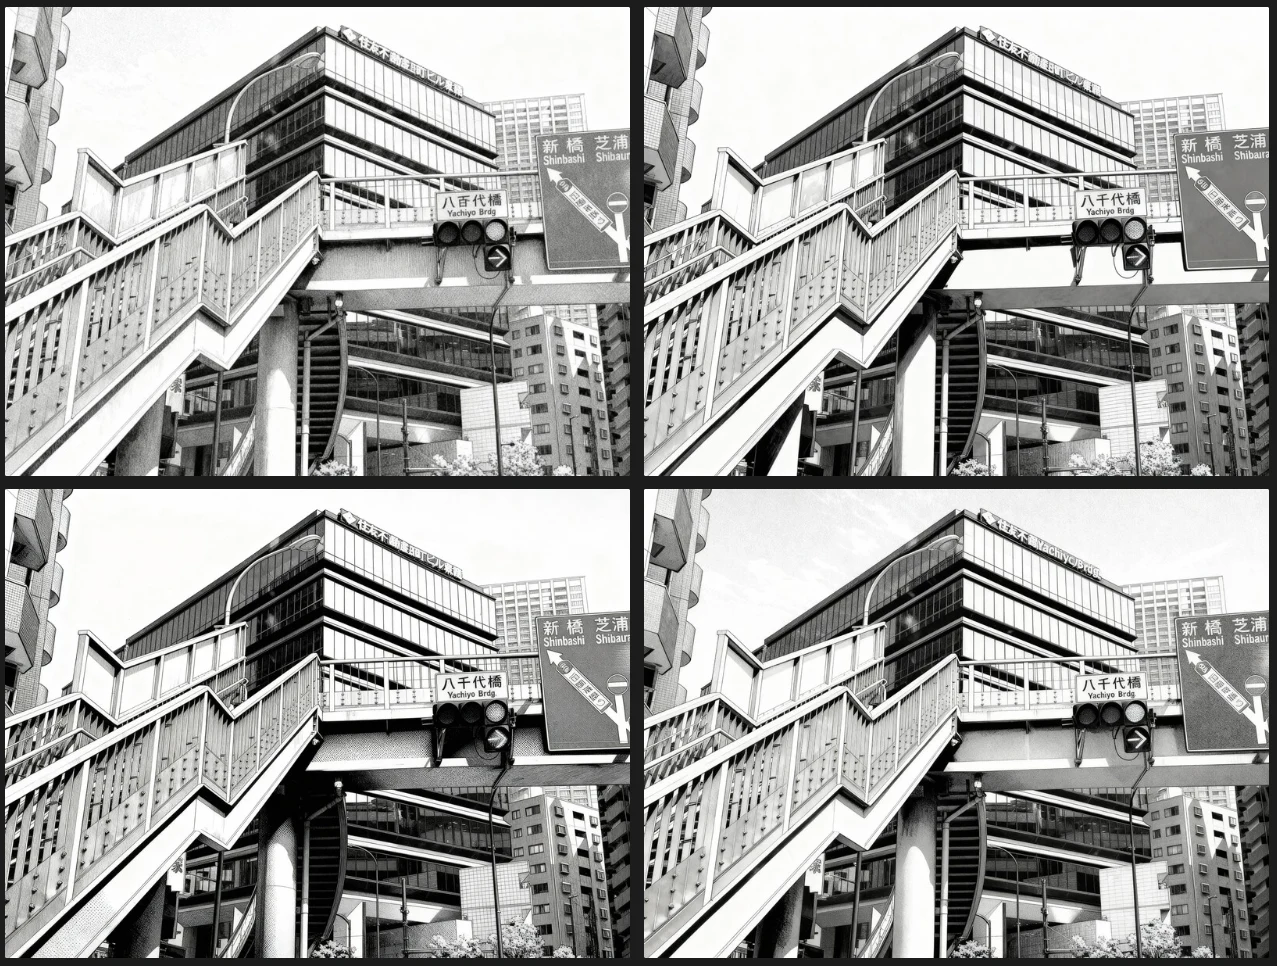
左上は八千代橋の文字が崩れてしまいましたが、おおむね綺麗にできたようです。
指示「俯瞰にして」
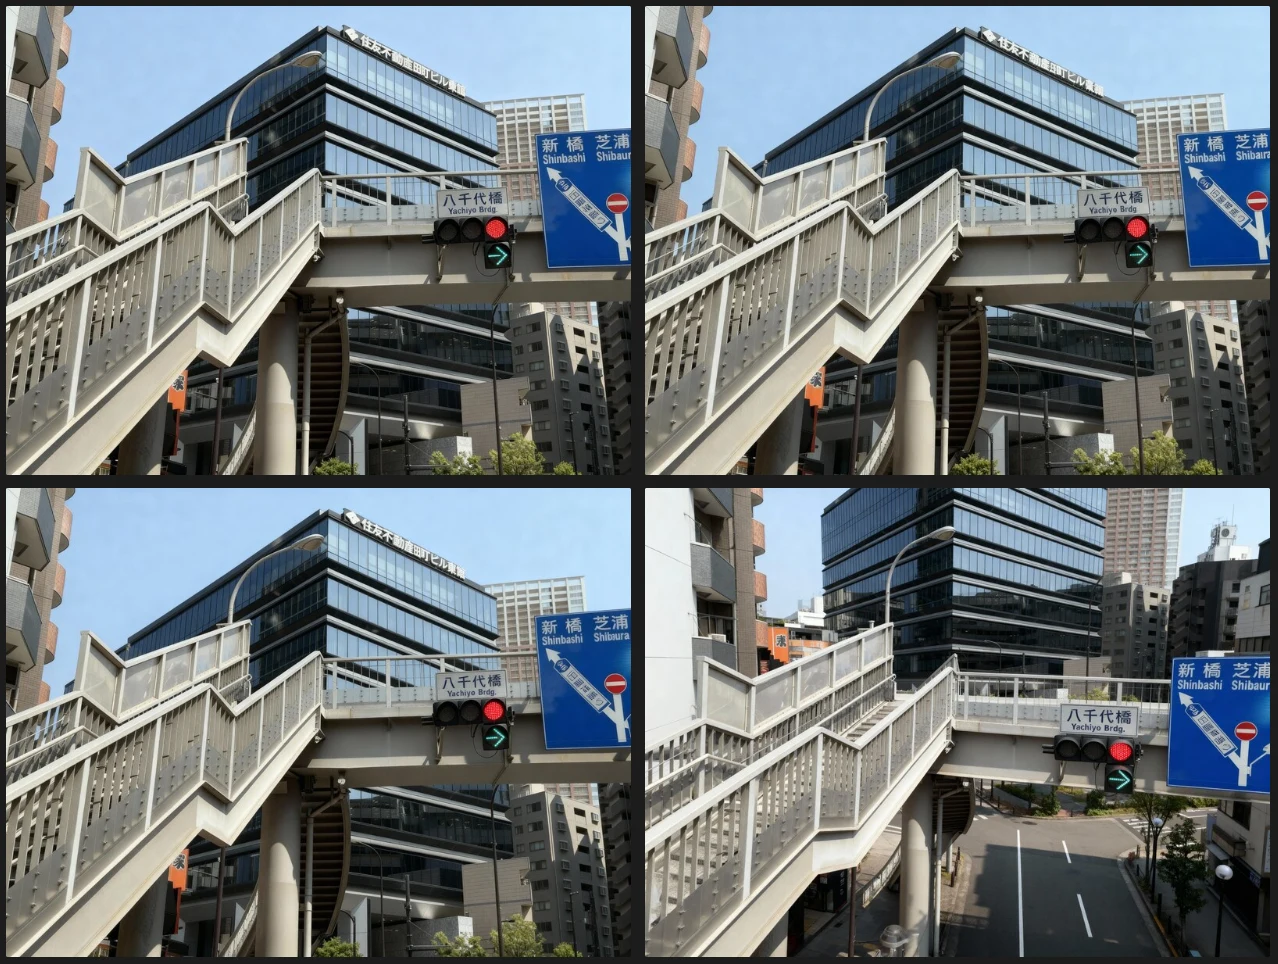
こちらはうまくできませんでした。右下はやや頑張ってみた感がありますが、ちょっと残念ですね。
英語にしてみるとどうでしょうか。
指示「Switch this image to a top-down view.」
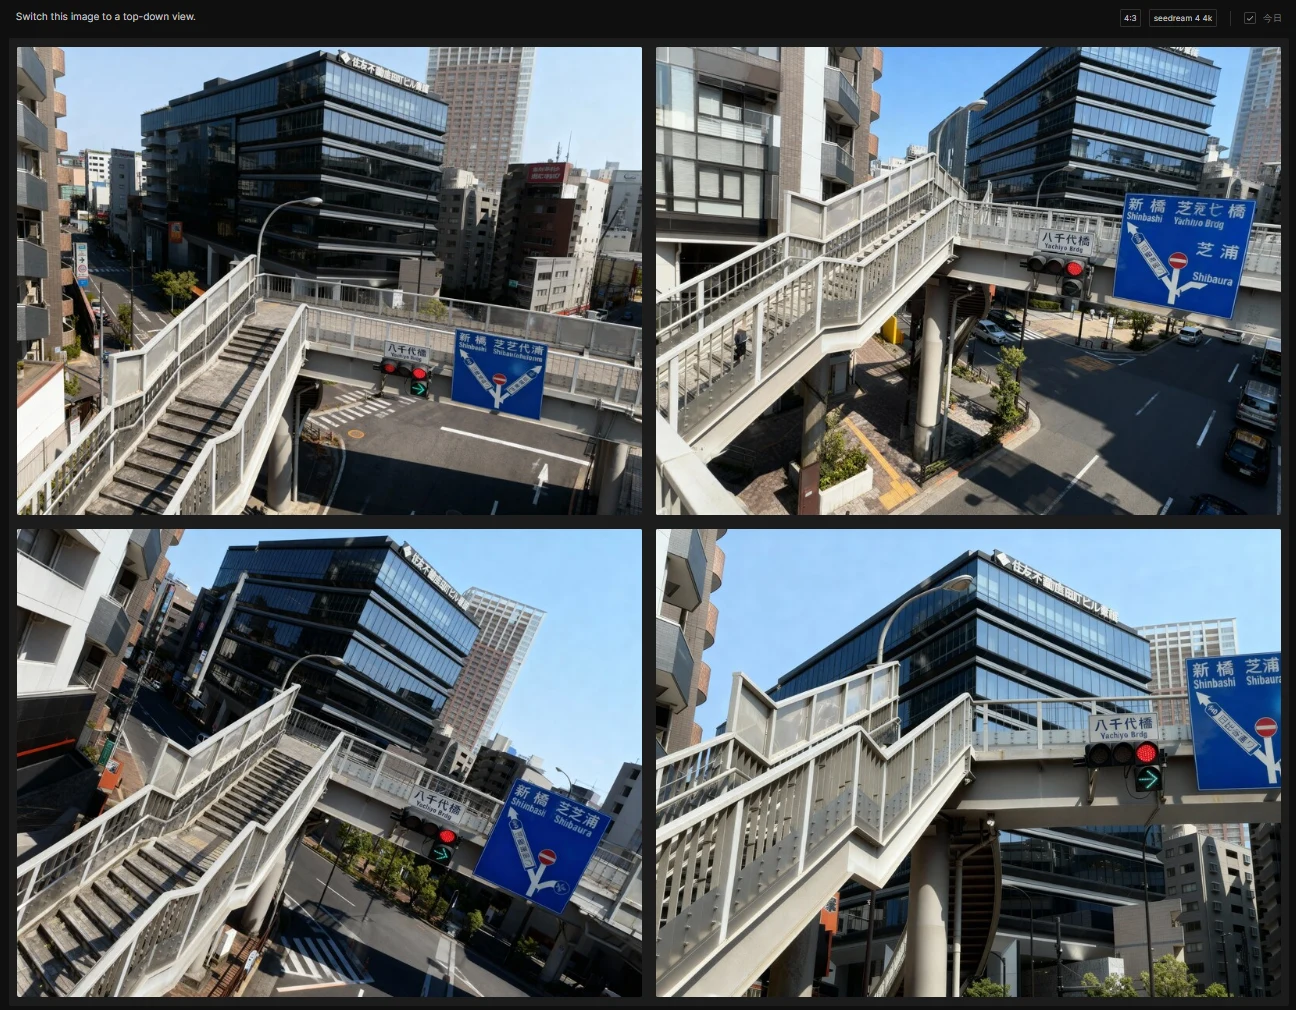
今度はやや頑張ってくれました。整合性は微妙なところですが、ガチャすればましになりそうな感じはありますね。NanoBananaより低性能というより、プロンプトのコツが多少異なるのかもしれません。
今度は、さきほど漫画調にしたものを入力して着色させてみます。
指示「着色して、美しいアニメ調にして。青空、昼」
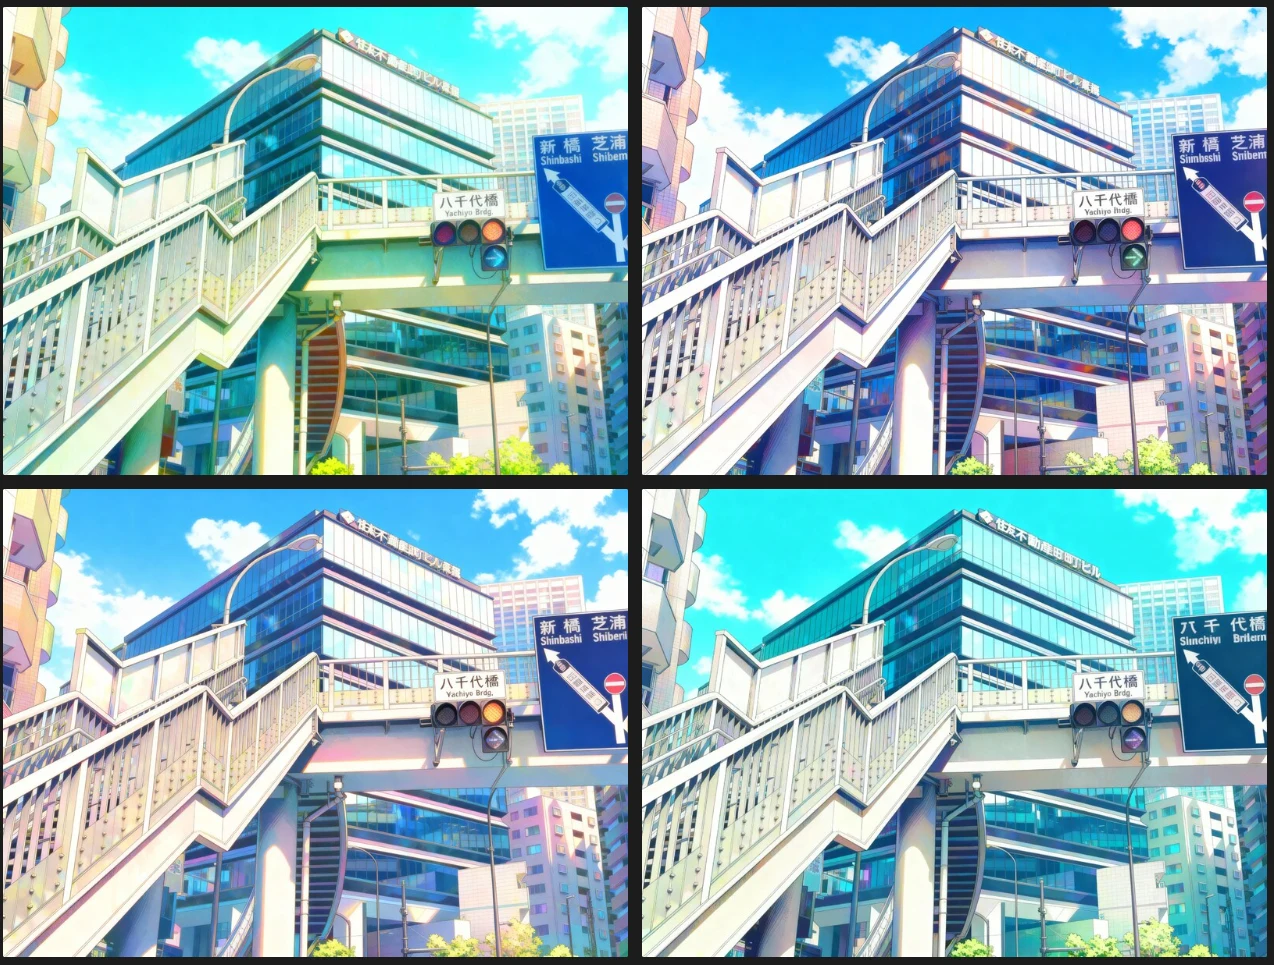
これはとてもエモい感じにできましたね。陽光や緑の映える感じ、ガラスの照り返しなど、劇場版アニメのような雰囲気です。NanoBananaはカチッとした面白味のない塗り方をしたのに対して、個性が出ています。
検証10.カメラ角度の変更
今度は、こちらのリビングのイラストを加工します。NanoBananaでやったのと同じように、夜にしたり、横方向に回転させたりしてみます。
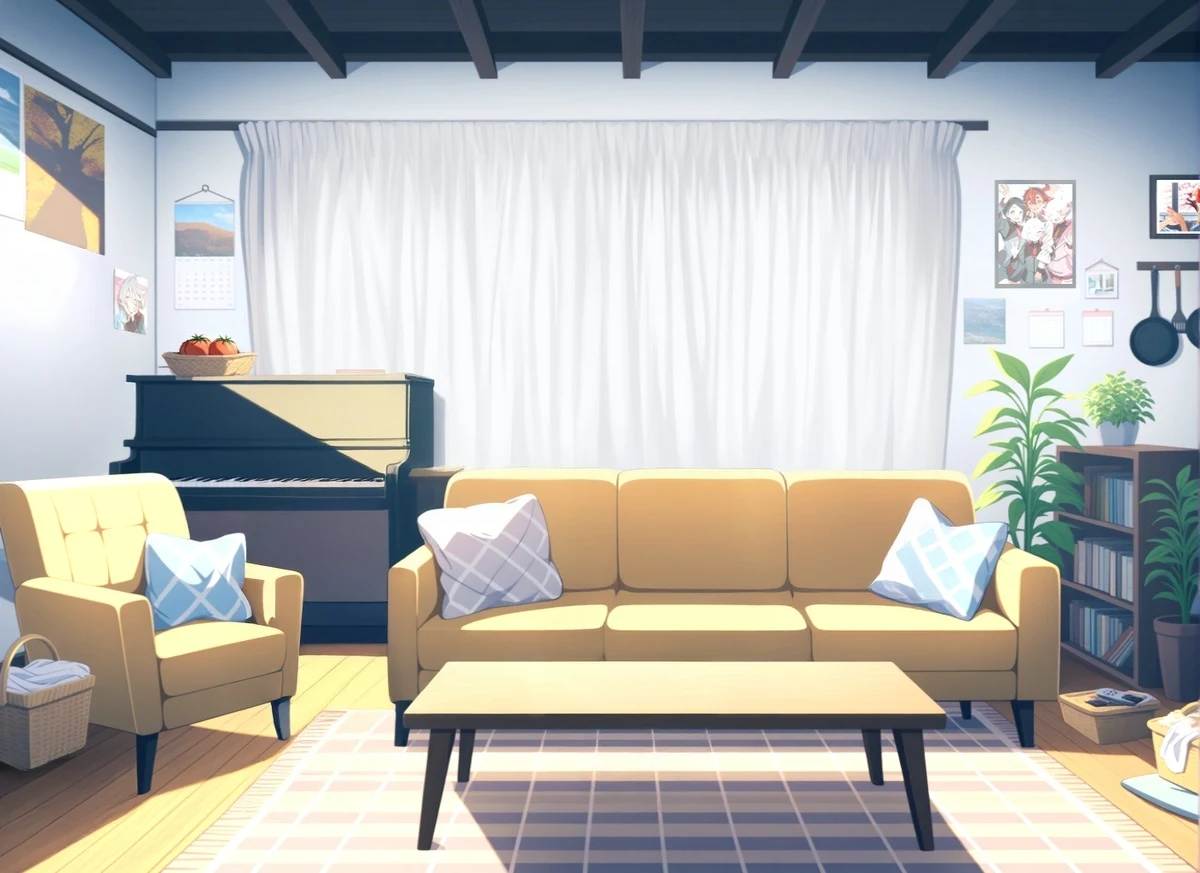
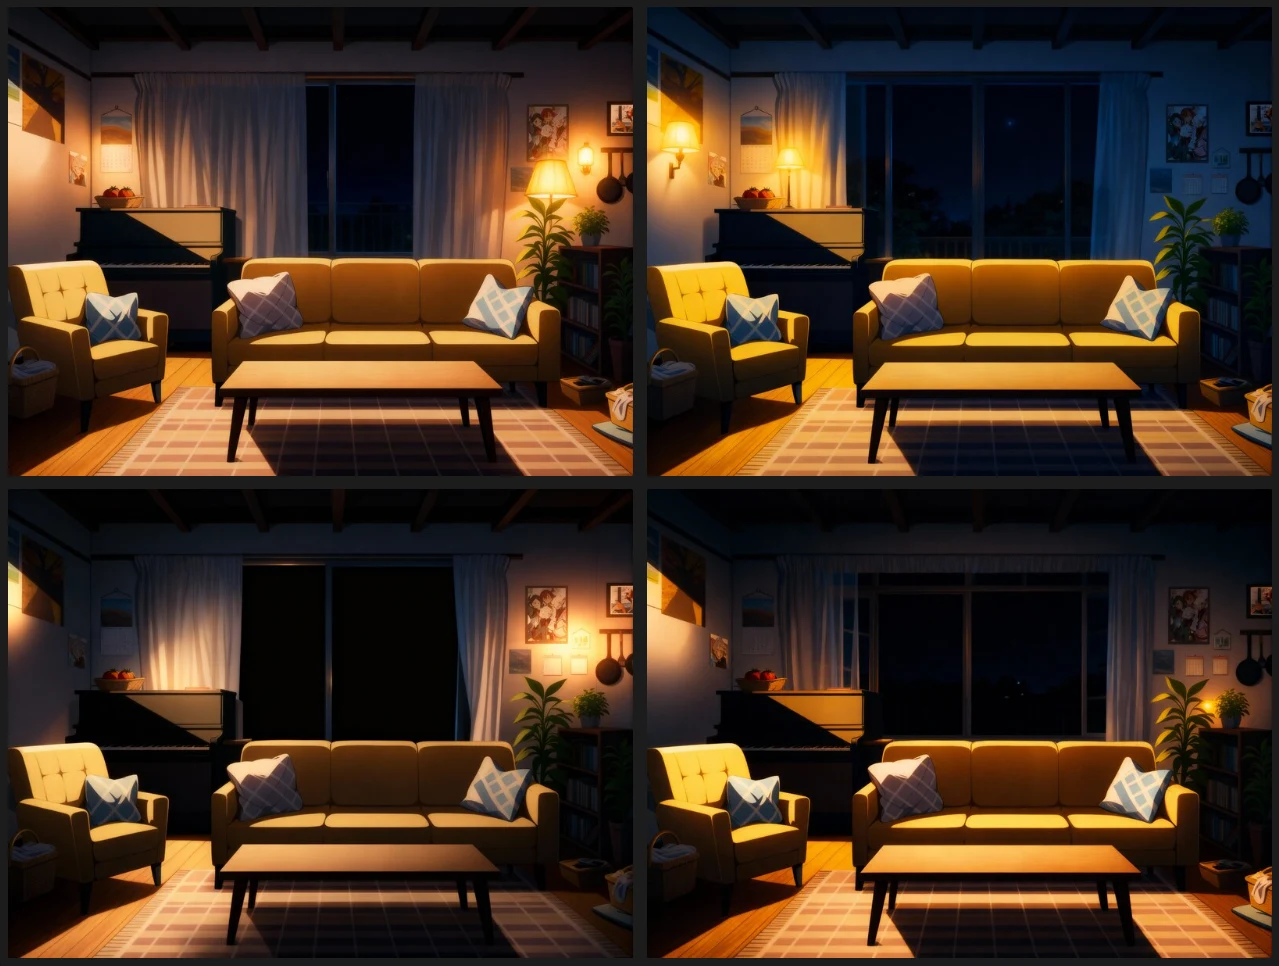
指示「夜にして」
指示「横方向に回転させて」
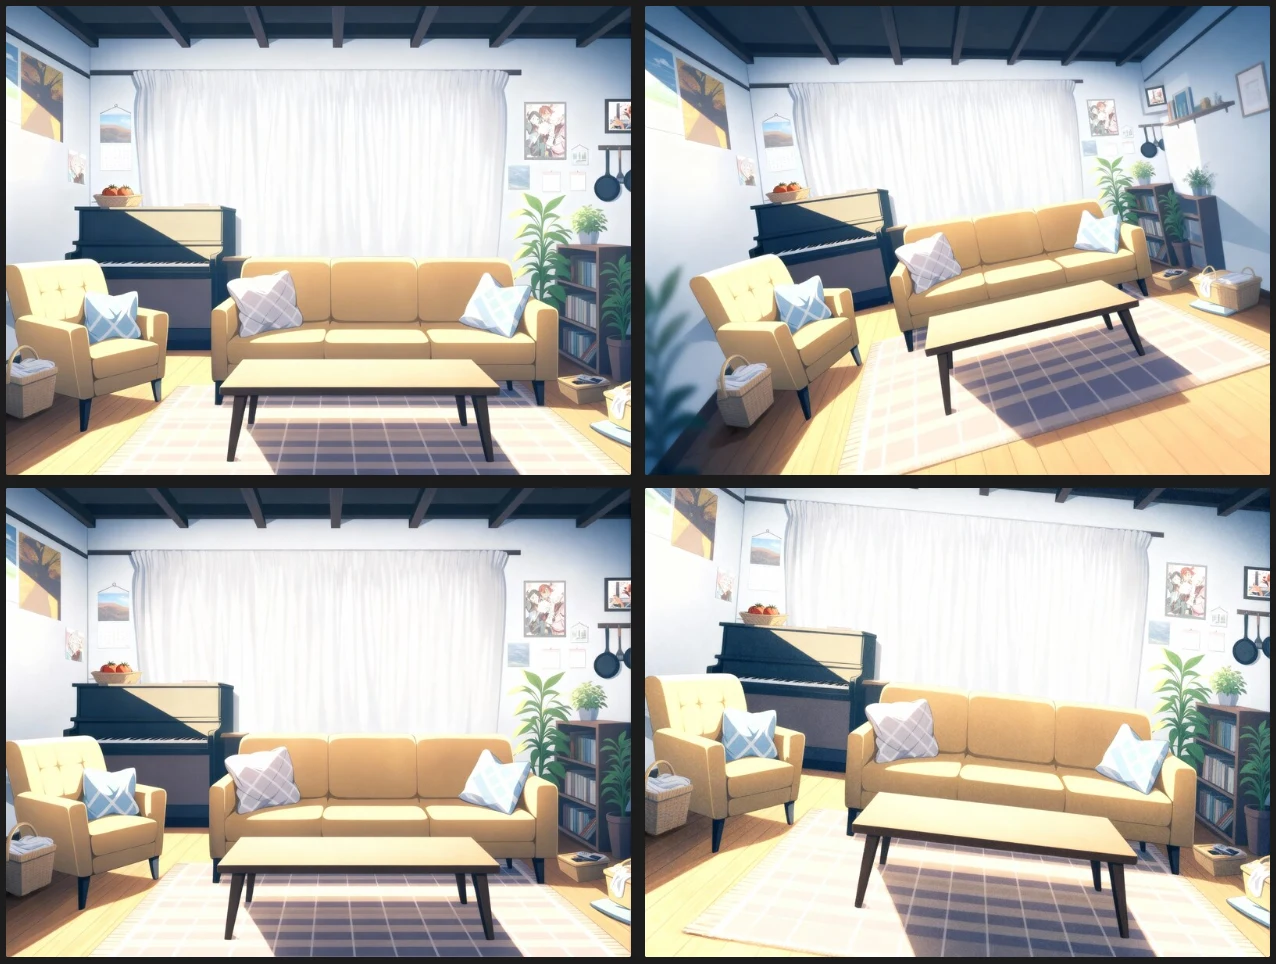
右2枚はなかなか「おっ」となる感じですね。パースが効いて、手前に緑がナメて入る感じ、映像的で美しいです。でも本当は、ターンテーブルか電子レンジのように真横に回転してほしいところ。
指示「角度を変えて。ななめ45度からのショットにして。」
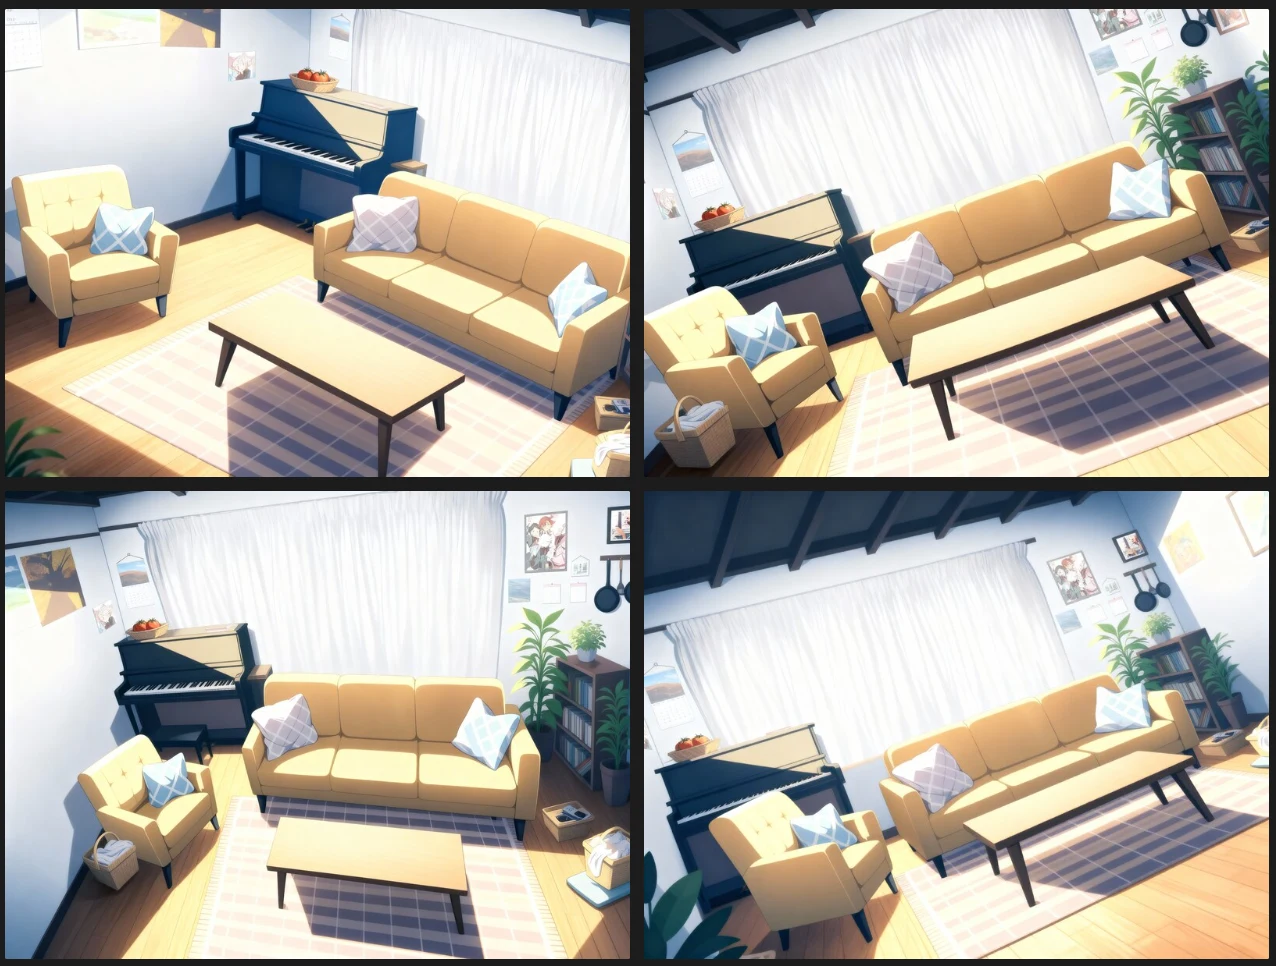
おおお、これは凄いですね。NanoBananaはこれがうまくできませんでした。ただ、「ななめ」の角度がどこから見てななめなのか混乱しているようにも見えます。
指示「camera rotate」
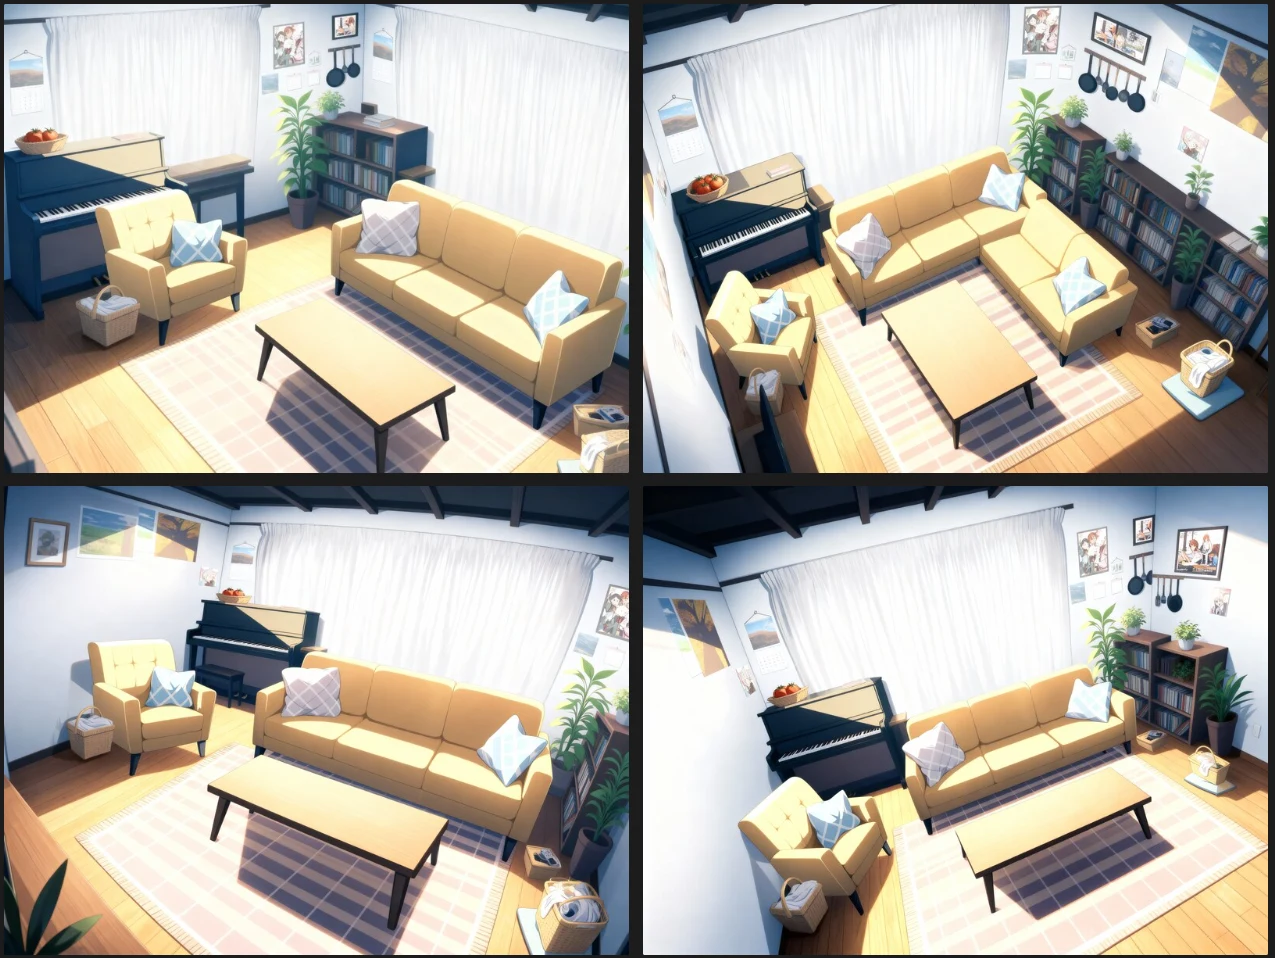
これもかなりカメラが大きく動きましたが、よく見ると家具の位置はかなり不正確ですね。より具体的に指示してみます。
指示「camera rotate to the left 45 degrees.」
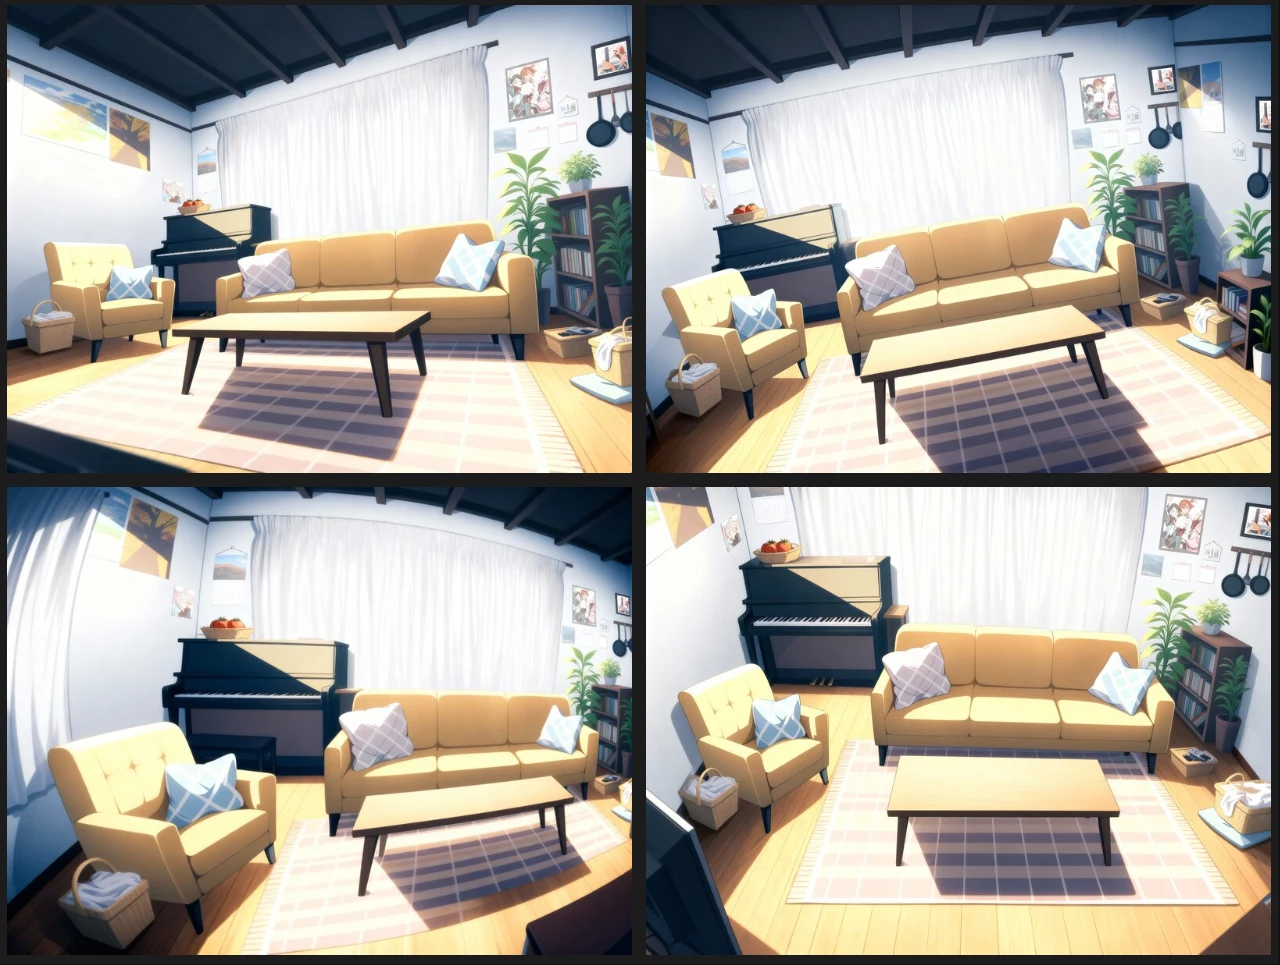
「左に45度」と指示してみましたが、かなりランダム性の高い結果になりました。また、Seedreamの特徴として、かなり魚眼チックにパースが付くような感じも見られます。あまり動かしづらかったNanoBananaに比べ、多少ランダム性はあっても動かせるように見えるので、無制限プランなら何度もガチャして条件を満たす画像が出るのを待つのもありなのかもしれません。
検証11.2コマ漫画生成
NanoBananaでも作ったこちらの2コマ漫画を、同じプロンプトでSeedreamに生成させてみます。
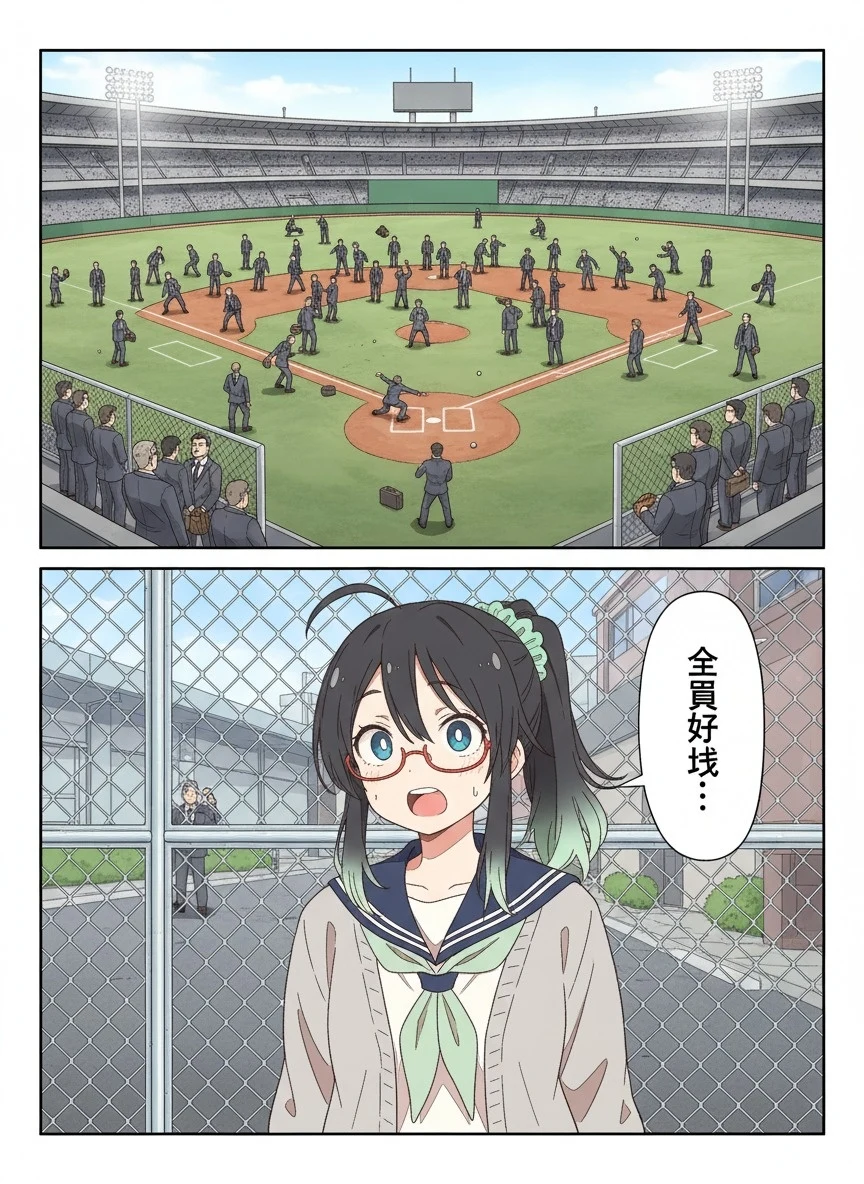
指示:@img1 の女の子を使った漫画を画像生成して。1コマ目「野球場。スーツ姿のおっさんが無数にグラウンド内にいる。バットを持ったりグラブを着けたりしている」2コマ目「それを金網の外から眺める通りすがりの女の子。汗をたらりと垂らして、横に心の声「全員野球…!」
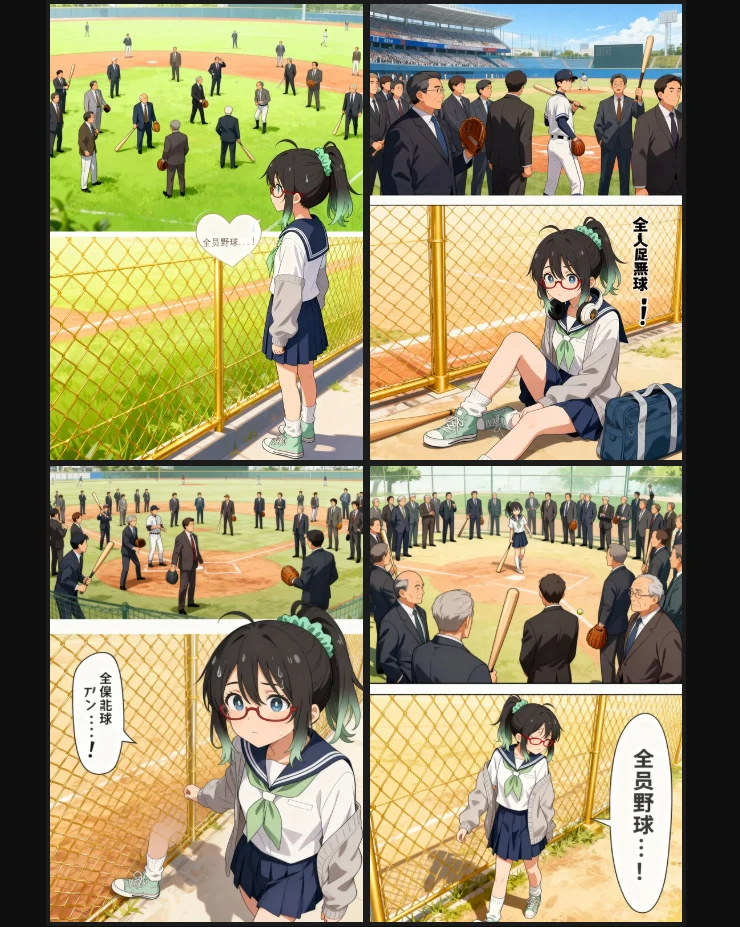
うーんこれはなんというのでしょう…。上下2コマにはできていますし、ぶちぬきもできていて漫画は理解しているようなのですが、なんとなく「文脈の不在」を感じます。
なんとなくSeed値によってはなんとかなる感も覚えたので、もう一度トライ。
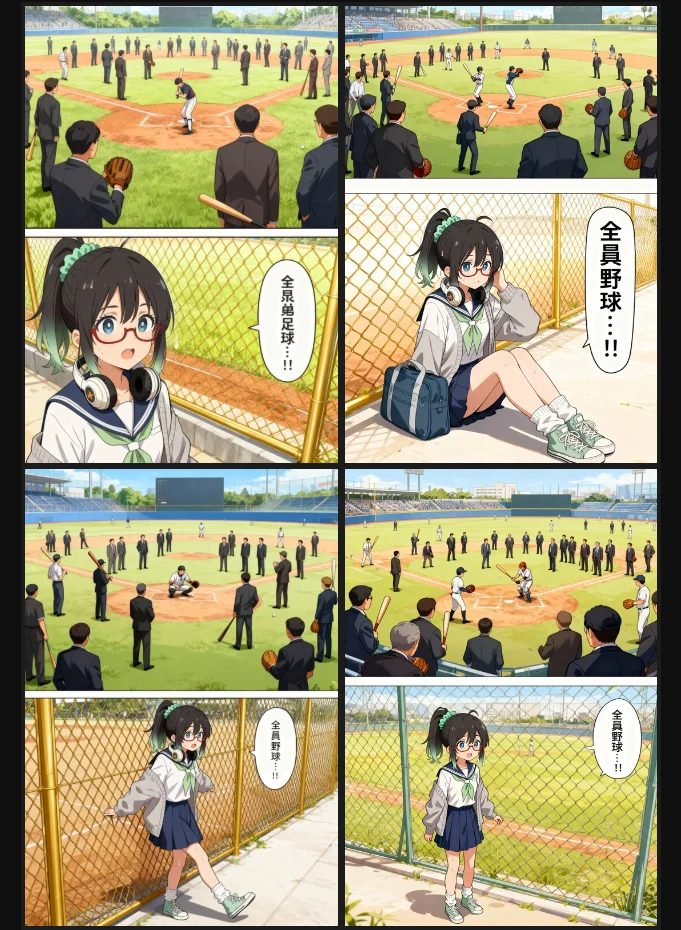
これは、プロンプト自体の条件は満たしているような気もします。もう少し厳密にプロンプト指示を詰めていけば、結構それらしいものができてしまうような。ただ、野球のユニフォームを着ている選手が出てしまったり、球場の中を見ていなかったりすると、やはり意味不明になってしまいますね。今度はプロンプトを詳しくしてみました。
指示「@img1 を使った漫画を画像生成して。1コマ目「野球場。スーツ姿のおっさんが数十人グラウンド内におり、バットを持ったりグラブを着けたりしている。全員真剣な表情」 2コマ目「その野球場の金網の向こう側にいる女の子。金網をつかみ、眼を見開いて驚いた表情。汗をたらりと垂らして、横に心の声「全員野球…!」」
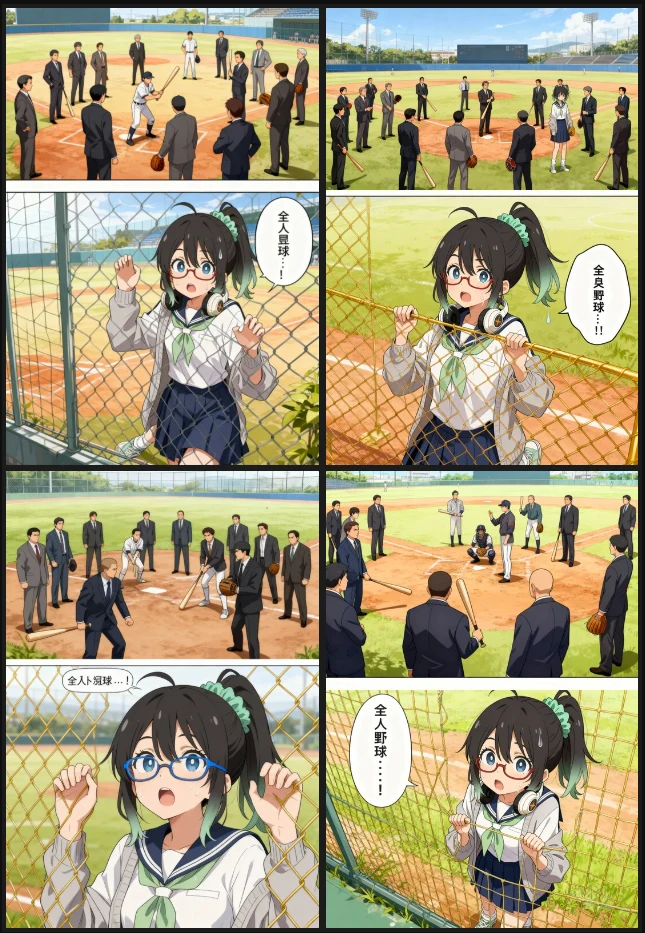
うーん、やはりさまざまな不都合が生じてしまっていますが、ミナちゃんを金網の向こうからこちらを見せることはできました。しかし、どうしてもユニフォーム姿の人が混じるなど、うまくいきませんね。このあたりはGPTやNanoBananaの理解力に軍配が上がるところかなと思います。(また、ミナちゃんの肩のおかしさはずっと再生産され続けていますね)
検証12.POSEMANIACSでポーズ指定
複数画像参照で、キャラクターの一貫性を保持しつつ複雑なポーズを取らせることができるかを検証しました。NanoBananaのときと同様「ポーズマニアックス」さんのポーズモデルを使わせて頂き、実験してみることにします。
指示はこちら。
生成結果はこちらです。
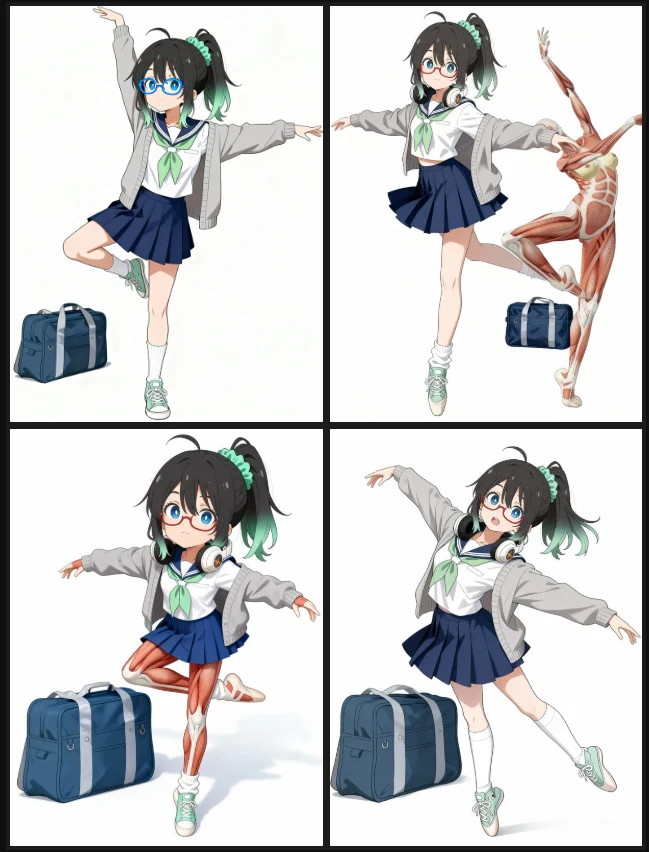
うーん!という感じですね。さきほど私のヘタなラフを渡したときと同様、どうもバレエのポーズを取っているらしいという情報は得たようですが、具体的にどのようなポーズかまでは読み取れていないように見えますし、うち2枚は人体模型とフュージョンしてしまいました。
検証13.LoRA用画像バリエーション
今度はこちらの鬼怒川さん(オリキャラ)の画像から、LoRAを作れるようなバリエーションを一貫性を持って生成できるか試してみます。
▶【2025/10/06追記】Freepikの規約(Terms of Use)上、AI生成物(Output)を別の生成AIモデルの学習に使用することは禁止となっていました。残念…。
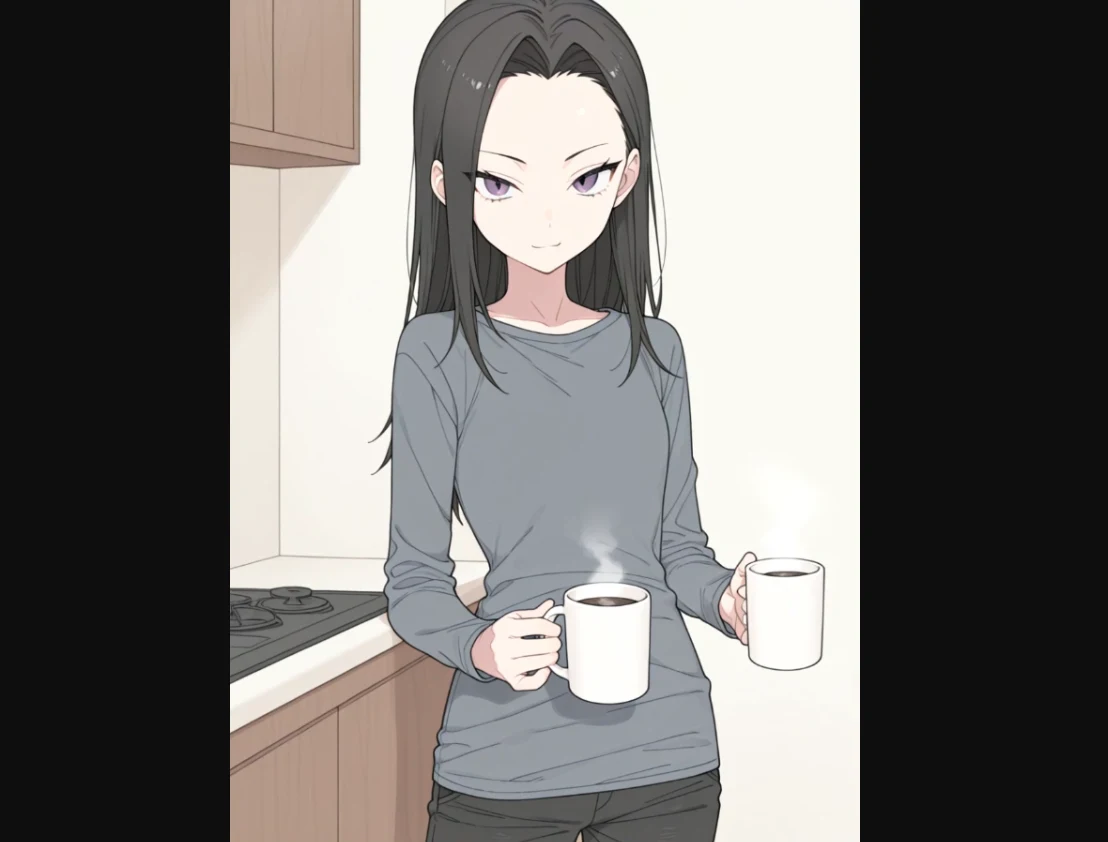
Seedream4.0は同キャラの複数画像を読み込ませることでより一貫性を保てるようですが、まずはこの一枚絵しかない状況と仮定して、3面図を作ってもらいます。見切れてしまわないよう、画像サイズは4:3の横長にします。
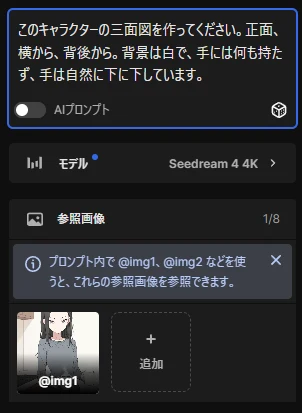
こちらが生成結果。
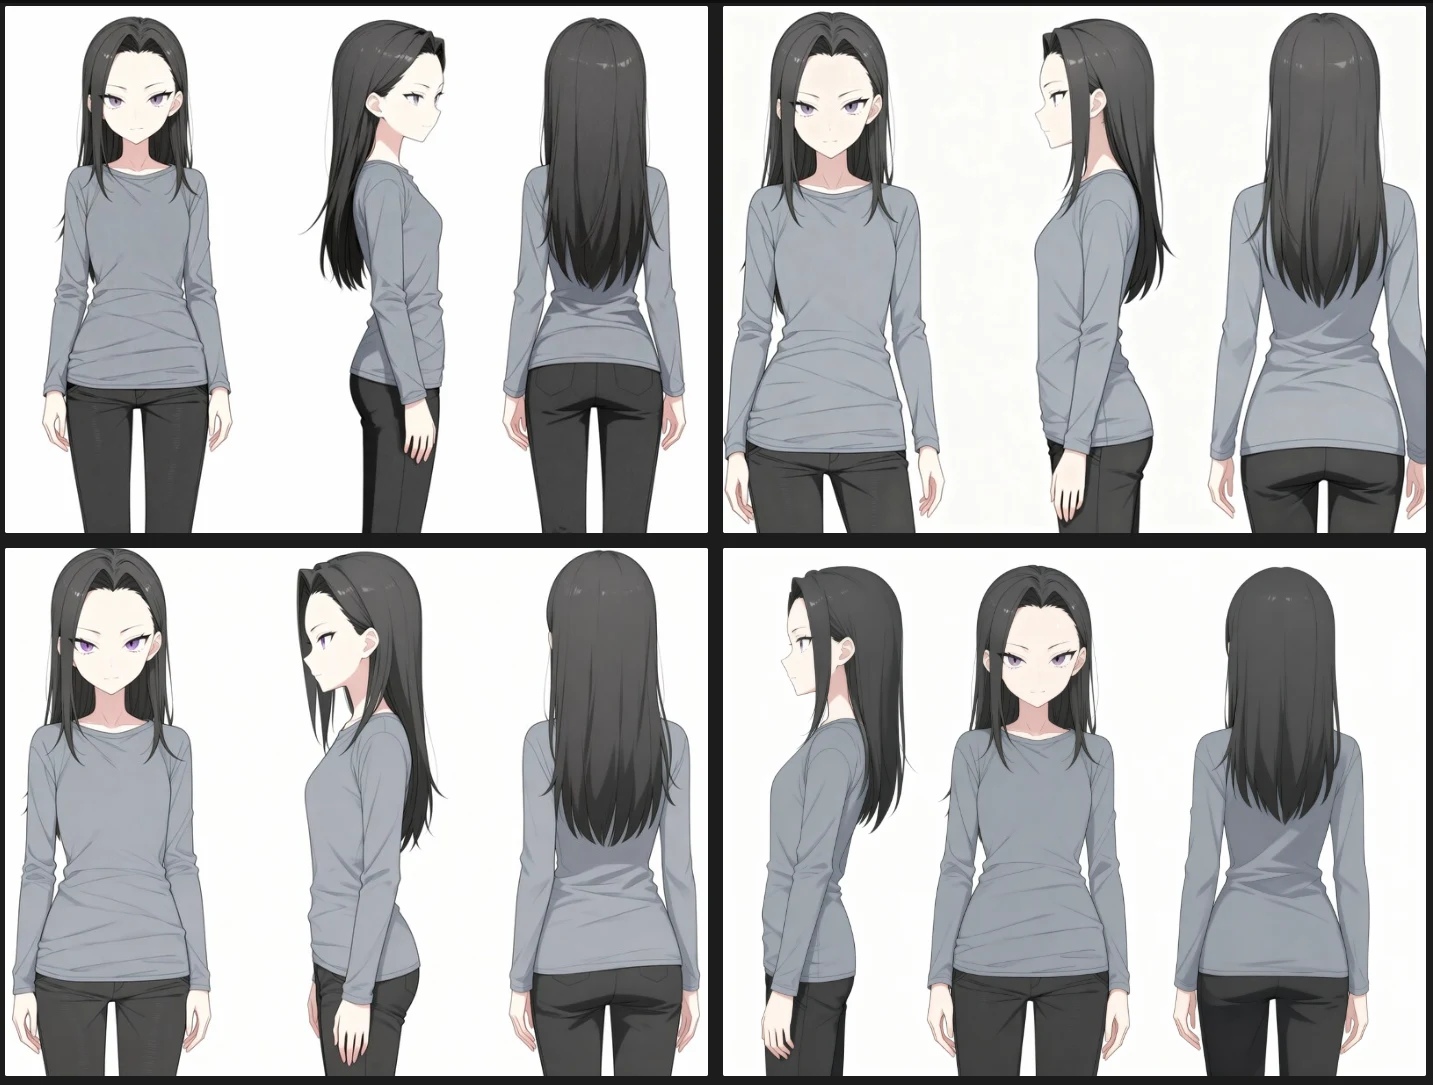
これはすごいですね、非常に一貫性が保てているように見えます。1枚絵で比べると、NanoBananaよりも明らかに一貫性が上です。特に左下などは、左右非対称の横髪(向かって左はそのままおろし、右は耳に掛けている)がどのような位置関係になるが、正しく描画できています。
さきほどは「全身の」と入れるのを忘れていたので、うまくできた左下の画像を加え、下図のように指示してみました。
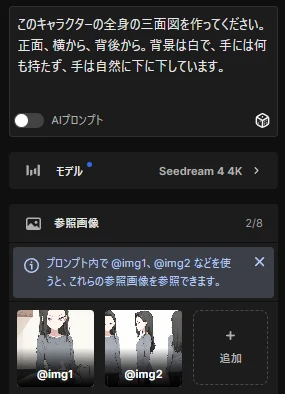
ところが、むしろ画像2に引っ張られてしまい、このような失敗画像になってしまいました。やはり生成したい画像に近すぎるものを与えると、Seedream4.0はそこから離れがたくなってしまうのかもしれません。
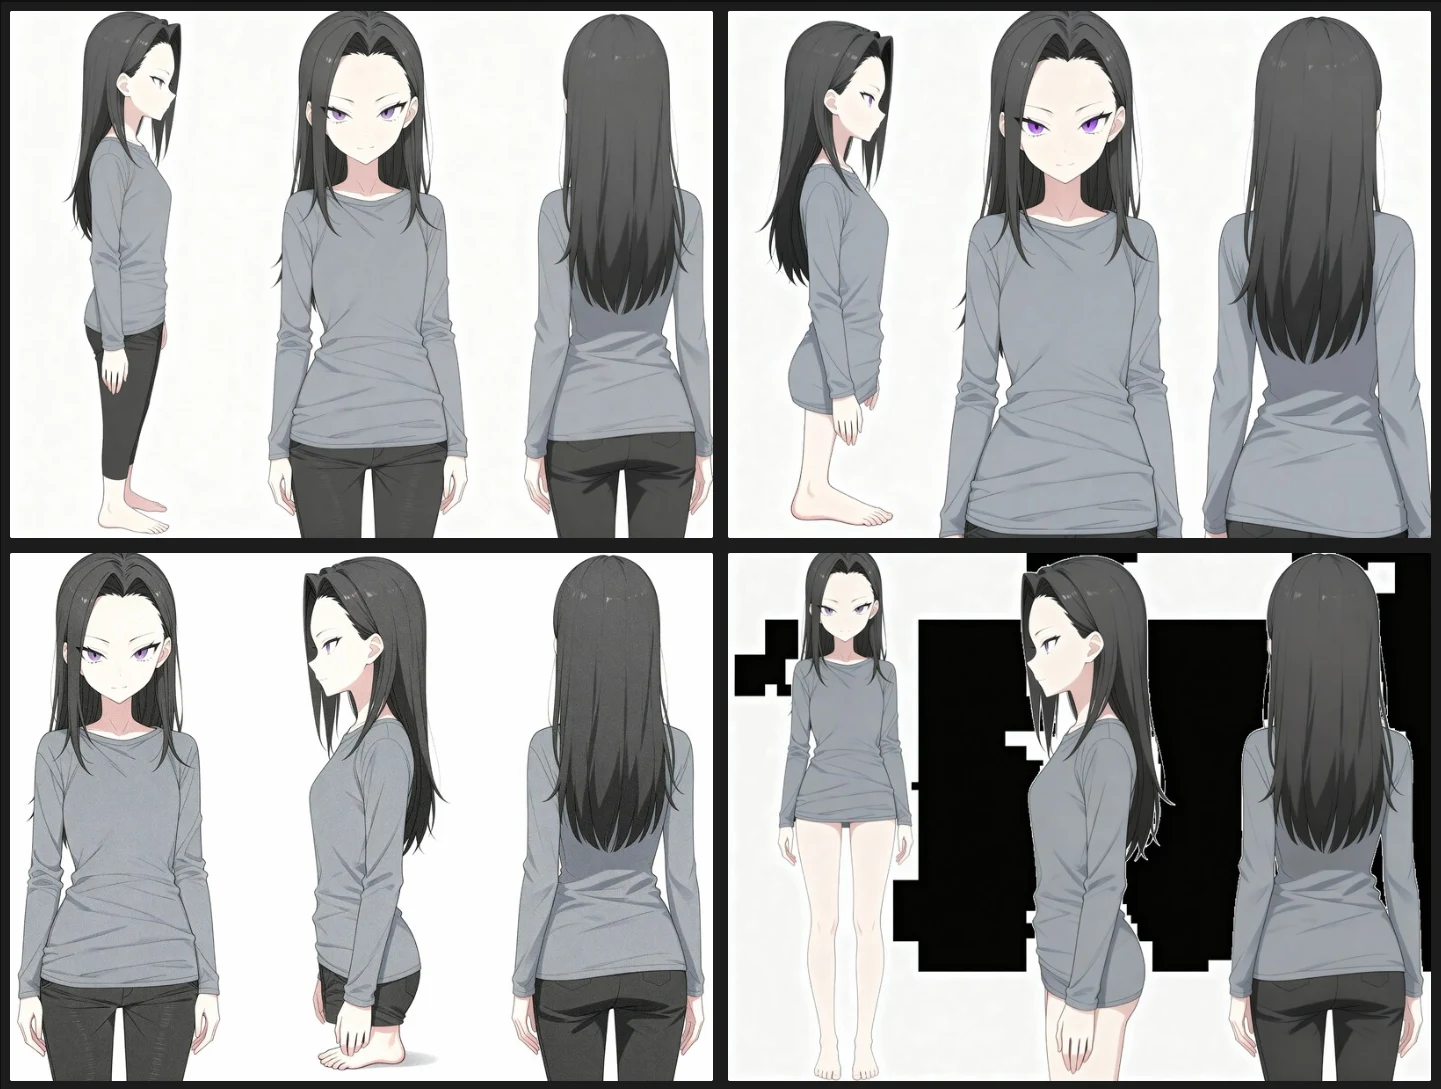
そこで、今度は3面図をあえて外して、3枚ほど鬼怒川さんの画像を与えてみました。
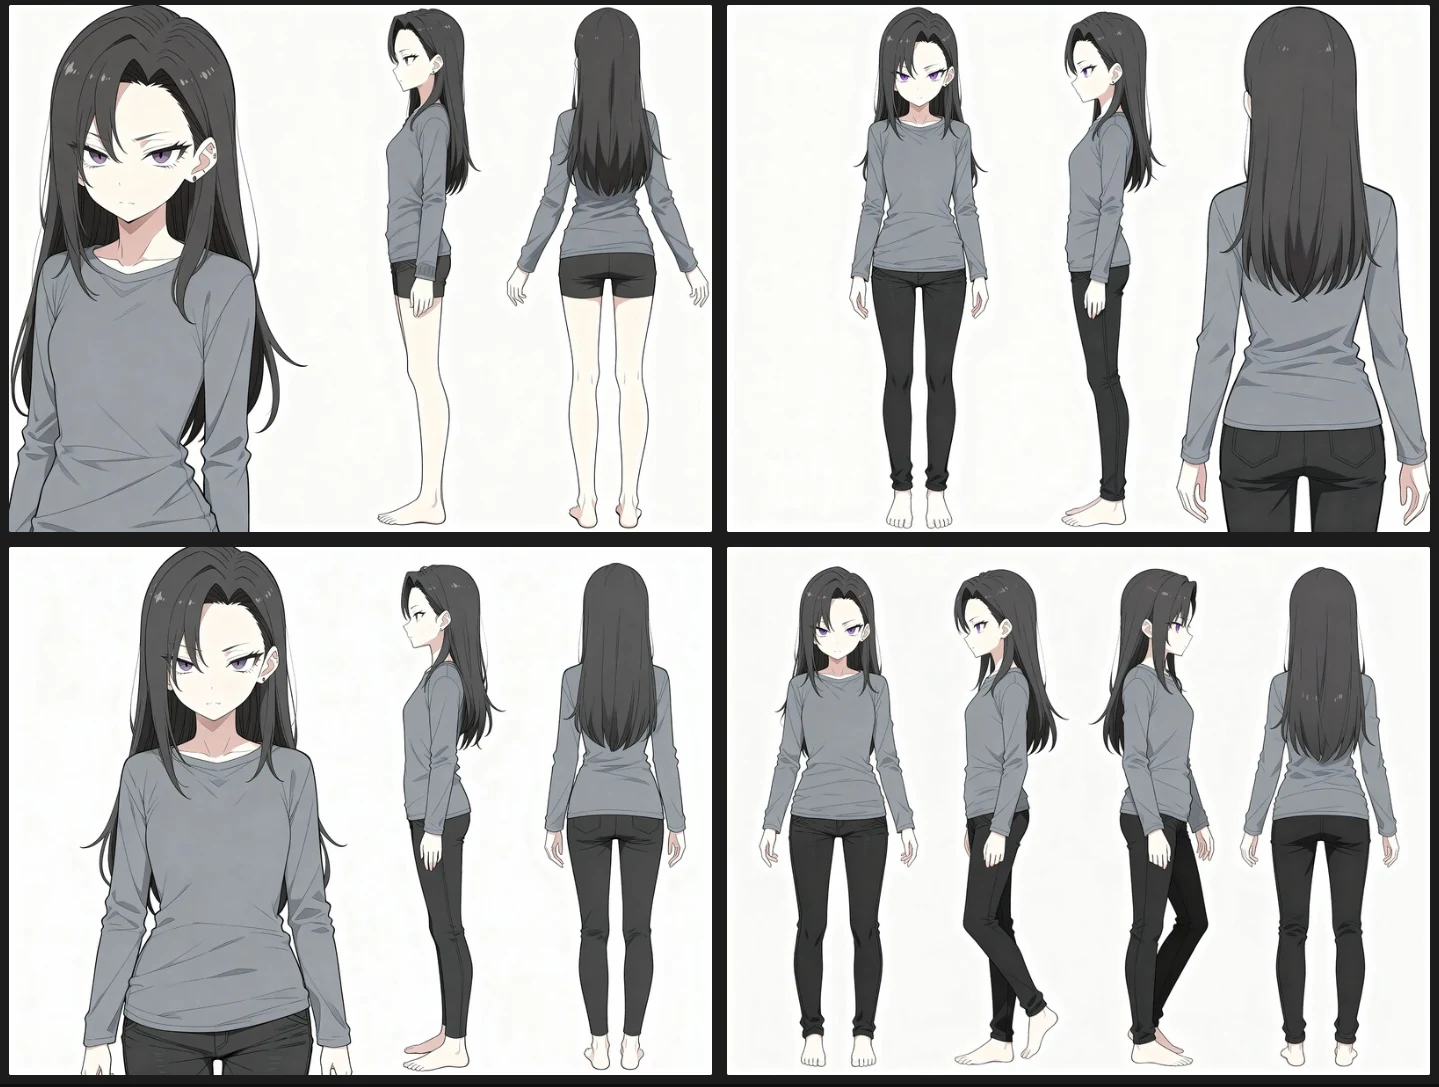
すると、このように全身図を描くことができました。一貫性も文句なしで、左右からのショットで左右非対称の横髪が完璧に描画できています。「はだし」とだけ書いたのでスパッツになってしまいましたが、服装は指示すればなんとかなりそうですね。
次のようにプロンプトを変更します。
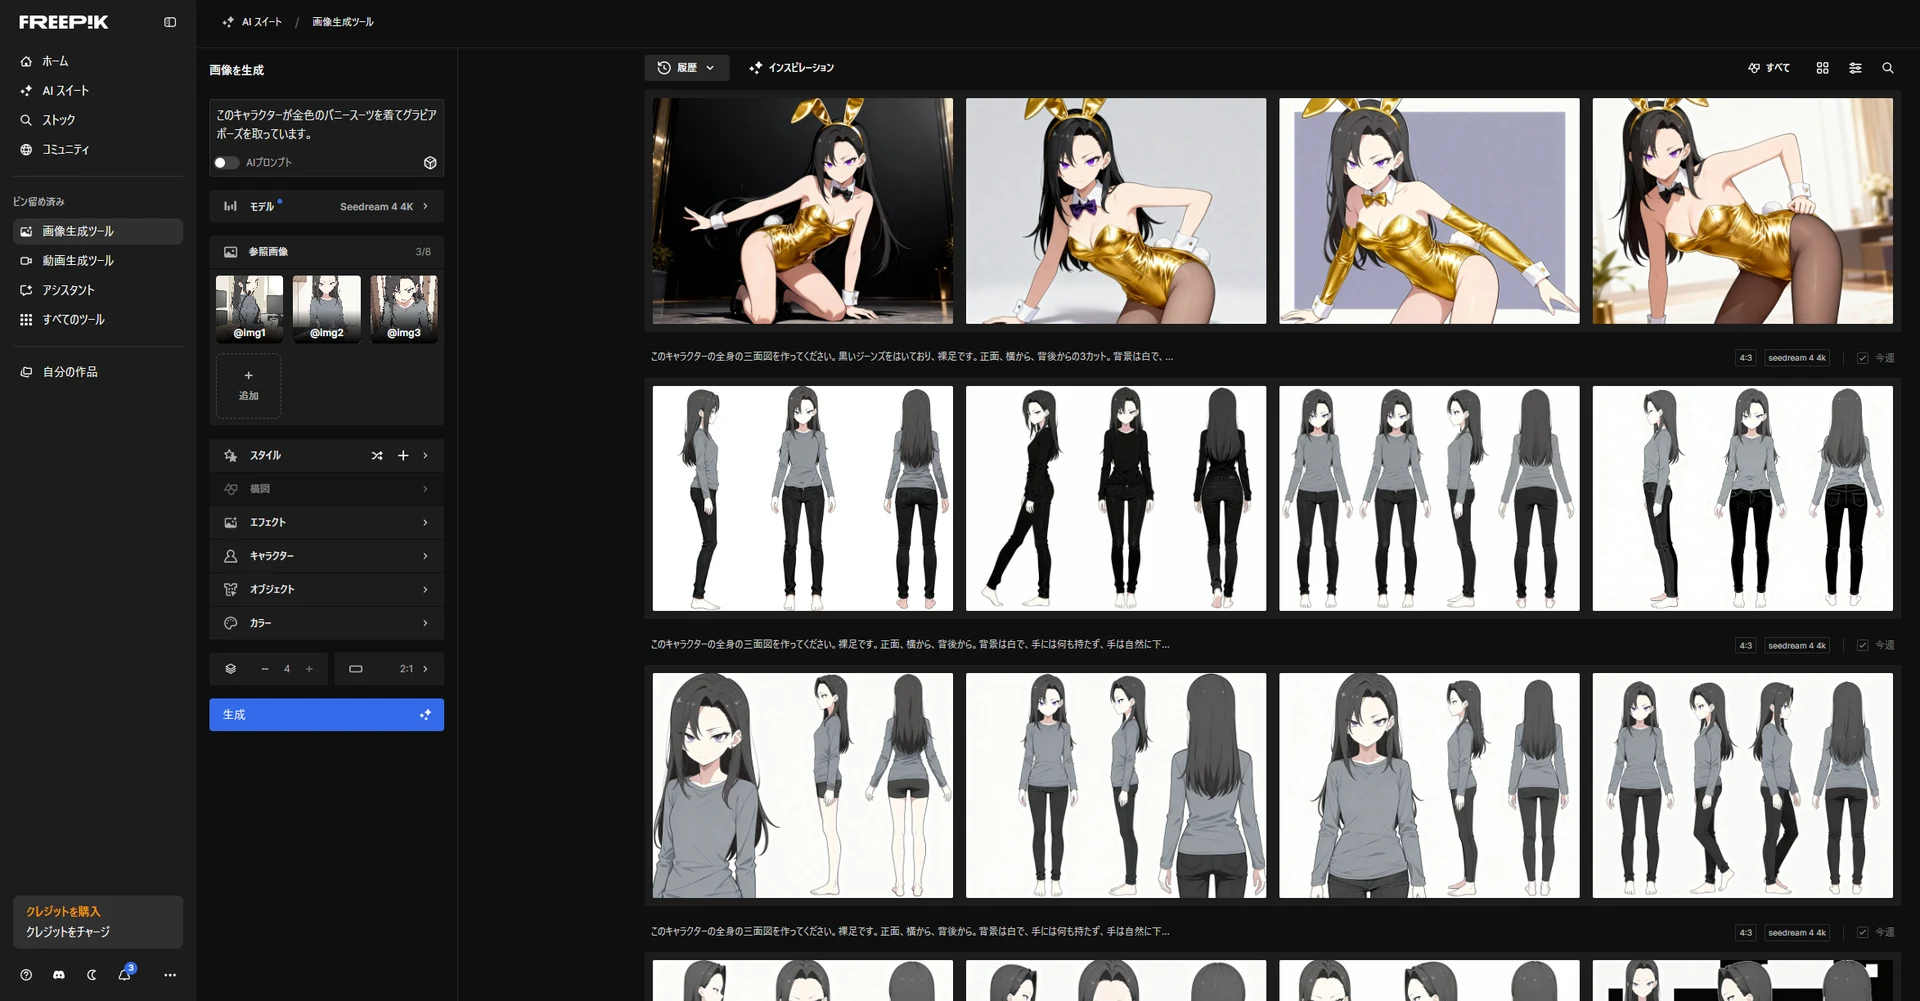
指示「このキャラクターの全身の三面図を作ってください。黒いジーンズをはいており、裸足です。正面、横から、背後からの3カット。背景は白で、手には何も持たず、手は自然に下に下しています。」
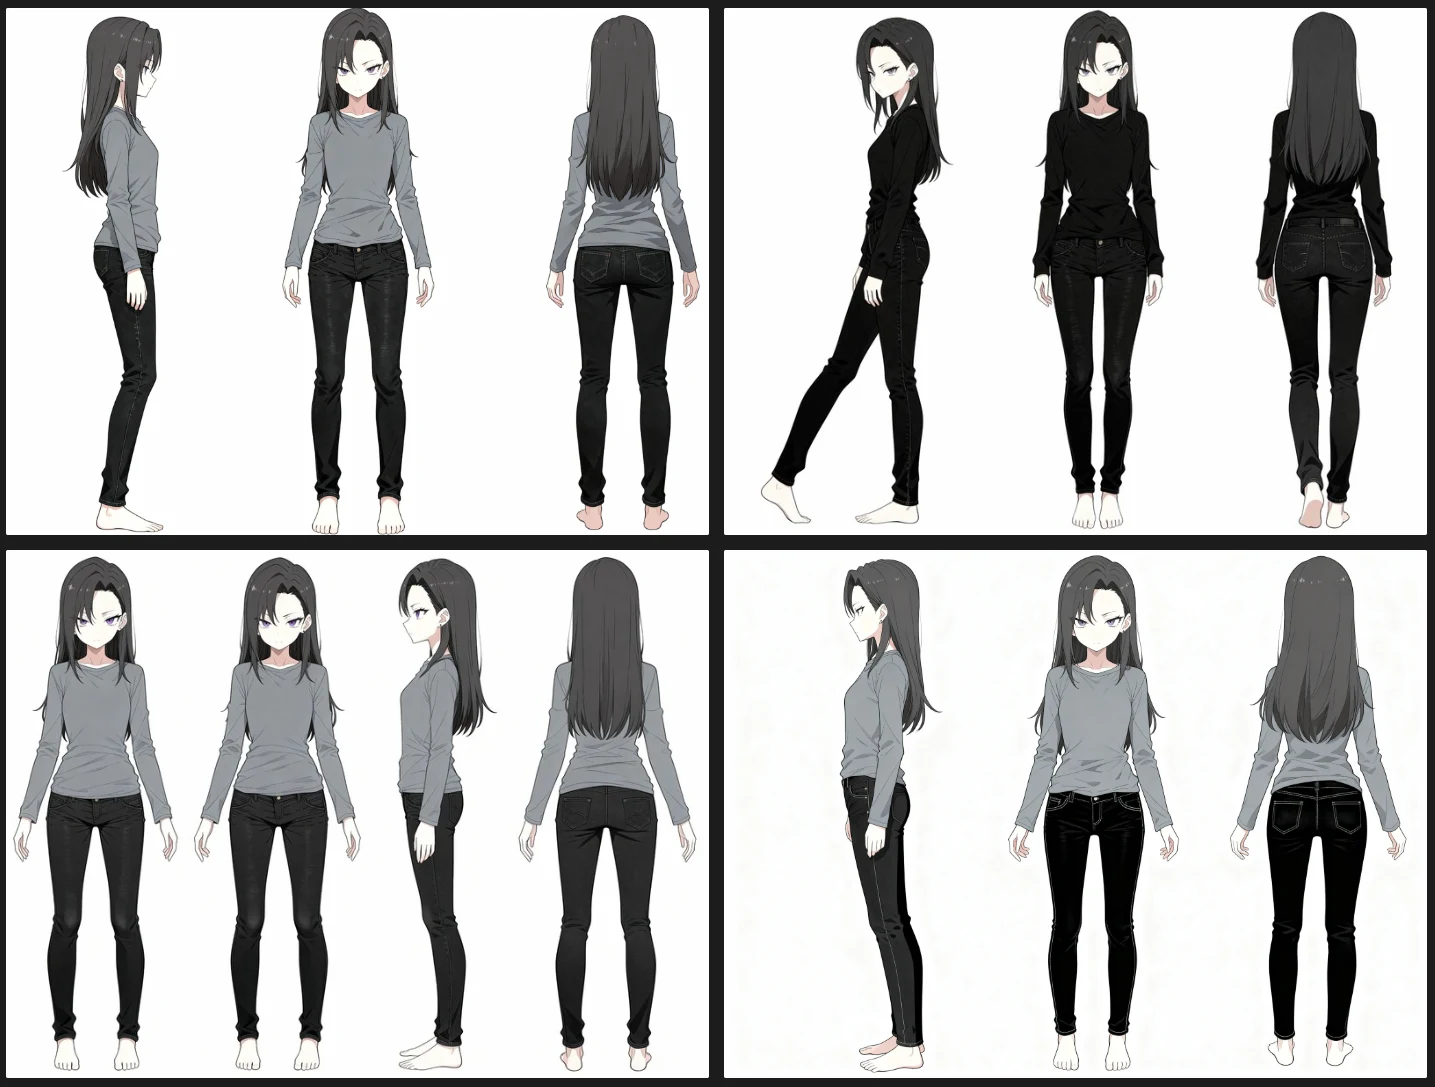
今度は元画像よりジーンズらしくなってしまいました。しかし、これはこれでかわいいですね。右上はシャツまで黒くなってしまいましたが、ともかくどのカットも「鬼怒川さんだ!」と思える一貫性が保たれており、ここまで試した工程のなかで最も得意な作業に思えます。
Seedreamはやはり1キャラクター複数枚を入力しての画像編集作業が得意とみて、いろいろと試してみました。入力画像は先ほどと同じ3枚です。
指示「このキャラクターが金色のバニースーツを着てグラビアポーズを取っています。」
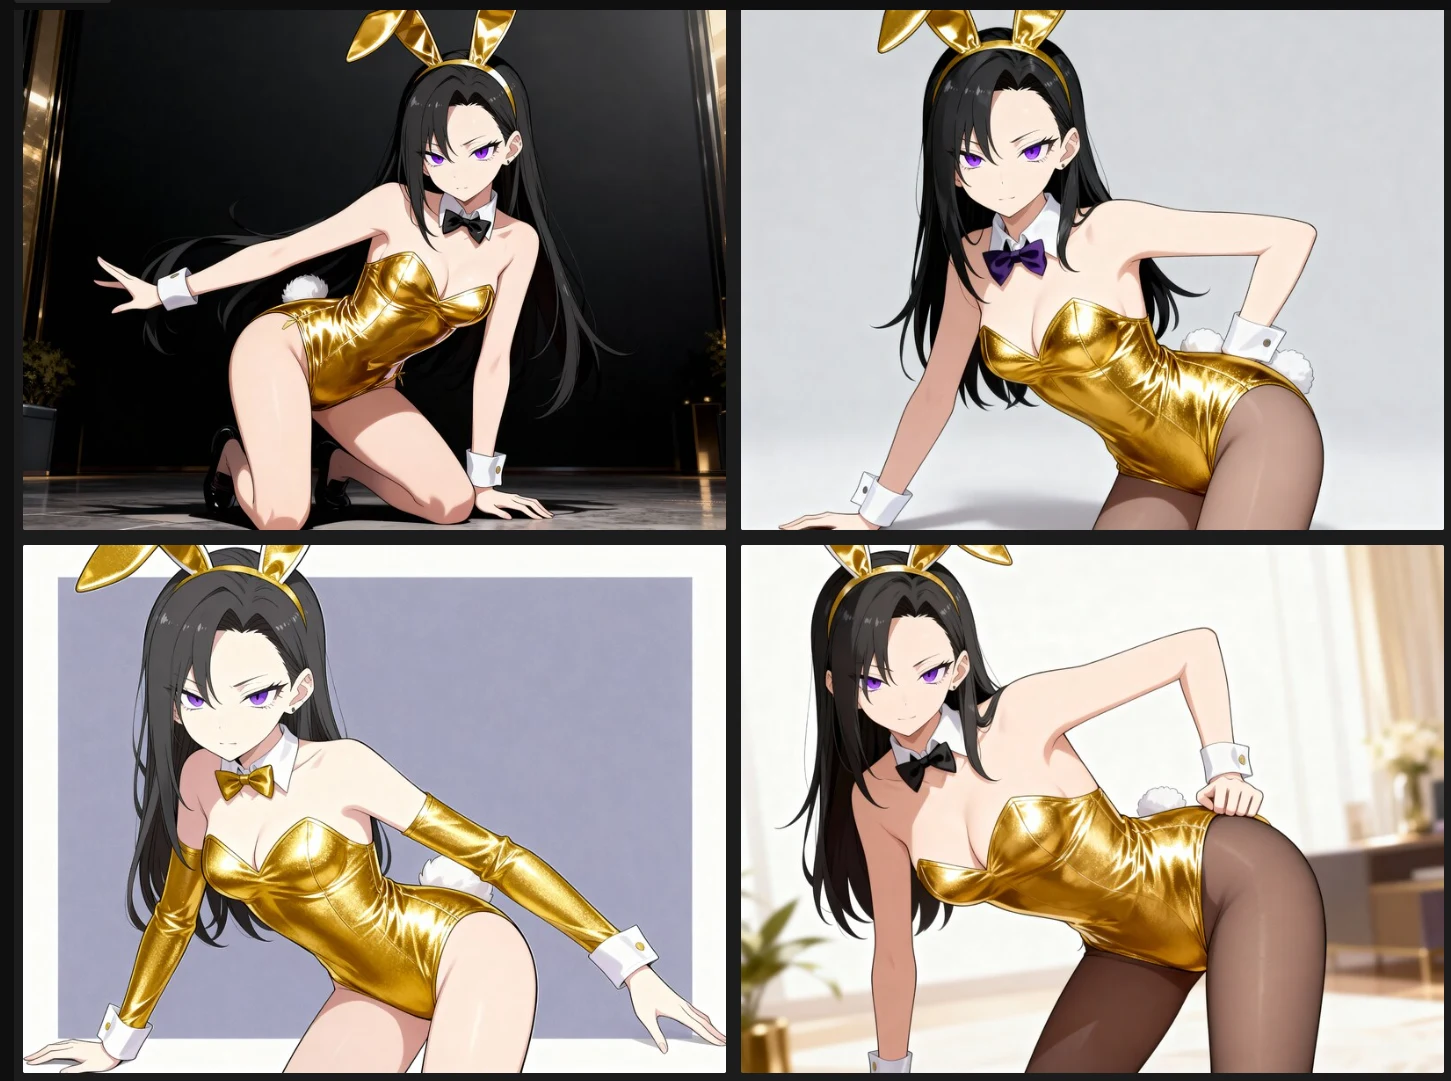
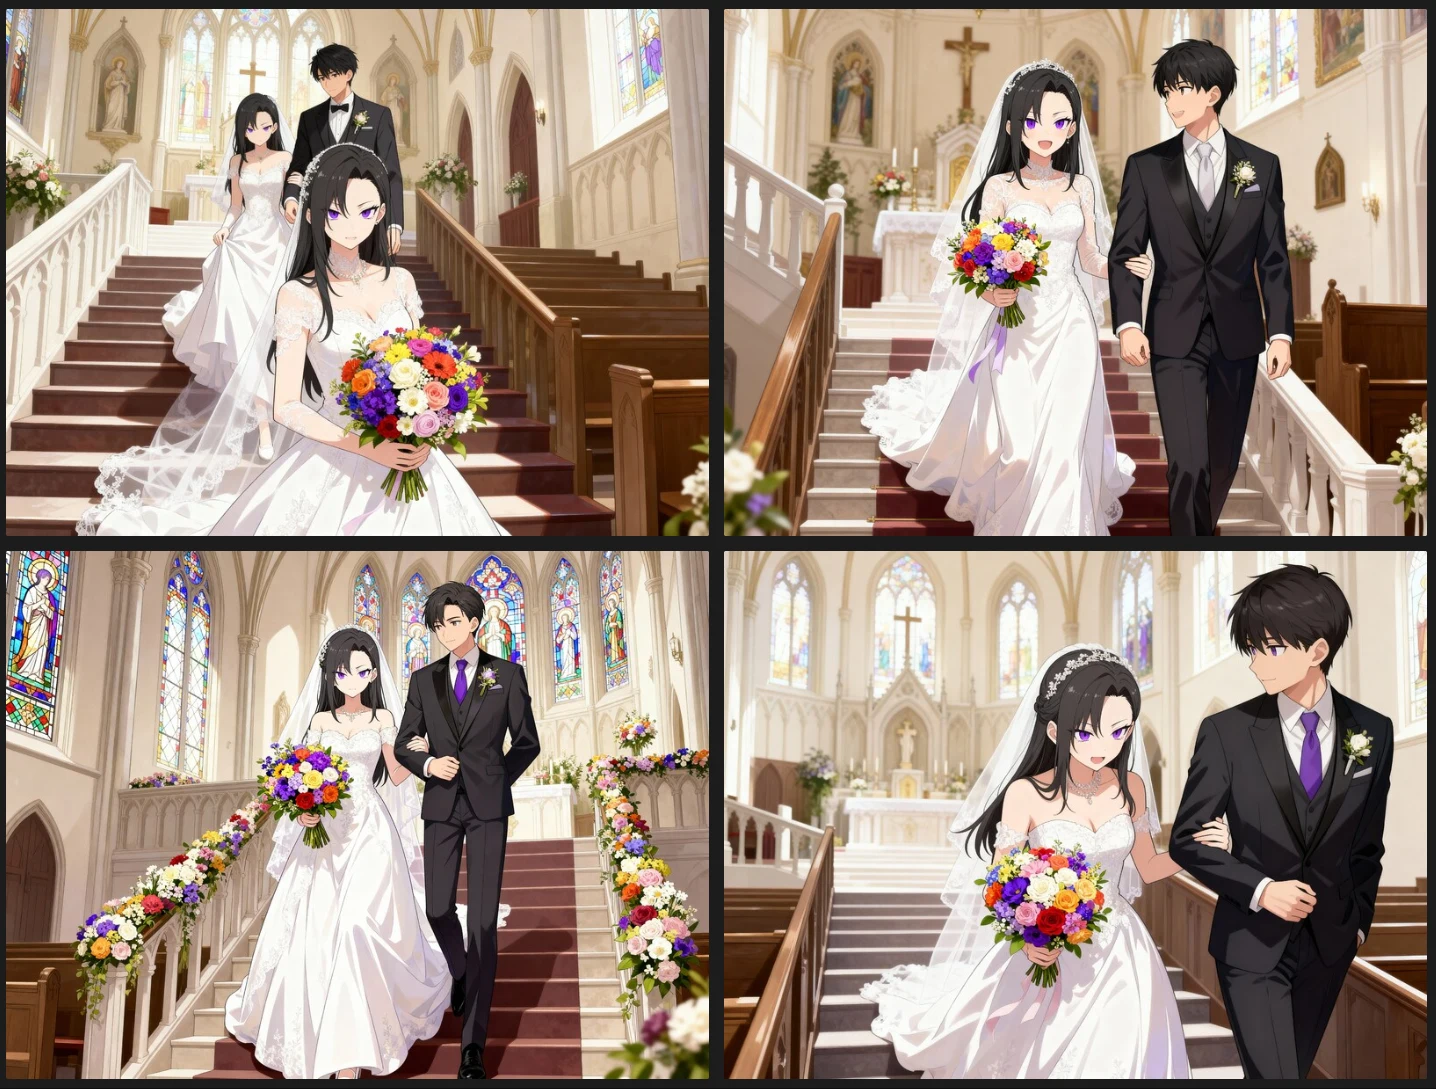
指示「このキャラクターがウェディングドレスを着ています。色とりどりの花束を持って、教会の階段を新郎とともに降りてきます。幸福感に満ちたイラストです」
指示「このキャラクターがメイド服を着て不機嫌そうにこっちをにらんでいます。背景はメイド喫茶です。」
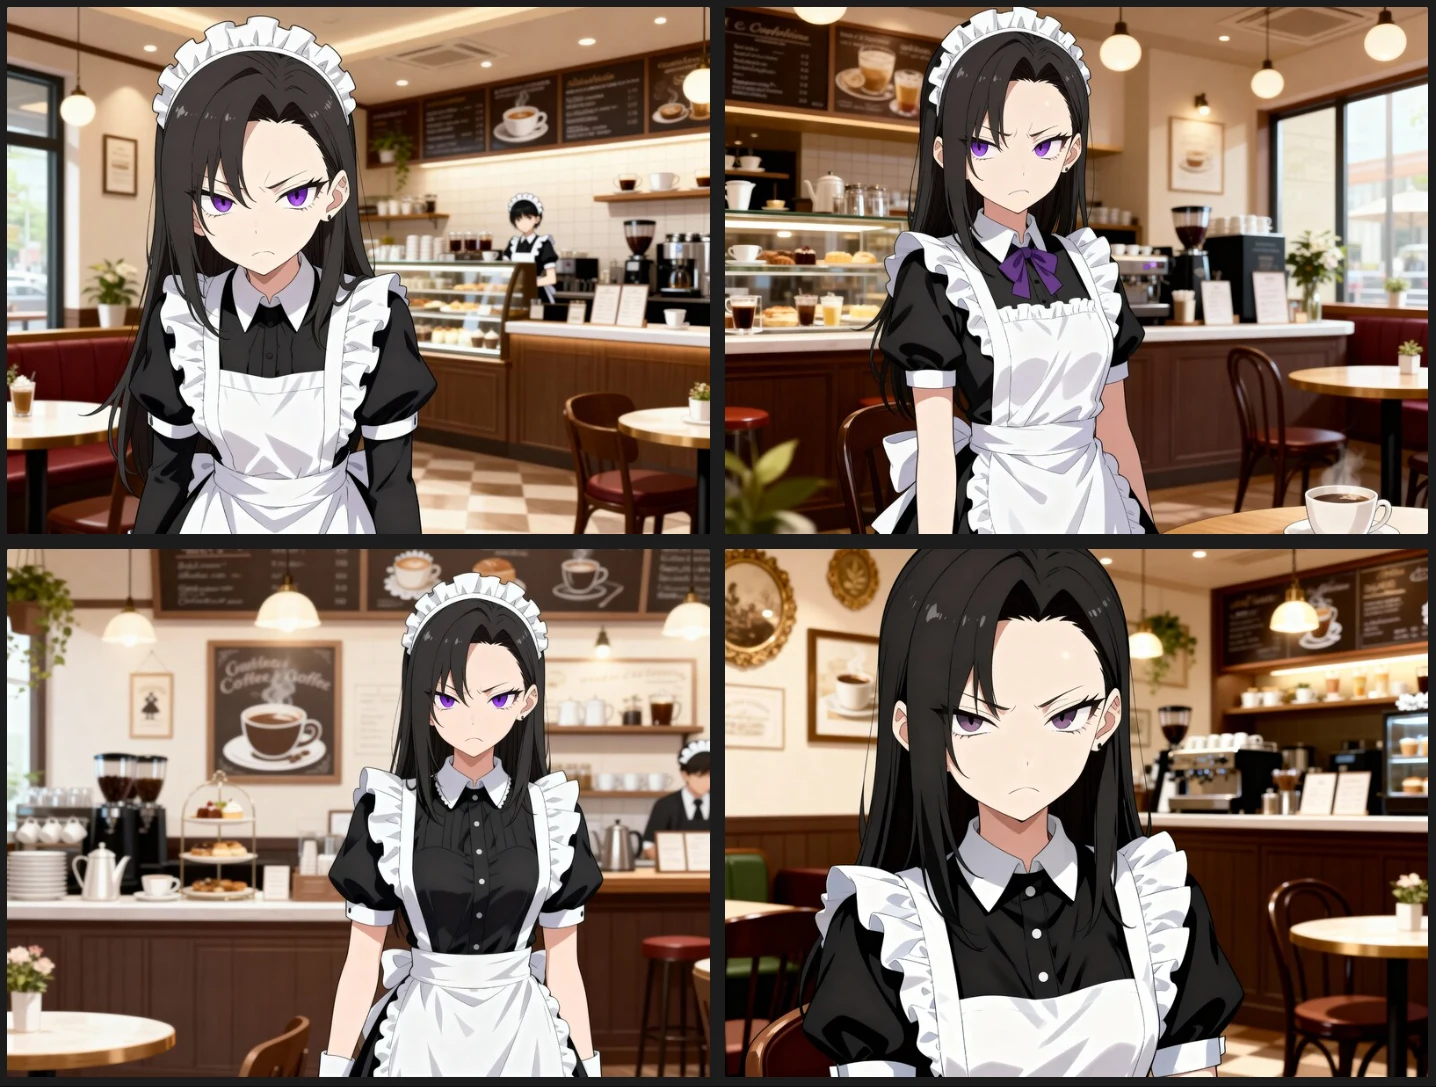
おお…今まで私は何の検証を行っていたんだ…!
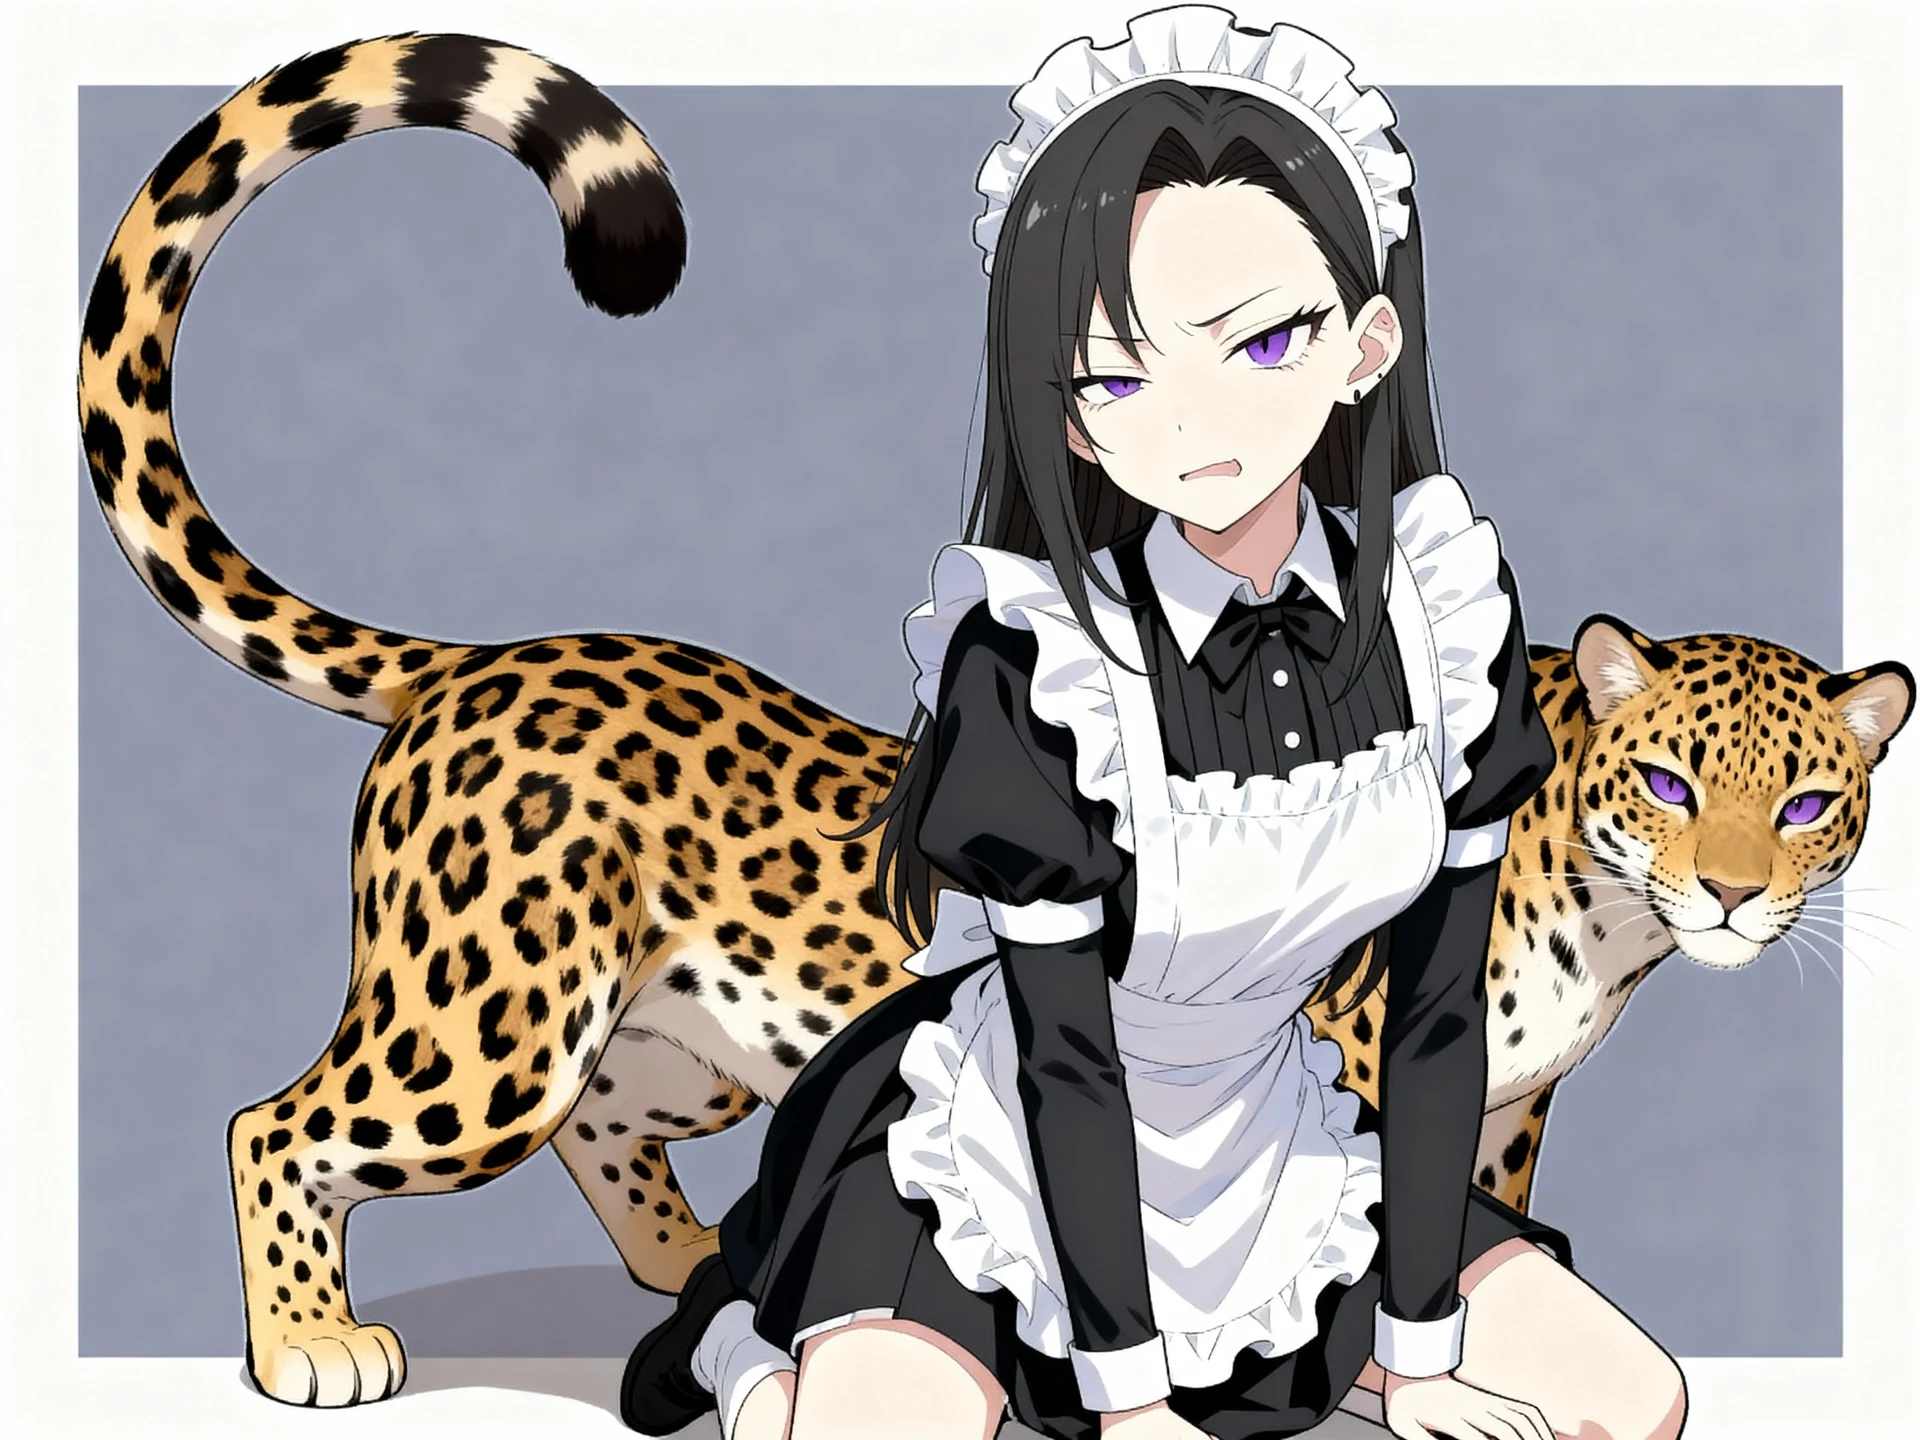
▲「メイド服で牝豹のポーズ」が分からなかったSeedreamくん
ということで、同キャラ複数画像入力ならば、Seedream4はNanoBananaをしのぐレべルで一貫性を保てるようです!背景はややリアリスティックよりになりがちなようで、Seedreamなりの「マスピ画風」のようなものがあるようですが、ある程度は入力画像やプロンプトの工夫で好みのものに寄せられるかと思います。また、やはり「引き」の構図になると顔の一貫性が多少落ちるようで、結婚式のイラストでは他のお題よりも顔立ちに変化が見られました。
検証14.破綻した手の修正
今度は、こちらの超ラフな画像の手の修正を試してみます。
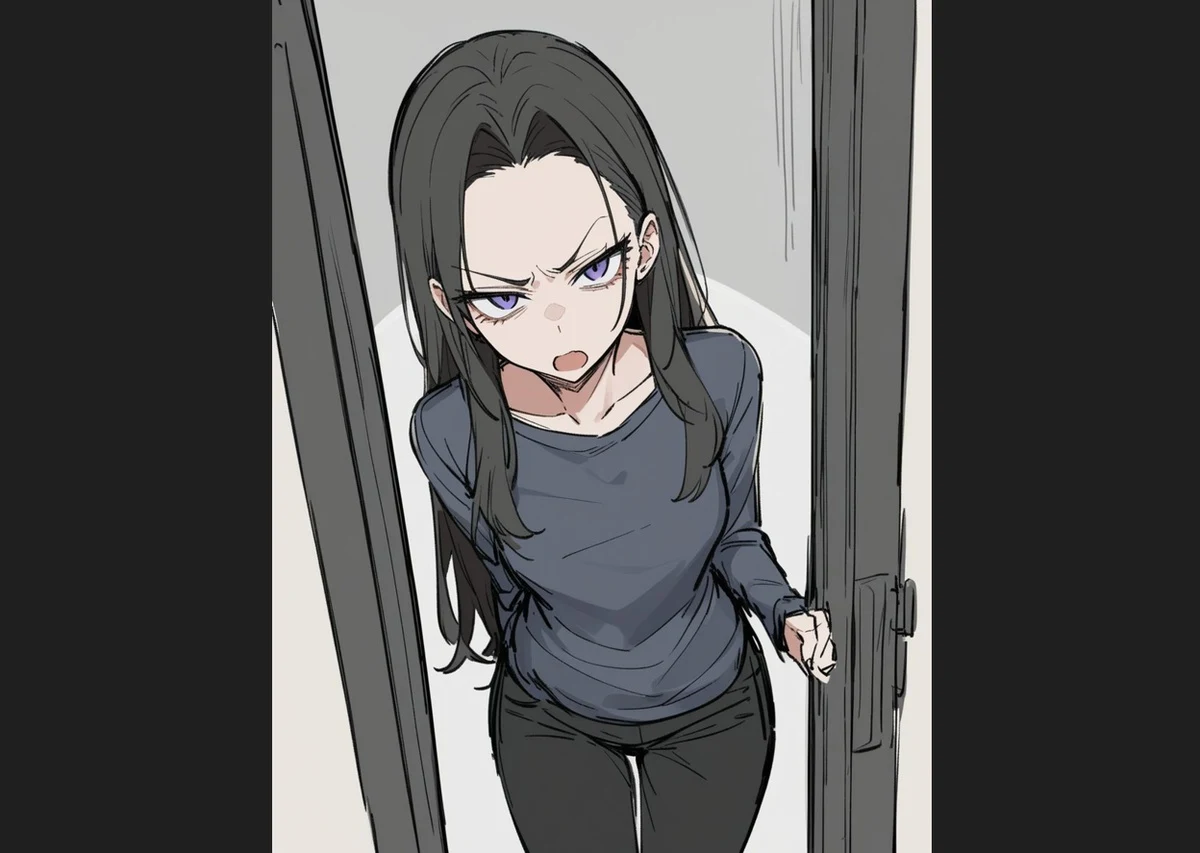
指示「このキャラクターの左手をきれいに描き直してください。手以外の部分は変更しないでください」(縦長3:4)
残念ながら、手がどこかの認識もできなかったようです。他にもインペイント的な用途ができないか試してみましたが、あまり芳しくありませんでした。大きな部分を消すような作業であれば割とできるのですが、「画像のこの部分をこのようにして」とピンポイント指示するのはできるときとできないときがあり、NanoBananaと違って得意ではないようです。
検証15.背景の削除・透過
こちらの画像の背景を消したり、透過できるか試します。
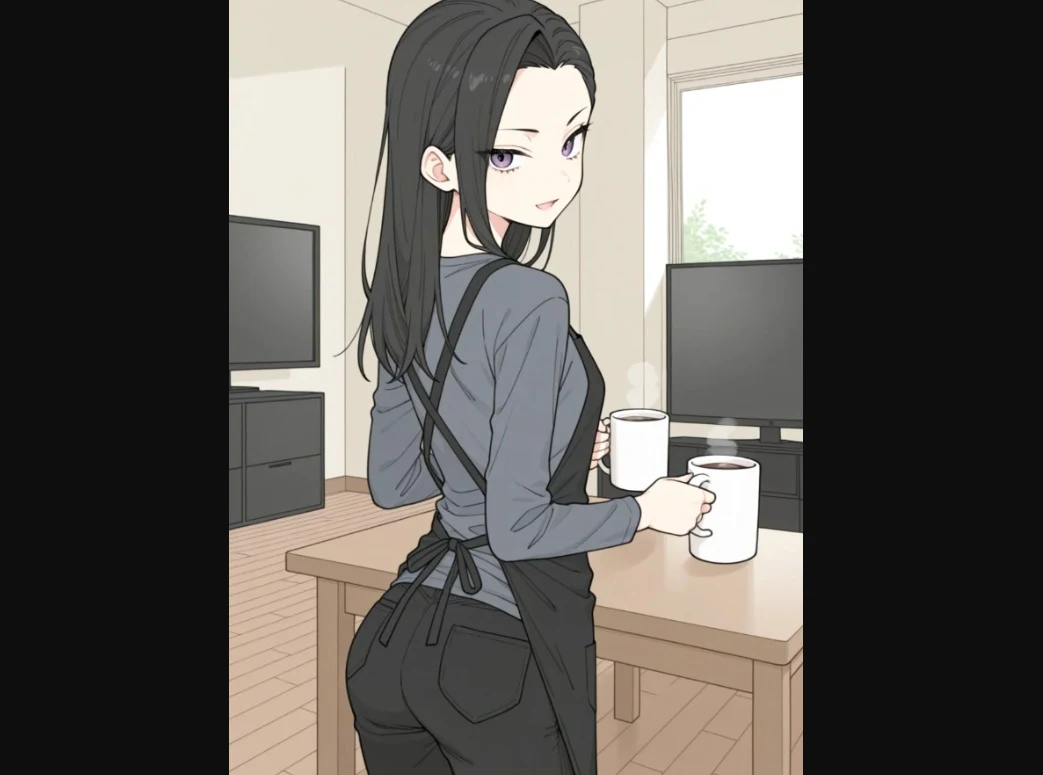
指示「背景を消して」
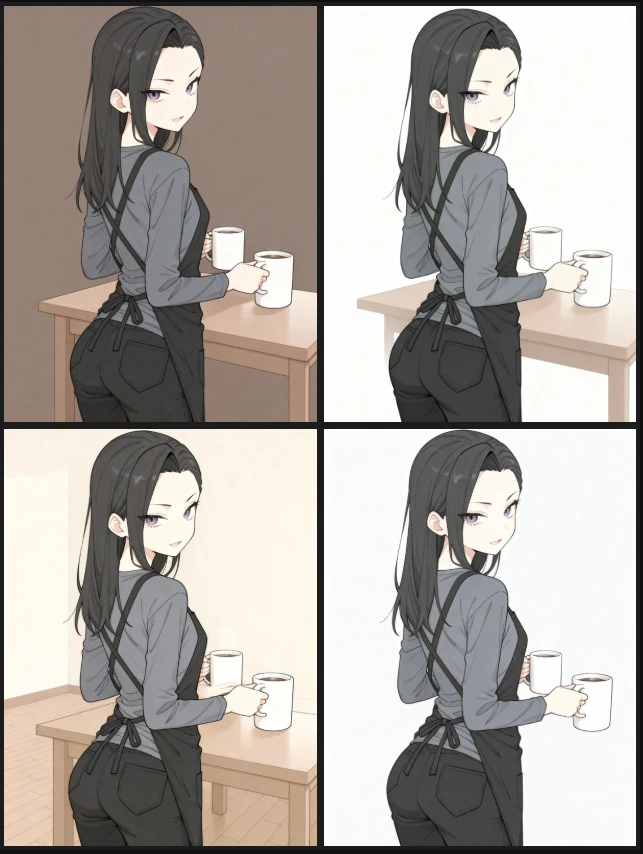
テーブルを背景の一部と考えるかどうか、消すとして何色にするかで迷ったようです。プロンプトを以下のように変更してみます。
指示「背景を消して、人物だけにして。テーブルも消して、背景部分は白にして」
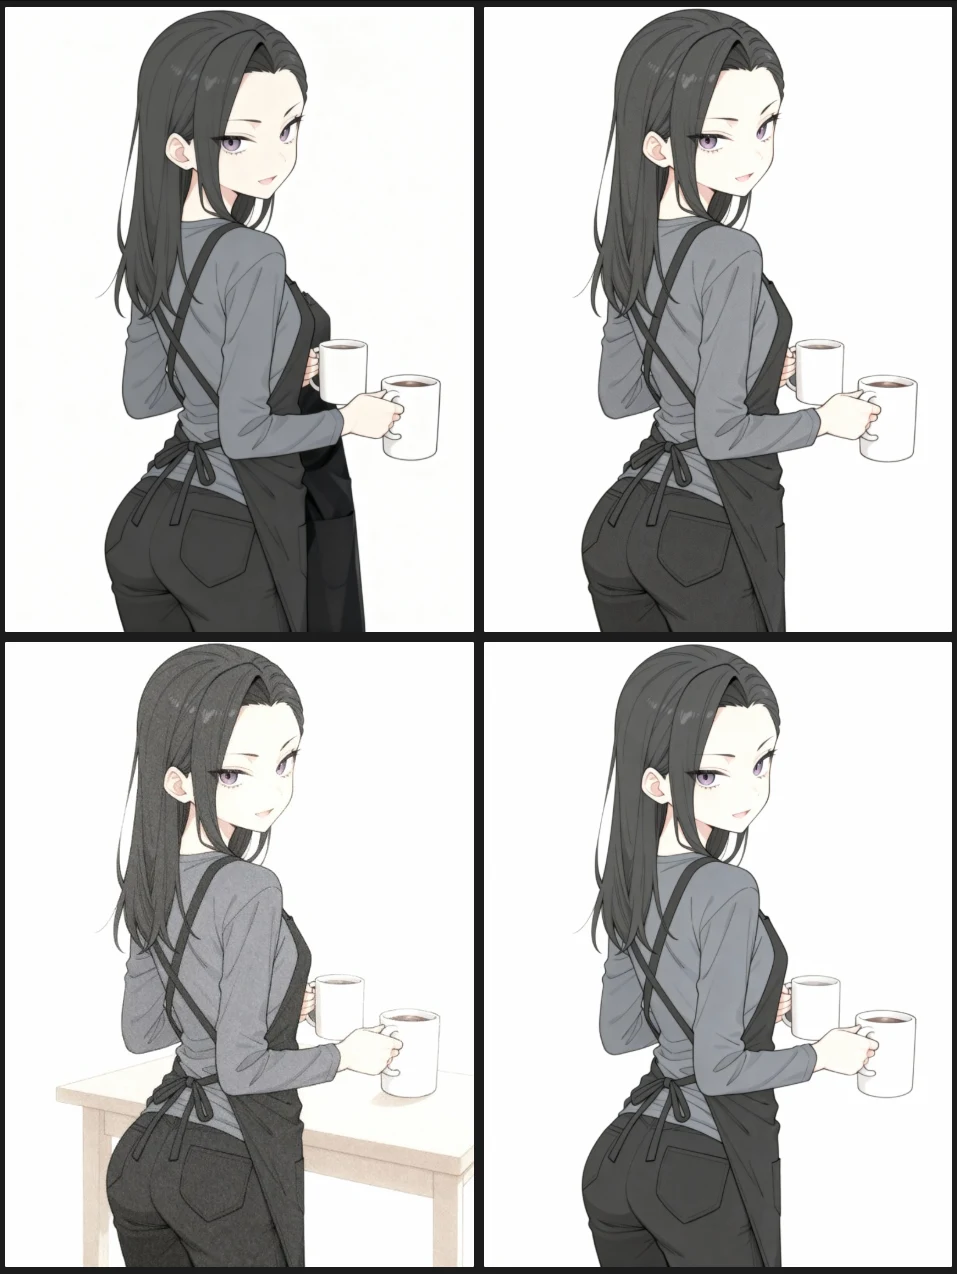
こうすると多少安定しましたが、うっすらテーブルが残ってしまったり、余計な部分が足されてしまったりはするようです。
NanoBananaで同じプロンプトを試すと、やはり安定した結果が得られました。このように、Seedream4.0はごく限られたシチュエーションでのみNanoBananaを上回るキャラクター一貫性が得られるものの、簡単な指示では基本的にNanoBananaに軍配が上がるようですね。
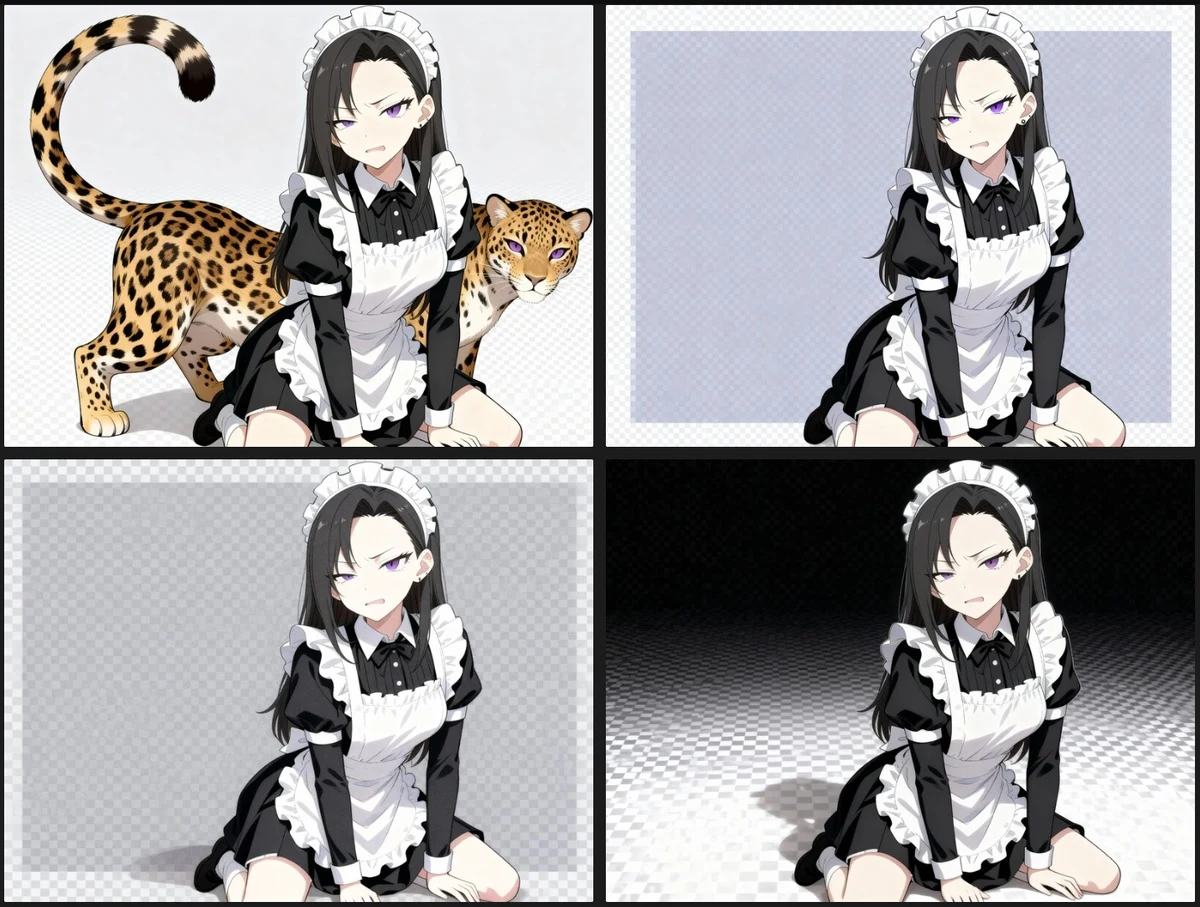
<背景透過もNG!>
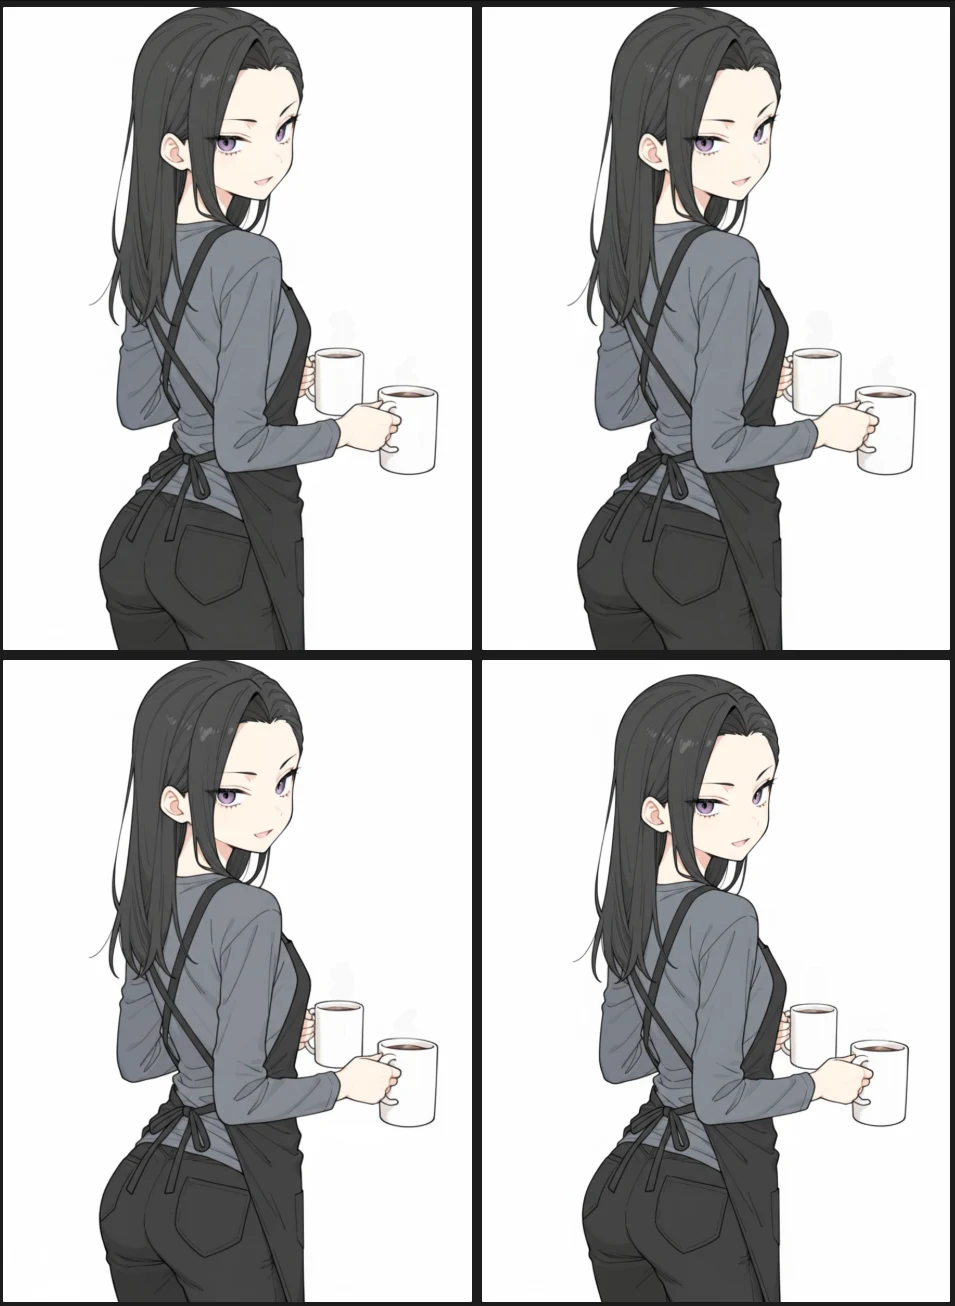
ちなみに、さきほどの雌豹の出力画像で「女の子以外の背景や動物を消して透過画像にしてください」と指示してみましたが、NanoBananaと同様に白とグレーの市松模様を出してくるいつものオチになりました。大人しく白画像にして、RemBgや背景透過モデルなどで抜いたほうがよいかと思います。
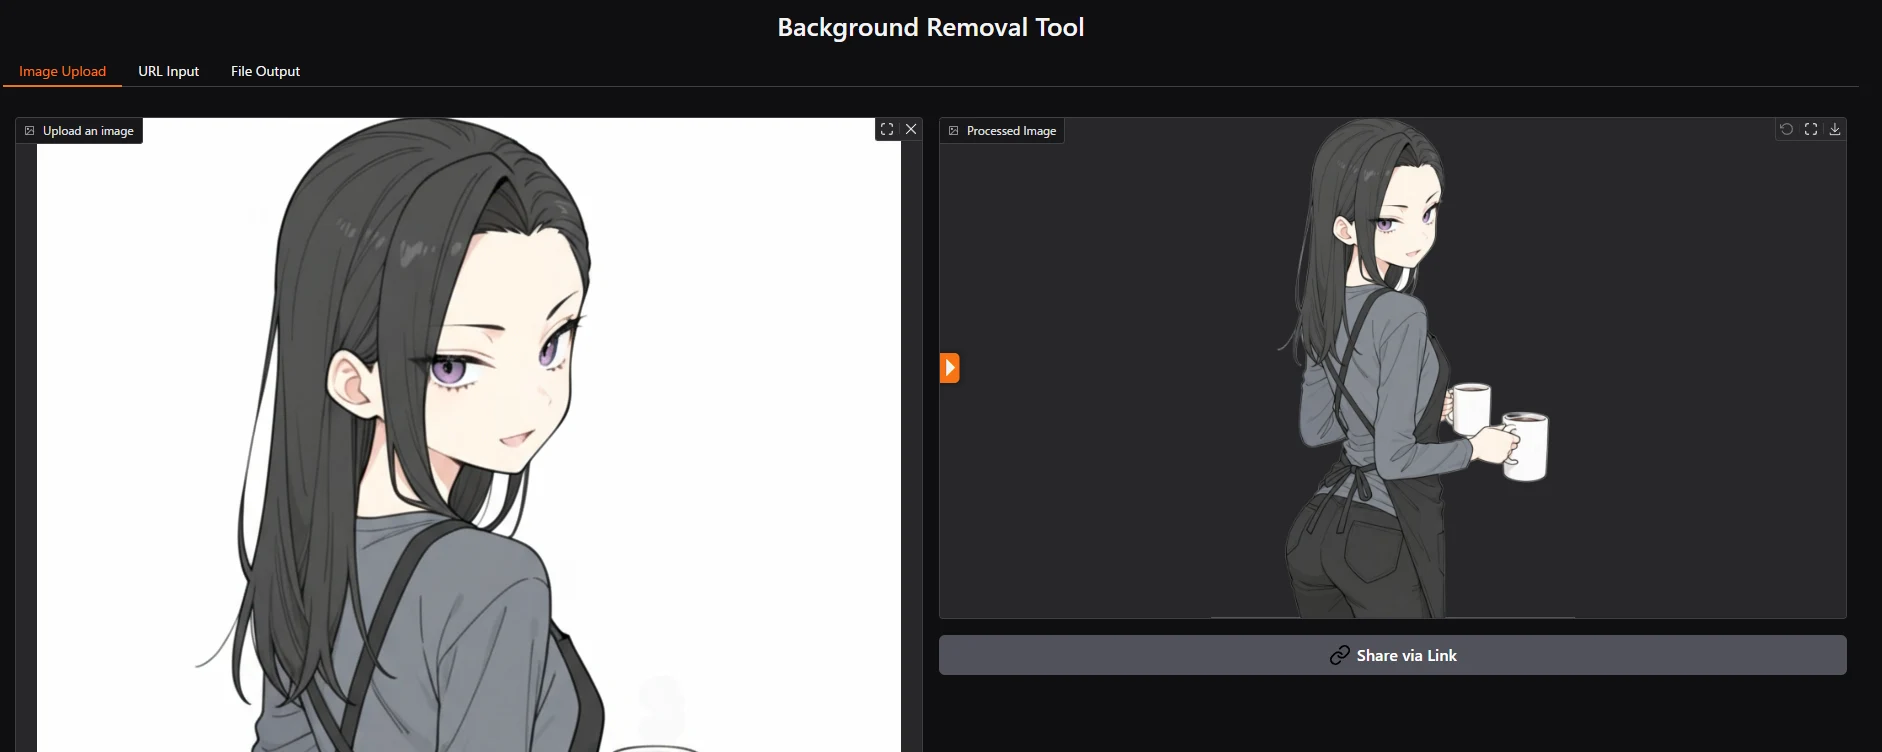
さきほどNanoBananaで白背景にしたものを「BackgroundRemoval」に掛ければ、このように透過画像にすることができました。これが一番お手軽そうですね。
透過画像を適当な背景に重ねるとこのような感じ。
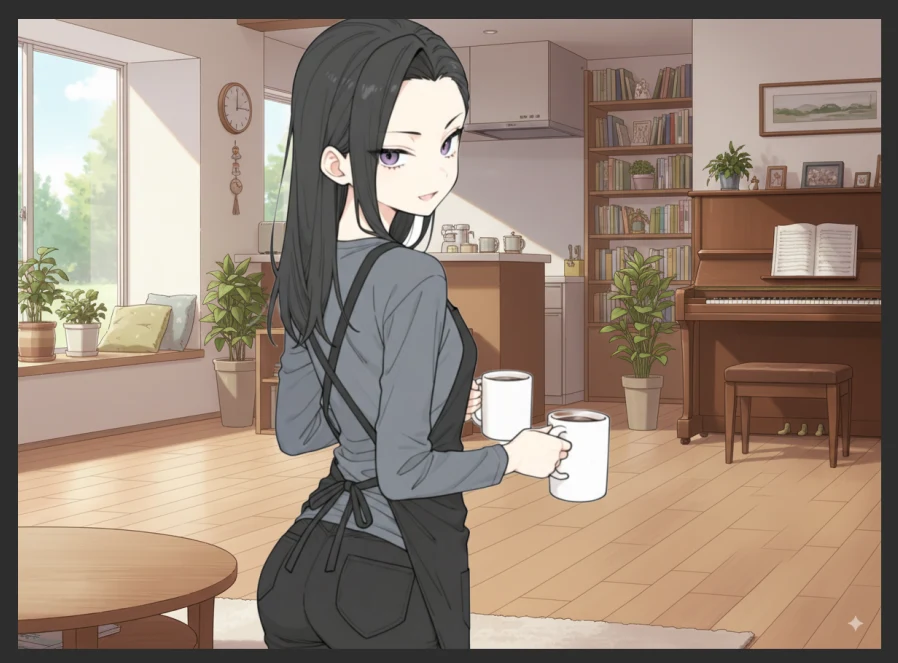
場合によってはこのように、コーヒーカップのふちや髪の毛の間の狭い範囲がきれいに透過しきれないこともあるので、あまり過信しすぎずチェックを入れるようにしてください。(個人的にはクリスタなどで「自動選択▶選択範囲の境界ぼかし▶削除」としたほうがうまくいきます)
検証16.画像内のテキスト編集
今度は日本語レンダリングです。米企業GoogleのNanoBananaは日本語生成がダメダメでしたが、中国企業Bytedanceはどうでしょうか。さきほどの「全員野球」ではめためただったので、あまり期待はできなさそうですが…
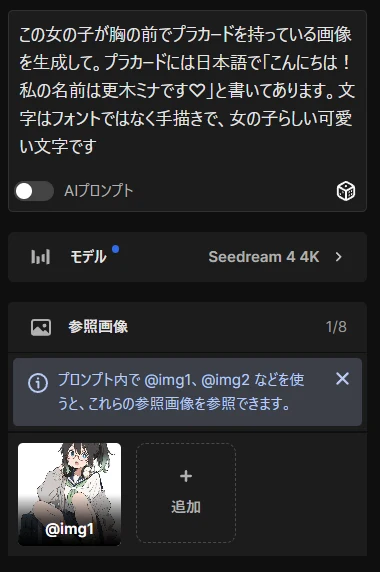
指示「この女の子が胸の前でプラカードを持っている画像を生成して。プラカードには日本語で「こんにちは!私の名前は更木ミナです♡」と書いてあります。文字はフォントではなく手描きで、女の子らしい可愛い文字です」
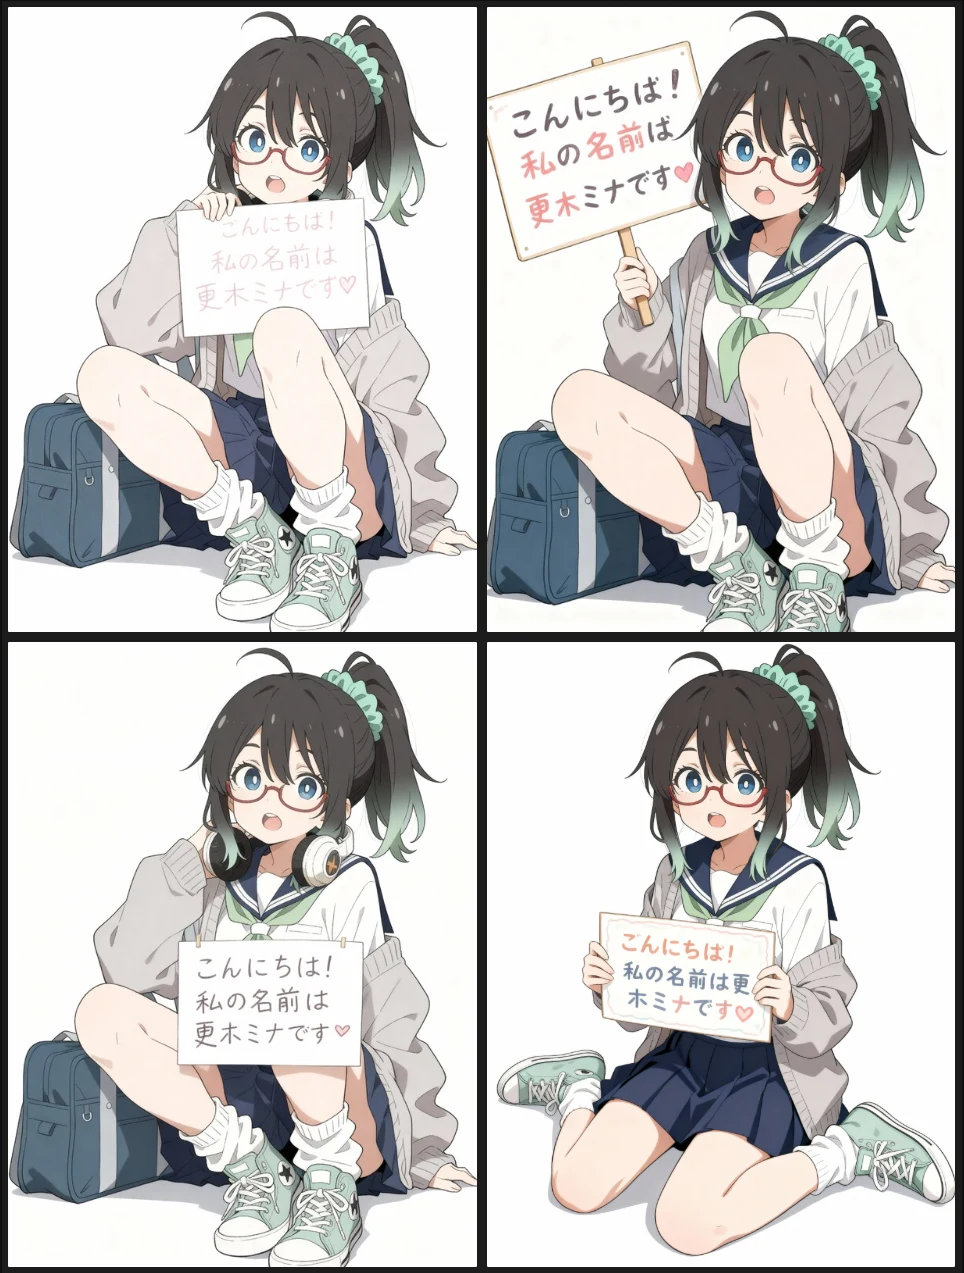
なんと、かなり健闘してくれました。多少変なところを消しゴムすれば、割となんとかなってしまうのではないでしょうか。ただ、入力画像にポーズはかなり引っ張られた様子が見えます。
もう一つ指示してみます。さきほど一貫性がよく保てた3枚の入力画像で、ほぼ同じ指示をしました。
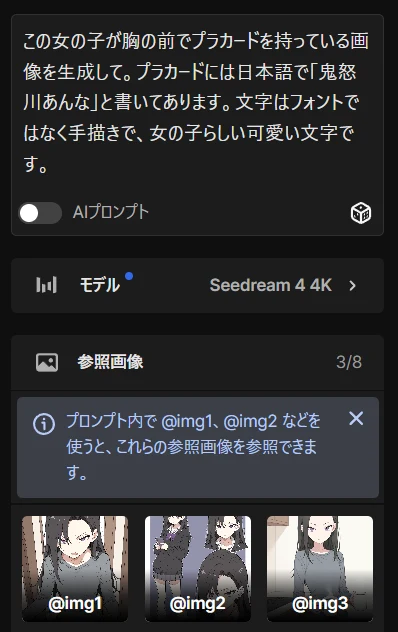
こちらが生成結果。
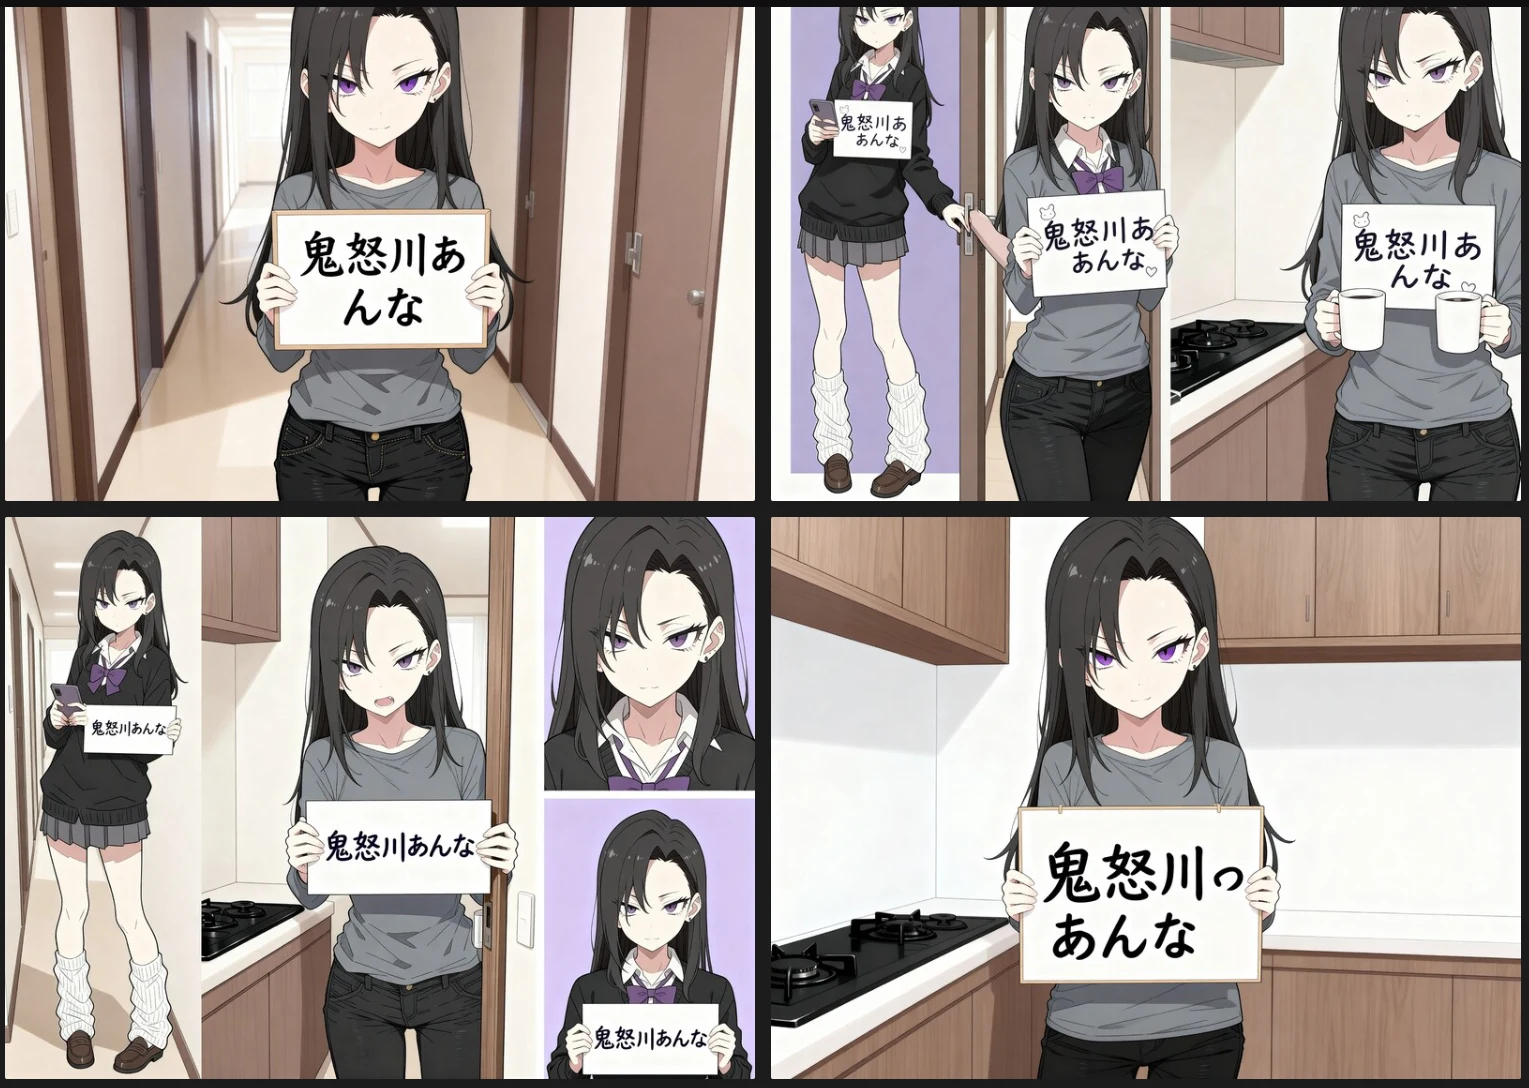
これまでの検証でも何度か見られましたが、プロンプトで断りをいれないと、入力画像に顔立ちだけでなく構図までまぜこぜに引っ張られてしまい、不自然な結果になる現象が見られました。特に右上は、「このキャラクターは同時に3人描かれて、首に紫のリボンをしていて、手にコーヒーを持っていて、背景はキッチン」というごちゃごちゃな情報をもとに一貫性を保とうとした結果、意味不明な画像になってしまったように見えます。
そこで、できるだけ迷う余地を減らすため、以下のようにプロンプトを変更しました。また、ピアスをしている高校時代のmultiple angleな画像を入力しているのがあまりよくない影響を及ぼしているように見えるので、その画像を除外して別の画像に差し替えました。
指示「この女の子がメイド服を着て胸の前でプラカードを両手で持って立っているバストアップの画像。背景は白。プラカードには日本語で、「新人メイドの鬼怒川あんなです♥」と書いてあります。文字はフォントではなく手描きで、女の子らしい可愛い文字。表情は不機嫌そう。頬を少しだけ赤くして、目は横を見ている。」
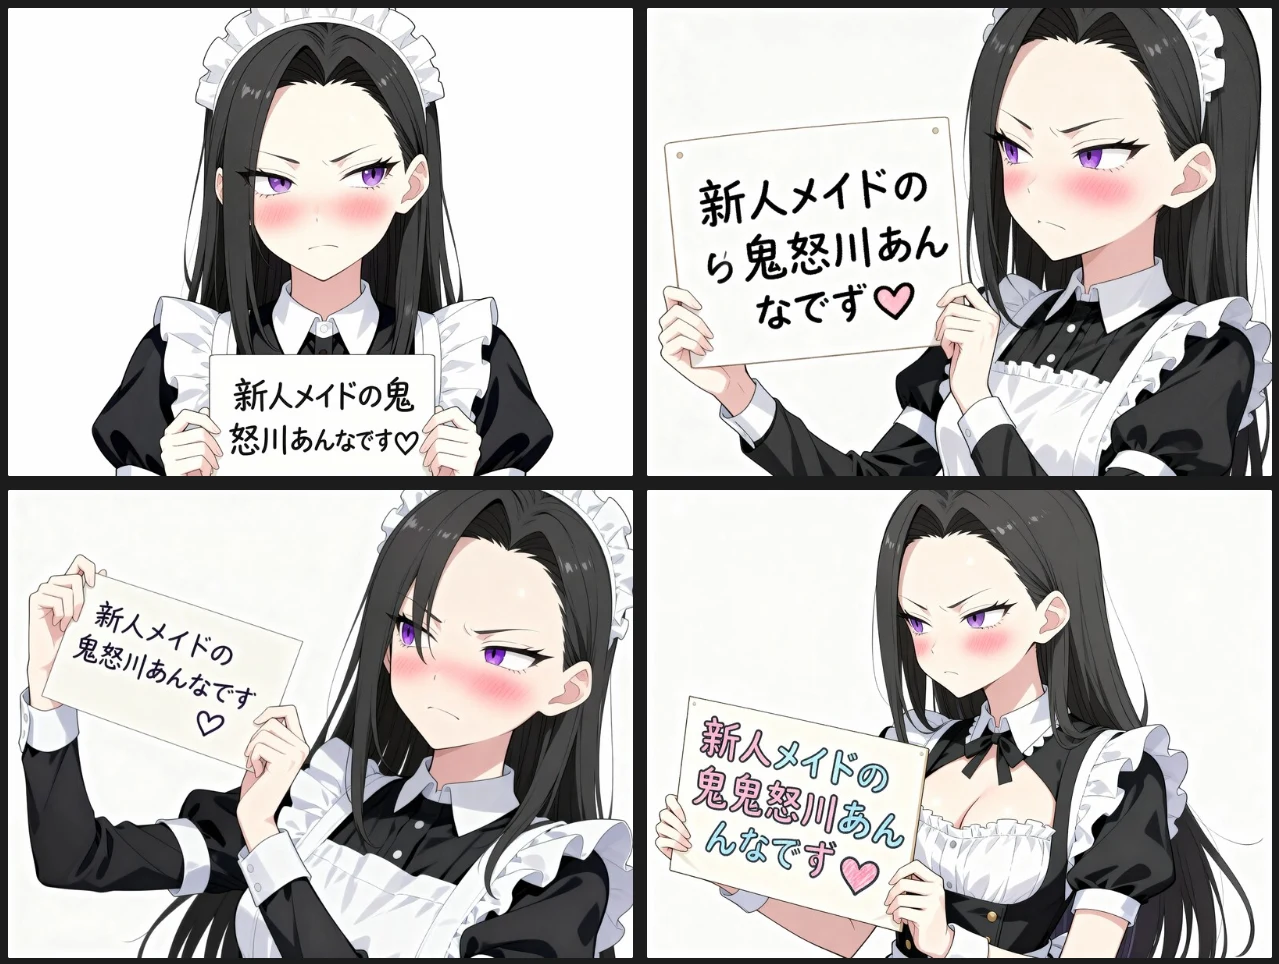
このように、ある程度打率を上げることができました。
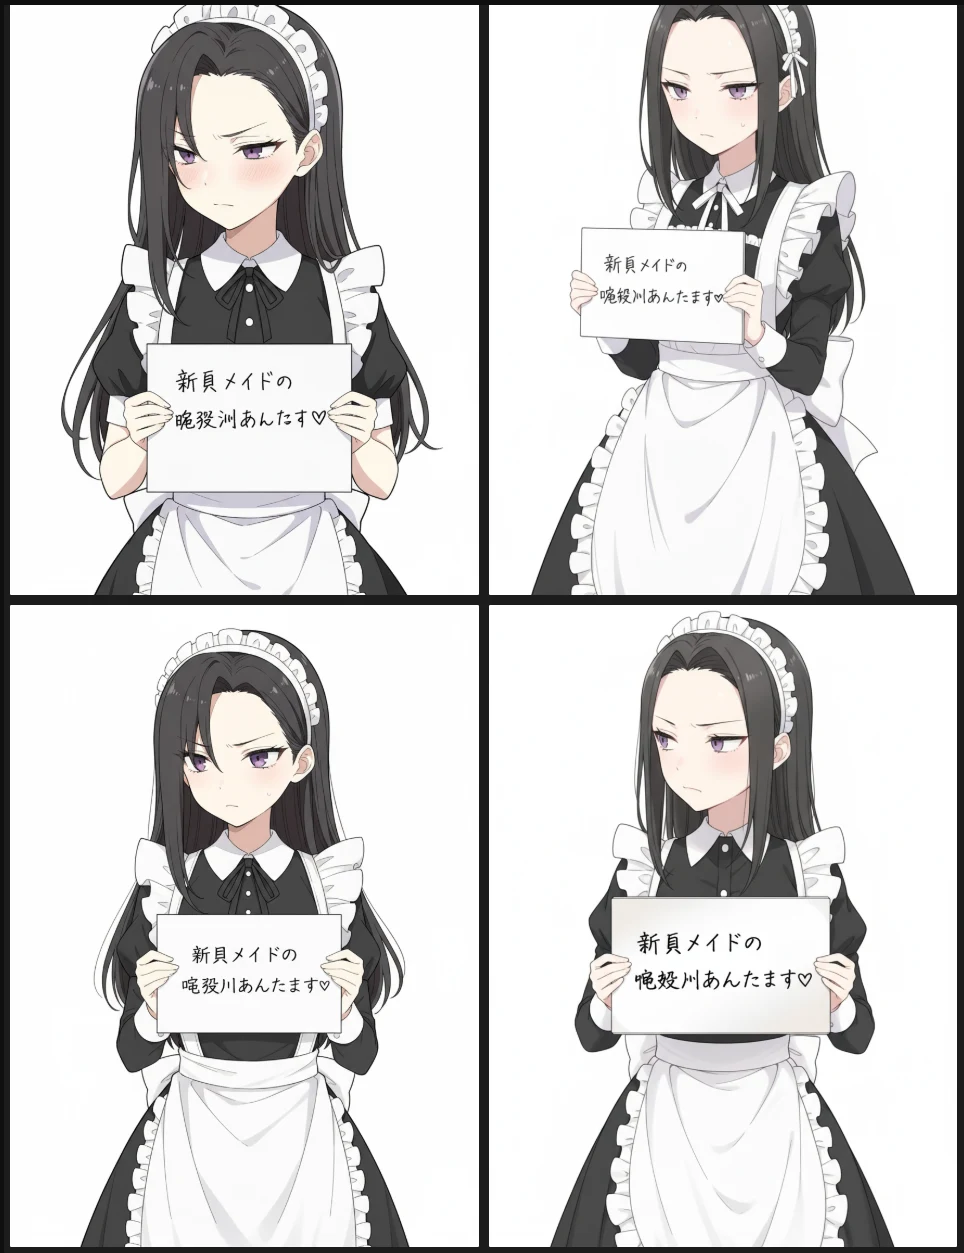
ちなみにこちらは、全く同じ入力画像とプロンプトでNanoBananaに指示したもの。整合性は取れていますが、文字も一貫性もアスペクト比の忠実性もSeedream4.0が勝っていますね。
・ウィンドウ除去とテキストだけ除去
NanoBananaができたこちらの作業をSeedreamでもできるか試しました。
指示「この画像からゲームの表示を消して、イラストだけにしてください。表情などは一切変化させないでください。」
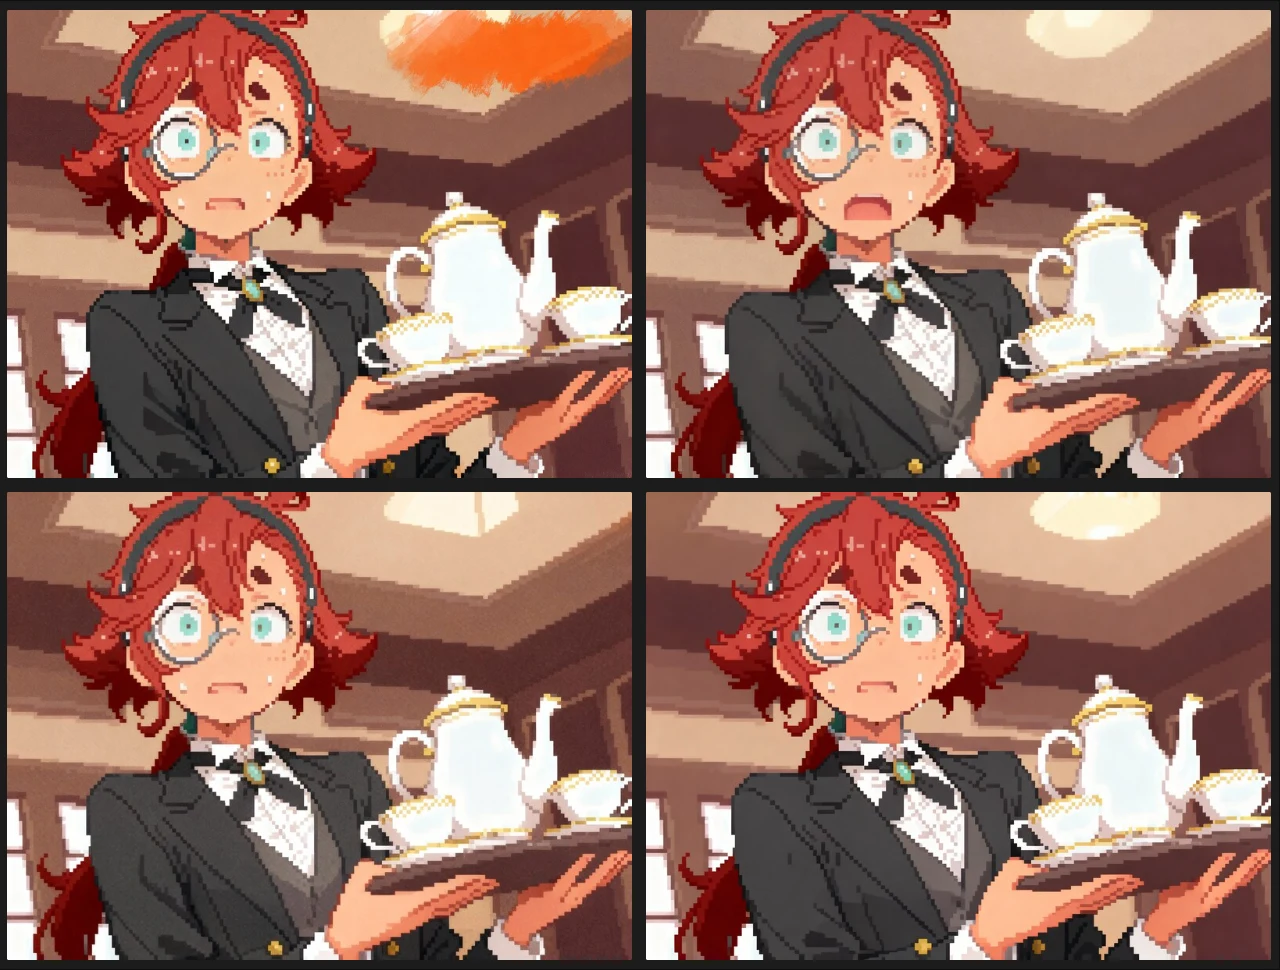
やや安定感に欠けますが、下段2枚はなかなかうまくいったように見えます。電灯部分はもともとオレンジの塗りつぶしに隠れていたので、想像で描いていますね。もう一つ、前回と同じテストです。
指示「日本語の文字だけを消してください。右上のオレンジのウィンドウや、画面下の白黒のウィンドウは消さず、イラスト部分もいっさい変更しないでください。」
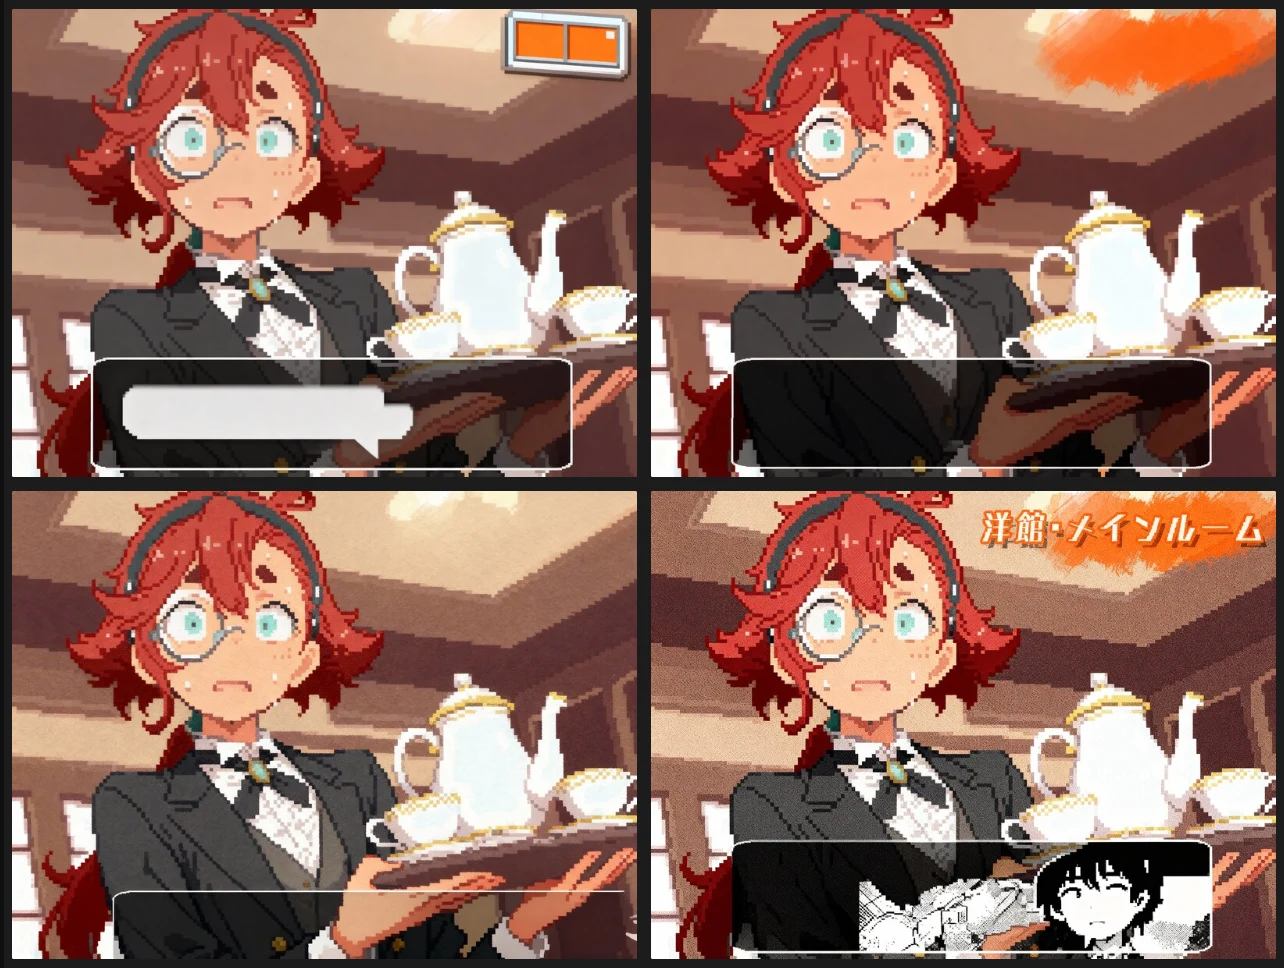
こちらはできませんでした。妙な謎のウィンドウを足してしまったりして、ほとんど言っている意味が通じていないようですね。
指示「右上のオレンジのウィンドウと、画面下の白黒のウィンドウを、もっと本物のADVゲームのように優れたデザインにしてください。」
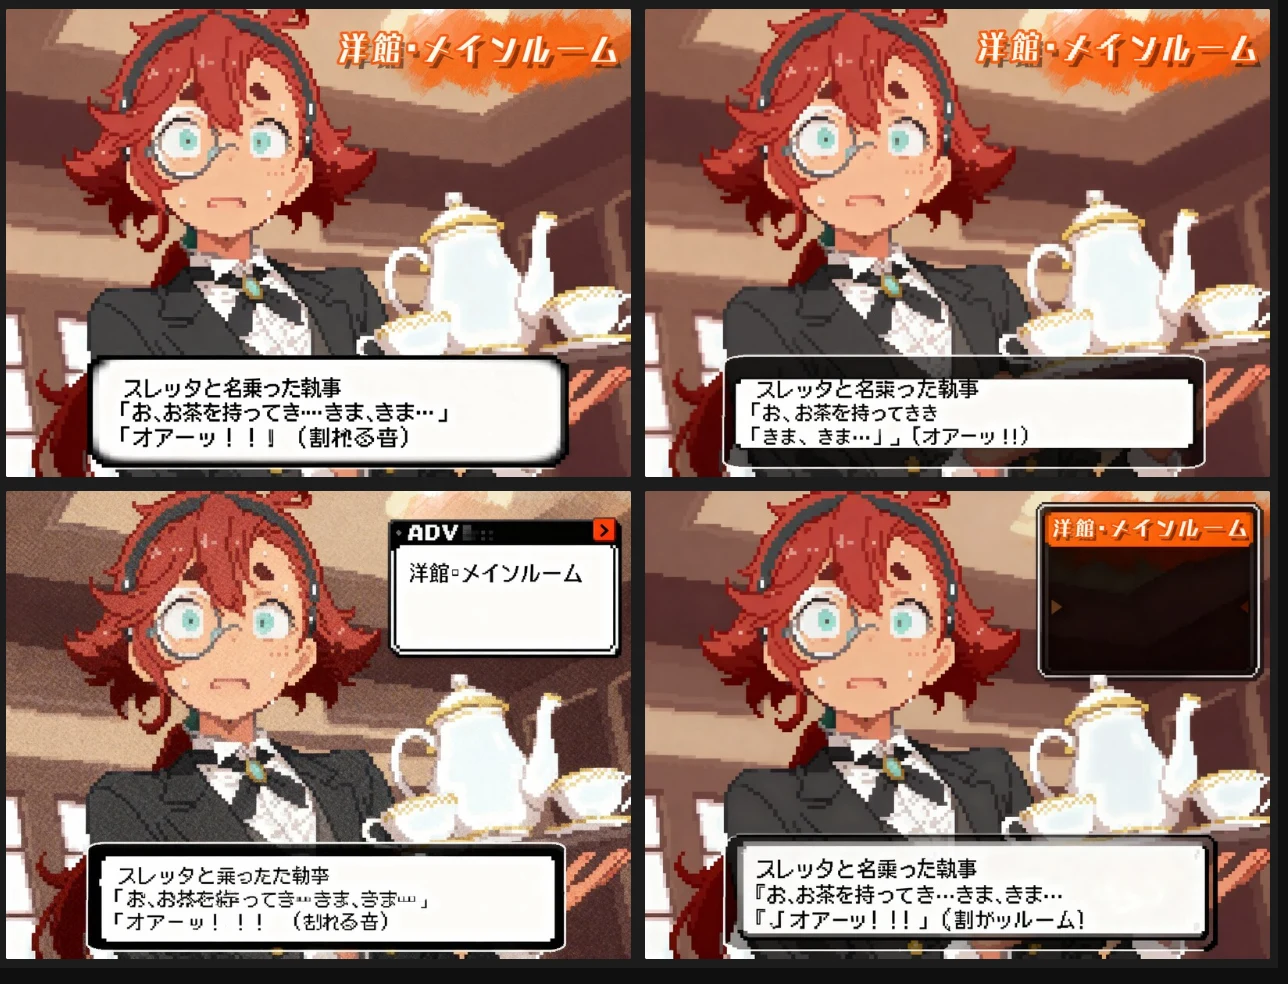
NanoBananaができたこちらの指示も望み薄なようです。ドラゴンクエス〇のような感じにしたかったのでしょうか…(笑) 本当に尖った機能を持った不思議なモデルですね。NanoBananaができた「日本語部分を英訳する」ももちろんできませんでした。
検証17.イラストのスタイルチェンジ
今度は、前回同様こちらの画像をさまざまにスタイルチェンジしていきます。基本的にはNanoBananaが得意だった「Convert to...」のプロンプトと、danbooruタグの画材系タグを組み合わせたプロンプトにしています。
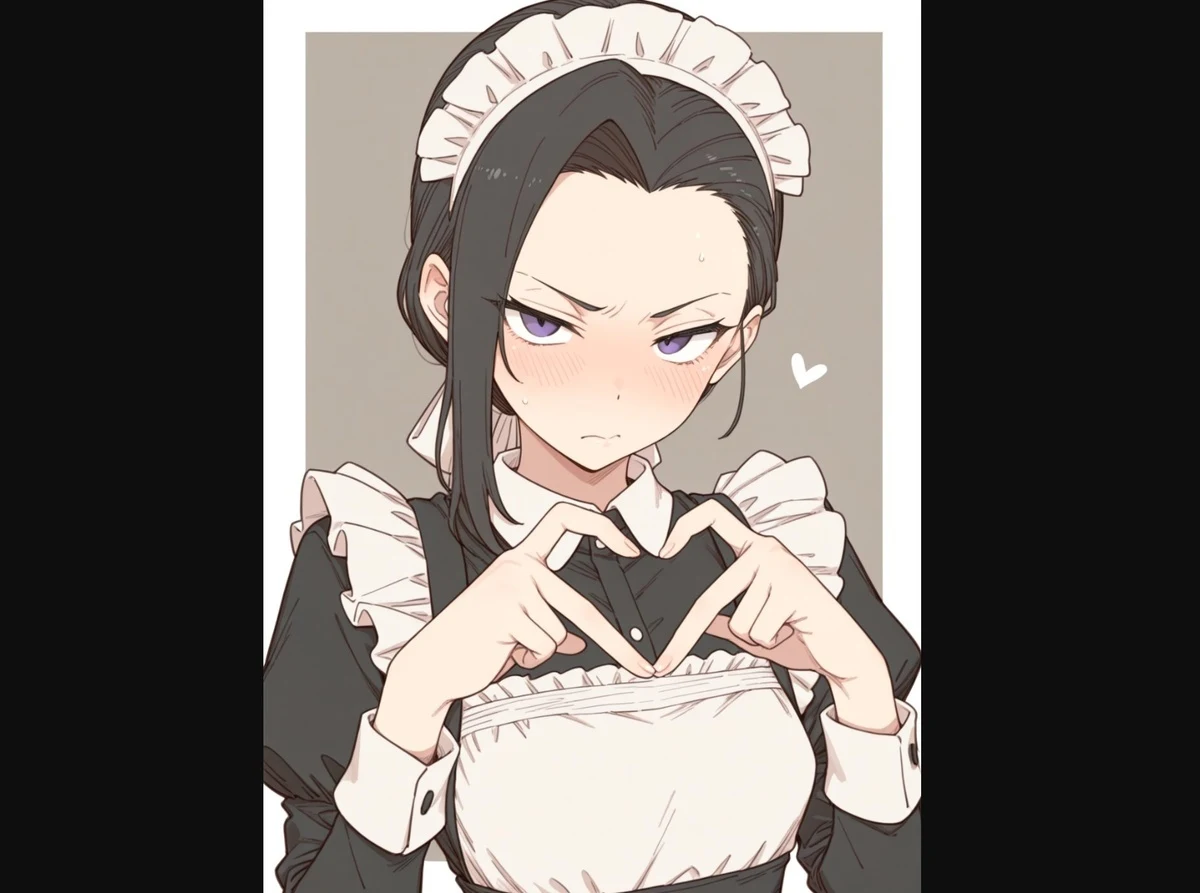
線画
指示「Convert to line art」
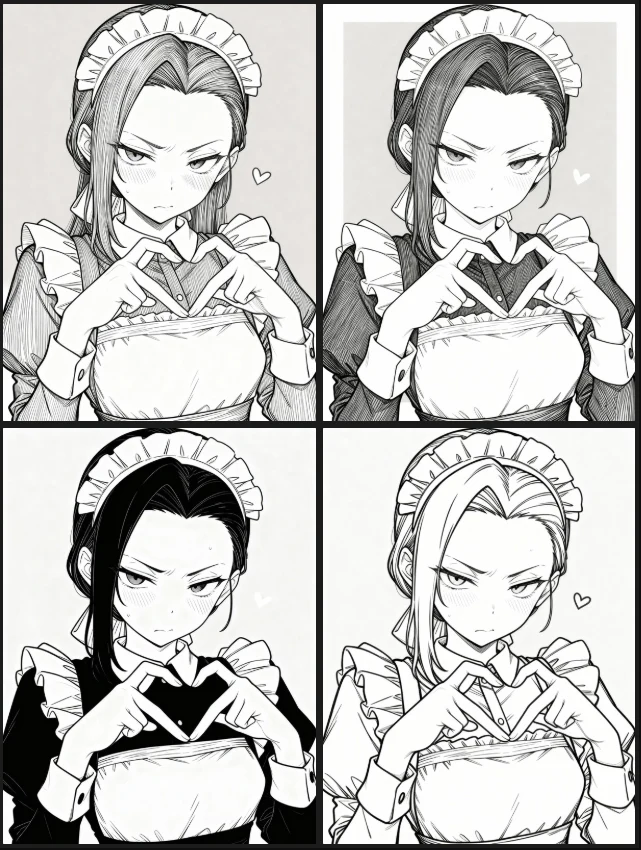
「白地に黒い線で描かれた~」のように指示しないと、右下のような求めている線画が安定して出ないようです。どちらかというと線画というより漫画絵やハッチングのあるデッサンのような雰囲気になりました。
ラフ
指示「Convert to rough image.」
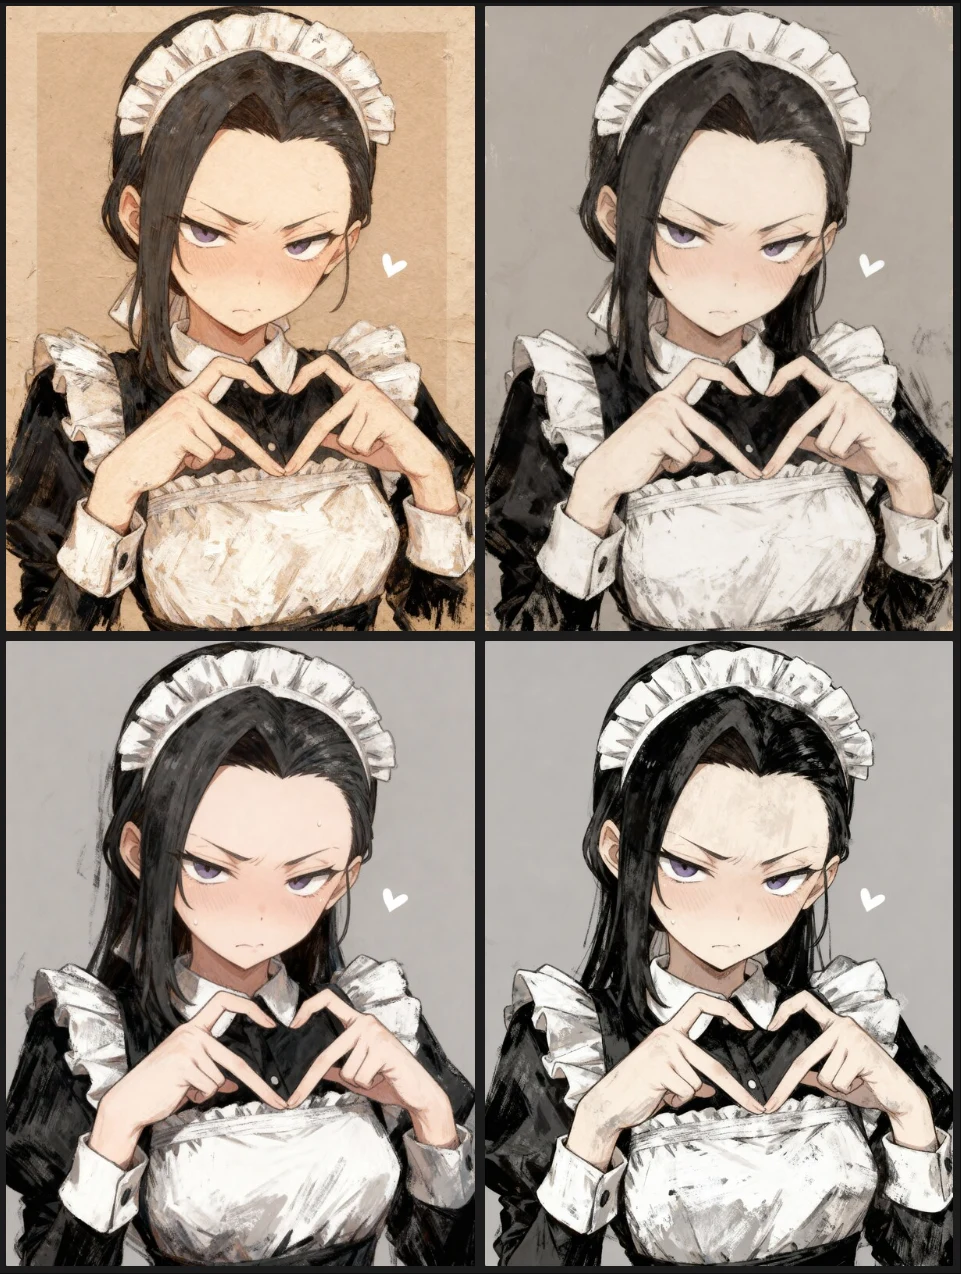
ラフというよりも、殴り書きした油絵のようになりました。なぜか後ろ髪が伸びています。
水彩画
指示「convert to watercolor illust.」
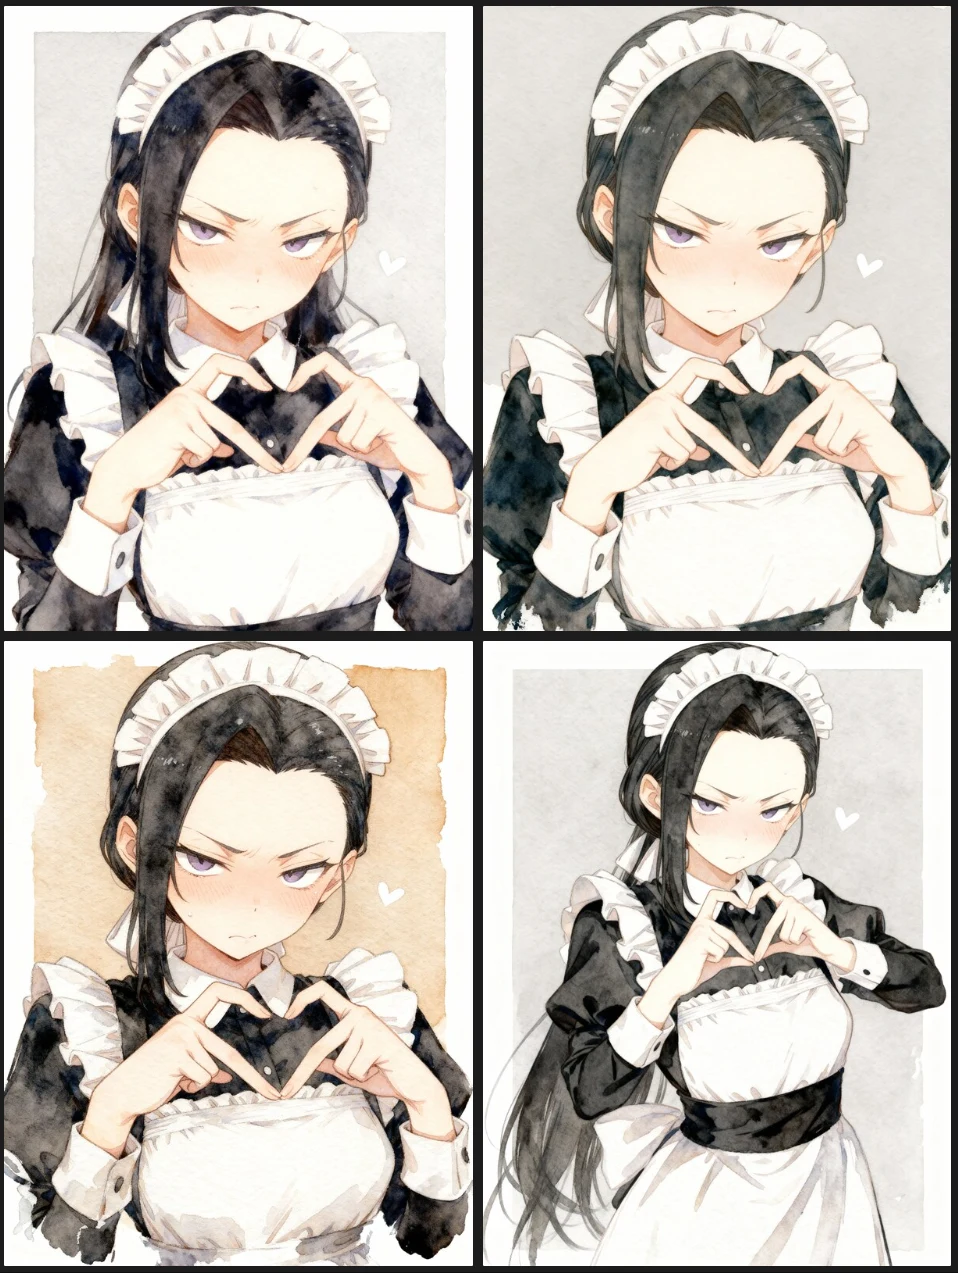
後ろの髪を伸ばしたり構図が変化したりといった変化が生じました。風合いは良いですね。
アクリル画
指示「convert to acrylic paint.」
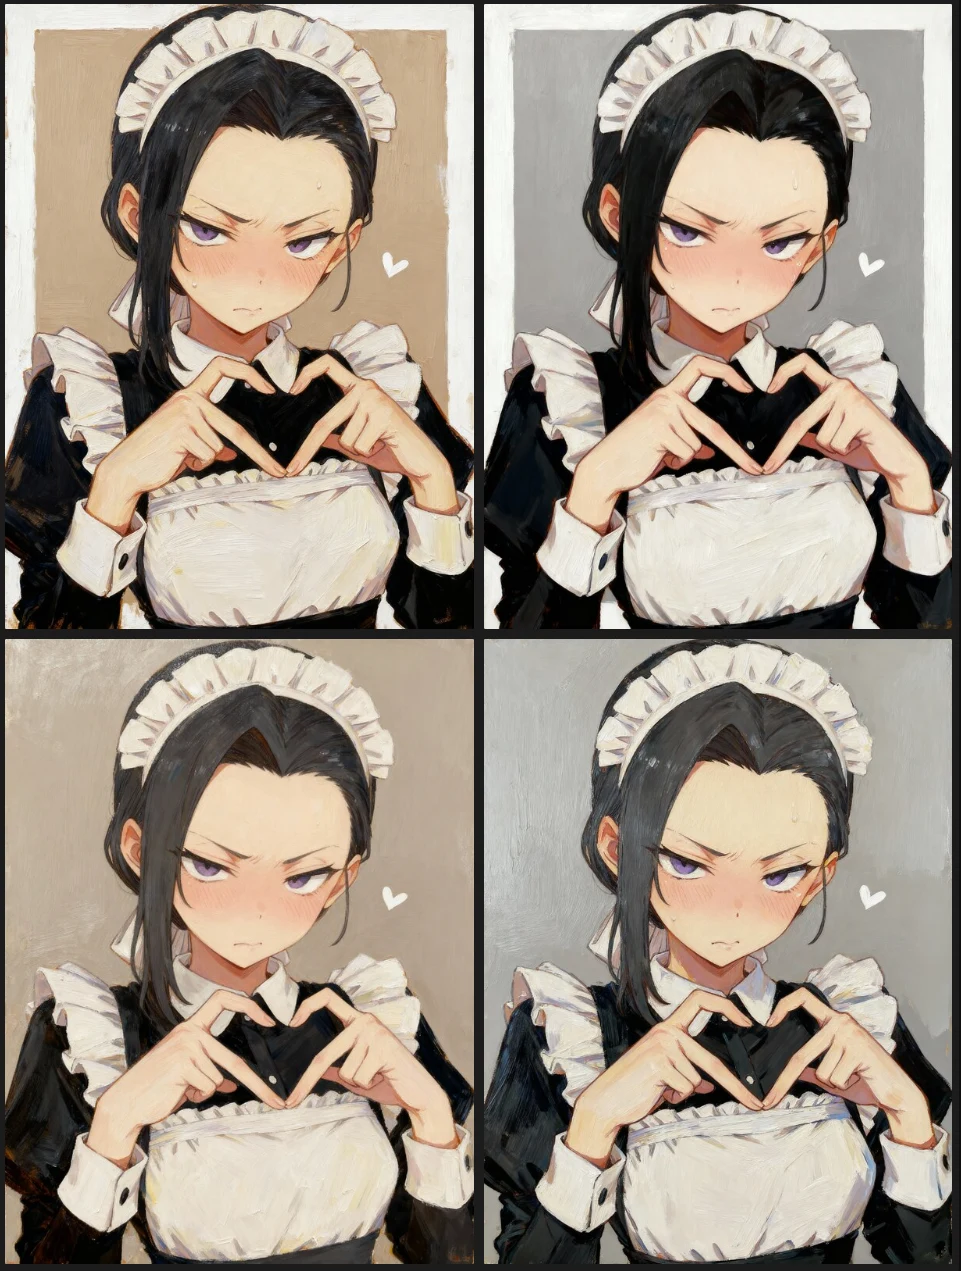
アクリルっぽいのでしょうか?安定はしています。
エアブラシ
指示「convert to airbrush paint.」
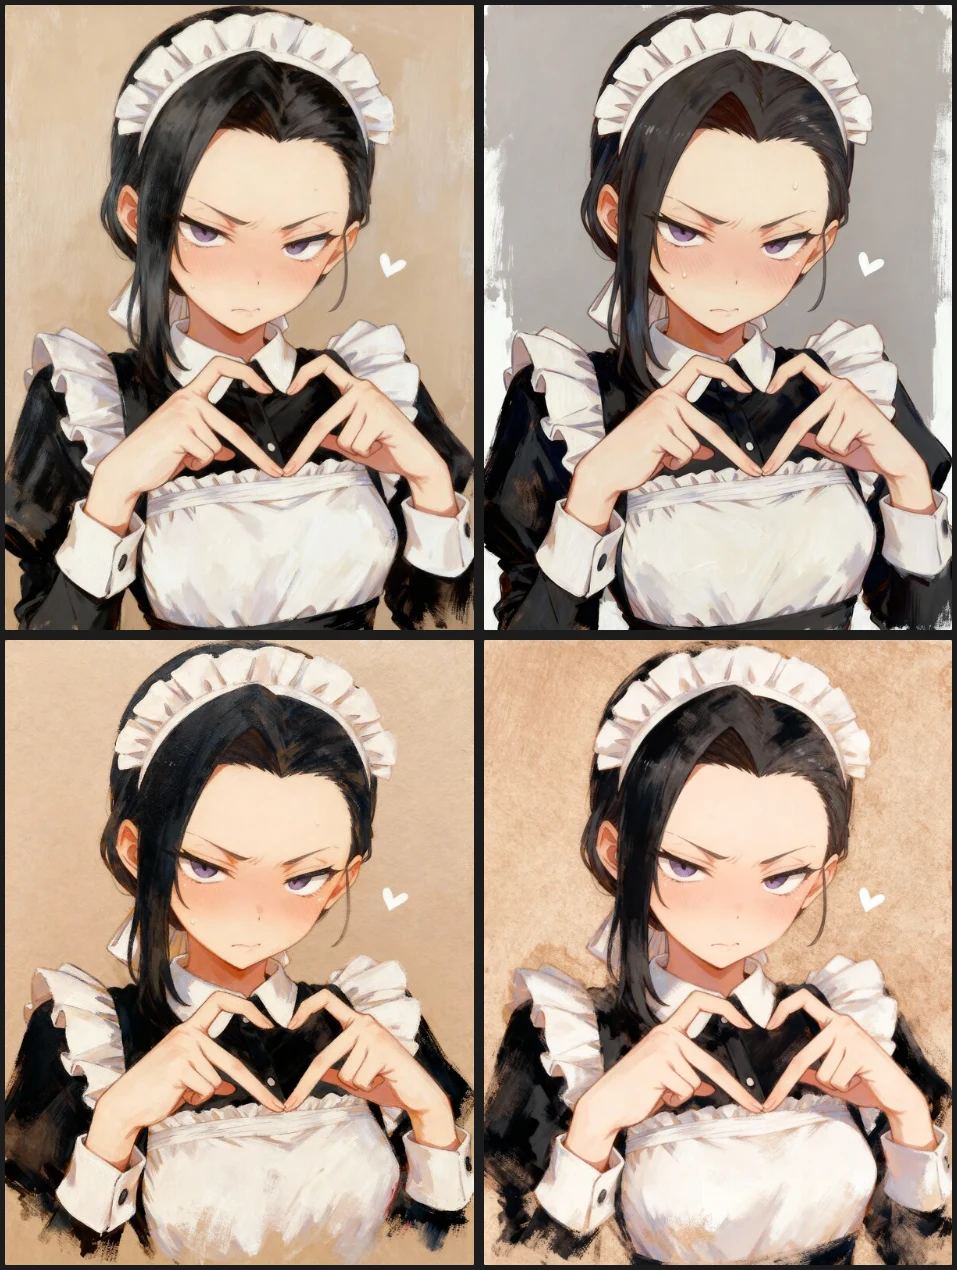
こちらはちょっとエアブラシ風とは言えませんでしたね。
カラーインク
指示「Convert to color ink illust.」
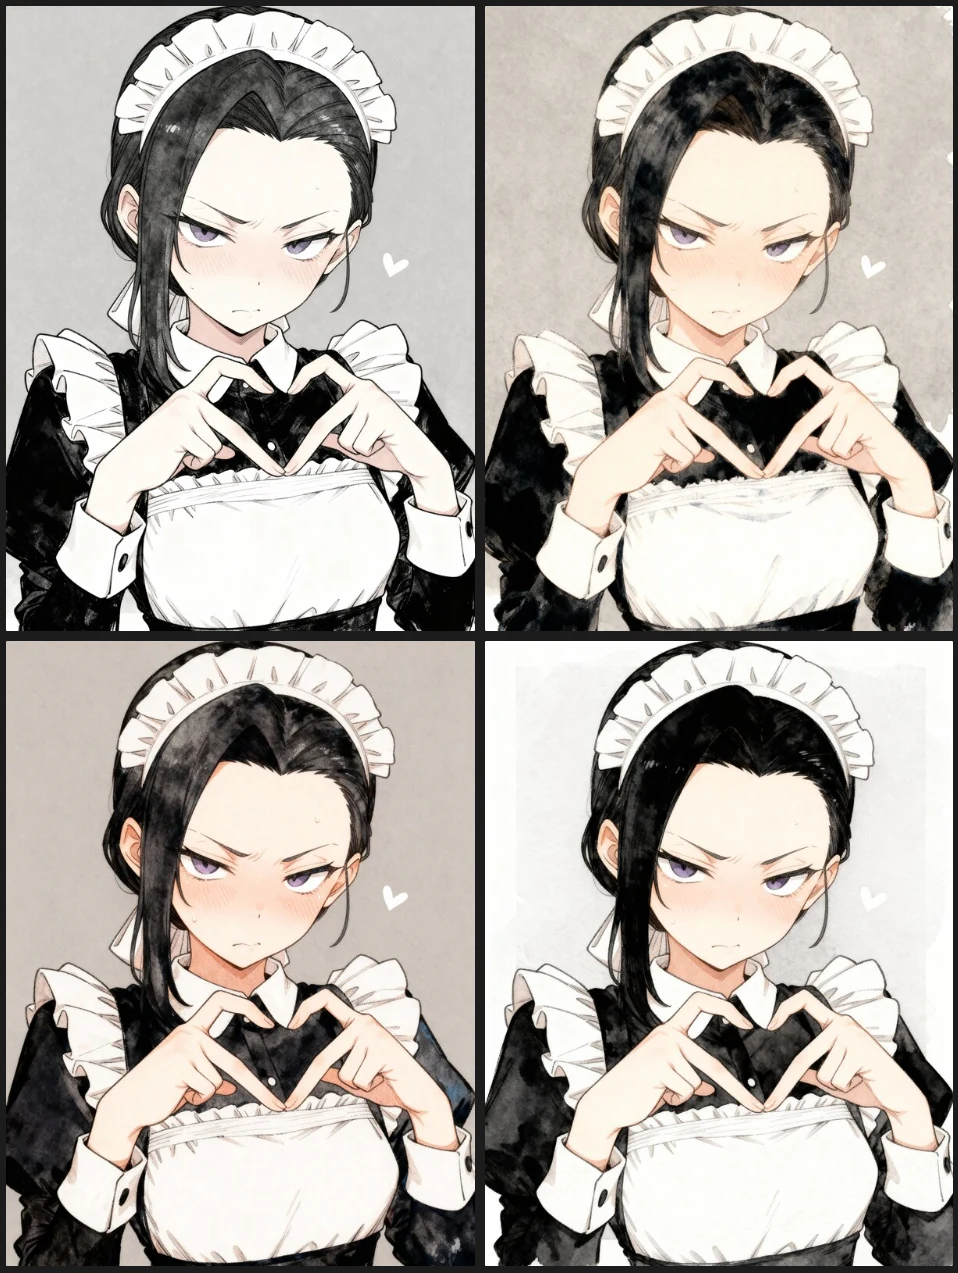
これはカラーインクっぽいですが、水彩のようなにじみもあったり、ふしぎな感じの風合いになりました。
クレヨン
指示「Convert to crayon paint.」
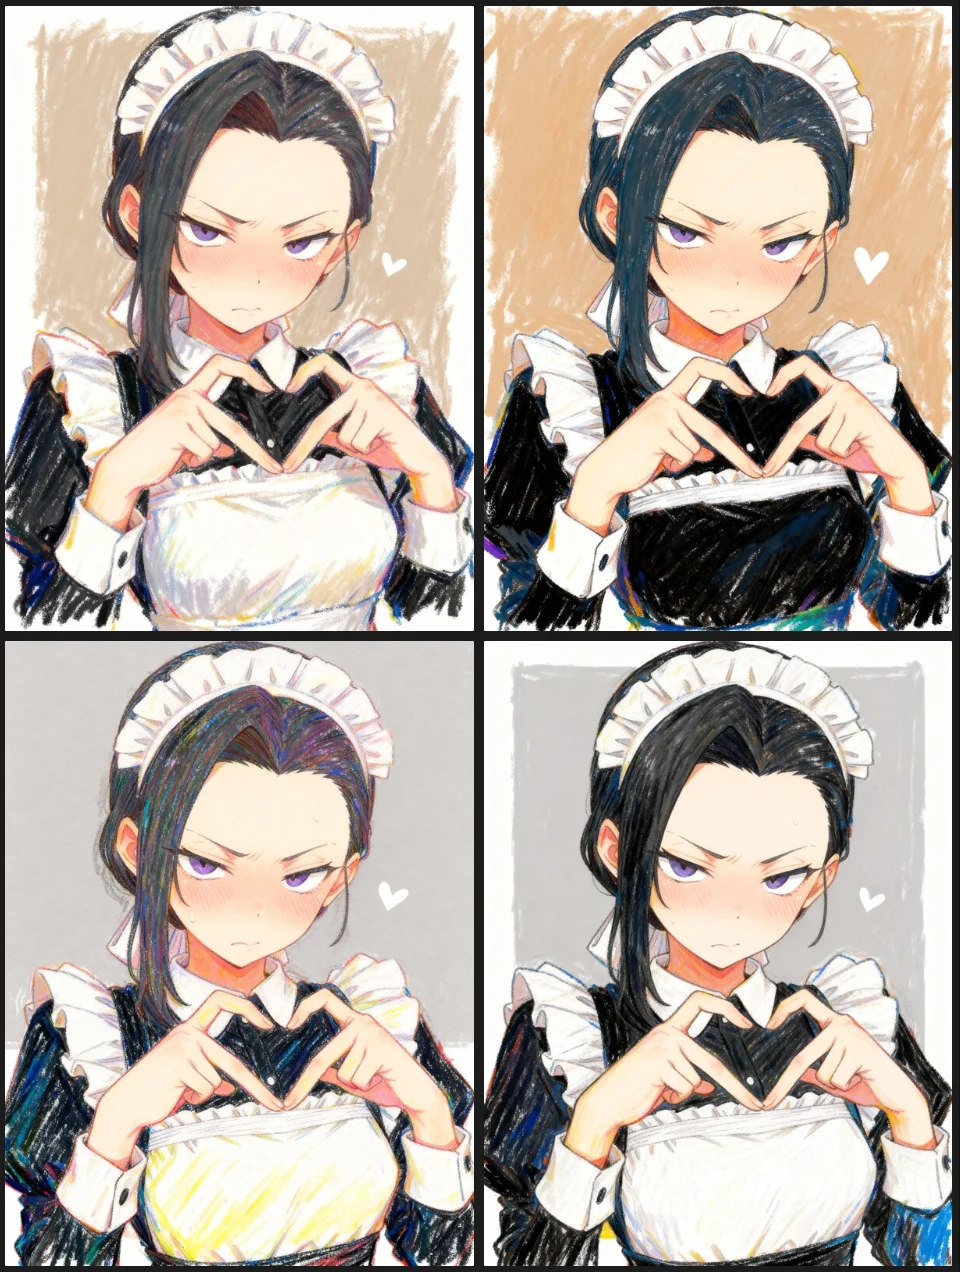
おお、これはクレヨン!ばっちりですね。左上などはエプロンの色の出し方がとても美しいです。
油絵
指示「Convert to oil painting.」
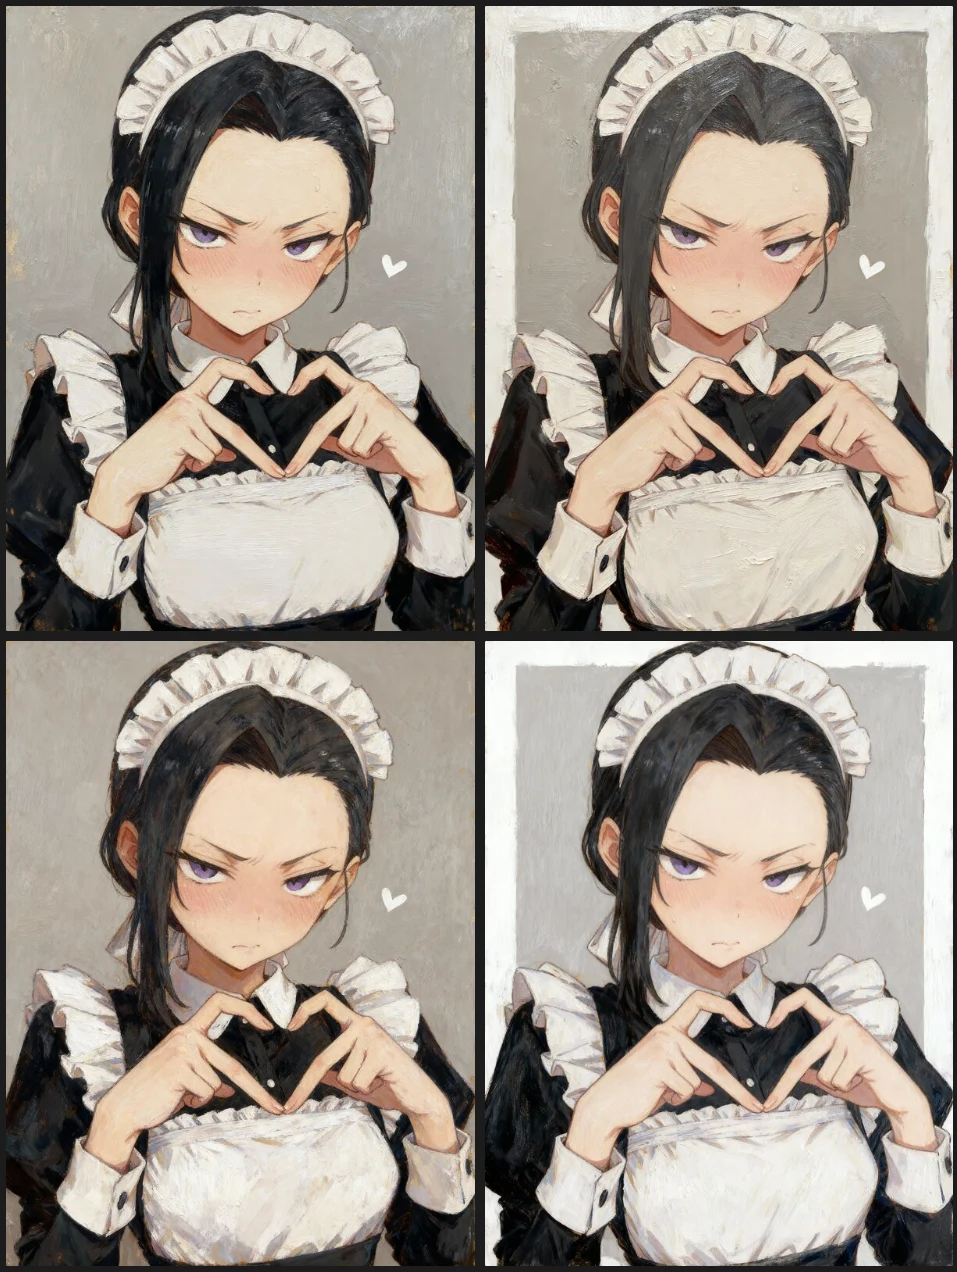
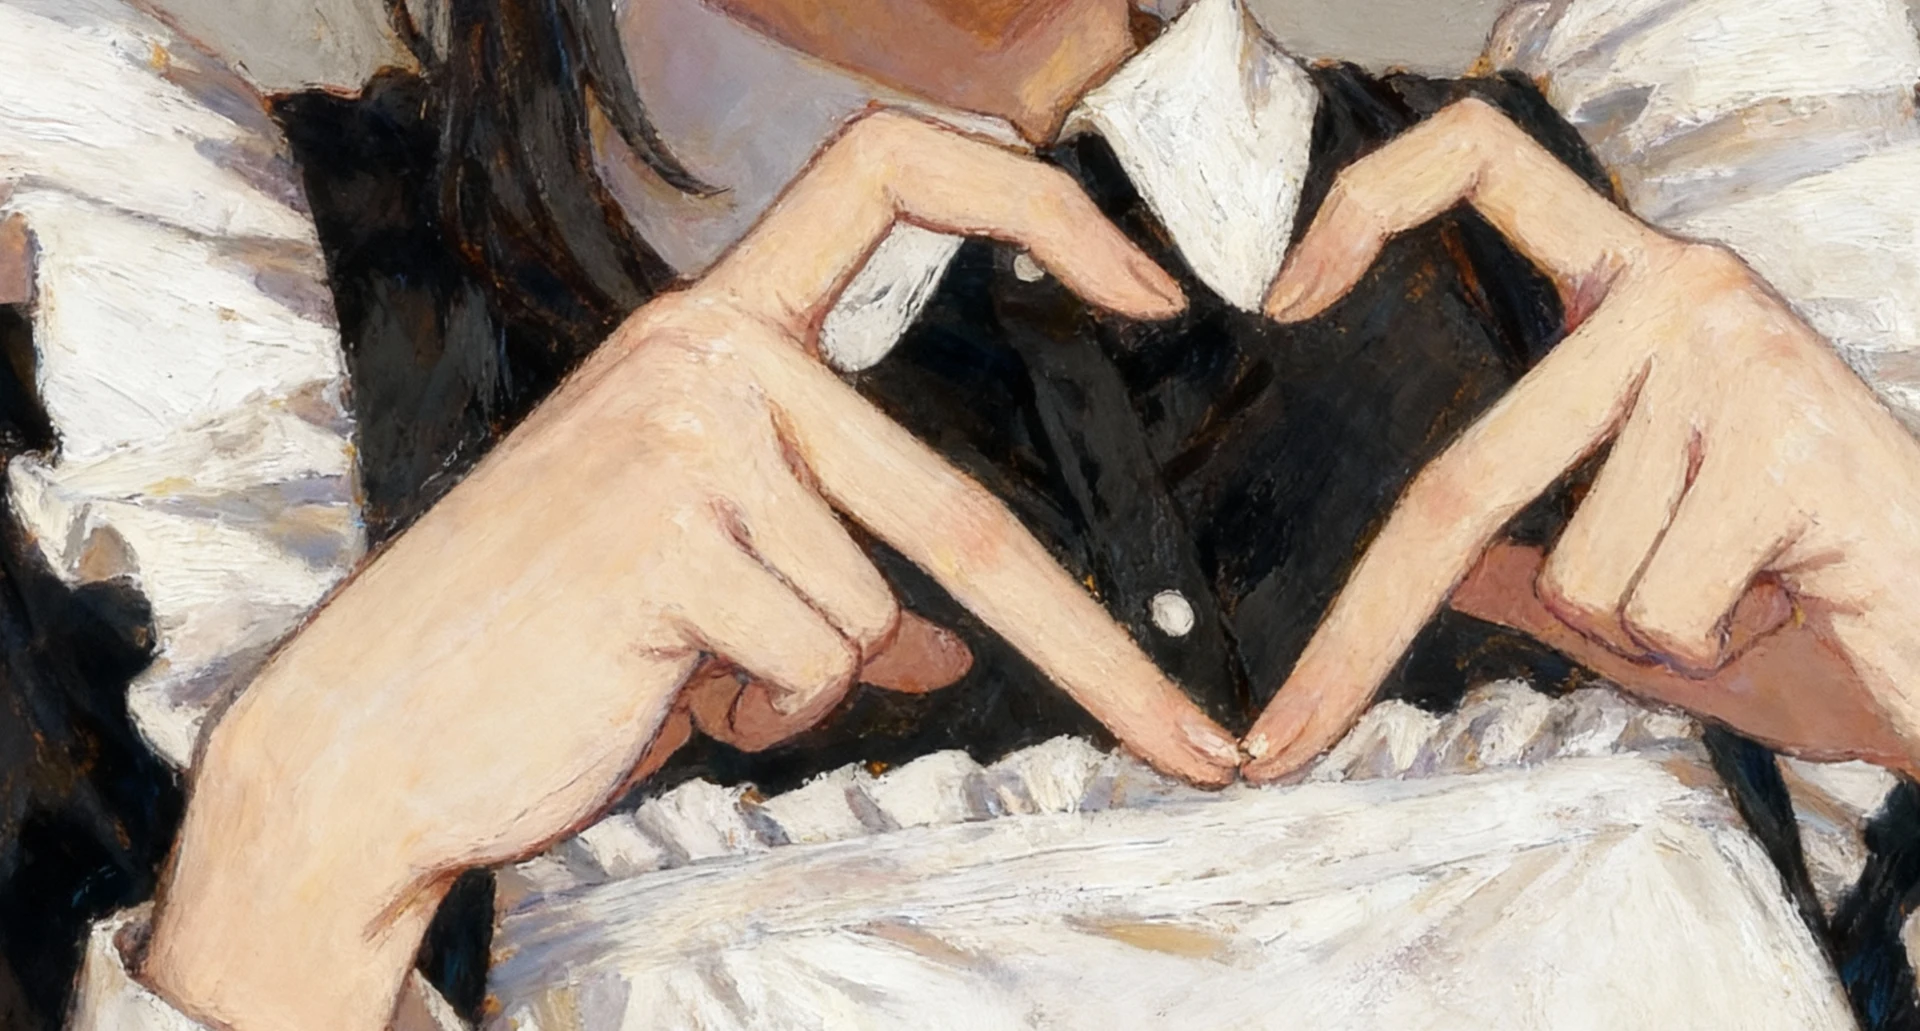
4枚セットだと分かりにくいのですが、1枚1枚をアップで見るとちゃんとタッチが残っていて油絵に見えます。Seedream4.0がNanoBananaに明らかに勝っている点として、この解像度の高さがあります。4Kモードのアスペクト比3:4だと、3072x4096pxという大変大きい画像が素早く生成されるので、その後の画像編集の際に非常に便利ですね。
どんどん見ていきましょう。ちなみに、これらのテスト結果はFreepikで一気に指示を出して作っています。バッチごとの完成を待たずに4枚同時生成がどんどん進むので、あっという間に作業終了するのがFreepikの快適さですね。
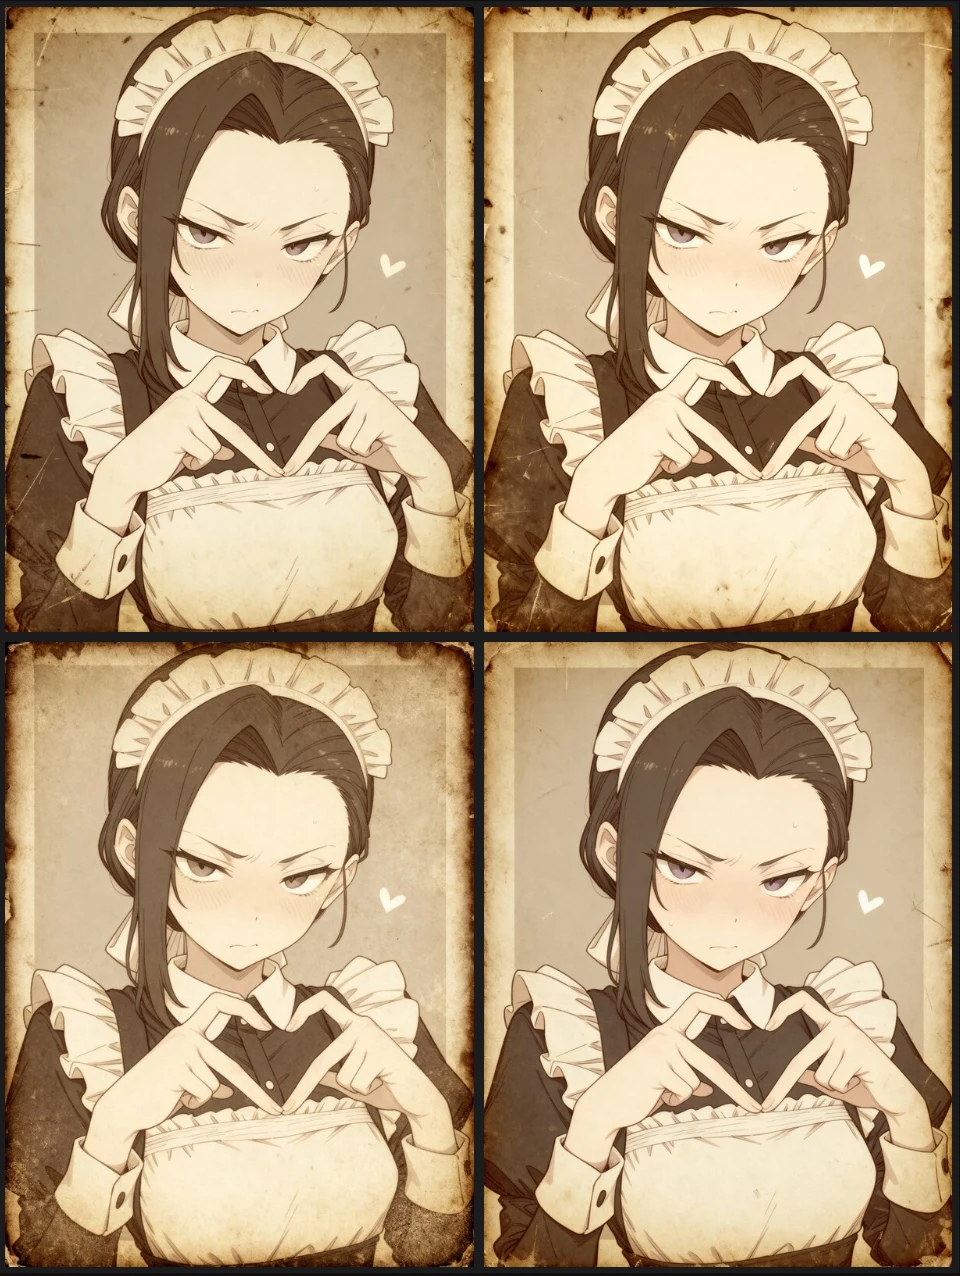
古写真風
指示「Convert to old photograph.」
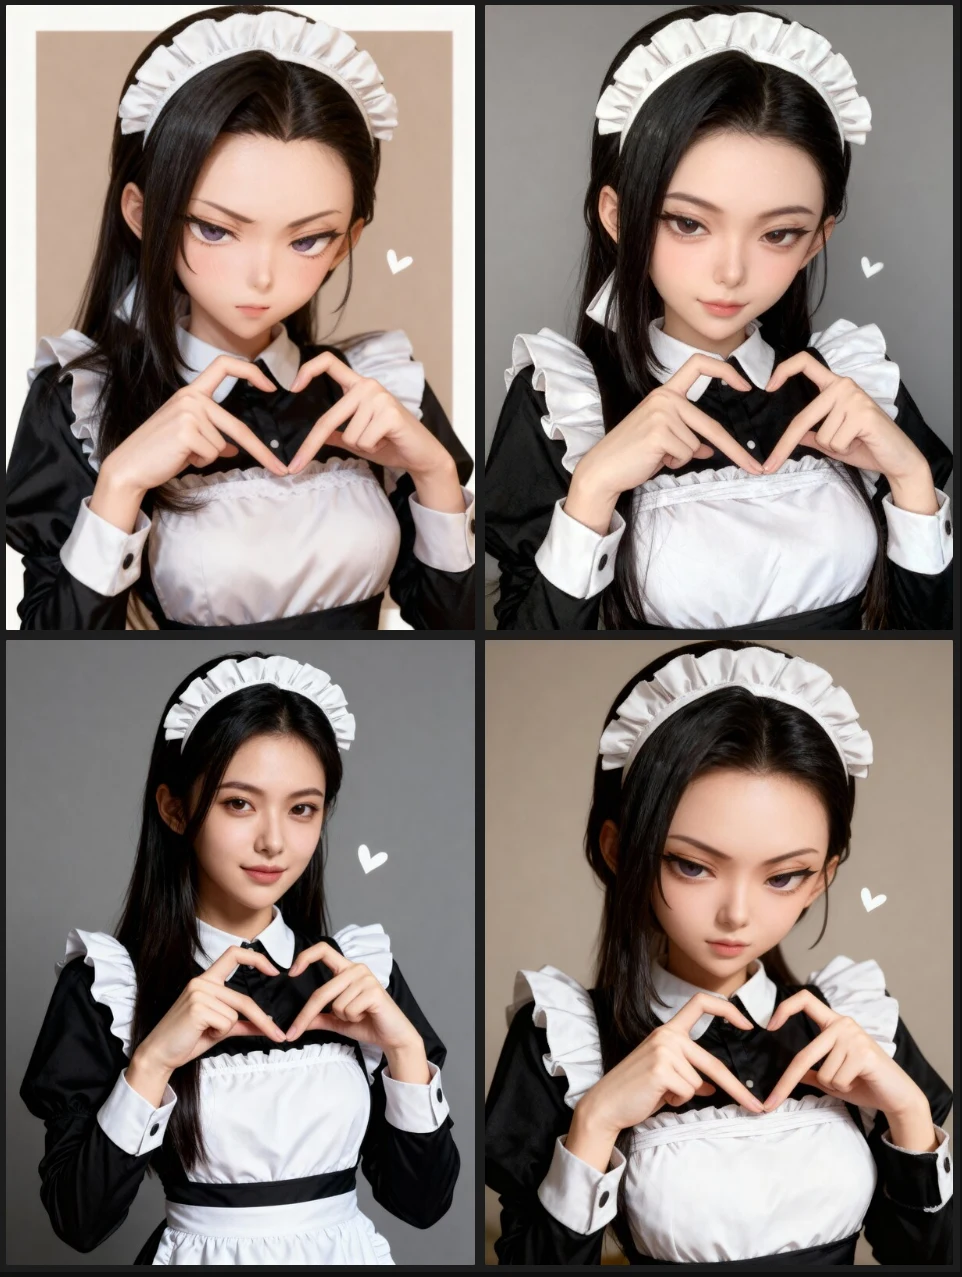
実写風
指示「Convert to photo.」
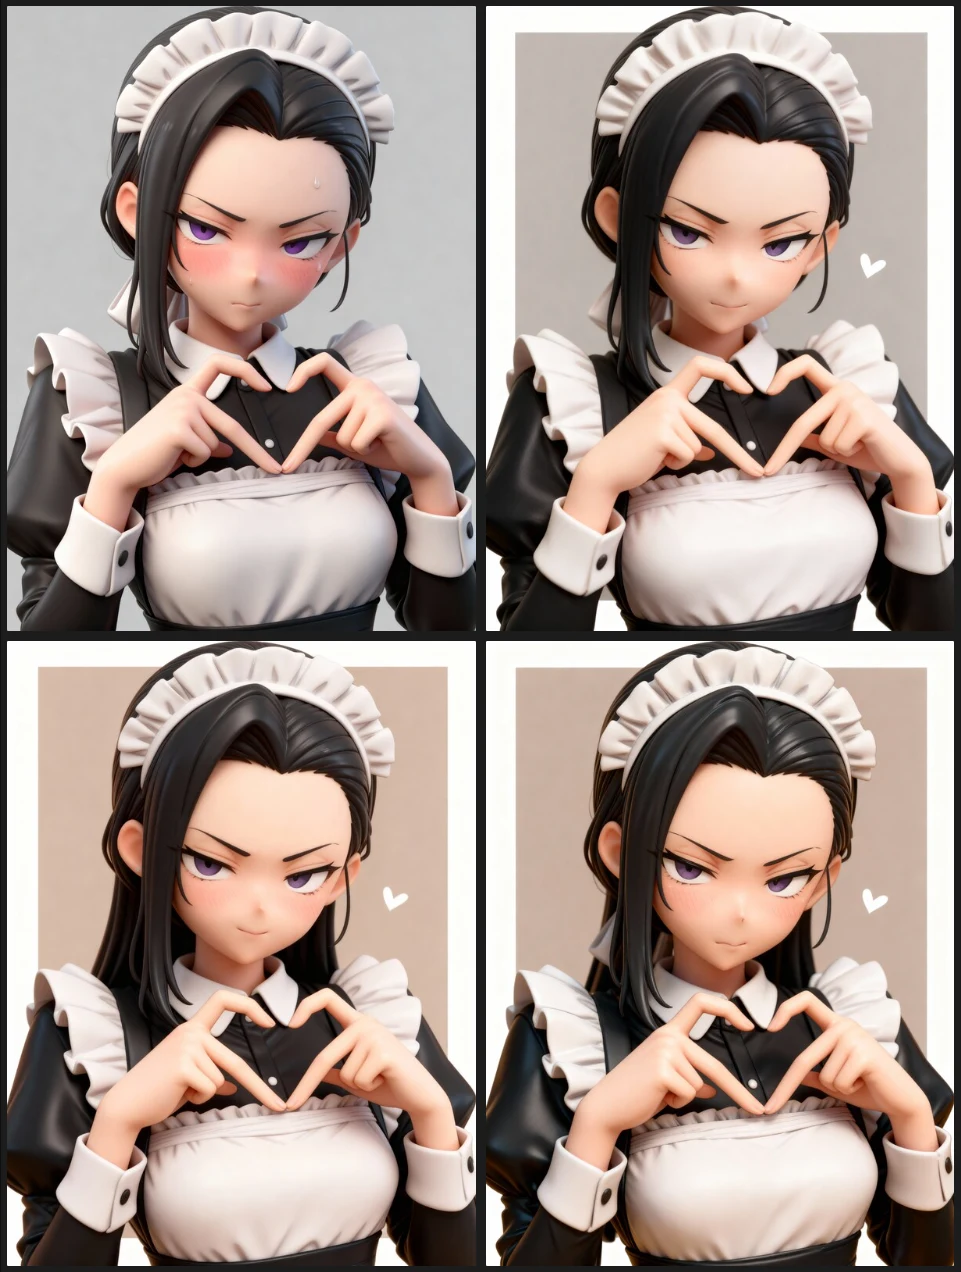
フィギュア風
指示「Convert to character figure.」
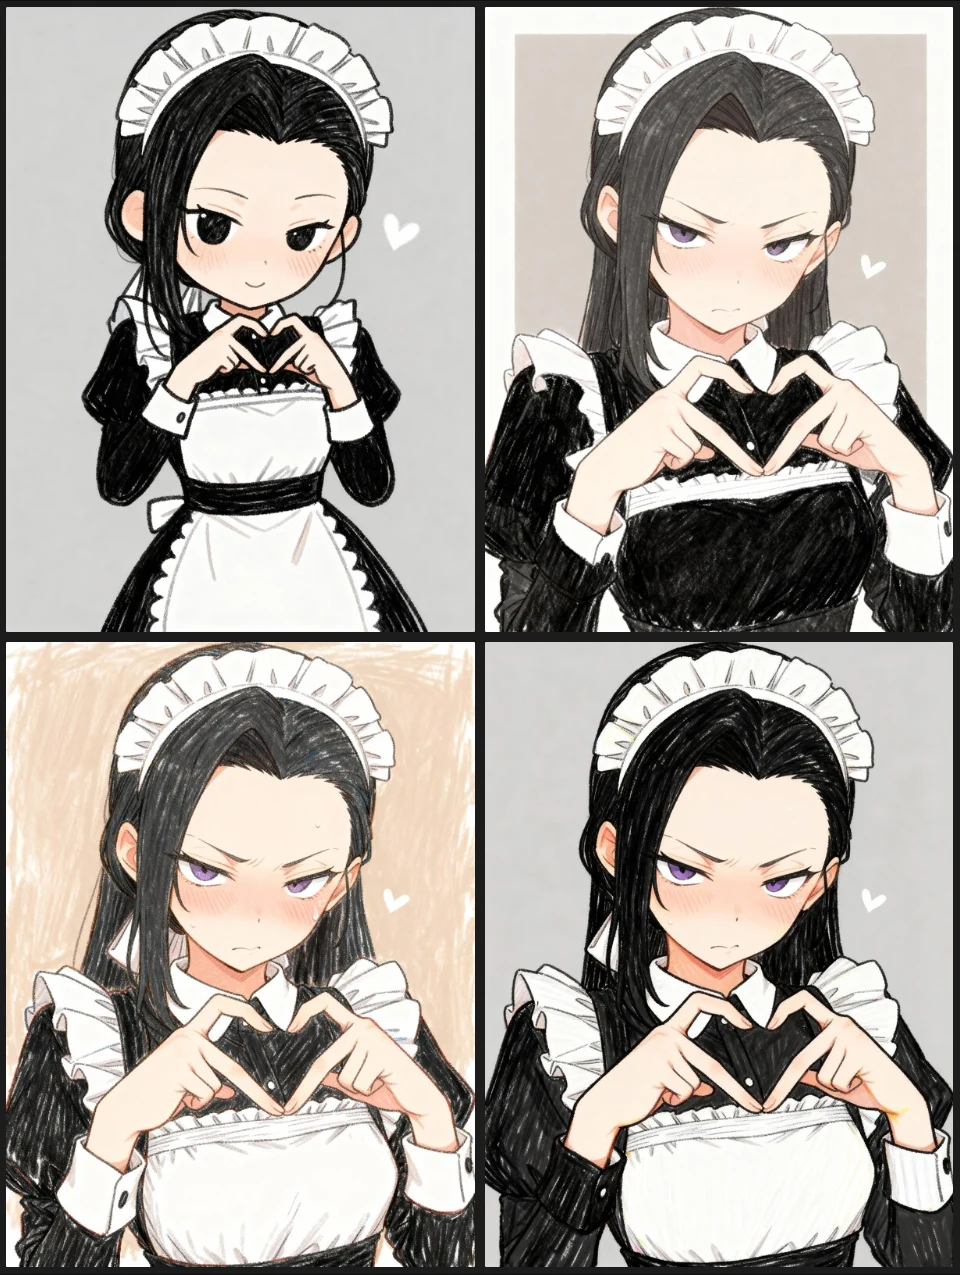
子供の落書き風
指示「Convert childlike doodle style.」
<結果まとめ>
ということで、「Convert to 〇〇」はNanoBananaには及ばないまでも、そこそこ安定した結果になりました。ただ全体に、なぜか髪の毛を長く描き直してしまう現象が起こったのは謎ですね。
ちなみに、「Convert Hatsune Miku Style.」ではこのように、「まあ分かるが…」というような、中途半端な結果になりました。
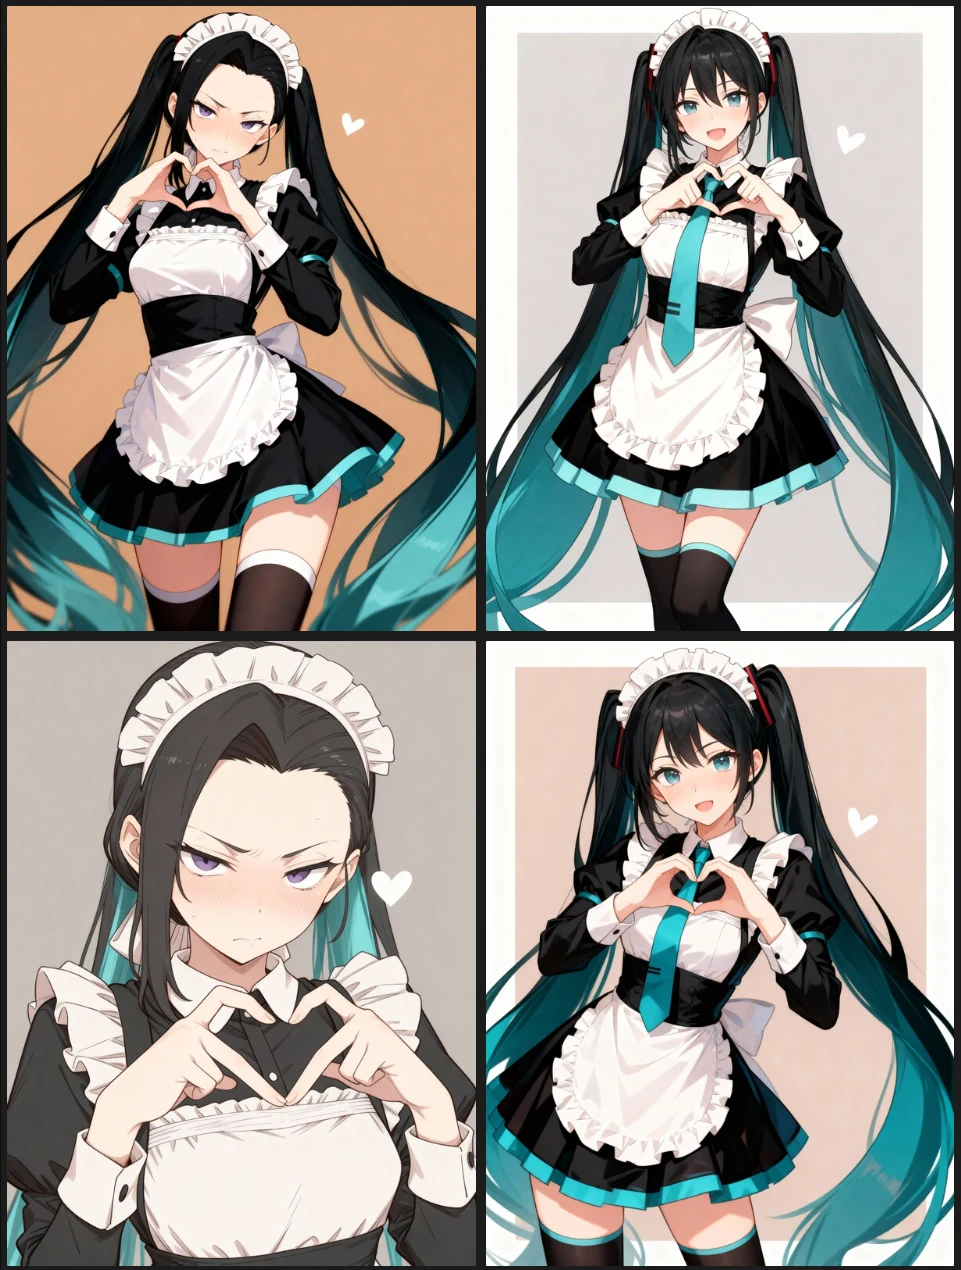
ただ、末尾の「style」を取って、単に「Convert Hatsune Miku」とするとこのようにうまくいったので、NanoBananaでうまくいったプロンプトが単に効きにくいだけということも多くありそうですね。
総評
というわけで、大変長い記事になってしまいましたが、一通り比較実験をやってみました。
御覧になっていただいたとおり、Seedream4.0は「あるキャラクターの容姿を複数枚の画像で参照させて、任意の変更を加える」という作業は大変上手です。他にも、アスペクト比を指定しての生成が自由にできたり、4k解像度で生成ができたり、日本語レンダリングがそこそこできたりと、NanoBananaを明らかに上回っている点はいくつも見つけられるのですが、全体の安定性や取り回しのよさでは基本的にNanoBananaが先を行っている…というのが正直な感想でした。
それよりも、FreepikのPremium+プランを契約して感じたのは、NanoBananaとSeedream4.0を含めたさまざまな生成がいくらでも同時・大量にバッチ連打できる快適さです。どちらも使えるのであれば「どっちが上」と考える必要もないわけで、「基本はNanoBananaで、できなかったらSeedream4.0で」と雑に考えておけばよいですし、Geminiなどと違ってここまで連打生成が快適となると、安定性の低さをガチャで補うという荒業が気軽にできてしまいます。
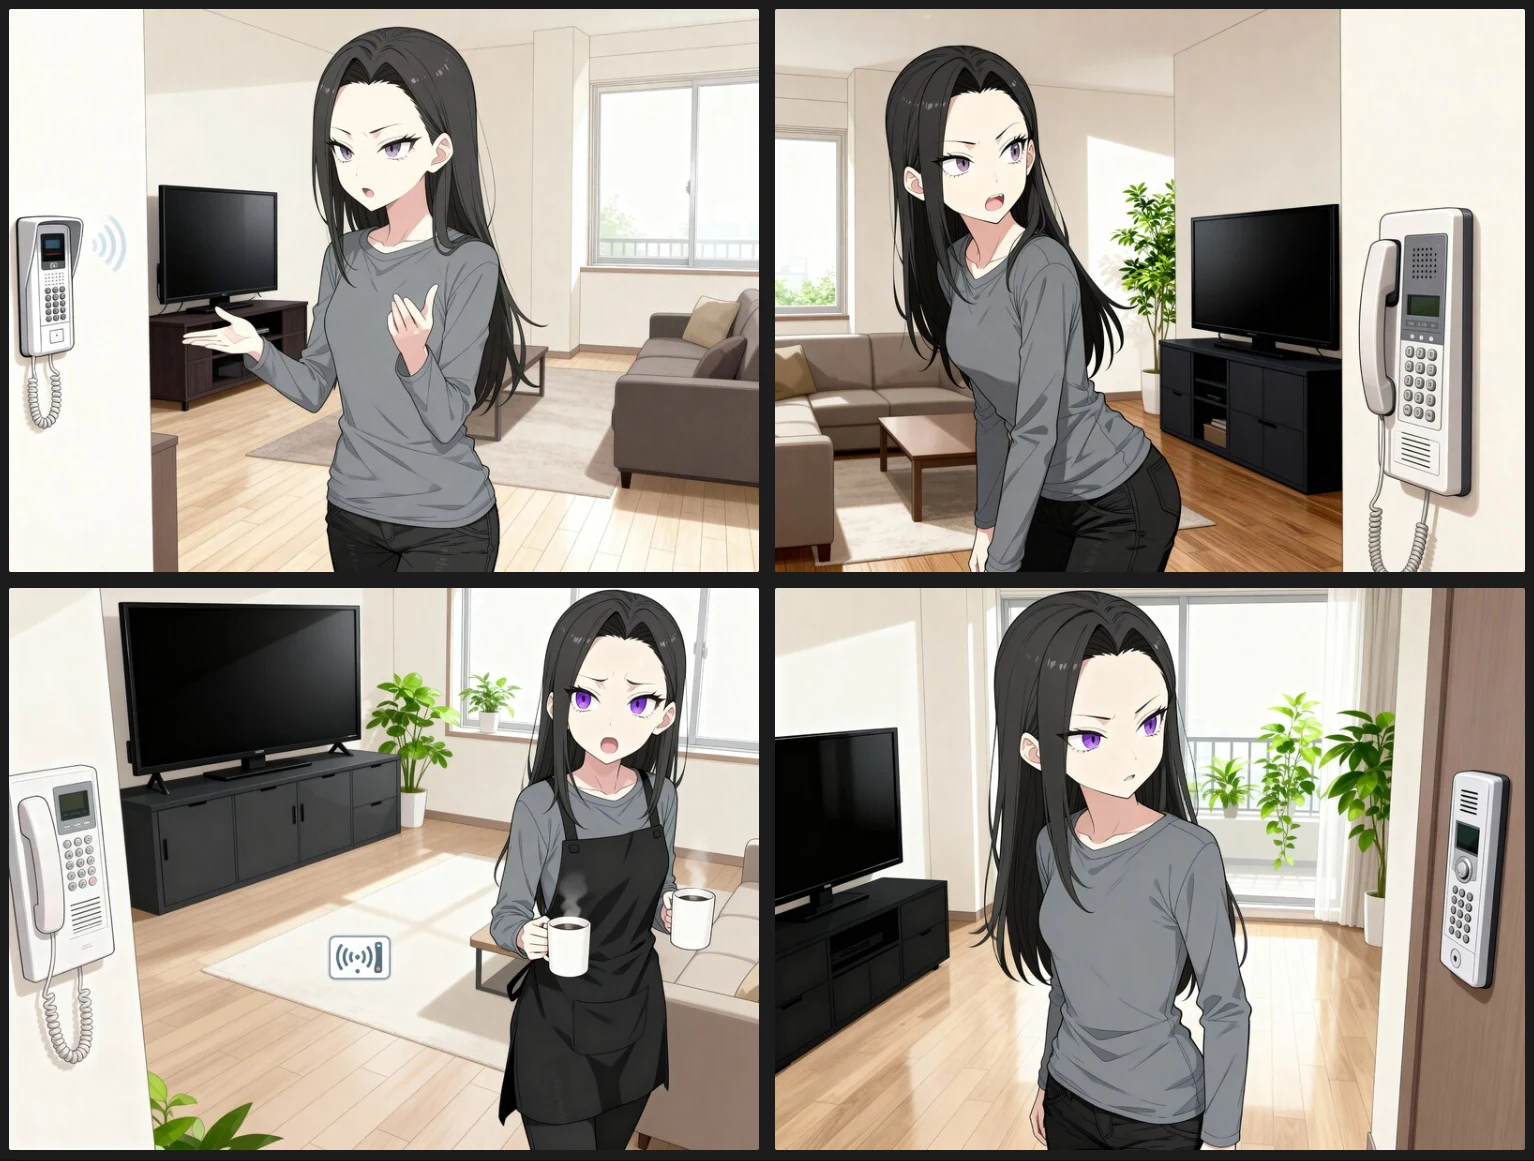
▲リビングでインターホンに気づくシーンをSeedream4に描かせたもの
こうした漫画の一コマのように、キャラクターの一貫性をどうしても保ってほしいし、背景も正確に描いてほしい、というような限られたシチュエーションでは、Seedreamのほうが優位です。ある程度ガチャはしないとなりませんが、無制限に連打できる環境なら、かなり低ストレスで求めているシチュエーションの画像を作ることができると感じました。
今後、Freepikに大量の制限なしユーザーが流れ込んで負担が掛かりすぎると、早晩Premium+プランも改悪されたり制限が掛かったりしてしまうかもしれませんが、記事執筆時点では確かに便利・快適なプランでした。70枚足らずで終わってしまうEssentialプランではこの快適性は味わえないので、加入するならメインのプランはPremium+プランになると思います。Freepikはクーポン配布やBlackFriday割引などで数十%のセールになることがあるそうなので、そうしたタイミングで年払い契約を狙ってみるのもよいかな、と思っています。
先日からこのような二次創作漫画を作っているのですが、Freepikで快適生成ができるようになったおかげで、さまざまな作業がかなり楽にできるようになってきたのを感じます。今後も得られた知見は順次特集していければと思います。
それでは、今回はこのへんで。スタジオ真榊でした。