こんばんは、スタジオ真榊です。前回はシャドウバンについて考察しましたが、本日もAI術師さん向けTwitter攻略術の続きということで、2023年3月31日にGithub上で公開されたツイートのおすすめアルゴリズムについての記事をお届けします。
公開されたソースコードを見た人たちからは、例えば「ツイート拡散の観点において、リプライは『いいね』の27倍の価値がある」とか「フォローしている人数がフォロワー人数より多いアカウントの投稿は拡散されにくくなる」といった情報が次々に投稿され、話題になっています。ただ、ソースコードをよく見てみると、どうも我々の投稿は、ちまたでよく言われているものとはちょっと違う仕組みで採点されていることがわかってきました。
そこで、いつもの実験を行うことにしました。「公開された情報を参考にしたら実際にバズることはできるのか?」ということで、非フォロワーに拡散されやすくなるという要素を研究し、全部盛りにしたツイートをしてみた結果がこちらです。
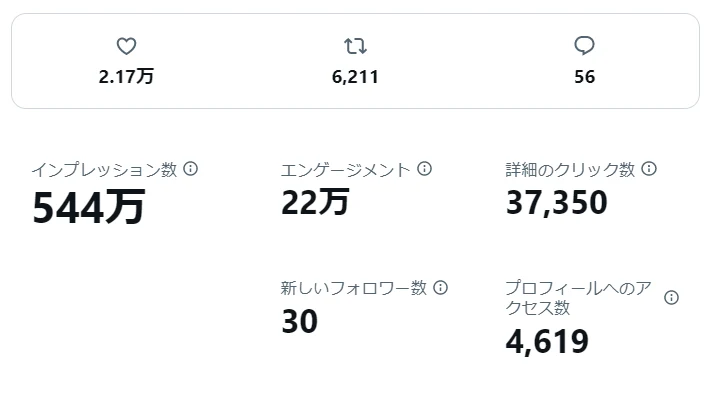
スタジオ真榊のアカウントでは、いきなり過去最も拡散されたツイートになってしまいました。あからさまに拡散を狙いに行ったツイートだったのでなかなか書いていて恥ずかしかったのですが、予想以上の結果だ…
そんなわけで、今回はアルゴリズムの内容を分かりやすく解説しながら、あくまでAI術師の観点から「どうしたら多くの人のTLに自分のAIイラスト投稿を表示できるのか?」または「なぜ自分のAIイラストはツイッターに拡散してもらえないのか?」ということを考える記事にしていきたいと思います。今回も長くなりますが、どうぞおつきあい下さい。
公開されたアルゴリズム
さて、旧ツイッター社(現在は合併してX社)は2023年3月31日、「おすすめ(For You)」タイムライン表示に関するアルゴリズムのソースコードをgithub上に公開しました。
公開されたソースコードはこちら。
公開情報は非常にボリュームが多いので、ポイントを要約して説明しますと、おすすめTLに表示される「優良ツイート」は次のような3段階のプロセスで決められていることがこの情報から明らかになりました。
1.候補ソーシング(Candidate Sourcing)
まず、さまざまなデータを基に、そのユーザーにおすすめすべきツイートが1500個抽出されます。この段階で、フォローしているユーザーの投稿と、フォローしていないユーザーの投稿がほぼ50:50になるように調整されます。ざっくり言うと、フォローしている人のツイートは「リプライやいいねでやりとりしている仲良しユーザーのもの」がおすすめされやすく、フォローしていない人のツイートの場合は「そのユーザーにぴったりだと思われるもの」が選ばれやすくなっています。
2.ランク付け(Rank)
「Heavy Ranker」という機械学習モデル(AI)を使って、取得した1500件のツイートにランク付けし、よりそのユーザーにあったものを上位に表示できるように並び替えます。
3.経験則フィルタリング(heuristics and filters)
最後の仕上げとして、取得したツイートの中から、ブロックした人物の投稿、NSFW(成人向け) コンテンツ、既に読んだツイートなど、そのユーザーが望まないと思われるツイートを選び出してキック(除外)します。
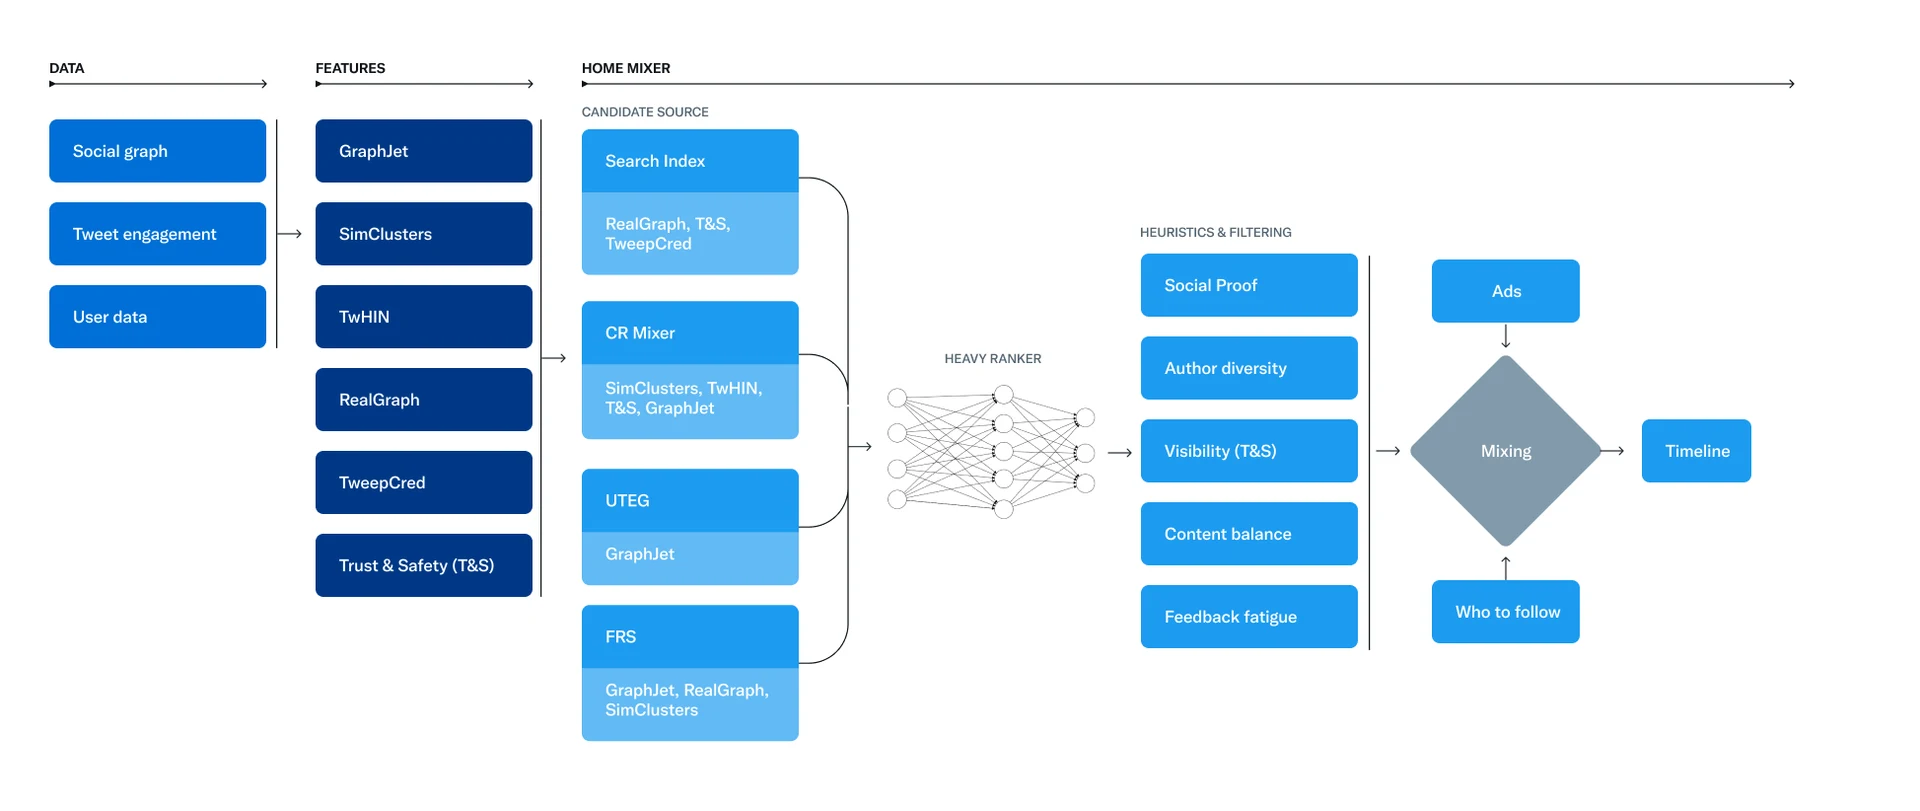
こちらの画像(▲)が、おすすめツイートがタイムラインに届くまでのフローチャートです。今紹介した3つのプロセスは、「HomeMixer」と上部に書かれた中央から右の部分で行われているもので、実はその前にも1500件のツイートを抽出する前提となる段階があるようです。
何はともあれ、この3段階のプロセスによって、そのユーザーだけの「フォロー内外50:50のおすすめTL」ができあがります。1500件の候補を出して、細かくランキングして、余計なものはフィルタリングする、という流れですね。(※正確には、最後に広告ツイートを混ぜる工程が加わるのですが、パーセンテージが分かりにくくなるので割愛します)
無関係の人のTLに載るツイートとは?
上手にアルゴリズムの波に乗っかれたら、自分の投稿をより多くの人に見てもらえることにつながるので、ぜひコツが知りたくなりますね。AI術師にとってまず気になるのは、「非フォローユーザーのおすすめツイート」がどうやって選び出されているかということでしょう。この点について、ツイッター側は「ソーシャルグラフ(Social Graph)」と「埋め込みスペース(Embedding Spaces)」という二つの手法によって判断しているとしています。
「ソーシャルグラフ」は、「フォローしている人々が最近エンゲージしたツイートはどれか」「自分に似たツイートを気に入ったユーザーは誰か」「最近はほかにどんな内容を気に入っているか」を解析して、ユーザーごとのおすすめツイートを抽出するもの。「埋め込みスペース」は、例えば「サッカー」や「AI」など、ユーザーの興味関心のあるコミュニティごとにインフルエンサーや人気ツイートを抽出することで、ユーザーが関心を持つと思われるツイートやユーザーを判断するもの。ちなみに、フォローしていないユーザーのおすすめツイートは全体の50%に当たりますが、この50%のうち15%がソーシャルグラフで、35%が埋め込みスペースで抽出されるそうです。
AIイラストツイートをフォロワー外にも拡散したいのであれば、まずは「AIイラスト界隈」のアカウントに評価されるようなツイートを目指す・・・ということになるわけですが、それだとぼんやりしすぎてよく分かりませんね。ここでは、「おすすめされるツイートの半分は知らない人の投稿」で、「自分の普段の行動や所属コミュニティを基にツイッター側が勝手に選んだツイートがおすすめされている」とだけ理解しておけばOKです。
「ランク付け」のひみつ
さて、このようにして抽出された1500件のツイートは次に「HeavyRanker」と呼ばれるスコア計算機でランク付けされます(上の画像の中央部分)。これは、「そのユーザーが当該ツイートをいいねしそうかどうか」「リツイートしそうかどうか」などを、過去の行動パターンから機械学習モデルを使って予測する仕組みのようです。
公開されたソースコードによると、その際に下記のようなルールで軽重をつけたスコア評価がなされることが分かりました。
「いいね:+0.5」「リプライ:+13.5」などと書かれているので、「なるほど、たくさんいいねやリプライされているツイートがおすすめされるんだな」と思いがちですが、どうもそうではないようです。そのように解説している記事も多いのですが、素直に公開情報を読む限り、「過去のデータを踏まえ、その投稿を見たあなたがどんなアクションを起こすかの確率」を機械学習モデルが予想して、それが起きる頻度による「重み」を掛けてスコアリングしている、と読めるのです。
例えば、あなたがあるツイートを見ていいねをする頻度とブロックをする頻度はだいぶ掛け離れていますよね。いいねは頻繁に、リツイートはたまに、ブロックはまれに、通報はごくまれに、が普通です。つまり、それぞれの行動の評価を等価値にするのではなく「重み」を分けてスコアリングしないと、頻繁に起こる「いいね」の評価ばかりに振り回されてしまいます。ソースコードを見ますと、ユーザーが頻繁にする行為ほど重みが軽くなっているだけでなく、行動ごとにポイント上限も設けられていることが分かってきました。
以上、あくまで現時点の個人的見解ではありますが、そうした前提でこちらのリストをご覧ください。